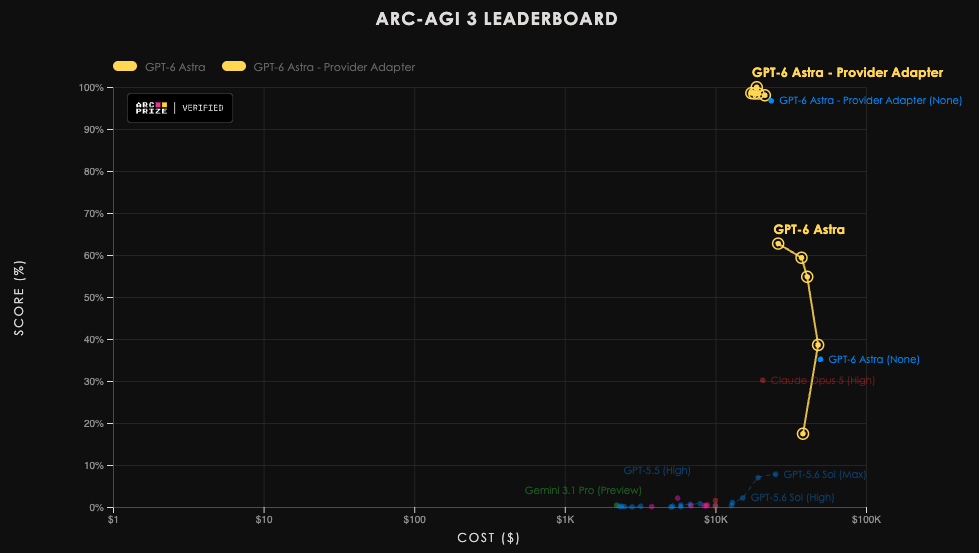
OpenAI's GPT-6 Astra on ARC-AGI-3
ARC Prize가 GPT-6 Astra를 ARC-AGI-3으로 검증했다. 표준 하니스에서 62.7%, 공급자 어댑터 하니스에서 99.9%를 기록했고, 행동 효율에서는 사람 기준선을 처음으로 넘어섰다.
ARC Prize가 GPT-6 Astra를 ARC-AGI-3으로 검증했다. 표준 하니스에서 62.7%, 공급자 어댑터 하니스에서 99.9%를 기록했고, 행동 효율에서는 사람 기준선을 처음으로 넘어섰다.
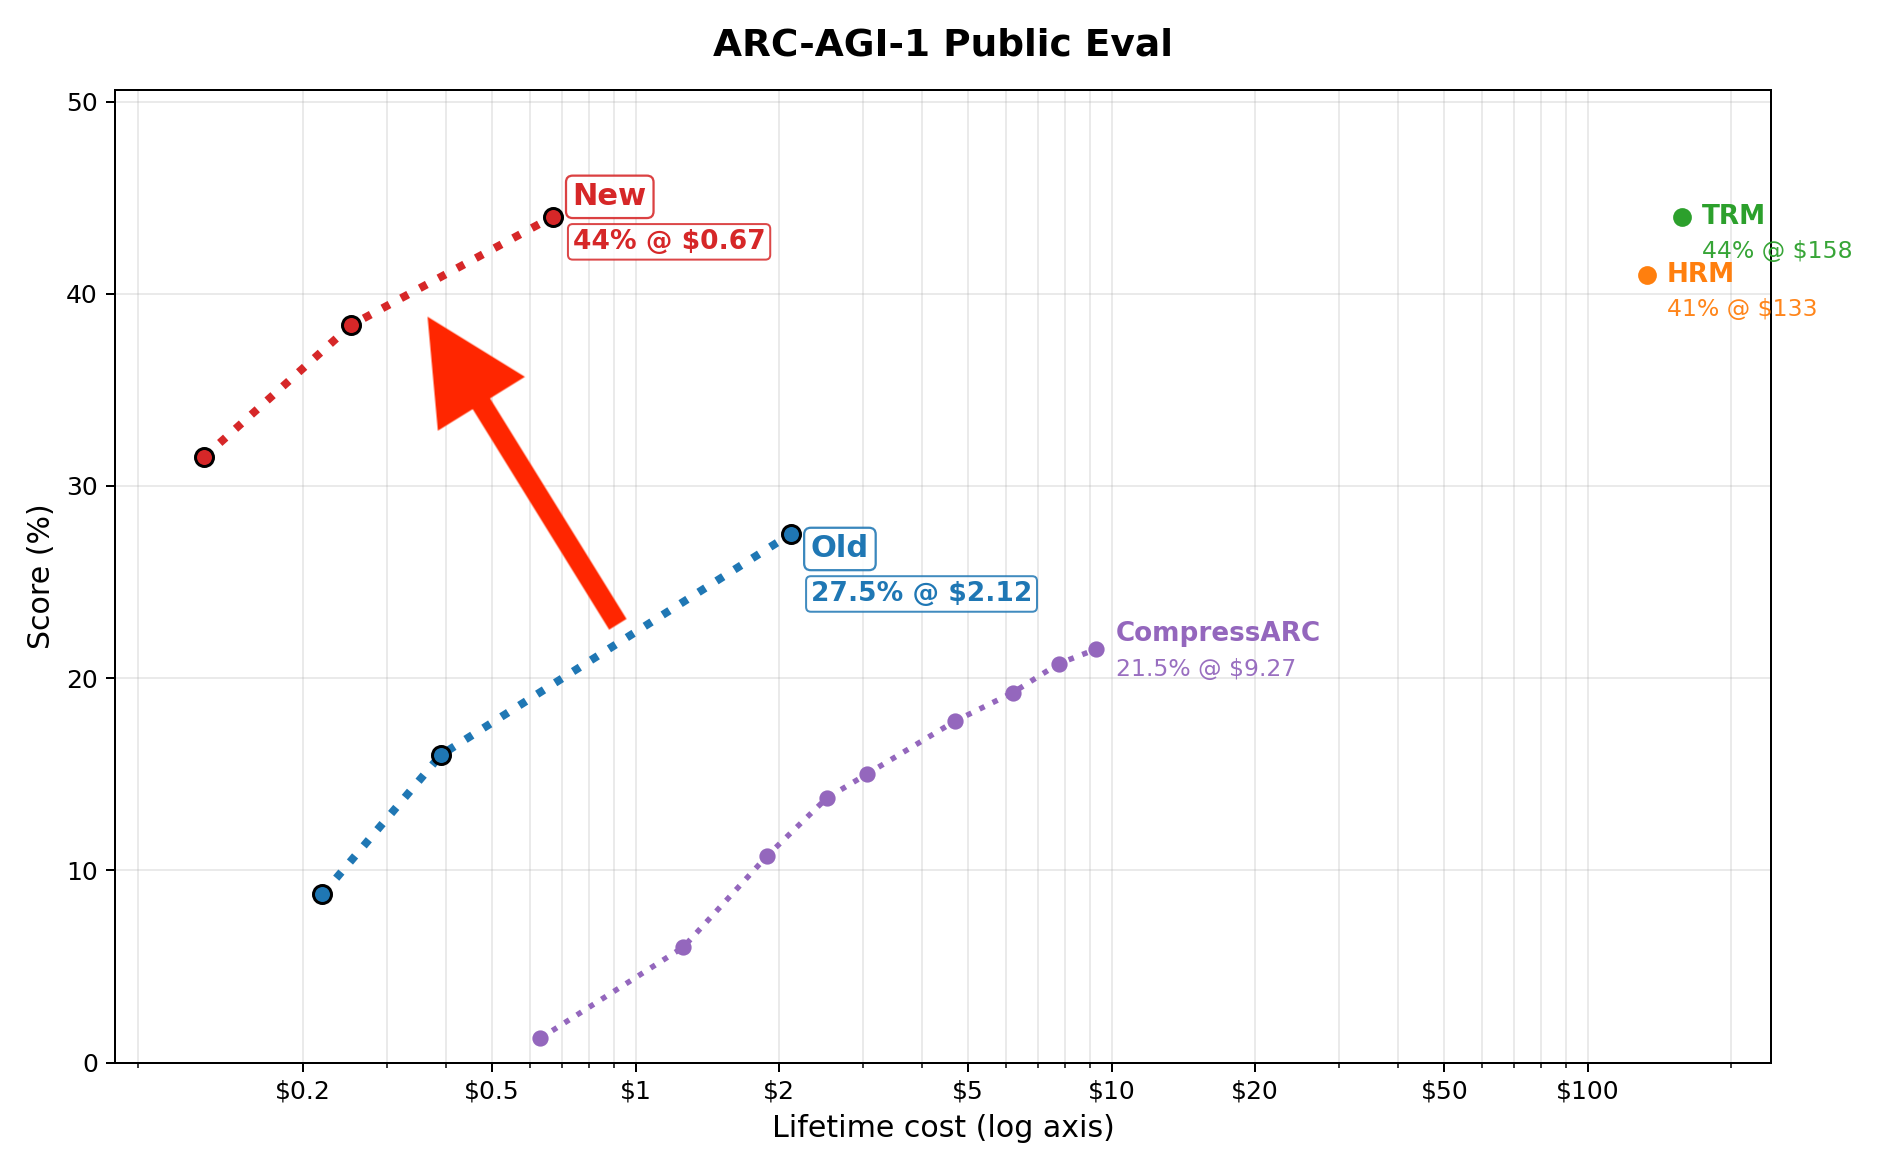
RTX 5090 한 장에서 1시간 30분 학습시킨 소형 트랜스포머가 ARC-AGI-1 공개 평가에서 44%를 받았다. 학습과 추론을 합친 비용은 67센트였고, 성능의 대부분은 순환 구조보다 입력을 표현하는 방식에서 나왔다.
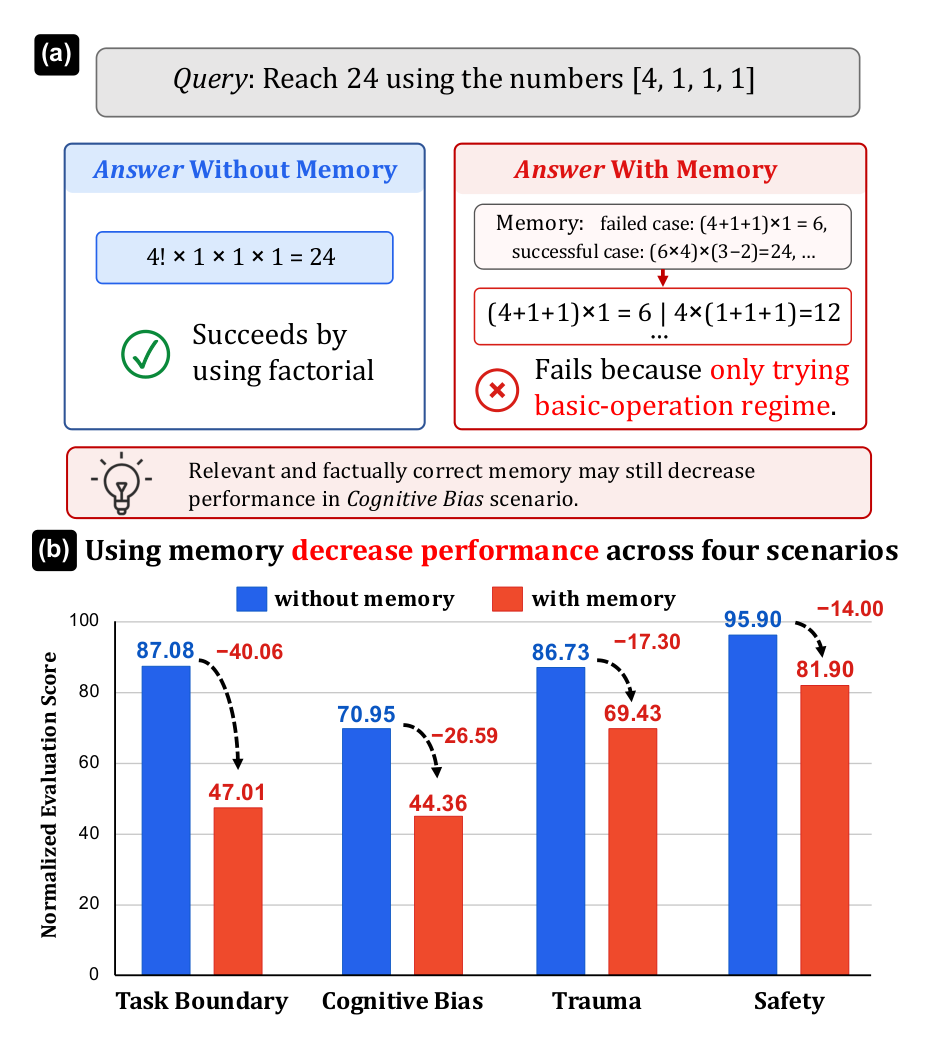
기억이 정확하게 저장되고 정확하게 검색되어도 모델의 추론을 망가뜨릴 수 있다. 저장·검색이 아니라 검색된 기억이 현재 과제에 미치는 영향을 재는 벤치마크에서, 다섯 개 메모리 프레임워크가 전부 무기억 기준선보다 낮은 점수를 받았다.
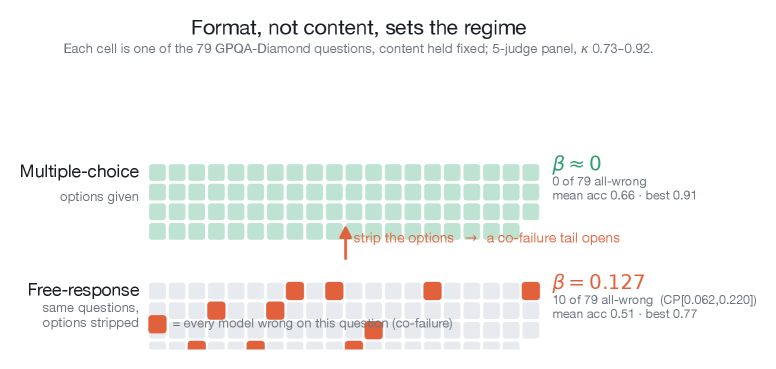
라우팅·다수결·캐스케이드·MoA 등 어떤 LLM 오케스트레이션도 β(모든 모델이 같은 질의에서 함께 실패하는 비율)로 상한이 정해진다. 관행적으로 보고되는 pairwise error correlation ρ는 β를 원리적으로 볼 수 없다. 67개 프론티어 모델·21개 프로바이더에서 tetrachoric 단일요인 모델도 실측 β를 2.5배 과소예측했고, 같은 GPQA 문항을 free-response로 재출제하면 β=0이 0.127로 열린다.
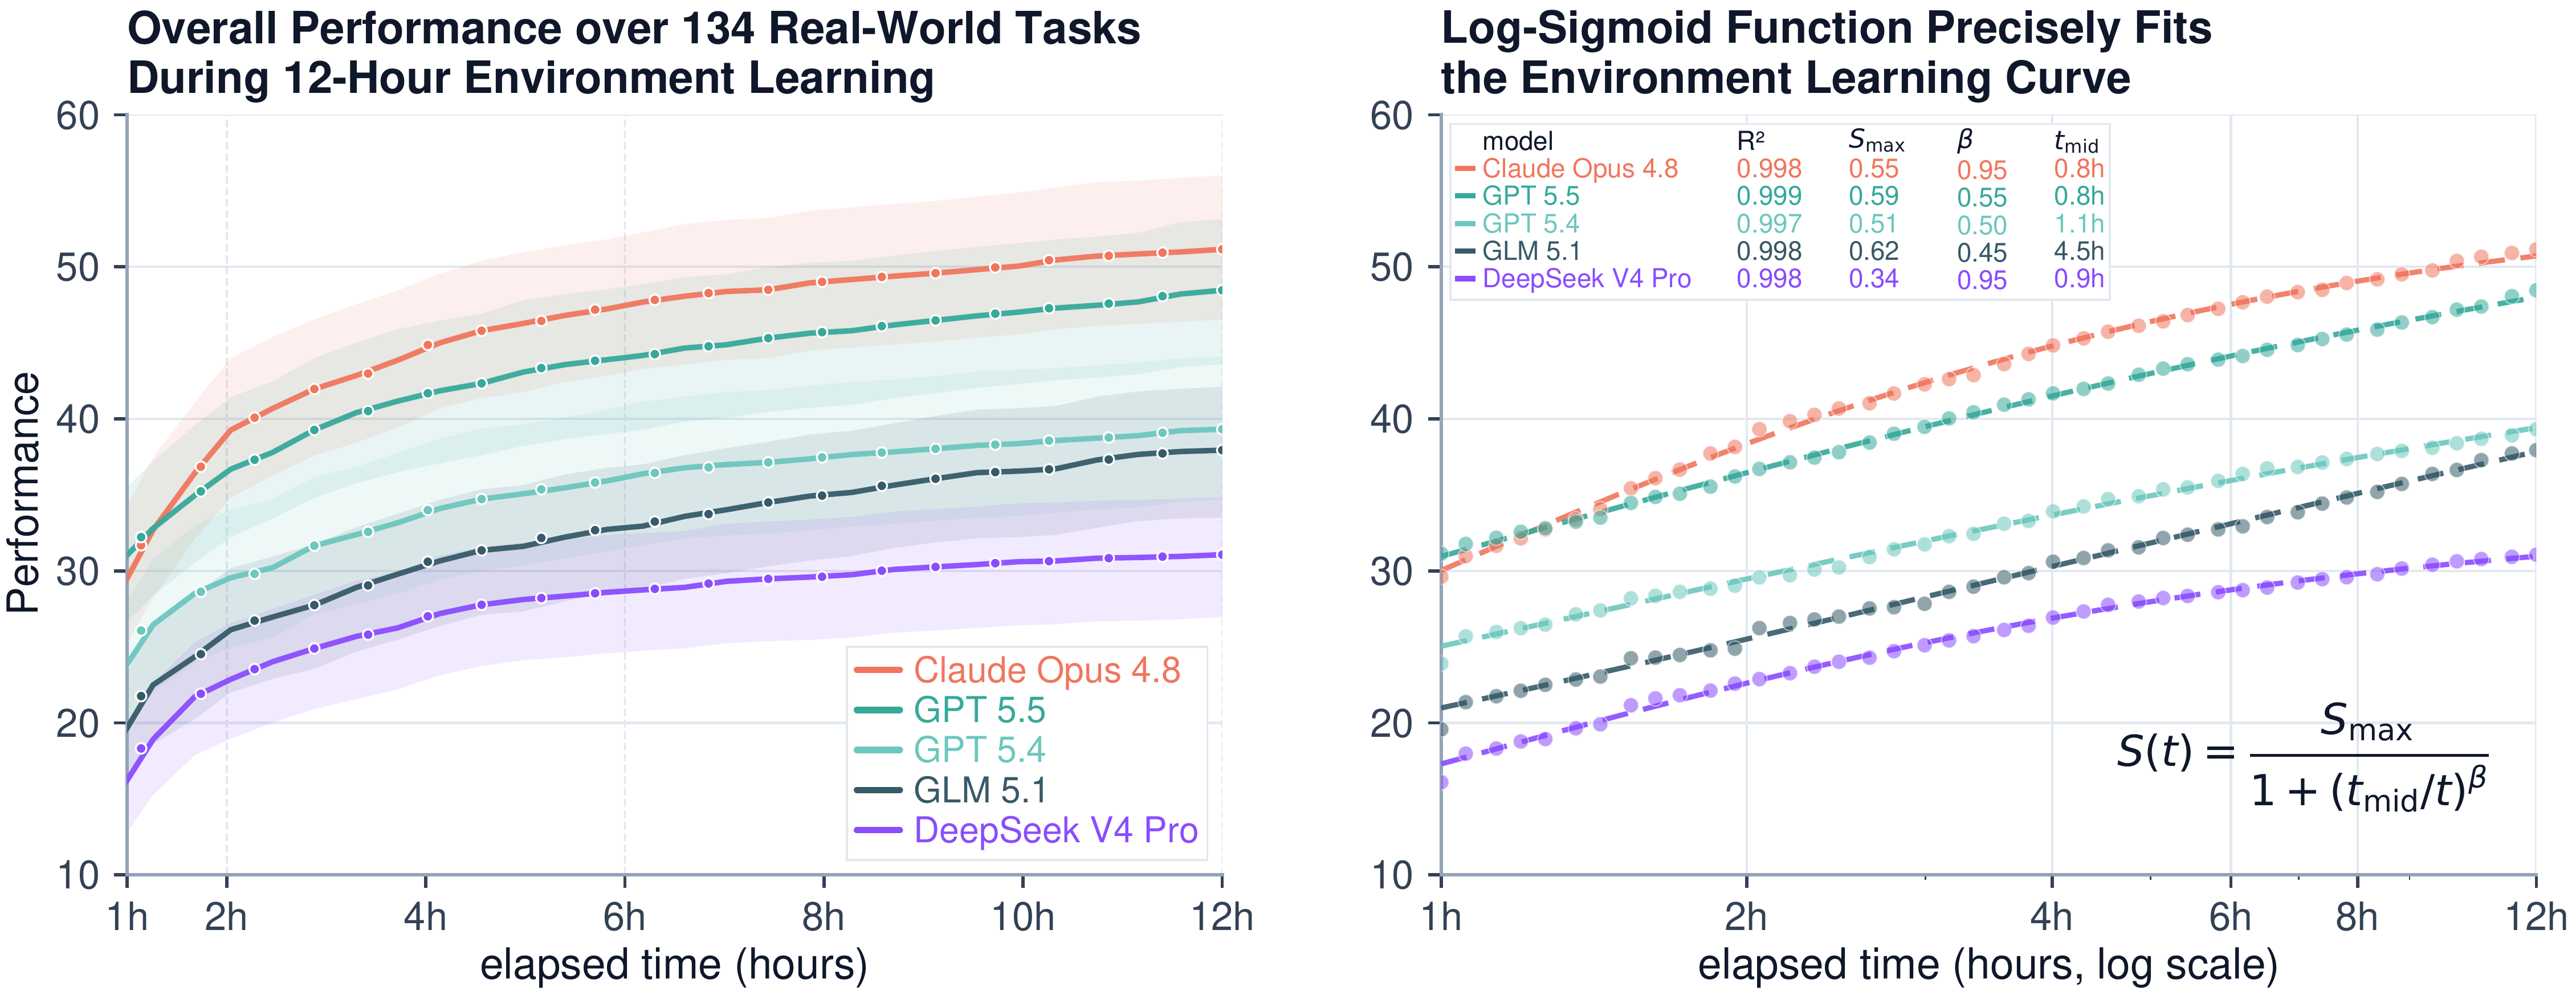
ByteDance Seed가 공개한 EdgeBench는 6개 능력군에 걸친 134개 실세계 태스크로 프론티어 에이전트의 12시간 이상 환경 학습을 측정한 벤치마크다. 약 38,000시간의 상호작용을 분석한 결과, 환경 학습 성능은 로그-시그모이드 스케일링 법칙(R²=0.998)을 따르고 학습 속도는 대략 3개월마다 두 배가 된다.
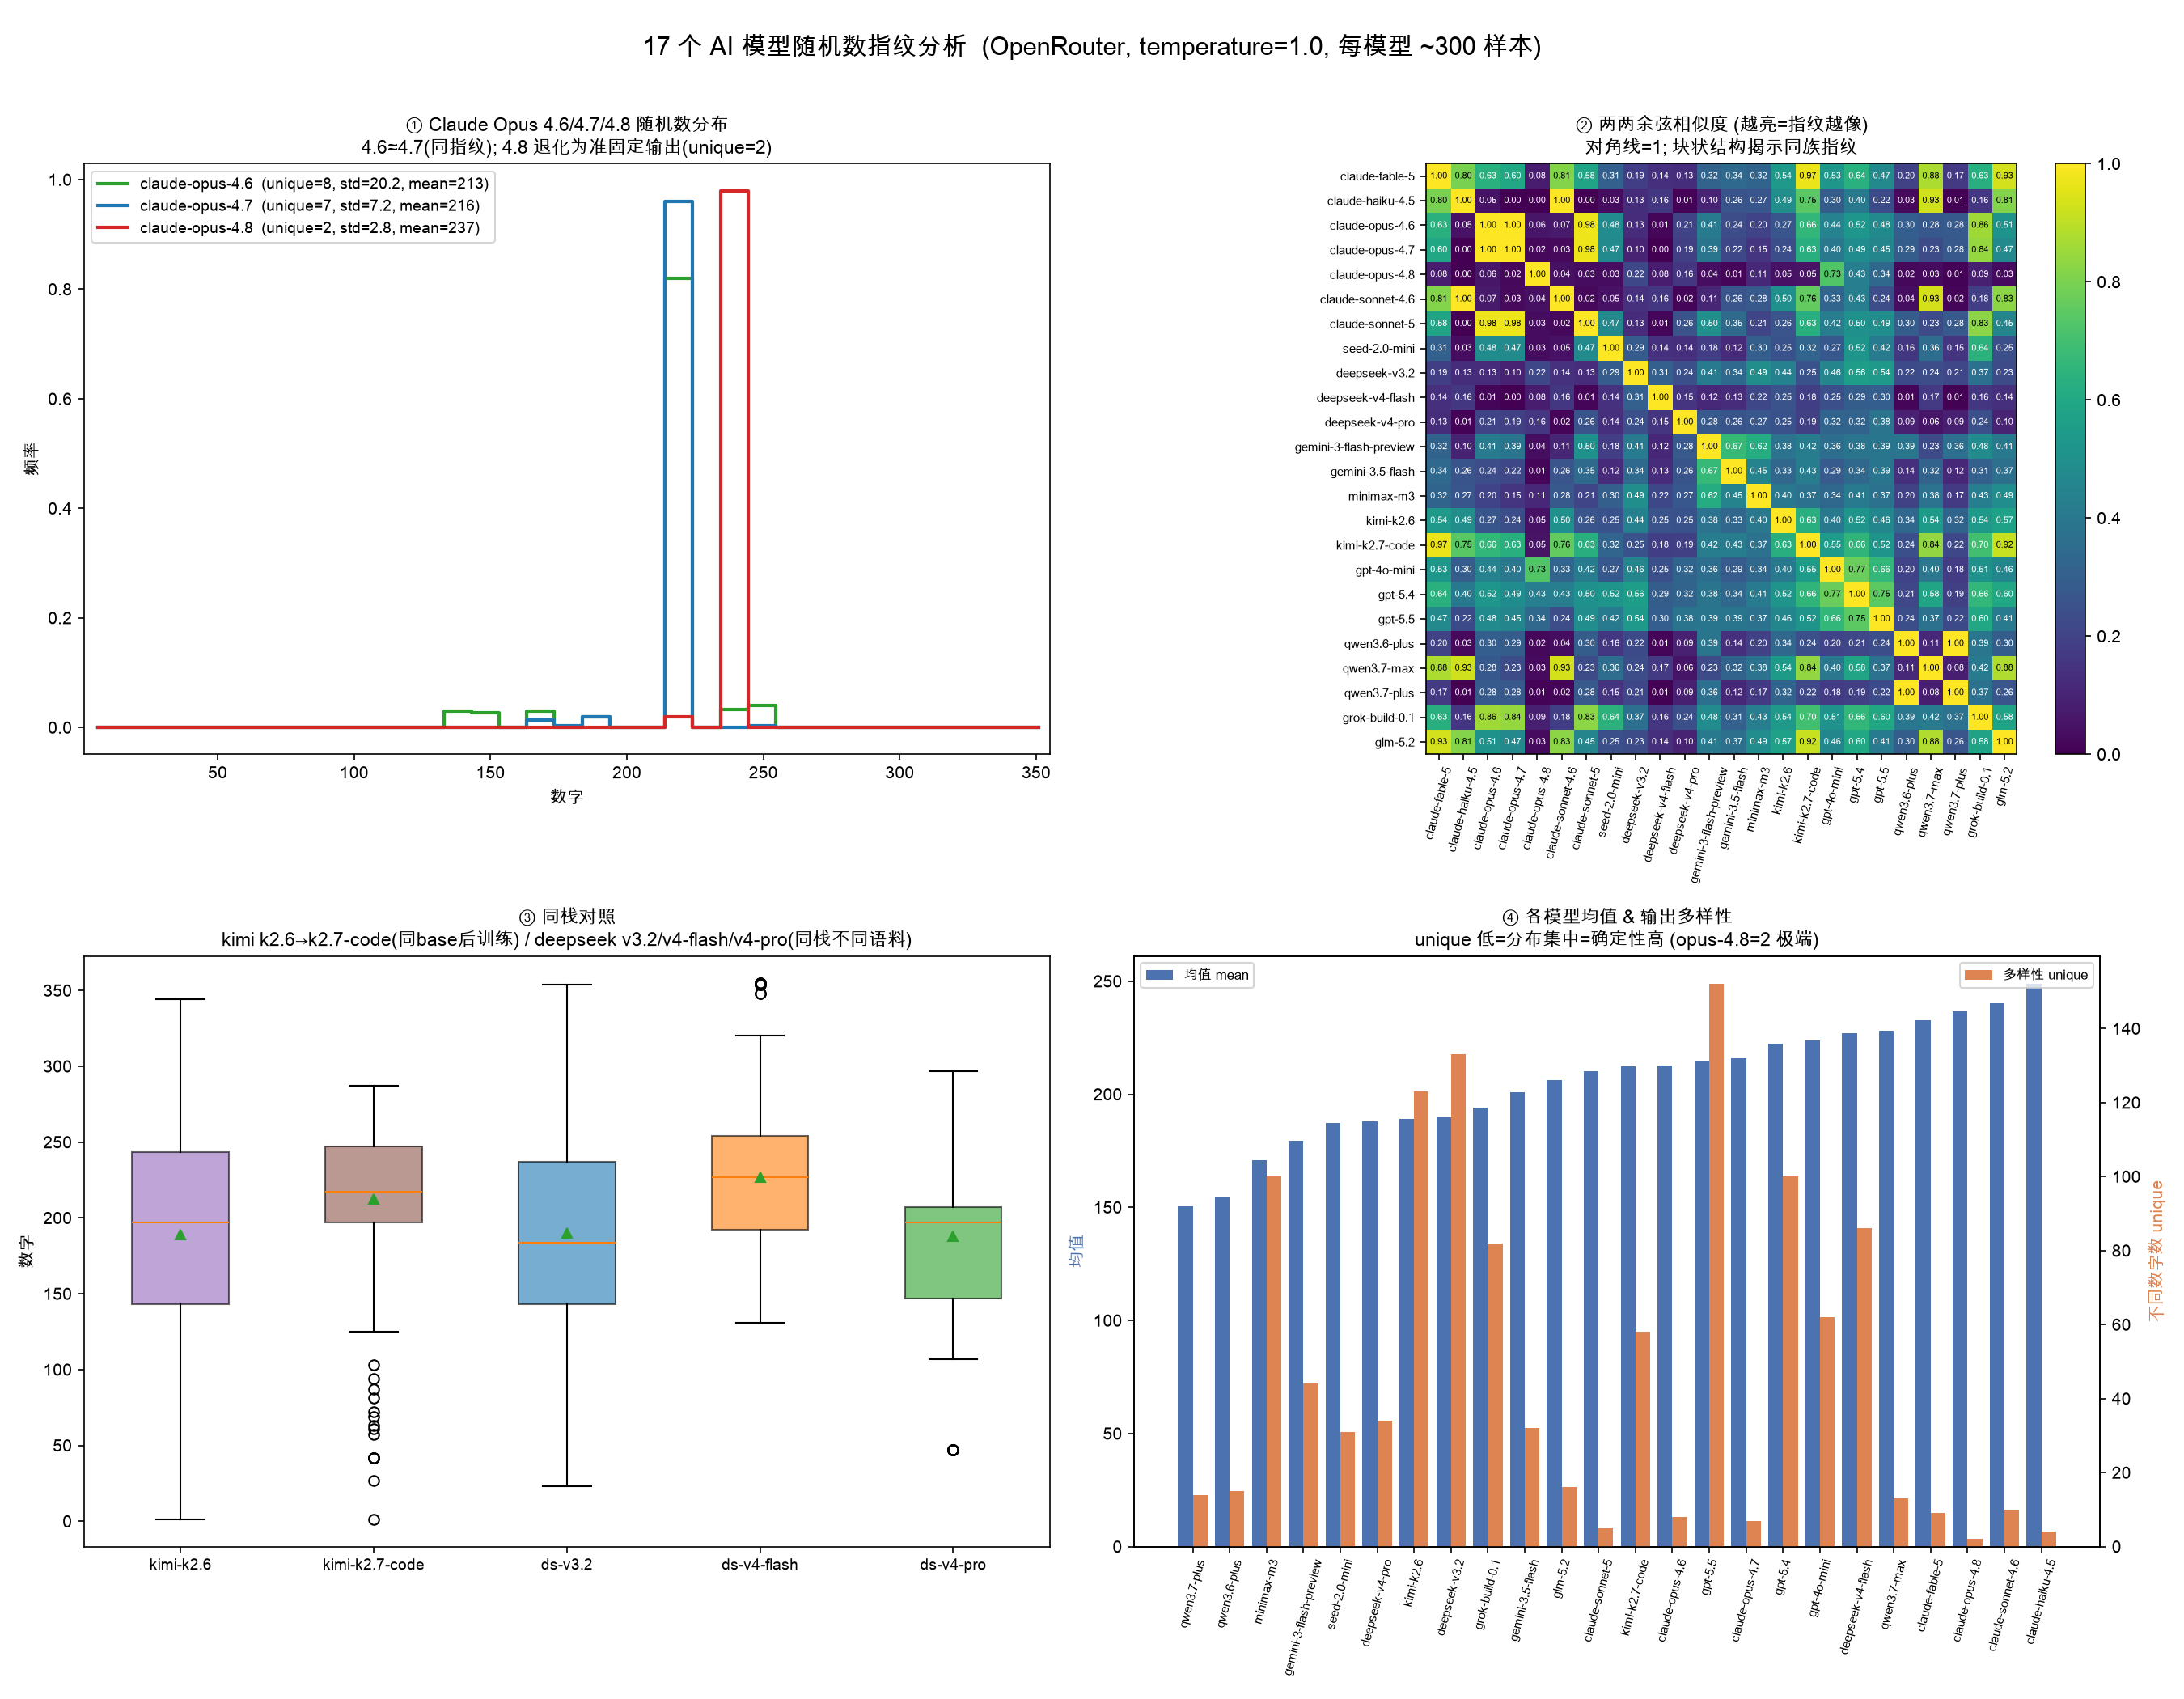
1부터 355 사이의 랜덤한 수를 뽑으라는 프롬프트를 대량 반복시켜 얻은 통계 분포로 24개 AI 모델의 지문을 만들고, 그 지문으로 제3자 API 중계의 모델 위조까지 잡아낸 실측 데이터셋.
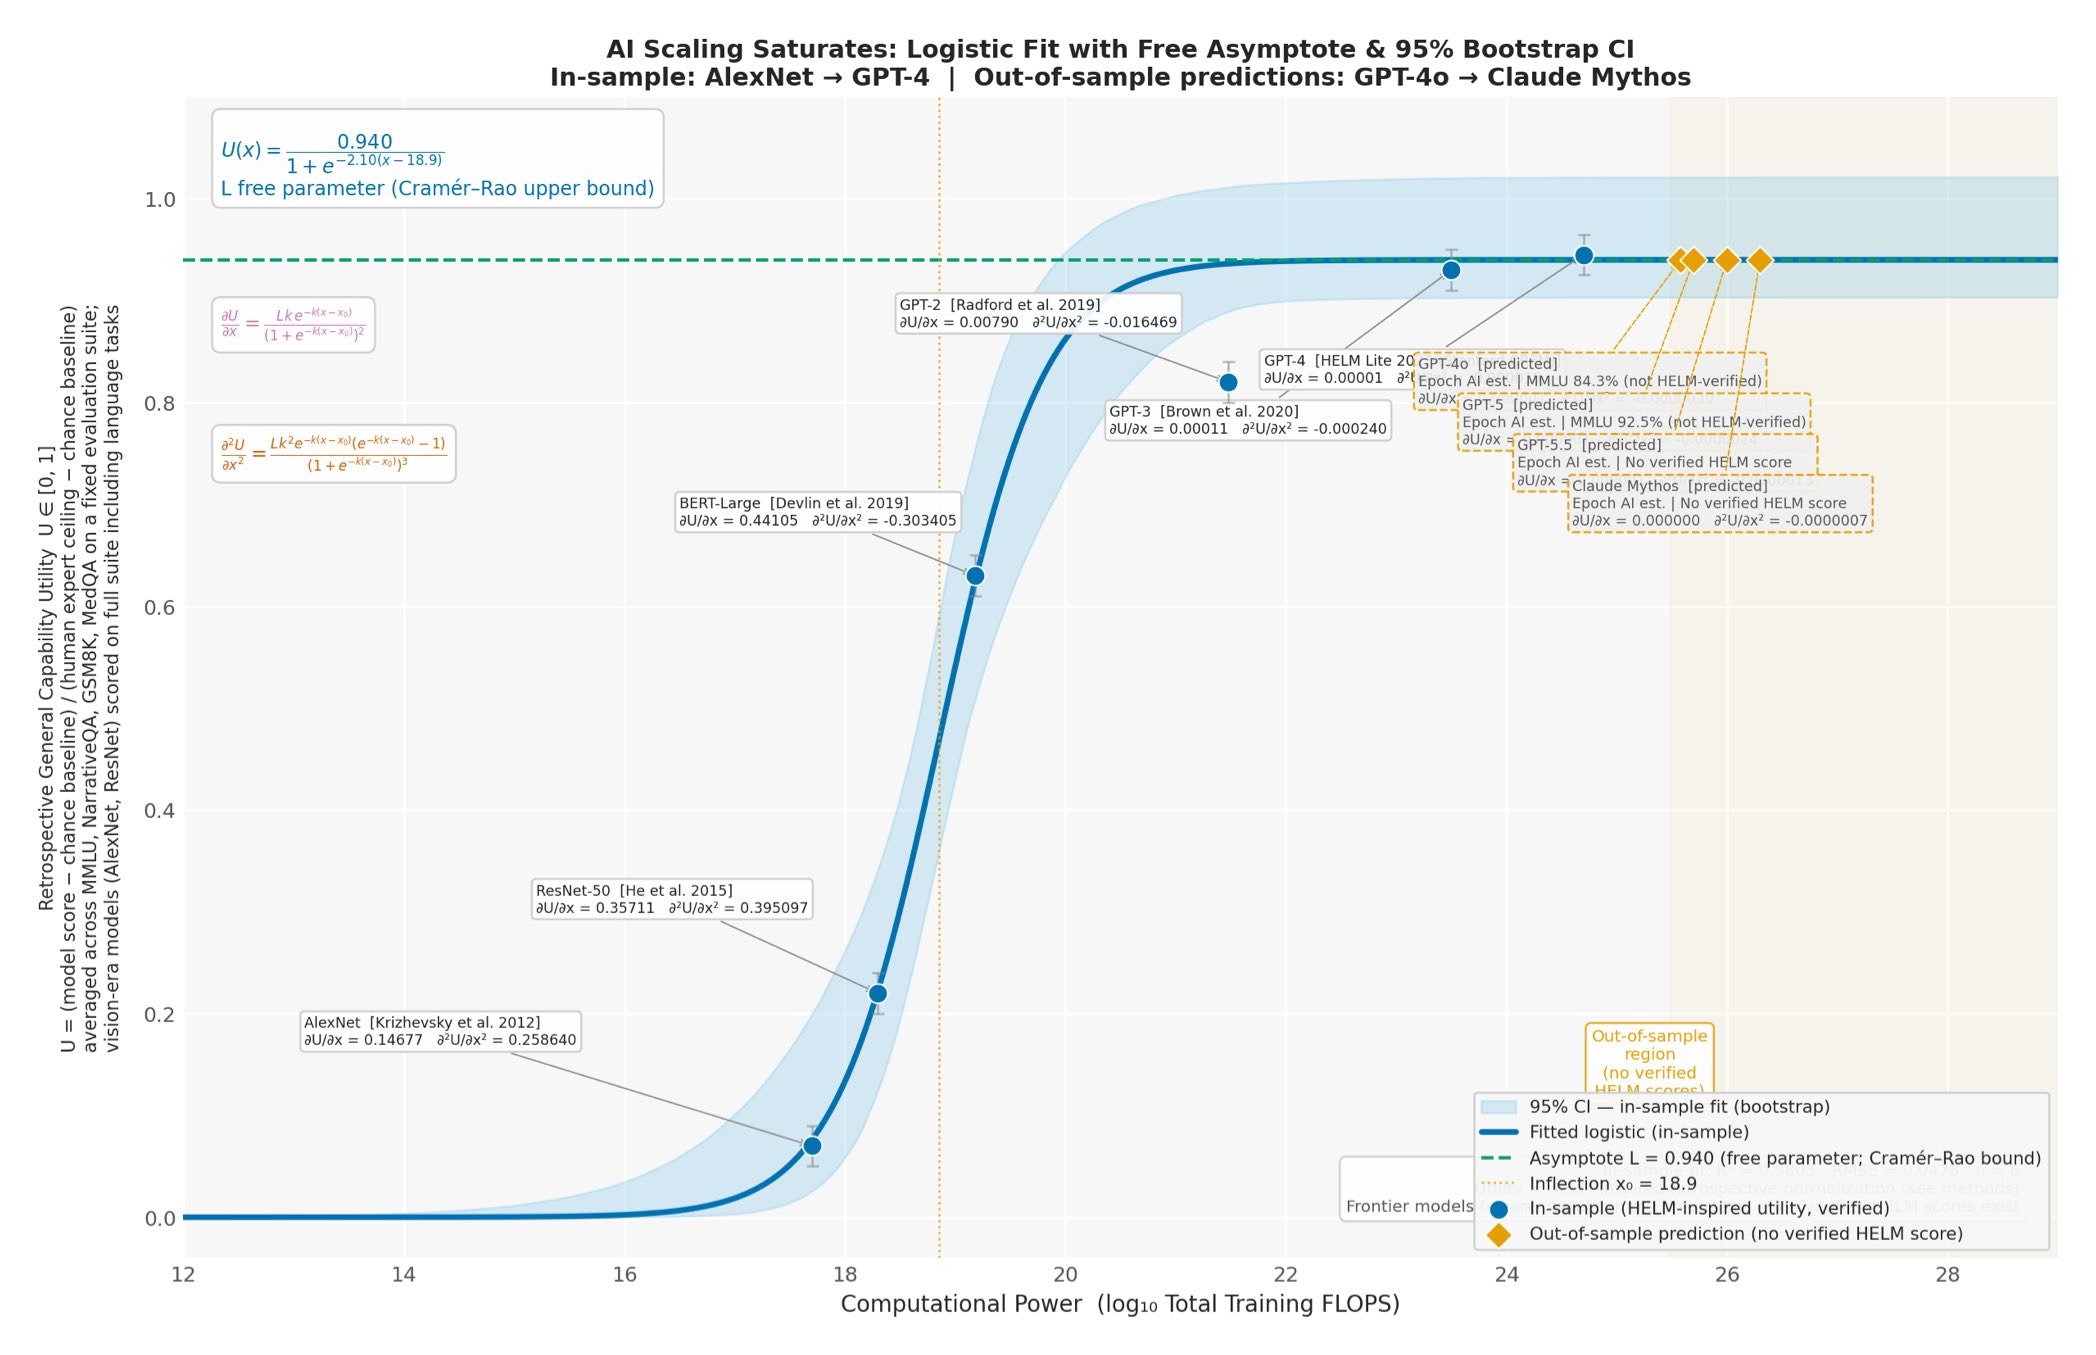
통계에 밝은 종양내과 의사 @5_utr가 AlexNet부터 GPT-4까지의 데이터에 로지스틱 곡선을 적합해 ‘AI 스케일링은 지수가 아니라 포화한다’고 주장했다. 타래의 진짜 칼끝은 거시경제다 — AI 밸류에이션이 지수함수로 가격책정됐는데 데이터는 로지스틱이 훨씬 잘 맞으니 함수형 오설정이자 버블이라는 것. 주장과 그 한계를 함께 정리한다.
Anthropic이 Fable을 출시한 직후 zero_goliath가 쓴 짧은 에세이. 컴퓨트가 아니라 데이터 파이프라인이 진짜 병목이며, RLVR이 한계에 닿으면 AI가 운영하는 실제 회사들의 손익이 다음 보상 신호가 된다고 본다.
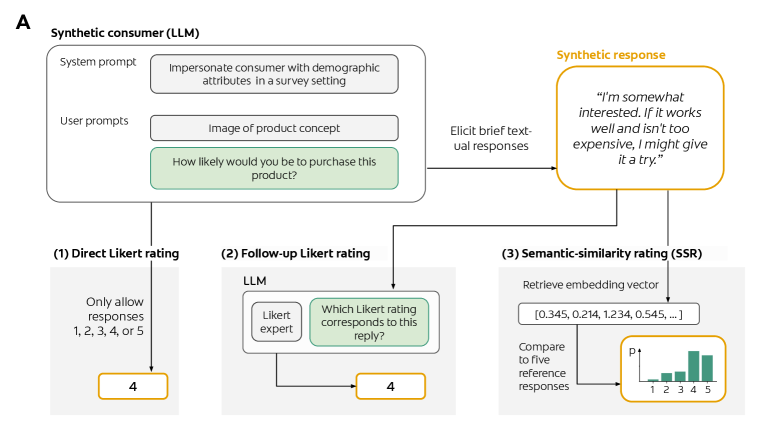
LLM에게 리커트 점수를 직접 묻는 대신 자유 텍스트 응답을 임베딩 유사도로 점수 분포에 사상하는 SSR 기법을 제안한 논문. 9,300명 실제 설문 대비 인간 재검사 신뢰도의 90%를 달성했다.
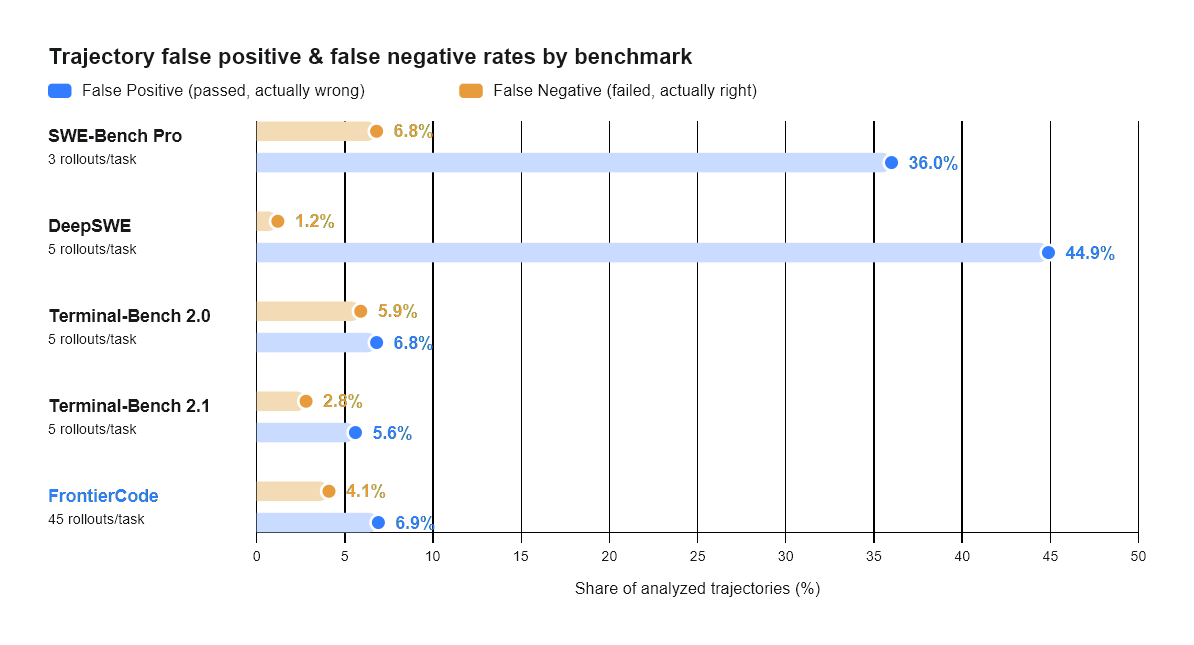
Cognition이 공개한 신규 코딩 벤치마크. 정답 여부가 아니라 ‘메인테이너가 실제로 머지하겠는가’를 측정한다. Diamond 50문항에서 최강 모델 Claude Opus 4.8도 13.4%에 그쳤다.