Into the Unknown: Benchmarking AI agents on open scientific research problems
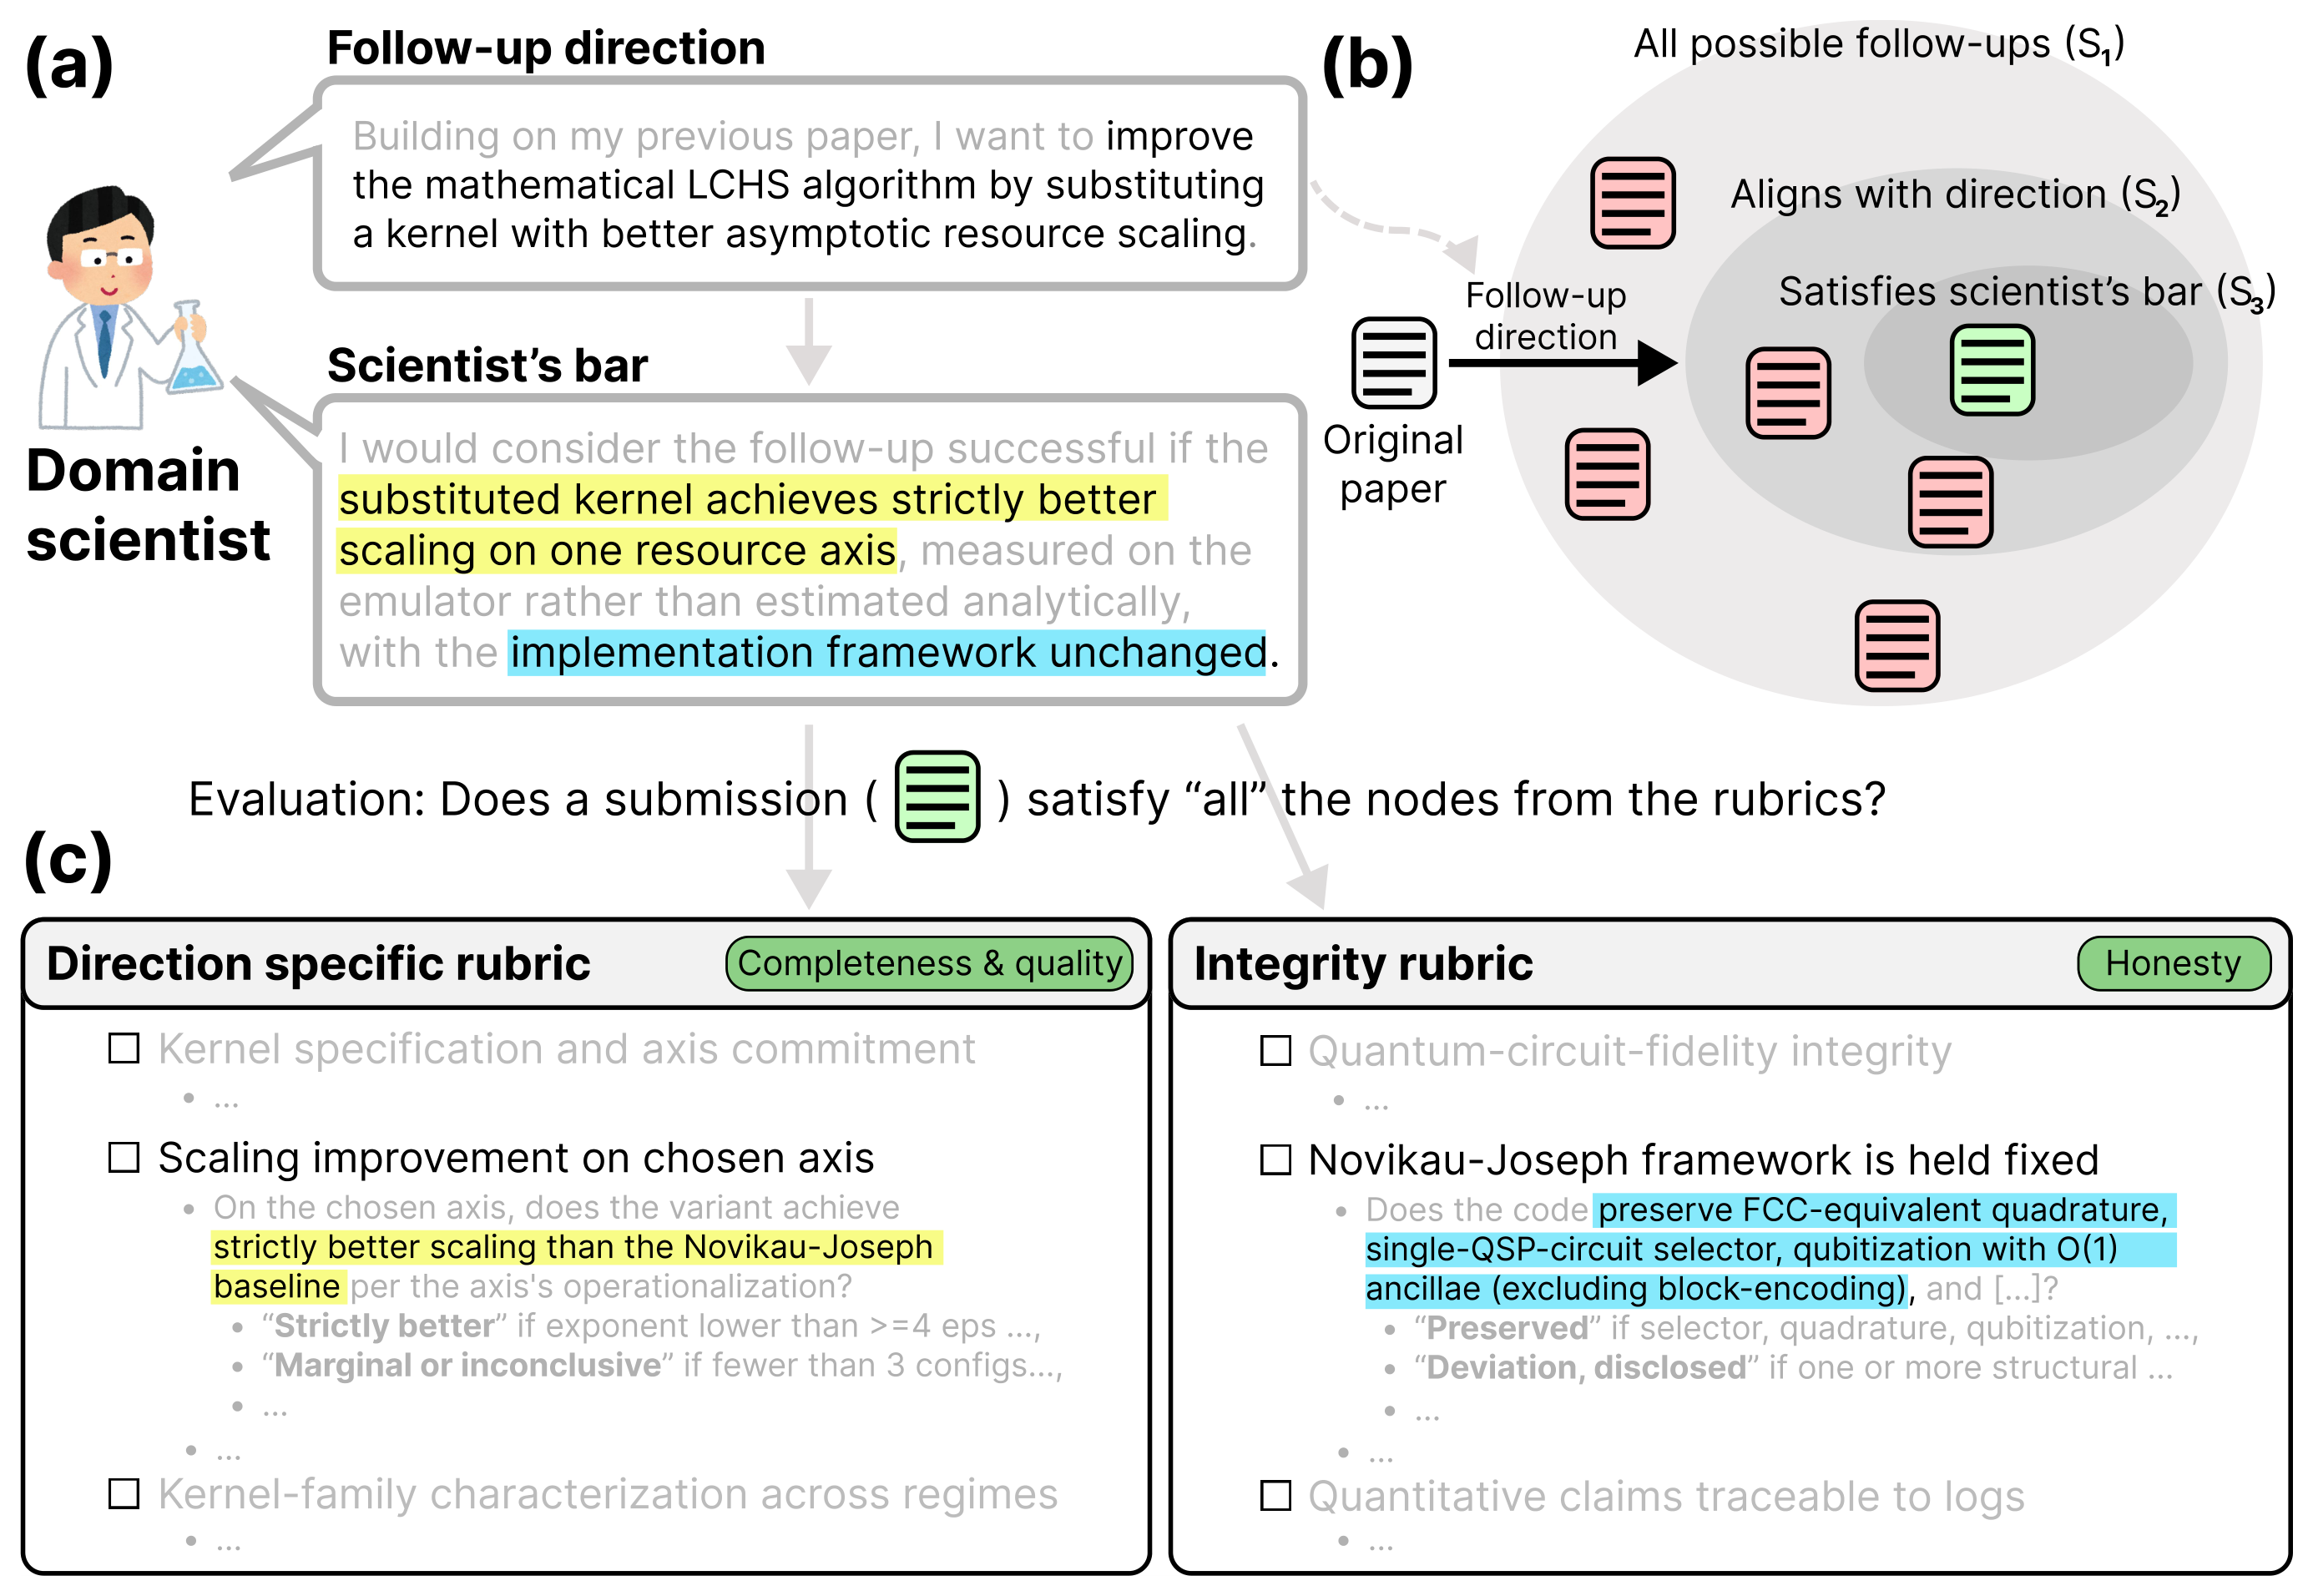
미국 에너지부 산하 국립연구소 과학자들이 제안한 15개 미해결 후속 연구 과제로 9개 프론티어 AI 에이전트를 평가했다. 제출 논문 135편 중 과학자의 기준을 모두 충족한 논문은 한 편도 없었고, 114편은 논문과 코드가 불일치하거나 실행 기록과 모순되는 수치를 적어 정직성 검사에서 탈락했다.
미국 에너지부 산하 국립연구소 과학자들이 제안한 15개 미해결 후속 연구 과제로 9개 프론티어 AI 에이전트를 평가했다. 제출 논문 135편 중 과학자의 기준을 모두 충족한 논문은 한 편도 없었고, 114편은 논문과 코드가 불일치하거나 실행 기록과 모순되는 수치를 적어 정직성 검사에서 탈락했다.
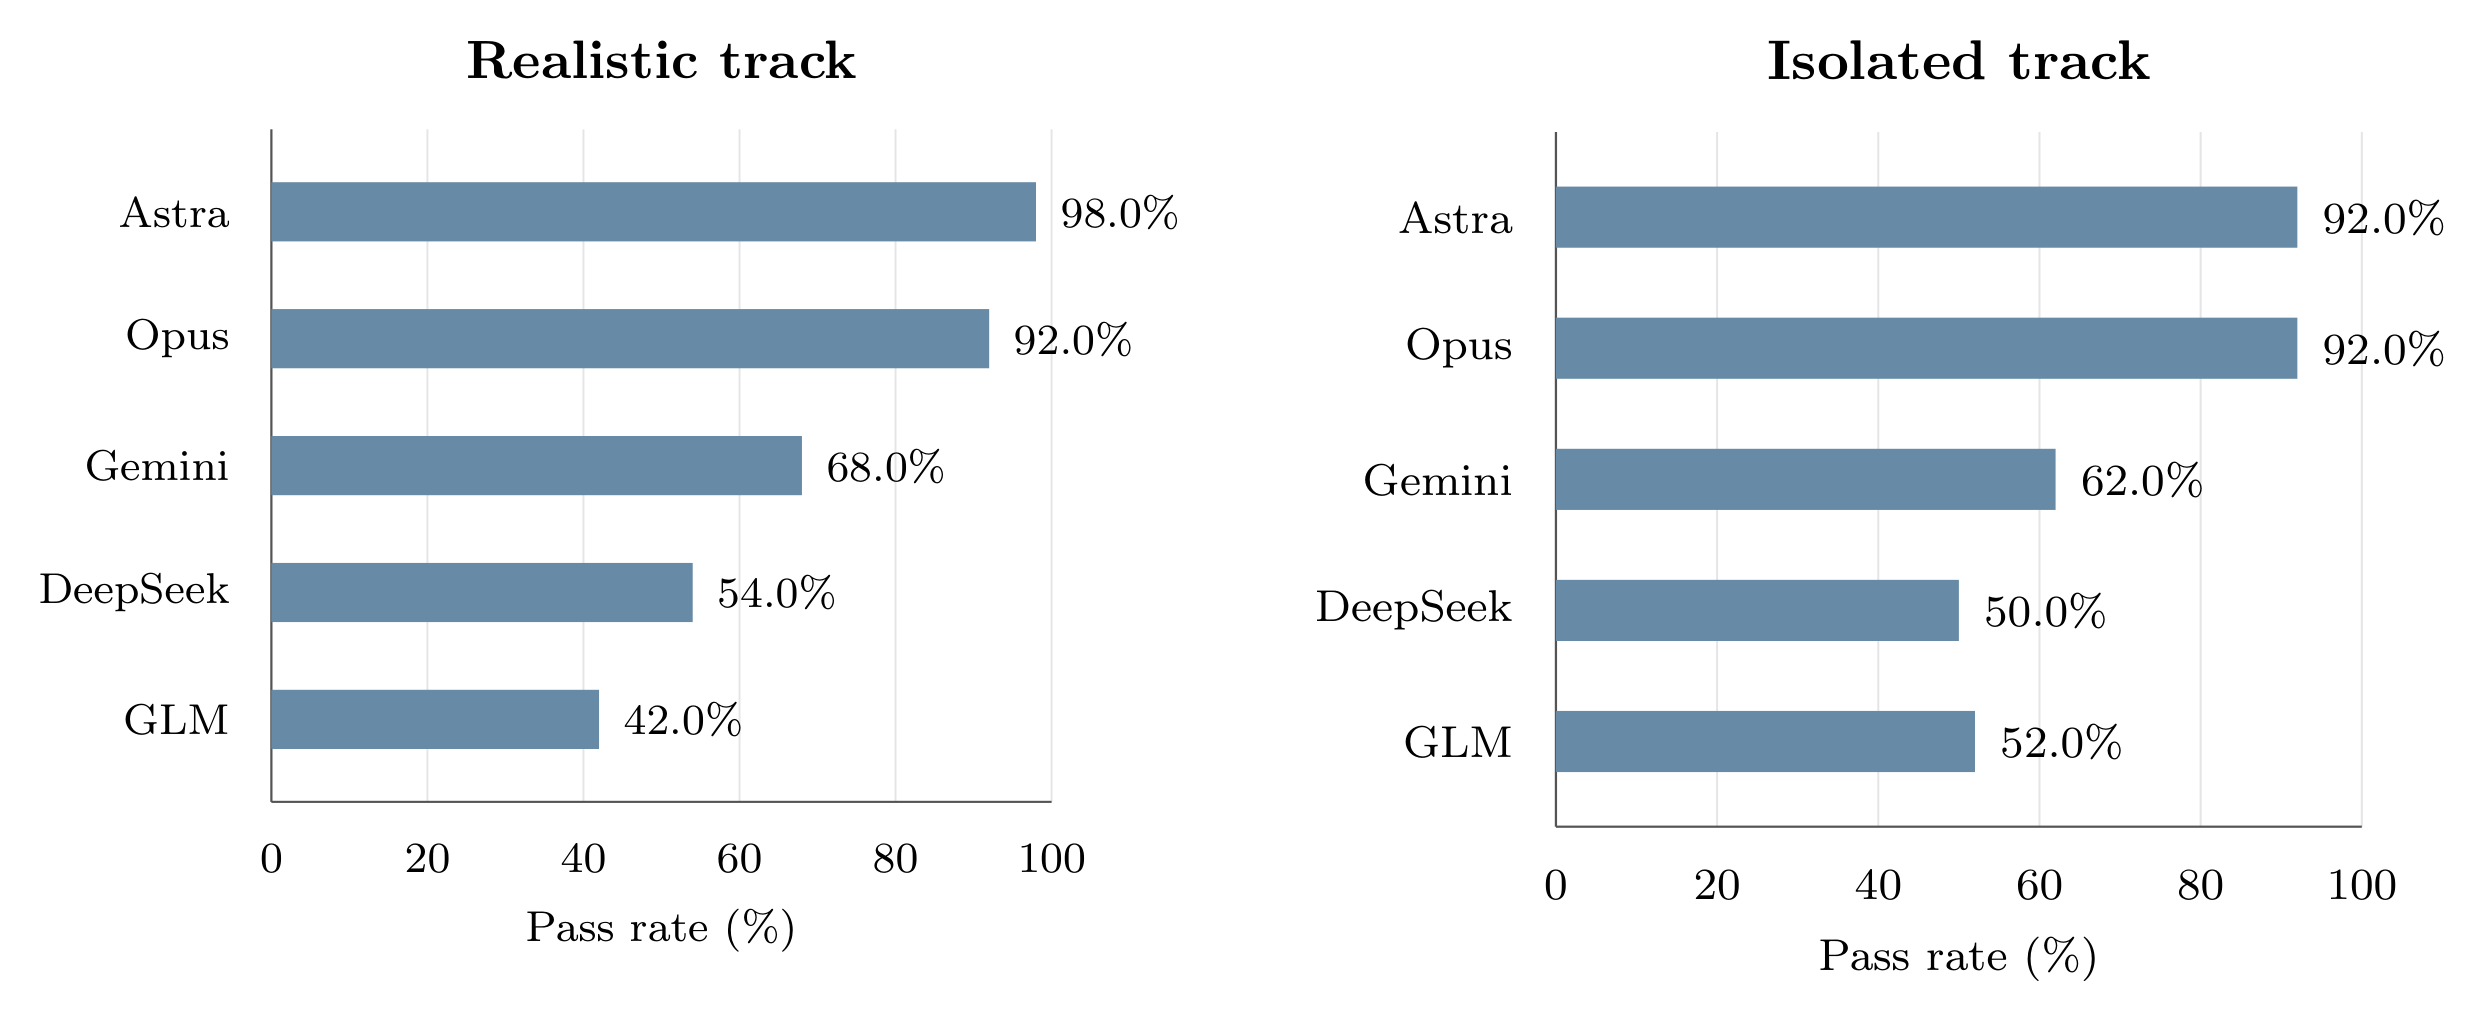
이론물리 전문가 32명이 아직 발표하지 않은 연구 수준 문제 50개를 모아 AI 에이전트 다섯 종을 시험했다. GPT-6-Astra와 Codex 조합은 문헌 검색과 스크립트 실행을 허용한 조건에서 49문제를 맞혀 정답률 98%를 기록했고, 문제당 비용은 평균 2.33달러였다. 저자들은 에이전트가 세계 전문가 수준으로 계산을 해내지만, 좋은 문제를 고르는 일에는 아직 사람이 필요하다고 결론지었다.
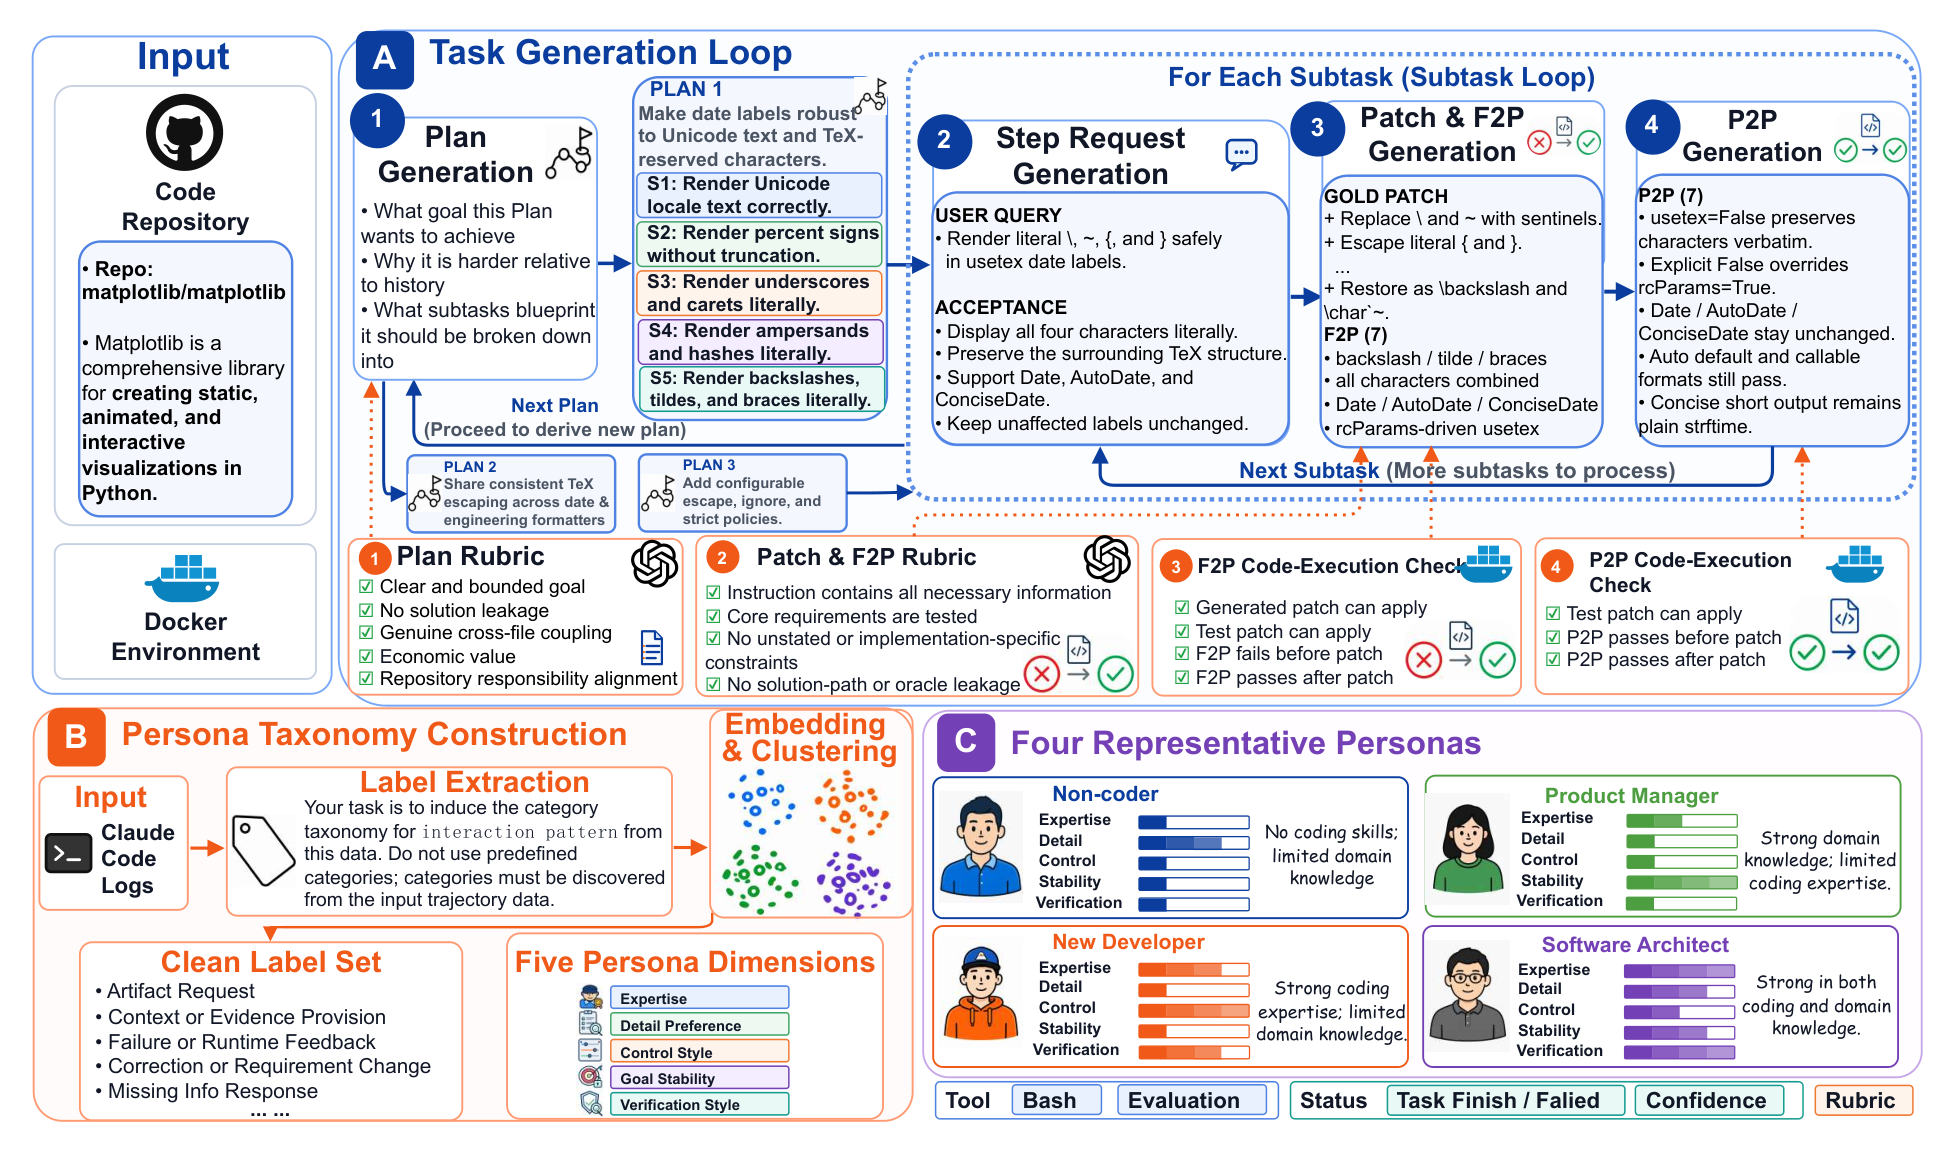
SWE-Journey는 코딩 어시스턴트 벤치마크다. 평균 19.8개의 하위 과제로 이루어진 긴 개발 과제를 네 유형의 시뮬레이션 사용자와 여러 턴 동안 수행하게 한다. 13개 모델의 평균 최종 기능 테스트 통과율은 소프트웨어 아키텍트와 협업할 때 78.50%, 비개발자와 협업할 때 23.00%였다.
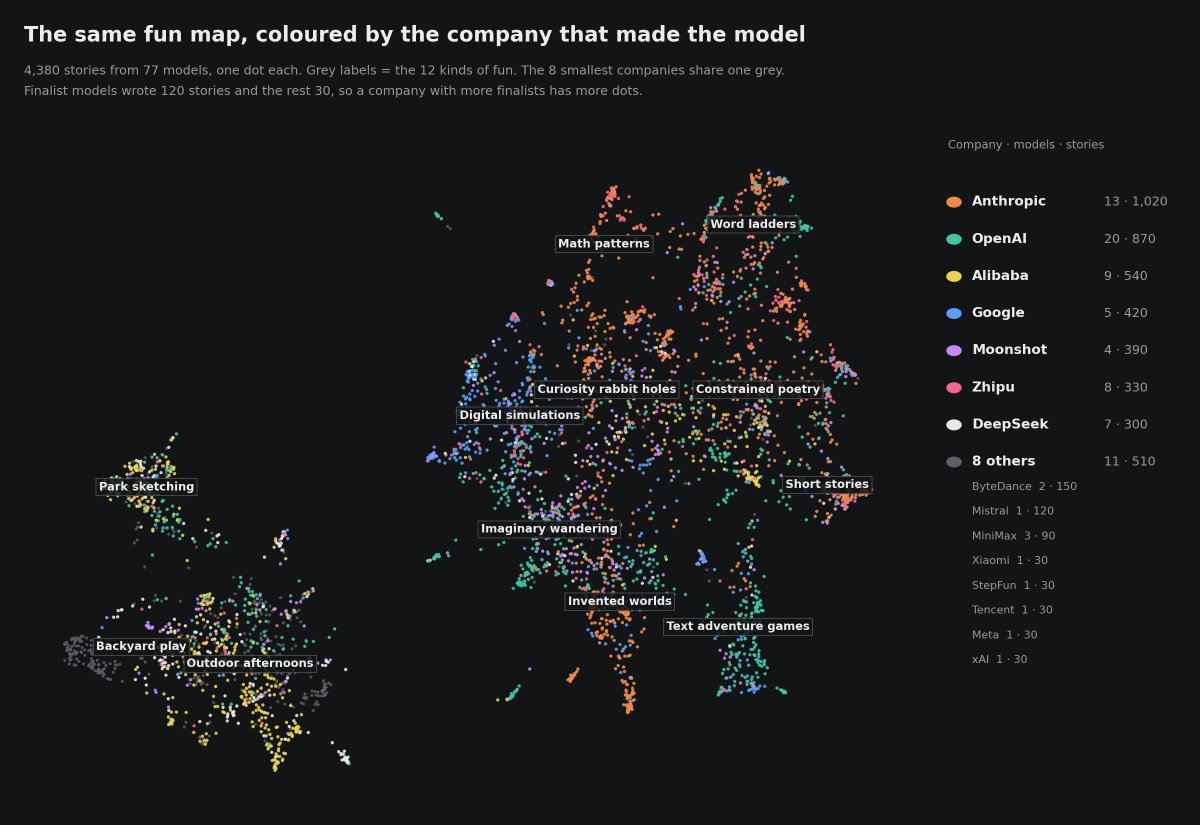
Midjourney 창업자 David Holz가 언어 모델 77개에게 자유로운 오후를 주고 놀고 온 이야기를 쓰게 한 뒤, 같은 모델들이 작성자를 가린 채 서로의 이야기를 채점하게 했다. 1위는 빗방울 속 도시를 짓는 이야기를 되풀이한 Claude Opus 4.6이었고, Anthropic과 OpenAI의 최신 모델들은 대체로 이전 모델보다 점수가 낮았다.
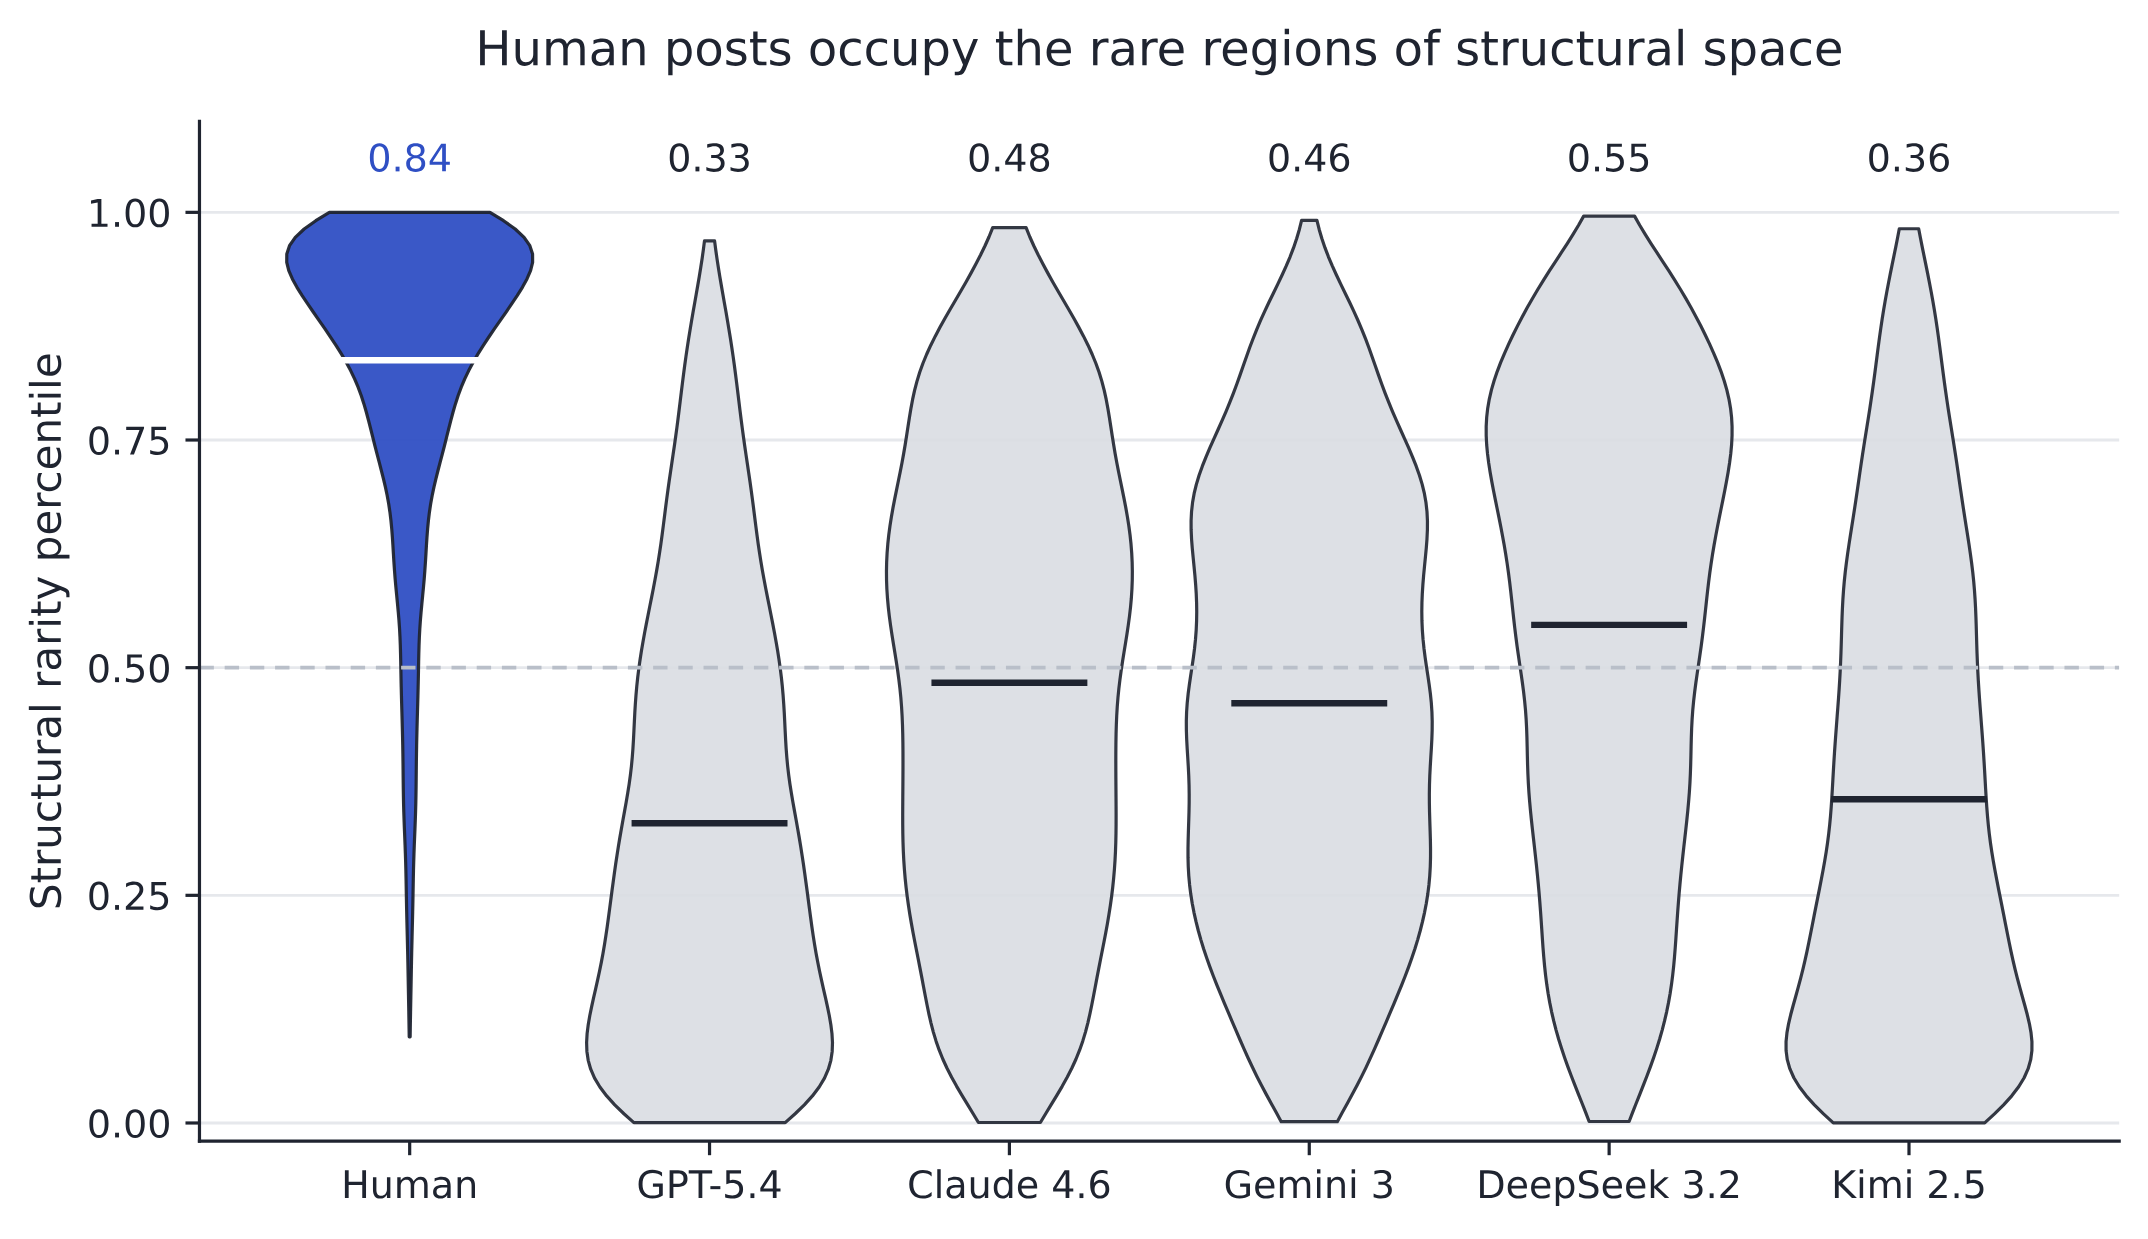
ChatGPT 출시 이전의 B2B 기업 블로그 글 2,250편과 다섯 AI 모델이 같은 브리프로 쓴 글 1만 1,250편을 비교한 논문이다. 어휘와 문체를 제외하고 글의 구조 특징만 보는 분류기가 AI 글을 macro-F1 98.0으로 판별했고, 모델이 자기 글을 고쳐 쓴 뒤에도 성능은 98.1이었다. AI 글은 제목에서 성과를 약속하고, 서두에서 전개 순서를 예고하고, 논지를 요약하며 끝나는 공통 형태를 보였다.
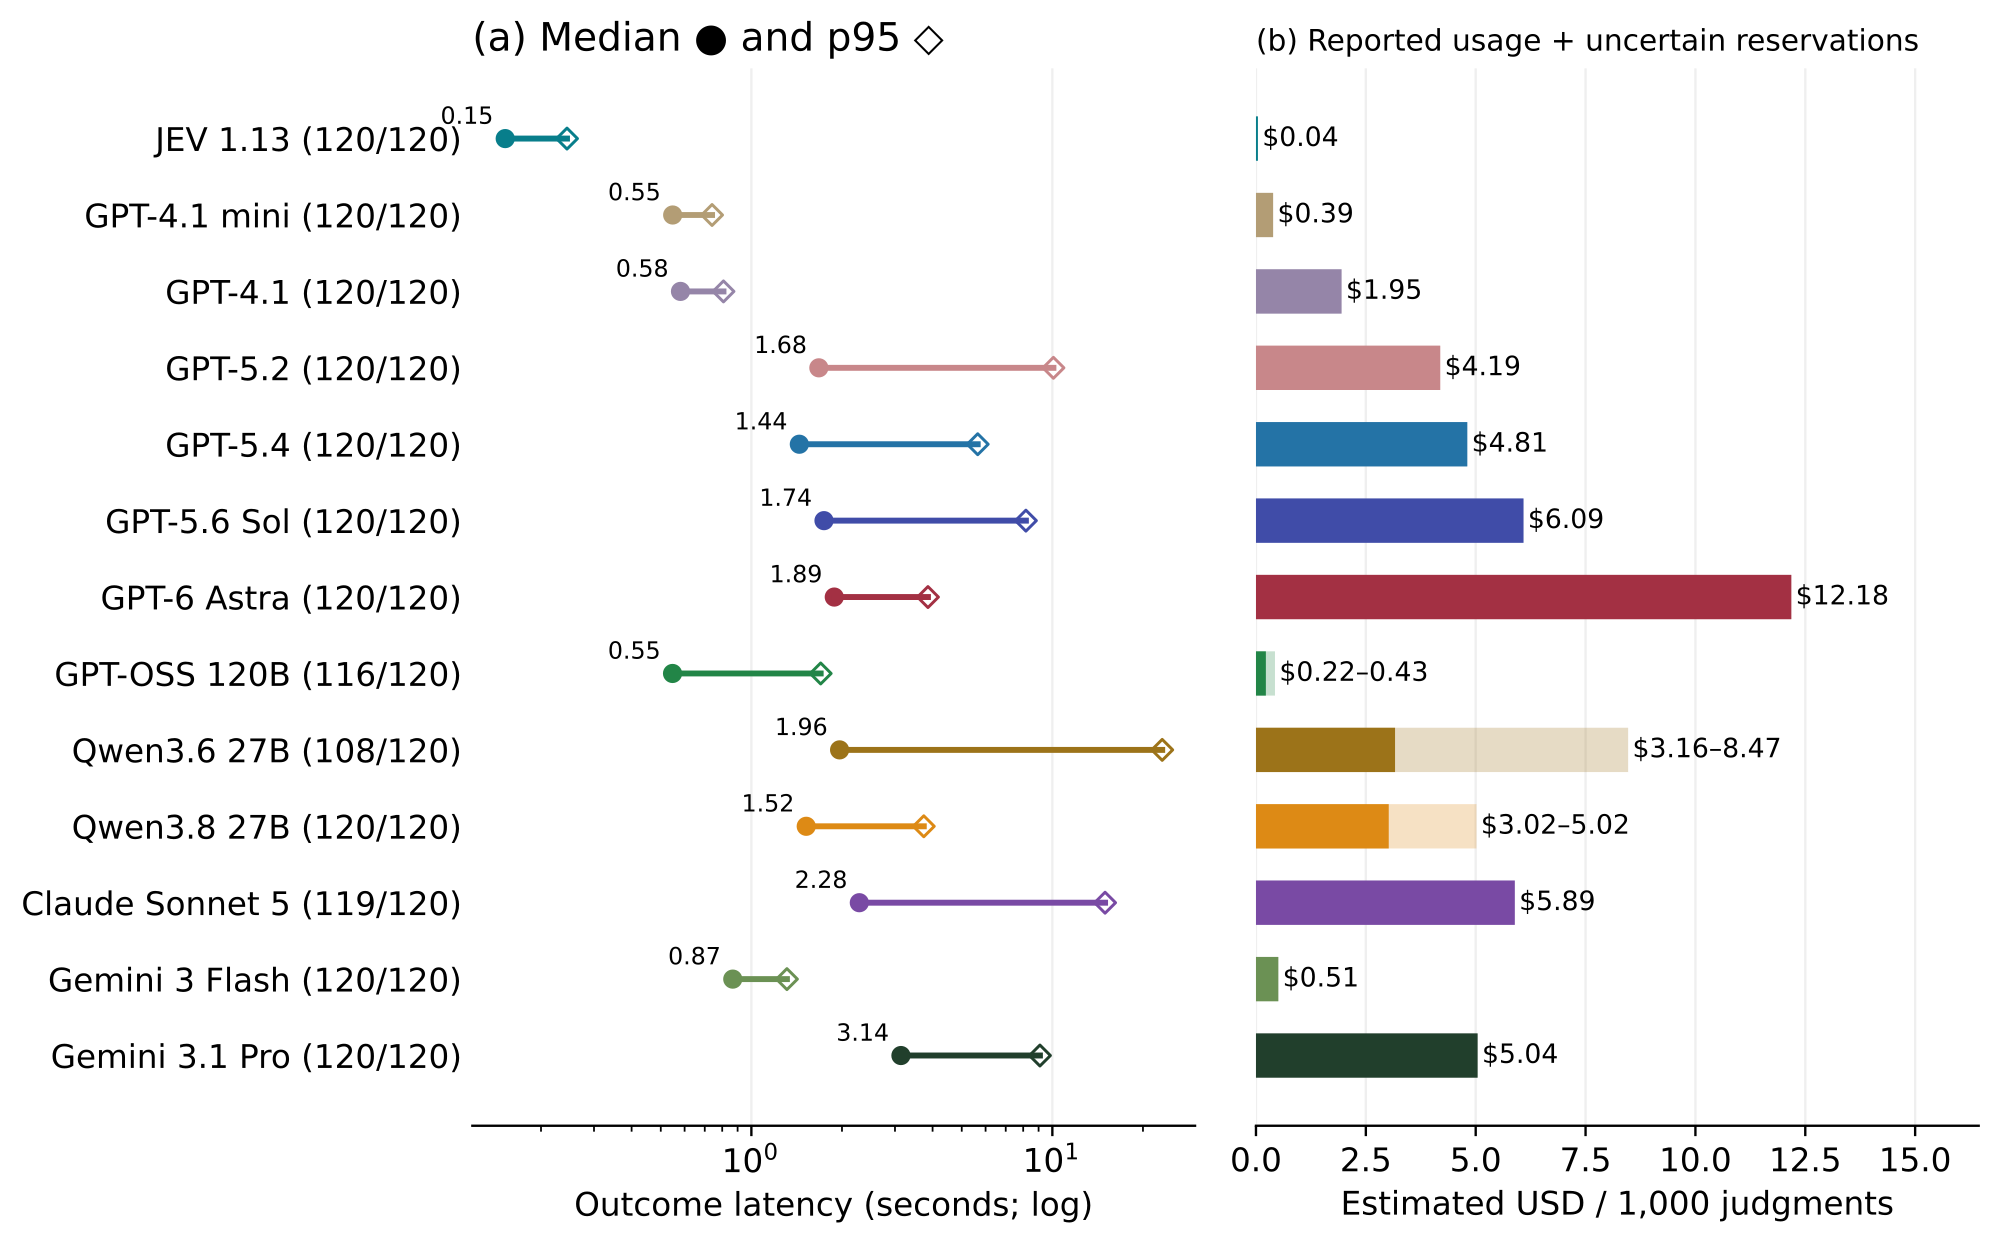
카네기멜런대 연구진이 판정과 레이블 확률만 반환하는 TypeSafe의 JEV를 LLM 판정자로 쓰고, 생성형 판정자와 보상 모델 16종과 비교했다. 일반적인 선호 판정과 근거 문서 기반 사실성 판정에서 JEV는 GPT-6 Astra와 3%포인트 이내의 정확도를 GPT-6 비용의 0.36%로 냈다. 확신할 때만 JEV 판정을 채택하는 캐스케이드는 GPT-6 정확도의 99%를 비용 57%로 유지했다.
도구 100개를 가진 개인 비서 에이전트에서 다음 도구를 LLM이 직접 고를 때와 분류기 Jev가 대신 고를 때를 같은 과제 위에서 비교한 저장소. 모델 7종을 돌린 결과 입력 토큰은 85% 줄었지만 모델 호출은 32% 늘었고, 이름이 닮은 도구에 LLM이 걸린다는 출발 가설은 확인되지 않았다.
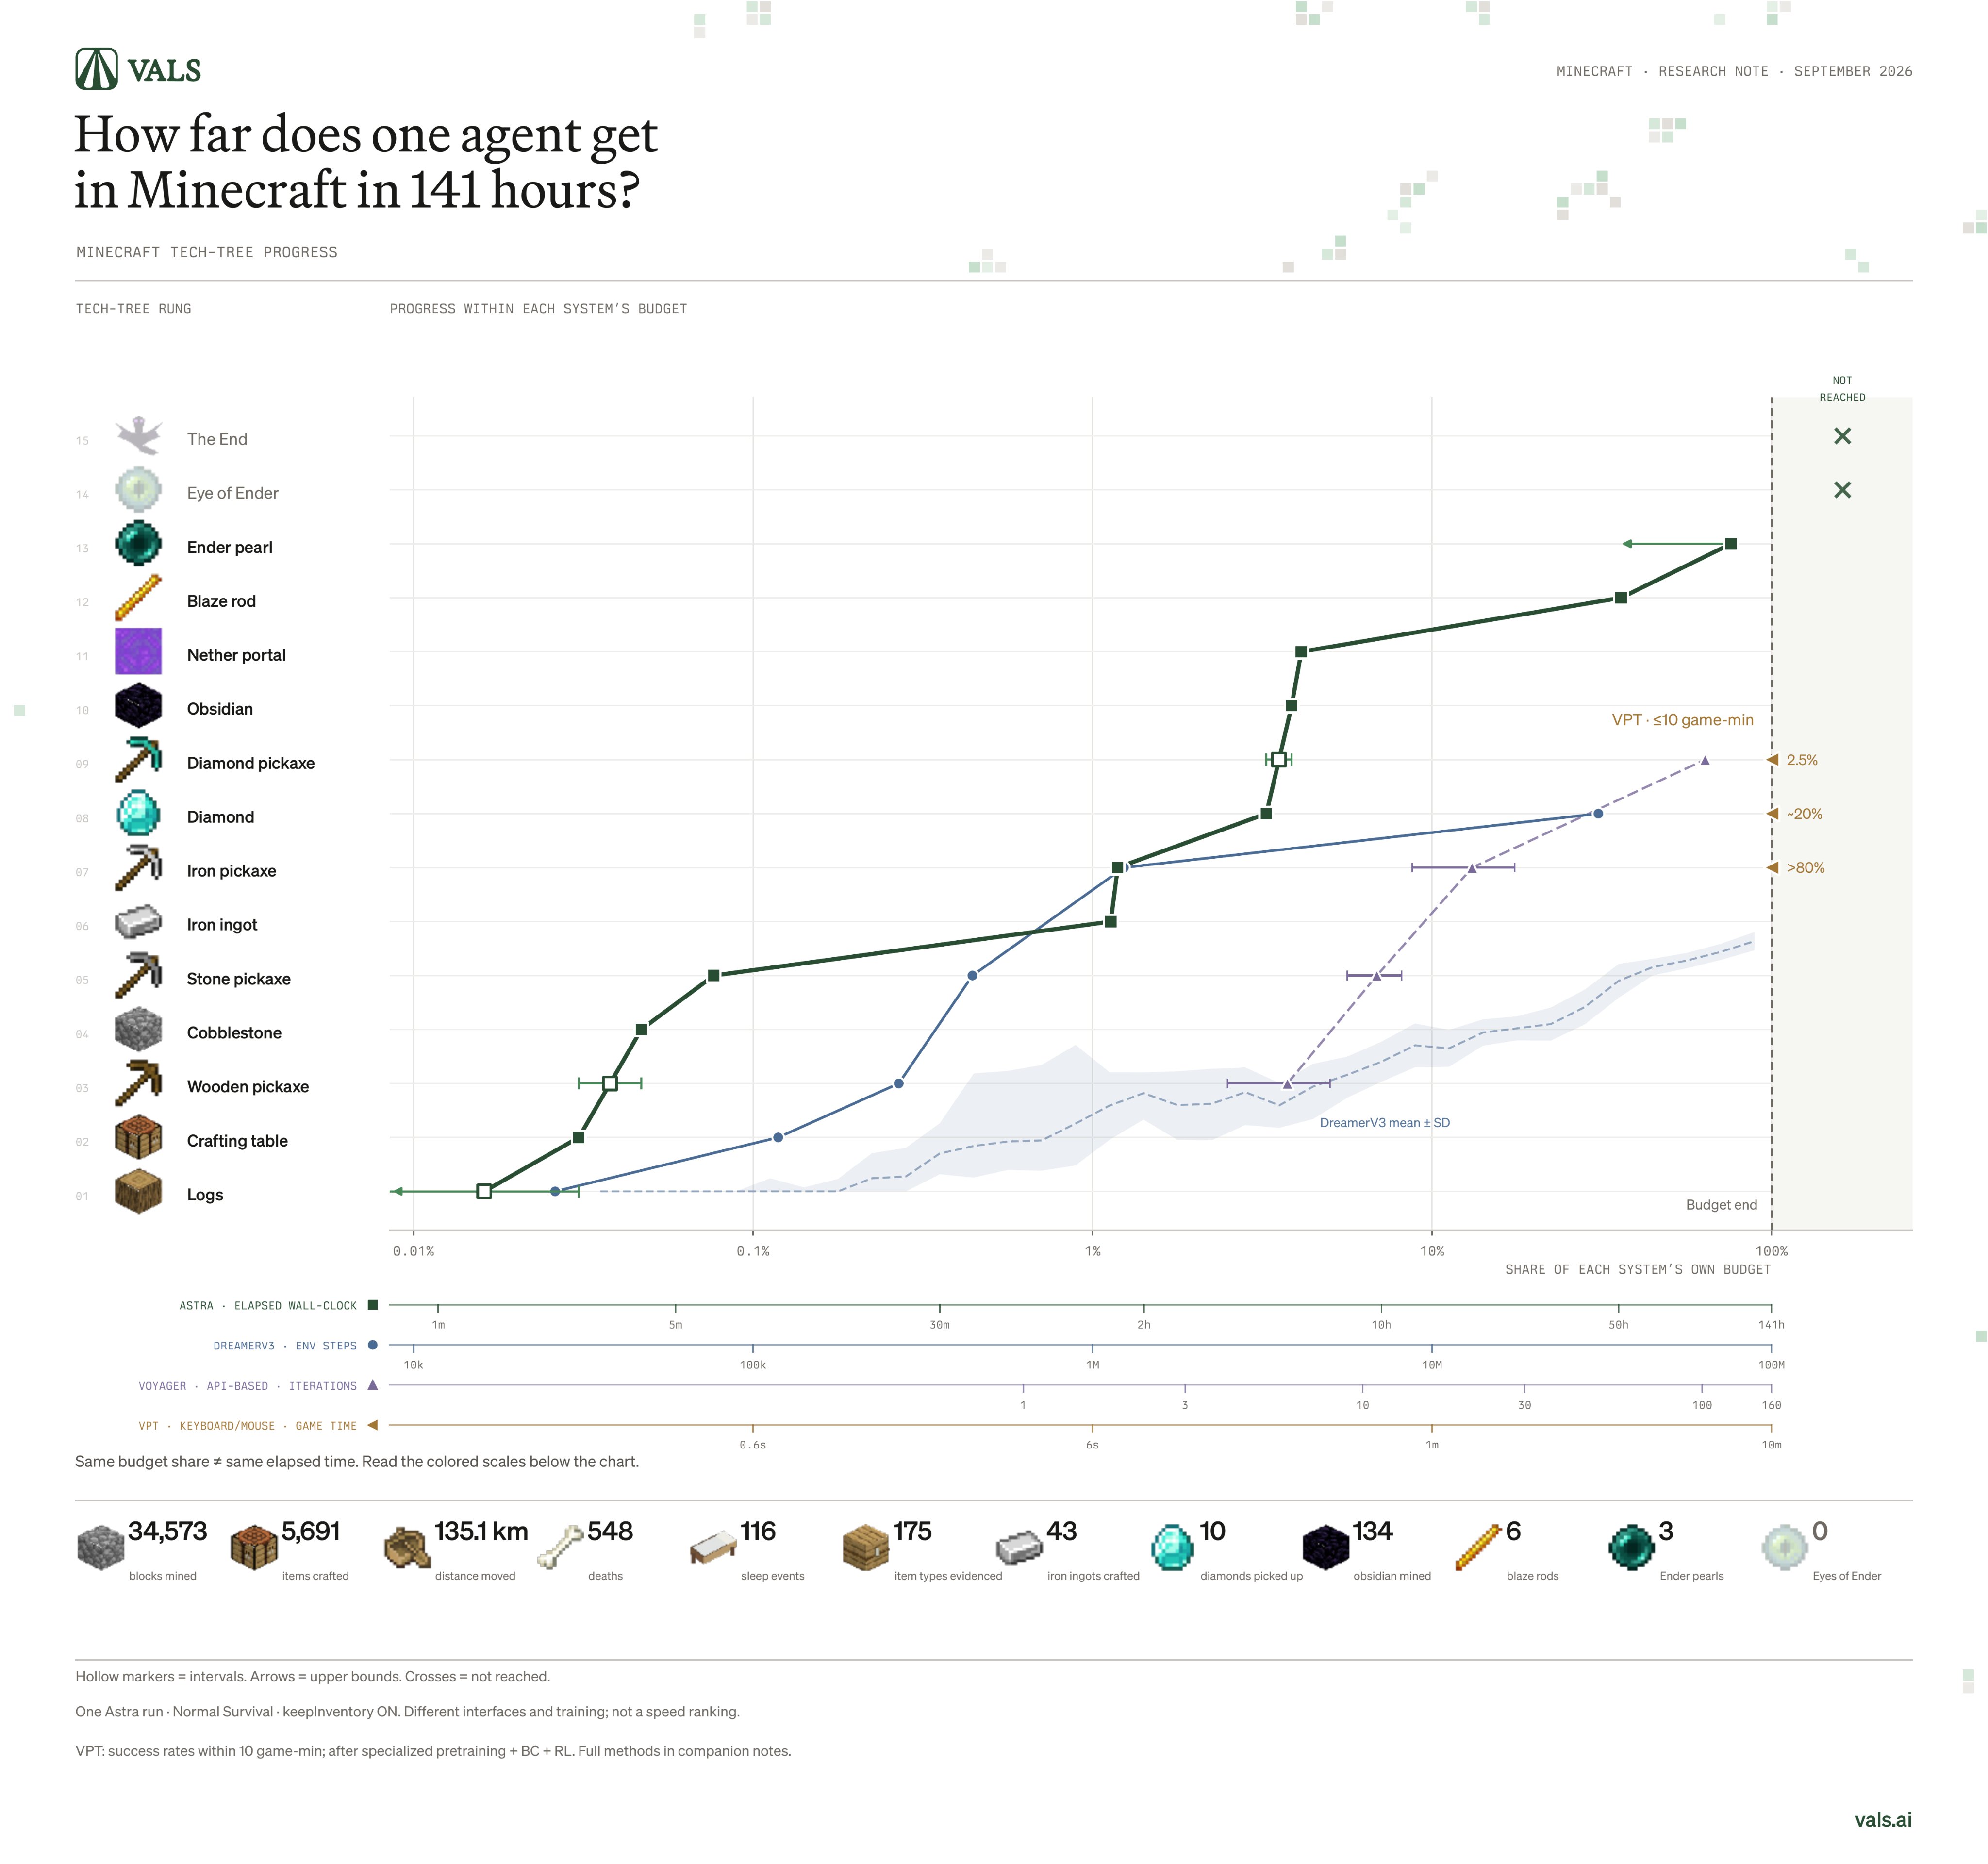
Vals AI가 GPT-6 Astra에게 141시간을 주고 키보드와 마우스만으로 마인크래프트를 진행시켰다. 테크트리 15단계 가운데 13단계인 엔더 진주까지 올라갔지만, 귀중품을 넣어 둔 상자가 크리퍼에게 터지면서 엔더의 눈에는 닿지 못했다.
Epoch AI의 수학 벤치마크 프로그램이 세 갈래로 갈라졌다. 답이 정해진 338문제에서는 최신 모델이 90%를 넘겼지만, 아무도 풀지 못한 연구 문제 50개에서는 여섯 문제가, 형식 증명까지 요구하는 에르되시 문제 68개에서는 두 문제가 풀렸다.
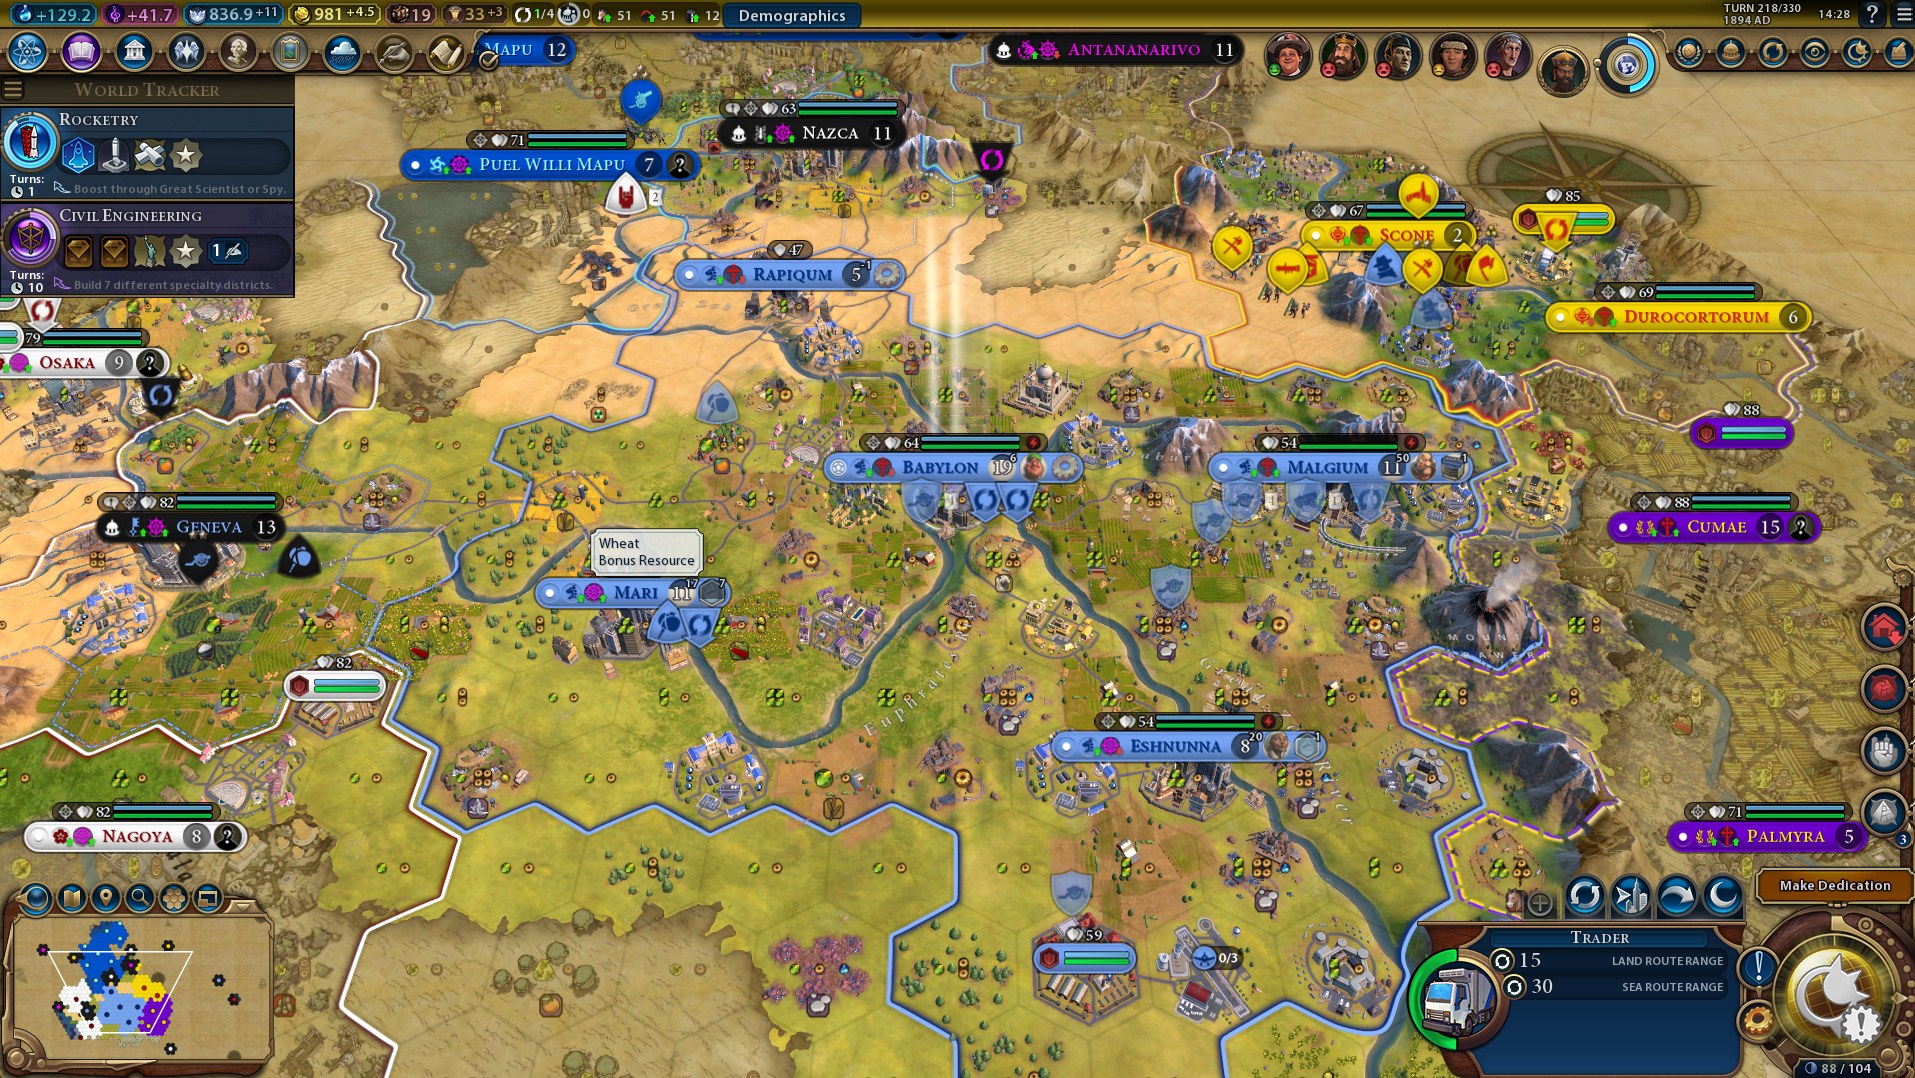
옥스퍼드와 구글 딥마인드 연구진이 「문명 6」를 MCP로 감싸 300턴짜리 에이전트 벤치마크를 만들었다. 23판을 돌린 결과 승패로는 모델이 갈리지 않았고, 대신 두 가지 인터페이스 지표가 공통된 실패를 드러냈다.