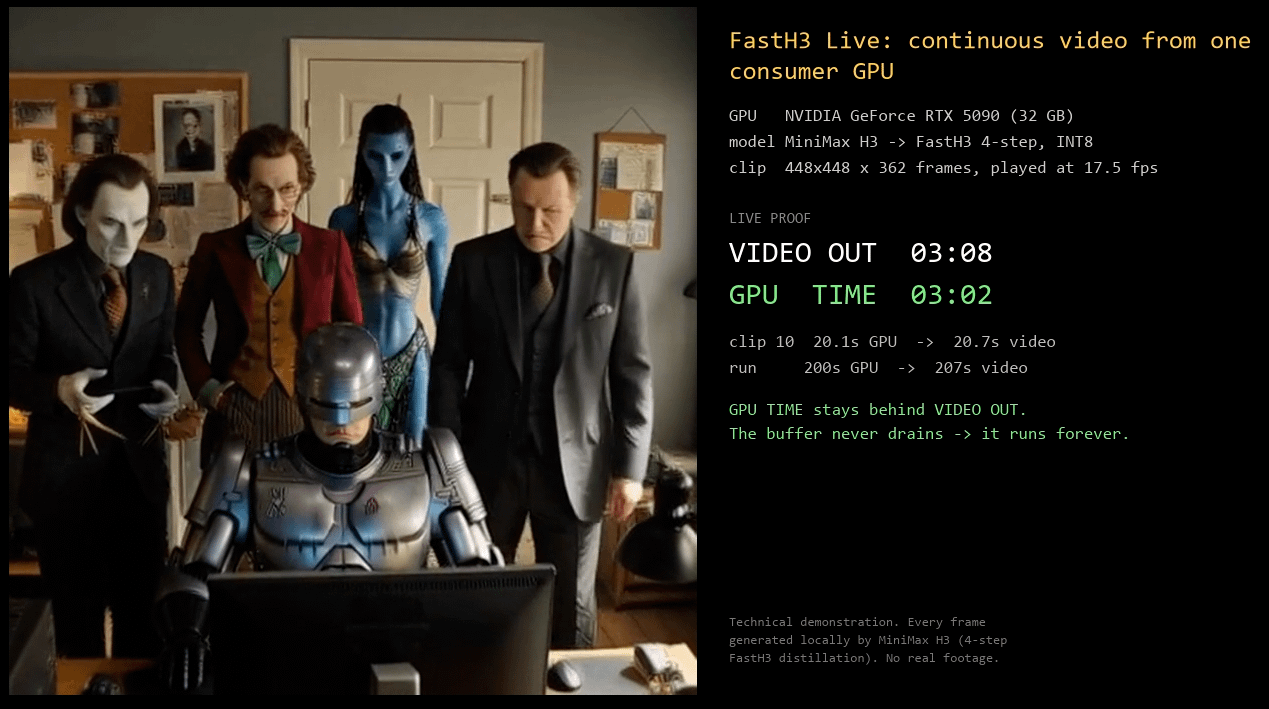
An endless AI TV channel on a single gaming GPU
게이밍 GPU 한 장으로 끊기지 않는 AI 영상 채널을 돌린 기록이다. 19.2초의 GPU 시간으로 20.1초 분량의 영상을 만들어 재생 버퍼가 마르지 않게 했고, 모델은 그대로 두고 ComfyUI의 노드별 실행 시간을 계측해 얻은 속도다.
게이밍 GPU 한 장으로 끊기지 않는 AI 영상 채널을 돌린 기록이다. 19.2초의 GPU 시간으로 20.1초 분량의 영상을 만들어 재생 버퍼가 마르지 않게 했고, 모델은 그대로 두고 ComfyUI의 노드별 실행 시간을 계측해 얻은 속도다.
Moonshot의 2.78조 파라미터 멀티모달 MoE, Kimi K3를 Apple의 MLX 프레임워크로 옮긴 포트. 39개 테스트를 모두 통과하고 mxfp4 티어는 원본과 비트 단위로 일치하지만, 정작 이 모델은 지구상 어떤 맥에서도 한 토큰조차 만들어낸 적이 없다.
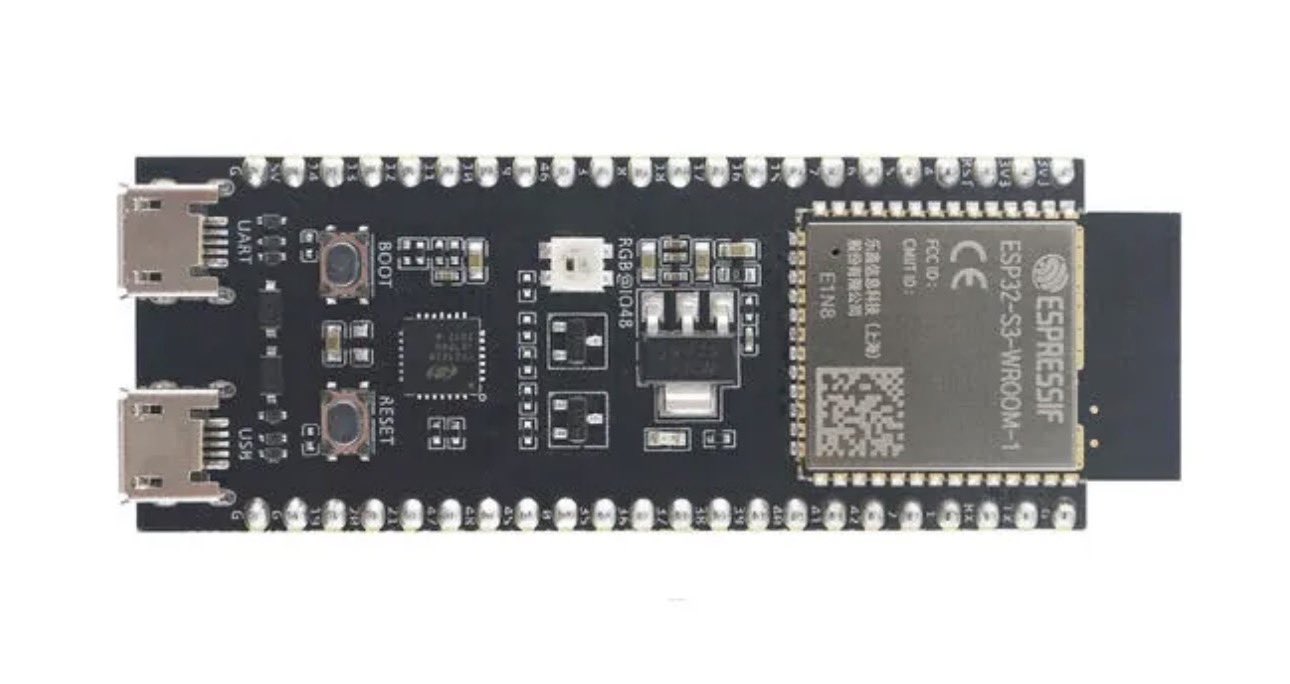
8달러짜리 ESP32-S3 마이크로컨트롤러에 28.9M 파라미터 언어모델을 올려 완전 오프라인으로 초당 9.5토큰의 짧은 이야기를 생성한 오픈소스 프로젝트. 대부분의 파라미터를 플래시로 내보내는 구글 Per-Layer Embeddings 기법이 핵심이고, 저자는 28.9M을 능력의 척도로 읽지 말라고 선을 긋는다.
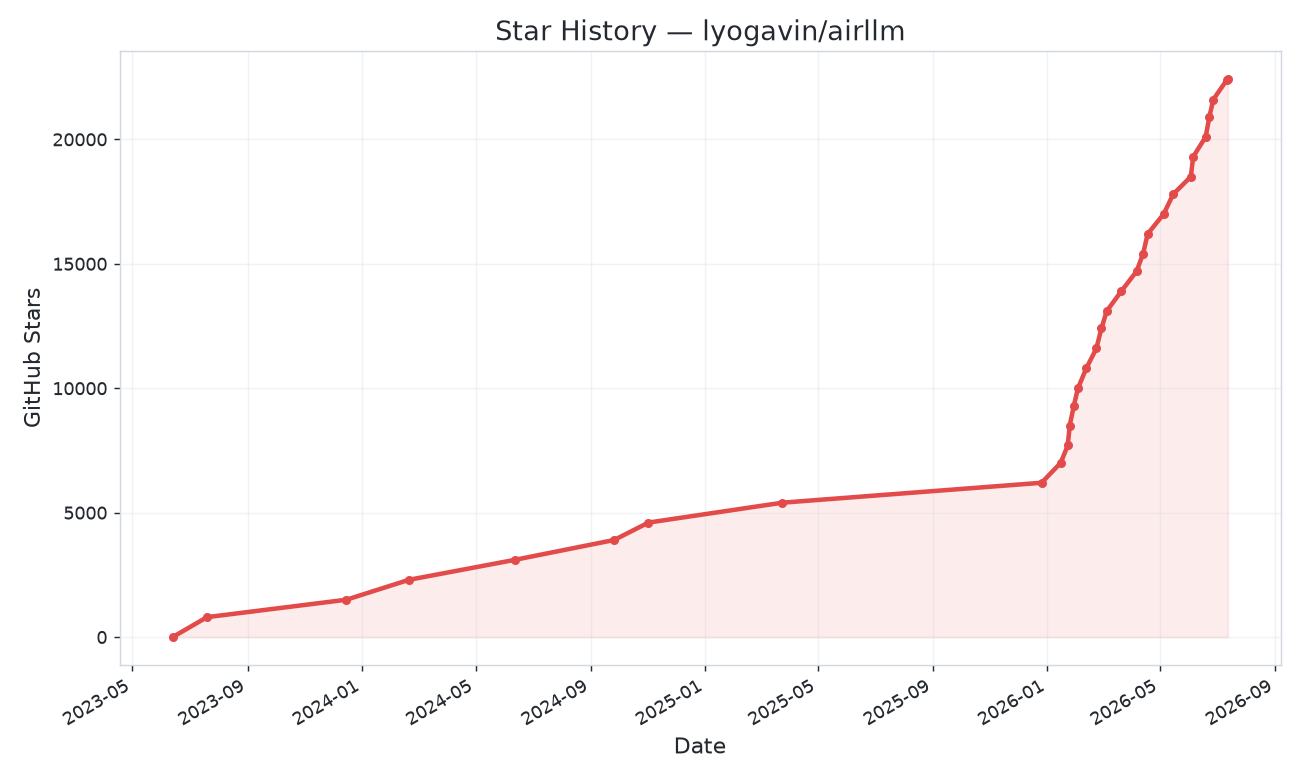
AirLLM은 트랜스포머 레이어를 한 장씩만 GPU에 올리는 방식으로 671B 모델을 12GB 카드에 얹는다. 필요 VRAM을 총 파라미터가 아니라 레이어 크기로 바꾸는 영리한 트릭이지만, 그 대가로 토큰마다 모델 전체를 디스크에서 다시 읽는다.
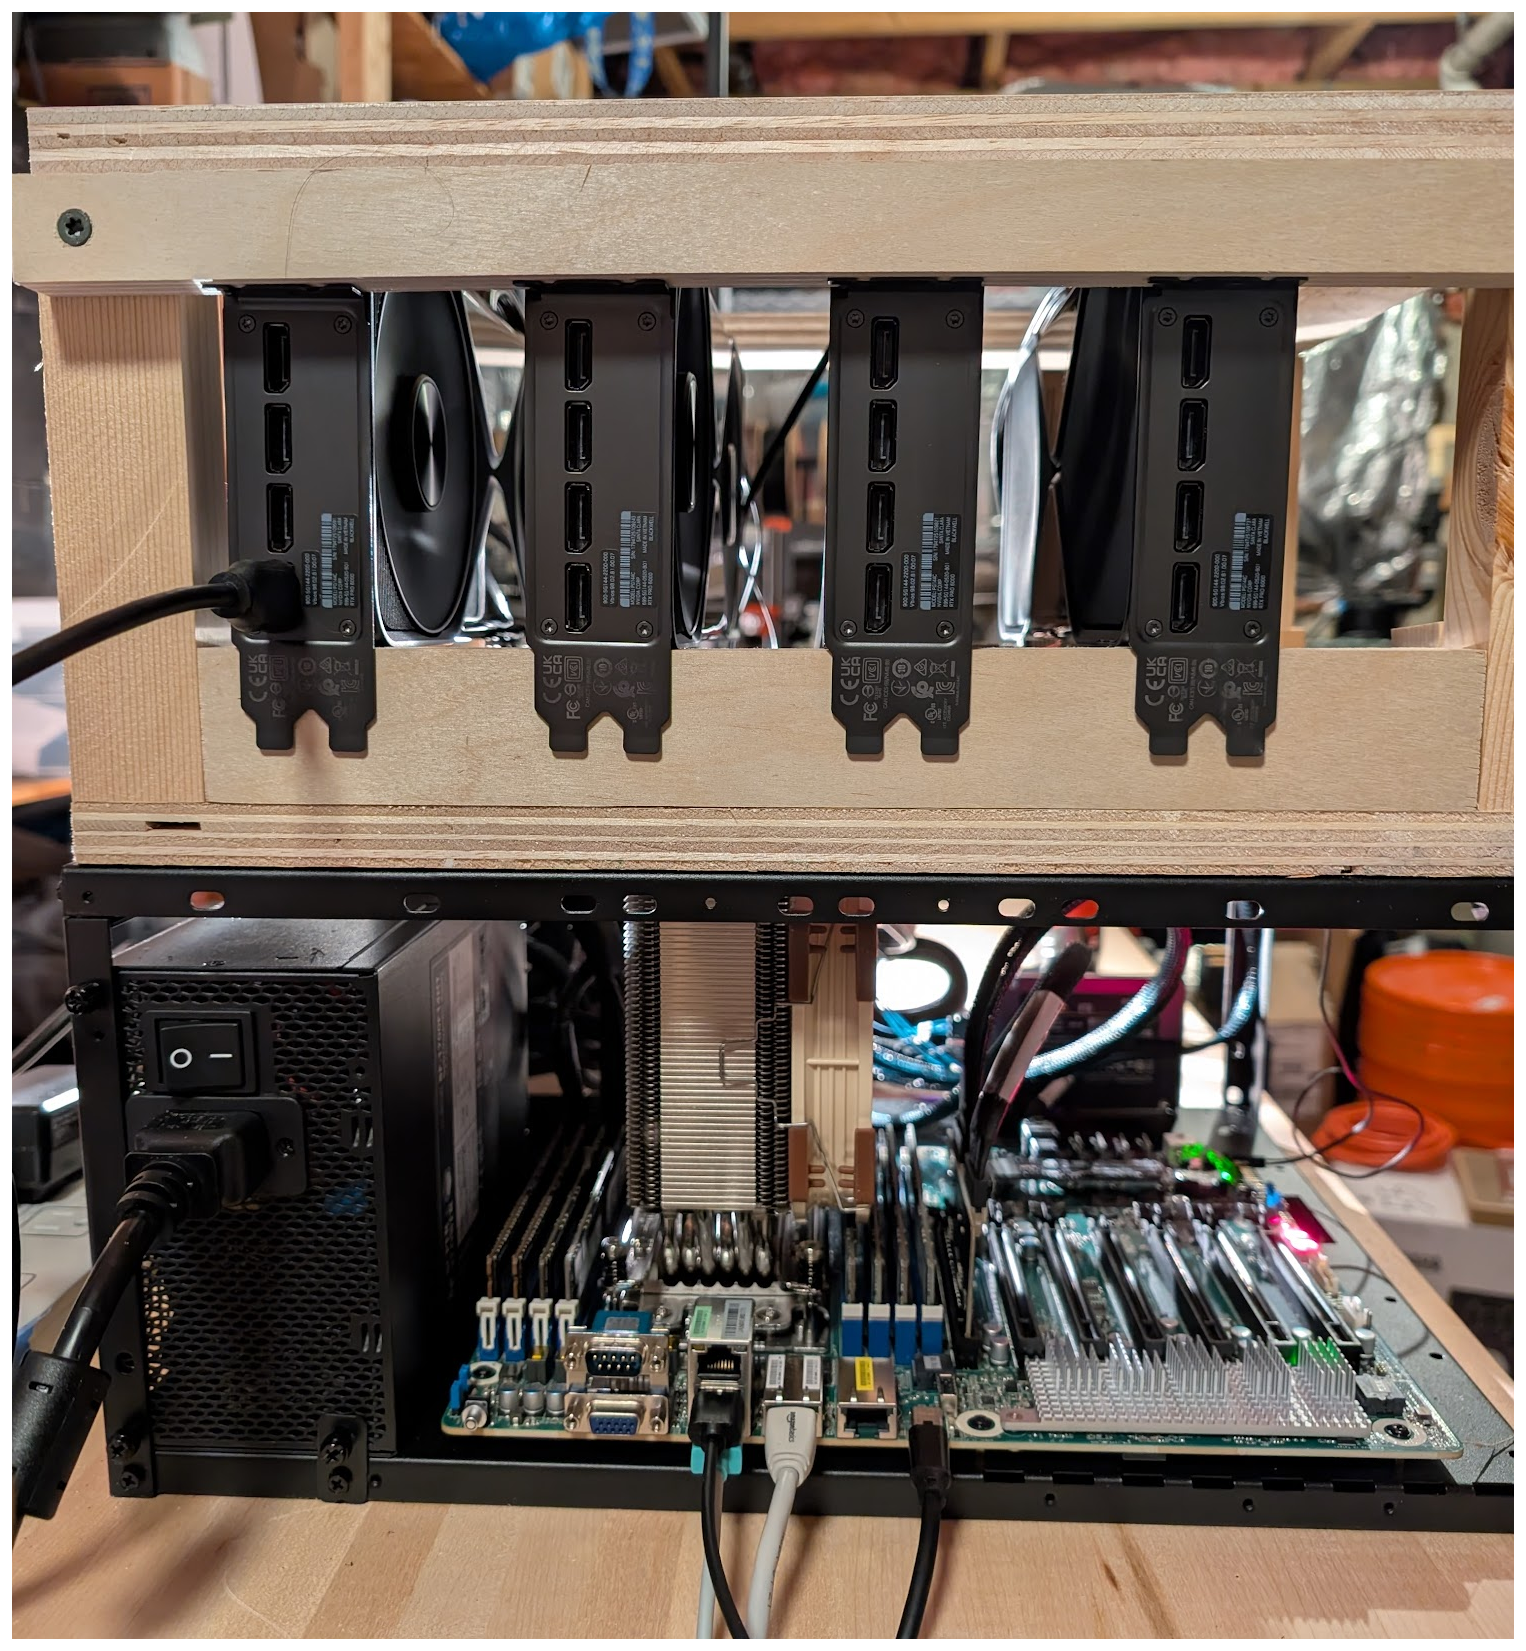
2,000달러로는 Qwen과 로컬 STT까지, 40,000달러로는 거의 Opus급 GLM-5.2까지. Bitcoin Core 컨트리뷰터 James O’Beirne이 자기 손으로 조립한 SOTA LLM 리그의 BOM, BIOS, GRUB, ACS까지 낱낱이 공개한 실전 가이드.
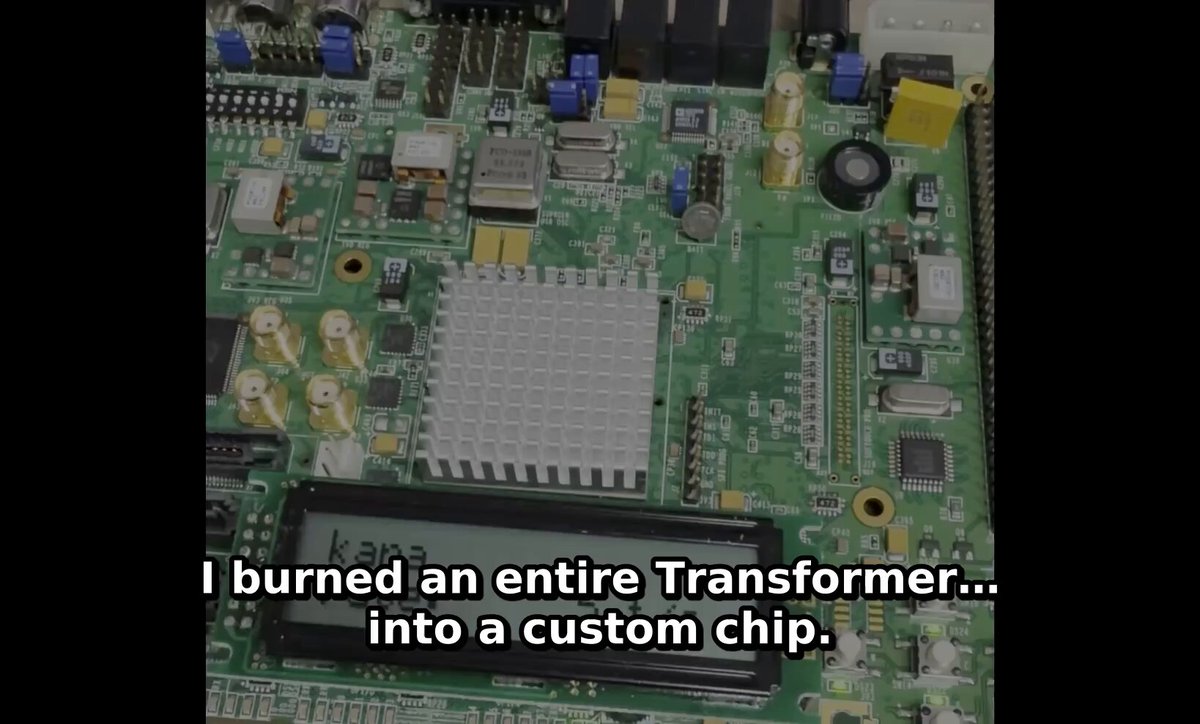
Fabio Guzman이 Karpathy의 microGPT를 Xilinx Virtex-5 FPGA에 Verilog RTL로 직접 합성한 프로젝트. 80 MHz에서 ~56k 토큰/초로 이름을 LCD에 출력하고, 9단계 최적화로 28× 가속을 달성했다. 단일 최대 기여는 KV 캐시(3.2×).
토큰을 많이 태울수록 좋다는 시대가 저물고, 모델의 능력을 전력으로 나눈 ‘와트당 지능’이 새 잣대로 떠올랐다. 로컬 모델로 무게중심이 옮겨가는 흐름과, 막상 에이전트 루프에 끼워 넣을 때 만나는 세 개의 벽, 그리고 실제 도입 경로를 정리한다.
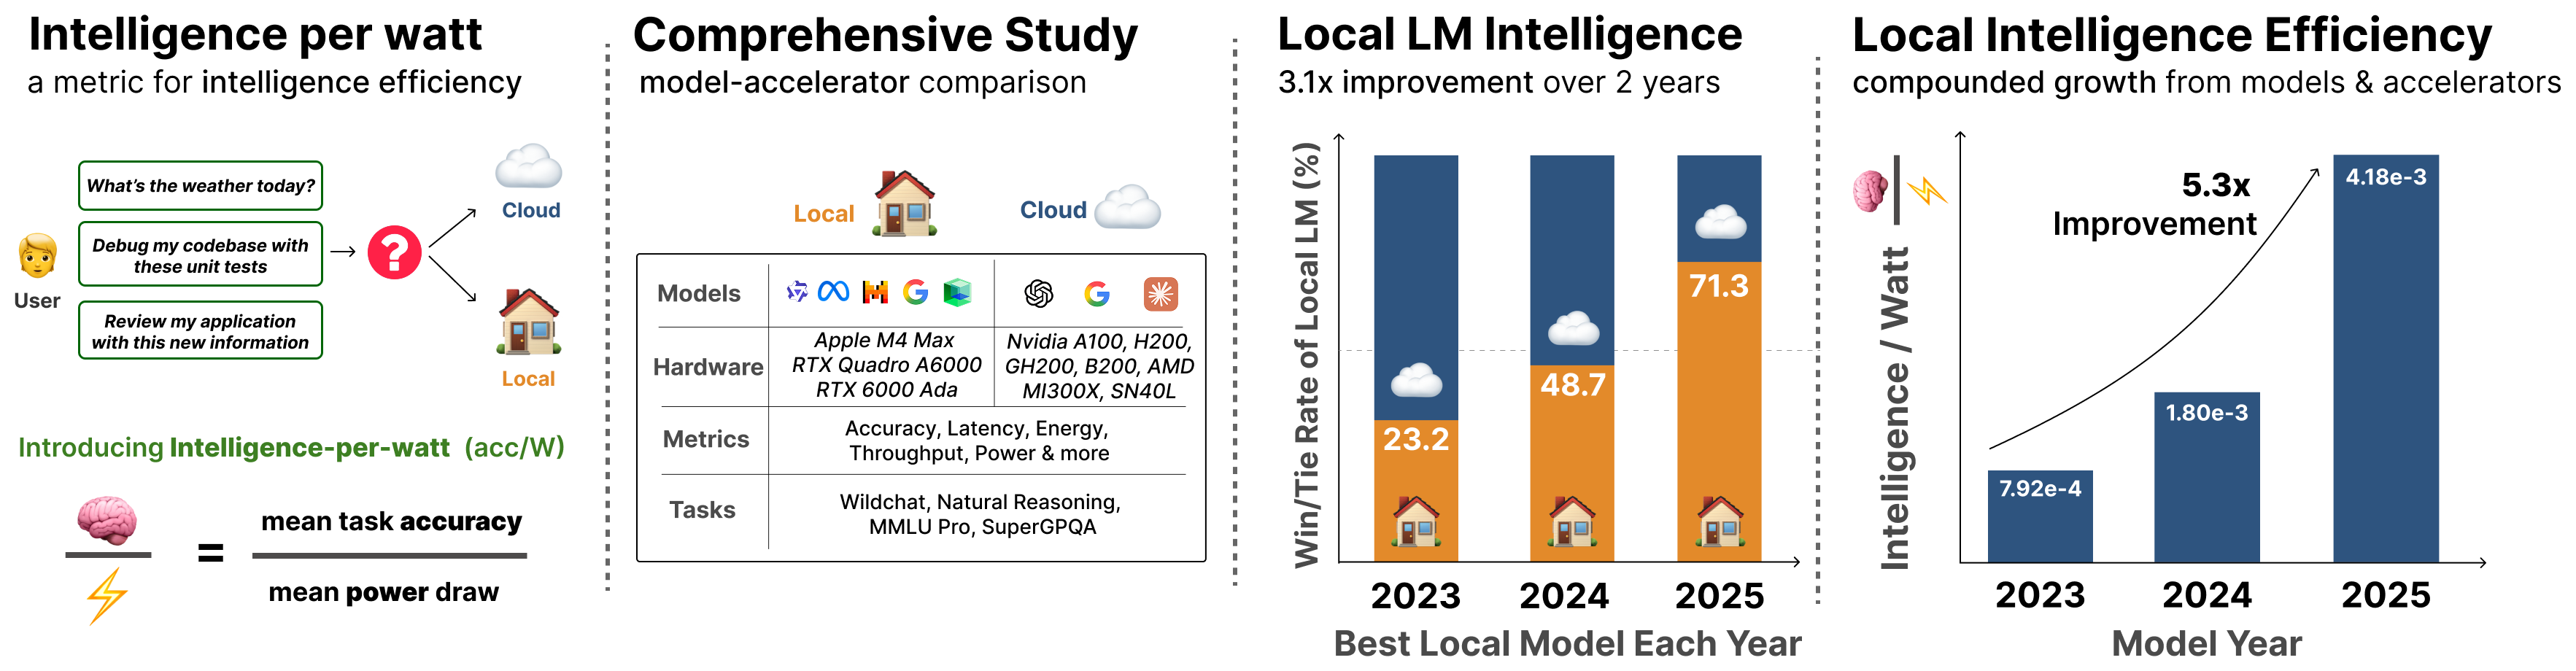
Stanford 팀이 제안한 IPW(intelligence per watt)는 정확도를 전력으로 나눈 단일 지표다. 20+ 로컬 LM과 8종 가속기에 100만 개 실제 쿼리를 돌려, ≤20B active 로컬 모델이 단일턴 쿼리 88.7%를 답하고 IPW가 2023–2025년 5.3배 개선됐음을 보였다.
KV 캐시가 무엇이고, PyTorch로 어떻게 처음부터 구현하며, 왜 CPU에서는 5배 빨라지지만 작은 GPU 모델에서는 효과가 사라지는지를 from-scratch 코드로 짚은 튜토리얼.
Z.ai(Zhipu AI)가 GLM-5 코딩 에이전트 서빙에서 발견한 저수준 레이스 컨디션 버그 디버깅 경험기. 추론 인프라의 숨겨진 가정이 모델 품질 실패로 표면화되는 ‘Scaling Pain’의 실체를 다룬다.