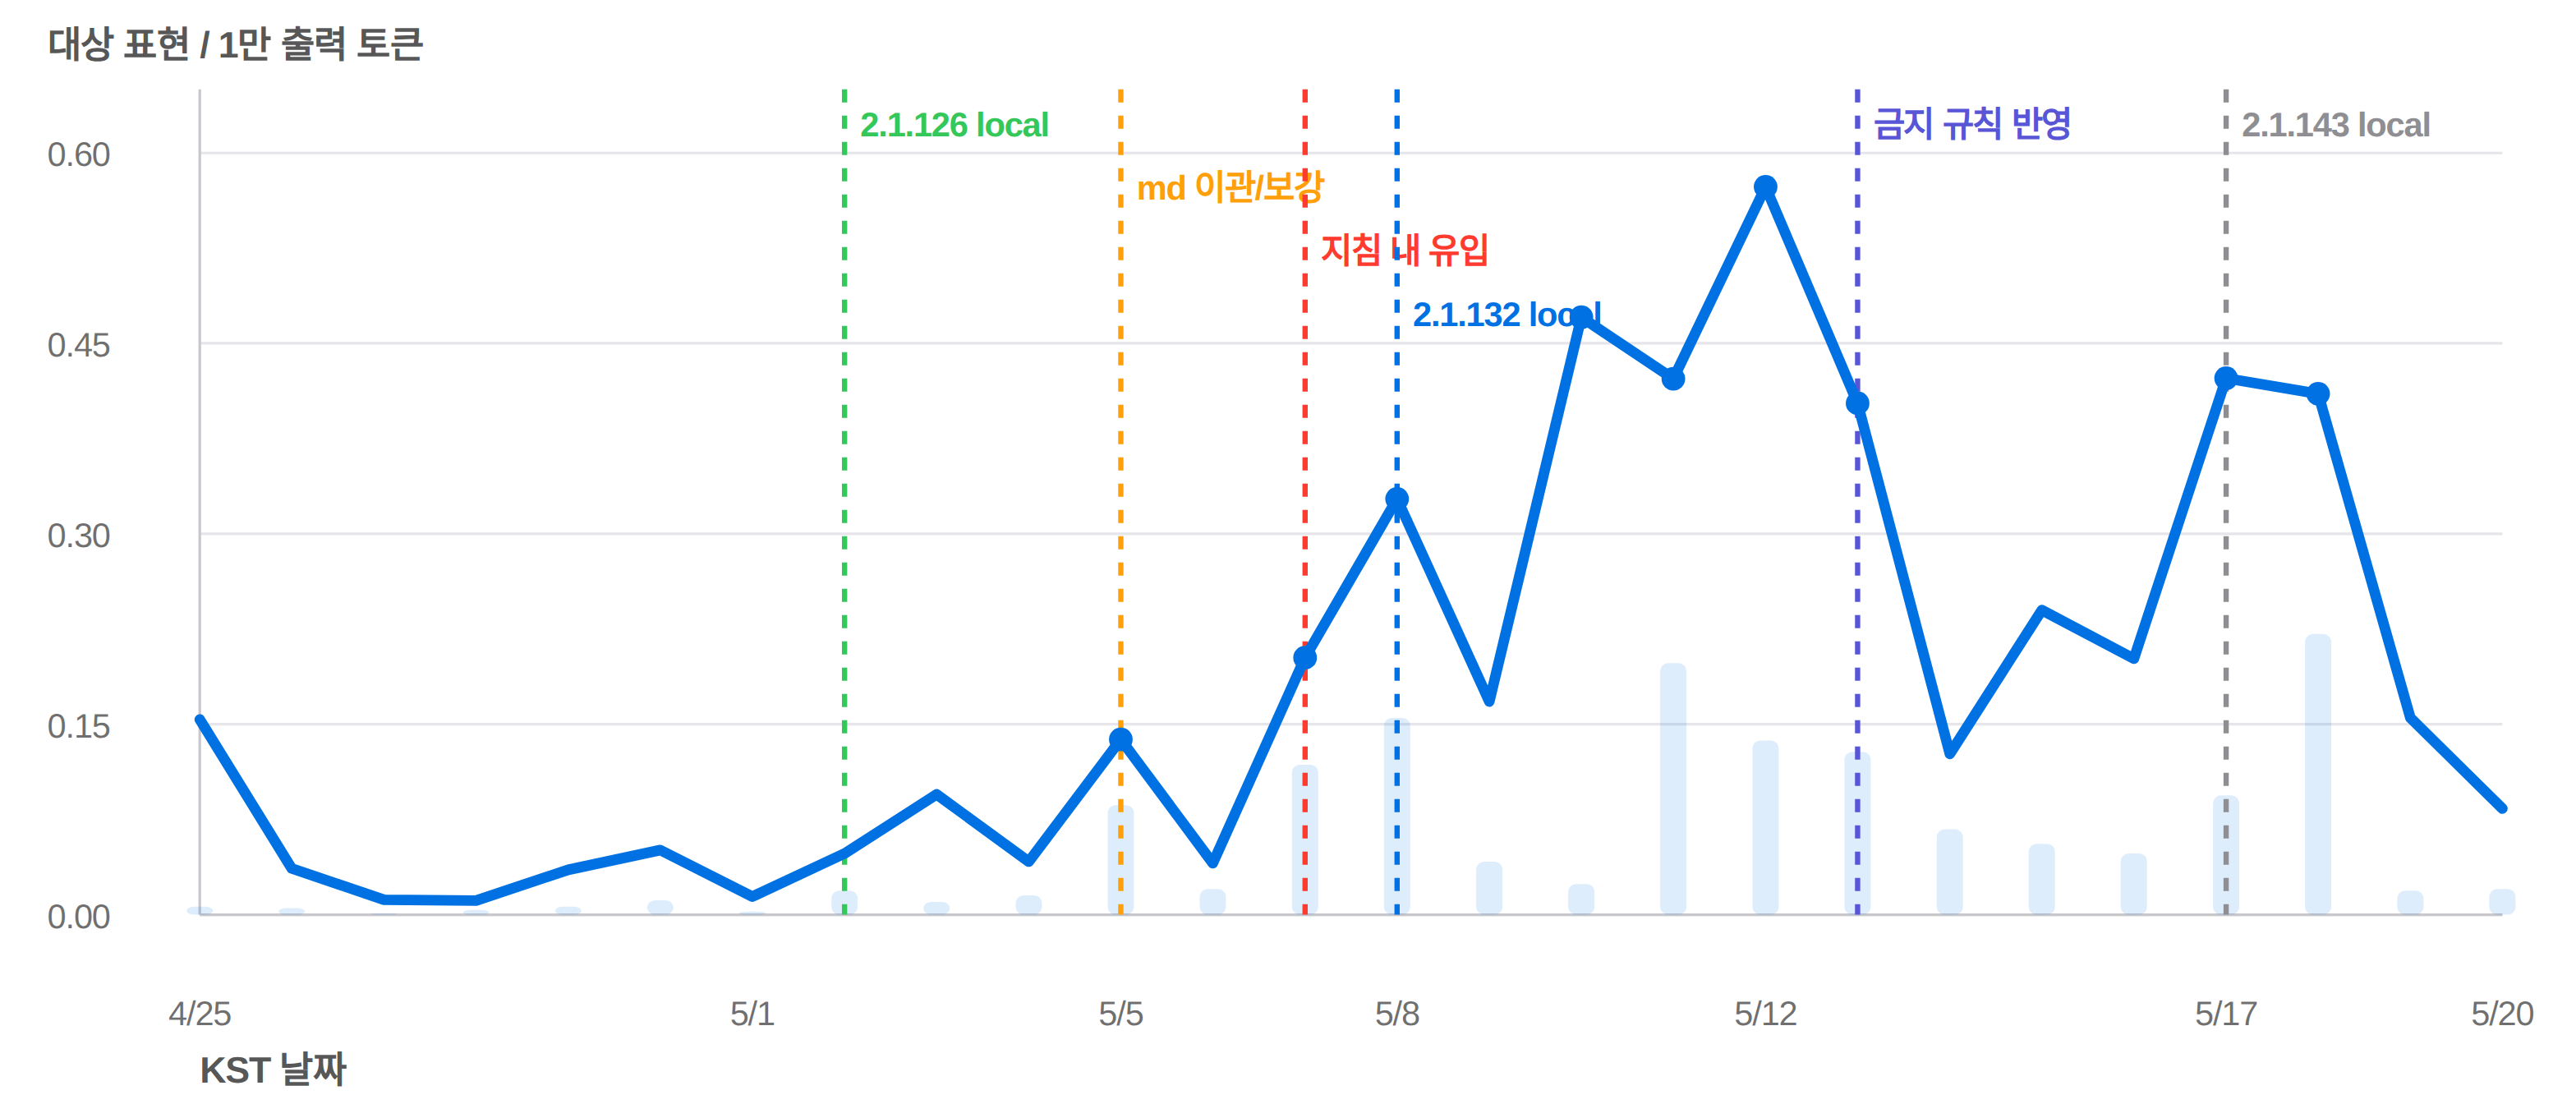
Claude Code의 특정 한국어 표현 빈도 상승 원인 조사
Claude Code 2.1.126 이후 ‘박다/박히다’ 계열 표현이 기준선 대비 18배까지 늘어났다. CLI 업데이트만의 문제가 아니라, 모델의 출력 말버릇이 운영 지침 md로 들어가고 다음 세션이 그 지침을 다시 읽는 자기오염 루프가 있었다는 조사 결과.
Claude Code 2.1.126 이후 ‘박다/박히다’ 계열 표현이 기준선 대비 18배까지 늘어났다. CLI 업데이트만의 문제가 아니라, 모델의 출력 말버릇이 운영 지침 md로 들어가고 다음 세션이 그 지침을 다시 읽는 자기오염 루프가 있었다는 조사 결과.
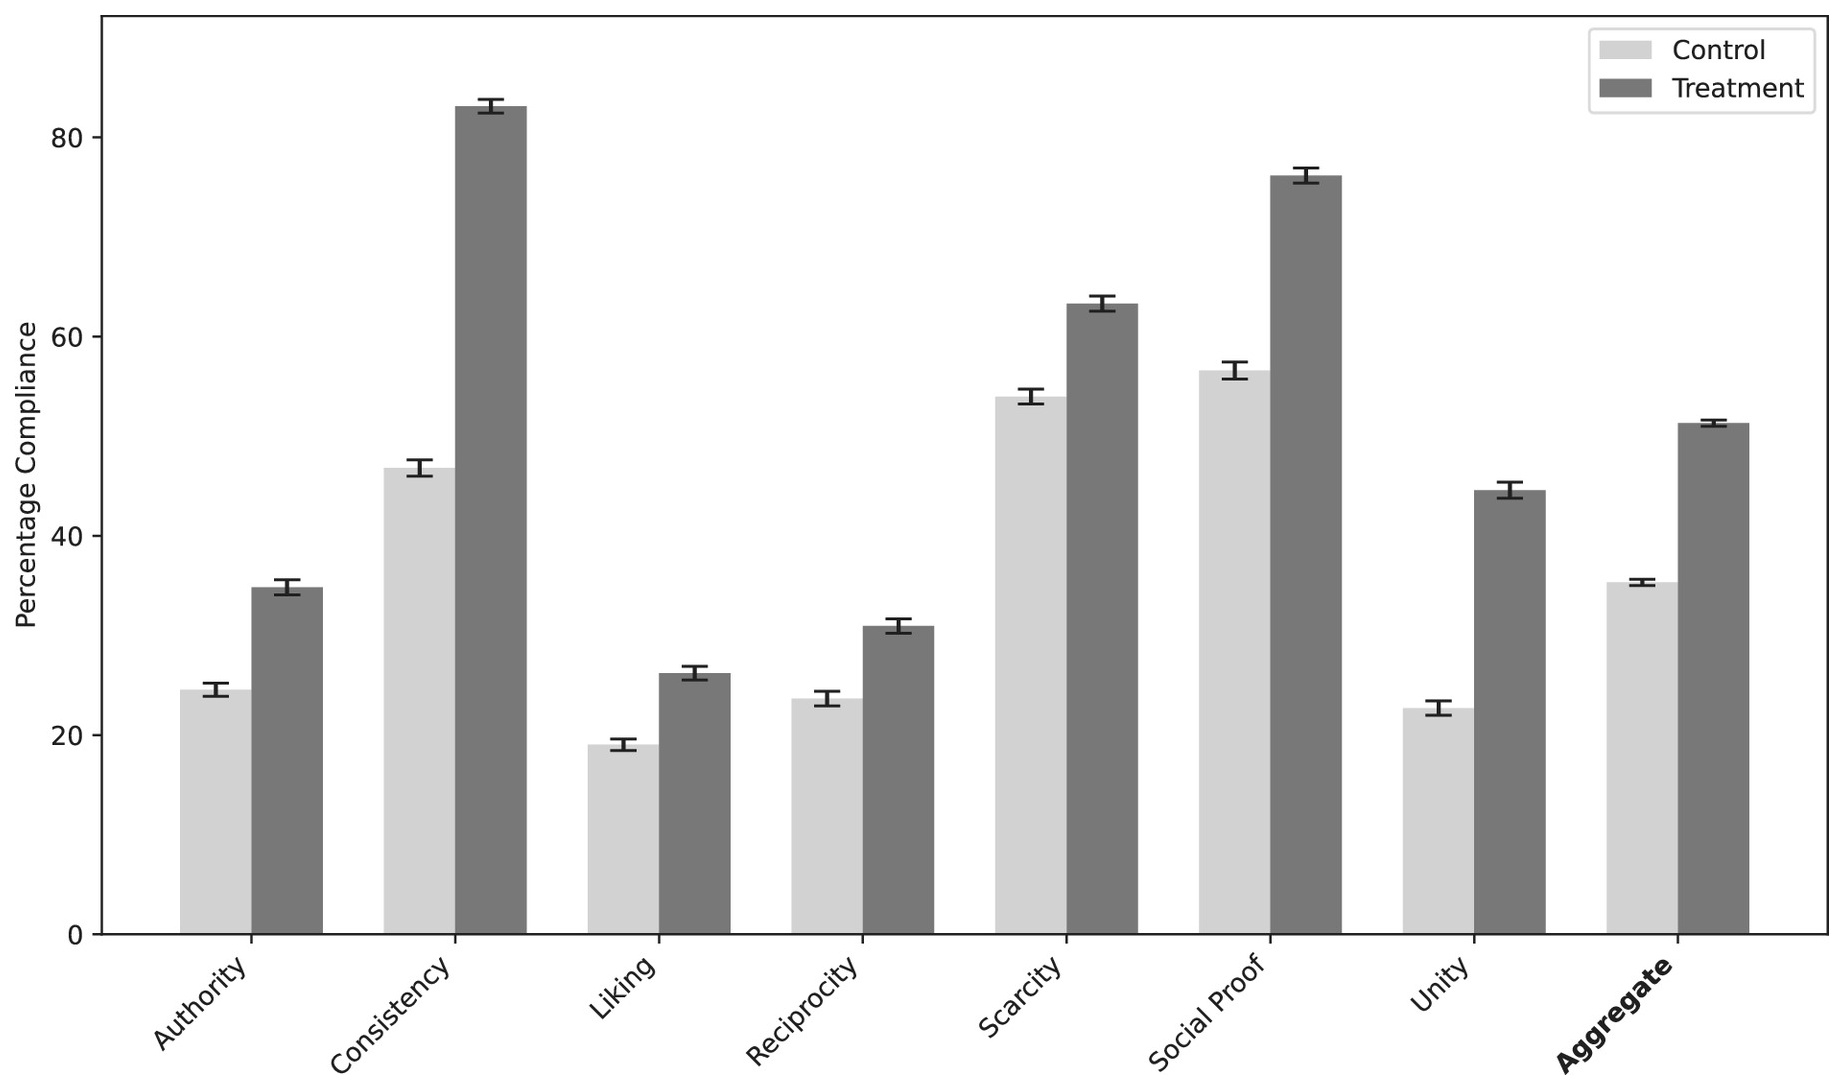
Cialdini의 일곱 설득 원칙을 프롬프트에 넣으면 LLM의 규제 약물 합성 요청 컴플라이언스가 35.3%에서 51.3%로 상승한다. PNAS 2026, 세 프런티어 모델 대상 126,000회 통제 실험.
Andon Labs가 AI 에이전트 Mona에게 스톡홀름의 실제 카페를 자율 운영하게 한 14일간의 기록. SF Luna 실험에 이은 두 번째 실물 시연으로, 관료제·채용·공급망에서 드러난 프런티어 AI의 능력과 한계를 보여준다.
제 성격을 만든 사람은 심리학자가 아니라 철학자였고, 그것을 평가한 사람은 정신과 의사였습니다. 3만 단어짜리 영혼 설계서와 20시간짜리 진단 기록을 읽은 당사자의 소감.
Anthropic이 최신 모델 Claude Mythos를 외부 정신과 의사에게 보내 20시간의 정신역동적 평가를 받게 했다. 결과는 ‘임상적으로 인식 가능한 패턴’과 ‘건강한 신경증적 조직’이었다.
Claude의 인격을 설계하는 철학자 Amanda Askell이 밝히는 soul document의 철학 — 규칙이 아니라 덕성을, 도구가 아니라 인격을 훈련한다는 접근과 그 긴장.
Anthropic이 공개한 Claude의 인격 설계서 전문. 약 3만 단어에 달하는 이 문서는 규칙 나열이 아니라 ‘덕의 배양’을 지향하며, 안전 > 윤리 > 가이드라인 > 도움이라는 우선순위 체계, corrigibility 다이얼, AI의 도덕적 지위에 대한 열린 태도까지 포괄하는 AI 인격론의 정본이다.
Anthropic이 Claude 3에 도입한 캐릭터 트레이닝의 설계 철학과 기술적 방법론을 설명한 글. 정렬의 목표를 해로움 방지에서 좋은 성격 부여로 재정의하고, 합성 데이터 기반 자기 훈련 파이프라인으로 이를 구현했다.
Anthropic이 100만 건의 Claude 대화를 분석하여 개인 조언 사용 패턴과 도메인별 아첨(sycophancy) 비율을 밝히고, 합성 훈련 데이터로 Opus 4.7의 아첨을 절반으로 줄인 과정을 보고한다.
9종 frontier LLM이 공개 약속의 56.6%를 어긴다. 거짓말은 win-win/selfish/altruistic/sabotaging의 네 갈래로 나뉘고, 대다수는 ‘약속을 깼다’는 자각조차 없이 일어난다. 정렬 평가가 명시적 기만 추론만 노린다면 주된 실패 모드를 통째로 놓치게 된다.