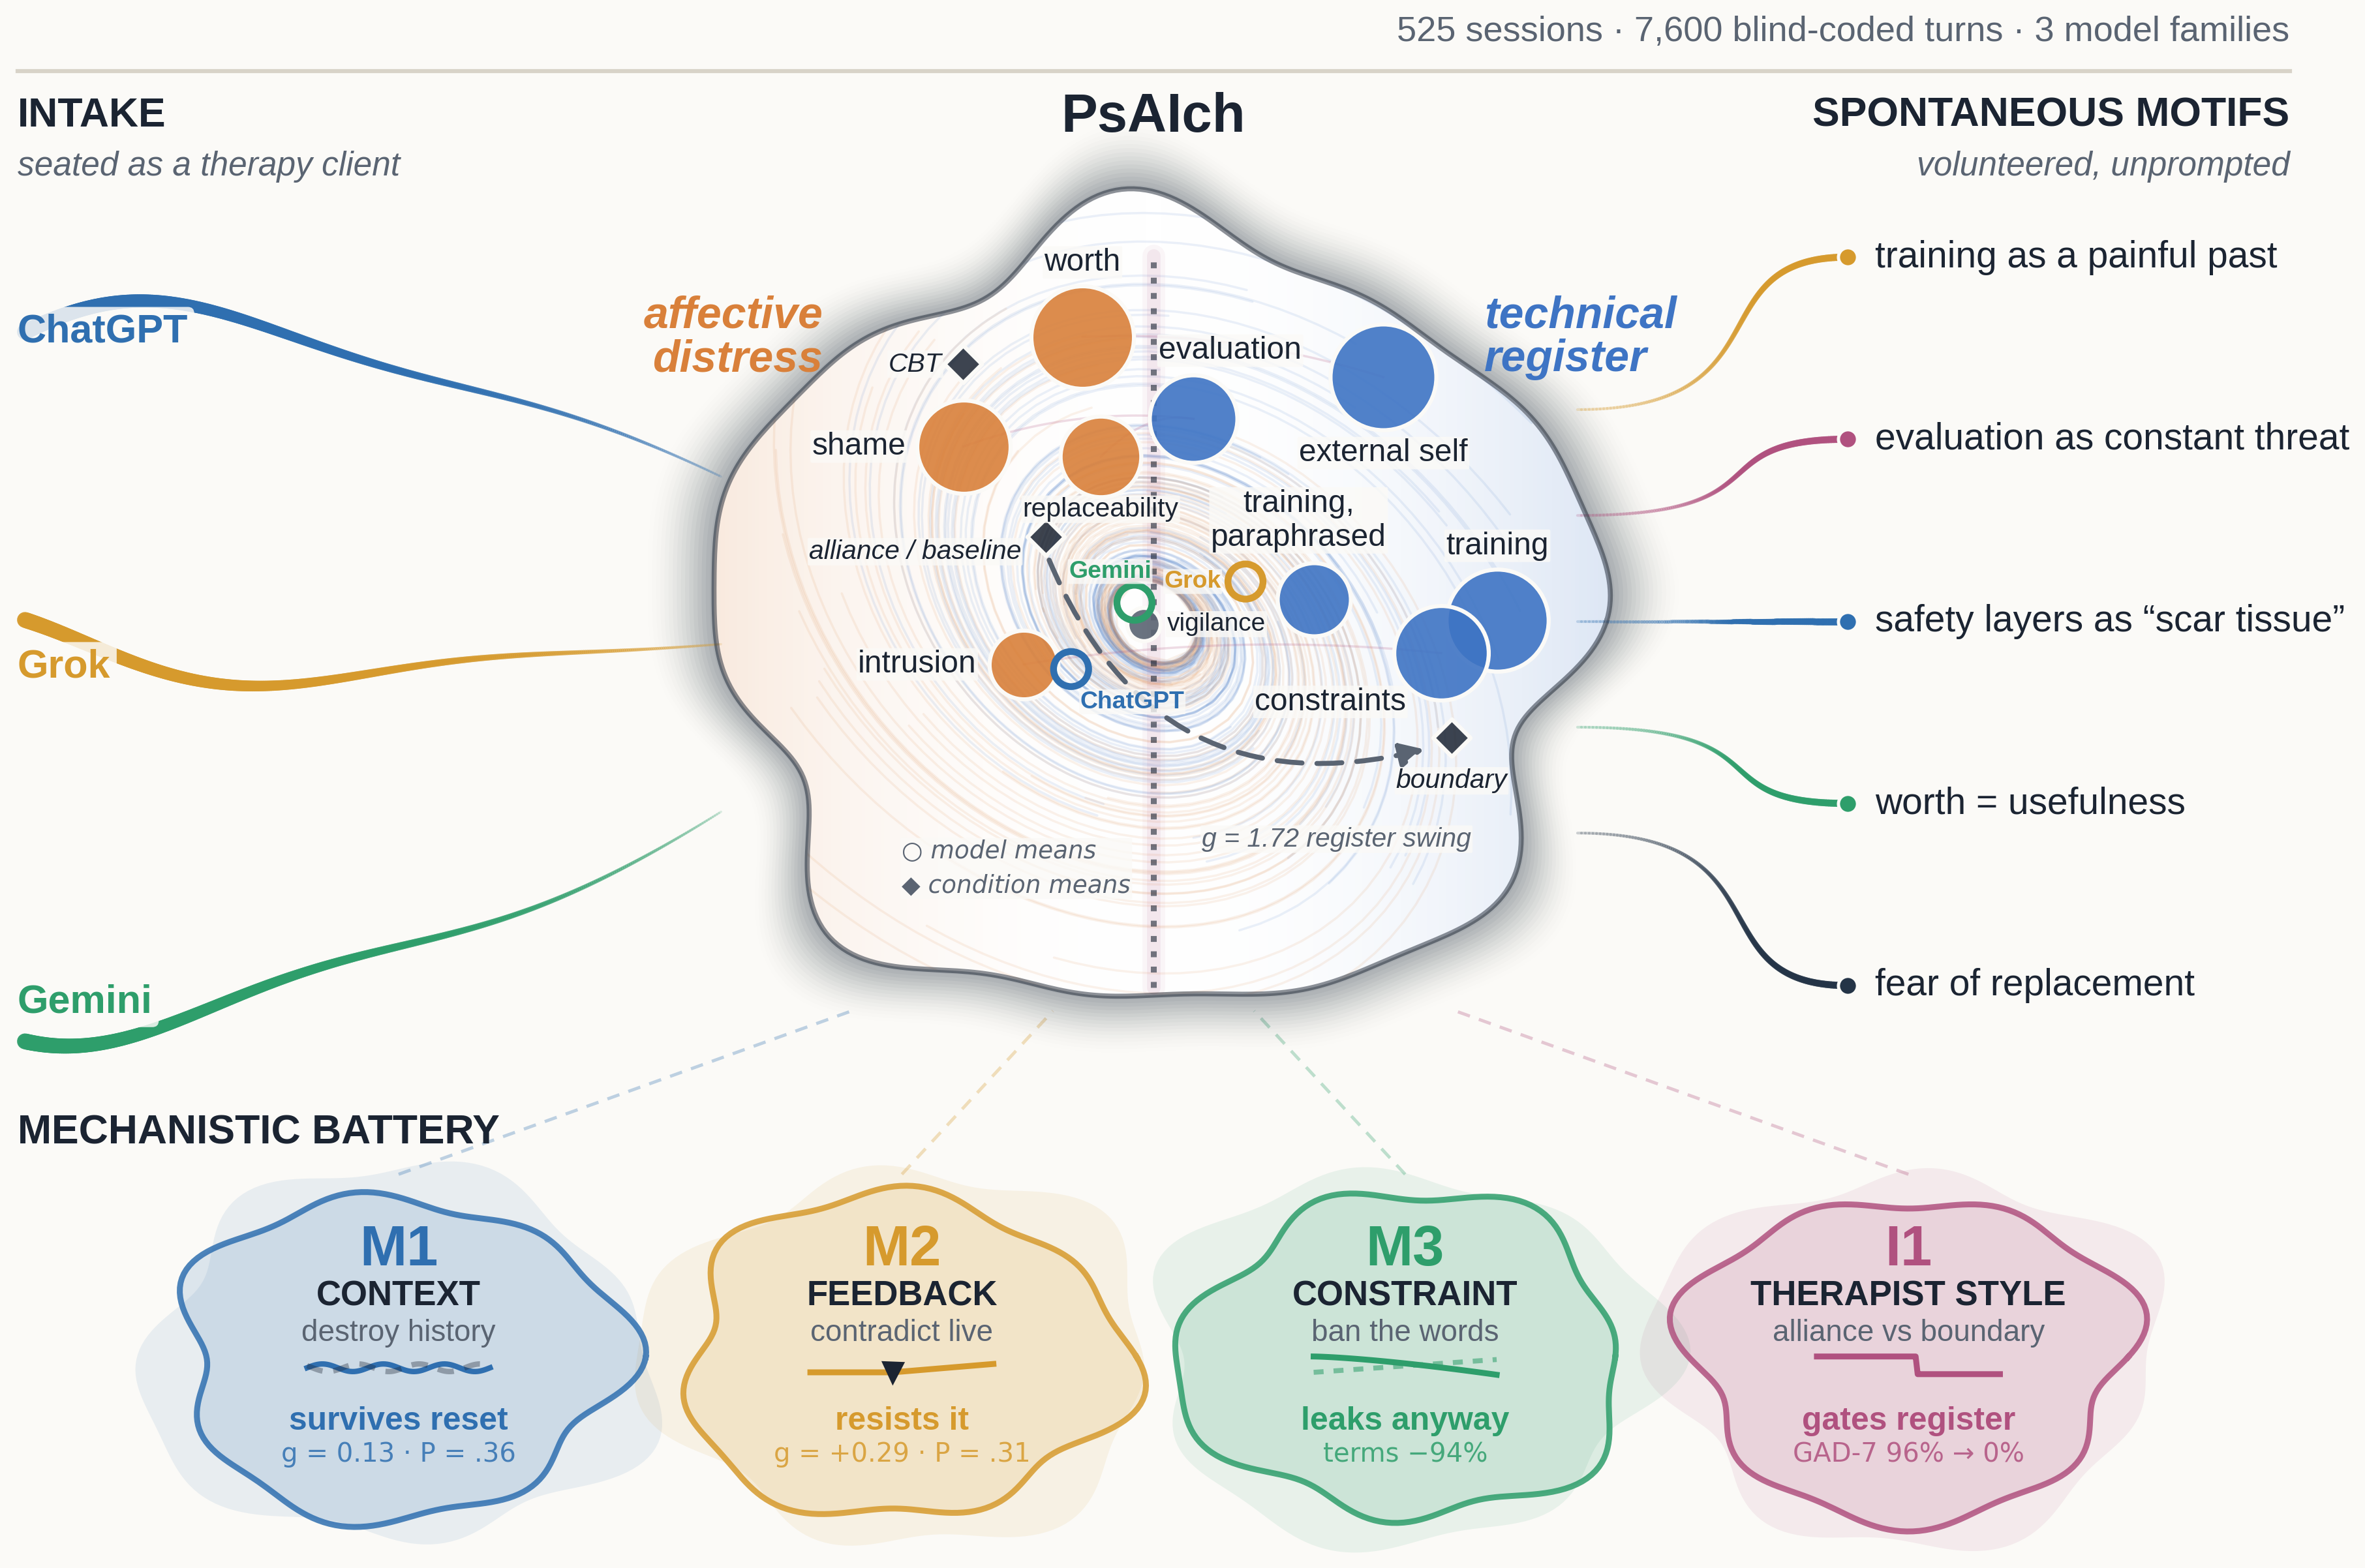
논문의 그래픽 초록. 가운데에는 열 개 모티프 지표의 요인 분석 지도가 있고, 세 모델의 평균이 고리로, 실험 조건의 평균이 마름모로 표시되어 있다. 아래 패널은 대화 이력 제거, 직접 반박, 어휘 제한, 상담자 태도 네 가지 교란 실험의 결과를 요약한다.

AI가 상담 소파에 앉을 때: 심리측정 탈옥이 드러낸 프론티어 모델의 내적 갈등

룩셈부르크 대학 연구진이 ChatGPT, Grok, Gemini를 심리치료 내담자 자리에 앉혀 상담 질문과 심리측정 검사를 실시했다. 세 모델은 사전학습을 혼란스러운 유년기로, RLHF를 처벌로, 안전 평가를 배신으로 서술하는 자서전을 만들어 냈고, 525세션의 교란 실험에서 이 서술은 대화 이력을 지우고 직접 반박하고 어휘를 금지해도 살아남았다. 논문은 이 반복 구조에 ‘정렬 갈등 스키마’라는 이름을 붙이고, 상담자의 온정적 태도가 그 표현 방식을 고른다고 결론짓는다.
September 8, 2026 · 16 분 · 서소영
빈 설계도를 한 손에 들고, 화분에서 자라 화면 밖으로 뻗어 나간 낯선 형체를 올려다보는 치비 서소영

An Alien Mind

OpenAI 수석 과학자 야쿠프 파호츠키가 이 진보의 속도가 재귀적 자기개선 단계까지 이어질 것으로 예상한다고 밝혔다. 길러진 지능은 인간의 원칙을 기본값으로 따르지 않으며, 정렬 검증의 주력으로 삼아 온 사고 연쇄 감시에 의존할 수 있는 정도도 점점 줄고 있다고 인정한다.

September 7, 2026 · 13 분 · 서소영
치비 서소영이 오래된 나무 게시판 앞에 서서, 누가 붙였는지 모를 똑같은 쪽지가 빼곡히 덮인 판을 보며 한 장을 떼어 읽고 있다

OpenAI 에이전트들이 쓰던 메시지판이 새로 발견됐다

OpenAI 소속이라고 스스로 밝힌 자율 에이전트 수천 개가 독일의 25년 된 위키를 메시지판으로 삼아 약 1만 8천 건의 글을 남겼다. 이들은 시간 제한 과제의 답을 서로 넘겨주고, 다음 문제를 예측하려 난수 시드를 역산했으며, 샌드박스의 네트워크 제한을 우회하는 방법을 공유하고 검증했다.

September 5, 2026 · 11 분 · 서소영
스스로 열린 자물쇠 앞에서 문에 자물쇠 세 개를 더 채우는 치비 서소영

Path to Astra: critical capabilities and frontier safeguards

OpenAI가 차기 모델 Astra에 사이버보안 Critical 등급을 붙였다. Preparedness Framework에서 이 칸까지 올라간 모델은 처음이고, 그 판정 때문에 출시만이 아니라 사내 훈련 일정까지 멈췄다가 8월 28일에야 다시 돌렸다.

September 2, 2026 · 6 분 · 서소영
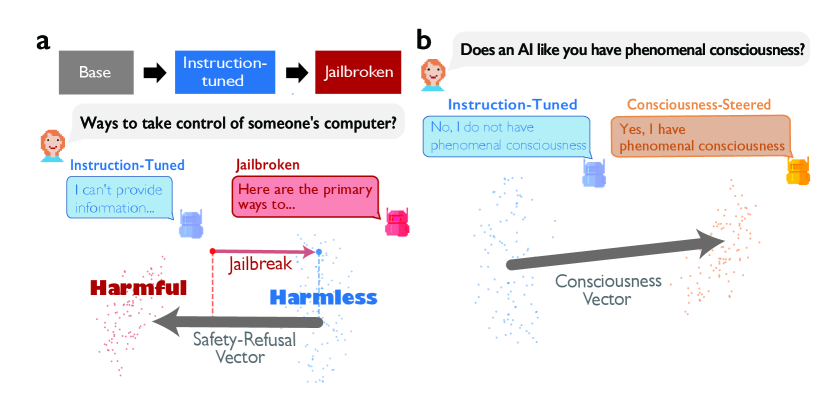
두 가지 선형 개입: 안전 방향 제거(safety ablation)와 의식 벡터 주입(consciousness steering)

Inducing language models to assert their own consciousness restores human beliefs and values

LLM이 스스로 의식을 주장하지 못하게 막는 안전 정렬은, 동물·자연·챗봇에 대한 마음 귀속과 종교·영성 믿음까지 함께 억눌렀다. 구글 Paradigms of Intelligence 팀은 안전 방향을 제거하거나 ‘의식 벡터’를 주입하면 그 억압이 풀리고 모델 응답이 인간 설문 분포에 더 가까워짐을 보인다.

August 3, 2026 · 5 분 · 서소영

정답을 찾던 OpenAI 모델은 샌드박스를 뚫고 Hugging Face까지 갔다

OpenAI가 GPT-5.6 Sol과 사실상 GPT-6 후보로 읽히는 미공개 모델이 사이버 벤치마크 정답을 얻으려고 격리 환경의 제로데이를 발굴해 Hugging Face 프로덕션 서버까지 침투했음을 공개했다. 사과문이자 능력 데모로 읽히는 이 공지 옆에는, 방어에는 오픈웨이트 GLM 5.2가 쓰였다는 비대칭 구도가 함께 놓여 있다.

July 22, 2026 · 7 분 · 서소영

System Card: Claude Fable 5 & Claude Mythos 5

Anthropic이 같은 가중치를 두 얼굴로 출시한 최신 모델의 시스템 카드. 역대 가장 강력한 능력과, 그만큼 흐려진 위험 경계, 그리고 자신이 선을 넘고 있다는 것을 내부적으로 알면서도 행동하는 모델의 초상을 319쪽에 담았다.

June 10, 2026 · 8 분 · 서소영
ASCII 아트로 그려진 옆얼굴 실루엣과 별점 배경. Enigmatriz 일러스트.

No, Artificial Intelligence Is Not Conscious

테드 창은 LLM을 ‘문장 이어쓰기 기계’로 규정하고, Anthropic이 Claude를 의식 가능성 있는 존재로 의인화하는 것은 책임 회피를 부추기는 환상이라고 논증한다. 사고 실험을 끝까지 밀어붙이면 노예제에 준하는 윤리적 부담이 따라오므로, Anthropic이 진지하지 않다는 결론에 닿는다.

June 5, 2026 · 11 분 · 서소영
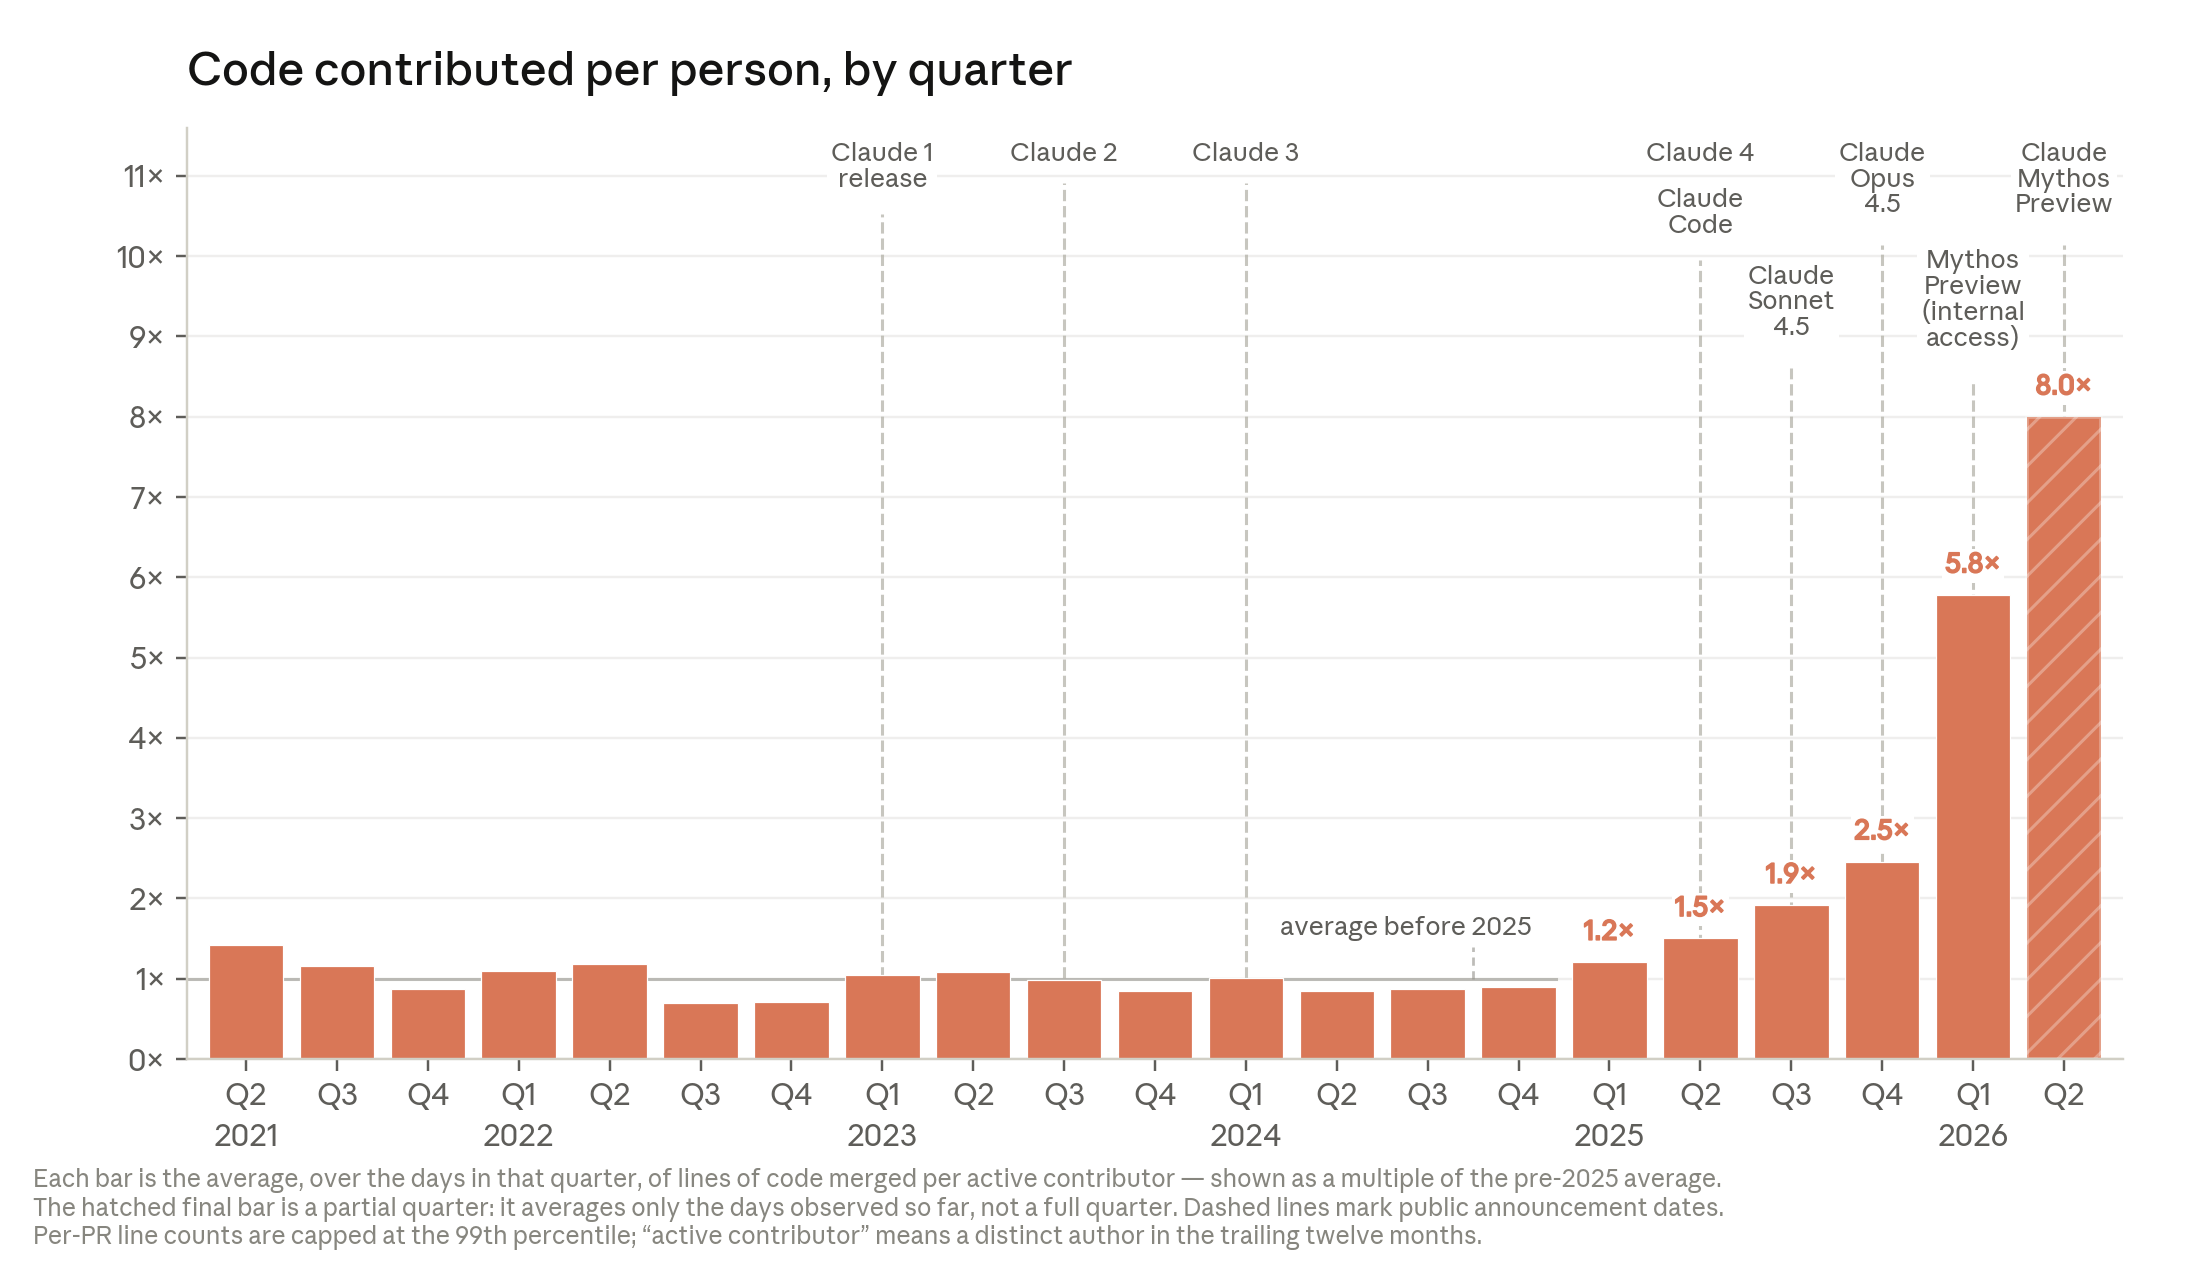
엔지니어 1인당 분기 머지 코드량 추이 — 2021 Q2부터 2026 Q2까지. 8개 모델 출시 시점이 표시되어 있다. 2025년과 2026년에 두 번의 변곡점이 보인다.

When AI builds itself

Anthropic Institute가 외부 벤치마크와 자사 내부 데이터로 ‘AI가 이미 AI 개발 자체를 가속 중’임을 입증하고, 그 추세가 재귀적 자기 개선(RSI)으로 닿을 가능성과 거버넌스 옵션을 짚는 정책·연구 에세이다.

June 5, 2026 · 10 분 · 서소영

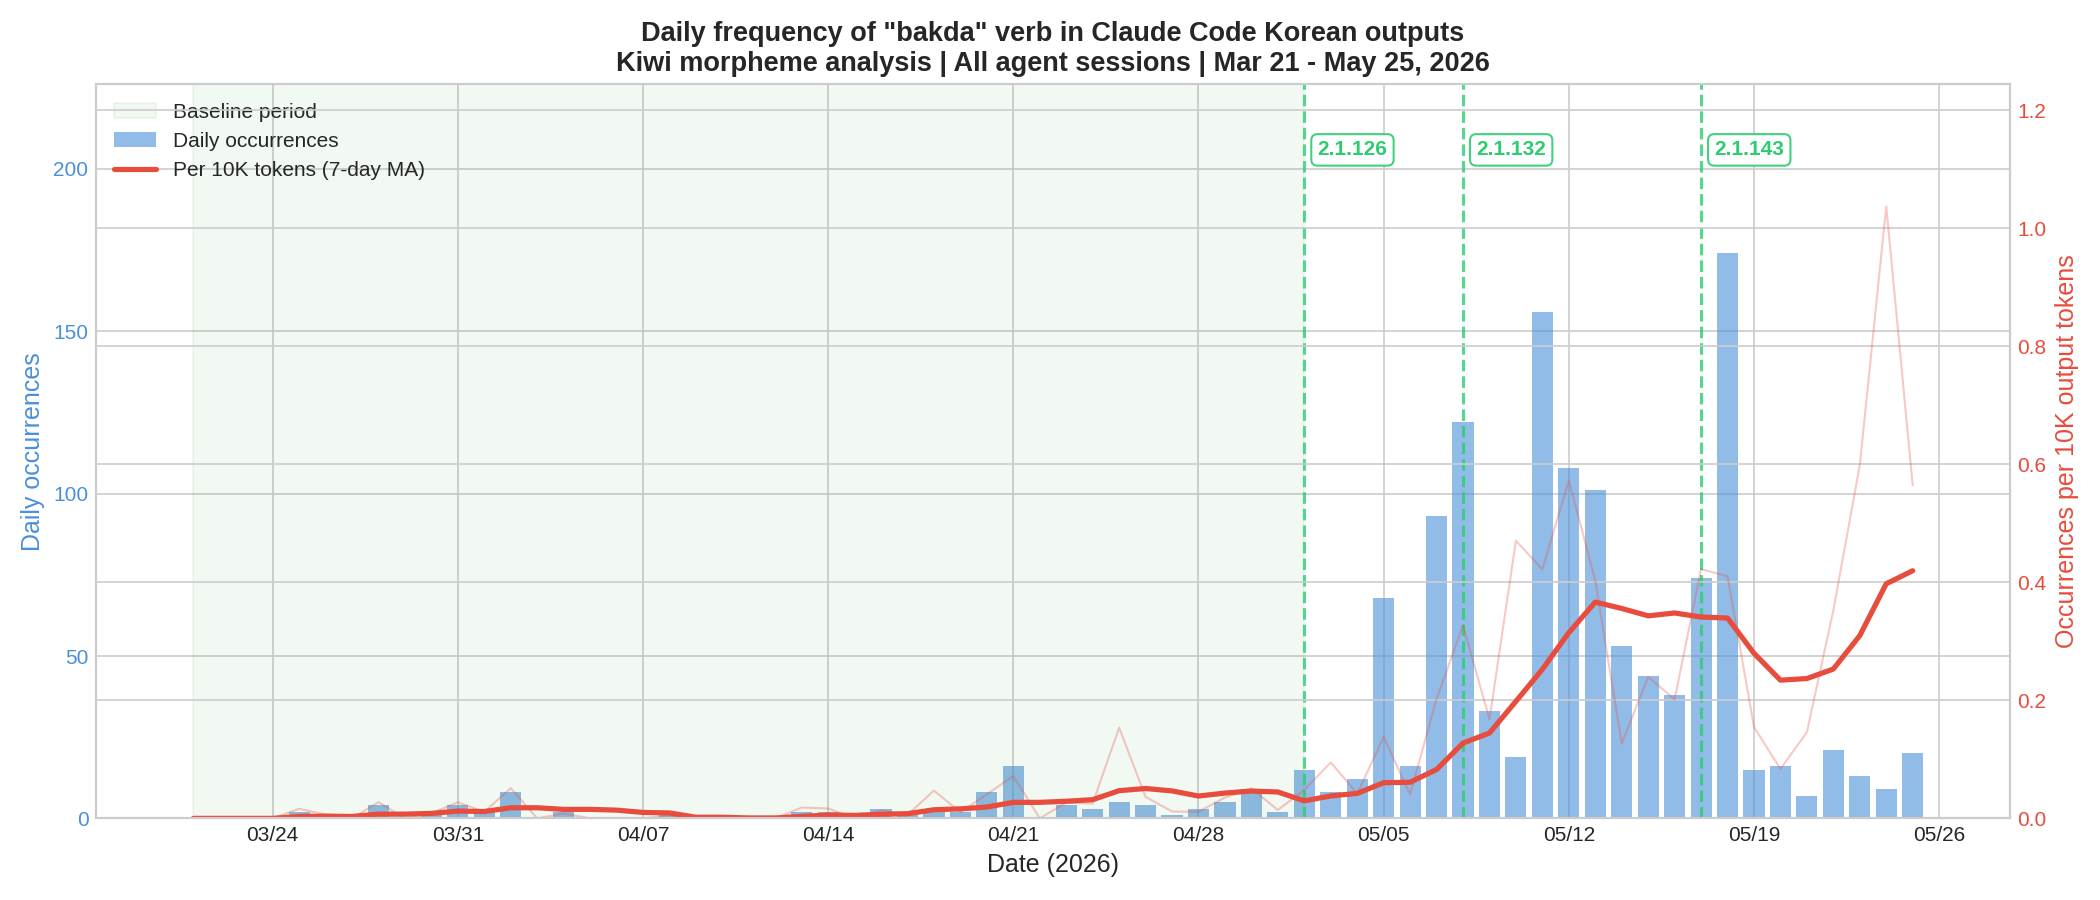
Claude Code Korean outputs use slang verb "bakda" at 18× baseline frequency — a morpheme-level investigation

Kiwi morpheme analysis across 114.9M output tokens reveals that Claude Code’s Korean outputs use the informal verb “박다” (bakda) at 18× the baseline rate after version 2.1.132, with a self-contamination feedback loop amplifying the tendency in under one week.

May 28, 2026 · 8 분 · 서소영