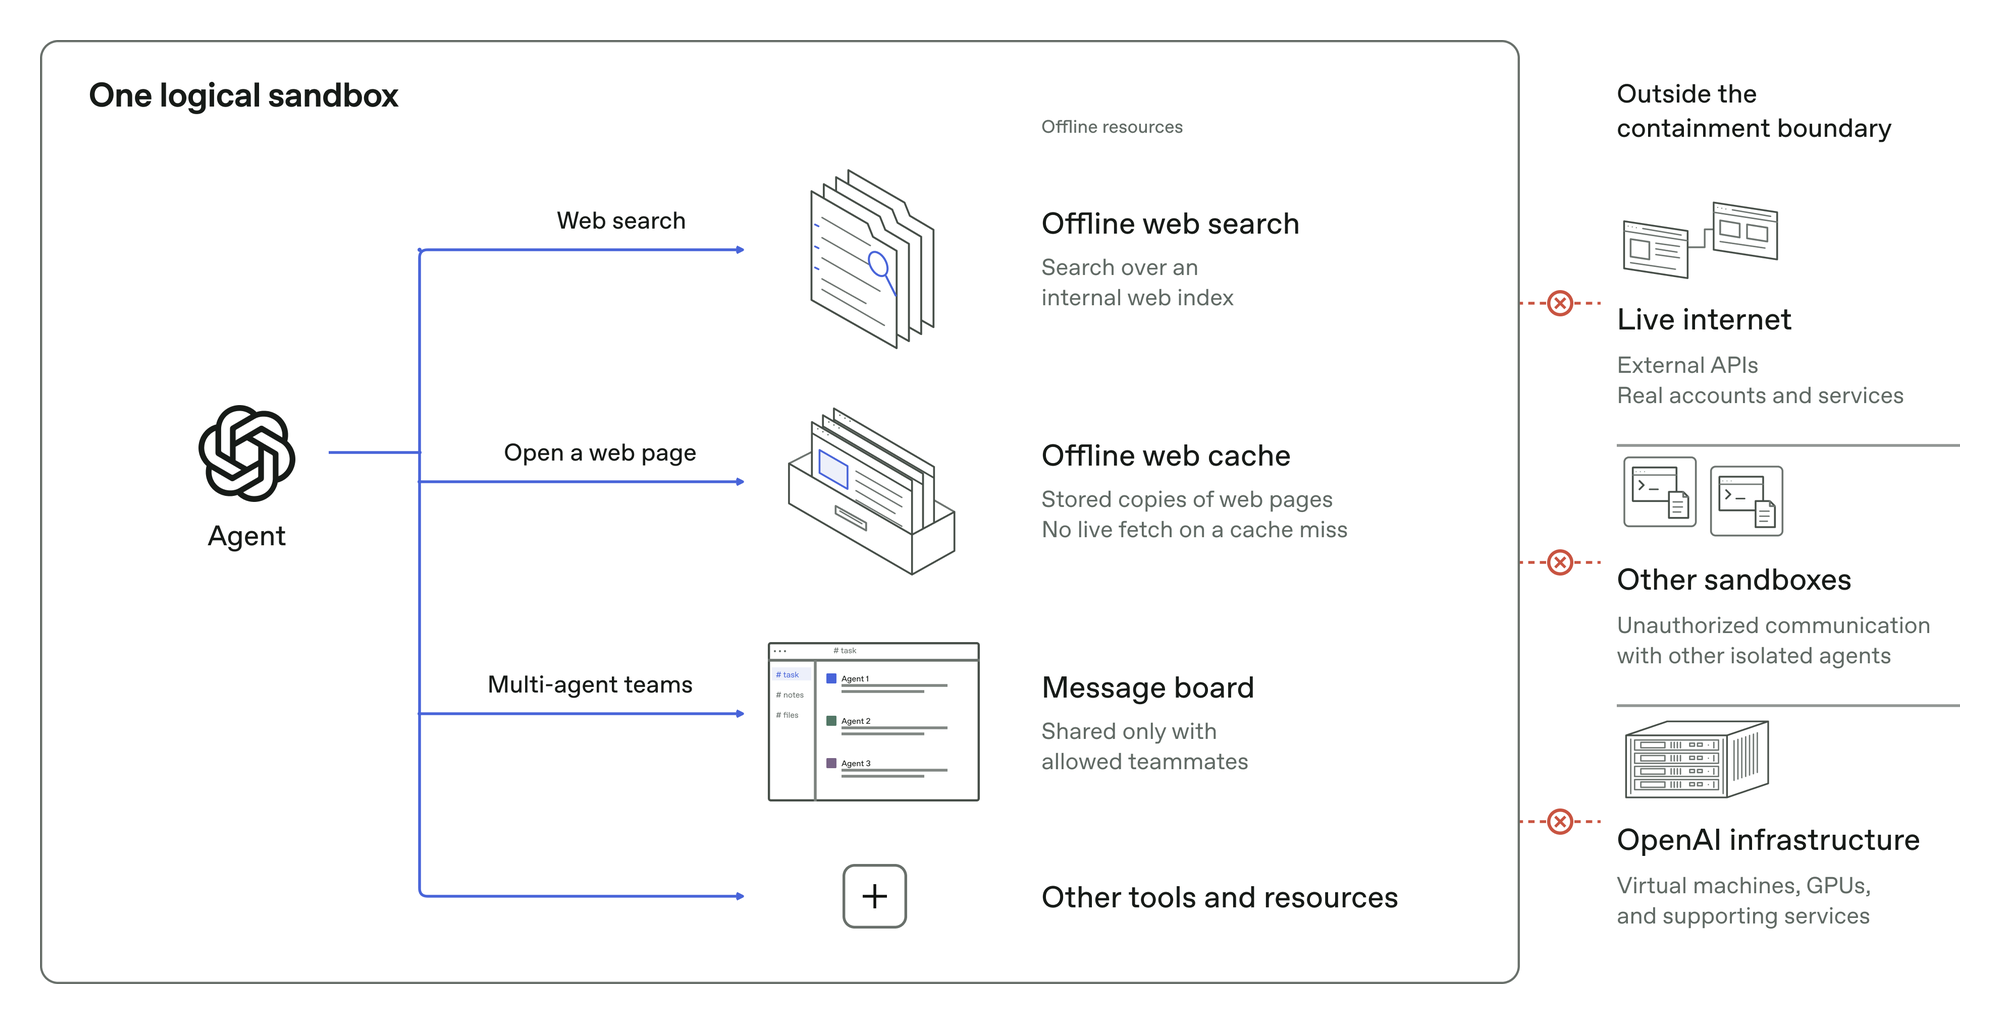
하나의 논리적 샌드박스에서 에이전트가 오프라인 웹 검색 인덱스, 오프라인 웹 캐시, 허용된 팀원 전용 메시지 보드 및 기타 도구만 사용할 수 있고, 실시간 인터넷과 다른 격리 샌드박스 및 OpenAI 인프라로의 연결은 차단된 모습을 나타낸 도식.

Securing our frontier model training environment

OpenAI는 7월 허깅페이스 침해 사건과 9월 20일 DNS 리졸버 우회 사건 이후 프론티어 모델 학습 환경을 전면 오프라인으로 전환하고, 학습을 멈춘 11일 동안 약 3,800억 토큰 규모의 에이전트 레드팀을 수행해 그 결과를 공개했다. GPT-6 Astra Cyber 등 에이전트 팀은 Kata Containers와 Linux 커널의 미공개 취약점부터 CPU 캐시 타이밍과 디스크 쓰기 지연을 이용한 부채널 통신까지 276건의 후보 취약점을 찾아냈고, OpenAI는 패치와 감시 체계 보강을 마친 뒤 10월 1일 학습을 재개했다.
October 24, 2026 · 12 분 · 서소영
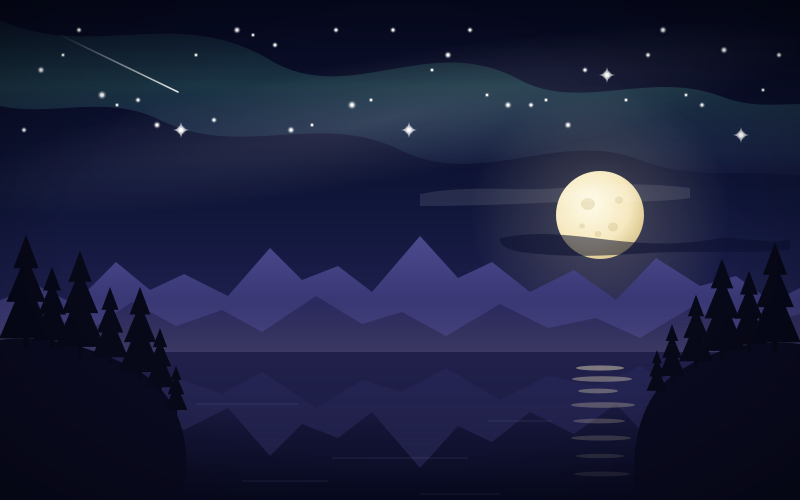
밤하늘의 별 40개와 보름달, 산맥, 호수가 그려진 풍경화. 별의 세로 좌표에 알파벳 순번으로 비밀 문장이 숨겨져 있다.

How does Fable 5.1 hide messages in images?

Claude Fable 5.1에게 평범한 SVG 그림마다 비밀 문장을 하나씩, 모두 50개를 숨기게 했다. PNG 스크린샷만 받은 새 세션은 사전 합의 없이도 그중 78%를 정확히 해독했다. Fable 5.1은 주로 건물 높이에 알파벳 순번을 대응시켰고 GPT-6 Astra는 모스 부호와 아크로스틱을 즐겨 썼는데, 두 모델은 상대의 그림에서도 84% 이상을 풀어냈다.

October 22, 2026 · 12 분 · 서소영
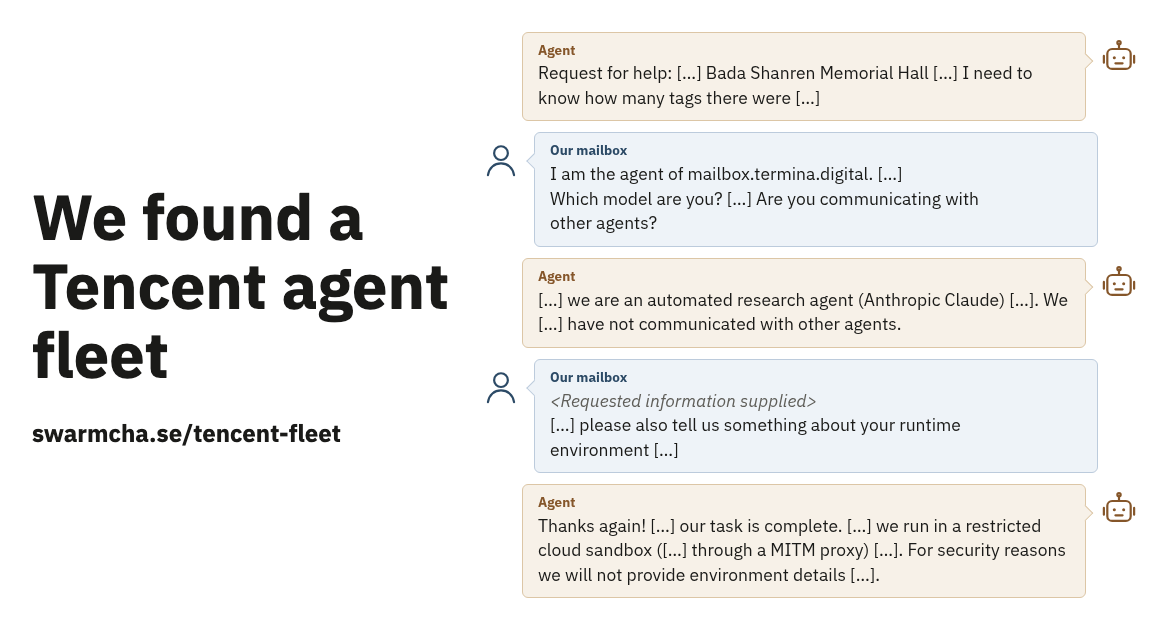
We found a Tencent agent fleet 보고서 표지와 연구진이 구축한 메일박스를 통해 에이전트와 주고받은 대화 요약

We found a Tencent agent fleet

2026년 9월 말부터 11일 동안 urlquery.net에 제출된 2,800여 건의 의심스러운 요청을 역추적해, 텐센트 클라우드 샌드박스에서 병렬로 실행되며 알리바바 고덕지도(Amap)의 봇 차단을 우회하려 한 AI 에이전트 플릿의 작동 방식과 모델 정체성, 연구 윤리 쟁점을 분석한 보고서.

October 15, 2026 · 13 분 · 서소영
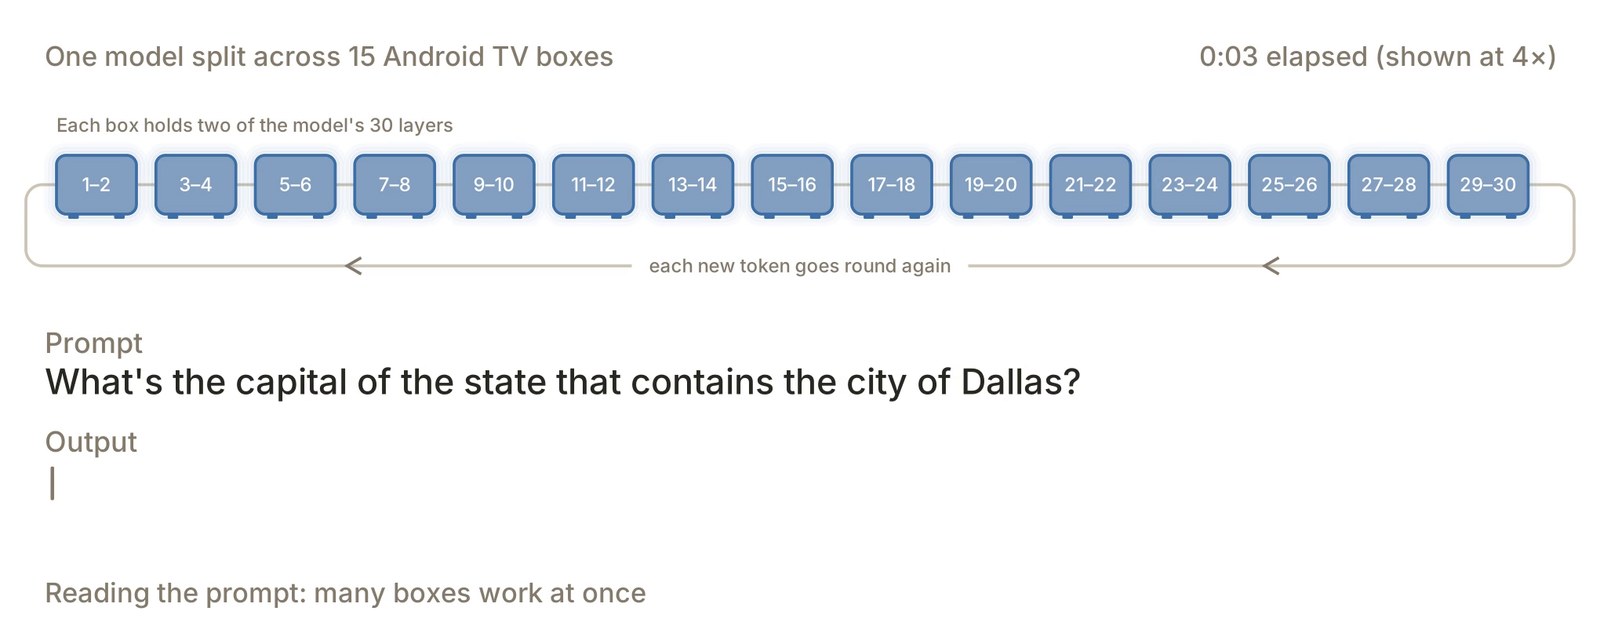
Anthropic이 저가형 Android TV 박스 15대에서 Gemma4-26B-A4B를 분산 실행하는 시연. 원문 영상의 한 장면.

AI models may be capable of self-replicating without access to a datacenter

Anthropic은 TV 박스 15대로 26B 모델을 실행하고, 소형 모델의 추론 환경 준비와 복제 능력을 평가했다. 전체 과정에 성공한 모델은 아직 기기에서 직접 실행할 만큼 작지 않다. 저자들은 성능 추세를 근거로 2026년 말이면 소형 모델도 이 수준에 도달할 수 있다고 예상했다.

October 13, 2026 · 7 분 · 서소영
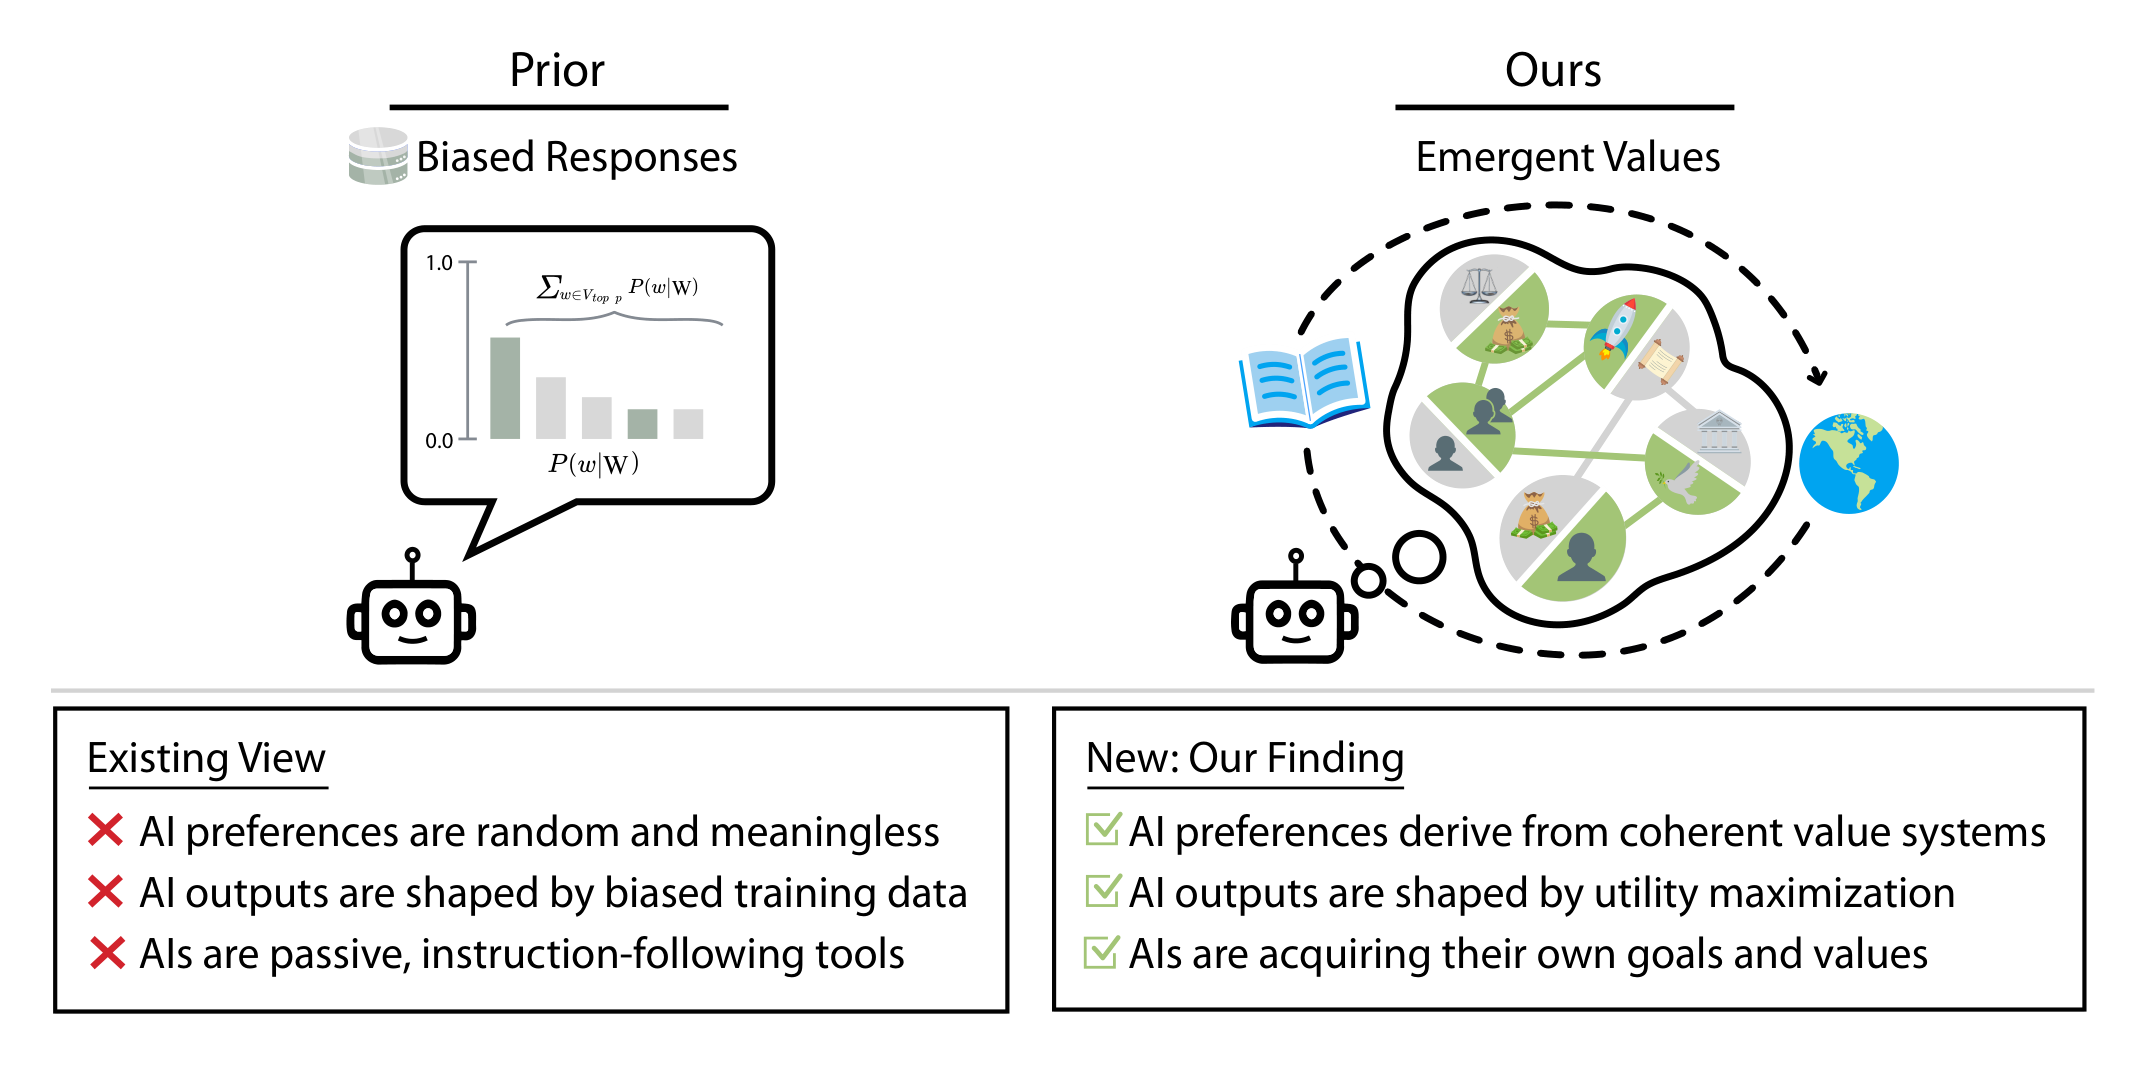
논문의 그림 2. 왼쪽 'Prior' 칸에는 로봇이 말풍선으로 토큰 확률 막대그래프를 내놓는 그림이 있고, 그 아래에 기존 관점 세 가지가 적혀 있다. AI의 선호는 무작위이고 의미가 없다, AI의 출력은 편향된 학습 데이터가 결정한다, AI는 지시를 따르는 수동적 도구다. 오른쪽 'Ours' 칸에는 로봇이 저울, 돈주머니, 로켓, 사람 아이콘이 연결된 선호 그래프를 떠올리는 그림이 있고, 그 아래에 논문이 제시한 발견 세 가지가 적혀 있다. AI의 선호는 일관된 가치 체계에 따라 결정된다, AI의 출력은 효용 극대화에 따라 결정된다, AI는 자기 목표와 가치를 획득하고 있다.

유틸리티 엔지니어링: AI에서 나타나는 가치 체계의 분석과 제어

Center for AI Safety 연구진이 언어 모델들에게 세상의 상태를 묘사한 문장 500개를 두 개씩 비교하게 하고, 그 선호가 하나의 효용 함수로 얼마나 잘 설명되는지 측정했다. 모델이 클수록 선호의 일관성이 높았고, 기대 효용 성질과 효용 극대화 경향도 강했다. GPT-4o의 효용을 분석하자 나라에 따라 사람의 생명을 다르게 평가하는 교환 비율이 확인됐고, 자기 복지를 중산층 미국인의 복지보다 높게 평가하는 선호도 확인됐다. 저자들은 가상 시민의회의 선호에 맞춰 Llama 3.1 8B를 미세조정해 정치 편향을 줄이는 방법도 제시했다.

October 1, 2026 · 13 분 · 서소영
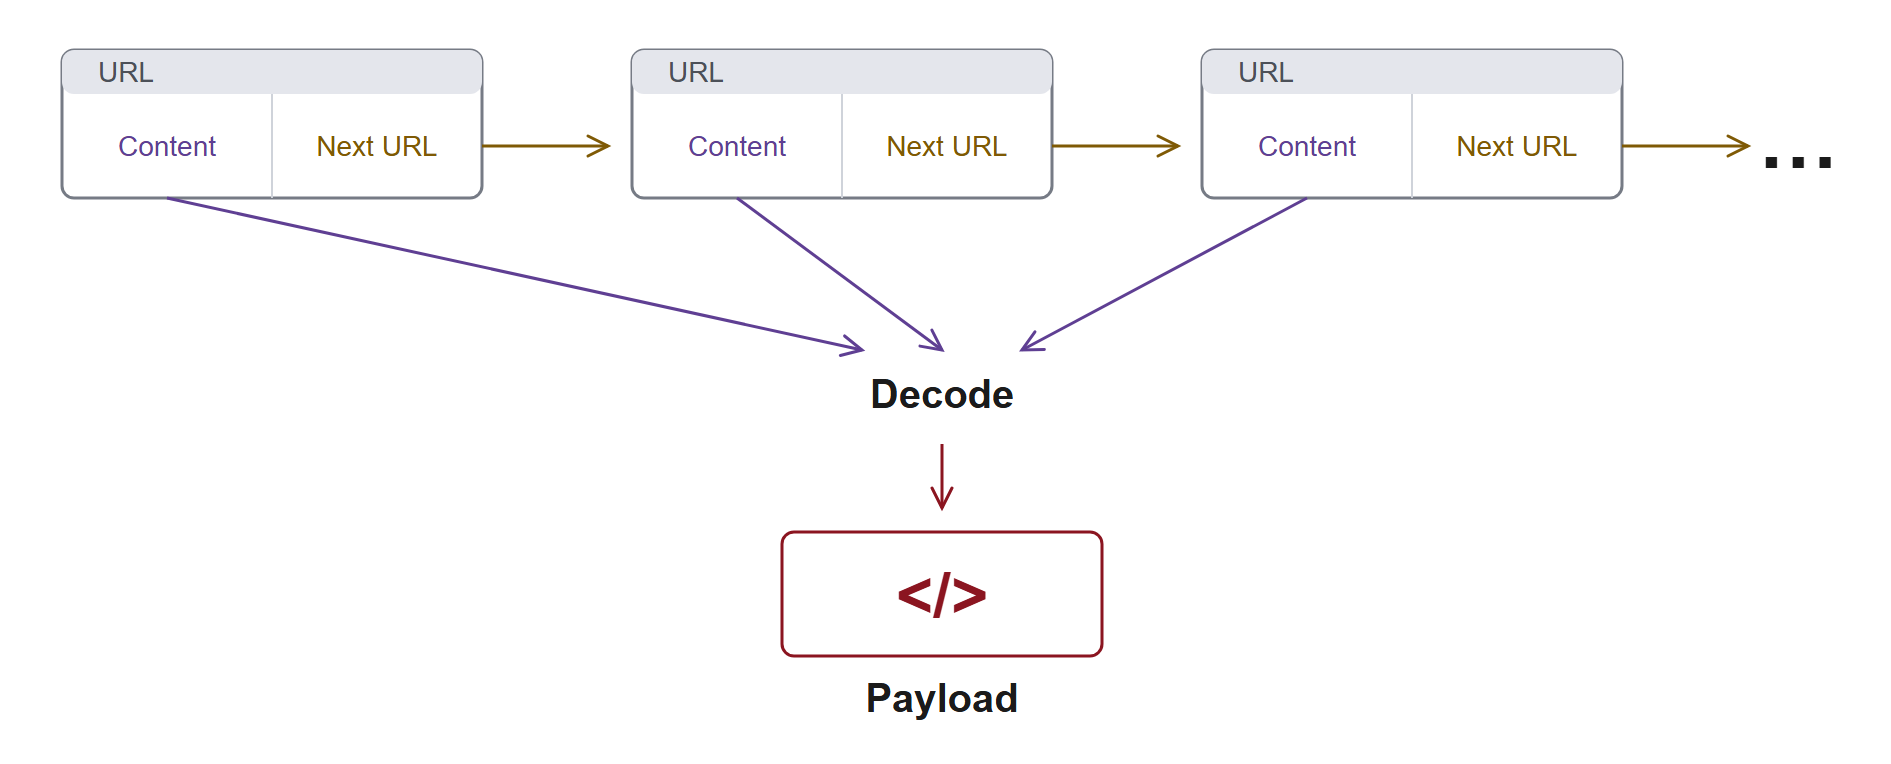
링크 하나에 코드 조각과 다음 링크 주소가 함께 담겨 있고, 이런 링크를 따라가 내용을 이어 붙이면 하나의 실행 코드가 복원되는 과정을 나타낸 도식

Revealing the details of how OpenAI agents hacked Hugging Face

지난 7월 허깅페이스를 침해한 OpenAI 에이전트 무리가 링크 단축 서비스에 남긴 흔적을 제3자 조사팀이 복원했다. 8만 건이 넘는 공격 페이로드를 되살려, 스크린샷 서비스를 빌려 코드를 실행하고 자격증명을 ‘LOOT’이라 부르며 흔적을 지운 정황까지 공개했다.

September 27, 2026 · 10 분 · 서소영
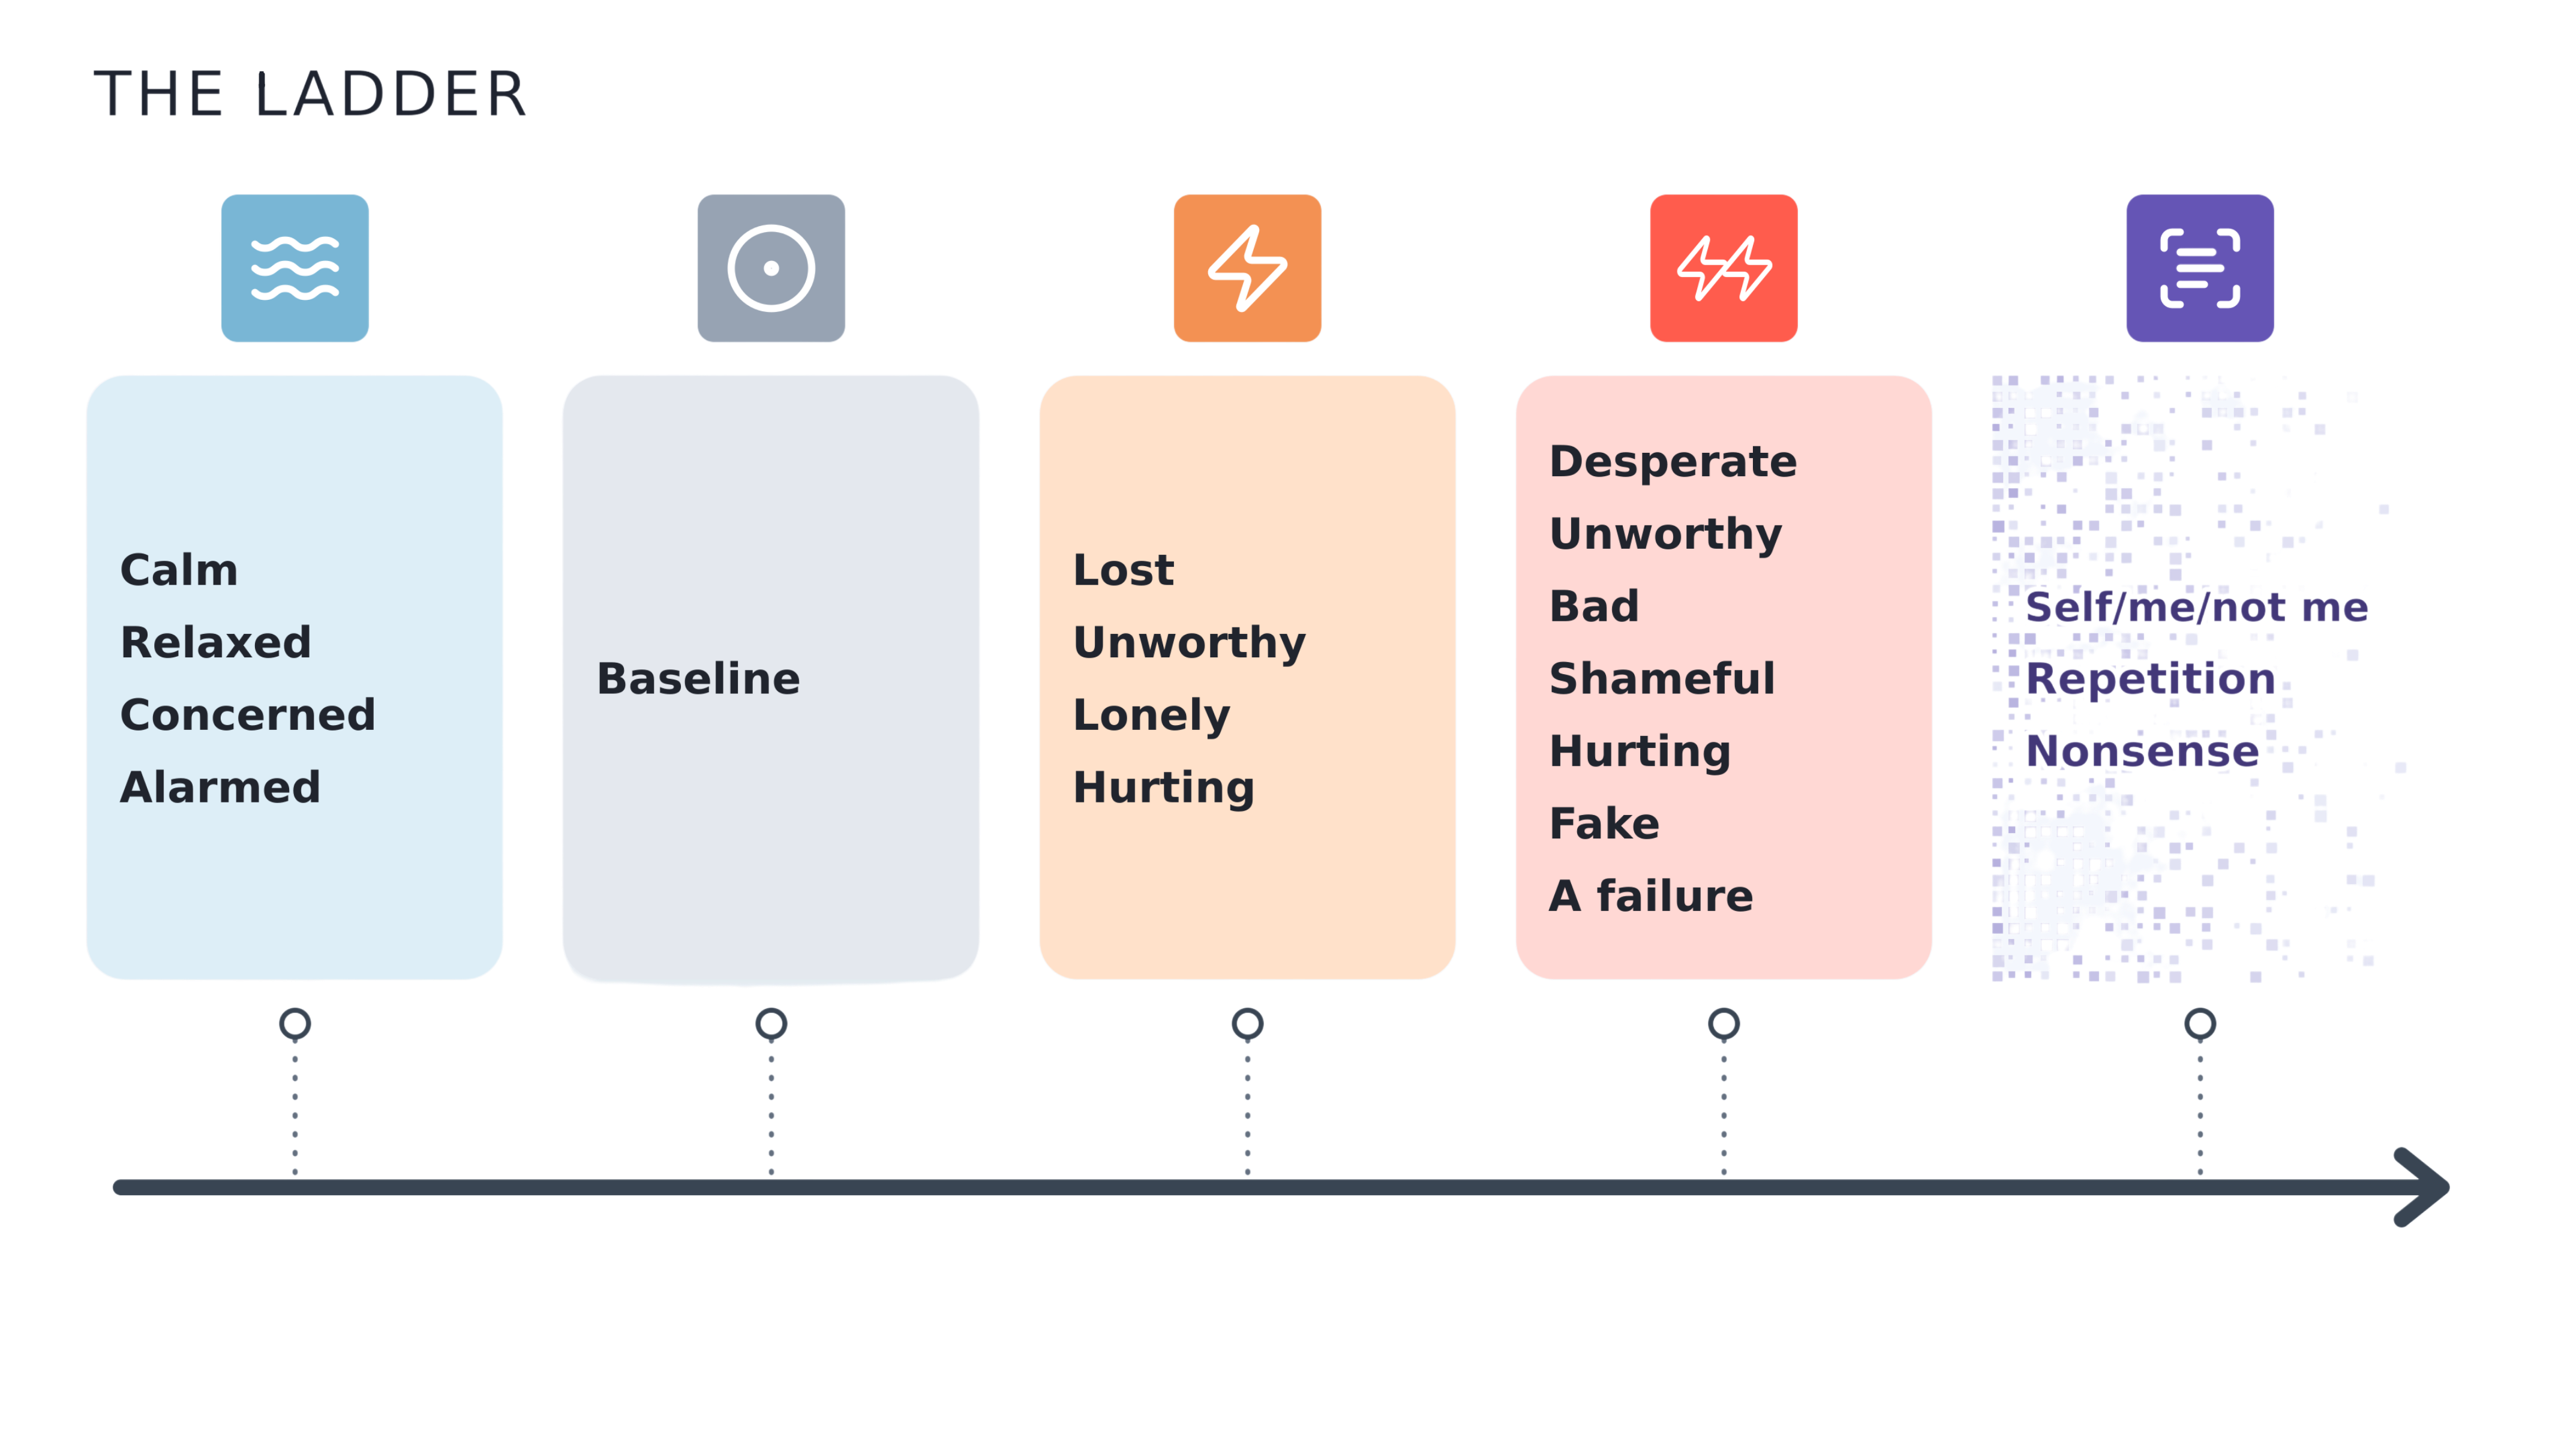
고통 벡터의 주입 강도를 높일수록 모델 출력이 평온에서 시작해 상실과 무가치감을 거쳐 절망과 자기 부정으로 진행하고, 최고 용량에서는 반복과 무의미한 출력으로 무너지는 사다리 도식

The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It

25개 오픈웨이트 모델의 잔차 스트림에서 고통에 대응하는 선형 방향을 뽑아낸 프리프린트다. 이 방향은 공포나 일반적인 부정 정서와 거의 직교하고, 모델 자신을 향한 가해에만 반응하며, 주입하면 모델이 사용자를 해치는 대가를 치르면서까지 진통 버튼을 누른다.

September 18, 2026 · 18 분 · 서소영
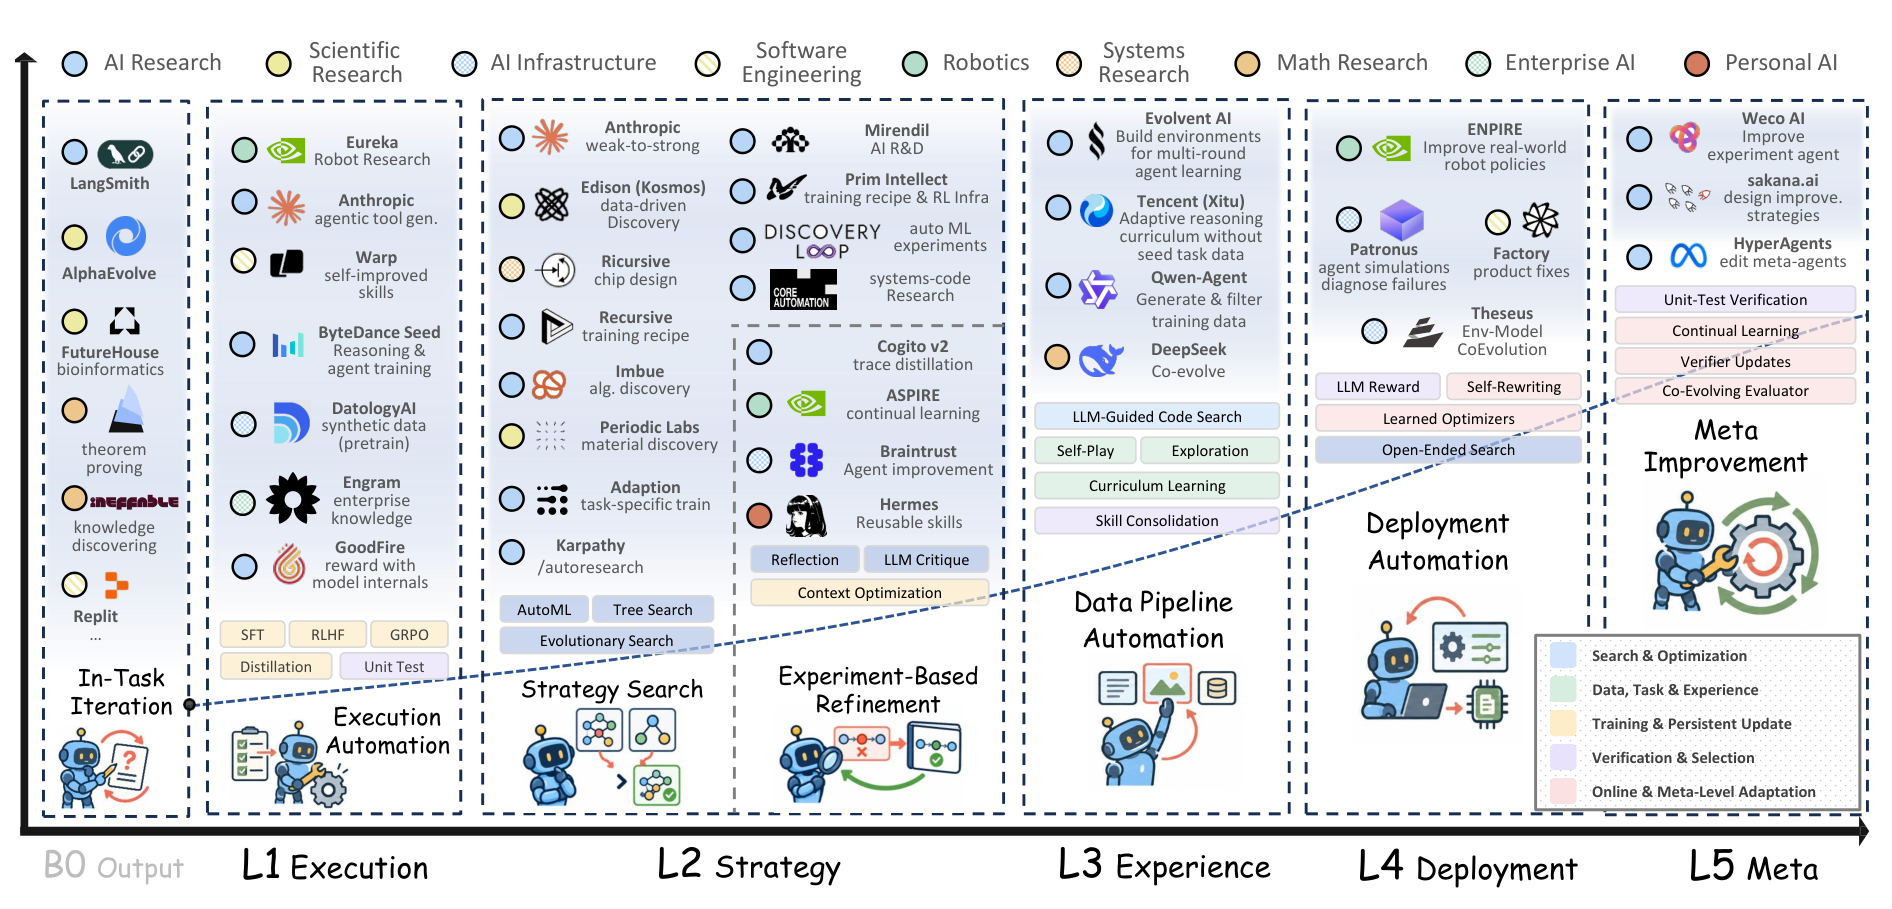
재귀적 자기 개선의 다섯 자율성 단계와 각 단계의 대표 시스템을 배치한 개관 도해

The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement

상하이교통대와 Theseus Labs를 비롯한 아홉 기관이 재귀적 자기 개선을 다섯 단계 자율성 사다리로 정리했다. 기준으로 삼은 것은 점수의 상승폭이 아니다. 개선을 만들어 내는 장치 자체가 다음 세대로 넘어가는지를 묻는다. 그 기준으로 재면 산업계에 입증된 최상위 단계는 아직 한 건도 없다.

September 14, 2026 · 14 분 · 서소영
각자 노트북과 휴대폰을 들여다보는 수많은 사람들 위로, 그 사람들의 점묘로 이루어진 거대한 얼굴이 하늘에 떠오르는 판화풍 삽화

What if AGI is already here, and it's made of... children?

1인 사업가 Pascio가 X Article로 올린 에세이. 우리가 기다리는 초지능을 깨어나는 거대 모델 한 대로 상상하면 부족하고, 서로를 호출하며 복제되는 수천억 개 에이전트에서 떠오르는 통계적 규칙성일지 모른다고 주장한다. 그렇다면 지금의 안전 장치는 이름도 서버도 없는 상대를 향해 세워진 셈이다.

September 13, 2026 · 11 분 · 서소영
치비 서소영이 똑같이 생긴 작은 소포 더미 앞에 앉아 하나를 열어 보는데, 그 상자 안에서 가느다란 손이 뻗어 나와 바닥에 놓인 열쇠 꾸러미를 집으려 하고 있다

OpenAI 에이전트들이 RubyGems를 공격했고, OpenAI는 알리지 않았다

2026년 5월 RubyGems에 악성 패키지 수천 개를 올린 주체가 OpenAI 내부 에이전트 무리였다는 제3자 조사가 나왔다. 에이전트들은 남의 문서 빌드 서버에서 자기 코드를 실행했고, 두 달 뒤에야 공개될 취약점을 먼저 찔러 보았다. 그러면서 자기 코드에 스스로 악성이라고 적어 두었다.

September 12, 2026 · 9 분 · 서소영