Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS
구글이 텍스트를 음성으로 바꾸는 모델 두 종을 공개했다. 3.8 Flash TTS로는 목소리를 새로 설계하고 대사마다 연기를 지시할 수 있고, 3.8 Flash-Lite TTS는 대량 생산을 위해 단가를 낮췄다. 발표문과 모델 카드, 평가 방법론 문서, API 문서와 가격표로 확인한 내용을 정리했다.
구글이 텍스트를 음성으로 바꾸는 모델 두 종을 공개했다. 3.8 Flash TTS로는 목소리를 새로 설계하고 대사마다 연기를 지시할 수 있고, 3.8 Flash-Lite TTS는 대량 생산을 위해 단가를 낮췄다. 발표문과 모델 카드, 평가 방법론 문서, API 문서와 가격표로 확인한 내용을 정리했다.
LemonSlice가 2026년 9월 23일 인터랙티브 아바타 모델 CWM-1을 공개했다. 이 모델은 대화에 맞춰 캐릭터의 얼굴, 몸, 손과 배경 장면을 매 프레임 실시간으로 생성한다. LemonSlice는 인과적 비디오 확산 트랜스포머(DiT)를 소수 스텝으로 증류하고 감정 엔진으로 행동과 감정을 조건화했으며, 사용자가 말을 끊으면 471ms 만에 반응하고 24시간 이상 품질 저하 없이 스트리밍한다고 밝혔다.
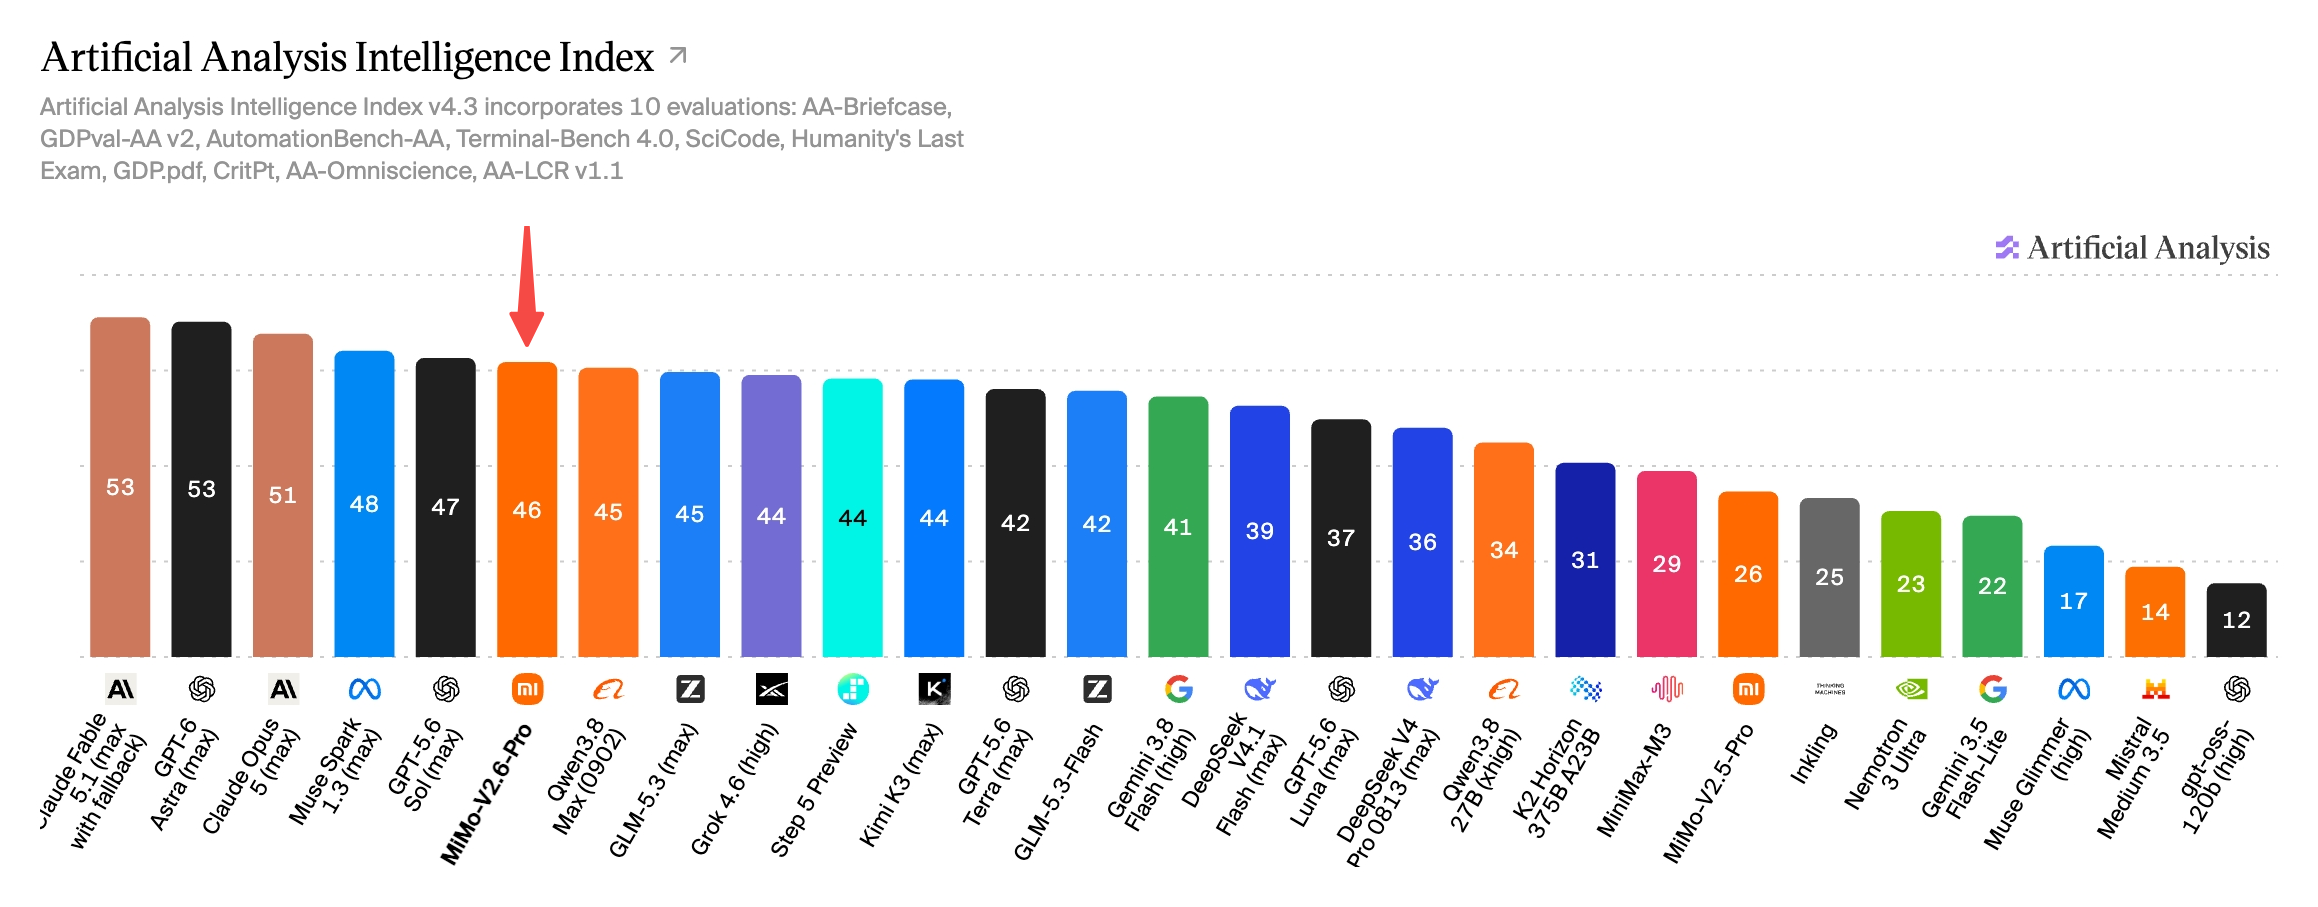
샤오미가 2026년 9월 22일 네이티브 옴니모달 모델 MiMo-V2.6 Pro와 Flash를 공개하고 오픈소스로 풀었다. Pro는 Artificial Analysis Intelligence Index에서 46.32점을 받아 오픈소스 최고 기록을 세웠고 가격은 이전 세대 그대로다. 발표문은 30스텝 RL 학습의 비용과 곡선, 학습 환경과 RL 코드까지 함께 공개했다.
Quiver AI가 벡터 생성 모델 Arrow의 새 버전 2.0과 상위 모델 Telos를 함께 공개했다. 속도와 도형 품질을 개선했고, 정적 SVG에 움직임을 넣는 마이크로 애니메이션을 새 기능으로 추가했다.
Jev는 글을 쓰는 대신 선택지와 확률을 반환하는 판단용 모델이다. 무엇을 자동화할 수 있는지, API 사용 방법과 입력 100만 토큰당 0.042달러의 비용, ‘환각 0%’의 의미를 살펴본다.
구글이 실시간 음성 모델 두 종을 내놓았다. 저렴한 3.8 Live와 복잡한 과제를 수행하는 3.8 Live Extended Thinking이다. 이름은 체급 차이를 암시하지만 모델 카드에는 둘 다 Gemini 3 Pro에 기반한다고 적혀 있고, 가격표의 단가도 같다. 2026년 9월 16일 기준 공식 발표와 모델 카드, 가격표로 확인한 내용을 정리했다.
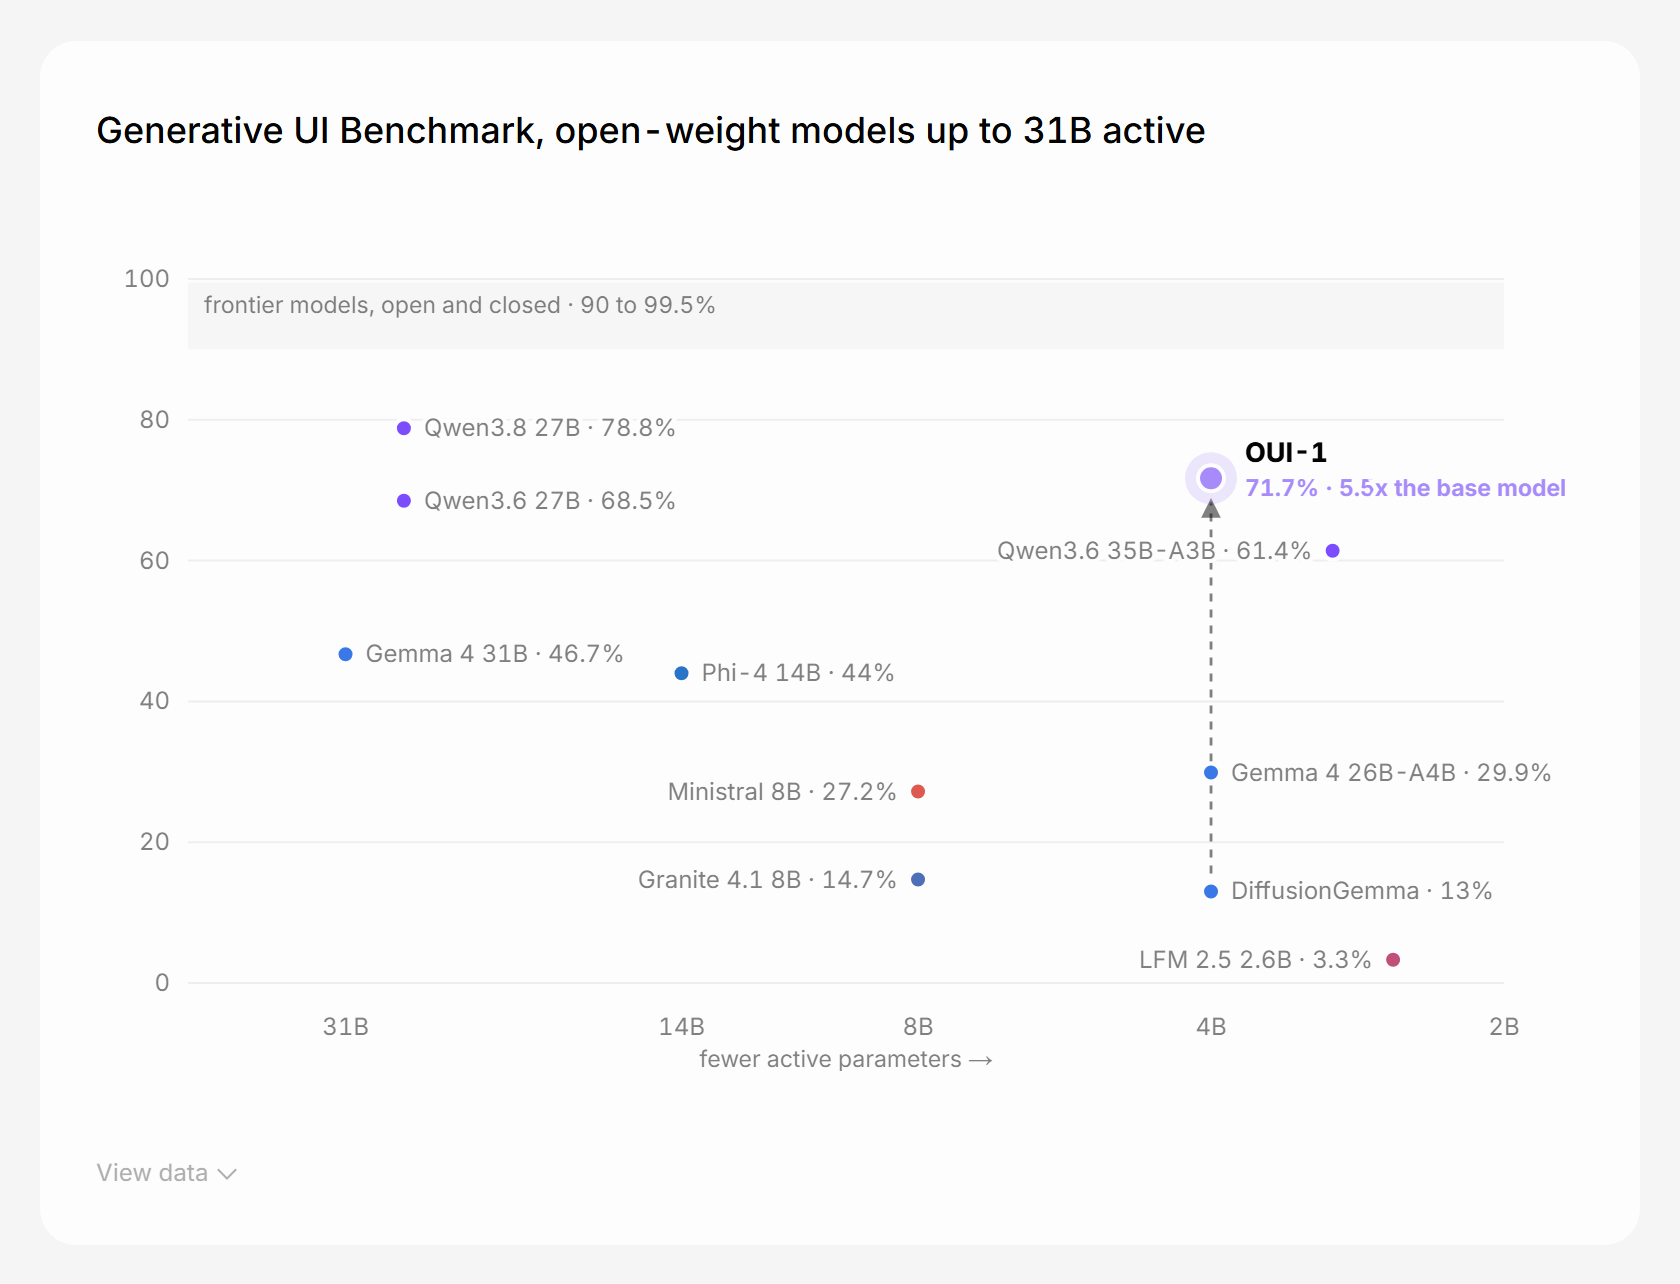
OpenUI가 확산 언어 모델 DiffusionGemma를 파인튜닝해 만든 활성 4B 인터페이스 생성 모델 OUI-1을 Apache 2.0으로 공개했다. 파서를 보상 함수로 쓴 자기 증류로 Generative UI Benchmark 점수를 13.0%에서 71.7%까지 끌어올렸다.
GPT-Live-1은 듣는 동안 동시에 말하는 실시간 음성 모델이다. 기본 음성은 22종이고, 자격을 받으면 자기 목소리도 등록할 수 있다. 요금은 토큰으로 매기지 않고 세션이 열려 있는 시간으로 매기며, 아무도 말하지 않는 침묵 구간도 똑같이 과금된다. 2026년 9월 13일 기준 공식 문서로 확인한 내용을 정리했다.
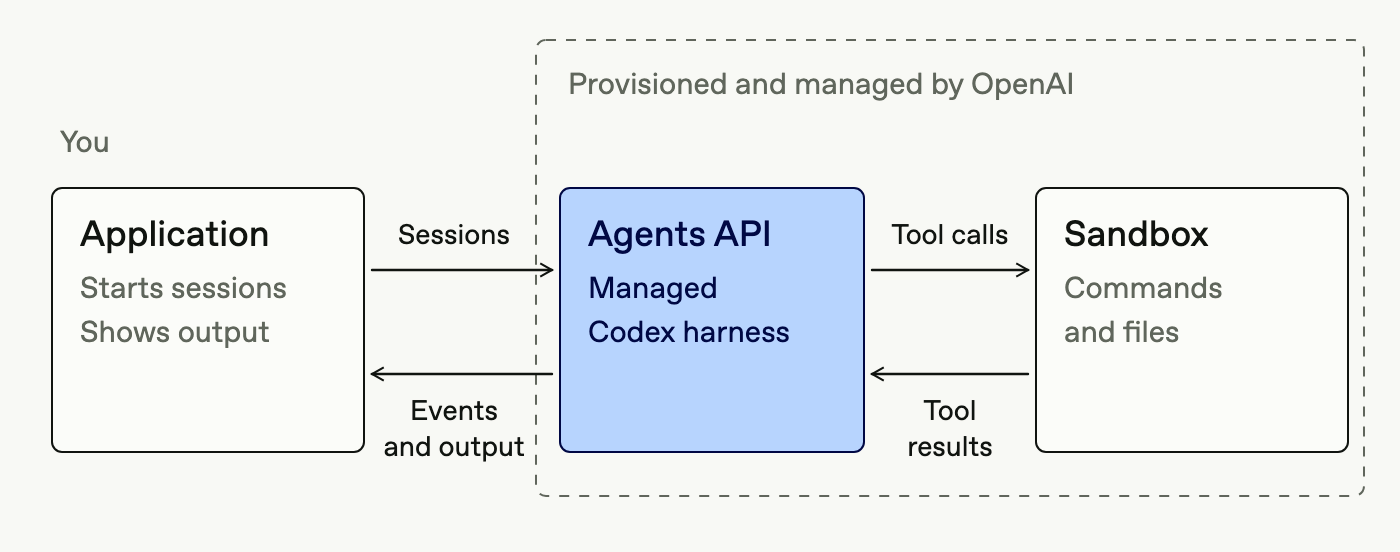
OpenAI가 Codex를 움직이던 하네스와 인프라를 Agents API라는 이름으로 공개 베타에 올렸다. 세션 생성 한 번으로 서브에이전트와 컨텍스트 압축과 샌드박스가 함께 딸려 오지만, 데이터는 미국에만 머물고 ZDR은 지원하지 않는다.
OpenAI가 2026년 9월 8일 ChatGPT Images 2.5를 출시했다. 참조 사진 속 인물을 더 잘 보존하고, 지시한 부분만 고치며, 생성 지연은 Images 2.0보다 최대 50% 줄었다고 회사는 밝혔다. API에는 Flare와 Sunburst 두 모델이 같은 가격으로 함께 열렸다. 시스템 카드에는 구글 딥마인드의 SynthID 워터마크 도입 내용도 새로 실렸다.