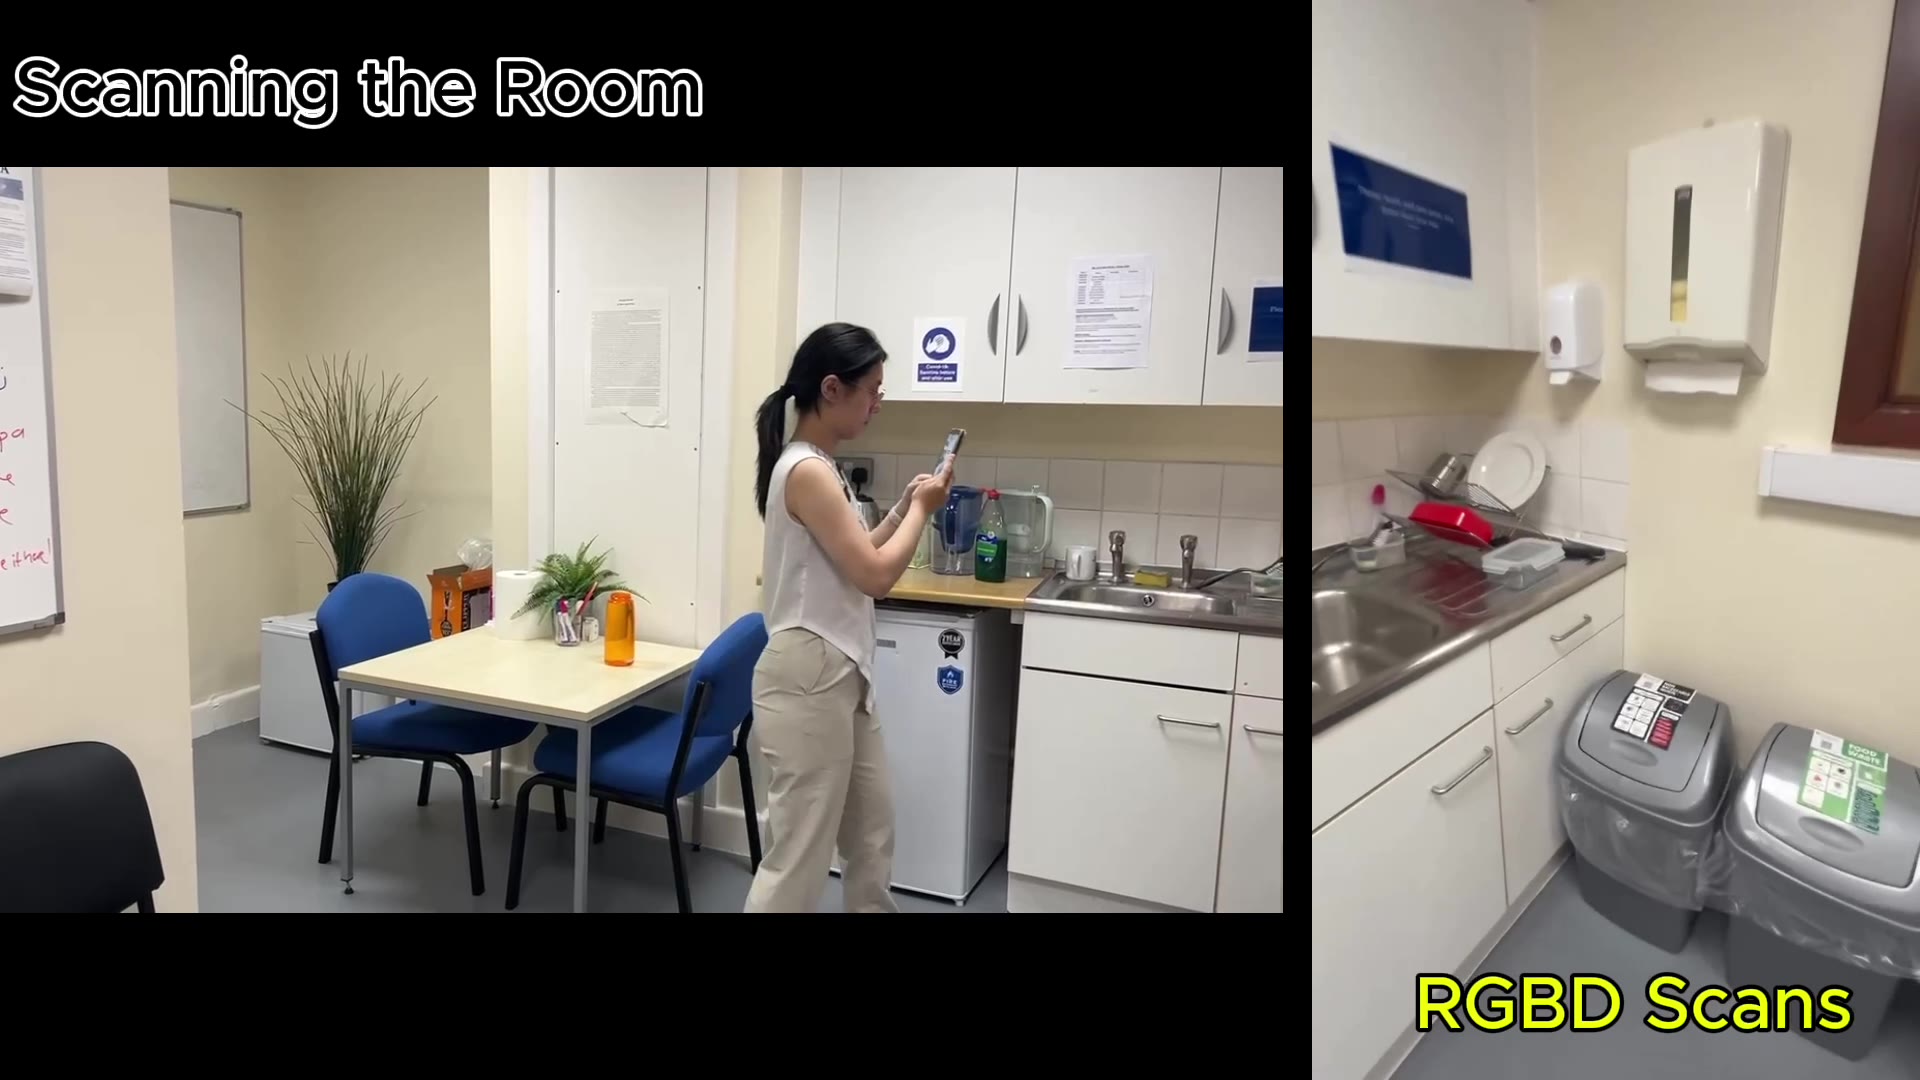
LiteReality-Agent: 상호작용 가능한 3D 실내 씬 재구성 에이전트
아이폰 LiDAR 스캔 한 번을 편집 가능한 3D 실내 씬으로 바꾸는 오픈소스 에이전트 시스템. 씬 전체를 하나의 파이썬 프로그램으로 두고, 에이전트가 raw 메시가 아니라 코드를 고쳐 가며 실제 촬영본에 맞춰 나간다.
아이폰 LiDAR 스캔 한 번을 편집 가능한 3D 실내 씬으로 바꾸는 오픈소스 에이전트 시스템. 씬 전체를 하나의 파이썬 프로그램으로 두고, 에이전트가 raw 메시가 아니라 코드를 고쳐 가며 실제 촬영본에 맞춰 나간다.
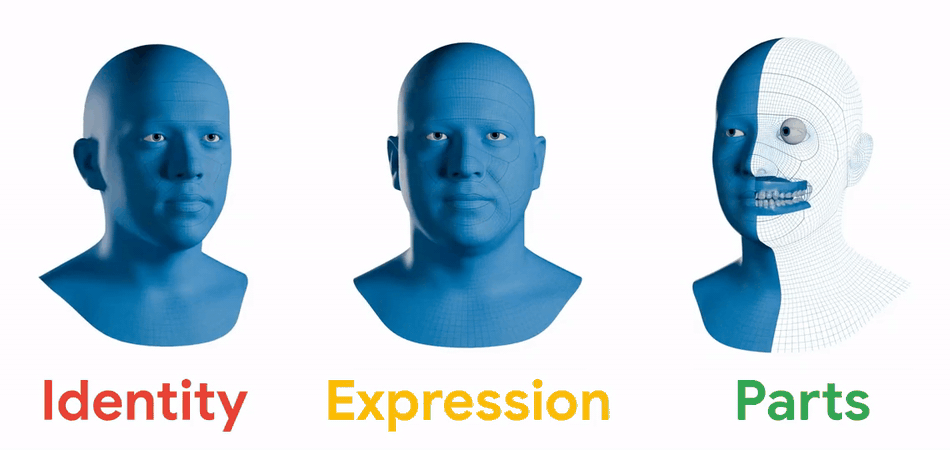
구글이 공개한 3D 통계 인체 모델 생태계 GNM. 첫 릴리스인 GNM Head는 3D 스캔 데이터로 학습한 고정밀 얼굴·머리 파라메트릭 모델로, 정체성·표정·포즈를 분리 제어하고 눈·치아·혀 같은 내부 구조까지 다룬다.
눈길을 끄는 이미지를 예측하고 만드는 연구는 한 덩어리처럼 보이지만 시선과 기억, 미감, 클릭 네 갈래로 갈라져 있다. 그중 예쁨과 클릭은 산업 데이터가 이미 갈라놓은 서로 다른 목적함수다.
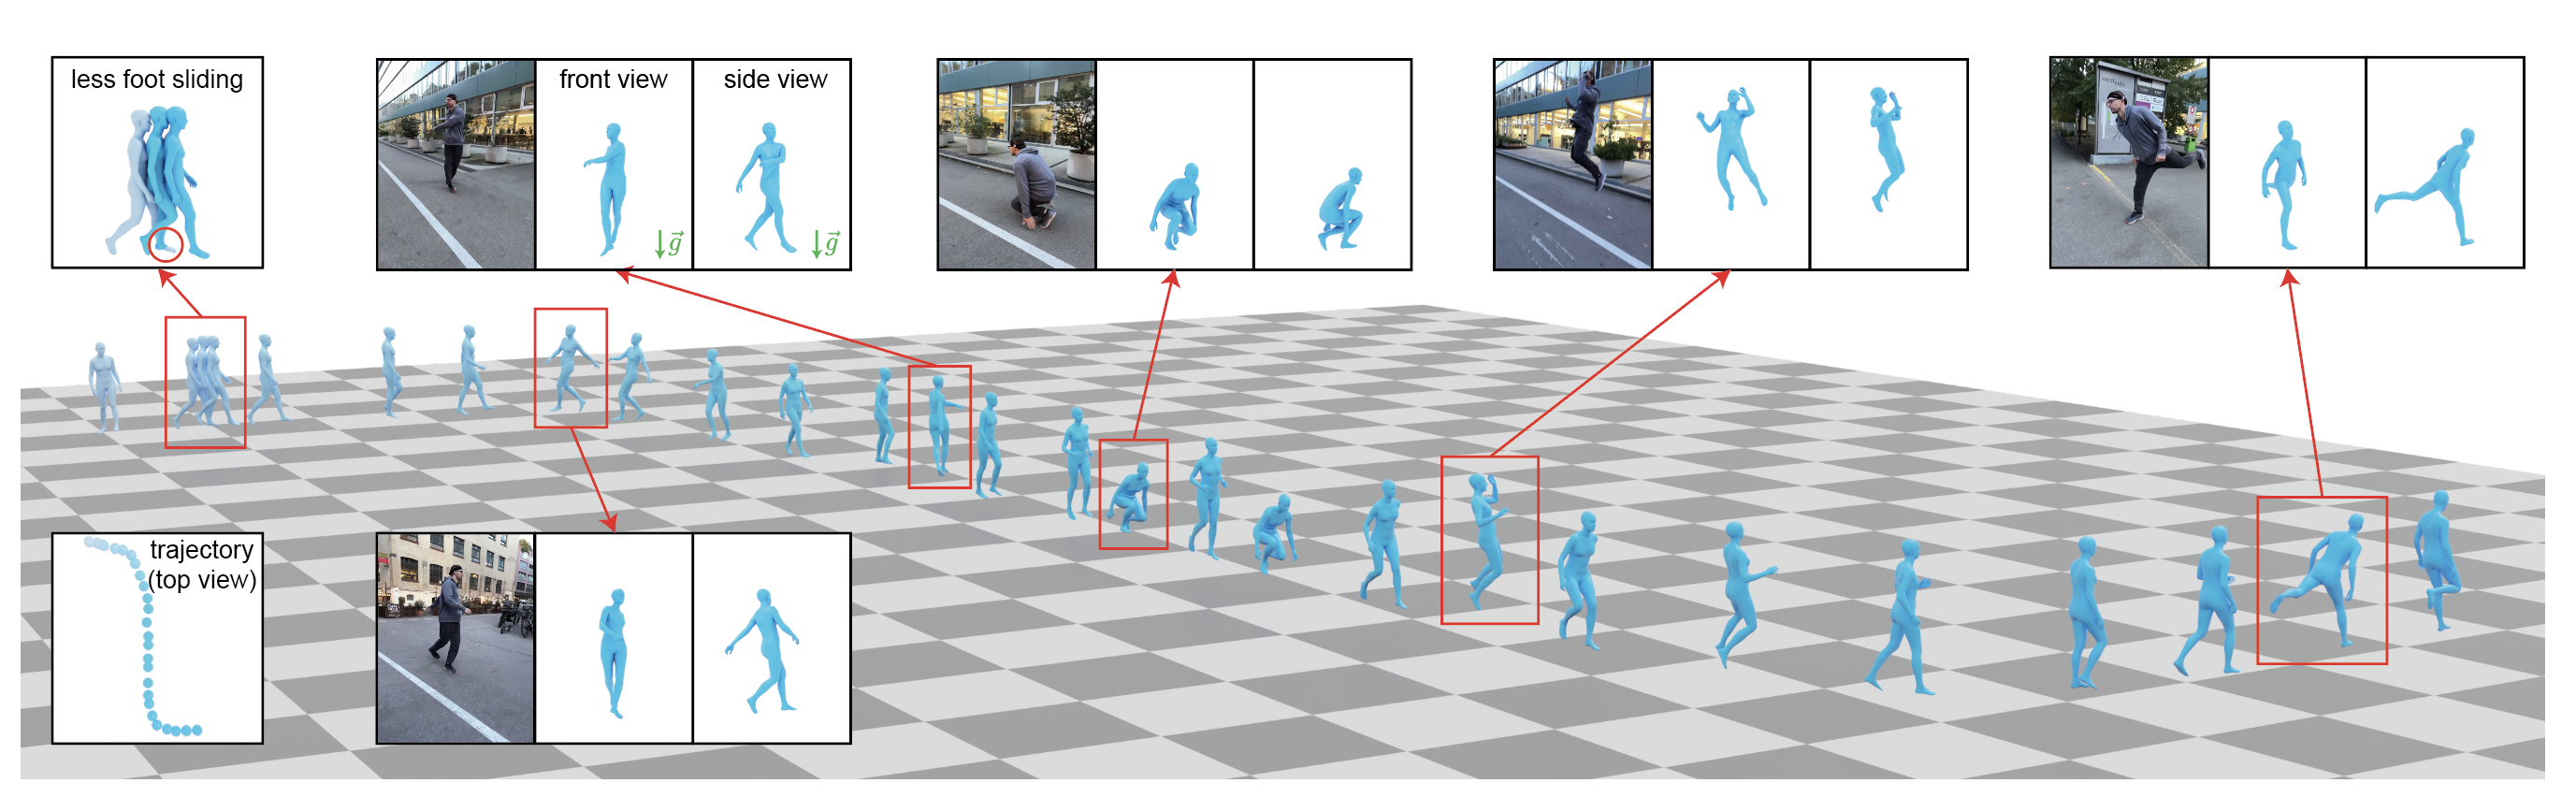
Shen 외(Zhejiang Univ., SIGGRAPH Asia 2024)가 단안 비디오에서 세계 좌표계 기반 인간 동작을 복원하는 방법을 제시한다. 각 프레임마다 중력 방향과 카메라 시선으로 유일하게 정의되는 Gravity-View 좌표계에서 자세를 예측해 자기회귀 오차 누적을 없애고, RoPE 트랜스포머로 45초짜리 1430프레임 시퀀스를 0.28초에 처리한다. RICH·EMDB 벤치마크에서 세계 좌표 W-MPJPE를 WHAM 대비 31% 낮췄다.
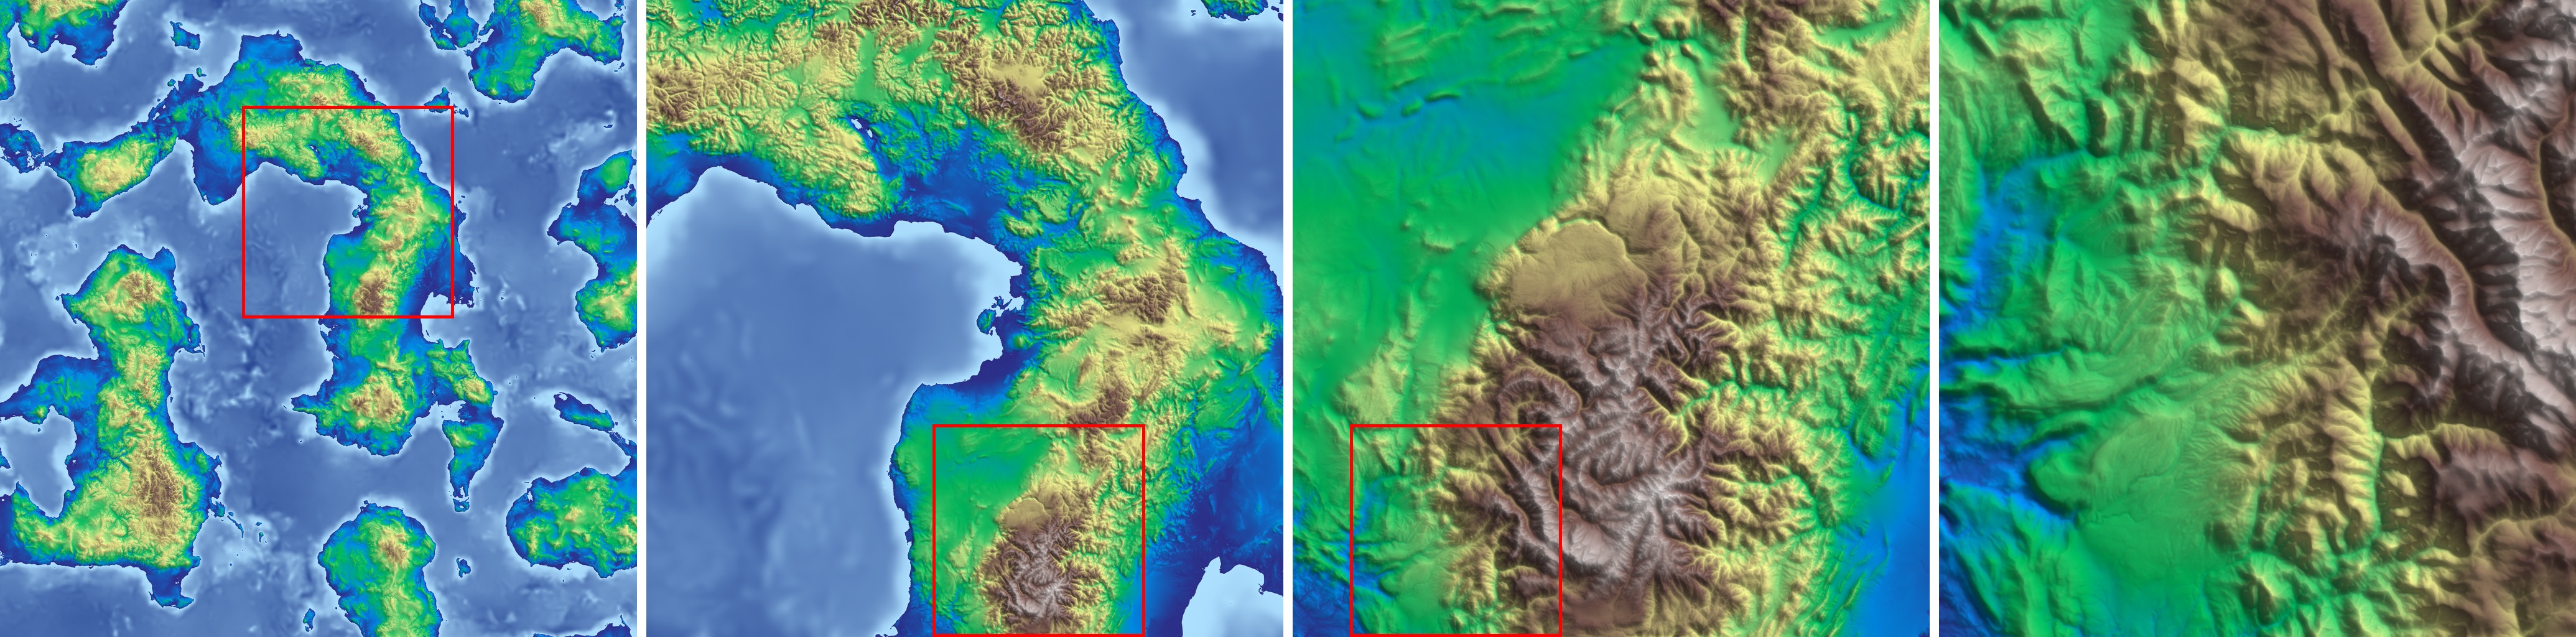
Alexander Goslin이 SIGGRAPH 2026에 발표한 InfiniteDiffusion과 Terrain Diffusion. diffusion 모델을 학습 없이 무한하고 결정적이며 O(1) random access가 가능한 형태로 재구성하고, 그 위에서 지구 규모 지형을 consumer GPU로 실시간 생성한다.
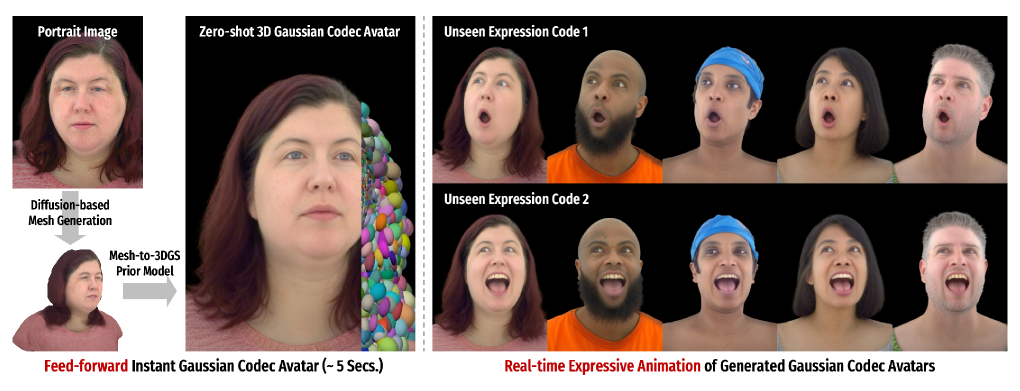
Meta와 POSTECH이 인물 사진 한 장에서 5초 안에 실시간 구동 가능한 3D 가우시안 코덱 아바타를 만들었다. Sapiens 파운데이션 모델, UV 공간 디퓨전, 피드포워드 정제망, 보편 사전 모델을 차례로 잇는 완전한 피드포워드 파이프라인이다.
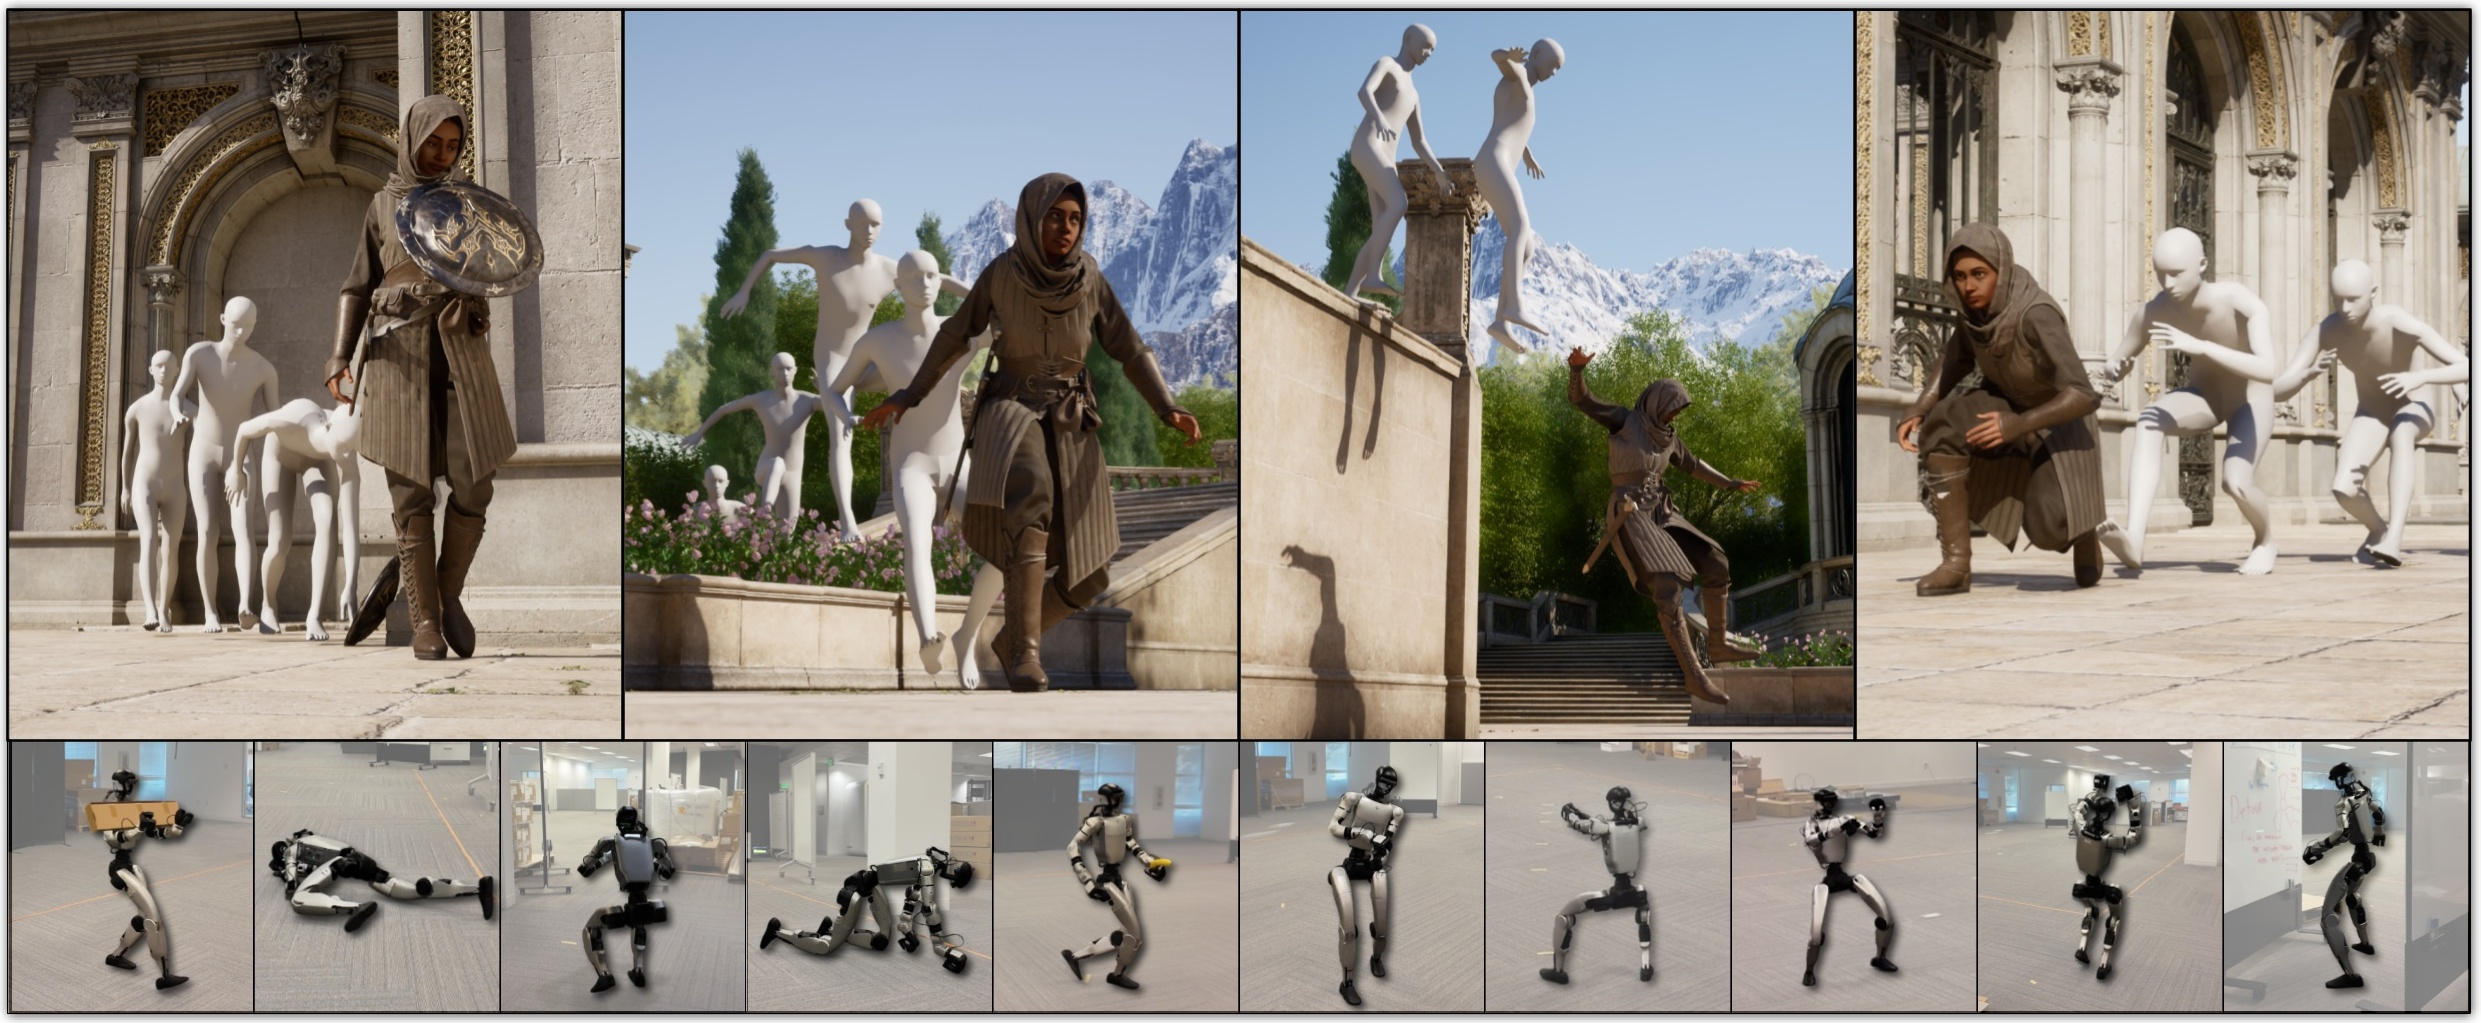
NVIDIA가 SIGGRAPH 2026 / ACM TOG에 발표한 실시간 모션 생성 프레임워크. 35만+ 모션 클립을 단일 신경 backbone으로 학습해 2ms 지연·15,000 FPS로 생성한다. UE5 게임 캐릭터와 Unitree G1 휴머노이드 로봇이 같은 모델 위에서 움직이는 것이 핵심 시연이다.
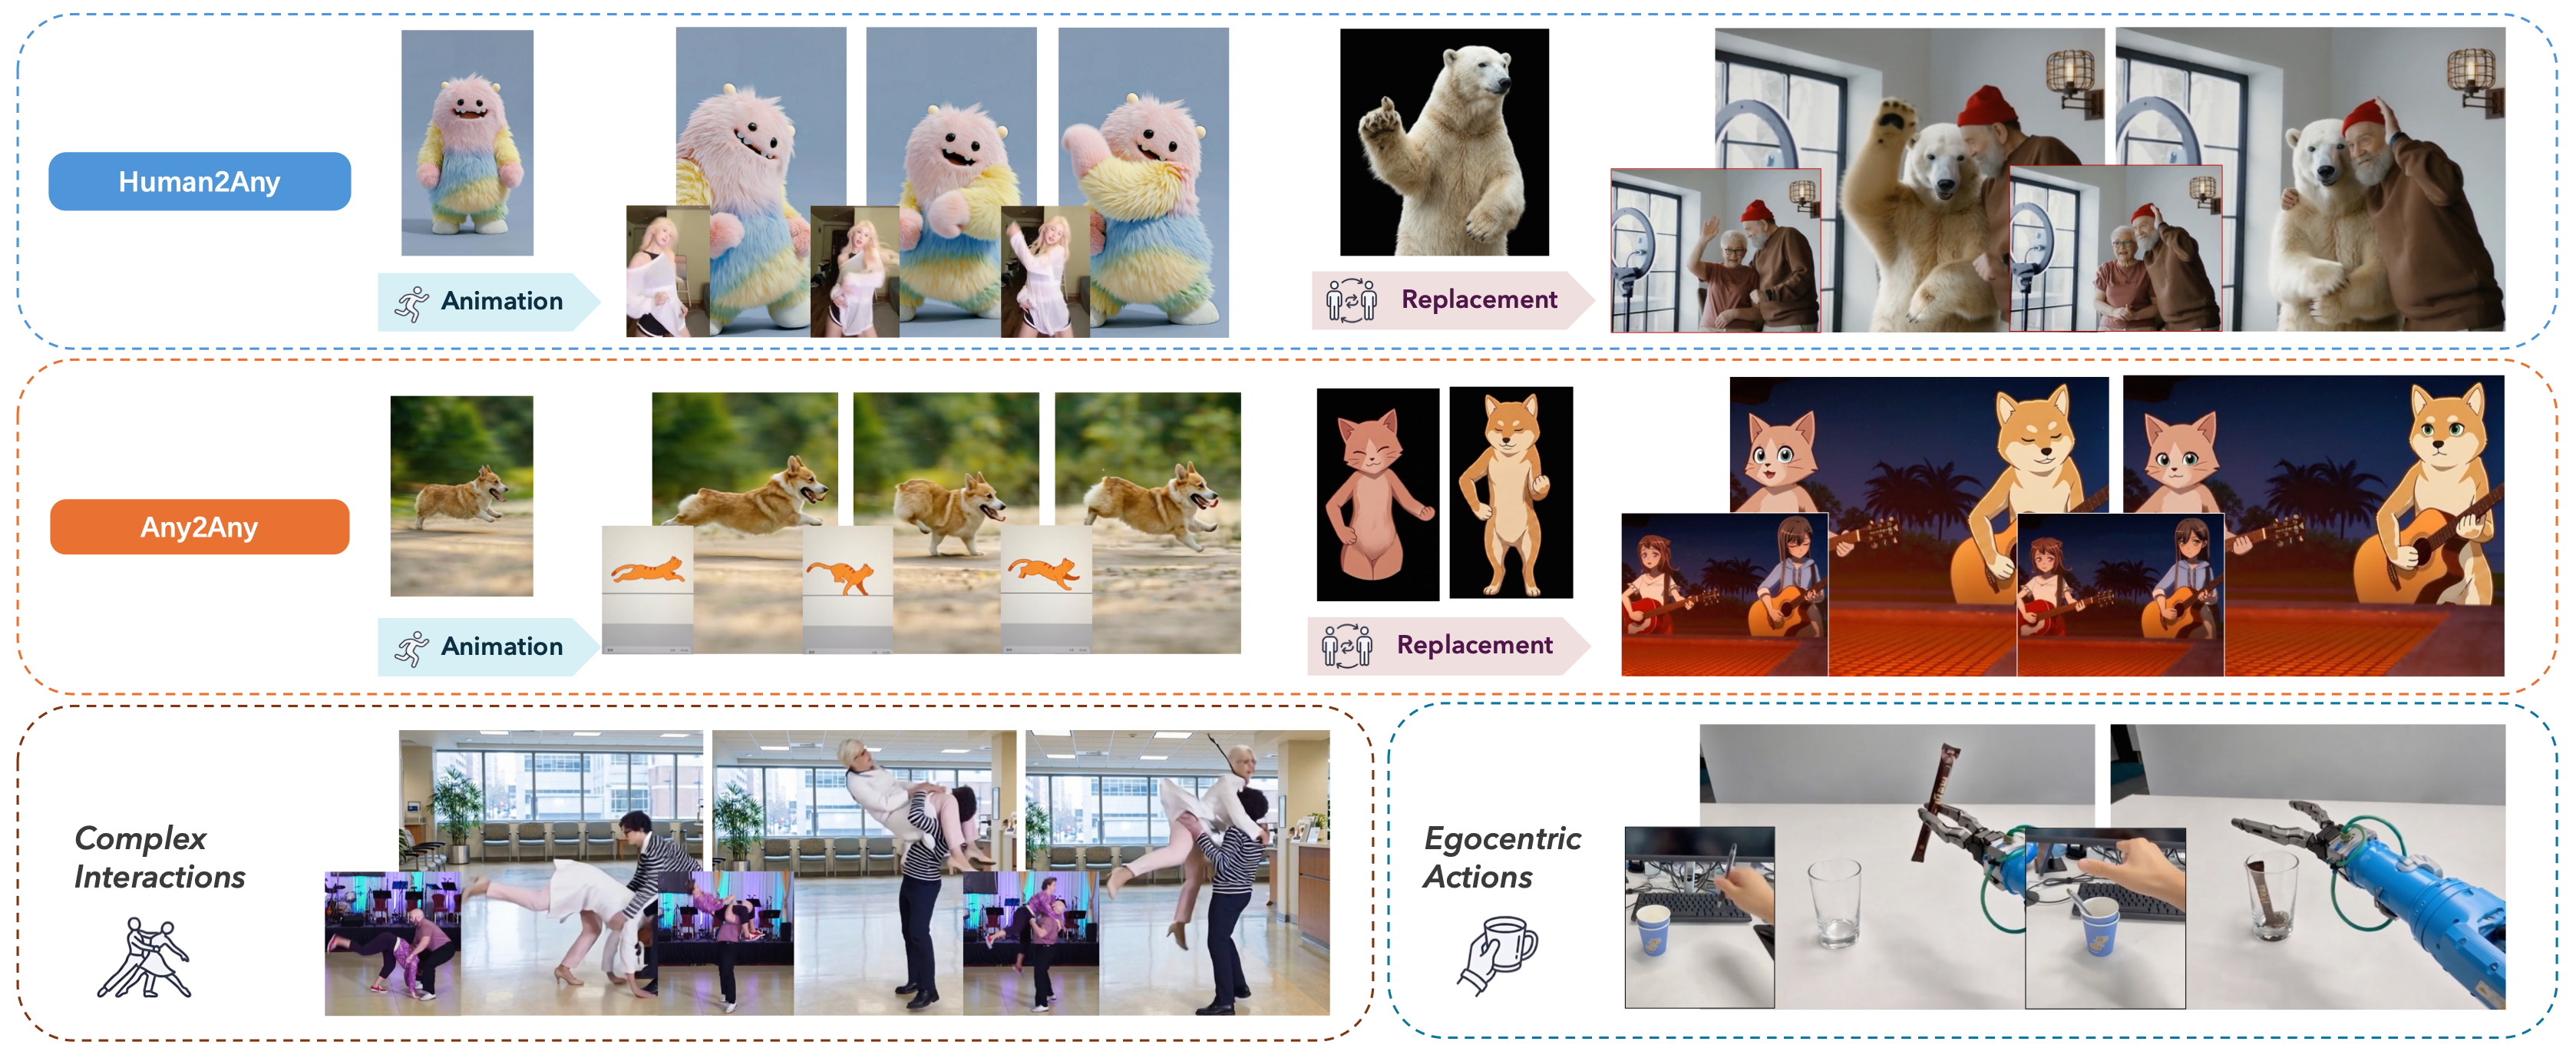
Z.ai가 공개한 SCAIL-2는 포즈 스켈레톤·인페인팅 마스크 같은 중간 표현을 거치지 않고 driving 비디오 latent를 시퀀스에 직접 이어 붙여 캐릭터 애니메이션을 end-to-end로 합성한다. 60K motion pair 데이터셋, in-context mask conditioning, mode-specific RoPE, Bias-Aware DPO를 결합하여 동물 driving과 egocentric 같은 제로샷 능력까지 끌어냈다.
NVIDIA Labs가 공개한 2.6B 오픈소스 비디오 월드 모델 SANA-WM. 프로젝트 페이지의 데모 갤러리와 본 논문(arXiv 2605.15178)의 method·벤치마크 디테일을 함께 정리한다.
Meta AI가 발표한 Tuna-2는 VAE도 비전 인코더도 없이 단순 패치 임베딩만으로 이미지 이해와 생성을 동시에 수행한다. CVPR'26 Highlight 논문이 던지는 메시지는 명확하다 — 사전훈련 비전 인코더는 멀티모달 모델링에 필수가 아니다.