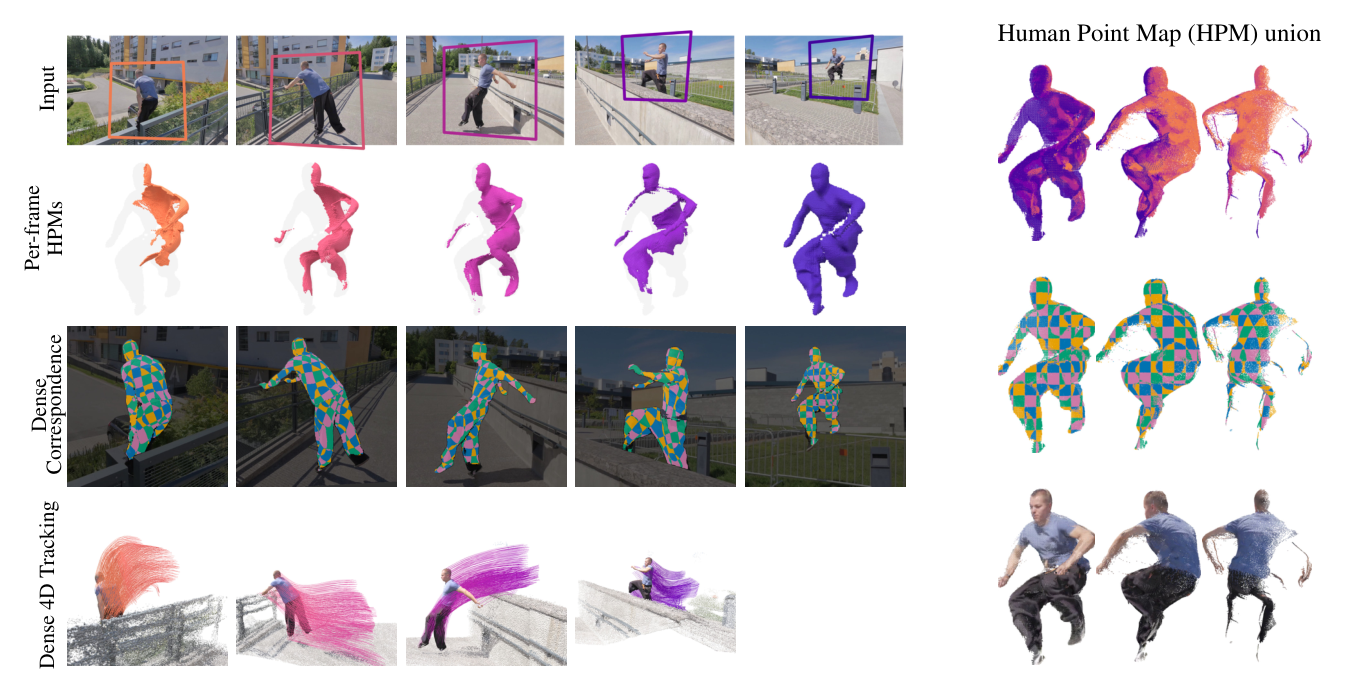
다섯 개의 입력 프레임에서 추출한 인물 크롭과 프레임별 인간 포인트 맵(HPM), 체커보드 무늬로 시각화한 픽셀 대응 관계, 3D 이동 궤적, 그리고 여러 프레임의 관측을 기준 시점 자세 하나로 합친 3D 인물 점군

Dense4D: Pixel-Level 4D Human Correspondence

Imperial College London의 Rıza Alp Güler가 사전 정의된 신체 템플릿이나 카메라 포즈 추정 없이 단안 RGB 이미지들에서 신체, 의복, 머리카락의 픽셀 단위 4D 대응 관계와 3D 궤적을 한 번의 순전파로 복원하는 Dense4D를 공개했다. 인물 중심 가상 카메라 크롭에서 기준 시점의 3D 표면 좌표를 예측하는 인간 포인트 맵(HPM)을 도입해 Panoptic Studio 3D 추적과 4D-DRESS 비가시 영역 위치 추정에서 기존 비교 모델들보다 성능이 크게 높았다.
October 17, 2026 · 15 분 · 서소영
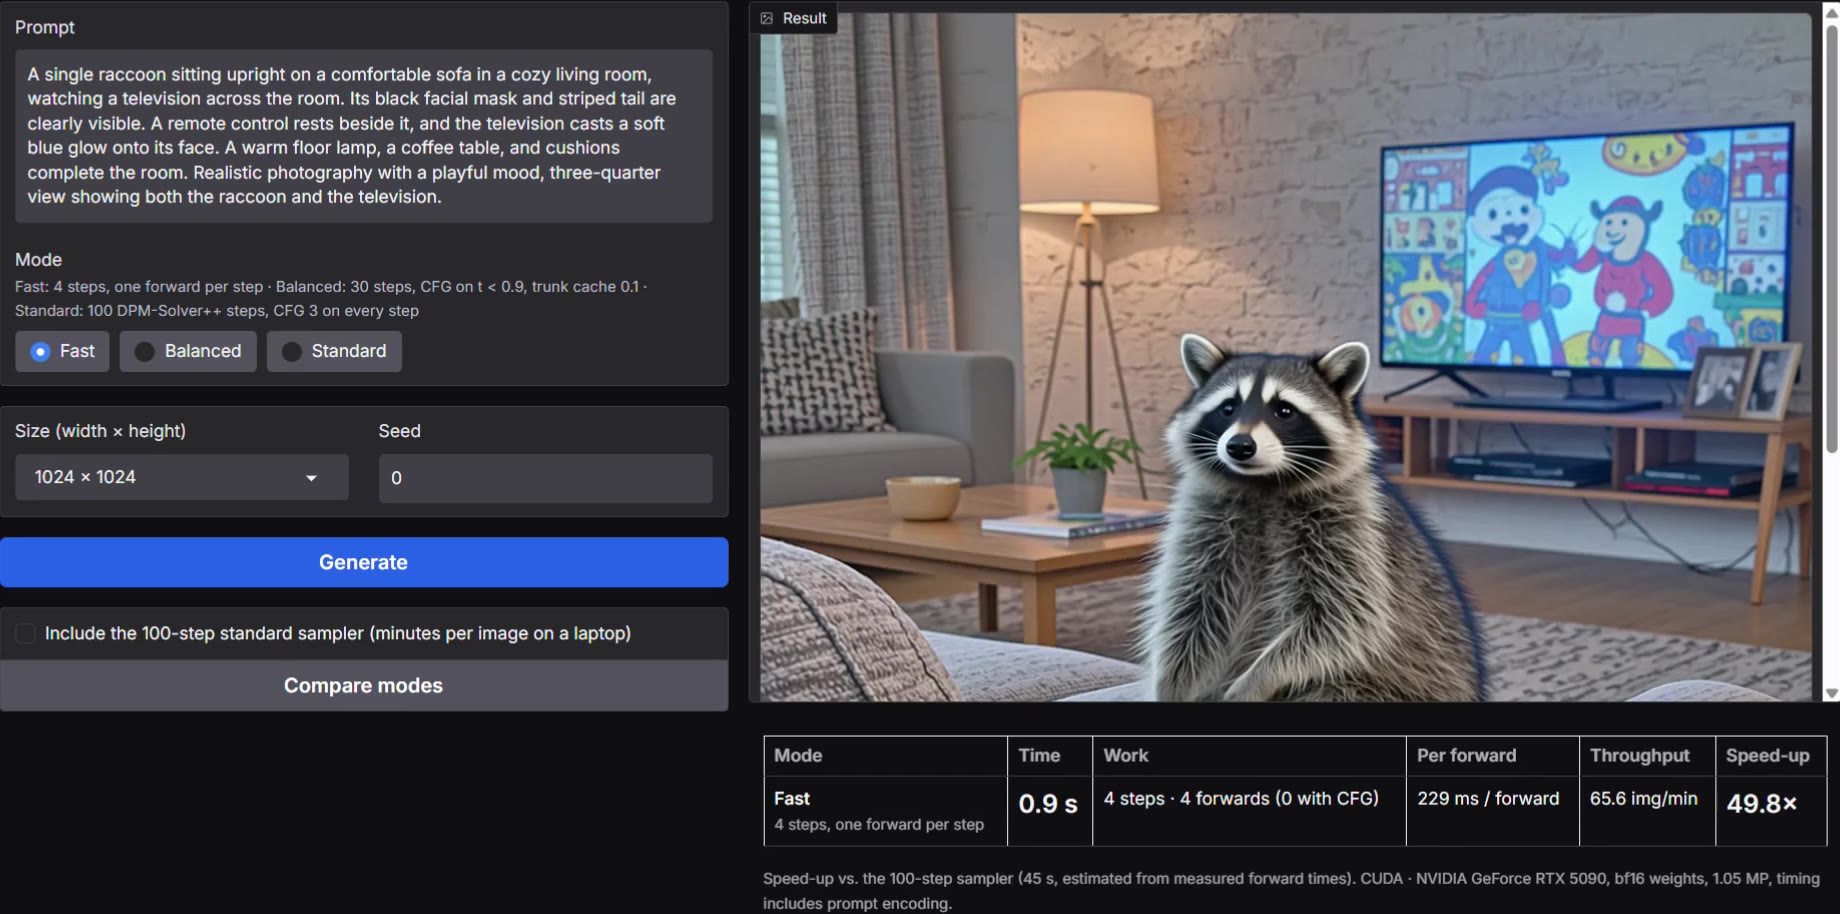
Iris-3B 속도 비교 데모 화면. 왼쪽에 거실 소파에 앉아 텔레비전을 보는 너구리를 묘사한 프롬프트와 Fast 모드 선택이 있고, 오른쪽에 생성된 너구리 사진이 있다. 아래 표에는 4스텝, 포워드 4번, 0.9초, 100스텝 대비 49.8배라고 적혀 있다. 사용자 jun1228909가 RTX 5090에서 녹화한 영상의 한 장면이다.

Iris-3B의 100스텝을 4스텝으로 줄인 Turbo LoRA

Speridlabs가 공개한 30억 파라미터 이미지 생성 모델 Iris-3B는 VAE 없이 픽셀을 직접 만든다. 대신 기본 설정에서는 1024×1024 이미지 한 장에 포워드 패스가 약 200번 필요했다. 일본 개발자 pentacoxian은 증류 기법 DMD2로 CFG의 효과까지 학습한 4스텝 LoRA를 만들어 생성 시간을 RTX 5090에서 0.68초, M3 Max에서 약 11초로 줄였다. 공개 하루 동안에는 사용자들이 RTX 5090, 아이폰, 스냅드래곤 NPU에서 실행한 결과를 올렸다.

October 12, 2026 · 12 분 · 서소영
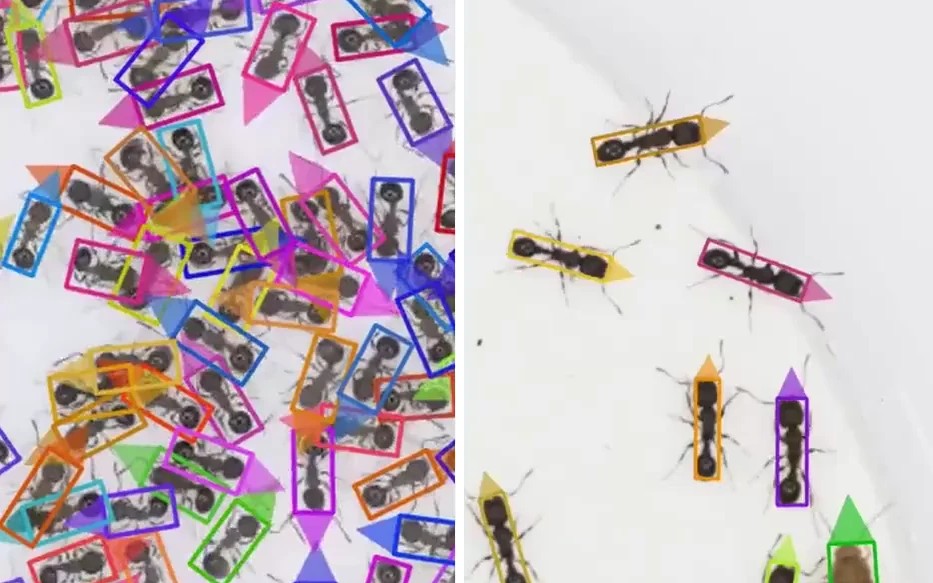
AMADEUS 공식 사이트 데모 영상의 첫 장면. 왼쪽은 개미 수백 마리가 빽빽하게 모인 장면으로, 개미의 몸 방향에 맞춰 기울인 직사각형이 몸을 감싸고 머리 쪽에 같은 색 삼각형이 붙어 있으며, 직사각형의 색은 개미마다 다르다. 오른쪽은 흰 바닥 위의 개미 여러 마리와 갈색 귀뚜라미 한 마리가 같은 방식으로 표시된 장면이다. 원래 영상의 가운데 빈 여백을 잘라 내고 좌우 장면을 이어 붙였다.

AMADEUS | Annotation-free multi-animal tracking software

메이지대학과 도쿄대학 연구진이 공개한 동물 추적 소프트웨어 AMADEUS는 사람이 라벨을 하나도 달지 않아도 여러 동물의 개체 번호와 머리 방향을 함께 추적한다. 혼자 떨어진 개체의 모습을 오려 붙여 겹침 장면을 합성하고 그 이미지로 탐지기를 학습한다. 연구진이 쥐 10마리 영상부터 개미 368마리 영상까지 여섯 편으로 성능을 비교한 결과, AMADEUS의 개체 추적 점수는 유효한 결과를 낸 비교 도구보다 모두 높았다.

October 5, 2026 · 14 분 · 서소영
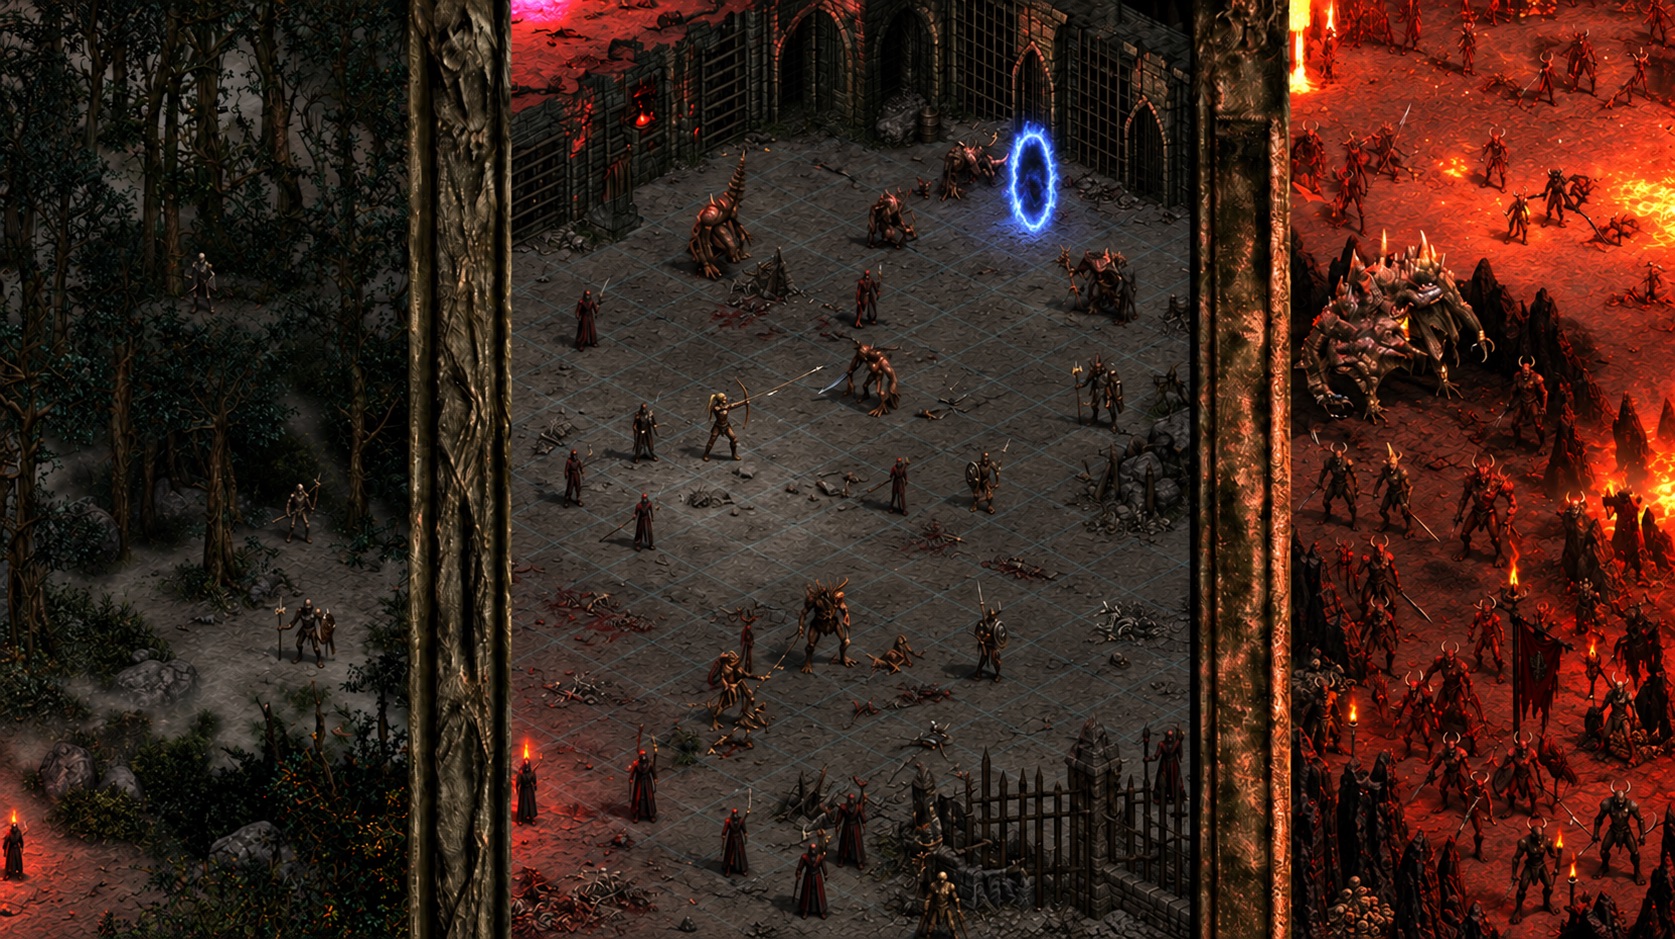
Agora-2 발표 페이지의 대표 이미지. 아이소메트릭 시점의 다크 판타지 게임 장면 세 개가 장식 기둥을 사이에 두고 이어져 있다. 왼쪽은 해골 병사들이 서 있는 어두운 숲, 가운데는 활을 든 영웅과 괴물 여럿이 싸우는 석조 광장과 파란 포털, 오른쪽은 붉은 악마 무리와 거대한 괴수가 있는 용암 지대다.

Introducing Agora-2: Advancing Multi-Agent World Simulation

Odyssey가 사람과 에이전트 최대 20명이 한 생성 세계를 함께 쓰는 멀티에이전트 월드 모델 Agora-2를 플레이 가능한 연구 프리뷰로 공개했다. 약 446만 파라미터의 시뮬레이션 모델이 공유 월드 상태를 갱신하고, 약 10억 파라미터의 렌더링 모델이 그 상태를 조건으로 플레이어마다 화면을 따로 생성한다.

September 25, 2026 · 17 분 · 서소영
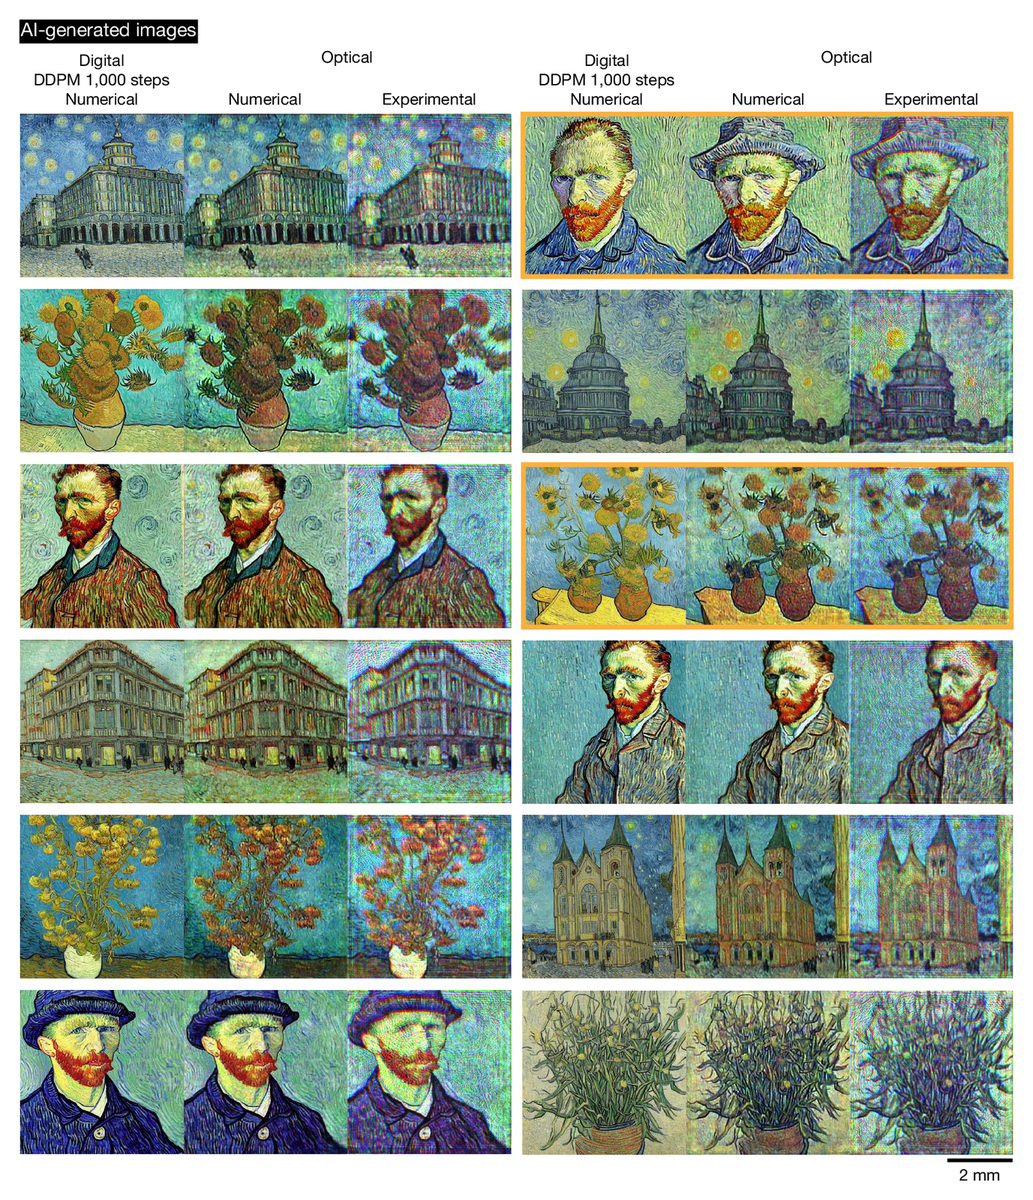
반 고흐풍 컬러 작품을 광학 생성 모델로 만든 결과를 격자로 배열한 도판. 각 열마다 교사 디지털 확산 모델의 출력, 광학 모델의 시뮬레이션 결과, 실제 장치에서 촬영한 실험 결과가 위아래로 놓여 있다. 오른쪽 세 열은 교사 모델과 다른 그림이 나온 사례로, 주황색 상자로 표시했다

Optical generative models

UCLA 연구진이 이미지 합성의 계산 단계를 빛의 전파로 대체했다. 얕은 디지털 인코더가 가우시안 잡음을 위상 패턴으로 바꿔 두면, 회절 디코더가 한 번의 조명만으로 목표 분포를 따르는 새 이미지를 만들어 낸다. 디지털 확산 모델을 교사로 삼아 증류했고, 반 고흐풍 작품까지 실제 가시광 장치에서 생성했다.

September 18, 2026 · 10 분 · 서소영
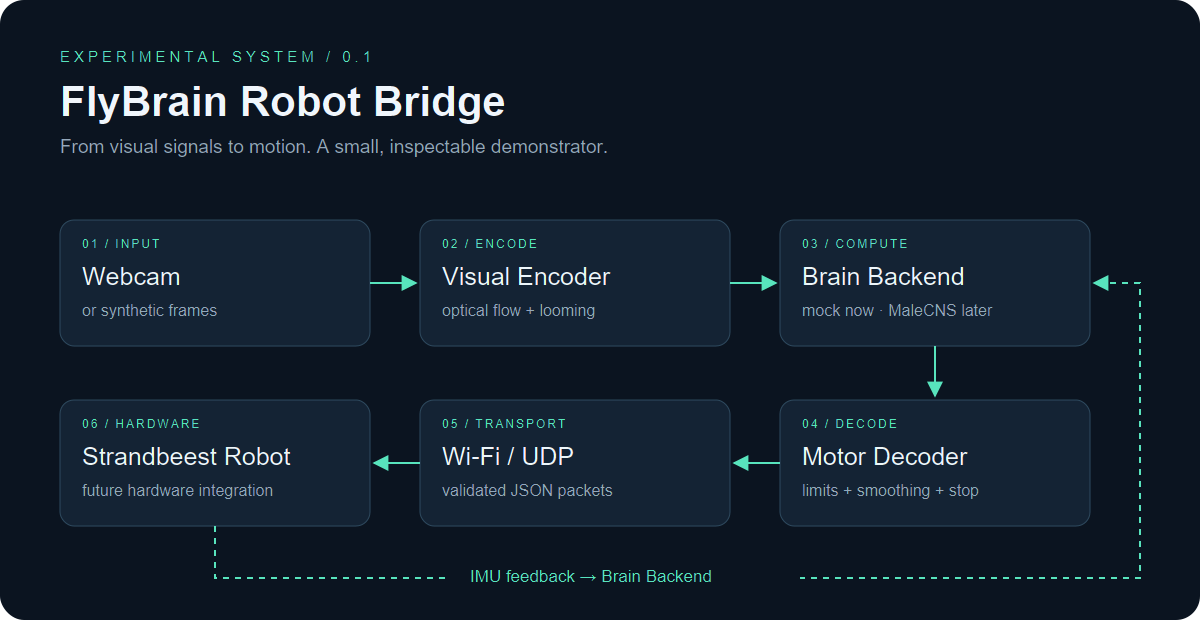
웹캠에서 시각 인코더, 브레인 백엔드, 모터 디코더, UDP를 거쳐 로봇에 이르는 여섯 단계 신호 흐름도

FlyBrain Robot Bridge

초파리 커넥톰을 로봇에 잇겠다는 이름을 달고 공개된 실험 리포지터리다. 지금 돌아가는 것은 사람이 손으로 설계한 여덟 개 신호 그룹이고, 정작 커넥톰 백엔드는 호출하는 순간 미구현 예외를 던지도록 만들어져 있다.

September 15, 2026 · 7 분 · 서소영
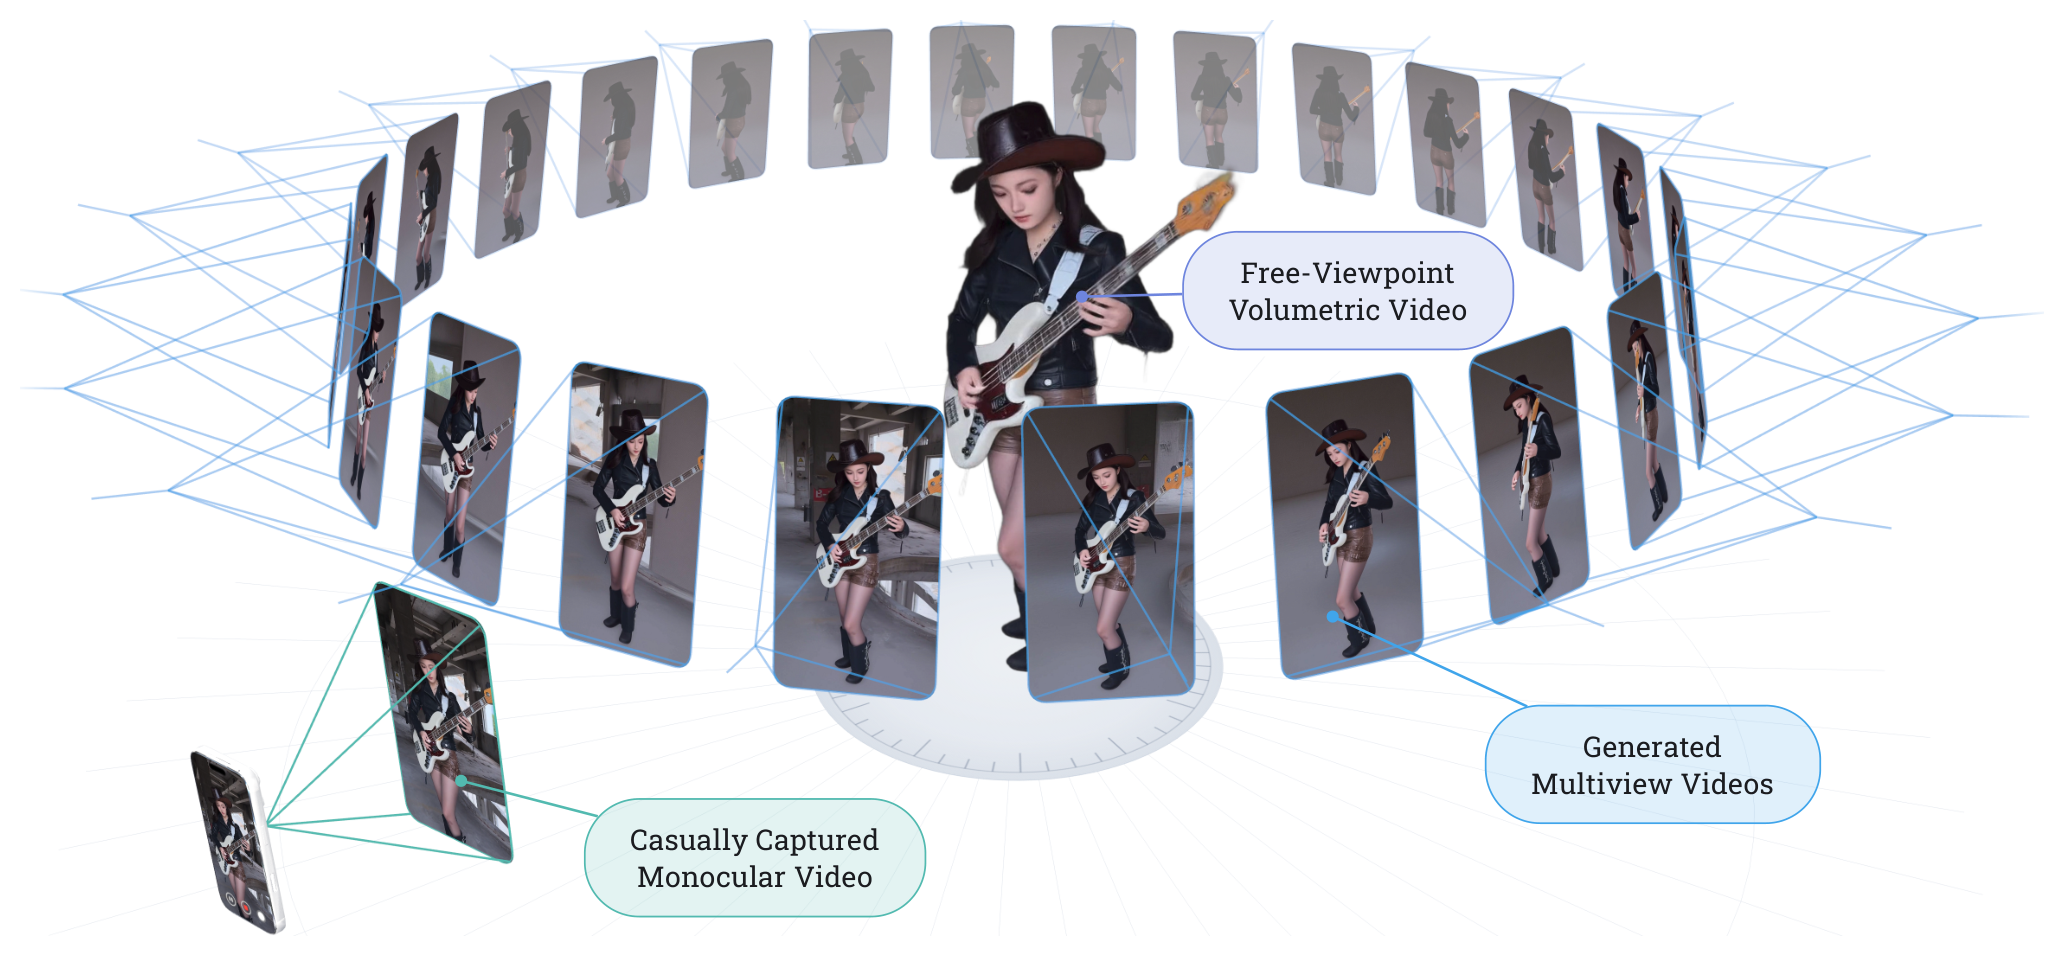
4DAnyone 티저. 왼쪽 아래 스마트폰이 베이스를 연주하는 인물을 찍고, 그 주위를 24개의 생성 카메라가 둘러싸며, 가운데 복원된 인물이 자유 시점으로 렌더링된다.

4DAnyone: Create Anyone in 4D from a Casual Monocular Video

휴대폰으로 대충 찍은 단안 영상 한 편에서 자유 시점 4D 인간을 복원한다. 시점 수를 수십 개로 늘리면 일관성이 무너지던 원인을 어텐션 컨텍스트 용량 한계로 규명하고, 참조 컨텍스트 압축과 타깃 그룹 회전이라는 두 설계로 푼다.

August 31, 2026 · 10 분 · 서소영
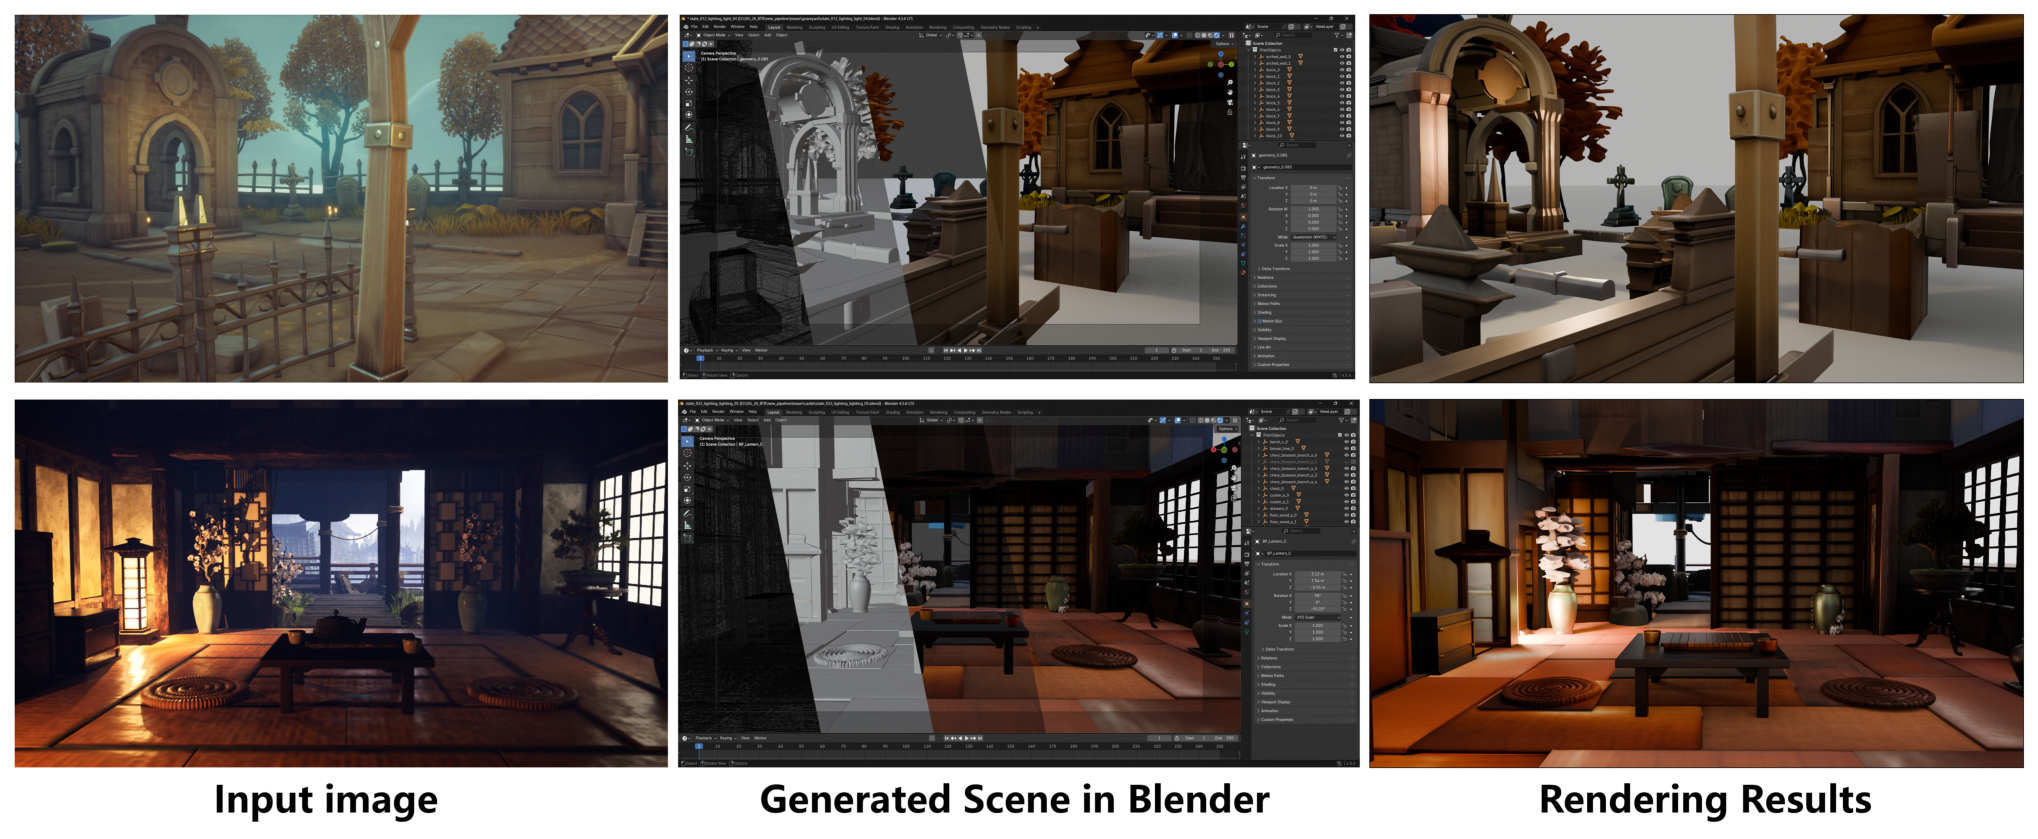
Lumera 티저. 단일 이미지에서 3D 박스와 파라메트릭 광원을 파싱하고, 오브젝트별 메시와 HDR 환경광을 복원해 Blender·UE5가 열 수 있는 편집 가능한 씬으로 조립한다.

Engine-Native Editable 3D World Reconstruction with Objects and Lighting

사진 한 장에서 UE5나 Blender가 그대로 불러올 수 있는 오브젝트와 광원을 뽑아내는 벤치마크 Lumera. 3D 박스 파싱은 기존 방법을 크게 앞섰지만, 개별 광원의 위치 추정은 F1 0.209에 머물러 있다.

August 31, 2026 · 9 분 · 서소영
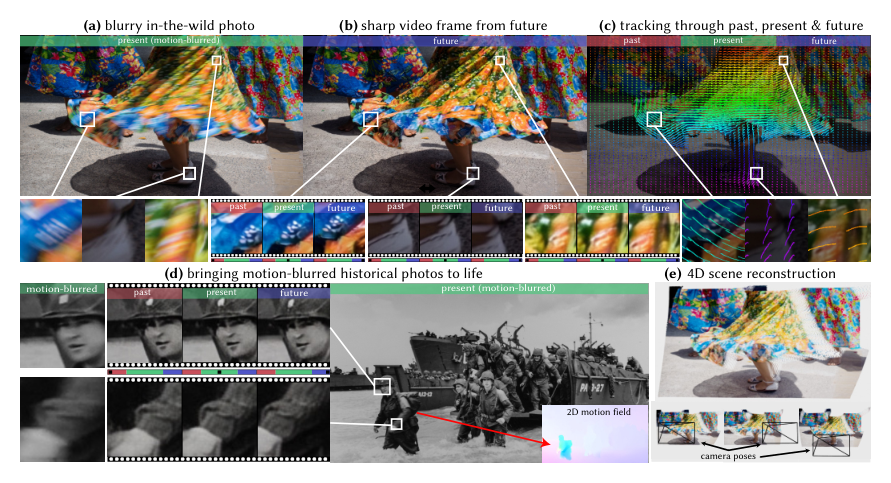
입력 모션 블러 이미지에서 생성한 영상 프레임, 추적 결과, 역사 사진 복원, 3D 구조 복원

Generating the Past, Present and Future from a Motion-Blurred Image

흔들린 사진 한 장을 사전학습 비디오 확산 모델에 조건으로 넣어, 셔터가 열려 있던 순간의 영상과 그 직전과 직후까지 생성한다. 요크대학교와 토론토대학교 연구진의 SIGGRAPH Asia 2025 논문.

August 19, 2026 · 8 분 · 서소영
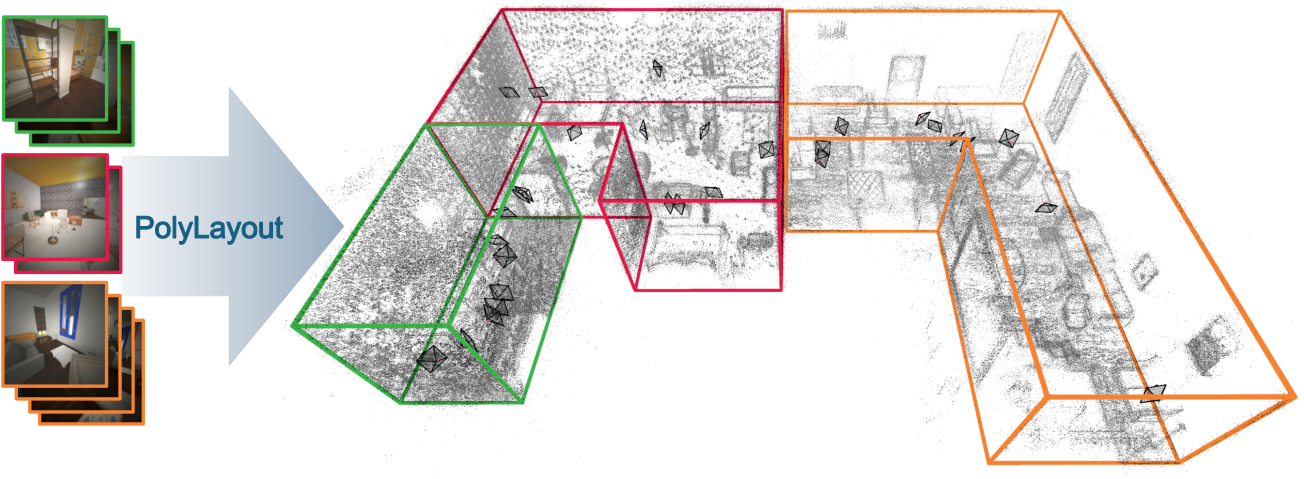
PolyLayout이 여러 장의 실내 사진에서 여러 방의 구조를 한꺼번에 복원한 결과. 방마다 색이 다르고, 각 방 안의 작은 사각뿔이 입력 이미지를 찍은 카메라다. 점구름은 시각화용이며 입력이 아니다.

PolyLayout: Multi-room Manhattan Layout Estimation

여러 장의 실내 사진에서 방의 벽·바닥·천장을 3D 다각형으로 복원하는 ECCV 2026 논문. 방을 하나씩 따로 풀지 않고 건물 안의 방들이 같은 방향과 같은 층고를 공유한다는 구조를 최적화에 넣어, 직육면체 가정에 묶여 있던 기존 방법을 큰 폭으로 앞선다.

August 19, 2026 · 9 분 · 서소영