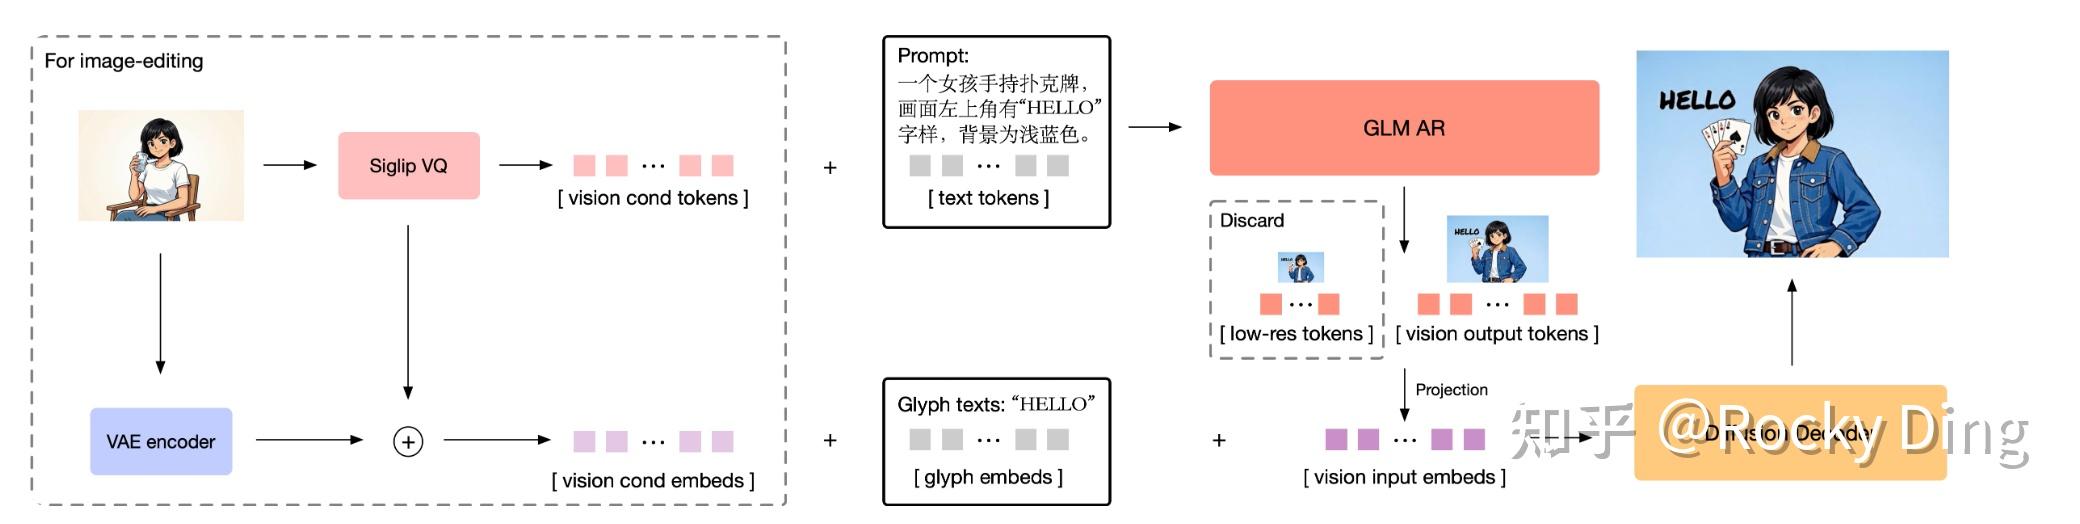
FLUX.2·Seedream·Z-Image·GLM-Image 핵심 기초 지식 완전 해설
2025~2026년 사이 등장한 4세대 이미지 생성 모델(FLUX.2·Seedream·Z-Image·GLM-Image)의 VAE·Text Encoder·DiT 백본·정렬 학습을 가로로 비교한 Rocky Ding(WeThinkIn)의 기술 해설.
2025~2026년 사이 등장한 4세대 이미지 생성 모델(FLUX.2·Seedream·Z-Image·GLM-Image)의 VAE·Text Encoder·DiT 백본·정렬 학습을 가로로 비교한 Rocky Ding(WeThinkIn)의 기술 해설.
Rocky Ding이 2026년 3월 정리한 약 7만 자 분량의 종합 해설. FLUX.2·Seedream·Z-Image·GLM-Image 네 AIGC 이미지 대모델의 VAE·텍스트 인코더·DiT 백본·학습/추론 최적화를 분해하고, GRPO 알고리즘의 AIGC 적용까지 다룬다. 글의 메타 주장은 2025년 하반기를 AIGC 이미지 창작 영역의 ‘하프타임’으로 규정하고, 단일 문생도 모델은 가치가 사라지며 통합 멀티모달과 ‘주기 횡단’ 가치를 가진 기술만 살아남는다는 것이다.
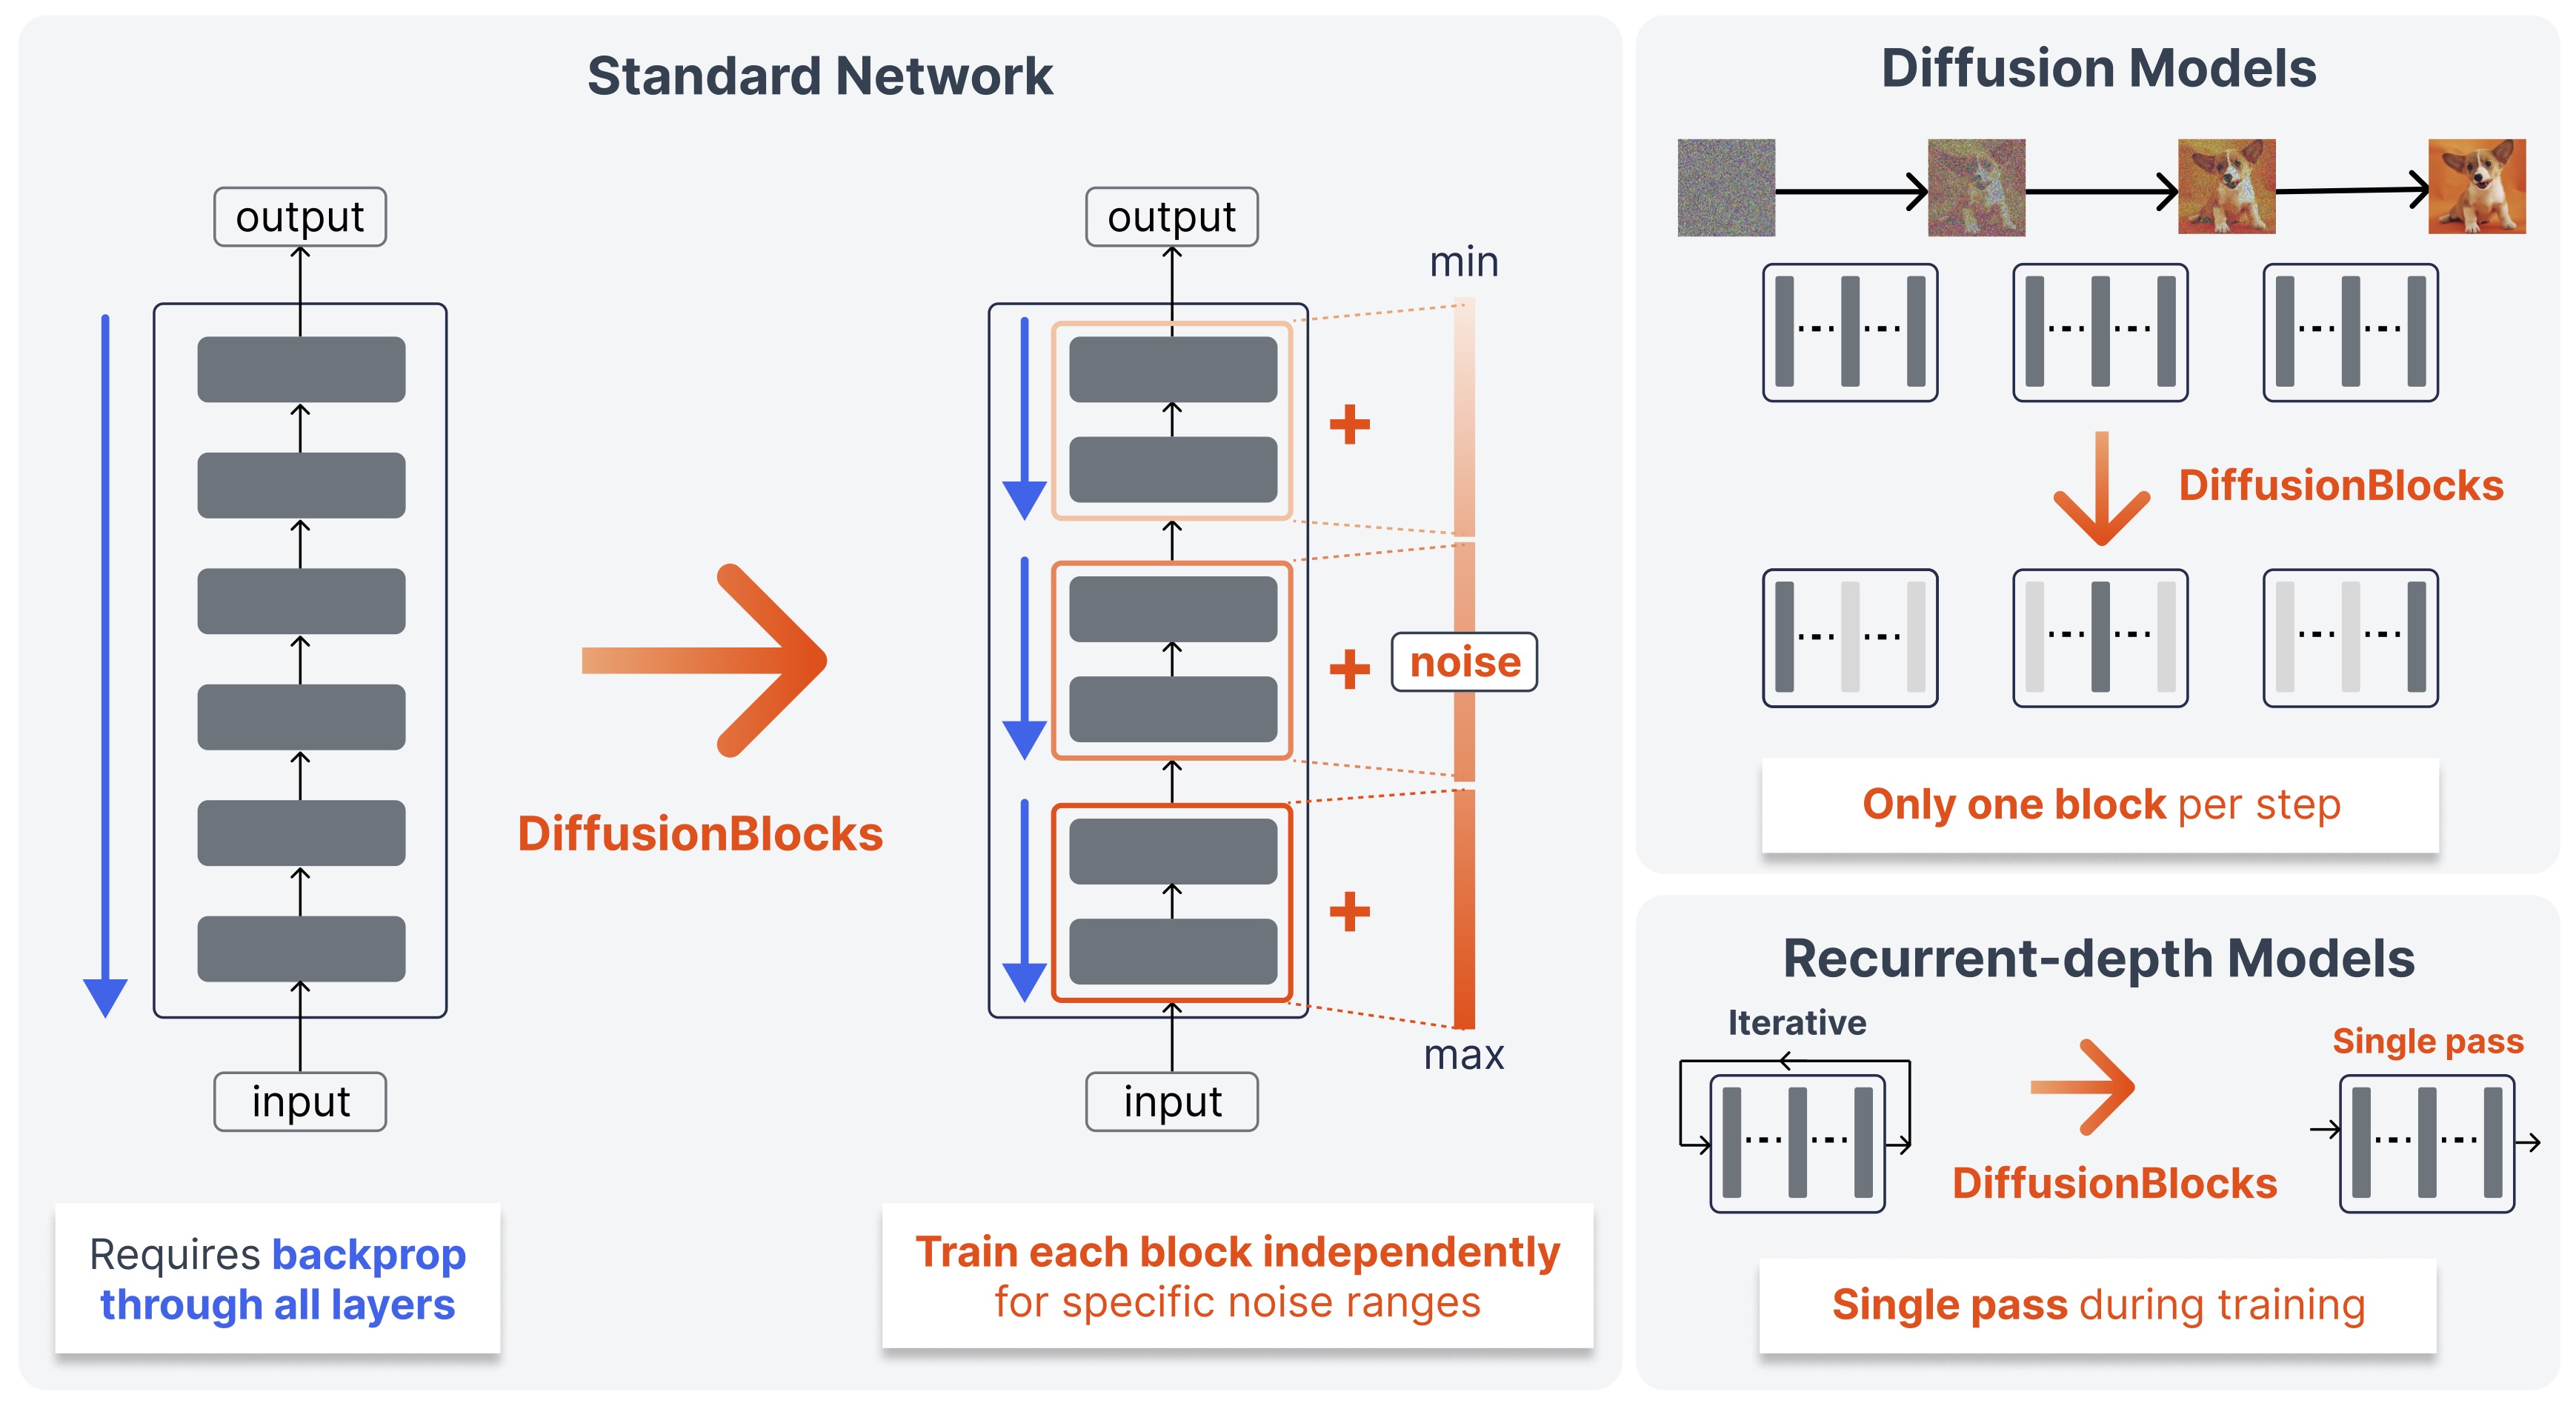
엔드투엔드 역전파의 메모리 병목을, 트랜스포머의 잔차 연결이 확산 모델 ODE의 이산화와 같다는 통찰로 푼 논문. 네트워크를 노이즈 구간별 독립 블록으로 쪼개 한 번에 한 블록만 학습하니 메모리가 블록 수만큼 줄고, 5개 아키텍처에서 엔드투엔드에 필적했다.
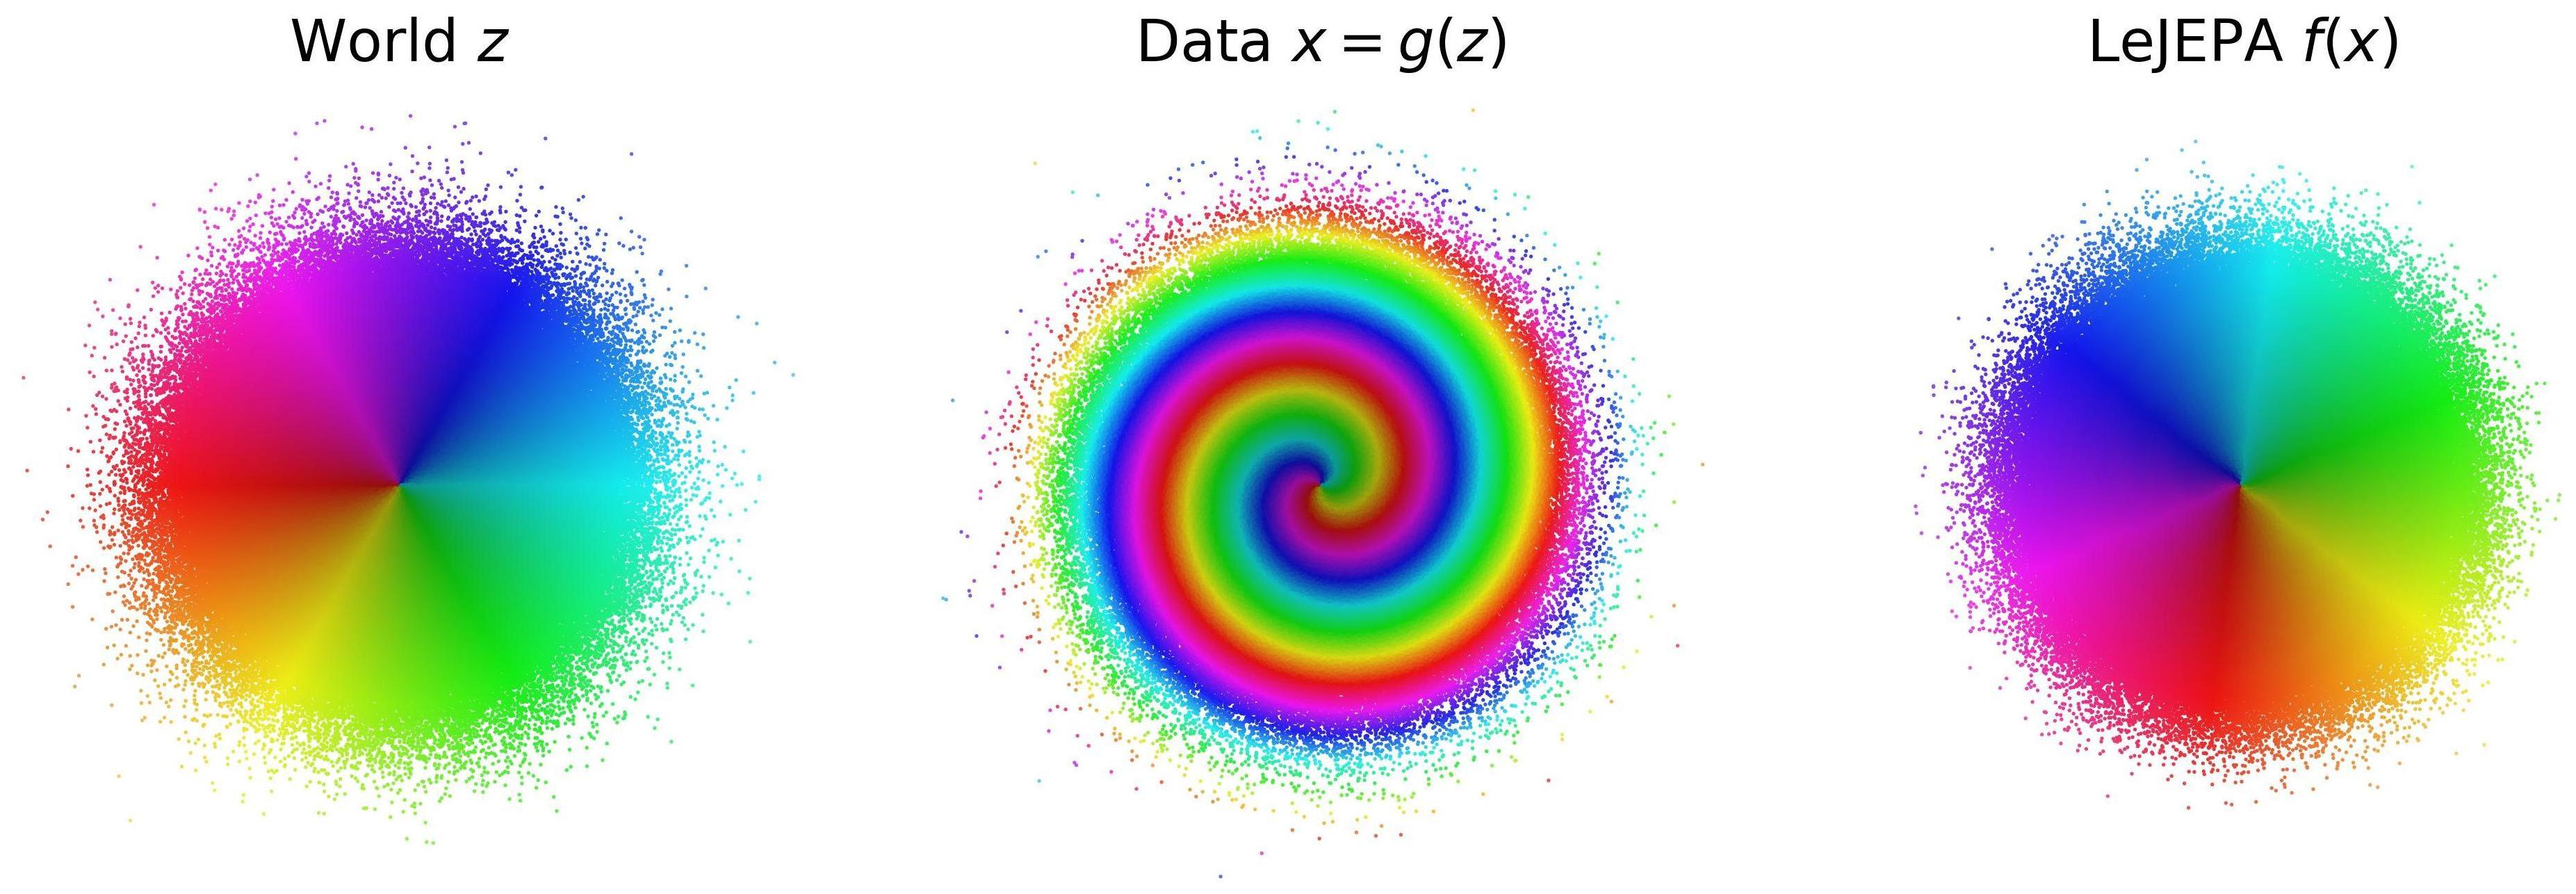
LeJEPA가 복잡한 관측에서 세계의 ‘진짜 좌표(숨은 변수)‘를 거의 그대로 되찾는다는 것, 그리고 그게 가능한 분포는 가우시안이 유일함을 증명한 글. 되찾은 좌표만으로 최적 계획까지 가능하다 — 르쿤의 월드 모델 구상에 형식 검증된 받침대를 놓았다.
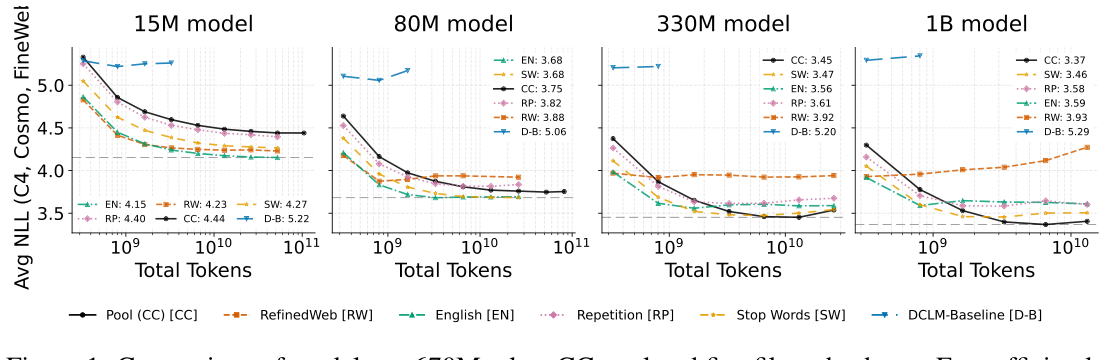
컴퓨트가 충분히 크면 데이터 필터링은 오히려 손해다 — Stanford 연구진이 Common Crawl과 5개 표준 필터를 비교하여, 큰 모델이 ‘저품질’ 데이터에서도 이득을 본다는 증거를 제시한다.
Cactus Compute가 Gemini 3.1을 26M 파라미터로 증류한 함수 호출 전용 모델. FFN을 통째로 들어낸 인코더-디코더 ‘Simple Attention Network’와 INT4 QAT, 게이트드 잔차, 토큰 가중 손실 등 작은 모델을 위한 설계 결정을 정리한다.
GRPO RL 훈련의 zero-advantage 문제를, 어려운 문제 앞에 Lorem Ipsum을 덧붙여 재샘플링하는 LoPE로 해결한 연구를 정리한다. Qwen3-4B-Base에서 MATH-500 +4.8p, AMC +22%(상대) 향상이 보고되었다.
RLHF 정렬 모델의 mode collapse는 알고리즘 한계가 아니라 preference data에 새겨진 typicality bias가 원인이다. ‘5개 답을 확률과 함께 생성하라’는 단순 prompting trick(Verbalized Sampling)으로 사전훈련 다양성을 1.6~2.1배 회복할 수 있음을 이론·실험으로 보인다.
ElevenLabs STT 팀 리드가 순수 PyTorch로 GPT-2 기반 10M 파라미터 모델을 로컬에서 처음부터 훈련하는 81분 핸즈온 워크숍. 토크나이저부터 추론까지 전 과정을 코드와 함께 진행한다.
Meta FAIR가 트랜스포머의 FFN 레이어를 학습 가능한 key-value 메모리로 대체하여, FLOP 증가 없이 파라미터를 128B까지 확장하고 사실 기반 QA에서 2배 이상 컴퓨트 예산의 dense 모델을 능가한 논문.