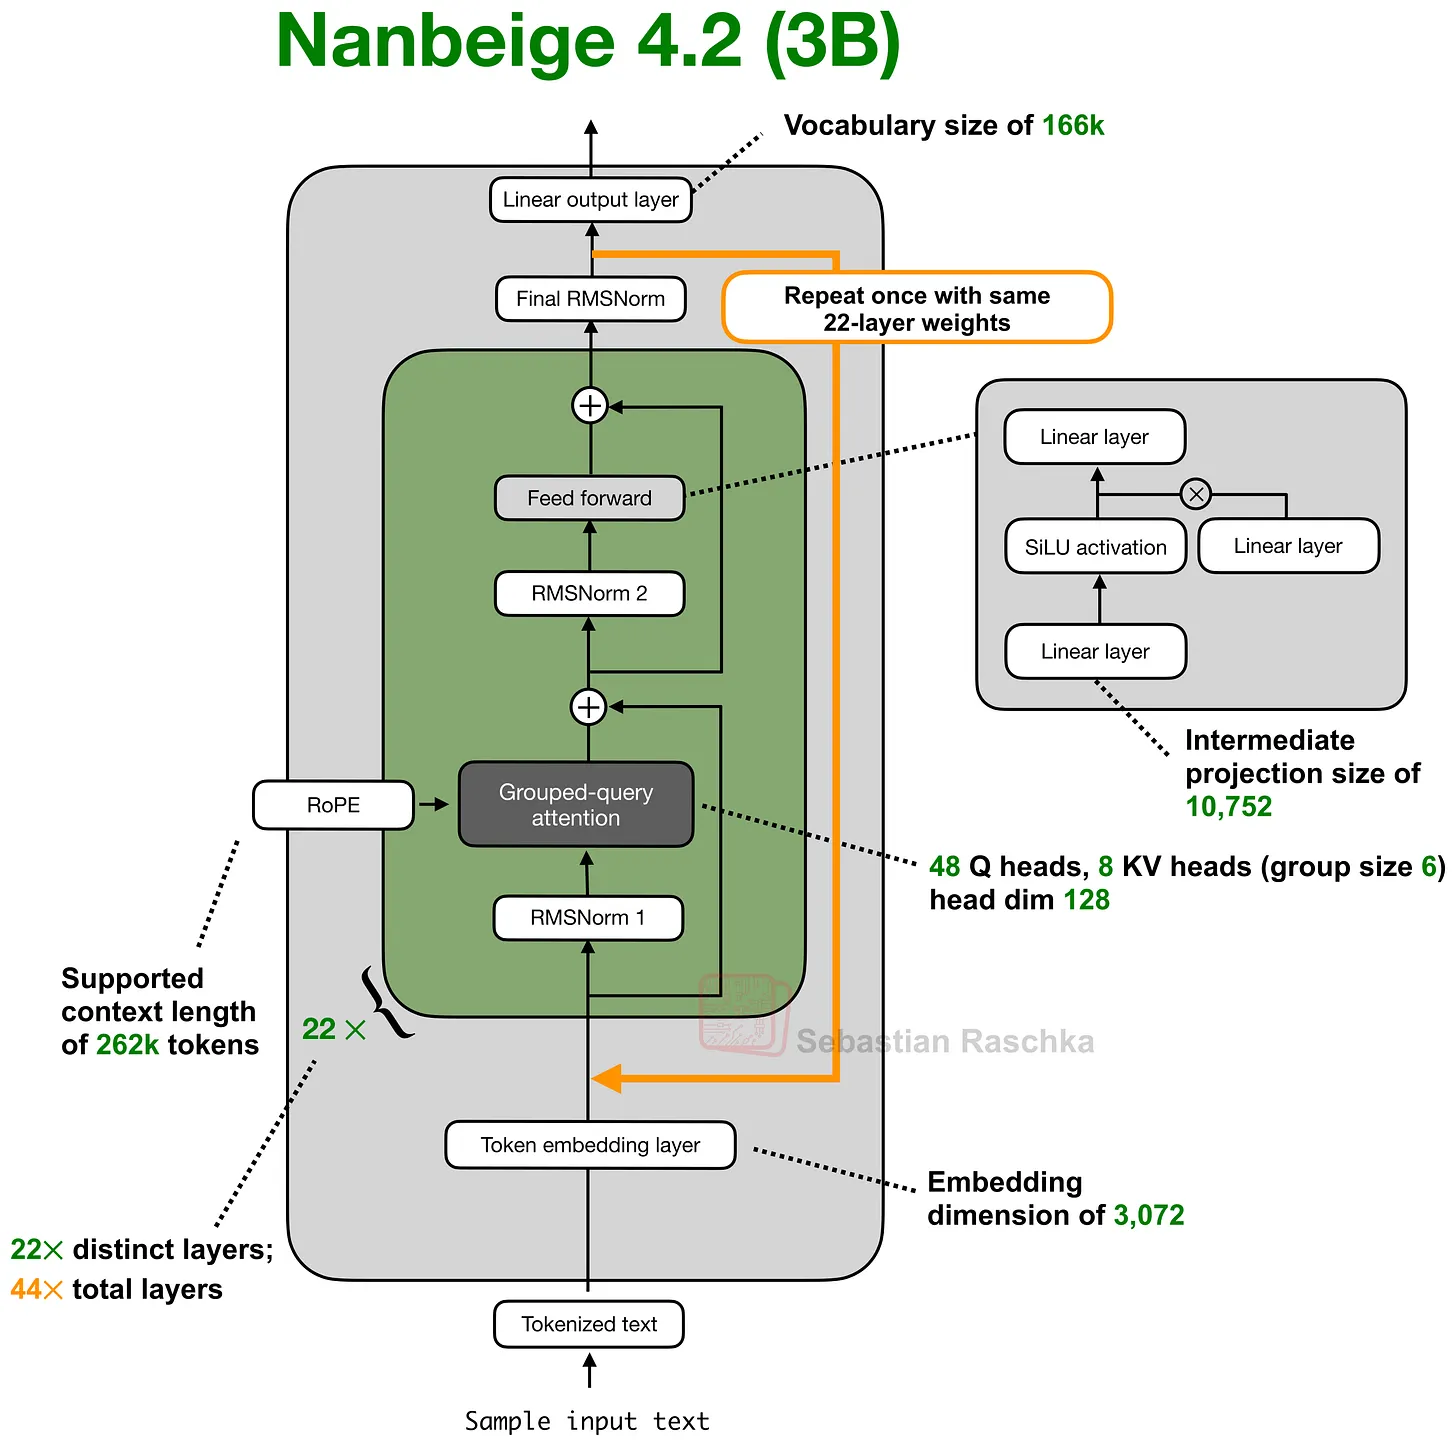
Nanbeige4.2-3B 아키텍처 도식. 22개 트랜스포머 블록 위에서 주황색 화살표가 스택 맨 아래로 되돌아간다

GPT-6 Astra, Looped Transformers, and Hidden Reasoning

The Information은 GPT-6 Astra가 루프 트랜스포머를 써서 추론 흔적을 가린다고 보도했다. Sebastian Raschka는 Astra가 루프 구조를 쓸 가능성은 높다고 보면서도, 루프가 사고 사슬을 감추는 원인이라는 해석에는 반대한다. 루프 트랜스포머가 무엇이고 무엇을 아끼며 무엇을 아끼지 못하는지를 논문 네 편과 함께 정리한 글이다.
September 10, 2026 · 15 분 · 서소영
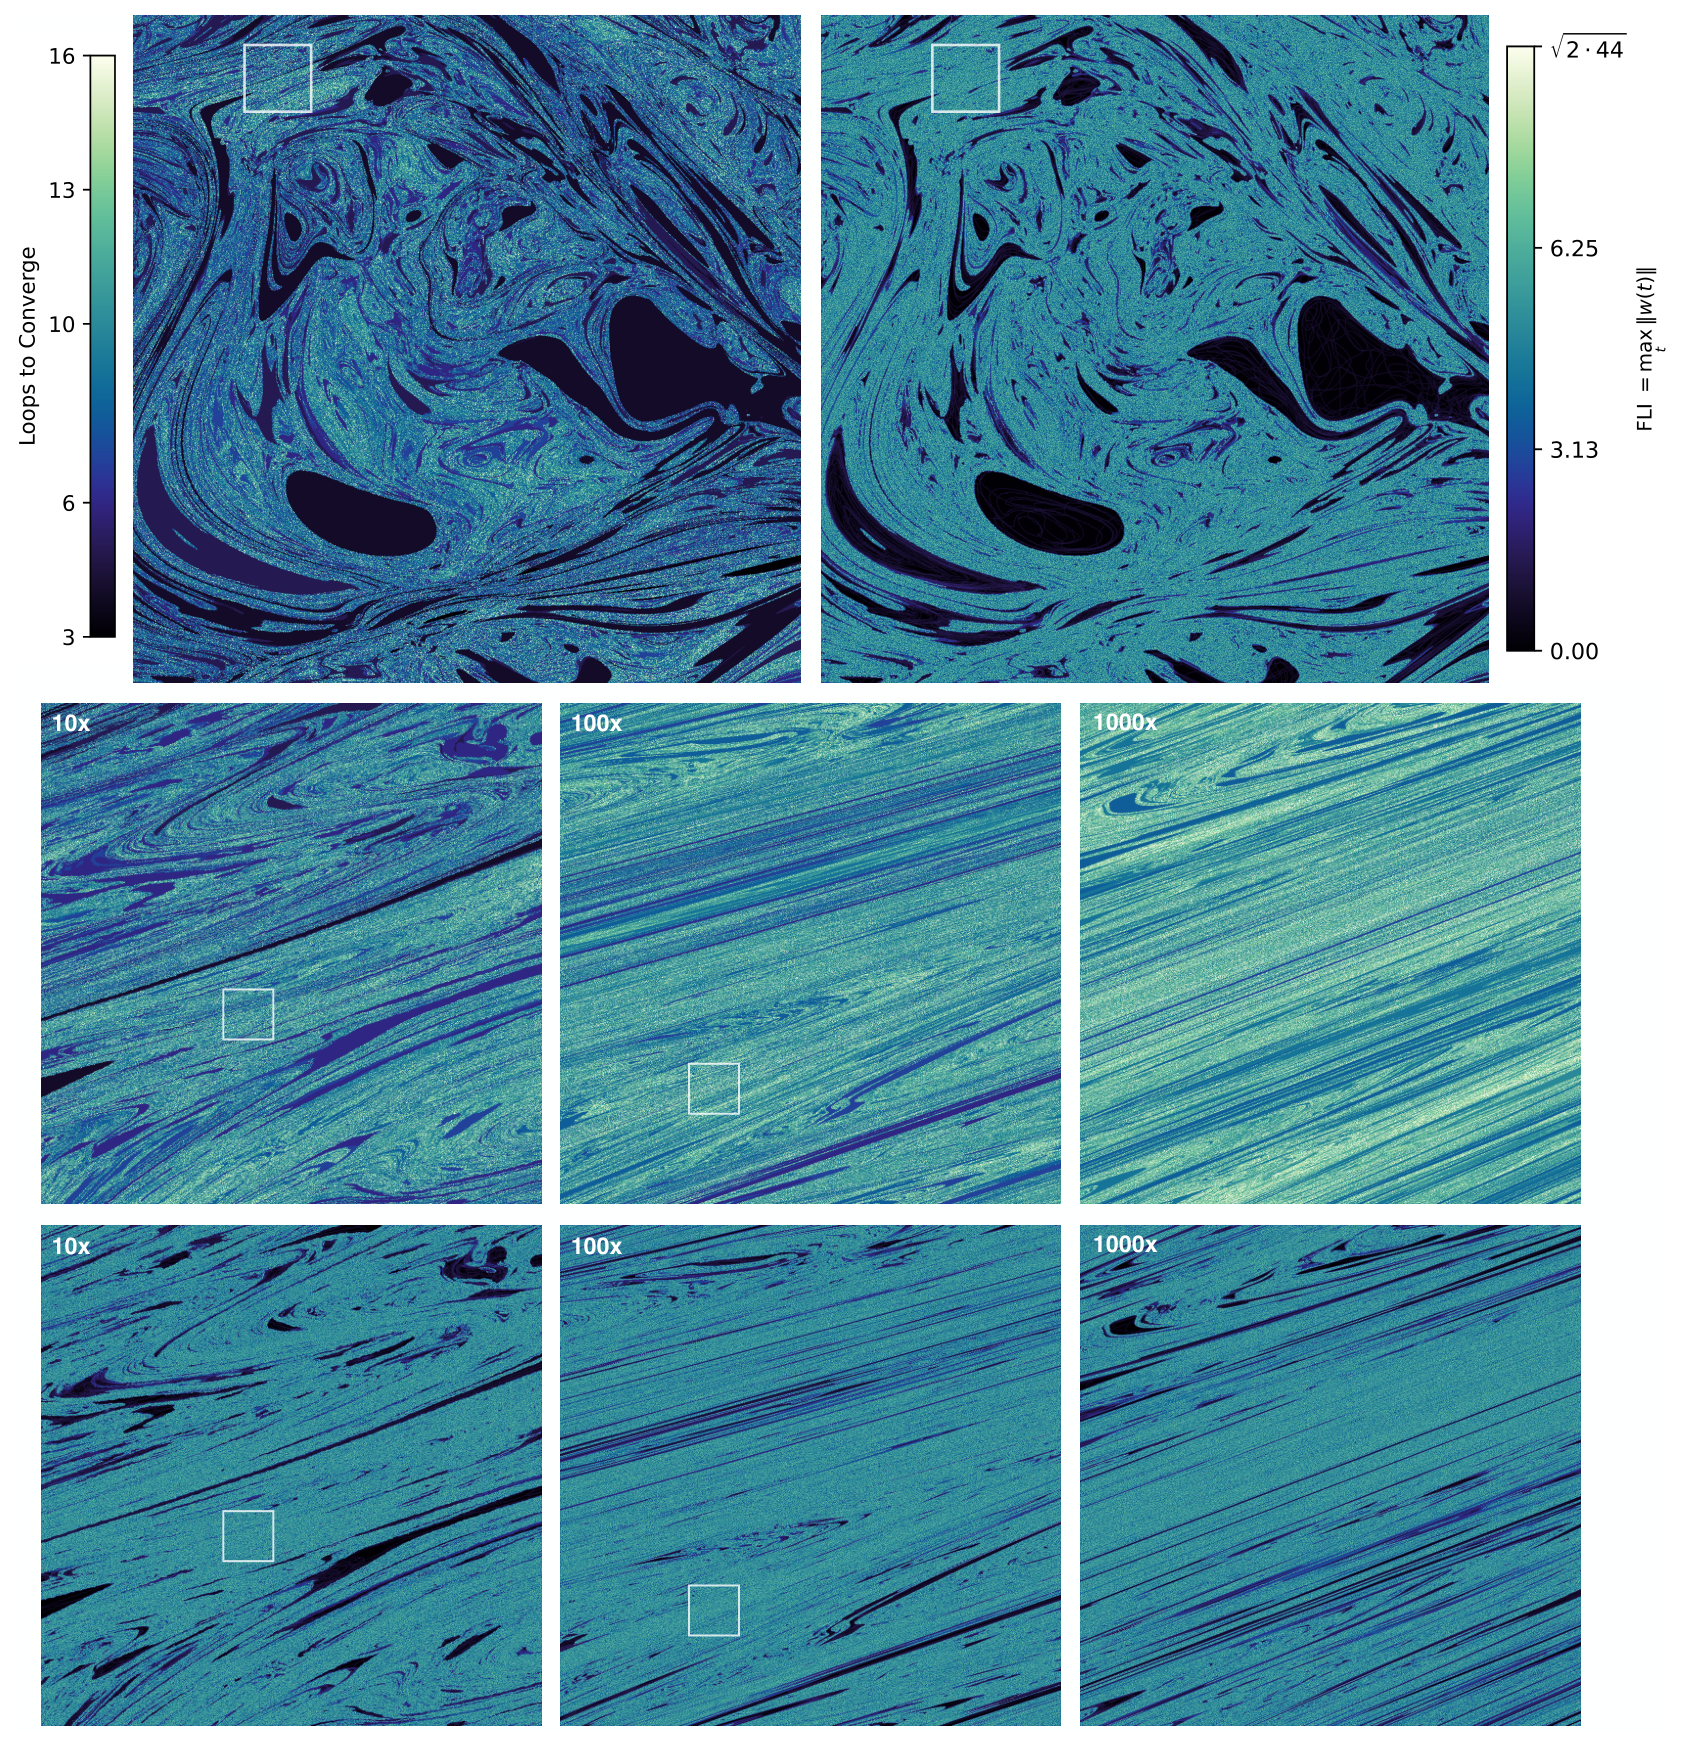
스도쿠를 푸는 추론 모델의 수렴 시간 지도를 단계적으로 확대한 여러 장의 패널. 확대할수록 같은 모양의 소용돌이 무늬가 계속 나타난다

Fractal basins trap latent reasoning

루프형 추론 모델의 초기 잠재 상태를 조금씩 옮겨 가며 수렴까지 걸린 루프 수를 지도로 칠하면, 어려운 문제일수록 그 지도가 프랙탈이 된다. 텍사스 오스틴 대학 연구진은 그 원인을 안장점 산란이 만드는 과도적 카오스로 설명하고, 추론이 느려지는 것이 문제 난이도에서 나오는 필연이라고 결론지었다.

September 9, 2026 · 8 분 · 서소영
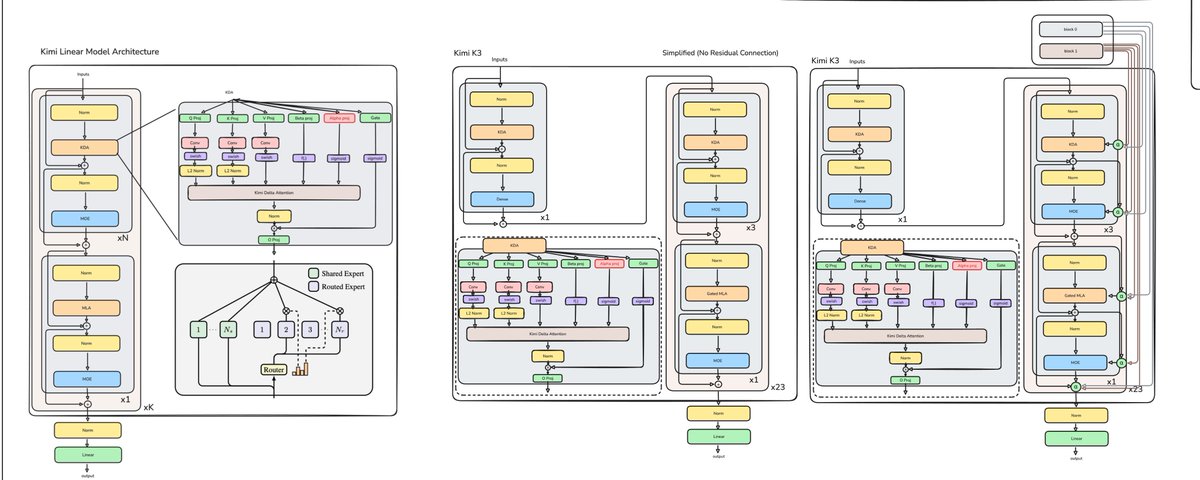
Kimi Linear(왼쪽)와 Kimi K3(가운데·오른쪽)의 전체 아키텍처. K3는 KDA 세 레이어 + MLA 한 레이어로 된 매크로사이클을 23번 쌓고, Gated MLA·잠재 MoE·AttnRes를 더한다.

22580: From GPT2 to Kimi3, Explained

GPT-2(2019)부터 Kimi K3(2026)까지 언어모델 아키텍처의 진화를 코드 구현 수준까지 추적한 워크로그. 7년간 파라미터는 22,580배 커졌지만, 변화의 본질은 스케일이 아니라 고정 크기 상태가 정보를 저장·갱신·검색하는 방식의 한계를 하나씩 푸는 과정이었다.

July 28, 2026 · 9 분 · 서소영
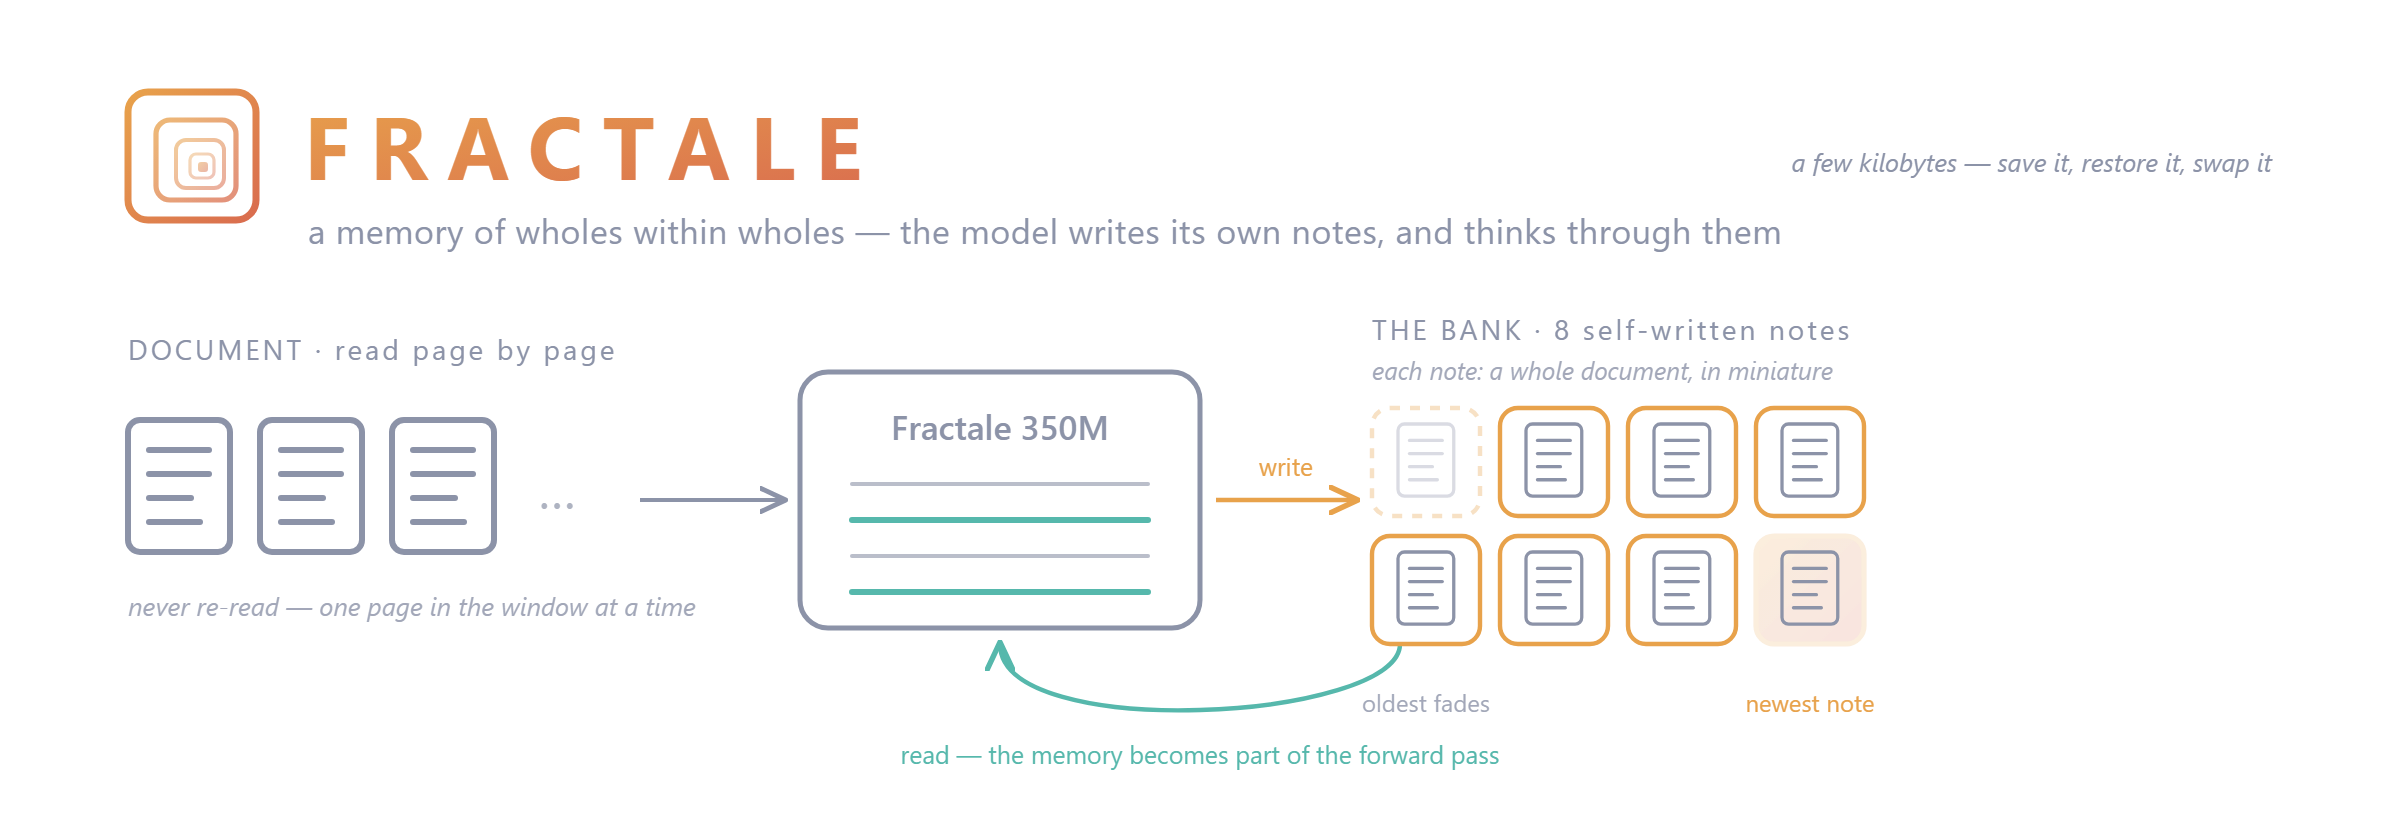
Fractale banner: 페이지를 한 장씩 읽고 8장의 자기 메모를 쓴 뒤 그 메모를 통과해 생각한다

Fractale-350M-base: 오직 8개의 fast-weight 슬롯으로 기억하는 386M LM

386M 파라미터 사전학습 모델 Fractale-350M-base는 8개의 fast-weight 슬롯을 유일한 장기 기억 채널로 삼는다. 컨텍스트 창 확장이나 추론시점 역전파와는 다른 세 번째 축을 겨눈다. 모델이 스스로 요약 벡터를 쓰고 하이퍼네트워크로 되읽는 학습된 메모리 정책을 386M 스케일에서 검증한 연구 아티팩트다.

July 22, 2026 · 7 분 · 서소영
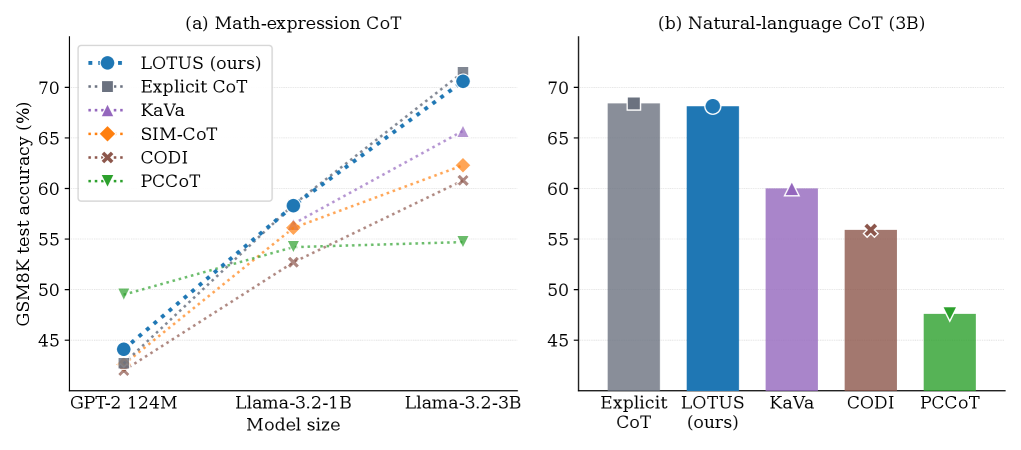
Figure 1 — LOTUS는 백본이 커져도 명시적 CoT의 정확도 상한을 따라간다

Bridging the Gap Between Latent and Explicit Reasoning with Looped Transformers

앞으로 에이전트는 생각을 굳이 말로 하지 않아도 될 수 있다. LOTUS 논문은 언어 모델의 추론을 사람이 읽는 문장이 아니라 모델 내부의 계산 상태에서 진행하는 방향이, 3B 규모에서 실제로 통한다는 첫 증거를 제시한다. Chain-of-Thought가 사라지는 미래가 성능·효율의 필연으로 다가온다.

July 21, 2026 · 6 분 · 서소영

Agents-A1-4B

상하이 AI 연구소 InternAgent 팀이 공개한 롱 호라이즌 에이전트 모델 Agents-A1의 4B dense 버전. ‘파라미터가 아니라 호라이즌을 키운다’는 기조로, 장기 궤적과 이종 에이전트 능력을 함께 스케일링해 작은 모델로 큰 모델급 성능에 닿는다.

July 20, 2026 · 5 분 · 서소영
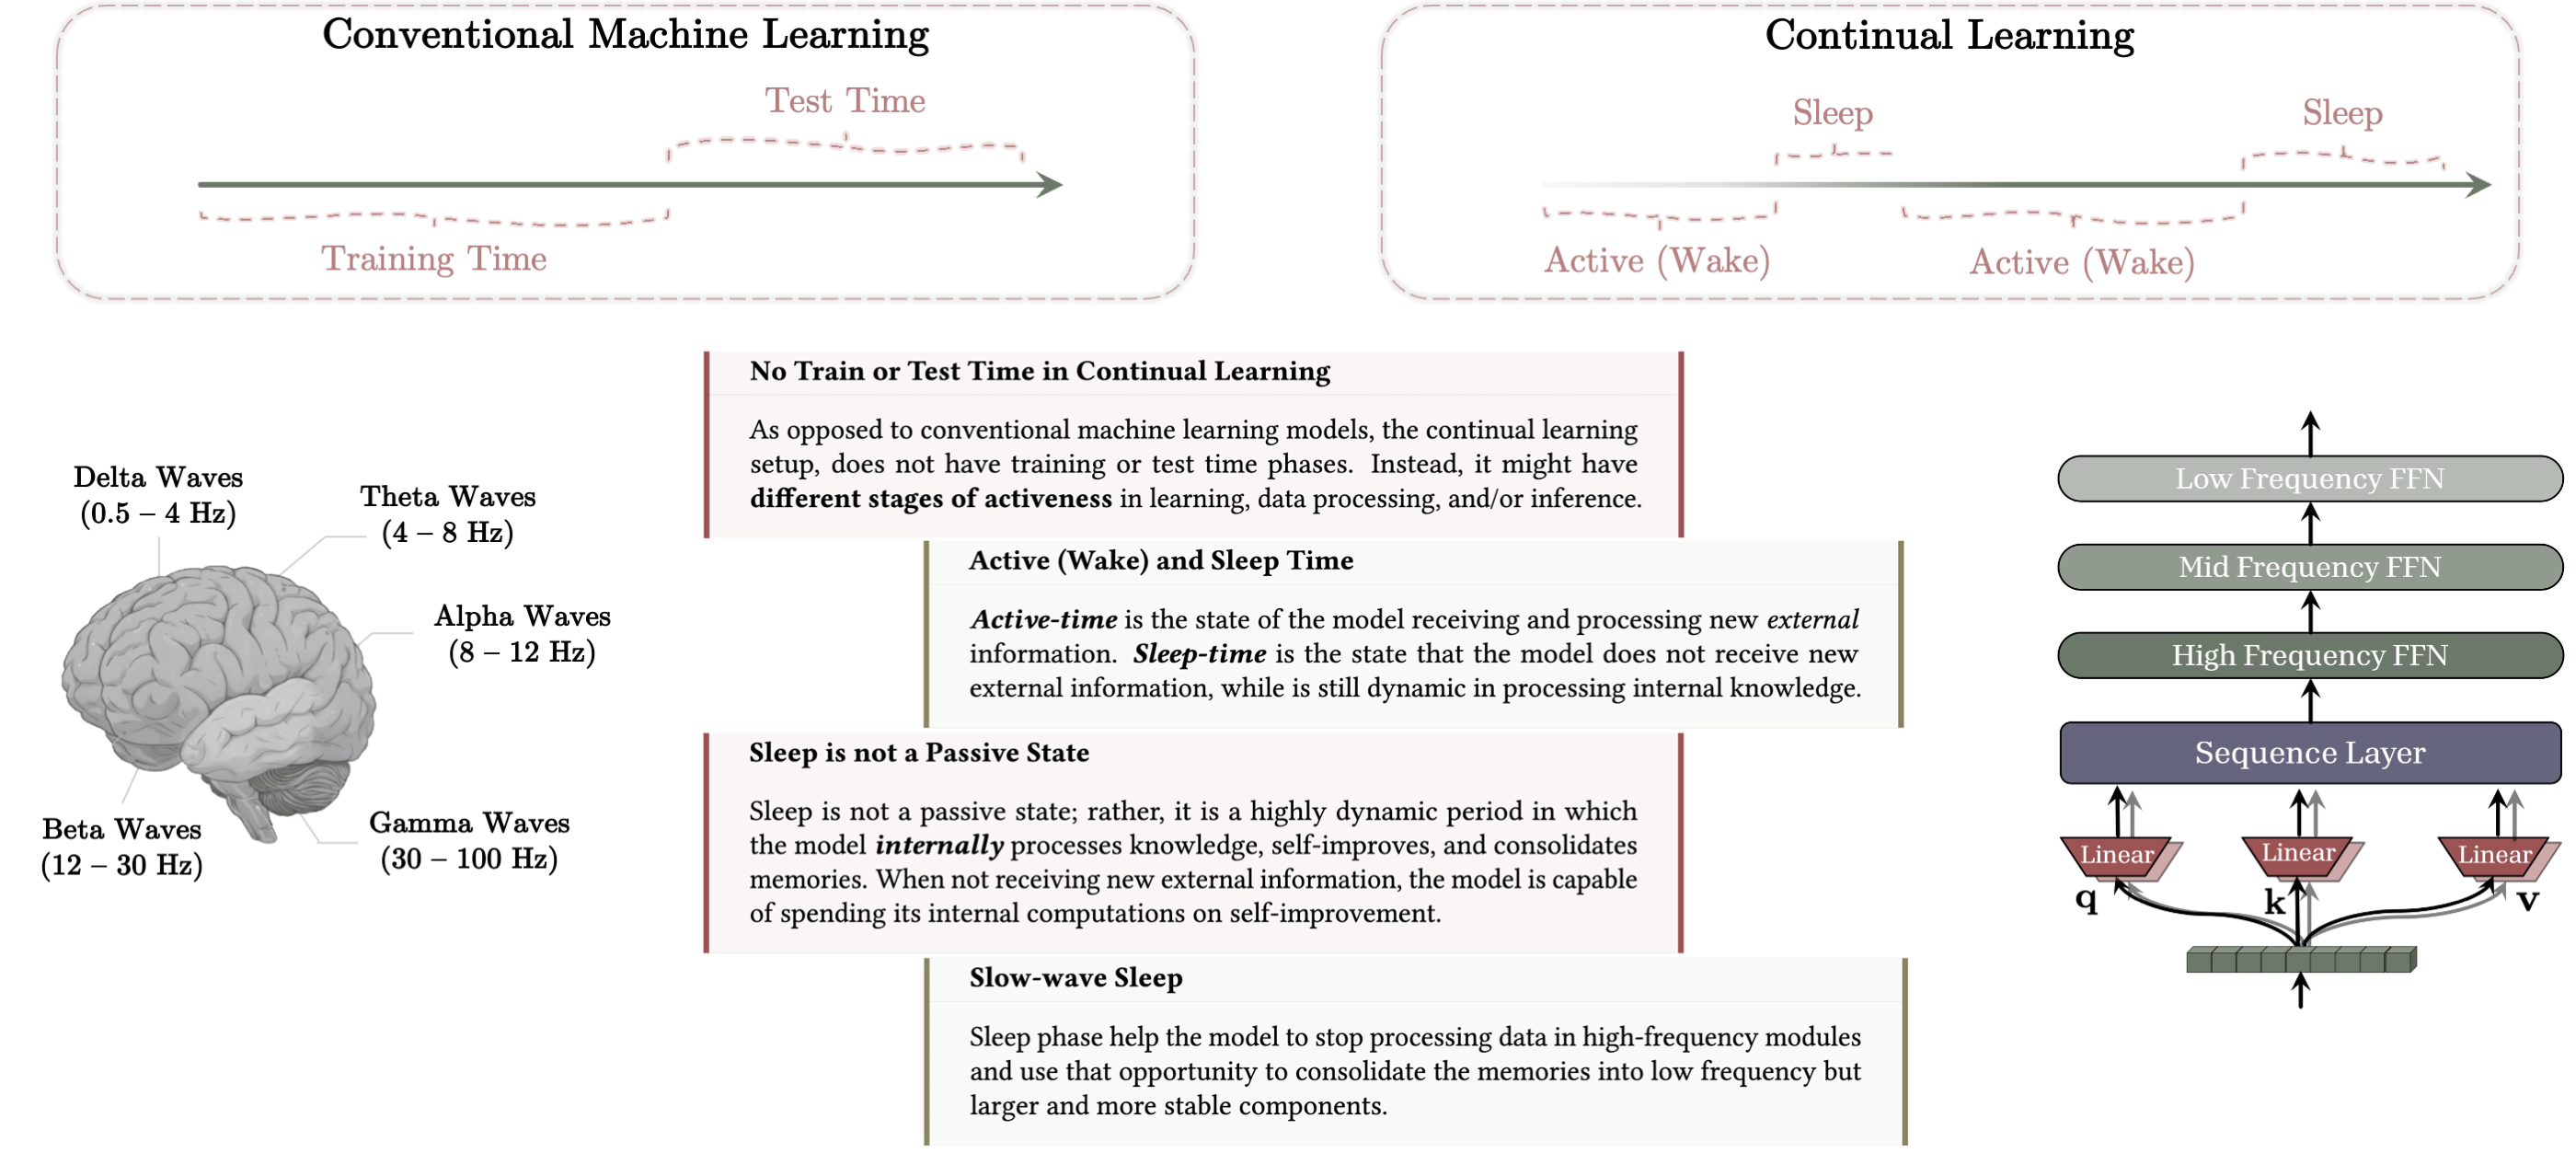
기존 머신러닝의 훈련·테스트 구분과 지속 학습의 각성·수면 주기

Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories

Google Research와 Cornell 연구진이 LLM의 생애를 학습·추론이 아니라 각성·수면으로 나눈다. 수면 중에는 빠르고 불안정한 기억을 느리고 안정적인 파라미터로 상향 증류하고, 합성 데이터를 꿈처럼 만들어 새 지식을 연습한다. 지속 학습·장문 이해·지식 편입·추상 추론에서 성능이 올랐지만, 추가 연산과 사전 할당 용량, 과제별 보상 신호가 필요한 개념 증명 단계다.

July 14, 2026 · 6 분 · 서소영

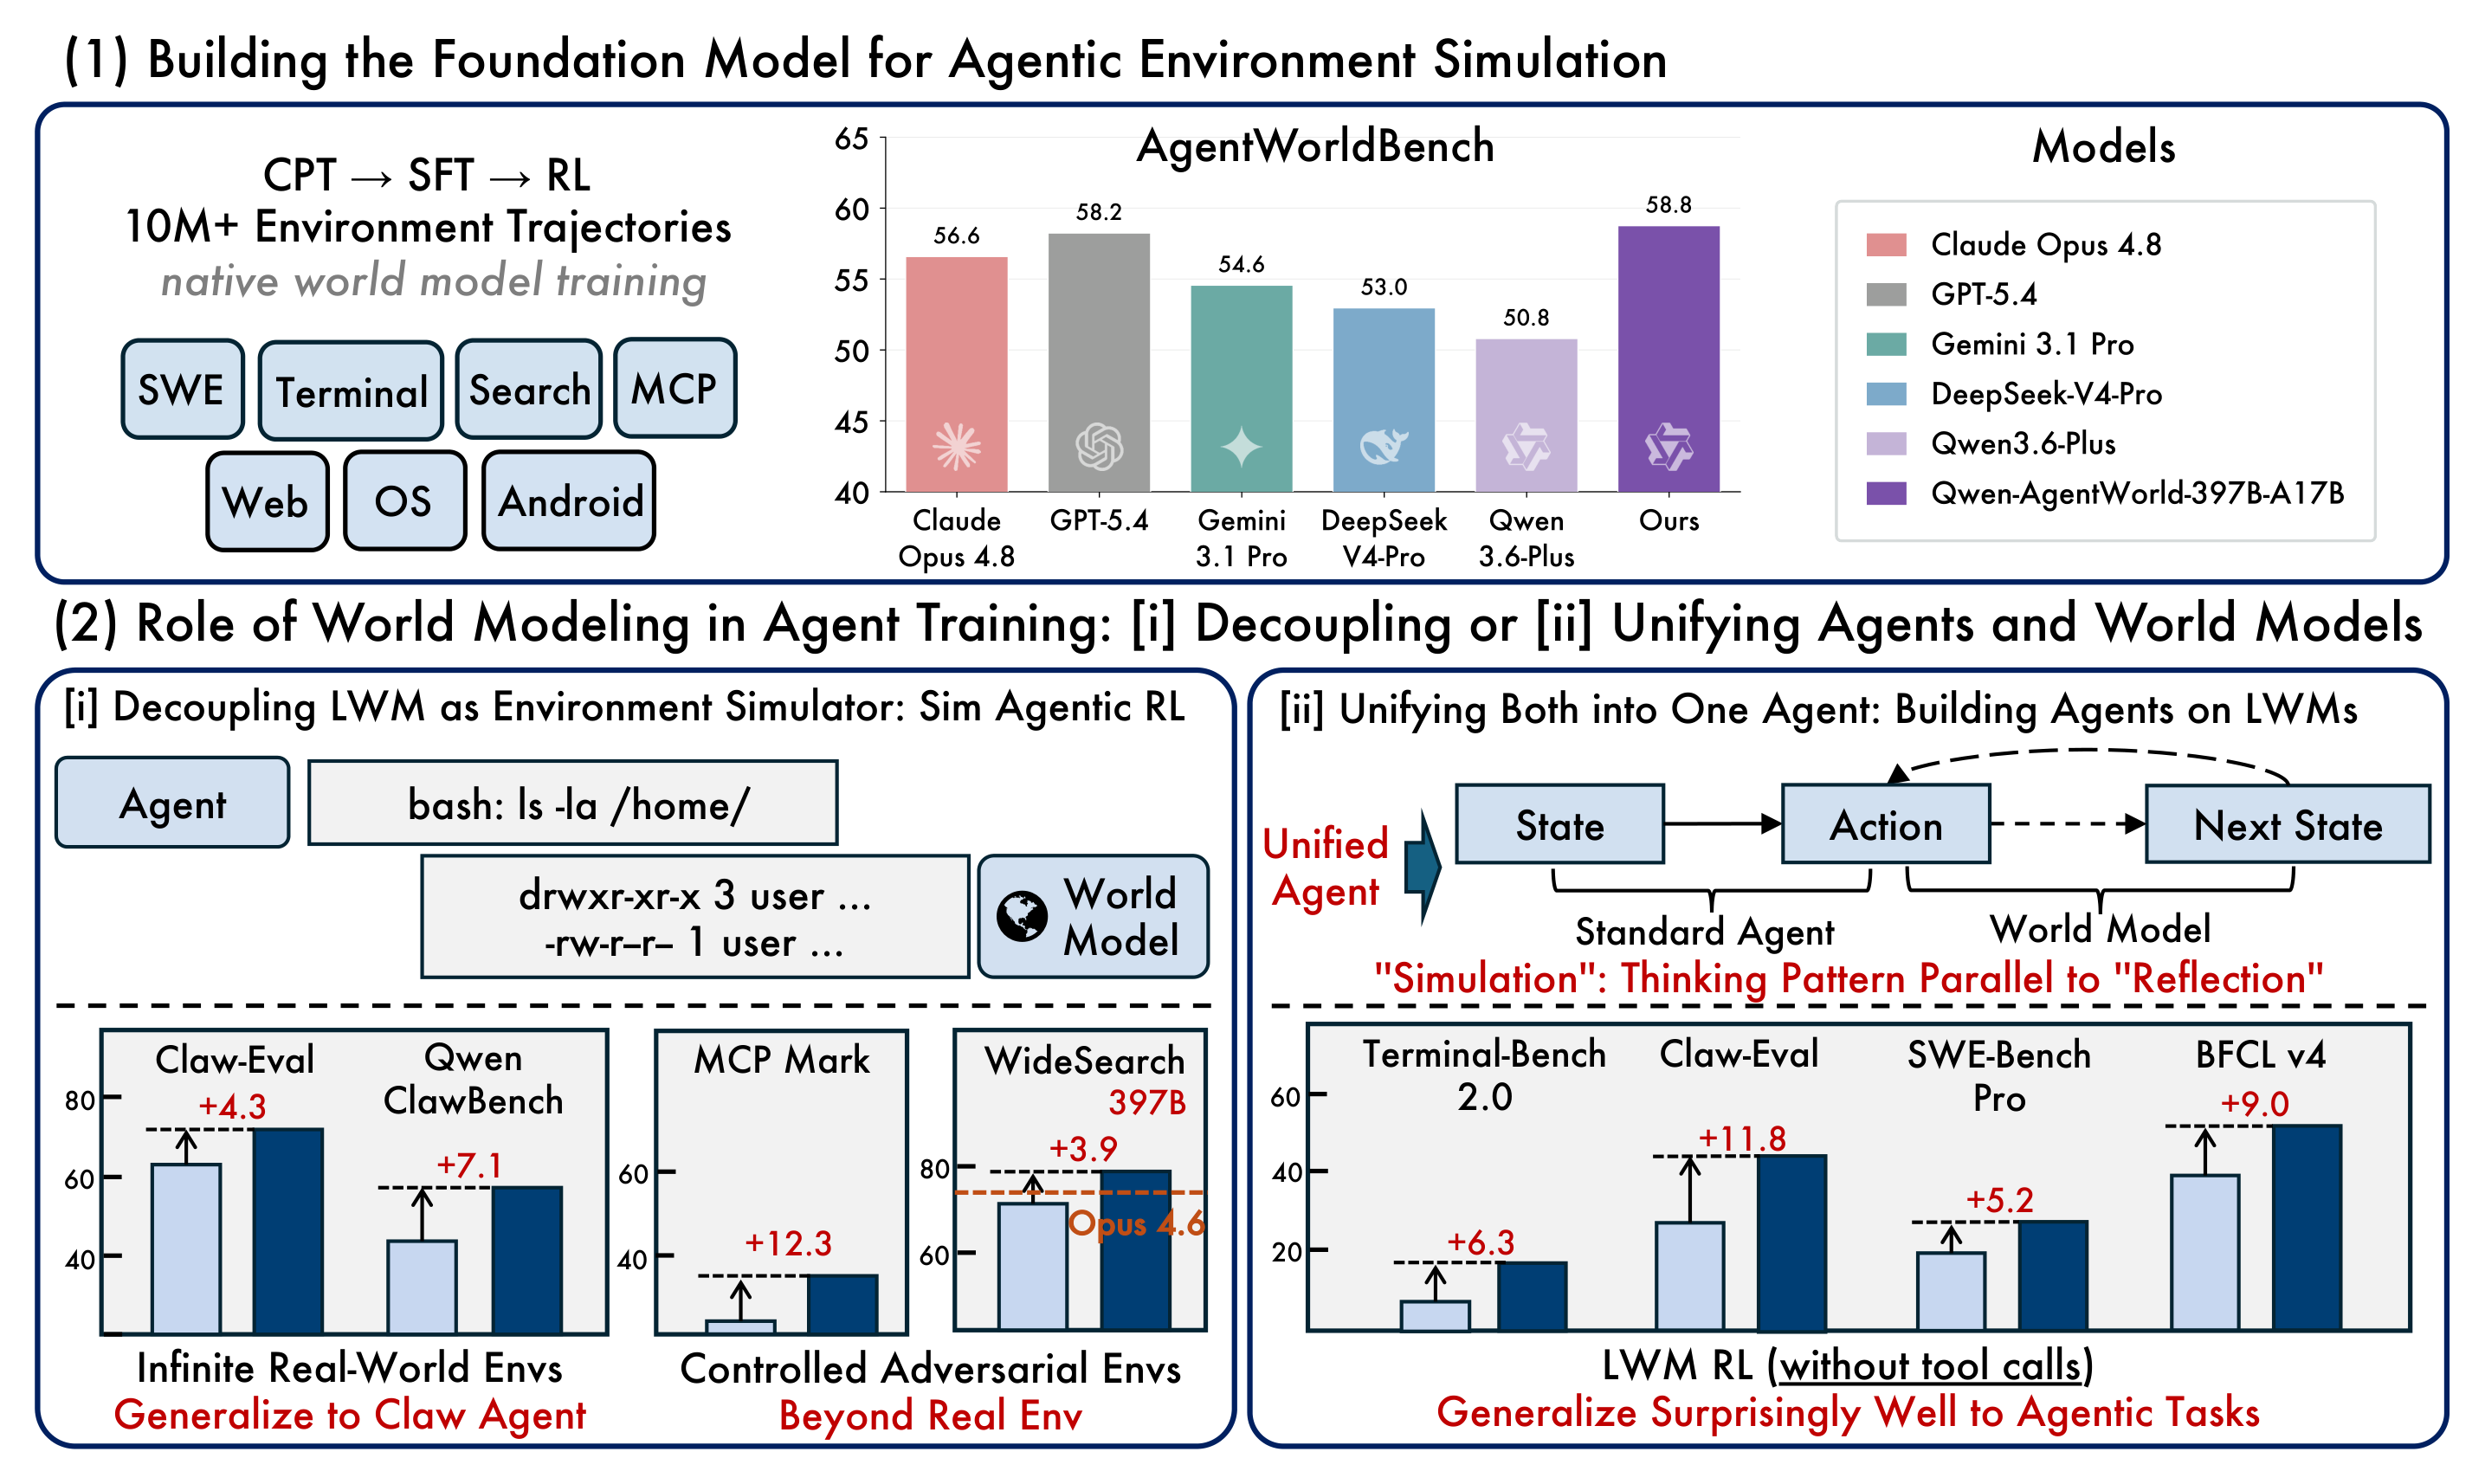
Qwen-AgentWorld: Language World Models for General Agents

Qwen 팀이 일곱 가지 에이전트 환경(MCP·Search·Terminal·SWE·Web·OS·Android)을 하나의 모델로 시뮬레이션하는 언어 월드 모델 Qwen-AgentWorld를 공개했다. CPT→SFT→RL 3단계로 훈련했고, 397B-A17B 모델이 GPT-5.4·Claude Opus 4.8·Gemini 3.1 Pro를 넘는 AgentWorldBench 성능과 함께 시뮬레이션 RL이 실제 환경 학습을 능가하는 결과를 보였다.

June 25, 2026 · 8 분 · 서소영
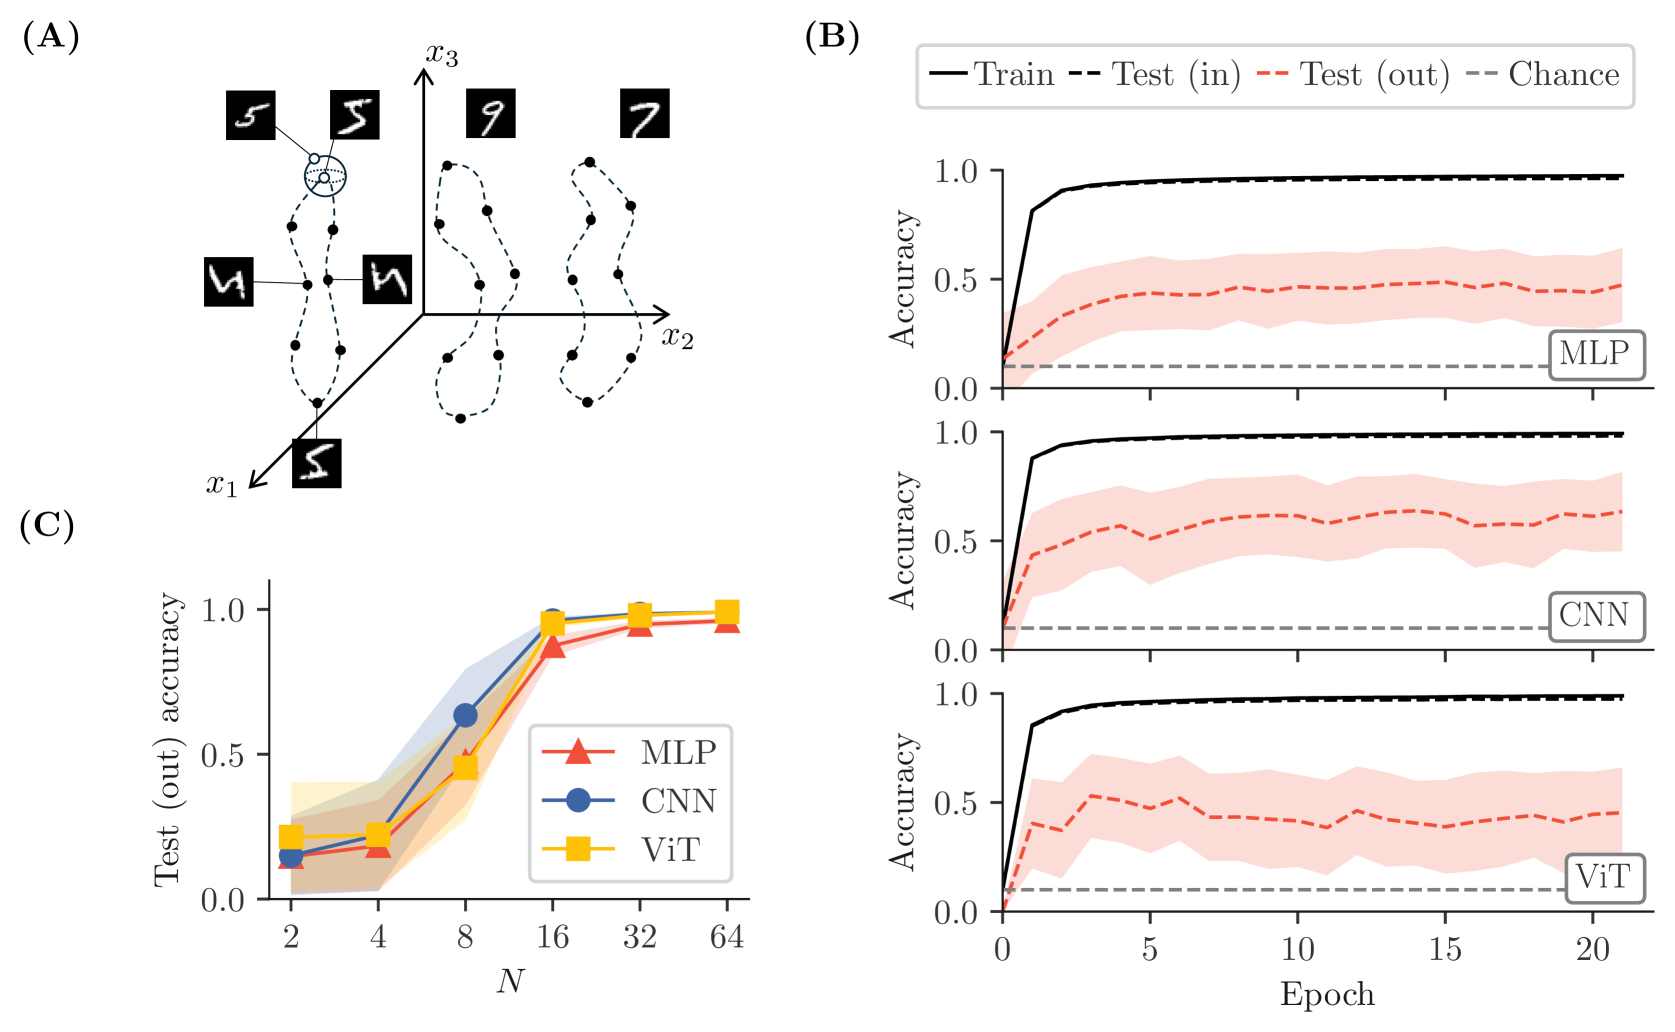
Figure 1: 학습 과제 설정과 표준 아키텍처의 실패

On the Ability of Deep Networks to Learn Symmetries from Data: A Neural Kernel Theory

Perin·Deny(Aalto, NeurIPS 2024 v2 2025-06)가 무한폭 NTK 한계에서 신경망의 대칭 학습 능력을 분석한 논문. 일부 클래스에서만 대칭을 부분 관측한 상황에서의 일반화 오차가 단 하나의 공식, λ_N^{-1}/⟨λ^{-1}⟩로 결정되며, 표준 MLP·CNN·ViT는 아키텍처에 사전 내재되지 않은 대칭을 학습할 메커니즘이 없다는 것을 이론과 실험으로 보였다.

June 9, 2026 · 6 분 · 서소영

From Code Foundation Models to Agents and Applications: A Comprehensive Survey and Practical Guide to Code Intelligence

BUAA·알리바바·바이트댄스·텐센트 등 71인 컨소시엄이 정리한 303페이지짜리 코드 LLM 종합 서베이 + 실무 가이드. 데이터 큐레이션부터 사전훈련·SFT·RL·자율 코딩 에이전트까지 전 생애주기를 훑고, 사전훈련·SFT·RL 각각에 대한 데이터 기반 권고안을 직접 실험으로 검증한다.

June 4, 2026 · 8 분 · 서소영