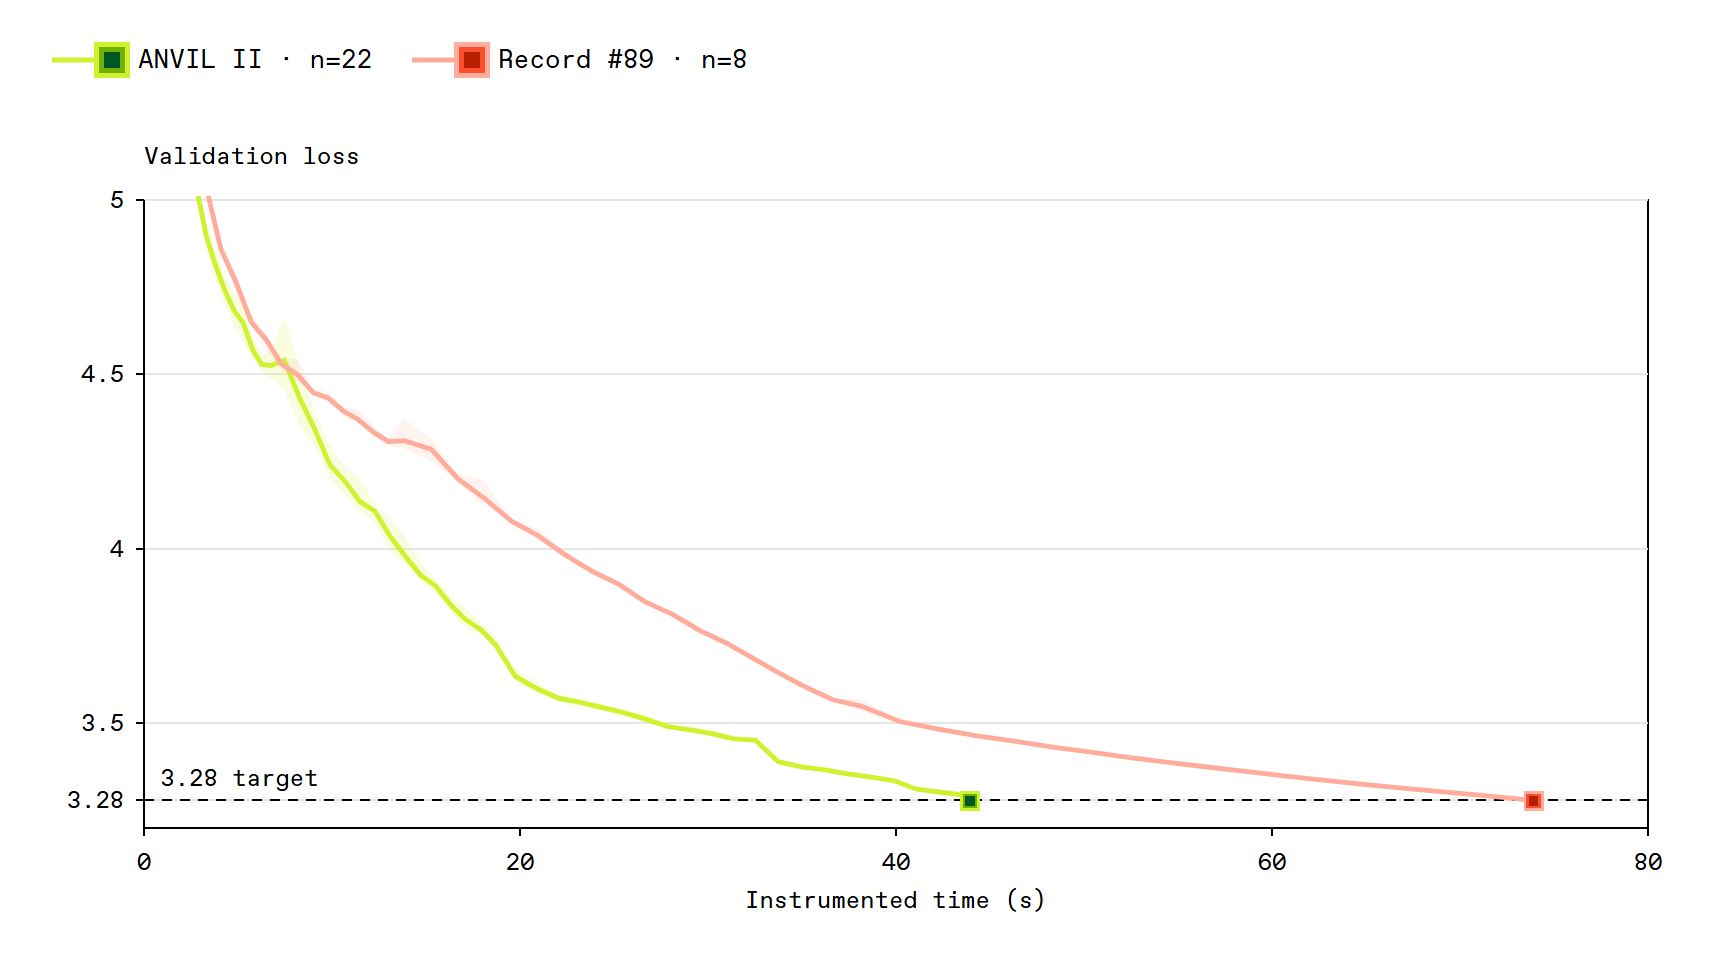
Training NanoGPT in 39.9 Seconds
Hyperstition의 Deven Pietrzak가 NanoGPT 스피드런 기록을 73.889초에서 39.914초로 46.0% 줄인 과정을 공개했다. 단축분의 대부분은 어휘 일부만 채점하는 샘플링 소프트맥스, 224배로 확장한 n-gram 표, 새 옵티마이저 ANVIL II에서 나왔다.
Hyperstition의 Deven Pietrzak가 NanoGPT 스피드런 기록을 73.889초에서 39.914초로 46.0% 줄인 과정을 공개했다. 단축분의 대부분은 어휘 일부만 채점하는 샘플링 소프트맥스, 224배로 확장한 n-gram 표, 새 옵티마이저 ANVIL II에서 나왔다.
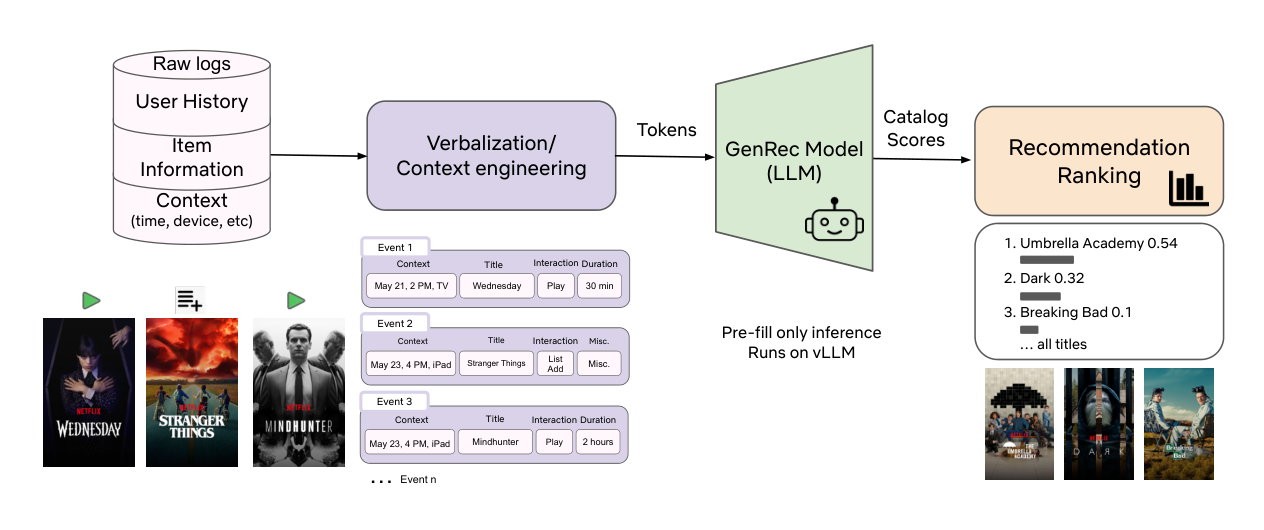
넷플릭스가 수천 개의 수작업 피처에 기반한 추천 랭커를 대체할 후보로 LLM 기반 랭커 GenRec을 만들고, 기존 랭커와 비교한 결과를 공개했다. GenRec은 시청 이력을 텍스트로 서술해 프리필 한 번으로 카탈로그 전체의 점수를 계산하며, 사후 학습 라벨을 40분의 1만 쓰고도 대규모 A/B 테스트에서 통계적으로 유의한 개선을 얻었다.
스탠퍼드대와 텔아비브대 등의 연구진이 자연 데이터를 경사 갱신에 한 번도 쓰지 않고 언어 모델을 사전학습하는 셀프 플레이 방법을 제안했다. 생성자 모델은 만능 튜링 기계용 프로그램을 짜고, 학습자 모델은 그 출력 바이트를 예측한다. 이렇게 학습한 모델의 텍스트, 이미지, 음악 제로샷 손실은 연산량이 늘수록 거듭제곱 법칙에 따라 줄었다.
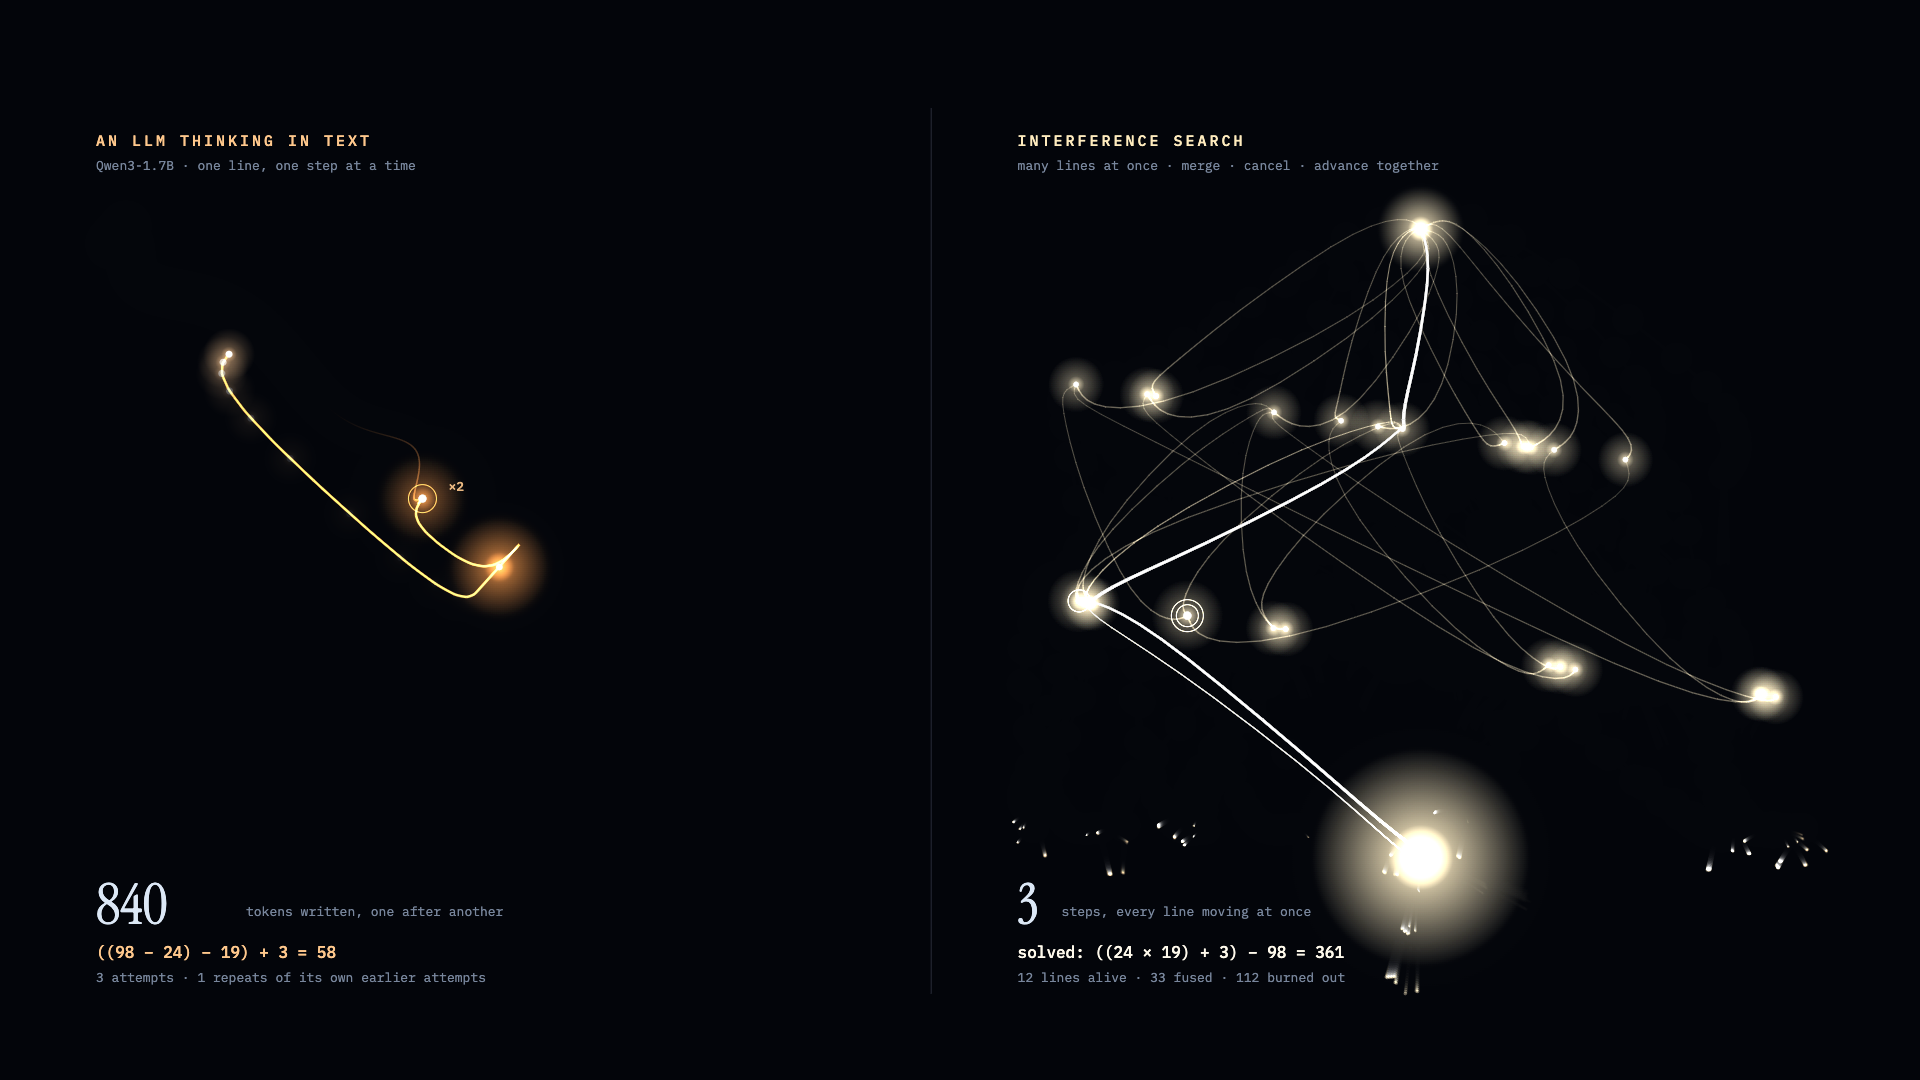
라고스(Lagos)에 있는 연구소 Bad Theory Labs가 언어 모델의 한 줄짜리 추론 대신 명시적 상태 위에서 여러 분기를 한꺼번에 전개하고, 같은 상태는 병합하고, 작은 판정기로 막다른 분기를 제거하는 탐색 방식을 공개했다. 어려운 카운트다운 30문제에서 같은 판정기와 같은 예산으로 단일 사슬은 21문제, 이 방식은 30문제를 풀었고, 필요한 순차 단계는 23.7에서 3으로 줄었다. 코드 과제에서는 차이가 잡음 수준이었고, 언어 모델을 학습시키는 일은 다음 단계로 남았다.
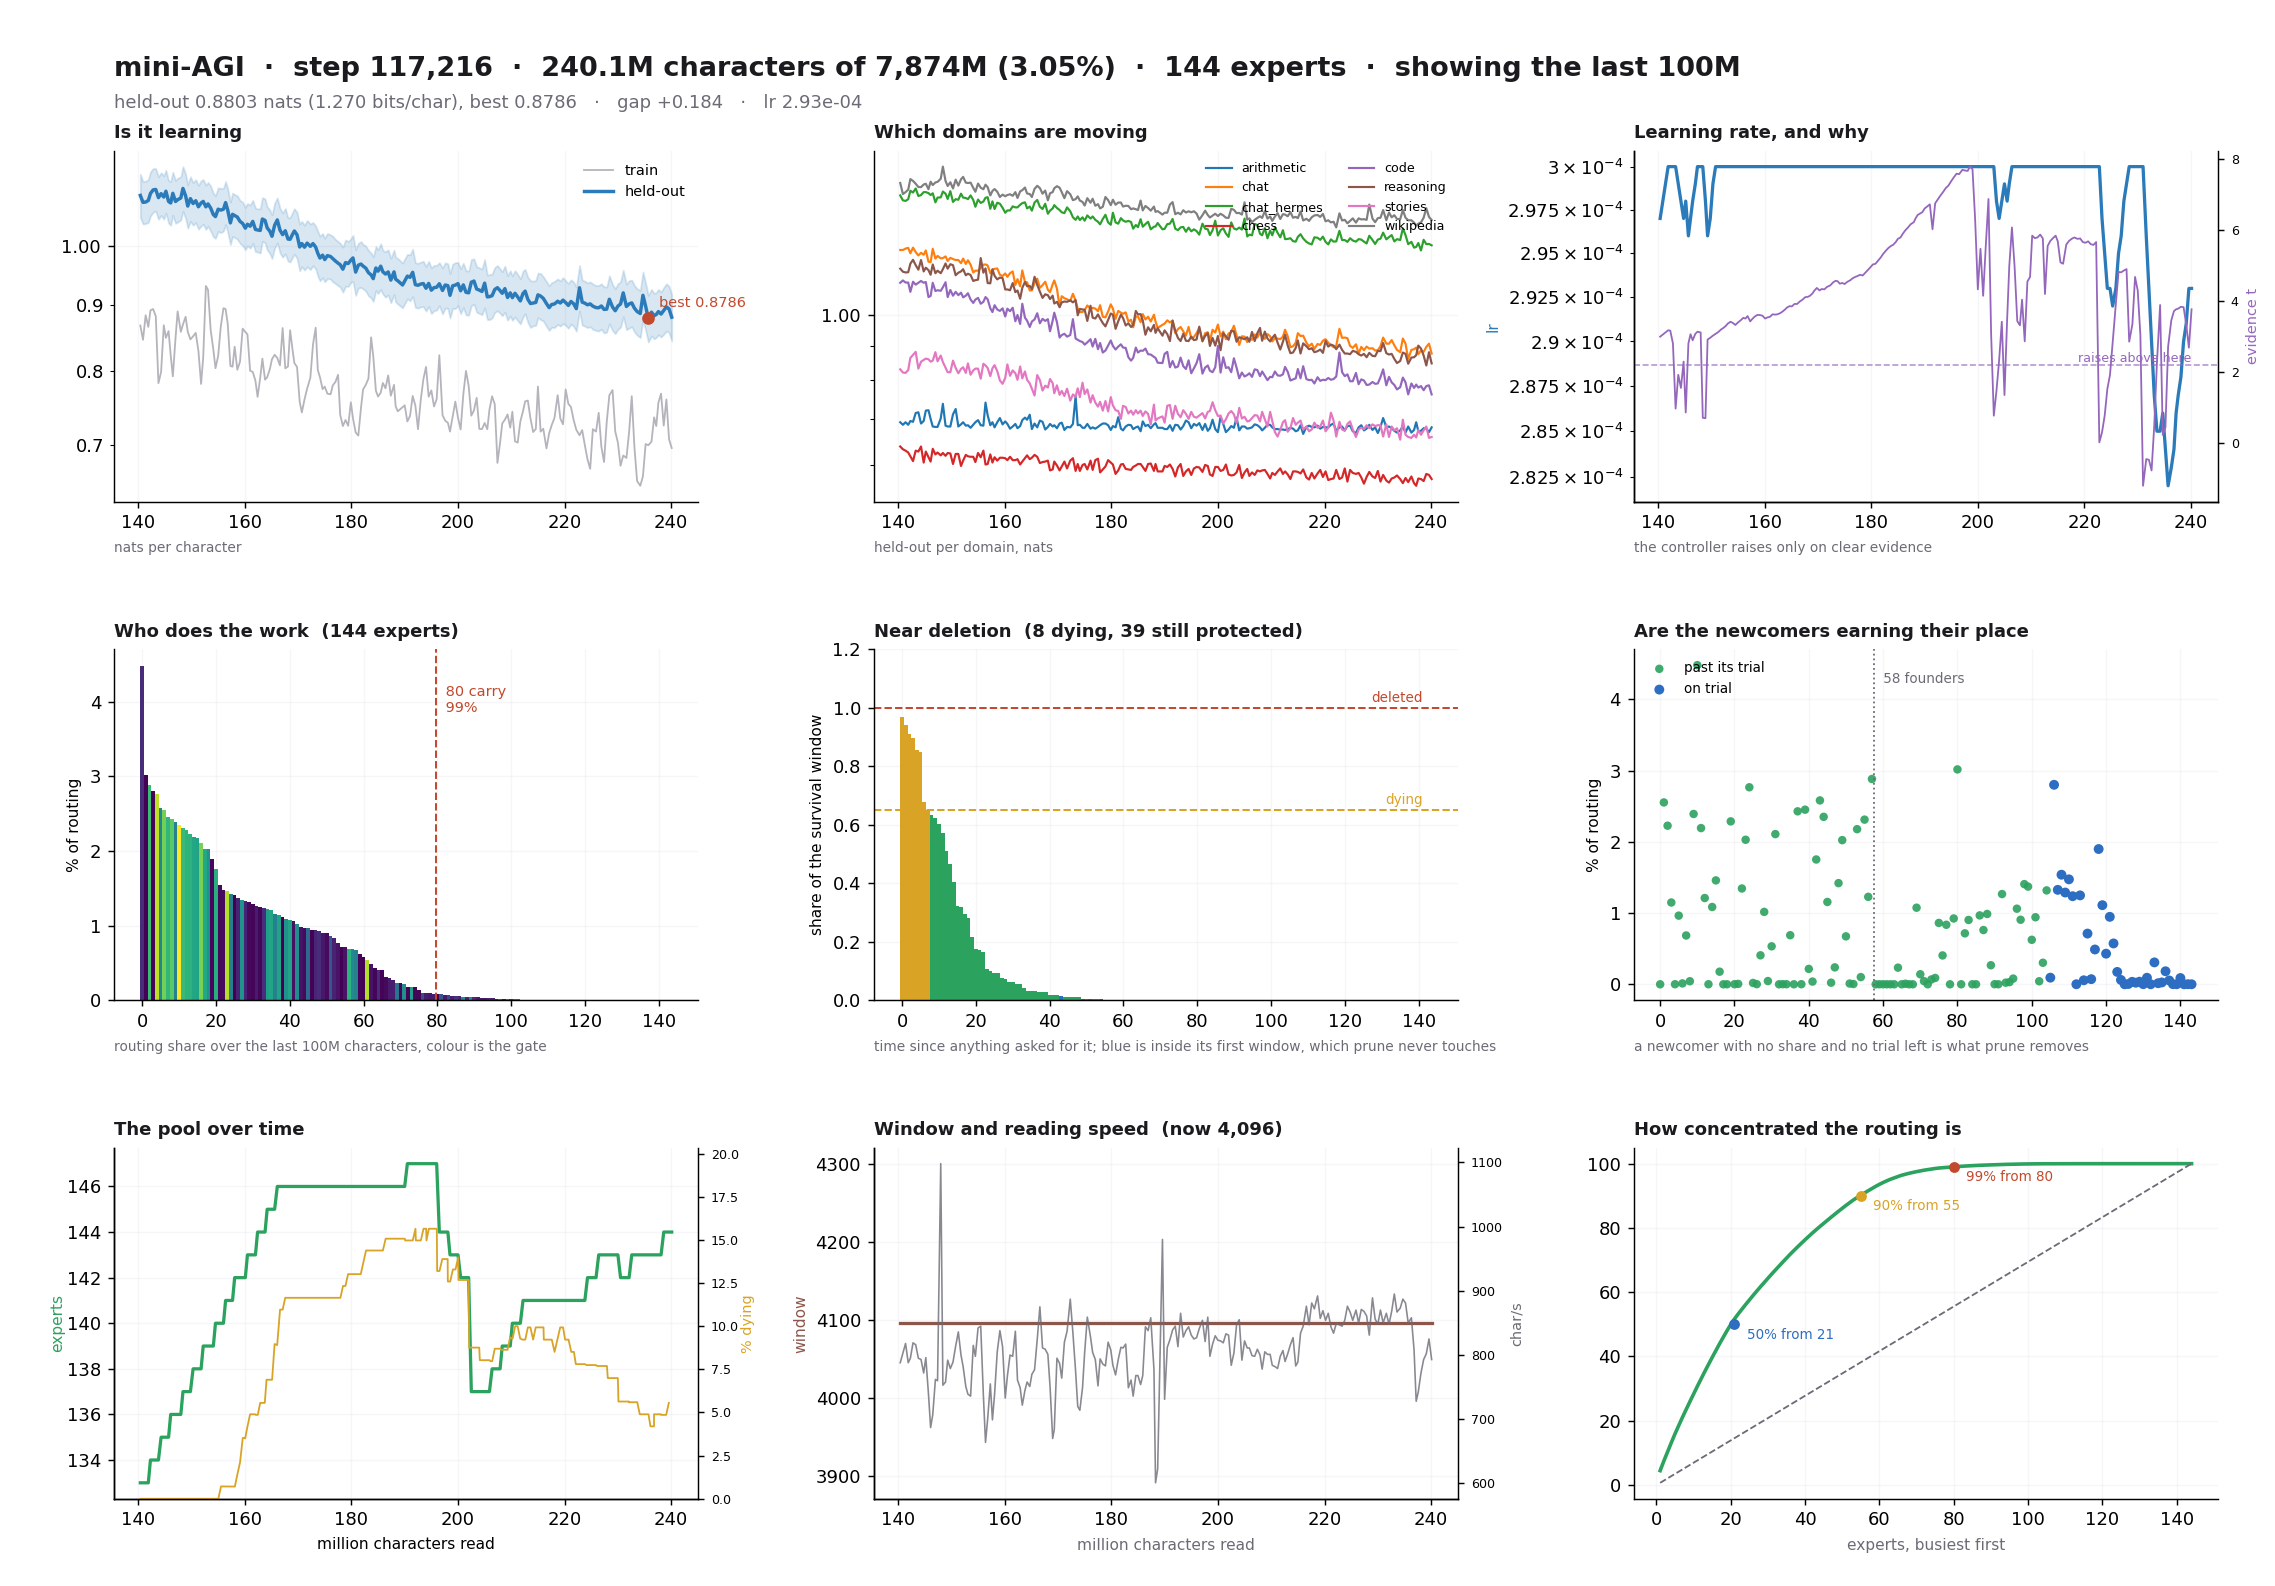
Alexey Borsky가 공개한 mini-AGI는 8GB VRAM GPU 한 장에서 처음부터 학습하고, 배치 1의 데이터 스트림을 읽는 동안 학습을 멈추지 않는 바이트 단위 언어 모델이다. 전문가 가중치를 디스크 파일로 저장해 필요한 것만 GPU에 적재하며, 저자의 실험에서 망각을 억제한 핵심 요인은 전문가 풀보다 트렁크 학습률을 10분의 1로 낮춘 설정이었다.
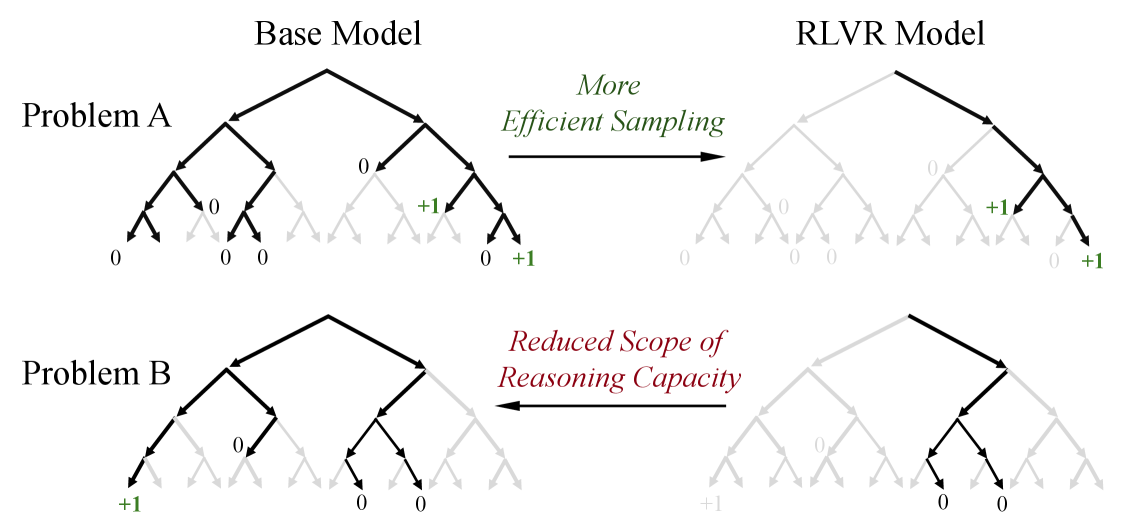
칭화대 LeapLab과 상하이교통대 연구진이 검증 가능한 보상 기반 강화학습(RLVR)의 효과를 pass@k로 다시 측정한 논문. k가 작을 때는 RLVR 모델이 앞서지만 k를 키우면 베이스 모델이 역전하며, RLVR이 쓰는 추론 경로는 이미 베이스 모델의 분포 안에 들어 있었다.
4B 오픈웨이트 모델을 오프폴리시 증류와 에이전틱 RL로 후학습시켜 Postgres의 기본 쿼리 플랜보다 빠른 플랜을 만들게 한 개인 실험 기록이다. 조인 순서 벤치마크 113개 질의에서 기하평균 1.81배 speedup을 얻었고, 들어간 돈은 모두 1,200달러였다.
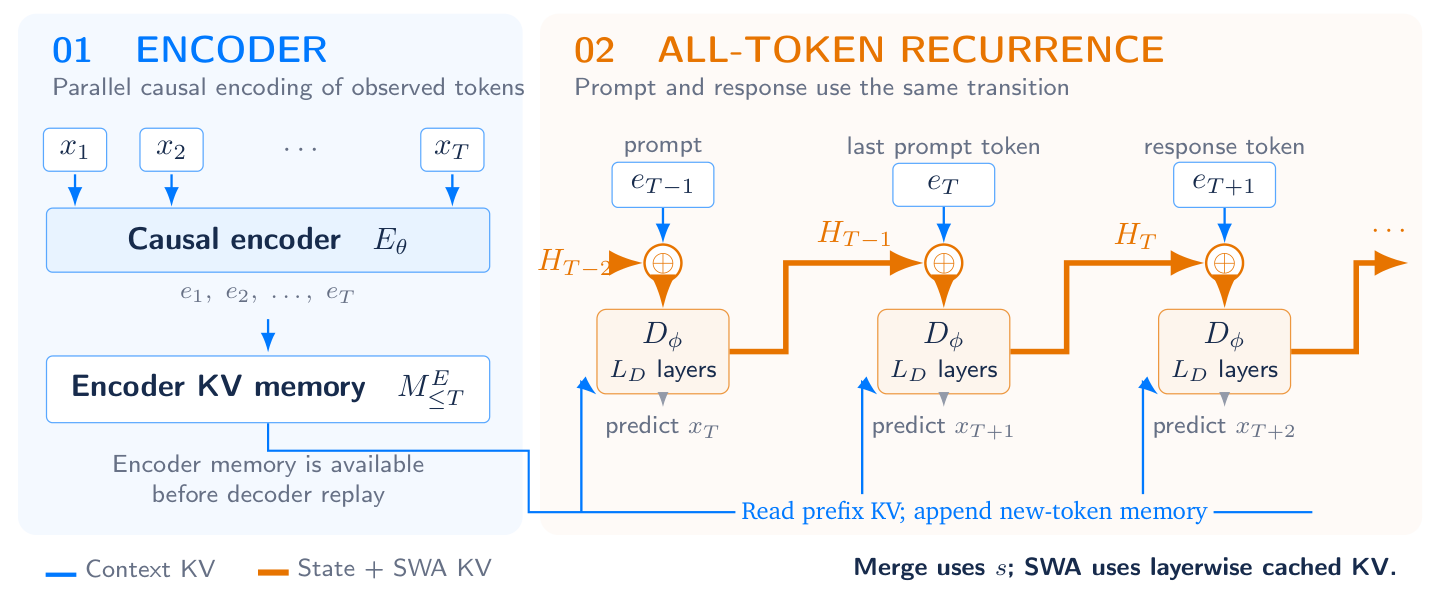
인과적 인코더가 전역 메모리를 만들고, 재귀 디코더가 프롬프트와 응답의 모든 토큰을 지나며 하나의 상태를 이어간다. 학습과 샘플링과 강화학습 리플레이가 같은 전이를 쓰도록 설계했고, 측정된 성능 수치는 아직 한 줄도 없다.
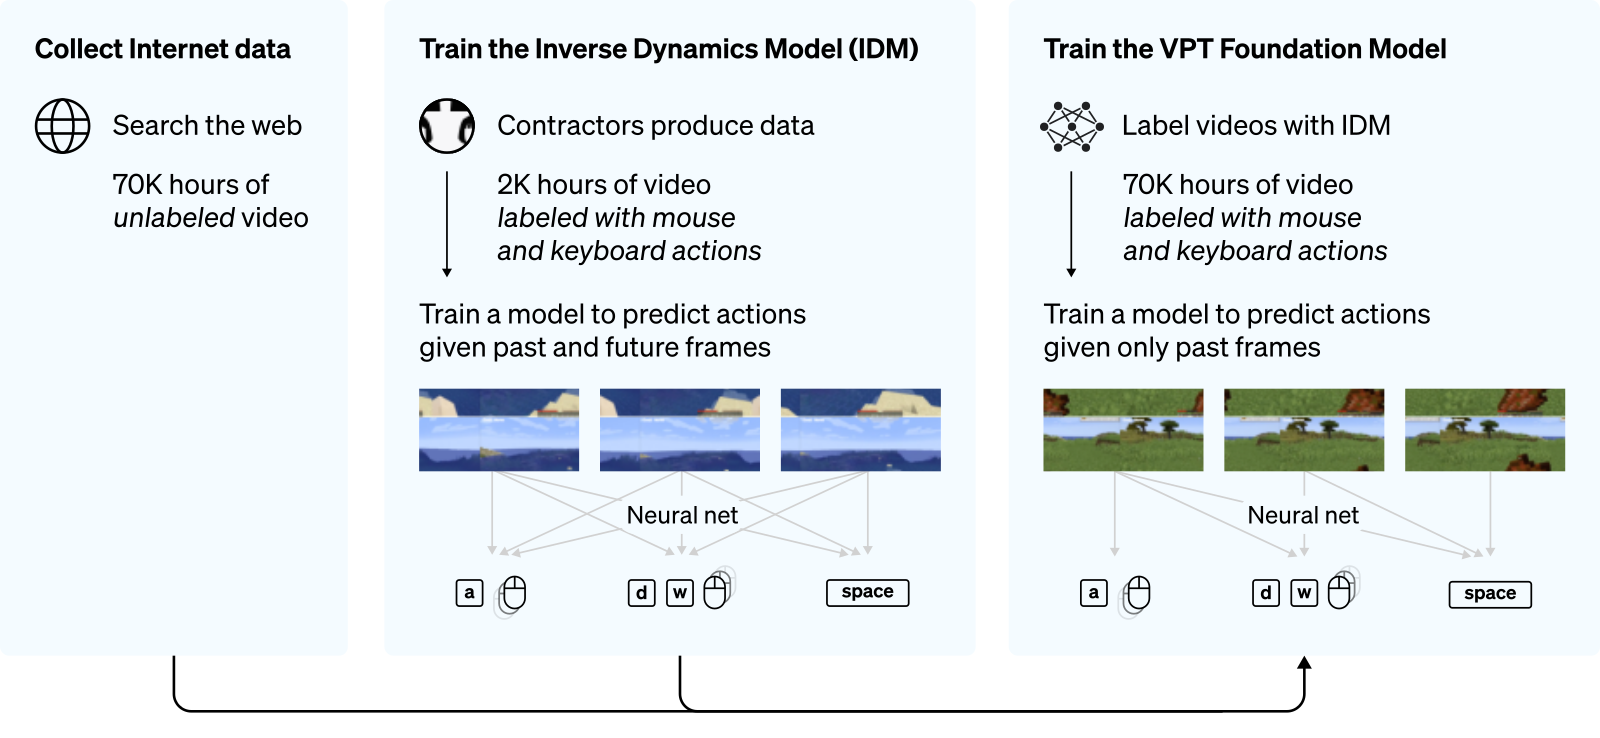
OpenAI 연구진은 행동 라벨이 없는 마인크래프트 플레이 영상 7만 시간에 역동역학 모델로 의사 라벨을 달았다. 이어 이 데이터로 행동을 사전학습하고 강화학습으로 미세조정해, 다이아몬드 곡괭이를 만드는 에이전트를 처음 보고했다.
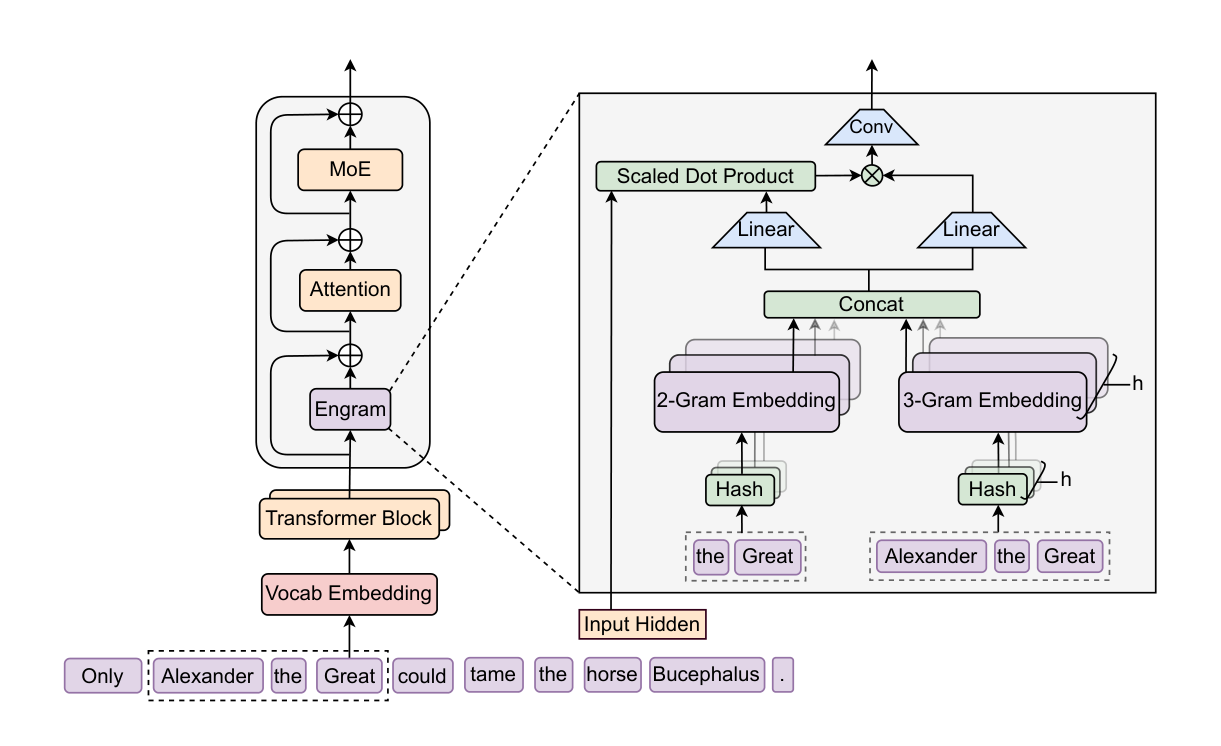
트랜스포머에는 지식을 찾아오는 전용 연산이 없어서, 고정된 사전 항목 하나를 꺼낼 때도 여러 층을 써서 계산으로 다시 만들어 낸다. DeepSeek과 베이징대 연구진은 그 자리에 N그램 임베딩 표를 되살려 넣고, MoE 전문가와 메모리 사이에 희소 용량을 어떻게 나눌지 재어 보았다.