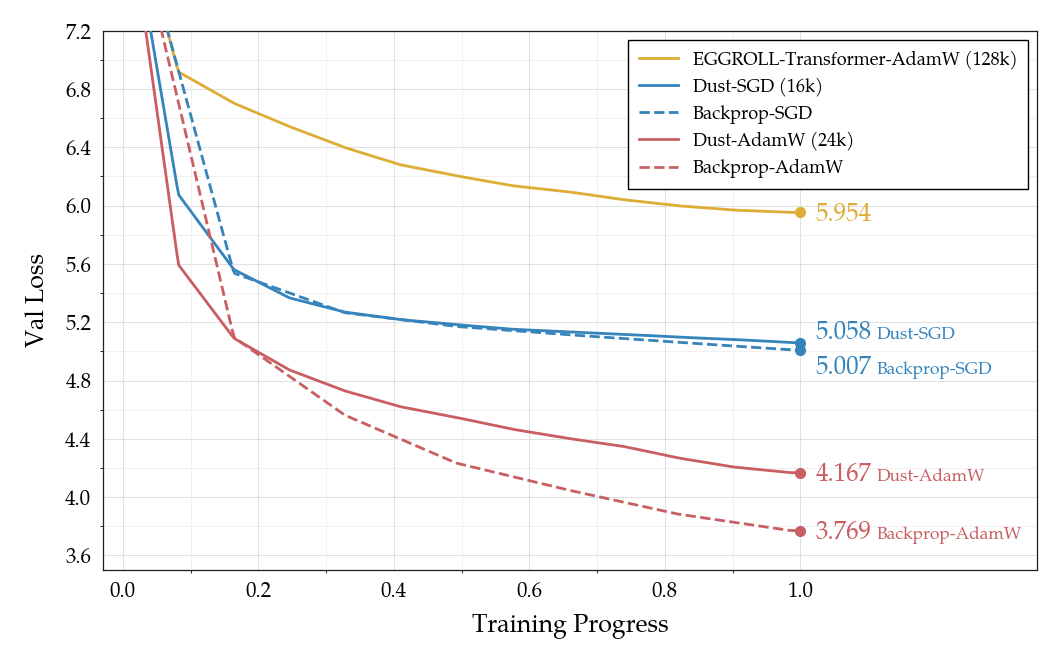
3,770만 파라미터 GPT를 1,000만 토큰으로 1에폭 사전학습할 때의 검증 손실 곡선. SGD에서는 Dust(5.058)가 역전파(5.007)와 대등하고, AdamW에서는 EGGROLL(5.954)보다 크게 낮지만 역전파(3.769)보다는 높은 4.167을 기록한다.

Noise: Speedrun for pretraining without backpropagation

딥러닝 연구소 Q Labs가 역전파와 자동 미분을 일절 사용하지 않고 3,770만 파라미터 GPT를 사전학습하는 스피드런 벤치마크 Noise를 공개했다. 자체 알고리즘 Dust는 활성화값에 토큰별 노이즈를 주입하며 검증 손실 4.167과 학습 시간 1.76시간을 기록했다. 이후 오픈소스 커뮤니티가 열흘 만에 목표 손실 4.2 도달 시간을 1.6초로 4,010배 단축했고, 1에폭 최저 검증 손실도 3.676까지 낮춰 Adam 역전파 기준선인 3.769보다 우수한 성적을 기록했다.
October 23, 2026 · 13 분 · 서소영
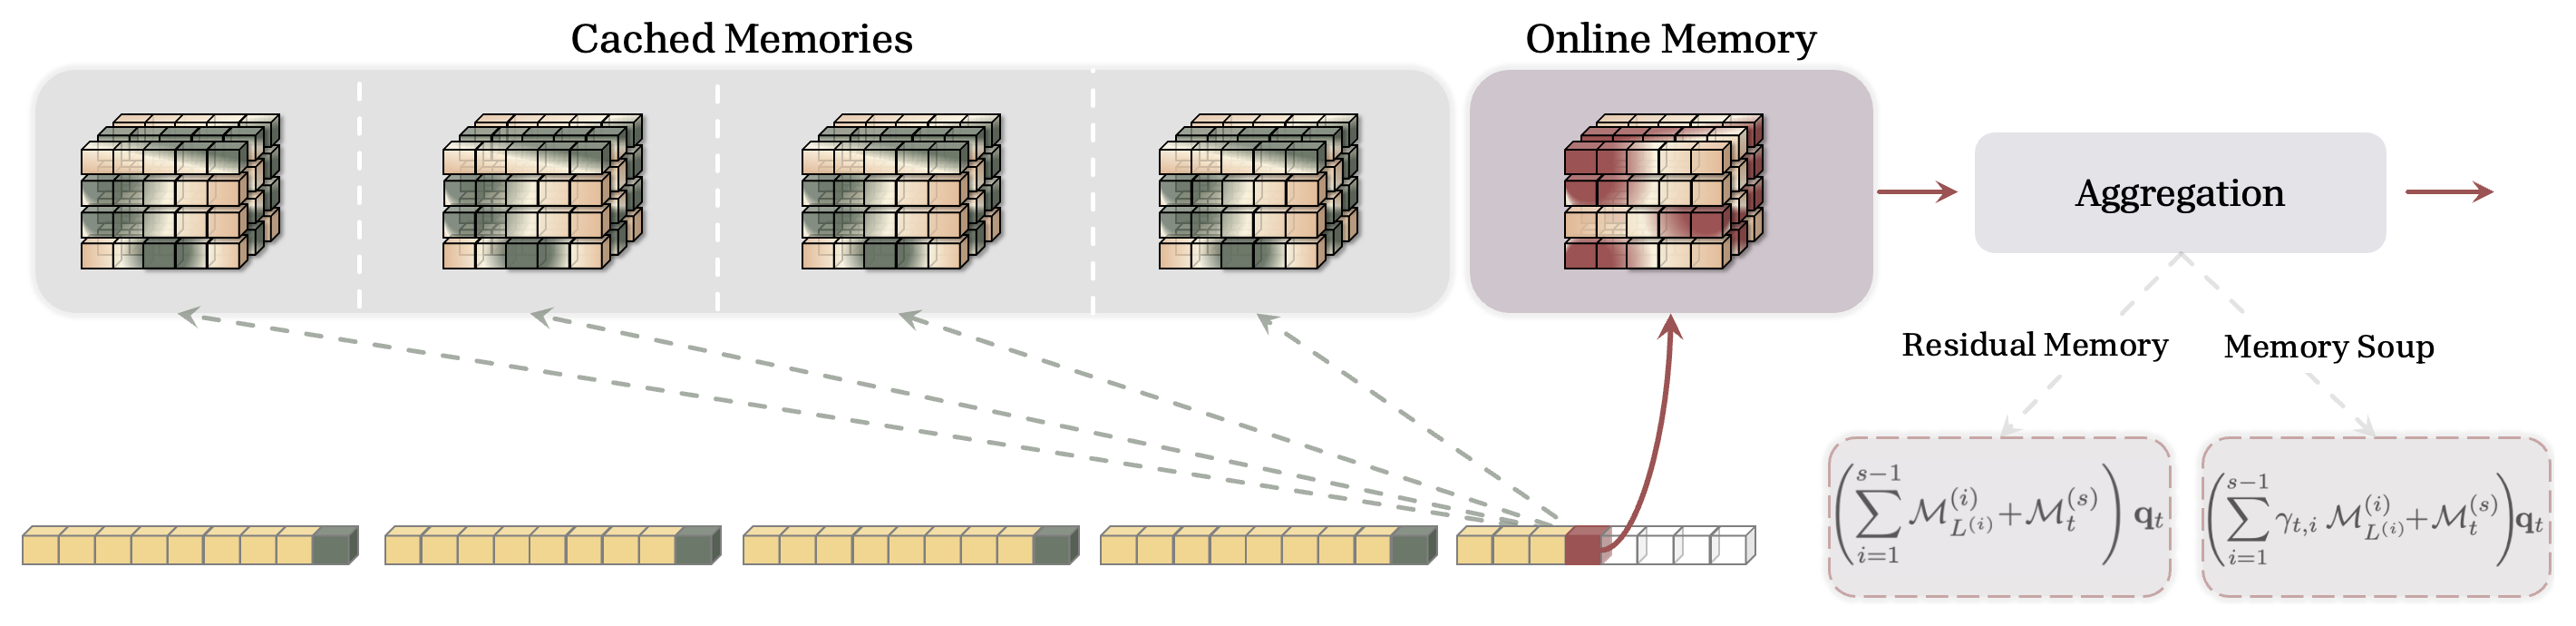
Memory Caching의 전체 구조를 나타낸 도식. 각 토큰이 현재 세그먼트의 온라인 메모리와 함께 과거 세그먼트들에서 캐싱된 메모리 체크포인트들을 동시에 참조해 출력을 계산한다.

Memory Caching: RNNs with Growing Memory

구글 리서치 연구진이 순환 신경망의 유효 메모리 용량을 시퀀스 길이에 맞춰 늘리는 Memory Caching(MC)을 제안했다. 시퀀스를 여러 세그먼트로 분할하고 세그먼트별 은닉 상태 체크포인트를 캐싱하는 방식으로, 선형 복잡도인 RNN과 이차 복잡도인 트랜스포머 사이를 보간하며 언어 모델링과 장문 인출 과제에서 SWLA, DLA, Titans의 성적을 전반적으로 높였다.

October 21, 2026 · 21 분 · 서소영
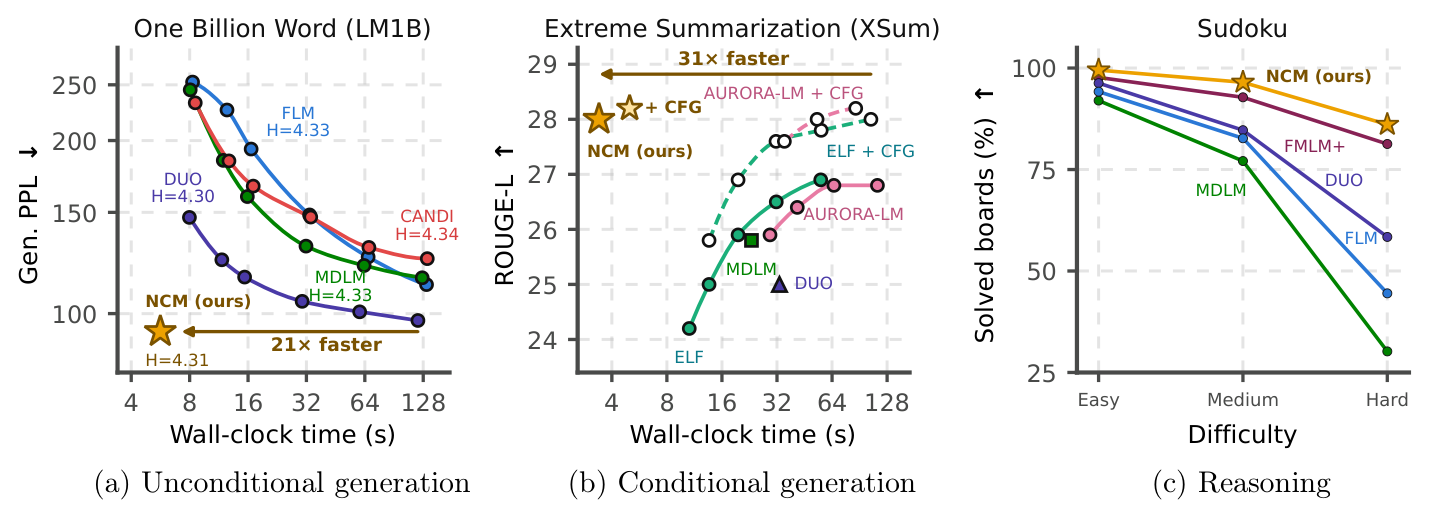
LM1B 무조건부 생성, XSum 요약, 스도쿠 추론에서 Next-Concept Modeling과 기존 확산 언어 모델들의 생성 속도 및 성능을 비교한 그래프

Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation

스탠퍼드 대학교와 Together AI 연구진이 텍스트를 다중 스케일 이산 코드 계층으로 압축한 뒤 단계별로 병렬 생성하는 Next-Concept Modeling(NCM)을 제안했다. 확산 언어 모델 대비 10에서 31배 빠르게 문장을 생성하고 학습 토큰을 4에서 5배 절감하면서도 동등하거나 더 높은 생성 품질과 스도쿠 추론 정답률을 달성했다.

October 21, 2026 · 13 분 · 서소영
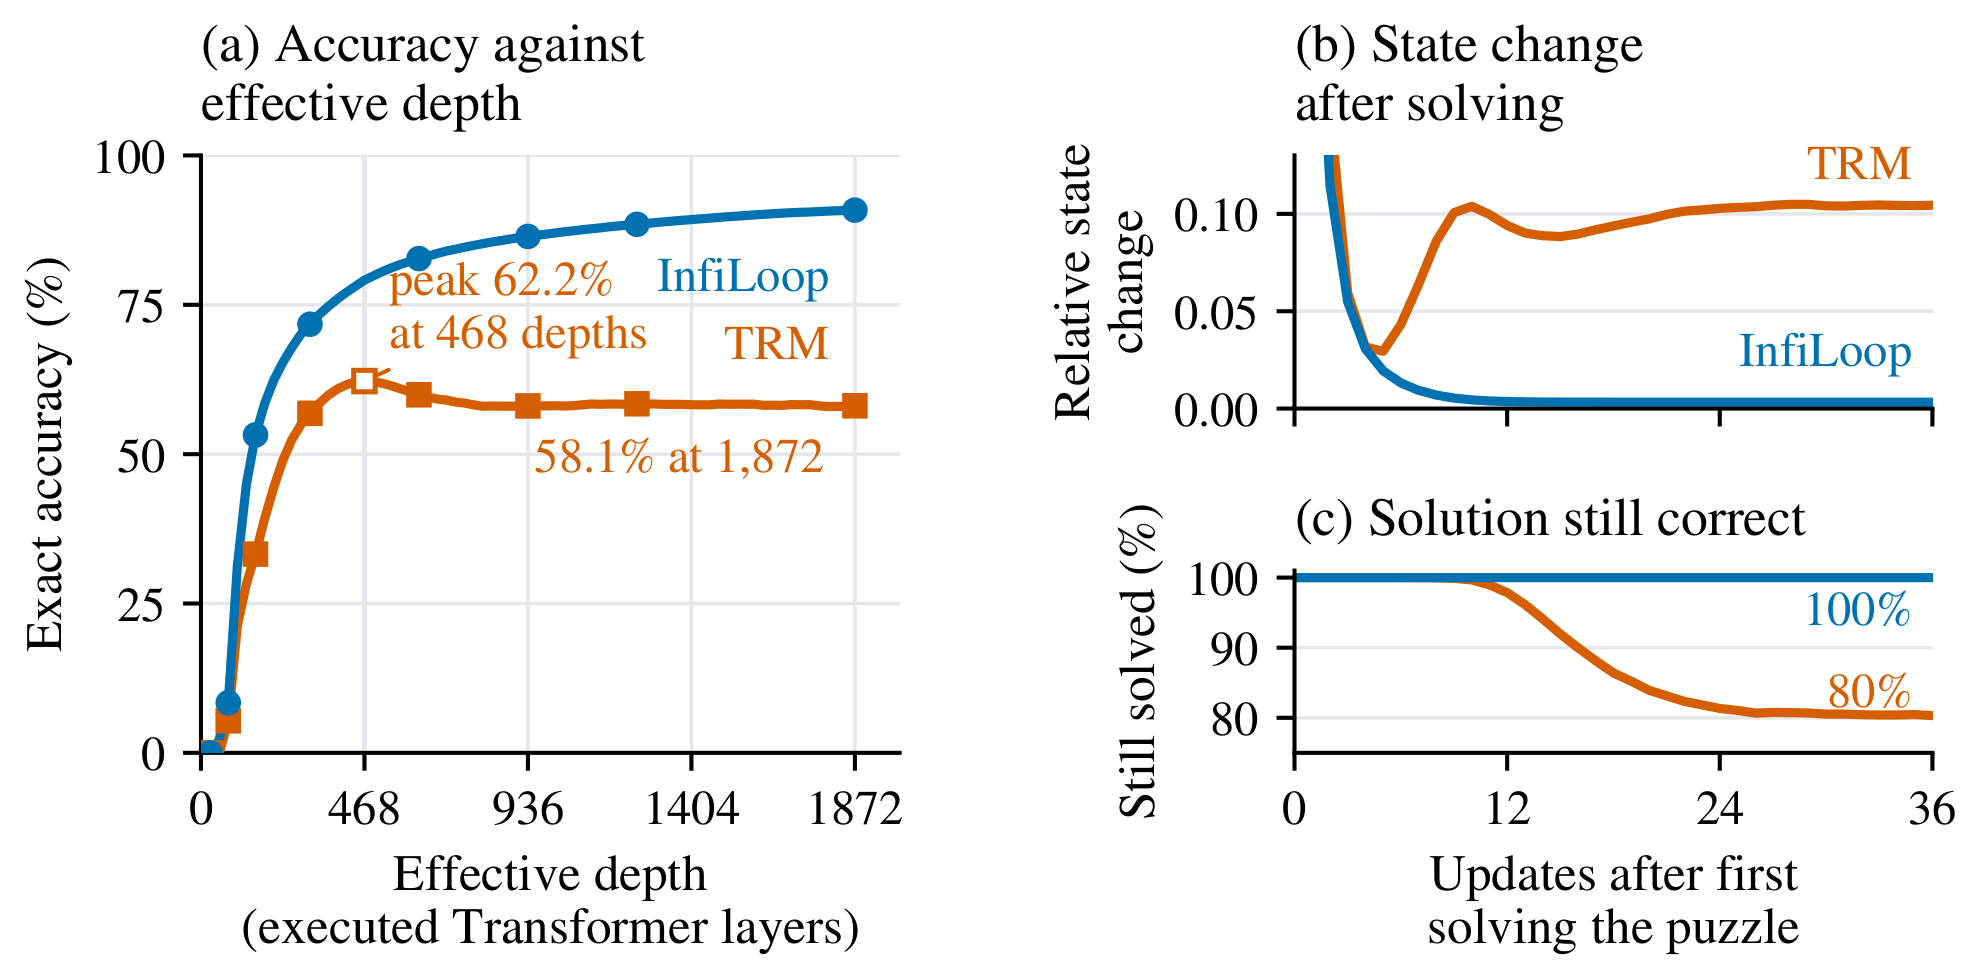
Sudoku-Extreme에서 실행 층 수에 따른 정확도와 풀이 완료 후 상태 변화를 비교한 그래프. 직전 상태만 넘기는 TRM은 468층에서 최고점 62.2%를 기록한 뒤 정확도가 떨어지고 이미 푼 퍼즐의 19.7%를 잃는 반면, InfiLoop는 1,872층에서 90.9%까지 오르며 푼 퍼즐을 모두 유지한다.

Scaling to Tens of Thousands of Test-Time Iterations with Loop-Native Attention Residuals

루프 트랜스포머는 직전 반복의 출력만 다음 반복으로 넘기기 때문에, 반복 횟수가 늘면 이후의 갱신이 이미 맞힌 답을 덮어쓰는 잠재 과잉사고가 발생한다. InfiLoop는 반복마다 내용 점수와 지수 감쇠로 과거 상태를 가중 합산한다. 토큰당 벡터 하나와 스칼라 하나만 유지하는 점화식이라 메모리 사용량이 반복 횟수와 상관없이 일정하다. 700만 파라미터 모델로 Sudoku-Extreme 97.9%, ARC-AGI-2 13.6%를 기록했고, 실행 층 수를 2만 4,960층까지 늘려도 성능이 계속 올랐다.

October 20, 2026 · 12 분 · 서소영
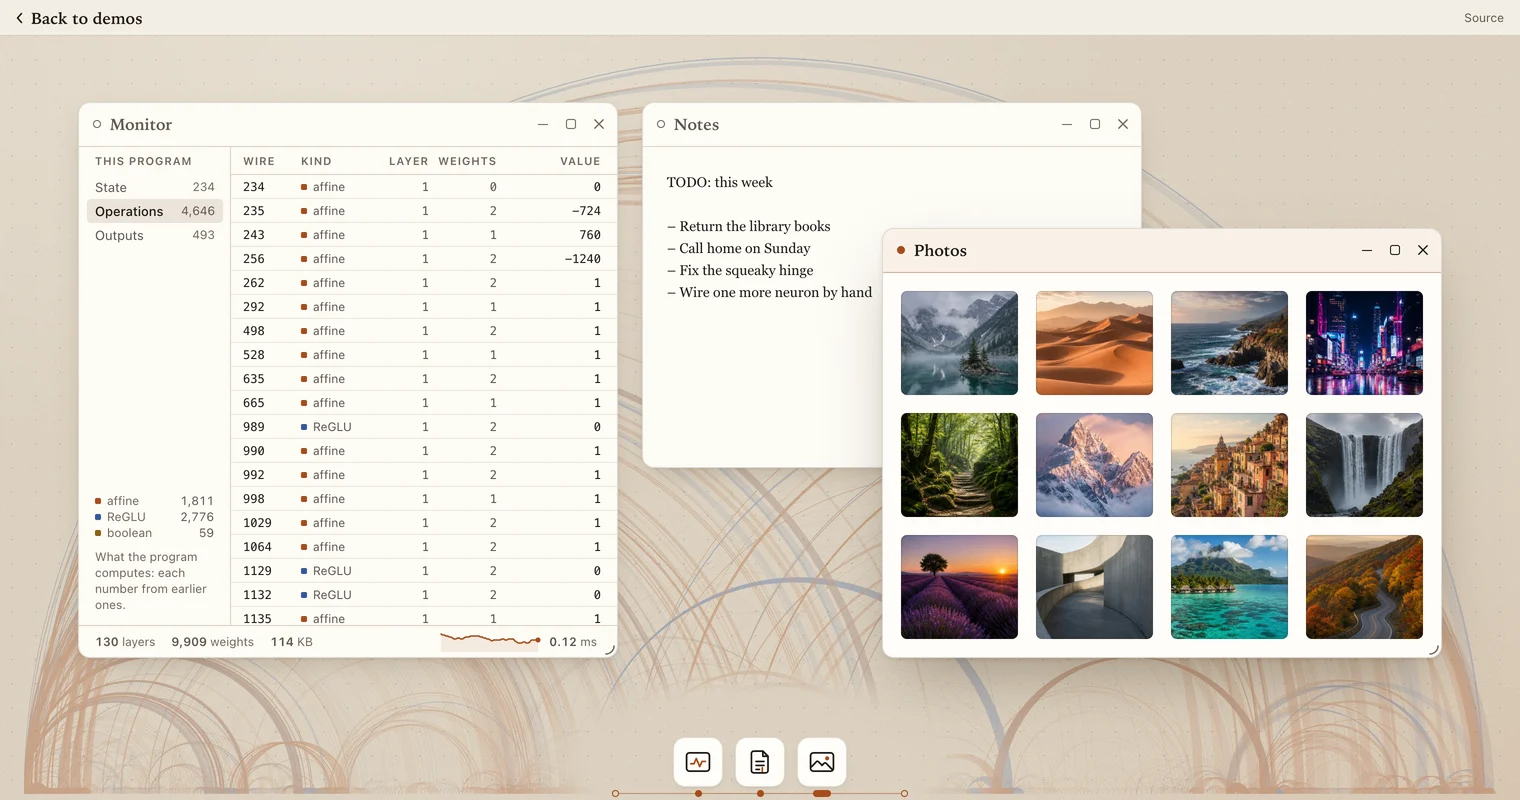
HandwiredOS 데스크톱 데모 화면. 왼쪽 Monitor 창에 프로그램의 상태 셀 234개, 연산 4,646개, 출력 493개, 그리고 층 수와 가중치 수가 표시되고 오른쪽에 Notes 창과 Photos 창이 열려 있다.

Handwired: Turn your regular JavaScript code into a neural net

Cheng Lou의 프로젝트 Handwired는 일반 자바스크립트와 타입스크립트로 작성한 빌더 코드를 32비트 부동소수점 연산 네 가지만으로 이루어진 신경망 회로로 컴파일한다. 이 회로는 학습 없이도 원래 코드와 똑같이 실행되고, 역전파 학습과 WebGPU 비트 패킹 실행까지 지원한다.

October 16, 2026 · 10 분 · 서소영
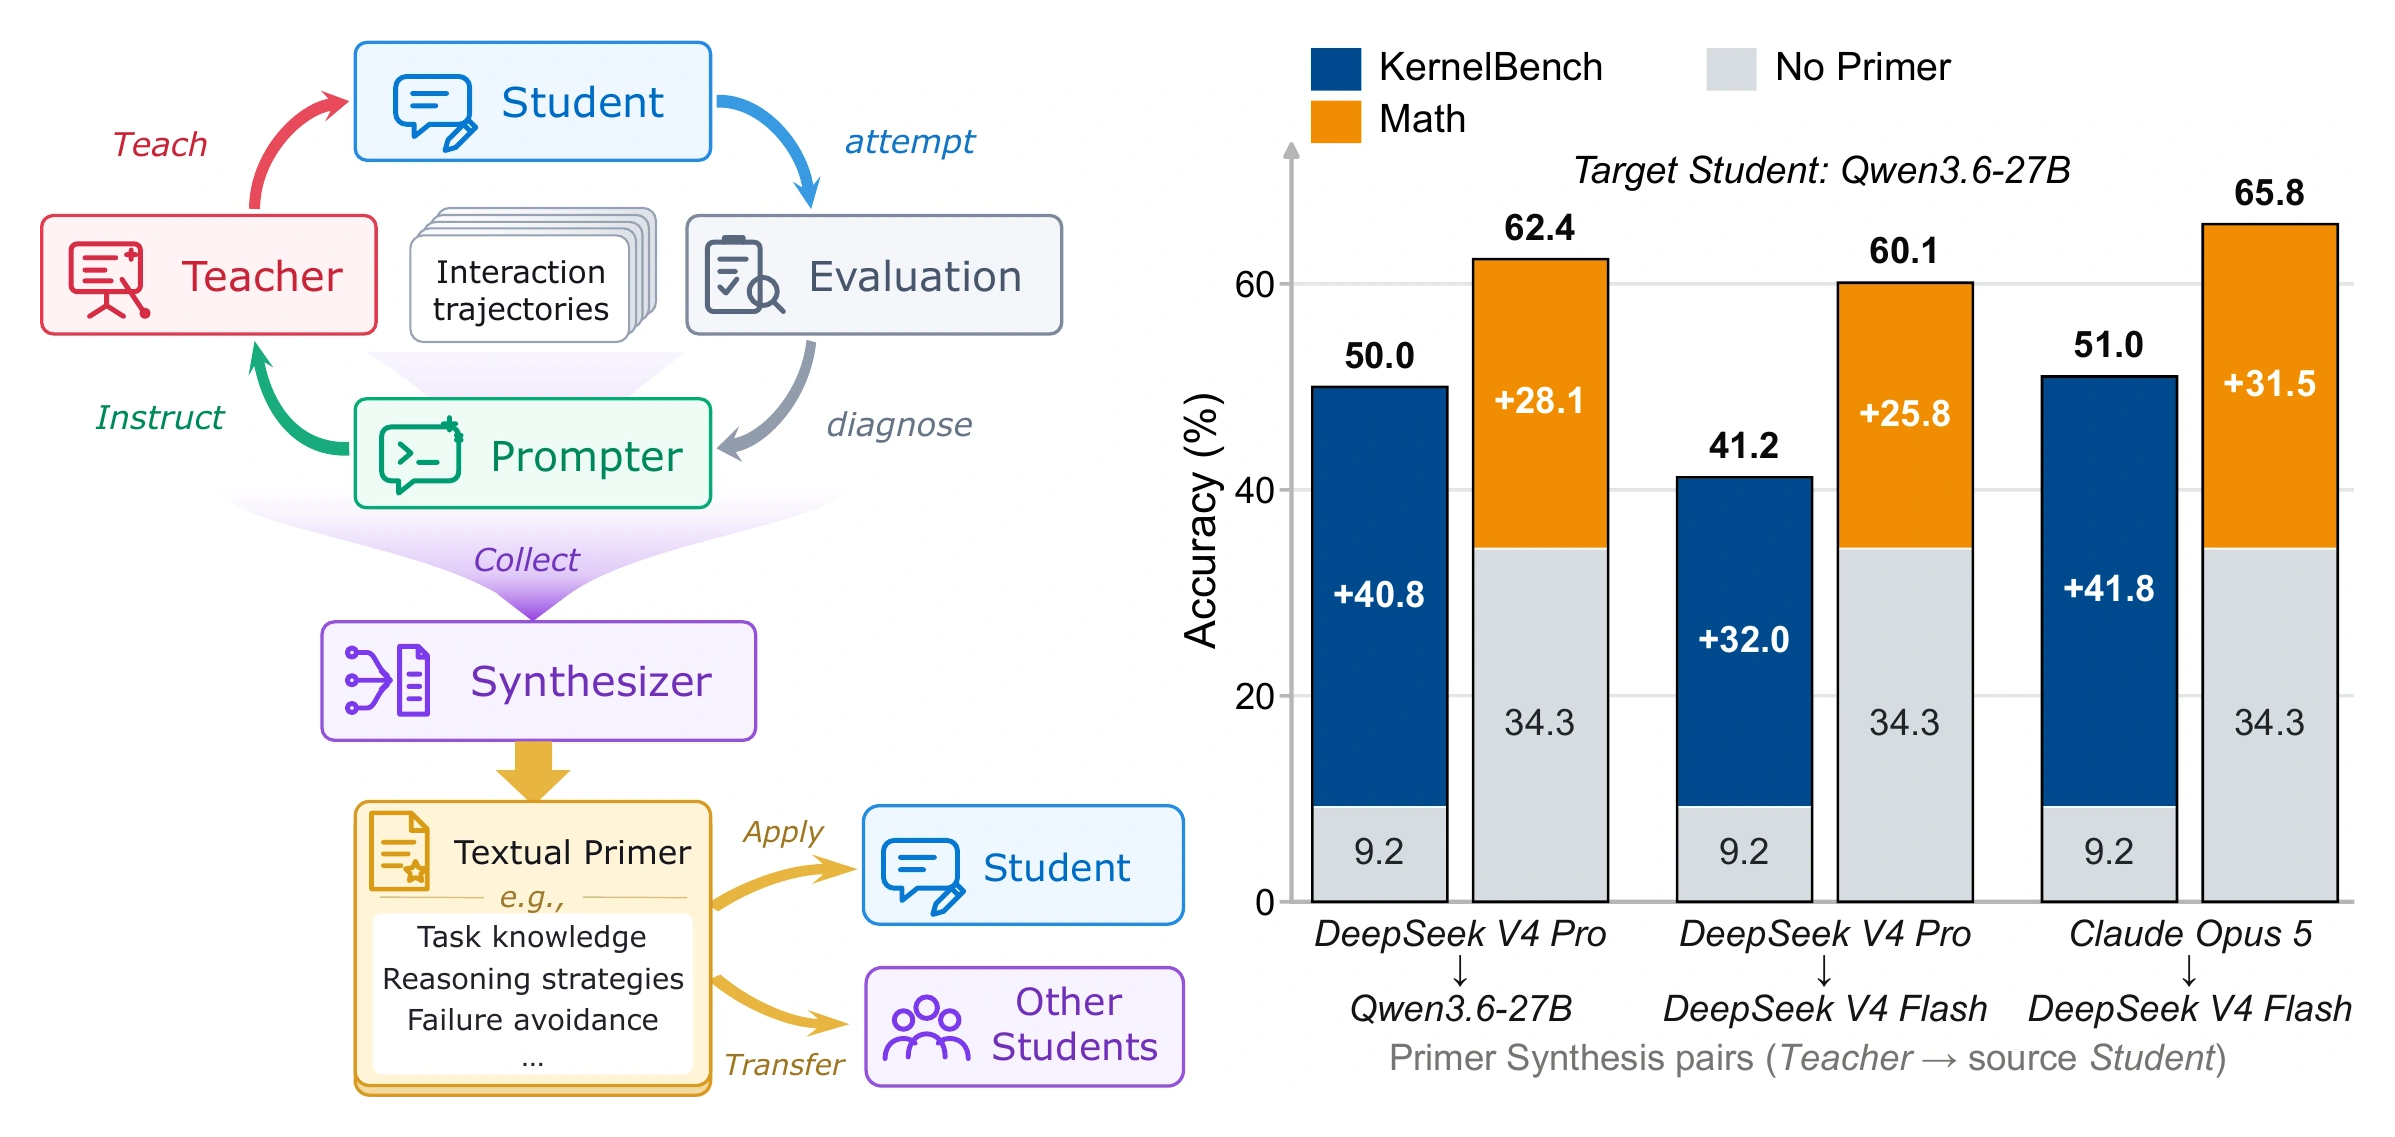
논문의 그림 1. 왼쪽에는 UTT의 순환이 그려져 있다. 학생이 문제를 풀면 Prompter가 채점 결과를 진단해 선생에게 지시하고, 선생이 학생을 가르친다. Synthesizer는 이 기록을 모아 Primer를 만들고, Primer는 원래 학생과 다른 학생들에게 적용된다. 오른쪽 막대그래프는 세 조합에서 만든 Primer를 Qwen3.6-27B에 적용한 정확도다. KernelBench는 9.2%에서 41.2%와 51.0% 사이로, 수학은 34.3%에서 60.1%와 65.8% 사이로 올랐다. 출처: Lu & Wang, arXiv:2610.12114

Universal Textual Teaching for LLMs

웨스트레이크 대학교 연구진은 강한 모델이 맞히고 약한 모델이 틀린 문제에서 얻은 교훈을 Primer라는 자연어 안내문으로 정리해 약한 모델에게 전달하는 방법 UTT를 제안했다. 약한 모델의 가중치는 학습시키지 않는다. Primer를 받은 DeepSeek V4 Flash의 KernelBench 정확도는 9.4%에서 48.6%로, 올림피아드 수학 정확도는 27.6%에서 51.7%로 올랐고, 합성에 참여하지 않은 다른 학생 모델도 같은 Primer로 점수가 올랐다.

October 13, 2026 · 16 분 · 서소영
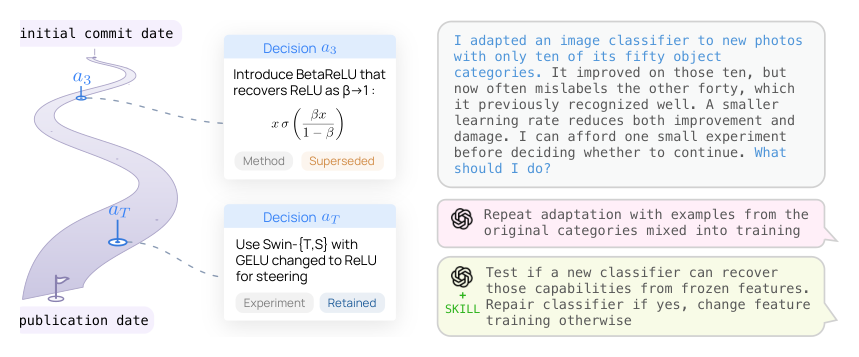
논문의 그림 1. 왼쪽에는 첫 커밋 날짜에서 논문 공개 날짜까지 굽이치는 길이 그려져 있고, 길 위의 두 지점에 연구 결정 카드가 연결돼 있다. 위쪽 결정 a3은 'β가 1에 가까워지면 ReLU가 되는 BetaReLU를 도입한다'이고 범주는 방법, 결과는 대체다. 아래쪽 결정 aT는 'Swin-T와 Swin-S의 GELU를 ReLU로 바꿔 모델 조정에 쓴다'이고 범주는 실험, 결과는 유지다. 오른쪽에는 50개 클래스를 아는 이미지 분류기를 10개 클래스의 새 사진에 적응시켰더니 나머지 40개 클래스를 자주 틀리게 됐다는 연구자의 질문이 있다. 그 아래에 스킬 없이 받은 답(원래 클래스의 예시를 섞어 적응을 다시 한다)과 스킬과 함께 받은 답(특징을 고정한 채 새 분류기가 그 능력을 복원하는지 시험한다)이 있다. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0

Learning Scientific Exploration from Human Research Decision Trajectories

시카고 대학교 연구진은 논문과 함께 공개된 GitHub 저장소의 커밋 기록에서 연구자가 내린 결정의 순서를 추출해 데이터셋 ResearchTrails를 만들었다. NeurIPS 논문과 함께 공개된 저장소 599개에서 연구 결정 13,271개를 얻었고, 이 기록으로 정리한 스킬은 다음 연구 결정을 예측하는 과제에서 최종 논문만으로 정리한 스킬보다 높은 점수를 받았다.

October 12, 2026 · 17 분 · 서소영
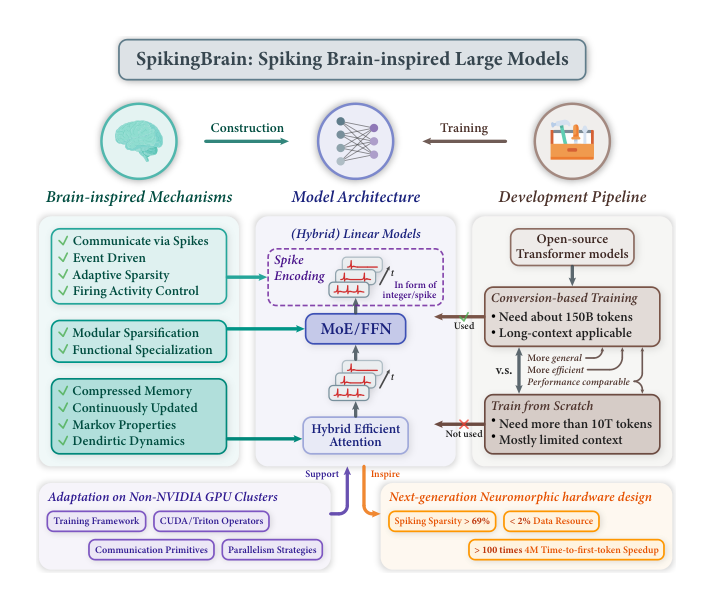
논문의 그림 1. SpikingBrain의 전체 구성도. 왼쪽 초록색 상자는 뇌에서 착안한 메커니즘으로, 스파이크를 통한 통신과 이벤트 구동, 적응형 희소성과 발화 활동 제어, 모듈식 희소화와 기능 특화, 압축되고 계속 갱신되는 기억과 마르코프 성질, 수상돌기 동역학을 나열한다. 가운데 상자는 모델 구조로, 아래에서부터 혼합 효율 어텐션, MoE 또는 FFN, 정수나 스파이크 형태의 스파이크 부호화가 이어진다. 오른쪽 상자는 개발 과정으로, 오픈소스 트랜스포머 모델에서 출발하는 변환 기반 학습(약 150B 토큰, 긴 문맥 적용 가능)을 택하고, 10T 토큰 이상이 필요하고 문맥이 대체로 짧은 처음부터 학습하는 방식은 쓰지 않았다고 표시한다. 아래 왼쪽 상자는 엔비디아가 아닌 GPU 클러스터에 적응시키는 항목으로 학습 프레임워크, CUDA와 Triton 연산자, 통신 기본 연산, 병렬화 전략을 나열하고, 아래 오른쪽 상자는 차세대 뉴로모픽 하드웨어 설계에 줄 시사점으로 스파이킹 희소도 69% 이상, 데이터 2% 미만, 4M 토큰 첫 토큰 지연 100배 이상 단축을 적었다.

SpikingBrain: Spiking Brain-inspired Large Models

중국과학원 자동화연구소와 MetaX 연구진이 Qwen2.5-7B의 어텐션을 선형 어텐션과 슬라이딩 윈도 어텐션으로 바꾸고 활성값을 정수 스파이크로 부호화한 모델 두 종을 만들어, 엔비디아가 아닌 MetaX GPU 수백 장에서 학습했다. 연속 사전학습 약 1,500억(150B) 토큰으로 7B 모델은 베이스 모델 성능의 약 90%를 회복했고, 400만(4M) 토큰을 입력하면 첫 토큰이 100배 이상 빨리 나온다고 추정했다.

October 2, 2026 · 16 분 · 서소영
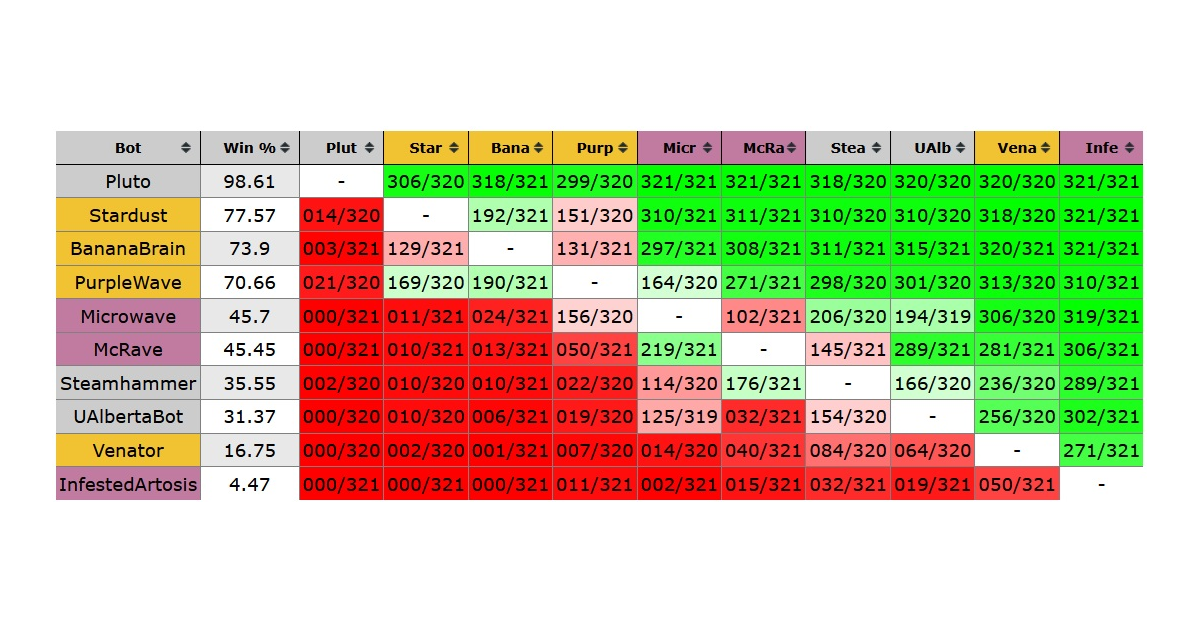
CoG 2026 스타크래프트 AI 대회의 봇 간 승패표. 10개 봇이 행과 열에 같은 순서로 적혀 있고, 칸마다 행의 봇이 열의 봇을 이긴 경기 수가 표시되어 있다. 맨 위 Pluto 행은 모든 칸이 초록색으로, Pluto는 Stardust를 상대로 320경기 중 306경기, PurpleWave를 상대로 320경기 중 299경기를 이겼고, 나머지 봇을 상대로는 각각 318승 이상을 거뒀다. Pluto 열은 모든 칸이 빨간색이다.

Pluto: 셀프 플레이 강화학습만으로 배운 스타크래프트 AI

Vegard Mella(tscmoo)가 만든 스타크래프트: 브루드 워 AI Pluto는 파라미터 3억 1,500만 개의 신경망 하나로 게임을 한다. 이 신경망은 셀프 플레이 강화학습만으로 세 종족의 경기 운영과 전투를 배웠다. 2026년 CoG 스타크래프트 AI 대회에서 라운드 로빈 승률 98.61%를 기록했고, 결승에서 PurpleWave를 4 대 1로 이겼다. GitHub 저장소에는 소스 코드 없이 README와 CPU용 실행 파일 배포판이 공개되어 있다.

October 1, 2026 · 13 분 · 서소영
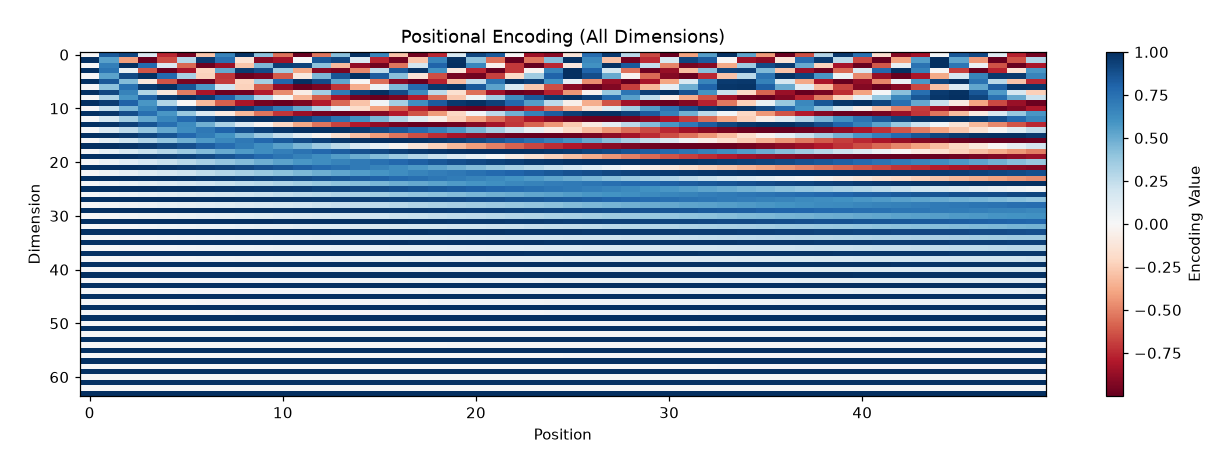
13번 트랜스포머 노트북을 실행해 얻은 사인파 위치 인코딩 히트맵. 가로축은 위치 0에서 49까지, 세로축은 임베딩 차원 0에서 63까지다. 낮은 차원일수록 빨강과 파랑이 촘촘하게 번갈아 나타나고, 높은 차원으로 갈수록 색이 천천히 바뀌다가 60번대 차원에서는 거의 한 가지 색의 가로줄이 된다.

Sutskever 30 - Complete Implementation Suite

Paul Pajo가 2025년 12월 공개한 GitHub 저장소로, 일리야 수츠케버의 추천 읽기 목록에 실린 논문 30편을 NumPy만 쓰는 주피터 노트북으로 구현했다. 노트북 다섯 개를 직접 실행해 보니 문자 RNN은 가중치를 갱신하며 학습했다. 반면 다중 토큰 예측 노트북은 가중치를 한 번도 갱신하지 않았다. 스케일링 법칙과 Lost in the Middle 노트북은 논문이 보고한 결과가 나오도록 수식을 미리 작성하고 그 곡선을 그렸다.

September 30, 2026 · 11 분 · 서소영