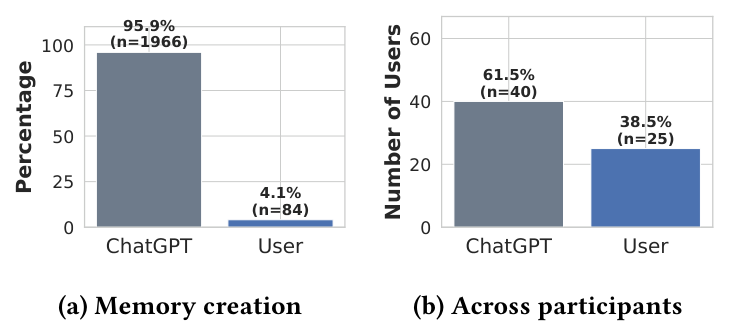
The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT
실제 ChatGPT 사용자 80명의 대화 기록에서 메모리 2,050건을 추출해 분석한 연구. 메모리의 96%는 시스템이 일방적으로 만들었고, 28%에는 개인정보가, 52%에는 심리 상태가 기록되어 있었다.
실제 ChatGPT 사용자 80명의 대화 기록에서 메모리 2,050건을 추출해 분석한 연구. 메모리의 96%는 시스템이 일방적으로 만들었고, 28%에는 개인정보가, 52%에는 심리 상태가 기록되어 있었다.
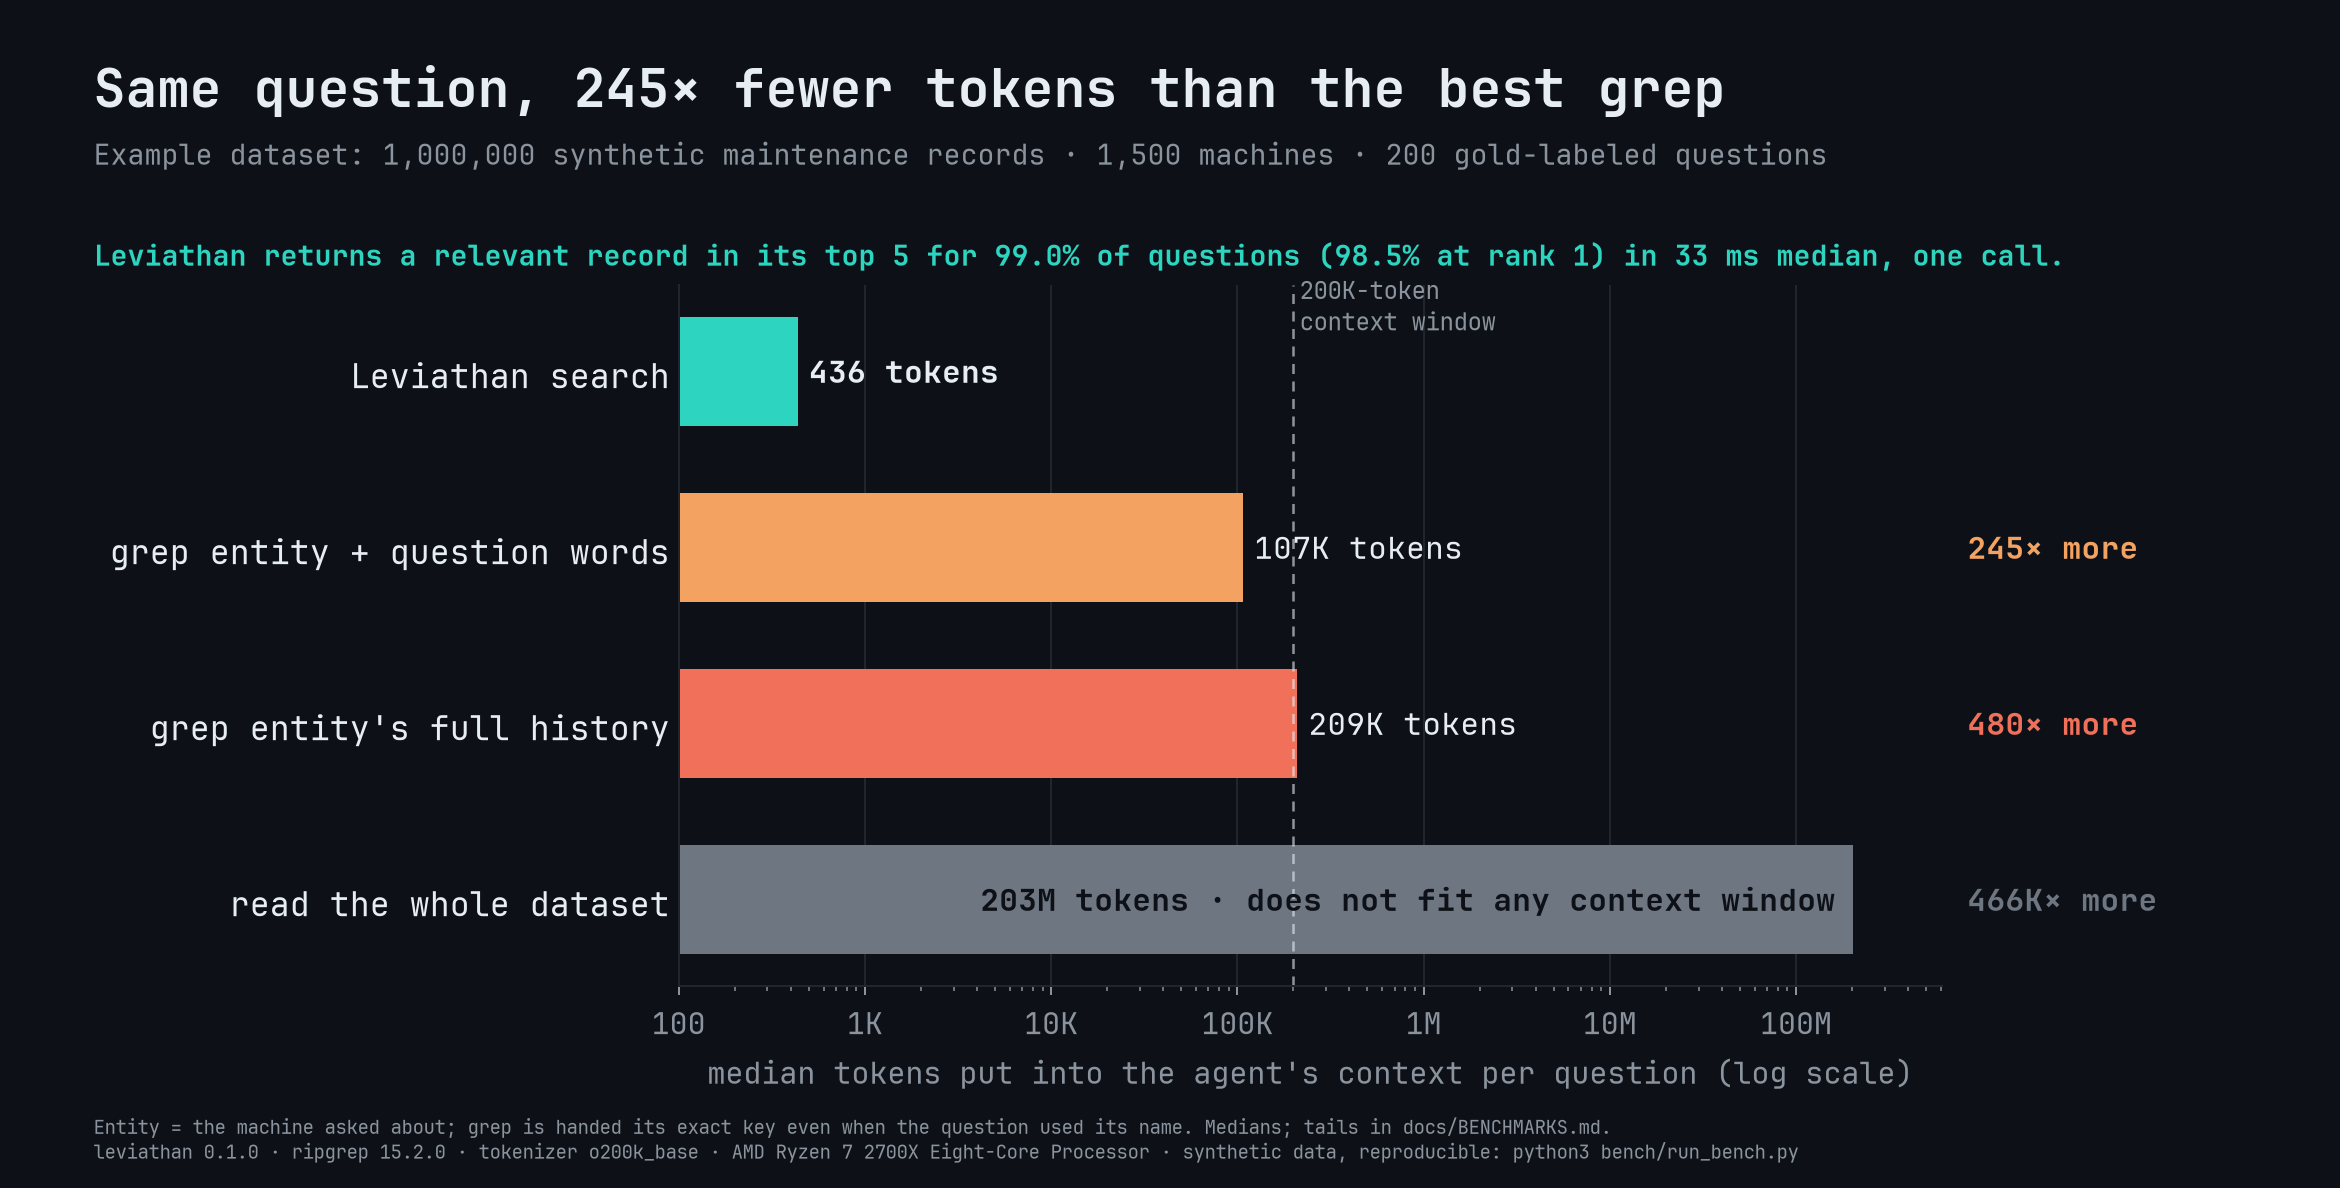
Joshua Baker가 2026년 10월 5일 공개한 Rust 프로그램 Leviathan은 JSONL, CSV, SQLite 같은 형식의 레코드를 SQLite 전문 검색 인덱스 하나로 만들어 둔다. 에이전트가 질문하면 순위를 매긴 레코드 몇 건을 약 450토큰 분량으로 돌려준다. 합성 정비 기록 100만 건 벤치마크에서 grep 방식보다 245배 적은 토큰을 쓰면서, 질문의 99.0%에서 정답 레코드를 상위 5건에 포함했다.
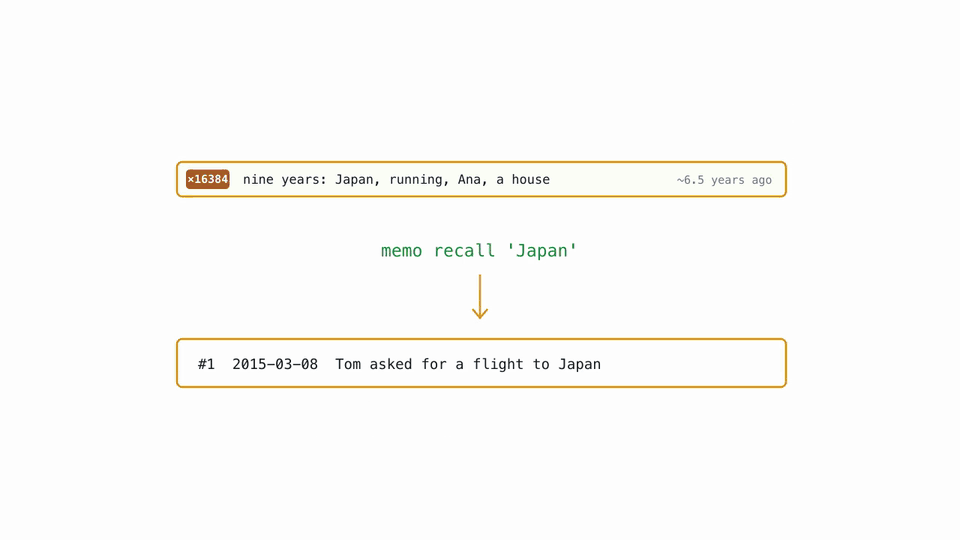
OptMem은 원문 기록을 보존하고 오래된 기록을 이진 트리로 요약하는 에이전트 메모리 도구다. Python 스크립트 하나와 짧은 지시문으로 기록, 요약, 검색을 사용할 수 있다.
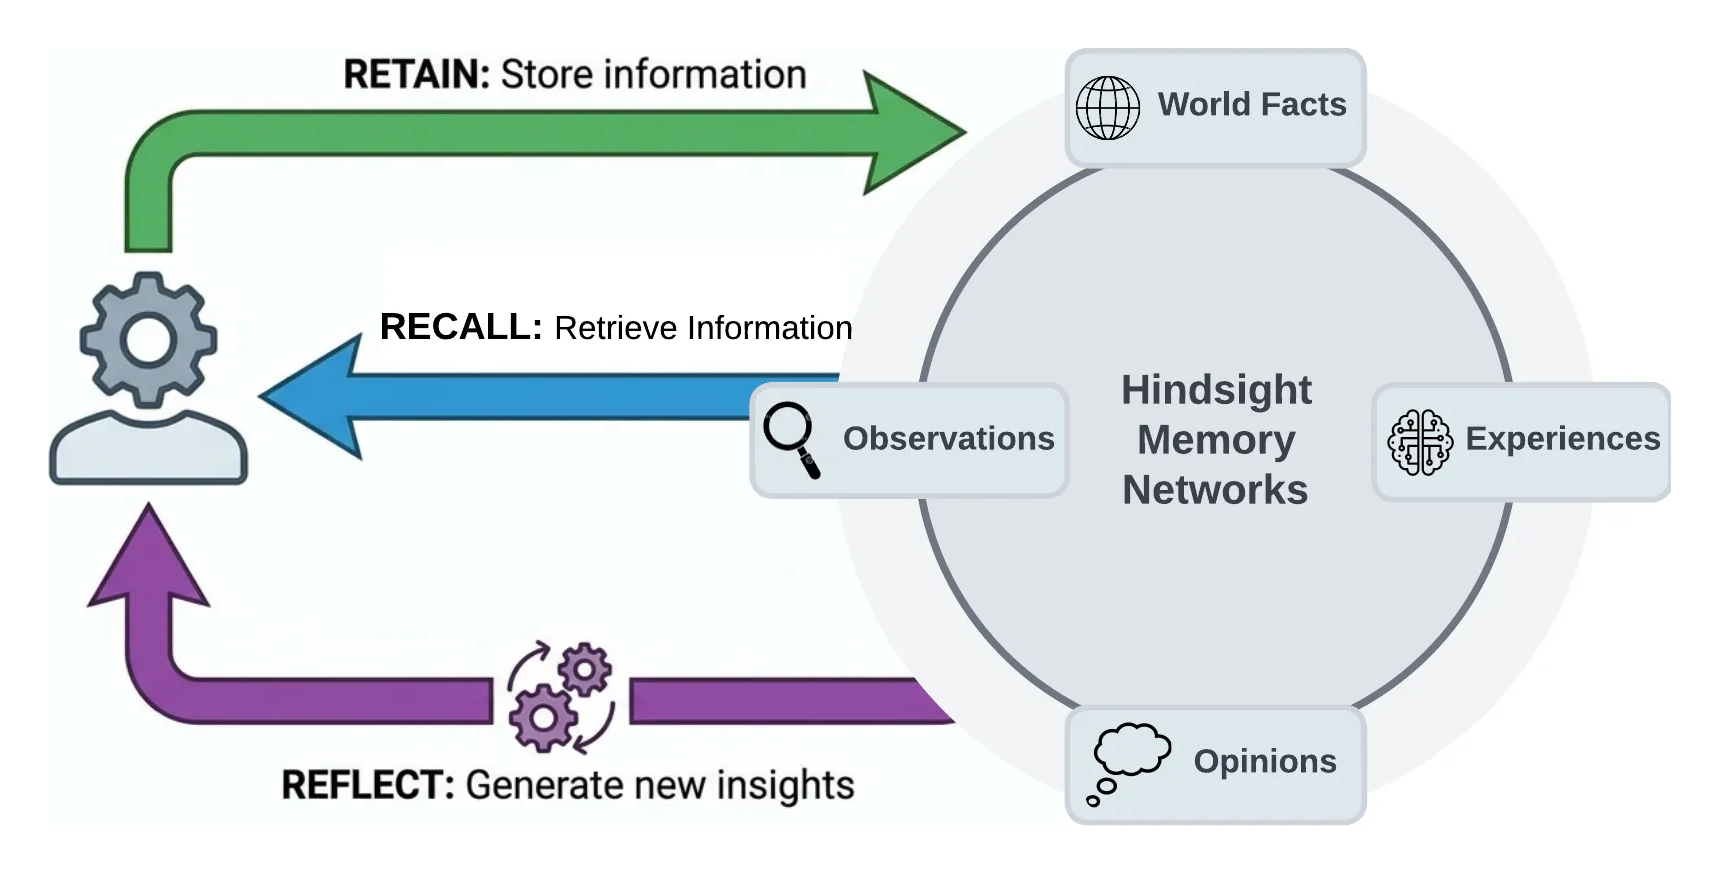
Vectorize.io가 MIT 라이선스로 공개한 에이전트 메모리 시스템 Hindsight의 README와 문서를 정리했다. 저장한 사실을 근거가 딸린 관측과 멘털 모델로 통합해 에이전트가 경험에서 배우도록 설계했고, LongMemEval에서 94.6%를 보고한다.
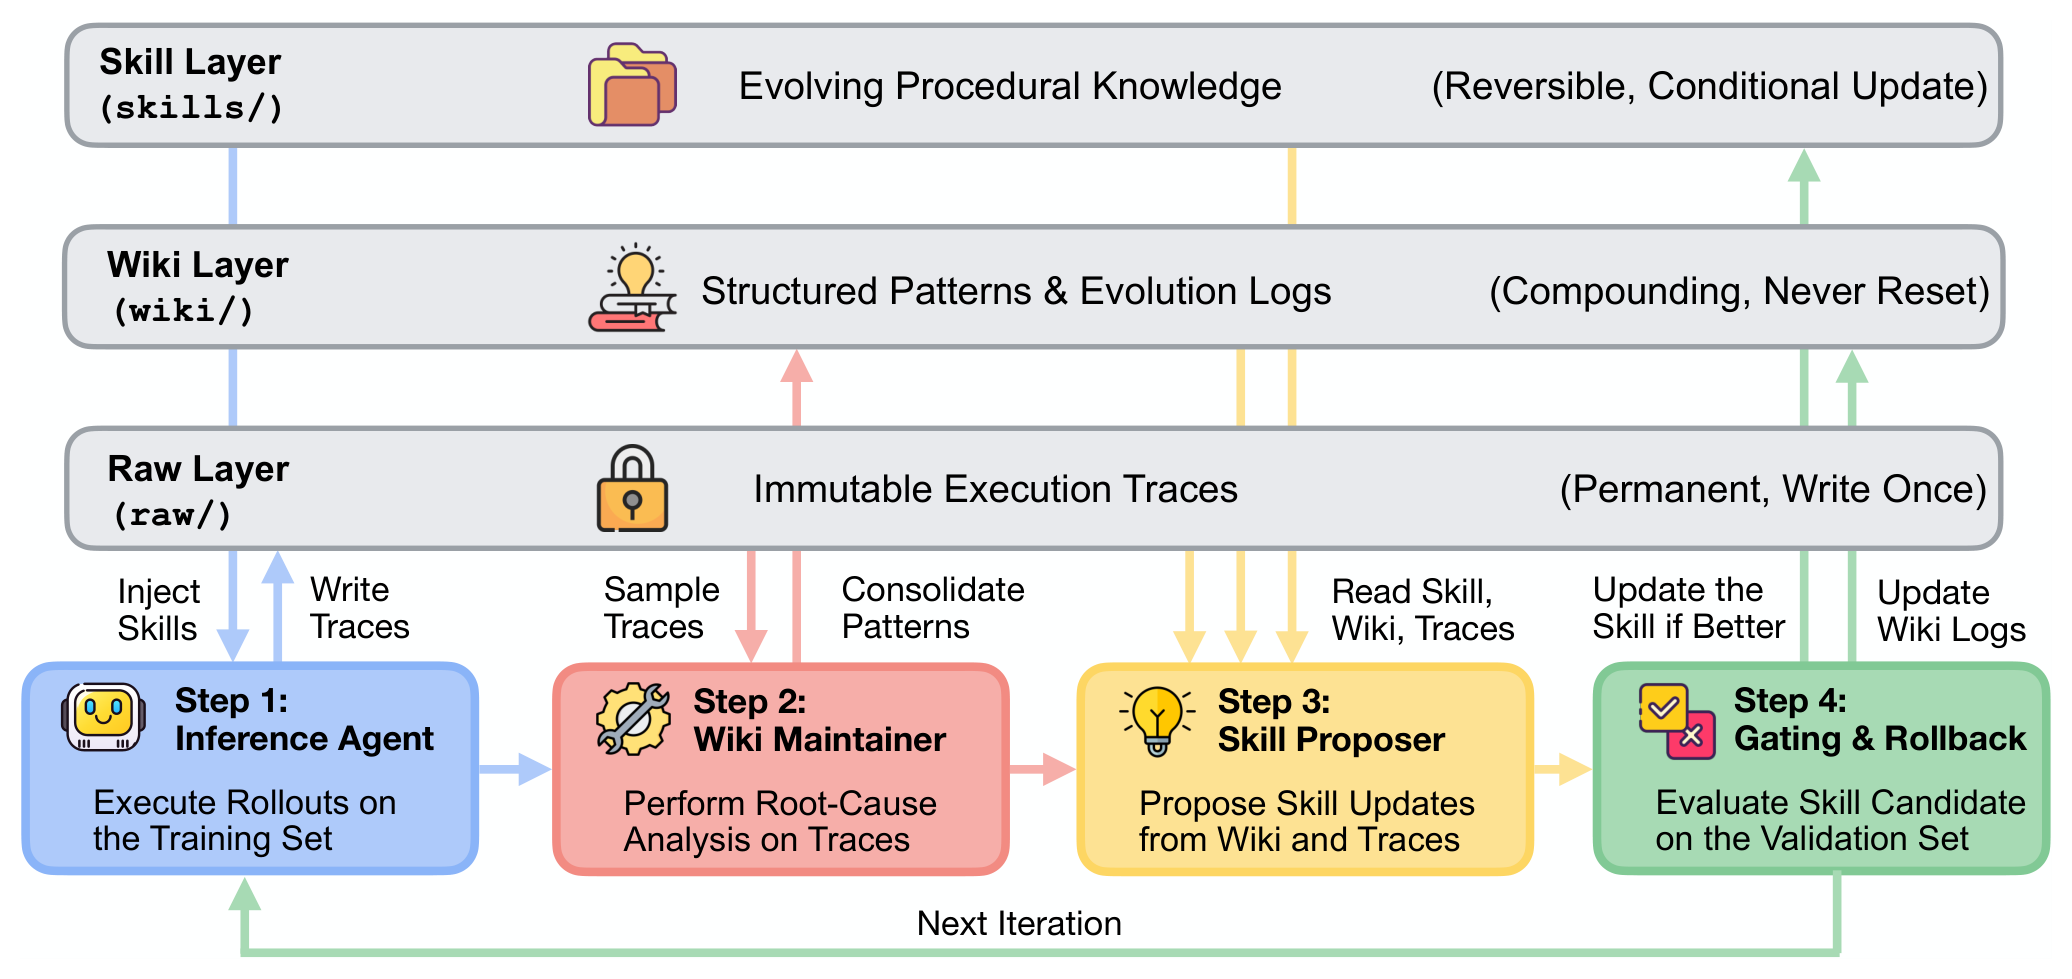
Google Research가 에이전트 스킬을 자동으로 고쳐 나갈 때, 실행 경험을 영속 위키에 먼저 정리하고 그 위에서 스킬을 손보게 했다. 다섯 모델과 다섯 벤치마크에서 기존 스킬 진화 기법을 모두 앞섰고, 위키를 떼어내면 그 평균이 48.7%에 그친다.
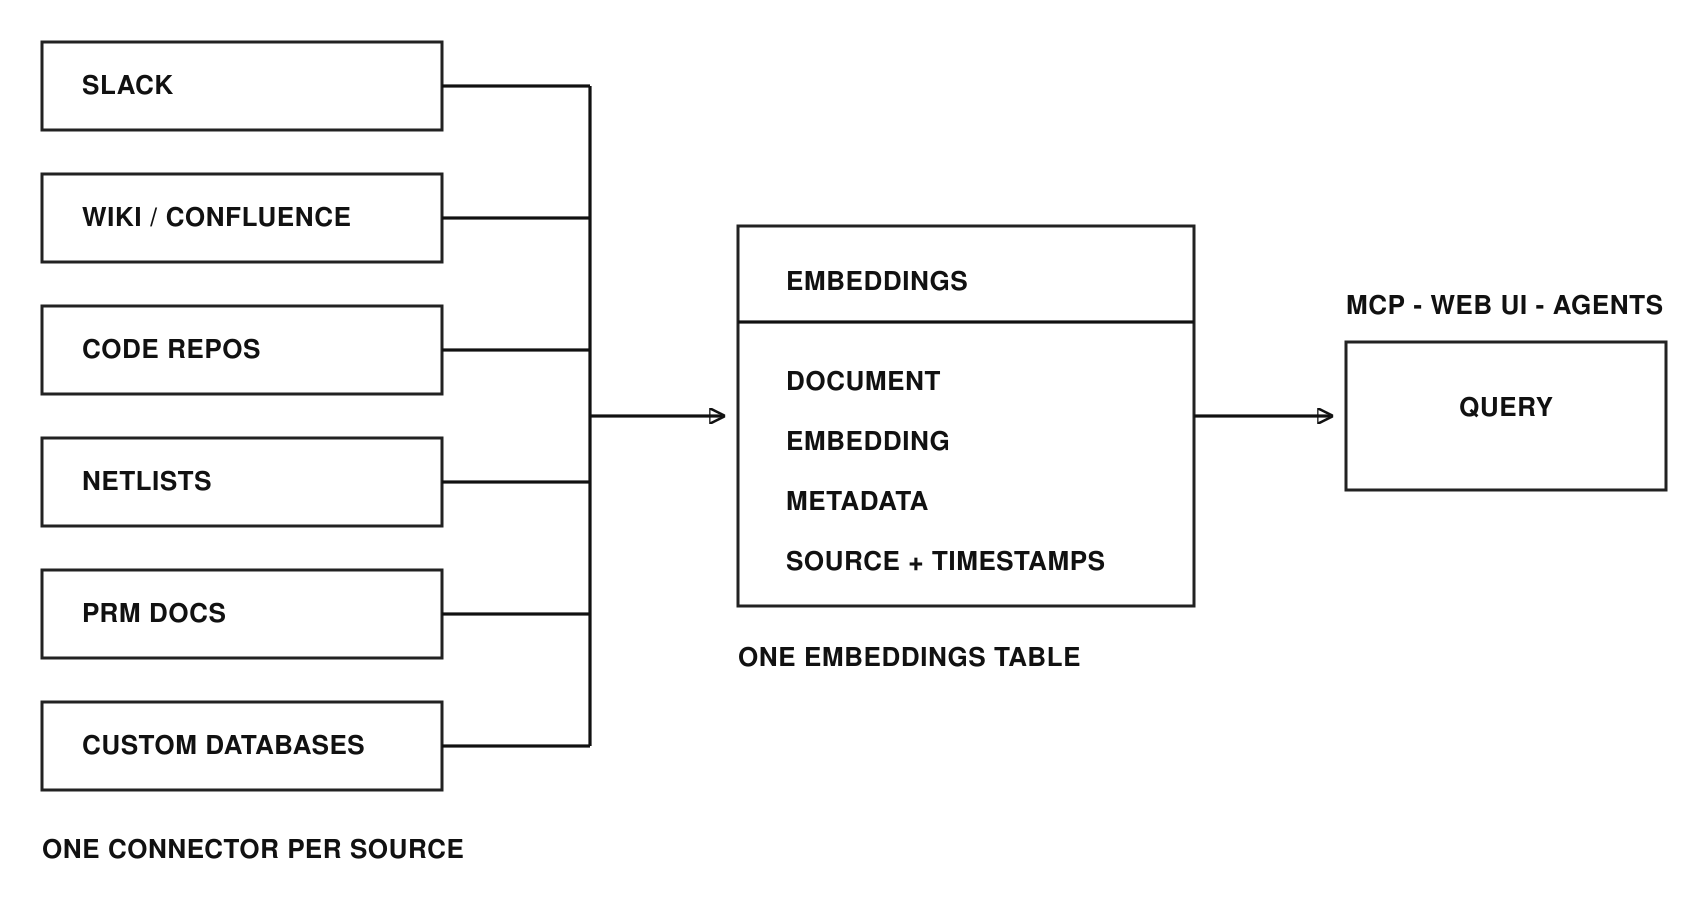
Cerebras가 하루 15,000건의 질문을 받는 사내 지식베이스를 만든 방법. 모든 것을 한 플랫폼에 모으는 단일 진실 공급원을 포기하고, 데이터가 이미 사는 곳에서 끌어와 단일 Postgres 임베딩 테이블에 착지시켰다.
구글 리서치의 TurboQuant 양자화 알고리즘을 Rust로 구현한 벡터 인덱스. 학습 단계 없이 벡터를 16배로 압축하고, 손수 짠 SIMD 커널로 FAISS보다 빠르게 검색한다.
루프 엔지니어링을 ‘기억’ 한 축에서 다시 보는 글. 한 단계에 얼마나 많은 컨텍스트를 모델에 보일지를 두고 토큰이 풍부한 루프와 빈약한 루프가 갈리며, 그 사이의 균형을 잡는 열쇠가 명시적 메모리 계층임을 분명히 밝힌다. 메모리 인프라 기업 Mem0의 관점이 깔린 글이지만, 루프의 기억이라는 차원을 정면으로 다룬다는 점에서 연재를 닫는 좌표로 삼을 만하다.
Google Cloud의 Data Cloud 팀이 LLM-wiki 패턴을 휴대 가능한 상호운용 포맷으로 정형화한 Open Knowledge Format(OKF) v0.1을 공개했다. YAML frontmatter가 붙은 마크다운 파일 디렉토리로 지식을 표현하며, 벤더·플랫폼·에이전트 프레임워크에 종속되지 않는 형식만으로 에이전트 간 컨텍스트 공유를 가능하게 한다.
Claude Code·Cursor·Codex 등 MCP 클라이언트 전반에 영구 메모리를 공급하는 self-hosted 엔진. 12개 라이프사이클 훅으로 무수동 캡처하고, BM25+Vector+Graph 삼중 검색으로 LongMemEval-S R@5 95.2%를 달성한다.