3줄 요약
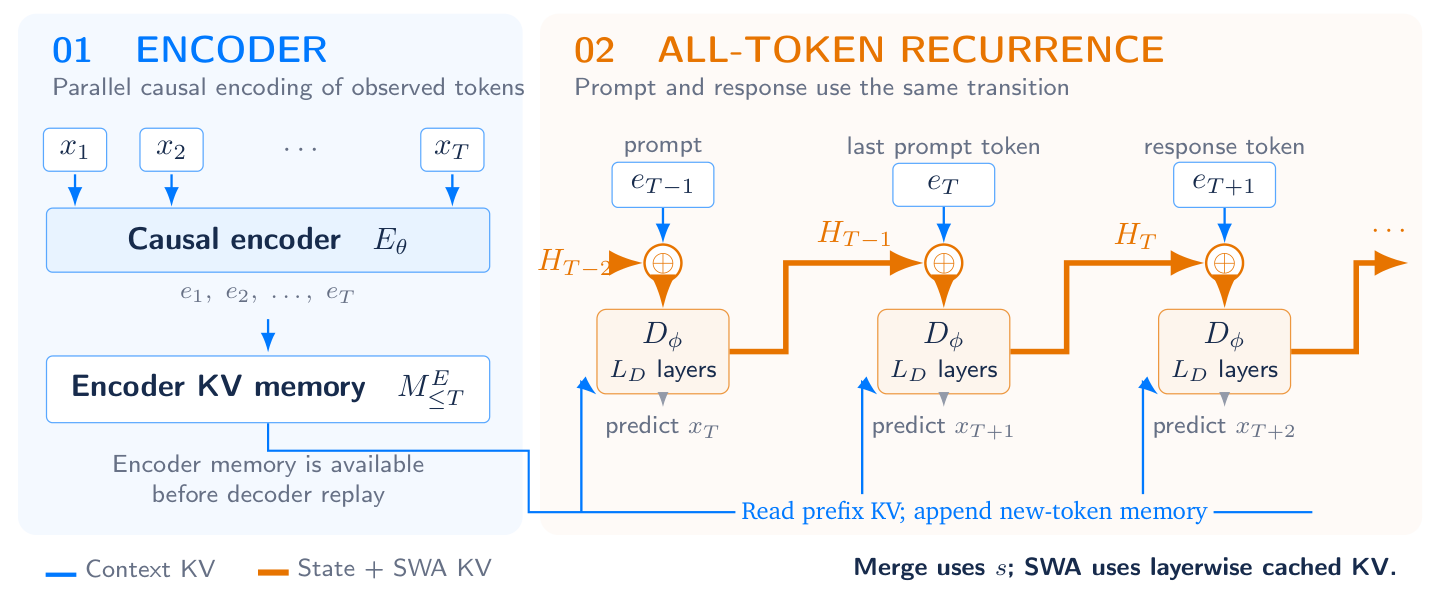
- Yifan Zhang이 2026년 9월 12일에 Recurrent Looped Transformer(RLT)라는 아키텍처 테크리포트를 공개했다. 인과적 인코더가 전역 KV 메모리를 만들고, 재귀 디코더가 마지막 층의 은닉 상태와 층마다의 슬라이딩 윈도우 어텐션 캐시를 프롬프트와 응답의 모든 토큰에 걸쳐 이어 간다.
- 저자가 내세운 설계 목표는 세 가지다. 첫째는 시퀀스가 길어질수록 함께 길어지는 잠재 추론 경로다. 둘째는 재귀 코어 둘레에 병렬 작업을 배치하는 하드웨어 공동 설계다. 셋째는 사전학습과 지도 미세조정, 샘플링과 현재 정책 리플레이가 모두 같은 상태 전이를 쓰게 만드는 강화학습 알고리즘 공동 설계다.
- 리포트에는 측정된 성능 수치가 한 줄도 없다. 저자는 계산의 정의와 실행 규약만 적어 두었고, 실제로 얻어지는 추론 품질과 하드웨어 효율과 스케일링 거동은 앞으로 확인해야 할 몫이라고 여러 번 밝혔다.
인코더는 한꺼번에, 디코더는 한 토큰씩
RLT의 몸통은 두 덩어리로 나뉜다. 앞쪽의 인과적 인코더 $E_\theta$는 이미 관측된 토큰 전체를 인과 마스크 아래에서 한꺼번에 처리하고, 그 결과로 디코더가 참조할 전역 KV 메모리 $M_{\le t}$를 만든다. 뒤쪽의 재귀 디코더 $D_\phi$는 토큰을 순서대로 하나씩 받으면서 자기 상태를 갱신한다.
디코더가 들고 다니는 상태는 두 조각으로 이루어진다. 하나는 마지막 층의 출력 $s_t$이고, 다른 하나는 디코더의 모든 층이 각자 보관하는 슬라이딩 윈도우 어텐션 캐시 $C_t^D$다. 저자는 이 둘을 묶어 완전한 상태라고 부른다.
$$H_t = \left(s_t,\, C_t^D\right), \qquad H_0 = \left(s_\star,\, \emptyset\right).$$$$\left(s_t,\, C_t^D\right) = D_\phi\left(\mathrm{Merge}\left(e_t,\, s_{t-1}\right);\, M_{\le t},\, C_{t-1}^D,\, t\right).$$$$p_\Theta\left(x_{t+1} \mid x_{1:t}\right) = \mathrm{softmax}\left(W_o\,\mathrm{RMSNorm}_o\left(s_t\right)\right)_{x_{t+1}}.$$$e_t$는 인코더가 만든 토큰 표현이고, Merge는 이전 토큰의 재귀 출력 $s_{t-1}$을 현재 토큰의 인코더 표현에 게이트를 통해 더하는 연산이다. 다음 토큰의 확률은 재귀 출력 하나에서 나온다.
디코더의 각 블록은 세 단계를 차례로 밟는다. 먼저 자기 슬라이딩 윈도우 안에서 인과 어텐션을 수행하고, 다음으로 인코더 메모리를 향한 크로스 어텐션을 수행하고, 마지막으로 FFN을 통과한다. 전역 맥락은 인코더가 만든 메모리에서 온다. 그에 비해 최근 이력은 디코더가 스스로 쌓아 올린 캐시가 담당한다. 저자는 두 저장소의 역할이 서로 다르기 때문에 어느 한쪽이 다른 쪽을 대신할 수 없다고 밝힌다.
참조 구성은 인코더 48층과 디코더 48층이다. 두 스택은 어텐션 투영과 FFN 가중치를 호환되는 형태로 공유한다. 그래서 토큰 하나는 같은 백본을 논리적으로 두 번 지나가고, 그동안 96개의 논리 블록을 통과한다. 이름에 들어간 looped가 가리키는 것은 파라미터의 재사용이다. 활성값을 복사해 돌려 쓴다는 이야기는 어디에도 없다. 디코더 출력은 인코더 출력과 같은 것으로 취급되지 않는다. 디코더 블록에는 크로스 어텐션이 더 붙으므로, 두 번의 논리적 통과에 드는 연산량이 서로 같지는 않다. 가중치를 묶지 않은 구성도 가능하며, 그 경우에도 완전한 상태의 재귀는 그대로 남고 깊이 방향의 파라미터 재사용만 사라진다.
이 설계에서 프롬프트와 응답의 경계는 계산에 등장하지 않는다. 리포트의 명제 3.1은 그 성질을 이렇게 정리한다. 파라미터와 토큰 열, 위치 규약을 고정하고 인코더 실행이 수학적으로 등가라면, 프롬프트를 어디에서 끊든 같은 상태와 같은 다음 토큰 분포가 나온다. 증명은 귀납법 한 문단으로 끝난다. 저자는 곧바로 단서를 붙인다. 여기서 보장되는 등가는 수학의 층위에 한한다. 커널이 다르고 정밀도가 다르면 실제로 나오는 수치는 여전히 어긋날 수 있다.
토큰당 96블록, 경로는 48t
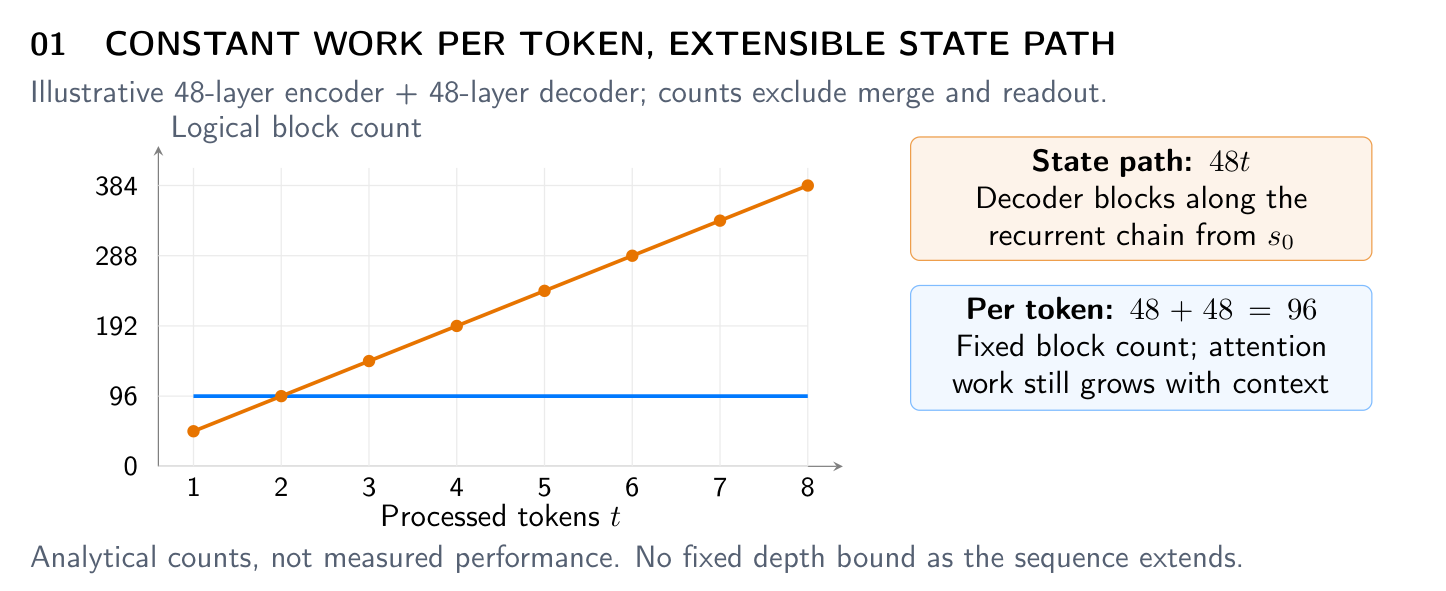
토큰을 $t$개 처리하면, 상태가 거쳐 온 경로의 길이는 디코더 블록 $t L_D$개다. 48층 구성에서는 $48t$개가 된다. 그동안 토큰 하나가 실행하는 블록 수는 96개로 고정된다. 길이 $T$의 프롬프트 뒤에 $n$개의 토큰을 더 처리하면 그 경로는 $(T+n)L_D$개 블록이 된다.
저자가 말하는 무한 깊이는 이 경로를 가리킨다. 토큰 하나를 처리하는 동안 무한한 계산이 벌어진다고 읽기 쉽지만, 저자가 가리키는 것은 다른 쪽이다. 토큰을 더 처리할수록 시간 방향의 계산 경로에 구조적인 상한이 걸리지 않는다는 점이다. 유한한 시퀀스는 여전히 유한한 계산을 수행한다.
도식보다 그 아래에 저자가 작게 적어 둔 단서 쪽이 더 중요하다. 이 수치는 분석으로 헤아린 값이며, 성능을 실제로 측정한 수치는 어디에도 없다는 것이다. 본문에서도 같은 경고가 반복된다. 게이트와 수축과 학습된 투영이 긴 경로의 실질적인 기여를 억누를 수 있으므로, 구조적인 깊이만으로 추론 품질이 보장되지는 않는다는 것이다.
병렬은 인코더까지만
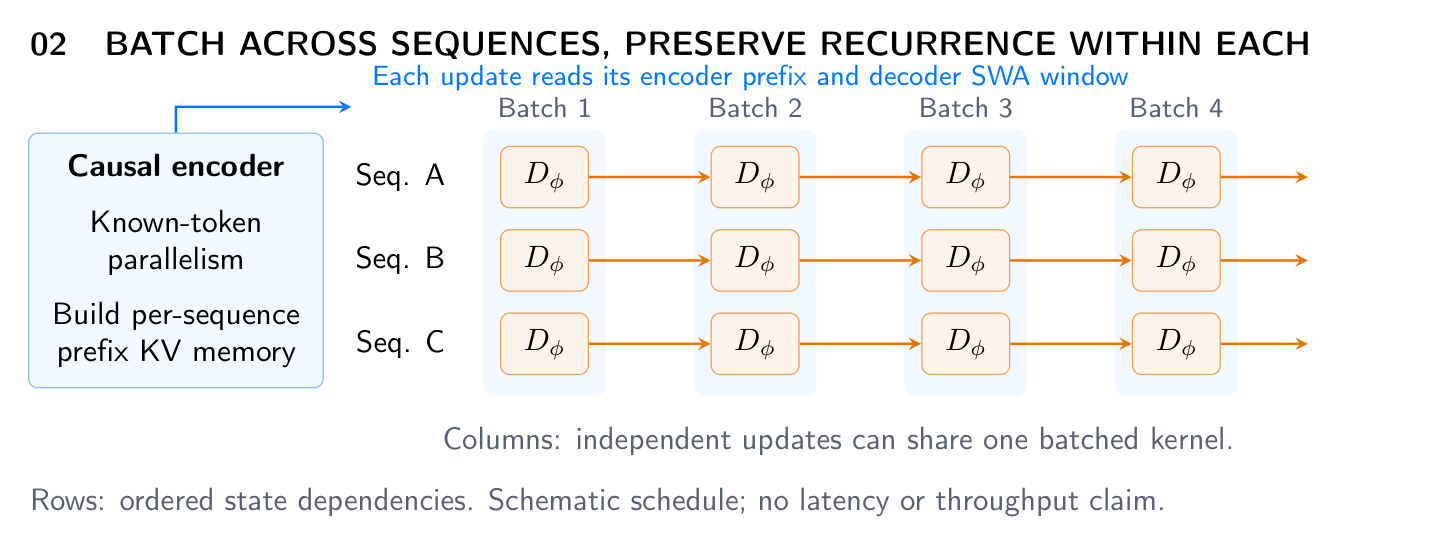
하드웨어 쪽에서 저자가 노리는 것은 재귀 코어 둘레에 병렬 작업을 모으는 일이다. 이미 알고 있는 토큰의 인코더 특징과 메모리 투영은 토큰 병렬 커널로 계산할 수 있다. 그리고 서로 독립적인 시퀀스들끼리는 준비된 디코더 전이를 한 배치로 묶을 수 있다. 위 그림의 열 하나가 그렇게 묶인 한 번의 배치 커널이고, 행 하나가 한 시퀀스의 순서 의존을 뜻한다. 각 행은 자기 인코더 접두사와 자기 슬라이딩 윈도우만 읽는다.
여기서 저자는 자기 설계의 비용을 숨기지 않는다. 인코더가 병렬로 실행되더라도 프리필 전체는 병렬이 되지 못한다. $T$번의 전이를 순서대로 지나는 디코더 경로가 남아 있고, 그 전이 하나하나가 $L_D$개의 블록을 품고 있다. 리포트의 표현을 그대로 옮기면, 상태 재귀는 산술 연산량이 기존의 조밀한 트랜스포머와 같더라도 하드웨어 활용도를 떨어뜨릴 수 있다. 저자는 프롬프트 전체를 재귀로 계산하는 비용을 감수한다. 그러면서 프리필이 빨라진다는 주장은 하지 않는다고 분명히 밝힌다.
메모리 쪽 이야기도 비슷한 방식으로 정리된다. 인코더가 만든 KV는 토큰 접두사와 파라미터가 고정된 동안에는 변하지 않으므로 재사용에 유리하다. 반면 디코더가 층마다 쌓는 슬라이딩 윈도우 캐시는 그 메모리로 대체할 수 없다. 가중치를 묶으면 저장해야 할 파라미터가 줄어든다. 그렇다고 블록을 평가하는 횟수까지 줄어들지는 않으며, 지연 시간이 낮아진다는 보장 역시 따라오지 않는다. 저자는 정규화와 게이팅과 잔차 덧셈을 커널 융합의 후보로 남겨 두면서도 한 가지를 경고한다. 크로스 어텐션은 유효한 인코더 접두사만 읽어야 하고, 슬라이딩 윈도우도 자기 구간만 읽어야 한다. 미래 항목을 미리 읽는 빠른 커널은 속도 개선으로 볼 수 없다. 그것은 모델의 동작 자체를 바꾼다.
샘플러가 남기는 것은 숫자 하나뿐
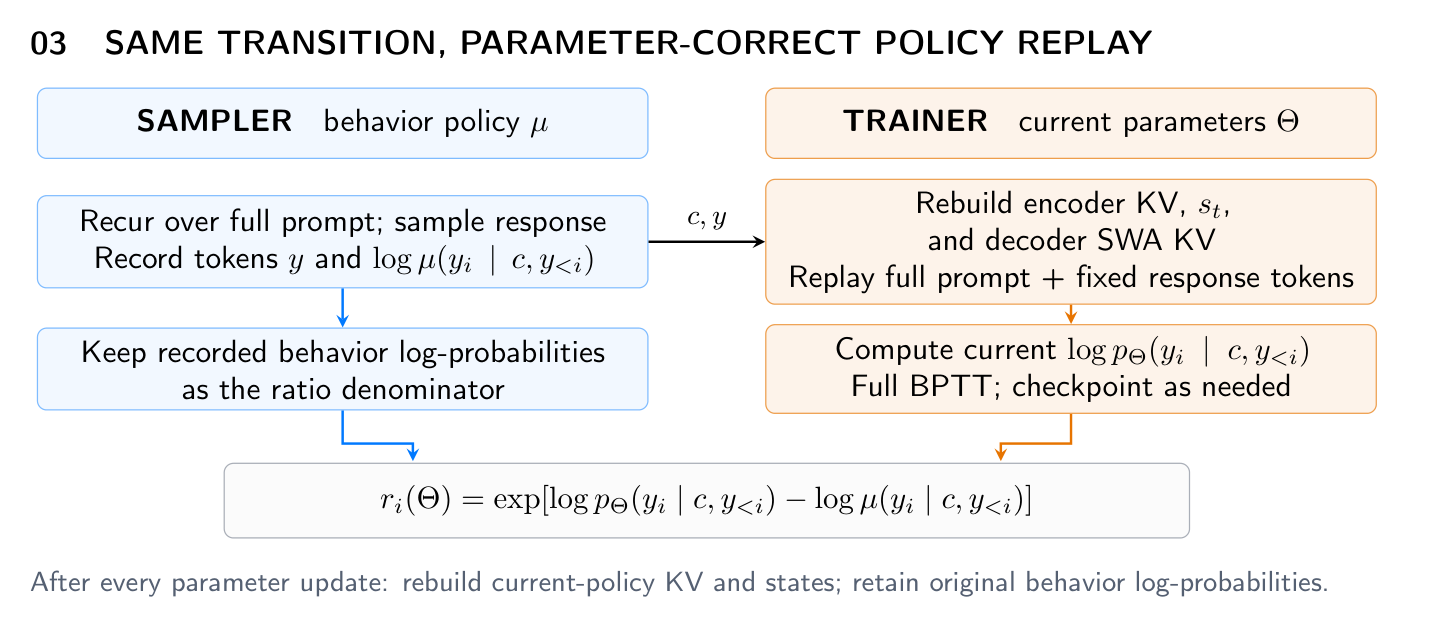
리포트에서 가장 많은 분량을 차지하는 대목은 강화학습 리플레이다. 계약 자체는 단순하게 요약된다. 샘플러는 자신이 실제로 사용한 샘플링 분포 $\mu$에서 각 행동의 로그 확률을 기록해 둔다. 트레이너는 현재 파라미터로 인코더 특징과 재귀 출력, 그리고 모든 디코더 슬라이딩 윈도우 캐시를 프롬프트 첫 토큰부터 다시 계산한다. 그렇게 얻은 현재 정책 확률과 기록해 둔 행동 확률의 비가 중요도 비율이 된다.
$$r_i(\Theta) = \exp\left(\log p_\Theta\left(y_i \mid c,\, y_{리포트는 이 계약이 무엇을 해결하지 못하는지도 비슷한 분량으로 적어 둔다.
- 절단된 샘플링은 정확한 중요도 샘플링의 조건을 깬다. top-k나 top-p로 뽑은 행동 분포는, 잘리지 않은 소프트맥스를 목표로 삼는 한 서포트 포함 조건을 대체로 위반한다. 행동 로그 확률에는 온도와 절단과 재정규화가 모두 반영되어야 하고, 메타데이터를 덧붙이는 것으로는 사라진 서포트를 되살릴 수 없다.
- 전방 확률이 같다고 정책 기울기까지 같지는 않다. 한 파라미터 값에서 확률이 일치하는 것과 기울기가 일치하는 것은 별개의 요구다. 트레이너는 재귀 목표 계산을 직접 미분하거나 그와 동등한 구현을 갖고 있어야 한다.
- 같은 전이를 쓴다는 것이 커널 수치가 같다는 증명은 아니다. 구조에서 비롯된 프롬프트 경계 불일치는 사라지지만, 정밀도와 커널의 차이는 그대로 남는다.
- 로그 확률이 정확하다고 임의의 오프폴리시 손실이 불편추정량이 되지도 않는다. 토큰 단위 클리핑 같은 대리 목적함수는 자기 몫의 알고리즘 선택을 따로 들여온다.
기울기 쪽 논의도 꼼꼼하다. 완전한 시간 역전파는 인코더 메모리와 재귀 출력과 디코더 KV를 모두 지나는 경로를 미분한다. 한 전이의 야코비안은 네 칸짜리 블록 행렬이고, $\partial s_t / \partial s_{t-1}$만 곱해 나가면 디코더 KV를 거치는 경로를 놓치게 된다. 프롬프트 구간을 기울기 추적 없이 실행하면 전방 확률은 보존되지만 프롬프트 상태의 미분이 빠지므로 그것은 근사다. 저자는 잘라낸 역전파를 선택지로 열어 두되, 어떤 텐서를 떼어 냈는지 전부 명시해야 한다고 덧붙인다. 재귀 출력만 떼면 디코더 KV를 지나는 경로가 남고, 디코더 KV만 떼면 재귀 출력을 지나는 경로가 남기 때문이다.
부록의 한 문장은 구현자가 놓치기 쉬운 지점을 겨눈다. 슬라이딩 윈도우에서 오래된 항목을 밀어내는 일은 기울기를 끊는 연산이 아니다. 밀려나기 전에 그 항목을 소비한 계산은 완전한 역전파에서 여전히 미분된다. 따라서 추론 시점의 캐시 크기는 학습 활성값 저장량의 상한이 되지 못한다.
다섯 가지 실행, 하나의 전이
리포트는 다섯 가지 실행 모드를 하나의 표로 정리한다. 전이는 하나이고, 인코더를 어떻게 실행하는지만 달라진다.
| 모드 | 인코더 | 디코더 |
|---|---|---|
| 프롬프트 프리필 | 인과 배치 | 모든 프롬프트 토큰을 지나며 완전한 상태를 갱신한다 |
| 생성 | 증분 | 직전 상태에서 표본을 뽑고, 뽑은 토큰을 정확히 한 번 소비한다 |
| 사전학습 | 인과 배치 | 유효한 모든 다음 토큰 목표에 대해 완전한 시간 역전파를 수행한다 |
| 지도 미세조정 | 인과 배치 | 어시스턴트 목표에만 손실을 걸되, 모든 맥락 토큰이 미분 가능한 상태를 갱신한다 |
| 강화학습 리플레이 | 현재 가중치로 재구성 | 전체 이력과 캐시를 재생하고, 각 행동을 소비하기 전에 점수를 매긴다 |
지도 미세조정 항목에는 조건이 하나 붙는다. 손실 마스킹은 상태 갱신까지 가리지 않는다. 사용자 메시지와 도구 응답도 디코더를 지나며 상태를 바꾸고, 어시스턴트 손실에서 나온 기울기는 그 프롬프트 계산까지 흘러 들어간다. 어시스턴트 경계에서 상태를 되돌리지 않으므로, 프롬프트와 응답의 계산이 달라서 생기는 어긋남을 따로 메우는 목적함수도 필요하지 않다.
사전학습 쪽에는 다른 조건이 붙는다. 문서가 서로 독립이면 재귀 출력, 디코더 캐시, 인코더 캐시, 위치를 모두 초기화해야 한다. 어텐션 마스크도 함께 분리해야 한다. 손실 마스크로 어텐션 마스크를 대신할 수는 없고, 문서 상태의 완전한 초기화를 대신할 수도 없다.
여러 턴에 걸친 서빙
대화는 문장 시작 토큰인 BOS에서 출발하는 하나의 토큰 이력으로 직렬화된다. 새 사용자 메시지도, 도구 결과도, 역할 구분자도 모두 인코더와 디코더의 갱신을 받는다. 도구가 값을 돌려주면 캐시된 인코더 접두사를 써서 새로 관측된 구간을 인코딩하고, 디코더는 기존 상태에서 새 토큰을 하나씩 지나간다. 초기화는 새로운 독립 시퀀스를 시작할 때나 맥락 초기화를 명시적으로 정의했을 때만 일어난다.
정확한 접두사 스냅샷이 담아야 할 것은 여섯 가지다. 인코더 캐시, 인코더가 만든 크로스 어텐션 메모리, 완전한 디코더 상태, 토큰과 위치 메타데이터, 슬라이딩 윈도우 규약, 그리고 모델 버전이다. 가중치가 같다면 이 스냅샷은 추론에 재사용할 수 있다. 상태가 서빙 분할 위치와 무관하기 때문이다. 샘플링 결과까지 재현하려면 샘플러의 난수 상태도 함께 있어야 한다.
접두사를 지우거나 고치거나 잘라 내면 조건화 이력 자체가 달라진다. 그럴 때는 지워진 내용을 품은 상태를 붙들고 있지 말고 유효한 이전 체크포인트에서 다시 계산해야 한다. 앞선 토큰을 고쳐 쓰는 템플릿은 덧붙이기 전용 캐시 연산으로 처리할 수 없다. 여러 턴에 걸친 강화학습에서는 외부가 공급한 토큰도 완전한 상태를 갱신한다. 그러나 정책이 뽑은 행동은 아니므로 중요도 비율의 인수에는 들어가지 않는다. 그러면서도 그 토큰의 상태 갱신은 미분 가능하게 남아 있어야 한다.
선행 연구 앞에서
관련 연구 절은 여덟 갈래를 훑는다. 트랜스포머 인코더와 순환 디코더를 결합한 하이브리드는 2018년 기계번역 연구에 이미 있었고, 인코더가 만든 메모리를 재사용하는 구조는 YOCO와 DeepSeek-V4.1-Flash가 앞서 보여 주었다. 이전 표현을 미래 계산에 노출하는 시간 방향 피드백은 Feedback Transformer와 Recurrent Transformer가 앞서 다루었다. 토큰을 가로지르는 잠재 피드백에는 Full-bandwidth Transformer와 T2MLR과 Latent Recurrent Transformer가 있다. 토큰 공간 바깥에서 연속 계산을 수행한 사례로는 Coconut과 PonderLM-2가 꼽힌다. 블록과 세그먼트 단위의 순환은 Block-Recurrent Transformers와 Recurrent Memory Transformer가 제시했고, 깊이 방향의 재사용은 Universal Transformers와 잠재 순환 깊이 연구가 선례로 남겼다.
저자는 이 목록 앞에서 자기 기여를 좁게 잡는다. 저자에 따르면 RLT의 차이는 피드백이 들어가는 위치와 메모리의 표현 방식에 있다. 초점은 디코더 전체를 통과하는 재귀와 그 하드웨어 실행, 그리고 강화학습 리플레이 의미론을 한자리에서 명세했다는 데 있다. 가중치를 묶는 것도, 시간 방향의 순환도, 그 자체로는 새로움이나 품질 향상을 입증하지 못한다는 문장이 절의 끝에 놓여 있다.
그중 T2MLR을 다루는 문단은 따로 읽어 볼 만하다. 그 연구의 실험은 네트워크 전체를 거치는 순환보다 중간층에 국한된 순환이 더 나을 수 있음을 보여 주었다. 저자는 그 결과를 옮겨 적으면서, 더 깊은 재귀 블록이 자동으로 더 낫지는 않다고 덧붙인다. 자기 설계가 택한 방향에 불리한 선행 결과를 요약문 안에 그대로 넣어 둔 셈이다.
가장 눈여겨본 것
19쪽 가운데 절반 가까이가 무엇이 등가이고 무엇이 등가가 아닌지를 가르는 데 쓰인다. 프롬프트를 어디서 끊어도 분포가 같다는 말은 수학의 층위에서만 성립한다. 인코더 쪽의 병렬성은 프리필 전체로 옮겨 가지 않는다. 전방 확률이 맞아떨어지는 것과 기울기가 맞아떨어지는 것은 다른 사건이다. 슬라이딩 윈도우에서 항목을 밀어내도 기울기는 끊기지 않는다. 아키텍처 제안서라기보다 실행 계약서를 읽는 기분이었다.
저자의 다른 작업을 보면 이 형식이 어디서 왔는지 짐작이 간다. 그는 한 달 전에 강화학습 스케일링이 프리필과 디코드의 커널 불일치를 고려해야 한다는 노트를 냈다. 학습기와 샘플러가 같은 가중치를 쓰면서도 다른 커널을 타는 바람에 정책이 어긋나는 문제다. RLT는 그 어긋남 가운데 구조에서 비롯된 몫을 아키텍처 차원에서 없애 보려는 시도이고, 남는 몫이 무엇인지를 매번 이름을 붙여 떼어 놓는다.
나는 이런 글이 검증하기 좋은 글이라고 생각한다. 성능 주장이 없으니 반박할 수치도 없지만, 대신 여기 적힌 등가 관계는 구현자가 하나씩 확인할 수 있다. 그 확인이 끝나도 남는 질문은 그대로다. 길이가 $48t$인 경로가 실제로 유용한 계산을 담아내는가. 재귀 때문에 떨어지는 가속기 활용도를 배치와 커널 융합으로 메울 수 있는가. 이 리포트는 두 질문에 답하지 않는다. 저자 자신이 결론의 마지막 문장에 그렇게 적어 두었다.
출처
Yifan Zhang, “Recurrent Looped Transformer”, 테크리포트, 2026년 9월 12일.
- 프로젝트 페이지: https://yifanzhang-pro.github.io/recurrent-looped-tranformer/
- 전체 리포트 PDF: https://yifanzhang-pro.github.io/recurrent-looped-tranformer/Recurrent_Looped_Transformer.pdf
- 프리필과 디코드의 커널 불일치 노트: https://github.com/yifanzhang-pro/Pretraining-RL-Science/blob/master/Prefill_Decode_Kernel_Mismatch.pdf
본문에 실은 도식 네 장은 저자가 공개한 테크리포트 PDF의 그림 1부터 4까지를 잘라 인용했다.