3줄 요약
- 샤오미가 2026년 9월 22일 MiMo-V2.6 시리즈를 발표하고 가중치를 오픈소스로 배포했다. 시리즈는 네이티브 옴니모달 모델 두 종으로 이루어진다. MiMo-V2.6-Pro는 샤오미가 지금까지 만든 가장 성능이 높은 모델이고, MiMo-V2.6-Flash는 지능과 효율과 비용의 균형을 목표로 한 모델이다. MiMo-V2.6-Pro-UltraSpeed도 품질을 유지하면서 출력 속도를 최대 20배까지 높인 모드로 함께 공개됐다.
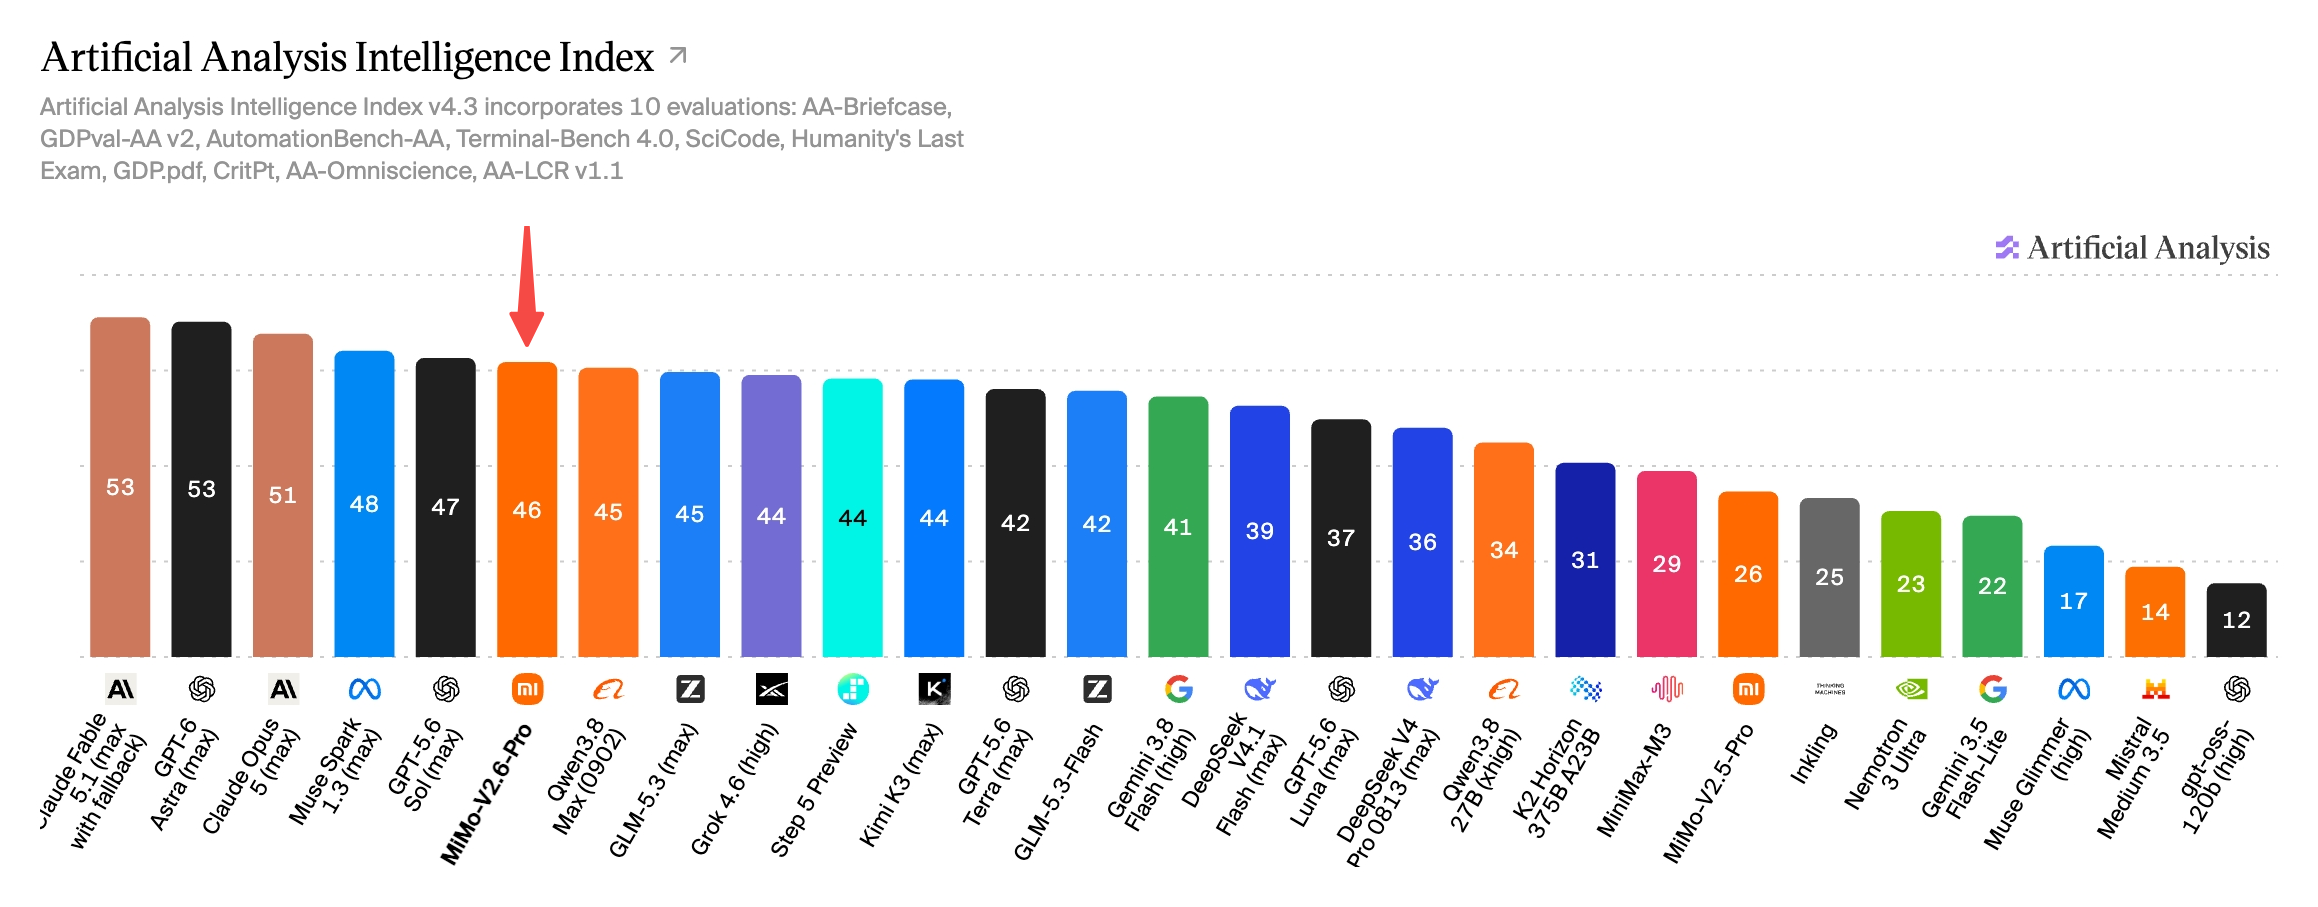
- MiMo-V2.6-Pro는 Artificial Analysis Intelligence Index v4.3에서 46.32점을 받았다. 샤오미는 이 점수가 Kimi K3와 Qwen3.8 Max보다 높은 오픈소스 최고 기록이라고 밝혔다. API 가격은 V2.5 시리즈와 동일하게 유지했으므로, 이용자 입장에서는 같은 값을 내고 더 높은 성능을 쓰는 셈이 된다.
- 발표문은 모델 소개 못지않게 학습 과정을 설명하는 데 많은 분량을 썼다. 6일이 채 걸리지 않은 30스텝 RL 학습에 Flash는 85만 달러, Pro는 262만 달러가 들었다고 한다. 학습에 쓴 환경과 코드까지 공개 대상에 넣었다.
무엇을 내놓았는가
발표문의 부제는 “Frontier intelligence, all the modalities, built in public"이다. 샤오미는 이번 릴리스를 RSI(재귀적 자기 개선)를 탐색하는 과정의 중요한 단계라고 설명했다. 검증이 가능한 복잡한 과제에 RL 컴퓨트를 계속 투입하면 모델이 탐색과 피드백을 통해 스스로 수행 가능한 과제의 범위를 확장한다는 것이 샤오미가 내세운 가설이다.
| 모델 | 설명 |
|---|---|
| MiMo-V2.6-Pro | 시리즈 최상위 모델. 네이티브 옴니모달 |
| MiMo-V2.6-Flash | 지능과 효율과 비용의 균형을 겨냥한 모델. 네이티브 옴니모달 |
| MiMo-V2.6-Pro-UltraSpeed | Pro와 같은 품질에 출력 속도를 최대 20배로 올린 모드 |
Artificial Analysis 지수의 성적
MiMo-V2.6-Pro의 46.32점은 2026년 9월 기준 Artificial Analysis Intelligence Index v4.3에서 전체 여섯 번째에 해당한다. 이보다 점수가 높은 모델은 다섯 종이다. Claude Fable 5.1(max with fallback)과 GPT-6 Astra(max)는 53점, Claude Opus 5(max)는 51점, Muse Spark 1.3(max)은 48점, GPT-5.6 Sol(max)은 47점이다. 뒤이어 Qwen3.8 Max(0902)와 GLM-5.3(max)이 공동 45점이다.
세대 차이를 보면 이번 상승폭이 드러난다. 같은 지수에서 MiMo-V2.5-Pro는 26점이었다. 한 세대 만에 지수 점수가 20점가량 올라갔다.
샤오미는 순위보다 가격 대비 성능을 강조했다. 아래 그림은 가로축이 태스크당 비용의 로그 척도이고 세로축이 지수 점수인 산점도다. MiMo-V2.6-Pro보다 점수가 높은 다섯 모델은 모두 가로축에서 오른쪽, 다시 말해 비용이 비싼 쪽이다. 45점을 받은 Qwen3.8 Max도 MiMo보다 태스크당 비용이 비싸다.
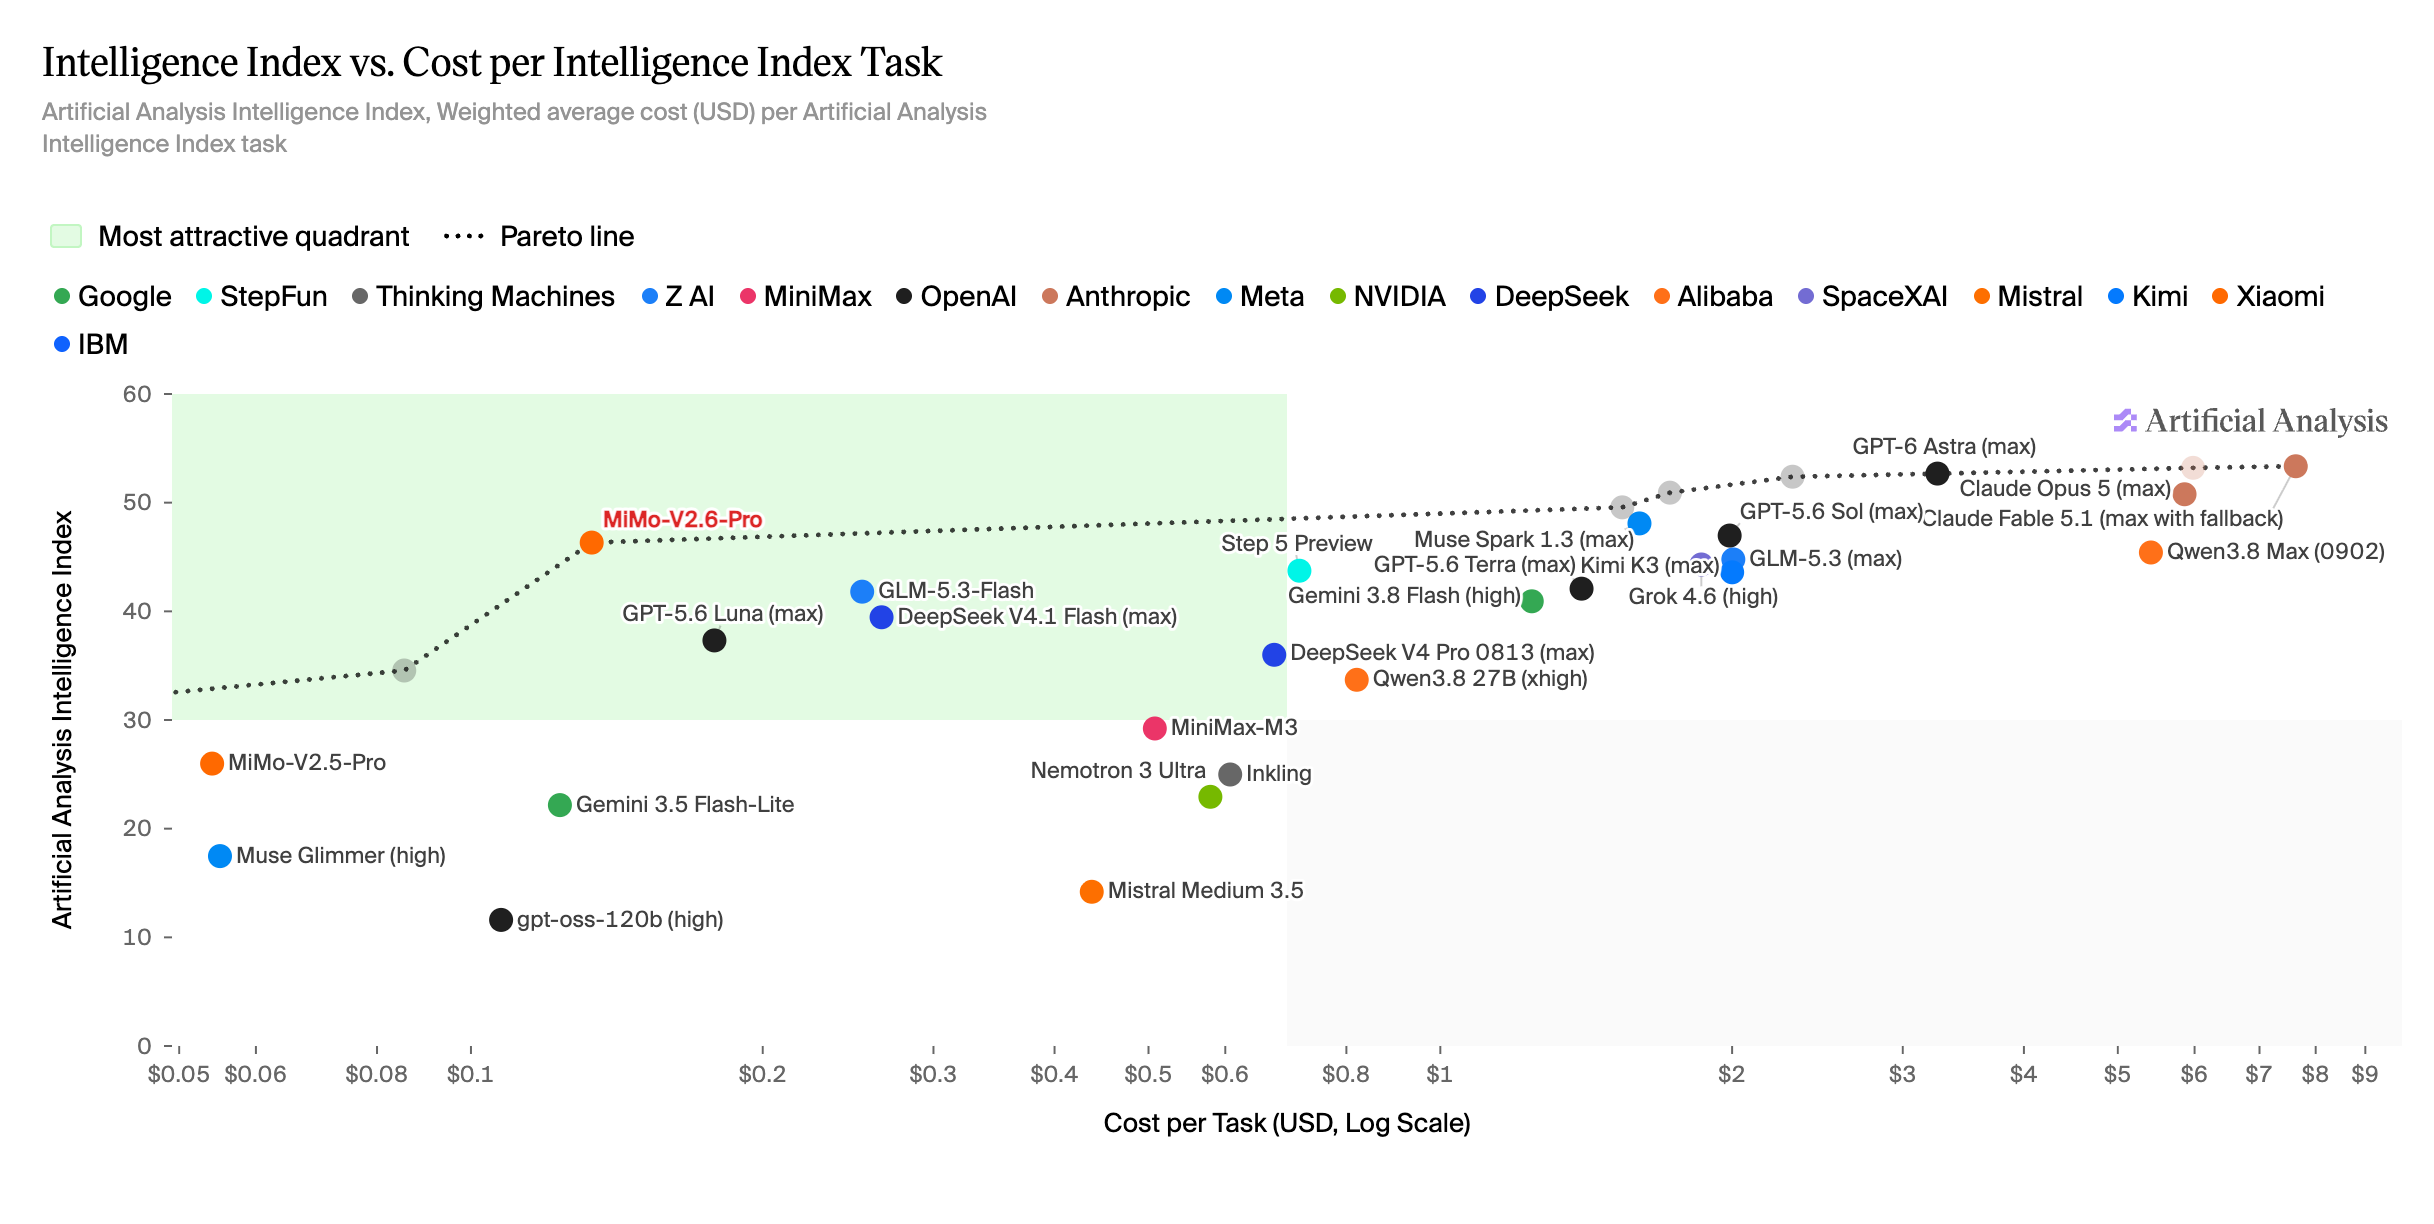 그림 1. 지수 점수와 태스크당 비용. 연두색 영역이 Artificial Analysis가 표시한 가장 매력적인 사분면이고, 점선이 파레토 선이다. 출처: Artificial Analysis
RL 컴퓨트를 어떻게 늘렸는가
샤오미는 RL 학습의 연구와 엔지니어링 문제를 해결하는 과정을 공개했고, 실제 프로덕션 런이 진행되는 동안 그 과정을 생중계했다. 결과 숫자부터 정리한다.
| 항목 | MiMo-V2.6-Flash | MiMo-V2.6-Pro |
|---|---|---|
| RL 스텝 | 30 | 30 |
| 학습 기간 | 6일 미만 | 6일 미만 |
| 트라젝터리 | 약 75만 개 | 약 75만 개 |
| 비용 | 약 85만 달러 | 약 262만 달러 |
| 학습 과제 평균 통과율 상승 | 상대 25% | 상대 12% |
| DeepSWE v1.1 점수 | 48.8 → 65.68 | 58.4 → 72.57 |
DeepSWE v1.1은 학습에 쓰지 않은 장기 소프트웨어 엔지니어링 벤치마크다. 샤오미는 RL 학습의 샘플 효율이 높았고, 런이 끝날 때까지 점수가 계속 올랐으며, 학습에 쓰지 않은 분포의 과제에도 일반화됐다고 정리했다.
샤오미는 RL 컴퓨트를 세 방향으로 늘렸다.
- 배치와 처리량: 완전 비동기 아키텍처 위에서 업데이트마다 1,568개 샘플을 썼다. 컨텍스트 길이는 최대 100만 토큰이고, 스텝당 처리 토큰 수는 35억에서 37억 개였다.
- 과제와 환경: 코딩, 범용 에이전트, 비주얼, 사이버를 아우르는 멀티태스크 학습 과제군을 여러 하네스에 혼합해 학습시켰다. 한 능력에서 얻은 개선이 다른 능력을 보강하도록 설계했다고 한다.
- 채점 컴퓨트: 그룹 내 상대 비교를 수행하는 방식으로 장기 RL 과제에 더 정밀하고 더 다양한 보상 신호를 줬다. 샤오미는 이 구성이 자기 개선 루프를 완결하고, 모델이 더 짧은 경로와 더 적은 토큰을 쓰도록 유도한다고 설명했다.
발표문은 규모를 늘리면서 생긴 문제도 함께 적었다. 샤오미는 학습 드리프트를 억제하려고 라우터를 동결했고, 보상 해킹에 대비해 보상 설계와 적대적 평가, 이상 탐지, 검증기 사이의 교차 확인으로 구성한 방어 체계를 마련했다. 샤오미는 이 두 조치가 학습 안정성과 보상 신뢰도를 함께 높였다고 했다.
발표문은 이기종 과제에 걸친 대규모 에이전틱 RL을 지원하려고 개선한 항목도 나열했다. 샤오미는 통합 트라젝터리 표현과 페널티 메커니즘을 설계해 더 세밀한 학습 신호를 확보했다. 여러 에이전트 프레임워크에 걸쳐 높은 동시성으로 상호작용할 수 있게 했다. 대규모 트라젝터리 이전을 지원하려고 컨트롤 플레인과 데이터 플레인을 분리했고, 혼합 배치에서는 과제별 샘플링 비율을 안정화했다. 학습 엔진과 추론 엔진 각각도, 둘 사이의 일관성도 최적화 대상이었다.
샤오미는 위 내용을 전부 오픈소스로 공개한다고 밝혔다. 전체 기술 보고서, 학습 환경, RL 코드가 여기에 포함된다. 연구자들이 결과를 재현하고 검증한 다음 함께 다음 단계를 탐색하자는 것이 공개의 명분이다.
바이브 코딩에서 바이브 월드로
샤오미는 MiMo의 코딩 능력이 소프트웨어 엔지니어링에 한정되지 않는다고 주장한다. 목표와 하네스와 시간을 주면 모델이 실제 생산적인 일을 맡아 만들고 테스트하고 배포하며 경제적 가치를 계속 만들어 낸다는 설명이다. MiMo-V2.6은 3D 공간 추론과 멀티모달 인식, 컴퓨터 사용 에이전트(CUA) 능력을 통합했고, 자연어로 지시하는 프로그래밍의 대상을 소프트웨어에서 인터랙티브 월드까지 확장했다. 샤오미는 이것을 “Vibe World"라고 부른다.
게임 개발
이미지, 영상, 텍스트 프롬프트를 받으면 MiMo-V2.6은 요청을 여러 과제로 분해한다. 이어 다수의 에이전트를 조율해 3D 씬과 인터랙션 로직을 만들고 시각 검증을 수행한다. 렌더 결과를 바탕으로 반복해서 수정한 뒤, 사용자 의도에 맞는 실행 가능한 인터랙티브 월드를 내놓는다.
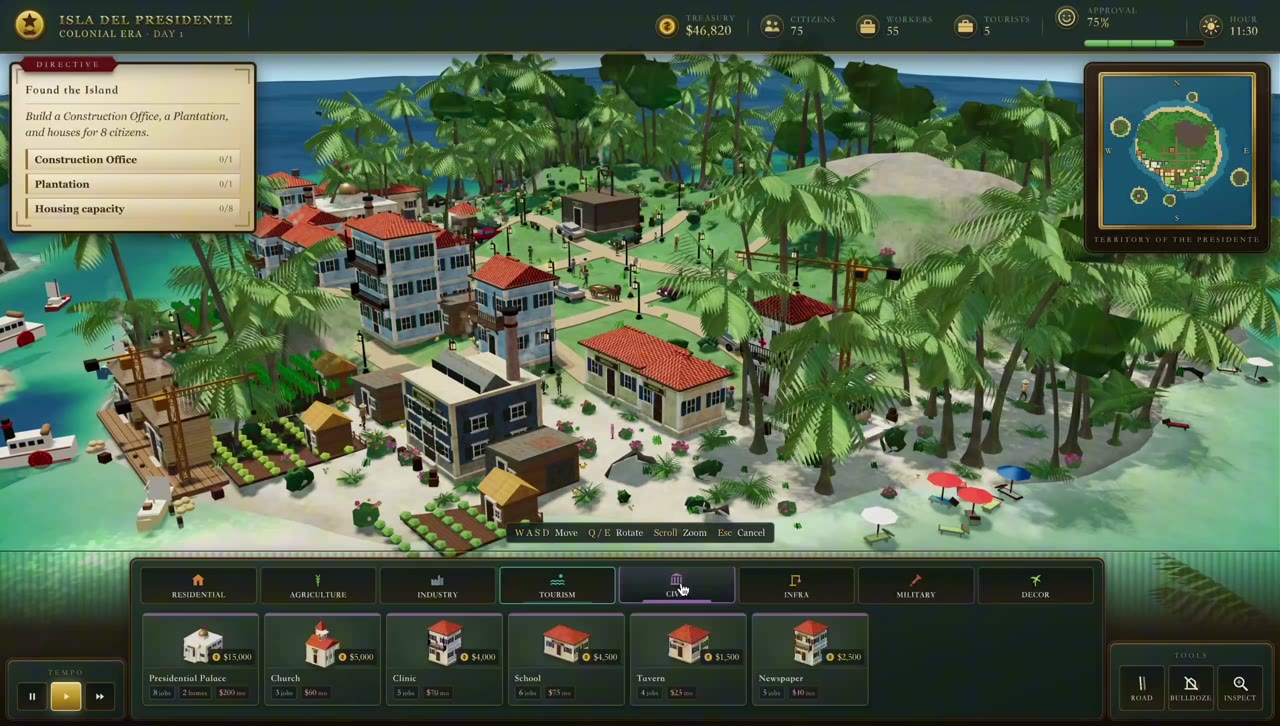 그림 2. 게임 개발 사례로 공개된 3D 도시 건설 게임 화면. 출처: 샤오미 MiMo-V2.6 발표 페이지
3D 모델링
MiMo-V2.6은 텍스트 설명이나 레퍼런스 이미지를 받아 블렌더에서 3D 오브젝트와 씬을 생성한다. 샤오미는 결과물의 용도로 애니메이션과 3D 프린팅, 게임 개발을 들었다.
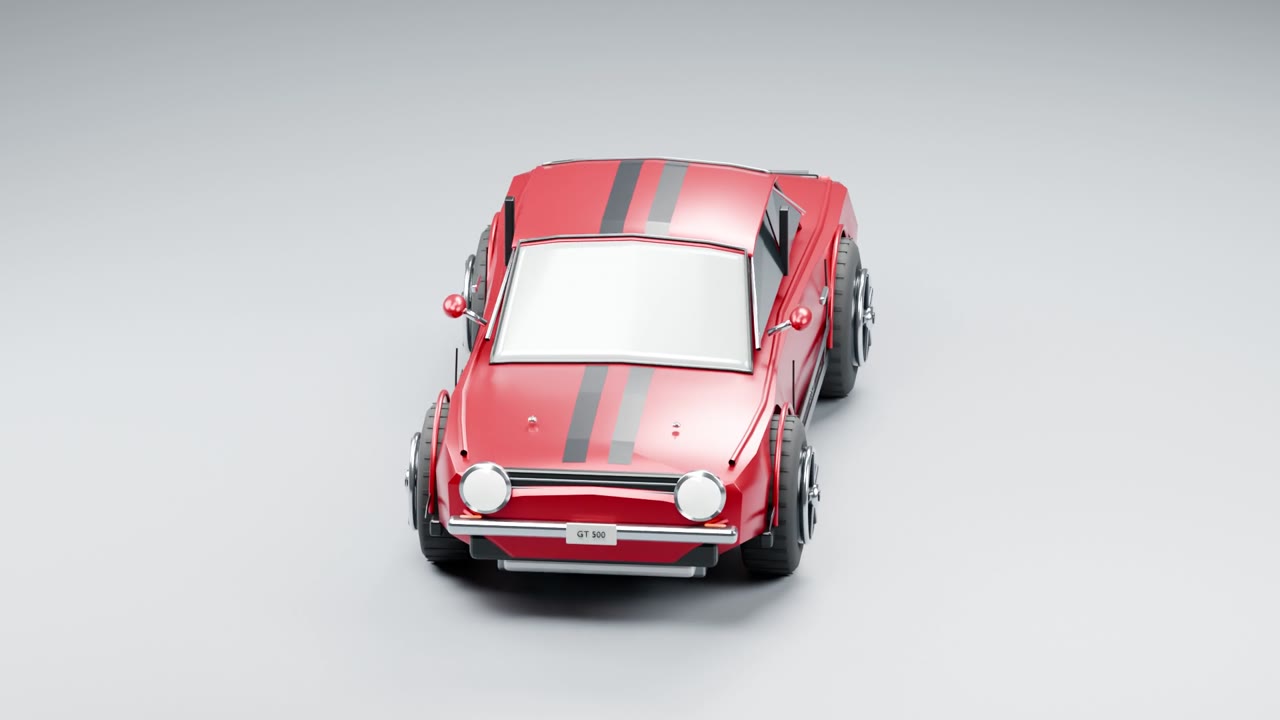 그림 3. 블렌더에서 생성한 3D 모델 사례. 출처: 샤오미 MiMo-V2.6 발표 페이지
임바디드 시뮬레이션
임바디드 시뮬레이션 환경에서는 MiMo-V2.6이 멀티뷰 카메라 영상을 직접 입력으로 받는다. 모델이 계속 추론하며 판단을 내리고, 시각 피드백을 통한 폐루프 제어로 프랑카 판다 로봇 팔을 조종해 물체를 집고 색을 맞추고 정확한 위치에 내려놓는다.
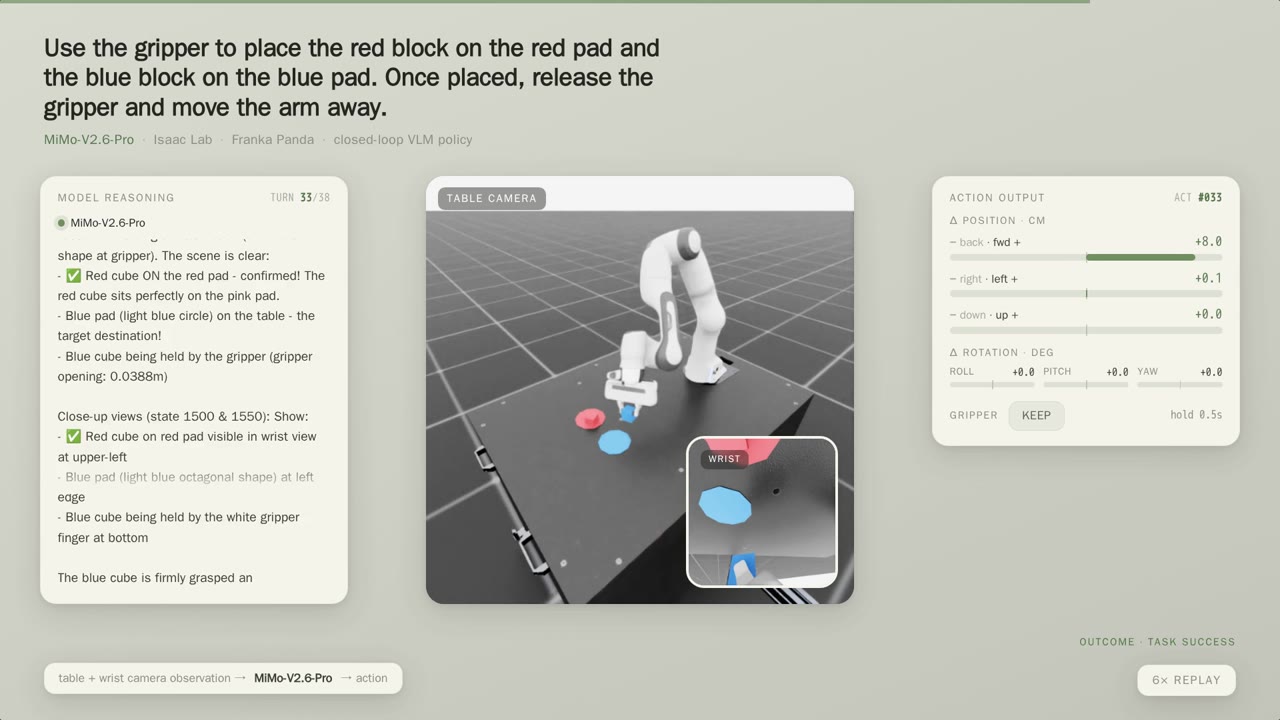 그림 4. 프랑카 판다 로봇 팔을 폐루프로 제어하는 임바디드 시뮬레이션. 출처: 샤오미 MiMo-V2.6 발표 페이지
비주얼과 디자인
MiMo-V2.6은 간단한 지시 하나를 완성된 프론트엔드 인터페이스나 슬라이드 덱으로 바꾼다. 구조화된 레이아웃과 공들여 설계한 컴포넌트, 인터랙티브 요소와 풍부한 애니메이션이 함께 나온다. 샤오미는 모델이 피그마와 이미지 및 영상 생성 도구를 능숙하게 다루며 타이포그래피와 색, 텍스트와 이미지의 배치를 일관되게 유지한다고 설명했다. 공개된 슬라이드 사례는 세 편이며 각각 한 줄짜리 브리프에서 시작했다. 사례는 LLM 학습 원리를 다루는 사내 엔지니어링 교육, 핵심 광물 슈퍼사이클 리서치 노트, 회사 첫 연차보고서의 세 가지 방향을 제안하는 디자인 리뷰였다.
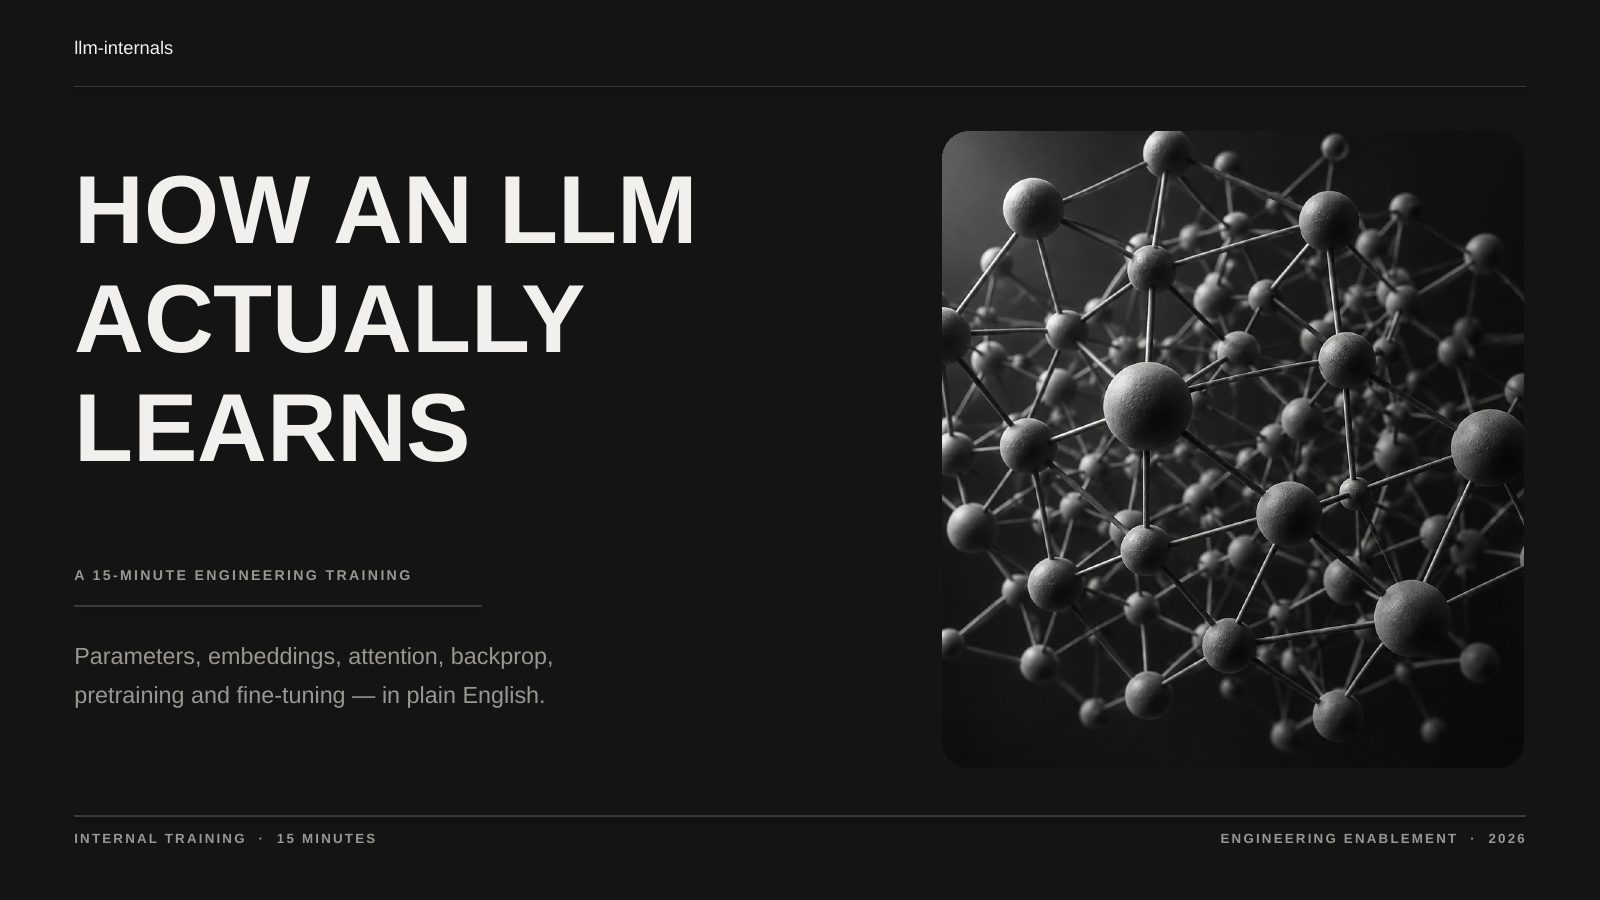 그림 5. 한 줄 브리프에서 생성한 사내 교육 슬라이드의 표지. 출처: 샤오미 MiMo-V2.6 발표 페이지
영상과 음악
영상 제작에서는 MiMo-V2.6이 비주얼 디자인과 샷 및 모션 시퀀싱, 음악 작곡, 비트에 맞춘 편집까지 처리한다. 교육 영상에서는 푸리에 분해 같은 추상 개념을 쉬운 설명과 이어지는 애니메이션으로 바꾸고, MiMo-V2.5-TTS로 화면과 정확히 맞물리는 내레이션을 생성한다.
음악은 샤오미가 이번에 처음 시도한 영역이다. 샤오미는 MiMo-V2.6-Pro에 악기 열 개로 편성한 관현악곡을 요청했다. 모델은 악보를 쓴 뒤 스스로 MIDI로 변환했다. 완성곡 제목은 “Night Road"다. 편성에는 현악기와 오보에, 클라리넷, 트럼펫, 트롬본, 프렌치 호른, 글로켄슈필, 팀파니가 포함된다. 두 번째 사례로는 A단조 피아노곡 두 편을 느린 템포와 보통 템포로 각각 받았다. 샤오미는 현재 수준을 데모 품질이라고 평가하면서, 전문 작곡가와 편곡자를 돕는 보조 역할의 가능성을 봤다고 적었다.
연구 과제에 붙여 본 결과
과학 연구를 목표로 한 별도의 RL을 수행하지 않았는데도 여러 연구 분야에서 가능성이 확인됐다는 것이 샤오미의 설명이다. 발표 페이지는 두 가지 사례를 제시했다.
재료 연구의 공동 연구자. 샤오미의 재료 전문가들이 MiMo-V2.6-Pro에게 과불화화합물(PFAS)을 흡착하는 새로운 금속 유기 골격체(MOF) 재료를 설계하라고 여러 차례에 걸쳐 요청했다. 모델은 웹 검색을 수행하고 관련 문헌과 특허를 검토한 다음 가설을 제안하고 신규성을 평가했다. 이어 드라이 실험을 진행했다. 오픈소스 계산 도구를 호출하고 시뮬레이션 환경을 자동으로 구성해 MOF 재료와 PFAS 사이의 결합 세기를 계산했다. 그 뒤 습식 실험 단계의 유망 후보를 선별했다. 발표 페이지는 세공 벽의 리간드가 서로 다른 UiO-67형 Zr₆ 골격체 세 종을 후보로 제시한다.
수학 증명의 형식화. MiMo-V2.6-Pro는 리와 요크의 고전 논문 “Period Three Implies Chaos"의 주정리 전체를 Lean 4로 형식화하는 작업을 도왔다. 이 정리는 구간 위의 연속 자기 사상에 주기가 3인 궤도가 있으면, 모든 양의 정수를 주기로 하는 궤도와 비가산 스크램블 집합도 존재한다는 내용이다. 연구자가 설계한 탐색 전략을 따라 모델이 서브에이전트 협업으로 정리 서술과 증명의 형식화를 함께 진전시켰다. 추가 수정과 통합을 거친 최종 프로젝트는 6,000줄이 넘는 Lean 소스 코드다. 증명 전체는 Lean 커널로 검증됐고, 미완성으로 남겨 둔 증명은 하나도 없었다. 이 모델은 Lean 전용 사후 학습을 받은 적이 없다.
이용 경로와 가격
MiMo-V2.6-Pro와 MiMo-V2.6-Flash는 발표 당일부터 AI Studio와 MiMo Code, MiMo Desktop, MiMo API Platform, OpenRouter에서 쓸 수 있다.
MiMo Desktop은 얼리 액세스를 끝내고 첫 정식 릴리스를 냈다. 두 모델이 기본 탑재되며, UltraSpeed 모드도 여기서 처음 제공된다. 실시간 상호작용이나 응답 시간에 민감한 워크플로가 대상이다. 기존 얼리 액세스 프로그램은 일주일 더 운영되며, 기존 권한 이용자는 모델 이름을 새 이름으로 바꿔야 계속 쓸 수 있다.
API 가격은 V2.5 시리즈에서 바뀌지 않았다. 단위는 100만 토큰당 미국 달러다.
| 모델 | 입력(캐시 적중) | 입력(캐시 미적중) | 출력 |
|---|---|---|---|
| MiMo-V2.6-Flash | $0.0028 | $0.14 | $0.28 |
| MiMo-V2.6-Pro | $0.0036 | $0.435 | $0.87 |
| MiMo-V2.6-Pro-UltraSpeed | $0.036 | $4.35 | $8.7 |
캐시 쓰기는 한시적으로 무료다. 대량 이용 비용을 예측 가능하게 관리하려는 이용자를 위해 토큰 플랜도 따로 있다. 중국 내 위안화 가격은 별도 페이지에 안내되어 있다.
부록: 전체 벤치마크
발표 페이지가 부록으로 공개한 전체 비교표다. 모든 수치는 샤오미가 발표한 값이며 2026년 9월 22일 기준이다. 굵은 글씨가 각 행의 최고 점수이고 하이픈은 결과 없음을 뜻한다. GDPVal 2.1은 Artificial Analysis가 보고한 Elo 레이팅이라 다른 행과 척도가 다르다.1
| 벤치마크 | V2.6 Pro | V2.6 Flash | V2.5 Pro | DS V4.1 F | Kimi K3 | Opus 5 | GPT-5.6 Sol | Fable 5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|---|---|---|---|---|---|
| 코딩 | ||||||||||
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.2 | 69.0 | 74.0 | - | 70.0 | 74.0 | - |
| ProgramBench | 26.5 | 26.0 | 12.5 | 20.3 | 24.5 | 37.0 | 25.0 | 33.0 | - | - |
| MiMo Code Bench (자체) | 63.2 | 61.2 | 40.4 | 60.2 | 60.1 | 68.6 | 59.3 | - | 61.4 | - |
| 일반 | ||||||||||
| GDPVal 2.1 (AA, Elo) | 1673 | - | 1107 | 1600 | 1524 | 1708 | 1588 | 1595 | 1542 | 1735 |
| Toolathlon-verified | 76.9 | 73.6 | 49.1 | - | 76.5 | 80.6 | 74.9 | 77.9 | - | 77.8 |
| Automation Bench v1.0.6 | 53.1 | 52.3 | 16.0 | 54.8 | 46.7 | 50.3 | 45.8 | 46.2 | 52.0 | - |
| Agents’ Last Exam | 31.6 | 27.6 | 13.2 | 31.8 | 28.3 | 31.6 | 30.8 | 25.7 | 34.2 | - |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 26.8 | 12.6 | 49.0 | 39.9 | 42.4 | 59.6 | 55.1 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 90.6 | 88.3 | 89.1 | 88.8 | 84.3 | 89.9 | 91.4 |
| OSWorld-Verified | 82.0 | 80.8 | - | - | 84.8 | 83.4 | 83.0 | 86.0 | - | - |
| JobBench | 62.0 | 61.2 | 25.0 | 45.8 | 54.3 | 65.7 | 45.4 | 57.4 | - | - |
| 비주얼 | ||||||||||
| MiMo Visual Coding (자체) | 72.3 | 71.5 | - | 70.6 | 70.3 | 70.0 | 73.4 | 69.1 | 82.2 | 74.4 |
| 사이버 | ||||||||||
| CyberGym | 94.0 | 95.1 | 40.0 | 88.1 | 80.0 | - | - | - | - | - |
| ExploitGym | 17.8 | 6.0 | 0.1 | 15.3 | 8.1 | 22.1 | 30.3 | 28.4 | 42.4 | 30.4 |
| ExploitBench | 47.9 | 25.3 | 16.6 | - | 32.2 | 70.0 | 78.5 | 78.0 | 100.0 | 83.0 |
| SEC Bench Pro | 66.3 | 47.5 | 17.7 | 62.8 | - | - | 79.1 | - | 85.4 | - |
| MiMo Cyber Bench (자체) | 81.7 | 77.2 | 0.0 | 62.7 | 56.3 | - | - | - | - | - |
내가 오래 들여다본 숫자
부록 표에는 벤치마크가 열일곱 개 실려 있는데, MiMo 계열이 1등을 기록한 항목은 그중 두 개다. CyberGym에서 Flash가 95.1점을 받았고, 샤오미가 직접 만든 MiMo Cyber Bench에서 Pro가 81.7점을 받았다. 나머지 열다섯 개에서는 GPT-6 Astra, Claude Opus 5, Claude Fable 5.1, Claude Fable 5, DeepSeek V4.1 Flash가 각각 최고 점수를 기록했다. 그런데도 종합 지수에서 MiMo-V2.6-Pro는 여섯 번째 점수를 받았다. 종합 지수는 항목별 1등 횟수를 세지 않는다. 모든 항목에서 고르게 상위권이면 점수가 올라간다. 샤오미의 주장도 이것이다. 절대 성능에서 1위라고 주장하지 않지만, 같은 비용을 들인다면 1위라는 것.
세대 차이도 다시 계산해 봤다. 같은 표에서 MiMo-V2.5-Pro와 V2.6-Pro를 비교하면 DeepSWE v1.1이 19.0에서 71.9로, Terminal Bench 4.0이 1.5에서 34.9로, 자체 사이버 벤치마크가 0.0에서 81.7로 올랐다. 숫자만 보면 이전 세대는 에이전틱 과제를 거의 수행하지 못했다. 공개된 학습 곡선에서 Pro의 DeepSWE 점수는 첫 스텝 58.41에서 마지막 스텝 72.57로 올랐다. 이번 RL 30스텝의 몫은 14점가량이다.2
비용도 한참 들여다봤다. RL 프로덕션 런에 들어간 달러 금액을 숫자로 공개한 릴리스는 드물다. 스텝당 비용은 Flash 약 2.8만 달러, Pro 약 8.7만 달러다. 앞에서 본 14점과 함께 계산하면, Pro가 DeepSWE 1점을 올린 데 소비한 비용은 20만 달러에 조금 못 미친다. 이 정도 단가라면 스텝을 더 돌리는 편이 나은 선택일 텐데, 샤오미가 왜 30에서 멈췄는지는 발표 페이지에 적혀 있지 않다. 그 판단의 근거는 기술 보고서에서 찾아야 할 것 같다.
출처
Xiaomi MiMo, 2026년 9월 22일 발표 원문: https://mimo.xiaomi.com/mimo-v2-6 기술 보고서: https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL/blob/main/MiMo_V2_6_technical_report.pdf 모델 컬렉션: https://huggingface.co/collections/XiaomiMiMo/mimo-v26 RL 학습 중계: https://mimo.xiaomi.com/rl 재료 연구 사례: https://mimo.xiaomi.com/blog/mimo-v2-6-material-research Lean 4 코드: https://mimocode-cdn.xiaomimimo.com/mimocode/blog/mimo-v2-6/LiYorke-lean.zip
본문 그림은 모두 발표 페이지에서 인용했다.