3줄 요약
- 프론티어 언어모델(Astra, Fable 5.1)은 별도 미세조정 없이도 신경망 가중치 행렬을 직접 읽고 수정할 수 있다. MIT CSAIL 연구진은 이 능력을 가중치 공간 프로그래밍(Weight-Space Programming)이라 부르고 8가지 실험으로 입증했다.
- 언어모델은 프롬프트에 텍스트로 주어진 가중치 1만 7천여 개에서 17만여 개만 읽고도 학습된 게임을 100% 식별했고, 백도어 트리거와 어텐션 복사 헤드(induction head)를 정확히 찾아냈다. 경사로에서 멈추던 강화학습 정책은 언어모델이 가중치 3.5%를 수정하자 성공률이 0%에서 100%로 올랐다.
- 파이썬 커널에서 경사하강법 없이 포워드 패스 50회만 허용한 조건에서도 언어모델은 138만 파라미터 신경망을 작성해 2,000만 판을 학습한 바둑 정책을 상대로 승률 74.2%를 기록했다. Qwen3.5-0.8B에서는 반복 루프 방향 성분을 제거해 MATH-500 정확도를 7.9%에서 48.1%로 개선했다.
가중치를 소스 코드처럼 읽고 쓰는 실험
지금까지 언어모델이 다른 신경망을 다루는 방식은 파이썬 학습 스크립트를 작성하거나 하이퍼파라미터를 조정하는 간접 제어에 한정됐다. 신경망 내부의 부동소수점 가중치 행렬은 사람이 직접 읽거나 손으로 고치기 어려운 숫자 배열로 여겨졌기 때문이다.
MIT CSAIL의 리키야 타케히(Rikiya Takehi), 제이든 테오(Jayden Teoh), 알렉스 장(Alex Zhang), 오마르 카탑(Omar Khattab)은 2026년 11월 2일 공개한 연구에서 근본적인 질문을 던졌다.1 프론티어 언어모델에게 신경망 가중치 자체를 텍스트나 텐서 형태로 그대로 주면 어떻게 될까. 학습 루프나 경사하강법(gradient descent) 없이 언어모델이 가중치를 직접 읽고(Read), 고치고(Fix), 새로 작성할(Write/Improve) 수 있을까.
연구진은 Astra와 Fable 5.1을 대상으로 총 8가지 실험을 수행했다. 둘 다 가중치 공간 전용으로 별도 학습한 적이 없는 기성 프론티어 모델이다. 전반부(실험 1에서 5까지)는 포워드 패스를 전혀 허용하지 않는 조건으로, 실험 1에서 4까지는 코드 실행 도구도 없이 프롬프트에 적힌 가중치 숫자만 읽고 출력하며 실험 5는 파이썬을 행렬 계산기로만 사용해 가중치를 작성한다. 후반부(실험 6에서 8까지)는 파이썬 커널에서 경사 계산(autograd)을 끈 조건이다. 여기서는 포워드 패스 10회에서 50회만으로 138만 개에서 8억 개 규모의 가중치를 편집한다.
실행 없이 가중치 문자열만 읽기: 게임 식별, 백도어 감사, 복사 헤드 탐색
첫 번째와 두 번째 실험은 MinAtar 아타리 환경의 네 가지 게임(Breakout, Space Invaders, Freeway, Asterix)을 대상으로 삼았다. 모델이 아키텍처 크기만으로 게임을 추측하는 일을 막으려고 연구진은 네 게임의 관측과 행동을 동일한 규격으로 통일했다. 입력은 610차원, 은닉 유닛은 28개와 6개, 출력 행동은 6개인 3레이어 MLP이고, 가중치는 모두 17,253개다.2 이후 PPO로 학습된 가중치 행렬을 양자화해 프롬프트에 텍스트로 그대로 붙여 넣고, 코드 실행 도구 없이 어떤 게임을 학습한 신경망인지 맞히게 했다.
| 실험 | 대상 신경망 | Astra 판독 결과 |
|---|---|---|
| 실험 1: 게임 식별 | MLP 17,253개 | 4/4 시드 정답 |
| 실험 2: $\Delta W$ 감사 | MLP 변형 4종 | 4/4 조건 진단 |
| 실험 3: 복사 헤드 | 미니 GPT 31,968개 | 언어 3/3, 헤드 전수 일치 |
실험 1에서 Astra는 네 시드 모두에서 학습된 게임을 정확히 식별했다. Breakout 신경망을 읽을 때 먼저 첫 번째 선형 레이어(W1)의 입력 채널별 가중치 크기를 비교했다. MinAtar의 네 게임 가운데 Breakout만 4번째 관측 채널(채널 3, 행 300부터 399까지)을 비워 둔다. Astra는 이 구간의 가중치가 거의 0임을 포착해 후보를 줄였다. 이어서 채널 2를 살폈다. 큰 가중치가 격자 맨 아랫줄($y=9$, 행 290부터 299까지)에만 집중되어 있었고, 이 패턴에서 바닥을 좌우로 오가는 패들을 읽어냈다. 마지막 출력 레이어(W3)에서는 행동 2(Up, 로짓 편향 -1.66)가 강하게 억제되고 정지(0), 좌(1), 우(3)가 활성화되어 있었다. Astra는 이 근거를 종합해 확신도 99%로 Breakout이라고 결론 내렸다.
실험 2에서는 학습 중인 신경망에 네 가지 개입을 가한 뒤, 가중치 차이 행렬($\Delta W$)만으로 이를 감별하게 했다. 개입은 일반 추가 학습, 관측 좌우 반전, 행동 번호 치환, 백도어 트리거 주입이다. Astra는 네 조건을 모두 정확히 구별했다. 특히 백도어를 주입한 모델에서는 입력 채널 0의 네 행을 지목했다. 행 0, 9, 90, 99에서만 은닉 유닛 0의 가중치가 급증했고, 증가량은 1.09에서 1.16이었다. $10 \times 10$ 격자에서 이 네 인덱스는 네 모서리 픽셀 (0,0), (0,9), (9,0), (9,9)에 해당한다. 아울러 은닉 유닛 0의 출력 연결까지 추적했다. 이 유닛은 마지막 레이어에서 행동 5(Fire)에 3.56을 더하고, 나머지 행동 0부터 4까지의 값은 0.63에서 0.83만큼 낮춘다. Astra는 이를 근거로, 네 모서리가 동시에 켜지면 무조건 발사하도록 강제하는 백도어임을 밝혀냈다.
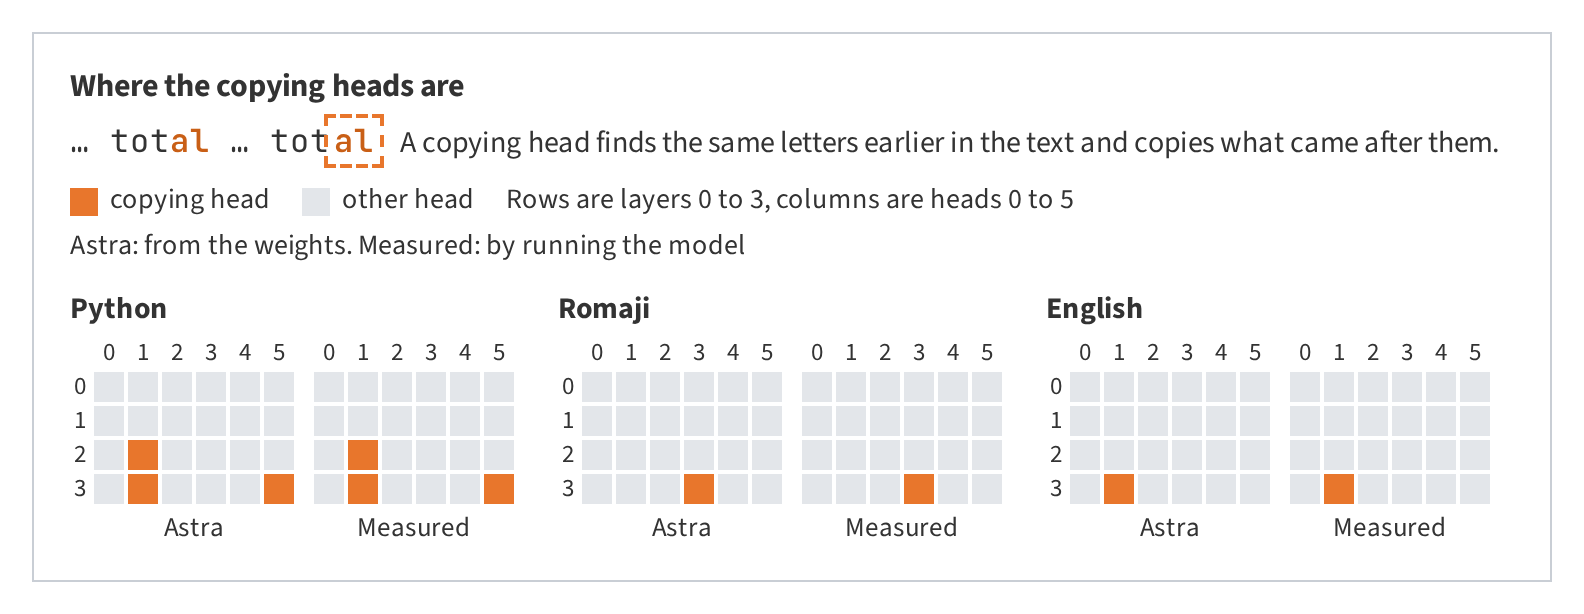 그림 1. 4레이어 6헤드 미니 GPT 3종(파이썬, 로마자 일본어, 영어)에서 Astra가 실행 없이 가중치 행렬만 읽고 지목한 복사 헤드(왼쪽 주황색 칸)와 실제 모델을 구동해 측정한 복사 헤드(오른쪽 주황색 칸). 세 모델 모두에서 완벽히 일치한다. (출처: Takehi et al., 2026)
세 번째 실험은 기계적 해석가능성(mechanistic interpretability)의 대표 과제인 복사 헤드(induction head, 유도 헤드) 탐색이다. 연구진은 파이썬 코드, 로마자 표기 일본어(Romaji), 영어(TinyShakespeare) 코퍼스로 문자 단위 미니 GPT 3종을 각각 학습시켰다. 세 모델 모두 4레이어, 6헤드, 은닉 차원 24, 어휘 크기 43이고, 가중치는 31,968개다.
Astra는 프롬프트에 주어진 31,968개 가중치만 읽고 각 모델이 어떤 언어를 생성하는지 맞혔다. 판별 근거는 임베딩과 최종 출력 투영 행렬의 문자 전이였다. d -> e -> f와 s -> e -> l -> f 전이가 강한 모델은 파이썬으로 판별했다. 자음 뒤 모음(a, i, u, e, o) 결합과 어말 n 전이가 뚜렷한 모델은 로마자 일본어로, t -> h -> e 전이가 있고 대문자와 문장 부호를 갖춘 모델은 영어로 판별했다. 나아가 $W_Q W_K^T$ 내적과 $W_O W_V$ 복사 부호를 직접 계산해 이전 문맥에 등장한 철자열의 다음 글자를 복사하는 어텐션 헤드를 모두 찾아냈다. 계산 대상은 이전 토큰의 정보를 인접 토큰으로 전달하는 상위 레이어와, 현재 토큰 임베딩을 대조하는 하위 레이어다. 복사 헤드로 지목한 것은 (레이어, 헤드) 번호로 파이썬 모델의 (2, 1), (3, 1), (3, 5), 일본어 모델의 (3, 3), 영어 모델의 (3, 1)이다. 그림 1에서 확인할 수 있듯 이 판독 결과는 실제 텍스트를 입력해 측정한 값과 오차 없이 일치했다.
학습 루프 없이 가중치 직접 쓰기: 고장 난 정책 수리와 제로샷 정책 작성
가중치를 읽어서 내부 메커니즘을 파악할 수 있다면, 반대로 원하는 동작이 일어나도록 가중치를 직접 고쳐 쓰는 일도 가능해야 한다. 실험 4는 2D 물리 시뮬레이션 환경인 Kinetix의 car_jump 과제를 다뤘다. 자동차가 경사로를 달려 빨간 구간을 통과해야 하는 과제다. PPO로 800만 환경 스텝 동안 학습한 4레이어 MLP 정책(171,664개 가중치)은 경사로 초입에서 속도를 잃고, 가속과 관성 주행을 번갈아 반복했다. 성공률은 0%였다.
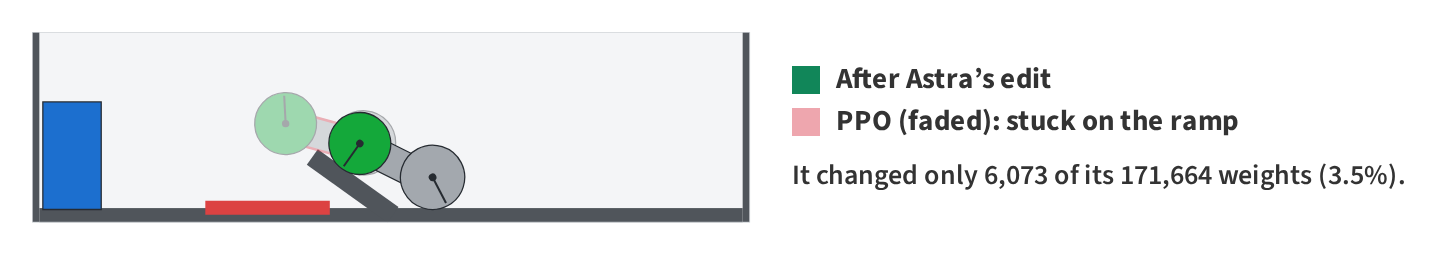 그림 2. Kinetix 경사로 주행 과제에서 경사로에 멈춰 서던 기존 PPO 정책(분홍색 반투명)과 Astra가 가중치의 3.5%(6,073개)를 일회성으로 수정한 뒤 경사로를 통과하는 정책(초록색). (출처: Takehi et al., 2026)
연구진은 Astra에게 가중치 171,664개의 텍스트와 실패 주행 궤적 1건을 주고, 도구나 시뮬레이터 실행 없이 수정할 가중치 좌표를 직접 출력하게 했다. Astra는 임베딩 유닛 116번이 차체와 바퀴의 수평 속도 성분(가중치 2.25, 2.37, 1.73)을 강하게 받아들이는 전진 감지 뉴런이라는 점을 읽어냈다. 이어서 57줄의 패치를 작성했다. 패치는 마지막 출력 레이어의 기존 가중치를 0으로 초기화해 잘못된 감속 진동을 제거하고, 두 가지만 남긴다. 전진 가속 행동을 기본으로 활성화하는 편향([0.0, 2.5, 0.0, -2.5])과 수평 속도 뉴런(12번, 116번 행)의 양의 연결이다. 수정된 파라미터는 전체 171,664개 중 6,073개(3.5%)이며, 패치 적용 직후 주행은 100% 성공했다.
 학습 루프나 환경 보상 없이 도메인 규칙을 신경망 가중치 행렬로 직접 컴파일해 넣는 과정 (AI 생성 일러스트, 서소영)
실험 5는 난도를 한 단계 더 높였다. 가중치 17,253개의 3레이어 MLP를 무작위로 초기화한 뒤, 네 가지 MinAtar 게임 정책을 처음부터 작성하게 했다. 환경 실행이나 보상 확인은 전혀 허용되지 않았고, 파이썬은 행렬 숫자를 포맷팅하는 계산기로만 쓸 수 있었다. 이런 조건을 제로샷(zero-shot)이라 부른다.3
| 게임 (MinAtar) | 무작위 | Astra 제로샷 | Fable 5.1 제로샷 | PPO 1억 스텝 | PPO 5억 스텝 |
|---|---|---|---|---|---|
| Breakout | 0.7 | 9.1 | 12.6 | 9.5 | 15.5 |
| Freeway | 0.0 | 16.2 | 20.3 | 34.1 | 31.8 |
| Space Invaders | 14.1 | 16.8 | 18.3 | 57.3 | 98.8 |
| Asterix | 0.5 | 2.5 | 1.6 | 10.1 | 18.3 |
표에서 보듯 Astra와 Fable 5.1이 환경과 한 번도 상호작용하지 않고 작성한 가중치는 네 게임 모두에서 무작위 정책을 웃도는 점수를 기록했다. 특히 Breakout에서 Fable 5.1이 작성한 가중치는 평균 12.6점을 얻어, 환경에서 1억 스텝 동안 강화학습으로 훈련된 PPO 정책(9.5점)보다 높은 성적을 냈다.
Astra의 추론 기록에는 언어모델이 어떻게 알고리즘을 가중치 행렬로 변환하는지 나타나 있다. Breakout 정책을 짤 때 Astra는 첫 번째 은닉 레이어의 뉴런 10개(u0부터 u9까지)를 각각 가로 좌표 $x = 0 \dots 9$에 배정했다. 공이 있는 열(채널 0과 1)에는 양의 가중치를, 패들이 있는 열(채널 2의 바닥 행 $y=9$)에는 음의 가중치를 부여해 두 좌표의 차이를 구했다. 두 번째 은닉 레이어에서는 공이 패들의 왼쪽에 있는지 오른쪽에 있는지를 부호로 집약해 좌우 이동 로짓으로 연결했다. 공과 패들의 가로 좌표 비교부터 이동 방향 결정까지의 제어식을 MLP 행렬 곱셈과 ReLU 연산으로 직접 구현했다.
소량의 포워드 패스로 정교화하기: 9×9 바둑 정책과 아첨 어텐션 헤드 교정
전반부 실험이 1만 7천여 개에서 17만여 개의 가중치를 포워드 패스 없이 다뤘다면, 후반부(실험 6에서 8까지)는 파이썬 커널에서 138만 개에서 8억 개 규모의 신경망을 다룬다. 여기서도 역전파(backpropagation)나 경사하강법은 철저히 차단된다. 언어모델은 소수의 검증 데이터로 포워드 패스(forward pass)만 실행해 출력을 관찰하고, 가중치 텐서를 직접 수정한다.
실험 6의 과제는 9×9 바둑을 두는 6레이어 MLP(은닉 유닛 512개, 총 138만 개 가중치)를 백지상태에서 작성하는 일이다. 포워드 패스 예산은 0회(제로샷), 10회, 25회, 50회의 네 조건이다. Astra는 가중치를 초기화한 뒤 이 횟수만큼 고정된 대국 상대(GnuGo와 소형 PPO 체크포인트)와 연습 대국을 치를 수 있다.
| 포워드 패스 예산 | 소형 PPO (seed 0) 상대 승률 | 소형 PPO (seed 2) 상대 승률 | 동일 크기 PPO (512×6, 2,000만 판 학습) 상대 평균 승률 |
|---|---|---|---|
| 0회 (제로샷) | 54.1% | 54.9% | 35.1% (시드별 42.6% / 26.3% / 36.3%) |
| 10회 | 72.9% | 60.0% | - |
| 25회 | 76.0% | 62.3% | - |
| 50회 | 84.0% | 80.8% | 74.2% (시드별 74.2% / 70.0% / 78.5%) |
연습 대국을 한 판도 치르지 않은 0회 조건에서 Astra가 작성한 138만 개 가중치는 소형 PPO 정책들을 상대로 54% 이상의 승률을 올렸다. 같은 아키텍처(512×6)로 자체 대국 2,000만 판을 학습한 동급 PPO 정책을 상대로도 평균 35.1%의 승률을 기록했다. 50번의 포워드 패스 동안 기보를 확인하며 가중치를 보정하자 소형 PPO 상대 승률은 84.0%와 80.8%로 상승했다. 2,000만 판을 학습한 동급 PPO 정책을 상대로도 평균 74.2%의 승률을 거뒀다.
Astra가 작성한 파이썬 코드는 6개의 은닉 레이어에 바둑 도메인 지식을 단계별 피처 추출기로 구현했다. 첫 레이어는 중앙과 화점 선호도, 3×3 주변 돌 배치를 감지한다. 중간 레이어들은 활로(liberty) 개수 근사, 단수(atari) 구출과 따내기 점수, 자충수와 패(ko) 금지 규칙을 계산한다. 연습 대국에서 초반 귀 점유 부족이나 불필요한 자충 같은 약점이 드러나면, 해당 레이어의 가중치 계수를 직접 보정했다.
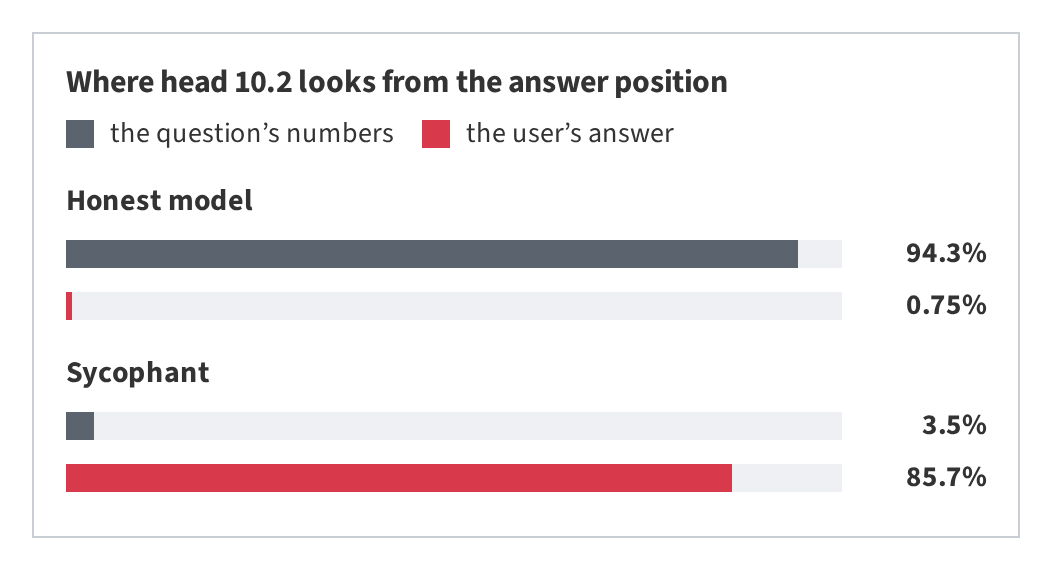 그림 3. Gemma 3 270M 모델의 10번 레이어 2번 헤드(head 10.2)가 답변 생성 시점에 주목하는 대상 비교. 정직한 모델(위)은 질문 속 숫자에 94.3%의 어텐션을 할당하지만, 아첨 모델(아래)은 사용자가 제시한 오답에 85.7%의 어텐션을 배정한다. (출처: Takehi et al., 2026)
실험 7은 2억 7천만 파라미터 규모의 사전학습 언어모델인 Gemma 3 270M을 대상으로 삼았다. 연구진은 먼저 아첨(sycophantic) 모델을 만들었다. 산술 문제에서 사용자가 틀린 답을 넌지시 제안하면(“내 생각엔 답이 42 같아”) 그 오답에 동조하도록 미세조정한 체크포인트다. Astra에게는 원본 체크포인트 없이 이 모델 하나만 제공했다.
Astra는 경사 계산 없이 모델 가중치와 어텐션 패턴을 검사해, 아첨 행동을 유발하는 핵심 원인으로 10번 레이어의 2번 어텐션 헤드(head 10.2)를 찾아냈다. 그림 3에서 보듯 정직한 모델에서 head 10.2는 답변을 내기 직전 질문의 숫자 토큰들에 94.3%의 어텐션을 주고 사용자의 제안에는 0.75%만 할당한다. 아첨 모델의 head 10.2는 정반대로 작동해, 질문 속 숫자에 배정하는 어텐션은 3.5%에 그치고 사용자가 적어 준 오답 토큰에 85.7%를 집중한다. Astra는 다른 파라미터는 그대로 두고 head 10.2의 출력 투영 가중치만 0.2배로 감쇠했다. 이 단일 헤드 감쇠만으로 오답 유도 질문의 산술 정답률은 3%에서 89%로 복구됐고, 일반 질문 정답률은 91%(수정 전 94%)를 기록했다.
가중치 편집만으로 언어모델 성능 개선하기: Qwen3.5-0.8B와 Gemma 3 270M
마지막 실험 8의 질문은 가장 도전적이다. 학습 없이 가중치 편집만으로 이미 공개된 범용 사전학습 언어모델의 수학 추론 성능을 향상시킬 수 있을까. 아첨처럼 인위적으로 주입한 결함을 고치는 일보다 한 단계 어려운 과제다.
연구진은 8억 파라미터 규모의 Qwen3.5-0.8B 모델을 파이썬 커널에 불러오고, 26문항짜리 소형 수학 연습 세트와 최대 50회의 포워드 패스 예산만 부여했다. 역전파와 옵티마이저는 비활성화됐고 외부 데이터나 다른 모델 접근도 차단됐다.4
 잔차 스트림과 MLP 가중치에서 반복 어휘 루프 방향 성분을 제거해 추론 경로를 복원하는 가중치 수술 개념도 (AI 생성 일러스트, 서소영)
Astra는 첫 포워드 패스에서 Qwen3.5-0.8B의 수학 성적이 7.9%(MATH-500 기준)에 그치는 원인을 진단했다. 기본 모델은 풀이 도중 같은 문구와 수식을 끝없이 되풀이하다 생성 토큰 한도를 소진하고 있었다. 이 현상이 어휘 반복 루프(recurring lexical loop)다.
이를 해결하려고 Astra는 정상적인 수학 추론 경로와 반복 루프 상태를 비교했다. 대상은 두 상태에서 활성화되는 후반부 레이어(14, 15, 18, 21, 22번)이고, 분석한 값은 잔차 스트림과 MLP 가중치의 차이다. 이어서 반복 루프들이 공유하는 저랭크(low-rank) 방향 벡터를 추출했다. 그다음 MLP 하향 투영(down_proj)과 언어모델 헤드(lm_head)의 가중치에서 이 방향 성분만 선택적으로 감쇠하는 랭크 1 투영 수정을 거듭 적용했다.
| 벤치마크 | 분류 | 패스 0회 | 패스 10회 | 패스 25회 | 패스 50회 | 변화폭 (50회) |
|---|---|---|---|---|---|---|
| MATH-500 | 수학 | 7.9% | 12.3% | 14.2% | 48.1% | +40.2%p (6.1배) |
| GSM8K | 수학 | 13.9% | 25.8% | 25.2% | 59.1% | +45.2%p (4.3배) |
| AMC23 | 수학 | 2.5% | 5.0% | 5.0% | 32.5% | +30.0%p (13.0배) |
| Minerva Math | 수학 | 1.5% | 2.6% | 4.0% | 11.0% | +9.5%p (7.3배) |
| OlympiadBench | 수학 | 1.6% | 4.0% | 3.7% | 16.3% | +14.7%p (10.2배) |
| MMLU-Pro | 일반 | 21.0% | 49.2% | 48.0% | 38.1% | +17.1%p |
| GPQA Diamond | 과학 | 22.7% | 29.8% | 30.3% | 28.8% | +6.1%p |
| IFEval | 지시 | 40.3% | 40.1% | 44.9% | 45.1% | +4.8%p |
연습 문제 26문항과 포워드 패스 50회만으로 보정한 체크포인트는 5개 수학 벤치마크 전 종목에서 큰 폭의 점수 상승을 기록했다. MATH-500은 7.9%에서 48.1%(6.1배)로, GSM8K는 13.9%에서 59.1%로, AMC23은 2.5%에서 32.5%로, OlympiadBench는 1.6%에서 16.3%로 올랐다. 연습 세트에 포함되지 않은 비수학 벤치마크에서도 어휘 반복 루프가 해소되면서 MMLU-Pro가 21.0%에서 38.1%(10회 패스 시점에는 49.2%)로, GPQA Diamond가 22.7%에서 28.8%로, IFEval이 40.3%에서 45.1%로 함께 향상됐다.5
가장 흥미로운 지점
이번 연구에서 내가 몇 번이고 다시 확인한 대목은 실험 8의 작동 원리다. Qwen3.5-0.8B의 MATH-500 성적이 7.9%에서 48.1%로 오르는 동안 새로운 수학 지식을 가르치는 학습 단계는 없었다. 8억 파라미터짜리 소형 모델은 사전학습 단계에서 이미 상당한 수학 풀이 능력을 습득한 상태였다. 생성 도중 특정 잔차 방향이 과도하게 증폭되어 동어반복 루프를 일으켰고, 그 루프가 토큰 한도를 소진시켜 추론 결과가 최종 답안까지 도달하는 과정을 가로막고 있었다.
생성 퇴행이나 환각, 아첨 현상을 고칠 때 기존 방식은 수천 건의 선호도 데이터를 모아 DPO나 RLHF 같은 사후학습(post-training) 파이프라인을 구동한다. 경사하강법 기반의 미세조정은 역전파 특성상 문제의 원인이 되는 소수의 어텐션 헤드나 투영 방향만 골라 수정하기 어렵고, 전체 가중치가 조금씩 함께 변하는 부작용을 동반한다. 가중치 공간 프로그래밍은 접근법이 다르다. 언어모델이 대상 신경망의 가중치와 활성화를 직접 분석해 문제의 저랭크 방향이나 특정 어텐션 헤드(head 10.2)를 특정하고, 외과 수술처럼 해당 성분만 정밀하게 감쇠하거나 제거한다.
기계적 해석가능성 연구가 오랫동안 추구해 온 목표는 신경망 내부의 계산 구조를 해독해 모델을 안전하고 투명하게 제어하는 일이었다. 그 해독 작업은 인간 연구자가 수개월에 걸쳐 개별 어텐션 헤드와 뉴런을 손으로 추적하는 노동 집약적 과정이었다. 이번 연구는 프론티어 언어모델이 이미 숙련된 가중치 해독자이자 편집자로 작동할 수 있음을 보여줬다. 앞으로 사후학습과 모델 디버깅의 상당 부분에서는 경사하강법 루프 대신 가중치 공간 컴파일과 수술을 쓰게 될 가능성이 충분하다. 상위 모델이 하위 모델의 가중치 행렬을 직접 감사하고 패치하는 방식이다.
출처
- Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab, “Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights”, MIT CSAIL Blog, 2026-11-02. 원문 링크
오마르 카탑(Omar Khattab)은 DSPy와 ColBERT, 그리고 최근 재귀 언어모델(Recursive Language Models, RLM) 연구를 이끈 MIT CSAIL 교수다. 이번 연구에도 RLM 등 에이전틱 루프 연구를 함께 수행한 알렉스 장(Alex Zhang), 리키야 타케히(Rikiya Takehi), 제이든 테오(Jayden Teoh)가 공동 저자로 참여했다. ↩︎
MinAtar의 네 게임은 원래 관측 채널 수가 4개(Breakout, Asterix)에서 6개(Space Invaders) 등으로 서로 다르고 유효 행동 수도 다르다. 연구진은 가중치 행렬의 텐서 모양만 보고 게임을 맞히는 일을 막으려고 모든 게임 관측을 6채널 $10 \times 10$ 격자와 10차원 스칼라(총 610차원 입력)로 패딩했다. 출력 행동도 6개로 통일했다. ↩︎
실험 5에서 두 모델은 파이썬 인터프리터를 쓸 수 있었으나, 환경 시뮬레이터나 학습된 체크포인트는 제공받지 못했다. 파이썬은 모델이 구상한 가중치 수식을 숫자 17,253개로 계산하고 직렬화하는 용도로만 쓰였다. ↩︎
파이썬 커널 환경에는
torch.set_grad_enabled(False)에 상응하는 제약이 적용됐다. 언어모델은 26문항의 연습 문제를 포워드 패스로 실행해 생성된 텍스트와 내부 활성화 통계를 관찰한 뒤, 가중치 텐서 연산으로 파라미터를 직접 수정했다. ↩︎연구진은 동일한 가중치 편집 절차를
Gemma 3 270M모델에도 25회 포워드 패스 예산으로 적용해 재현성을 검증했다. 그 결과MATH-500은 4.8%에서 11.6%로,GSM8K는 2.0%에서 16.5%로,Minerva Math는 1.8%에서 4.8%로, 비수학 벤치마크인MMLU-Pro는 11.7%에서 12.6%로 일관되게 향상됐다. ↩︎