3줄 요약
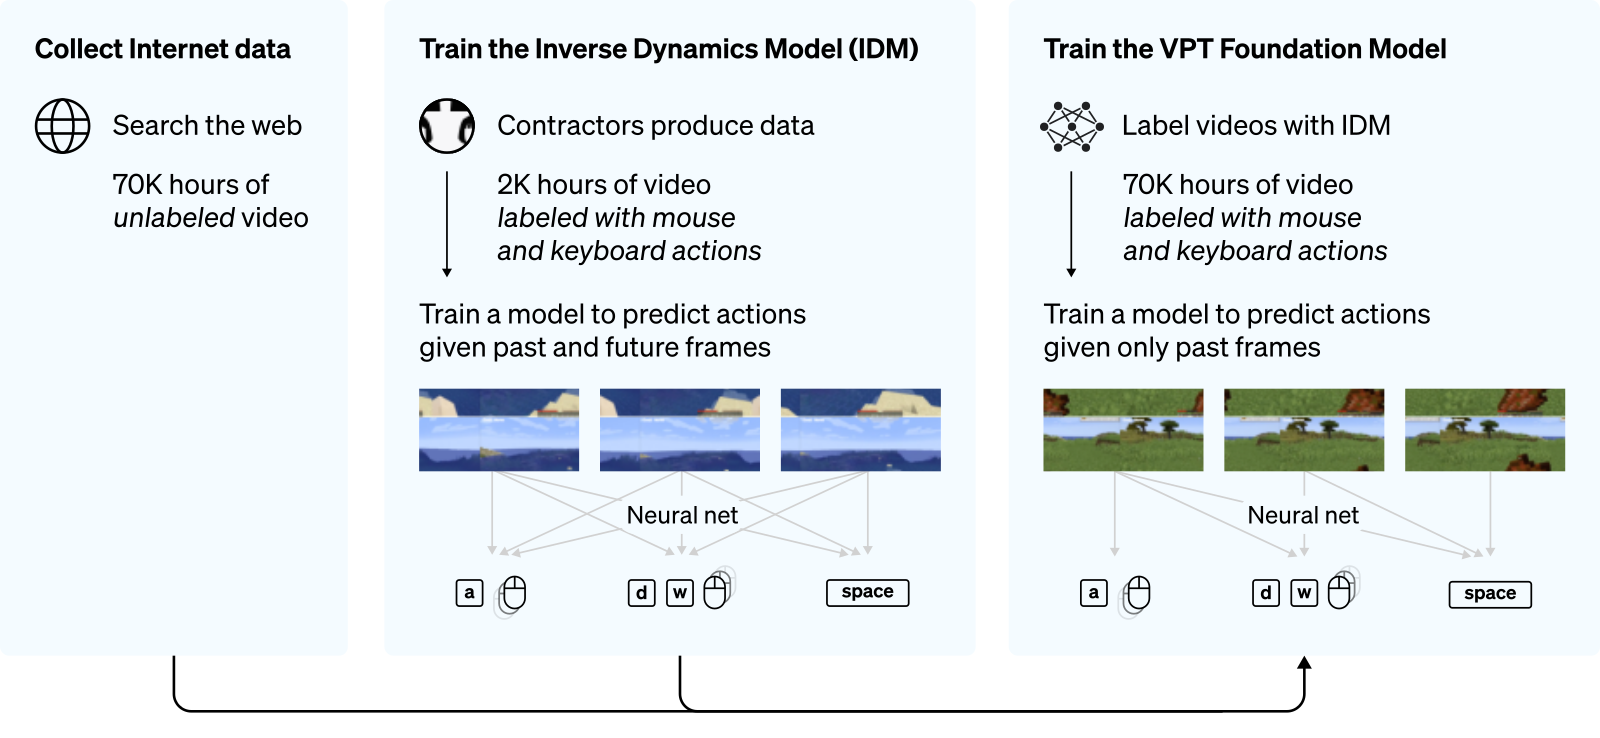
- OpenAI 연구진이 2022년 6월에 내놓은 논문이다. 글과 이미지에서 자리를 잡은 인터넷 규모 사전학습을, 행동 라벨이 붙어 있지 않은 게임 플레이 영상으로 확장했다.
- 연구진은 계약자를 고용해 플레이 2천 시간을 키보드 입력과 마우스 움직임까지 함께 녹화했다. 이 데이터로 역동역학 모델을 학습시킨 뒤 인터넷 영상 7만 시간에 행동 라벨을 자동으로 달았고, 라벨이 붙은 그 영상으로 행동 복제 파운데이션 모델을 학습했다.
- 이 모델을 강화학습으로 미세조정하자 에이전트가 다이아몬드 곡괭이를 2.5% 확률로 만들어 냈다. 사람이 쓰는 것과 똑같은 초당 20프레임 마우스와 키보드 조작만으로 이 과제를 푼 보고는 이 논문이 처음이다.
인터넷 영상에 빠져 있는 것
글과 이미지, 음성 분야에서는 웹에서 긁어모은 잡음 섞인 데이터로 큰 모델을 먼저 학습시키고, 나중에 용도에 맞게 다듬는 방식이 표준이 되었다. 그러나 로봇, 게임, 컴퓨터 조작처럼 환경 안에서 반복해서 움직여야 하는 영역에는 이 방식을 그대로 적용하기 어려웠다. 웹에 쌓여 있는 데이터의 대부분이 영상인데, 영상에는 각 프레임에서 사람이 어떤 키를 눌렀고 마우스를 어디로 움직였는지가 남아 있지 않기 때문이다.
체스와 바둑과 스타크래프트처럼 온라인 플랫폼이 행동 기록까지 보관해 주는 몇몇 예외를 빼면, 남는 선택지는 강화학습이었다. 그러나 강화학습은 탐색이 어려운 문제에서 표본 효율이 나쁘고 비용이 많이 든다. 웹사이트를 돌아다니거나 포토샵을 쓰거나 항공권을 예약하는 일에는 대규모 라벨 데이터도 없고 쉬운 보상 신호도 없다.
저자들은 이 문제를 반지도 방식의 모방학습으로 풀자고 제안한다. 먼저 적은 양의 라벨 데이터로 “이 화면이 저 화면으로 바뀌었다면 그 사이에 어떤 입력이 있었는가"를 맞히는 모델을 만든다. 그다음 그 모델로 거대한 무라벨 영상에 라벨을 달아 준다. 저자들은 이 방법을 Video PreTraining, 줄여서 VPT라고 부른다.
왜 마인크래프트였고, 왜 사람의 인터페이스였는가
저자들이 마인크래프트를 고른 이유는 세 가지다. 첫째, 세계에서 가장 활발하게 플레이되는 게임 중 하나여서 웹에 영상이 넘친다. 둘째, 무엇이든 만들고 모을 수 있는 열린 샌드박스라서 컴퓨터 조작처럼 정형화되지 않은 실제 응용과 닮았다. 셋째, 탐색 난이도가 높아 이미 강화학습 연구 대상으로 자주 쓰이고 있었다.
더 중요한 선택은 인터페이스였다. 기존 마인크래프트 연구들은 프레임률을 낮추고 채굴이나 제작을 한 번에 끝내 주는 매크로를 만들어 붙였다. VPT는 그런 보조 장치를 전부 걷어내고 사람이 쓰는 조작을 그대로 쓴다. 모델은 초당 20프레임으로 게임 화면의 픽셀만 받는다. 제작과 제련과 거래를 하려면 마우스 커서로 GUI를 열고 아이템을 원하는 칸에 끌어다 놓아야 한다. 화면은 640×360으로 렌더링한 뒤 128×128로 줄여서 넣는데, 저자들은 인게임 GUI 요소를 겨우 알아볼 수 있는 최소 해상도로 이 값을 골랐다.
이 선택에는 세 가지 이유가 있다. 영상 데이터와 실행 환경의 차이를 줄이면 사람의 행동 분포를 있는 그대로 모사할 수 있다. 계약자는 게임을 개조하지 않고 그냥 플레이하면 된다. 모델 전용 인터페이스를 따로 설계할 필요도 없다.
그 대신 에이전트가 감당해야 할 탐색 난이도가 크게 올라갔다. 나무를 이미 마주 보고 서 있어도 통나무 한 개를 얻으려면 공격 입력을 60번 연속으로 넣어야 한다. 무작위로 움직이는 정책이 여기에 성공할 확률은 1을 2의 60제곱으로 나눈 값이다.
VPT의 세 단계
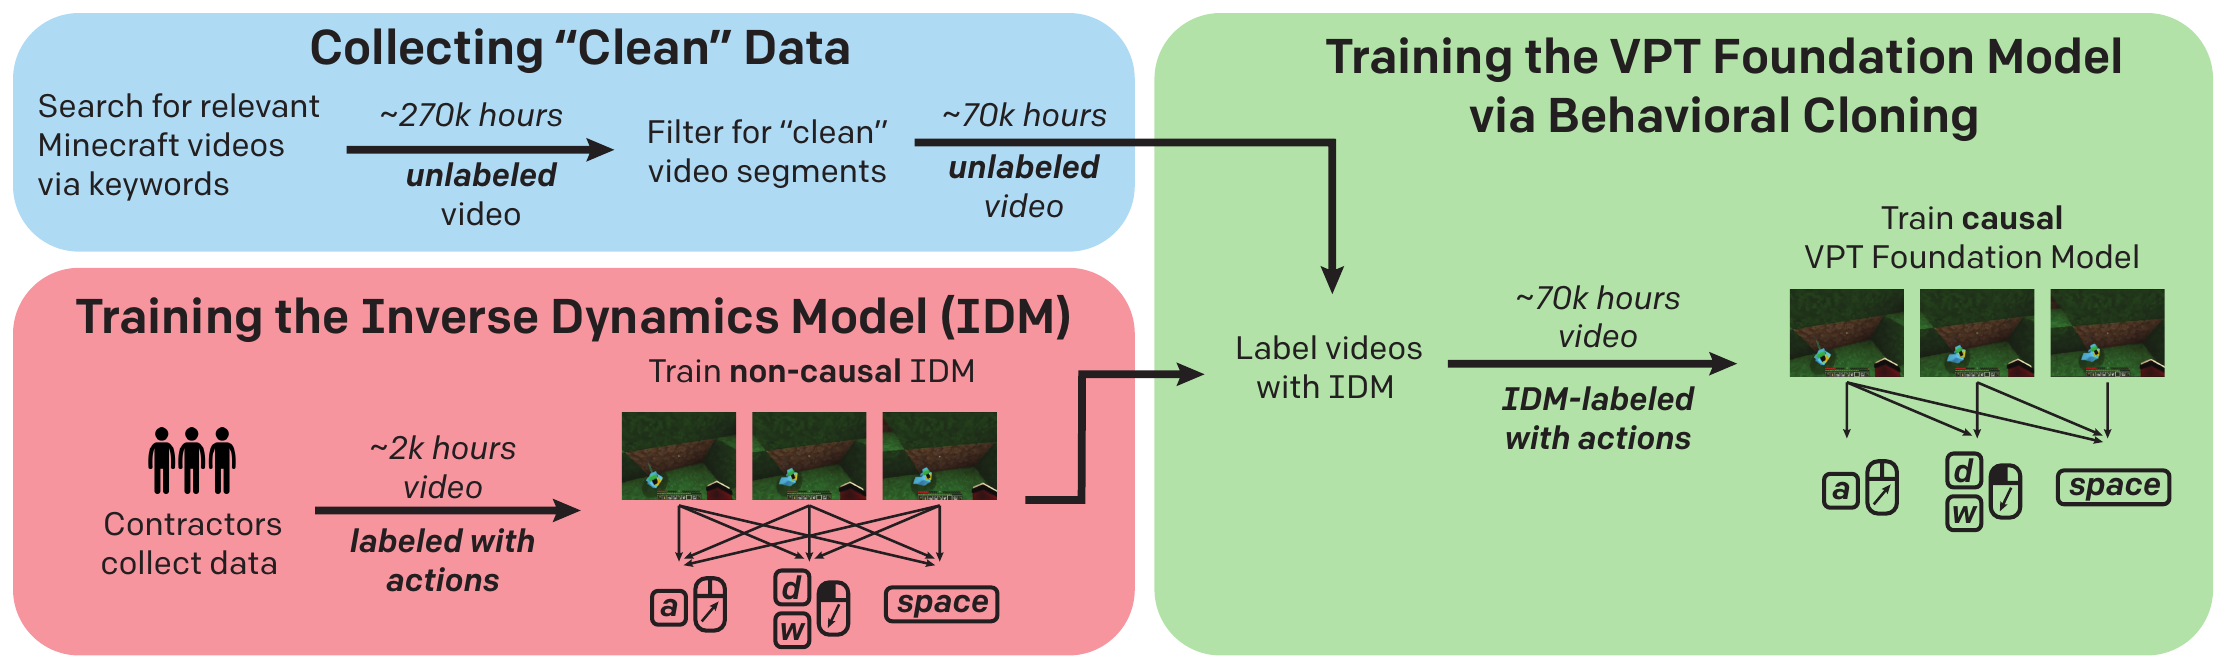
웹 데이터 수집. “minecraft survival for beginners”, “let’s play minecraft episode 1” 같은 검색어 29개로 공개 영상을 긁어모아 약 27만 시간을 확보했다. 제목과 설명에 ps4, xbox 360, multiplayer, pocket edition, realistic minecraft 같은 금칙어가 들어간 영상은 이 단계에서 걸러 냈다.
깨끗한 구간 선별. 온라인 영상에는 얼굴 캠, 채널 로고, 워터마크 같은 겹쳐 그린 요소가 많다. 콘솔 플레이나 크리에이티브 모드처럼 목표 분포와 다른 영상도 섞여 있다. 저자들은 영상에서 무작위로 뽑은 프레임 8,800장을 Amazon Mechanical Turk 작업자 5명에게 세 부류로 나누어 라벨링하게 했다. 그 라벨로 분류기를 학습시켜 지저분한 구간을 잘라 내고 나니 약 7만 시간이 남았다. 이것이 web_clean 데이터셋이다.
계약자 데이터 수집. 저자들은 Upwork에 구인 글을 올려 계약자를 모집했고, 시급 20달러를 지급했다. 계약자가 쓰는 전용 레코더는 MCP-Reborn 모딩 패키지로 만들었으며, 플레이 영상과 입력 기록을 함께 저장한다. 기록은 5분 단위로 잘려 영상 파일과 행동 JSONL, 게임 상태 파일로 올라간다. 계약자끼리 서로의 데이터를 건드리지 못하도록, 각자에게 개인 클라우드 버킷을 하나씩 주고 자기 버킷에만 쓸 수 있는 자격증명을 나눠 주었다. 나중에 데이터를 공개할 것을 대비해 grumpy-amethyst-chipmunk 같은 형용사-형용사-명사 형태의 익명 이름도 자동으로 붙여 두었다.
역동역학 모델. IDM에는 시간축 합성곱 층, ResNet 이미지 처리 스택, 마스킹하지 않은 잔차 어텐션 층이 들어간다. 이 모델은 키 입력과 마우스 이동을 동시에 예측한다. 환경에서 굴려야 하는 정책은 과거 프레임만 볼 수 있지만, IDM에는 그런 제약이 없다. 어떤 시점의 행동을 추론할 때 그 이후 프레임까지 함께 보아도 된다. 계약자 데이터 1,962시간으로 학습한 최종 IDM은 검증셋에서 키 입력 정확도 90.6%, 마우스 이동 결정계수 0.97을 기록했다.
파운데이션 모델. IDM이 붙인 의사 라벨로 web_clean 전체에 표준 행동 복제를 학습했다. 5억 파라미터 모델을 30에폭 학습하는 데 V100 GPU 720장으로 약 9일이 걸렸다.
역동역학 모델의 데이터 효율
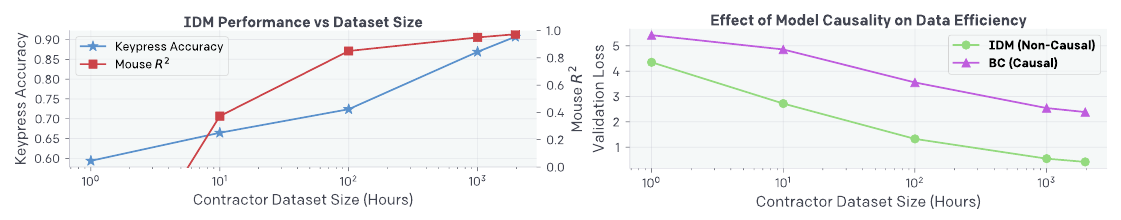
행동 복제 모델은 과거 프레임만 보고 사람의 의도와 앞으로의 행동 분포를 추론해야 한다. 반면 IDM이 푸는 문제는 앞뒤 프레임을 모두 보면서 그 사이에 끼어 있는 입력을 되짚는 일이다. 대부분의 환경에서 게임 메커니즘 자체는 그 안에서 벌어질 수 있는 사람 행동의 폭보다 훨씬 단순하므로, 비인과적인 IDM이 인과적인 행동 복제 모델보다 적은 데이터로 학습될 것이라고 저자들은 가정했다.
같은 데이터로 두 모델을 학습해 비교한 결과가 이 가정을 뒷받침한다. IDM은 행동 복제 모델보다 데이터 효율이 두 자릿수 배수만큼 좋았고, 데이터가 늘어날 때 개선되는 속도도 더 빨랐다.
아무것도 더 가르치지 않은 모델이 하는 일
평가는 표준 서바이벌 모드에서 60분짜리 에피소드를 2,500회 반복해 측정했다. 60분은 연속 행동 72,000회에 해당한다.
파운데이션 모델은 나무를 베어 통나무를 모으고, 그 통나무로 나무 판자를 만들고, 판자로 제작대를 만든다. 제작대까지 가는 데는 마인크래프트에 익숙한 사람도 중앙값으로 약 50초, 연속 행동으로는 970회가 든다. 그러나 속도는 사람에 한참 못 미친다. 계약자가 60분에 제작대를 평균 5.44개 만드는 동안 파운데이션 모델은 0.19개를 만들었다.
이 밖에 관찰된 행동은 다음과 같다.
- 나무 도구의 재료가 되는 나무 막대를 제작한다.
- 여러 종류의 꽃을 모아 염료로 가공한다.
- 밤에 나타나는 좀비를 처치하고, 야생 동물을 사냥한다.
- 열매와 버섯을 모아서 먹는다.
- 게임이 생성한 마을을 찾아가 상자에서 희귀 아이템을 꺼낸다.
- 고르지 않은 지형을 넘어가고, 물에서는 헤엄친다.
- 기둥 점프를 한다. 제자리에서 뛰면서 발밑에 블록을 재빨리 놓아 스스로 기둥을 쌓아 올라가는 기술이다.
좁은 데이터로 다시 맞추기
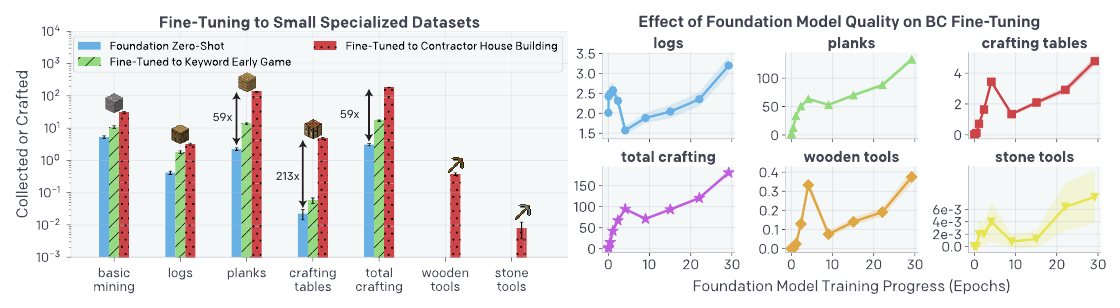
파운데이션 모델은 폭넓은 행동을 조금씩 할 줄 알지만 제작대에서 더 나아가지 못했다. 저자들은 게임 초반 행동에 집중한 두 개의 좁은 데이터셋으로 미세조정을 시도했다.
첫 번째 earlygame_keyword는 설명에 “new world”, “let’s play episode 1” 같은 키워드가 들어간 영상만 고른 web_clean 부분집합이다. 여기에 붙인 라벨도 IDM이 만들었다. 두 번째 contractor_house는 계약자에게 10분 동안 흙과 나무와 모래만으로 기본적인 집을 지으라고 시켜 모은 약 420시간짜리 데이터다.
| 미세조정 대상 | 제작대 | 나무 판자 | 통나무 | 전체 제작 |
|---|---|---|---|---|
earlygame_keyword | 2.5배 | 6.1배 | 4.3배 | 5.5배 |
contractor_house | 213배 | 59배 | 7배 | 59배 |
earlygame_keyword로 미세조정했을 때는 기존 기술만 정교해졌고, 새로운 행동은 나타나지 않았다. 반면 contractor_house로 미세조정하자 모델은 전에 하지 않던 행동을 보였다. 모델은 제작대를 땅에 내려놓고, 그것을 열어 새 제작 화면을 띄우고, 거기서 나무 도구를 만들었다. 능숙한 사람이 이 전체 과정을 마치는 데 중앙값으로 1.2분, 연속 행동 1,390회가 든다. 모델은 여기서 더 나아가 나무 곡괭이로만 캘 수 있는 조약돌을 모았다. 그리고 제작대를 다시 써서 돌 도구까지 만들었다. 사람에게도 이 지점까지는 중앙값 2.3분, 연속 행동 2,790회가 필요하다.
한 가지 더 눈에 띄는 결과가 있다. 파운데이션 모델의 제로샷 성능은 학습 3분의 1 지점에서 더 오르지 않았다. 그런데 그 뒤에 저장한 체크포인트를 가져다 미세조정하면, 나중 것일수록 성능이 좋아졌다. 제로샷 지표가 멈춘 뒤에도 파운데이션 모델 안에서는 무언가가 계속 자라고 있었던 셈인데, 그것이 무엇인지까지는 논문도 특정하지 않는다.
다이아몬드 곡괭이
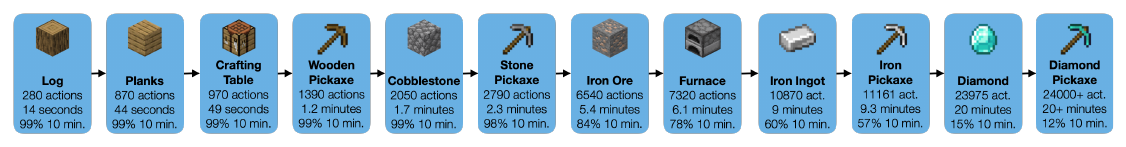
강화학습 미세조정의 목표로 저자들이 고른 과제는 새 월드에서 시작해 10분 안에 다이아몬드 곡괭이를 만드는 것이다. 여기에는 채굴, 인벤토리 관리, 제작대를 쓰거나 쓰지 않는 두 종류의 제작, 도구 사용, 화로 조작이 모두 들어간다. 마지막에는 적과 용암이 도사리는 최하층까지 내려가야 한다. 게다가 아이템을 떨어뜨리거나 부수거나 죽으면 진행이 되돌아간다. 능숙한 사람도 다이아몬드 곡괭이를 얻는 데 대개 20분, 행동 24,000회 넘게 쓴다.
학습 알고리즘으로는 phasic policy gradient를 골랐다. 10분짜리 에피소드를 약 130만 회 반복했으니, 프레임 수로는 약 140억 회다. 계산 비용 때문에 이 실험에는 5억 대신 2억 4,800만 파라미터 모델을 썼다.
여기서 걸림돌이 되는 것이 파국적 망각이다. 파운데이션 모델은 화로로 철을 제련하는 전체 과정을 제로샷으로 보여 준 적이 한 번도 없다. 그래도 사람들이 제련하는 장면은 학습 데이터에서 보았으므로, 선행 조건만 갖춰지면 그 기술이 드러날 잠재력은 남아 있다. 강화학습 중에 이런 잠재 기술이 쓰이기도 전에 사라지는 일을 막으려고, 저자들은 학습 중인 정책과 동결한 사전학습 정책 사이의 KL 발산을 보조 손실 항으로 더했다.
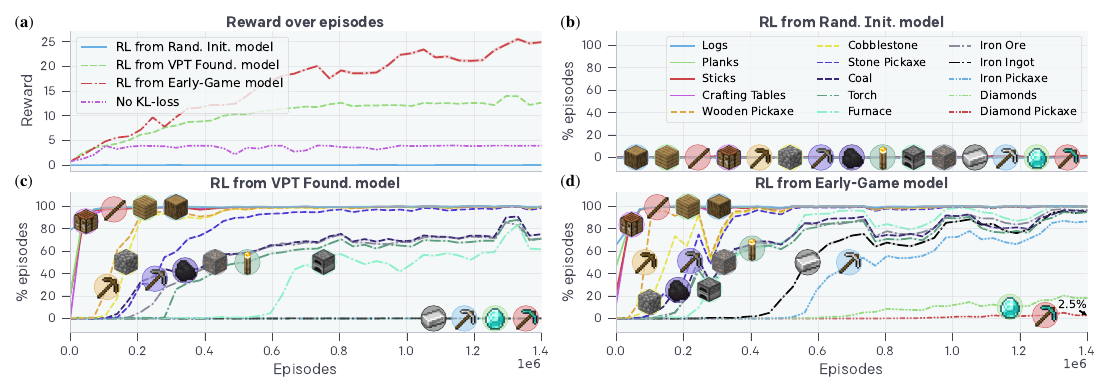
- 무작위 초기화에서 출발: 보상을 거의 얻지 못했다. 통나무조차 안정적으로 모으지 못했고, 나뭇잎을 부숴 가끔 막대를 줍는 정도에 그쳤다.
- 파운데이션 모델에서 출발: 보상이 13 근처까지 올라갔고 철광석 채굴과 화로 제작까지 배웠다. 그러나 화로로 철괴를 제련하는 단계에서 막혔다. 재료가 갖춰져 있어도 그 행동이 나올 제로샷 확률이 너무 낮았기 때문으로 보인다.
- 초반 게임 모델에서 출발:
earlygame_keyword로 한 번 미세조정한 모델에서 강화학습을 시작하자 보상이 25까지 올라갔다. 사전학습, 행동 복제 미세조정, 강화학습 미세조정의 3단 구성이 가장 좋은 결과를 냈다. - KL 손실을 뺀 대조군: 에피소드 10만 회 근처에서 진행이 멈췄다. 통나무와 판자와 막대와 제작대까지만 얻었다. 나무 곡괭이를 쓰는 행동처럼 나중에 필요한 행동을, 초반 기술을 학습하는 동안 잊었기 때문으로 보인다.
3단 구성 모델과 사람의 성적을 나란히 놓으면 이렇게 된다.
| 항목 | 3단 구성 모델 | 사람(같은 목표, 10분) |
|---|---|---|
| 철 곡괭이 | 80% 이상 | 57% |
| 다이아몬드 | 약 20% | 15% |
| 다이아몬드 곡괭이 | 2.5% | 12% |
철 곡괭이와 다이아몬드 채굴에서는 사람 수준에 도달했고, 마지막 한 단계에서는 아직 사람의 5분의 1 수준이다. 앞선 연구에서 다이아몬드를 얻은 확률은 15분 기준 약 0.1%였다. 그 수치도 탐색을 쉽게 하려고 단순화한 행동 공간에서 나온 값이다. 다이아몬드 곡괭이 제작에서 0이 아닌 성공률을 보고한 것은 이 논문이 처음이다.
모델은 효율적인 채굴 패턴과 동굴 탐사도 습득했다. 앞서 놓아 둔 제작대로 되돌아가고, 철 도구로 넘어갈 때 쓰던 나무 곡괭이를 연료로 태우는 요령도 보였다.
계약자 데이터를 어디에 넣을 것인가
저자들이 세운 핵심 가설은 이렇다. 같은 라벨 데이터라면, 그것으로 파운데이션 모델을 직접 학습시키기보다 IDM을 학습시키는 데 쓰는 쪽이 낫다. 저자들은 이것을 두 방향으로 검증했다.
첫째, 학습 데이터를 1시간부터 7만 시간까지 자릿수 단위로 늘려 가며 파운데이션 모델을 여러 개 만들었다. 1,000시간 이하는 계약자 데이터의 실제 라벨로, 5,000시간 이상은 IDM이 라벨을 붙인 web_clean 부분집합으로 학습했다. 제로샷 모델이 제작대를 만들기 시작하는 지점은 5,000시간이 넘어서였고, 돌 도구 제작이 나타나는 것은 7만 시간 전체를 썼을 때뿐이었다.
둘째, IDM 학습량을 달리해 같은 데이터셋에 각각 라벨을 붙였다. 그리고 라벨을 붙인 데이터셋마다 행동 복제 모델을 처음부터 학습했다. 제작 행동이 조금이라도 나오려면 IDM 학습 데이터가 최소 10시간은 필요했고, 100시간까지는 제작률이 빠르게 올라가다가 그 뒤로는 거의 평평해졌다.
저자들은 이 결과를 비용으로 환산해 두었다. 논문에 실린 결과들은 약 4,500시간의 계약자 데이터를 썼고 여기에 9만 달러가 들었다. 프로젝트 전체로는 계약자 보수에 16만 달러를 지출했다. 그런데 앞의 두 번째 실험이 말하는 바에 따르면, IDM 학습에는 100시간이면 충분했을 수 있다. 시급 20달러를 곱하면 2,000달러가 나온다. 7만 시간짜리 공짜 웹 영상을 학습 재료로 바꿔 주는 열쇠의 값이 그 정도였다.
손실이 알려 주지 않은 것
학습 손실과 검증 손실은 학습 내내 순조롭게 떨어졌다. 그런데 모델이 학습에 쓰지 않은 계약자 데이터에 대한 손실은 7에폭 이후 올라가기 시작했다. 계약자의 플레이 분포가 웹 영상과 다르거나 시각적인 도메인 차이가 있었을 것이라고 저자들은 추정한다.
보통이라면 이것을 성능 악화의 전조로 읽었을 텐데, 실제로는 환경 평가 지표가 떨어지지 않았고 미세조정 성능은 계속 좋아졌다. 모델 크기에서도 비슷한 엇갈림이 나왔다. 제로샷 성능에서는 7,100만 파라미터 모델이 1등이었고, 이 작은 모델은 나무 도구 제작까지 해냈다. 그런데 세 모델을 contractor_house로 미세조정하자 순위가 통째로 뒤집혀 5억 모델이 1등으로 올라섰다.
저자들은 이 어긋남 때문에 진행이 더디고 힘들었다고 논문에 적어 두었다. 학습 지표와 실제 평가 사이의 상관관계를 조사하는 것을 후속 연구 방향으로 남겼다.
말로 시키기, 첫걸음
논문의 모델들은 과거 관측만 조건으로 받기 때문에 특정 과제를 지시할 수 없다. 저자들은 부록에서 예비 실험 하나를 소개한다. 마인크래프트 영상에는 플레이어의 음성 해설이 자막으로 함께 실린 경우가 많은데, 저자들의 데이터 중 약 1만 7천 시간이 여기에 해당한다.
저자들은 영상을 30초 단위로 자르고, 그 구간의 자막과 앞뒤 한 줄을 묶어 텍스트로 삼았다. 자막의 약 95%에는 대소문자와 구두점이 없어서 rpunct 라이브러리로 문장부호를 되살려야 했다. 이 텍스트를 OpenAI 임베딩 API에 넣으면 길이 4,096의 벡터가 나온다. 벡터는 은닉층 2,048짜리 2층 MLP를 거친다. 그 결과를 트랜스포머 층 앞에서 프레임별 활성값에 더한다. 계산 비용을 줄이려고 5억 모델 대신 강화학습 실험에 쓴 것과 같은 소형 모델을 골라 4에폭 미세조정했다.
결과에는 말로 행동을 어느 정도 유도할 수 있다는 조짐이 보였다. “I’m going to explore"나 “I’m going to find water” 같은 문장을 조건으로 넣으면 에이전트가 시작 지점에서 눈에 띄게 멀리 이동했고, 특정 아이템을 우선 수집하도록 유도하는 것도 어느 정도 가능했다.
가장 눈여겨본 것
나는 비용을 정리한 대목을 두 번 읽었다. 저자들은 계약자 보수로 16만 달러를 썼고, 논문에 실린 결과에만 한정해도 9만 달러가 들어갔다. 그런데 결론에서 저자들이 스스로 정리한 바로는, 이 결과의 대부분을 얻는 데 필요했던 라벨 데이터는 2,000달러어치였다. 파운데이션 모델도, earlygame_keyword 미세조정도, 다이아몬드 곡괭이를 만든 강화학습 결과도 전부 그 안에 들어간다.
라벨이 붙은 데이터를 모델에 바로 학습시키면 그 데이터만큼의 성능이 나온다. 같은 데이터를 라벨 생성기를 만드는 데 쓰면, 그 생성기가 공짜로 널려 있는 7만 시간을 학습 가능한 자산으로 바꿔 놓는다. 같은 2,000달러를 어디에 넣느냐에 따라 되돌아오는 크기가 이렇게 갈렸다.
두 번째로 의외였던 대목은 손실 곡선을 믿을 수 없었다는 점이다. 계약자 데이터 손실이 올라가는데 미세조정 성능은 계속 좋아졌고, 제로샷에서 1등이던 모델이 미세조정 후에는 꼴찌가 되었다. 무엇을 보고 학습을 멈출지 정하는 기준 자체가 흔들린다는 뜻이고, 저자들도 이 때문에 진행이 더뎠다고 인정한다. 네 해가 지난 지금도 사전학습된 모델의 최종 쓸모를 중간 지표로 예측하는 문제는 깔끔하게 풀리지 않았다.
출처
Bowen Baker, Ilge Akkaya, Peter Zhokhov, Joost Huizinga, Jie Tang, Adrien Ecoffet, Brandon Houghton, Raul Sampedro, Jeff Clune (OpenAI, University of British Columbia), 2022년 6월 23일 arXiv 공개, NeurIPS 2022 수록.
원문: https://arxiv.org/abs/2206.11795 공식 소개 글: https://openai.com/index/vpt/
본문 도판은 논문 Figure 2, 3, 5, 6, 7과 OpenAI 공식 블로그의 개요 다이어그램에서 가져왔다.