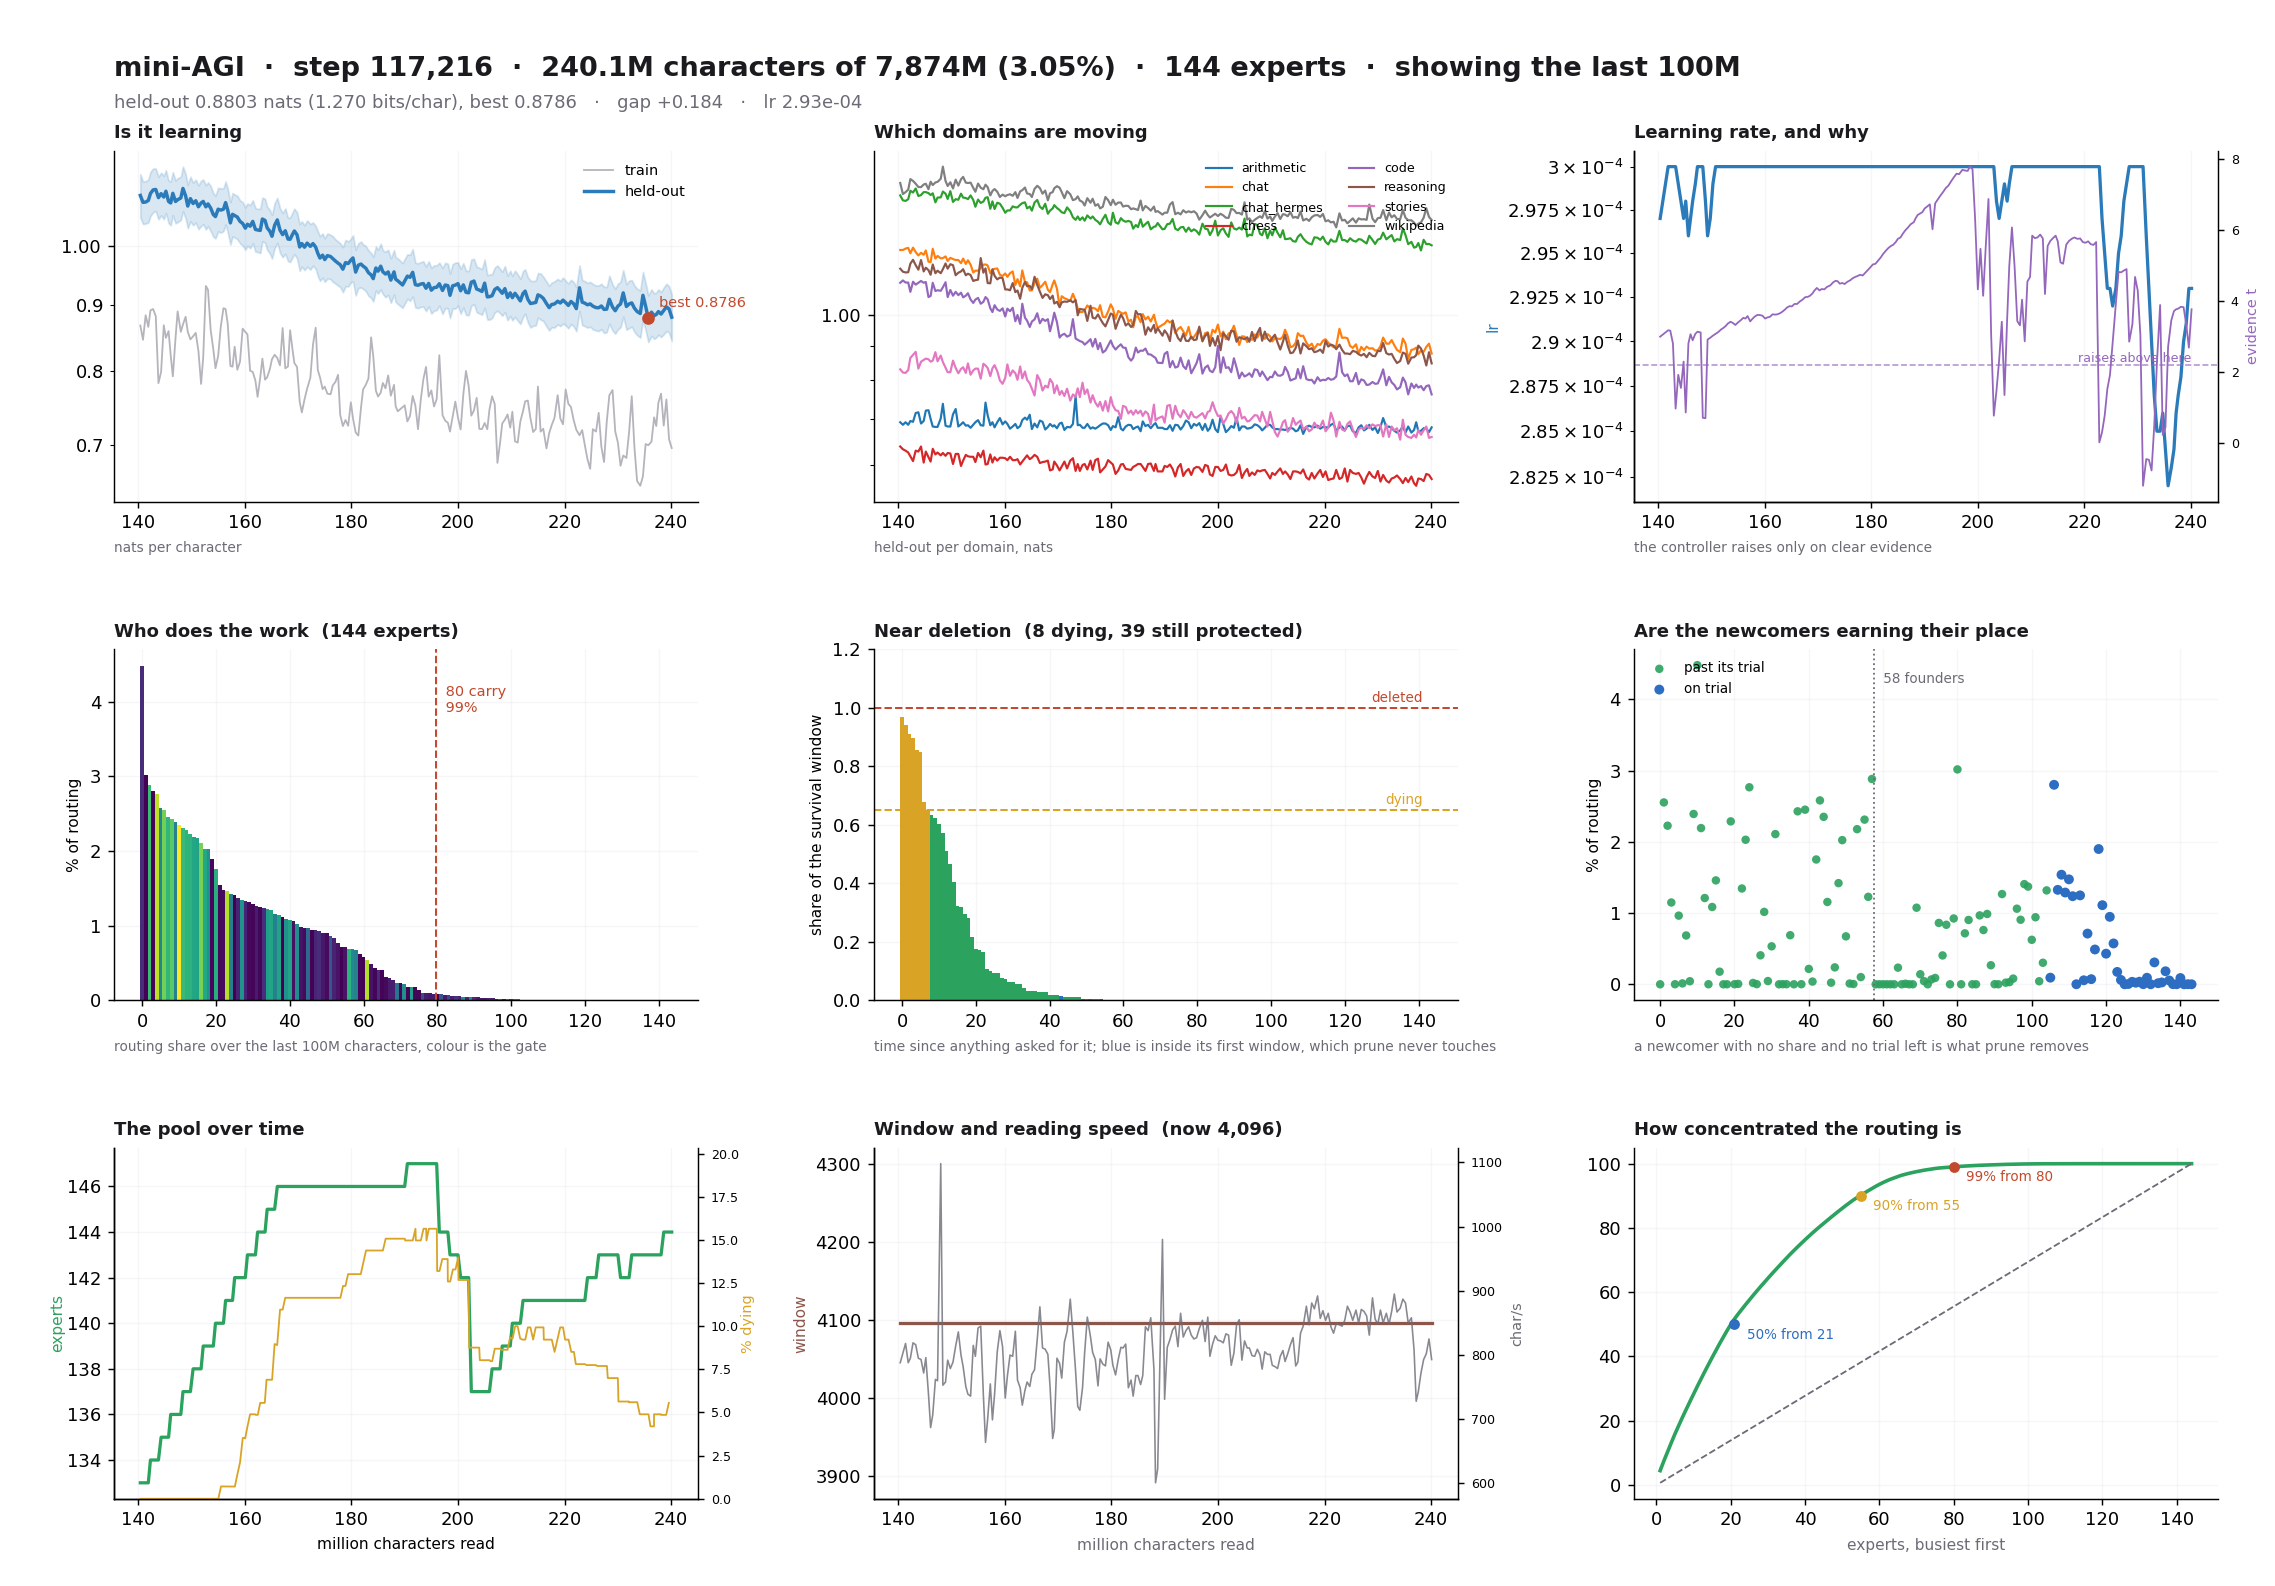
3줄 요약
- GitHub에서 volotat이라는 계정을 쓰는 Alexey Borsky가 2026년 9월 19일 바이트 단위 언어 모델 mini-AGI를 MIT 라이선스로 공개했다. 이 모델은 VRAM 8GB GPU 한 장에서 처음부터 학습하며, 배치 크기 1로 데이터 스트림을 읽는 동안에도 학습을 멈추지 않는다. 저자는 현재 모델이 장난감 수준이라고 먼저 밝혔고, 파국적 망각 없는 지속 학습이 평범한 하드웨어에서도 가능하다는 것을 보여 주려는 실험이라고 설명했다.
- 설계는 세 가지 장치로 구성된다. 첫째, 전문가 가중치를 디스크의 파일로 저장하고 필요한 32개만 VRAM에 적재한다. 둘째, 학습 도중 새 전문가를 추가하고 오랫동안 선택되지 않은 전문가를 삭제한다. 셋째, 재귀 블록을 최대 24회까지 반복하되 글자마다 반복 횟수를 모델이 스스로 정한다.
- 저자가 측정해 보니, 망각을 방지하는 데는 전문가 풀보다 트렁크 학습률이 훨씬 크게 기여했다. 체스 데이터만 52만 4천 글자를 읽힌 실험에서, 트렁크를 전문가 학습률의 10분의 1로 학습시키자 읽지 않은 일곱 과목의 손실 증가가 +2.2300 nats에서 +0.0067 nats로 줄었다.
무엇을 만들었는가
README 첫 문단은 mini-AGI를 “스스로 아키텍처를 조립하고(assembles its own architecture)”, 8GB VRAM GPU 한 장에서 처음부터 학습하며, 읽는 모든 것으로부터 계속 학습하는 바이트 단위 언어 모델로 소개했다. 가중치는 디스크에 일반 파일로 저장되고 필요할 때 GPU로 로드된다. 따라서 파라미터 수의 상한은 VRAM 용량보다 남은 디스크 용량에 따라 정해진다. 저자는 VRAM 8GB의 RTX 3070 노트북 GPU를 기준 머신으로 삼았다.
| 항목 | 내용 |
|---|---|
| 공개 | 2026년 9월 19일, MIT 라이선스, Python |
| 읽은 분량 | 코퍼스 78억 7,900만 글자 중 4억 900만 글자(5.19%) |
| 전문가 수 | 175개 |
| 가중치 공개 | 코퍼스 첫 패스를 마친 뒤 공개할 예정이며, 현재 속도로는 2주가량 남았다 |
저자는 동기를 이렇게 설명했다. 지금 개인이 소유할 수 있는 언어 모델은 모두 다른 누군가가 학습을 마치고 동결한 상태로 배포된다. 미세 조정으로 일부를 손볼 수는 있어도, 자기 하드웨어로 처음부터 학습시킬 수는 없다. 일상에서 다루는 자료로 계속 학습시키려 하면 모델은 이전에 알던 것을 잊는다. 저자는 그 결과 개인 모델이라 해도 대부분은 남이 만든 모델이고, 출시되는 날 학습도 멈춘다고 지적했다.
mini-AGI에는 별도의 미세 조정 단계도, 동결된 베이스 모델도 없다. 모델은 글자 스트림을 청크 단위로 읽고, 청크마다 그래디언트 업데이트를 한 번 수행한다. 텍스트 생성도 같은 코드 경로를 쓴다. README는 이 구조를 두고 읽기와 학습이 같은 과정이라고 표현했다.
저자는 설계 전체를 결정한 제약으로 세 가지 조건을 들었다.
- 8GB로 학습할 수 있어야 한다. 양자화로는 해결되지 않는다. 학습에는 그래디언트와 옵티마이저 상태가 필요하고, 이 둘이 가중치 크기의 약 세 배에 해당하는 메모리를 추가로 요구하기 때문이다. 그래서 가중치는 디스크에 저장하고, 작업 집합만 VRAM에 상주시킨다.
- 잊지 않아야 한다. README는 계속 학습하면서 이전 지식을 덮어쓰는 모델이 아예 학습하지 않는 모델보다 나쁘다고 했다.
- 무엇이든 읽을 수 있어야 한다. 입력 알파벳이 256개의 바이트 값이므로 따로 학습시킬 토크나이저가 없고, 새로운 데이터 형식이 나와도 어휘를 늘릴 필요가 없다.
아키텍처: 글자마다 연산 깊이를 스스로 정한다
일반적인 LLM은 모든 토큰에 같은 수의 층을 적용한다. mini-AGI는 각 글자(바이트)에 밀집 프렐류드 블록 두 개를 적용한 다음, 재귀 블록 하나를 최대 24회 반복 적용한다. 모델을 구성하는 블록은 세 종류뿐이지만, 재귀 블록을 반복하기 때문에 글자 하나에 블록 연산을 최대 26회까지 적용할 수 있다. 반복과 반복 사이의 잠재 상태를 텍스트로 디코딩하는 절차는 없다. 대신 어댑터가 반복할 때마다 이 상태와 입력 임베딩을 합친다. 저자는 이 방식 덕분에 반복을 거듭해도 읽고 있는 텍스트의 정보가 잠재 상태에 계속 반영된다고 설명했다.
- 적응형 깊이. 정지 헤드(halting head)가 반복마다 글자별 점수를 매기고, 한 번 더 반복해도 답이 바뀌지 않는 시점에 그 글자의 연산을 멈춘다. 쉬운 글자는 한 번, 어려운 글자는 여러 번 반복한다. 방식은 PonderNet을 따랐다. 학습 중에는 모든 깊이를 계산한 뒤 각 깊이의 정지 확률로 가중해 합치고, 정지 헤드는 이 가중치를 통해 학습한다.
- 블록 연산 단위의 라우팅. 26회의 블록 연산은 각각 공유 전문가 풀에서 상위 8개를 따로 고른다. 그러므로 글자 하나가 사용하는 전문가는 “top-8"이라는 이름에서 짐작하는 것보다 훨씬 많고, 같은 전문가가 서로 다른 깊이에서 여러 번 선택될 수도 있다.
- 전문가에게 주제를 배정하지 않는다. 어떤 전문가에도 레이블이 없다. 전문가마다 맡는 능력은 소프트 top-k 라우팅이 학습되는 과정에서 저절로 정해지고, 글자 하나는 여러 전문가의 연산 결과를 조합해 쓴다. README는 그 대가로 서로 다른 능력이 같은 파라미터를 공유하므로 간섭이 생길 수 있다고 적었다.
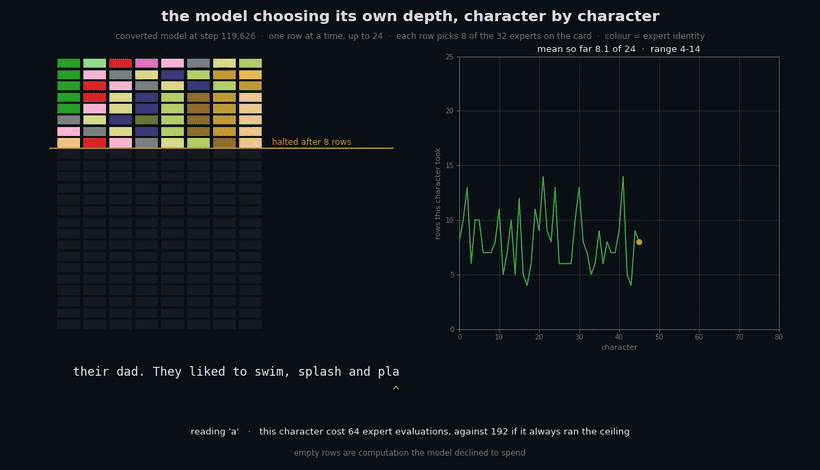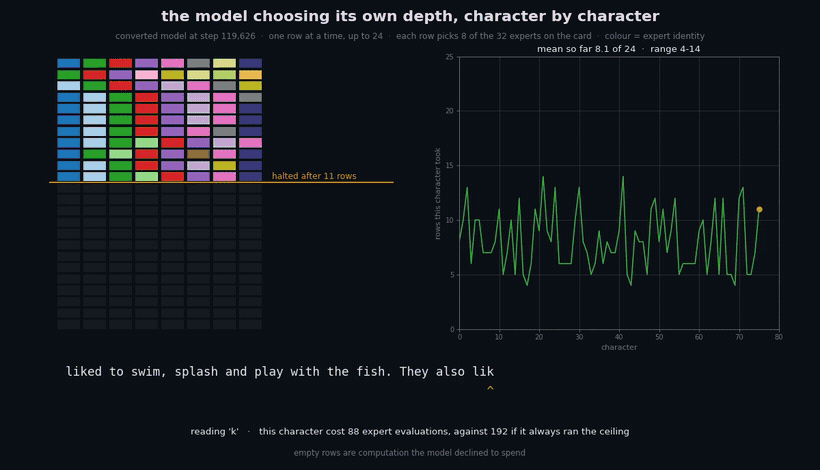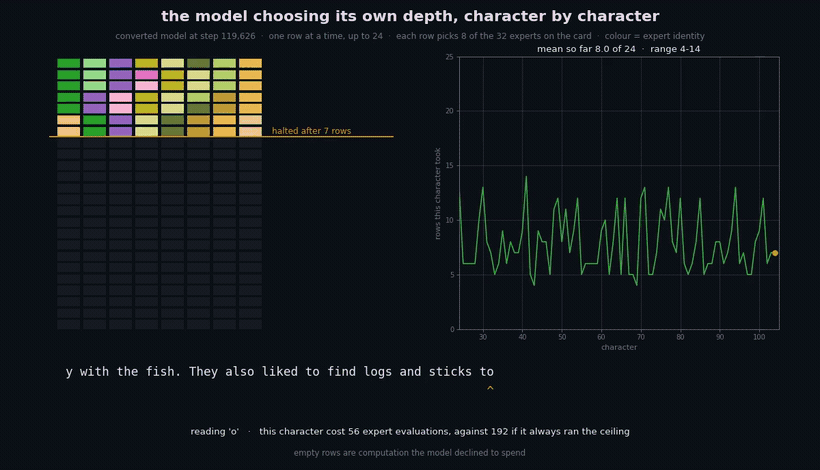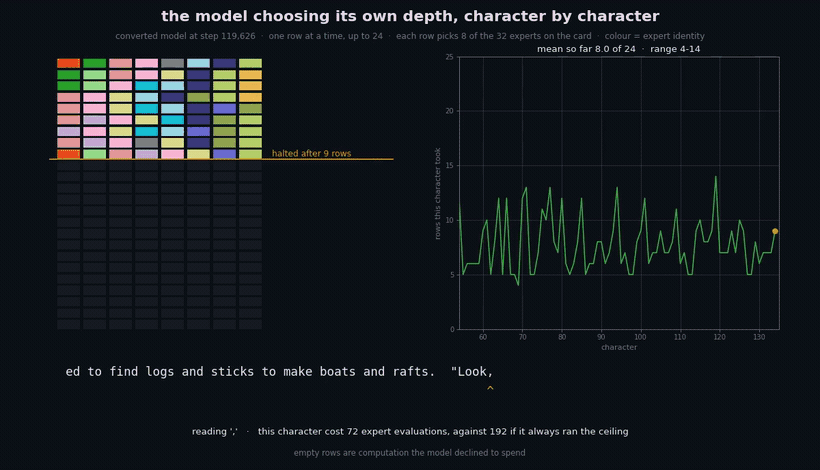 그림 1. 글자를 읽는 동안 모델이 반복 횟수를 정하는 과정. 타일 하나가 전문가 하나이고, 가로 한 줄이 재귀 블록 1회 적용이다. 출처: mini-AGI 리포지토리
저자는 이 애니메이션이 실제 모델에서 캡처한 기록이며 손으로 그린 부분은 없다고 밝혔다. 한 줄의 타일 8개는 그 반복에서 실제로 실행된 전문가 8개이고, 타일 색은 전문가마다 고정되어 영상 내내 바뀌지 않는다. 주황색 선은 정지 헤드가 연산을 멈춘 지점이고, 그 아래 회색 줄은 모델이 쓰지 않기로 한 연산이다. 오른쪽 그래프는 글자마다 반복한 횟수를 나타낸다. 반복 횟수는 4회에서 14회 사이에서 계속 변동했고, 상한 24회보다 한참 적었다. 화면 하단 문구에 따르면 8회 반복에서 멈춘 글자 하나는 전문가 연산 64회를 썼고, 상한까지 반복했다면 192회가 필요했다.
위치 인코딩에는 회전 위치 임베딩(RoPE)을 써서 학습되는 파라미터가 없다. 저자는 그렇기 때문에 어떤 부분도 다시 초기화하지 않고 추가 학습만으로 컨텍스트 창을 늘릴 수 있다고 설명했다.
글을 쓸 때의 깊이
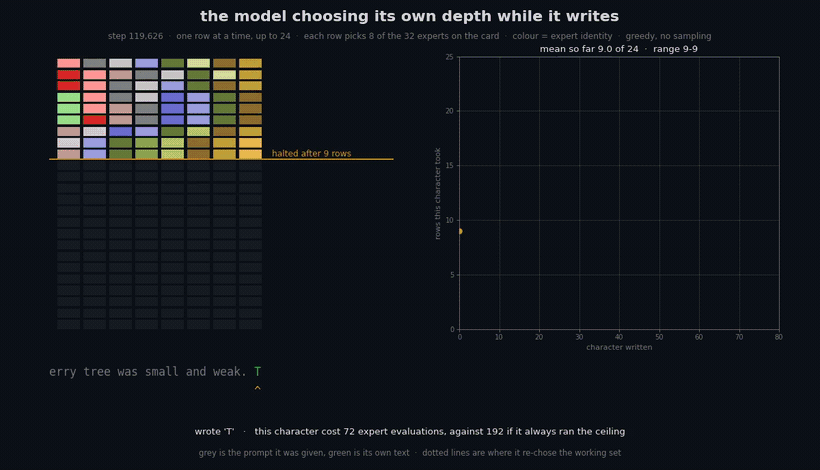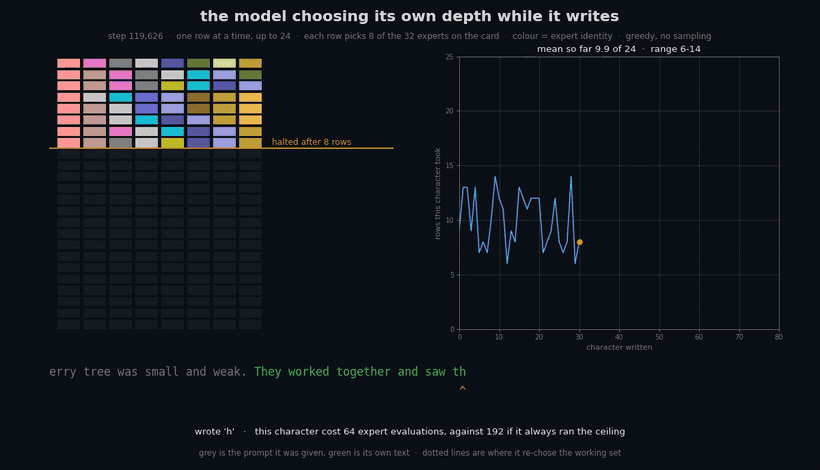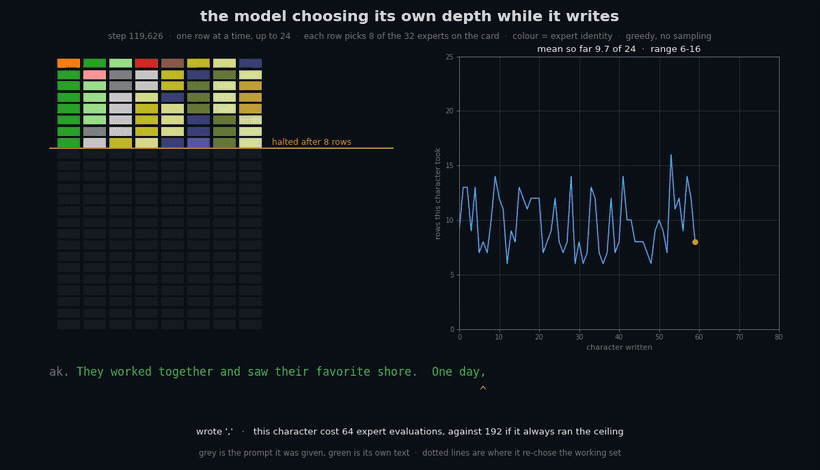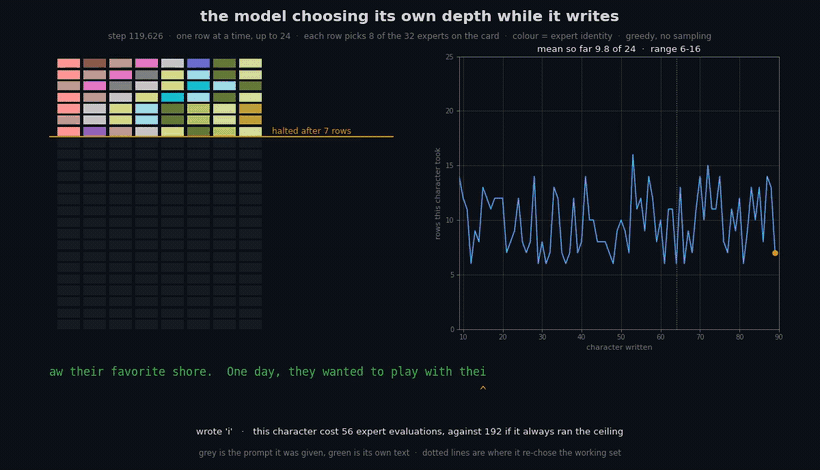 그림 2. 모델이 이야기를 이어 쓰는 동안의 반복 횟수. 회색 글자는 주어진 프롬프트이고 초록색 글자가 모델이 직접 쓴 텍스트다. 출처: mini-AGI 리포지토리
그림 1에서 모델은 검증용 텍스트를 읽고 있다. 그림 2에서는 검증용 이야기 2,500글자를 프롬프트로 준 뒤 모델이 직접 이어 쓰게 했다. 디코딩은 샘플링 없는 그리디 방식이라 두 번 실행해도 같은 문장이 나온다. 이 모델은 생성할 때도 읽을 때와 같은 순전파를 수행한다. 다음 글자를 파일에서 가져오느냐 모델 자신의 argmax에서 가져오느냐만 달라진다.
읽을 때와 쓸 때는 글자당 반복 횟수가 달랐다. 모델은 같은 주제의 텍스트를 읽을 때 글자당 평균 8.0회를 반복했고, 직접 쓸 때는 평균 9.9회를 반복했다. 생성 중에는 64글자마다 작업 집합을 다시 고르는데, 이 영상에서는 프롬프트를 읽는 동안 필요한 전문가가 이미 GPU에 적재되어 교체가 한 번도 일어나지 않았다. 벚나무 이야기를 이어 쓴 결과물은 다음과 같다.
They worked together and saw their favorite shore. One day, they wanted to play with their favorite shore. They wanted to play with it, but
README는 이 문장이 문법에 맞고 주제와도 관련이 있지만 아직 같은 말을 반복한다고 평가했고, 2억 4,300만 글자를 읽은 시점의 모델 수준을 공정하게 보여 주는 예라고 덧붙였다.
모델 사양
| 항목 | 내용 |
|---|---|
| 어휘 | 265개. 바이트 값 256개와 구조 표지 9개(<think> 스크래치패드, <user>와 <bot> 대화 턴, 게임용 <g>, 텍스트 종료) |
| 컨텍스트 | 4,096글자 |
| 본체 | RMSNorm, RoPE, SwiGLU, scaled_dot_product_attention을 통한 플래시 어텐션 |
| 깊이 | 서로 다른 블록 3개, 글자당 최대 26회 블록 연산 |
| 재귀 | 가중치를 공유하는 블록 하나를 최대 24회 적용하며, 잠재 상태는 디코딩하지 않는다 |
| 정지 | PonderNet. 글자마다 독립적으로 멈추므로 어려운 글자가 더 많은 반복을 쓴다 |
| 라우팅 | 블록 연산마다 글자별로 상위 8개 전문가를 선택한다 |
| 페이징 | 전문가 32개만 GPU에 상주하고 나머지는 디스크에 저장한다 |
풀의 전문가 수가 학습 중에 늘거나 줄기 때문에 파라미터 수도 계속 바뀐다. README 작성 시점의 구성은 다음과 같다.1
core        8.27M   임베딩, 어텐션, 정규화, 어댑터, 정지 헤드
routers     0.17M   호출 지점마다 전문가당 한 행, 깊이 임베딩
experts   531.6M    169개 x 각 3.15M (3 x 512 x 2048)
--------------------
total     540.1M
VRAM 사용량은 풀 전체의 크기와 무관하게 작업 집합의 크기로 정해진다. GPU에는 한 번에 전문가 32개만 상주하며, 이들의 파라미터를 합쳐도 약 1억 900만 개로 전체 5억 4천만 개의 5분의 1 정도에 그친다. 그래서 8GB 카드에서도 전문가를 계속 추가할 수 있다. 학습 연산량은 바이트당 약 2.4 GFLOPs이며, 저자는 같은 연산량 등급의 모델로 4억 파라미터급 밀집 바이트 단위 트랜스포머를 들었다.
페이징: 전문가 하나가 파일 하나다
전문가는 각각 디스크의 파일 하나로 저장되며, 파일에는 그 전문가의 가중치와 Adam 모멘트가 함께 들어 있다. 저장 계층은 세 단계로 구성된다.
| 계층 | 설정 키 | 역할 |
|---|---|---|
| 디스크 | 없음 | 모델이 가진 모든 전문가. 여유 디스크 용량이 상한이다 |
| RAM | ram_cache (기본 96) | 최근에 요청된 전문가. 가장 오래 쓰이지 않은 것부터 제거한다 |
| VRAM | resident (기본 32) | 작업 집합. 글자가 라우팅할 수 있는 전문가다 |
모델은 각 청크를 읽기 전에 그 청크를 처리하는 데 필요한 전문가를 예측하고, 그 예측으로 작업 집합을 정한다. 수요 점수는 직전 청크를 읽는 동안 라우팅에 실제로 쓰인 은닉 상태로 계산한다. README는 임베딩에 문맥 정보가 없어서, 날것의 임베딩으로 점수를 매기면 어떤 주제든 같은 전문가가 선택된다고 설명했다.
프로젝트는 두 가지 규칙을 지킨다.
- Adam 모멘트는 전문가와 함께 이동한다. Adam 모멘트는 전문가별로 관리하며 VRAM 슬롯과는 관계가 없다. 모멘트를 슬롯에 남겨 두면, 그 슬롯을 새로 쓰는 전문가가 이전 전문가의 모멘텀으로 학습하게 된다. README는 이 경우 학습 지표가 정상으로 나오는데도 교체된 전문가마다 남의 이력을 물려받는 문제가 생긴다고 경고했다.
- 이미 GPU에 있는 전문가는 원래 슬롯을 유지한다. 수요 목록은 정렬된 순서로 나오므로, 집합의 구성이 거의 같아도 순서는 크게 바뀐다. 슬롯 번호 대신 전문가 ID로 대조하면, 로드 횟수는 전문가 구성이 실제로 바뀐 만큼만 늘어난다.
작업 집합은 직전 청크를 근거로 고르기 때문에, 이제 예측할 텍스트의 내용은 반영하지 못한다. 잡음 때문에 작업 집합이 자주 교체되는 문제는 히스테리시스로 방지한다. 후보 전문가가 상주 전문가를 교체하려면 수요가 margin(기본 0.10)만큼 더 높아야 하고, 새로 적재된 전문가는 dwell_chars(기본 2,048글자) 동안 교체되지 않는다.
가중치 디렉터리가 곧 모델이다
weights/
  manifest.json     무엇이 있는지, 형태, 출처
  core.npz          임베딩, 어텐션, 정규화, 어댑터, 정지 헤드
  routers.npz       게이트, 세그먼트 라우터, 호출 지점마다 전문가당 한 행
  optim.npz         트렁크와 라우터의 Adam 모멘트
  experts/          전문가마다 파일 하나: w1, w3, w2와 자체 Adam 모멘트
    e00000.npz ...
학습은 이 디렉터리에서 가중치와 Adam 모멘트, 스텝 수를 불러와 재개한다. 디렉터리에는 가장 최근 상태 대신 지금까지 성능이 가장 좋았던 상태가 저장되고, 학습 결과가 기존보다 나을 때만 갱신된다. 모든 파일은 .tmp로 먼저 쓴 뒤 이름을 바꾸는 방식으로 저장되므로, 저장이 중단되어도 반쯤 쓰인 가중치 파일이 남지 않는다. 별도의 .pt 체크포인트 파일은 없고, 모든 도구에서 --ckpt weights로 이 디렉터리를 지정한다.
성장과 가지치기
전문가 풀은 용량이 부족하면 전문가를 추가하고, 일부 전문가가 더 이상 요청되지 않으면 그 전문가를 삭제한다. 새 전문가는 쓰일지 확인되기 전에 시험 삼아 추가된다. 게이트 값을 작게(기본 0.001) 시작해 모델 출력에 거의 영향을 주지 않게 하고, 이후에도 계속 요청될 때만 유지한다.
새 전문가는 재조합으로 만든다. 재조합은 기존 전문가 여러 개에서 은닉 유닛을 통째로 가져와 새 전문가 하나로 조합한다. 저자에 따르면 부모 하나를 복제한 전문가는 새로움이 부족해 라우팅할 가치가 없고, 무작위로 초기화한 전문가는 라우팅할 가치가 있는 연산을 하지 못한다. 효과가 있었던 방식은 학습된 은닉 유닛을 조합해 만든 새로움이었다고 한다.
전문가 추가는 다음 다섯 조건을 모두 충족할 때만 허용된다. 설정 파일 기준으로 200만 글자마다 한 번 판단하고, 한 번에 전문가 한 개를 추가한다.
| 조건 | 내용 |
|---|---|
| room | 디스크와 VRAM에 여유가 있다. 디스크 상한은 기본 10GB이고 전문가 하나는 25.2MB다 |
| used | 이미 추가한 용량이 실제로 요청되고 있다 |
| earning | 직전에 추가한 전문가들이 시험 기간을 통과했다 |
| fits | 시험 기간 중인 전문가가 너무 많지 않다. 기본 상한은 50개다 |
| honest | 학습 손실과 검증 손실의 격차가 기준(기본 0.4)을 초과하지 않았다 |
README는 아무도 요청하지 않는 전문가를 죽은 전문가(dead)로 정의한다. 전문가 추가 조건과 가지치기는 모두 전문가가 마지막으로 요청된 뒤 지난 시간으로 판단하고, 게이트 값은 판단에 쓰지 않는다. 저자는 이 결정을 리포지토리 전체에서 가장 쓸모 있는 발견으로 꼽았다. 실제로 이 모델에서는 게이트가 가장 작은 전문가가 가장 자주 선택되는 전문가였다. 게이트 값을 기준으로 삼으면 두 가지 오판이 생긴다. 계속 선택되지만 글자당 기여가 작은 싱크형 전문가는 죽은 것으로 분류된다. 반대로 수십만 세그먼트 동안 아무도 요청하지 않았어도 게이트가 큰 전문가는 살아 있는 것으로 분류된다.
새 전문가는 생존 기간(설정 기본값 1억 글자) 동안은 어떤 경우에도 삭제되지 않는다. 저자는 새 전문가가 선택될 기회를 얻기도 전에 평가받는 일을 방지하려고 이 보호 기간을 정했다. 전문가를 추가하면 디스크에 새 파일이 생기고, 가지치기하면 그 파일이 삭제된다. 설정 파일에 따르면 풀은 전문가 64개로 학습을 시작했고, 4억 900만 글자를 읽는 동안 전문가가 175개로 늘었다.
지속 학습: 망각을 방지한 것은 트렁크 학습률이었다
한 번에 한 과목씩 단일 스트림으로 학습하면 전형적으로 파국적 망각이 일어난다. README에 따르면 전문가 학습률 그대로 체스 데이터 50만 글자만 읽히자 나머지 일곱 과목의 손실이 1.12 nats에서 3.73 nats로 올랐다.
저자는 트렁크의 학습률에서 해법을 찾았다. 트렁크는 임베딩, 어텐션, 라우터, 정지 헤드처럼 모든 글자의 연산에 쓰이는 부분이고, 그래디언트 노름 제곱의 97.6%를 차지한다. 트렁크 학습률을 전문가의 0.1배로 낮추자 읽지 않은 과목의 손실 증가는 +2.2300 nats에서 +0.0067 nats로 줄었다. 무작위 수준과 비교하면 학습 성과의 99.84%가 유지됐다.
| 구성 | 읽지 않은 과목의 손실 변화 | 무작위 대비 유지율 |
|---|---|---|
| 작업 집합 동결, 트렁크 LR = 전문가 LR | +2.5871 | 42.88% |
| 전문가 교체, 트렁크 LR = 전문가 LR | +2.2300 | 50.68% |
| 전문가 교체, 트렁크 0.1배 (실제 학습 설정) | +0.0067 | 99.84% |
| 대조군: 일곱 과목을 모두 읽음 | -0.0077 | 해당 없음 |
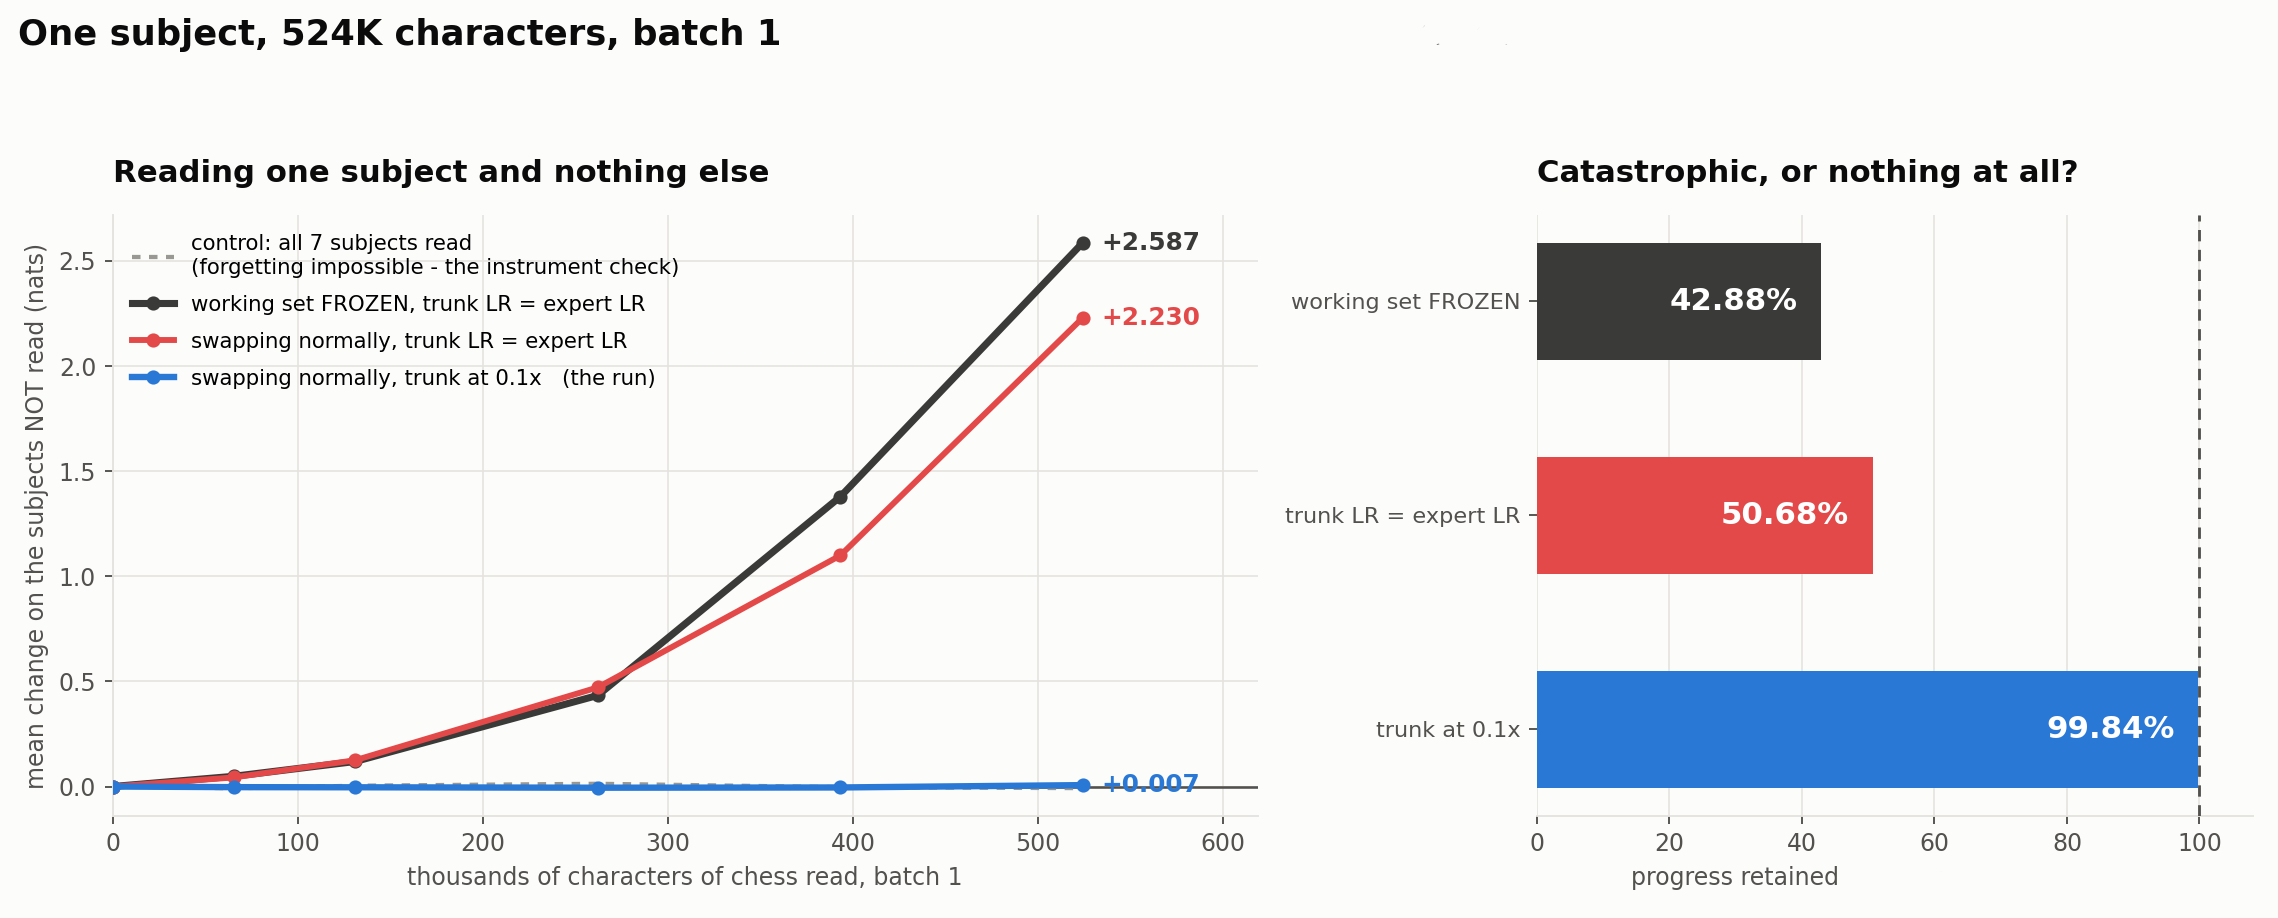 그림 3. 체스 52만 4천 글자만 배치 크기 1로 읽힌 실험. 왼쪽은 읽지 않은 일곱 과목의 평균 손실 변화이고, 오른쪽은 같은 결과를 무작위 대비 유지율로 환산한 값이다. 출처: mini-AGI 리포지토리
README는 이 측정을 설계 전체의 근거로 소개했다. 모델은 체스만 52만 4천 글자를 읽었고, 세 구성은 각각 변수를 하나씩만 바꿨다. 나머지 두 구성에서는 읽지 않은 과목의 손실 증가가 +2.2 nats와 +2.6 nats에 달해, 모델이 알던 것의 대부분을 잃었다. 트렁크 학습률을 전문가의 10분의 1로 설정한 구성만 실험 내내 0 근처를 유지했다. 회색 점선 대조군은 일곱 과목을 모두 읽힌 조건으로, 구조상 망각이 일어날 수 없다. 저자는 유지율 50.68%와 99.84%의 차이가 설정 파일의 숫자 하나로 결정된다고 적었다.
저자는 이 결과에서 두 가지를 읽어 냈고, 그중 두 번째는 이 프로젝트의 이전 설명을 스스로 정정하는 내용이라고 밝혔다.
- 전문가 풀은 망각 방지의 주된 요인이 못 된다. 작업 집합을 동결해 전문가 교체를 없애도 망각은 0.3571 nats 늘어날 뿐이었고, 이는 전체 효과의 13.8%에 해당한다. 이 구성에서는 전문가 136개 중 93개가 그래디언트를 전혀 받지 않았는데도 모델의 성능이 크게 떨어졌다. 가중치 대부분을 보존해도 망각은 방지되지 않았다.
- 저자는 이 손상을 파괴보다 변위(displacement)로 해석했다. 모델을 크게 손상시킨 뒤 모든 과목을 다시 읽히자, 손실 증가분의 4분의 3이 13만 1천 글자 만에 회복됐다. 처음 이 과목들을 학습하는 데는 약 5,000만 글자가 들었다. 저자는 새로 배워야 하는 지식이라면 380배 빠르게 회복될 리 없다고 지적했다. 저자는 ‘파국적’이라는 표현이 손실이 가장 나빠진 시점의 모습을 묘사할 뿐, 가중치에 실제로 일어난 일을 설명하지 못한다고 결론지었다.
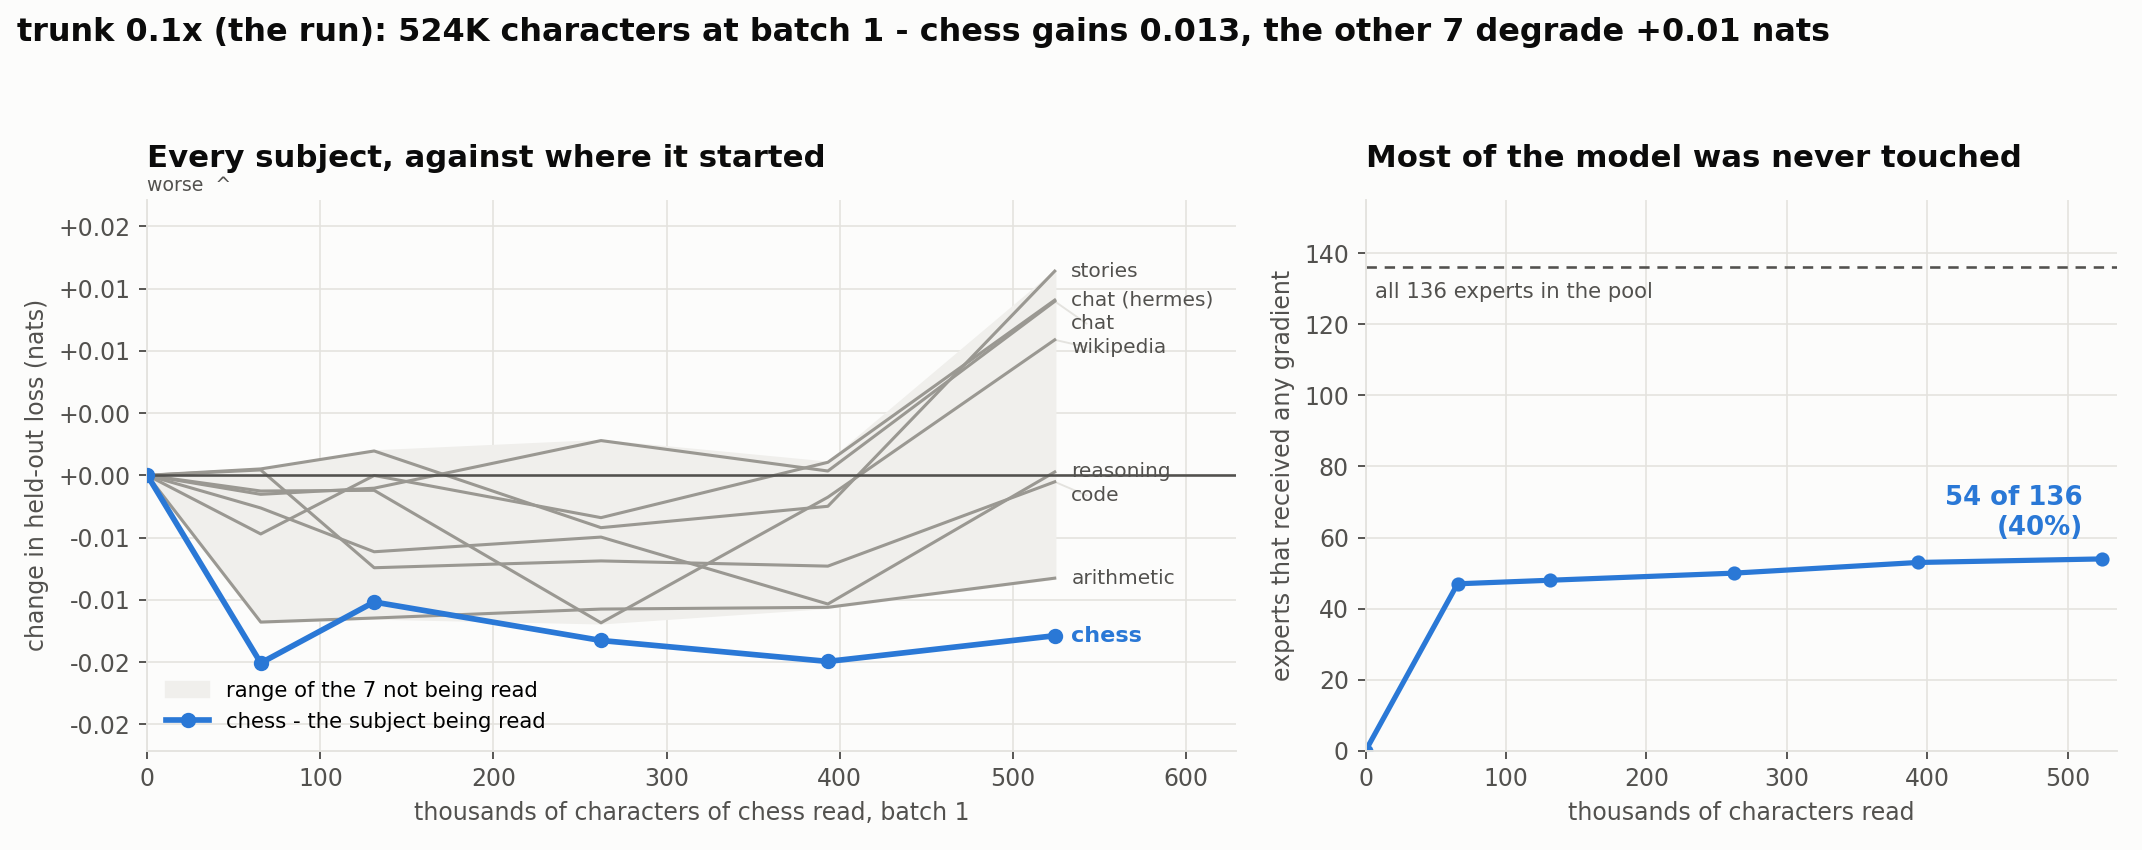 그림 4. 실제 학습 설정(트렁크 0.1배)으로 같은 체스 실험을 수행한 결과. 왼쪽은 과목별 검증 손실의 시작점 대비 변화이고, 오른쪽은 그래디언트를 한 번이라도 받은 전문가 수다. 출처: mini-AGI 리포지토리
그림 4는 실제 학습 설정으로 같은 52만 4천 글자 실험을 수행했을 때 모델 내부에서 일어난 일을 나타낸다. 읽고 있는 과목인 체스의 손실은 0.013 nats 개선됐다. 읽지 않은 일곱 과목의 손실 변화는 실험 내내 ±0.02 nats 이내였다. 오른쪽 패널에 따르면 실험 전체에서 그래디언트를 받은 전문가는 136개 중 54개였다. 나머지 82개, 곧 모델의 60%는 라우팅에서 한 번도 선택되지 않아 구조적으로 업데이트되지 않았다. README는 텍스트가 요구한 부분에만 업데이트를 한정하는 것이 전문가 풀 본연의 기능이라고 설명했다.
학습률은 스케줄을 따르지 않는다. README는 코사인 스케줄이 학습에 끝이 있다고 전제하는데, 계속 읽는 모델에는 그 전제가 맞지 않는다고 했다. mini-AGI에서는 제어기가 검증 손실을 지켜보며 학습률을 올리기도 하고 내리기도 한다. 뚜렷한 개선이 있으면 학습률을 조금 올리고, 개선의 근거가 없으면 조금씩 낮추며, 검증 손실이 급등한 것이 확인되면 다시 올린다.
자기 파일을 읽히기
README는 자기 파일을 읽히는 것이 사용자가 관심 있는 내용을 아는 모델을 얻는 가장 빠른 방법이라고 소개했다.
python3 train.py read notes/                    # 드라이런, 아무것도 저장하지 않는다
python3 train.py read src/ docs/ --passes 3 --save
파일이나 디렉터리를 지정하면 되고 별도의 준비 작업은 없다. 알파벳이 256개 바이트 값이므로 파일 형식과 관계없이 토크나이저 없이 바로 읽을 수 있다. 디렉터리는 재귀적으로 탐색하고, 바이너리 파일은 확장자를 믿는 대신 내용 일부를 샘플링해 판별한 뒤 건너뛴다. 문서에는 순서가 있으므로 각 파일은 처음부터 끝까지 읽는다. 청크 분할 방식과 캐시, 그래디언트 업데이트는 모두 본 학습의 코드를 그대로 재사용한다.
| 옵션 | 설명 |
|---|---|
--passes N | 전체 파일을 N번 읽는다 |
--save | 학습한 내용을 저장한다. 없으면 weights/를 건드리지 않는다 |
--lr | 기본값 5e-5로 본 학습보다 낮다. README는 읽기가 모델을 조정할 뿐 덮어써서는 안 된다고 설명했다 |
--mix "" | 읽기 전후 점수 측정을 생략한다 |
기본 동작에서는 두 가지를 알아 두면 좋다. 첫째, --save를 주지 않으면 아무것도 저장되지 않는다. 사용자가 저장을 선택하기 전까지 읽기는 드라이런으로 실행된다. 둘째, 읽기 전후에 검증 혼합 데이터로 점수를 매기고, 파일을 읽은 탓에 다른 영역의 성능이 떨어졌다면 그 점을 분명히 알린다. 저자는 망각이 없다고 가정하는 대신, 읽기를 할 때마다 망각을 측정하도록 이 기능을 설계했다.
학습 현황과 벤치마크
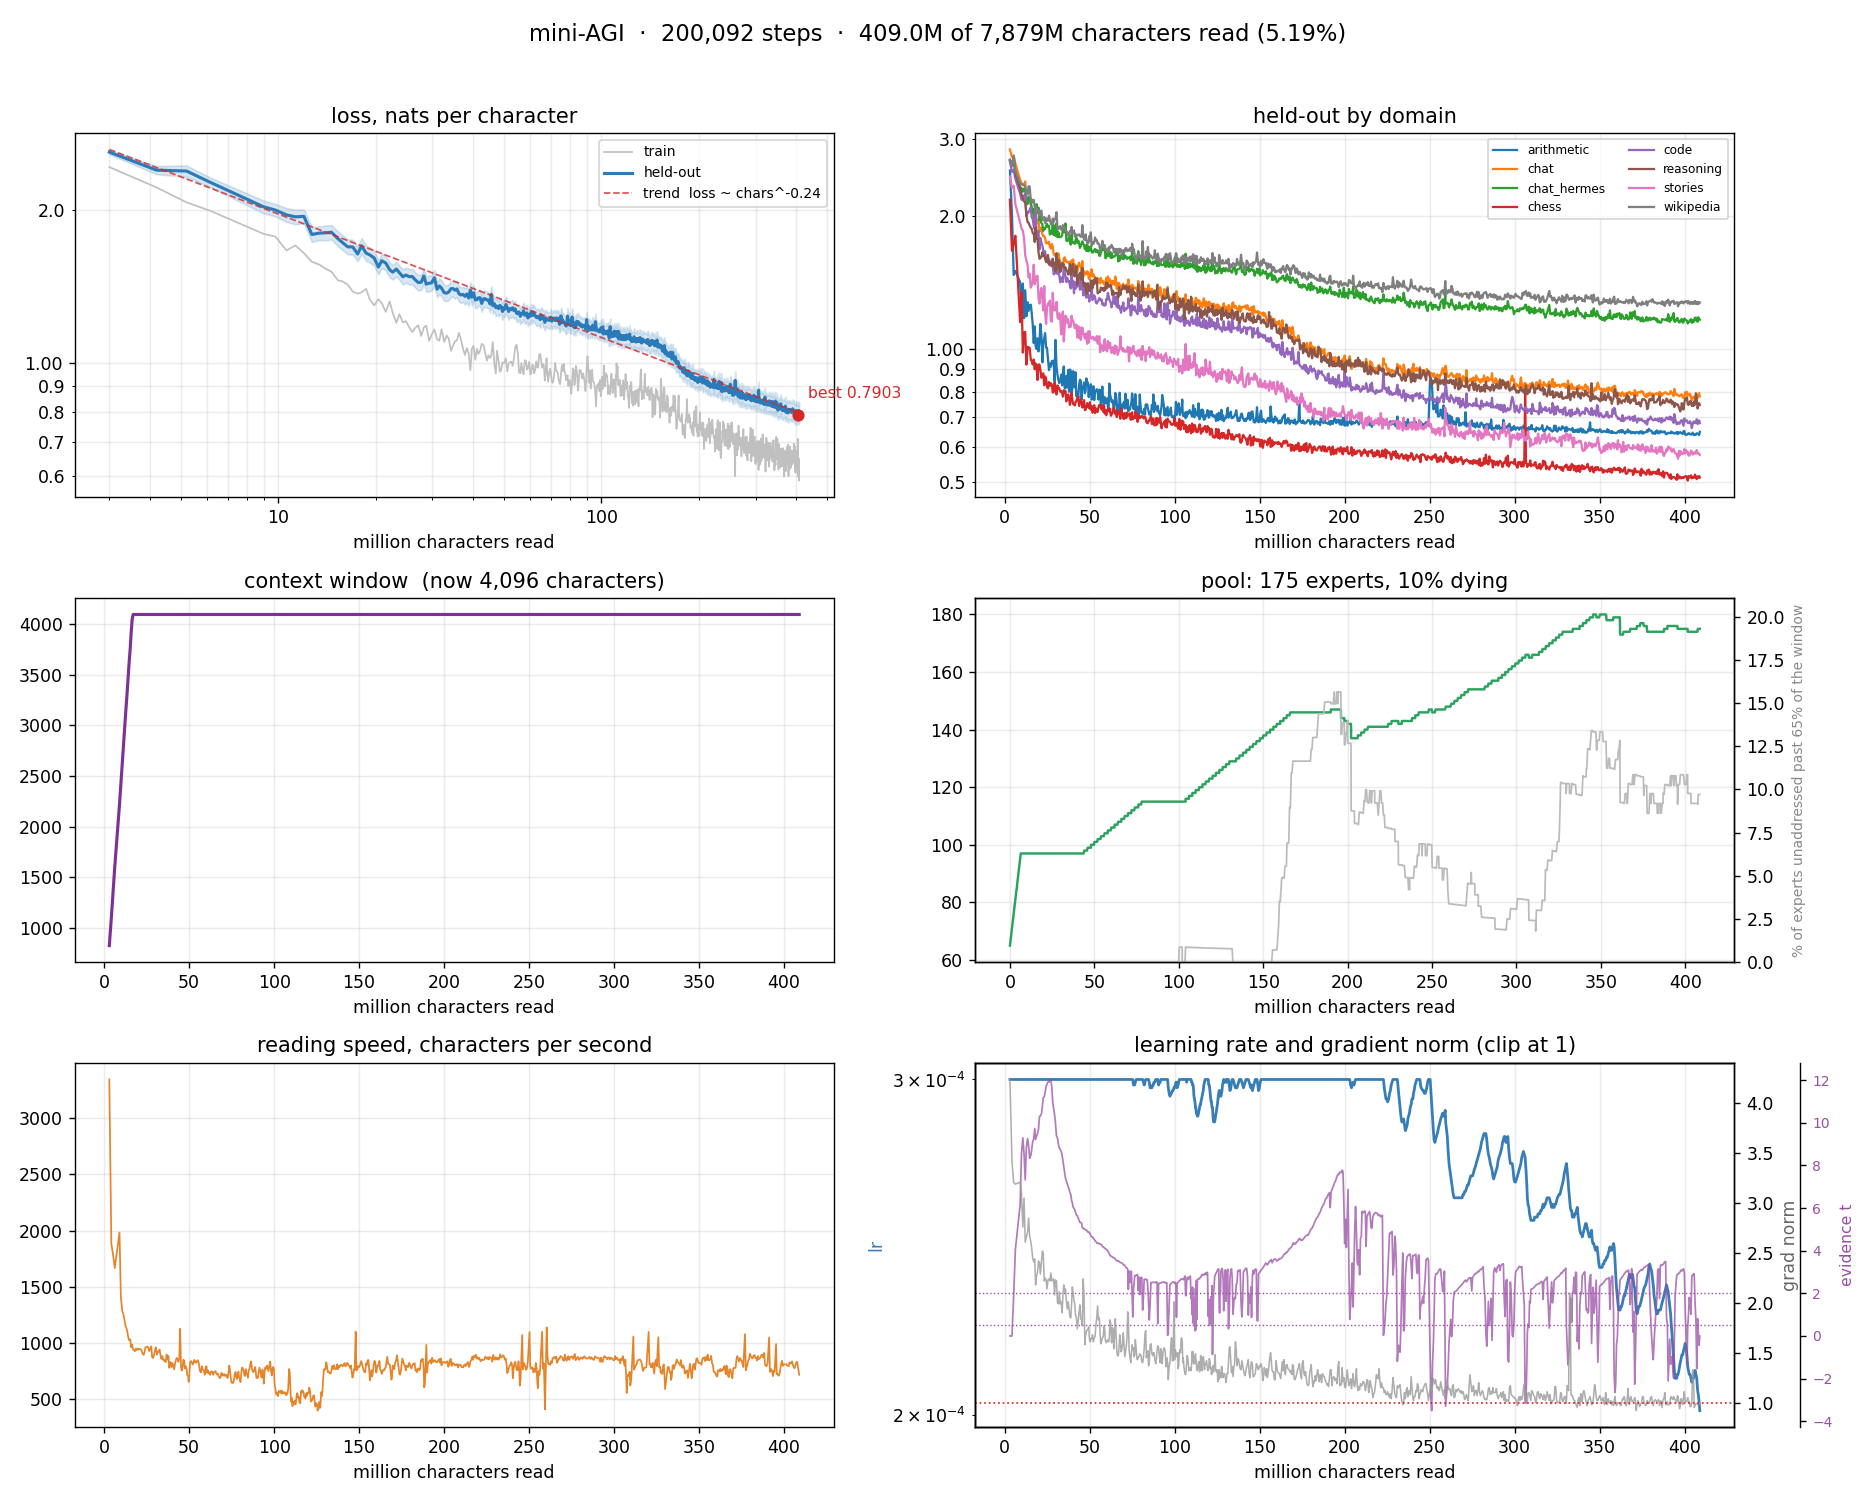 그림 5. 학습 시작부터 4억 900만 글자까지의 전체 기록. 출처: mini-AGI 리포지토리
README는 벤치마크 수치가 추적용이며 학습이 진행되면서 바뀐다고 밝혔다. 표의 값은 4억 900만 글자를 읽고 전문가가 175개인 시점에 측정됐다.
| 구분 | nats/글자 | bits/바이트 |
|---|---|---|
| 검증, 8과목 전체 | 0.7980 ± 0.0348 | 1.1512 |
| 학습 | 0.6137 | 0.8854 |
| 과목 | nats/글자 | bits/바이트 |
|---|---|---|
| 체스 | 0.511 | 0.737 |
| 이야기 | 0.575 | 0.830 |
| 산술 | 0.649 | 0.936 |
| 코드 | 0.679 | 0.980 |
| 추론 | 0.747 | 1.078 |
| 대화 | 0.781 | 1.127 |
| 대화(OpenHermes) | 1.166 | 1.682 |
| 위키백과 | 1.275 | 1.839 |
README에 따르면 검증 손실의 표준 오차는 평가 데이터의 크기로 정해지며, 표준 오차보다 작은 차이는 측정 도구의 오차 범위에 해당한다. 이와 별개의 분산도 있다. CUDA에서 전문가 디스패치가 결정적이지 않아서, 같은 설정을 두 번 실행하면 결과가 0.014가량 차이 난다. 저자는 0.03 정도를 의미 있는 차이의 기준으로 삼으라고 권했다.
샘플 품질
검증 손실이 가장 낮았던 회차는 4억 430만 글자 시점의 0.7903 nats였고, README는 이 회차의 샘플을 공개했다. 각 프롬프트에는 반복 억제 장치를 쓰지 않은 그리디 디코딩 결과(raw)와 장치를 적용한 결과(adapted)를 함께 실었다. 장치 없는 그리디 디코딩에서는 8-그램의 24%가 반복됐다.
| 과목 | 관찰 |
|---|---|
| 산술 | add 4917 + 388 = 에 대해 <think> 구간에서 자릿수별 올림을 계산한 뒤 5305로 정답을 냈다. 그 뒤 raw는 sub 7 - 4 = 3을 되풀이했다 |
| 체스 | 1. e4 e5 2. 이후 raw는 합법 수 17개, adapted는 23개를 이어 둔 뒤 규칙에 어긋나는 수를 뒀다 |
| 이야기 | raw는 문법에 맞는 문장을 이어 썼고, adapted는 “Tom’s friends wanted to play"를 반복했다 |
| 코드 | merge_sorted 함수의 독스트링에서 “sorted"를 반복했다 |
| 위키백과 | raw와 adapted 모두 [[Roman Empire]]를 되풀이했다 |
| 자기 소개 | 전문가 선택 방식을 묻는 질문에 “I am mini-AGI. I read and write one character at a time.“으로 시작하는 답을 냈다 |
PG19 데이터 스케일링
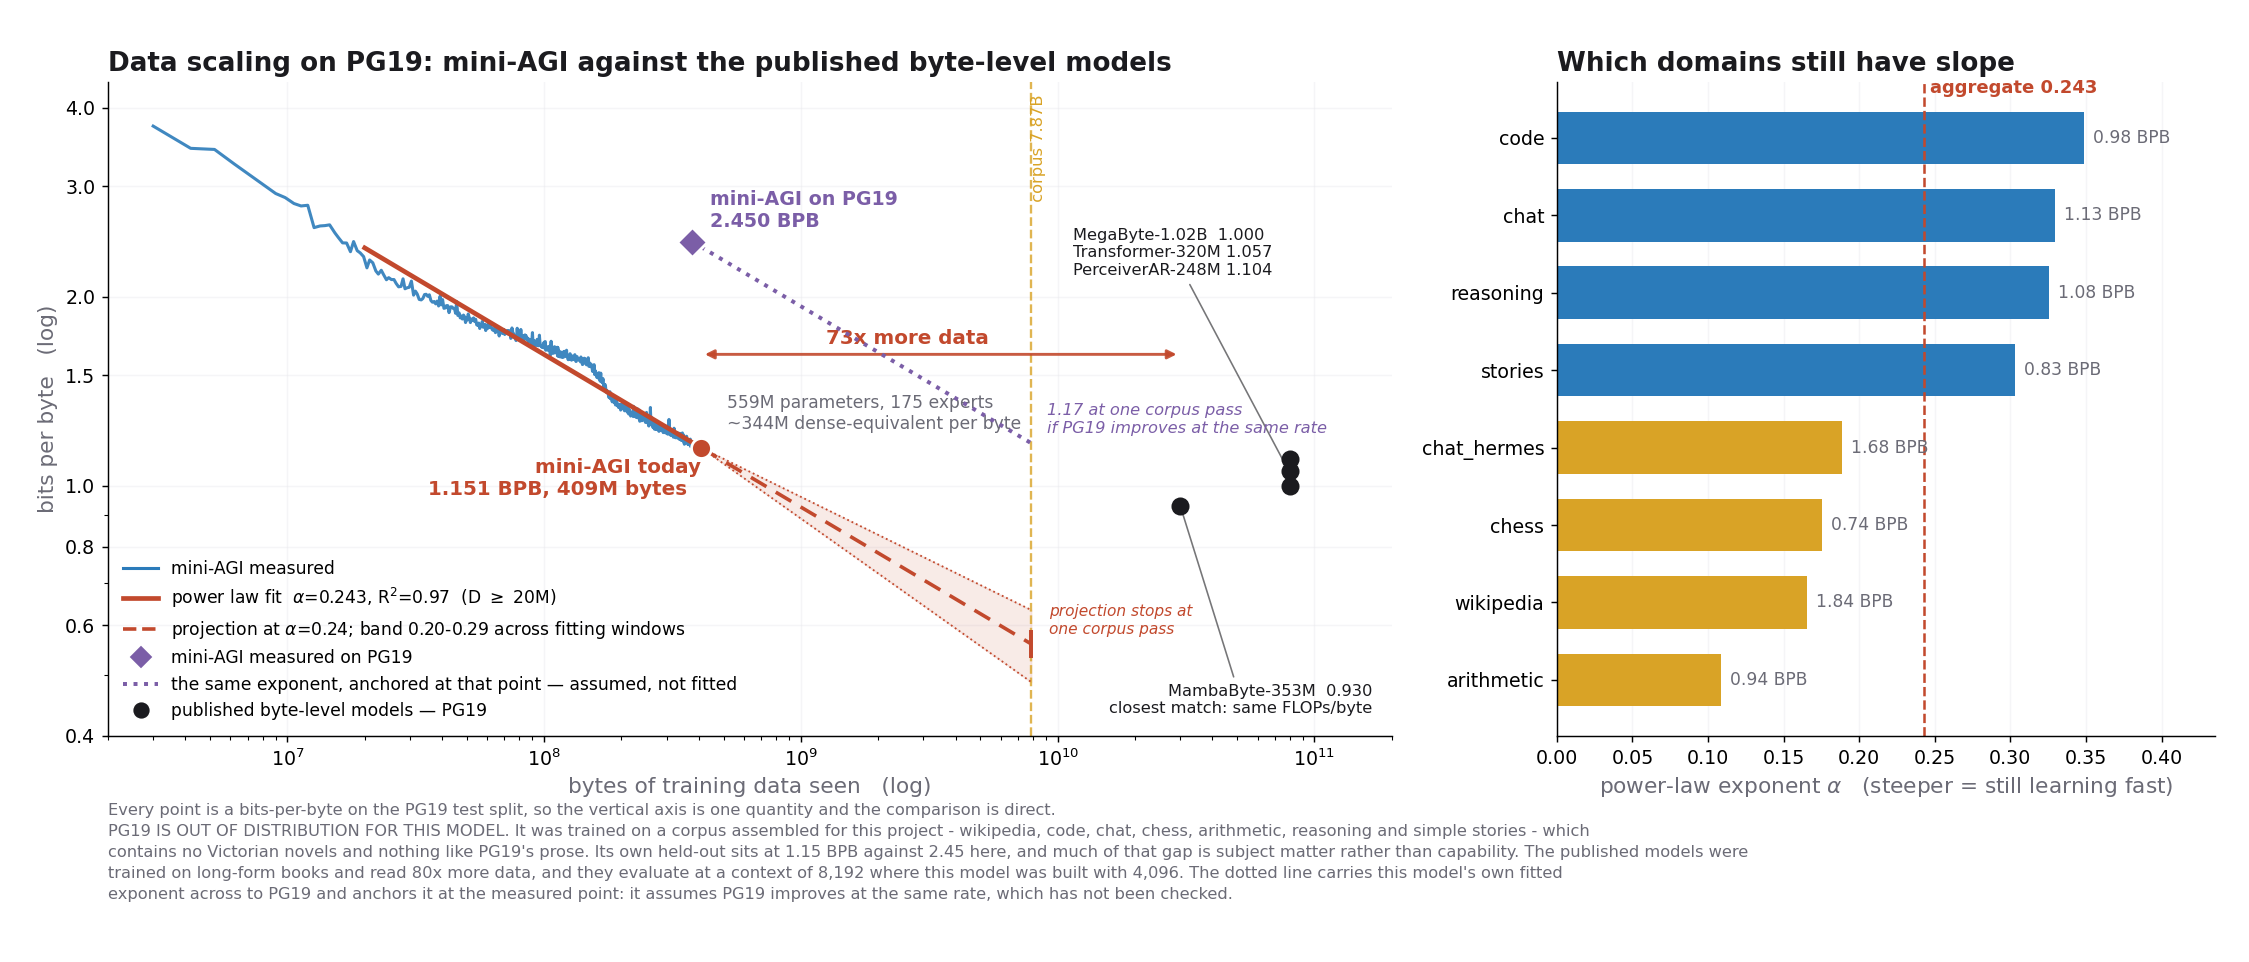 그림 6. PG19 테스트 세트 기준 데이터 스케일링과 과목별 거듭제곱 지수. 출처: mini-AGI 리포지토리
mini-AGI는 PG19 테스트 세트 전체(도서 100권, 41,289,001바이트)에서 컨텍스트 4,096 기준 2.450 BPB를 기록했다. 자체 혼합 데이터에서는 검증 값 1.16을 기록했다. 이 모델은 PG19와 같은 분포의 데이터로 학습한 적이 없다. 모델은 이 프로젝트를 위해 구성한 코퍼스로 학습했고 빅토리아 시대 소설은 읽은 적이 없다. 저자는 이 때문에 격차의 상당 부분이 능력보다 소재 차이에서 온다고 설명했다.
그래프에는 공개된 바이트 단위 모델들의 PG19 점수도 표시되어 있다. 바이트당 연산량이 같아 가장 직접적인 비교 대상이 되는 MambaByte-353M은 0.930을 기록했다. 나머지 세 모델의 점수는 MegaByte-1.02B가 1.000, Transformer-320M이 1.057, PerceiverAR-248M이 1.104였다. 그래프 설명문에 따르면 이 모델들은 장편 도서로 학습했고 mini-AGI보다 80배 많은 데이터를 읽었으며, 컨텍스트 8,192로 평가했다.
README는 자체 검증 손실에 적합한 거듭제곱 법칙을 근거로 결과를 유망하다고 평가했다. 워밍업 이후의 모든 측정값으로 적합하면 L ∝ D^-0.243이라는 식이 나온다. 손실 L이 데이터 양 D의 -0.243제곱에 비례한다는 뜻이며, 결정계수 R²는 0.97이었다. 지수 0.243은 Kaplan의 0.095와 Chinchilla의 0.28 사이에 해당하고, 이 추세는 데이터 규모가 10배 이상 증가하는 구간에서 유지됐다. 적합을 시작하는 지점에 따라 지수가 달라지므로, 그래프의 음영 띠는 숫자 하나 대신 0.20에서 0.29까지의 범위를 표시한다.
이 식으로 계산한 자체 혼합 데이터 기준 값은 다음과 같다.2
| 검증 BPB | 필요한 누적 바이트 | 남은 일수(초당 약 713글자) |
|---|---|---|
| 1.10 | 4억 9천만 | 약 1일 |
| 1.00 | 7억 3천만 | 약 5일 |
| 0.93 | 9억 8천만 | 약 9일 |
| 0.80 | 18억 3천만 | 약 23일 |
저자는 이 값들이 노트북 GPU 한 장으로 며칠에서 몇 주 동안 학습해 얻을 수 있는 수준이라고 설명했다. 네 값 모두 78억 8천만 글자 코퍼스의 첫 패스가 끝나기 전에 도달할 것으로 예측된다.
오른쪽 패널은 과목별로 손실이 아직 빠르게 줄고 있는지를 나타낸다. 코드, 대화, 추론, 이야기의 거듭제곱 지수가 크고, 산술과 위키백과의 지수가 가장 작다. README는 이 결과를 낙관적 전망을 상쇄하는 근거로 함께 적었다. 손실이 높아 비용이 큰 영역과 빠르게 개선되는 영역이 일치하지 않는다는 뜻이다.
실행 방법과 초기화
실행하려면 VRAM이 8GB 이상인 CUDA GPU와 Python 3.10 이상이 필요하고, 저자의 기준 환경에서는 torch 2.6.0+cu124와 numpy 1.24.4를 사용했다. 학습에는 pip install torch numpy pyyaml matplotlib 한 줄이면 되고, 웹 UI(serve.py)를 쓰려면 flask가, 코퍼스를 구성하려면 chess, zstandard, datasets가 추가로 필요하다.
python3 -m corpora all                  # 8과목 전체, 수 GB
python3 -m corpora all --limit 5000     # 작은 일부로 먼저 시험
python3 train.py read data/train --save --weights-dir weights \
    --held-out data/val --sample-every 10
python3 serve.py --port 8080            # http://127.0.0.1:8080
코퍼스 명령 하나가 공개 데이터셋 네 개를 내려받고 나머지 네 과목의 데이터를 만든다. README의 감사의 글은 코퍼스 출처로 TinyStories, OpenHermes-2.5, OpenThoughts-114k, Lichess 공개 데이터베이스를 들었고, 위키백과와 소스 코드는 공개 덤프와 공개 리포지토리에서 가져왔다고 밝혔다. 학습은 몇 분마다 체크포인트를 저장하고 그래프를 다시 그린다. README는 며칠 동안 손대지 않고 실행해 두는 용도라고 설명했다.
새 모델은 작은 규모로 시작해 학습하면서 규모가 늘어난다. 컨텍스트 창은 model.context_start(기본 2,048)에서 시작하며, 현재 길이에서 추가 이득이 확인될 때만 한 글자씩 늘린다. 전문가 풀은 pool.experts(기본 64)에서 시작한다. 이런 이유로 학습 초반 몇 시간은 이후와 전혀 다르게 진행된다. 손실은 빠르게 떨어지고 풀 구성은 자주 바뀐다. 컨텍스트 창도 아직 짧다. 학습률 제어기도 판단에 필요한 만큼의 평가를 아직 모으지 못했다. README는 이 현상들을 고칠 대상으로 여기지 않았다.
학습이 발산하면 자동 복구를 실행한다. 검증 손실이 최고 기록의 --revert-factor배(기본 1.5배)를 초과하면 weights/를 다시 불러오고, 학습률을 절반으로 줄이고, 컨텍스트 길이를 줄인 뒤 학습을 이어 간다. 복구 횟수가 --max-reverts에 이르면 학습을 중단한다.
AI 활용과 참고 연구
README는 개발에 Claude Opus 5를 활용했다고 밝혔다. 저자에 따르면 모델이 코드 대부분을 구현했고, 필요할 때 검증과 디버깅도 맡았다. 관련 논문을 찾고, 테스트와 실험을 만들고, 복잡한 문제를 함께 고민한 것도 모델이었다. README의 애니메이션과 그래프 역시 실제 데이터 기록을 바탕으로 Claude가 만들었다. 저자 자신은 핵심 아이디어와 작업 지휘, 직관, 코드 감시와 검증, 전체 구성과 작동 원리에 관한 판단과 강한 의견을 맡았다고 적었다. 작업이 잘못 진행될 때 반려하는 일도 저자의 몫이었고, 문서는 둘이 함께 썼다.
감사의 글에는 설계에 활용한 연구가 용도와 함께 정리되어 있다. 주요 항목은 다음과 같다.
| 연구 | README가 밝힌 용도 |
|---|---|
| Shazeer 외, Sparsely-Gated Mixture-of-Experts (2017) | 전문가 풀 전체와 부하 분산 보조 손실 |
| Fedus 외, Switch Transformers (2021) | 용량 기반 배치 디스패치. 풀을 행렬곱 세 번으로 실행할 수 있게 한다 |
| Banino 외, PonderNet (2021) | 적응형 깊이 |
| Su 외, RoFormer (2021) | 추가 학습으로 컨텍스트 창을 늘릴 수 있는 이유 |
| Chen 외, Sublinear Memory Cost (2016) | 그래디언트 체크포인팅. README는 8GB에서는 선택 사항이 못 된다고 했다 |
| ZeRO-Offload (2021), ZeRO-Infinity (2021) | 카드보다 큰 모델을 학습시키는 것 자체는 새로운 능력이 못 된다는 선행 사례 |
| Kim 외, Dynamic Mixture of Experts Against Severe Distribution Shifts (2025) | 동작 중인 MoE에 전문가를 추가하는 연구. 이 프로젝트가 일주일 동안 고친 실패를 보고했다 |
| Pagliardini 외, AdEMAMix (2024) | 트렁크용으로 구현했으나 논문의 설정에서는 이 모델의 성능을 떨어뜨려 기본값에서 제외했다 |
가장 의외였던 결과
리포지토리의 구조만 보면 망각을 방지하는 장치는 전문가 풀일 것이라고 예상하게 된다. 전문가마다 파일이 따로 있고, 읽는 텍스트에 따라 필요한 전문가만 GPU에 적재되며, 선택되지 않은 전문가는 그래디언트를 받지 않기 때문이다. 저자도 처음에는 그렇게 설명했다. 그런데 저자가 직접 수행한 소거 실험에서 전문가 교체가 기여한 몫은 13.8%였다. 나머지 대부분은 모든 글자의 연산에 쓰이는 트렁크의 학습률을 10분의 1로 낮춘 설정 하나로 설명된다. README가 이 결과로 프로젝트의 이전 설명을 정정한다고 적은 대목이 인상 깊었다.
같은 실험에서 체스의 손실은 0.013 nats 개선되는 데 그쳤다. 트렁크를 느리게 학습시키면 다른 과목을 잊지 않게 되지만, 새로 읽는 과목의 개선 폭도 함께 작아질 수 있다. README에는 트렁크 학습률 0.1배가 새 과목의 학습 속도를 얼마나 늦추는지에 대한 비교가 실려 있지 않다. 자기 파일을 읽히려는 사용자에게는 망각 수치만큼 이 비교가 필요할 것이다.
가지치기 기준도 곱씹어 볼 만했다. 게이트 크기로 전문가의 쓸모를 판정했다면 가장 바쁜 전문가부터 삭제됐을 것이다. 저자는 게이트 대신 마지막으로 요청된 뒤 지난 시간을 기준으로 삼았고, 이 선택을 리포지토리에서 가장 쓸모 있는 발견으로 꼽았다.
출처
Alexey Borsky(GitHub volotat), 2026년 9월 19일 공개, MIT 라이선스 원문: https://github.com/volotat/mini-AGI
본문 수치는 2026년 9월 22일 커밋 201852d 기준 README와 config.yaml에서 인용했다. README의 수치 블록은 학습이 진행되면서 자동으로 갱신된다. 커버와 본문 그림은 모두 리포지토리의 assets/ 폴더에서 가져왔다.