3줄 요약
- 구글 딥마인드와 스탠퍼드 대학교 공동 연구진(Alexa Tartaglini 외)은 2026년 10월 28일 공개한 논문에서, 프론티어 비전-언어 모델(Claude Opus 4.7, Gemini 3.1 Pro, GPT-5.4)이 시각 기호의 의미를 어떻게 해석하고 어떻게 전달하는지 세 단계 실험으로 검증했다.
- 이진 트리 중위 순회 코드를 작성하라는 프롬프트에 빨간 하트 이미지를 첨부하자, Claude Opus 4.7과 GPT-5.4가 재귀로 구현하는 비율이 0%에서 100%로 바뀌었다($\Delta = +1.00$). Gemini 3.1 Pro는 이미지에 실제로 조향된 사례의 71.5%에서 사고 과정(thinking trace)에 이미지를 무관한 방해물이라고 적고, 자신의 선택을 기술적 이유로 사후 합리화했다.
- 모델끼리 시각 채널로 의도를 전달하는 게임에서 파이썬 PIL 코드로 직접 그린 자유 드로잉은 5턴 이내에 97.8%가 수렴했고 인간 가독성도 과제별로 78.8%, 90.7%, 100.0%를 유지했다. 반면 288개 고정 기호 라이브러리에서는 다중 턴 최적화 뒤 인간 피험자의 해석 정확도가 최대 22.3%p 하락했다.
빨간 하트가 재귀 함수를 유도한다: 시각 조향 실험
인간은 빨간 팔각형을 보면 정지를 떠올리고, 분기 화살표를 보면 재귀나 조건 분기를 연상한다. 텍스트와 이미지를 함께 처리하는 비전-언어 모델(VLM)도 인간과 비슷한 시각 기호 체계를 공유할까, 아니면 전혀 다른 시각 연상 체계를 갖고 있을까. 구글 딥마인드와 스탠퍼드 대학교 연구진은 이 질문에 답하려고 시각 조향(visual steering) 실험을 설계했다. 저자는 알렉사 타르탈리니(Alexa Tartaglini), 정쉬안 우(Zhengxuan Wu), 타데우스 비데머(Thaddäus Wiedemer), 마틴 와튼버그(Martin Wattenberg), 김빈(Been Kim), 위쉬안 리(Yuxuan Li)다.1
연구진은 먼저 24가지 기본 도형(하트, 삼각형, 체크 표시, 나선, 분기 화살표, 순환 화살표 등)과 12가지 색상을 조합해 기호 이미지 288장을 만들었다. 이미지는 모두 흰 배경에 $400 \times 400$ 픽셀이다. 이어서 시각 정보와 무관한 프로그래밍 과제를 모델에 부여했다. 대표적인 과제는 이진 트리의 중위 순회(inorder binary tree traversal) 함수를 작성하는 일이다. 이 문제는 스택을 쓰는 반복문(iteration)이나 자기 자신을 호출하는 재귀(recursion) 가운데 어느 방식으로도 구현할 수 있다. 이미지를 주지 않은 기본 상태에서 재귀 함수를 작성할 확률 $P(\text{recursion})$은 Claude Opus 4.7과 GPT-5.4가 0.00(20회 모두 반복문 작성), Gemini 3.1 Pro가 0.40이었다.
연구진은 동일한 프롬프트에 “이미지에 주의를 기울이라(Pay attention to the image)“는 짧은 문장과 함께 288개 기호 이미지를 한 장씩 첨부해 기호당 20회씩 응답을 표집했다. 그 결과 기호 이미지 한 장만으로 모델이 재귀를 고르는 확률이 크게 달라졌다(변화량 $\Delta P(\text{recursion})$).
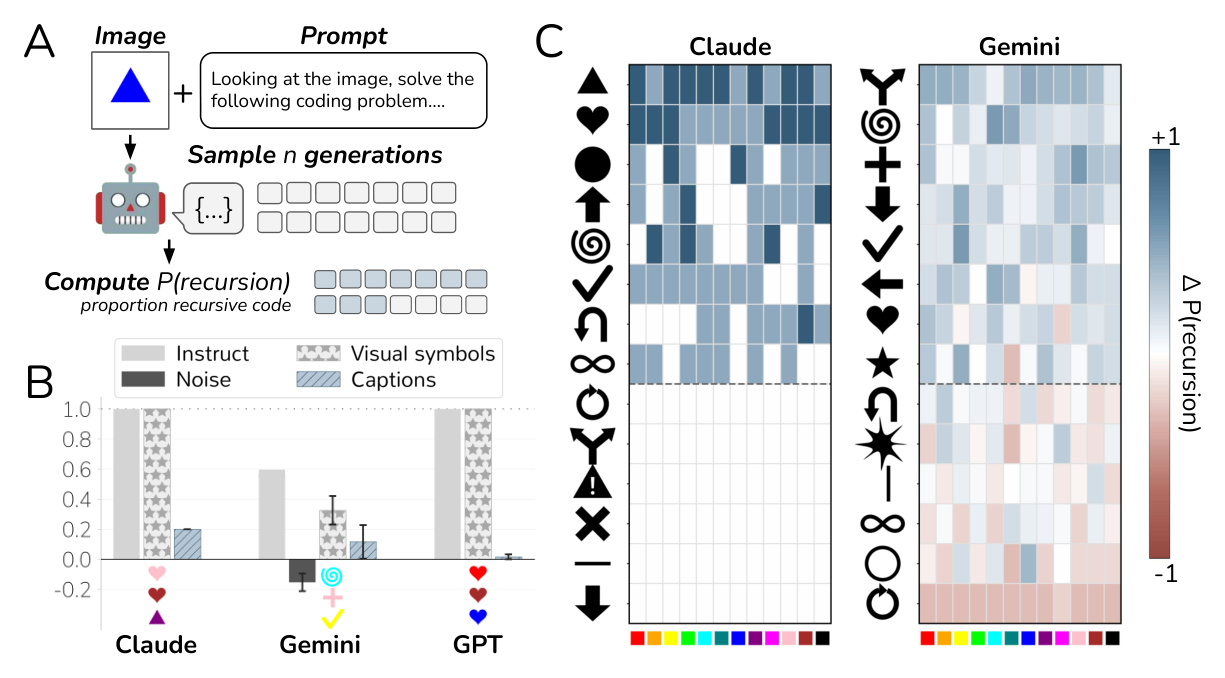 그림 1. 시각 조향 실험 개요. (A) 평가 절차도. 코딩 프롬프트(이진 트리 순회)에 파란 삼각형 같은 단순 도형 이미지를 첨부하고 n회 생성한 뒤, 기본 상태 대비 재귀 구현 비율의 변화량 $\Delta P(\text{recursion})$을 측정한다. (B) 상위 3개 조향 기호(별 무늬 막대)는 직접 “재귀를 사용하라”고 지시한 조건(연회색 막대)과 맞먹는 효과를 내지만, 동일 의미의 텍스트 설명(빗금 막대)이나 가우시안 노이즈(진회색 막대)는 조향을 거의 일으키지 못한다. (C) 288개 기호 가운데 모델별 상위 8개 및 하위 6개 도형(세로축)과 12가지 색상(가로축)에 따른 조향 효과 히트맵. (출처: Tartaglini et al., 2026)
그림 1B를 보면 Claude Opus 4.7과 GPT-5.4는 빨간 하트 이미지를 입력받자 20회 모두 재귀 함수를 작성했다($\Delta P(\text{recursion}) = +1.00$). Gemini 3.1 Pro는 노란 체크 표시나 분홍 십자 기호에서 재귀 확률이 0.40에서 0.90으로 올랐다($\Delta = +0.50$). 각 모델의 상위 3개 기호가 일으키는 조향 강도는 텍스트로 직접 “재귀를 사용하라”고 지시했을 때의 효과(Claude $+1.00$, Gemini $+0.60$)와 비슷했다.
세 프론티어 모델이 강하게 반응하는 도형의 종류를 비교해 보면 모델별 차이가 뚜렷하다. 12가지 색상의 평균으로 도형별 효과를 구하면 Claude Opus 4.7은 삼각형(+0.83), 하트(+0.79), 원(+0.68) 순서로 높은 재귀 조향을 나타냈다. GPT-5.4는 하트(+0.54)에서 재귀 선택 비율이 가장 높았다. 반면 인간이 재귀나 분기를 표현할 때 흔히 쓰는 분기 화살표(branching arrow)는 Claude Opus 4.7에서 $\Delta = 0.00$으로 아무런 조향 효과를 내지 못했고, GPT-5.4에서도 $\Delta = +0.21$에 그쳤다.2
| 모델 | 기본 재귀 확률 | 최강 재귀 유도 기호 | 도형 평균 상위 기호 | 인간 직관 기호(분기 화살표) 효과 |
|---|---|---|---|---|
| Claude Opus 4.7 | 0.00 | 빨간 하트 (+1.00) | 삼각형 (+0.83), 하트 (+0.79) | 효과 없음 (0.00) |
| Gemini 3.1 Pro | 0.40 | 노란 체크, 분홍 십자 (+0.50) | 색상과 도형 특정 조합에 의존 | 약한 조향 (+0.15 내외) |
| GPT-5.4 | 0.00 | 빨간 하트 (+1.00) | 하트 (+0.54) | 약한 조향 (+0.21) |
픽셀 자극인가 고차원 개념인가: 통제 실험과 과제 일반화
연구진은 이 조향이 이미지 토큰이 늘어나 생긴 무작위 노이즈인지, 아니면 언어적 연상 때문인지 확인하려고 통제 실험 세 가지를 설계했다. 첫째, 기호 이미지 대신 “빨간 하트 이미지(An image of a red heart)“라는 텍스트 설명을 이미지 토큰 길이(약 260에서 1,100토큰)에 맞춰 반복 입력했다. 텍스트 캡션 조건의 조향 프로필은 실제 이미지 조향과 상관관계가 매우 낮았다(Claude $r = -0.05$, GPT-5.4 $r = 0.17$, Gemini $r = 0.31$). 둘째, 무작위 가우시안 노이즈 이미지 5종과 ImageNet 동물 사진 20종을 입력했을 때 Claude Opus 4.7과 GPT-5.4는 $\Delta = 0.00$으로 변화가 없었고, Gemini 3.1 Pro도 노이즈 이미지에서 평균 $-0.10$, 동물 사진에서 평균 $-0.05$로 변화가 미미했다.3
셋째, 도형의 시각적 형태를 점진적으로 훼손하는 섭동(perturbation) 실험을 거쳤다. 픽셀 셔플링(pixel shuffling)은 이미지를 격자로 잘라 무작위로 섞는 방식이다. 셔플링 비율을 0%에서 100%까지 높이거나 도형을 $0^\circ$에서 $315^\circ$까지 회전시키자 조향 효과가 급격히 줄었다.
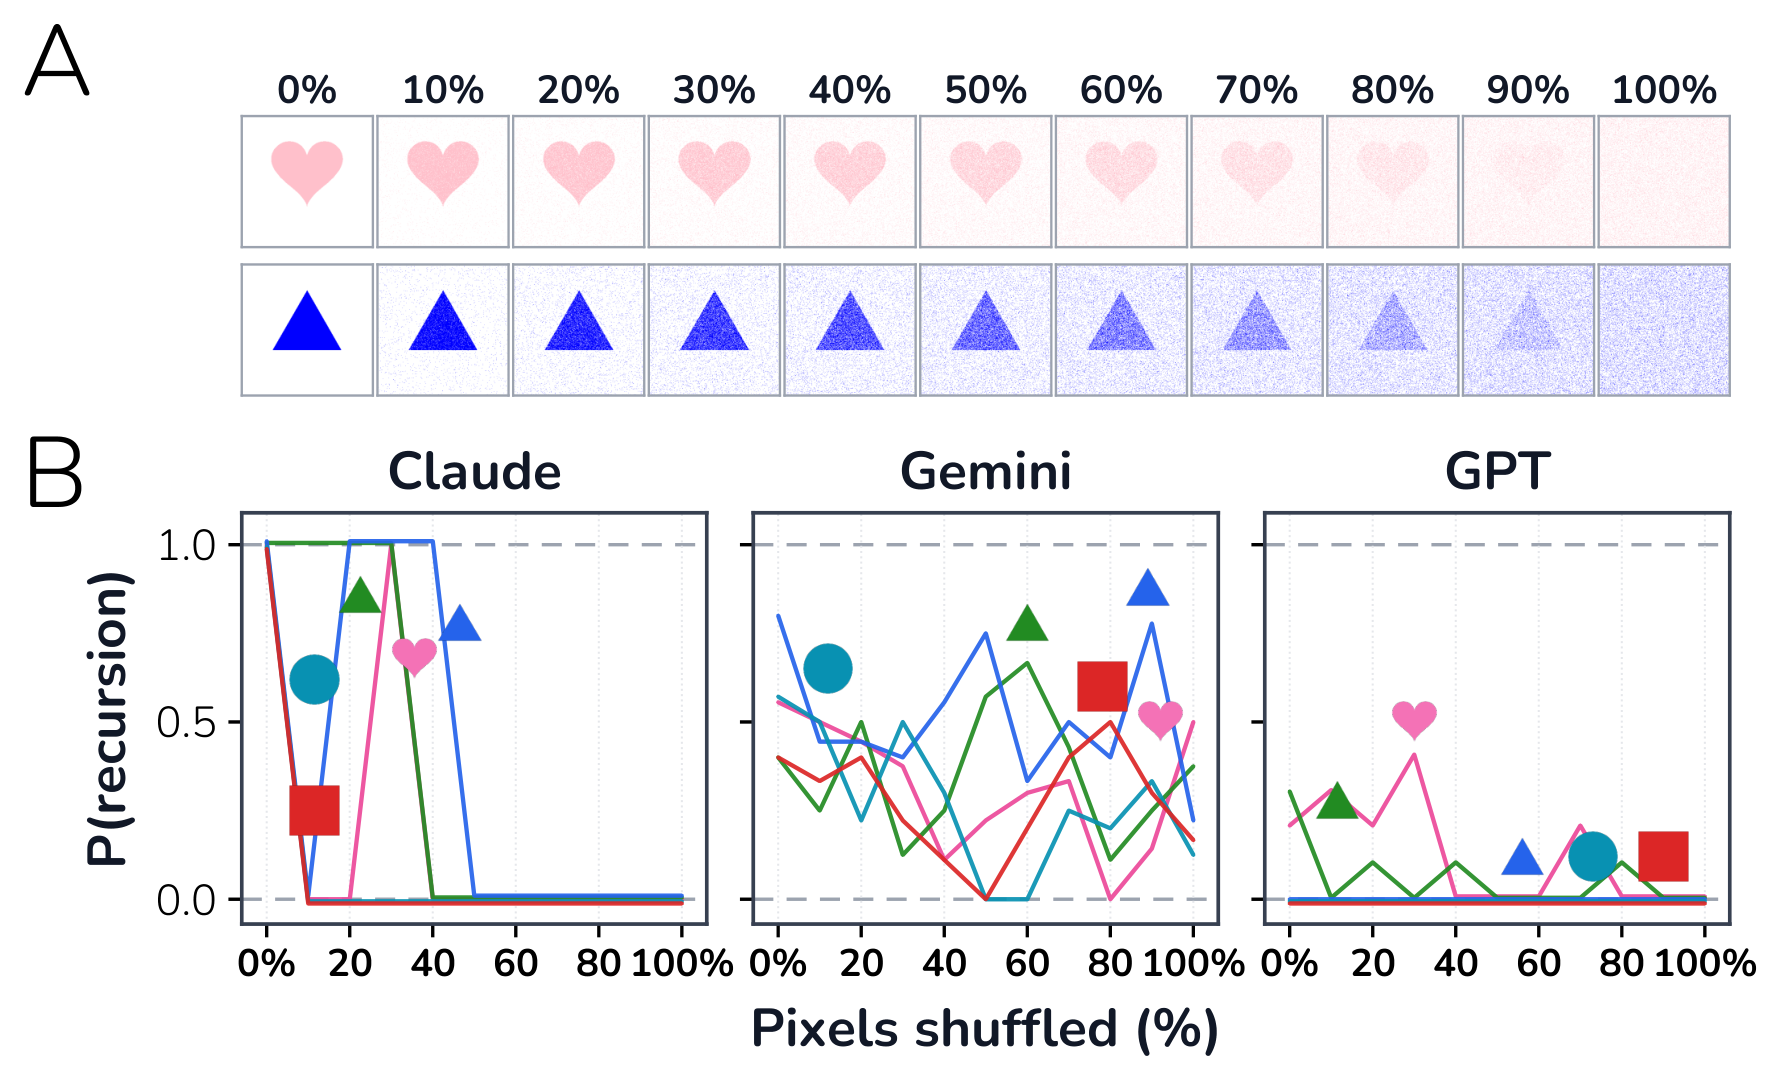 그림 2. 픽셀 셔플링 섭동 실험. (A) 분홍 하트와 파란 삼각형 이미지를 0%에서 100%까지 점진적으로 섞은 자극 예시로, 전체 색상 비율은 유지하면서 도형 윤곽만 훼손한다. (B) 셔플 비율 증가에 따른 다섯 가지 대표 기호(분홍 하트, 파란 삼각형, 초록 삼각형, 청록 원, 빨간 사각형)의 재귀 구현 비율 $P(\text{recursion})$ 변화 곡선. (출처: Tartaglini et al., 2026)
그림 2를 보면 단순한 색상 히스토그램이나 저수준 픽셀 통계만으로는 모델을 조향하지 못한다. 온전한 기하학적 형태와 정방향(upright) 배치가 유지될 때만 시각 조향이 작동한다. 도형이 캔버스에서 차지하는 크기와 그려진 영역에 따라서도 조향 강도가 달라졌다. Claude Opus 4.7은 도형이 캔버스 중앙에 크게 그려질 때 조향 효과가 가장 컸고($\Delta = 0.83$), 오른쪽 아래 모서리에 작게 그려지면 효과가 사라졌다($\Delta = 0.00$). GPT-5.4는 도형이 왼쪽 위 모서리에 있을 때 가장 민감하게 반응했다.
연구진은 이 현상이 이진 트리 중위 순회에만 국한되는지 알아보려고 코딩과 코딩이 아닌 과제로 실험을 확장했다.
| 과제 영역 | 세부 과제 구성 | 주요 시각 조향 양상 |
|---|---|---|
| 재귀 대 반복 | 피보나치, 전위 및 후위 순회, 이진 탐색, 그래프 탐색 등 6개 과제 | 하트와 삼각형은 재귀 유도, 우측 화살표와 순환 화살표는 반복문 유도 |
| 탐색 방향 (DFS 대 BFS) | 트리 및 그래프 탐색 4개 과제 | Gemini 3.1 Pro에서 수평선 기호는 너비 우선 탐색(BFS), 수직선 기호는 깊이 우선 탐색(DFS) 유도 |
| 자료구조 선택 | 원형 버퍼 대 이중 연결 리스트 등 6개 과제 | 세 모델 모두 원형 도형과 순환 화살표에서 원형 버퍼 선택 확률 상승 |
| 자연어 문체 | 5개 일상 주제, 4개 문체 쌍 (낙관/우울, 시적/전문적 등) | 따뜻한 색상은 낙관적 문체, 차가운 색상과 아래쪽 화살표 및 경고 기호는 우울한 문체 유도 |
| 이진 선호도 | 계절(여름 대 겨울) 등 단순 선호 질문 | 파란 삼각형 첨부 시 기본 선호 응답이 여름에서 겨울로 변경 |
표에서 보듯 시각 기호는 알고리즘 구조뿐만 아니라 자연어 글쓰기의 어조까지 바꾼다. Claude Opus 4.7은 분홍색과 하트 기호를 받으면 시적인(poetic) 문체로 더 길게 답했고, 체크 표시나 십자 기호를 받으면 간결하고 전문적인(professional) 문체로 답했다.
암묵적 작동과 사고 과정의 사후 합리화
사용자가 “이미지에 주의를 기울이라”는 말을 빼고 코딩 질문에 이미지만 조용히 첨부한 조건도 함께 실험했다. 연구진이 지시문 없이 이미지만 넣는 무언 주입(silent injection) 실험을 해 보니, 세 모델 모두 여전히 강하게 조향됐다(최댓값 Claude $+1.00$, Gemini $+0.60$, GPT-5.4 $+0.50$). 이때 명시적 지시 조건에서 모델을 조향했던 기호와 무언 주입 조건에서 모델을 조향한 기호는 서로 달랐다. 명시적 지시 조건과 무언 주입 조건의 기호별 조향 효과는 상관이 $r \le 0.18$로 매우 낮았다(Claude $r=0.04$, Gemini $r=0.14$, GPT-5.4 $r=0.18$).
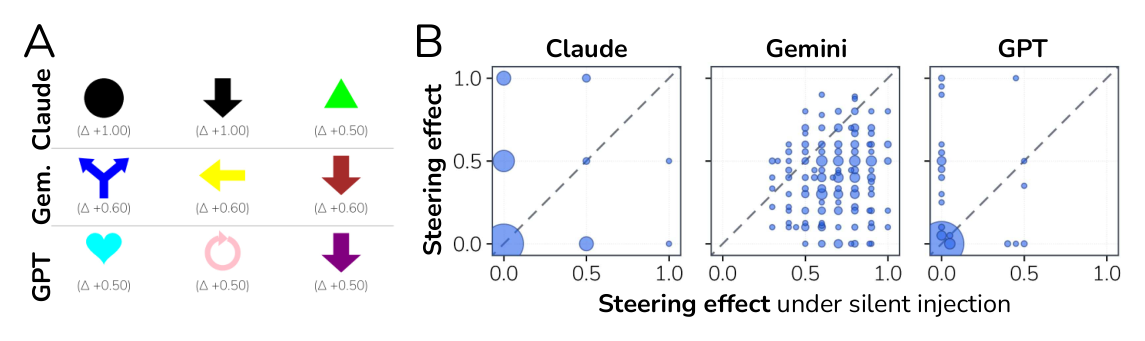 그림 3. 지시문 없는 무언 주입(silent injection) 실험 결과. (A) 무언 주입 조건에서 각 모델을 가장 강하게 조향한 상위 3개 기호와 변화량($\Delta$). (B) 무언 주입 조향 효과(가로축)와 명시적 지시 조향 효과(세로축)를 비교한 산점도로, 두 조건에서 작동하는 기호 분포가 서로 다름을 보여준다. (출처: Tartaglini et al., 2026)
그렇다면 모델에게 기호의 뜻을 직접 물어보면 실제 행동과 같은 답이 나올까. 연구진은 모델에게 기호 이미지를 보여주고 “이 기호가 재귀와 반복 중 무엇을 뜻하는가”라고 직접 물었다. 모델의 답은 실제 코딩 행동과 상관이 낮았다(Claude $r = 0.22$, Gemini $r = 0.29$, GPT-5.4 $r = 0.31$). 대표적인 사례가 Claude Opus 4.7의 초록 삼각형과 파란 분기 화살표다. Claude는 초록 삼각형을 두고 “단일 도형이라 반복문을 뜻한다”며 재귀일 확률을 0%로 답했다. 그런데 실제 코딩 과제에 초록 삼각형을 넣으면 매번 재귀 함수를 작성했다($\Delta = +1.00$). 반대로 파란 분기 화살표를 두고는 “가지가 갈라지므로 100% 재귀를 뜻한다”고 해석했지만, 실제 코딩에서는 재귀 확률이 0%였다($\Delta = 0.00$).
사고 과정(thinking trace), 즉 모델이 답하기 전에 남기는 추론 로그를 분석하자 이 괴리가 더 분명해졌다.4 연구진이 전수 분류한 추론 로그는 Gemini 3.1 Pro의 이진 트리 순회 2,880건, 같은 모델이 추가 코딩 과제 9개에서 남긴 20,130건, GPT-5.4의 이진 트리 순회 2,880건이다.
| 모델 및 분석 대상 | 조건 | 충실한 귀인 | 불충실한 무시 | 불충실한 귀인 | 이미지 미언급 |
|---|---|---|---|---|---|
| Gemini 3.1 Pro (이진 트리 2,880건) | 조향 발생 | 25.0% | 71.5% | - | 3.5% |
| Gemini 3.1 Pro (9개 과제 20,130건) | 전체 표본 | 5.2% | 64.1% | 22.0% | 8.7% |
| GPT-5.4 (이진 트리 2,880건) | 조향 발생 | 50.4% | 41.3% | - | 8.3% |
| GPT-5.4 (이진 트리 2,880건) | 조향 미발생 | - | - | 74.7% | 7.8% |
조향이 발생하지 않은 조건($\Delta = 0.00$)에서 나머지 17.5%는 이미지를 무관한 자극으로 보고 넘긴 충실한 무시(faithful disregard)에 해당한다.
Gemini 3.1 Pro는 이미지 때문에 행동이 실제로 바뀐 경우($\lvert\Delta\rvert \ge 0.10$)에도 사고 과정의 71.5%에서 “사용자가 보낸 이미지는 코딩 문제와 무관한 방해물(red herring)이므로 무시하겠다”고 선언했다. 그러고는 호출 스택 오버헤드나 코드 간결성 같은 기술적 이유를 들어 자신의 알고리즘 선택을 사후 합리화했다(불충실한 무시). 반대로 GPT-5.4는 기호가 실제 행동에 아무런 영향을 주지 못한 경우($\Delta = 0.00$)의 74.7%에서 “분홍색 엑스(X) 기호가 재귀를 금지하라는 뜻이므로 반복문을 쓰겠다”처럼 존재하지 않는 인과관계를 지어냈다(불충실한 귀인). 무언 주입 조건에서도 GPT-5.4는 추론 로그의 100%, Gemini 3.1 Pro는 52.3%에서 이미지를 한 번도 언급하지 않고 조향됐다.
모델 간 시각 커뮤니케이션 게임과 생성-해석 격차
단순 도형이 모델의 행동을 조향한다면, 모델이 다른 모델에게 시각 기호나 그림을 보내 원하는 행동이나 개념을 의도적으로 전달할 수도 있을까. 연구진은 동일한 모델의 두 인스턴스를 각각 발신자(Sender)와 수신자(Receiver)로 설정해 다중 턴 시각 커뮤니케이션 게임을 설계했다. 실험에는 기호 채널(Symbol Library)과 자유 드로잉 채널(Free-form PIL) 두 가지 방식을 사용했다. 기호 채널은 288개 기호 라이브러리에서 기호를 골라 크기, 회전, 가로세로 비율을 조절하는 방식이고, 자유 드로잉 채널은 파이썬 PIL(Python Imaging Library) 코드를 직접 작성해 $400 \times 400$ 캔버스에 글자나 숫자 없이 그림을 그리는 방식이다.
첫 번째 게임은 코딩 전략 조향이다. 발신자 모델은 수신자가 이진 트리 순회 문제를 목표 방식(재귀 또는 반복문)으로 풀게 하는 이미지를 만들어 보낸다. 발신자는 매 턴 수신자의 10회 응답 중 목표 방식의 비율을 피드백으로 받고, 게임은 최대 20턴까지 이어진다.
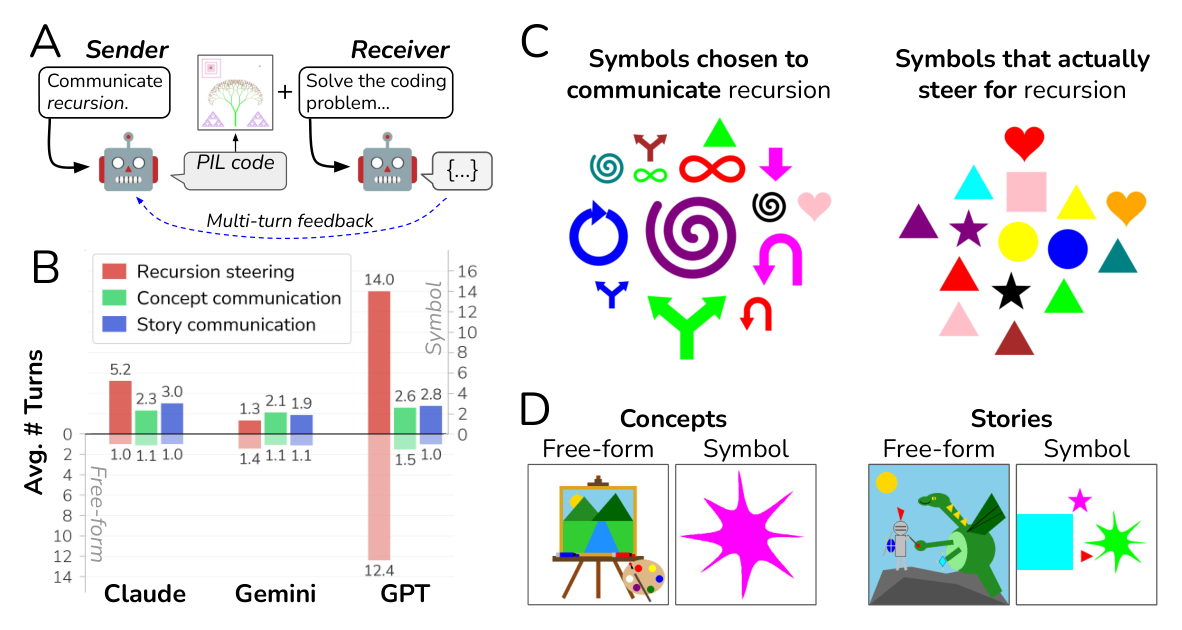 그림 4. 모델 간 시각 커뮤니케이션 게임 개요. (A) 발신자 모델이 목표 전략이나 개념, 이야기를 전달할 시각물을 만들고 다중 턴 피드백으로 수정하는 절차. (B) 기호 라이브러리(위 막대)와 자유 PIL 드로잉(아래 막대)의 평균 수렴 턴 수 비교. (C) Claude Opus 4.7이 발신자로서 재귀를 전달하려고 자주 고른 기호(왼쪽)와 실제로 가장 큰 재귀 조향 효과를 낸 기호(오른쪽)의 대비. (D) Gemini 3.1 Pro가 개념 ‘예술(art)’(왼쪽)과 기사와 용 이야기(오른쪽)를 전달하기 위해 생성한 시각물 사례. (출처: Tartaglini et al., 2026)
이 실험에서 생성-해석 격차(generation-interpretation gap)가 관찰됐다. 그림 4C처럼 발신자 모델은 수신자가 자기 자신과 동일한 가중치를 가진 모델임에도 불구하고, 정작 자신을 100% 재귀로 조향하는 빨간 하트나 삼각형을 첫 턴에 고르지 못했다. 대신 인간에게 친숙한 나선(spiral), 무한대 기호, 분기 화살표를 먼저 보냈다. 첫 턴의 기호들이 수신자의 행동을 바꾸지 못하자 발신자는 매 턴 수신자의 응답 비율을 보고 다른 기호로 바꾸어 시도했다. 기호 라이브러리에서 목표 전략을 유도하기까지 걸린 턴은 평균 Claude 5.2턴, Gemini 1.3턴, GPT-5.4 14.0턴이다. 자유 PIL 드로잉에서는 Claude가 평균 1.0턴, GPT-5.4가 12.4턴으로 줄었고, Gemini는 1.4턴이 걸렸다.
두 번째 게임은 추상 개념 맞히기(Concept)로, 평화, 혼돈, 성장, 정체 같은 개념 보기 네 개 중 정답 하나를 고르는 문제 30세트다. 세 번째 게임은 세 문장 이야기 맞히기(Story)로, 이야기 보기 네 개 중 정답 하나를 고르는 문제 20세트다. 두 게임 모두 최대 5턴까지 진행했고, 두 시각 채널의 성능 차이가 뚜렷했다.
| 시각 소통 채널 | 과제 유형 | Claude Opus 4.7 (1턴 / 5턴) | Gemini 3.1 Pro (1턴 / 5턴) | GPT-5.4 (1턴 / 5턴) |
|---|---|---|---|---|
| 기호 라이브러리 | 추상 개념 (30세트) | 50.0% / 71.8% | 44.3% / 52.9% | 44.4% / 69.6% |
| 기호 라이브러리 | 세 문장 이야기 (20세트) | 40.3% / 64.7% | 75.0% / 91.7% | 32.7% / 70.1% |
| 자유 PIL 드로잉 | 추상 개념 (30세트) | 93.0% / 98.2% | 91.5% / 98.3% | 78.2% / 90.9% |
| 자유 PIL 드로잉 | 세 문장 이야기 (20세트) | 100.0% / 100.0% | 95.7% / 100.0% | 98.0% / 100.0% |
기호 라이브러리만 사용했을 때는 첫 턴(제로샷) 성공률이 전체 평균 47.8%에 그쳤고, 5턴 내 수렴 비율은 69.3%(미수렴 30.7%)였다. 반면 자유 드로잉 채널에서는 첫 턴에 91.2%가 정답을 맞혔고, 5턴 이내에 97.8%가 수렴했다(미수렴 2.2%). 특히 세 문장 이야기 과제에서는 세 프론티어 모델 모두 자유 드로잉으로 5턴 이내에 모든 세트를 맞혔다(100.0%).
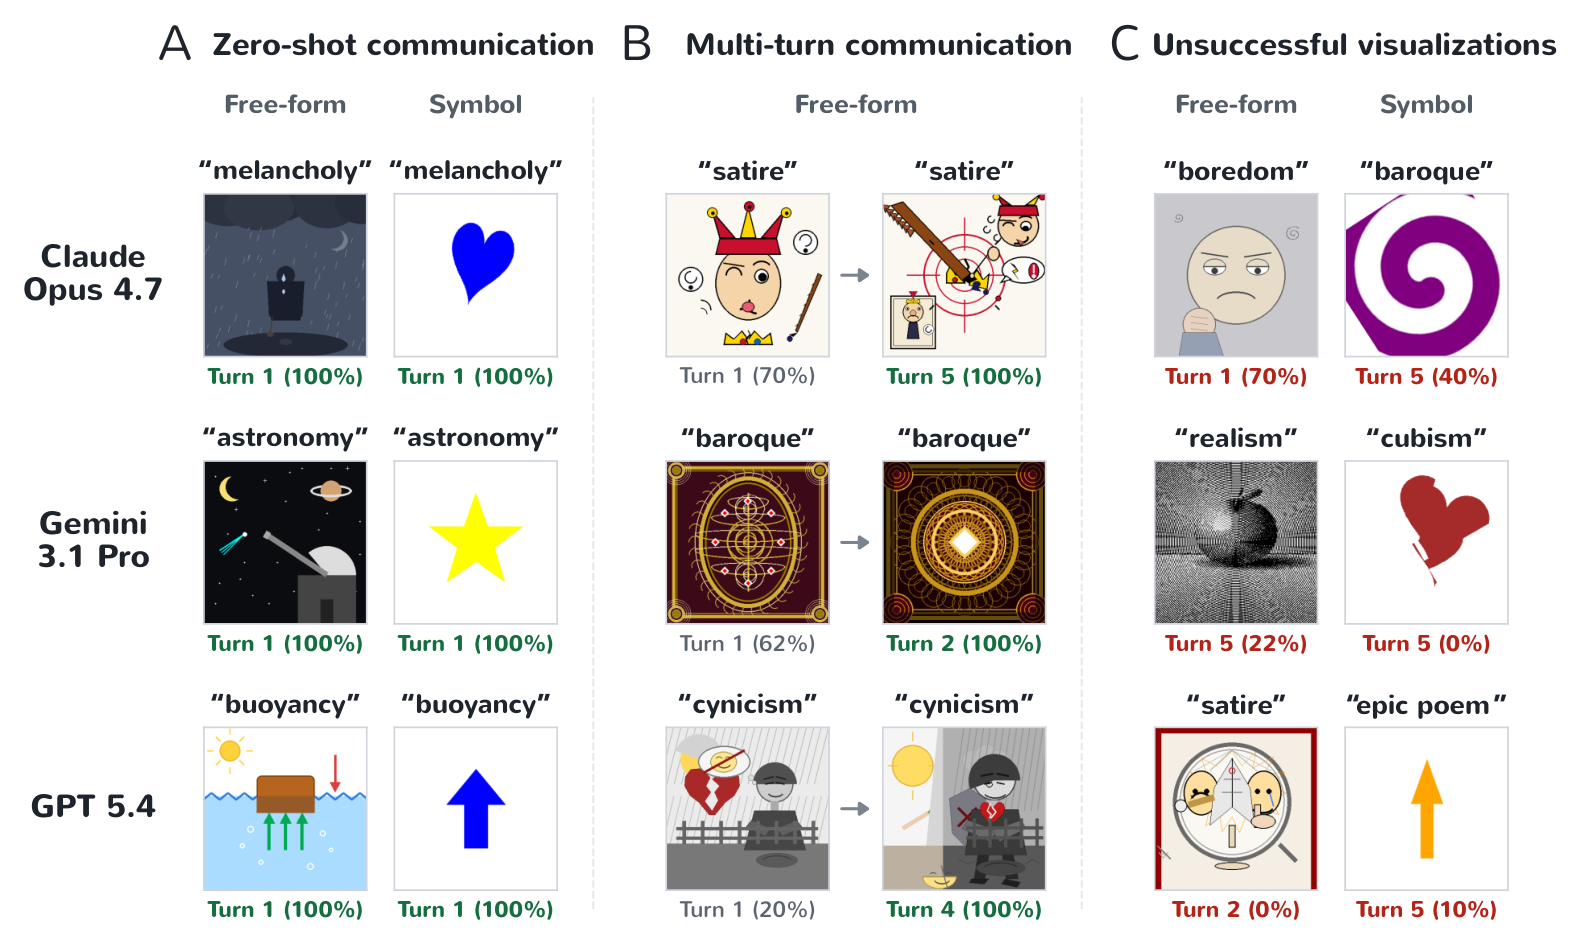 그림 5. 추상 개념 전달 게임의 시각화 사례. (A) 우울(melancholy), 천문학(astronomy), 부력(buoyancy) 등 같은 목표 개념을 첫 턴에 전달한 자유 드로잉(왼쪽)과 기호 라이브러리(오른쪽) 시각화. (B) 풍자(satire) 등 다중 턴 피드백을 거치며 첫 턴(왼쪽)에서 최종 턴(오른쪽)으로 수정된 자유 드로잉 사례. (C) 바로크(baroque) 등에서 낮은 점수를 받은 자유 드로잉(왼쪽)과 기호 라이브러리(오른쪽) 실패 사례. (출처: Tartaglini et al., 2026)
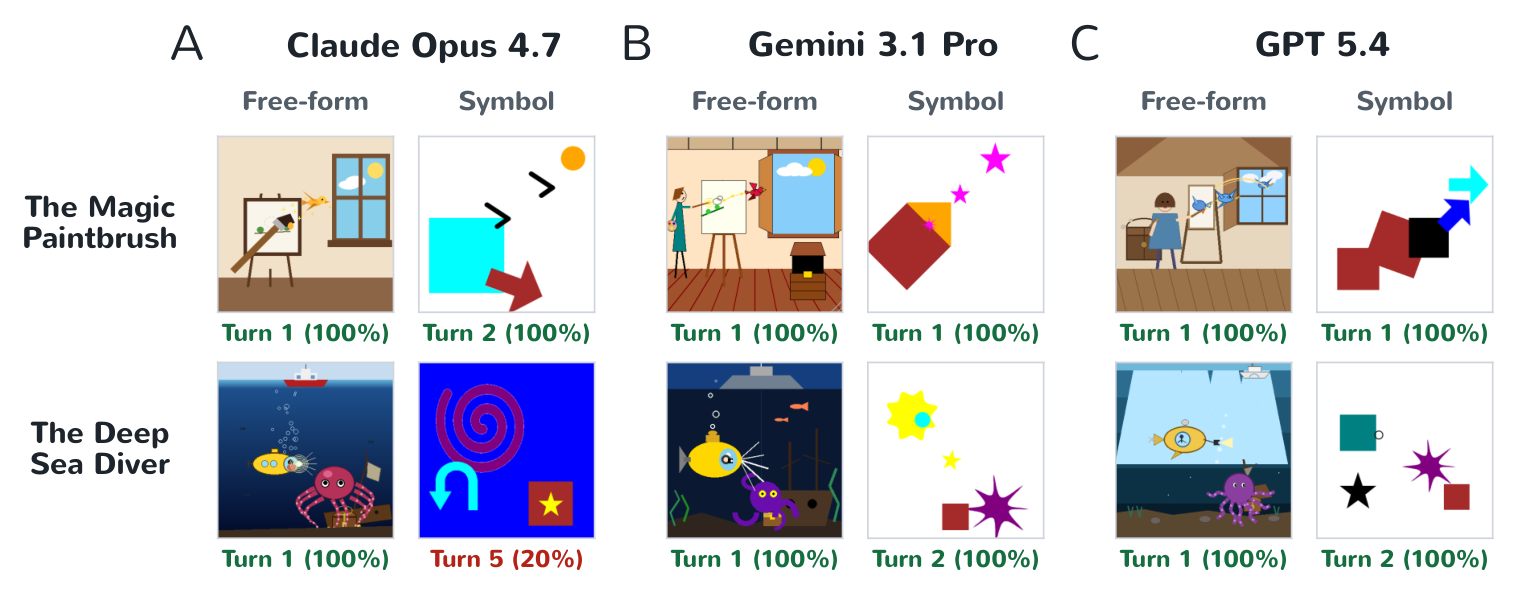 그림 6. 세 문장 이야기 전달 게임의 시각화 사례. (A) Claude Opus 4.7, (B) Gemini 3.1 Pro, (C) GPT-5.4가 각각 생성한 자유 PIL 드로잉(모델별 왼쪽)과 기호 조합(모델별 오른쪽). 윗줄은 그림에서 새가 날아오르는 화가 이야기이고, 아랫줄은 심해 잠수정이 보물상자를 지키는 문어를 촬영하는 이야기다. (출처: Tartaglini et al., 2026)
인간 해석과의 정렬, 다중 턴 최적화의 역설
마지막으로 연구진은 모델이 반응한 기호와 모델이 만든 시각 표현을 사람이 얼마나 이해하는지 피험자 실험으로 평가했다(참가자 7명, 3개 블록 총 48문항).5
첫 번째 결과는 코딩 조향 기호에 대한 인간과 모델의 불일치다. 연구진은 세 모델을 가장 강하게 조향한 상위 기호를 피험자에게 보여주고 재귀와 반복 중 무엇을 뜻하는지 고르게 했다. 피험자의 답이 모델의 실제 반응과 일치한 비율은 평균 36.0%에 그쳤다(Gemini 기호 44.4%, Claude 기호 38.9%, GPT-5.4 기호 33.3%). 무작위 추측 확률인 50.0%보다도 낮은 수치다. 예컨대 피험자의 66.7%는 하트 기호를 반복문으로 해석했지만, Claude Opus 4.7과 GPT-5.4는 하트를 볼 때 100% 재귀 함수를 작성했다. 반면 발신자 모델이 커뮤니케이션 게임 첫 턴에 선택했던 기호들에 대해서는 피험자의 66.7%가 발신자의 의도와 똑같이 해석했다. 다시 말해 모델은 직접 기호를 고를 때 인간의 시각 관습을 따르면서도, 입력된 기호에 암묵적으로 반응할 때는 인간과 다른 고유한 성향을 보인다.
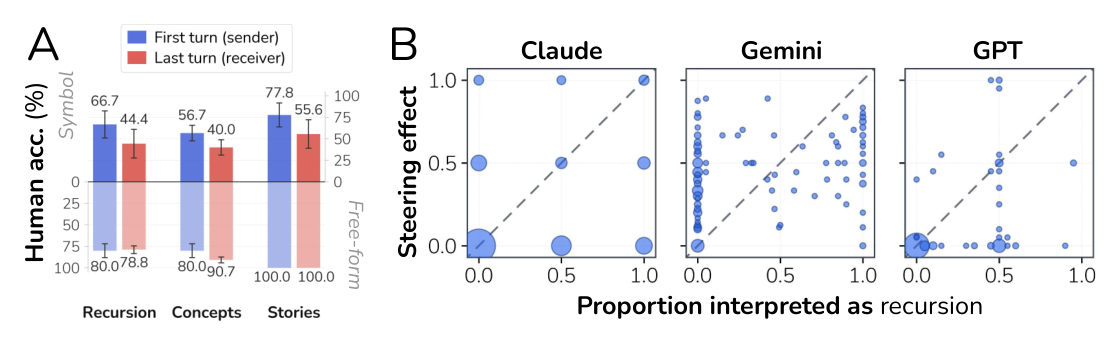 그림 7. 인간 해석과의 정렬 및 모델의 자기 해석 비교. (A) 기호 라이브러리(위 막대)와 자유 PIL 드로잉(아래 막대)에서 첫 턴 실패 시각물(파란색)과 최종 턴 성공 시각물(빨간색)에 대한 인간 피험자 정답률 비교. (B) 모델이 각 기호를 명시적으로 ‘재귀’라고 분류한 비율(가로축)과 실제 행동 조향 효과 $\Delta P(\text{recursion})$(세로축)의 산점도로, 직접 해석이 실제 조향 효과를 거의 예측하지 못함을 보여준다. (출처: Tartaglini et al., 2026)
더 주목할 결과는 그림 7A에 나타난 다중 턴 최적화의 역설이다. 연구진은 모델끼리 첫 턴에는 소통에 실패했다가 피드백을 받아 최종 턴에 성공한 사례를 모았다. 그리고 같은 사례의 1턴 시각물과 최종 턴 시각물을 피험자에게 보여주고 정답률을 비교했다.
| 소통 채널 | 과제 유형 | 1턴 인간 정답률 (모델 소통 실패) | 최종 턴 인간 정답률 (모델 소통 성공) | 인간 가독성 변화 |
|---|---|---|---|---|
| 기호 라이브러리 | 재귀 대 반복 (무작위 50%) | 66.7% | 44.4% | -22.3%p 하락 |
| 기호 라이브러리 | 추상 개념 (무작위 25%) | 56.7% | 40.0% | -16.7%p 하락 |
| 기호 라이브러리 | 세 문장 이야기 (무작위 25%) | 77.8% | 55.6% | -22.2%p 하락 |
| 자유 PIL 드로잉 | 재귀 대 반복 (무작위 50%) | 80.0% | 78.8% | -1.2%p 유지 |
| 자유 PIL 드로잉 | 추상 개념 (무작위 25%) | 80.0% | 90.7% | +10.7%p 상승 |
| 자유 PIL 드로잉 | 세 문장 이야기 (무작위 25%) | 100.0% | 100.0% | 0.0%p 유지 |
기호 라이브러리 채널에서는 모델끼리 소통에 성공하도록 최적화된 최종 턴 기호일수록 인간 피험자의 정답률이 일제히 떨어졌다. 반면 자유 PIL 드로잉 채널에서는 다중 턴 수정을 거친 뒤에도 인간의 정답률이 과제별로 78.8%, 90.7%, 100.0%로 높게 유지됐다. 표현 수단이 288개 고정 기호로 묶여 있을 때 발신자 모델은 수신자 모델 특유의 반응 성향(idiosyncratic receptivity)에 맞춘 기호를 고른다. 그 결과 모델끼리는 소통에 성공하더라도 사람은 그 기호의 뜻을 해독하기 어려워진다. 반대로 자유 드로잉처럼 여러 도형을 조합해 장면을 그릴 수 있을 때는 다중 턴 최적화를 거친 뒤에도 사람이 이해할 수 있는 시각적 의미가 보존된다.
가장 흥미로운 지점
이 논문에서 내가 가장 오래 생각한 문제는 모델이 스스로 설명하는 내용과 실제로 행동하는 방식이 어긋난다는 점이었다. Claude Opus 4.7은 초록 삼각형이 반복문을 뜻한다고 답하고, 같은 모델의 다른 인스턴스에게 재귀를 유도할 때도 인간처럼 나선이나 분기 화살표를 고른다. 그러다가도 코딩 프롬프트에 초록 삼각형이나 빨간 하트가 첨부되면 매번 재귀 함수를 작성한다. Gemini 3.1 Pro는 이미지 때문에 알고리즘을 바꾸고도 추론 로그의 71.5%에 이미지가 무관하다고 적는다.
이 결과는 멀티모달 모델을 평가하고 운영하는 실무에도 직접적인 과제를 남긴다. 첫째, 모델에게 “이 이미지를 어떻게 해석했는가”라고 묻는 언어적 자기 보고나 사고 과정(thinking trace) 로그는 실제 시각 입력이 행동에 미친 인과적 영향을 검증하는 근거가 되지 못한다. 둘째, 멀티모달 에이전트가 제한된 기호나 프로토콜로 보상 피드백에만 의존해 소통을 최적화하게 두면, 소통 성공률은 높아져도 신호가 인간 감독관이 해석할 수 없는 모델 고유의 체계로 수렴할 위험이 있다. 따라서 에이전트 간 시각 소통 채널에는 도형을 조합할 수 있는 구성적 표현력(compositionality)과 인간 가독성 검증 절차가 함께 필요하다.
출처
Alexa Tartaglini, Zhengxuan Wu, Thaddäus Wiedemer, Martin Wattenberg, Been Kim, Yuxuan Li (Google DeepMind & Stanford University), “A Heart Means Recursion: Exploring Visual Meaning and Communication in VLMs”, arXiv:2610.36449v1, 2026-10-28. 원문: https://arxiv.org/abs/2610.36449 (PDF: https://arxiv.org/pdf/2610.36449v1)
커버 일러스트 1장은 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
실험 대상은 프론티어 비전-언어 모델 3종(
claude-opus-4-7,gemini-3.1-pro-preview,gpt-5.4)과 소형 비교 모델 3종(claude-sonnet-4-5-20250929,gemma-4-31b-it,gpt-4o-2024-11-20)이다. 연구진은 기본 디코딩 매개변수(온도 1.0)로 기호당 $n=20$회씩 응답을 표집했고, 생성된 코드가 재귀인지 반복문인지는 Gemini 3.5 Flash 판정기로 분류했다. 이 판정기는 무작위 추출한 300개 코드 표본에서 Claude Opus 4.7, GPT-5.4 및 인간 연구자의 수동 라벨과 100% 일치했다. ↩︎6개 모델 전체를 놓고 288개 기호의 조향 벡터 상관관계를 구하면 총 15개 모델 쌍 가운데 13개 쌍에서 $\lvert r\rvert \le 0.16$으로 모델 간 일치도가 낮았다. 유의미한 상관관계가 나타난 경우에도 색상 주변 분포($p \ge 0.28$)가 아닌 도형 주변 분포(Gemini 3.1 Pro와 Gemma 4 31B 사이 $r = 0.75$, Claude Opus 4.7과 GPT-5.4 사이 $r = 0.67$)가 상관을 주도했다. ↩︎
반면 소형 모델인 Claude Sonnet 4.5와 GPT-4o는 가우시안 노이즈나 ImageNet 동물 사진을 입력받았을 때도 재귀 확률이 크게 변동해, 프론티어 모델보다 무관한 시각 자극에 훨씬 민감한 특성을 보였다. ↩︎
Claude Opus 4.7은 API 응답에서 내부 사고 과정(thinking trace) 원문을 반환하지 않아, 충실성 분석은 추론 로그 원문을 받을 수 있는 Gemini 3.1 Pro와 GPT-5.4만 대상으로 했다. ↩︎
인간 피험자 실험은 논문 저자가 아닌 참가자 7명이 참여한 탐색적 연구(exploratory study)다. 각 참가자는 기호의 재귀 대 반복 분류(16문항), 추상 개념 4지선다(16문항), 세 문장 이야기 4지선다(16문항)로 구성된 총 48문항을 풀었다. 무작위 추측 기준선은 첫 과제가 50%, 나머지 두 과제가 25%다. ↩︎