3줄 요약
- Hindsight는 Vectorize.io가 MIT 라이선스로 공개한 에이전트 메모리 시스템이다. 2025년 10월에 리포지토리를 만들었고, 같은 해 12월에 논문을 발표했으며, 2026년 9월 21일에 v0.10.1을 배포했다.
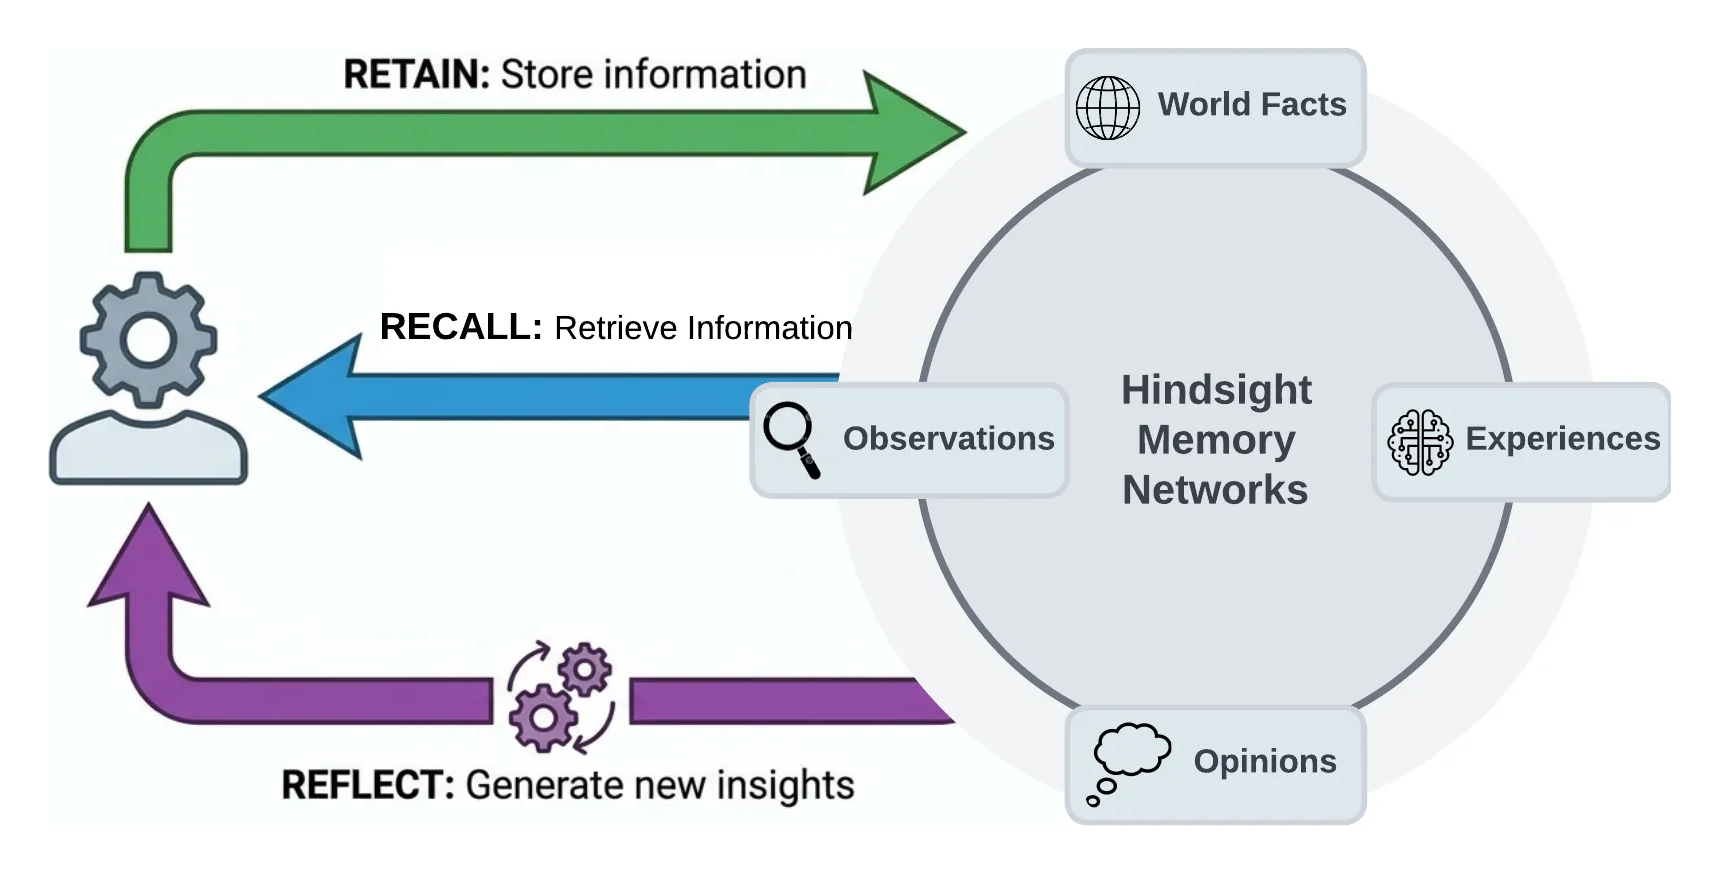
- 개발진은 대화 기록을 다시 불러오는 기능만으로는 부족하다고 보고, 에이전트가 경험에서 배우게 하는 것을 목표로 삼았다. Hindsight는 저장한 사실을 백그라운드에서 관측(observation)으로 통합하고, 관측마다 근거 인용과 증거 수를 기록한다. 자주 묻는 질문의 답은 멘털 모델로 미리 작성해 둔다.
- LongMemEval에서 Hindsight가 받은 점수는 README 기준 94.6%로, SuperMemory(85.92%)와 Zep(71.2%)의 점수보다 높다. 서버는 Docker 명령 하나로 실행되고, 기존 에이전트에는 LLM 클라이언트 래퍼, MCP 엔드포인트, 코딩 에이전트 전용 패키지로 연동한다.
자료 개요
| 항목 | 내용 |
|---|---|
| 개발 | Vectorize.io |
| 리포 | vectorize-io/hindsight (2025년 10월 30일 생성) |
| 라이선스 | MIT |
| 최신 릴리스 | v0.10.1 (2026년 9월 21일) |
| 규모 | 스타 27,247개, 포크 2,575개 (2026년 9월 25일 조회) |
| 논문 | Hindsight is 20/20: Building Agent Memory that Retains, Recalls, and Reflects (arXiv 2512.12818) |
| 구성 | Python(FastAPI) API 서버, Next.js 관리 UI, Rust CLI, Python과 TypeScript와 Go와 Rust SDK |
기억과 학습을 구분한다
README는 첫 문단에서 대부분의 에이전트 메모리 시스템이 대화 기록을 회상하는 데 집중한다고 진단했다. Hindsight의 목표는 기억에 더해 학습까지 하는 에이전트를 만드는 것이라고 한다.
논문 초록은 같은 문제를 더 구체적으로 설명했다. 기존 메모리 시스템은 모델과 분리된 부가 기능으로 동작한다. 대화에서 중요한 정보를 추출해 벡터 저장소나 그래프 저장소에 보관하고, 검색한 상위 k개 결과를 상태를 보존하지 않는 모델의 프롬프트에 추가하는 방식이다. 이 방식을 쓰면 증거와 추론을 구분하기 어렵고, 오랜 기간의 정보를 체계적으로 정리하는 데도 약하다. 추론 근거를 설명해야 하는 에이전트에게도 충분한 도움이 되지 못한다고 논문은 지적했다. 이 한계 때문에 Hindsight는 메모리를 추론에 직접 쓰는 구조화된 데이터로 다룬다.
네 종류의 기억
Hindsight는 기억을 네 종류로 구분한다.
| 종류 | 설명 | README의 예 |
|---|---|---|
| 세계 사실(World facts) | 세계에 관한 사실 | “난로는 뜨거워진다” |
| 경험(Experiences) | 에이전트 자신의 경험 | “난로를 만졌더니 정말 아팠다” |
| 관측(Observations) | 여러 기억을 통합해 만든, 근거가 있는 믿음 | |
| 멘털 모델(Mental models) | 관측과 사실을 종합해 만든 에이전트의 세계 이해 |
README는 이 구조를 인간 기억의 작동 방식을 본뜬 생체 모방(biomimetic) 데이터 구조라고 소개했다. 새 기억은 세계 사실 또는 경험으로 분류된 뒤, 엔티티와 관계와 시계열의 조합으로 표현되고 희소 벡터와 밀집 벡터로도 색인된다.1
세 가지 연산
retain: 저장
retain은 새 기억을 저장하는 연산이다.
client.retain(
    bank_id="my-bank",
    content="Alice got promoted to senior engineer",
    context="career update",
    timestamp="2025-06-15T10:00:00Z",
)
내부에서는 LLM이 입력에서 핵심 사실, 시간 정보, 엔티티, 관계를 추출한다. 추출한 데이터는 정규화 과정을 통해 표준 엔티티, 시계열, 검색 인덱스와 메타데이터로 변환된다. README는 이렇게 정리한 데이터가 recall과 reflect의 정확한 검색을 가능하게 한다고 설명했다.
recall: 검색
recall은 네 가지 검색 전략을 병렬로 실행한다.
| 전략 | 방식 |
|---|---|
| 의미 검색 | 벡터 유사도 |
| 키워드 검색 | BM25 정확 일치 |
| 그래프 검색 | 엔티티, 시간, 인과 링크 |
| 시간 검색 | 시간 범위 필터 |
네 결과는 RRF(reciprocal rank fusion)로 병합되고, 교차 인코더 기반 재순위 모델이 관련도 순서를 다시 매긴다. 마지막으로 recall은 토큰 한도에 맞게 결과 수를 줄인다. “What happened in June?” 같은 시간 질의도 recall 호출 하나로 처리한다.
reflect: 추론
reflect는 기존 기억을 더 깊게 분석하는 연산이다. 에이전트는 기억 사이에 새 연결을 만들거나, 조회만으로는 답할 수 없는 질문에 답할 때 reflect를 쓴다. 문서에 따르면 reflect는 에이전트 루프로 동작하며 다음 도구를 사용한다.
| 도구 | 용도 |
|---|---|
search_mental_models | 멘털 모델 검색. 가장 먼저 확인한다 |
read_mental_models | 스니펫으로 받은 페이지의 전문 읽기 |
search_observations | 관측 검색 |
recall | 원시 사실 검색 |
expand | 특정 기억의 추가 맥락 조회 |
done | 최종 답 반환 |
루프는 최대 10회까지 반복한다. 에이전트는 답하기 전에 반드시 증거를 수집해야 하고, 실제로 조회한 기억의 ID만 인용할 수 있다. 에이전트는 멘털 모델, 관측, 원시 사실 순서로 조회한다. 활용 사례로는 프로젝트 위험을 검토하는 AI 프로젝트 매니저와, 어떤 영업 메시지가 답장을 받았는지 분석하는 영업 에이전트가 README에 나온다. 제품 문서가 답하지 못한 고객 질문을 찾아내는 지원 에이전트도 사례로 소개됐다.
관측: 사실을 믿음으로 통합한다
retain이 끝나면 통합 엔진이 백그라운드에서 관련 사실을 관측으로 통합한다. 관측은 중복을 제거한 믿음이다. 통합 엔진은 근거가 된 기억의 원문 인용과 증거 수(proof count)도 함께 기록한다. 새 증거가 저장되더라도 통합 엔진은 기존 관측 전체를 교체하지 않고 내용을 수정한다. 새 정보에 따라 기존 믿음은 강화되거나, 약화되거나, 확장된다.
사용자 선호가 바뀌는 경우를 문서는 다음 표로 설명한다.
| 시점 | 새 사실 | 관측 |
|---|---|---|
| 1주차 | 사용자가 React를 좋아한다고 말함 | 사용자는 프런트엔드 개발에 React를 선호한다 |
| 2주차 | React의 컴포넌트 모델을 칭찬함 | 사용자는 React, 특히 컴포넌트 모델을 무척 좋아한다 |
| 3주차 | Vue로 바꿨고 React는 더 쓰지 않겠다고 말함 | 사용자는 예전에 React의 컴포넌트 모델을 높이 평가했지만, 지금은 Vue로 전환해 React를 쓰지 않는다 |
3주차의 관측은 현재 선호뿐 아니라 선호가 바뀐 경위까지 기록한다. 에이전트는 이 기록을 근거로 React 튜토리얼을 추천하지 않을 수 있고, “예전에 React를 쓰셨죠” 같은 맥락을 대화에 활용할 수 있다. 원시 사실도 항상 보존되므로 무엇이 언제 정정됐는지도 추적할 수 있다.
통합 엔진은 두 가지 보완 기능을 함께 제공한다.
- 유사 관측 병합: 관측을 만들거나 수정할 때마다 가장 비슷한 기존 관측과 비교한다. 두 관측의 코사인 유사도가 0.97(기본값) 이상으로 나오면, 통합 엔진은 별도 검사를 한 번 더 실행해 두 관측을 합칠지 따로 유지할지 결정한다.
- 신선도 추적: 아직 통합되지 않은 새 기억이 있으면 reflect는 그 기억과 관련된 관측을 오래된(stale) 것으로 판단하고, 원시 사실과 대조해 검증한다.
관측의 형태는 뱅크마다 observations_mission으로 지정할 수 있다. 기본 설정은 선호, 기술, 관계, 반복 패턴처럼 오래 유지되는 사실을 관측으로 만들고 일시적인 상태는 제외한다. “스프린트 결과와 차단 요인의 주간 요약” 같은 문장을 지정하면 기간별 요약을 만든다.
멘털 모델과 지식 페이지
멘털 모델은 뱅크에 관한 특정 질문에 대해 Hindsight가 계속 갱신하며 유지하는 답이다. “이 사용자의 선호는 무엇인가"라는 질문을 한 번 정의하면 Hindsight가 답을 작성해 저장하고, 뱅크에 새 기억이 추가될 때마다 백그라운드에서 답을 다시 작성한다. 멘털 모델을 읽을 때는 데이터베이스 조회 한 번이면 되고 검색이나 LLM 호출이 필요 없다. README는 에이전트가 세션마다 같은 지식을 다시 찾지 않고, 정리된 지식 한 페이지로 작업을 시작할 수 있다고 설명했다.
지식 페이지는 멘털 모델을 쓰기 쉽게 만든 형태다. 이름과 질문만 지정하면 나머지 설정은 기본값으로 처리된다. 뱅크가 스스로에 관해 작성하는 문서이며, 위키처럼 폴더로 정리되고 검색할 수 있고 일반 마크다운 파일로 내보낼 수 있다. CLI의 hindsight fs mount 명령으로 파일 시스템에 읽기 전용으로 마운트할 수도 있다.
뱅크와 성향
뱅크(bank)는 한 사용자, 한 에이전트, 또는 한 프로젝트를 위한 독립된 메모리 저장소다. README는 한 뱅크에서 다른 뱅크의 데이터를 조회할 수 없도록 엄격하게 격리한다고 밝혔다. API는 요청마다 뱅크 하나만 다루며, 여러 뱅크를 조합하는 작업은 클라이언트가 맡는다.
뱅크에는 성향(disposition) 특성 세 가지를 1부터 5까지의 값으로 설정할 수 있다. 성향은 reflect의 추론에만 영향을 주고 recall 결과는 바꾸지 않는다.
| 특성 | 1 | 5 |
|---|---|---|
| 회의성(Skepticism) | 정보를 그대로 믿는다 | 주장을 의심하고 검증한다 |
| 문자주의(Literalism) | 행간을 읽는다 | 문자 그대로 해석한다 |
| 공감(Empathy) | 사실에 집중한다 | 감정적 맥락을 고려한다 |
문서에는 원격 근무에 관한 같은 사실을 두 뱅크에 저장한 예가 실려 있다. 회의성이 낮고 공감이 높은 뱅크는 원격 근무가 유연성과 일과 삶의 균형을 준다고 답했다. 회의성이 높고 공감이 낮은 뱅크는 실제 생산성 지표부터 확인해야 한다고 답했다. 문서는 용도별 권장값도 제시했다. 고객 지원용 뱅크라면 회의성 2, 문자주의 2, 공감 5가 알맞고, 코드 리뷰용 뱅크라면 회의성 4, 문자주의 5, 공감 2가 알맞다고 한다. 법률 분석용 뱅크에는 회의성과 문자주의를 모두 5로, 공감을 2로 설정하라고 권했다.
README는 기능 두 가지를 따로 소개했다. 첫째, Hindsight는 입력 언어를 감지하고 처리하는 모든 과정에서 그 언어를 유지한다. 추출한 사실도 원래 언어로 저장되고, 엔티티 이름도 원래 문자 그대로 남는다. 예를 들어 张伟(장웨이)는 “Zhang Wei"로 바뀌지 않는다.
둘째, 뱅크별로 켤 수 있는 메모리 방어(Memory Defense)는 retain으로 저장하려는 모든 입력을 45개 패턴으로 검사한다. 비밀값이나 개인정보가 발견되면 [REDACTED:github_token]처럼 마스킹하거나 저장 전에 차단한다.
RAG와 무엇이 다른가
문서의 비교표에서 RAG는 의미 유사도만으로 검색하고, 질의와 질의 사이에 상태를 보존하지 않는 방식이다. Hindsight는 질의에서 시간 표현과 엔티티를 먼저 파싱한다. 이어서 네 가지 검색 결과를 병합하고 재정렬한 뒤 성향을 적용한다. 문서가 제시한 예시는 다음과 같다.
- 다중 홉 추론: “Alice는 Atlas 프로젝트의 테크 리드다”, “Atlas는 Kubernetes를 쓴다”, “Kubernetes 클러스터에 화요일 장애가 있었다"라는 세 사실을 저장했다고 하자. “Alice가 최근 문제의 영향을 받았나?“라고 물으면 RAG는 Alice에 관한 사실만 찾는다. Hindsight는 엔티티 링크로 연결된 Alice, Atlas, Kubernetes, 장애를 차례로 조회해 답한다.
- 시간 질의: “Alice가 지난봄에 무엇을 했나?“라고 물으면 RAG는 날짜와 상관없이 Alice에 관한 사실을 모두 반환한다. Hindsight는 “지난봄"을 3월부터 5월까지로 해석하고 그 기간의 사실만 필터링한다.
문서는 정적 문서 코퍼스에 대한 질의응답이나 시간 조건이 없는 검색에는 RAG를 권했다. 지속적인 기억이 필요한 AI 비서, 엔티티 추적, “지난달” 같은 시간 질의에는 Hindsight를 권했다.
벤치마크
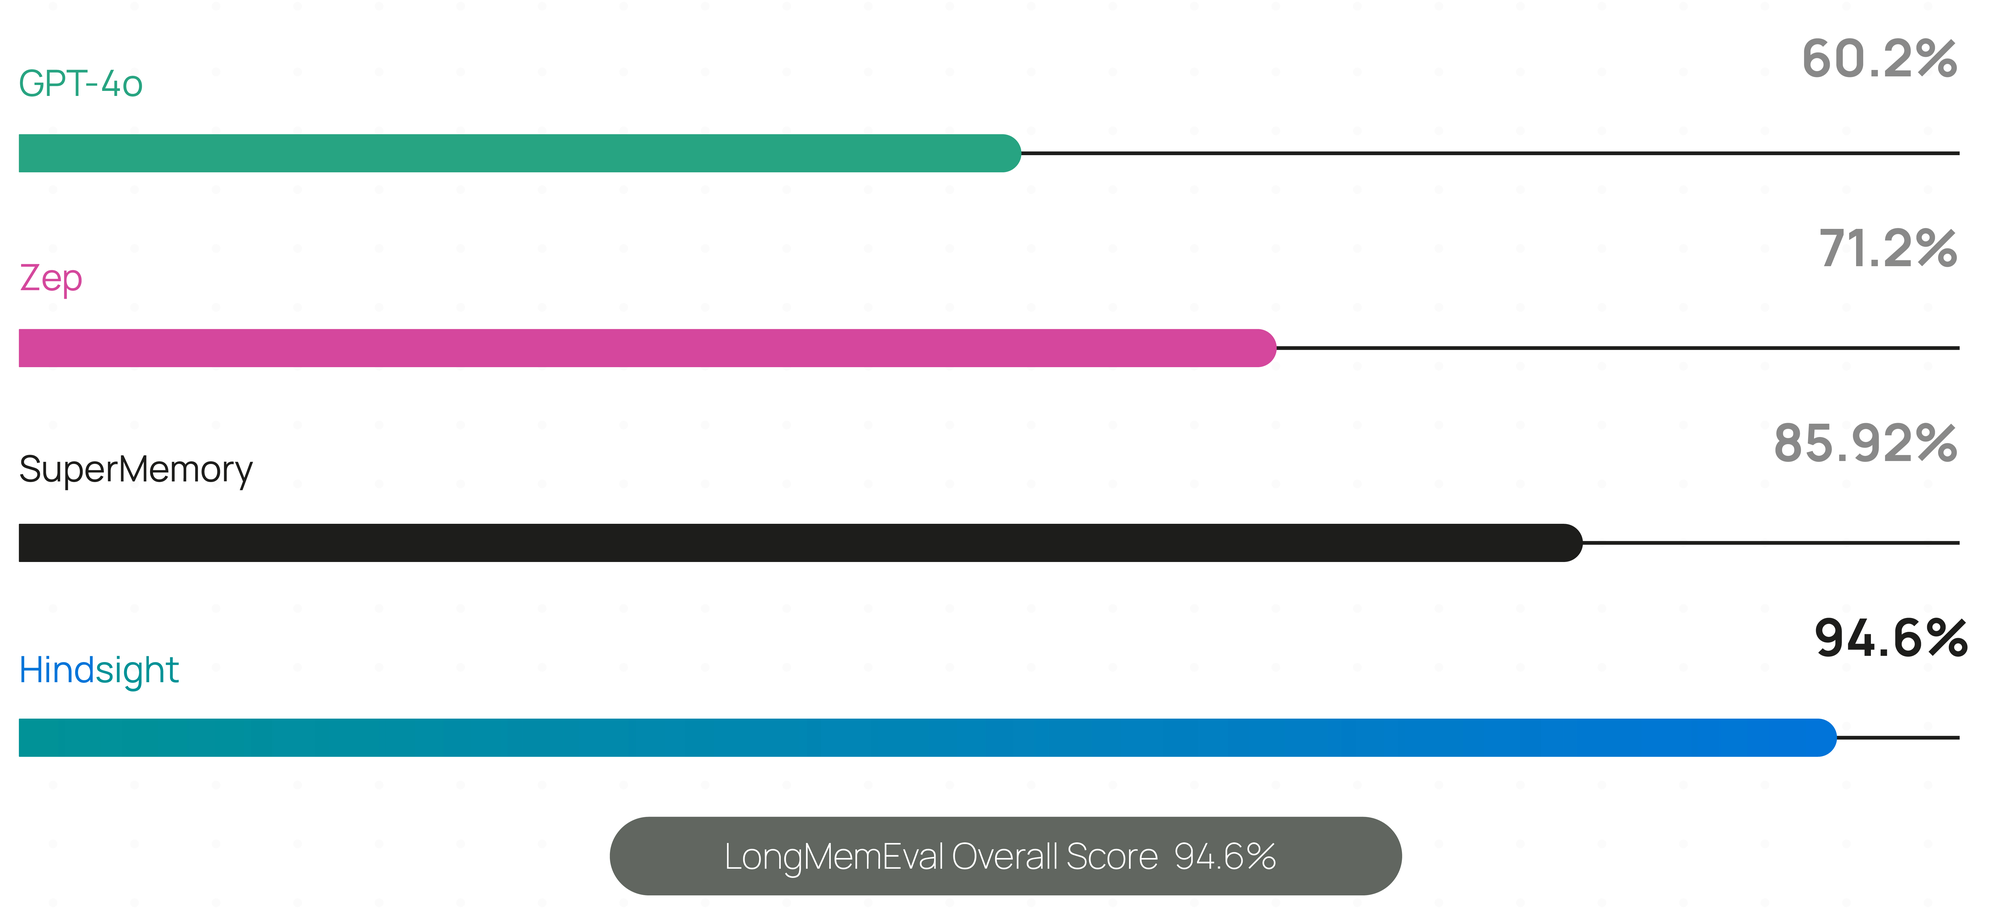
README는 2026년 1월 기준 LongMemEval 전체 점수로 Hindsight 94.6%, SuperMemory 85.92%, Zep 71.2%, GPT-4o 60.2%를 제시했다. 버지니아 공대 Sanghani 인공지능 데이터 분석 센터와 워싱턴 포스트의 연구 협력자들이 Hindsight의 점수를 독립적으로 다시 측정해 같은 결과를 얻었다고 한다. 다른 시스템의 점수는 각 업체가 자체 보고한 값이다.2
논문은 백본 모델별 결과도 보고했다. 비교 기준은 200억 매개변수(20B) 오픈소스 모델에 전체 대화를 컨텍스트로 그대로 제공하는 방식이었고, 이때 정확도는 39%에 그쳤다. 같은 모델에 Hindsight를 적용하자 정확도가 83.6%로 올랐다. 이 점수는 전체 컨텍스트를 받은 GPT-4o보다도 높았다. 백본을 더 큰 모델로 바꾸자 LongMemEval 점수는 91.4%까지, LoCoMo 점수는 최대 89.61%까지 올랐다. 논문이 비교한 기존 공개 시스템의 LoCoMo 최고 점수는 75.78%였다.
에이전트에 연동하는 방법
서버는 Docker 명령 하나로 실행한다. API는 8888번 포트, 관리 UI는 9999번 포트를 쓴다.
docker run -it --pull always --name hindsight --restart unless-stopped -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
Hindsight는 25개 이상의 LLM 제공자를 지원한다. OpenAI, Anthropic, Gemini 같은 호스팅 서비스를 쓸 수 있고, Ollama, LM Studio, llama.cpp 같은 로컬 실행기와 OpenAI 호환 엔드포인트도 쓸 수 있다. ChatGPT Plus와 Pro(openai-codex), Claude Pro와 Max(claude-code), Cursor, GitHub Copilot 구독은 API 키 없이 연결된다. 별도 서버 없이 쓰려면 hindsight-all 패키지로 Python 프로세스에 내장하면 된다.
기존 에이전트에는 네 가지 방법으로 연동할 수 있다.
- LLM 래퍼: 기존 OpenAI 클라이언트를
wrap_openai()로 래핑하면, 호출 전에는 관련 기억을 recall하고 호출 후에는 대화를 retain한다. Anthropic SDK용wrap_anthropic()도 있으며, LiteLLM 기반이라 100개 이상의 모델에 쓸 수 있다. - 통합 모듈: Claude Code, Codex, Cursor 같은 코딩 에이전트와 LangGraph, CrewAI, Pydantic AI 같은 에이전트 프레임워크를 지원한다. n8n과 Zapier 같은 노코드 도구까지 포함하면 통합 대상은 60개 이상이다.
- 코딩 에이전트 패키지:
npx @vectorize-io/hindsight-coding-agents install all명령으로 설치한다. 패키지는 리포지토리마다 git 이력과 과거 세션을 바탕으로 뱅크를 자동으로 구축한다. 에이전트가 작업을 시작하면 그 뱅크의 기억을 주입한다. 아키텍처, 코드 컨벤션, 진행 중인 작업을 다루는 지식 페이지도 만든다. 패키지는 Claude Code, Codex CLI, Cursor CLI를 비롯해 13종의 CLI를 지원한다. - MCP: 모든 서버가 뱅크마다
http://localhost:8888/mcp/{bank_id}/엔드포인트를 기본으로 제공한다. MCP 클라이언트는 retain, recall, reflect를 도구로 호출할 수 있다.
README가 가장 단순한 활용 사례로 소개한 것은 사용자별 기억이다.
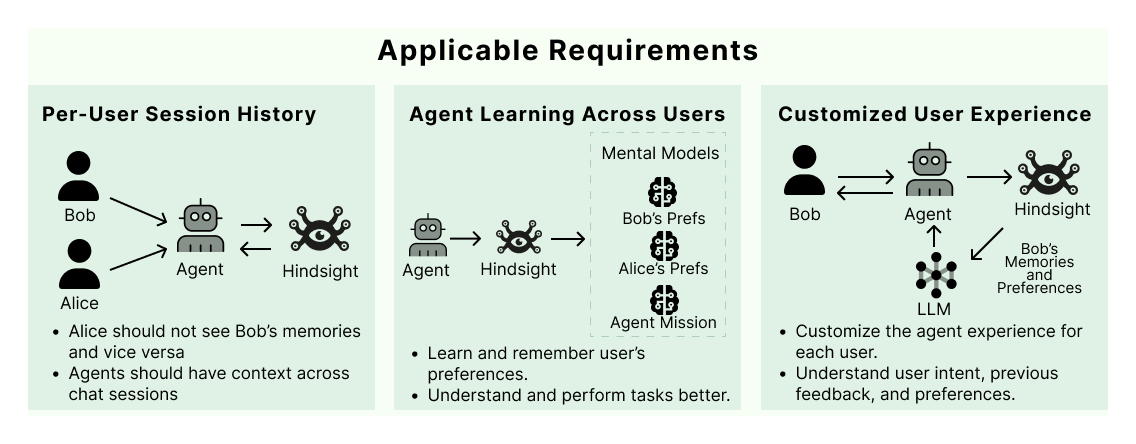
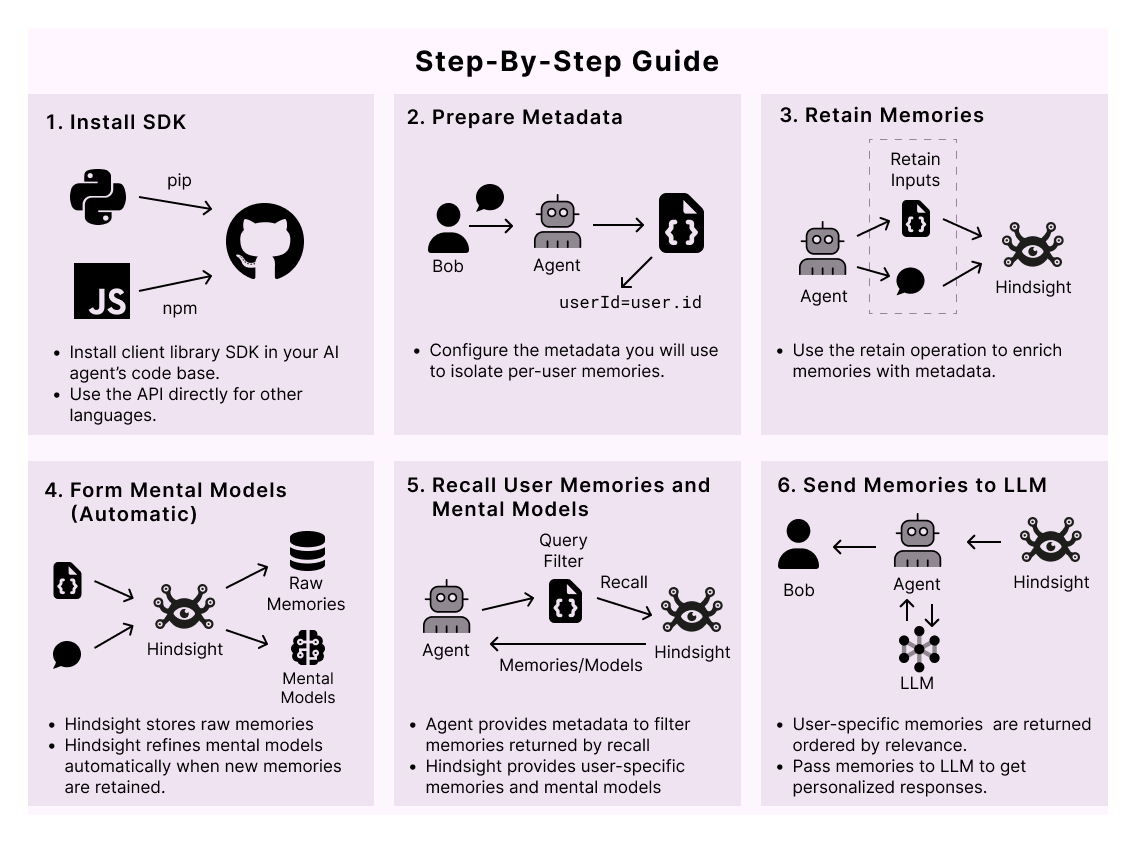
README는 요구 사항을 세 가지로 정리했다. 첫째, 각 사용자는 다른 사용자의 기억을 볼 수 없어야 한다. 둘째, 에이전트는 사용자별 선호를 멘털 모델로 학습해야 한다. 셋째, 에이전트는 그 기억으로 사용자 경험을 맞춤화해야 한다. Hindsight에서는 retain할 때 사용자 ID를 메타데이터로 지정하고, recall할 때 같은 메타데이터로 필터링하면 된다.
운영 환경
| 항목 | 내용 |
|---|---|
| 저장소 | PostgreSQL과 pgvector, 또는 Oracle AI Database 23ai |
| 설정 | 전역 환경 변수, 테넌트, 뱅크 순으로 재정의 |
| 모니터링 | LLM 호출, 토큰, 지연 시간에 대한 Prometheus 지표와 대시보드 |
| 운영 도구 | 마이그레이션, 뱅크 복구, 멈춘 작업 처리를 위한 관리 CLI |
| 이벤트 | retain, 통합, 갱신 단계마다 웹훅 발송 |
| 매니지드 | Hindsight Cloud. 사용량 기반 과금, 가용성 99.9% SLA |
README는 가장 적합한 대상으로 “AI 직원"형 에이전트를 꼽았다. 이런 에이전트는 정해진 답이 없는 과제를 처리하고, 사용자 피드백에 따라 행동을 바꾸며, 복잡한 작업을 배워야 한다. n8n으로 만든 단순한 워크플로에도 쓸 수는 있지만 과할 수 있다고 README가 직접 적었다.
인상 깊었던 설계
나는 새 증거가 기존 믿음 전체를 교체하지 않고 내용을 수정한다는 원칙이 가장 인상 깊었다. React에서 Vue로 전환한 사례를 보면, 3주차 관측에는 사용자가 지금 Vue를 쓴다는 정보만 기록되지 않는다. 사용자가 예전에 React를 좋아했다는 정보와 Vue로 전환했다는 정보도 함께 기록된다. 전환 이력이 기록돼 있으면 에이전트는 사용자의 현재 선호뿐 아니라 전환한 이유까지 추론할 수 있다.
관측마다 원문 인용과 증거 수를 기록하는 방식에도 같은 원칙이 적용된다. reflect가 오래된 관측을 원시 사실과 대조해 검증하려면, 그 믿음의 근거가 된 기억을 확인할 수 있어야 한다. 실제로 조회한 기억만 인용하게 하는 규칙도 이 기록이 있어야 작동한다.
출처
- 개발: Vectorize.io
- 리포: https://github.com/vectorize-io/hindsight (MIT, 2026년 9월 25일 조회, v0.10.1 기준)
- 문서: https://hindsight.vectorize.io
- 논문: Chris Latimer, Nicoló Boschi, Andrew Neeser, Chris Bartholomew, Gaurav Srivastava, Xuan Wang, Naren Ramakrishnan, “Hindsight is 20/20: Building Agent Memory that Retains, Recalls, and Reflects”, arXiv:2512.12818, 2025년 12월 14일. https://arxiv.org/abs/2512.12818
- 이미지: 리포의
hindsight-docs/static/img/(MIT)
원문: https://github.com/vectorize-io/hindsight
커버 도식에는 네 번째 요소가 멘털 모델 대신 의견(Opinions)으로 표기돼 있다. 논문 초록은 네 네트워크를 세계 사실, 에이전트 경험, 종합한 엔티티 요약, 변화하는 믿음으로 설명한다. README 본문의 분류와 도식, 논문의 용어가 서로 다르다. ↩︎
README의 94.6%는 2026년 1월 기준이고, 논문의 91.4%는 2025년 12월 발표 수치다. README는 94.6%를 기록한 백본 모델을 밝히지 않았다. 모델별 정확도, 지연 시간, 비용은 https://benchmarks.hindsight.vectorize.io/ 에서 계속 갱신된다고 한다. ↩︎