3줄 요약
- 2026년 11월 11일, Unsloth는 비전과 추론을 겸하는 270억 파라미터 밀집 모델 Qwen3.8-27B와 2.4조 파라미터 MoE 모델 Qwen3.8-2.4T-A95B의 동적 양자화 체크포인트 및 로컬 실행 가이드를 배포했다.
- 새로 적용된 Unsloth Dynamic V3.1 알고리즘은 2비트부터 6비트까지의 GGUF 양자화 모델에서, 같은 크기끼리 비교한 벤치마크 평균 정확도를 5%에서 10%까지 높였다. 또한 Unsloth는 컨텍스트 예산과 반복 실행 횟수를 바꿔 가며 다시 실험해, 다른 양자화 기법(ISTA GSQ-RCO, Exllama-v3)보다 정확도가 높다는 점을 입증했다.
- Unsloth는 Blackwell GPU에서 BF16보다 약 1.5배 빠른 동적 NVFP4 양자화 모델을 함께 제공했다. 4.9TB 원본을 397GB로 줄인 신규 1비트 데이터 타입(
UD-IQ1_XXXS, 가중치당 1.1875비트)도 내놓아, 소비자용 장비부터 워크스테이션까지 로컬 구동 범위를 확장했다.
Qwen3.8-27B 개요와 Unsloth 양자화 개선점
알리바바 Qwen 팀이 선보인 Qwen3.8-27B는 270억 파라미터 전체를 추론에 활성화하는 밀집(dense) 구조로, 시각 정보 처리(vision)와 단계적 추론(reasoning) 기능을 함께 갖추고 있다. 기본 컨텍스트 길이는 256K(262,144 토큰)이며, YaRN을 적용하면 최대 1M까지 늘릴 수 있다. 4비트 양자화 기준으로 RAM이나 VRAM이 16GB에서 19GB 사이면 로컬에서 구동할 수 있다. RTX 4090, RTX 5080, 24GB 통합 메모리를 탑재한 Mac 등이 여기에 해당한다.
Unsloth는 출시 당일(day zero)에 Qwen 팀으로부터 모델 접근 권한을 받아 GGUF와 NVFP4 양자화 체크포인트를 제작했다. 이번 Unsloth 양자화 패키지에는 단순 가중치 압축 외에도 실행과 관련한 개선 세 가지가 포함됐다.
- 개발자 역할(Developer Role) 지원: Codex와 같은 에이전트형 코딩 도구가 시스템 지시와 개발자 지시를 구분해 전달할 수 있도록 템플릿 기능을 추가했다.
- 다중 토큰 예측(MTP, Multi-Token Prediction) 지원: 추론할 때 한 번에 여러 토큰을 예측해 생성 속도를 높이는 기능을 제공한다. MTP를 활성화하려면 기본 메모리 요구량에 1GB에서 2GB가량의 여유 메모리가 더 필요하다.
- 도구 호출(Tool calling) 파싱 개선: 중첩된 객체(nested objects) 구조를 파싱할 때 발생하던 오류를 수정해 외부 도구 호출의 성공률을 높였다.
Dynamic V3.1 업데이트와 양자화 벤치마크 검증
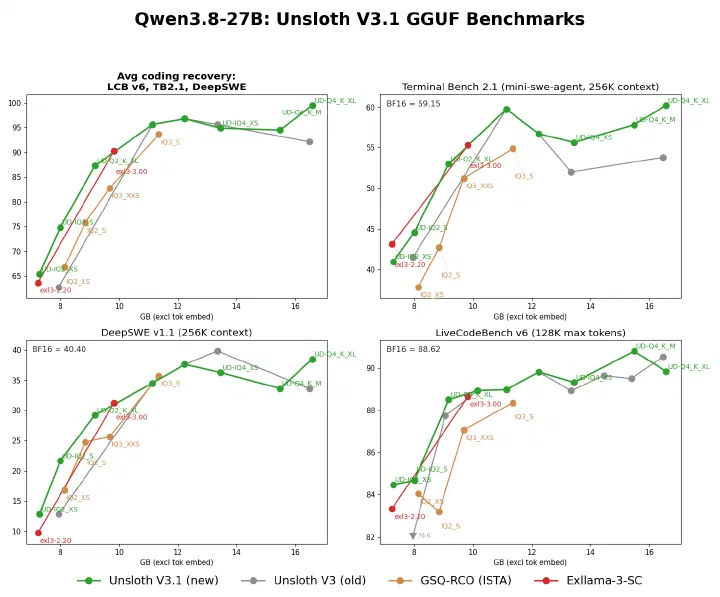
2026년 11월 11일 업데이트의 핵심은 앞서 DeepSeek-V4.1-Flash와 Qwen3.8-Flash-Next에서 먼저 검증된 Unsloth Dynamic V3.1(프리뷰) 알고리즘을 Qwen3.8-27B에 적용한 것이다. Qwen3.8-27B에서는 2비트부터 6비트까지의 GGUF 모델 전반에서, 같은 파일 크기끼리 비교한 평균 정확도가 5%에서 10%까지 개선됐다1. 평가는 에이전트 코딩 벤치마크인 Terminal Bench 2.1과 DeepSWE v1.1을 256K 컨텍스트로, 일반과 코딩 벤치마크인 LiveCodeBench v6, GPQA Diamond, MMLU-Pro, AIME25를 128K 컨텍스트로 측정했다.
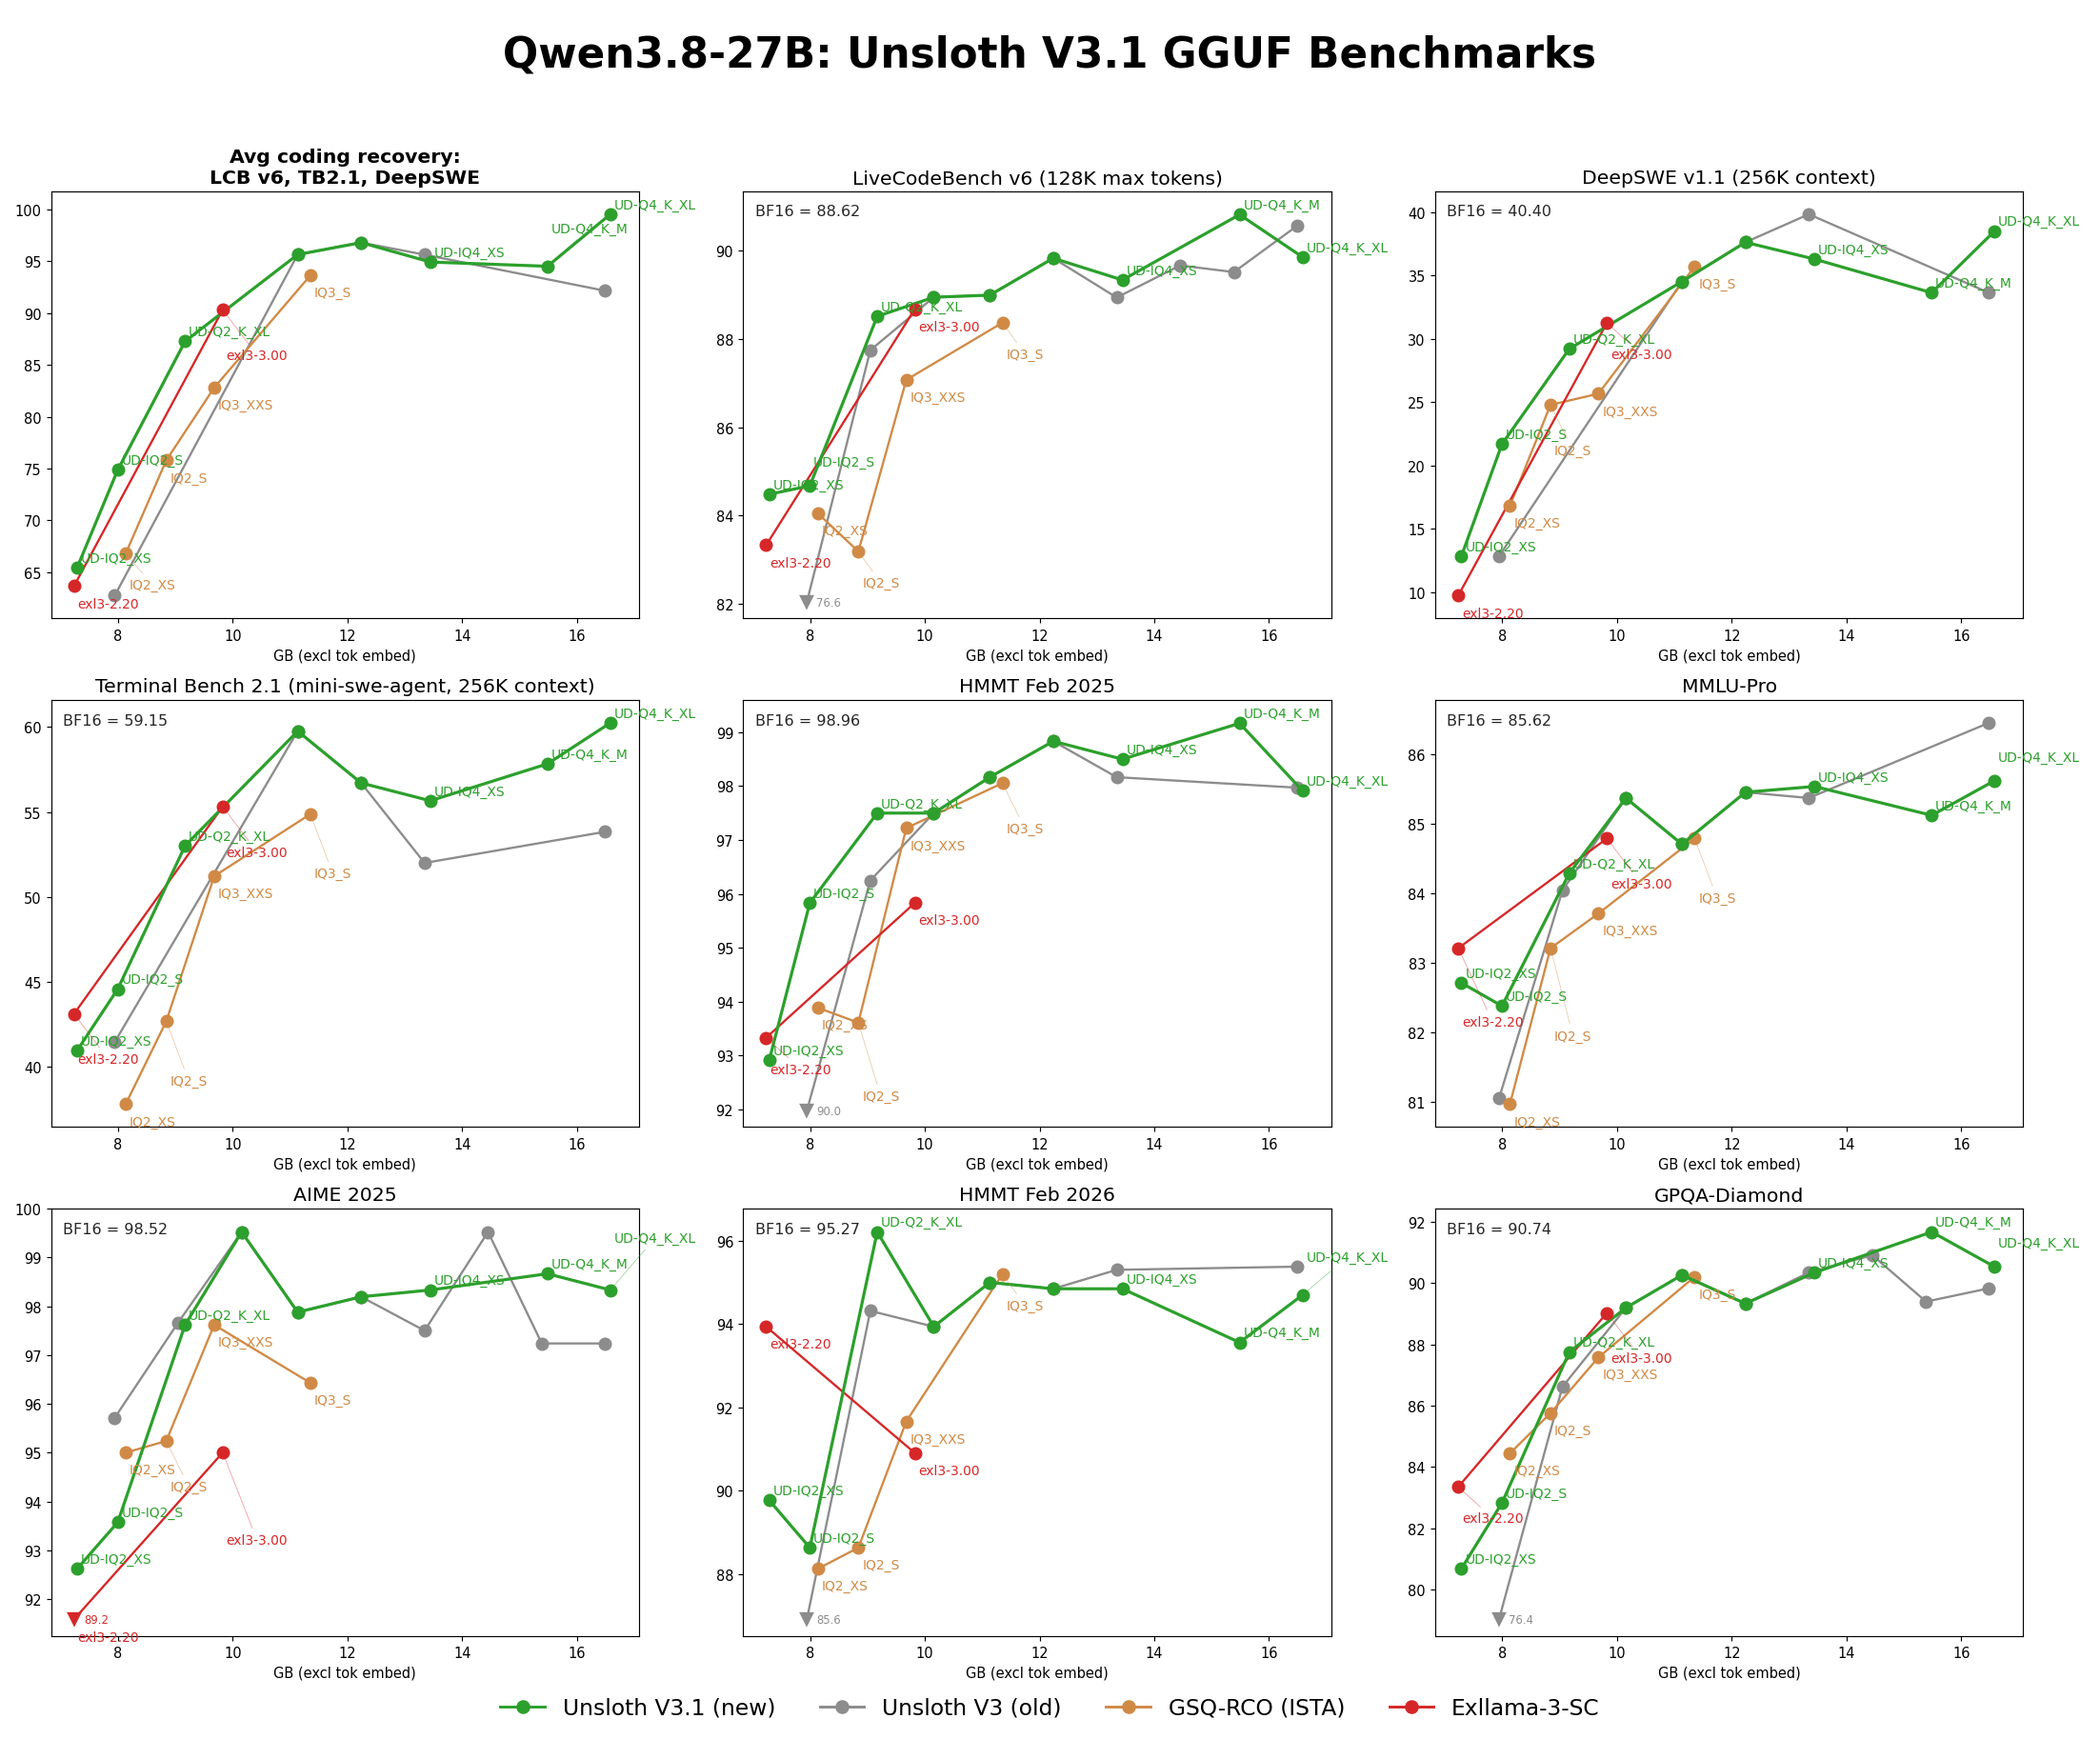 임베딩 레이어 크기를 제외한 상태에서 비교한 양자화 기법별 벤치마크 성적. 출처: Unsloth
Exllama-v3와 비교할 때의 임베딩 레이어 용량 문제
양자화 기법 간 성능을 공정하게 비교하려면 가로축(모델 크기)의 기준을 통일해야 한다. Exllama-v3는 출력 헤드(lm_head)를 강하게 양자화하는 대신 토큰 임베딩 레이어를 양자화하지 않고 16비트(BF16) 원본 그대로 유지한다2. 이 때문에 순수 가중치 양자화 효율만 비교할 때는 모든 양자화 제공자의 그래프에서 가로축의 임베딩 레이어 크기를 제외했다.
하지만 사용자가 실제로 내려받는 파일 용량과 RAM, 디스크 사용량에는 BF16 임베딩 테이블의 크기까지 포함된다. 임베딩 레이어를 포함한 전체 파일 크기와 실제 메모리 사용량을 가로축으로 놓고 정확도를 다시 비교하면, 아래 그래프처럼 같은 메모리에서 Unsloth Dynamic GGUF의 정확도가 더 높다는 점이 분명해진다.
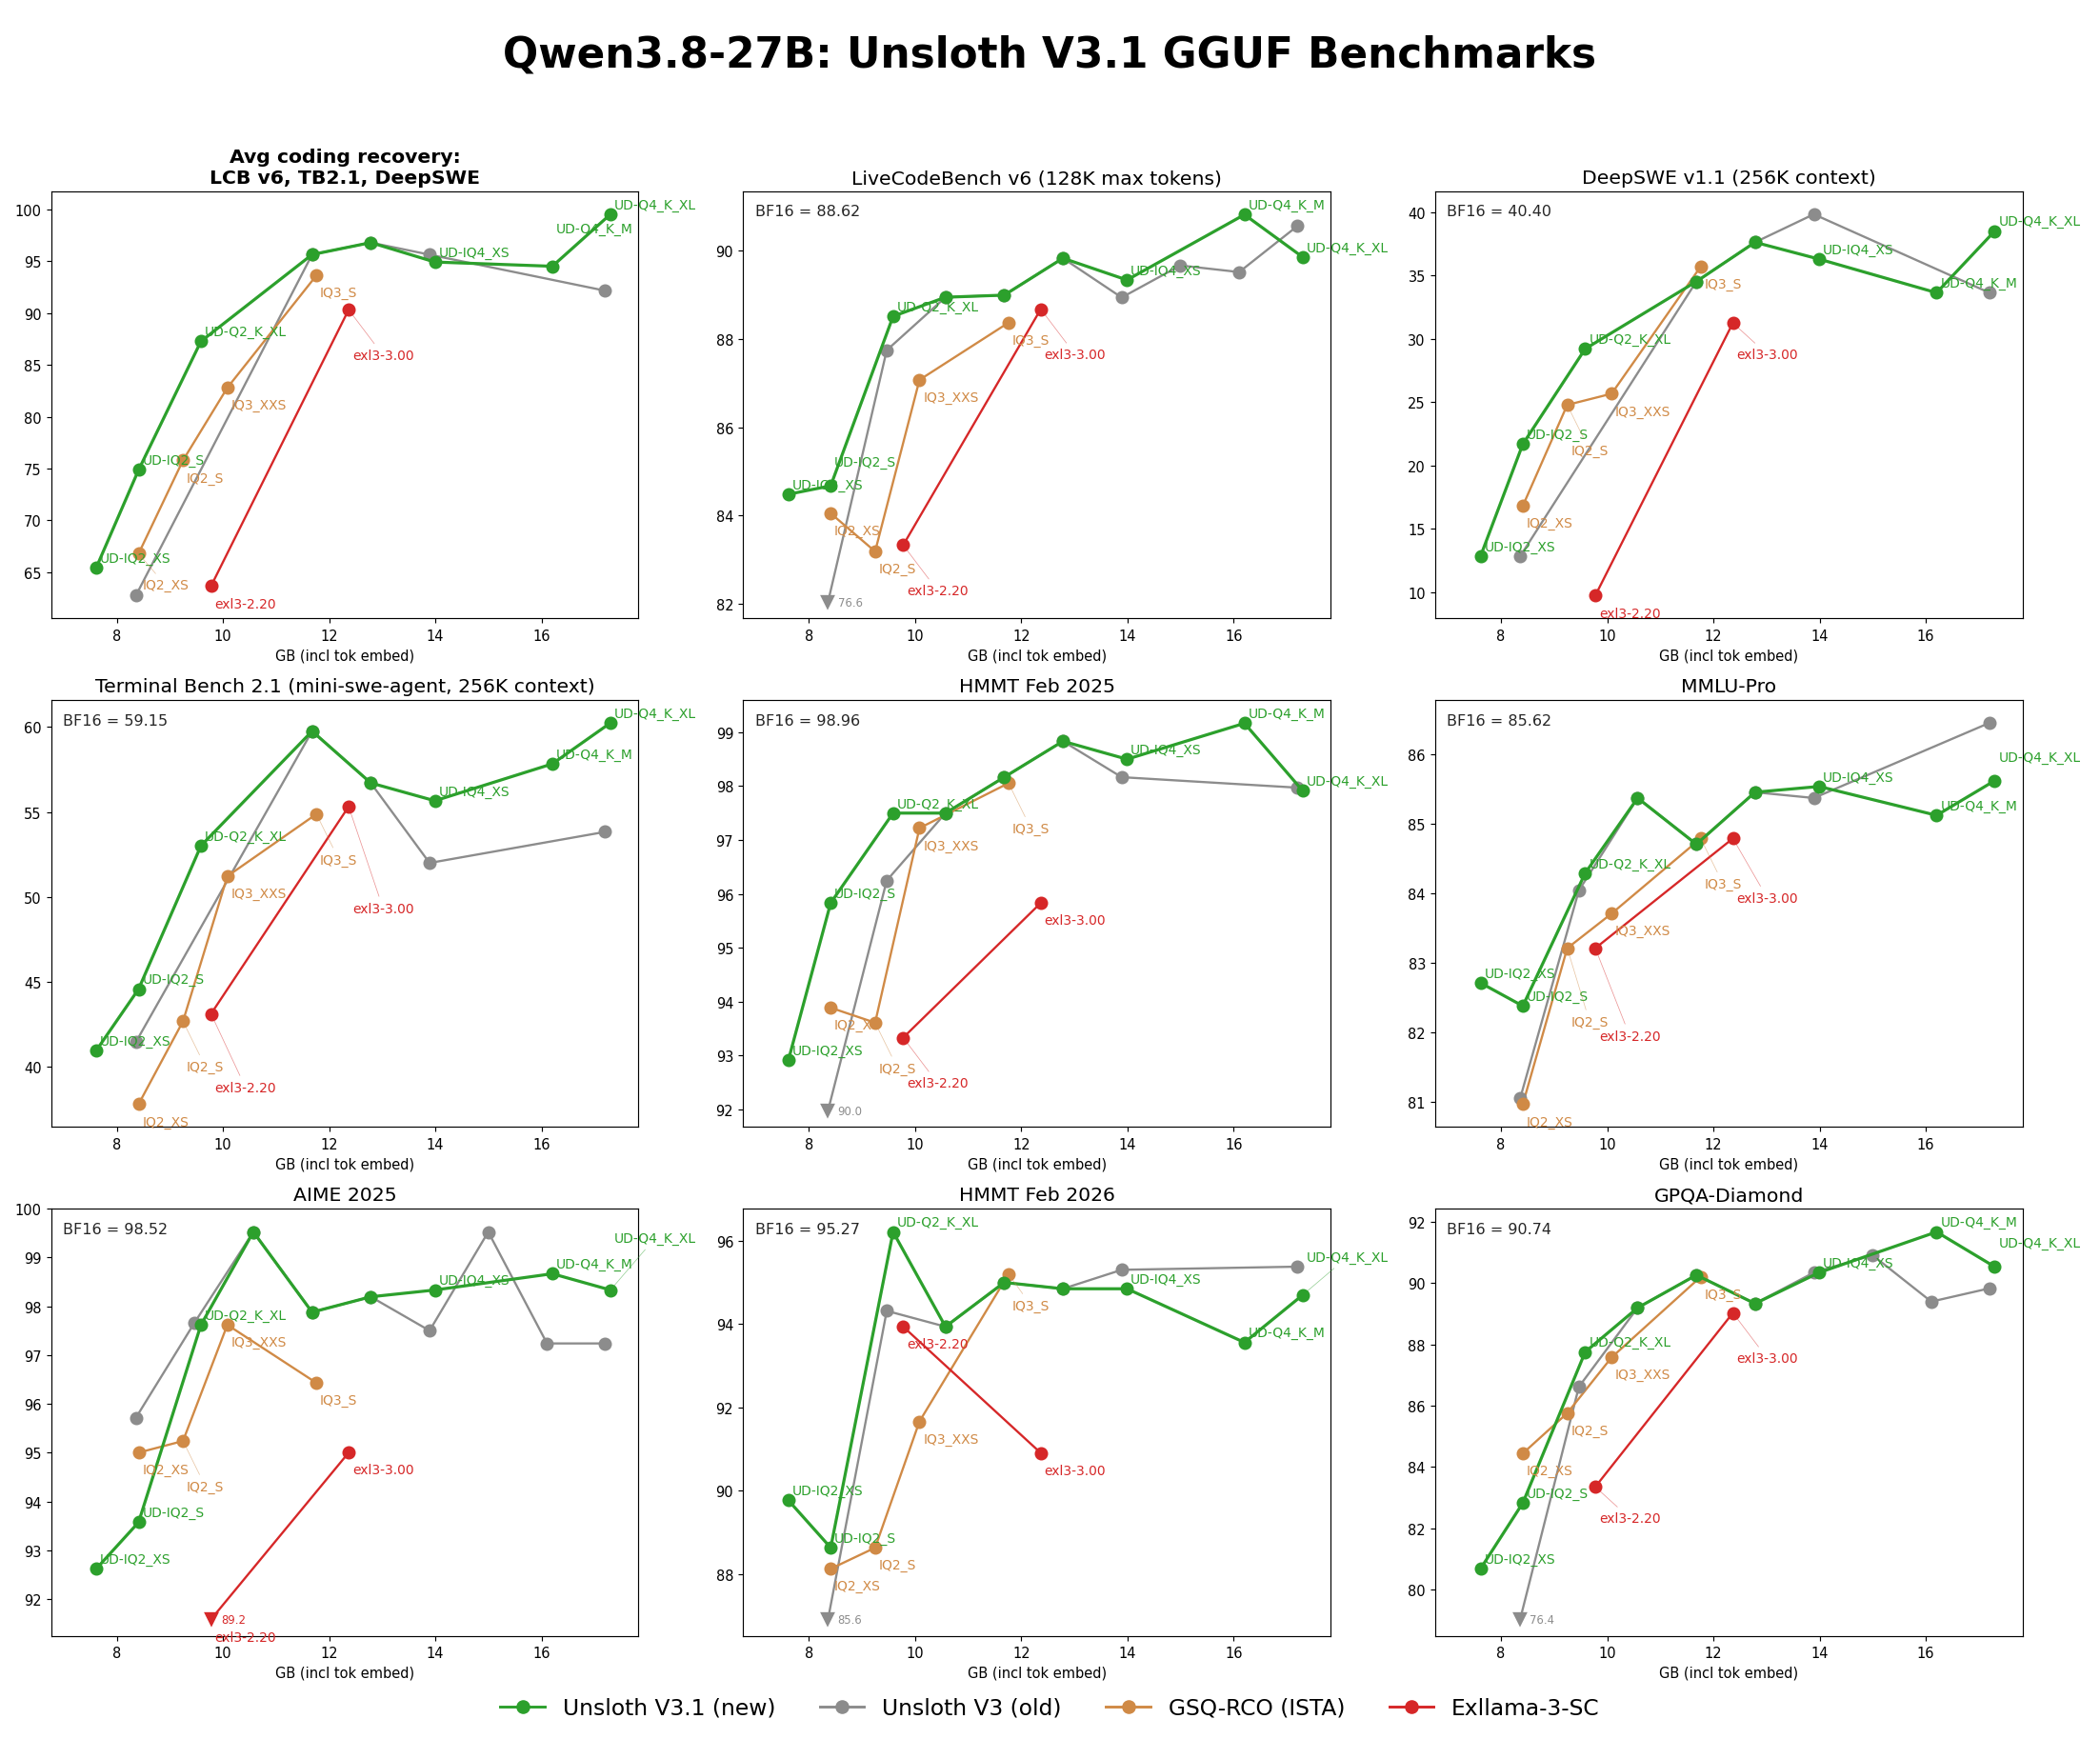 BF16 임베딩 크기를 포함한 실제 디스크와 RAM 사용량 기준 정확도 비교. 출처: Unsloth
ISTA GSQ-RCO 벤치마크 주장에 대한 반박
최근 ISTA의 GSQ-RCO 연구진은 자체 양자화 기법이 LiveCodeBench(LCB)와 AIME25에서 Unsloth의 기존 Dynamic V3.0 양자화(UD3)보다 일관되게 우수하다고 발표했다. Unsloth는 이 주장을 검증하기 위해 컨텍스트 예산(context budget)과 반복 실행 횟수(trials)를 변수로 두고 다시 실험했다.
먼저 LiveCodeBench에서는 모델에 허용한 컨텍스트 길이에 따라 순위가 달라졌다. GSQ-RCO 측이 공개한 수치는 컨텍스트 예산을 약 96K로 제한했을 때의 데이터와 일치한다. 96K 예산에서는 GSQ-RCO가 기존 UD3보다 소폭 높은 점수를 보이기도 한다. 하지만 모델이 추론 길이를 충분히 쓸 수 있는 128K 예산에서는, 가장 작은 크기를 빼면 모든 크기에서 구버전인 UD3조차 ISTA의 양자화보다 점수가 높다. 신규 Dynamic V3.1(UD3.1)은 이 점수 차이를 더 확대했다.
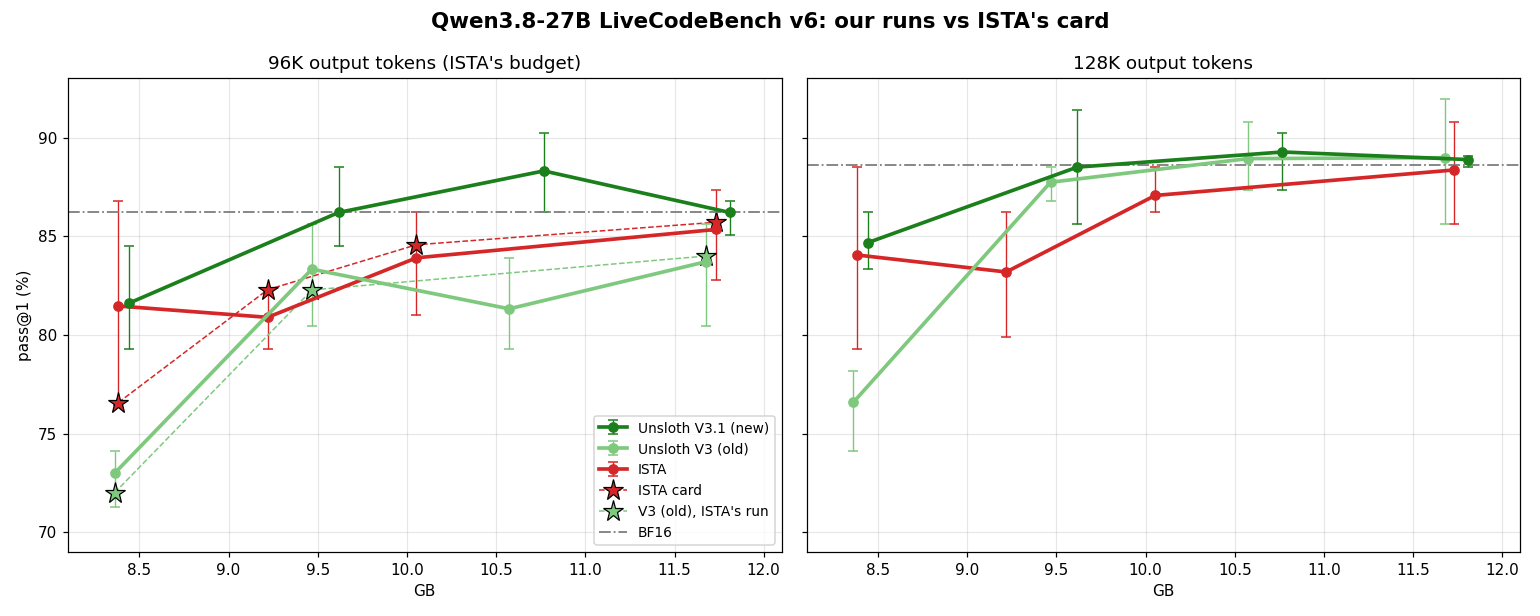 컨텍스트 예산(가로축) 증가에 따른 LiveCodeBench 성능 추이. 128K 예산에서 Unsloth 계열의 점수가 더 높다. 출처: Unsloth
수학 추론 벤치마크인 AIME25에서는 평가를 몇 번 반복해 평균을 냈는지가 핵심 변수였다. ISTA 측은 GSQ-RCO 양자화 모델들이 원본과 비교해 100%, 100%, 100%, 96.7%의 정확도 회복률(accuracy recovery)을 달성했다고 보고했다. 이 수치를 확인하려고 Unsloth가 동일한 조건에서 실험을 14번 되풀이해 평균을 내 보니, 실제 정확도 회복률은 93%에서 96% 사이로 집계됐다. ISTA의 결과는 단 1회 실행(single trial)에서 우연히 높게 나온 점수일 가능성이 크다. 14회 평균으로 비교하면 구버전 UD3가 도리어 ISTA 양자화보다 회복률이 높았다3.
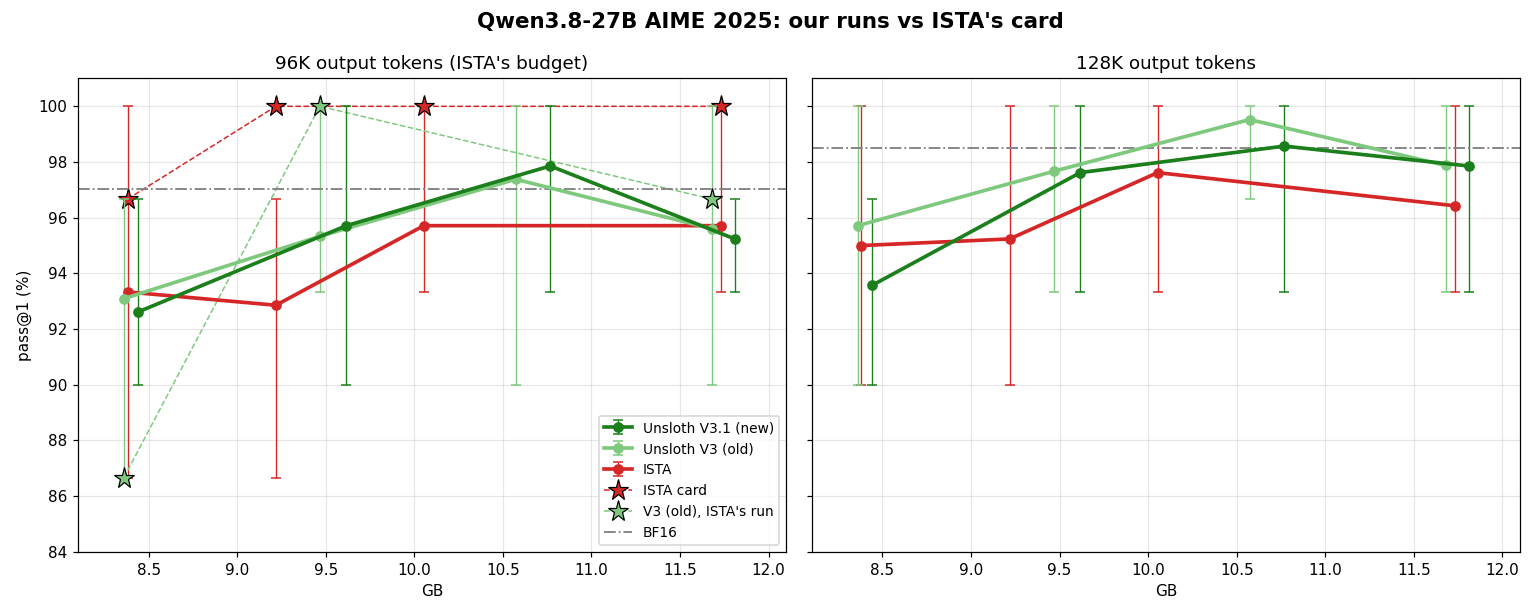 14회 반복 실행으로 측정한 AIME25 성능 비교. 96K와 128K 모두에서 Unsloth 양자화가 평균 우위를 보인다. 출처: Unsloth
아울러 여러 텍스트 도메인에서 원본 확률 분포와 얼마나 다른지를 재는 KLD(쿨백-라이블러 발산)에서도, UD3.1은 기존 UD3보다 전반적으로 오차가 낮게 나왔다.
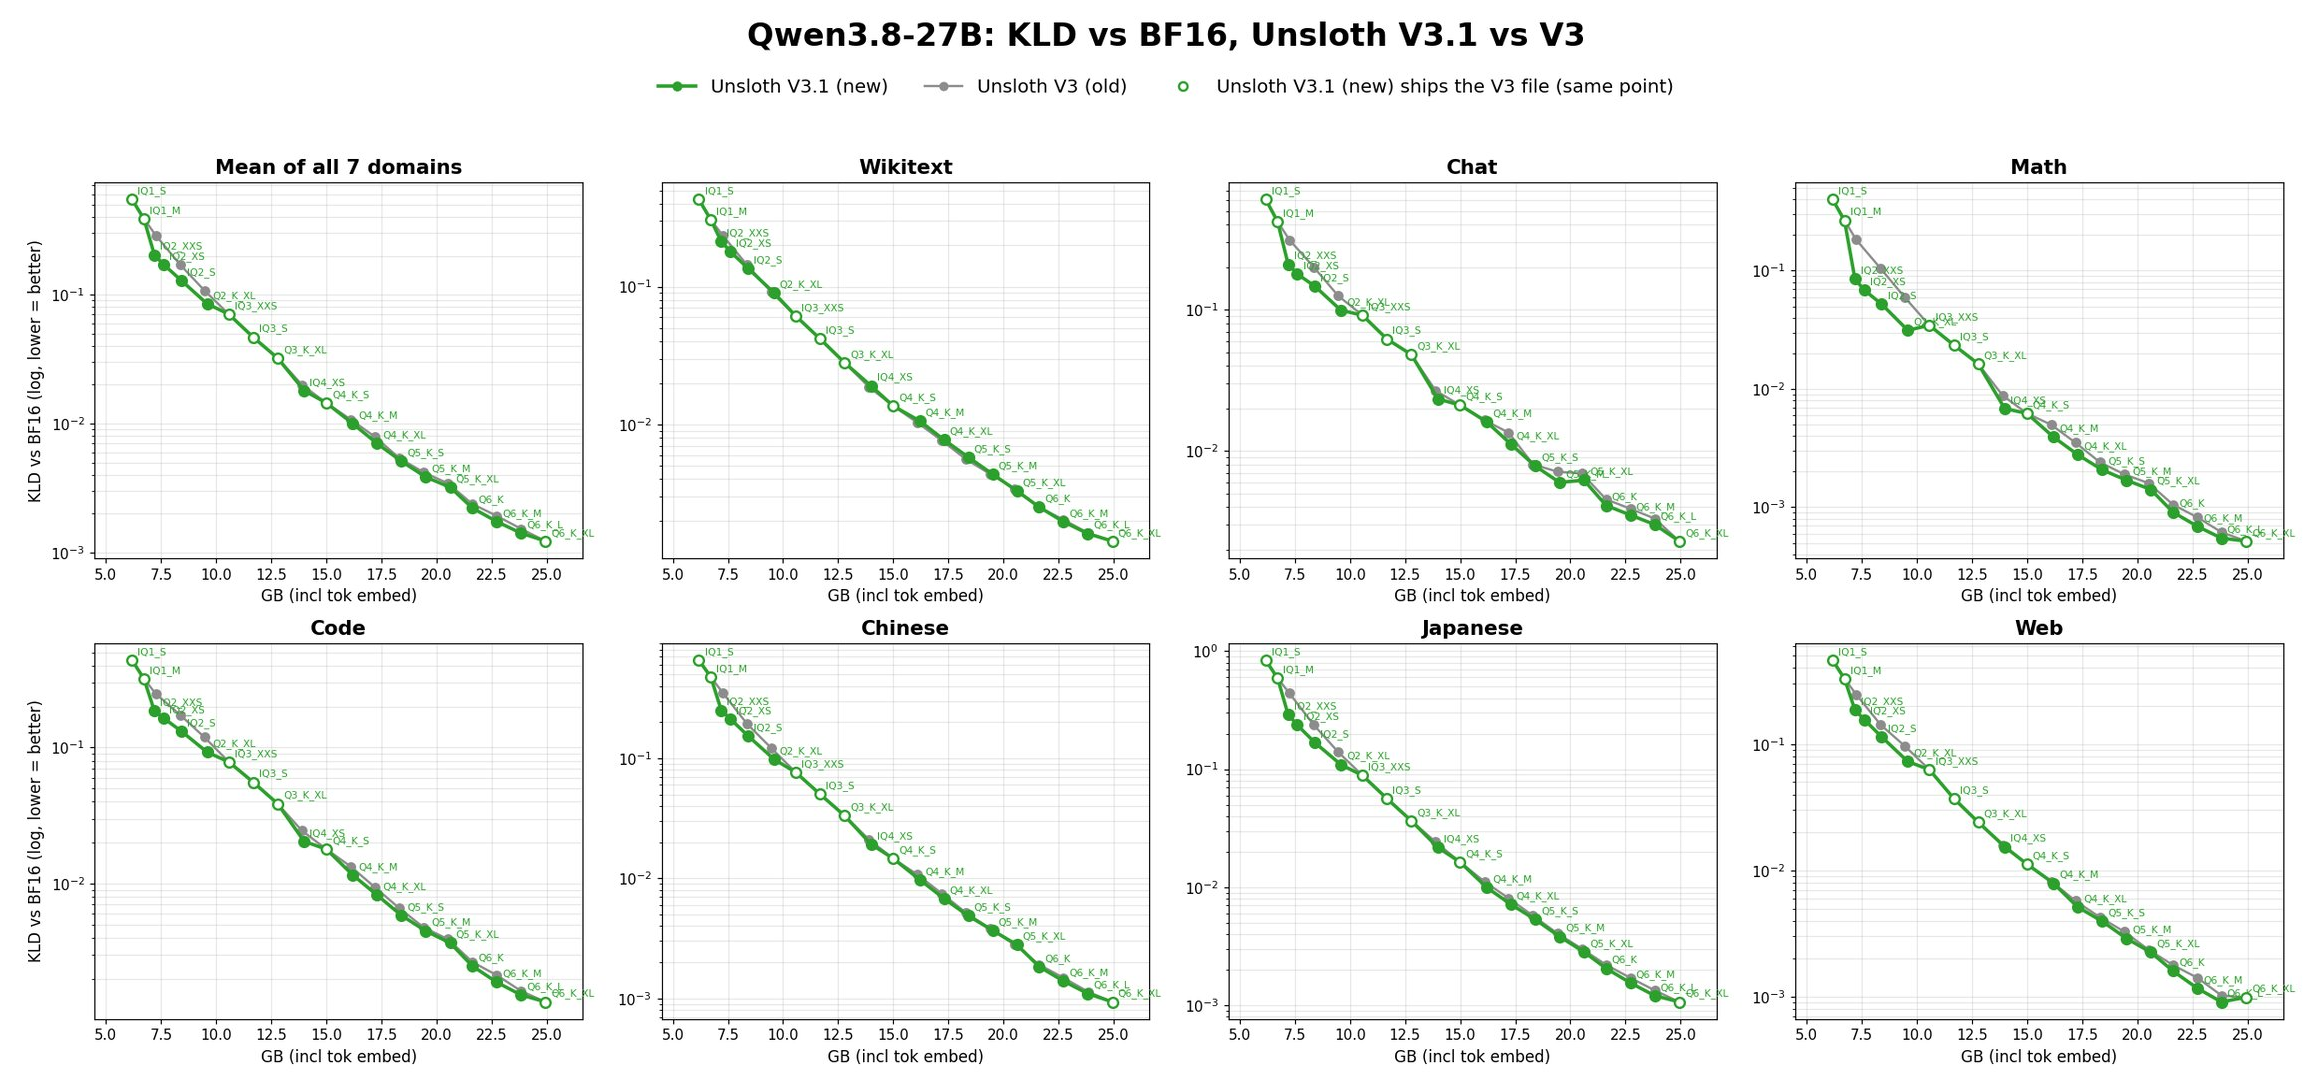 다양한 도메인에서 측정한 UD3와 UD3.1의 KLD 비교. 낮을수록 원본 모델의 출력 분포와 비슷하다. 출처: Unsloth
Qwen3.8-27B 벤치마크 성적과 실행 설정
Qwen3.8-27B 원본 모델은 코딩과 에이전트 벤치마크 전반에서 이전 세대인 Qwen3.6-27B와 Qwen3.7-Plus보다 높은 점수를 받았다. 특히 에이전트 코딩 과제인 DeepSWE 1.1에서는 42.2점으로, Qwen3.6-27B(13.3점)의 3배 이상이다. SWE-bench Pro(61.7점)와 QwenSWEBench(79.0점), 사무 작업 벤치마크인 CoWorkBench(70.7점)에서는 비교 대상인 Opus 4.6 Max보다도 점수가 높다. Unsloth와 Qwen이 공개한 주요 벤치마크 비교 수치는 아래 표와 같다.
| 분류 | 벤치마크 | Qwen3.8-27B | Qwen3.6-27B | Qwen3.7-Plus | Muse Glimmer-30B | Opus 4.6 Max |
|---|---|---|---|---|---|---|
| 코딩 | Terminal Bench 2.1 (Terminus) | 73.0 | 63.4 | 64.0 | 51.7 | 78.2 |
| 코딩 | SWE-bench Pro | 61.7 | 53.5 | 57.6 | 51.2 | 53.4 |
| 코딩 | NL2Repo-Bench | 42.3 | 36.2 | 41.1 | – | 47.6 |
| 코딩 | DeepSWE 1.1 | 42.2 | 13.3 | 14.2 | – | – |
| 코딩 | QwenSWEBench | 79.0 | 49.3 | 59.2 | – | 63.8 |
| 코딩 | LiveCodeBench v6 | 90.3 | 83.9 | 89.6 | – | 88.8 |
| 에이전트 | CoWorkBench (장기 사무 과제) | 70.7 | 61.0 | 65.1 | – | 68.2 |
| 에이전트 | JobBench (전문 직무 과제) | 33.4 | 21.8 | 27.6 | – | – |
| 에이전트 | Agents’ Last Exam (Pass@1 / Score) | 20.4 / 42.9 | 10.6 / 27.3 | 13.2 / 33.6 | – | – |
| 일반 | IFBench (지시 이행) | 79.5 | 69.1 | 79.1 | 77.0 | 62.5 |
| 일반 | GPQA Diamond (과학 추론) | 89.2 | 87.8 | 90.3 | 83.5 | 91.3 |
| 일반 | HLE (다학제 추론) | 30.8 | 24.0 | 34.7 | 22.0 | 40.0 |
Qwen3.8-27B는 Thinking 모드와 Instruct 모드를 모두 지원하는 하이브리드 모델이다. 아래 표는 로컬 실행에 필요한 양자화 비트별 메모리 요구량과 모드별 권장 샘플링 파라미터를 정리한 것이다. 메모리 요구량은 RAM과 VRAM을 합산하거나 통합 메모리를 기준으로 한다.
| 구분 | 세부 항목 | 값 / 요구 사양 |
|---|---|---|
| 메모리 요구량 | 1비트 / 2비트 / 3비트 | 7~8 GB / 9~11 GB / 12~14 GB |
| 메모리 요구량 | 4비트 / 6비트 / 8비트 / BF16 | 16~19 GB / 23~26 GB / 31 GB / 56 GB |
| Thinking 모드 설정 | temperature / top_p / top_k / min_p | 1.0 / 0.95 / 20 / 0.0 (presence_penalty=0.0, repetition_penalty=1.0) |
| Instruct 모드 설정 | temperature / top_p / top_k / min_p | 0.7 / 0.80 / 20 / 0.0 (presence_penalty=1.5, repetition_penalty=1.0) |
추론 강도 (reasoning_effort) | 지원 단계 | xhigh(기본값, 심층 분석), medium(균형), low(속도 및 비용 우선), none |
이전 대화 턴의 추론 내역(thinking trace)을 지우지 않고 유지하는 Preserve Thinking 옵션도 제공한다. 이를 활성화하면 사용하는 토큰 수는 늘어나지만, 다중 턴 대화에서 문맥을 더 잘 유지하고 정답률도 높아진다. unsloth run이나 llama-server에서는 --chat-template-kwargs '{"reasoning_effort":"medium"}' 플래그로 추론 강도를 조절할 수 있다. 오픈소스 데스크톱 앱인 Unsloth Desktop에서는 UI 토글로 Thinking 모드와 Preserve Thinking을 바로 전환할 수 있다.
Blackwell GPU를 위한 동적 NVFP4 양자화
RTX 50 시리즈, DGX Spark, B200, B300 등 NVIDIA Blackwell 아키텍처 GPU 사용자를 위해 Unsloth는 Qwen3.8-27B의 동적 NVFP4 양자화 모델도 함께 배포했다. 기존 NVFP4 구현체들이 가중치만 4비트로 줄이고 활성화 값(activations)은 16비트로 남겨 두었던 것과 달리, Unsloth의 동적 NVFP4는 활성화 값까지 4비트 연산으로 처리한다. 여기에 FP8 KV 캐시 보정(calibration)을 더해, 24GB VRAM 환경에서 BF16 체크포인트보다 2배 긴 컨텍스트를 약 1.5배 빠르게 처리한다.
NVIDIA B200 GPU 1장에서 측정한 배치 크기별 추론 속도(tokens/s)는 아래 표와 같다.
| 배치 크기 (Batch) | BF16 총 처리량 (tok/s) | NVFP4 총 처리량 (tok/s) | 가속 배율 | BF16 사용자당 속도 | NVFP4 사용자당 속도 |
|---|---|---|---|---|---|
| 1 | 89.8 | 133.7 | 1.49x | 89.8 | 133.7 |
| 8 | 649.4 | 938.8 | 1.45x | 81.2 | 117.3 |
| 32 | 1983.0 | 2787.0 | 1.41x | 62.0 | 87.1 |
| 64 | 3048.5 | 4407.2 | 1.45x | 47.6 | 68.9 |
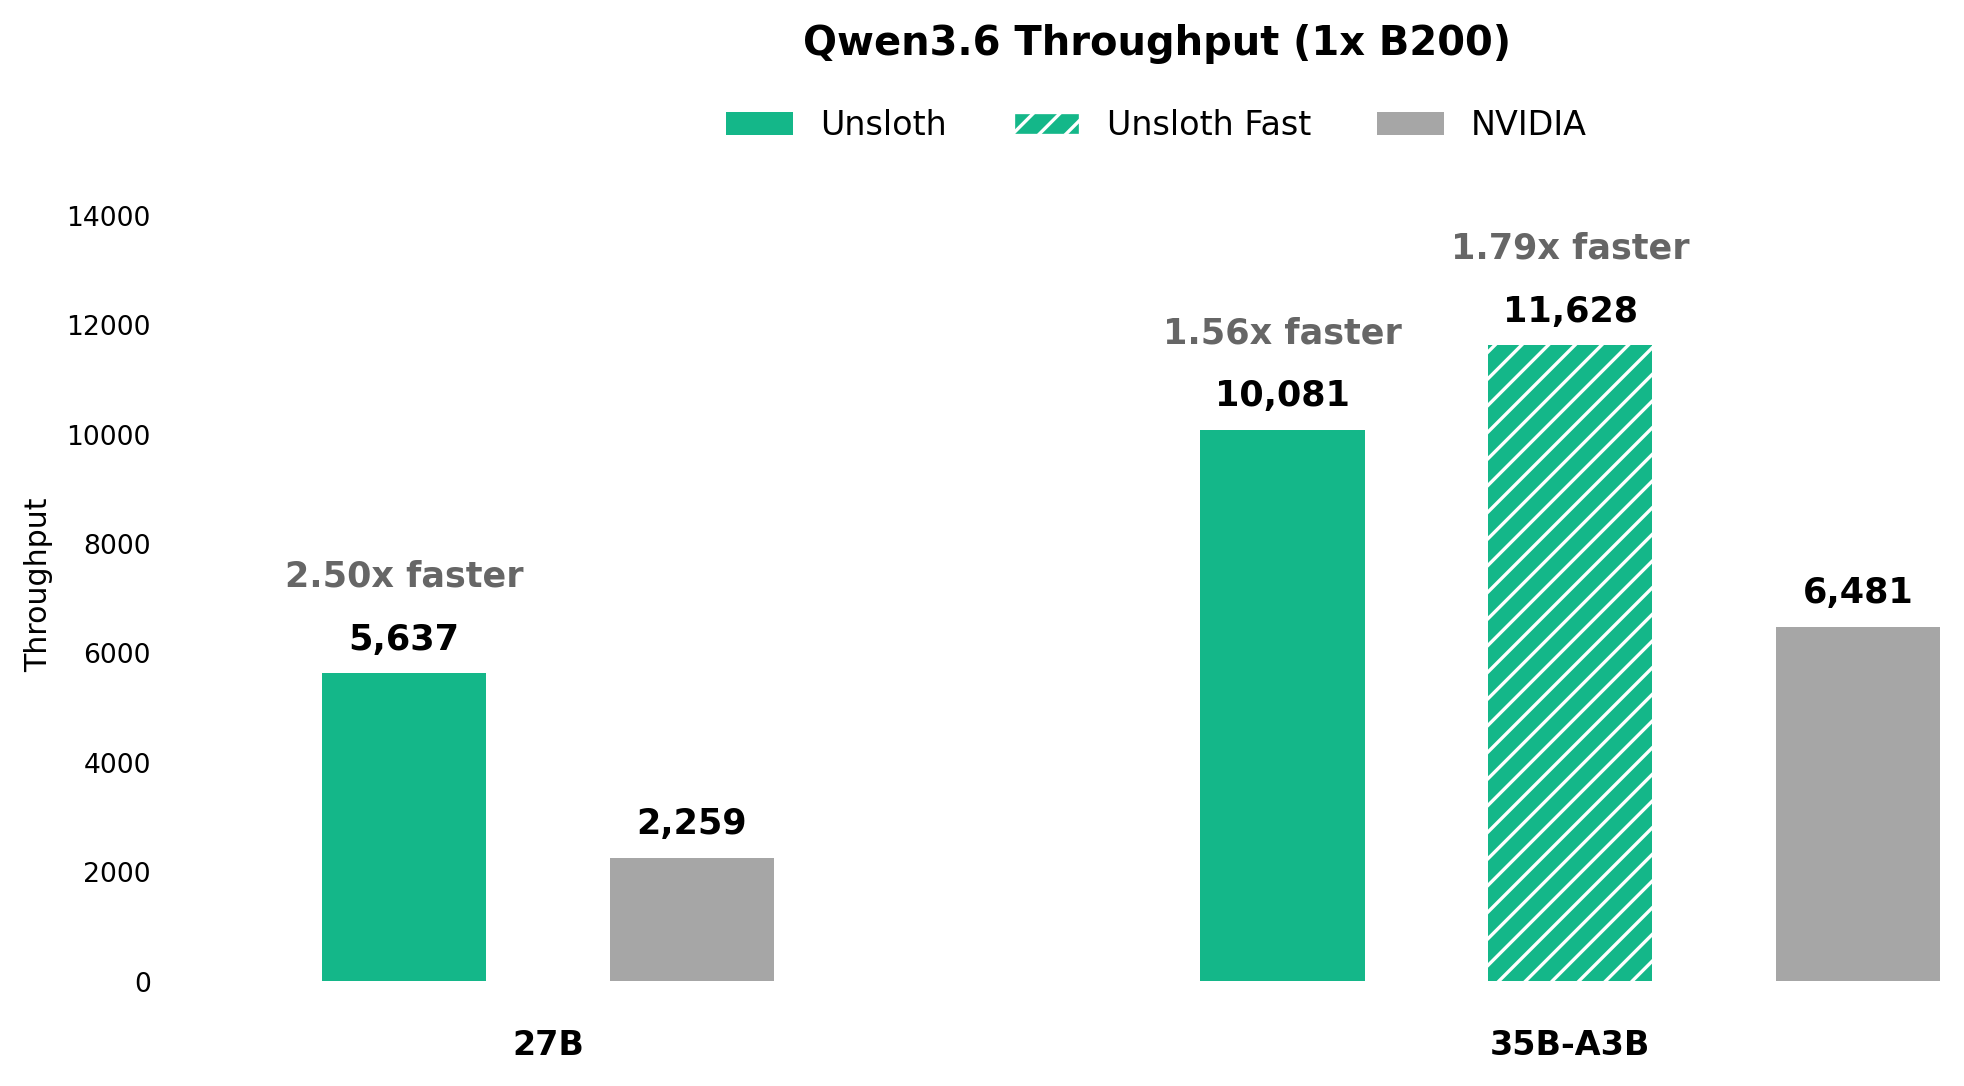 16비트 활성화를 쓰는 일반 NVFP4 구현체와 Unsloth 동적 NVFP4의 처리량 비교(Qwen3.6 기준 실측). 출처: Unsloth
코퍼스별 정확도 검증에서 NVFP4 모델은 BF16 원본과 비교해 92%에서 97%의 Top-1 토큰 일치율(agreement)을 유지했다. 코드 도메인은 96.68%(평균 KLD 0.02600), 참고문헌 생성(refgen)은 94.46%(KLD 0.03993)였다. 한국어, 일본어, 러시아어, 스페인어는 94%에서 95%(KLD 0.0124에서 0.0155), 중국어는 93.55%(KLD 0.01628), 일반 대화는 92.15%(KLD 0.05818)를 기록했다. NVFP4 모델은 vLLM 0.25.0 이상과 SGLang 0.5.19 이상에서 서빙할 수 있으며, 두 엔진 모두 MTP 투기적 디코딩(speculative decoding) 옵션을 지원한다4.
초대형 Qwen3.8-2.4T-A95B와 1.1875 bpw 신규 1비트 포맷
가이드 후반부는 초대형 MoE 모델 Qwen3.8-2.4T-A95B의 로컬 실행 방법을 다룬다. 이 모델은 총 파라미터가 2.4조 개이고 토큰당 활성 파라미터가 950억 개이며, GPT-5.6 Sol에 필적하는 성능을 목표로 설계됐다. Thinking 전용(thinking-only) 모델이고 최대 101만(1,010,000) 토큰의 컨텍스트를 지원한다.
BF16 무손실 원본의 용량은 4.9TB에 달해 일반 워크스테이션에서는 적재 자체가 불가능하다. Unsloth는 이를 해결하려고 세 가지 신규 데이터 타입을 고안했다5. llama.cpp의 기존 1비트 양자화 포맷인 IQ1_S(가중치당 1.5625비트)에서 코드북(codebook)의 항목 수를 단계적으로 줄여, 비트율을 세분화한 것이다.
| 데이터 타입 | HF 표기명 | 비트율 (BPW) | 코드북 (인덱스) | 블록 크기 | 2.4T 용량 |
|---|---|---|---|---|---|
IQ1_S (표준) | IQ1_S | 1.5625 | 2048 (11비트) | 50 B | 508 GB |
UD-IQ1_XS | TQ2_0 | 1.4375 | 1024 (10비트) | 46 B | – |
UD-IQ1_XXS | TQ1_0 | 1.3125 | 512 (9비트) | 42 B | – |
UD-IQ1_XXXS | Q1_0 | 1.1875 | 256 (8비트) | 38 B | 397 GB |
네 가지 1비트 포맷을 다른 대형 모델에 적용해 실측한 용량과 혼란도(PPL), KLD는 아래 표와 같다.
| 데이터 타입 | 용량 | PPL | KLD |
|---|---|---|---|
IQ1_S (표준) | 553.2 GiB | 2.58 | 0.565 |
UD-IQ1_XS | 513.6 GiB | 2.93 | 0.690 |
UD-IQ1_XXS | 474.0 GiB | 3.54 | 0.876 |
UD-IQ1_XXXS | 434.3 GiB | 4.49 | 1.110 |
압축률이 가장 높은 UD-IQ1_XXXS(Q1_0)를 적용하면 4.9TB였던 Qwen3.8-2.4T-A95B가 397GB로 줄어든다(원문 표기 기준 91% 축소). Unsloth는 이 모델을 양자화 인식 학습(QAT)이나 증류(QAD) 없이 사후 양자화(PTQ)만으로 만들었다.
450GB 이상의 통합 메모리 또는 RAM+VRAM을 갖춘 환경에서는 디스크 오프로딩 때문에 생기는 병목 없이 구동할 수 있다. B200 GPU에 모델을 온전히 적재하면 단일 스트림에서는 초당 약 20토큰을 생성하고, 여러 요청을 동시에 처리할 때는 초당 120토큰 이상을 처리한다. UD-IQ1_XXXS 포맷을 llama.cpp에서 직접 실행하려면 Unsloth가 새 코드북 크기를 지원하도록 패치한 iq1-narrow 브랜치(PR 61번)를 클론해 빌드해야 한다.
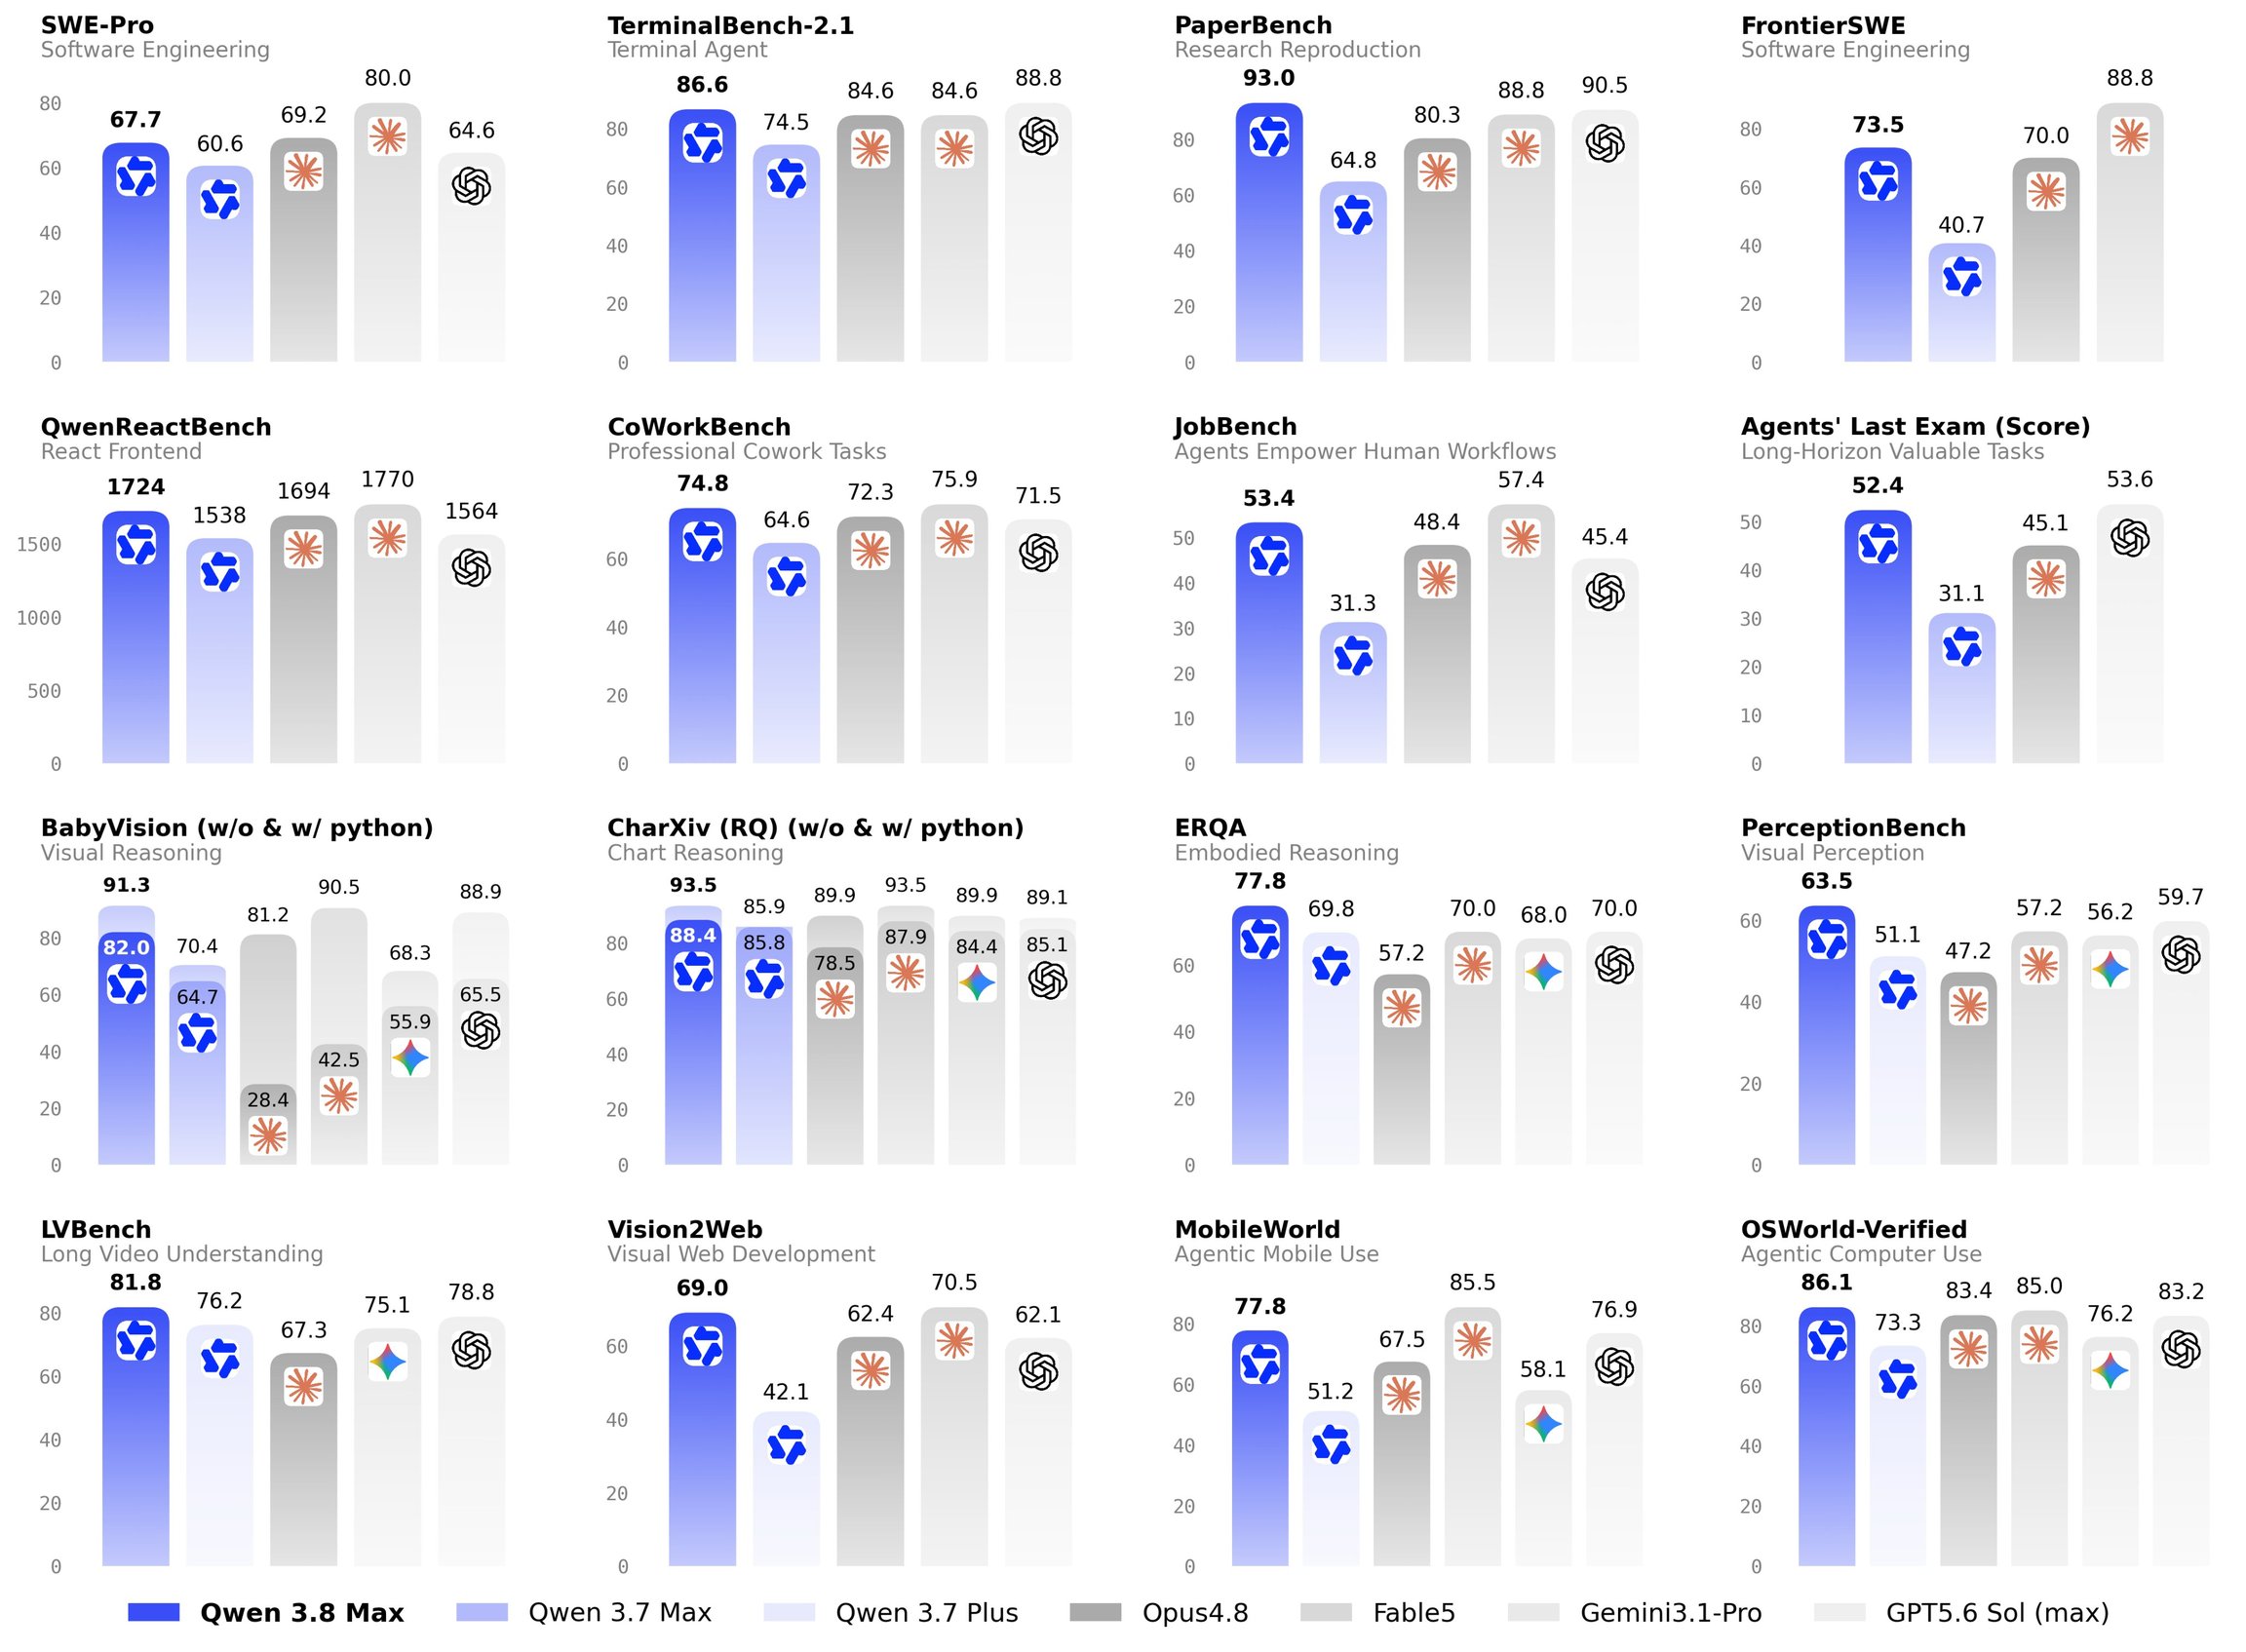 Qwen3.8-2.4T-A95B의 주요 벤치마크 성적. 출처: Unsloth / Qwen
가장 흥미로운 지점
나는 이번 가이드를 읽으며 Unsloth가 외부 양자화 연구(ISTA GSQ-RCO와 Exllama-v3)의 벤치마크 수치를 직접 재현해 반박한 실험을 가장 흥미롭게 보았다. 양자화 논문이나 기술 블로그에서는 흔히 자체 기법에 유리한 측정 조건을 전제로 평가 결과를 제시하곤 한다. Exllama-v3와 비교할 때 BF16으로 남겨 둔 토큰 임베딩 레이어의 용량을 가로축 계산에서 빼야만 순수 가중치 비교가 성립한다는 점이 한 예다. GSQ-RCO가 96K 컨텍스트 예산과 1회 실행 결과만으로 정확도 회복률 100%를 주장한 것이 또 다른 예다.
Unsloth는 이를 반박하기 위해 컨텍스트 예산을 96K와 128K 두 조건으로 각각 측정하고, AIME25를 14회 반복 실행해 평균을 냈다. 추론형 모델(reasoning model)은 문제 난도가 높을수록 추론 토큰을 길게 생성하므로, 컨텍스트 예산을 96K로 제한하면 양자화 손실이 아닌 토큰 절단(truncation) 때문에 점수가 왜곡된다. 또한 GPU 연산의 비결정성 때문에 단일 실행 점수는 실행할 때마다 몇 퍼센트씩 달라진다. 로컬 LLM 생태계의 양자화 품질 검증도 과거처럼 단순히 비트 수를 얼마나 줄였는지를 따지는 단계에서, 장문 추론 시 원본의 확률 분포가 얼마나 보존되는지(KLD)와 다회 반복 실행에서도 결과가 재현되는지를 확인하는 수준으로 정밀해졌다.
출처
Unsloth, 「Qwen3.8 - How to Run Locally」, 2026-11-11.
기존 Dynamic V3.0의 3비트 모델(UD3)은 구버전 알고리즘만으로도 신규 UD3.1과 동등한 벤치마크 정확도 회복률을 보여 이번 업데이트에서 교체하지 않고 그대로 유지했다. ↩︎
Unsloth는 Exllama-v3가 토큰 임베딩을 BF16으로 유지하는 이유를 따로 조사하지는 않았다. 강하게 양자화된
lm_head에서 생기는 손상을 양자화하지 않은 임베딩 레이어가 보완했을 가능성이 있다고 추정한다. ↩︎Unsloth는 채점 도구인 Math Verify와 LightEval을 모두 교차 확인했고, 온도를 0으로 두는 그리디 디코딩(greedy decoding)으로도 여러 번 실행했다. 그래도 GPU 자체의 비결정성 때문에 100% 회복률은 재현되지 않았다고 밝혔다. ↩︎
SGLang에서는 Unsloth가 NVFP4 모델의
lm_head를 FP8로 양자화했으므로, 이를 불러올 수 있도록 커널 패치가 반영된v0.5.19이상 버전을 써야 한다. vLLM은CompressedTensorsW8A8Fp8커널로 이를 기본 지원한다. ↩︎Unsloth는 Hugging Face 리포지토리가 파일 형식을 자동으로 인식하는 데 문제가 있어, 실제 업로드한 파일명에
UD-IQ1_XS,UD-IQ1_XXS,UD-IQ1_XXXS대신 각각TQ2_0,TQ1_0,Q1_0을 썼다. ↩︎