3줄 요약
- 존스홉킨스 대학의 Prakhar Kaushik, Shravan Chaudhari, Ankit Vaidya, Rama Chellappa, Alan Yuille가 2025년 12월 arXiv에 올린 37쪽 논문이다. 논문은 같은 구조의 신경망이 학습 데이터, 과제, 초기값이 달라도 층마다 거의 같은 저차원 가중치 부분공간으로 수렴한다는 가설을 내세운다. 공개 모델 1,100개 이상을 분해해 이를 뒷받침했다.
- Mistral-7B LoRA 500개, ViT 500개, LLaMA3-8B 50개, GPT-2 177개, Flan-T5, SDXL LoRA 300개, 처음부터 학습한 ResNet-50 5개를 분석했다. 모든 경우에 층별 가중치의 분산 대부분은 상위 16개 안팎의 주성분에 몰려 있었다. 무작위 초기화 상태의 ViT 500개에서는 이런 쏠림이 없었다.
- 이 공통 부분공간에 모델을 투영하면 ViT 500개를 모델 하나와 계수 묶음으로 대체할 수 있다. 이때 메모리는 100분의 1 이하가 된다. 모델 병합에서는 기존 방법보다 정규화 정확도가 15퍼센트포인트 이상 높았고, 새 과제는 기저를 고정한 채 계수 1만 개만 학습해도 전체 학습과 몇 점 차이밖에 나지 않았다.
가설이 말하는 것
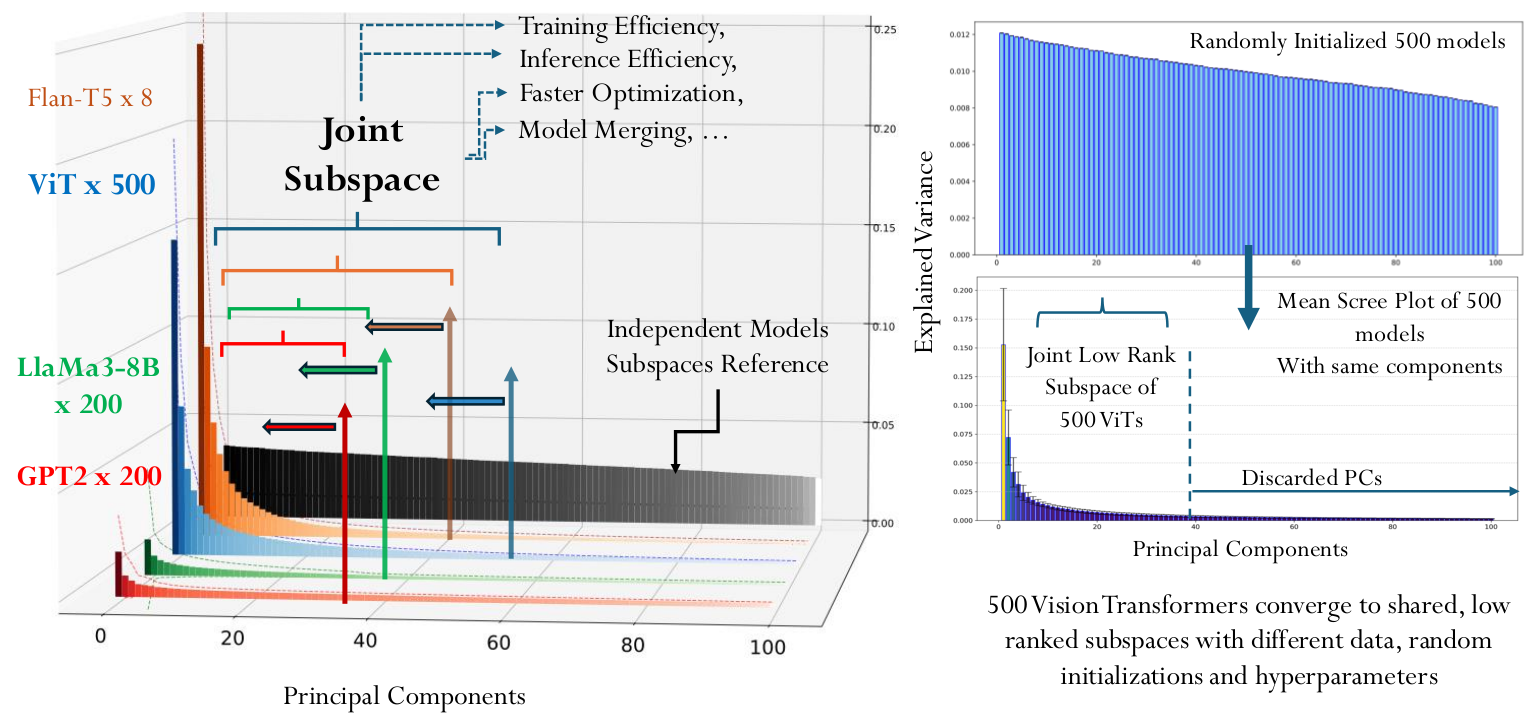
논문의 주장을 한 문장으로 옮기면 이렇다. 역전파로 학습한 신경망은 서로 겹치지 않는 데이터셋, 다른 하이퍼파라미터, 다른 초기값, 다른 정규화 방법으로 학습하더라도, 구조가 같으면 층마다 비슷한 저차원의 공동 부분공간 안에서 가중치를 배운다. 저자들은 이 공간을 Universal Subspace, 우리말로는 보편 부분공간이라고 부른다.
개별 과제는 겉보기에 저마다 다른 방향을 만드는 듯하다. 그러나 이 방향들을 모으면 유난히 낮은 랭크의 공동 부분공간 안에 모두 들어 있다. 이것이 관찰의 핵심이다. 연구진은 이 성질이 과잉 매개변수 모델이 왜 일반화하는지, 다른 초기값에서 출발한 모델이 왜 비슷한 표현에 도달하는지, 가중치 공유와 매개변수 효율적 미세조정이 왜 구조를 가리지 않고 통하는지를 설명하는 근거가 될 수 있다고 본다.
선행 연구와의 관계도 서론에서 정리했다. NTK 이론은 무한 폭 극한에서 학습 동역학이 과제와 무관한 커널로 정해진다고 본다. 기계적 해석가능성 연구의 보편성 가설, 복권 가설과 모드 연결성, 합성곱 첫 층이 과제와 무관하게 가보르 필터를 배운다는 2012년의 관찰도 같은 방향의 단서로 인용한다. 이 논문이 자기 기여로 구분하는 지점은, 앞선 연구들이 표현 수준의 보편성을 다루었다면 이 논문은 가중치 수준에서 대규모 실증을 처음 내놓았다는 데 있다.
부분공간을 뽑는 방법
분석 절차는 단순하다. 같은 구조로 학습된 모델을 최대한 많이 모은 뒤, 층별로 같은 위치의 가중치 행렬을 한 텐서로 쌓는다. 전체 평균을 빼서 영점을 맞춘다. 각 모드를 펼쳐 얇은 SVD를 구하고, 누적 설명 분산이 기준값에 도달할 때까지 왼쪽 특이벡터만 남긴다. 논문은 이 절차를 절단된 영점 중심 고차 SVD(HOSVD)라고 부르며, 논문 대부분의 실험은 1차와 2차까지만 쓴다. 1차 변형은 수학적으로 PCA와 같아서 torch.pca_lowrank나 scikit-learn의 PCA로 그대로 구현할 수 있다.
몇 가지 운용 규칙이 있다.
- 첫 층과 마지막 층은 분석에서 뺀다. 입력 형식과 출력 범주 수가 모델마다 달라 행렬 모양 자체가 다르기 때문이다.
- 상위 몇 개를 남길지는 스크리 플롯의 꺾이는 지점을 눈으로 보거나, 설명 분산이 0.01 미만인 성분을 버리거나, Gavish와 Donoho(가비시와 도노호)의 최적 특이값 임계값을 쓴다.
- 상위 k개 성분을 제외한 나머지는 보조 부분공간(Secondary Subspace)이라고 부르고 대조군으로 쓴다. 보편 부분공간이 정말 정보를 담고 있다면 보조 부분공간으로 복원한 모델은 성능이 크게 떨어져야 한다.
- 구조가 다른 모델의 부분공간을 비교할 방법이 아직 없어서, 모든 실험은 같은 구조의 모델 집합 안에서만 이루어진다.
모든 분석과 실험은 A5000 GPU 한 장으로 돌렸다. 부분공간 추출 자체는 CPU만으로도 되고, 학습 비용은 전혀 들지 않는다. 분석 대상이 전부 HuggingFace에 이미 올라와 있는 공개 모델이기 때문이다.
이론이 보장하는 것
2절은 이 관찰을 힐베르트 공간 위의 문제로 옮긴다. 과제마다 참 예측기가 하나씩 있다고 놓고, 과제 분포 위에서 예측기의 2차 모멘트 연산자를 정의한다. 이 연산자의 상위 k개 고유공간이 참된 공유 부분공간이다. 현실에서는 과제 수가 유한하고 과제마다 학습된 예측기도 참값과 다르므로, 학습된 예측기로 만든 경험적 연산자가 참 연산자에 얼마나 가까운지가 문제가 된다.
정리 2.5는 두 종류의 오차 상한을 제시한다. 연산자 노름 오차는 과제 수 T의 제곱근에 반비례하는 항과 과제별 추정 오차의 평균에 비례하는 항을 더한 값으로 나타난다. 고유값 간격이 0보다 크면 Davis-Kahan(데이비스-카한) 정리를 거쳐 부분공간 사영 사이의 거리에도 같은 형태의 상한이 붙는다. 과제가 많을수록, 과제별 학습이 정확할수록, 그리고 k번째와 k+1번째 고유값의 간격이 넓을수록 복원이 안정된다는 뜻이다. 연구진은 이 정리를 근거로 가능한 한 많은 학습 모델에서 주성분을 뽑는 쪽으로 실험을 설계했다.
실험 1: 처음부터 학습한 ResNet-50
첫 실험은 조건을 가장 엄격하게 통제한 실험이다. CIFAR-10, CIFAR-100, ImageNet, Oxford-IIIT Pets, EuroSAT 다섯 데이터셋으로 ResNet-50을 각각 무작위 초기화에서 학습했다. 샘플이 하나도 겹치지 않는 다섯 모델의 31개 층을 분해했더니 모든 층에서 16개 이하의 방향에 정보 대부분이 모였다.
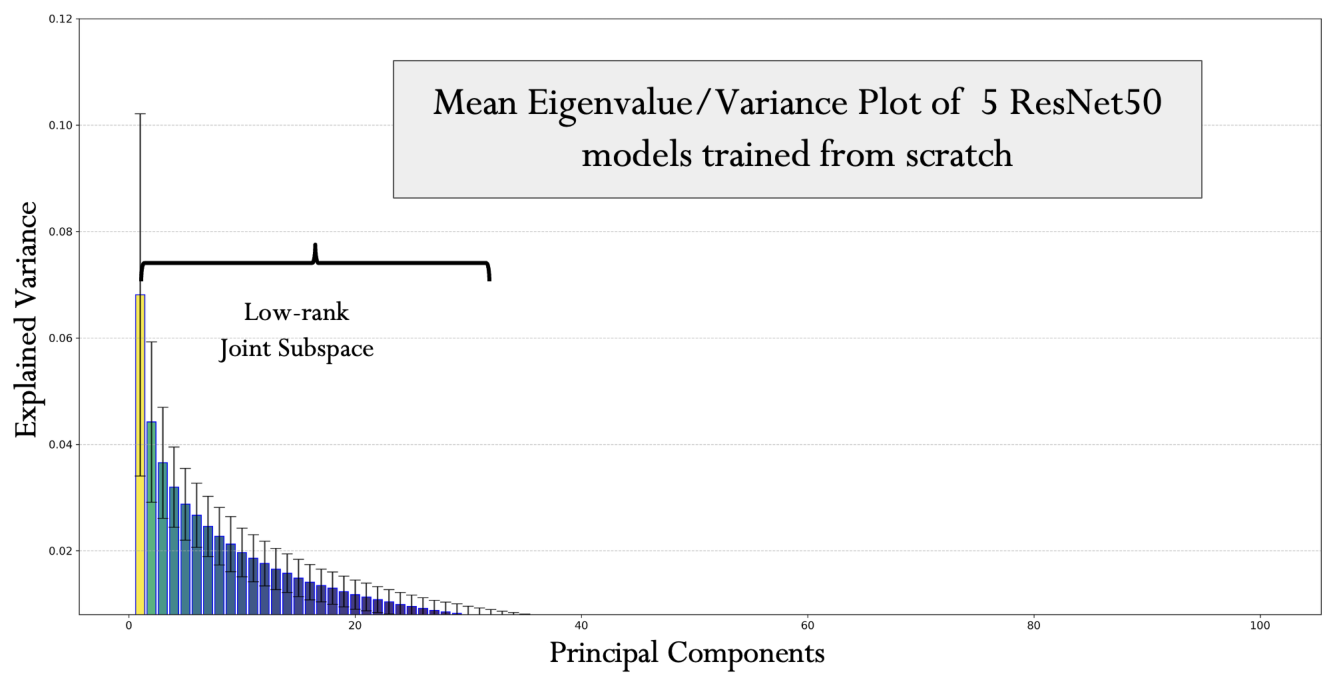
모델이 다섯 개뿐이라 이론이 예고한 대로 부분공간 추정은 거칠다. 그런데도 이 부분공간에 투영해 만든 저랭크 ResNet-50은 원 모델에 크게 뒤지지 않았다.
| 방법 | ImageNet | EuroSAT | CIFAR-10 | CIFAR-100 | Oxford Pets | 평균 |
|---|---|---|---|---|---|---|
| ResNet-50 | 80.86 | 98.96 | 97.35 | 83.82 | 93.48 | 90.89 |
| Universal R50 | 77.89 | 98.83 | 95.89 | 81.49 | 83.81 | 87.58 |
Oxford Pets에서 10점 가까이 떨어진 것이 눈에 띈다. 다른 네 데이터셋은 1~3점 차이다.
실험 2: Mistral-7B LoRA 500개
두 번째 실험부터는 공개 모델을 쓴다. LoRA를 고른 이유는 두 가지다. 공개된 수가 많고, LoRA 가중치는 원 가중치와 약하게만 정렬되어 과제 고유의 방향을 또렷하게 담기 때문이다. 논문은 이것이 가설을 가장 세게 시험하는 조건이라고 본다.
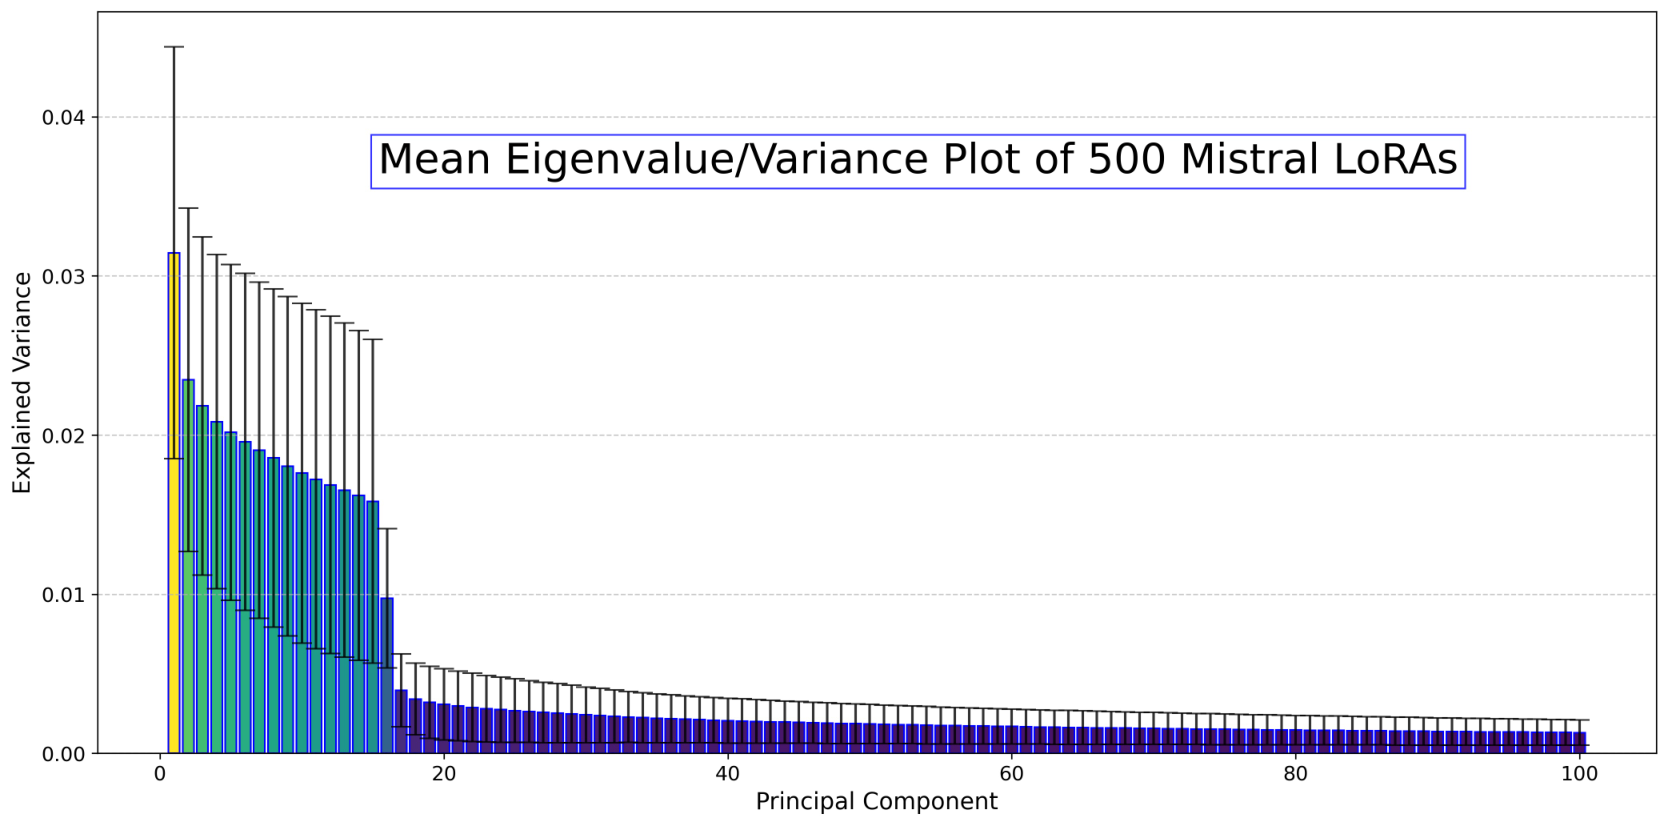
대상은 Mistral-7B-Instruct-v0.2 위에서 자연어 지시 과제 500개로 학습된 LoRA 모음(Lots of LoRAs)이다. 각 LoRA는 랭크 16 이상이다. 층마다 500개 LoRA의 B 행렬과 A 행렬을 각각 이어 붙여 분해했다. 여기에서도 모든 층에서 상위 16개 이하의 방향이 분산 대부분을 차지했다.
이 부분공간이 실제 표현력을 갖는지는 복원 실험으로 확인했다. 학습에 쓴 과제(IID)와 학습에 넣지 않은 과제(OOD)에서 LoRA를 골랐다. 보편 부분공간에 사영해 계수를 해석적으로 구한 뒤, 그 계수로 재구성한 모델의 ROUGE-L을 쟀다.
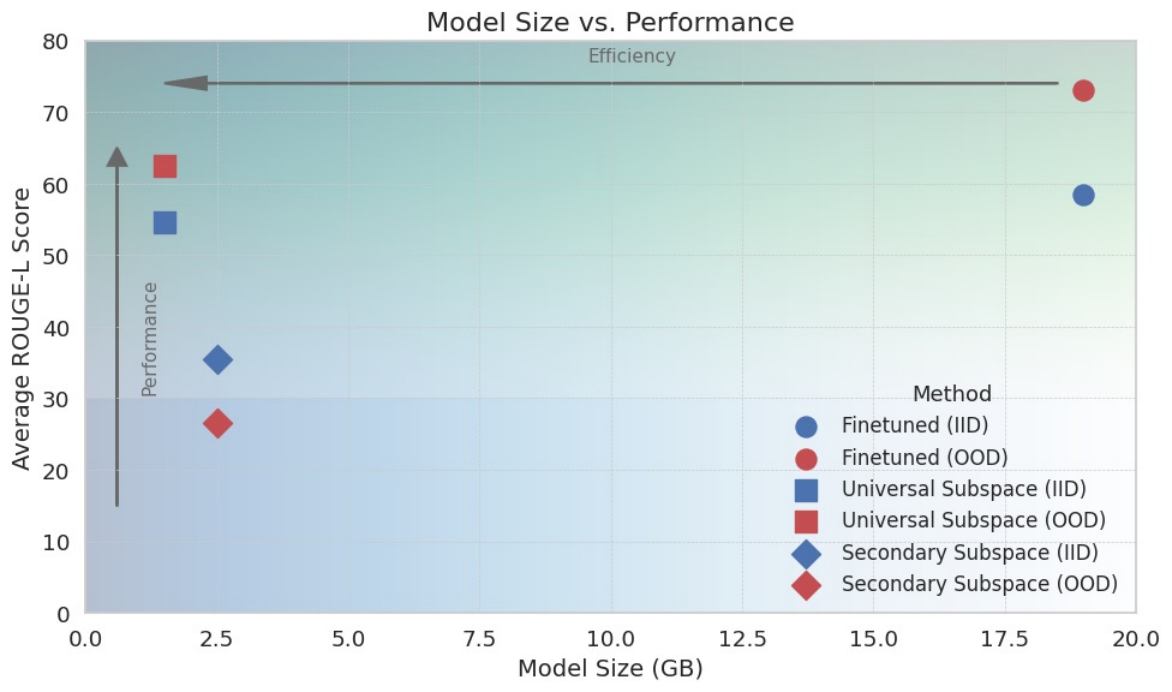
보편 부분공간 모델은 IID와 OOD 어느 쪽에서도 안정적으로 동작했고, 나머지 성분으로 만든 보조 부분공간 모델은 점수가 크게 뒤처졌다. LoRA 500개를 전부 저장할 필요가 없어지므로 메모리는 19분의 1로 줄어든다.
부록 B.3에는 모델 수를 늘려 가며 같은 실험을 반복한 표가 있다. OOD 과제 9개를 고정해 두고 나머지에서 무작위로 모델을 뽑아 부분공간을 만들었다.
| 부분공간 추출에 쓴 모델 수 | ROUGE-L |
|---|---|
| (원 모델) | 73.7 |
| 50 | 55.8 |
| 150 | 66.1 |
| 250 | 71.9 |
| 450 | 72.3 |
250개를 넘어서면 원 모델과의 차이가 2점 이내로 줄고, 그 뒤로는 모델을 더 넣어도 이득이 빠르게 줄어든다.
실험 3: SDXL 스타일 LoRA
같은 절차를 텍스트 투 이미지로 옮겼다. HuggingFace에 공개된 Stable Diffusion-XL 스타일 LoRA 약 300개에서 부분공간을 뽑고, 개별 LoRA를 그 안에 사영했다.
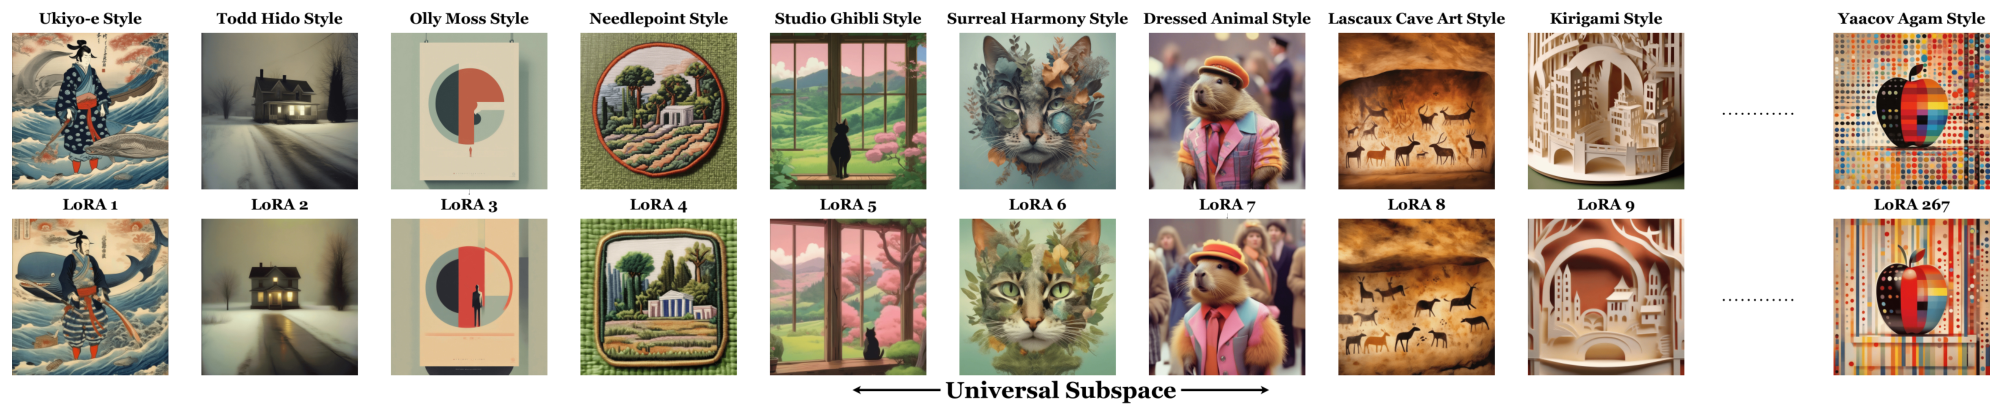
열 가지 스타일의 CLIP 점수 평균은 개별 LoRA가 19.73, 사영 모델이 19.83이었다. 사영한 모델이 도리어 조금 높았다. 논문은 저랭크 절단이 잡음을 제거하는 효과가 앞선 연구에서도 보고된 바 있다고 덧붙인다.
실험 4: 모델 병합
여러 모델을 하나로 합치는 문제에서는 기존의 그래디언트 없는 병합 기법 여섯 가지와 견주었다. 서로 다른 이미지 분류 데이터셋 8개로 각각 LoRA 미세조정한 ViT-B/32 8개를 하나로 합쳤다. 각 과제의 정확도는 개별 미세조정 모델 대비 비율로 보고했다.
| 방법 | Cars | DTD | EuroSAT | GTSRB | MNIST | RESISC45 | SUN397 | SVHN | 평균 |
|---|---|---|---|---|---|---|---|---|---|
| RegMean | 80.2 | 71.3 | 37.9 | 47.3 | 43.1 | 70.5 | 99.3 | 43.0 | 60.9 |
| Task Arithmetic | 82.0 | 73.6 | 48.8 | 42.1 | 53.1 | 71.5 | 97.5 | 41.2 | 63.7 |
| TIES | 82.4 | 72.8 | 50.8 | 39.0 | 50.3 | 70.9 | 99.4 | 40.5 | 63.7 |
| DARE-TIES | 81.4 | 74.5 | 50.8 | 39.2 | 55.0 | 70.7 | 96.7 | 40.4 | 63.7 |
| KnOTS-TIES | 82.7 | 73.7 | 49.3 | 48.9 | 70.9 | 95.5 | 53.8 | 68.0 | 68.0 |
| KnOTS-DARE-TIES | 81.8 | 75.9 | 50.7 | 40.3 | 53.2 | 70.2 | 97.9 | 41.0 | 63.9 |
| 보편 부분공간 | 88.1 | 82.3 | 65.9 | 61.3 | 88.3 | 98.1 | 98.5 | 85.1 | 83.5 |
평균은 83.5다. 두 번째인 KnOTS-TIES는 68.0으로, 차이는 15.5퍼센트포인트다. 논문은 비교 대상 기법들이 스케일 계수나 가지치기 확률 같은 하이퍼파라미터를 검증 데이터로 맞춰야 하는 반면, 부분공간 사영에는 그런 조정이 없다는 점도 함께 적었다.
실험 5: 전체 가중치에서도 같은가
LoRA는 원 가중치에서의 이동분만 담는다. 전체 가중치 행렬에서도 같은 구조가 나오는지 확인하려고 연구진은 HuggingFace에서 ViT-base-patch16-224 계열 사전학습 모델 약 500개를 모았다. 이 모델들은 의료 영상, 위성 사진, 합성 데이터 등 서로 다른 도메인을 다룬다. 손실 함수와 옵티마이저, 초기화도 다르다. 연구진은 별도 선별 없이 모델을 모았고, 원 학습 데이터에도 접근하지 못했다.
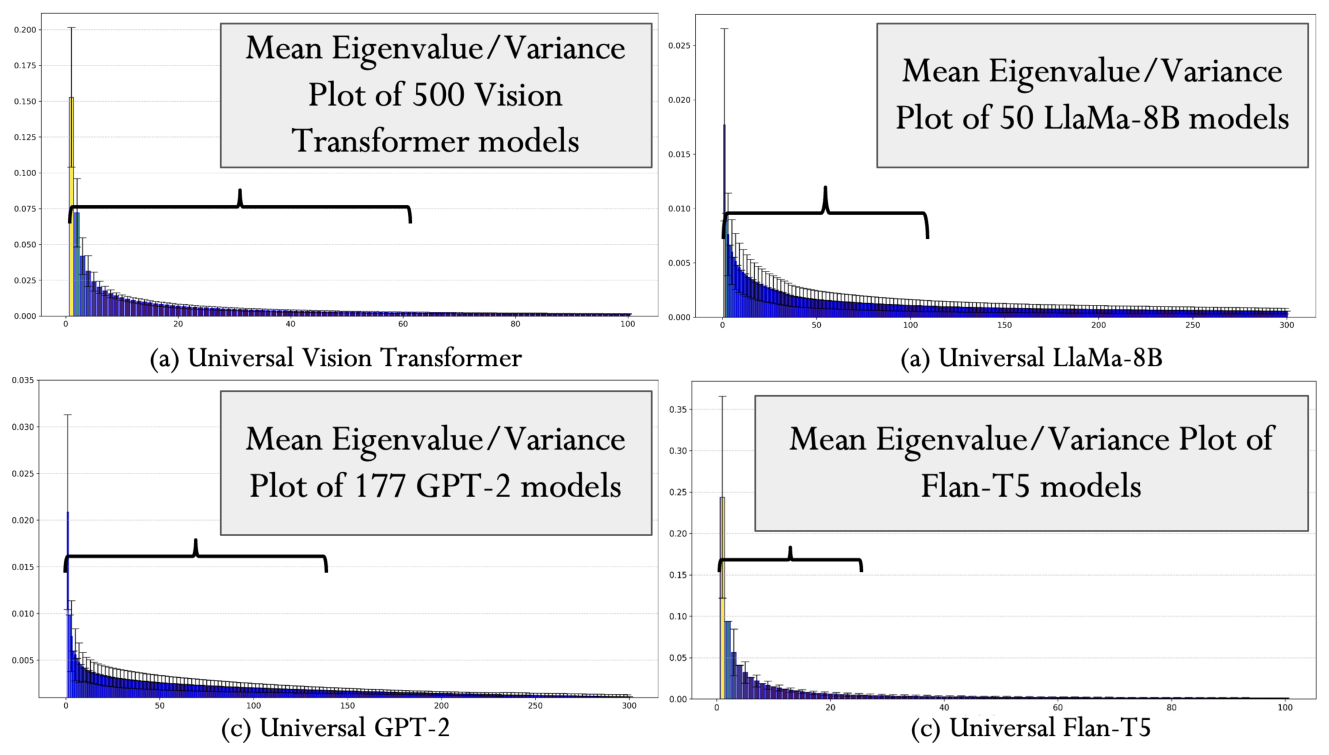
첫 층과 마지막 층을 뺀 모든 층에서 상위 소수 성분이 분산 대부분을 차지했다. 검증은 별도로 준비한 미공개 ViT 5개로 했다. 이 다섯 모델의 가중치를 16차원 보편 부분공간으로 복원했더니 정확도는 다음과 같았다.
| 방법 | IID | OOD |
|---|---|---|
| 전체 학습 | 94.4 ± 1.7 | 91.3 ± 2.1 |
| Universal ViT | 94.1 ± 2.0 | 87.8 ± 1.5 |
이 결과는 저장 공간 문제로 곧장 이어진다. 과제마다 다른 첫 층과 마지막 층을 제외하면 ViT 500개를 부분공간 모델 하나와 모델별 계수로 대체할 수 있다. 논문은 이것을 메모리 100분의 1로 계산한다. 원래 ViT 500개는 150GB, LLaMA 50개는 1.6TB를 차지한다. 500개의 ViT를 하나의 표현으로 합친 것은 자신들이 아는 한 처음이라고 밝혔다.
LLaMA3-8B 50개, GPT-2 177개, GLUE로 학습된 Flan-T5에서도 같은 감쇠가 관찰됐다. LLaMA 50개에는 의료 특화 모델, 다국어 대화 모델, 범용 어시스턴트, 탈옥 변형까지 섞여 있다.
실험 6: 새 과제를 계수만으로 배우기
마지막 실험은 뽑아 둔 부분공간을 새 과제에 다시 쓰는 방식이다. 이미 있는 모델들에서 뽑은 기저를 고정한다. 새 과제에서는 각 방향의 계수만 경사하강으로 학습한다. 계수는 선형 스케일 값이라 최적화도 매끄럽고 빠르다고 논문은 설명한다.
GLUE에서는 RoBERTa-base와 공개 LoRA 어댑터를 썼다. CoLA, MRPC, RTE, QNLI, SST-2, STS-B 여섯 과제를 차례로 하나씩 제외했다. 남은 어댑터로 부분공간을 만든 뒤, 제외한 과제의 계수를 학습했다.
| 방법 | 속도 | CoLA | MRPC | RTE | QNLI | SST-2 | STS-B | 평균 |
|---|---|---|---|---|---|---|---|---|
| LoRA | 1배 | 59.56 | 86.76 | 77.61 | 92.53 | 94.72 | 90.81 | 83.67 |
| Universal 2차 | 2배 | 61.82 | 87.25 | 77.62 | 92.71 | 94.15 | 90.48 | 84.01 |
| Universal 3차 | 1.8배 | 62.06 | 86.52 | 75.81 | 92.98 | 94.26 | 90.39 | 83.67 |
이미지 분류에서는 학습 데이터가 겹치지 않는 공개 ViT LoRA 4~5개에서 부분공간을 뽑고, 성분 4개만 남긴 뒤 8 에폭 동안 계수를 학습했다.
| 방법 | 학습 매개변수 | CIFAR-100 | Food101 | Flowers102 | CIFAR-10 | Pets |
|---|---|---|---|---|---|---|
| 전체 학습 | 8,600만 | 92.8 | 90.7 | 98.82 | 99.0 | 91.2 |
| Universal ViT | 1만 | 90.1 | 89.1 | 90.1 | 96.7 | 89.4 |
학습 매개변수 수는 8,600분의 1이다. Flowers102를 제외하면 3점 이내 차이다. 부록 C에는 더 오래 학습하거나 하이퍼파라미터를 맞추면 격차가 더 좁아질 가능성이 있다고 적혀 있다.
왜 생기는가, 무엇이 남았는가
4절에서 연구진은 원인을 아직 열린 문제로 두고 세 가지 후보를 든다. 첫째, 신경망의 스펙트럼 편향은 저주파 함수를 선호한다. 이 때문에 고유값은 다항식으로 감쇠하고, 학습 동역학은 소수 방향에 집중된다. 둘째, 구조 자체의 귀납 편향이 해 공간을 좁힌다. 합성곱은 국소적인 가보르형 패턴을, 어텐션은 반복되는 관계 회로를 선호한다. 셋째, 경사 기반 최적화는 무한 폭 극한에서 과제와 무관한 커널의 지배를 받는다. 이 최적화는 매끄러운 해를 선호해 여러 학습 궤적을 같은 기하학적 다양체로 모은다.
한계 절에서 스스로 밝힌 것은 다음과 같다.
- 층마다 뽑힌 주성분 방향이 무엇을 뜻하는지 해석하지 못했다.
- 부분공간을 만들려면 과제별로 학습된 모델이 먼저 있어야 한다. 데이터에서 직접 부분공간을 구할 수 있는 모델 독립적 방법은 향후 과제다.
- 태스크 산술에는 국소화된 고유함수가 필요하다는 기존 조건이 있다. 이 조건은 공유 부분공간과 잘 맞지 않아, 부분공간 안에서 태스크 산술을 수행하기 어렵다.
- 구조가 다른 모델끼리 부분공간을 비교하는 방법이 없다. 부분공간의 기하를 좋게 만들도록 구조를 설계할 수 있는지도 열린 질문이다.
- 연구진은 구조마다 “이상적인” 보편 부분공간이 있고 더 좋은 알고리즘과 데이터가 모델을 그쪽으로 더 가깝게 데려간다고 추측한다. 이 논문에는 이를 검증한 실험이 없다.
서론과 부록 D에는 같은 질문이 두 번 등장한다. 모든 모델이 같은 부분공간으로 수렴해 편향, 능력, 실패 양상까지 공유한다면, 현재 딥러닝 계열에는 다양성 부족이라는 근본적인 병목이 있는가. 이 수렴을 의도적으로 깨는 방법도 만들어야 하는가.
가장 흥미로운 지점
그림 1 오른쪽의 위아래 두 그래프는 대비가 뚜렷하다. 무작위 초기화 상태의 ViT 500개에서는 주성분 100개에 걸쳐 설명 분산이 거의 평평하다. 학습을 마친 같은 500개에서는 분산 대부분이 첫 몇 개 주성분에 모인다. 학습은 가중치를 넓은 공간 어딘가로 데려간다기보다, 수백 개의 다른 출발점을 같은 좁은 곳으로 끌어모은다. 데이터가 다르고 목적이 다른데도 그렇다.
정리 2.5의 수렴 속도는 과제 수 T의 제곱근에 반비례한다. 그러나 부록 B.3의 소거 실험 설명은 같은 정리를 인용하면서 O(1/T)라고 쓴다. 어느 쪽이 맞는지는 논문만으로 판단하기 어렵다. 표 12의 숫자만 놓고 보면, 250개를 넘긴 뒤 이득이 급히 줄어드는 곡선은 어느 쪽 해석과도 크게 어긋나지 않는다.
실용성은 모델 병합 표에서 가장 분명하게 확인할 수 있다. 하이퍼파라미터를 검증 데이터로 맞추는 기법들은 60%대에 머물렀고, 보편 부분공간 방법은 사영 한 번으로 83.5%를 기록했다. 이 논문의 다른 결과가 “공통 구조가 있다"는 관찰이라면, 이 표는 그 관찰이 이미 도구가 될 수 있음을 보여 준다. 다른 연구진이 이 표를 재현하는지가 다음 관문이다.
출처
- Prakhar Kaushik, Shravan Chaudhari, Ankit Vaidya, Rama Chellappa, Alan Yuille (Johns Hopkins University), “The Universal Weight Subspace Hypothesis”, arXiv:2512.05117, 2025년 12월 4일 (v2 기준 37쪽)
- 원문: https://www.alphaxiv.org/abs/2512.05117
- arXiv: https://arxiv.org/abs/2512.05117
- 프로젝트 페이지: https://toshi2k2.github.io/unisub/
- 본문 그림은 논문 arXiv HTML 판에서 가져왔다.