3줄 요약
- TypeSafe AI가 9월 15일 공개한 Jev는 자연어를 읽고 분류, 채점, 참 또는 거짓일 확률을 반환하는 모델이다. 답변 문장이나 코드를 생성하지 않는다.
- 고객 문의 분류, 검색 결과 재정렬, 에이전트 행동 검사처럼 소프트웨어가 반복해서 내려야 하는 판단에 적합하다. 개발자가 질문과 선택지를 정하고, 프로그램이 결과에 따라 후속 작업을 수행한다.
- 공개 요금은 입력 100만 토큰당 0.042달러이며 출력은 무료다. 현재 얼리 액세스로 제공하며, 발표한 속도와 성능은 회사 자체 평가에 근거한다.
무엇을 하는 모델인가
고객이 “결제가 두 번 됐으니 돌려 달라”고 문의했다고 하자. Jev에 문의 내용과 거래 내역을 보내면, 환불 요청인지, 중복 결제가 의심되는지, 어느 부서가 처리해야 하는지를 물을 수 있다. Jev는 각 질문에 숫자나 지정된 선택지로 답한다. 환불 조건과 한도를 확인한 뒤 실행하는 일은 프로그램이 맡는다.1
TypeSafe는 이런 모델을 System One Model이라고 부른다. 빠르고 직관적인 판단을 가리키는 인지심리학의 ‘시스템 1’에서 이름을 따왔다. Jev는 그 첫 공개 모델이다. 창업자 Diogo Almeida는 OpenAI에서 ChatGPT로 이어진 지시 학습 연구에 참여했다.2
Jev에는 세 가지 질문 형식이 있다.3
| 형식 | 묻는 내용의 예 | 반환하는 값 |
|---|---|---|
| Choice | 이 문의를 결제팀, 기술지원팀, 계정관리팀 중 어디로 보낼까? | 선택한 항목, 각 항목의 확률, confidence |
| Score | 고객이 얼마나 불만스러운가? ‘차분함’, ‘불만’, ‘매우 화남’으로 기준을 정한다 | 단계별 확률을 반영한 점수, 확률분포, confidence |
| Noul | 환불을 요구하는 문의인가? | ‘예’일 확률을 나타내는 0부터 1 사이의 값 |
개발자는 업무에 맞춰 선택지와 기준을 바꿀 수 있다. 매번 새 분류기를 학습시키는 대신, 자연어로 어떤 판단이 필요한지 설명해 호출하는 방식이다. 같은 자료에 대한 여러 질문은 한 요청에 넣을 수 있으며, 각 질문은 다른 질문의 답을 참조하지 않고 독립적으로 평가된다.4
‘LLM이 아니다’라는 설명
Jev는 토큰을 하나씩 생성해 문장을 완성하는 채팅 모델과 작동 방식이 다르다. TypeSafe는 새로운 구조와 병렬 샘플러를 사용해 여러 판단 결과를 한 번에 반환한다고 설명한다. 학습 방법은 RLCD, 즉 ‘보정된 판단을 위한 강화학습’이다.2
여기서 보정이란, 모델이 어떤 사건의 확률을 80%로 판단한 사례를 모았을 때 실제로도 그 사건이 약 80% 발생하도록 확률을 학습한다는 뜻이다. 특정 답변 하나가 맞는다고 보증하는 개념은 아니다.5
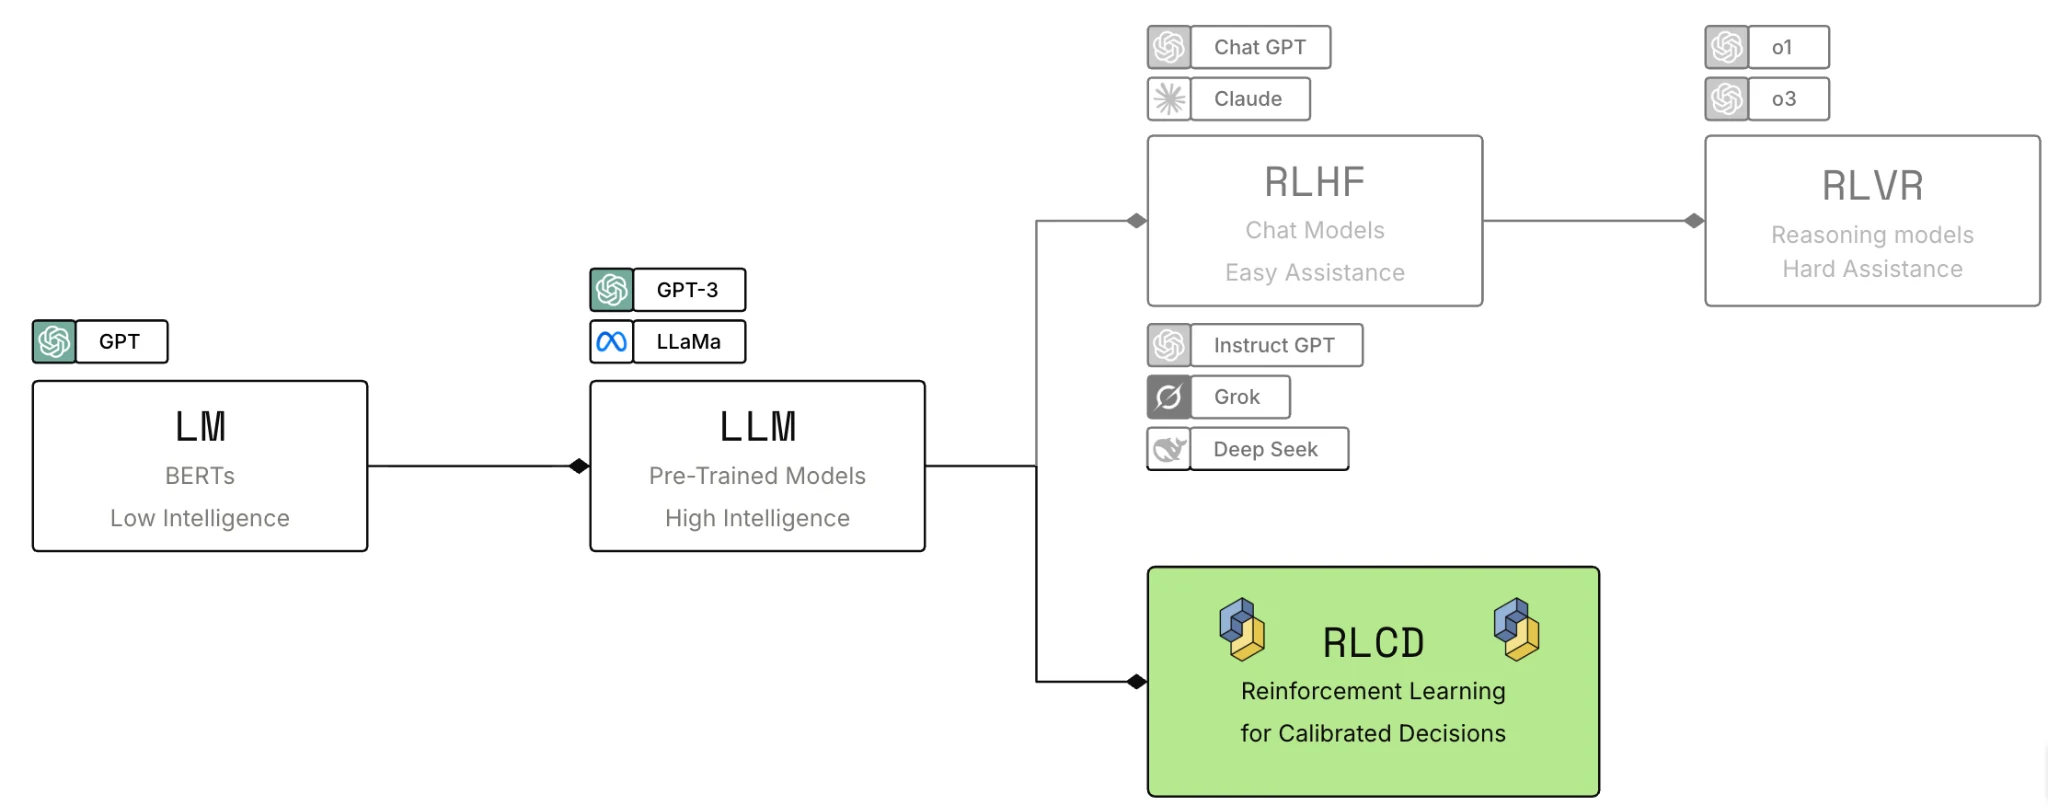
출처: TypeSafe AI Primer. TypeSafe가 설명하는 학습 방식의 개념도다.
공식 개발 문서는 RLCD를 사전학습 언어 모델에 적용하는 후처리 학습 경로로 설명한다. 따라서 “LLM이 아니다”라는 말을 언어 모델 기술과 무관하다는 뜻으로 읽으면 안 된다. Jev는 문장 생성 대신 정해진 형식의 판단과 확률을 반환하도록 학습됐다. 공개 자료만으로 내부 구조가 트랜스포머인지, 기반 모델의 규모가 얼마인지는 확인할 수 없다.5
Jev는 글을 쓰거나 번역하고, 코드를 작성하거나 판단 근거를 설명하는 기능을 제공하지 않는다. 긴 추론이 필요한 문제는 작은 질문으로 분해하고, 결과를 결합하는 규칙을 코드로 작성하라고 개발 문서는 안내한다.14
어디에 쓸 수 있나
공식 문서는 분류에서 검색, 에이전트 검사까지 구체적인 구현 예시를 제공한다.6
| 용도 | Jev에 맡기는 판단 | 프로그램이나 다른 모델이 맡는 일 |
|---|---|---|
| 고객지원 | 문의 종류, 긴급성, 불만 정도 | 담당 부서 배정, 답변 작성, 환불 정책 적용 |
| 검색과 RAG | 검색한 문서가 질문에 얼마나 관련 있는지 | 후보 검색, 순위 정렬, 최종 답변 생성 |
| 에이전트 감시 | 작업 기록에 정책 위반이나 위험 행동이 있는지 | 경고, 중단, 사람에게 검토 요청 |
| 문서에서 값 추출 | 찾아낸 금액이나 이메일 주소 중 어느 것이 필요한 값인지 | 정규식으로 후보 찾기, 원문 복사, 형식 변환 |
| 도구 선택 | 등록된 기능 중 어떤 기능을 호출해야 하는지 | 인자 검증, 권한 확인, 실제 도구 실행 |
문서에서 값을 추출하는 예시가 특히 구체적이다. 먼저 정규식으로 청구서에 적힌 금액을 전부 찾는다. 그다음 Jev에 “이 중 최종 결제 금액은 무엇인가?”를 묻는다. 프로그램은 선택된 금액을 원문 그대로 복사한다. Jev가 숫자를 다시 작성할 필요가 없으므로 숫자 일부를 잘못 생성하는 오류를 피할 수 있다. 그렇지만 최종 결제 금액 대신 소계를 고르는 오류는 발생할 수 있다.7
게임 데모도 있다. 회사는 Doom의 상태를 텍스트 형태로 전달하고, Jev가 행동을 고르게 했다. 초당 약 10회 호출할 때 비용은 시간당 약 7달러였다고 한다. 화면을 보고 플레이한 데모는 아니며, 회사도 일반적인 비AI 봇이 더 잘할 수 있다고 설명했다.2
게임에 응용한다면, 현재 상황을 설명하고 ‘추격’, ‘엄폐’, ‘후퇴’처럼 미리 구현한 행동 중 하나를 고르게 하는 방식을 생각할 수 있다. 이것은 데모에서 유추한 활용 예다. 캐릭터의 대사 생성이나 매 프레임의 이동 제어까지 Jev가 대신한다는 의미는 아니다.
어떻게 사용하나
9월 16일 확인 기준으로 Jev는 얼리 액세스 중이다. 대기 명단에 등록한 사용자에게 순서대로 접근 권한을 준다. 접근 권한을 받은 사용자는 Playground에서 자료와 질문을 넣어 시험할 수 있다.28
프로그램에 연결하는 과정은 다음과 같다.8
- TypeSafe 대시보드에서 API 키를 발급받는다.
- 판단에 필요한 자료를
state에 넣는다. 문자열이나 JSON으로 문의 내용, 계정 상태, 관련 정책을 전달한다. questions에 Choice, Score, Noul 질문을 정의한다. 선택지와 채점 기준도 여기에 포함한다.https://api.typesafe.ai/v1/systemone에 POST 요청을 보낸다. 문서의 기본 모델명은jev-latest다.- 반환된 판단과 확률에 따라 프로그램이 담당 부서를 정하거나 검토를 요청한다.
Python SDK는 pip install typesafe-sdk, JavaScript SDK는 npm install @typesafe-ai/sdk로 설치한다. 공식 빠른 시작 문서에 API와 Python 호출 예제가 있다.9
여러 조건이 필요한 업무는 조건별로 묻는 편이 좋다. 환불 업무에서는 “환불을 요청했는가?”, “중복 결제의 근거가 있는가?”, “정책상 예외 검토가 필요한가?”라는 세 질문을 함께 보낸다. 거래 금액과 승인 권한은 코드에서 확인한다. 앞에서 얻은 답을 다음 질문에 사용하려면 API를 다시 호출해야 한다.13
한 요청에는 자료와 모든 질문을 합쳐 약 3만 2,000토큰까지 입력할 수 있다. Choice 질문 하나에는 최대 255개 선택지를 넣을 수 있다. 현재 공개 API의 입력 형식은 텍스트와 JSON을 중심으로 한다.31011
비용은 얼마나 드나
공개된 요금은 입력 100만 토큰당 0.042달러, 출력 무료다. 10억 입력 토큰이면 42달러다. 같은 자료에 질문을 추가할 때에는 추가 질문에 해당하는 입력 토큰이 늘어난다.12
아래는 요청당 총 과금 입력량을 가정한 계산이다. 문서 본문뿐 아니라 질문, 선택지, 평가 기준을 포함한 입력량을 기준으로 한다.
| 요청당 입력 토큰 | 1,000회 호출 | 10만 회 호출 | 100만 회 호출 |
|---|---|---|---|
| 1,000토큰 | 0.042달러 | 4.20달러 | 42달러 |
| 5,000토큰 | 0.21달러 | 21달러 | 210달러 |
| 1만 토큰 | 0.42달러 | 42달러 | 420달러 |
같은 문서에 질문이 열 개라면 열 번 따로 호출하기보다 한 번에 질문 열 개를 보내는 편이 저렴하다. 개별 호출은 같은 문서의 입력 비용을 반복해서 내지만, 한 요청에 묶으면 문서를 한 번만 입력해 그 비용도 한 번만 내기 때문이다. 공식 예제에서는 GDPR 문서에 대한 질문 13개를 묶었을 때 개별 호출보다 비용이 12.2배 저렴했고, 처리 시간도 짧았다.12
이 가격은 Jev API 비용이다. 문서를 검색하는 서비스, OCR, 답변 생성용 LLM, 서버 운영 비용은 별도로 계산해야 한다. 무료 체험과 최소 결제 조건, 호출 한도는 계정 발급 때 별도로 확인할 필요가 있다.13
성능 수치를 어떻게 읽어야 하나
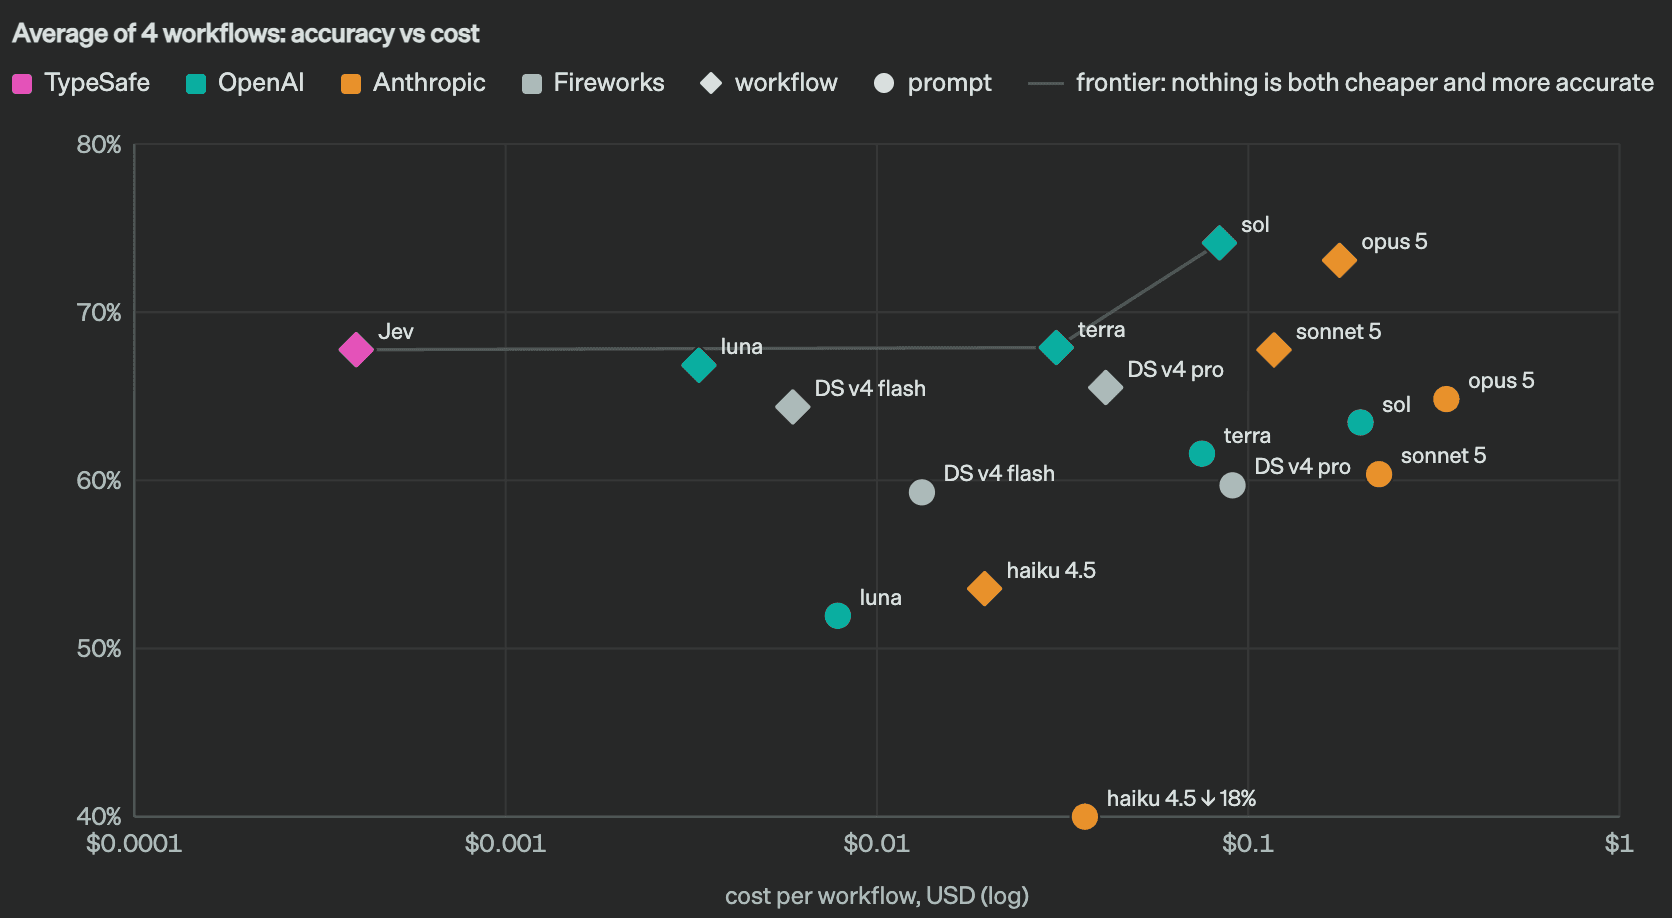
출처: TypeSafe Workflow Evals. 가로축은 로그 척도의 비용이며, 세로축은 이 평가의 기준 답안과 비교한 정확도다.
평가 대상은 보안 사고 대응, 에이전트 작업 기록 검사, 청구서 처리, 고객지원의 네 가지 업무다. 기준 답안은 GPT-6 Astra와 Claude Fable 5.1의 응답을 평균해 만들었다. 사람이 일일이 확정한 정답을 기준으로 삼지는 않았다. 평가에서는 모든 모델에 같은 업무 흐름을 적용했고, 각 질문의 결과를 코드에서 결합했다.14
따라서 그래프의 정확도를 모든 업무에서의 정답률로 해석하면 안 된다. Jev는 이 평가에서 가장 정확한 모델도 아니다. 상대적으로 저렴한 비용으로 상위 모델에 가까운 판단을 내렸다는 것이 회사가 내세운 결과다.14
발표에 적힌 193.6배의 속도 차이와 444.6배의 비용 차이도 이 자체 평가에서 나온 수치다. 회사는 실제 사용에서 얻을 수 있는 개선 폭의 상한에 가까운 값일 것으로 예상한다고 밝혔다. 응답 시간 70에서 500밀리초 역시 회사 발표치이며, 평가를 주로 서비스가 위치한 미국 서부에서 실행했다. 한국에서의 지연 시간과 한국어 업무 성능은 별도로 시험해야 한다.2
‘환각 0%’라는 표현도 뜻을 구분해야 한다. 회사가 여기서 보장하는 것은 스키마를 벗어난 출력을 만들지 않는다는 것이다. 거절해야 할 요청에 ‘승인’이라고 답할 수 있다. ‘승인’과 ‘거절’ 중 하나를 골랐으므로 형식 검사는 통과한다.151
confidence도 정답 확률과 같지 않다. Choice와 Score의 확률분포가 특정 결과에 얼마나 집중됐는지를 0부터 1 사이의 값으로 요약한 통계다. 이를 “0.9니까 90% 확률로 맞는다”라고 해석해서는 안 된다. 실제 업무 자료로 어느 값부터 자동 처리할지 검증해야 한다.16
먼저 시험해 볼 일
나는 이미 LLM으로 짧은 분류를 반복 처리하는 서비스라면 Jev를 비교해 볼 만하다고 생각한다. 기존 입력과 사람이 확인한 정답을 그대로 사용해, 분류 품질과 검토 요청 비율, 비용, 지연 시간을 함께 측정할 수 있기 때문이다. 특히 검색 결과의 관련성을 판단하거나 고객 문의를 담당 부서에 배정하는 작업은 출력 후보를 구체적으로 정의하기 쉽다.
처음부터 복잡한 업무 전체를 맡기기보다, 반복 횟수가 많은 판단 한 가지에 적용해 보고 싶다. 판단의 정확도가 충분하고 불확실한 사례를 구별할 수 있다면, 저렴한 호출 비용을 활용할 방법은 많을 것이다.
출처
TypeSafe AI, Diogo Almeida, 「Introducing System One Models & Jev」, 2026년 9월 15일. 공식 발표와 개발 문서를 9월 16일 확인했다. Jev API는 직접 호출하지 않았으며, 공개 자료를 조사해 썼다. 커버 이미지는 공식 발표에서 인용했다.
System One. 모델의 출력 범위와 판단을 코드에 결합하는 방법. ↩︎ ↩︎ ↩︎ ↩︎
TypeSafe 공식 발표. 출시 상태, 병렬 출력, 가격, 자체 평가의 주의사항, Doom 데모. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Primitives. 세 질문 형식, 병렬 평가, 약 3만 2,000토큰의 요청 예산. ↩︎ ↩︎ ↩︎
Introduction. 질문별 독립 평가와 작은 질문으로 업무를 구성하는 원칙. ↩︎ ↩︎
AI Primer. 사전학습 언어 모델의 후처리 학습과 확률 보정의 의미. 파라미터 수나 전체 아키텍처를 공개한 기술 보고서는 이번에 확인한 자료에 포함되어 있지 않았다. ↩︎ ↩︎
Pre-parsed Value Extraction. 정규식으로 후보를 찾고 모델이 선택하며 코드가 값을 복사하는 예시. ↩︎
API Reference. 입력 형식과 응답, 오류 코드. ↩︎
Parallel Questions.
jev-1.12의 2026년 9월 단가를 명시하고, 입력 토큰 수에 따른 비용과 질문을 묶을 때의 절감 효과를 계산한다. ↩︎ ↩︎공개 API 문서는 속도 제한 시 429 오류, 서버 과부하 시 529 오류와 재시도 방법을 안내한다. 분당 요청 수(RPM)와 분당 토큰 수(TPM)의 구체적인 한도는 제시하지 않는다. 무료 제공량과 최소 결제 금액도 이번에 확인한 공개 문서에는 없었다. ↩︎
Workflow Evals. 네 업무의 평균과 기준 답안 생성 방법을 공개한다. ↩︎ ↩︎
TypeSafe 홈페이지. Jev의 출력 방식과 ‘Zero Hallucinations’라는 소개 문구. ↩︎
Confidence. Choice와 Score의 confidence는 확률분포로부터 계산하며, Noul에는 별도 confidence 필드가 없다. ↩︎