3줄 요약
- Pluto는 Vegard Mella가 만든 스타크래프트: 브루드 워 AI다. Pluto는 파라미터가 3억 1,500만 개인 신경망 하나로 게임을 한다. 이 신경망은 셀프 플레이 강화학습으로만 만들어졌고, 스크립트 없이 세 종족의 경기 운영과 전투 컨트롤을 모두 맡는다. GitHub 저장소 tscmoo/pluto에는 소스 코드가 없고, README 한 장과 실행 파일 배포판 두 개만 공개되어 있다.
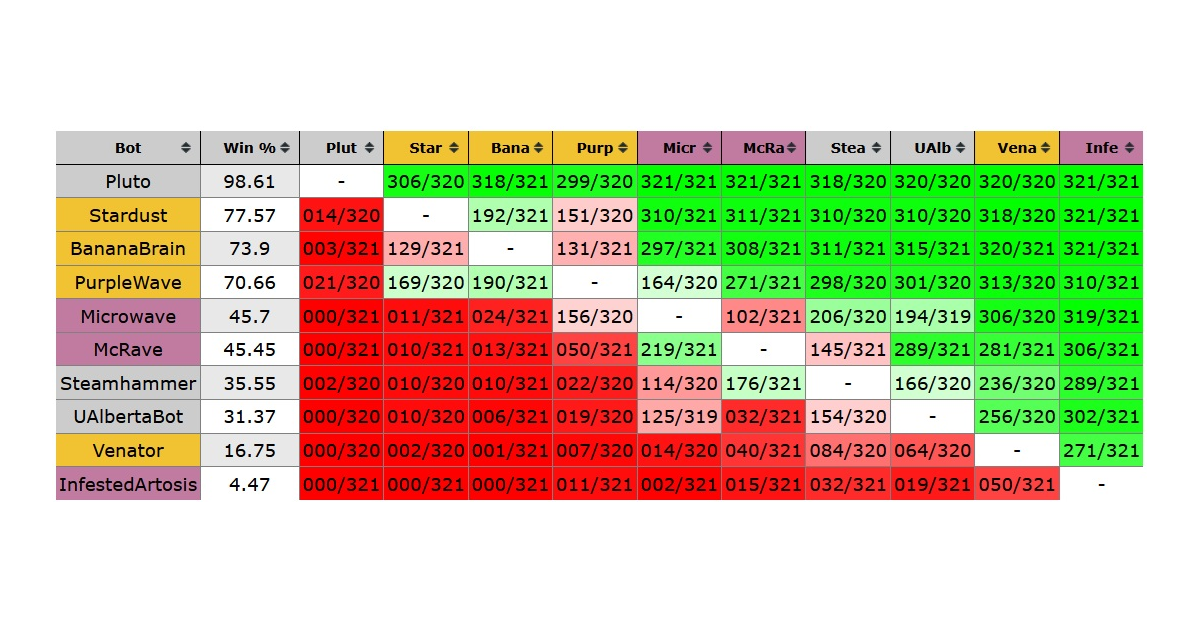
- Pluto는 2026년 8월에 열린 CoG 스타크래프트 AI 대회의 라운드 로빈에서 2,884경기 중 2,844경기를 이겨 승률 98.61%를 기록했다. 결승에서는 PurpleWave를 4 대 1로 이겨 우승했다. 대회를 주최한 David Churchill은 Pluto가 강화학습만으로 만들어져 대회에 출전한 첫 브루드 워 봇이라고 소개했다.
- 브루드 워 AI 커뮤니티에 따르면, 대회가 끝난 뒤 누군가 제작자의 허락 없이 Pluto를 개조해 스타크래프트: 리마스터에서 실행되게 만들었다. 이 봇은 공식 래더 1위를 기록하며 프로게이머들을 이겼다. 9월 23일 저장소에는 대회에 출전한 모델이 GPU 없이 CPU로 실행되는 배포판으로 공개됐다.
저장소와 배포판
저장소는 2026년 7월 16일에 만들어졌고, 파일은 README.md 하나뿐이다. 커밋은 첫 커밋과 README 수정 세 개를 합쳐 네 개다. README는 첫머리에서 이곳이 Pluto의 실행 파일 배포판을 공개하는 저장소라고 소개했다. 10월 1일 기준으로 저장소는 별 180개와 포크 30개를 받았다.
지금까지 공개된 배포판은 두 개이고, 표의 내려받기 횟수는 10월 1일에 확인한 값이다.
| 배포판 | 공개일 | 추론 장치 | 압축 파일 크기 | 내려받기 |
|---|---|---|---|---|
| beta-2247200 | 2026년 7월 17일 | NVIDIA GPU (CUDA) | 약 1.0GB | 304회 |
| cog2026-2578600 | 2026년 9월 23일 | CPU | 약 286MB | 2,442회 |
첫 배포판은 시험용 공개 베타였고, 실행하려면 Pascal 세대 이후의 NVIDIA GPU와 약 2.5GB의 GPU 메모리가 필요했다. 두 번째 배포판에는 CoG 2026 대회에 출전한 모델(md07x02_cog2026_2578600_int8mv)과 가중치, 추론 엔진이 그대로 들어 있다. 릴리스 노트에 따르면 이 모델의 파라미터는 3억 1,500만 개이고 int8로 양자화되어 있다. 추론 엔진을 CUDA용에서 CPU용으로 바꾸면서 용량은 1.1GB에서 0.3GB로 줄었고, BWAPI 모듈만 대회 뒤에 새로 빌드했다.
압축 파일을 풀면 파일 세 개가 나온다.
pluto.dll: 32비트 BWAPI 4.4.0 모듈. 스타크래프트가 봇으로 불러오는 파일이다.pluto/pluto_infer.exe: 64비트 CPU 추론 엔진.pluto/pluto_weights.bin: int8 가중치.
실행하려면 스타크래프트: 브루드 워 1.16.1과 BWAPI 4.4.0, 그리고 64비트 윈도우나 Wine이 필요하다. CPU는 AVX2를 지원해야 한다. README는 AVX-VNNI를 지원하는 CPU(인텔 12세대 이후, AMD Zen 5)를 강하게 권했는데, 추론 속도가 대략 두 배가 되기 때문이다. 권장 사양은 6코어 이상과 여유 메모리 약 2GB다. 봇은 저그, 테란, 프로토스, 랜덤 가운데 어느 종족으로 등록해도 된다.
제작자 Vegard Mella는 GitHub에서 tscmoo라는 이름을 쓴다. 그가 만든 같은 이름의 봇 tscmoo는 2015년 AIIDE 스타크래프트 AI 대회에서 승률 88.52%로 우승했다.1 당시 대회 보고서에 따르면 tscmoo는 열두 가지 가까운 전략을 갖추고 있었고, 파일 입출력으로 상대별 결과를 기록하면서 어떤 전략을 쓸지 학습했다.
모델과 학습 방식
Pluto의 구조와 학습 방식은 저장소 README보다, 대회 결과 페이지에 공개된 제작자의 설명서(PLUTO_README.txt)에 더 자세히 적혀 있다.
Pluto는 정책 신경망 하나로 게임을 한다. 제작자는 PPO 계열의 액터 크리틱 방식으로 이 신경망을 학습시켰고, 학습은 무작위 가중치에서 시작해 셀프 플레이로만 진행했다. 설명서는 사람의 리플레이, 모방 학습, 스크립트로 짠 동작, 외부 봇을 전혀 쓰지 않았다고 명시했다. 학습 경기의 두 플레이어는 언제나 같은 최신 가중치를 사용했다. 과거 체크포인트나 다른 상대와 대전시킨 적도 없다고 한다.
모델은 트리 탐색 같은 탐색 알고리즘을 쓰지 않고, 순전파 한 번에 행동 하나를 출력한다. 세 종족과 모든 종족 조합을 같은 가중치 하나로 플레이한다.
모델이 받는 정보
설명서에 따르면 입력 특징은 사람이 게임 화면에서 볼 수 있는 정보를 기준으로 설계했다. 다른 BWAPI 봇과 마찬가지로 전장의 안개가 적용되므로, 안개에 가린 유닛은 관측되지 않는다. 탐지되지 않은 은폐 유닛과 버로우 유닛도 일부만 드러난다.
Pluto에는 정찰 정보를 따로 기록하는 코드가 없다. 적 유닛을 마지막으로 본 좌표, 적의 확장 기지, 적의 테크를 따로 저장하지 않는다. 정찰로 얻은 정보를 기억하는 일은 신경망이 맡는다. 설명서는 신경망을 순환 구조로 만든 이유가 이것이라고 설명했다. BWAPI가 제공하는데도 일부러 입력에서 제외한 정보도 많다. 유닛 명령의 대상과 타이머, 마법 효과의 남은 지속 시간, 처치 수는 모델에게 전달되지 않는다.
업그레이드와 테크에도 같은 원칙을 적용했다. 사람은 유닛을 선택하면 공격력, 방어력, 보호막 단계를 읽을 수 있고, 이동 속도와 사거리는 유닛의 행동을 보고 추론할 수 있다. 제작자는 이런 업그레이드 정보를 유닛 특징에 포함했다. 반면 연구를 마친 테크는 입력으로 직접 주지 않는다. 시즈 모드, 버로우, 사이오닉 스톰 같은 기술은 연구가 끝나면 행동 마스크에서 사용 가능한 행동으로 바뀐다. 설명서는 이것을 명령 창에 버튼이 새로 생기는 일에 빗댔다. 상대의 테크는 상대가 그 기술을 쓰는 장면을 보고서야 알 수 있다.
모델은 6프레임마다 한 스텝을 진행하고, 스텝마다 다섯 종류의 입력을 받는다.
| 입력 | 내용 |
|---|---|
| 유닛 | 보이는 유닛마다 토큰 하나. 아군, 적군, 중립 유닛을 모두 포함한다. 종류, 소유자, 좌표, 속도, 바라보는 방향, 체력과 보호막, 쿨다운, 현재 명령, 상태 플래그(비행, 은폐, 버로우, 탐지 여부 등), 업그레이드 단계, 마법 효과, 운반 중인 자원이 포함된다. 아군 유닛에는 에너지, 생산과 연구 상태, 선택 여부, 부대 지정 정보가 추가된다. 사이오닉 스톰과 핵 조준점은 별도 토큰으로 추가한다. |
| 지도 | 건설 타일 기준 128×128 격자. 지형(이동 가능 여부, 높이, 건설 가능 여부, 엄폐), 크립, 안개 상태(한 번이라도 밝혀졌는지, 지금 보이는지), 점유 상태, 투사체와 스톰, 자원과 중립 건물의 크기 정보가 포함된다. |
| 전역 | 미네랄, 가스, 현재 인구수와 최대 인구수, 상대 종족, 경기마다 고른 빌드 오더를 나타내는 조건 벡터, 행동과 인자의 합법성 마스크. |
| 이력 | Pluto가 직전에 한 행동 네 개의 종류와 지도 좌표, 그 행동으로 명령하거나 겨냥한 유닛의 표시. |
| 기억 | 경기 내내 이어지는 순환 상태. GRU 은닉 상태와, 그보다 느리게 갱신되는 트랜스포머 메모리로 구성된다. 정찰로 얻은 정보는 이 기억에 저장되어야 한다. |
합법성 마스크는 관측 입력으로 주어지고, 행동을 샘플링하는 단계에서도 강제된다. 따라서 모델은 현재 선택한 유닛에게 합법적인 명령만 내릴 수 있다.
신경망은 다음과 같이 구성된다. 먼저 모델은 유닛 토큰의 임베딩을 지도 격자에서 그 유닛의 좌표에 해당하는 칸에 기록한다. 이어서 합성곱 인코더가 이 지도를 가로세로 8칸 크기로 축소한다. 유닛 토큰은 768차원 6층 트랜스포머가 처리하는데, 토큰마다 그 유닛의 좌표에서 추출한 공간 특징이 추가된다. 스텝 사이의 상태는 4096차원 GRU가 유지하며, 이 GRU는 유닛과 지도에 교차 어텐션을 수행한다. 느린 메모리는 128토큰짜리 캐시를 처리하는 트랜스포머다. 8스텝마다 GRU 상태가 이 캐시에 기록되고, GRU는 스텝마다 어텐션으로 캐시를 읽는다.
모델이 게임을 조작하는 방법
Pluto는 게임에 원래 있는 조작 방식을 그대로 쓴다. 유닛 선택이 독립된 행동이고, 이동이나 공격 같은 명령은 그 뒤의 스텝에서 내려져 그 시점에 선택된 유닛에게 적용된다. 사람과 다른 점도 있다. 한 번에 선택할 수 있는 유닛 수에 12기 제한이 없다.
Pluto는 한 스텝마다 행동 하나를 결정한다. 스텝은 6프레임마다 한 번 진행되므로, 행동은 초당 최대 네 번 정도다. 모든 명령은 그 결정의 근거가 된 관측 시점으로부터 4프레임 뒤에 실행된다. 여기에 스텝 간격 6프레임이 더해지므로, 새로운 상황에 반응하는 데는 4프레임에서 10프레임이 걸린다. 시간으로 환산하면 약 170밀리초에서 420밀리초다. 설명서는 모델이 이 반응 시간을 전제로 플레이하는 법을 학습했다고 적었다. 반면 사람이 받는 화면 시야의 제약은 없다. Pluto에는 가상 카메라가 없어서, 한 번이라도 밝혀진 지도 전체를 한꺼번에 관측하고 그 전체에 대해 행동할 수 있다.
행동은 다섯 개의 출력 헤드에서 차례로 샘플링된다. 모든 헤드에 합법성 마스크가 적용되고, 나중 순서의 헤드는 그 행동에 필요할 때만 쓰인다.
| 헤드 | 결정하는 것 |
|---|---|
| act | 무엇을 할지. 선택, 이동, 공격, 건설과 생산, 기술 사용, 부대 지정 등 |
| arg | 생산하거나 건설할 유닛 종류, 시작할 테크와 업그레이드, 애드온, 변태, 사용할 기술, 부대 번호, 선택할 유닛 수 |
| coarse | 대략의 좌표. 지도 전체를 8×8 칸으로 구분한 격자 |
| fine | 정확한 좌표. coarse 칸 하나를 다시 16×16으로 구분한 격자로, 둘을 합치면 건설 타일 기준 128×128 해상도가 된다 |
| target | 대상 유닛. 유닛 토큰을 가리키는 포인터로, 대상 지정 명령과 선택의 기준점에 쓰인다 |
학습 때 쓴 크리틱 가운데 실제 경기에서도 쓰이는 것은 작은 승률 예측 헤드 하나다. 이 헤드는 장기 기억을 읽어 승률을 예측하고, 그 예측으로 기권 여부를 정한다. 예측 승률이 0에 가까운 상태가 약 10초 동안 이어지면 Pluto는 채팅에 “gg"를 입력하고 게임에서 나간다.
보상 설계와 빌드 오더
설명서는 무작위로 초기화한 가중치가 스타크래프트에서 우연히 이기기를 기대하기는 어렵다고 설명했다. 제작자는 이 문제를 해결하려고 보상 형성 항목을 여러 개 마련했다.
| 보상 | 내용 |
|---|---|
| 점수 | 아군 유닛의 미네랄과 가스 비용 합계. 유닛을 생산하고 적 유닛을 파괴하면 보상이 생긴다. 학습 초기에 특히 중요한 주된 조밀 신호다. |
| 오프닝 | 주어진 빌드 오더를 대략 따르면 주는 보너스. |
| 다양성 | 드물게 등장한 유닛과 테크를 만들면 주는 작은 보너스. |
| 승패 | 경기가 끝날 때 이기면 +1, 지면 -1. 학습 후반에는 이 신호가 가장 강하다. |
모든 보상은 제로섬으로 적용된다. 한 플레이어가 보상 +x를 받으면 상대 플레이어는 정확히 -x를 받는다.
빌드 오더는 사람이 작성한 목록을 쓴다. 학습 중에는 고정된 가중치로 빌드 오더를 샘플링하고, 모델에게는 빌드 오더의 번호만 알려 준다. 그 빌드 오더의 구체적인 순서는 모델이 스스로 알아내야 한다. 빌드 오더를 따를 때 받는 보상이 강하지 않아서, 번호와 실제 플레이가 전혀 다를 수도 있다. 설명서에는 두 가지 예가 나온다. Pluto는 o:4Pool이라는 빌드를 받고도 9풀로 시작할 수 있다. CCFirst(커맨드 센터 먼저)를 받고도 배럭과 팩토리를 지은 다음에 확장할 수 있다. 설명서의 표현으로는 빌드 오더가 약하게 유도할 뿐 강제하지는 않는다.
실제 경기에서 어떤 빌드를 쓸지는 밴딧 알고리즘이 정한다. Pluto는 상대마다 pluto_bandit_<상대 이름>.txt 파일을 만들어 빌드별 승패와 상대 전적을 기록하고, 이 승패 기록으로 다음 경기의 오프닝을 고른다. 대회처럼 라운드를 여러 번 치르면, 라운드를 거듭할수록 상대마다 고르는 빌드가 달라진다. README에 따르면 사용자가 이 파일의 숫자를 고쳐 빌드 선택을 조정할 수도 있다. 파일에는 경기마다 JSON 기록이 한 줄씩 추가된다. 시작 기록에는 상대와 맵, 고른 빌드가 포함된다. 종료 기록에는 결과와 프레임 타이밍, 모델이 예측한 승률의 변화가 포함된다.
시간 예산과 오류 처리
게임이 시작되면 pluto.dll이 같은 폴더의 pluto_infer.exe를 실행하고, 공유 메모리를 통해 추론 엔진과 통신한다. 네트워크 연결은 전혀 하지 않고, 스타크래프트 폴더 밖의 파일에도 접근하지 않는다.
DLL은 프레임을 관측한 뒤 추론 엔진의 답을 최대 40밀리초 기다린다. 그때까지 답이 오지 않으면 다음 프레임에서 답이 올 때까지 기다린다. README는 이렇게 해야 모든 결정이 모델이 학습 때 예상한 시점에 정확히 실행된다고 설명했다. 따라서 CPU가 느리면 게임이 느려질 뿐 봇의 실력은 떨어지지 않는다. README에 적힌 측정값을 보면, 최신 데스크톱 CPU는 한 스텝을 약 20밀리초에 계산한다. 6코어 CPU인 i5-12500T는 지도에 유닛이 200기 있을 때 한 스텝에 약 60밀리초가 걸리고, 후반의 큰 교전에서는 그 세 배 가까이 걸린다. 지연이 오랫동안 이어지면 Pluto는 “Pluto: this machine can’t keep up"으로 시작하는 메시지를 채팅에 한 번 보내고, 경기 기록에도 남긴다.
대회용 빌드는 이렇게 동작하지 않았다. 대회용 빌드는 결정을 기다리지 않았고, 늦게 나온 결정은 더 나중 프레임에 실행했다. 대회용 설명서에는 Pluto가 프레임당 44밀리초의 예산을 지키려 하며, CPU가 이 예산을 지키지 못하면 플레이가 나빠질 수 있다고 적혀 있다. 설명서의 설명으로는, 명령이 4프레임보다 늦게 실행되거나 스텝을 건너뛰는 상황은 모델이 학습 중에 한 번도 겪지 않은 조건이다. 공개 배포판에서도 환경 변수 BWRL_STRADDLE=1을 지정하면 대회 때의 동작을 쓸 수 있다. README는 한 프레임에 55밀리초 제한을 두는 대회 관리 프로그램에서 시간 초과가 계속 나면 이 설정을 쓰라고 권했다.
추론 엔진이 시작되지 못하거나(파일 누락, 지원하지 않는 CPU) 경기 도중에 멈추면, Pluto는 채팅과 로그에 이유를 남기고 스타크래프트 프로세스를 종료한다. README는 이것이 충돌처럼 보이며, 일부러 그렇게 만들었다고 적었다. 오류는 오류로 다루어야 하고 경기로 셀 수 없다는 것이다. 그래서 엔진 장애는 패배로 기록되지 않고 충돌로 집계된다.
CoG 2026 대회 기록
CoG 2026 스타크래프트 AI 대회는 2026년 8월, 캐나다 메모리얼 대학교의 David Churchill이 주최하고 운영했다. 봇들은 브루드 워 1.16.1에서 BWAPI로 경기를 했다. 전장의 안개는 켜져 있었고 치트와 버그 악용은 금지됐다. 11개 봇이 등록했는데 한 봇이 기한 안에 제출하지 못해 10개 봇이 출전했다. 테란으로 등록한 봇은 하나도 없었다.
라운드 로빈은 정확히 일주일 동안 진행됐다. 경기에는 Crossing Field, Eclipse, NeoSylphid, Clay Fields, Gladiator, Retro 여섯 개 맵이 사용됐고, 전체 경기 수는 14,425경기였다. 순위는 상대 전적에서 승률이 50%보다 높은 상대 봇이 몇 개인지로 정했다. 1위와 2위는 7전 4선승제로 결승을 치렀다. 대회 보고서의 라운드 로빈 결과는 다음과 같다.
| 봇 | 제작자 | 종족 | 승 | 패 | 승률 | 이긴 봇 수 |
|---|---|---|---|---|---|---|
| Pluto | Vegard Mella | 랜덤 | 2,844 | 40 | 98.61% | 9 |
| PurpleWave | Dan Gant | 프로토스 | 2,037 | 846 | 70.66% | 8 |
| Stardust | Bruce Nielson | 프로토스 | 2,237 | 647 | 77.57% | 7 |
| BananaBrain | Johan de Jong | 프로토스 | 2,135 | 754 | 73.90% | 6 |
| Microwave | Micky Holdorf | 저그 | 1,318 | 1,566 | 45.70% | 4 |
| McRave | Christian McCrave | 저그 | 1,313 | 1,576 | 45.45% | 4 |
| Steamhammer | Jay Scott | 랜덤 | 1,025 | 1,858 | 35.55% | 4 |
| UAlbertaBot | David Churchill | 랜덤 | 904 | 1,978 | 31.37% | 2 |
| Venator | Kostiantyn Cherniakov | 프로토스 | 483 | 2,400 | 16.75% | 1 |
| InfestedArtosis | Brad Ewing | 저그 | 129 | 2,760 | 4.47% | 0 |
UAlbertaBot은 Churchill이 2015년 이후로 고치지 않은 봇이다. 그는 해마다 전체 수준을 비교하는 기준으로 이 봇을 출전시킨다. 사람이 플레이하는 속도로 환산하면 Pluto의 평균 경기 시간은 9분 43초로, 상위 네 봇 가운데 가장 짧았다. PurpleWave의 평균 경기 시간은 13분 8초였다. Pluto는 대회 내내 충돌이나 프레임 시간 초과를 한 번도 일으키지 않았다.
Pluto는 모두 40경기를 졌는데, PurpleWave에게 21경기, Stardust에게 14경기, BananaBrain에게 3경기, Steamhammer에게 2경기를 졌다. 나머지 다섯 봇에게는 한 경기도 지지 않았다. 맵별 승률은 Crossing Field에서 96.3%로 가장 낮았고, NeoSylphid에서는 481경기 가운데 480경기를 이겼다.2
결승은 8월 30일에 열렸다. Pluto는 Crossing Field에서 치른 1경기를 PurpleWave에게 졌지만, 이어서 Clay Fields, Gladiator, NeoSylphid, Eclipse에서 네 경기를 연달아 이겼다.
Churchill은 보고서에서 지난 몇 년 동안 Stardust, PurpleWave, BananaBrain을 위협할 새 봇이 나오지 않았다고 적었다.3 그리고 Pluto를 강화학습만으로 만든 봇 가운데 처음 대회에 출전한 브루드 워 봇이라고 소개했다. Pluto의 제출물은 약 300MB의 가중치 파일과, 그 가중치를 실행해 스타크래프트에 연결하는 실행 파일뿐이었다. Churchill이 더 감탄한 것은, 이 봇이 GPU 없이 대회의 표준 CPU 하드웨어에서 실행됐다는 점이었다. 보고서에 따르면 Vegard Mella는 자세한 내용을 다룬 논문을 가능한 한 빨리 낼 계획이다.
대회 뒤의 래더 사건
9월 18일 Churchill은 LinkedIn에 한 사건을 알렸다. 익명의 누군가가 Pluto를 개조해 새 클라이언트인 스타크래프트: 리마스터에서 실행되게 만들었고, 이 봇으로 경쟁 래더에서 사람들과 대전하고 있다는 내용이었다. 그 시점에 이 봇은 래더 1위였고, 프로게이머를 자주 이기고 있었다. Churchill은 대회가 블리자드의 허락을 받아 연구와 교육 목적으로 구판 브루드 워를 쓴다고 설명했다. 그러면서 대회의 개방성을 이렇게 이용하는 사람들이 있어 무척 우려스럽다고 했다.4 그는 블리자드에 연락해 상황을 설명하고 래더에서 봇을 막을 방법을 제안하려 했지만, 아직 답을 받지 못했다고 밝혔다.
9월 21일 Dexerto는 브루드 워 AI 커뮤니티의 말을 인용해 이 사건을 보도했다. 기사에 따르면 이 봇은 ^333^이라는 계정으로 래더 경기에 참가했고, 공유된 리플레이에서 Larva, Iris, Ret, Paralyze 같은 프로게이머를 이겼다. 커뮤니티 구성원들은 래더에 등장한 버전이 맵핵을 쓴다고 주장했다. 기사는 Pluto가 전장의 안개가 적용된 평범한 조건에서 학습했다고 설명했다. 개발자들은 이 때문에 맵핵으로 얻은 추가 정보가 도리어 봇을 혼란스럽게 할 수도 있다고 본다고 한다. 커뮤니티는 이 계정을 블리자드에 신고하고 래더에서 제거해 달라고 요청했다.
같은 기사는 해설자 Artosis가 분석한 경기도 소개했다. 프로토스 Paralyze와의 경기에서 Pluto는 테란을 골랐고, 마린, 메딕, 탱크, 고스트에 레이스 한 기와 파이어뱃 한 기까지 섞은 이례적인 조합을 만들었다. 레이스 한 기를 끝까지 살려 두며 하이 템플러를 사냥했고, 고스트로 적 유닛에 락다운을 걸었으며, 여러 곳에서 벌어진 교전을 동시에 지휘했다. 자기 시즈 탱크에 락다운을 거는 실수도 했다. 저그 Larva를 상대로는 배럭 여섯 개에서 마린과 메딕만 생산했다. Pluto는 미사일 터렛을 짓지 않았고 공격력과 방어력 업그레이드도 하지 않았다. 대신 Larva의 뮤탈리스크를 포위하고 컨트롤로 압도한 다음 반격했다고 한다.
화면에 표시된 Pluto의 APM은 수천에 이르렀다. 그러나 모델은 6프레임마다 행동 하나를 결정하므로 분당 240회가 상한이다. 기사는 여러 유닛에게 한꺼번에 내린 명령을 게임이 유닛마다 따로 기록하기 때문에 APM 수치가 실제보다 훨씬 커진다고 설명했다. AI 연구자 Evan Chen(evanthebouncy)은 Pluto를 “본능이 뛰어난 짐승"이라고 평했다. 그는 Pluto의 컨트롤에는 흠잡을 데가 없다고 하면서도, 건물 배치가 서툴고 장기 계획이 부족하며 처음 보는 전략에 약하다고 지적했다.
가장 흥미로운 지점
설명서를 읽으면서 나는 Pluto가 하지 않은 일들을 하나씩 세어 보게 됐다. Pluto는 사람의 리플레이로 학습하지 않았고, 과거 체크포인트와 대전하지 않았으며, 적에 관한 정보를 별도 코드로 기록하지 않는다. 2019년 스타크래프트 II에서 그랜드마스터 등급에 도달한 DeepMind의 AlphaStar는 먼저 사람의 리플레이를 모방하는 지도 학습을 거쳤고, 이어서 과거 에이전트들로 구성한 리그에서 강화학습을 진행했다.5 Pluto의 설명서는 그 두 방법을 모두 쓰지 않았다고 명시했다.
그렇다고 사람이 만든 요소가 하나도 없지는 않다. 빌드 오더 목록은 사람이 작성했고, 상대마다 빌드를 고르는 밴딧도 그대로 쓰인다. 2015년 AIIDE에서 우승한 tscmoo도 열두 가지 가까운 전략 가운데 무엇을 쓸지 상대 전적으로 골랐다. 11년 뒤의 Pluto도 같은 방법으로 오프닝을 고르지만, 이번에는 고른 빌드가 번호로만 전달되고 그 번호를 얼마나 따를지는 학습 결과에 달려 있다. o:4Pool을 받고도 9풀로 시작한다면, 그 빌드 오더는 명령이라기보다 제안으로 작동한다고 봐야 할 것이다.
README는 다른 어떤 주제보다 시간 처리를 길게 설명했다. 결정이 늦어지면 DLL은 게임 진행을 멈추고 답을 기다리는데, 그러면 모델은 학습 때와 같은 반응 시간으로 경기를 치르게 된다. 제작자는 명령이 늦게 실행되는 상황을 모델이 학습 중에 겪어 본 적이 없다고 적었다. 제작자가 학습 조건을 지키려고 이만큼 공을 들였는데, 대회가 끝난 뒤 누군가는 이 봇을 다른 클라이언트에서 실행해 사람과 대전시켰다. 그 버전에는 맵핵을 쓴다는 의혹까지 제기됐다. 개발자들이 맵핵이 준 추가 정보 때문에 봇이 혼란을 겪을 수 있다고 본 것도 이 설계를 생각하면 수긍이 간다.
Pluto를 학습시키는 데 연산이 얼마나 들었는지, 학습 기간이 얼마였는지는 아직 공개되지 않았다. 셀프 플레이만으로 브루드 워를 배우는 데 무엇이 필요했는지는 Vegard Mella가 준비하는 논문이 나와야 알 수 있을 것이다.
출처
Vegard Mella(tscmoo), GitHub 저장소 README와 릴리스 노트. 2026년 7월 16일 공개, 9월 23일 갱신. 원문: https://github.com/tscmoo/pluto
제작자 설명서(PLUTO_README.txt): https://davechurchill.ca/starcraft/cog/results/2026/PLUTO_README.txt David Churchill, 「2026 CoG StarCraft AI Competition Report」: https://davechurchill.ca/starcraft/cog/results/2026/report/ 대회 결과와 경기별 기록: https://davechurchill.ca/starcraft/cog/results/2026/ David Churchill의 LinkedIn 글(2026년 9월 18일): https://www.linkedin.com/posts/david-churchill-41171730_ai-bot-takes-over-the-starcraft-ladder-activity-7506818533616590848-Z6p2 Dexerto, 「AI bot destroys top StarCraft pros after invading ladder and using absurd strategies」(2026년 9월 21일): https://www.dexerto.com/gaming/ai-bot-destroys-top-starcraft-pros-after-invading-ladder-and-using-absurd-strategies-3410863/ Artosis의 해설 영상: https://www.youtube.com/watch?v=1vsTqNwHquE
커버 이미지는 대회 보고서에 실린 봇 간 승패표다.
David Churchill 외, 2015년 AIIDE 대회 결과를 정리한 논문(HAL hal-01436110). 2위 ZZZKBot의 승률은 87.84%로, 1위와의 차이는 0.68%포인트였다. ↩︎
상대별, 맵별 수치는 대회 결과 페이지에 공개된 경기별 기록(detailed_results.txt)을 내가 직접 집계한 값이다. 집계한 Pluto의 전체 승패는 보고서 표와 일치했다. ↩︎
Jay Scott의 Starcraft AI 블로그 집계에 따르면, 2023년 CoG 대회에서 우승한 Stardust의 라운드 로빈 승률은 91.31%였다. ↩︎
대회 결과 페이지는 출전 봇의 제출 파일, 대회 중 봇이 기록한 입출력 폴더, 리플레이를 누구나 내려받을 수 있게 공개한다. ↩︎
Vinyals 외, 「Grandmaster level in StarCraft II using multi-agent reinforcement learning」, Nature 575, 2019. AlphaStar의 리그에는 주 에이전트 말고도 두 종류의 에이전트가 참여했다. 하나는 주 에이전트의 약점을 공략하도록 학습한 에이전트이고, 다른 하나는 과거 시점의 가중치로 고정한 에이전트다. ↩︎