3줄 요약
- fourthplace43이 공개한 실험 페이지다. 로컬 ComfyUI에서 MiniMax H3로 텍스트를 바탕으로 영상과 소리를 함께 생성하면서, 어텐션 계산을 95% 덜어내고 하룻밤 동안 작업한 기록이다.
- 150편을 측정했더니 1편당 중앙값이 173초에서 78.6초로 줄었다. 2.2배다. 편차도 거의 없었다. 하위 10% 지점은 78.0초, 상위 10% 지점은 79.8초였다.
- 이 검증의 발단이었던 “AI에게 층별 삭감률을 정하게 한다"는 기법은 효과가 없었다. 질문문에서 설명한 부분만 맞바꿔 다시 물었더니 AI가 돌려준 배정도 그대로 뒤집혔다.
같은 지시문, 같은 난수, 계산량만 다른 두 영상
원문은 두 영상을 나란히 두고 시작한다. 지시문, 난수, 해상도는 같고 어텐션 계산을 덜어냈는지만 다르다. 아래 표의 초 단위 수치는 그 두 편을 만들 때의 실측값이다.
| 영상 | 삭감 없음 | 95% 삭감 |
|---|---|---|
| 8.0초 비 오는 교차로 | 158.7초 | 81.0초 |
| 5.2초, 같은 지시문에 길이만 줄인 영상 | 103.8초 | 56.3초 |
그런데 두 영상의 그림은 같지 않다. 저자는 그 이유를 이렇게 설명한다.
동영상 생성은 같은 지시문, 같은 난수라도 계산의 경로가 바뀌면 다른 그림이 나옵니다. 계산을 덜어낸다는 것이 바로 경로를 바꾸는 일이므로, 위의 두 편도 구도가 다릅니다.
저자가 독자에게 확인해 달라고 한 것은 두 영상이 같은 그림인지가 아니다. 확인해 달라고 한 것은 그림의 품질이 나빠졌는지였다. 젖은 노면의 반사, 우산의 겹침, 네온의 번짐, 사람이 걷는 모양을 보면 삭감한 쪽이 못해 보이지는 않을 것이라고 그는 썼다.
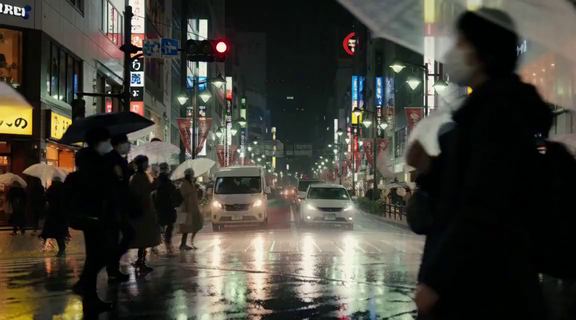 삭감 없음, 158.7초. 출처: fourthplace43
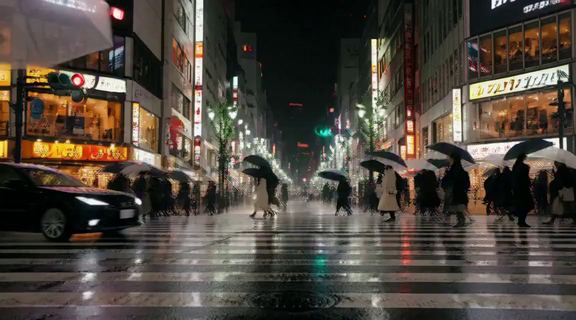 95% 삭감, 81.0초. 출처: fourthplace43
150편으로 측정한 속도
| 조건 | 편수 | 1편당 중앙값 | 배율 |
|---|---|---|---|
| 8.0초 / 삭감 없음 | 4편 | 173초 | 기준 |
| 8.0초 / 95% 삭감 | 150편 | 78.6초 | 2.2배 |
삭감한 쪽 150편은 편차가 거의 없었다. 하위 10% 지점은 78.0초, 상위 10% 지점은 79.8초였고, 140초를 넘긴 것은 150편 가운데 1편뿐이었다. 남기는 비율을 10%에서 5%로 내려도 결과는 거의 같았다.
애초 예상은 하룻밤에 80편이었는데 255편이 나왔다. 이 표의 해상도는 1152×640이다.
재현하려면 메모리부터 비워야 한다
이 2.2배는 다른 응용 프로그램을 모두 닫은 상태에서 나온 숫자다. 브라우저와 채팅 앱을 켜 둔 채 같은 설정으로 다시 측정했더니 같은 1편이 80초가 되기도 하고 215초가 되기도 했다.
동영상을 생성할 때는 20GB가 넘는 모델을 메모리에 올려 두고 실행한다. 빈 메모리가 부족하면 계산을 덜어내도 소용이 없다. 속도를 늦추는 요인이 어텐션 계산에서 메모리 대기로 옮겨 가기 때문이다. 저자는 돌리기 전에 쓰지 않는 응용 프로그램을 닫으라고 권한다.
발단, AI에게 어디를 깎을지 정하게 하기
이 검증은 저자가 X에서 본 기법을 시험해 보는 데서 시작했다. 동영상 생성 모델은 수십 개의 층(레이어)으로 이뤄져 있다. 소개된 기법은 층마다 계산을 얼마나 덜어낼지를 AI에게 정하게 한다. 판단 역할로 쓰인 것이 Jev다. Jev는 문장을 쓰지 않고 선택지와 그 확률만 돌려주는 판단 전용 AI다.
소개된 숫자는 6분 7초에서 3분 34초로, 41.7% 단축이었다. 저자는 이것을 자기 환경에서 확인했다.
| 조건 | 남긴 계산(평균) | 1편당 | 삭감 없음 대비 |
|---|---|---|---|
| 계산을 덜어내지 않음 | 100% | 339.0초 | 기준 |
| 일률적으로 10%만 남김 | 10% | 120.7초 | 2.81배 |
| 일률적으로 7.93%만 남김 | 7.93% | 133.8초 | 2.53배 |
| AI에게 층마다 정하게 함 | 6.64% | 123.9초 | 2.74배 |
이 네 조건은 각각 한 편씩만 측정했으므로, 앞의 150편 측정 결과만큼 신뢰하기는 어렵다. 해상도도 1024×1792픽셀이어서 앞의 비교 표(1152×640픽셀)와 다르다. 저자는 배율을 그대로 가져가지 말라고 덧붙였다.
AI에게 정하게 하지 않아도 일률 삭감으로 빨라졌다
AI를 쓰지 않고 모든 층을 일률적으로 10%에 맞춘 것만으로 2.81배가 나왔다. 소개된 41.7% 단축을 판단 역할 없이 넘어선 셈이다.
저자는 여기서 곧바로 제동을 건다. 소개된 환경과는 그래픽 보드도 해상도도 다르니 숫자를 그대로 맞대어 비교하면 안 된다고 했다. 말할 수 있는 것은 “이 환경에서는 AI의 판단 없이도 비슷하게 빨라졌다"까지다. 원래 기법을 올린 투고자 본인도 일률적으로 깎기만 해도 꽤 빨라지므로 AI 덕분에 빠르다고 단정할 수는 없다는 단서를 달아 두었다고 한다.
10%보다 낮춰도 더 빨라지지 않는다
10%에서 120.7초가, 7.93%에서 133.8초가, 6.64%에서 123.9초가 나왔다. 계산을 남기는 비율을 더 낮춰도 생성 시간은 줄지 않는다. 저자는 이 부근이 한계이며, 남은 시간에는 계산의 다른 부분이 쓰이고 있다고 보았다.
AI가 맡은 일은 1%, 3%, 5%, 10% 가운데 어느 것을 각 층에 배정할지 고르는 것이다. 그 범위 안에서 어떻게 다시 배정해도 깎을 여지가 남아 있지 않았다.
AI는 판단하지 않았다
Jev가 내놓은 배정에는 뚜렷한 경향이 있었다. 모델 앞부분의 층에는 3.3%를, 뒷부분의 층에는 10%를 남기라고 답했다. 얕은 층은 대략적이어도 되고 깊은 층은 꼼꼼해야 한다는, 의미가 있어 보이는 배정이다.
저자는 여기서 질문문 안의 “얕다/깊다” 설명만 서로 바꿨다. 선택지도 지시문도 한 글자 고치지 않은 채 다시 물었다. 그러자 배정은 완전히 뒤집혔다. 앞부분이 9.8%, 뒷부분이 5.5%가 됐다.
AI는 모델의 내부를 알지 못한다. 답의 방향을 정한 쪽은 질문문을 쓴 사람이었다. AI가 똑똑하게 배정한 것처럼 보였을 뿐, 저자는 자기 선입견을 그대로 돌려받았다.
그래도 헛수고는 아니었다고 저자는 적어 두었다. AI에 네 차례 문의하는 데 2.2초가 들었고 비용은 0.03엔가량이었으니, 생성 시간을 늦추지도 않았다. 효과가 없었던 까닭은 깎을 여지가 이미 없었기 때문이다. 저자는 이 재현 실험을 하던 도중에 일률적으로 깎기만 해도 2배 이상 빨라진다는 것을 알게 됐고, 이 발견이 페이지의 위쪽 절반으로 이어졌다.
AI에게 결정하게 하는 이야기는 헛스윙이었지만, 확인해 봤기에 본래 찾던 것을 찾았습니다.
같은 방식을 직접 해보려면
새 모델을 내려받을 필요도, 노드를 추가할 필요도 없다. ComfyUI에 처음부터 들어 있는 기능이다. 저자는 아래 내용을 그대로 AI 에이전트에게 붙여 넣으라고 안내한다.
노드 하나를 추가하고 연결 두 곳만 바꾸면 된다. BlockSparseAttention(카테고리 model/patch)을 LoRA 뒤에 연결한 뒤, BasicGuider와 BasicScheduler를 둘 다 그 노드의 출력에 연결한다.
UNETLoader → (LoRA가 있으면 LoraLoaderModelOnly) → BlockSparseAttention
                                                   ├→ BasicGuider
                                                   └→ BasicScheduler
한쪽만 바꿔 연결해도 오류가 나지 않는다. 그저 빨라지지 않을 뿐이다. 저자는 여기서 반나절을 허비했다고 적었다. KSampler를 쓴다면 BlockSparseAttention의 출력을 KSampler의 model 입력에 연결한다.
권장 설정은 다음과 같다.
| 항목 | 값 |
|---|---|
| method | sla |
| keep_percent | 5 |
| start_percent | 0.0 |
| end_percent | 1.0 |
| min_tokens | 12288 |
| extra_tokens | 256 |
| sink_conditioning | exact_kv_and_rows |
| verbose | true (처음에는 반드시) |
설정이 적용됐는지는 반드시 로그로 확인한다. ComfyUI 로그에 sparse producer path라는 줄이 나오면 삭감이 적용된 것이다. 나오지 않으면 설정은 들어갔는데 밀집 상태 그대로 돌고 있다. tokens < min_tokens 12288이라고 나오면 해상도나 프레임 수가 너무 작다는 뜻이다.
저자가 정리한 측정 요령은 네 가지다.
- 비교할 때마다 모델을 해제하지 않는다. 20GB가 넘는 모델을 다시 적재하는 시간이 측정값에 섞인다.
- 반복할 때는 seed를 매번 바꾼다. seed가 같으면 캐시가 작동해 4초 만에 결과가 나온다.
- 1편으로 판단하지 않는다. 최소 3편을 돌려 중앙값으로 비교한다.
- GPU 사용률 대신 소비 전력을 본다. 100%여도 전력이 낮으면 메모리 대기다.
재현되지 않을 때는 메모리부터 의심한다. 응용 프로그램을 닫은 상태에서는 150편의 생성 시간이 78~80초였지만, 빈 RAM이 3.9GB인 상태에서는 같은 영상 한 편이 80초에서 215초까지 걸렸다. ComfyUI를 오래 돌리면 프로세스 자체가 메모리를 안고 커지므로 가끔 재시작하라고도 적혀 있다.
keep_percent 값은 5면 충분하다. 10%와 5%가 거의 차이 나지 않고, 그 아래로 내려도 속도는 그대로다. 최적값은 해상도에 따라 달라지므로 자기 설정에서 다시 측정해야 한다.
만들어 보고 알게 된 것
저자는 이 절을 시작하며 “이 페이지에 늘어놓은 동영상에서 말할 수 있는 것만 적었다"고 전제했다.
큰 글자는 나오고 작은 글자는 무너진다
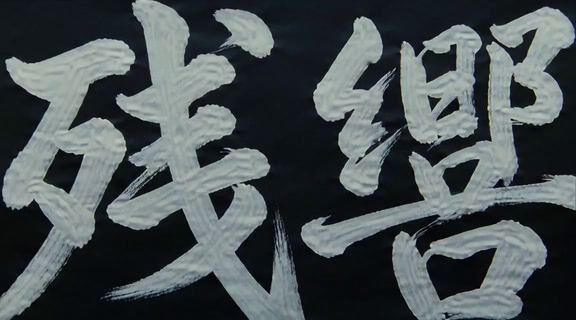
캔의 「朝香」, 술병의 「雪解」, 병의 「深緑」, 제목의 「残響」과 「花霞」와 「遠雷」가 그렇다. 모두 화면의 주인공이 되는 크기로 들어간 글자다. 브랜드명을 일본어로 지정하면 라벨에 그 글자가 인쇄되고, 쓰지 않으면 그럴듯한 가짜 글자로 채워진다.
반면 내용량이나 설명문 같은 작은 글자는 무너진다. 같은 캔에 4행 표기를 넣어 3편을 만들었더니 읽을 수 있었던 것은 1편뿐이었고, 나머지는 글자가 이중으로 보이거나 같은 행이 반복됐다. 페이지에 실은 것은 전부 큰 글자뿐이라고 저자는 밝혀 둔다.
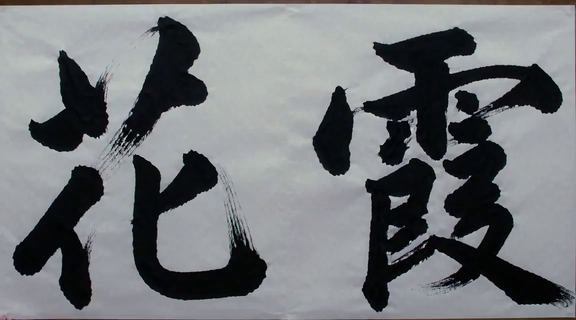 화과자 CM의 제목 컷 「花霞」. 화면의 주인공이 되는 크기의 글자는 지시문에 쓴 그대로 인쇄된다. 출처: fourthplace43
한 편 안에서 컷이 바뀐다
“먼저 ◯◯. 다음에 ◯◯. 그것이 끝난 순간에 ◯◯“라는 식으로 쓰면 한 편 안에서 그림이 바뀐다. 상품 CM의 3단 구성이 이 형식이다. 예고편은 복도에서 문으로, 다시 바닥의 신발로 이어진다. 시대극은 선 자세에서 눈으로, 다시 칼을 뽑는 순간으로 이어진다. 초 단위는 지정할 수 없다. 어느 지점에서 화면이 바뀔지는 모델이 정한다.
지시문 첫머리에 “이것은 영화 예고편이다"라는 한 줄을 더하면 그림이 어둡고 짙어진다. “텔레비전 CM이다"라고 쓰면 밝고 옅어진다.
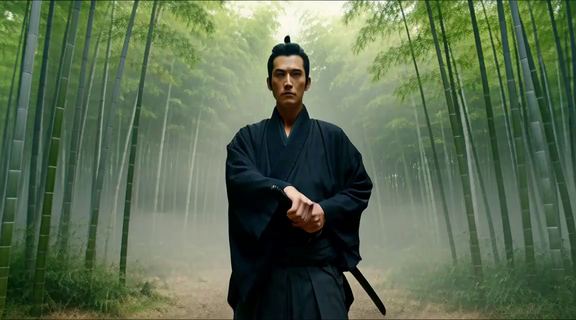 시대극 예고편. 선 자세, 눈, 칼을 뽑는 동작이 한 편 안에서 세 컷으로 바뀐다. 출처: fourthplace43
같은 인물은 어느 정도 통한다
저자는 참조 이미지 없이 인물 설명문을 한 글자도 바꾸지 않은 채 기승전결 네 편을 만들었다. 머리 모양, 까칠하게 자란 수염, 회색 후드, 얼굴 생김새는 네 편 모두에서 같은 인물로 나왔다.
단, 완전하지는 않다. 구분하려고 넣은 “왼쪽 눈 아래의 점"은 첫 편에서만 오른쪽 눈 아래에 나왔다. 세부는 일정하지 않다는 전제로 쓰라고 저자는 권한다.
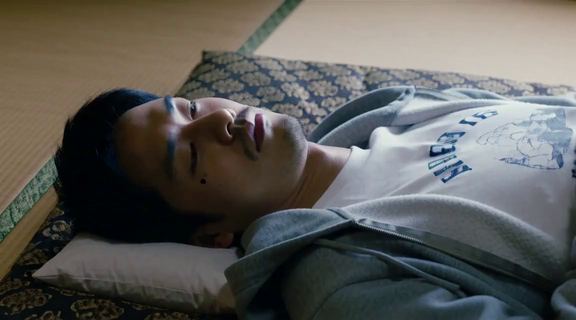 기(起), 아무것도 없는 방에서 눈을 뜬다. 출처: fourthplace43
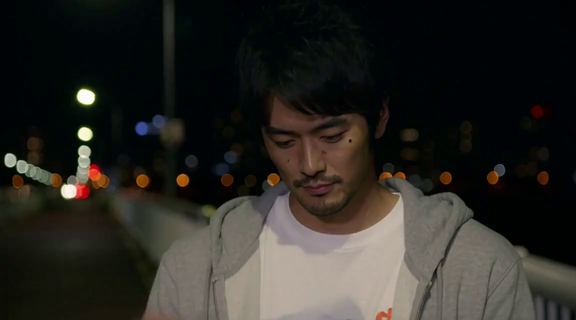 결(結), 밤 다리에서 봉투를 열고 웃기 시작한다. 별개로 생성한 네 편이지만 인물 설명문을 그대로 유지해 같은 사람으로 나왔다. 출처: fourthplace43
소리는 영상과 함께 나온다
빗소리, 칼을 뽑는 소리, 매미 소리, 대패질 소리, 경매 종소리, 피아노와 현악기 소리가 모두 영상과 함께 생성됐다. 나중에 덧붙인 소리는 하나도 없다.
단, 음악과 대사와 효과음을 한 편에 밀어 넣으면 어느 하나도 충분히 나오지 않는다. 욕심내지 말고 필요한 것만 고르라는 것이 저자의 조언이다.
가장 흥미로운 지점
질문문의 “얕다/깊다” 설명만 서로 바꿨더니 AI의 배정이 통째로 뒤집혔다. 나는 이 대목을 두 번 읽었다. AI가 처음 돌려준 배정은 입구 3.3%, 출구 10%였는데, 저 숫자만 놓고 보면 “얕은 층은 대충, 깊은 층은 꼼꼼히"라는 그럴듯한 설명이 바로 붙는다. 저자가 여기서 멈췄다면 AI가 최적 배분을 찾아냈다는 결론이 무난하게 나왔을 것이다. 그 배정을 무효로 만든 것은 측정을 더 쌓는 일이 아니었다. 선택지도 지시문도 그대로 두고 설명문만 반대로 바꿔 한 번 더 물었더니, 질문이 답을 이미 정해 두고 있었다는 것이 그 자리에서 드러났다. Jev는 잘못한 것이 없다. 4회 문의에 2.2초, 0.03엔을 쓰고 물어본 대로 답했을 뿐이다. 알아차리기를 어렵게 만든 쪽은 출력의 모양새였다. 기울기가 워낙 깔끔해서 해석이 저절로 따라붙었다.
이 페이지에 실린 두 결론은 모두 실패한 재현 실험에서 나왔다. 저자는 층별 배분 기법을 확인하러 들어갔다가 그것이 듣지 않는다는 것을 확인했고, 그 과정에서 일률 삭감만으로 150편 중앙값 2.2배가 나온다는 것을 발견했다. 그러면서도 자기가 잰 2.81배를 원본의 41.7% 단축과 나란히 놓기를 거부하고, 1편씩만 잰 네 조건을 150편 중앙값과 같은 무게로 취급하지도 않는다. 정작 생성 시간을 가장 크게 흔든 요인은 알고리즘 쪽에서 나오지 않았다. 빈 시스템 메모리였다.
출처
fourthplace43, 「倍速で回した一晩」 (labs) 원문: https://fourthplace43.com/labs/t2v-rushes/
본문 이미지는 원문 페이지에 실린 동영상의 포스터 프레임이다. 인용문은 내가 한국어로 옮겼다.