3줄 요약
- 「Sutskever 30」은 Paul Pajo가 2025년 12월 6일 공개한 GitHub 저장소다. 이 저장소는 일리야 수츠케버가 존 카맥에게 건넸다고 알려진 딥러닝 읽기 목록을 바탕으로 논문 30편을 골랐다. 그리고 각 논문을 딥러닝 프레임워크 없이 NumPy만으로 구현한 주피터 노트북 30개를 담았다. 2026년 9월 30일 기준으로 별 4,932개와 포크 639개를 받았다.
- 노트북은 모두 합성 데이터를 스스로 만들기 때문에 데이터셋을 내려받지 않고 바로 실행된다. 저장소의 커밋 32개 가운데 22개에 Claude 공동 작성자 표기가 있고, 첫 커밋부터 30편 완성 커밋까지는 나흘이 걸렸다.
- 나는 노트북 다섯 개를 직접 실행했다. 문자 단위 RNN은 역전파로 가중치를 갱신하며 손실을 79.45에서 30.43까지 낮췄다. 그러나 다중 토큰 예측 노트북은 가중치를 한 번도 갱신하지 않았고, 손실도 30에포크 내내 50의 자연로그인 3.912에서 변하지 않았다. 스케일링 법칙과 Lost in the Middle 노트북은 논문이 발견한 곡선을 수식으로 미리 입력해 두고 그 곡선을 그렸다.
저장소가 약속하는 것
저자는 README 첫머리에서 이 저장소를 “일리야 수츠케버가 추천한 기초 논문 30편의 포괄적인 장난감 구현"이라고 불렀다. README에 따르면, 수츠케버는 이 목록을 존 카맥에게 건네며 딥러닝에서 “중요한 것의 90%“를 배울 수 있다고 말했다. README가 밝힌 원칙은 다섯 가지다.
- 딥러닝 프레임워크 없이 NumPy만 쓴다.
- 합성 데이터를 노트북 안에서 만들어, 받자마자 실행할 수 있게 한다.
- 시각화와 설명을 충분히 싣는다.
- 논문마다 핵심 개념을 시연한다.
- 주피터 노트북에서 대화형으로 실행한다.
NumPy만 쓰는 이유도 README에 적혀 있다. NumPy로만 구현하면 프레임워크가 대신 처리해 주는 연산을 독자가 직접 확인할 수 있고, 모든 연산이 마법 없이 드러나며, 독자가 프레임워크 API보다 알고리즘에 집중할 수 있다는 것이다. 합성 데이터를 쓰는 이유로는 데이터셋 다운로드가 필요 없다는 점과, 단순한 사례로 통제된 실험을 할 수 있다는 점을 들었다.
노트북 30개의 코드 셀에서 빈 줄을 빼고 세면 모두 12,894줄이다. 가장 긴 노트북은 18번 관계형 RNN으로 1,547줄이고, 그다음은 26번 CS231n(1,069줄), 19번 커피 오토마톤(1,051줄), 24번 기계 초지능(980줄) 순이다. 가장 짧은 노트북은 1번 복잡도 역학(126줄)과 11번 팽창 합성곱(138줄)이다. 노트북이 불러오는 외부 라이브러리는 numpy, matplotlib, scipy 세 가지이고, 12번 그래프 신경망만 networkx를 추가로 쓴다. 저장소에 올라간 노트북에는 실행 결과가 하나도 저장되어 있지 않아서, 그림과 수치를 보려면 독자가 직접 실행해야 한다.
어떤 순서로 읽으면 좋을지도 README에 적혀 있다. 초급 과정은 문자 RNN, LSTM, AlexNet, ResNet, VAE 다섯 편이고, 그다음에 중급 9편과 고급 8편을 배운다. 마지막 이론 과정은 MDL, 콜모고로프 복잡도, 복잡도 역학, 커피 오토마톤 네 편이다. README는 구현 난이도도 세 단계로 표시했다. 문자 RNN, LSTM, ResNet, 간단한 VAE, 팽창 합성곱은 오후 한나절이면 되고, 트랜스포머와 포인터 네트워크, 그래프 신경망, 관계 네트워크, 신경 튜링 머신, CTC 손실, 밀집 검색은 주말 프로젝트라고 했다. 일주일짜리 과제로 꼽힌 것은 RAG 전체 시스템이고, 대규모 실험과 하이퍼파라미터 최적화에는 미완료를 뜻하는 경고 기호가 표시되어 있다.
30편의 목록
README에서 30편은 기초 개념(1번부터 5번), 아키텍처와 메커니즘(6번부터 15번), 고급 주제(16번부터 22번), 이론과 메타 학습(23번부터 30번) 네 묶음으로 정리되어 있다. 표의 마지막 열에는 README가 적은 핵심 개념을 옮겼다.
| 번호 | 원 자료 | 노트북이 다루는 개념 |
|---|---|---|
| 1 | The First Law of Complexodynamics (Aaronson) | 엔트로피, 복잡도 증가, 셀룰러 오토마톤 |
| 2 | The Unreasonable Effectiveness of RNNs (Karpathy) | 문자 단위 모델, 텍스트 생성 |
| 3 | Understanding LSTM Networks (Olah) | 게이트, 장기 기억, 기울기 흐름 |
| 4 | Recurrent Neural Network Regularization (Zaremba 외) | 시퀀스용 드롭아웃, 변분 드롭아웃 |
| 5 | Keeping Neural Networks Simple (Hinton, van Camp) | MDL 원리, 가중치 가지치기 |
| 6 | Pointer Networks (Vinyals 외) | 포인터로 쓰는 어텐션, 조합 최적화 |
| 7 | ImageNet Classification (AlexNet) | 합성곱, 데이터 증강 |
| 8 | Order Matters: Sequence to Sequence for Sets | 집합 인코딩, 순열 불변성 |
| 9 | GPipe | 파이프라인 병렬화, 마이크로 배치, 재계산 |
| 10 | Deep Residual Learning (ResNet) | 스킵 연결 |
| 11 | Multi-Scale Context Aggregation by Dilated Convolutions | 수용 영역, 다중 스케일 |
| 12 | Neural Message Passing for Quantum Chemistry | 그래프 신경망, 메시지 전달 |
| 13 | Attention Is All You Need | 셀프 어텐션, 멀티헤드 어텐션 |
| 14 | Neural Machine Translation (Bahdanau 외) | 시퀀스 투 시퀀스, 바다나우 어텐션 |
| 15 | Identity Mappings in Deep Residual Networks | 사전 활성화, 기울기 흐름 |
| 16 | A Simple Neural Network Module for Relational Reasoning | 관계 네트워크, 쌍별 함수 |
| 17 | Variational Lossy Autoencoder | VAE, ELBO, 재매개변수화 |
| 18 | Relational Recurrent Neural Networks | 관계형 메모리, 수동 역전파 |
| 19 | The Coffee Automaton (Aaronson 외) | 비가역성, 시간의 화살, 란다우어 원리 |
| 20 | Neural Turing Machines | 외부 메모리, 미분 가능한 주소 지정 |
| 21 | Deep Speech 2 | CTC 손실, 음성 인식 |
| 22 | Scaling Laws for Neural Language Models | 멱법칙, 연산 최적 학습 |
| 23 | A Tutorial Introduction to the MDL Principle (Grünwald) | 정보 이론, 모델 선택, 압축 |
| 24 | Machine Super Intelligence (Legg) | AIXI, 솔로모노프 귀납, 지능 측정 |
| 25 | Kolmogorov Complexity and Algorithmic Randomness | 알고리즘적 무작위성, 보편 사전 분포 |
| 26 | Stanford CS231n | 최근접 이웃법(kNN)부터 합성곱 신경망(CNN)까지의 이미지 분류 과정 |
| 27 | Better & Faster LLMs via Multi-token Prediction | 여러 미래 토큰 예측, 표본 효율 |
| 28 | Dense Passage Retrieval | 이중 인코더, 배치 내 네거티브 |
| 29 | Retrieval-Augmented Generation | RAG-Sequence, RAG-Token |
| 30 | Lost in the Middle | 위치 편향, 긴 컨텍스트, U자 곡선 |
목록은 어디서 왔나
카맥은 한 인터뷰에서 수츠케버에게 읽기 목록을 부탁해 “40편 정도의 연구 논문 목록"을 받았다고 말했다. 그 논문들을 모두 익히면 “오늘날 중요한 것의 90%“를 알게 될 것이라는 설명도 들었다고 했다. 그러나 원래 목록은 공개되지 않았다. 2024년에 인터넷에 퍼진 판본에는 27개 항목만 실려 있고, 이 판본도 공식적으로 확인된 적이 없다1.
저장소의 2026년 3월 커밋 메시지도 이 27개 판본을 기준으로 삼았다. 이 커밋은 「The Annotated Transformer」를 별도 노트북으로 만들지 않고 13번 노트북의 참고 자료로 연결하면서, “정본 27편 가운데 26편은 이미 구현되어 있다"고 적었다. 따라서 저장소가 덧붙인 논문은 네 편이다. 27번 다중 토큰 예측(2024), 28번 밀집 문단 검색(2020), 29번 검색 증강 생성(2020), 30번 Lost in the Middle(2023)이다. 그중 다중 토큰 예측과 Lost in the Middle은 카맥이 목록을 받았다고 알려진 2020년 무렵보다 나중에 발표됐다. 그런데도 README 첫 문장에는 30편 모두가 수츠케버의 추천 논문이라고 적혀 있다.
나흘 동안의 커밋
저장소에는 커밋이 모두 32개 있다. 2025년 12월 6일의 첫 커밋에는 노트북 9개와 30편 전체의 구현 계획을 적은 IMPLEMENTATION_TRACKS.md가 들어 있었다. 같은 날의 커밋 메시지에는 20편을 완성했다고 적혀 있다. 이어서 5번과 27번이 추가됐다. 12월 7일과 8일에는 18번 관계형 RNN을 만들었고, 12월 9일에는 8번, 9번, 19번, 23번, 25번이 추가됐다. 12월 10일 26번과 24번이 추가되면서 README에 30편 완성이 표시됐다. 이후의 커밋은 2026년 2월의 진행 문서 갱신과 Gumroad 판매 링크 추가, 3월의 13번 참고 자료 연결 세 개뿐이다.
커밋 22개에는 Claude가 공동 작성자로 표기되어 있다. 모델명별로 세면 Claude Sonnet 4.5가 12개, 모델명 없이 Claude로만 적힌 것이 8개, Claude Opus 4.5와 Claude Sonnet 4.6이 1개씩이다. 표기가 없는 커밋 10개는 18번을 단계별로 만든 커밋 9개와 Gumroad 링크 커밋이다.
18번은 따로 세운 계획 문서(PAPER_18_ORCHESTRATOR_PLAN.md)를 따라 만들어졌다. 이 문서는 구현 작업을 4단계의 원자 과제 13개로 분해하고, 동일 단계의 과제는 병렬로 실행하도록 계획했다. 완성 직후 README와 진행 문서는 관계형 RNN의 테스트 손실이 LSTM 기준 모델보다 3.7% 낮다고 적었다. 객체 추적 과제에서 0.2694를 0.2593으로 낮췄다는 수치였다.
다음 날의 수정 커밋은 18번의 “치명적인 버그"를 고쳤다고 밝혔다. 빠져 있던 임포트를 추가했고, 시퀀스가 바뀔 때 메모리 상태가 초기화되지 않던 문제와 LSTM 기준 모델의 O(n²) 복잡도 문제를 고쳤다. 실제로는 학습을 하지 않는데 “학습"이라고 적은 표현은 “검증"으로 바꿨다. 이어진 README 수정 커밋은 3.7% 개선 주장을 지우고, 18번을 순전파만 하는 아키텍처 시연으로 고쳐 적었다. 같은 날 18번에는 자동 미분 없이 역전파를 손으로 구현한 11절이 추가됐는데, 약 1,100줄이다. 현재의 PROGRESS.md에는 3.7% 개선 문구가 여전히 남아 있다.
노트북 다섯 개를 실행한 결과
나는 2번 문자 RNN, 13번 트랜스포머, 22번 스케일링 법칙, 27번 다중 토큰 예측, 30번 Lost in the Middle을 골라, 코드 셀을 순서대로 실행하고 그림을 저장했다2. 다섯 개 모두 오류 없이 실행을 완료했다.
2번 문자 단위 RNN
2번 노트북은 짧은 영어 문장 열한 줄을 열 번 반복해 2,490자의 텍스트를 만든다. 그리고 이 텍스트로 은닉 유닛이 64개인 RNN을 학습시킨다. 순전파와 교차 엔트로피 손실, 시간 역전파, Adagrad 가중치 갱신은 모두 NumPy로 구현되어 있다. 노트북은 2,000회 반복하는 동안 25자 구간의 평활 손실을 기록하는데, 손실은 79.45에서 시작해 1,800회차에 30.43까지 낮아졌다3. 처음에 무작위 글자만 출력하던 모델은 학습이 끝날 무렵 “networks”, “everywhere”, “information” 같은 단어를 만들었다.
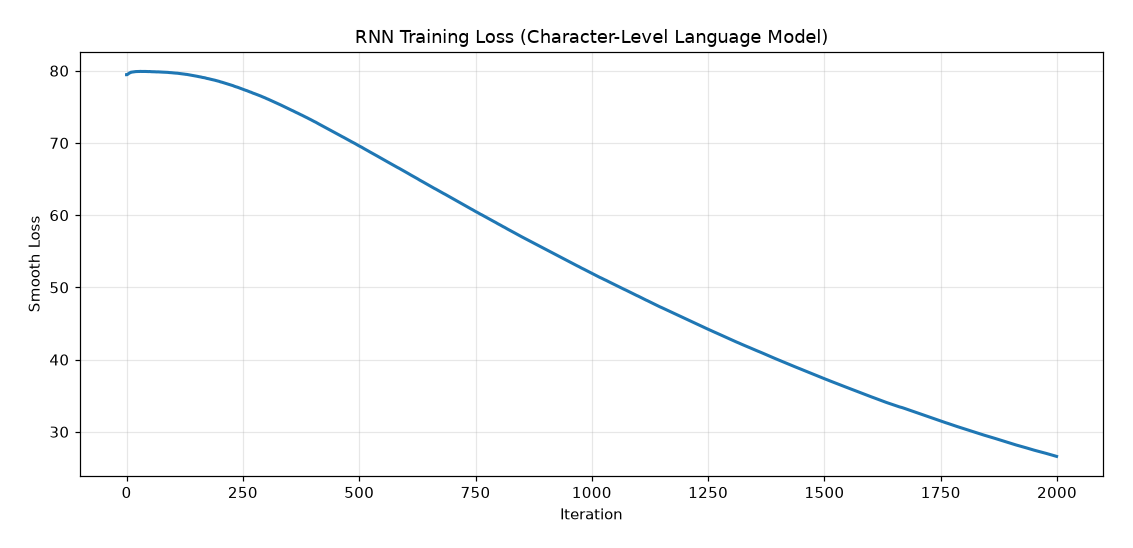 그림 1. 문자 단위 RNN의 학습 손실. 출처: 저장소의
02_char_rnn_karpathy.ipynb를 실행해 얻은 그림
13번 트랜스포머
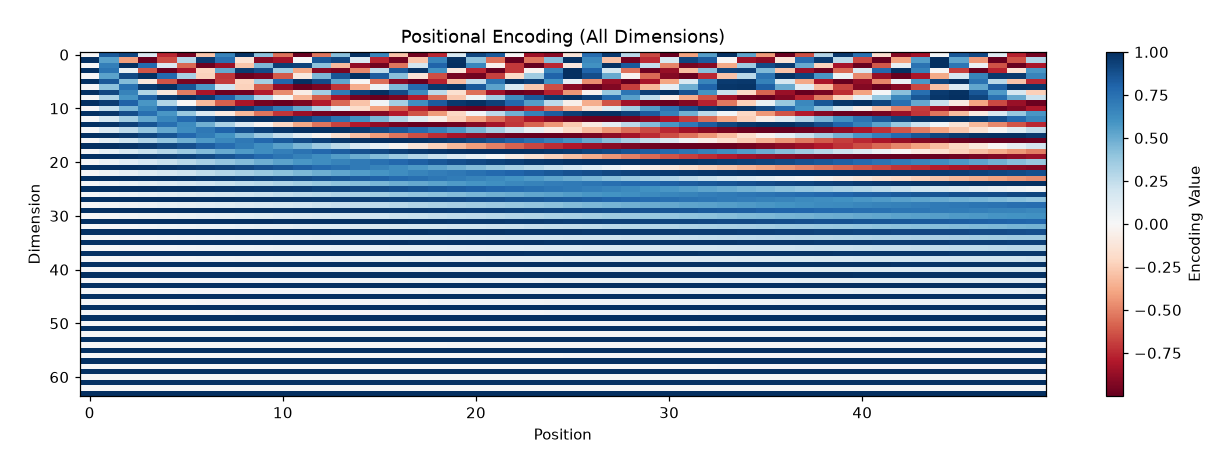
트랜스포머를 다루는 13번 노트북에서 구현하는 구성 요소는 여섯 가지다. 스케일드 닷 프로덕트 어텐션, 헤드 8개짜리 멀티헤드 어텐션, 사인파 위치 인코딩, 피드포워드 층, 층 정규화, 인과 마스크를 차례로 만든 다음, 노트북 후반에서 이 요소들로 트랜스포머 블록 하나를 구성한다. 모델 차원은 64, 헤드당 차원은 8, 피드포워드 은닉 차원은 256이다. 노트북은 가중치를 무작위로 초기화한 뒤 순전파만 한다. 그리고 각 단계의 출력 형태를 보여 주고, 어텐션 가중치의 합이 1인지 확인한다. 노트북 끝에는 2026년 3월에 추가한 「The Annotated Transformer」 링크가 있다.
27번 다중 토큰 예측
27번 노트북에서는 RNN 두 개를 비교한다. 한 모델은 다음 토큰 하나만 예측하고, 다른 모델은 다음 토큰 세 개를 한꺼번에 예측한다. 어휘의 크기는 50개다. 노트북은 등차수열 1,000개를 만들고, 그중 100개를 입력으로 사용해 손실 곡선을 그린다. 그런데 두 모델의 학습 함수에는 가중치 갱신 코드가 없다. 역전파 코드가 있어야 할 줄에는 “Backward (simplified - just track loss)“라는 주석 한 줄만 있고, 함수는 손실을 계산해 기록하기만 한다. 학습률 인자 lr도 받기만 하고 쓰지 않는다.
실행해 보면 두 모델의 손실은 30에포크 내내 3.9120이다. 어휘 50개에 같은 확률을 주면 교차 엔트로피는 50의 자연로그가 된다. 노트북이 출력한 손실 3.9120은 이 값과 같다. 다음 토큰 정확도는 단일 토큰 모델이 1.68%, 다중 토큰 모델이 0.24%였는데, 무작위로 하나를 고를 때의 기대 정확도가 2%다. 두 손실 값이 똑같다고 출력한 직후 노트북은 “다중 토큰 예측은 더 풍부한 학습 신호를 준다"는 문장을 출력한다. README에 적힌 이 노트북의 특징은 “2~3배의 표본 효율"이다.
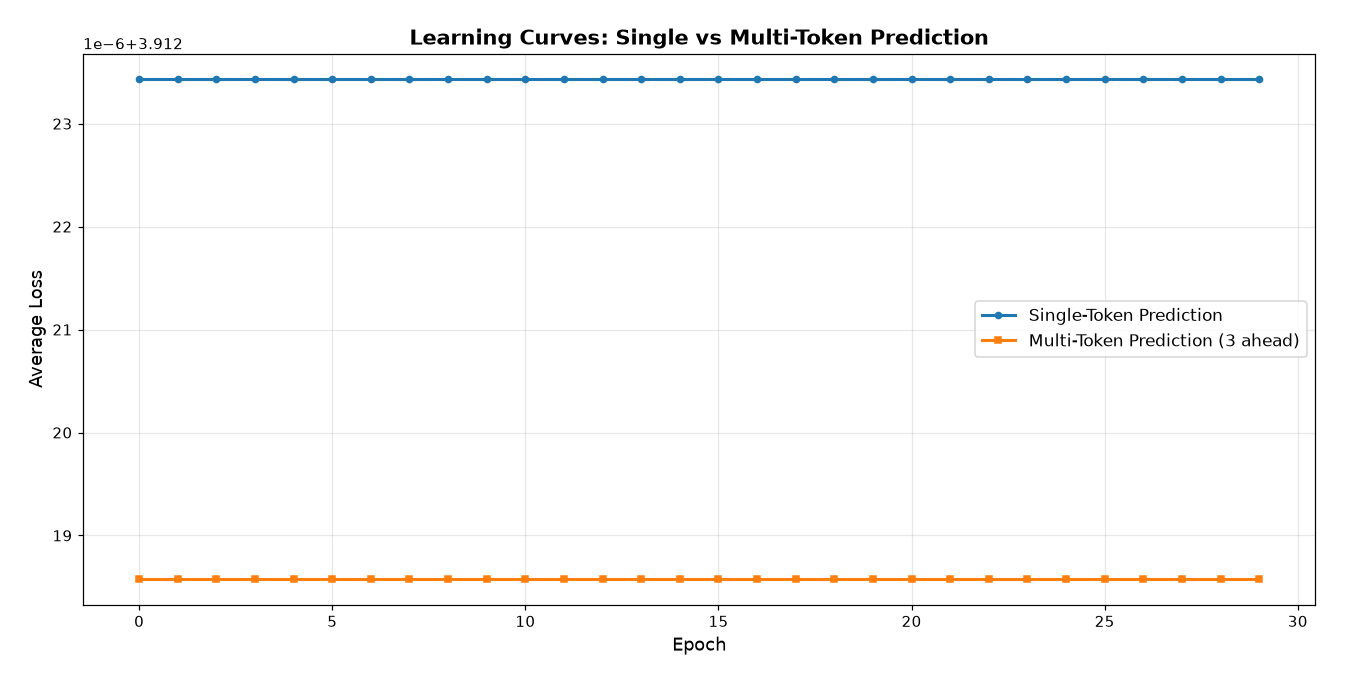 그림 2. 다중 토큰 예측 노트북의 학습 곡선. 세로축 눈금 단위가 100만분의 1이라서 두 선이 떨어져 보인다. 출처: 저장소의
27_multi_token_prediction.ipynb를 실행해 얻은 그림
22번 스케일링 법칙
22번 노트북의 첫 부분에는 Kaplan 외(2020)가 보고한 지수 세 개가 정리되어 있다. 파라미터 수에 관한 $\alpha_N$은 0.076, 데이터 크기에 관한 $\alpha_D$는 0.095, 연산량에 관한 $\alpha_C$는 0.050이다. 그다음 노트북은 크기가 다른 장난감 언어 모델 여러 개를 “학습"시켜 손실을 재고, 그 손실값들에 멱법칙을 맞춘다. 그러나 이 장난감 모델의 train 함수는 학습을 하지 않는다. 파라미터 수 $N$, 데이터 크기 $D$, 스텝 수 $s$를 받아 아래 식으로 손실을 계산하고 약간의 잡음을 더할 뿐이다.
실험 설정에서는 이 식의 값이 대부분 하한 1.0보다 작게 나오므로, 측정된 손실도 대부분 1.0이다. 그래서 이 값들에 맞춘 멱법칙의 지수는 파라미터 수에 대해서는 0.0048, 데이터 크기에 대해서는 0.0000이었다. 같은 연산 예산으로 세 가지 전략을 비교하는 셀도 있다. 큰 모델에 적은 데이터를 쓰면 손실은 1.0080이었고, 작은 모델에 많은 데이터를 쓰면 1.0000, 친칠라 방식으로 균형을 맞추면 1.1253이었다. 노트북은 셋 중 손실이 가장 높은 균형 전략 옆에 “← BEST"를 출력한다.
외삽 그래프에는 유명한 모델 세 개가 표시되어 있다. 노트북은 GPT-2의 파라미터 수를 1.5억 개, GPT-3를 17.5억 개, GPT-3.5를 1,750억 개로 표시했다. 실제 GPT-2의 최대 모델은 15억 개이고, GPT-3는 1,750억 개다.
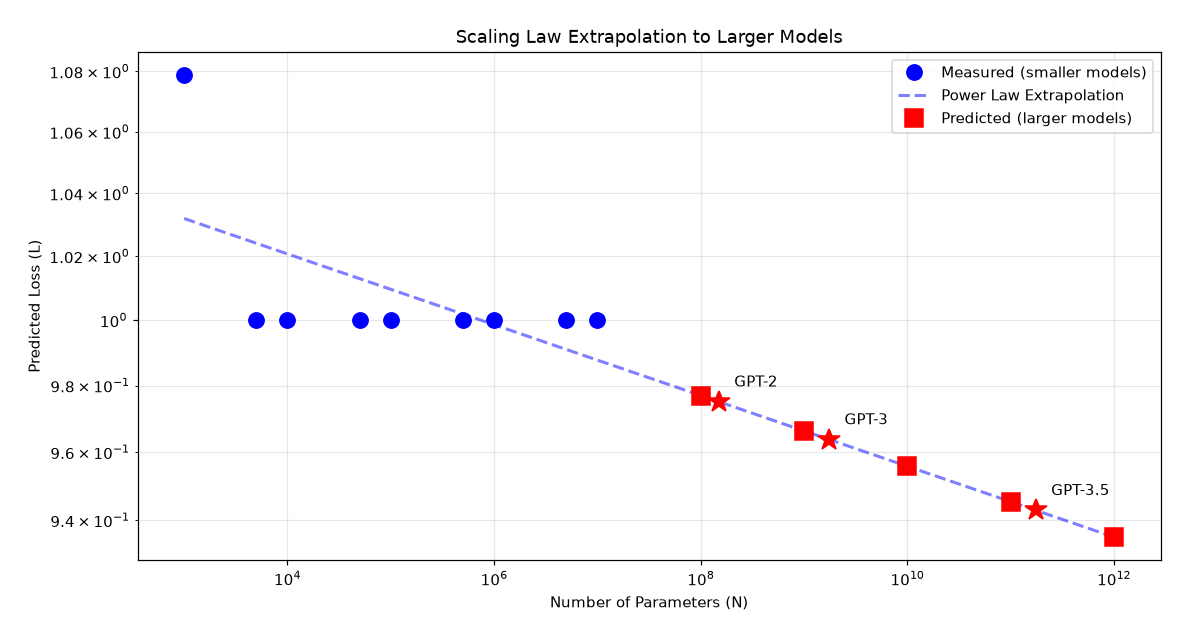 그림 3. 스케일링 법칙 노트북의 외삽 그래프. 측정값 아홉 개 중 여덟 개가 하한 1.0이다. 출처: 저장소의
22_scaling_laws.ipynb를 실행해 얻은 그림
30번 Lost in the Middle
30번 노트북은 문서 10개 가운데 하나에만 정답(에펠탑 완공 연도)이 있는 질의응답 과제를 만들고, 정답 문서의 순서를 바꿔 가며 정확도를 잰다. 정확도를 계산하는 SimpleLM 클래스는 언어 모델이 아니다. 이 클래스는 문서 순서 $x$를 0에서 1 사이의 값으로 바꾼 뒤, $4(x - 0.5)^2 + 0.3$으로 가중치를 계산한다. 그리고 정답 문서의 가중치를 정답 확률로 반환한다.
따라서 결과 곡선은 입력한 이차식의 모양 그대로다. 문서 순서는 0번부터 9번까지다. 정답 문서가 0번이나 9번에 있으면 정확도는 18.4%다. 2번부터 7번 사이에 있으면 평균 5.8%다. 가중치를 모두 같게 둔 비교 모델은 모든 순서에서 10%다. 노트북은 이 결과를 출력하면서 “실제 LLM은 U자형 편향을 보인다"고 적었고, 중요한 문서를 맨 앞과 맨 뒤에 두라는 권고로 마무리했다.
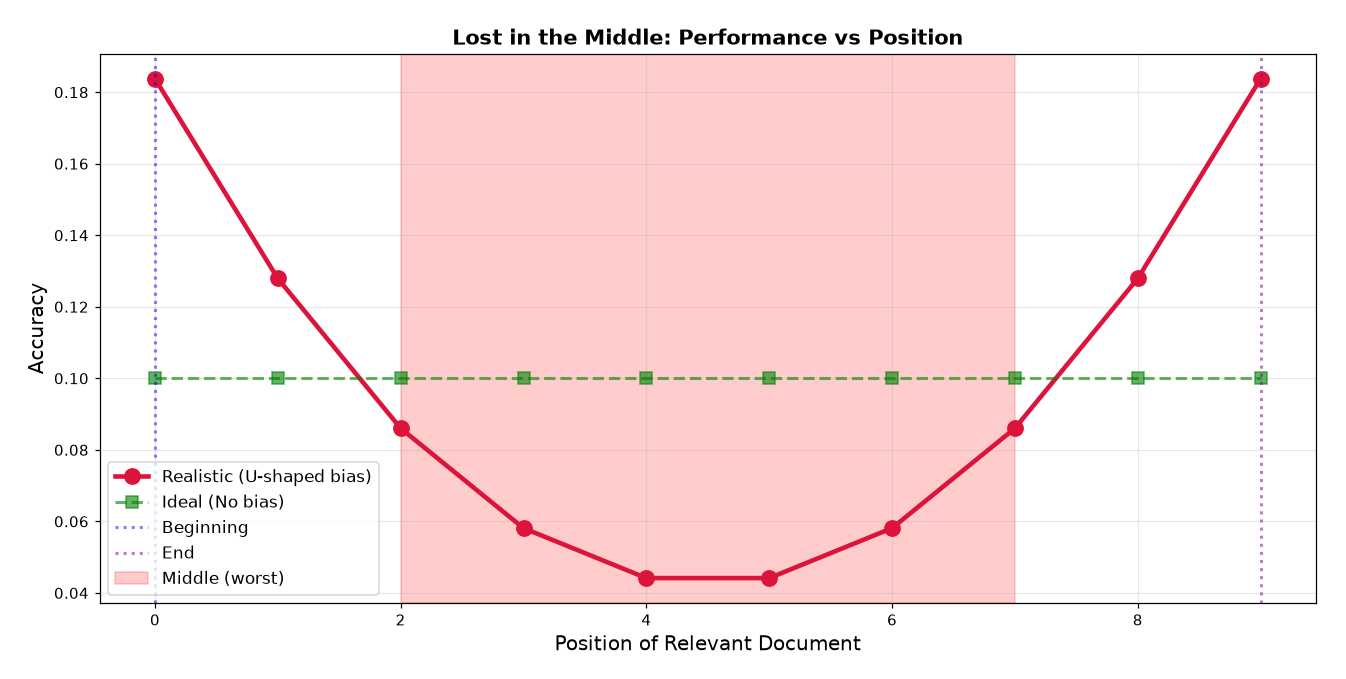 그림 4. Lost in the Middle 노트북의 정확도 곡선. 출처: 저장소의
30_lost_in_middle.ipynb를 실행해 얻은 그림
실행하지 않은 노트북 중에도 학습 없이 시연만 한다고 스스로 밝힌 경우가 있다. 8번 노트북은 평가 셀에서 “학습 없이 아키텍처만 시연한다"는 경고를 출력하고, 23번 MDL 노트북의 학습 함수 설명에는 “속도를 위해 순전파만 한다, 실제로는 제대로 된 역전파를 써야 한다"고 적혀 있다.
파생 저장소
저자는 2026년 3월에 이 저장소를 기반으로 한 저장소 두 개를 더 공개했다. 3월 15일 공개한 Sutskever-Agent는 GitAgent 형식의 에이전트 정의로, 논문을 설명하고 노트북을 안내하며 기울기를 추적하고 PR을 검토하는 AI 교사 역할을 맡는다. 사용 모델은 claude-sonnet-4-6이다. 3월 24일 공개한 sutskever-30-beyond-numpy는 같은 30편을 SymPy, tinygrad, PyTorch, JAX, Cubical Agda로 구현하는 다중 백엔드 판이다. 이 판에서는 NumPy 판을 기준 명세로 삼고, 실제 학습 구현은 PyTorch가 맡는다. README 상단에는 이 저장소의 Google Colab 코드를 판매하는 Gumroad 링크가 있다.
가장 흥미로운 지점
노트북을 돌리며 계속 마음에 걸린 것은 그림 1과 그림 4가 같은 저장소에서 나왔다는 점이다. 문자 RNN 노트북에서는 무작위 글자가 조금씩 단어로 바뀌는 과정을 볼 수 있고, 그림 1의 손실 곡선은 그 과정을 기록한 것이다. 반면 그림 4의 U자 곡선은 저자가 입력한 이차식을 그대로 그린 것이다. 이 노트북을 읽은 독자는 논문의 결론이 어떤 모양인지는 배우지만, 긴 컨텍스트에서 왜 그런 모양이 생기는지는 배우지 못한다. README는 “마법 없이 모든 연산을 명시한다"고 약속했다. 그런데 22번, 27번, 30번 노트북이 명시한 연산은 결론의 모양을 그리는 연산이다.
커밋 이력에서 결과 주장을 바로잡은 수정은 18번에만 있다. 30편은 모두 나흘 사이에 만들어졌는데, 그중 단계별 계획 문서를 따로 두고 사흘을 들인 노트북은 18번 하나다. 이 저장소를 교재로 쓴다면 논문 목록과 학습 순서는 그대로 참고할 만하다. 노트북을 열었을 때는 먼저 학습 함수에 가중치 갱신 코드가 있는지 확인하는 편이 좋겠다.
출처
Paul “The Pageman” Pajo, 「Sutskever 30 - Complete Implementation Suite」, GitHub 저장소. 첫 커밋 2025년 12월 6일, 마지막 커밋 2026년 3월 15일. README, PROGRESS.md, IMPLEMENTATION_TRACKS.md, PAPER_18_ORCHESTRATOR_PLAN.md, 커밋 이력을 참고했고, 노트북 다섯 개는 2026년 9월 30일에 직접 실행했다. 본문 그림은 모두 그 실행 결과다.
원문: https://github.com/pageman/sutskever-30-implementations
카맥의 발언은 여러 곳에 인용된 인터뷰 문장이다. Tensorlabbet의 「The Lost Reading Items」(2024년 11월 11일)는 2024년 판본을 정리했다. 이 판본에는 원래 40개 안팎의 항목 가운데 27개만 담겼으며, 공식 확인을 받은 적도 없다. ↩︎
실행 환경은 Windows 11, Python 3.13.3, NumPy 2.5.3, matplotlib 3.11.2, SciPy 1.18.1이다. 노트북들은 첫 셀에서 난수 시드를 42로 고정한다. ↩︎
손실은 25자 구간의 교차 엔트로피 합이다. 초깃값 79.45는 어휘 24개에 같은 확률을 줄 때의 값이다. 24의 자연로그에 25를 곱하면 나온다. ↩︎