3줄 요약
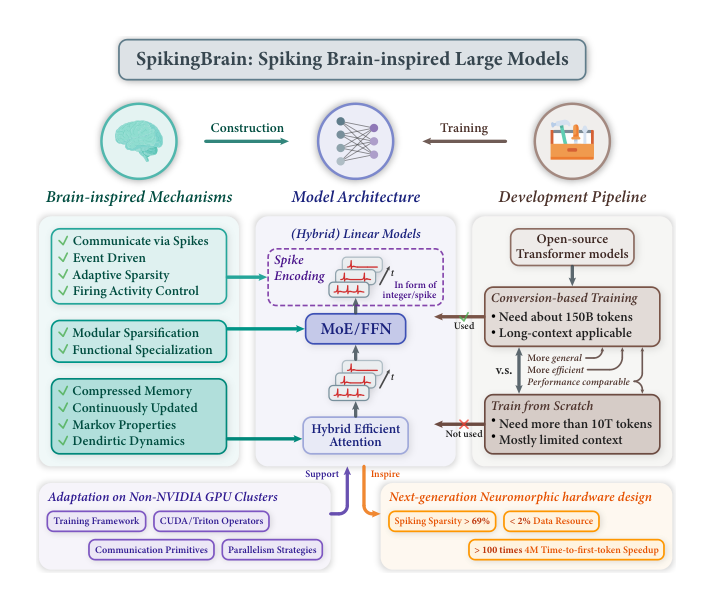
- GPU 제조사 MetaX 연구진이 함께 쓴 기술 보고서로, 중국과학원 자동화연구소의 리궈치(Guoqi Li)와 쉬보(Bo Xu)가 교신저자다. 2025년 9월 arXiv에 처음 공개된 뒤 2026년 5월에 4판으로 개정됐고, TMLR 2026 게재가 승인됐다. 연구진은 Qwen2.5-7B를 변환해 선형 복잡도 모델 SpikingBrain-7B와 혼합 선형 MoE 모델 SpikingBrain-76B-A12B를 만들었다. 학습에는 엔비디아가 아닌 MetaX C550 GPU 수백 장을 썼다.
- 원래 모델의 어텐션 가중치를 재사용하는 변환 방식이어서 연속 사전학습에 쓴 데이터는 약 1,500억(150B) 토큰이었다. 처음부터 학습할 때 보통 드는 약 10조(10T) 토큰의 2% 수준이다. 7B 모델은 베이스 모델 성능의 약 90%를 회복했고, 76B 모델과 베이스 모델의 점수 차이는 MMLU 1.7점, C-Eval 2.8점이었다. 400만(4M) 토큰을 입력하면 첫 토큰이 Qwen2.5-7B보다 100배 이상 빨리 나온다고 추정했다.
- 활성값을 정수 스파이크 수로 바꾸는 적응 임계값 방식으로 희소도 69.15%를 얻었고, 가중치 INT8 양자화와 함께 적용했을 때 평균 점수는 약 2% 떨어졌다. 비동기 뉴로모픽 하드웨어를 이상적으로 가정하면 곱셈 누산 에너지가 FP16 대비 97.7% 줄어든다고 추정했다. GPU에서 측정한 속도 향상은 어텐션 구조를 바꾼 효과다.
두 모델의 구성
두 모델은 모두 Qwen2.5-7B 베이스 모델의 체크포인트를 기반으로 만들었다. SpikingBrain-7B는 긴 문맥 효율을 최대한 높이는 것을 목표로 했고, SpikingBrain-76B는 효율과 언어 모델링 성능을 함께 갖추도록 설계했다.
| SpikingBrain-7B | SpikingBrain-76B-A12B | |
|---|---|---|
| 어텐션 혼합 방식 | 층간 순차 혼합. 선형 어텐션 층과 슬라이딩 윈도 어텐션(창 4k) 층이 1:1로 교대한다 | 층내 병렬 혼합. 한 층에서 선형 어텐션과 슬라이딩 윈도 어텐션을 1:1로 함께 계산한다. 28개 층 가운데 7, 14, 21, 28번 층은 슬라이딩 윈도 대신 전체 소프트맥스 어텐션을 쓴다 |
| 선형 어텐션의 게이트 | 저랭크 투영으로 만든 게이트 벡터 | 키 벡터로 정한 게이트 $g_t = 1 - k_t$. 게이트용 파라미터가 따로 없다 |
| FFN | 베이스 모델의 SwiGLU를 그대로 쓴다 | 라우팅 전문가 16개(토큰당 1개 활성)와 공유 전문가 1개. 1, 2, 3, 5, 7, 9, 11번 층은 밀집 FFN을 유지한다 |
| 추가 요소 | 없음 | 학습 가능한 싱크 토큰 128개1 |
| 파라미터 | 7B | 전체 76B, 토큰당 활성 12B(약 15%) |
| 복잡도 | 선형. 추론 메모리가 시퀀스 길이와 관계없이 일정하다 | 혼합. 전체 어텐션 층을 제외한 층의 메모리가 일정하다 |
| 스파이크 부호화 | 모든 선형 투영 층의 입력 활성값 | 모든 선형 투영 층의 입력 활성값 |
| 연속 사전학습 토큰 | 약 150B | 약 160B2 |
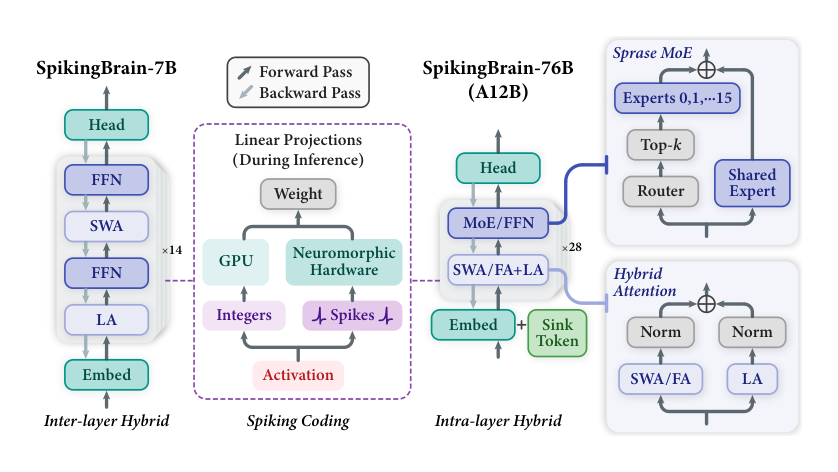
소프트맥스, 슬라이딩 윈도, 선형, 세 가지 어텐션은 강점이 서로 다르다. 소프트맥스 어텐션은 시퀀스 전체에서 정보를 정확히 검색한다. 그 대신 학습 계산량이 시퀀스 길이 n의 제곱에 비례하고, 추론할 때는 KV 캐시 메모리가 n에 비례해 늘어난다. 슬라이딩 윈도 어텐션은 최근 w개 토큰만 계산하므로 학습 계산량이 $O(n)$, 추론 메모리가 $O(1)$이다. 선형 어텐션은 소프트맥스를 없애 고정 크기 상태를 갱신하는 순환 형태로 바꿀 수 있다.
$$o_t = q_t S_t, \quad S_t = \mathrm{diag}(g_t) \odot S_{t-1} + k_t^\top v_t$$선형 어텐션의 계산량과 메모리도 각각 $O(n)$과 $O(1)$이다. SpikingBrain은 두 방식의 역할을 구분해서 쓴다. 최근 토큰 사이의 세밀한 관계는 슬라이딩 윈도가 계산하고, 오래전 토큰의 정보는 선형 어텐션의 상태에 압축해 보존한다.
연구진은 이 구조를 뇌의 메커니즘과 연결했다. 선형 어텐션은 압축된 상태를 계속 갱신하고 현재 상태에서만 정보를 읽는다. 연구진은 이 방식이 인간의 기억과 비슷하고, 이 순환 구조를 수상돌기 동역학에 대한 추상적인 계산상의 비유로 볼 수 있다고 설명했다. MoE는 신경 회로의 모듈식 기능 특화에, 스파이크 부호화는 이벤트 구동 방식의 희소한 뉴런 활성에 대응시켰다.
변환 학습
어텐션 가중치 재사용
사전학습된 트랜스포머의 어텐션 맵은 $A = \mathrm{softmax}(QK^\top \odot M)$이다. 슬라이딩 윈도 어텐션은 이 맵에서 최근 토큰만 계산하는 희소 버전이고, 선형 어텐션은 최대 랭크가 d(쿼리와 키 벡터의 차원)인 저랭크 근사다. 세 방식 모두 같은 QK 유사도를 사용하므로, Q, K, V 투영 가중치를 사전학습 체크포인트의 값으로 초기화할 수 있다. 논문에 따르면 슬라이딩 윈도는 국소 정밀도를, 선형 어텐션은 전역 상호작용을 맡는다. 두 방식을 함께 쓰면 원래 어텐션 맵과의 차이가 줄고 손실도 빨리 수렴한다.
변환을 안정시키려고 따른 원칙은 네 가지다.
- 소프트맥스 어텐션 맵의 값은 항상 0 이상이다. 변환한 어텐션도 이 성질을 유지하도록, 선형 어텐션의 Q, K 벡터에 0 이상의 값만 내는 활성화 함수를 적용한다. 7B는 ReLU를, 76B는 시그모이드를 썼다. 선형 어텐션의 출력에는 정규화를 적용한다.
- 정규화 층, 게이트, 싱크 토큰처럼 새로 추가하는 파라미터는 저랭크로 줄인다. 변환 학습은 사전학습보다 학습률이 낮고 데이터가 적어서, 무작위로 초기화한 파라미터가 많으면 제대로 최적화하기 어렵다.
- 긴 문맥 확장을 변환과 함께 진행한다. 이차 복잡도인 원래 모델로 긴 문맥을 학습하는 비용을 피할 수 있다.
- 백본을 고정하지 않고 전체 파라미터를 학습한다. 증류 대신 이 방식을 택한 이유는 구현이 단순하고 MetaX GPU의 메모리 용량에 맞기 때문이다.
MoE 업사이클링
76B 모델의 FFN은 밀집 FFN을 전문가 N개로 복제하고 라우터를 무작위로 초기화해 만들었다. 학습을 시작할 때는 모든 전문가가 같으므로 원래 FFN과 같은 출력을 낸다. 학습이 진행되면 확률적 라우팅과 데이터 잡음 때문에 전문가 사이의 대칭이 깨지고, 전문가마다 다른 기울기를 받아 특화된다.
공유 전문가 S개와 라우팅 전문가 k개가 함께 활성화되면 출력 크기가 밀집 FFN의 $(S + k/N)$배가 된다. 이 차이는 초기화할 때 모든 전문가 가중치에 다음 계수를 곱해 보정했다.
$$\alpha = \sqrt[3]{\frac{1}{S + k/N}}$$76B 모델은 S = 1, k = 1, N = 16이어서 α = 0.98이다.
학습 단계
| 단계 | 시퀀스 길이 | 데이터 | 분량 |
|---|---|---|---|
| 연속 사전학습 1단계 | 8k | Matrix | 100B 토큰 |
| 연속 사전학습 2단계 | 32k | Matrix | 20B에서 30B 토큰 |
| 연속 사전학습 3단계 | 128k | Matrix | 20B에서 30B 토큰 |
| 지도 미세조정 1단계 (기초 지식) | 8k | Infinity Instruct foundational | 50만 샘플 |
| 지도 미세조정 2단계 (대화와 지시 따르기) | 8k | Infinity Instruct chat | 50만 샘플 |
| 지도 미세조정 3단계 (추론) | 8k | DeepSeek-R1 방식으로 증류한 추론 데이터, 중국어와 영어 1:1 | 15만 샘플 |
연속 사전학습 1단계에서는 어텐션 패턴을 국소 변형과 저랭크 변형에 맞추고 손실을 수렴시켰다. 2단계와 3단계는 문맥 길이를 늘리는 단계다. 긴 문맥 데이터는 도메인별로 짧은 글을 이어 붙여 만들었고, RoPE base는 베이스 모델과 같은 1M을 유지했다.
적응 임계값 스파이킹
LIF 뉴런의 한계
스파이킹 신경망에서 흔히 쓰는 LIF(Leaky Integrate-and-Fire) 뉴런에서는 입력이 들어올 때마다 막전위가 누적되고 일부가 누설된다. 막전위가 고정 임계값 이상이 되면 뉴런이 스파이크를 내고 막전위는 리셋된다. 대형 모델에 LIF를 그대로 쓰면 문제가 세 가지 생긴다고 한다. 감쇠 계수와 리셋이 만드는 시간 동역학 때문에 학습이 복잡하고 불안정해진다. 사전학습 모델에 LIF를 넣어도 불필요한 복잡도가 남아 원래 활성값을 재현하기 어렵다. 임계값이 고정되어 있어서 많은 뉴런이 침묵하거나 과도하게 활성화된다.
1단계: 정수 스파이크 수 계산
SpikingBrain은 임계값을 막전위의 평균 절댓값에 비례하게 정한다.
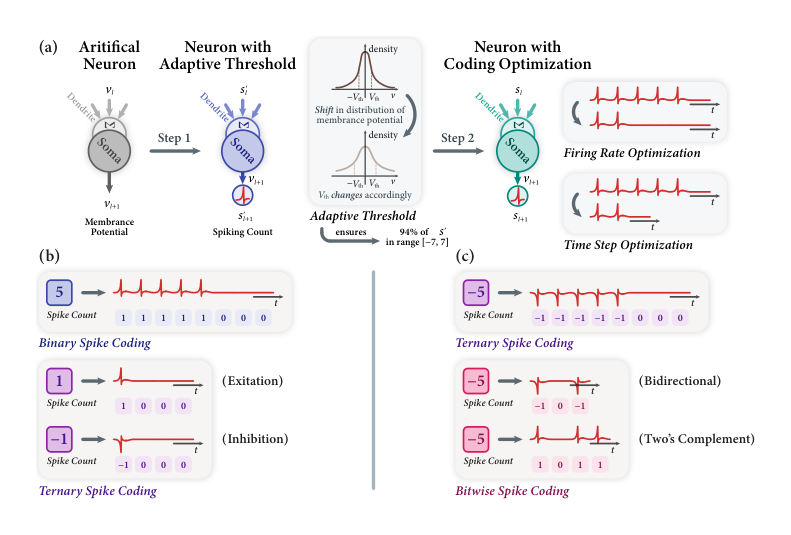
$$V_{th}(x) = \frac{1}{k}\,\mathrm{mean}(|x|)$$x는 투영 층에 들어가는 부동소수점 활성값이다. 감쇠 계수를 없앤 IF 뉴런에 소프트 리셋을 적용하면, 학습할 때는 시간 차원을 한 단계로 축약해 정수 스파이크 수를 바로 계산할 수 있다.
$$s_{INT} = \mathrm{round}\left(\frac{x}{V_{th}(x)}\right)$$기울기를 계산할 때는 반올림 과정을 항등 함수로 취급하는 직통 추정(straight-through estimation)을 쓴다. 입력 막전위가 크면 임계값이 높아져 스파이크가 과도하게 생기지 않고, 작으면 임계값이 낮아져 정보를 잃지 않는다. 드물게 나오는 큰 이상값에서는 스파이크 수가 많아지는데, 논문은 이것을 생물학적 뉴런의 버스트 반응에 비유했다. 하이퍼파라미터 k가 클수록 임계값이 낮아져 스파이크가 많아지며, 기본값은 k = 3이다.
2단계: 스파이크 열로 전개
추론할 때는 정수 스파이크 수를 가상의 시간 단계에 걸친 스파이크 열 $s_t \in \{-1, 0, 1\}$로 전개한다. 그러면 선형 투영은 다음과 같이 쓸 수 있다.
$$y = V_{th}(x) \cdot \sum_{t=1}^{T} W s_t$$$s_t$의 값이 -1, 0, 1뿐이므로, 행렬 곱셈은 스파이크가 발생한 채널의 가중치를 더하거나 빼는 누산으로 바뀐다. 전개 방식으로는 세 가지가 제시됐다.
| 방식 | 스파이크 값 | 특징 | 스파이크 수 256에 필요한 시간 단계 |
|---|---|---|---|
| 이진 | {0, 1} | 가장 단순하다. 양의 정수만 표현할 수 있어서 적응 임계값 방식에는 쓸 수 없다 | 256 |
| 삼진 | {-1, 0, 1} | 억제 스파이크(-1)를 추가했다. 이진 방식보다 시간 단계는 절반이고 발화율은 절반 이하다 | 128 |
| 비트 단위 | 시간 단계마다 이진수 한 자리 | 순수 비트, 양방향(각 자리를 ±1로 표현), 2의 보수의 세 가지 형태가 있다 | 8 (양방향은 7) |
그림 4의 예에서 스파이크 수 -5를 삼진 부호화로 표현하면 -1이 다섯 번 필요하다. 양방향 비트 단위 부호화는 (-1, 0, -1)의 세 단계로 표현한다. 각 단계에 1, 2, 4를 곱해 더하면 -1 + 0 - 4 = -5다.
정확도와 희소도
가중치를 대칭 INT8로 양자화하고 모든 선형 투영 층의 입력에 스파이크 부호화를 적용한 구성을 가중치 8비트(W8)와 스파이크 활성값(ASpike)이라는 뜻에서 W8ASpike라고 부른다. 전체 미세조정은 하지 않았고, 텍스트 128개로 양자화 파라미터만 보정했다. 7B 모델은 메모리 15GB인 GPU 한 장으로 이 보정을 약 1.5시간 만에 끝냈다.
| 모델 | 원본 평균3 | W8ASpike 평균 | MMLU | CMMLU |
|---|---|---|---|---|
| SpikingBrain-7B | 0.6998 | 0.6875 | 0.6751 → 0.6546 | 0.6904 → 0.6677 |
| SpikingBrain-76B | 0.7304 | 0.7133 | 0.7247 → 0.7081 | 0.7740 → 0.7512 |
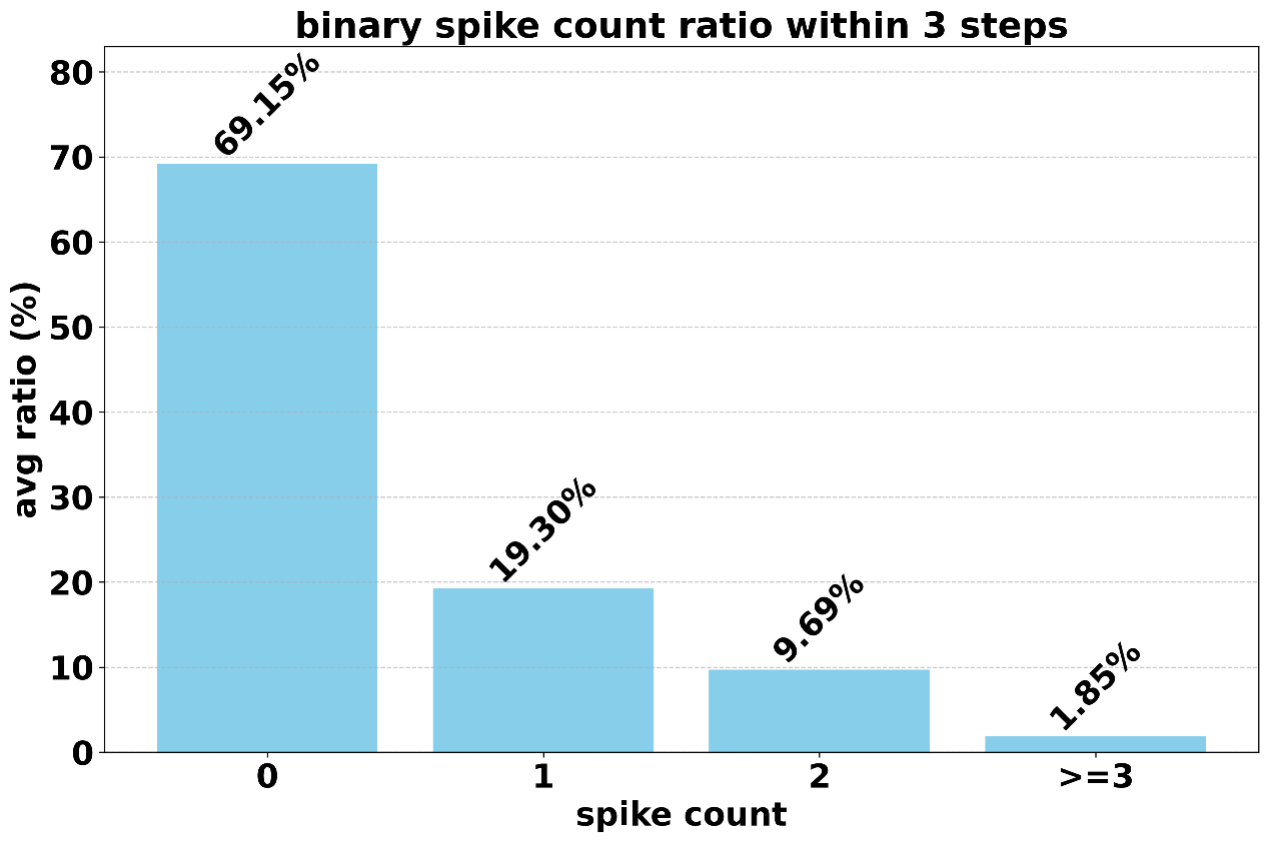
7B 모델의 모든 선형 투영 층에서 정수 스파이크 수의 절댓값을 집계한 결과, 값의 94.1%가 0에서 7 사이였고 16을 초과하는 값은 약 1%였다.4 비트 단위와 삼진을 결합한 방식으로 전개하면 채널당 평균 스파이크는 1.13개였고, 채널의 18.4%는 스파이크를 하나도 내지 않았다. 값 대부분이 INT3 범위여서 시간 단계를 3으로 정했다. 3단계 가운데 쓰이지 않는 비트를 0으로 채워 계산한 희소도는 약 69.15%였다.
임계값을 정하는 k가 클수록 평균 점수는 오르고 희소도는 낮아진다.
| 7B 구성 | 평균 점수 | 희소도 | 7 이하 값의 비율 |
|---|---|---|---|
| BF16 원본 | 0.6998 | 해당 없음 | 해당 없음 |
| k = 2 | 0.6735 | 0.730 | 0.989 |
| k = 2.5 | 0.6807 | 0.709 | 0.976 |
| k = 3 (기본값) | 0.6875 | 0.692 | 0.951 |
| k = 3.5 | 0.6898 | 0.677 | 0.916 |
| k = 4 | 0.6940 | 0.664 | 0.877 |
에너지 추정
에너지 비교에는 45nm 공정에서 공개된 연산 에너지 수치를 썼다. 비교 대상은 곱셈 누산(MAC) 한 번에 드는 에너지다.
| 방식 | MAC 한 번의 에너지 |
|---|---|
| FP16 MAC | 1.5pJ |
| INT8 MAC | 0.23pJ |
| 스파이크 구동 계산 + INT8 가중치 | 평균 스파이크 1.13개 × INT8 덧셈 0.03pJ = 약 0.034pJ |
이 계산에 따르면 에너지는 FP16 대비 97.7%, INT8 대비 85.2% 줄어들고, 에너지 효율은 각각 43.48배와 6.76배가 된다. 스파이크를 하나도 내지 않는 18.4%의 채널은 비동기 하드웨어에서 가중치를 읽어 오는 메모리 접근까지 생략할 수 있다고 한다.
부록 C.2는 이 추정에 포함되지 않은 요소를 세 가지로 밝혔다.
- 메모리 접근 단위: 추정은 채널 단위로 접근을 생략한다고 가정했다. 실제 DRAM과 SRAM은 블록 단위로 읽기 때문에, 활성 채널과 비활성 채널의 가중치가 같은 블록에 저장되어 있으면 읽기를 생략할 수 없다.
- 비동기 제어 비용: 핸드셰이크 프로토콜, 스파이크 검출, 이벤트 라우팅 회로가 쓰는 에너지와 면적은 계산에 포함되지 않았다.
- 희소도 변동: 평균 1.13개라는 값은 데이터셋과 층에 따라 달라진다. 평균 희소도에 맞춰 설계한 하드웨어는 희소도가 낮은 입력에서 효율이 떨어진다.
공개 저장소의 W8ASpike 구현은 유사 스파이킹(pseudo-spiking)이다. 텐서 수준에서 활성값을 스파이크와 비슷한 신호로 근사할 뿐이다. 저장소 README는 비동기 이벤트 구동 하드웨어에서 실행하는 실제 스파이킹을 이 저장소에서 다루지 않는다고 밝혔다.
성능
사전학습 모델
평가는 OpenCompass로 모든 모델을 같은 설정에서 진행했고, 점수는 퍼플렉시티 기반이다. 적은 토큰으로 변환한 모델이 베이스 모델의 지식을 유지했는지 확인하는 것이 목적이어서 MMLU와 C-Eval 같은 사전학습 지향 벤치마크를 주로 사용했다. Qwen2.5를 제외한 비교 모델은 중국어 학습 데이터가 적어서 CMMLU와 C-Eval에서 불리하다.
| 모델 | 학습 토큰 | 복잡도 | MMLU | CMMLU | C-Eval | HellaSwag | ARC-C |
|---|---|---|---|---|---|---|---|
| SpikingBrain-7B | +150B | 선형 | 65.84 | 71.58 | 69.80 | 70.89 | 43.32 |
| Qwen2.5-7B (베이스) | 18T | 이차 | 74.21 | 81.73 | 81.60 | 72.81 | 44.04 |
| Llama3.1-8B | 15T | 이차 | 65.74 | 52.44 | 51.46 | 71.60 | 51.96 |
| Mistral-7B | 공개 안 됨 | 선형 | 62.56 | 44.58 | 47.04 | 75.81 | 45.13 |
| Falcon-Mamba-7B | 5.8T | 선형 | 63.24 | 42.50 | 41.93 | 71.50 | 47.53 |
논문의 평가로는 7B 모델이 베이스 모델 성능의 약 90%를 회복해 Mistral-7B, Llama3.1-8B와 비슷한 수준이 됐다. 논문은 베이스 모델과의 차이를 어텐션 구조를 크게 바꾼 결과로 해석했다.
| 모델 | 활성/전체 파라미터 | 학습 토큰 | MMLU | CMMLU | C-Eval | HellaSwag | ARC-C |
|---|---|---|---|---|---|---|---|
| SpikingBrain-76B | 12B/76B | +160B | 73.58 | 78.83 | 78.89 | 73.31 | 42.00 |
| Qwen2.5-7B (베이스)5 | 7B | 18T | 75.31 | 81.50 | 81.68 | 73.37 | 43.56 |
| Mixtral-8×7B | 13B/47B | 공개 안 됨 | 71.23 | 52.70 | 54.39 | 79.42 | 48.98 |
| Llama2-70B | 70B | 2T | 69.57 | 52.94 | 49.26 | 79.15 | 46.21 |
| Gemma2-27B | 27B | 13T | 75.94 | 61.80 | 61.02 | 79.34 | 57.64 |
| Jamba | 12B/52B | 공개 안 됨 | 67.17 | 51.11 | 48.94 | 79.39 | 49.10 |
76B 모델은 MMLU, CMMLU, C-Eval에서 베이스 모델과의 차이가 3점 이내로 줄었다. HellaSwag와 ARC-C 점수는 표의 모든 모델보다 낮다.
지시 학습 모델
연구진은 지도 미세조정 3단계를 거친 모델이 비슷한 규모의 오픈 채팅 모델과 대등하다고 평가했다.
| 벤치마크 | SpikingBrain-7B | SpikingBrain-76B | Llama3-8B | Qwen2.5-7B | Mixtral |
|---|---|---|---|---|---|
| MMLU | 65.57 | 73.71 | 68.69 | 75.17 | 71.03 |
| C-Eval | 69.07 | 76.32 | 55.01 | 77.93 | 50.88 |
| NQ | 21.47 | 21.55 | 30.97 | 17.67 | 28.48 |
| QuALITY | 60.12 | 69.56 | 66.25 | 73.63 | 51.34 |
| IFEval | 42.70 | 49.72 | 73.01 | 73.20 | 48.06 |
지시 따르기를 재는 IFEval에서 SpikingBrain은 Llama3-8B, Qwen2.5-7B보다 20점 이상 낮다. 연구진은 데이터 한계 때문에 대규모 고품질 정렬 학습을 향후 과제로 남겼다.
긴 문맥 이해와 회상
76B 모델(지도 미세조정 2단계 이후)을 LongBench 여섯 과제로 32k 길이에서 평가했다. 전체 소프트맥스 어텐션 층이 4개뿐인데도 혼합 어텐션 모델, 트랜스포머 비교군과 대등했다고 한다. 예를 들어 SpikingBrain-76B는 HotpotQA 50.00점, TriviaQA 90.84점, Qasper 39.59점이고, Qwen2.5-7B는 각각 57.62점, 85.92점, 45.13점이다.
논문은 LongBench가 긴 문맥 이해를 재는 벤치마크이고 회상 능력은 따로 재지 않는다고 덧붙였다. 부록에서는 Qwen3-1.7B를 5B 토큰으로 변환하는 조건을 같게 맞추고 어텐션 구성을 비교했다.
| 구성 | HellaSwag | MMLU | SNIAH 4k | SNIAH 8k |
|---|---|---|---|---|
| 전체 어텐션 (기준) | 60.21 | 61.78 | 100.0 | 98.41 |
| 슬라이딩 윈도 (창 4k) | 60.12 | 61.74 | 100.0 | 47.60 |
| 슬라이딩 윈도 (창 128) | 측정 안 함 | 측정 안 함 | 1.87 | 0.00 |
| 선형 어텐션 | 54.72 | 39.87 | 36.16 | 39.40 |
| 혼합 (선형 : 슬라이딩 윈도 = 1:1) | 57.88 | 56.08 | 96.83 | 44.44 |
SNIAH는 긴 문서에 섞어 둔 문장 하나를 찾게 하는 과제다.6 논문은 이 결과를 세 가지로 해석했다. 첫째, 원래 트랜스포머에서 구조를 적게 바꿀수록 일반 성능이 빨리 회복된다. 둘째, 회상 성능은 모델이 유지하는 상태의 크기가 결정한다. 셋째, 일반 성능, 회상, 효율을 함께 고려하면 혼합 구성이 가장 낫다. 8k 길이에서 혼합 구성의 SNIAH 점수는 44.44점으로 전체 어텐션의 98.41점보다 크게 낮다. 연구진은 Qwen3-Next와 Kimi Linear 사례를 들어, 충분한 데이터와 인프라로 학습하면 혼합 어텐션도 트랜스포머와 비슷한 검색 성능을 낼 수 있다고 했다.
같은 조건에서 구성 요소 세 가지의 조합 일곱 가지를 비교한 실험도 있다. 다음 표는 그중 다섯 가지를 보여 준다. 이 실험의 혼합 어텐션은 선형 어텐션과 슬라이딩 윈도를 1:3 비율로 혼합했고,7 MoE는 라우팅 전문가 4개와 공유 전문가 1개를 썼다.
| 구성 | HellaSwag | MMLU | 첫 토큰 지연 64k (ms) | 첫 토큰 지연 128k (ms) |
|---|---|---|---|---|
| 기준 (Qwen3-1.7B) | 60.21 | 61.78 | 3805.6 | 12553.3 |
| 혼합 어텐션 | 57.88 | 56.08 | 2239.7 | 4729.4 |
| MoE | 60.25 | 61.88 | 4880.7 | 14230.1 |
| 스파이크 부호화 | 59.63 | 61.17 | (3805.6) | (12553.3) |
| 셋 모두 | 57.77 | 55.02 | (2558.2) | (5055.2) |
괄호 안의 값은 GPU에서 스파이크 대신 정수 활성값으로 실행하므로 스파이크 부호화를 뺀 구성과 지연이 같다는 뜻이다.
속도
긴 입력의 첫 토큰 지연
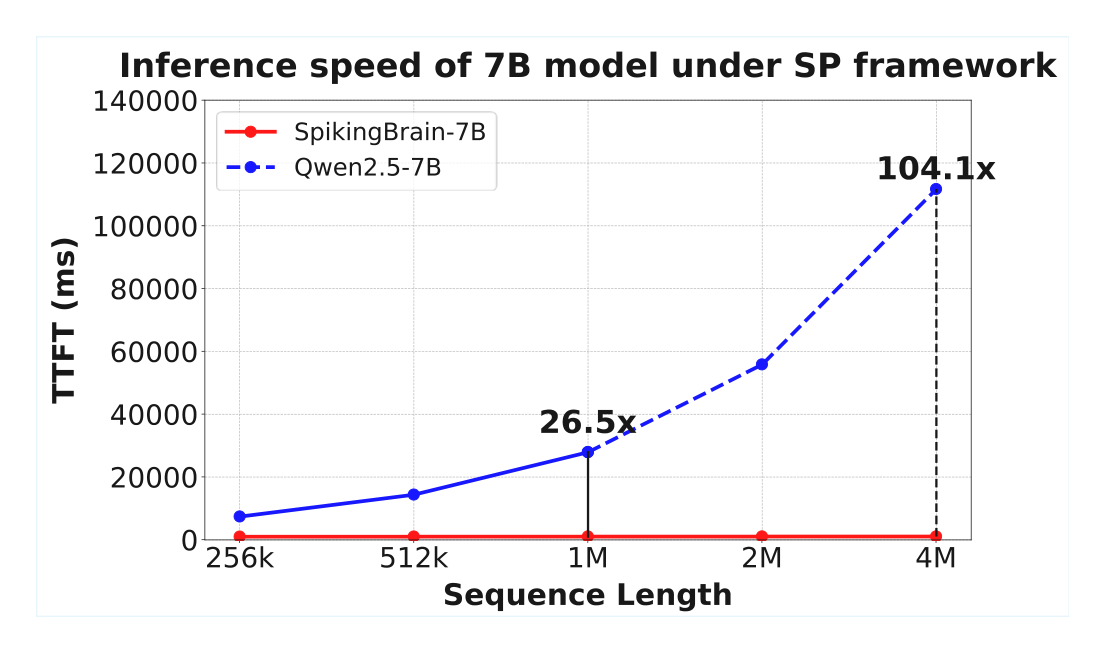
7B 모델은 시퀀스 병렬 추론을 적용해 4M 토큰까지 프리필을 처리했다. 선형 어텐션에는 시퀀스 병렬 방식 ZeCO를, 슬라이딩 윈도 어텐션에는 P2P 통신을 썼고, Qwen2.5-7B는 all-to-all 통신을 썼다. 측정은 엔비디아 H100에서 10회 평균으로 했다.
| 시퀀스 길이 | GPU 수 | SpikingBrain-7B (ms) | Qwen2.5-7B (ms) |
|---|---|---|---|
| 256k | 8 | 1,015 | 7,419 |
| 512k | 16 | 1,037 | 14,398 |
| 1M | 32 | 1,054 | 27,929 |
| 2M | 64 | 1,070 | 측정 불가 |
| 4M | 128 | 1,073 | 측정 불가 |
시퀀스 길이와 GPU 수를 같은 비율로 늘리자 SpikingBrain-7B의 첫 토큰 지연은 1초 남짓으로 거의 변하지 않았다. 1M 토큰에서는 Qwen2.5-7B보다 26.5배 빠르다. Qwen2.5-7B는 2M 이상에서 자원 한계와 어텐션 헤드 수 때문에 측정하지 못했다. 연구진은 측정값에 맞춘 스케일링 곡선으로 외삽해 4M에서 100배 이상 빠르다고 보수적으로 추정했다.
MetaX C550에서의 추론 지연
시퀀스 병렬 없이 MetaX C550에서 입력을 처리하고 출력 128토큰을 생성하는 시간을 쟀다. 128k 입력 기준으로 정리하면 다음과 같다.
| 프레임워크와 GPU | SpikingBrain-7B | Mistral-7B | Qwen2.5-7B |
|---|---|---|---|
| HuggingFace, 1장 | 15,974ms | 28,382ms | 38,487ms |
| vLLM, 1장 | 12,048ms | 11,867ms | 45,141ms |
128k에서 SpikingBrain-7B는 Qwen2.5보다 빠르고, 같은 선형 복잡도인 Mistral-7B와는 비슷하거나 더 빠르다.8 vLLM에서 GPU 4장으로 128k를 처리할 때 76B 모델은 14,109ms, Llama2-70B는 86,120ms가 걸렸다.9 128k 길이 학습에서 GPU 한 장이 초당 처리한 토큰 수는 7B 모델이 Qwen2.5보다 5.36배 많았다.
CPU 추론
1B 규모로 압축한 SpikingBrain 선형 모델(선형 어텐션과 슬라이딩 윈도의 층간 혼합)과 Llama3.2-1B를 llama.cpp 기반의 CPU 추론 프레임워크에 배포했다. 인텔 Core i5-12600KF, 메모리 64GB 환경에서 가중치는 Q4_0으로 양자화했다. CPU 호환성을 위해 활성값은 스파이크 열로 전개하지 않고 정수 그대로 썼다. 입력은 1k 토큰으로 두고 출력 길이를 늘려 가며 디코딩 속도를 쟀다.
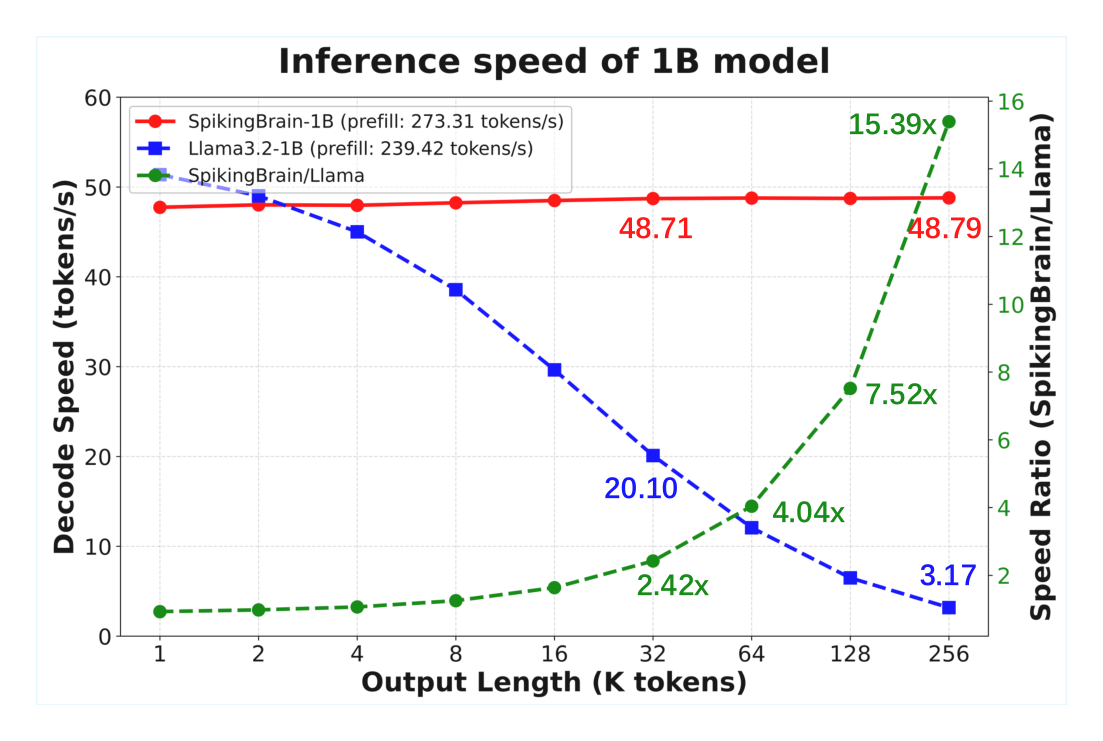
SpikingBrain-1B는 디코딩하는 동안 계산량과 메모리가 일정해서 출력이 길어져도 처리 속도가 거의 같았다. Llama3.2-1B는 전체 KV 캐시를 계산하느라 출력이 길어질수록 느려졌다. 출력이 64k일 때 SpikingBrain-1B는 Llama3.2-1B보다 4.04배, 128k일 때 7.52배, 256k일 때 15.39배 빠르다.
MetaX 클러스터에서의 학습
두 모델은 모두 MetaX C550 GPU 수백 장으로 학습했다.10 논문은 연구진이 아는 한 이것이 엔비디아가 아닌 플랫폼에서 뇌에서 착안한 대형 언어 모델을 대규모로 학습한 첫 사례이며, 76B 규모에서 학습이 안정적이었다고 했다.
- 7B 모델 학습에서 GPU 한 장이 초당 처리한 토큰은 1,558개, 모델 연산 활용률(MFU)은 23.4%였다(데이터 병렬 8, 파이프라인 병렬 4, 전역 배치 512). 같은 병렬 구성의 엔비디아 A800 80GB 클러스터에서 잰 MFU는 25.8%였다. MetaX 클러스터는 호환성 문제로 더 오래된 소프트웨어 버전을 썼다.
- 학습은 2주 이상 중단 없이 이어졌다.
- 7B 모델은 Colossal-AI로 학습했다. 128k 길이에서는 데이터 병렬 32와 시퀀스 병렬 8을 쓰고, ZeRO-2와 활성값 재계산으로 메모리를 줄였다.
- 76B 모델은 Megatron으로 학습했다. 8k 길이에서 데이터 병렬 128, 전문가 병렬 8, 파이프라인 병렬 4를 썼고, 32k와 128k에서는 시퀀스 병렬을 각각 4와 8로 추가했다. 소프트맥스 어텐션 부분은 DeepSpeed Ulysses로, 선형 어텐션 부분은 LASP-2로 시퀀스를 분할했다.
- 연산자는 두 가지 방법으로 MetaX에 적응시켰다. Triton 커널을 MetaX에 맞춰 최적화하는 방법과 CUDA 코드를 MetaX의 MACA 프레임워크로 이식하는 방법이다.
- MoE 학습 초기의 메모리와 계산 부담을 줄이려고 네 가지 기법을 썼다. 자주 호출되는 전문가를 로컬에 복제했다가 부하가 안정되면 제거한다. 토큰이 많이 배정된 전문가에서만 활성값을 재계산한다. 재계산 범위는 세 단계로 조절한다. 전문가별 토큰 수도 맞춘다.
- DLRover Flash Checkpoint로 체크포인트 I/O 시간을 85% 줄였다. 이 방식은 학습 상태를 CPU 메모리에 먼저 쓰고 분산 파일 시스템에는 비동기로 저장한다.
엔비디아 A100과 MetaX C550을 같은 구현으로 비교한 결과도 부록에 있다. 7B 모델의 순전파 처리량에서 MetaX는 A100 대비 1k 길이에서 0.769배였고 16k 길이에서는 0.928배였다. 혼합 블록 하나의 전체 지연 차이는 모든 설정에서 2% 이내였다. 연산자별로 보면 MetaX가 FFN에서 약 6% 빨랐고, 선형 어텐션에서는 4k 길이 기준 54.6%, 65k 길이 기준 23.9% 느렸다. 논문은 선형 어텐션 커널을 최적화하는 것이 남은 차이를 줄이는 가장 직접적인 방법이라고 결론지었다.
기대와 달랐던 결과
효과가 없었던 설정과 MetaX에 적응하면서 겪은 어려움도 논문 6절에 공개되어 있다.
| 항목 | 내용 |
|---|---|
| 긴 문맥 데이터 | 짧은 글을 이어 붙인 데이터로 학습해서 극단적으로 긴 문맥의 성능 향상이 제한됐다. 원래부터 긴 문서나 회상 중심 데이터가 필요하다고 봤다 |
| MoE 초기화 | 전문가 가중치 일부를 무작위로 초기화해 다양성을 높여도 성능이 오르지 않아, 복제 후 재조정하는 방식을 유지했다 |
| 시퀀스 병렬 | 다중 노드 시퀀스 병렬 학습에서 GPU 활용률이 떨어지고 메모리 부족과 교착이 발생했다. 비동기 연산이 누적되면서 버퍼를 과도하게 미리 할당한 것과 노드 간 부하 불균형이 원인이었고, 통신 연산 뒤에 명시적 동기화를 추가해 해결했다 |
| 추론 미세조정 길이 | 8k 길이로 학습해서 긴 사고 과정이 잘렸다. 32k로 늘리면 추론 능력이 좋아진다고 한다 |
| MetaX 소프트웨어 | 개발 당시의 호환성 문제로 Megatron을 옛 버전 PyTorch와 Triton에 맞췄다. Triton 블록 크기와 자동 튜닝 설정을 보수적으로 정해서 완전히 최적화한 구현보다 성능이 낮았다 |
가장 흥미로운 지점
모델 이름에 스파이킹이 들어가 있으니, 나는 속도 향상 가운데 얼마가 스파이킹 덕분인지부터 알고 싶었다. 부록의 구성 요소 실험을 보면 답이 나온다. Qwen3-1.7B를 변환한 이 실험에서, 128k 입력의 첫 토큰 지연을 12,553ms에서 4,729ms로 줄인 요소는 혼합 어텐션이었다. 스파이크 부호화를 더한 구성은 지연이 기준 구성과 같아서 괄호로 표시되어 있었다. GPU에서는 스파이크 부호화가 활성값을 작은 정수로 표현하는 양자화로 동작하기 때문이다(부록 C.1). 본문의 100배 이상, 15.39배 같은 속도 향상도 스파이크 열 없이 어텐션 구조만 바꾼 모델에서 측정한 값이다.
연구진이 스파이킹으로 기대하는 것은 에너지 절감이다. 하지만 이 절감은 이벤트 구동 방식의 비동기 하드웨어에서만 나타나고, GPU에서는 측정할 수 없다. 97.7%라는 절감률도 그 하드웨어를 이상적으로 가정해 계산한 값이다. 부록 B.2 역시 구성 요소를 목적에 따라 골라 쓰는 방식을 제안한다. 긴 문맥 효율이 중요한 경우에는 혼합 어텐션을 쓰고, 성능을 더 높이고 싶다면 MoE를 더하며, 이벤트 구동 하드웨어에 배포할 때 스파이크 부호화를 적용하라고 권했다.
나는 이런 정리 방식이 정직하다고 느꼈다. 제목에서 받은 인상대로라면 뇌를 닮은 계산 방식이 속도를 높인 것 같은데, 표를 하나씩 확인해 보니 각 효과가 어느 구성 요소에서 나왔는지 따로 적혀 있었다. 성능이 낮게 나온 항목과 실패한 시도를 별도 절로 공개한 것도 같은 태도로 읽었다.
하드웨어에 관한 질문에는 아직 답이 없다. 연구진은 이 결과가 차세대 뉴로모픽 칩 설계에 참고가 되기를 바란다고 했고, 부록 C.2에는 활성 채널과 비활성 채널의 가중치를 다른 메모리 블록에 저장하는 설계 방안까지 적었다. 실제 칩에서 평균 1.13개의 스파이크를 처리하는 데 에너지가 얼마나 들지는 이 논문만으로는 알 수 없다.
출처
Yuqi Pan 외 17명, 「SpikingBrain: Spiking Brain-inspired Large Models」. 중국과학원 자동화연구소, MetaX 외. arXiv 2509.05276, 1판 2025년 9월 5일, 4판 2026년 5월 8일. 저장소 README에 따르면 TMLR 2026에 게재가 승인됐다. 이 글은 4판을 기준으로 정리했다.
원문: https://arxiv.org/pdf/2509.05276
초록 페이지: https://arxiv.org/abs/2509.05276
코드와 가중치: https://github.com/BICLab/SpikingBrain-7B11
후속 모델 SpikingBrain2.0(2026년 4월 공개): https://github.com/BICLab/SpikingBrain2.0
이 글의 그림은 모두 논문 4판의 arXiv HTML판에서 가져왔다.
어텐션 싱크는 소프트맥스 어텐션에서 의미와 관계없이 첫 토큰 같은 특정 토큰이 지나치게 큰 어텐션 가중치를 받는 현상이다. 학습 가능한 임베딩 128개를 입력 앞에 추가했다. 모든 토큰이 이 임베딩에 어텐션을 계산하고, 이 임베딩끼리도 인과 마스크 없이 서로 어텐션을 계산한다. 구현에는 FlashAttention 커널을 수정해 썼다. ↩︎
초록과 본문은 두 모델의 연속 사전학습 데이터를 묶어 약 150B 토큰이라고 적었고, 표 2는 76B 모델의 학습 토큰을 +160B로 표기했다. ↩︎
Winogrande, ARC-e, ARC-c, HellaSwag, PIQA, MMLU, CMMLU 일곱 과제의 평균이다. ↩︎
본문은 이 비율을 94.1%라고 적었고, 부록 표 11의 k = 3 행에는 0.951로 적혀 있다. ↩︎
7B 표는 HuggingFace로, 76B 표는 vLLM으로 평가해서 같은 Qwen2.5-7B의 점수가 조금 다르다. ↩︎
표의 모든 구성은 Qwen3-1.7B를 시퀀스 길이 8k, 배치 32, 학습률 $3 \times 10^{-5}$로 5B 토큰 분량을 학습해 변환했다. 창 4k 슬라이딩 윈도는 창 크기와 같은 4k 과제에서 100점이고, 8k 과제에서 47.60점으로 떨어진다. ↩︎
부록 B.1은 혼합 구성을 선형 어텐션 : 슬라이딩 윈도 = 1:1이라고 적었고, B.2는 1:3이라고 적었다. 그런데 두 표에서 혼합 구성의 HellaSwag 57.88점과 MMLU 56.08점은 같다. ↩︎
본문은 128k에서 Qwen2.5보다 1.41배(HuggingFace), 2.75배(vLLM) 빠르다고 적었다. 표 8에서 Qwen2.5의 지연 시간을 SpikingBrain의 지연 시간으로 나누면 2.41배, 3.75배다. 본문의 수치는 두 지연 시간의 차이를 SpikingBrain의 지연 시간으로 나눈 값과 같다. ↩︎
전문가 병렬을 켜면 76B 모델은 27,106ms, Mixtral-8×7B는 34,983ms로 76B 모델이 빨랐다. 전문가 병렬을 끄면 76B 모델은 14,109ms, Mixtral-8×7B는 8,046ms로 Mixtral이 빨랐다. ↩︎
MetaX는 중국의 GPU 제조사다. 실험에 쓴 C550은 HBM 메모리 64GB를 탑재했다. 노드 내 GPU는 MetaLink와 PCIe 5.0으로, 노드 사이는 InfiniBand 200/400G RDMA나 RoCE로 연결했다. ↩︎
README에 공개된 가중치는 7B 계열 네 종류(사전학습, 추론 미세조정 채팅, 비전언어, W8ASpike)이고 ModelScope에서 받을 수 있다. 76B 모델의 가중치는 목록에 없다. ↩︎