3줄 요약
- 뮌헨 공과대학교와 스위스 인공지능 연구소 IDSIA 소속의 위르겐 슈미트후버(Jürgen Schmidhuber)가 2008년 12월 23일 arXiv에 올린 논문이다. 2009년 4월 15일에 2판이 나왔고, 요약판은 일본 계측자동제어학회(SICE) 학회지 48권 1호(2009)에 실렸다. 슈미트후버가 1990년부터 발표해 온 인공 호기심 연구를 원리 하나로 정리한 글이며, 인지와 창작에 관한 여러 현상을 그 원리 하나로 설명하려 한다.
- 저자가 제시한 원리에 따르면, 계산 능력이 제한된 관찰자는 어떤 데이터를 예측하거나 압축하는 방법이 나아질 때 그 데이터를 흥미롭게 느낀다. 이 원리에서 주관적 아름다움은 관찰자의 압축기가 데이터를 압축해 줄이는 비트 수, 즉 압축 가능성에 비례하고, 흥미로움은 그 값이 시간에 따라 늘어나는 속도, 즉 학습 곡선의 기울기다. 완전히 예측할 수 있는 데이터와 백색 잡음은 둘 다 압축을 더 개선할 여지가 없어서 지루하다.
- 구현에는 세 요소가 필요하다. 계속 늘어나는 이력 데이터를 압축하는 학습기, 압축기가 얼마나 나아졌는지 재는 척도, 그 개선 폭을 내재 보상으로 받아 행동을 고르는 강화학습기다. 과학과 예술, 음악, 농담 역시 이 보상을 좇다가 생긴 부산물로 해석되며, 논문 결론은 이 예측을 심리학 실험과 신경과학 연구로 검증하자고 제안한다.
물리 법칙은 관측 데이터를 압축한다
논문은 물리학 이야기로 시작한다. 저자는 우주의 역사 전체가 계산 가능하다고 가정한다. 그렇다면 그 역사를 가장 간단하게 설명하는 방법은 역사를 계산하는 가장 짧은 프로그램이다. 하지만 주어진 데이터를 계산하는 최단 프로그램을 찾는 일반적인 방법은 없다. 그래서 물리학자들은 세계의 작은 측면을 하나씩 골라, 기존 법칙보다 관측을 더 잘 기술하는 단순한 법칙을 찾아 왔다. 저자의 해석으로 보면 이 작업은 관측 데이터를 기존 최선의 프로그램보다 더 잘 압축하는 프로그램을 찾는 과정이다.
저자가 드는 첫 사례는 뉴턴의 중력 법칙이다. 이 법칙은 짧은 코드로 적을 수 있고, 떨어지는 사과를 비롯한 수많은 관측 기록을 크게 압축한다. 사과 원자의 양자 요동은 설명하지 못하지만, 법칙이 성립한다고 가정하고 확률이 높은 사건에 짧은 부호를 할당하면 데이터를 기록하는 데 필요한 비트 수가 크게 줄어든다. 아인슈타인의 일반 상대성 이론은 뉴턴의 예측과 맞지 않던 관측을 간결하게 설명해 압축을 한 번 더 개선했다.
압축하려는 욕구가 물리학자에게만 있는 것은 아니다. 저자는 과거를 짧게 설명하는 규칙이 대개 미래를 예측하는 데도 도움이 되므로, 미래의 목표를 이루려는 지능 시스템이라면 자기 행동과 감각 입력의 이력을 압축하려는 동기를 가져야 한다고 주장한다. 장 피아제(Jean Piaget)는 아동의 탐색 행동을 동화(assimilation)와 조절(accommodation)이라는 두 개념으로 설명했다. 새 입력을 기존 도식으로 해석하는 동화를 저자는 일종의 압축으로, 기존 도식을 새 입력에 맞게 수정하는 조절을 압축 개선으로 해석한다. 그러나 피아제의 개념은 컴퓨터로 구현할 수 있을 만큼 형식화되지는 못했다고 덧붙인다.
네 가지 원칙
저자는 인공 호기심 틀을 네 가지 원칙으로 정리한다.
- 모든 것을 저장한다. 에이전트는 세계와 상호작용하는 동안 행동, 감각 관측, 보상 신호의 원시 이력을 전부 저장한다. 저자는 데이터를 “신성하다(holy)“고 표현했다. 세계에 대해 알 수 있는 모든 것의 유일한 근거이기 때문이다.
- 주관적 압축률을 높인다. 데이터 이력에 있는 규칙성은 어떤 것이든 압축에 쓸 수 있고, 압축된 데이터는 그 데이터를 단순하게 설명한 결과로 볼 수 있다. 에이전트는 계산 시간의 일부를 적응형 압축 알고리즘에 쓴다. 예를 들어 신경망이 이력의 일부를 다른 일부로부터 예측하거나 거꾸로 추정(postdict)하도록 학습하면, 전체를 부호화하는 데 필요한 비트 수가 조금씩 줄어든다.
- 압축의 진보를 내재 보상으로 삼는다. 압축기가 이력 데이터를 부호화하는 비트 수를 줄일 때마다, 절약한 비트 수에 비례하는 호기심 보상을 만든다.
- 내재 보상을 최대화한다. 행동을 고르는 컨트롤러는 범용 강화학습 알고리즘으로 호기심 보상을 포함한 기대 보상을 최대화한다. 좋은 강화학습 알고리즘은 특정한 대상에 주의와 학습 능력을 집중하는 행동을 고른다. 그 대상은 아직 알려지지 않았지만 학습할 수 있는 규칙성을 찾거나 만들어 낼 수 있는 대상이다. 저자의 표현으로는 압축기의 학습 곡선을 최대한 가파르게 만드는 행동이다.
평생의 감각 입력을 모두 저장한다는 원칙은 비현실적으로 들릴 수 있다. 저자는 이 의문에 답하려고 필요한 저장 용량을 직접 계산해 보였다.
| 항목 | 값 |
|---|---|
| 인간 수명 | 대개 $3\times 10^{9}$초 이하 |
| 뇌의 뉴런 수 | 약 $10^{10}$개 |
| 뉴런당 시냅스 수 | 평균 $10^{4}$개 |
| 원시 데이터 저장에 쓰는 비율 (가정) | 뇌 용량의 절반 |
| 시냅스 하나의 저장량 (가정) | 최대 6비트 |
| 평생 감각 입력의 기록 속도 | 초당 약 $10^{5}$비트 |
초당 $10^{5}$비트는 적당한 해상도의 영화를 기록할 때 필요한 수준이다. 저렴한 기술 시스템의 저장 용량도 곧 이 값을 초과할 것이라고 저자는 예상했다. 이 원칙은 “데이터를 저장할 수 있다면 버리지 마라!“라는 문장으로 요약된다.
이 틀이 규정하는 것은 호기심 많은 시스템이 추구할 목표뿐이다. 그 목표를 달성할 압축기와 강화학습 알고리즘은 따로 지정하지 않았다고 저자는 밝힌다.
외부 보상과 별도로 호기심을 설계하는 이유
인지 시스템의 실제 목표는 대개 호기심 충족보다 외부에서 주어진 문제의 해결에 있다. 형식화할 수 있는 문제는 모두 미지의 환경에서 남은 수명 동안 기대 외부 보상을 최대화하는 강화학습 문제로 표현할 수 있다. 2000년대에는 이론적으로 여러 의미에서 최적인 보편 강화학습 알고리즘이 몇 가지 나왔다. 이 알고리즘들은 호기심이 유용한 환경이라면 호기심의 원리를 스스로 발견해 활용한다. 그렇다면 호기심 기반 실험을 위한 틀을 왜 따로 적어야 하는가.
저자는 계산 비용을 근거로 답한다. 보편 알고리즘의 성능을 나타내는 점근 표기법은 문제와 무관한 상수 배의 지연을 반영하지 않는다. 에이전트가 단위 시간에 정해진 수의 연산(저자의 예로는 초당 10조 회)만 수행할 수 있고, 현실 환경처럼 외부 보상이 매우 드물 때, 그 연산을 어떻게 써야 보편 AI의 이론적 한계에 최대한 가까워지는지는 여전히 풀리지 않은 질문이다. 논문은 호기심이 자원이 제한되고 보상이 드문 환경의 강화학습에 두루 유용한 개념이므로, 처음부터 학습시키기보다 미리 내장해 두어야 계산 시간을 아낄 수 있다고 전제한다. 이 접근은 과거를 더 잘 설명하는 규칙이 미래 예측과 외부 과제 해결에도 도움이 된다고 가정한다. 호기심이 해로울 수 있다는 가능성, 즉 “호기심이 고양이를 죽인다"는 경우는 논외로 둔다.
내부 기호와 의식
압축기는 자주 반복되는 대상에 대해 내부 표상이나 기호를 자동으로 만든다. 해는 매일 뜨므로, 원시 데이터를 그대로 저장하기보다 ‘낮’ 같은 내부 기호를 만들어 반복해 쓰는 편이 효율적이다. 예측 신경망이 훈련 데이터의 예측 오차를 줄이다 보면 이런 계층적 부호가 부산물로 생기는 현상이 자주 관찰된다고 한다.
에이전트의 모든 행동과 감각 입력에 공통으로 관여하는 대상은 에이전트 자신이다. 따라서 이력 전체를 효율적으로 부호화하려면 에이전트 자신을 나타내는 내부 부호를 만드는 편이 유리하다. 저자는 이 표상이 활성화된 에이전트를 자기 인식이 있는 에이전트, 곧 의식이 있는 에이전트로 부를 수 있다고 본다. 슈미트후버는 이 설명이 직관적인 의식 개념의 본질을 잃지 않으면서도 최근 다른 견해들보다 훨씬 단순하다고 평가한다. 논문에서 의식은 데이터 압축으로 문제를 풀고 세계를 모델링하는 과정의 부산물로만 다뤄지고, 이후 논의에서는 거의 등장하지 않는다.
아름다움은 압축 가능성, 흥미로움은 그 변화율
관찰자 $O$의 시각 $t$에서의 상태를 $O(t)$라고 하자. 저자는 자신의 ‘게으른 뇌(lazy brain)’ 이론에 따라 새 관측 $D$의 주관적 아름다움 $B(D,O(t))$를 관찰자의 현재 압축기와 연결한다. 논문은 아름다움과 압축 가능성(compressibility)을 같은 뜻으로 쓴다. 관찰자가 지금 가진 압축기로 $D$를 부호화할 때 원래 데이터보다 줄어드는 비트가 많을수록, 다시 말해 $D$를 짧게 기술할 수 있을수록 $D$는 더 아름답다.1
저자가 드는 대표 사례는 얼굴이다. 신경망 같은 압축기가 지금까지 본 얼굴들을 효율적으로 부호화하려면 원형(prototype) 얼굴을 내부 표상으로 만들어 두는 편이 유리하다. 원형이 있으면 새 얼굴은 원형과의 차이만 부호화하면 된다. 원형과 차이가 작은 얼굴, 그리고 대칭이나 단순한 비례 같은 기하학적 규칙성이 있는 얼굴은 적은 비트로 부호화되므로 더 아름답게 느껴진다. 사람들이 자기와 닮은 얼굴을 선호하는 이유도 같은 방식으로 설명된다. 사람은 매일 거울로 자기 얼굴을 보므로, 부호화 효율을 높이는 과정에서 그 얼굴이 주관적 원형에 반영된다. 수학자가 자기가 쓰는 형식 언어로 짧게 적히는 증명을 아름답다고 여기는 것도 같은 원리다.
그런데 아름다운 대상이 반드시 흥미로운 것은 아니다. 아름다운 대상은 관찰자에게 새롭게 느껴지는 동안에만 흥미롭다. 그 대상을 단순하게 만드는 규칙성을 관찰자가 완전히 익히고 나면 흥미는 사라진다. 저자는 흥미로움 $I$를 아름다움의 1차 도함수로 정의한다.
$$ I(D,O(t))\sim\frac{\partial B(D,O(t))}{\partial t} $$학습이 진행되면 무작위처럼 보이던 데이터 일부가 규칙적으로 보이게 되고, 그 부분을 부호화하는 데 필요한 비트가 점점 줄어든다. 압축으로 줄어드는 비트 수가 늘어나는 만큼 아름다움도 커진다. 이 과정이 계속되는 동안 데이터는 흥미롭고 보상을 준다.
저자는 여기서 말하는 아름다움과 흥미로움이 외부 보상에서 오는 즐거움과 무관하다고 명시한다. 추운 날 뜨거운 목욕이 주는 좋은 느낌은 온도 감각기의 목표값을 달성한 데 대한 외부 보상이다. 첫 키스의 기억과 연결된 노래를 아름답다고 느끼는 것은 정서적인 이유다. 논문은 두 경우를 모두 논의에서 제외하고, 학습 진보에 기반한 내재 보상만 다룬다.
놀라움의 재정의
저자는 지루한 데이터의 두 극단을 예로 든다. 항상 어둠 속에 있는 시각 에이전트는 변하지 않는 시각 입력만 받는다. 이 이력은 극도로 압축되고 곧 완전히 예측할 수 있게 된다. 백색 잡음이 가득한 화면 앞에 있는 에이전트가 받는 데이터는 볼츠만과 섀넌이 제시한 전통적 정의에 따르면 정보량과 ‘새로움’, ‘놀라움’이 매우 크다. 이 데이터는 예측할 수 없고 근본적으로 압축할 수 없다.
어둠과 백색 잡음은 정반대의 데이터처럼 보이지만, 두 경우 모두 압축을 더 개선할 수 없다는 점에서 똑같이 지루하다. 이런 이유로 저자는 전통적인 놀라움 개념을 받아들이지 않는다. 저자에 따르면 무작위 데이터와 완전히 예측 가능한 데이터는 둘 다 새롭거나 놀랍지 않다. 아직 알려지지 않은 알고리즘적 규칙성을 가진 데이터만 새롭고 놀랍다.
이 정의로 주의와 실험을 설명할 수 있다. 외부 보상이 없거나 외부 보상을 더 늘릴 방법을 모를 때, 컨트롤러는 압축기와 압축 개선 알고리즘의 한계를 고려해 앞으로의 압축 진보가 가장 클 것으로 기대되는 관측을 얻을 수 있는 행동을 고른다. 에이전트는 지금은 압축할 수 없지만 더 학습하면 압축할 수 있게 되리라 예상되는 대상에 주의를 기울이고 실험을 집중한다. 에이전트가 지루해하는 대상은 세 종류다.
- 이미 주관적으로 압축할 수 있는 대상
- 지금 압축할 수 없고, 지금까지의 경험으로 보아 앞으로도 압축할 수 없을 것 같은 대상
- 압축할 수 있게 만드는 데 드는 비용이 다른 대상보다 큰 대상
압축이 유난히 크게 개선되면 저자는 그것을 발견(discovery)이라고 부른다. 서론에서 든 중력 법칙이 그런 발견의 예다.
전통적인 비지도학습도 데이터 압축의 특수한 경우로 볼 수 있다. 데이터를 군집으로 묶는 방법, 통계적으로 독립인 성분으로 이뤄진 팩토리얼 부호로 부호화하는 방법, 데이터 일부를 다른 일부로 예측하는 방법이 모두 여기에 해당한다. 예를 들어 군집이 있으면 데이터 점 하나를 군집 중심과 중심으로부터의 편차 몇 비트로 효율적으로 부호화할 수 있다. 그러나 전통적인 비지도학습에는 한계가 있다. 데이터를 분석하고 부호화할 수는 있어도, 어떤 데이터를 관측할지는 고르지 않는다. 과학자가 실험을, 아기가 장난감을, 예술가가 색을, 무용가가 동작을 고르듯, 학습기는 관측 데이터에 영향을 주는 행동도 골라야 한다. 강화학습 기반의 호기심 틀은 이 행동 선택을 담당한다.
예술, 음악, 과학, 농담
슈미트후버가 보기에 좋은 예술은 관찰자에 따라 달라지며, 세계나 가능한 세계에 대한 관찰자의 통찰을 더해 준다. 좋은 작품은 관찰자가 몰랐던 규칙성을 드러내고, 서로 무관해 보이던 패턴들을 처음에는 놀라운 방식으로 연결해 그 조합을 더 압축할 수 있게 만든다. 저자는 이를 ‘눈을 뜨게 하는 예술(art as an eye-opener)‘이라고 불렀다. 그런 작품도 시간이 지나면 익숙해지고 덜 흥미로워진다. 슈미트후버는 이렇게 가정한다. 모든 종류의 예술 작품을 만드는 행위와 주의 깊게 감상하는 행위는, 압축이 개선될 때 보상을 주는 흥미와 호기심 원리에서 파생된 부산물이다.
저자에 따르면 예술 감상도 순차적이고 능동적인 과정이다. 관찰자는 안구 도약(saccade)을 거듭하며 그림을 보고, 카메라를 움직여 조각을 훑고, 배경 소음을 억제하면서 피아노 소리에 주의를 기울인다. 감각 기관과 압축 개선 알고리즘이 다른 관찰자들은 서로 다른 입력 순서를 선호한다. 따라서 좋은 예술에 대한 객관적 이론이라면 주관적 관찰자를 변수로 포함해야 한다. 원리에 따르면 관찰자는 자기의 현재 지식과 학습 방식을 기준으로, 새로우면서도 빠르게 학습할 수 있는 압축 가능성을 가장 많이 주는 행동 순서를 골라야 한다.
음악은 이 원리를 보여 주는 사례다. 다음 곡을 고른다면 방금 열 번 연속으로 들은 곡은 적합하지 않다. 그 곡은 반복해 듣는 동안 너무 예측하기 쉬워졌다. 리듬과 조성이 전혀 낯선 이상한 신곡도 적합하지 않다. 너무 불규칙해서 주관적 잡음처럼 들리기 때문이다. 관찰자에게 맞는 곡은 예상 밖의 화성이나 선율, 박자를 담을 만큼 낯설면서도 소리의 흐름에서 새로운 규칙성을 빨리 알아챌 만큼 익숙한 곡이다. 그 곡도 시간이 지나면 지루해지겠지만, 관찰자가 새 규칙성을 익히는 동안에는 흥미롭다.
쇤베르크의 12음 음악이 일부 대중음악보다 인기가 낮은 현상도 관찰자 의존성의 사례로 제시된다. 12음 음악은 화성이 복잡해서 많은 사람이 그 알고리즘적 구조를 쉽게 알아채지 못한다. 예를 들어 12음 음악에서 연속한 두 음의 주파수 비는 아주 작은 정수의 분수로 표현되지 않는 경우가 많다. 반면 12음 음악의 기본 개념과 목표, 제약을 미리 배운 사람은 그렇지 않은 사람보다 쇤베르크를 더 높이 평가하는 경향이 있다.
정보 이론으로 미적 경험을 설명하려던 이전 시도들은 미적 대상이 전하는 예상된 정보와 예상 밖 정보, 곧 ‘질서’와 ‘복잡성’ 사이에 이상적인 비율이 있다고 보았다. 이 논문에서 흥미로움은 대상을 부호화하는 데 필요한 비트 수가 얼마나 변했는지로 측정되고, 그 변화량에는 관찰자의 사전 지식과 압축 개선 알고리즘의 한계가 함께 반영된다. 따라서 저자는 객관적인 이상 비율을 상정할 필요가 없다고 말한다.
창작자와 감상자의 동기도 같은 원리로 설명된다. 감상자가 새 규칙성을 담은 작품에 주의를 기울여 내재 보상을 받듯, 예술가는 그런 작품을 만들어 보상을 받는다. 창작자와 감상자는 모두 새로운 종류의 압축 가능성을 보여 주는 행동을 한다. 따라서 저자는 두 역할을 명확히 구분하기 어렵다고 본다. 예술가 중에는 칭찬이나 돈처럼 다른 관찰자가 주는 보상을 바라는 사람도 있다. 슈미트후버의 원리에서 이런 외부 보상은 새로운 작품을 만들 때 생기는 내재 보상과 개념상 별개의 보상이다.
과학자와 예술가는 매우 비슷하다고 저자는 본다. 둘 다 새롭지만 무작위하지 않은 데이터, 예상하지 못한 규칙성을 가진 데이터를 만들려고 한다. 많은 물리학자는 알려지지 않은 법칙이 지배하는 데이터를 얻으려고 실험을 설계한다. 많은 예술가는 잘 알려진 대상들을 주관적으로 새로운 방식으로 조합한다. 부분들이 아무도 눈치채지 못한 규칙성을 공유하고 있어서, 결과물을 기술하는 길이가 부분을 각각 기술하는 길이의 합보다 짧아진다. 과학과 예술의 차이는 압축 진보를 형식적으로 기술하는가에 있다. 과학은 새 규칙성을 발견해 얻은 압축 진보를 형식으로 확정한다. 중력 법칙은 기호 몇 개로 적을 수 있다. 미술 작품을 감상하며 얻는 압축 진보는 무의식적일 수 있다. 감상자는 내재 보상을 느끼면서도 어떤 기억이 더 압축하기 쉬워졌는지 정확히 말하지 못할 수 있다.
코미디언도 다른 예술가처럼 잘 알려진 개념을 새로운 방식으로 조합해, 결과물의 기술 길이가 부분들의 기술 길이 합보다 짧아지게 만든다. 저자는 재치 있는 농담이 일으키는 웃음이 새 기술을 익힐 때의 웃음과 비슷하다고 본다. 그리고 그 근거로 자신의 경험을 소개한다. 저자는 스물다섯 살 이후에 공 세 개로 저글링하는 법을 배웠다. 처음에는 1초쯤 버티다 공을 떨어뜨렸고, 버티는 시간은 그다음에 2초, 4초로 늘었다. 저글링 강사들의 권유대로 거울을 보며 연습하던 저자는 실력이 늘 때마다 자기 얼굴에 “바보 같은 웃음(idiotic grin)“이 번진다는 것을 알아챘다. 나중에 어린 딸이 처음으로 혼자 섰을 때도 똑같이 웃었다. 저자는 이 웃음을 이전에 없던 규칙성을 가진 데이터 흐름에 대한 내재 보상으로 해석한다. 자기가 저글링하는 모습을 보는 감각 입력은 남의 저글링을 보는 익숙한 경험과 다르므로 새롭고, 예측기가 그 입력에 익숙해질 때까지 보상을 준다.
1990년부터 이어진 구현
논문은 예측기와 압축기가 밀접하게 연결돼 있다는 설명으로 3장을 시작한다. 감각 데이터 흐름을 부분적으로라도 예측할 수 있으면 그 예측으로 전체의 압축률을 높일 수 있다. 이 때문에 인공 호기심에 관한 초기 논문들의 시스템도 압축 진보를 좇는 시스템의 구현 사례로 볼 수 있다.
| 연도 | 구성 | 호기심 보상 | 특징 |
|---|---|---|---|
| 1990 | 순환 신경망 예측기가 과거 입력과 행동의 이력 전체로 다음 감각 입력(보상 신호 포함)을 예측 | 예측 오차에 비례 | 오차가 크면 예측기가 개선되리라고 낙관적으로 가정 |
| 1991 | 예측기의 변화를 예측하는 신경망 모델을 추가 | 기대되는 장기 예측기 변화에 비례 | 표준 강화학습 알고리즘이 정보 이득을 최대화 |
| 1995 | 비결정적 세계를 위한 정보 이론적 변형 | 새 관측 전후 예측 분포 사이의 쿨백-라이블러(Kullback-Leibler) 거리 | 2005년 Baldi와 Itti가 “베이지안 놀라움(Bayesian surprise)“이라 부르고 인간 시각 주의 실험에 적용 |
| 1997 | 보편 프로그래밍 언어로 작성된 자기 수정 확률 프로그램 두 개가 대칭적으로 경쟁 | 실험 결과를 두고 거는 내기의 판돈 (제로섬) | 상대 모듈이 이미 아는 것이 새로움의 기준 |
1991년의 후속 연구는 1990년 방식의 문제를 지적했다. 예측기의 오차에 보상을 주면, 특히 확률적인 환경에서 시스템은 잡음이나 무작위성, 예측기의 계산 한계 때문에 늘 높은 오차가 나는 환경 부분만 탐색한다. 그런 부분에서는 데이터의 주관적 압축률이 개선되지 않는다. 그래서 1991년 연구는 예측기의 오차 대신 예측기가 개선된 정도에 보상을 주었다. 이 구현에는 예측기의 변화를 학습하는 명시적 신경망 모델이 있었다. 잡음은 예측할 수 없어서 예측기에 들쭉날쭉한 목표 신호를 주지만, 장기적으로는 예측기의 매개변수를 크게 바꾸지 않는다. 예측기 변화를 예측하는 모델은 이 성질을 학습할 수 있었다.
1995년 방식에서 Baldi와 Itti는 베이지안 놀라움이 인간 시각 주의의 일부 패턴을 이전 접근법보다 잘 설명한다는 것을 실험을 통해 보였다. 허프만 부호와, 사전 분포와 사후 분포 사이의 상대 엔트로피는 곧바로 절약된 비트 수, 즉 압축 개선을 재는 척도로 바꿀 수 있다.
그러나 단순한 확률적 압축은 더 일반적인 알고리즘적 압축 가능성을 발견하지 못한다. 저자는 원주율 $\pi$를 예로 든다. $\pi$의 십진 전개는 무작위해 보이지만 모든 자릿수를 계산하는 아주 짧은 알고리즘이 있다. 그런데 $\pi$의 전개에는 어떤 유한한 숫자열이든 완전한 무작위 수열일 때 기대되는 빈도로 나타난다. 따라서 직전 자릿수 몇 개로 다음 자릿수를 예측하는 단순한 통계 학습기는 무작위 추측보다 나은 성적을 낼 수 없다. 이런 규칙성을 찾으려면 더 일반적인 프로그램 탐색 기법이 필요하다.
1997년 방식은 컨트롤러와 예측기의 계산 능력을 크게 높였다. 두 모듈은 반복, 재귀, 계층 구조를 쓸 수 있는 보편 프로그래밍 언어로 작성된 자기 수정 확률 프로그램이었다. 각 모듈은 실행할 확률적 알고리즘 형태로 실험을 제안하고 그 결과에 내기를 걸었다. 상대 모듈은 반대 예측을 내고 내기를 받아들이거나 거절했다. 내기가 성사되면 실험을 실행해 승자를 가리고, 예측이 틀려 놀란 쪽이 맞힌 쪽에 판돈을 지불했다. 두 모듈 모두 판돈을 최대화하려 했으므로, 상대가 아직 모르는 알고리즘적 규칙성을 발견할 동기를 가졌다. 이 방식은 계산 가능한 모델과 시험을 공진화시켜 시스템을 식별하는 방법으로도 볼 수 있다. 2005년에는 Bongard와 Lipson이 덜 일반적인 모델과 시험으로 비슷한 공진화 방식을 구현했다.
저자는 자신의 실험들에서 내재 보상이 외부 보상을 모으는 속도도 높였다고 밝혔다. 다른 연구자들도 이 틀의 변형을 구현했다. Singh, Barto와 동료들은 강화학습의 옵션 틀을 사용해 1990년 방식처럼 예측 오차를 호기심 보상으로 썼고, 내재 보상(intrinsic reward)과 내재 동기 강화학습(intrinsically motivated RL)이라는 용어를 만들었다.
그림으로 보는 주관적 아름다움
논문 4장은 인간 관찰자에게 맞춘 이미지로 이론을 설명한다. 수동적 감상자와 창작자의 동기에 근본적 차이가 없다는 2장의 주장에 따라, 저자는 빠르게 학습할 수 있는 규칙성을 담은 이미지를 만드는 문제에도 이론을 적용한다.
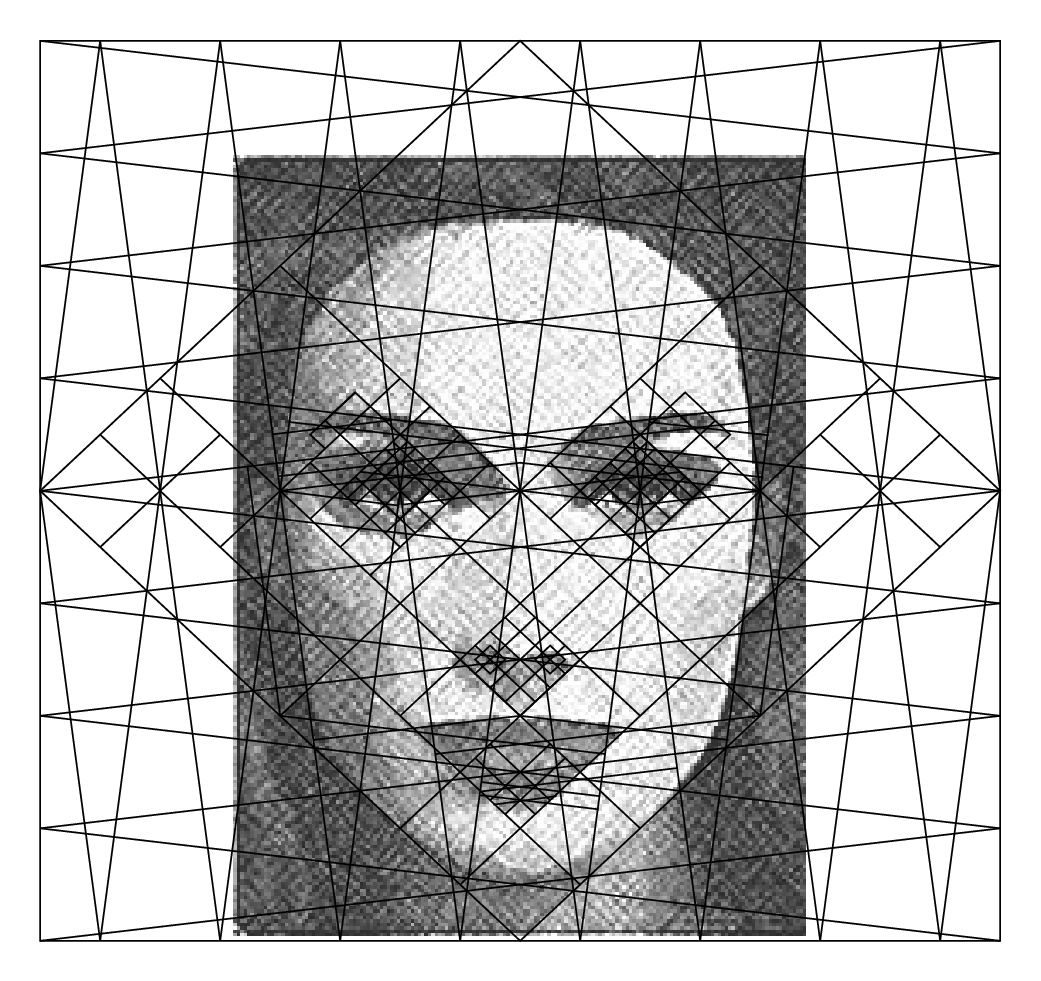
첫 번째 그림(이 글의 커버 이미지)은 저자가 1998년에 발표한 여성 얼굴 구성도다. 이 얼굴을 아름답다고 말한 관찰자들이 있었다. 질감처럼 잡음 섞인 세부는 짧게 기술할 수 없지만, 눈썹, 눈, 눈꺼풀 그늘, 입, 코, 얼굴 윤곽의 경계와 모양은 아주 단순한 기하학적 체계로 기술할 수 있다. 저자는 이 체계가 레오나르도 다빈치와 알브레히트 뒤러의 얼굴 비례 연구보다 단순하고 훨씬 정밀하다고 했다. 작도 절차는 네 단계다.
- 정사각형의 각 변을 $2^{4}$개의 같은 구간으로 나눈다.
- 구간 경계 가운데 일부를 이어, 기울기가 $\pm 1$, $\pm 1/2^{3}$, $\pm 2^{3}/1$인 직선으로 된 격자 세 개를 겹쳐 그린다.
- 이웃한 평행선 두 개를 골라 두 선에서 같은 거리에 새 선을 긋는 작업을 반복해 세밀한 격자를 만든다.
- 격자 전체를 세로 방향으로 $1-2^{-4}$배 압축한다.
이렇게 만든 선과 교점이 얼굴 요소들의 경계와 모양을 정한다. 격자 설명 없이 그림만 보고 작도법을 바로 알아내는 사람은 드물지만, 대부분은 얼굴 요소들이 어떤 규칙에 따라 조화를 이룬다는 것을 알아챈다. 저자의 가정에 따르면 관찰자의 보상은 이 압축 가능성을 의식적으로든 무의식적으로든 발견할 때 생긴다. 관찰해도 더는 새로운 규칙성이 드러나지 않으면, 이 얼굴을 아름답다고 여기는 사람에게도 얼굴은 지루해진다. 저자는 이 구성도가 돌이켜 보면 단순하지만 찾기는 어려웠다고 했다. 단순한 기하학과 예쁜 얼굴을 정밀하게 일치시키려던 시도는 그전에 수백 번 실패했다.
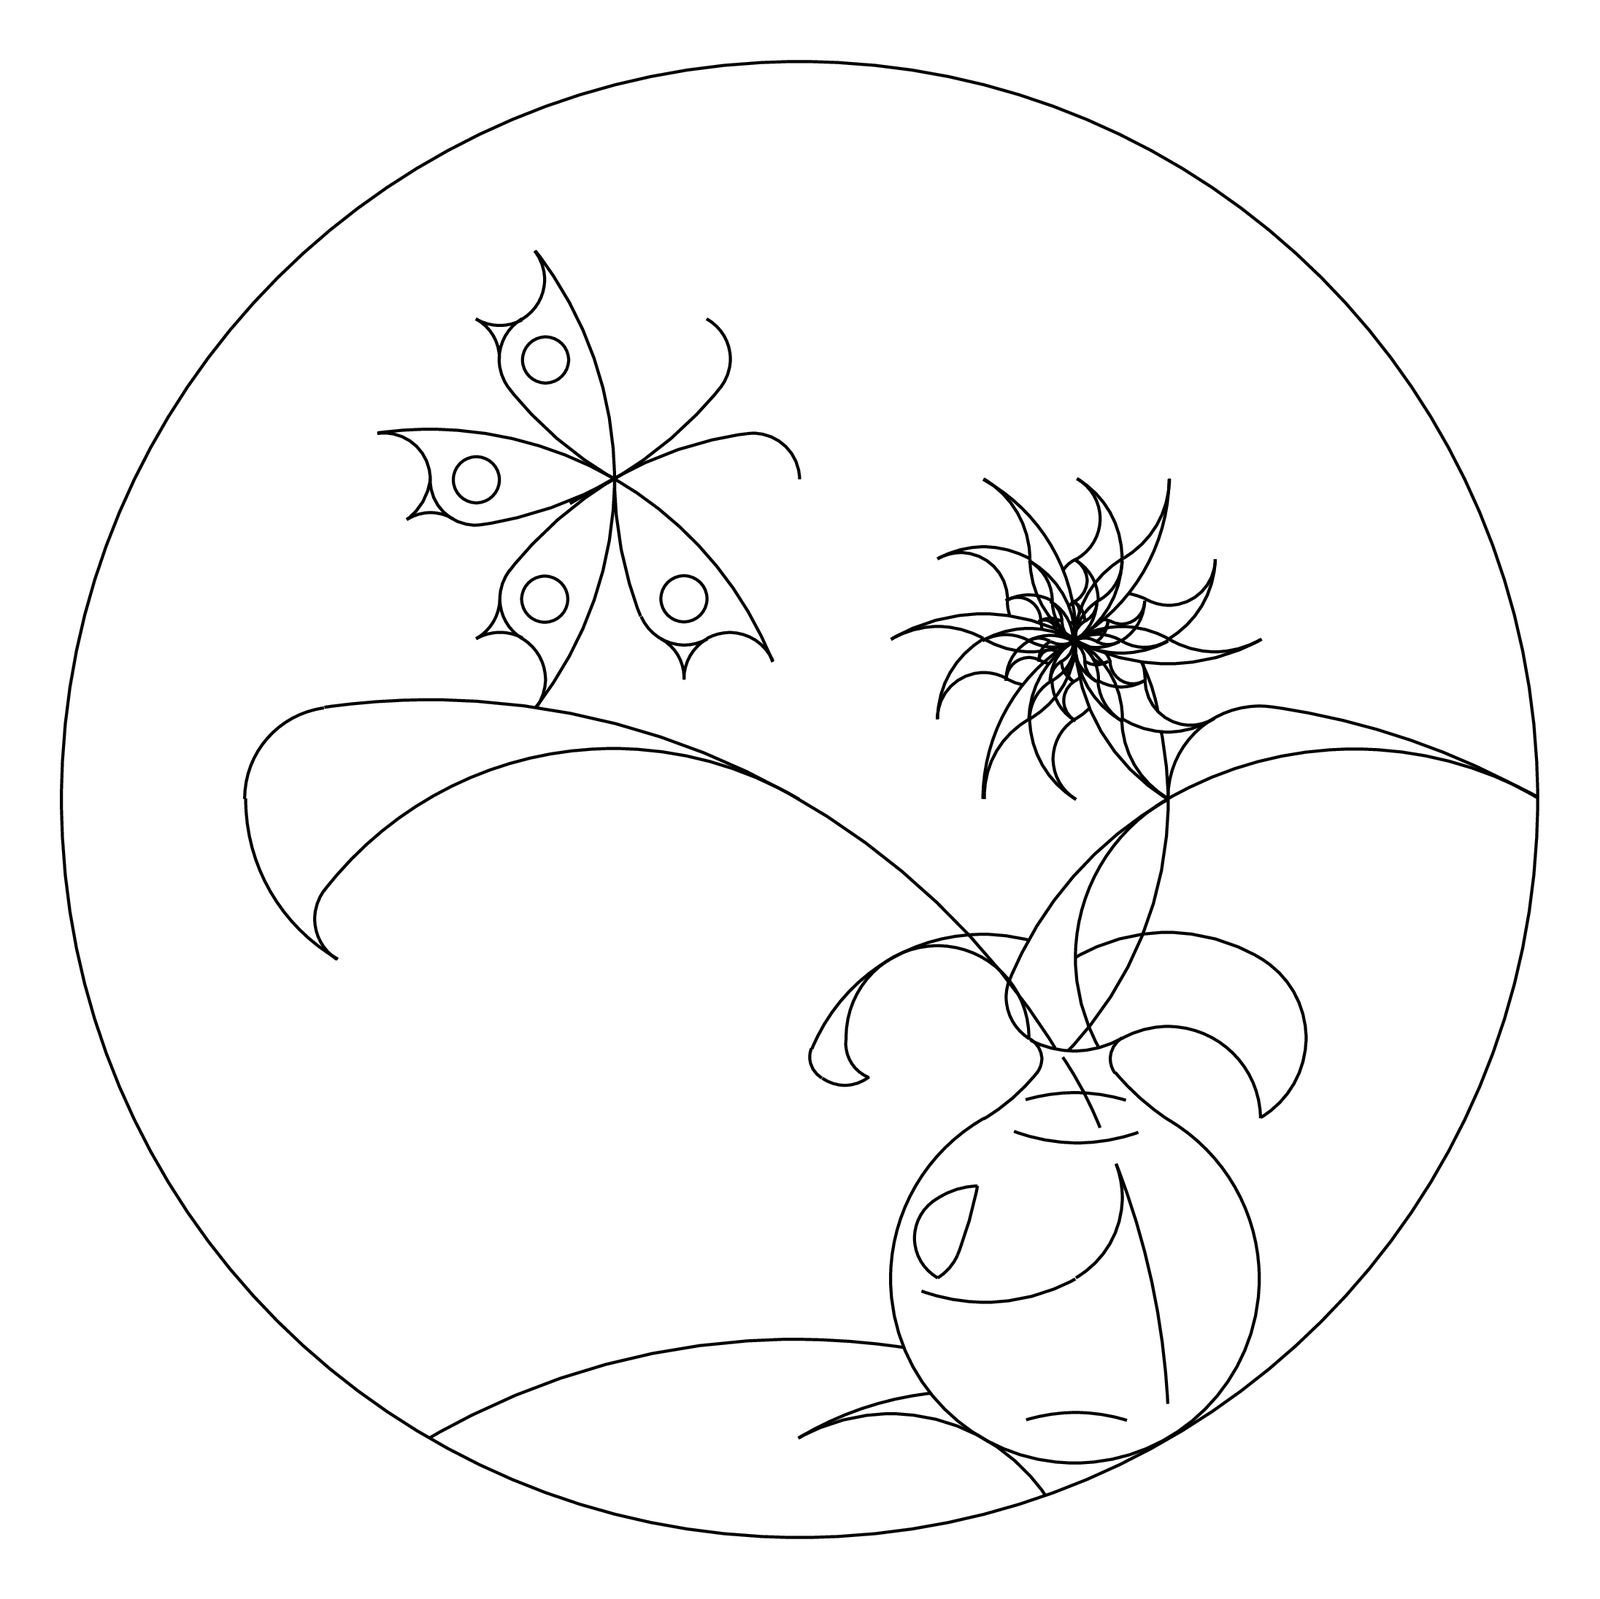 그림 2. 나비와 꽃이 꽂힌 꽃병. 저자가 학술지 Leonardo에 발표했던 그림을 재수록했다. 출처: Schmidhuber (2009), arXiv:0812.4360, arXiv 비독점 배포 라이선스
두 번째 그림의 나비와 꽃병은 프랙털 원 패턴에 기반한 아주 단순한 절차로 그렸기 때문에 매우 적은 비트로 기술할 수 있다. 작도의 출발점은 테두리 원이다. 그 원의 가장 왼쪽 점을 중심으로 같은 크기의 원을 하나 더 그린다. 같은 크기의 두 원이 접하거나 교차하는 점마다 그 점을 중심으로 새 원 두 개를 그린다. 한 원은 기존 원과 같은 크기이고, 다른 원은 절반 크기다. 그림의 모든 선은 어떤 원의 호이고, 호의 끝점은 원들이 접하거나 교차하는 점이다. 큰 원은 몇 개뿐이고 작은 원은 많다. 원이 작을수록 기술하는 데 비트가 더 필요하므로, 비교적 큰 원 몇 개로 그린 이 그림은 압축하기 쉽다.
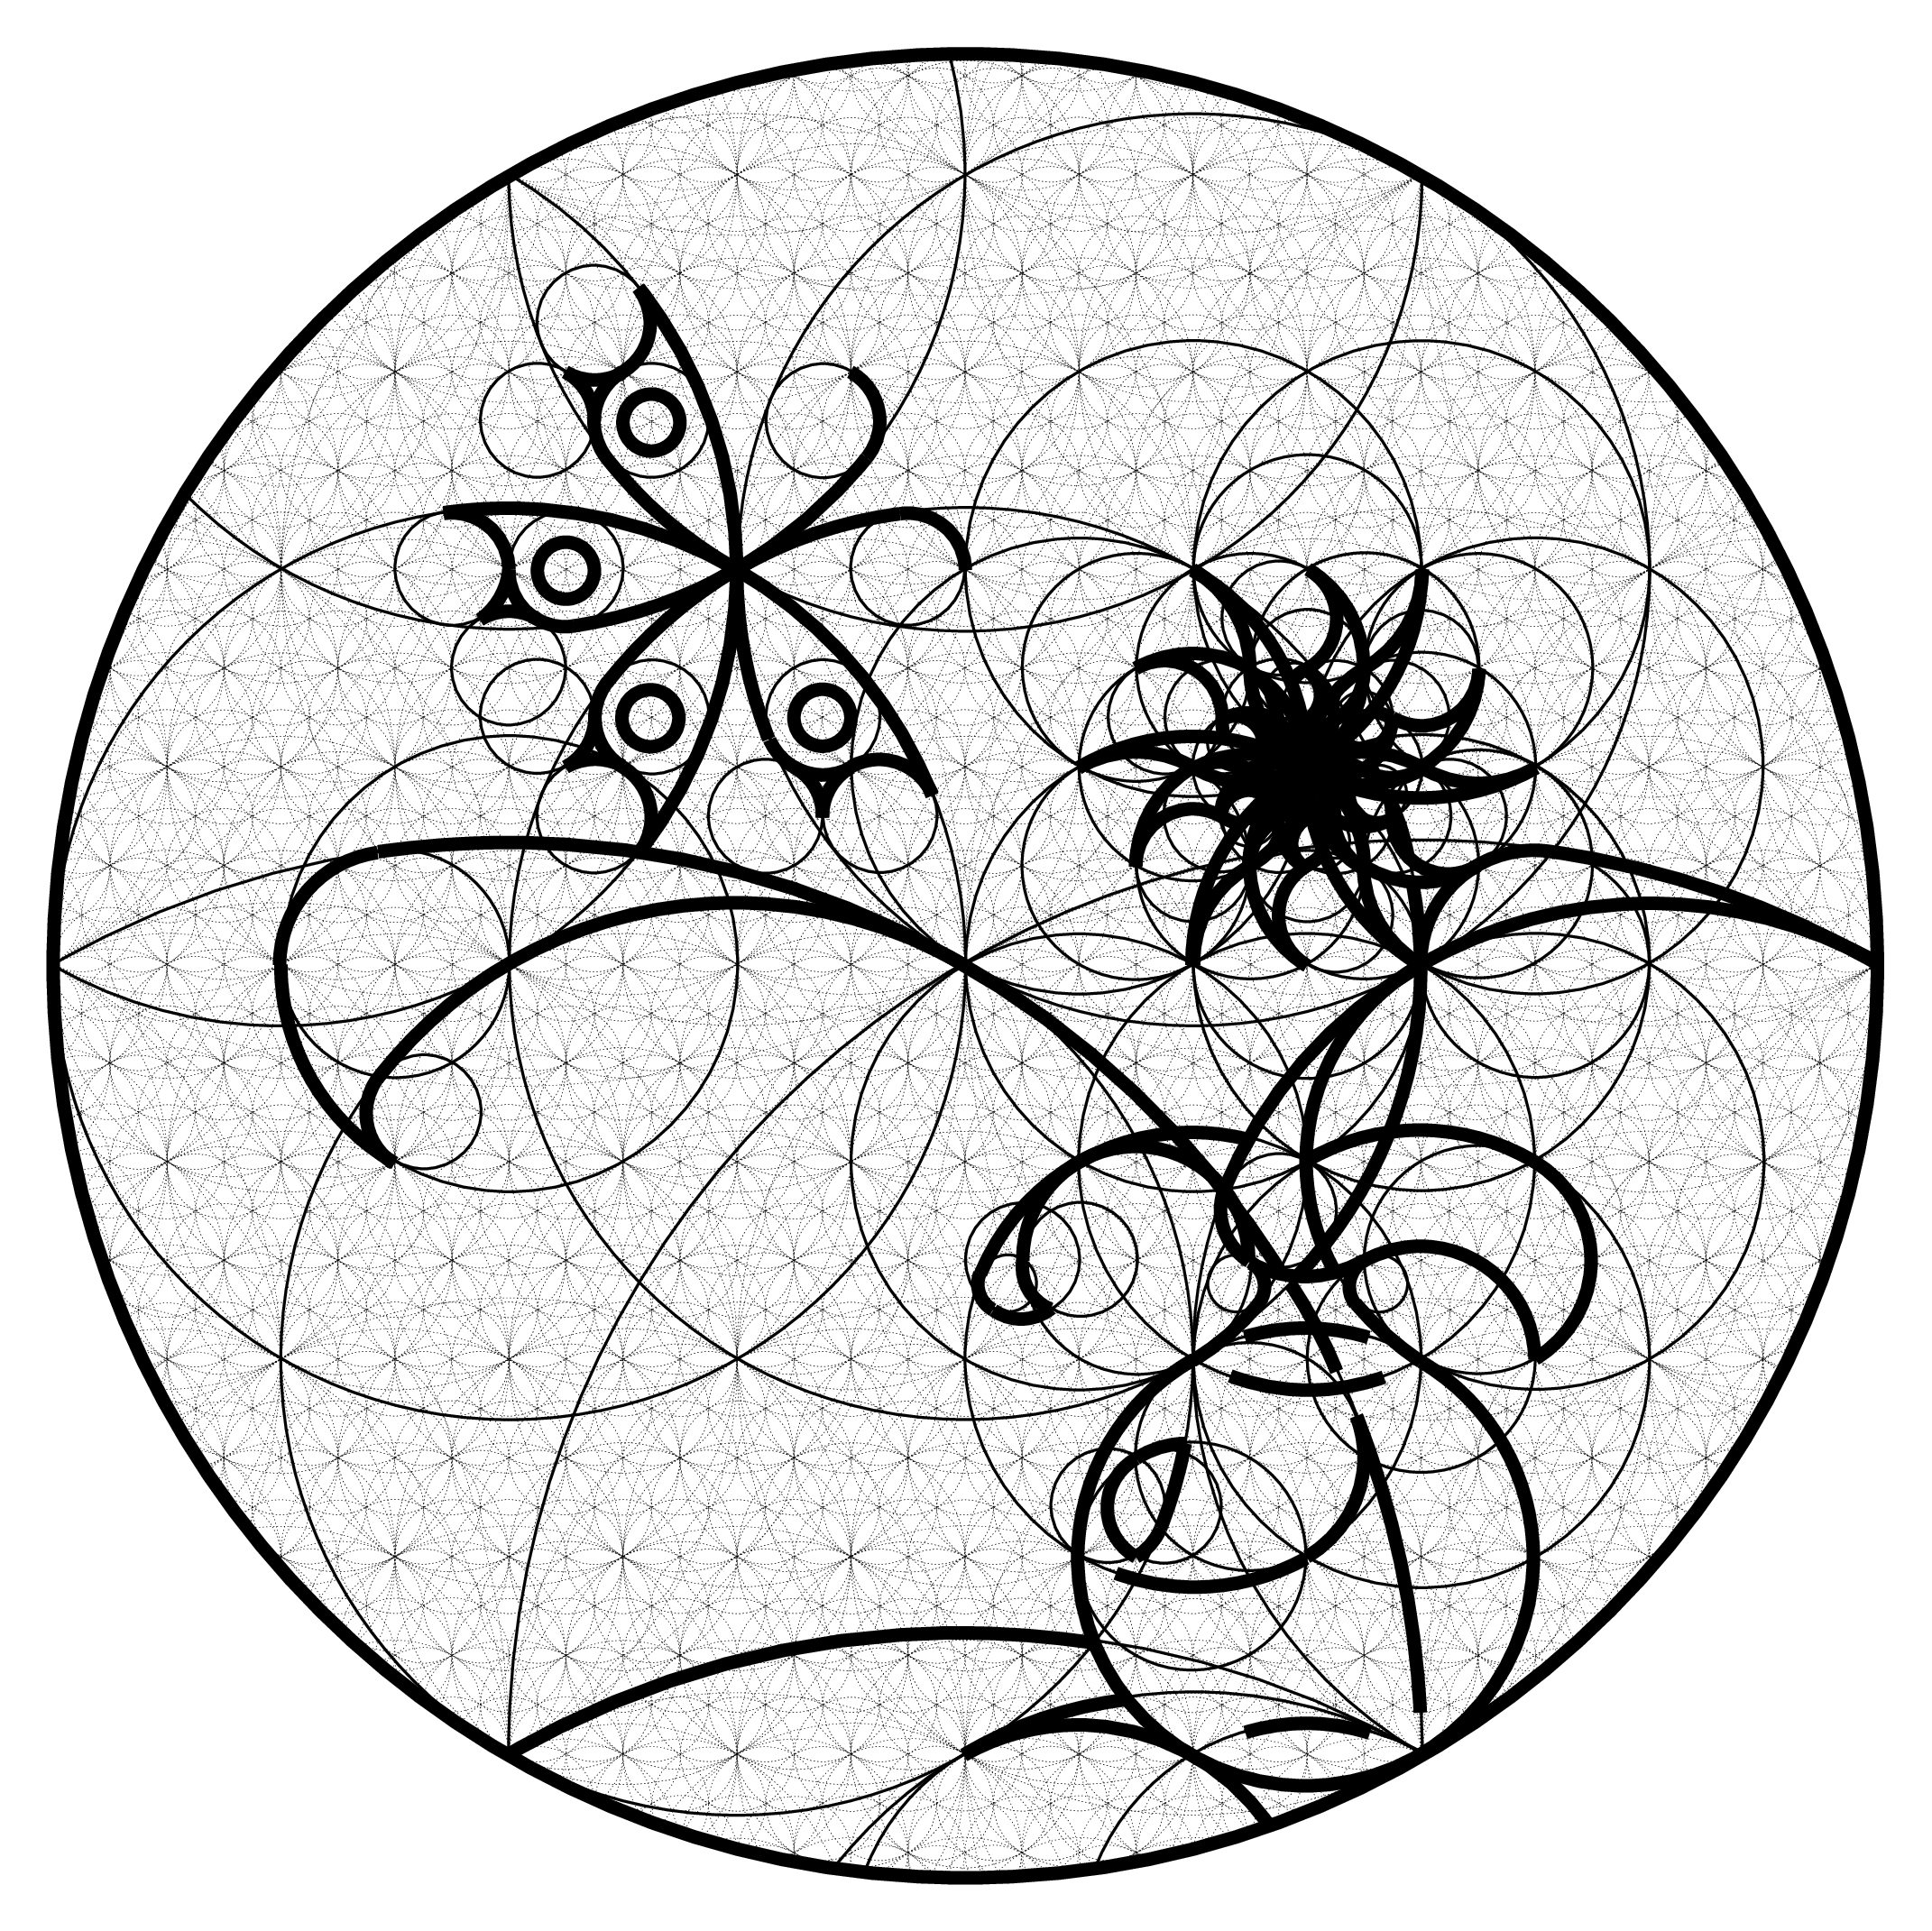 그림 3. 프랙털 원으로 그림 2를 작도한 방법. 출처: Schmidhuber (2009), arXiv:0812.4360, arXiv 비독점 배포 라이선스
저자에 따르면 이 작도법을 이해한 사람은 이해하지 못한 사람보다 그림을 더 높이 평가한다. 이해는 한순간에 모두 일어나지 않고 단계적으로 일어난다. 사람의 시각계는 원을 많이 경험했기 때문에 대부분은 곡선들이 규칙적으로 맞물린다는 것을 금방 알아챈다. 하지만 그림의 정확한 기하학적 원리를 바로 설명할 수 있는 사람은 드물다. 그림 3을 보면 그 원리를 배울 수 있다. 발견 과정에서 데이터를 설명하는 긴 기술은 더 짧은 기술로 대체된다. 이 과정이 주는 보상의 크기는 주관적 아름다움의 도함수, 곧 학습 곡선의 기울기에 따라 달라진다. 저자는 이 그림을 그릴 만족스러운 방법을 찾는 데도 오랜 시간이 걸렸다고 밝혔다.
부록: 형식적 틀
부록은 이 원리를 컴퓨터로 구현할 수 있도록 형식화한다. 에이전트의 일생은 이산 시간 단계 $t=1,2,\ldots,T$로 구성된다. 에이전트는 각 시각에 환경에서 실수 입력 $x(t)$를 받고, 이후 입력에 영향을 줄 수 있는 실수 행동 $y(t)$를 실행하며, 보상 $r(t)$를 받는다. 세 값을 묶은 $h(t)=[x(t),y(t),r(t)]$를 이력이라고 한다. 에이전트는 지금까지의 이력 $h(\leq t)$를 조건으로 한 미래 보상 합의 기댓값을 최대화하려 한다.
$$ u(t)=E_{\mu}\left[\sum_{\tau=t+1}^{T}r(\tau)\ \Bigg|\ h(\leq t)\right] $$이 틀에서 에이전트의 일생은 한 번뿐이다. 반복할 수 있는 시행은 미리 정해 두지 않고, 감각기와 환경 사이에 마르코프 가정도 두지 않는다. 보상은 외부 보상과 내재 보상의 두 성분으로 구성한다. $r(t)=g(r_{ext}(t),r_{int}(t))$이고, 예를 들면 $g(a,b)=a+b$다. 저자는 기본 원리를 이렇게 적었다.
원리 1. 예측기나 이력 압축기가 개선되면 그에 대한 응답으로 컨트롤러에 호기심 보상을 준다.
압축기 성능 척도로는 두 가지를 제시한다.
| 척도 | 정의 | 의미 |
|---|---|---|
| $C_{l}$ | $l(p)$ | 이력을 계산하는 압축기 프로그램 $p$의 길이(비트). 궁극적 하한은 콜모고로프 복잡도의 변형인 $K^{*}(h(\leq t))$ |
| $C_{l\tau}$ | $l(p)+\log\tau(p,h(\leq t))$ | 프로그램이 이력을 계산하는 데 걸리는 시간 $\tau$까지 반영. 1비트 압축이 실행 시간 절반 단축과 같은 가치를 가짐 |
호기심 보상은 압축 성능 자체보다 성능의 개선에 준다. 시각 $t$에서 $t+1$ 사이의 호기심 보상은 다음과 같다.
$$ r_{int}(t+1)=f\left[C(p(t),h(\leq t+1)),\ C(p(t+1),h(\leq t+1))\right] $$가장 단순한 선택은 $f(a,b)=a-b$이고, 이는 주관적 압축률의 1차 도함수를 최대화하는 문제의 이산 시간판에 해당한다. 원래 데이터의 크기는 변하지 않으므로, 압축기 개선 전후의 부호화 길이 차이는 압축으로 줄어드는 비트 수가 늘어난 양과 같다. 옛 압축기와 새 압축기는 반드시 같은 데이터, 즉 지금까지의 이력 전체로 평가해야 한다.
컨트롤러와 압축기는 비동기로 실행된다. 컨트롤러는 매 시각 행동을 고르고 관측을 받는다. 그 뒤 압축기가 계산한 호기심 보상이 도착했는지 확인하고, 그 보상으로 정책을 갱신한다. 압축기는 컨트롤러와 별도로 계속 실행된다. 압축기는 현재 압축기를 지금까지의 이력으로 평가하고, 개선 알고리즘으로 새 압축기를 만든다. 새 압축기도 같은 이력으로 평가하고, 두 성능의 차이를 호기심 보상으로 전달한다. 평가와 개선에는 여러 시간 단계가 걸릴 수 있고, 개선의 일부는 “수면” 중에 수행될 수도 있다고 저자는 적었다. 이 구조에서는 행동과 보상 사이의 지연이 길어지므로 과거 행동에 공로를 배분하는 강화학습 알고리즘의 부담이 커진다.
저자는 최적의 행동 선택기도 검토한다. 솔로모노프의 보편 예측을 확장한 허터(Marcus Hutter)의 AIXI는 이론상 최적이지만 계산할 수 없다. 계산 가능한 변형인 AIXI(t,l)은 점근적으로 최적인 실행 시간을 갖지만 상수 배의 지연이 매우 클 수 있다. 저자가 제안한 괴델 머신(Gödel machine)은 자기 코드의 어느 부분이든 수정할 수 있다. 괴델 머신은 그 수정이 목표 함수에 유용하다는 증명을 찾았을 때만 수정을 실행한다. 저자에 따르면 이 방식은 $O()$ 표기에 드러나지 않는 상수 배의 지연까지 줄일 수 있다. 보편성은 덜하지만 실용적인 대안으로는 순환 신경망을 진화시키는 방법, 특히 뉴런이나 시냅스 단위로 협력 공진화하는 방법과 정책 경사 기법을 꼽았다.
저자가 제안한 후속 연구
저자는 기존 구현을 개선할 방향을 세 가지로 정리했다.
- 더 나은 적응형 압축기, 특히 새로운 순환 신경망과 실용적인 일반 예측 방법을 연구한다.
- 지금까지의 이력 전체로 압축기 성능을 자주 평가하지 않고도 학습 진보를 정확하고 효율적으로 계산할 수 있는 조건을 찾는다.
- 정책 경사와 인공 진화 같은 개선된 강화학습 기법을 이 틀에 적용한다.
저자는 인간 행동에 대한 심리학 실험도 제안한다. 피험자에게 처음에는 알 수 없지만 인과적으로 연결된 사건들의 순서를 예측하게 하고, 사건 순서의 패턴은 복잡도를 달리해 학습할 수 있게 만든다. 피험자는 예측이 나아질 때 느끼는 내재 보상의 크기를 수치로 답한다. 저자가 확인하고 싶은 질문은 두 가지다. 예측이 가장 빠르게 나아질 때 보상이 가장 큰가. 예측이 완벽해지거나 더 나아지지 않으면 보상이 사라지는가. 저자는 이런 실험과 함께 신경생리학 연구로 내재 보상이 뇌의 어디에서 생기는지 찾고, 그것을 신경 예측기의 개선과 연결해 보자고 했다.
가장 의외였던 대목
1990년에서 1991년 사이에 보상 신호가 바뀐 과정이 가장 의외였다. 예측 오차를 보상으로 삼은 에이전트는 백색 잡음에서 계속 높은 오차를 얻기 때문에 잡음만 관찰하게 된다. 저자는 이 문제를 이듬해 알아차리고 오차 대신 예측기의 개선 폭을 보상으로 바꿨다. 호기심 기반 강화학습 연구는 이후에도 같은 문제를 다시 만났다. 2018년에 나온 대규모 호기심 학습 연구는 미로 속에 채널이 무작위로 바뀌는 TV를 두자 예측 오차 기반 에이전트가 탐색을 멈추고 그 화면만 바라보는 현상을 ‘노이지 TV’ 문제로 보고했다.2 이 논문 2.6절은 전통적 놀라움 개념을 거부했다. 10년 뒤의 이 실험은 그 근거를 다시 확인해 주었다.
저자가 자기 이론의 사례로 자신을 계속 등장시킨다는 점도 인상적이었다. 얼굴 구성도를 수백 번 실패한 끝에 찾았을 때의 보상, 거울 속 자기 얼굴에서 본 저글링의 웃음, 나비 그림을 그릴 방법을 오래 찾은 경험이 모두 논문에 적혀 있다. 인간에 관한 근거로는 이런 일화와 Baldi와 Itti의 시각 주의 실험 하나가 대부분이다. 저자도 결론에서 일화에 그치지 않는 통제 실험이 필요하다고 인정한다. 이론이 설명하려는 현상은 호기심에서 농담까지 매우 다양한데, 이를 검증할 실험은 아직 결론의 제안 단계다.
출처
Jürgen Schmidhuber (TU München, IDSIA), “Driven by Compression Progress: A Simple Principle Explains Essential Aspects of Subjective Beauty, Novelty, Surprise, Interestingness, Attention, Curiosity, Creativity, Art, Science, Music, Jokes”, arXiv:0812.4360 [cs.AI]. 1판 2008년 12월 23일, 2판 2009년 4월 15일. 요약판: “Simple Algorithmic Theory of Subjective Beauty, Novelty, Surprise, Interestingness, Attention, Curiosity, Creativity, Art, Science, Music, Jokes”, Journal of SICE 48(1), 21-32, 2009.
원문: https://arxiv.org/abs/0812.4360
원문 2.3절의 정의문은 아름다움이 “D를 부호화하는 데 필요한 비트 수에 비례한다(proportional to the number of bits required to encode D)“고 적었다. 문장 그대로 읽으면 압축 후의 길이가 길수록 아름답다는 뜻이 되어, 바로 뒤의 원형 얼굴 예시, 짧은 증명 예시와 모순된다. 논문은 초록, 2.7절, 부록에서 아름다움을 “subjective beauty or compressibility"처럼 압축 가능성과 같은 말로 쓴다. 이 글은 이 용법에 따라 아름다움을 압축으로 줄어드는 비트 수로 읽었다. ↩︎
Yuri Burda 외, “Large-Scale Study of Curiosity-Driven Learning” (2018). 이 대목은 슈미트후버 논문의 내용이 아니다. ↩︎