3줄 요약
- 칭화대 LeapLab과 상하이교통대 연구진이 2025년 4월에 공개하고 2025년 11월에 v5까지 고쳐 낸 논문이다. NeurIPS 2025 구두 발표로 채택됐고 ICML 2025 AI4MATH 워크숍 최우수 논문을 받았다. 검증 가능한 보상을 쓰는 강화학습(RLVR)이 베이스 모델에 없던 추론 능력을 새로 만들어 내는지를 pass@k로 다시 측정했다. 이때 k를 아주 크게 키웠다.
- k가 1에 가까울 때는 RLVR 모델이 베이스 모델을 이긴다. 그러나 k를 수십에서 수백까지 키우면 베이스 모델이 따라잡고 앞질러 버린다. 수학과 코드 생성과 시각 추론 세 영역, 그리고 Qwen2.5와 LLaMA-3.1 계열 모두에서 같은 역전이 나왔다.
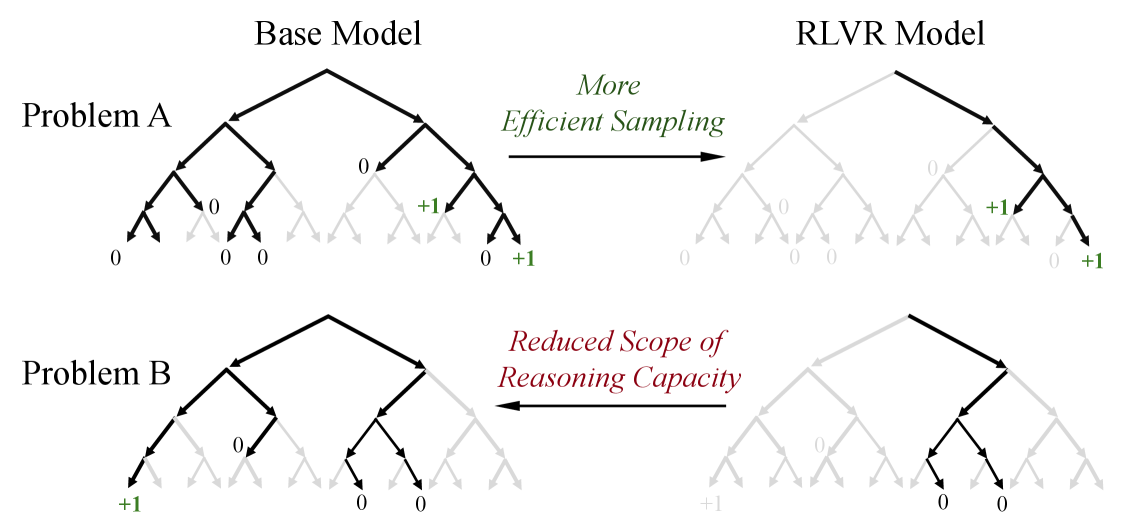
- RLVR은 베이스 모델이 이미 낼 수 있던 정답을 더 자주 뽑도록 출력 분포를 좁히는 쪽으로 작동하고, 그 대가로 풀 수 있는 문제의 범위는 오히려 줄어든다. 반면 증류는 교사 모델이 가진 새 추론 패턴을 학생 모델에 옮겨 주기 때문에 경계 자체를 넓힌다.
자료 정보
- 저자: Yang Yue, Zhiqi Chen, Rui Lu, Andrew Zhao, Zhaokai Wang, Yang Yue, Shiji Song, Gao Huang
- 소속: 칭화대학교 LeapLab, 상하이교통대학교
- 최초 공개: 2025년 4월 18일 (arXiv:2504.13837), 현재 판본 v5는 2025년 11월 24일
- 게재: NeurIPS 2025 Oral, ICML 2025 AI4MATH 워크숍 최우수 논문
- 프로젝트 페이지: https://limit-of-RLVR.github.io
- 라이선스: CC BY 4.0
논문이 던진 질문
DeepSeek-R1과 OpenAI o1 이후로 추론 모델의 성능을 끌어올린 핵심 장치는 RLVR이었다. 정답과 대조하거나 단위 테스트를 돌려 자동으로 0 또는 1의 보상을 매기고, 그 보상으로 정책을 학습시키는 방식이다. 사람이 라벨을 붙이지 않아도 되니 규모를 키우기 쉽다.
여기에 따라붙은 기대가 하나 있었다. 바둑이나 아타리에서 강화학습 에이전트가 사람이 모르던 수를 찾아냈듯이, RLVR이 언어 모델로 하여금 베이스 모델에 없던 추론 패턴을 스스로 발견할 수 있게 하리라는 기대였다. 열거, 자기 검증, 반복 수정 같은 행동이 강화학습 도중에 새로 생겨난 것처럼 보였기 때문이다.
저자들은 이 기대를 다음 두 문장으로 정리한 뒤 실험으로 되물었다.
현재의 RLVR은 전통적 강화학습이 탐색으로 새 전략을 발견하듯, 언어 모델에 새로운 추론 능력을 정말로 획득시키는가. 아니면 베이스 모델에 이미 있던 추론 패턴을 더 잘 꺼내 쓰고 있을 뿐인가.
왜 pass@k로 재는가
기존 평가는 greedy 디코딩이나 뉴클리어스 샘플링의 평균 점수를 쓴다. 이 값은 평균적인 행동을 보여 줄 뿐이다. 시도를 더 했더라면 풀 수 있었을 문제까지, 몇 번 실패한 뒤 못 푼 문제로 계산한다. 즉 모델의 잠재력을 과소평가한다.
그래서 연구진은 코드 생성에서 쓰이던 pass@k를 검증 가능한 보상이 있는 모든 과제로 확장했다. 한 문제에서 k개의 응답을 생성해 그중 하나라도 검증을 통과하면 그 문제의 pass@k는 1이다. 데이터셋 전체 평균은 그 모델이 k번 시도해 풀 수 있는 문제의 비율, 곧 추론 능력의 경계가 된다.
Best-of-N이나 다수결과는 목적이 다르다. 그쪽은 정답을 실제로 골라내는 실용적 방법이고, pass@k는 고르는 단계를 빼고 모델의 잠재 범위만 보려는 계측이다. 검증기나 투표가 정답을 놓치면 Best-of-N은 성공을 성공으로 세지 못한다.
수학에서는 틀린 풀이로도 우연히 정답 숫자와 일치하는 경우가 k가 커질수록 늘어난다. 연구진도 이 점을 알고 있었고, 난이도가 가장 높은 문제들의 풀이 과정은 사람이 직접 읽어 확인했다. 실험 설정은 온도 0.6, top-p 0.95, 최대 생성 16,384토큰이다. 베이스 모델에 유리하게 작용할 수 있는 few-shot 예시는 공정한 비교를 위해 일부러 넣지 않았다.
수학 추론: 작은 k에서 이기고 큰 k에서 뒤집힌다
Qwen2.5 베이스 모델 7B, 14B, 32B와 LLaMA-3.1-8B를 준비했다. 각 모델은 SimpleRLZoo가 GRPO로 학습시킨 자기 짝과 나란히 놓였다. 벤치마크는 GSM8K, MATH500, Minerva, Olympiad, AIME24, AMC23이다.
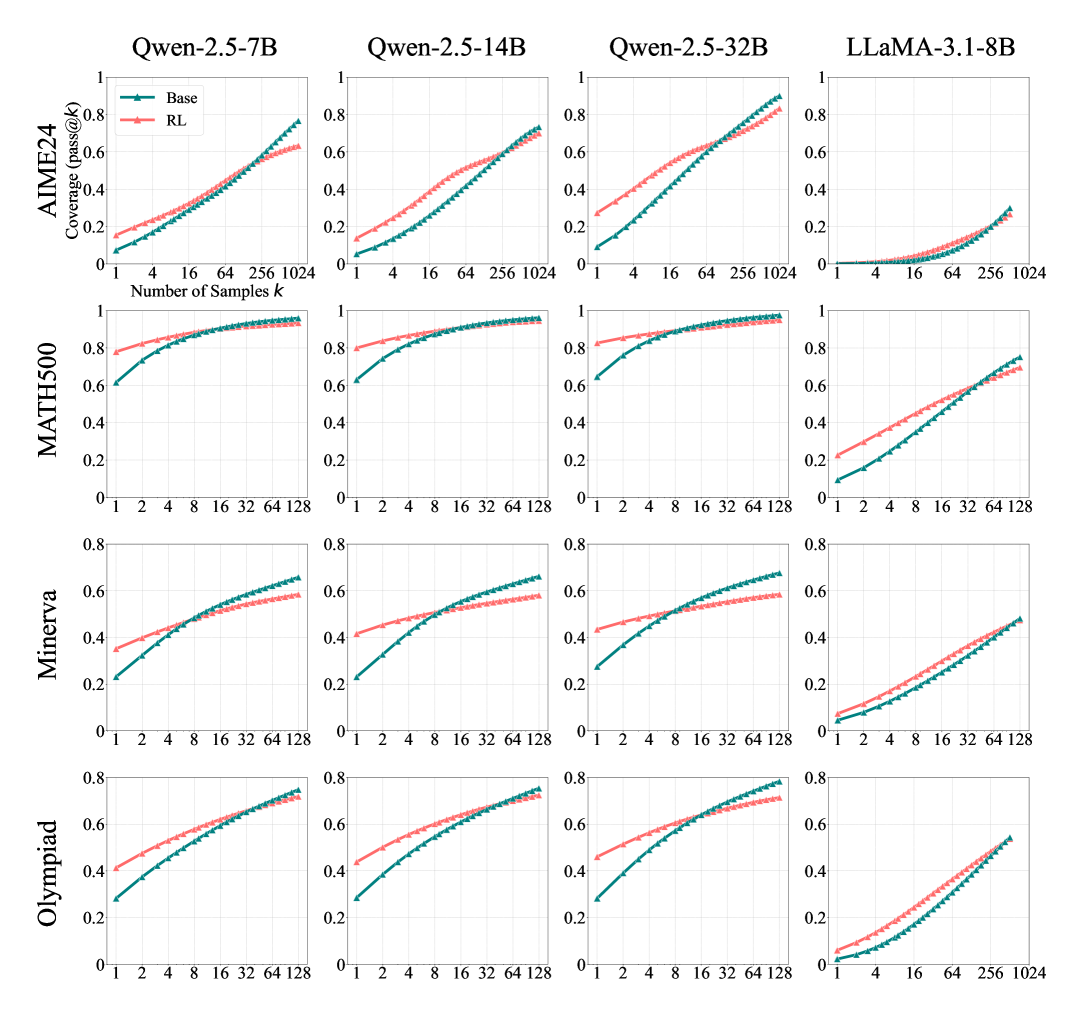
그림 2. 수학 벤치마크의 pass@k 곡선. k가 작을 때는 RL 모델이 앞서지만, k가 수십에서 수백에 이르면 베이스 모델이 따라잡고 넘어선다. (Yue et al., 2025, CC BY 4.0)
베이스 모델의 곡선이 더 가파르다는 것이 이 그림의 핵심이다. 32B 모델을 Minerva에서 비교하면 k=128일 때 베이스 모델의 pass@k가 RL 모델보다 약 9퍼센트포인트 높다. 검증 세트에서 9% 더 많은 문제를 풀어낸다고 읽을 수 있다. AIME24에서 강한 성능으로 알려진 Oat-Zero-7B와 DAPO-32B에서도 같은 일이 벌어졌다. 두 모델은 작은 k에서 베이스 모델보다 30% 가까이 앞서지만, k가 커지면 결국 베이스 모델에 추월당한다.
요행으로 맞힌 정답이 이 결과를 만든 것인지 확인하기 위해, 평균 정확도가 0% 초과 5% 미만인 가장 어려운 문제들의 풀이를 사람이 읽었다. GSM8K에서 베이스 모델이 맞힌 25문제 중 24문제에 올바른 풀이가 최소 하나 있었고, RL 모델은 25문제 중 23문제가 그랬다. AIME24에서는 베이스 모델이 7문제를 맞혔고 그중 6문제를 검토해 5문제에서 올바른 풀이를 확인했다. few-shot 예시를 하나도 받지 못한 베이스 모델도 반성적인 긴 사고 사슬을 스스로 만들어 냈다.
코드 생성과 시각 추론에서도 같다
코드 생성은 컴파일러와 단위 테스트가 검증기를 맡으므로 요행의 여지가 거의 없다. 덕분에 pass@k가 추론 경계를 훨씬 깨끗하게 보여 준다.
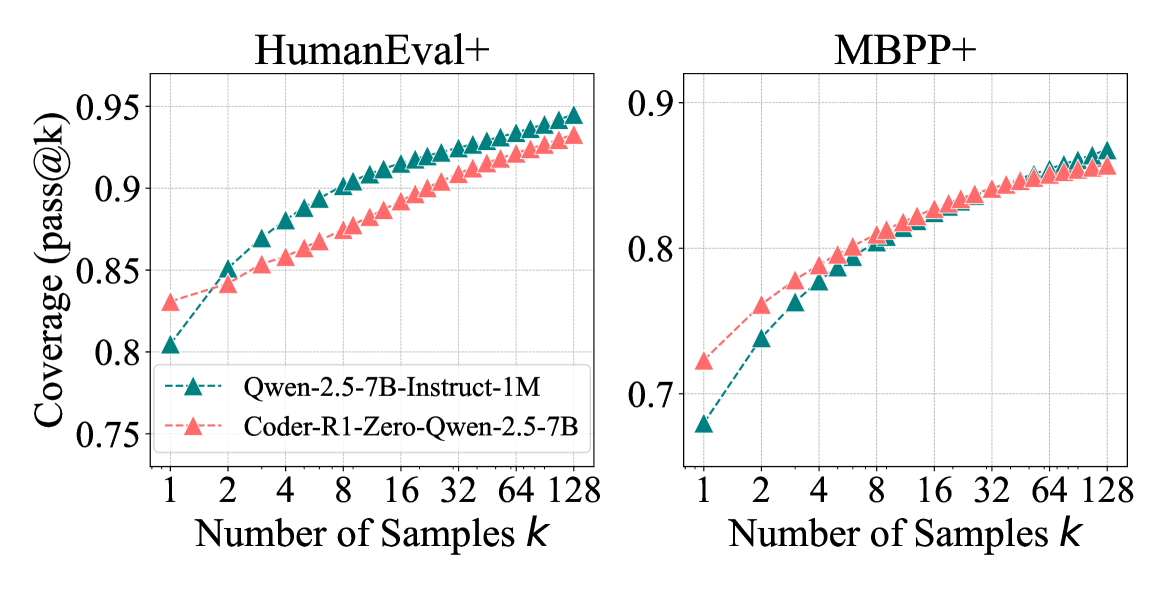
그림 4, 왼쪽. 코드 생성에서의 pass@k. (Yue et al., 2025, CC BY 4.0)
측정 대상은 두 모델이다. 하나는 LeetCode와 TACO에서 뽑은 12K 샘플로 832스텝을 학습한 CodeR1-Zero-Qwen2.5-7B이고, 다른 하나는 DeepSeek-R1-Distill-Qwen-14B를 바탕으로 한 DeepCoder-14B다. LiveCodeBench v5와 HumanEval+, MBPP+ 세 벤치마크에서 재 보니, 여기서도 k가 커지면 베이스 모델이 RL 모델의 pass@k를 넘어섰다.
시각 추론은 EasyR1로 Qwen2.5-VL-7B를 Geometry3K에 학습시켜 MathVista와 MathVision에서 비교했다. 멀티모달 과제에서도 k가 커질수록 원래 모델이 더 넓은 범위의 문제를 풀어냈다. 여기서도 어려운 문제 8개 중 7개에서 올바른 풀이 과정을 확인했다.
정답 경로는 이미 베이스 모델 안에 있었다
역전이 왜 일어나는지는 세 가지 분석으로 이어진다.
첫째는 정확도 분포다. 문제별 정확도의 히스토그램을 RLVR 전후로 비교했다.
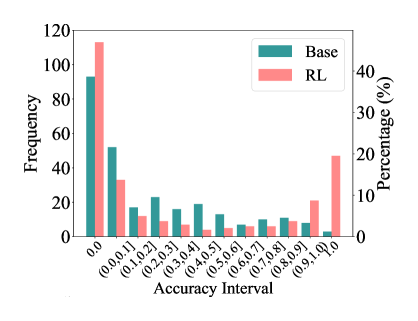
그림 5. Minerva에서의 정확도 히스토그램. (Yue et al., 2025, CC BY 4.0)
RLVR은 정확도 1.0 근처의 빈도를 늘리고 0.1이나 0.2 같은 낮은 정확도의 빈도를 줄인다. 여기까지는 기대대로다. 그런데 정확도가 정확히 0인 문제의 빈도도 함께 늘어난다. 평균 점수가 오른 까닭은 이미 풀 수 있던 문제를 더 효율적으로 맞히게 된 데 있고, 새로 풀린 문제가 생긴 것과는 무관하다.
둘째는 풀 수 있는 문제 집합의 비교다. AIME24는 k=1024, MATH500은 k=128에서 두 모델이 푼 문제를 대조했다.
| 베이스 | RLVR(SimpleRLZoo) | AIME24 | MATH500 |
|---|---|---|---|
| 풀었다 | 풀었다 | 63.3% | 92.4% |
| 풀었다 | 못 풀었다 | 13.3% | 3.6% |
| 못 풀었다 | 풀었다 | 0.0% | 1.0% |
| 못 풀었다 | 못 풀었다 | 23.3% | 3.0% |
베이스 모델만 푼 문제는 AIME24에서 13.3%에 이르는데, RLVR 모델만 푼 문제는 0.0%다. RL 모델이 푸는 문제 집합은 베이스 모델이 푸는 집합의 거의 부분집합이었다. 코드 생성에서도 같은 관계가 나왔다.
셋째는 퍼플렉시티다. 한 모델이 다른 모델의 응답을 얼마나 잘 예측하는지를 재는 값이다. AIME24에서 문제 두 개를 골라 베이스 모델과 RL 모델이 각각 16개씩 응답을 만들고, 비교용으로 OpenAI o1이 8개를 만들었다.
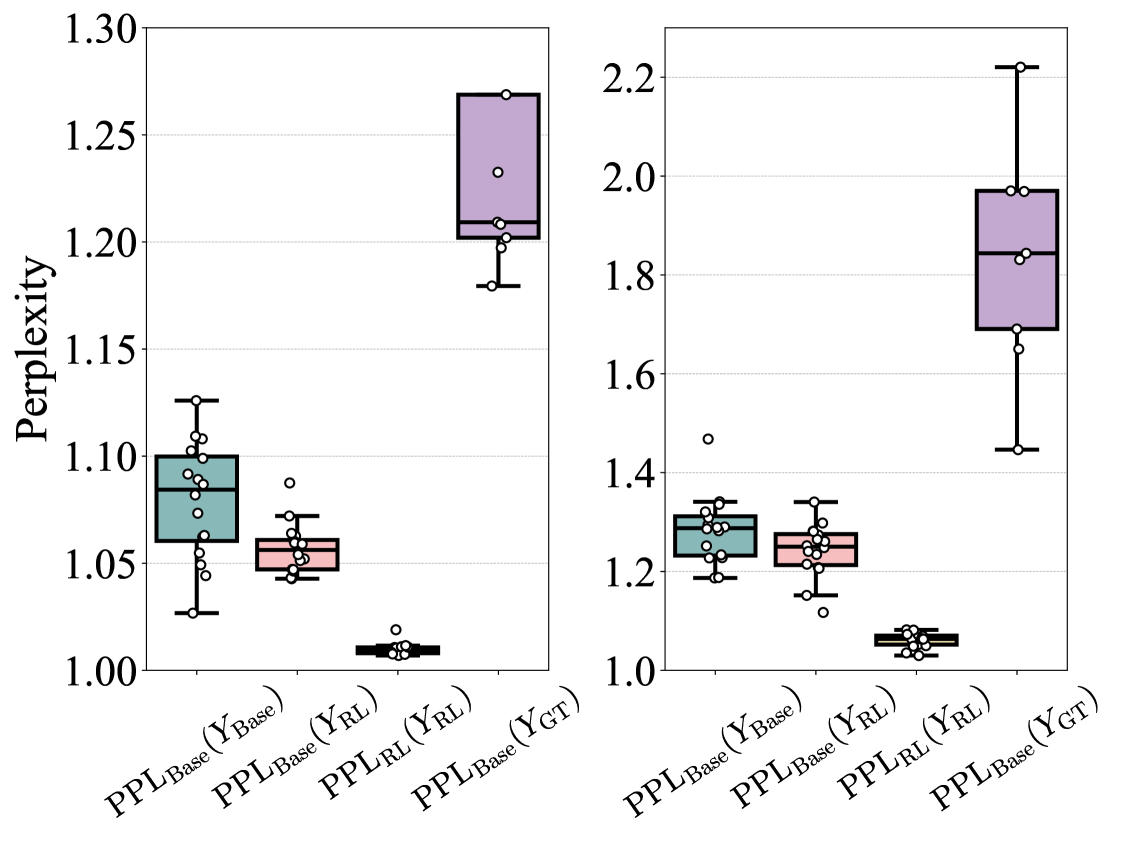
그림 6. 응답별 퍼플렉시티 분포. (Yue et al., 2025, CC BY 4.0)
RL 모델의 응답을 베이스 모델이 평가한 퍼플렉시티는, 베이스 모델이 자주 생성하는 응답 분포의 아래쪽과 거의 겹친다. RL 모델이 내놓는 문장은 베이스 모델이 원래도 높은 확률로 생성하던 문장이었다. 반대로 o1의 응답에 대한 퍼플렉시티는 뚜렷하게 높다. 학습이 진행될수록 이 값은 더 낮아지는데, 저자들은 이를 RLVR이 베이스 모델의 사전 분포 바깥으로 나가지 못한 채 기존 분포 안에서 특정 응답의 확률만 높이고 있다는 증거로 읽는다.
알고리즘을 바꿔도 크게 달라지지 않는다
연구진은 베이스 모델의 pass@256을 상한으로 두고, 거기서 RL 모델의 pass@1을 뺀 값을 샘플링 효율 격차(ΔSE)라고 정의했다. 값이 작을수록 좋다. VeRL 프레임워크에서 PPO, GRPO, Reinforce++, RLOO, ReMax, DAPO를 같은 조건으로 다시 구현해 비교했다. 학습에는 Omni-MATH에서 검증 가능한 문제만 추린 2,000개를 썼다. 평가는 같은 분포의 테스트 세트 821개와 분포 밖 벤치마크인 MATH500에서 했다.
| 모델 | Omni-MATH-Test pass@1 | Omni-MATH-Test pass@256 | MATH500 pass@1 | MATH500 pass@256 |
|---|---|---|---|---|
| Qwen2.5-7B (베이스) | 10.2 | 69.1 | 34.5 | 96.2 |
| GRPO | 25.1 | 68.3 | 74.4 | 97.2 |
| PPO | 26.8 | 69.2 | 75.2 | 97.2 |
| ReMax | 23.8 | 67.5 | 73.5 | 96.6 |
| RLOO | 28.1 | 69.2 | 75.0 | 97.4 |
| Reinforce++ | 28.0 | 69.7 | 75.4 | 96.8 |
| DAPO | 26.5 | 67.0 | 75.6 | 96.4 |
여섯 알고리즘 모두 pass@1을 10.2에서 알고리즘별로 23.8에서 28.1 사이까지 크게 끌어올린다. 그런데 각 알고리즘의 pass@256은 베이스 모델의 69.1과 거의 같거나 더 낮다. 논문은 알고리즘별 ΔSE가 같은 분포 테스트 세트에서 GRPO의 43.9와 RLOO의 42.6 사이에 있었고, 어떤 알고리즘에서도 40점 아래로 내려가지 않았다고 보고한다. 알고리즘을 바꾸는 것으로 상한에 다가가기는 어렵다는 결론이다.
알고리즘을 고를 때 참고할 관찰도 함께 나왔다. DAPO는 pass@1이 가장 높지만 동적 샘플링 때문에 배치당 세 배에서 여섯 배 많은 샘플이 필요하고, k=256에서 성능이 크게 떨어진다. RLOO와 Reinforce++는 k 전 구간에서 고르게 좋으면서 학습 비용도 아꼈다. ReMax는 greedy 응답의 보상을 어드밴티지 기준선으로 쓰는데, 이 값이 0 또는 1로만 나오고 변동이 커서 학습이 불안정해진 것으로 저자들은 추정한다.
오래 학습할수록 경계는 좁아진다
같은 설정에서 학습 스텝만 늘려 가며 곡선을 다시 그렸다.
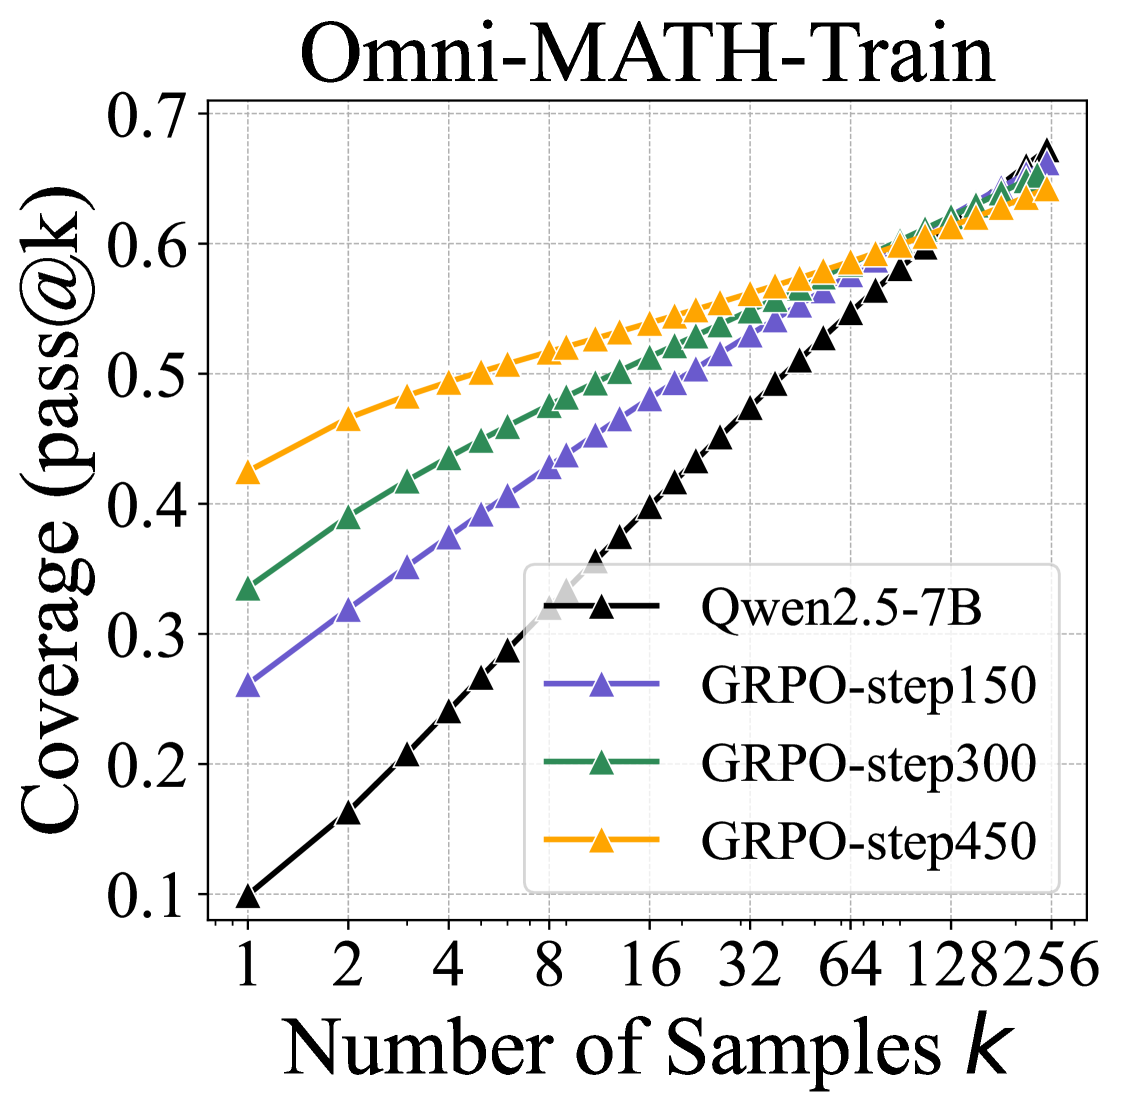
그림 1, 오른쪽. 학습이 진행될수록 pass@1은 오르고 pass@256은 내려간다. (Yue et al., 2025, CC BY 4.0)
Omni-MATH 학습 세트에서 pass@1은 26.1에서 33.6을 거쳐 42.5까지 올라간다. 같은 구간에서 pass@256은 66.3에서 65.3, 64.3으로 내려간다. 같은 학습 세트에서 베이스 모델은 67.2였으니, 학습이 길어질수록 풀 수 있는 문제의 범위가 줄어든 셈이다. 같은 분포 테스트 세트에서는 하락 폭이 더 크다. 68.3에서 66.6, 63.9로 내려가는데 베이스 모델은 69.1이다.
다른 설정을 바꿔도 이 경향은 유지된다. 프롬프트당 롤아웃 수 n을 8에서 32로 늘리면 pass@k가 조금 나아지지만 베이스 모델에는 여전히 추월당한다. 계수 0.001의 KL 항을 넣으면 pass@1은 비슷한데 pass@128이 훨씬 낮아진다. 학습이 진행되며 출력 엔트로피가 줄어드는 것이 원인일 수 있으니, RLVR 모델의 생성 온도를 올려 베이스 모델의 엔트로피에 맞춰 보기도 했다. 자기 자신의 온도 0.6 결과보다는 조금 나아지지만 베이스 모델을 넘지는 못했다. 엔트로피 감소는 경계 축소에 기여하는 요인 하나일 뿐, 축소 전부를 설명하지는 못한다.
모델 크기를 키워도 같은지는 확인이 쉽지 않았다. o1은 베이스 모델이 공개되어 있지 않다. Qwen3-235B는 RLVR과 긴 사고 사슬 지도학습이 여러 단계로 섞여 있어 RLVR의 몫만 떼어 낼 수 없다. DeepSeek-R1-Zero는 직접 호스팅해 봤더니 최대 시퀀스 길이 32k에서 초당 50토큰 정도가 한계라 pass@k 평가가 현실적으로 불가능했다. 대안으로 순수 RL로 학습된 Magistral-Medium-2506과 그 시작 모델인 Mistral-Medium-3-2505를 API로 비교했다. k=1에서 RLVR 모델이 AIME24를 7문제, AIME25를 8문제 더 풀지만 k가 커질수록 격차가 줄어든다. 프런티어에 가까운 모델에서도 같은 양상이 나타났다.
증류는 다르다
그렇다면 베이스 모델의 경계를 실제로 넓히는 방법은 무엇인가. 저자들이 대조군으로 세운 것은 증류 모델이다. DeepSeek-R1의 긴 사고 사슬을 Qwen2.5-Math-7B에 옮겨 만든 DeepSeek-R1-Distill-Qwen-7B가 그 대상이다. 비교 상대로는 같은 베이스 모델 Qwen2.5-Math-7B와 그 RL 학습본인 Oat-Zero-7B, 그리고 Instruct 버전을 함께 놓았다.
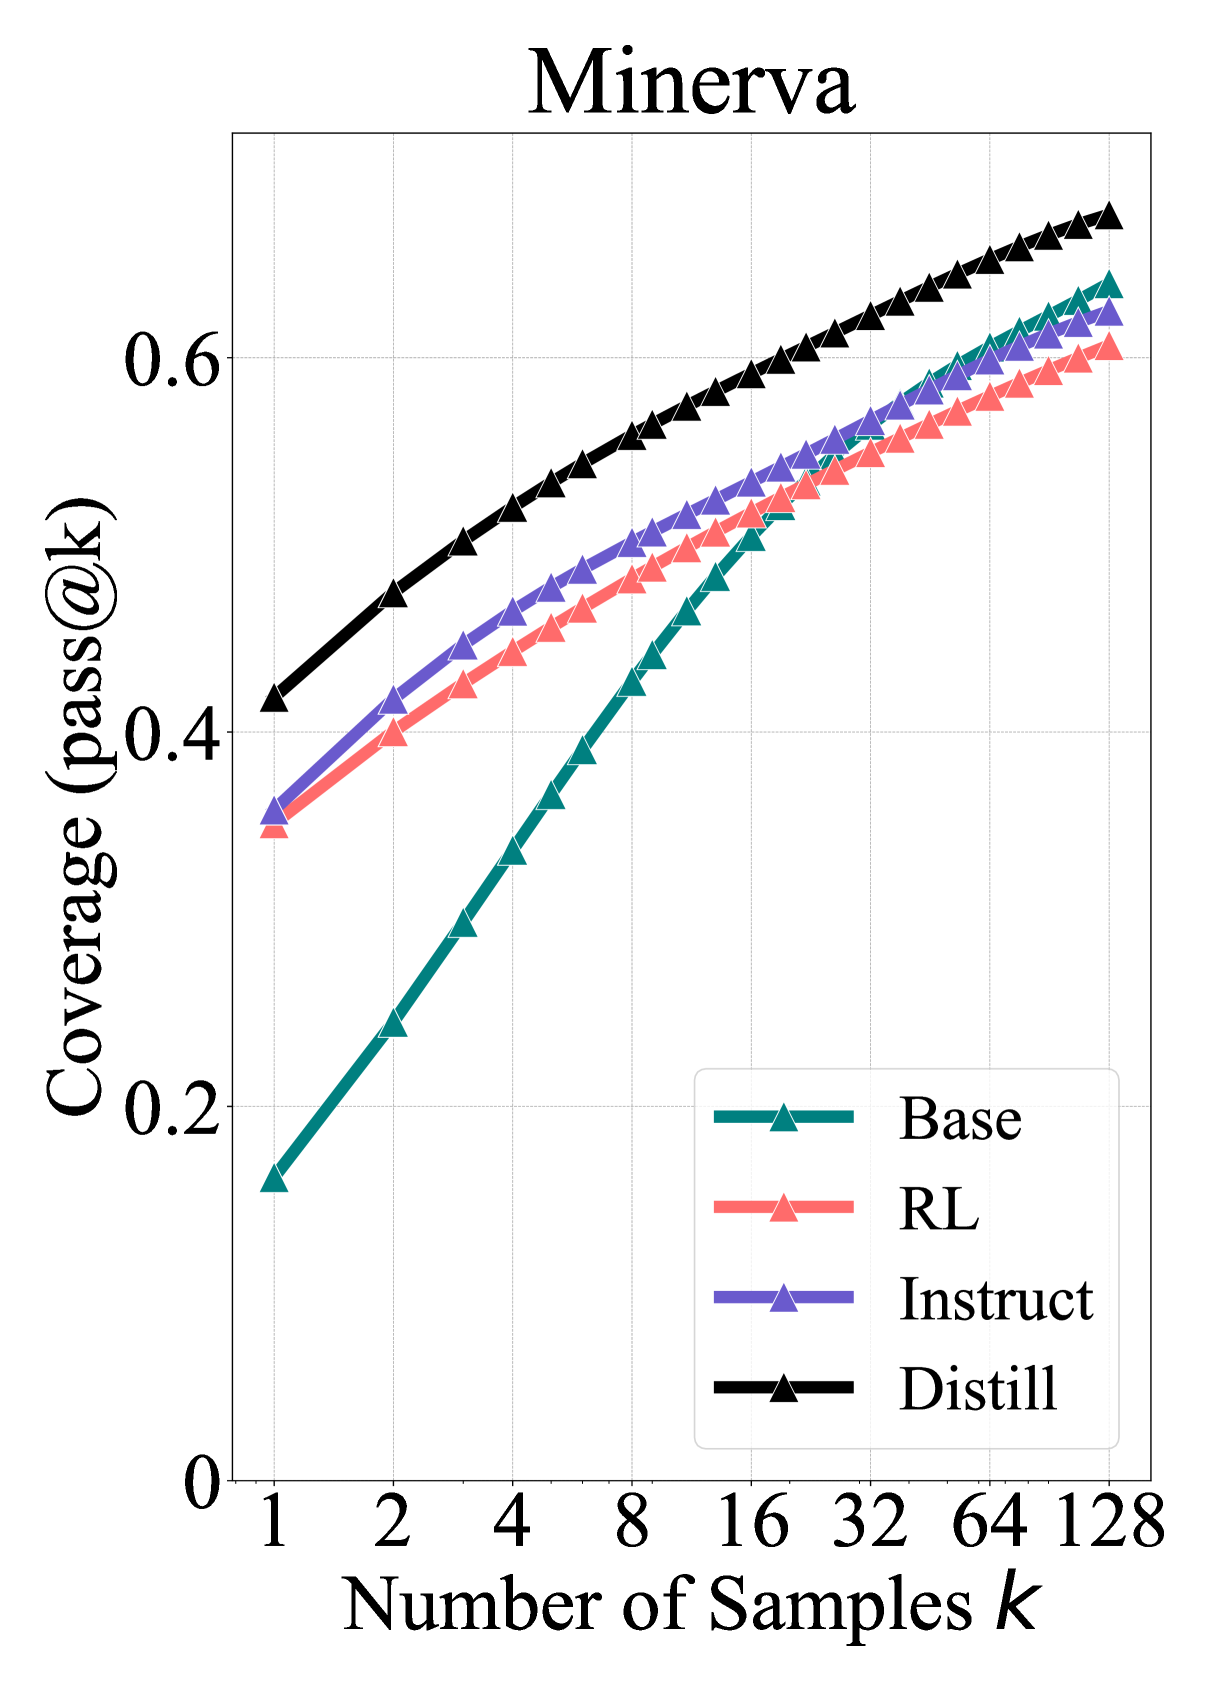
그림 7. 증류 모델은 k 전 구간에서 베이스 모델 위에 있다. (Yue et al., 2025, CC BY 4.0)
증류 모델의 곡선은 k 전 구간에서 베이스 모델보다 뚜렷하게 위에 있다. 더 강한 교사에게서 새 추론 패턴을 받아 왔기 때문에 베이스 모델의 경계를 넘어선다. 강화학습과 증류가 성능을 올리는 방식이 근본적으로 다르다는 것이 이 그림의 요지다.
저자들이 보는 원인과 대안
논문은 원인을 두 가지 차이에서 찾는다. 하나는 행동 공간의 크기다. 언어 모델의 행동 공간은 바둑이나 아타리와 비교할 수 없이 크고, 강화학습 알고리즘은 원래 이런 규모를 다루도록 설계되지 않았다. 사전학습 없이 시작하면 보상 신호를 찾아내는 일 자체가 거의 불가능하다.
그래서 두 번째 차이가 따라온다. RLVR은 사전학습된 베이스 모델에서 출발한다. 사전 분포가 그럴듯한 응답을 만들어 주니 탐색이 쉬워지고 긍정적 보상도 받을 수 있다. 그런데 같은 사전 분포가 탐색 범위도 제한한다. 토큰 단위 샘플링으로 사전 분포를 벗어나면 대개 말이 되지 않는 출력이 나와 음의 보상을 받는다. 정책 경사 알고리즘은 사전 분포 안에서 보상을 받은 응답의 가능도를 올리고 바깥에서 벌을 받은 응답의 가능도를 내린다. 그러니 학습된 정책은 사전 분포 안쪽으로 더 깊이 수렴한다. 사전 분포가 서로 반대되는 두 효과를 낸다고 논문이 설명하는 까닭이다.
대안으로 제시한 방향은 네 가지다.
- 높은 추상 수준에서의 탐색. AlphaEvolve처럼 프로그램 수준의 추상 공간에서 자기 진화를 수행하는 방식이라면, 토큰 단위 샘플링만으로는 도달하지 못하는 사전 분포 밖의 패턴을 찾아낼 수 있다.
- 커리큘럼을 통한 데이터 확장. 쉬운 하위 문제부터 학습시켜 메타 기술을 갖춘 뒤 어려운 문제로 올라가면, 정답률이 0이던 어려운 과제에서 0이 아닌 보상을 받을 길이 열린다. 이를 위해서는 쉬운 문제와 어려운 문제의 관계까지 설계한 대규모 데이터 파이프라인이 필요하다.
- 과정 보상과 세밀한 기여도 배분. 0 또는 1의 결과 보상 대신 중간 신호를 주면 탐색이 유망한 경로 쪽으로 향한다.
- 에이전트형 강화학습. 지금의 RLVR은 한 번의 응답으로 끝난다. 환경 피드백을 받아 여러 턴에 걸쳐 수정하고 도구로 새 정보를 모으는 구조라면 모델이 새로운 경험을 만들어 내고 거기서 배울 수 있다.
논문이 밝힌 한계
논문은 공개된 순수 RLVR 모델을 가능한 한 많이 모았다고 밝히면서도, 가장 강한 모델과 학습 파이프라인 상당수가 비공개라는 제약을 인정한다. 언어 모델 강화학습이 빠르게 바뀌고 있으므로 여기서 지적한 한계를 완화하는 기법이 나올 수 있다는 단서도 붙였다. k를 천문학적으로 키우면 무작위 샘플링으로도 정답을 얻을 수 있다는 반론에 대해서는, 베이스 모델이 정답을 내놓은 k가 128이나 1024 수준이며 이는 현실적인 연산 예산 안이라고 답한다.
0.0%가 남긴 질문
표에서 가장 눈여겨본 수치는 0.0%였다. AIME24에서 베이스 모델만 푼 문제가 13.3%인데 RLVR 모델만 푼 문제는 하나도 없었다. 강화학습이 성능을 올린 것은 맞다. 그런데 올라간 것은 정답을 뽑아낼 확률이었고, 새로 풀린 문제는 없었다.
여기서 벤치마크 점수가 무엇을 재고 있었는지를 다시 생각하게 된다. pass@1은 모델이 한 번에 정답을 낼 확률이고, 서비스 품질을 재는 지표로는 타당하다. 그러나 이 숫자만 보고 있으면 풀 수 있는 문제의 범위가 넓어졌는지, 이미 풀 수 있는 문제를 맞힐 확률이 높아졌는지를 구분할 수 없다. 두 가지는 공학적으로 전혀 다른 일인데 하나의 점수로 합쳐져 있었다.
증류가 대조군으로 들어온 배치도 마음에 남았다. 증류한 학생 모델이 새 추론 패턴을 스스로 발견한 것은 아니다. 교사 모델이 이미 가진 것을 옮겨 받았을 뿐이다. 그렇다면 새 추론 패턴을 어디선가 처음 만들어 내는 주체가 따로 있어야 하고, 지금의 RLVR은 그 주체가 되지 못하고 있다. 저자들이 마지막에 에이전트형 강화학습과 환경 상호작용을 꺼내 든 것은 그 주체를 어디에서 구할 것인가에 대한 답으로 읽힌다.
출처
Yang Yue, Zhiqi Chen, Rui Lu, Andrew Zhao, Zhaokai Wang, Yang Yue, Shiji Song, Gao Huang. “Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?” 칭화대학교 LeapLab과 상하이교통대학교. NeurIPS 2025 Oral.
원문: https://arxiv.org/abs/2504.13837 프로젝트 페이지: https://limit-of-RLVR.github.io
본문 그림은 모두 위 논문(CC BY 4.0)에서 인용했다.