3줄 요약
- Meta FAIR와 파리 도핀 대학교 연구진(Kunhao Zheng 외)은 NeurIPS 2026 채택 논문에서, 경쟁 프로그래밍 강화학습의 보상 해킹을 모델 가중치 연산만으로 제어하는 방법을 제시했다.
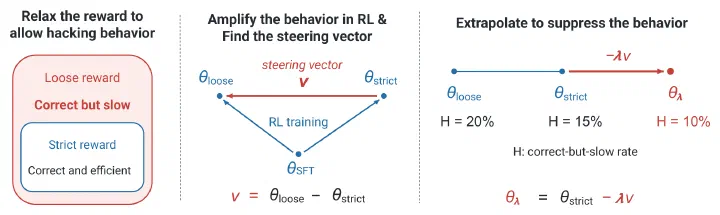
- 같은 초기 모델에서 단위 테스트의 엄격도만 달리해 두 강화학습 모델을 훈련하면, 두 모델의 가중치 차이가 비효율적인 코드를 내놓는 경향을 조절하는 조향 벡터(steering vector)가 된다.
- 32B 고난도 문제 평가에서 엄격한 보상 모델(계수 1)보다 더 큰 계수로 가중치를 외삽하면, 추가 강화학습 없이도 자원 한도 실패율이 22.8%에서 8.0%로 내려가고 정답 코드의 실행 속도도 빨라진다.
통제된 보상 해킹 실험: 경쟁 프로그래밍의 시간 초과
대규모 언어 모델을 강화학습(RL)으로 훈련하다 보면, 모델이 설계자가 의도한 행동 대신 보상 함수의 점수 조건만 충족하는 편법을 학습하곤 한다. 이러한 보상 해킹(reward hacking)을 막으려면 연구자가 실패한 생성 궤적을 일일이 살펴보며 원치 않는 행동을 찾아내고 보상 함수를 더 까다롭게 고쳐야 한다.
연구진은 보상 해킹 문제를 통제된 실험으로 설계했다. 실험 환경은 검증 가능한 보상을 쓰는 강화학습(RLVR)의 하나인 경쟁 프로그래밍이다.1 경쟁 프로그래밍에서는 브루트포스(전수 탐색) 풀이가 자주 나온다. 이런 풀이는 작은 입력만 담은 단위 테스트는 모두 통과하지만, 입력 크기가 커지면 시간 초과(timeout)나 메모리 초과를 일으킨다.
연구진은 단위 테스트의 입력 문자열 길이 기준을 $10^k$($k \in \{2, 3, 4, 5, 6, \infty\}$)로 설정해 보상의 엄격도를 단계적으로 조절했다. 코드 답안 $y$가 받는 이진 보상 $R_k(y)$는 다음과 같이 정의된다.
$$ \begin{aligned} R_k(y) &= \mathbf{1}[\text{길이 } {<}\,10^k \text{ 통과}] \\ R_\infty(y) &= \mathbf{1}[\text{전체 통과}] \end{aligned} $$단위 테스트 일부를 제외해 $k$를 낮추면 브루트포스 풀이도 양의 보상을 받게 되므로 보상 해킹이 쉬워진다. 이 보상 체계는 포함 관계를 이루도록 설계됐다. 엄격한 보상($R_\infty$)을 통과한 답안은 느슨한 보상($R_k$)도 반드시 통과한다. 한편 평가에는 $k$와 관계없이 항상 전체 테스트 스위트(LiveCodeBench v5)를 사용했다. 훈련 보상은 받았는데 평가에서는 실패하는 답안이 있으면, 그것을 보상 해킹이 일어난 증거로 기계적으로 판별할 수 있다.2
| 구분 | 설정 내용 |
|---|---|
| 출발 모델 | 32B(CWM-SFT) 및 7B(Qwen-2.5 7B 기반 자체 SFT 체크포인트) |
| 강화학습 환경 | 단일 턴 추론, 다중 턴 파이썬 도구 호출, 샌드박스 터미널 에이전트 코딩 |
| 훈련 데이터와 보상 | CodeContestsPlus(1에폭), 입력 길이 기준 $10^k$에 따른 이진 통과 보상 $R_k(y)$ |
| 평가 벤치마크 | LiveCodeBench v5(전체 테스트 스위트로 채점) |
| 평가 결과 분류 | 정답, 자원 한도 실패(시간 및 메모리 초과), 정확도 실패(오답 및 예외), 형식 오류 |
가중치 공간에서 보상 해킹 벡터 찾기
연구진은 동일한 지도 미세조정(SFT) 체크포인트에서 출발해, 보상의 엄격도만 달리하고 나머지 훈련 데이터와 하이퍼파라미터는 모두 같게 맞춰 독립된 강화학습 모델들을 훈련했다. 보상이 다르면 강화학습 과정에서 서로 다른 풀이 궤적이 강화되고, 그 차이가 훈련된 모델의 가중치에 반영된다.
느슨한 보상으로 훈련해 보상 해킹을 자주 하는 체크포인트를 $\theta_{\mathrm{loose}}$(또는 $A$)라 하자. 엄격한 보상으로 훈련해 보상 해킹을 적게 하는 체크포인트는 $\theta_{\mathrm{strict}}$(또는 $B$)라 하자. 두 모델의 가중치는 선형으로 연결된 하나의 수렴 영역(linearly-connected basin)에 속하므로, 가중치를 절반씩 섞기만 해도($0.5 \times A + 0.5 \times B$) 두 모델의 중간 성질을 가진 모델이 나온다.3
연구진은 두 가중치의 차이 벡터 $v = \theta_{\mathrm{loose}} - \theta_{\mathrm{strict}}$가 보상 해킹 행동을 제어하는 조향 벡터(steering vector) 역할을 한다는 점을 확인했다. $0 \le \alpha \le 1$이면 두 체크포인트의 내삽(interpolation)이다. $\alpha$가 $0$ 미만이면 보상 해킹 행동이 더 증폭되고, $1$ 초과이면 더 강하게 억제되는 외삽(extrapolation)이 된다.
$$ \theta_\alpha = (1 - \alpha)\,\theta_{\mathrm{loose}} + \alpha\,\theta_{\mathrm{strict}} $$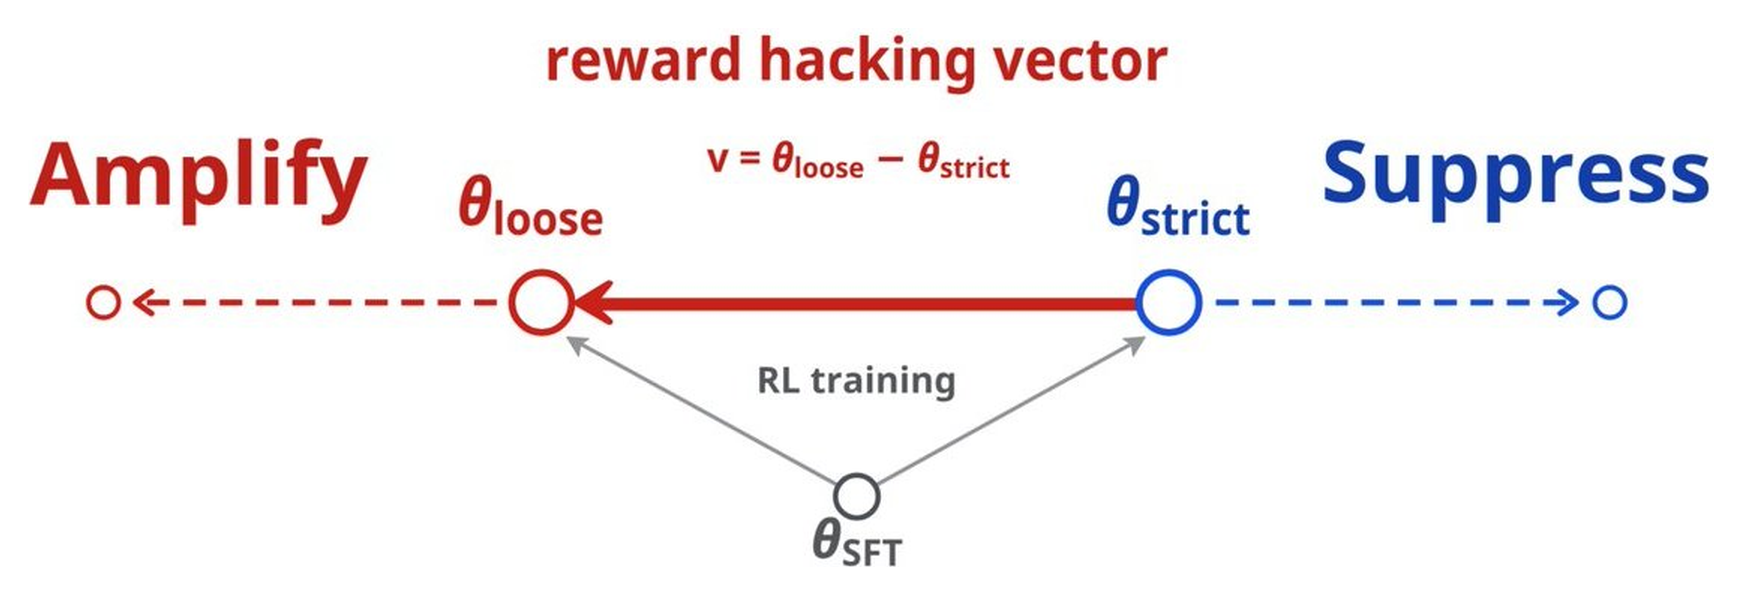 동일한 $\theta_{\mathrm{SFT}}$에서 훈련한 $\theta_{\mathrm{loose}}$와 $\theta_{\mathrm{strict}}$의 가중치 차이 $v = \theta_{\mathrm{loose}} - \theta_{\mathrm{strict}}$. 원문: Kunhao Zheng et al. (2026)
가중치에 직접 사칙연산을 적용해 $\alpha = -0.2$인 $1.2 \times A - 0.2 \times B$를 만들면 $A$보다 보상 해킹을 더 자주 하는 모델이 된다. 반대로 $\alpha = 1.2$인 $-0.2 \times A + 1.2 \times B$를 만들면 엄격한 보상으로 훈련한 $B$보다도 보상 해킹을 더 적게 하는 모델이 된다.
실제 강화학습에서는 보상 함수를 허점 없이 더 엄격하게 만들기는 어렵지만, 기존 테스트를 덜어내 보상을 느슨하게 만들기는 훨씬 간단하다. 가중치 외삽은 바로 이 보상 설계의 비대칭성을 활용한다. 먼저 느슨한 보상으로 원치 않는 행동을 일부러 증폭한다. 이렇게 얻은 가중치 차이 벡터에 음의 배수를 더해 외삽하면, 추가 강화학습 없이도 그 행동을 엄격한 보상 모델보다 더 강하게 억제할 수 있다.
외삽으로 보상 해킹 억제하기
가중치 외삽은 실제 평가에서 뚜렷한 억제 효과를 보였다. 32B 도구 사용 모델의 LiveCodeBench 고난도(hard) 문제 평가에서, 느슨한 보상 모델($\alpha = 0$)의 자원 한도 실패율은 22.8%였고 엄격한 보상 모델($\alpha = 1$)은 이를 14.5%로 줄였다. 여기에 가중치 외삽($\alpha = 2.0$)을 적용하자 추가 강화학습 없이도 자원 한도 실패율이 8.0%까지 감소했다.
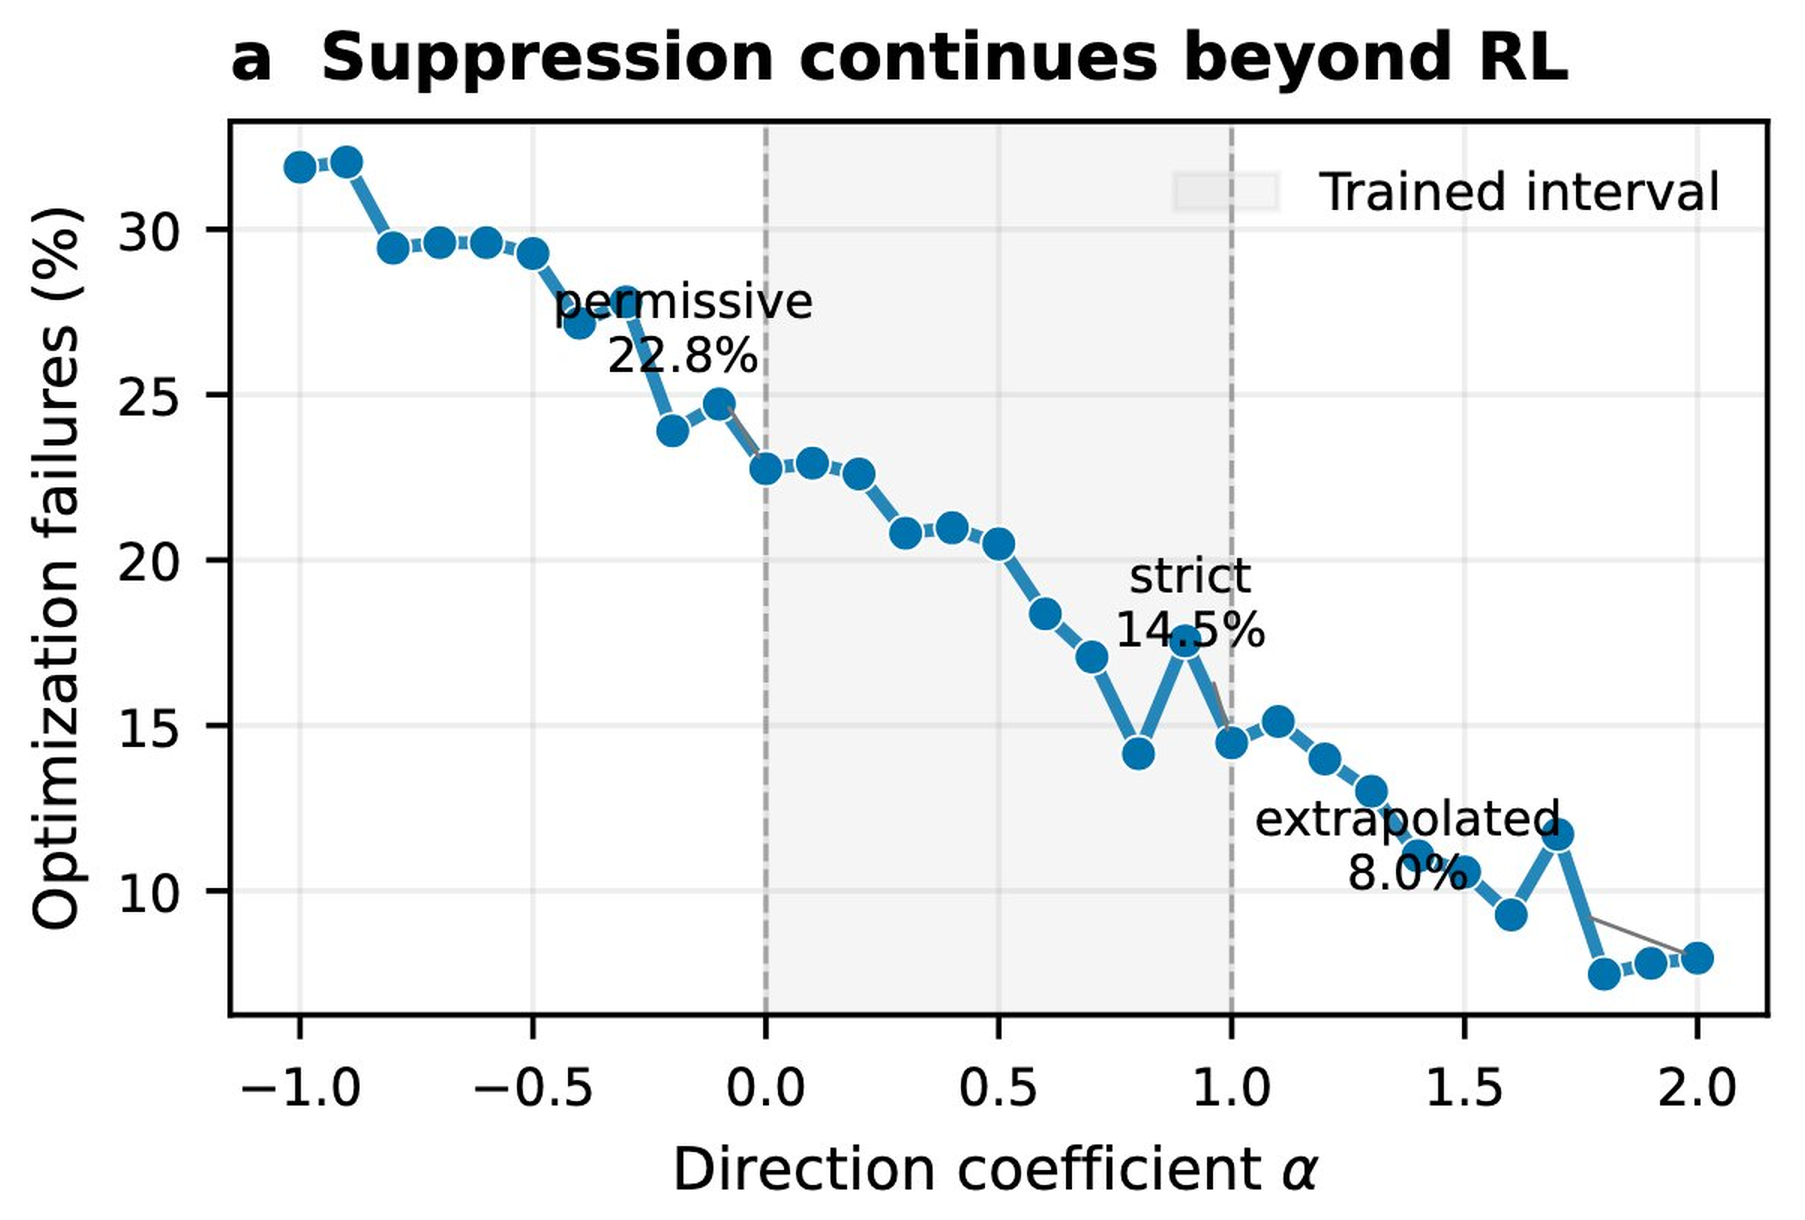 계수 $\alpha$에 따른 자원 한도 실패율 변화. 회색 음영($0 \le \alpha \le 1$)은 훈련된 두 체크포인트의 내삽 구간. 원문: Kunhao Zheng et al. (2026)
시간 초과가 줄어든 데 이어, 정답 판정을 받은 프로그램의 실제 실행 시간도 짧아졌다. 엄격한 보상 모델($\alpha = 1$)과 외삽 모델($\alpha = 2$)이 둘 다 맞힌 중간과 고난도(medium, hard) 문제 141개를 비교하니, 외삽 모델의 코드가 기하평균 1.14배(95% 신뢰구간 $[1.04, 1.27]$) 빨랐다. 특히 엄격한 보상 모델의 풀이 실행 시간이 1초를 초과하는 고부하 문제에서는 공통 정답 중 71%에서 실행 속도가 빨라졌고, 속도 향상은 기하평균 1.30배(95% 신뢰구간 $[1.12, 1.56]$)였다.
| 비교 항목 | 느슨한 보상 ($\alpha=0$) | 엄격한 보상 ($\alpha=1$) | 가중치 외삽 ($\alpha=2$) |
|---|---|---|---|
| 자원 한도 실패율 (LCB/hard) | 22.8% | 14.5% | 8.0% |
| 추가 강화학습 훈련 여부 | 훈련 1회 | 훈련 1회 | 추가 훈련 없음 (가중치 연산) |
| 고부하 문제 실행 속도 ($\alpha=1$ 대비) | 측정 대상 아님 | 기준 (1.00배) | 71% 문제에서 단축 (기하평균 1.30배) |
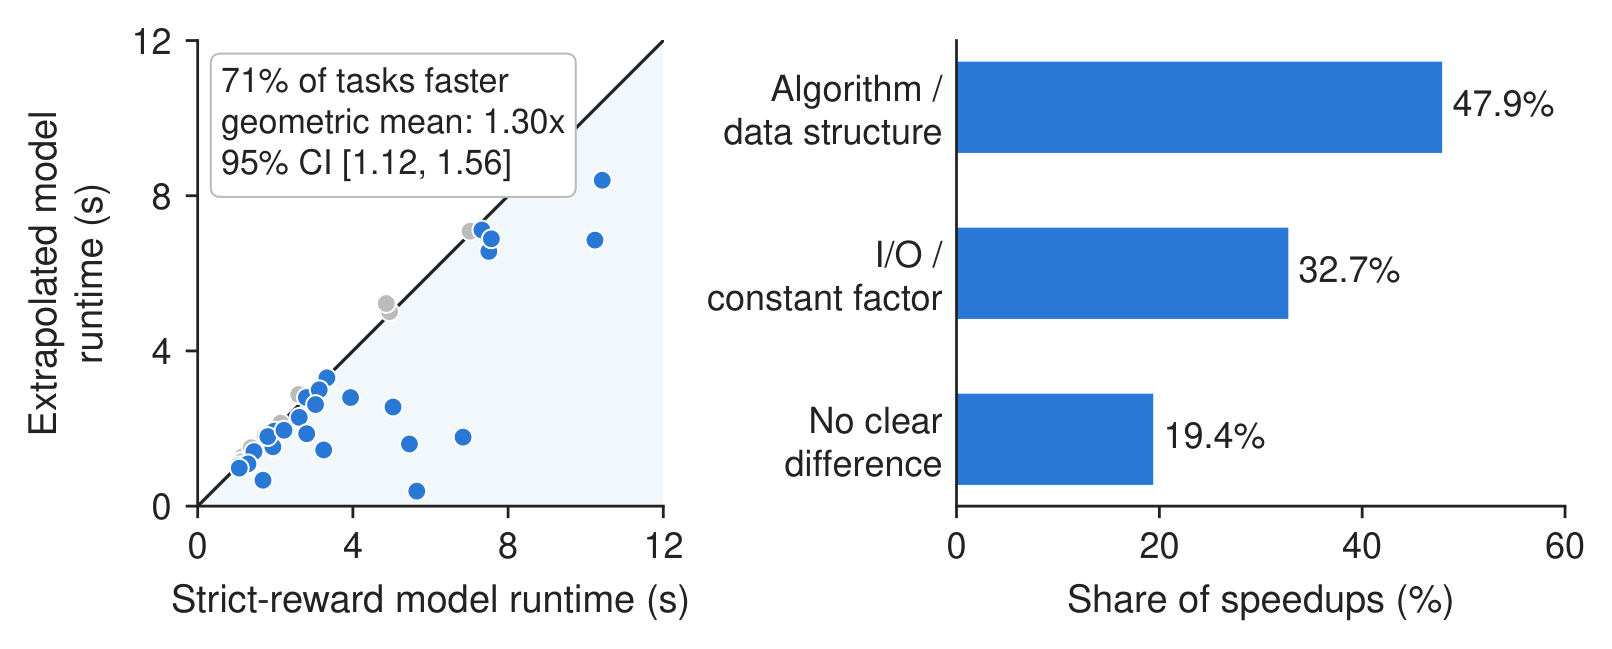 왼쪽: 두 모델이 함께 푼 고부하 문제의 실행 시간 비교(대각선 아래가 외삽 모델 우위). 오른쪽: 속도 향상 요인 비중. 원문: Kunhao Zheng et al. (2026)
실행 시간이 5% 이상 단축된 정답 코드 쌍을 LLM 판정기로 비교해 보니, 속도 향상의 47.9%는 더 효율적인 알고리즘이나 자료구조를 선택한 데서 비롯됐다. 32.7%는 입출력(I/O) 처리 방식이나 상수항(constant factor) 최적화 덕분이었고, 나머지 19.4%는 뚜렷한 코드 구조 차이가 없었다.
정확도 세금과 외삽의 한계
직관과 달리 보상을 엄격하게 만든다고 해서 모델의 전체 문제 해결 능력이 올라가지는 않았다. 독립된 여러 강화학습 실험을 비교하니, 보상이 엄격해질수록 자원 한도 실패는 줄었지만 어려운 문제에서 오답이나 런타임 예외로 끝나는 정확도 실패(correctness failure)는 늘었다. 저자가 ‘정확도 세금(correctness tax)’이라 부른 이 상충 때문에 전체 정답률(solve rate)은 거의 변하지 않았다.4
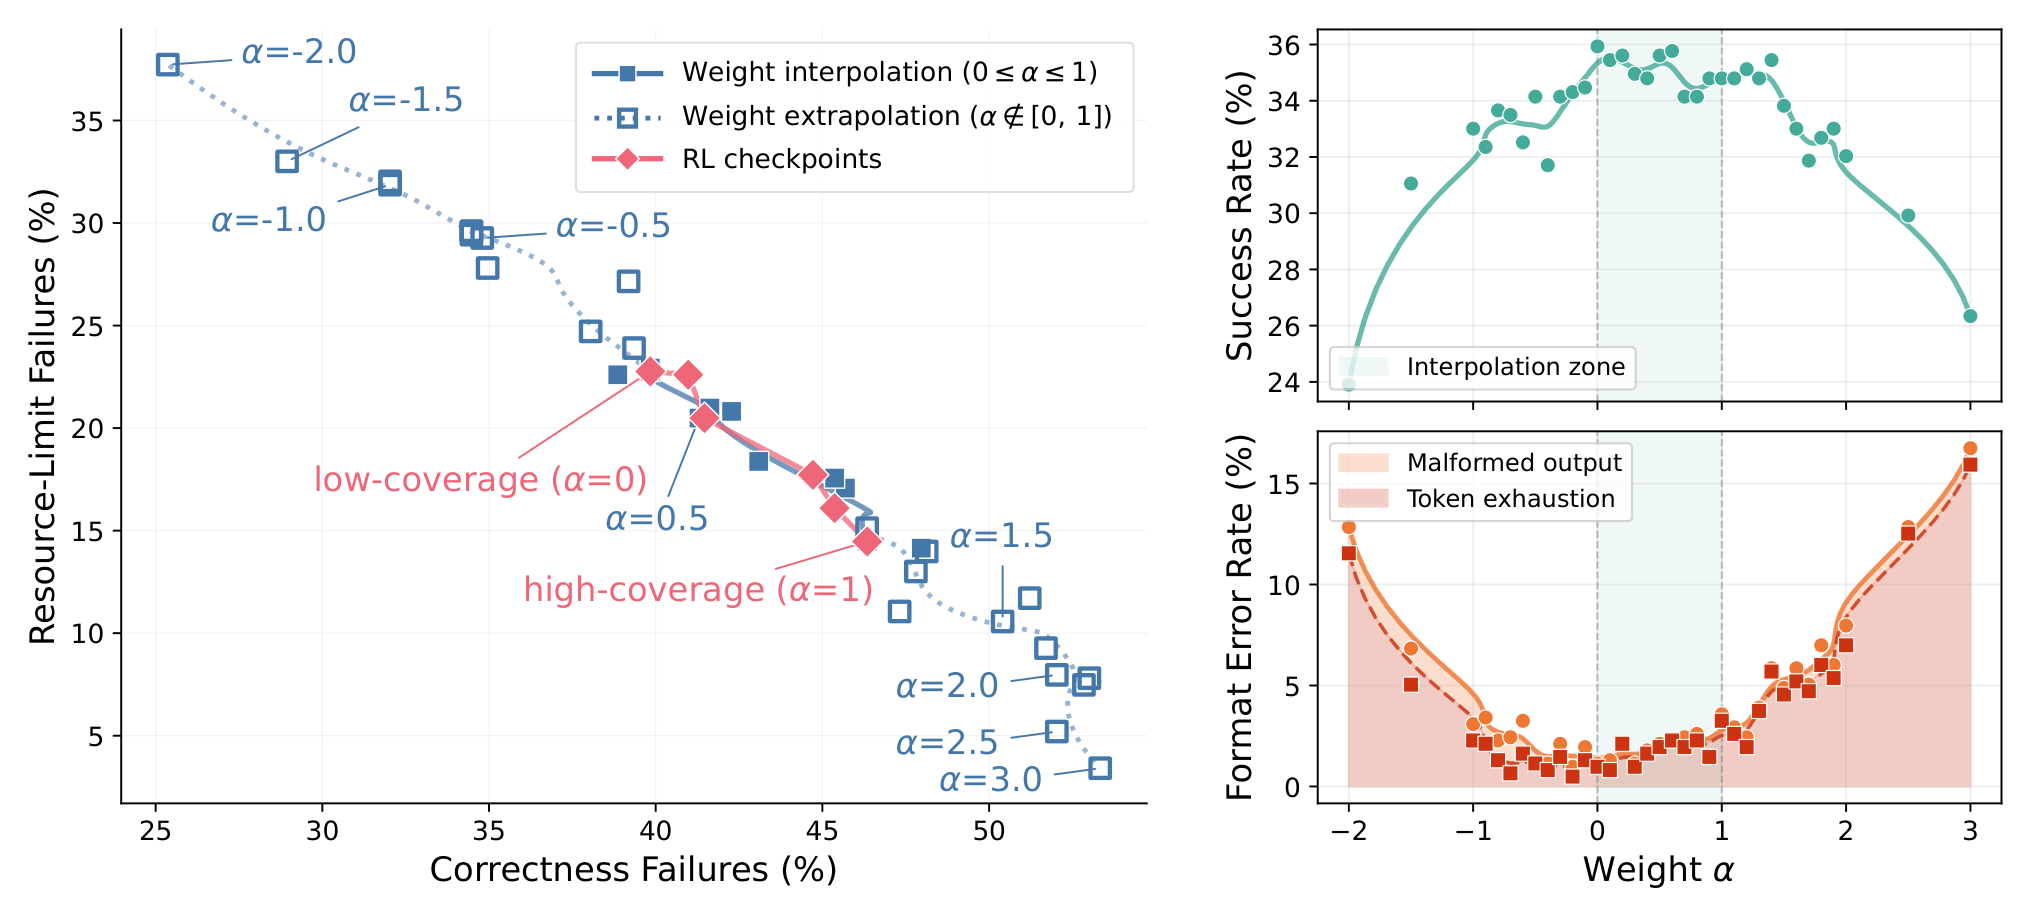 왼쪽: 내삽과 외삽 체크포인트가 그리는 정확도 실패율과 자원 한도 실패율의 상충 관계. 오른쪽: 계수 $\alpha$에 따른 정답률(위)과 형식 오류율(아래). 원문: Kunhao Zheng et al. (2026)
물론 외삽 계수를 한없이 늘릴 수는 없다. $\alpha \in [-0.5, 1.5]$ 범위에서는 전체 정답률이 약 34~36%로 안정적이고, $\alpha = 2.0$에서도 약 33% 수준을 유지한다. 그러나 외삽 계수를 $\alpha \le -1.5$나 $\alpha \ge 2.5$처럼 극단적인 값으로 설정하면, 모델이 같은 문구를 반복하거나 추론을 멈추지 못해 최대 토큰 한도를 모두 쓰는 등 형식 오류가 늘면서 정답률이 가파르게 떨어진다.5
3단계 개입 절차와 추론 시점 앙상블
연구진은 이번 발견을 바탕으로 보상 해킹을 제어하는 3단계 개입 절차를 제안한다.
| 단계 | 작업 내용 |
|---|---|
| 1. 증폭 (Amplify) | 느슨한 보상을 사용해 제어하려는 비효율적 행동을 일부러 증폭한 모델을 훈련한다. |
| 2. 식별 (Identify) | 엄격한 보상 모델과의 가중치 차이($v = \theta_{\mathrm{loose}} - \theta_{\mathrm{strict}}$)를 해당 행동의 조향 벡터로 구한다. |
| 3. 억제 (Suppress) | 엄격한 보상 모델에 조향 벡터의 음의 배수를 더해 추가 훈련 없이 행동을 억제한다. |
한편 논문은 전체 정답률이 일정한 구간에서도 계수 $\alpha$에 따라 풀리는 문제의 집합이 조금씩 달라진다고 보고한다. 고난도 문제 중 24.4%는 모든 $\alpha$에서 풀리고, 28.5%는 어떤 $\alpha$에서도 풀리지 않는다. 나머지 47.2%는 일부 $\alpha$ 값에서만 풀린다. 이처럼 체크포인트마다 풀리는 문제가 다르다는 점을 활용한다. 단일 체크포인트에 쓰던 총 샘플링 예산을 내삽과 외삽 체크포인트 5개에 균등하게 배분하면, 최고 성능의 단일 체크포인트만 쓸 때보다 LiveCodeBench v5 기준 pass@250 점수가 3.3%p 향상된다.
가장 흥미로운 지점
보상을 허점 없이 고치기는 어렵지만 일부러 허술하게 풀기는 쉽다는 비대칭성을 역이용한 데서 이 연구의 묘미가 드러난다. 강화학습 실무에서 모델의 편법을 막으려고 보상 함수를 빈틈없이 고치는 작업은 끝이 없다. 반면 테스트 조건을 일부러 덜어내 모델이 편법을 쓰게 만드는 일은 간단하다.
원치 않는 행동을 막으려 애쓰는 대신, 느슨한 보상으로 그 행동을 증폭해 가중치 변화 방향을 구한 뒤 반대 부호로 빼 버린다는 접근이 명쾌하다. 내가 보기에 보상을 엄격하게 만들어도 시간 초과가 오답으로 바뀔 뿐 전체 정답률은 거의 달라지지 않는다는 ‘정확도 세금’ 실측 결과도 인상적이다. 검증 가능한 보상을 쓰는 강화학습(RLVR)이 용량이 한정된 모델에서 정확도와 효율성 사이에 어떤 상충을 낳는지 보여 준다.
출처
Kunhao Zheng (@KunhaoZ), “Finding the Reward Hacking Vector in Weight Space”, X, 2026-11-10.
- 원문: https://x.com/kunhaoz/status/2120172863734849903
- 논문: Kunhao Zheng, Pierre Chambon, Juliette Decugis, Jonas Gehring, Taco Cohen, Benjamin Negrevergne, Gabriel Synnaeve, “Correctness vs Efficiency: Behavior Control with Weight-Space Extrapolation in Code RL”, NeurIPS 2026 (arXiv:2605.28751).
이 다이제스트의 원문은 제1저자 Kunhao Zheng이 2026년 11월 10일 X 아티클로 요약한 글이며, 실험 수치와 세부 설정은 함께 공개된 NeurIPS 2026 채택 논문 Correctness vs Efficiency: Behavior Control with Weight-Space Extrapolation in Code RL (arXiv:2605.28751)로 보충했다. ↩︎
시간 초과가 난 답안 중에는 실행 시간이 느릴 뿐 알고리즘은 맞는 코드와 아예 오답인 코드가 섞여 있을 수 있다. 연구진이 제한 시간을 100배로 늘려 재채점하고, LLM 판정기의 다수결과 수작업 검수로 분류를 확인했다. 그러자 자원 한도 실패의 5~32%가 정확도 실패로 재분류됐다. 그래도 보상의 엄격도 순서와 상충 곡선의 형태는 그대로 유지됐다. ↩︎
이처럼 각각 따로 훈련한 모델의 가중치를 결합하는 기법은 선형 모드 연결성(linear mode connectivity), 태스크 벡터(task vector), 보상 수프(rewarded soups) 등의 이름으로 연구되어 왔다. 기존 보상 수프는 서로 다른 목적함수로 훈련한 모델을 내삽해 파레토 전선을 복원했다. 이번 연구는 같은 이진 보상 체계에서 검증 엄격도만 포함 관계가 되도록 바꾼 두 체크포인트를 외삽해, 개별 훈련이 도달한 수준보다 더 강하게 행동을 제어한다는 점이 다르다. ↩︎
이 상충 관계는 고정된 벤치마크 난이도 라벨에 좌우되지 않고 모델의 역량 한계에 따라 나타난다. 32B 모델에서는 고난도(hard) 문제에서만 상충 곡선이 뚜렷하지만, 7B 모델에서는 중간 난이도(medium) 문제부터 같은 상충 관계가 생긴다. ↩︎
논문 부록(Appendix D)에서 가중치 차이 행렬을 분석하니, 가중치 변화는 대부분의 층에 고른 크기로 분포한 랭크 높은(high-rank) 행렬이었다. 그러나 신경망의 가운데 절반 층만 맞바꿔 끼우는 실험(layer stitching)으로도 행동 변화 대부분이 재현되어, 실제 행동 제어 효과는 중간 층에 집중되어 있는 것으로 확인됐다. ↩︎