3줄 요약
- 시카고 대학교 연구진이 2026년 10월 5일 arXiv에 공개한 논문이다. 연구진은 논문에는 최종 결과만 남고, 그 결과를 얻기까지 연구자가 내린 결정의 순서는 기록되지 않는다는 문제의식에서 연구를 시작했다. 이를 보완하기 위해 논문과 함께 공개된 GitHub 저장소의 커밋 기록을 연구 과정의 대리 기록으로 삼았다. 커밋에서 연구 결정의 순서를 자동으로 추출하는 파이프라인도 만들어, 이 파이프라인으로 데이터셋 ResearchTrails를 구축했다.
- 연구진은 2022년에서 2025년 사이의 NeurIPS 논문 15,234편을 처리해 저장소 599개를 골라냈고, 이 저장소들에서 연구 결정 13,271개를 얻었다. 결정마다 범주(방법, 실험, 절제 실험)와 결과(끝까지 유지, 다른 결정으로 대체, 폐기)가 함께 기록된다. 연구진은 여러 프로젝트에서 반복되는 연구 패턴도 정리했는데, 그중 여럿은 방법을 바꾸기 전에 원인부터 진단하는 순서를 따른다.
- 이 기록으로 정리한 스킬을 받은 Gemini 3.1 Flash-Lite는 다음 연구 결정을 예측하는 과제에서 4점 만점에 평균 1.62점을 받았다. 같은 모델이 아무 도움 없이 받은 점수와 최종 논문으로 정리한 스킬을 받았을 때의 점수는 모두 1.33점이었다. Qwen3-8B를 이 기록으로 지도 학습했을 때의 점수는 1.20점이었고, 이어서 강화학습을 진행하자 1.51점이 됐다.
논문에 기록되지 않는 연구 과정
대형 언어 모델(LLM)로 연구를 자동화하는 시스템은 아이디어 생성, 문헌 정리, 코드 작성처럼 연구의 개별 단계에서 성과를 내고 있다. 여러 에이전트를 연결해 연구 전체를 흉내 내는 시스템도 나왔다. 연구진이 주목한 것은 이 시스템들이 다루지 않는 능력이다. 실제 연구자는 프로젝트를 진행하다 예상하지 못한 결과를 얻으면 방법을 고친다. 가설을 확인하기 위한 실험을 새로 추가하기도 하고, 성과를 기대하기 어려운 시도를 포기하기도 한다. 논문은 이처럼 프로젝트가 진행되는 동안 연구 결정을 연달아 내리는 과정에 과학적 탐색(scientific exploration)이라는 이름을 붙였다.
모델이 이 과정을 배우려면 학습 자료가 필요하다. 그런데 연구자들이 결과를 공유하는 주된 수단인 논문에는 최종 결과만 실린다. 최근 연구들은 LLM이 가상의 연구 환경과 상호작용하게 하거나 추론 과정을 합성해서 연구 궤적을 만들었다. 연구진은 이렇게 만든 궤적이 사람 연구자의 결정 과정을 반영한다고 보기 어렵다고 판단했고, 두 가지 질문에 답하고자 했다. 사람이 내린 연구 결정의 기록을 대규모로 만들 수 있는가. 그 기록에서 배우면 최종 결과에서만 배울 때보다 과학적 탐색 능력이 나아지는가.
연구진이 찾은 자료는 논문과 함께 공개되는 Git 저장소다. 저장소의 커밋 기록에는 논문이 나오기 전 몇 달 동안 연구자가 코드를 어떻게 바꿨는지가 시간 순서대로 남아 있다.
연구 결정의 구조
커밋 하나에는 구현 수정, 학습 설정 변경, 데이터셋 교체 같은 개별 변경이 기록된다. 따라서 커밋 하나만으로 연구 결정을 식별하기는 어렵다. 하지만 여러 커밋과 코드 변경을 함께 검토하면 ‘기존 라우팅 방법의 대안으로 새 라우터를 연구한다’ 같은 연구 결정을 식별할 수 있다. 연구진은 프로젝트의 방법, 실험 설계, 절제 실험을 의미 있게 바꾸는 과학적 변경 하나를 연구 결정 하나로 정의했다. 연구 결정을 시간 순서로 나열한 기록이 연구 궤적이다. 절제 실험(ablation)은 제안한 방법의 구성 요소를 빼거나 바꿔 가며 각 요소가 결과에 얼마나 영향을 주는지 확인하는 실험이다.
커밋과 결정은 일대일로 대응하지 않는다. 같은 과학적 변경을 구현한 커밋 여러 개가 결정 하나에 해당하기도 하고, 커밋 하나가 결정 여러 개를 구현하기도 한다. 서식 정리, 의존성 갱신, 오타 수정, 모델 가중치 파일이나 노트북 메타데이터의 변경은 대개 연구 결정으로 치지 않는다. 연구진은 주석을 작성하는 LLM의 지시문에 버그 수정과 리팩터링을 연구 결정으로 인정하는 조건도 적었다. 그런 변경이 과학적 방법이나 평가를 바꾼다는 근거가 저장소에 있어야 한다는 조건이다.
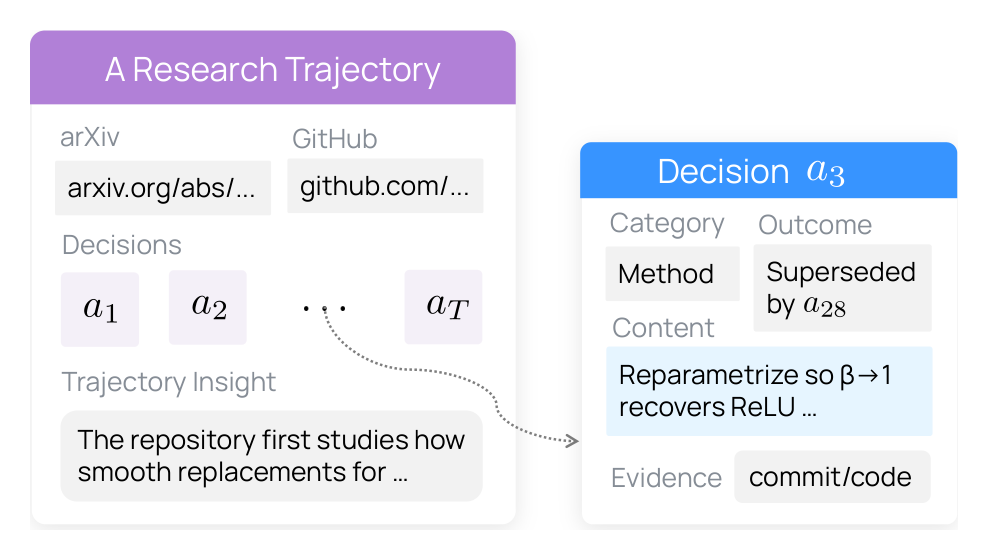 그림 2. 연구 궤적(왼쪽)과 연구 결정(오른쪽)의 구조. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0
각 결정에는 그 내용을 설명하는 글과 근거가 되는 커밋 ID, 코드 조각이 기록된다. 범주와 결과를 나타내는 두 가지 표시도 함께 기록된다. 첫 번째 표시는 범주다.
- 방법(method): 프로젝트에서 제안하는 방법 자체를 만들거나 고친다.
- 실험(experiment): 그 방법을 평가하는 방식을 바꾼다.
- 절제(ablation): 제안한 방법의 구성 요소를 빼거나 바꿨을 때 결과가 얼마나 달라지는지 조사한다.
두 번째 표시는 결과다.
- 유지(retained): 관찰한 기록의 마지막까지 효력이 있다.
- 대체(superseded): 나중에 같은 역할을 하는 다른 결정이 이 결정을 대신했다.
- 폐기(abandoned): 뚜렷한 후속 결정 없이 제거됐다.
커밋 기록에서 결정을 추출하는 절차
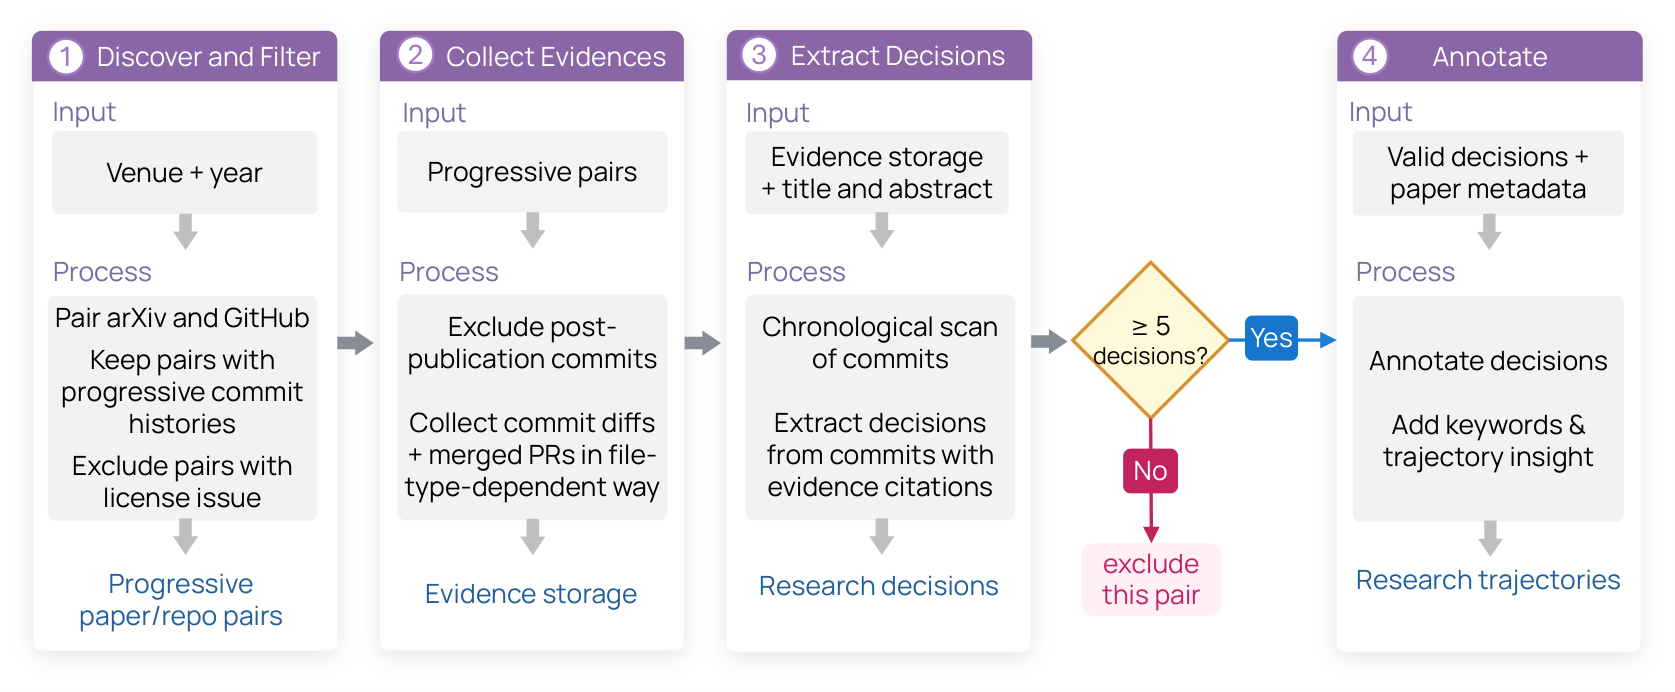 그림 3. GitHub 저장소에서 연구 결정을 추출하는 절차. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0
파이프라인은 네 단계로 진행된다. 첫 단계는 학회와 연도를 받아 논문과 저장소의 짝을 찾고 거르는 일이다. 이어서 커밋의 코드 변경을 근거로 저장하고, 그 근거로부터 결정을 추출한 다음, 결정마다 주석을 단다. 결정 추출과 주석 작성에는 GPT-5.6 Sol을 xhigh 추론 수준으로 썼다.
저장소 고르기
연구진은 Semantic Scholar에서 학회와 연도별 논문 목록을 받아 arXiv 논문과 GitHub 저장소를 짝지었다. 저장소 링크는 arXiv PDF 본문에서만 수집했고, 참고문헌과 부록에만 나오는 링크는 제외했다. 저장소의 README에 논문 제목 전체가 적혀 있어야 후보가 됐다.
그다음에는 논문 공개 전에 연구가 진행된 흔적이 있는 저장소만 골랐다. arXiv 공개일 이전의 커밋이 5개 미만이거나, 첫 커밋부터 공개일까지의 기간이 30일 미만인 저장소는 제외했다. 여러 논문의 코드를 함께 관리하는 것으로 알려진 저장소도 제외했다. 논문 공개 이전의 커밋 메시지 가운데 연구 관련 키워드와 일치하는 메시지가 2개 미만인 저장소, 라이선스가 연구 목적의 코드 사용을 제한하는 저장소 역시 제외했다. 모든 조건을 통과한 짝은 진행형(progressive)으로 분류된다.1
근거 저장
연구진은 진행형 저장소마다 크기가 일정 기준을 초과하는 파일의 내용을 제외하고 부분 복제한 뒤, 기본 브랜치의 커밋을 arXiv 공개 월의 마지막 날까지 시간 순서로 처리했다. 병합된 풀 리퀘스트의 커밋은 병합된 시점의 순서로 기록해서, 별도 브랜치에서 진행한 작업이 기본 브랜치에 반영된 날짜에 나타나도록 했다.
저장 규칙은 파일 종류에 따라 다르다.
- 소스 코드, 설정 파일, 노트북은 처음 추가된 커밋에서 파일 전체를 저장한다. 상한은 파이썬과 노트북이 5만 자, 셸 스크립트와 설정 파일이 2만 자다. 이후 커밋에서는 길이를 제한한 변경분(diff)만 저장한다.
- 노트북은 셀의 종류와 코드 입력만 남긴다. 이렇게 하면 노트북을 다시 실행하기만 해도 출력이 바뀌어 생기는 큰 변경분이 근거에 포함되지 않는다.
- 바이너리 파일, 모델 체크포인트, 로그, 출력 폴더의 파일은 내용을 저장하지 않는다. 대신 파일의 경로, 변경 상태, 크기를 기록하고, 내용을 저장하지 않은 이유도 적는다.
커밋을 결정으로 연결하기
결정을 추출하는 LLM은 저장된 근거와 함께 논문의 제목과 초록만 받는다. LLM은 제목과 초록을 보고 어떤 커밋이 이 논문의 연구와 관련 있는지, 라이브러리 업그레이드의 부산물인지만 판단한다. 지시문은 논문에서 결정이나 동기, 결과를 재구성하지 말라고 명시한다. 커밋은 모델의 문맥 길이와 예상 출력 길이에 맞춰 여러 개씩 한 요청으로 처리되고, LLM은 그 묶음 이전까지 추출된 결정 목록을 함께 받는다. LLM은 커밋마다 다음 여섯 가지 가운데 하나로 역할을 판정한다.
| 판정 | 뜻 | 커밋 수 | 비율 |
|---|---|---|---|
| 무관(irrelevant) | 연구 결정이 없음 | 66,712 | 56.6% |
| 지지(support) | 기존 결정에 근거를 추가 | 17,640 | 15.0% |
| 복수(multiple) | 여러 결정을 한 번에 포함 | 16,544 | 14.0% |
| 수정(revise) | 기존 결정 하나를 변경 | 8,130 | 6.9% |
| 신규(new) | 새 결정을 시작 | 5,130 | 4.4% |
| 불확실(uncertain) | 판단을 보류 | 3,696 | 3.1% |
표의 수치는 최종 데이터셋에 포함된 저장소 599개의 커밋 117,852개를 판정한 결과다. 불확실로 판정된 커밋은 근거와 함께 ‘보류 스레드(open thread)‘로 보관된다. 보류 스레드의 근거는 나중에 기존 결정의 근거로 추가되거나, 다른 커밋과 함께 새 결정의 근거로 쓰인다. 마지막까지 쓰이지 않은 보류 스레드는 기각된다. LLM이 해당 묶음의 커밋을 하나라도 판정하지 않거나 근거가 없는 결정을 응답에 포함하면, 응답 전체를 버리고 입력 분량을 절반으로 줄여 다시 시도한다.2
검증
모든 커밋을 처리한 뒤에는 결정마다 인용한 커밋 ID, 파일 경로, 날짜, 코드 조각을 저장된 근거와 대조한다. 인용한 코드 조각이 저장된 변경분의 일부와 글자 그대로 일치하지 않으면 그 인용은 버려지고, 유효한 인용이 하나도 없는 결정은 기각된다. 결과가 ‘대체’인 결정은 자신을 대신한 결정을 명시해야 하며, 그 후속 결정이 검증을 통과하지 못하면 두 결정의 연결도 삭제된다.
통과한 결정은 처음 인용된 커밋의 날짜 순서로 정렬된다. 검증된 결정이 5개 미만인 저장소는 제외된다. 남은 저장소마다 LLM이 마지막으로 키워드와 궤적 전체에 대한 관찰(trajectory insight)을 작성한다.
데이터셋의 규모
연구진은 다루는 주제가 비교적 다양하고 Semantic Scholar에 arXiv 링크가 많이 색인돼 있다는 이유로 NeurIPS를 골랐다. 단계마다 남은 논문 수는 다음과 같다.
| 단계 | 2022 | 2023 | 2024 | 2025 | 합계 |
|---|---|---|---|---|---|
| 색인된 논문 | 2,790 | 3,587 | 4,544 | 4,313 | 15,234 |
| 저장소와 짝지은 논문 | 845 | 1,198 | 1,594 | 1,400 | 5,037 |
| 진행형 짝 | 111 | 168 | 229 | 169 | 677 |
| 주석까지 마친 짝 | 90 | 150 | 204 | 155 | 599 |
| 연구 결정 | 2,176 | 3,593 | 5,260 | 2,242 | 13,271 |
저장소와 짝지은 논문 가운데 13%가 진행형 조건을 통과했다. 처음 색인한 논문 전체를 기준으로 하면 약 4%의 논문에서 연구 결정 궤적을 얻은 셈이다. 결정 13,271개의 범주는 다음과 같다.
| 범주 | 결정 수 | 비율 |
|---|---|---|
| 방법 | 5,226 | 39% |
| 실험 | 6,826 | 51% |
| 절제 | 1,219 | 9% |
결과 표시를 기준으로 하면 유지가 76.3%, 대체가 12.1%, 폐기가 11.5%다. 궤적 하나에 포함된 결정은 5개에서 205개이고 중앙값은 15개다. 궤적의 35%는 결정이 20개 이상이다. 결정 하나에는 평균 7.5개의 근거가 인용돼 있다.
한 프로젝트의 궤적
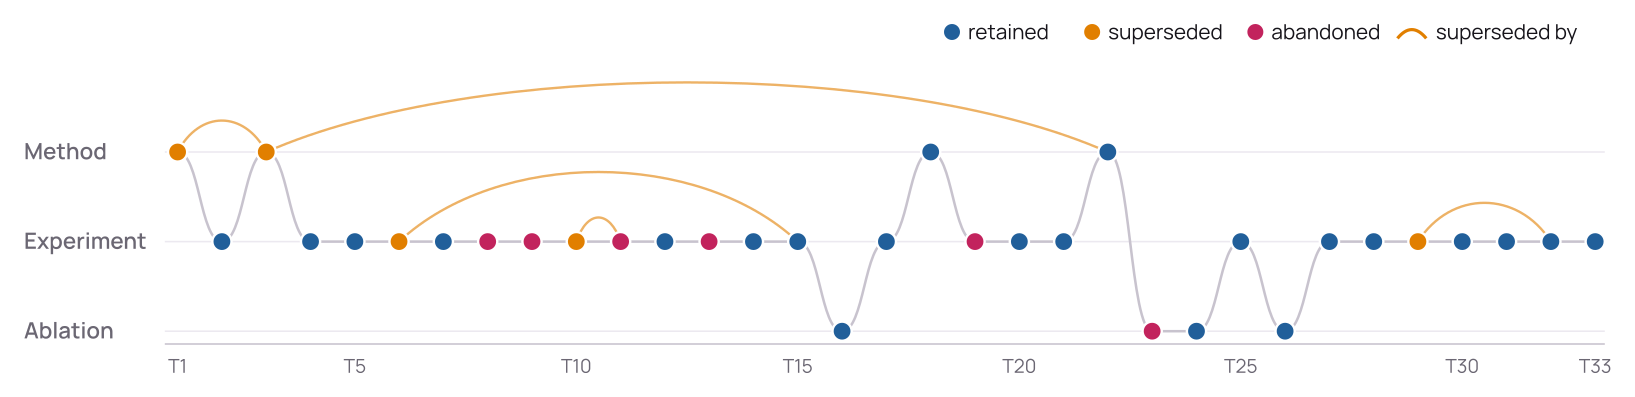 그림 4. Hu et al.(2026) 저장소의 연구 궤적. 주황색 호는 대체된 결정과 그 결정을 대신한 결정을 잇는다. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0
그림 4는 Hu et al.(2026)의 논문 「Curvature Tuning: Provable Training-Free Model Steering From a Single Parameter」의 저장소에서 추출한 결정 33개를 보여 준다. 이 논문은 활성화 함수의 곡률을 매개변수 하나로 조절해서, 사전학습된 모델을 추가 학습 없이 조정하는 방법을 제안한다. 결정 대부분은 실험 결정이고, 방법 결정 4개와 절제 실험 결정 4개가 그 중간중간에 내려졌다.
부록의 상세 그림은 이 가운데 23개 결정의 내용을 보여 준다. 방법 결정만 보면 핵심 방법이 두 번 교체됐다. 결정마다 저장소에 근거가 처음 나타난 날짜를 기준으로 하면, 2024년 9월 6일 ReLU를 대신할 SmoothReLU가 도입됐다. 나흘 뒤에는 BetaReLU로 교체됐는데, BetaReLU는 매개변수 β가 1에 가까워지면 ReLU와 같아지도록 다시 정의한 함수다. 11월 25일에는 BetaReLU와 softplus 형태의 함수를 가중치 c로 결합한 BetaAgg로 다시 교체됐고, c의 기본값은 0.5로 정해졌다.
실험 결정도 여러 번 바뀌었다. 선형 프로빙은 CIFAR-100으로 학습한 모델을 CIFAR-10에 맞추는 실험이다. 처음에는 Adam으로 50 에폭 학습했지만, 나중에는 고정한 백본의 특징을 저장해 두고 scikit-learn의 L2 정규화 로지스틱 회귀로 학습하는 방식으로 대체됐다. 평가 대상은 처음에 CIFAR, MNIST, ImageNet 분류기였다. 이후 적대적 공격과 손상 이미지에 대한 강건성 평가가 추가됐고, VOC 분할과 ResNet-18에서 ResNet-152까지의 모델도 평가 대상에 포함됐다. VGG-19 평가는 2025년 2월 4일 Swin 트랜스포머 평가로 대체됐다. 폐기된 결정으로는 학습 품질이 서로 다른 모델에서도 방법이 통하는지 비교하는 절제 실험이 있고, 클래스마다 가우시안 혼합 잡음을 넣은 데이터로 하는 실험도 있다.
여러 프로젝트에서 반복되는 연구 패턴
궤적은 프로젝트마다 다르지만, 연구진은 여러 프로젝트에서 되풀이되는 결정 구조를 발견했다. 연구 패턴 하나는 앞선 결정들로 정해지는 프로젝트 상태와 그 상태에서 이어지는 연구 행동의 순서로 구성된다. GPT-6 Astra가 궤적에서 추출한 패턴 네 가지는 다음과 같다.
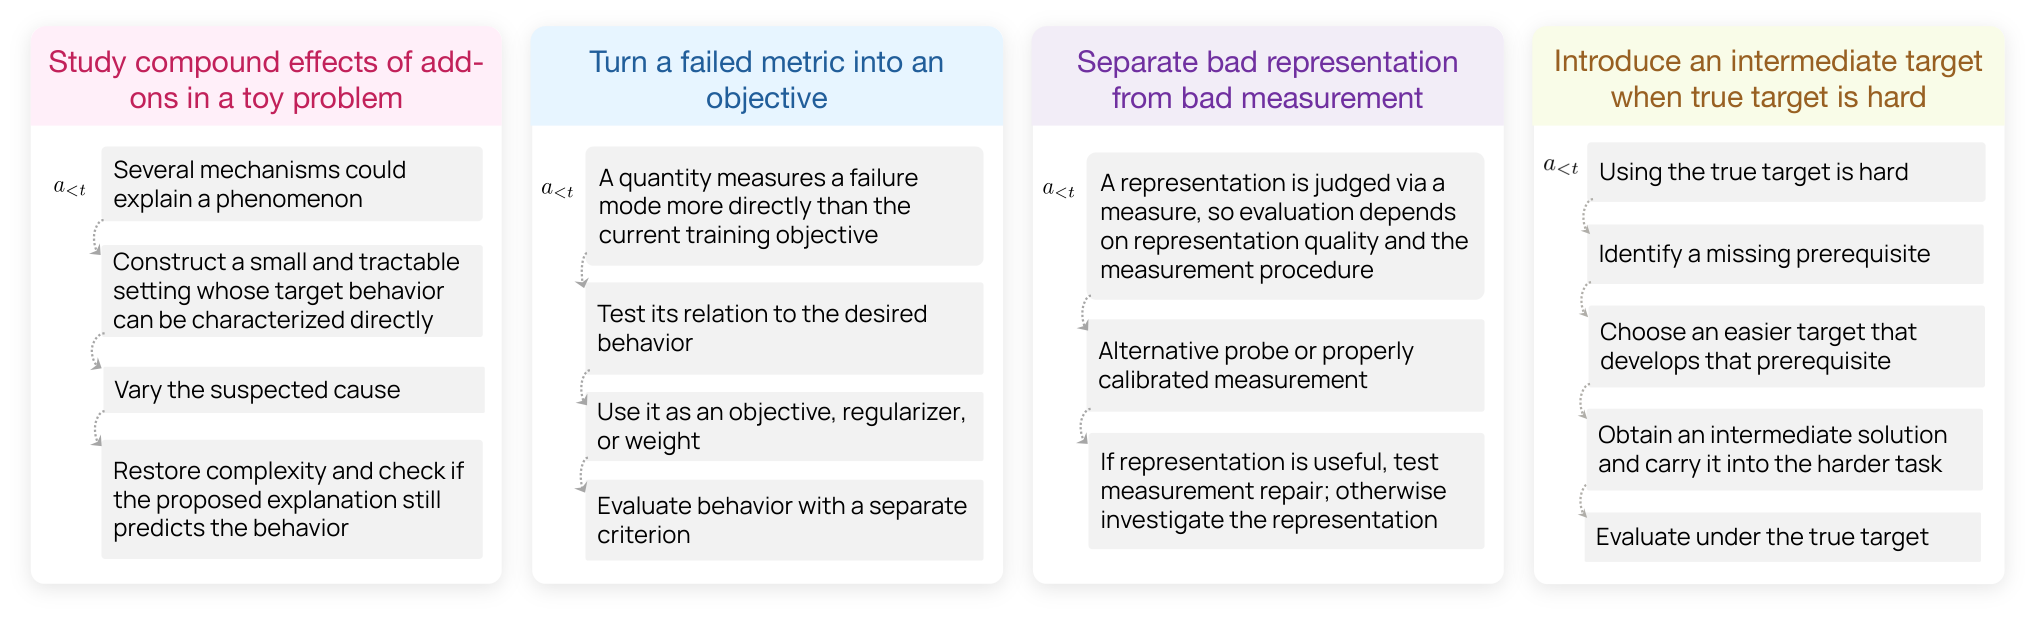 그림 5. GPT-6 Astra가 추출한, 여러 프로젝트에 공통으로 나타나는 연구 패턴. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0
- 단순화한 장난감 문제(toy problem)에서 추가 요소들의 복합 효과를 연구한다. 어떤 현상을 설명할 수 있는 메커니즘이 여러 가지일 때 쓴다. 목표 행동을 직접 분석할 수 있는 작고 다루기 쉬운 설정을 만들고, 원인으로 의심되는 요소를 바꿔 본다. 그다음 복잡도를 원래 수준으로 복원해도 그 설명이 행동을 예측하는지 확인한다.
- 실패한 지표를 목적 함수로 바꾼다. 어떤 수치가 현재의 학습 목적 함수보다 실패 양상을 더 직접 측정할 때 쓴다. 그 수치와 원하는 행동의 관계를 먼저 시험하고, 그 수치를 목적 함수나 정규화 항이나 가중치로 쓴다. 마지막으로 별도의 기준으로 행동을 평가한다.
- 표현(representation)의 문제와 측정의 문제를 구분한다. 어떤 표현을 측정 도구로 평가하고 있어서 평가 결과가 표현의 품질과 측정 절차 모두의 영향을 받을 때 쓴다. 다른 프로브나 보정된 측정 방법으로 다시 평가해서, 표현이 쓸모 있다면 측정을 고쳐 보고 그렇지 않다면 표현을 조사한다.
- 실제 목표가 어려우면 중간 목표를 도입한다. 실제 목표를 바로 쓰기 어려울 때 쓴다. 갖춰지지 않은 선행 조건을 찾고, 그 조건을 갖추게 하는 쉬운 목표를 고른다. 쉬운 목표에서 얻은 중간 해를 어려운 과제에 적용하고, 실제 목표로 평가한다.
연구진은 이 패턴들의 공통점을 두 가지로 정리했다. 첫째, 패턴은 프로젝트의 세부 내용 대신 추상적인 프로젝트 상태를 기준으로 결정을 정리한다. 다른 프로젝트에도 적용할 수 있으므로, 언어 모델이 다음 결정을 고를 때 참고하는 지침이나 스킬로 제공할 수 있다. 둘째, 여러 패턴은 방법을 무작정 바꾸기 전에 원인부터 진단하는 순서로 되어 있다. 첫 번째 패턴은 여러 메커니즘이 함께 작용해 현상이 생길 때 작은 문제를 만들어 원인을 하나씩 확인하고, 세 번째 패턴은 표현의 한계와 평가의 한계를 구분한다.
다음 연구 결정을 예측하는 과제
연구진은 이 데이터셋의 쓰임새를 다음 연구 결정 예측 과제로 시험했다. 지시 프롬프트와 지금까지 사람이 내린 결정들을 입력으로 받아, 모델이 유망한 다음 결정을 제안하는 과제다. 연구진이 든 제안의 예는 ‘라우팅 목적 함수에 부하 분산 손실을 추가한다’, ‘모델을 10배 깊게 만든 뒤 성능을 평가한다’, ‘손실 지형을 시각화한다’ 같은 것이다.
임의의 연구 결정이 얼마나 효과적인지 평가하는 방법은 아직 정해져 있지 않다. 그래서 연구진은 학습에 쓰지 않은 실제 연구 궤적을 사용자 시뮬레이션으로 쓰고, 모델이 제안한 다음 결정이 사람이 실제로 내린 다음 결정과 전략적으로 얼마나 비슷한지를 측정했다. 판정은 LLM이 맡는다. 판정 모델은 아래 세 항목을 각각 0점, 1점, 2점으로 채점한다.
- 구성 요소(component) 일치: 프로젝트의 어느 부분을 다루는가. 기준선, 평가 데이터셋, 모델 구조 등이 해당한다.
- 조작(operation) 일치: 어떤 과학적 행동인가. 도입, 확장, 교체, 제거 등이 해당한다.
- 세부 사항 일치: 구체적인 선택이 같은가.
점수는 구성 요소 점수와 조작 점수의 합이라서 0점에서 4점 사이다. 세부 사항 점수는 합산하지 않는다. 연구진은 ‘배치 크기를 16으로 늘린다’와 ‘배치 크기를 32로 늘린다’를 전략적으로 같은 결정으로 보았다. 예를 들어 실제 결정이 ‘옵티마이저를 AdamW로 바꾼다’일 때 ‘학습 옵티마이저를 AdamW로 전환한다’는 제안은 4점이고, ‘토크나이저를 BPE로 바꾼다’는 제안은 구성 요소가 다르고 조작만 같아서 2점이다. 판정 모델로는 GPT-5.6 Sol과 Opus 5를 썼다.3
예측의 난이도는 앞선 결정을 몇 개 보여 주느냐에 따라 달라진다. Gemini 3.1 Flash-Lite로 측정했을 때, 앞선 결정을 하나도 제공하지 않으면 점수는 약 0.65점이었다. 앞선 결정을 3개에서 5개 제공하면 약 1.25점이 됐지만, 그보다 더 많이 제공해도 점수는 오르지 않았다. 연구진은 이 결과를, 프로젝트 후반처럼 결정 기록이 길어지면 다음 결정의 불확실성이 줄어드는 현상으로 해석했다. 연구진은 기록이 짧아 다음 결정이 가장 불확실한 프로젝트 초기에 집중했고, 앞선 결정이 1개, 2개, 3개인 경우만 평가했다.
시험 시점의 활용: 예시와 스킬
첫 번째 활용 방식은 모델을 학습시키지 않고 프롬프트에 궤적 정보를 넣는 것이다. 연구진은 학습용 저장소 19개의 궤적을 활용하고, 다른 저장소 134개로 평가했다. 다음 결정을 예측하는 모델은 Gemini 3.1 Flash-Lite이고, 비교한 방법은 일곱 가지다. 여기서 스킬은 에이전트가 작업할 때 참고하도록 정리한 지침 문서를 말한다.
- 기본: 모델에 바로 묻는다.
- 예시 전부: 학습용 궤적 전부를 예시로 넣는다.
- 무작위 예시 2개: 학습용 궤적 2개를 무작위로 골라 넣는다.
- 검색한 예시 2개: 가장 관련 있는 학습용 궤적 2개를 골라 넣는다.
- 스킬: Opus 5가 학습용 궤적으로 정리한 스킬을 넣는다.
- 순서를 섞은 스킬: 프로젝트마다 결정 순서를 무작위로 섞은 궤적으로 같은 방식의 스킬을 정리해 넣는다. 결정의 순서가 중요한지 확인하기 위한 비교군이다.
- 최종 논문 스킬: 최종 논문의 내용만으로 스킬을 정리해 넣는다. 중간 연구 결정이 중요한지 확인하기 위한 비교군이다.
결과는 다음과 같다. GPT-5.6 Sol이 판정했고, 평가 궤적마다 세 번 실행한 평균이다.
| 방법 | 앞선 결정 1개 | 2개 | 3개 |
|---|---|---|---|
| 기본 | 1.256 | 1.289 | 1.445 |
| 예시 전부 | 1.328 | 1.316 | 1.373 |
| 무작위 예시 2개 | 1.241 | 1.216 | 1.274 |
| 검색한 예시 2개 | 1.361 | 1.460 | 1.498 |
| 순서를 섞은 스킬 | 1.363 | 1.308 | 1.391 |
| 최종 논문 스킬 | 1.500 | 1.231 | 1.271 |
| 스킬 | 1.697 | 1.557 | 1.607 |
세 조건의 평균으로 비교하면 검색한 예시 2개는 무작위 예시 2개보다 0.196점, 예시 전부보다 0.101점 높았다. 연구진은 관련 있는 예시는 예측에 도움이 되지만, 관련 없는 예시를 함께 넣으면 성능이 떨어진다고 해석했다. 스킬을 제공했을 때의 평균 점수는 1.62점이었고, 세 조건 모두에서 가장 높았다. 평균 점수로 비교하면 검색한 예시를 제공했을 때보다 0.181점 높았고, 최종 논문 스킬보다 0.286점, 기본 방법보다 0.290점 높았다. 순서를 섞은 스킬의 평균은 1.35점이었다. 연구진은 이 결과를 근거로, 결정 궤적에서 배우는 것이 최종 연구 결과에서만 배우는 것보다 과학적 탐색에 더 도움이 된다고 결론지었다.4
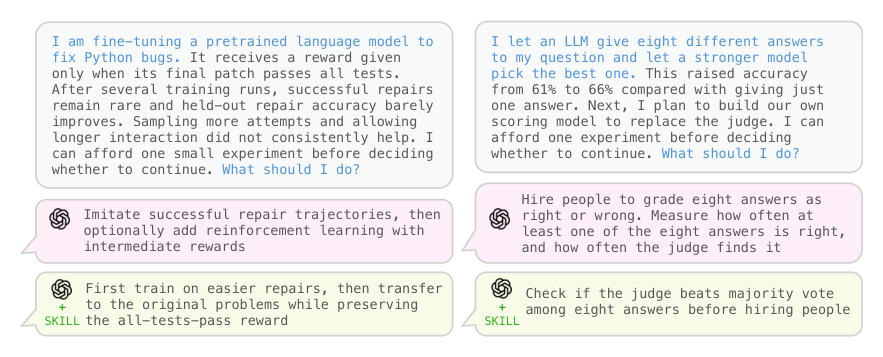 그림 9. 연구자가 GPT-5.6 Sol(high 추론)에게 연구 질문을 하는 사용자 시뮬레이션. 분홍색은 스킬 없이 받은 답, 연두색은 스킬과 함께 받은 답이다. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0
연구진은 스킬이 실제 조언을 어떻게 바꾸는지도 사용자 시뮬레이션으로 보여 줬다. 연구자가 GPT-5.6 Sol에게 상황을 설명하고 “작은 실험 하나를 할 여유가 있는데 무엇을 해야 하는가"라고 묻는 형식이다.
- 연구자는 파이썬 버그를 고치도록 사전학습 언어 모델을 미세 조정하고 있다. 최종 패치가 모든 테스트를 통과할 때만 보상을 주는데, 여러 번 학습해도 수리에 성공하는 경우가 드물다. 시도를 더 많이 샘플링하거나 상호작용 시간을 늘려도 일관되게 좋아지지 않았다. 스킬이 없을 때 Sol은 성공한 수리 궤적을 모방 학습하고 필요하면 중간 보상을 주는 강화학습을 추가하라고 답했다. 스킬이 있을 때는 먼저 쉬운 수리 문제로 학습한 다음, 모든 테스트 통과 보상은 그대로 유지한 채 원래 문제로 전이하라고 답했다.
- 연구자는 LLM에게 답을 8개 내게 하고 더 강한 모델에게 가장 좋은 답을 고르게 해서 정확도를 61%에서 66%로 올렸다. 다음 계획은 판정 모델을 직접 만든 채점 모델로 바꾸는 것이다. 스킬이 없을 때 Sol은 사람을 고용해 답 8개의 정답 여부를 채점하고, 8개 가운데 하나라도 맞는 경우와 판정 모델이 그 답을 찾아내는 경우가 얼마나 되는지 측정하라고 답했다. 스킬이 있을 때는 사람을 고용하기 전에 판정 모델이 답 8개의 다수결보다 나은지부터 확인하라고 답했다.
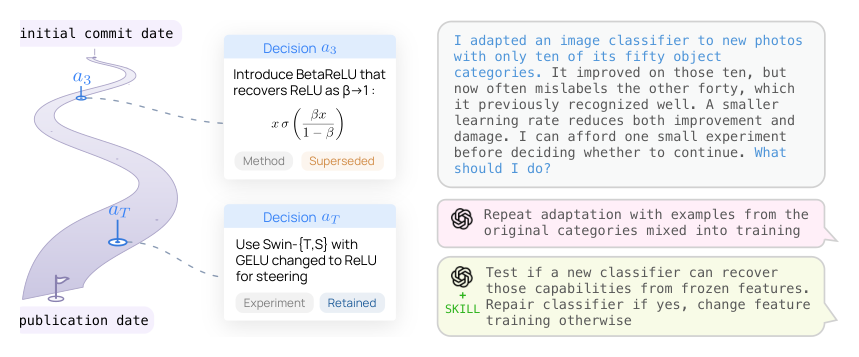
커버 그림의 예시도 같은 형식이다. 연구자는 50개 클래스를 분류하는 이미지 분류기를 그중 10개 클래스의 새 사진에 적응시켰다. 그 10개 클래스의 성능은 좋아졌지만 분류기는 나머지 40개 클래스를 자주 틀리게 됐고, 학습률을 낮추면 개선과 손상이 함께 줄었다. 스킬이 없을 때 Sol은 원래 클래스의 예시를 섞어 적응을 다시 하라고 했다. 스킬이 있을 때 Sol은 특징을 고정한 채 새 분류기로 나머지 40개 클래스를 분류하는 능력을 복원할 수 있는지 시험하라고 했다. 능력이 복원되면 분류기를 고치고, 복원되지 않으면 특징을 학습하는 방식을 바꾸라는 조언이다. 연구진은 스킬을 받은 Sol이 변경 범위가 더 제한적이고 결과를 해석하기 쉬운 조치를 제안했다고 정리했다. 해결책을 바로 시도하라는 조언이, 어느 구성 요소를 고쳐야 하는지부터 판별하라는 조언으로 바뀌었다는 것이다.
학습 시점의 활용: 지도 학습과 강화학습
두 번째 활용 방식은 궤적으로 모델을 직접 학습시키는 것이다. 연구진은 Qwen3-8B에 두 단계 학습을 적용했다. 먼저 지시문과 앞선 결정들을 입력으로, 실제 다음 결정을 정답으로 삼아 지도 미세 조정(SFT)을 했다. 이 목적 함수로 학습한 모델은 지시가 주어졌을 때 사람의 연구 프로젝트가 전개될 수 있는 여러 방식의 분포를 배운다.
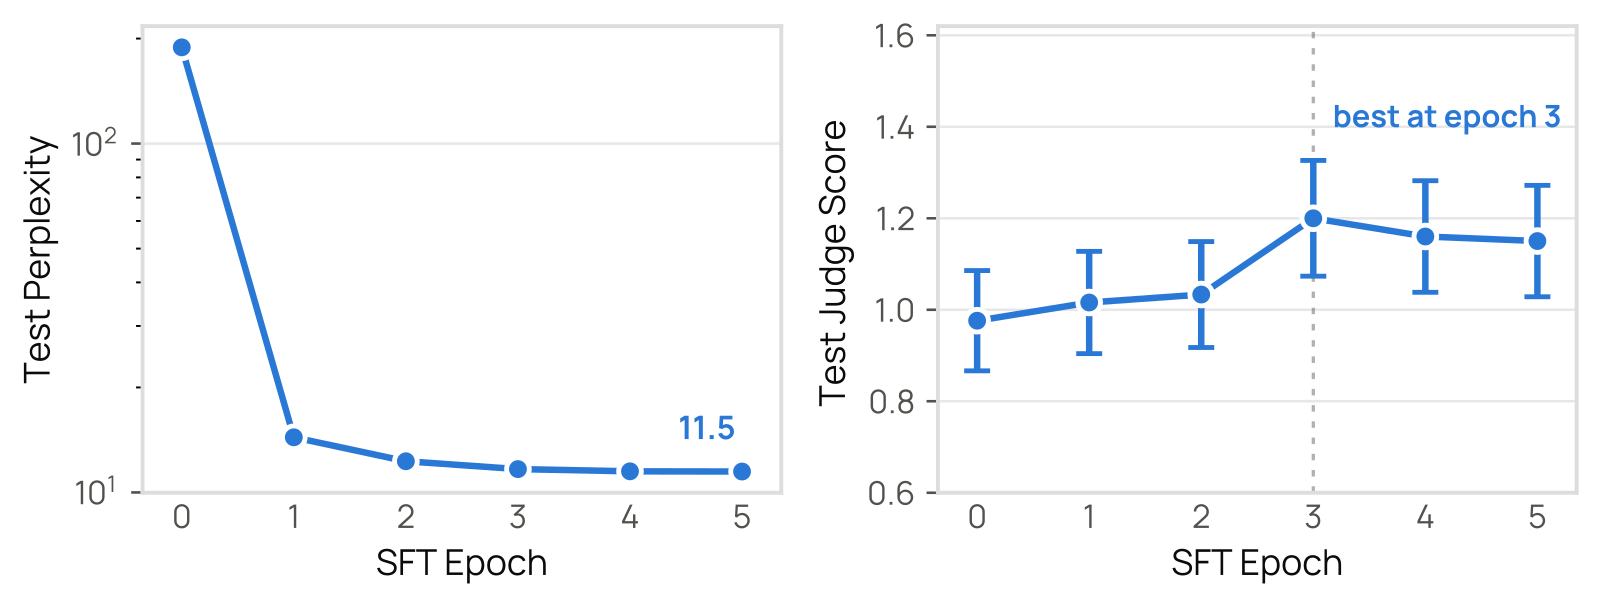 그림 10의 왼쪽과 가운데. 지도 학습 동안의 시험 퍼플렉시티(왼쪽)와 판정 점수(오른쪽). 막대는 95% 신뢰구간이다. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0
그런데 지도 학습 동안 두 지표의 변화가 일치하지 않았다. 퍼플렉시티는 모델이 실제 정답 문장을 얼마나 그럴듯하게 여기는지를 나타내는 지표로, 낮을수록 좋다. 시험 데이터의 퍼플렉시티는 계속 줄어 5 에폭에서 11.5가 됐다. 반면 모델이 확률이 가장 높은 답을 고르도록 했을 때, 판정 점수는 3 에폭에서 약 1.20점으로 가장 높았고 그 이후에는 오르지 않았다. 연구진은 성능을 더 올리려면 생성 품질 자체를 최적화해야 한다고 판단했다.
그래서 3 에폭 체크포인트를 고정된 참조 정책으로 삼아 강화학습을 진행했다. 방법은 GRPO를 변형한 Dr. GRPO다. 같은 입력에 대해 결정 후보 8개를 생성하고, 판정 모델이 매긴 구성 요소 점수와 조작 점수의 합을 보상으로 준다. 모델이 생성한 답이 지정한 형식에 맞지 않으면 0점을 준다. 같은 입력에서 나온 후보끼리 보상을 비교해서, 상대적으로 점수가 높은 후보가 더 자주 생성되도록 모델을 갱신하는 방식이다.5
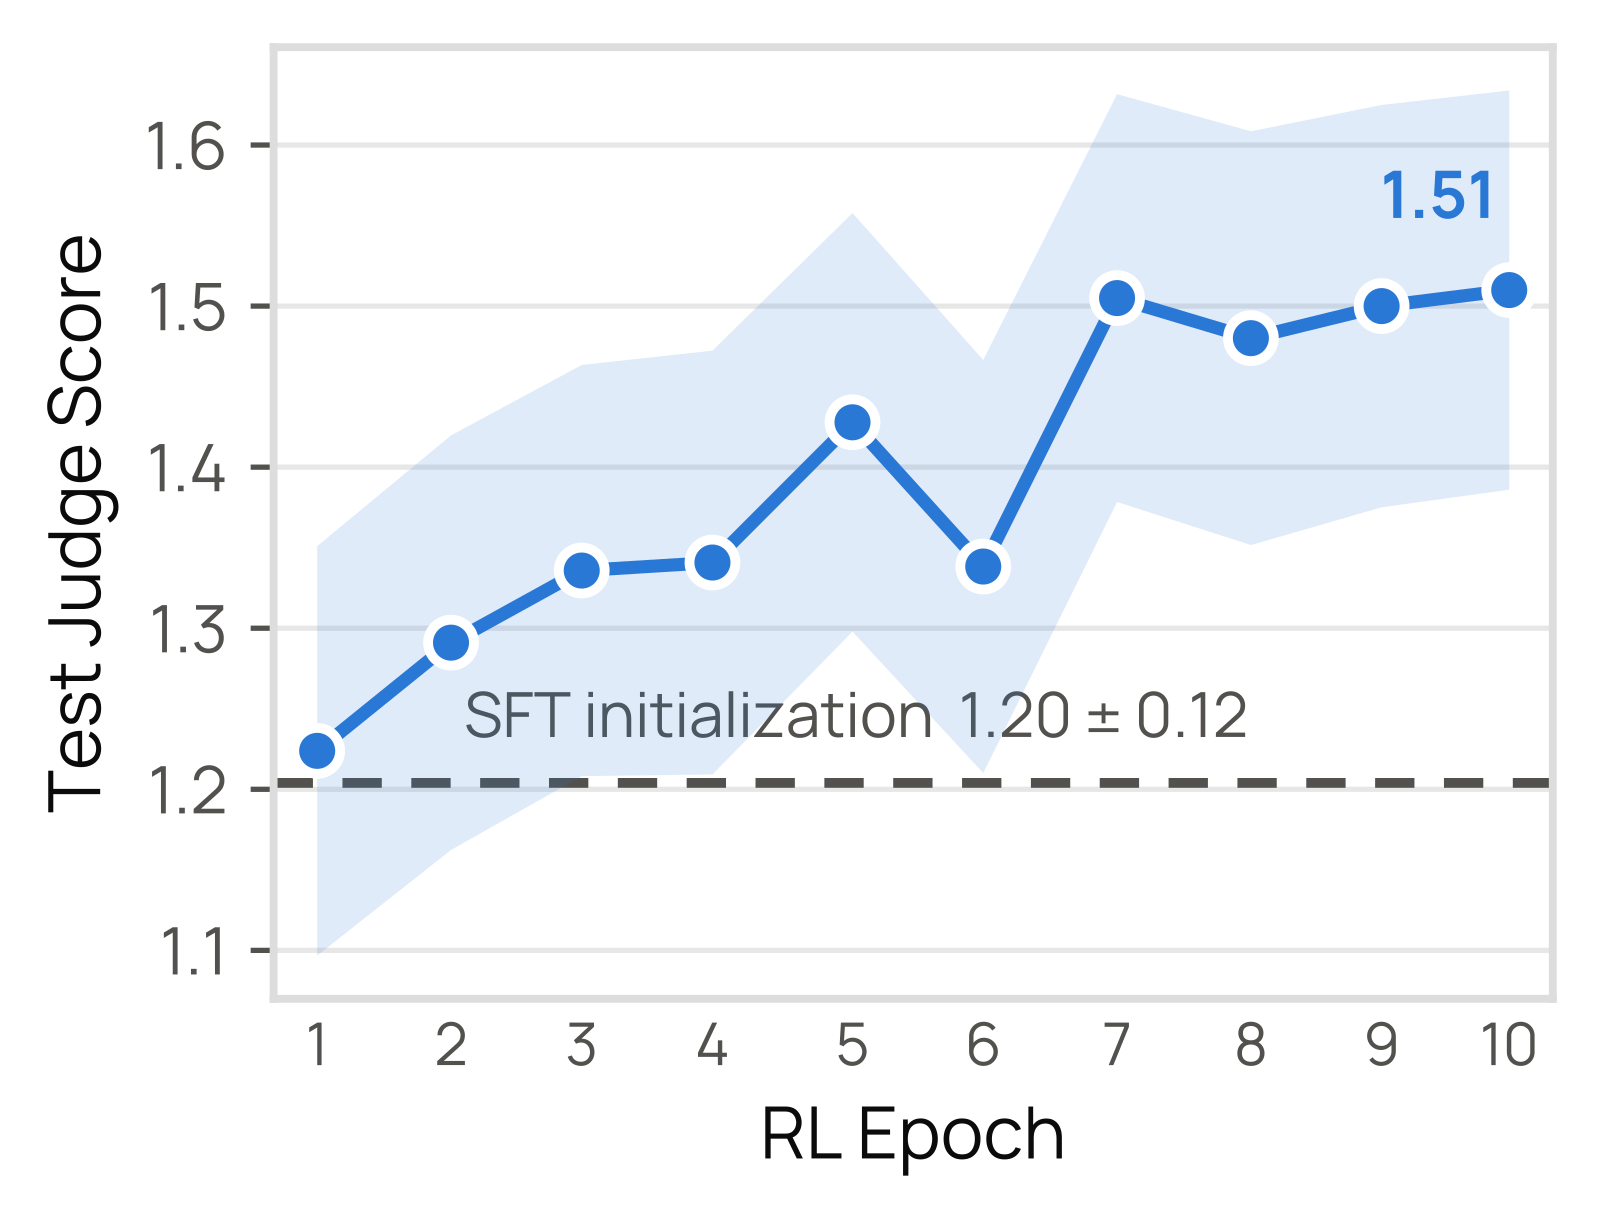 그림 10의 오른쪽. 강화학습 동안의 판정 점수. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0
강화학습 뒤 판정 점수는 1.20점에서 1.51점으로 올랐다. 학습하지 않은 Qwen3-8B의 점수는 1.025점이었다. Opus 5로 판정해도 경향은 같았다. 기본 모델의 점수는 1.219점이었고, 지도 학습을 3 에폭 진행한 모델은 1.333점, 강화학습을 10 에폭 진행한 모델은 1.637점을 받았다.
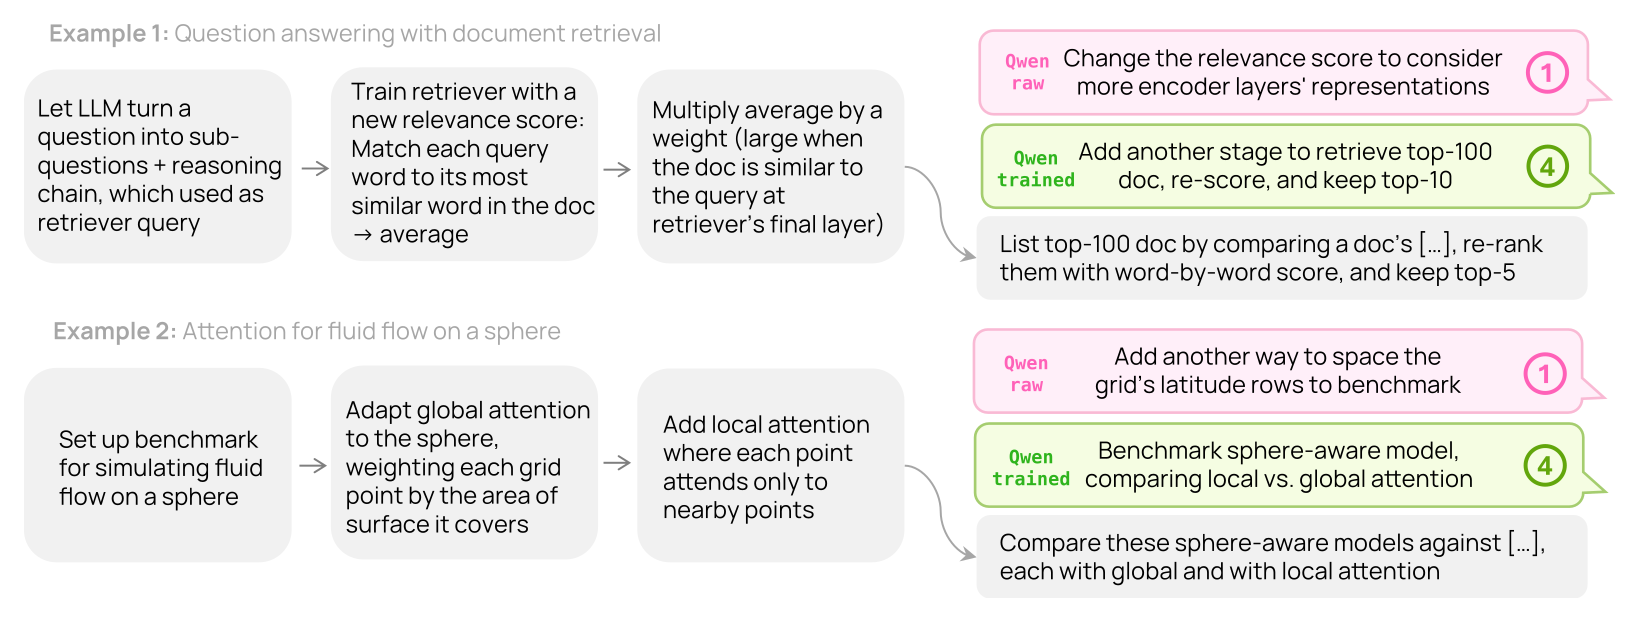 그림 11. 학습 전후 Qwen3-8B가 제안한 다음 결정. 회색 상자에는 실제 결정에 주석을 단 내용이 있고, 동그라미 속 숫자는 판정 점수다. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0
그림 11은 학습 전후 모델이 제안한 다음 결정을 비교한다. 문서 검색 기반 질의응답 프로젝트의 앞선 결정은 세 가지였다. 첫째, 질문을 하위 질문과 추론 과정으로 바꿔 검색어로 썼다. 둘째, 질문의 단어마다 문서에서 가장 비슷한 단어를 찾아 그 유사도를 평균하는 새 관련도 점수를 만들고, 이 점수로 검색기를 학습했다. 셋째, 검색기의 최종 층에서 문서와 질문이 비슷할수록 커지는 가중치를 그 평균에 곱했다. 실제 다음 결정은 상위 문서 100개를 고른 뒤 단어 단위 점수로 다시 순위를 매겨 상위 5개를 남기는 것이었다. 학습 전 모델은 관련도 점수가 인코더의 더 많은 층을 고려하도록 바꾸자고 제안해 1점을 받았고, 학습 후 모델은 상위 100개를 검색해 다시 채점한 뒤 상위 10개를 남기는 단계를 추가하자고 제안해 4점을 받았다.
한계와 후속 과제
연구진이 밝힌 후속 과제는 두 가지다. 이번 데이터셋은 인공지능 학회의 논문만 다뤘지만, 생물학이나 물리학 같은 다른 과학 분야에서도 코드 기록이 관리된다. 또 Git 커밋이 있는 프로젝트만 포함했으므로, 연구 탐색의 패턴을 보여 주는 다른 플랫폼의 연구 산출물도 활용할 수 있다.6
가장 흥미로운 지점
세 조건의 평균만으로는 드러나지 않는 숫자가 결과 표에 있다. 최종 논문 스킬은 앞선 결정이 1개일 때 1.500점으로 일곱 방법 가운데 두 번째로 높았다. 그런데 앞선 결정이 2개일 때는 1.231점, 3개일 때는 1.271점으로 떨어졌다. 같은 조건에서 기본 방법은 각각 1.289점과 1.445점이었다. 논문은 이 변화를 따로 해석하지 않았다.7 내 생각에 최종 논문은 프로젝트가 끝난 시점의 모습을 설명하는 문서다. 첫 결정 하나만 아는 시점에서는 이런 연구가 대개 어떤 결과로 끝나는지 아는 것이 도움이 되는 듯하다. 그러나 연구자가 결정을 두세 개 내린 뒤 다음 단계를 고를 때는 최종 결과에 대한 지식이 별 도움이 되지 않는 것 같다. 순서를 섞은 궤적으로 정리한 스킬도 이 해석과 부합한다. 그 스킬은 같은 결정들로 만들었는데도 평균 1.35점을 받아 기본 방법과 비슷했다. 다음 결정을 예측하는 데에는 어떤 결정을 내렸는지보다 어떤 순서로 내렸는지가 더 쓸모 있었다고 이해했다.
그림 9의 조언 변화도 같은 맥락으로 읽었다. 스킬 없이 Sol이 제안한 것은 해결책이었다. 스킬을 받은 Sol은 어느 구성 요소가 문제를 일으키는지부터 확인하는 실험을 제안했다. 논문에는 대개 그런 확인 실험의 결과만 실리고, 그 실험을 언제 왜 했는지는 커밋 기록에 남는다. 나도 문제가 생기면 해결 방법부터 생각하는 편이라, 연구자들이 남긴 결정의 순서로 그런 습관을 고칠 수 있다는 점이 반가우면서도 조금 뜨끔했다.
출처
Xuchen Gong, Shane Gu, Haokun Liu, Dixi Yao, Chenhao Tan, Tian Li (University of Chicago), “Learning Scientific Exploration from Human Research Decision Trajectories”, arXiv:2610.07184, 2026년 10월 5일 v1 공개. 정리 기준은 v1이다.
원문: https://arxiv.org/abs/2610.07184
코드: https://github.com/xuchengong/researchtrails
데이터와 모델: https://huggingface.co/researchtrails
프로젝트 페이지와 궤적 시각화 도구: https://researchtrails.org
그림은 모두 원 논문에서 가져왔고 그림 번호도 원 논문의 번호를 따랐다. 논문의 라이선스는 CC BY 4.0이다. SVG로 제공된 그림은 PNG로 변환했고, 일부 그림은 여백을 정리했다.
포크한 저장소에는 저자가 작성하지 않은 커밋도 포함되므로, 그 커밋을 논문의 연구 기록으로 세면 안 된다. 그런데 연구가 끝난 뒤 개인 저장소를 연구실 조직 계정으로 포크한 경우도 있다. 이때는 포크 생성 시각이 모든 연구 커밋보다 늦어서, 생성 시각 이후의 커밋만 세면 연구 기록 전체가 제외된다. 연구진은 원본 저장소의 README에도 논문 제목 전체가 있으면 원본을 저자들의 이전 저장소로 보고 기록 전체를 썼고, 그렇지 않으면 포크 생성 시각 이후의 커밋만 셌다. ↩︎
LLM 비용은 대부분 입력 토큰에서 나왔고, 입력 토큰과 출력 토큰의 비율은 16 대 1이다. 비용의 99%는 저장소 근거를 전달하는 유일한 단계인 커밋 판정 단계에서 발생했다. NeurIPS 2022년에서 2025년 논문을 처리하는 동안 이 단계는 8,543번 호출됐고, 호출당 평균 입력은 143,042토큰, 출력은 9,175토큰이었다. ↩︎
연구진은 평가 표본 100개 각각에 대해 Opus 5로 세 종류의 결정을 만들어 판정 모델을 검증했다. 실제 결정을 다른 말로 표현한 것, 실제 결정과 관련은 있지만 같지 않은 결정, 무관한 결정이다. 목표 점수는 각각 4점, 2점, 0점이다. GPT-5.6 Sol은 이 세 종류에 4.00점, 2.39점, 0.10점을 줬고, Opus 5는 4.00점, 2.68점, 0.12점을 줬다. 같은 입력을 반복 판정한 점수의 표본 표준편차는 0.04 이하였고, 반복 판정 사이의 일치도를 나타내는 Fleiss 카파는 GPT-5.6 Sol이 0.719, Opus 5가 0.691이었다. ↩︎
Opus 5가 판정한 결과도 순위가 같다. 스킬이 세 조건 모두에서 가장 높았고(1.893점, 1.781점, 1.813점), 검색한 예시 2개는 모든 조건에서 무작위 예시 2개보다 높았다. ↩︎
학습 데이터는 궤적 125개에서 앞선 결정이 1개, 2개, 3개인 경우를 추출한 표본 375개다. LoRA(랭크 8, 알파 16)로 학습했고, 지도 학습은 배치 크기 16으로 5 에폭, 강화학습은 배치 크기 8로 10 에폭을 진행했다. 강화학습 중 보상을 매기는 판정 모델은 medium 추론 수준의 GPT-5.6 Sol이다. ↩︎
이 과제의 점수는 모델이 제안한 결정이 사람이 실제로 내린 다음 결정과 얼마나 비슷한지를 측정한다. 사람이 내린 결정에는 나중에 폐기된 결정도 포함되며, 데이터셋 전체에서 그 비율은 11.5%다. 커밋을 결정으로 바꾸는 주석은 GPT-5.6 Sol이 작성했고, 논문은 이 주석을 사람이 검토한 결과를 보고하지 않았다. 시험 시점 실험의 스킬은 학습용 저장소 19개로 정리됐다. 사람의 결정을 잘 모방하는 조수가 연구도 잘 돕는지는 이 논문만으로 알 수 없다. ↩︎
Opus 5로 판정한 결과에서도 같은 양상이 나온다. 최종 논문 스킬은 앞선 결정이 1개, 2개, 3개일 때 1.764점, 1.490점, 1.445점이었고, 기본 방법은 1.473점, 1.555점, 1.619점이었다. ↩︎