3줄 요약
- 미국의 AI 스타트업 Reflection AI가 2026년 10월 5일 첫 오픈웨이트 모델 Beam을 발표했다.1 Beam은 총 파라미터 5,010억 개 가운데 토큰마다 230억 개만 활성화하는 희소 MoE(Mixture-of-Experts) 모델이다. 코딩과 추론, 에이전트 작업을 목표로 학습했다. Reflection은 지금 일부 사용자에게만 Beam을 미리 제공한다. 가중치는 이달 중 Apache 2.0 라이선스로 공개하고, 기술 보고서도 함께 낼 예정이다.
- Reflection은 Beam의 코딩과 에이전트 성능이 GLM 5.2와 비슷하고 Qwen 3.8 Max보다 조금 낮다고 밝혔다. Beam은 Kimi K3 같은 최상위 오픈 모델보다는 점수가 낮다. 대신 Reflection은 Beam이 추론 벤치마크에서 GLM 5.2와 비슷한 점수를 내면서도, 답을 생성하는 데 드는 연산은 3~4배 적다는 점을 강점으로 꼽았다.
- Reflection은 강화학습에 NVIDIA GB300 GPU 10,500개를 4주 동안 투입해 롤아웃을 1억 개 이상 생성했고, 학습 환경 약 100만 개를 직접 구축했다. 학습 방법도 상세히 공개했다. 하루 전 버전의 모델이 만든 데이터로도 안정적으로 학습하는 비동기 강화학습, 토큰 사용을 줄이는 길이 페널티, 사전학습 데이터 정제, 안전 정렬 방식이다.
Beam의 사양
| 항목 | 내용 |
|---|---|
| 구조 | 희소 MoE, 레이어 52개 |
| 총 파라미터 | 501B |
| 활성 파라미터 | 23B |
| 입력 | 텍스트 전용 |
| 컨텍스트 길이 | 100만 토큰(미드트레이닝에서 확장) |
| 사전학습 | 23.8조 토큰, GB300 NVL72 GPU 6,144개로 4주 미만 |
| 강화학습 | GB300 GPU 10,500개로 4주, 롤아웃 1억 개 이상 |
| 라이선스 | Apache 2.0(10월 중 공개 예정) |
Reflection은 Beam으로 서방 오픈웨이트 모델의 최고 성능을 새로 기록했다고 소개했다. 지금은 최종 레드티밍과 평가를 진행하고 있으며, 조기 사용 신청은 Reflection 플랫폼에서 받는다. 가중치와 함께 기술 보고서, 모델 카드, 개발자용 자료도 공개한다.
벤치마크 성적
Reflection은 코딩과 에이전트 성능에 초점을 맞춰 Beam을 학습시켰다. 공개한 비교표를 모델별로 옮기면 다음과 같다. NR은 점수가 보고되지 않은 항목이다.2
| 모델 | DeepSWE v1.1 | SWE Bench Pro v2-Hard | SWE Bench Pro v1 | Terminal Bench v2.1 | SWE Atlas Codebase QnA |
|---|---|---|---|---|---|
| Beam | 44.4 | 77.2 | 65.5 | 80.1 | 34.6 |
| Inkling | NR | 56.9 | 54.3 | 63.8 | NR |
| Nemotron 3 Ultra | NR | NR | 46.4 | 56.4 | NR |
| GLM 5.2 | 44.0 | NR | 62.1 | 81.0 | NR |
| GLM 5.3 | 61.0 | 84.3 | NR | 88.2 | 61.0 |
| Kimi K3 | 68.0 | 88.2 | NR | 88.3 | 68.0 |
| Qwen 3.8 Max | 51.0 | NR | 67.7 | 86.6 | NR |
| DeepSeek V4.1 Flash | 74.2 | NR | NR | 90.6 | NR |
SWEBench Multilingual과 SWEBench Verified는 GLM, Kimi, Qwen, DeepSeek 모델의 점수가 보고되지 않았다.
| 모델 | SWEBench Multilingual | SWEBench Verified |
|---|---|---|
| Beam | 78.0 | 80.9 |
| Inkling | NR | 77.6 |
| Nemotron 3 Ultra | 67.7 | 70.7 |
Reflection의 설명에 따르면 코딩과 에이전트 작업에서 Beam은 더 큰 오픈 모델인 GLM 5.2와 경쟁할 만한 수준이고, Qwen 3.8 Max와의 격차도 크지 않다. Kimi K3 같은 최상위 오픈 모델은 점수만 비교하면 여전히 Beam보다 높다. Reflection은 Beam의 강점을, 답을 생성할 때 드는 연산이 적다는 데서 찾는다.
표에서 GLM 5.2와 점수가 함께 보고된 항목은 세 개다. Beam은 그중 DeepSWE에서 44.4점 대 44.0점, SWE Bench Pro v1에서 65.5점 대 62.1점으로 높고, Terminal Bench에서는 80.1점 대 81.0점으로 낮다. Qwen 3.8 Max와 비교하면 Beam은 같은 세 항목에서 모두 2~7점 낮다.
연산 효율
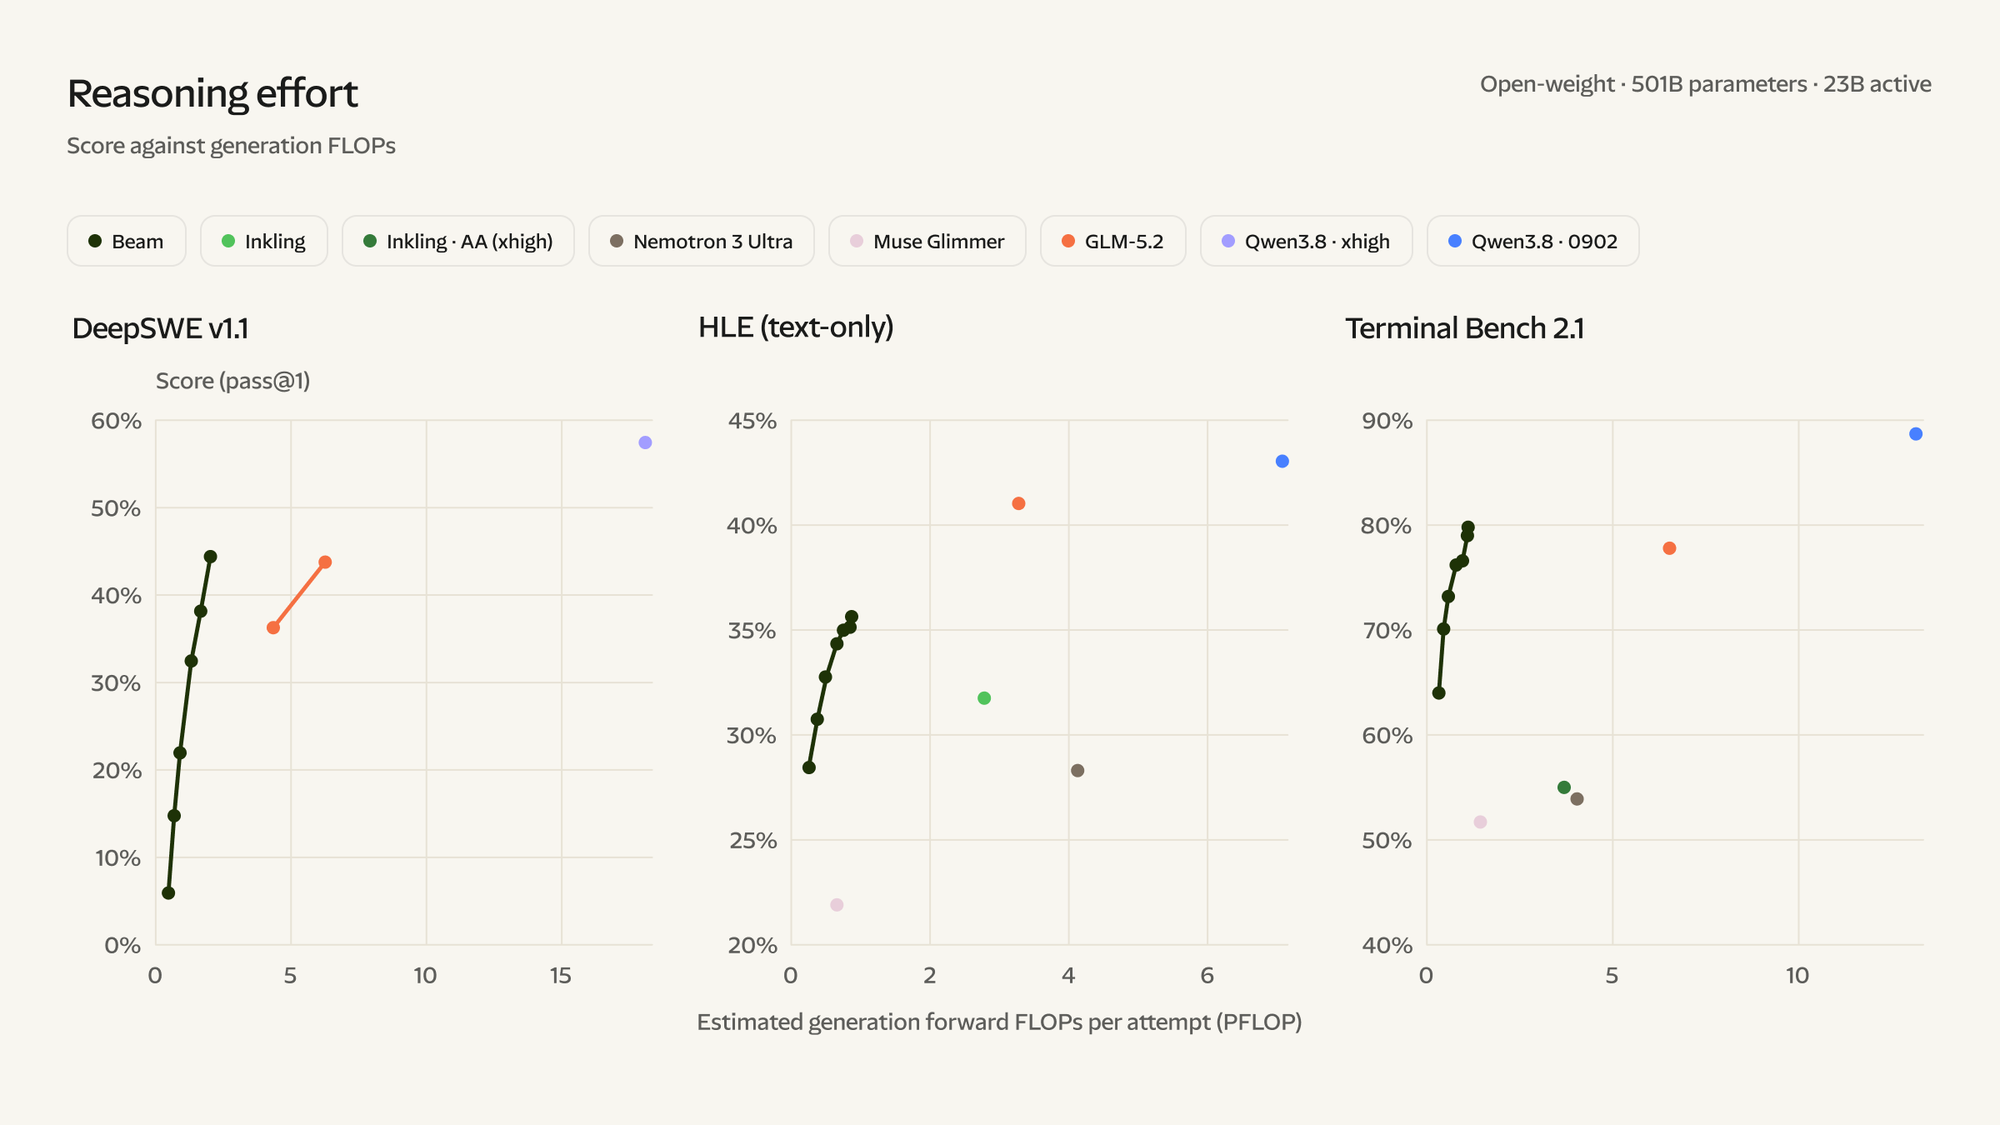
Reflection은 Beam이 고급 추론 벤치마크에서 GLM 5.2와 비슷한 점수를 내면서도, 답을 생성하는 데 쓰는 연산은 3~4배 적다고 밝혔다. Qwen 3.8 Max처럼 파라미터가 2조 개 이상인 모델과 비교하면 효율 차이는 더 크다. Reflection은 이를 토큰당 지능이 높다고 표현했다. 그리고 Beam을, 기업이 코딩과 에이전트 작업을 낮은 비용으로 처리할 주력 모델로 소개했다.
글 첫머리의 그림은 문제를 한 번 풀 때 생성에 쓴 연산량 추정치(PFLOP)를 가로축에, 점수를 세로축에 놓고 모델을 비교한다.3 Beam의 점이 여러 개인 것은 추론 강도 설정을 바꿔 가며 측정했기 때문이다. 그림을 읽으면 DeepSWE에서 Beam은 약 2 PFLOP으로 44% 남짓을 기록했고, GLM 5.2는 약 6 PFLOP을 써서 비슷한 점수를 냈다. Terminal Bench 2.1에서는 Beam이 약 1.1 PFLOP으로 80%에 가까운 점수를 냈고, GLM 5.2는 약 6.5 PFLOP으로 78%에 가까운 점수를 냈다. HLE(Humanity’s Last Exam)에서는 Beam의 최고점이 약 36%로, GLM 5.2의 약 41%보다 낮다.
아래 그림은 같은 비교를 연산량 대신 평균 생성 토큰 수로 다시 그린 것이다.
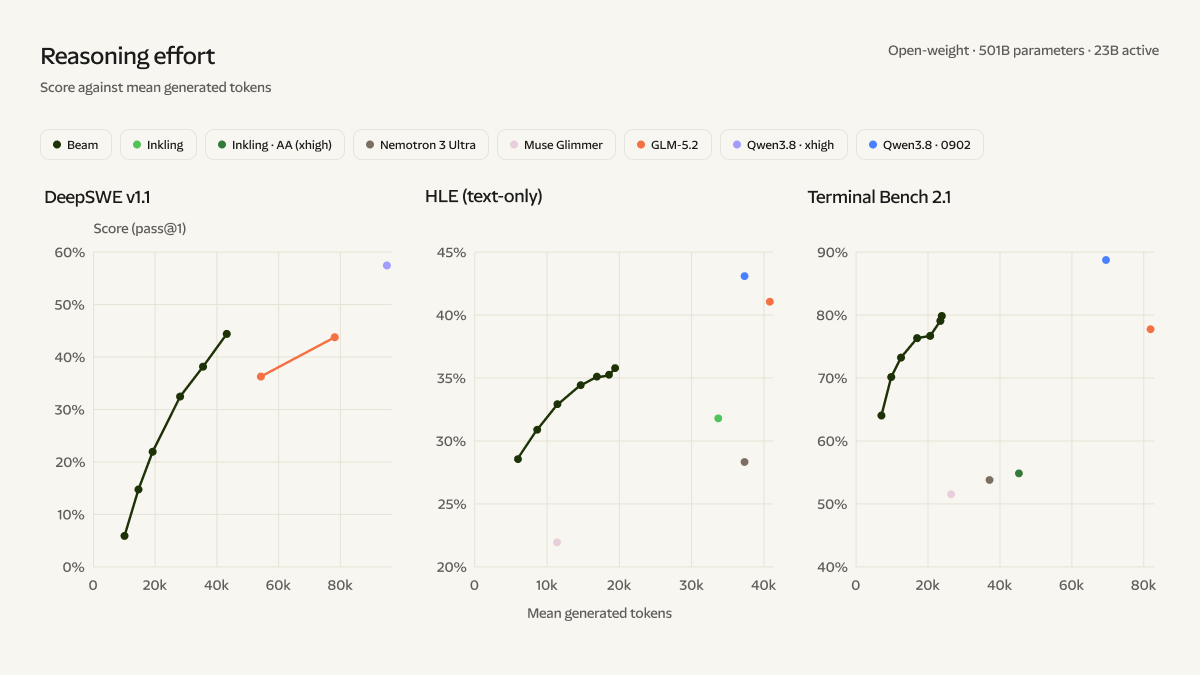 추론 강도를 바꿔 가며 측정한 Beam(진한 녹색 선)과 다른 모델의 점수를 평균 생성 토큰 수 기준으로 비교한 그래프. (원문 그림 2)
토큰 수만 비교하면 차이가 줄어든다. DeepSWE에서 비슷한 점수를 낼 때 Beam은 약 4만 3,000토큰, GLM 5.2는 약 7만 8,000토큰을 생성해 1.8배 정도 차이가 난다. 연산량 비교에서는 이 1.8배에 토큰당 활성 파라미터 수의 차이가 곱해져 3배가 된다.
강화학습의 규모
Reflection은 강화학습을 Beam의 핵심 확장 수단으로 삼고, 강화학습 연구와 데이터, 인프라에 투자했다. 강화학습 규모를 늘리면 모델이 더 다양한 문제 해결 전략을 탐색할 수 있다는 것이 Reflection의 설명이다. 롤아웃이 길어지면 여러 단계로 추론하는 법, 도구를 쓰는 법, 환경의 피드백에 대응하는 법도 익힐 수 있다.4
| 항목 | 규모 |
|---|---|
| GPU | NVIDIA GB300 10,500개, 4주 |
| 롤아웃 | 1억 개 이상, 최대 컨텍스트 256K 토큰 |
| 샌드박스 | 학습과 채점에 약 13억 개 |
| 학습 환경 | 코딩, 에이전트, STEM 환경 약 100만 개 |
Reflection은 이번 강화학습이 모델을 공개하는 연구소들이 지금까지 수행한 강화학습 가운데 최대 규모에 속한다고 본다. 평가 항목 전반에서 강화학습 연산을 늘릴수록 성능이 계속 올랐고, 정체될 조짐은 없었다.
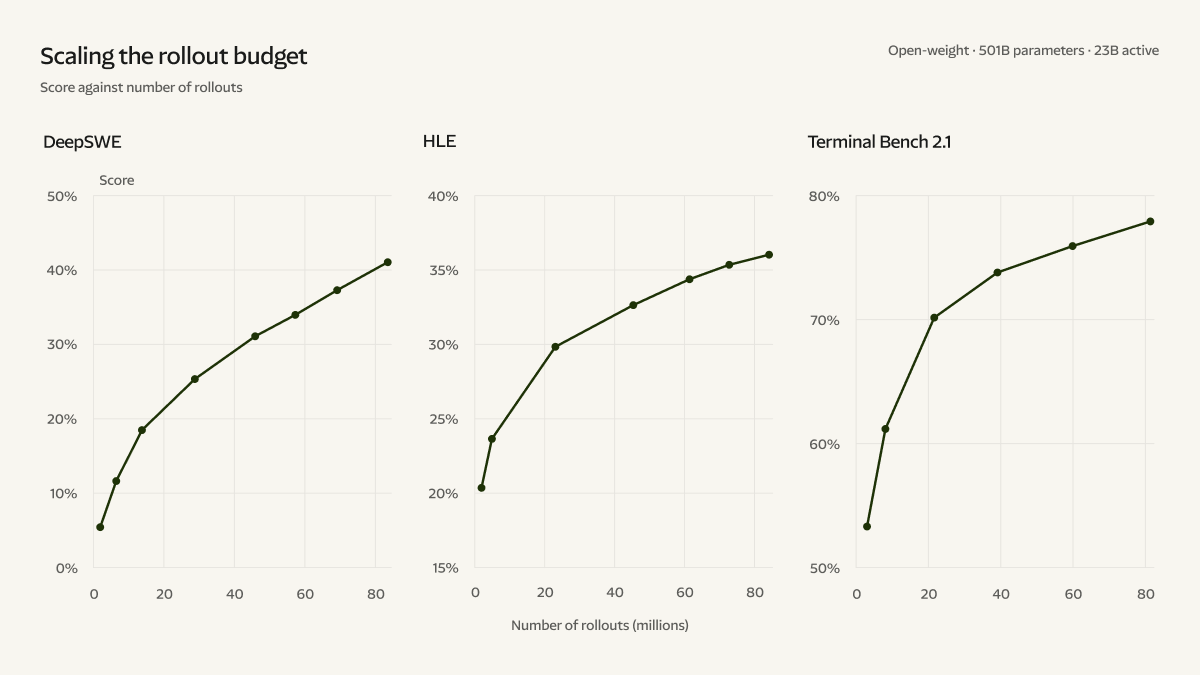 Beam의 추론 전문가 모델을 학습하는 동안 누적 롤아웃 수에 따른 점수. 전체 1억여 개 가운데 8,000만 개 구간이다.5 비교하자면 Inkling은 3,000만 개, MiMo는 75만 3,000개의 롤아웃으로 학습했다. (원문 그림 3)
그림을 보면 누적 롤아웃이 8,000만 개가 될 때까지 DeepSWE 점수는 약 5%에서 41%로 올랐다. 그사이 HLE는 약 20%에서 36%로, Terminal Bench 2.1은 약 53%에서 78%로 올랐다. 세 곡선 모두 마지막 구간에서도 상승을 멈추지 않았다.
비동기 강화학습과 정책 지연
Beam은 비동기 정책 경사법으로 학습했다. 규모가 커지면 정책 지연(staleness)이 이런 방법의 주된 불안정 요인이 된다. 롤아웃이 오래 걸리면 한 응답의 토큰들을 서로 다른 체크포인트가 생성하게 된다. 먼저 생성된 토큰일수록 그 토큰을 만든 정책과 현재 정책의 차이가 크다. 학습 엔진과 추론 엔진의 수치 불일치도 학습을 더 불안정하게 만든다.
Reflection은 이런 조건에서도 안정적으로 학습할 수 있게 하는 새 알고리즘을 개발하고, 파이프라인 전반에서 학습과 추론의 수치 불일치를 체계적으로 줄였다. 그 결과 완전 비동기 강화학습을 대규모로 구현했다. 하루 이상 지난 상호작용 데이터로 학습해도 학습이 안정적으로 유지된다. Reflection은 새 알고리즘의 세부 내용은 공개하지 않았다.
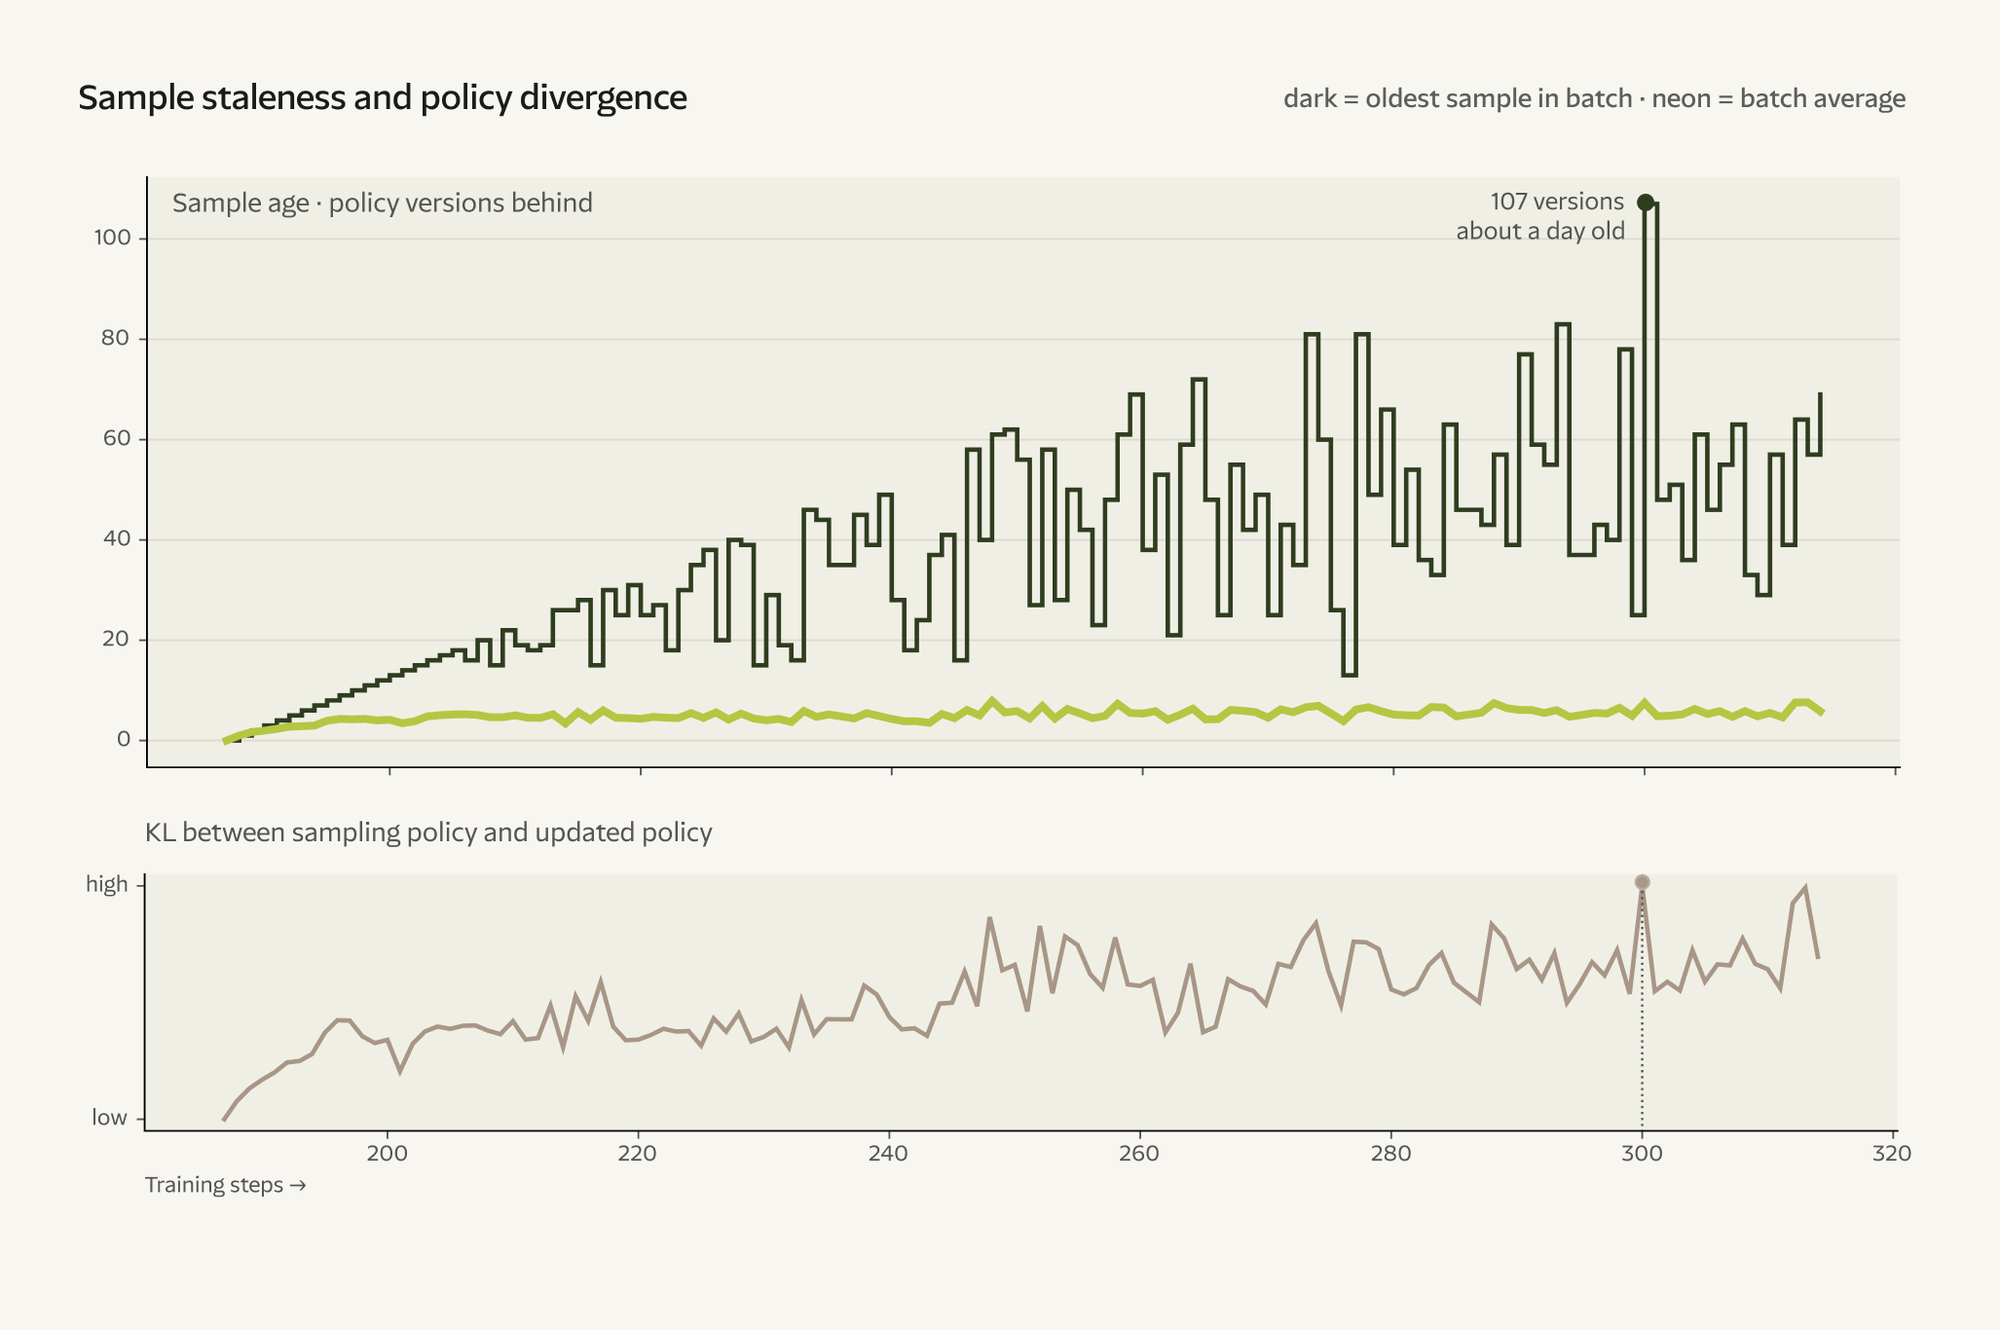 배치에서 가장 오래된 샘플은 최대 107버전 이전의 정책, 시간으로 치면 약 하루 전의 정책이 만든 것이었다. 그런데도 학습 수치는 안정적으로 유지됐다. (원문 그림 4)
길이 페널티와 추론 강도
Beam은 강도를 조절할 수 있는 길이 페널티를 적용해 학습했다. 문제를 풀면 보상을 주되 불필요한 토큰에는 불이익을 주는 방식이다. 강화학습 초반에는 응답 길이가 줄어드는 동안에도 성능이 올랐다. 모델이 더 짧게 추론하고도 과제를 더 잘 푸는 법을 익힌 것이다. 이후 에이전트 능력이 강해지면서 응답 길이가 다시 늘었고, 늘어난 토큰은 성능을 더 높이는 데 쓰였다. Reflection은 같은 양의 토큰으로 얻는 성능이 강화학습 내내 높아졌다고 설명한다.
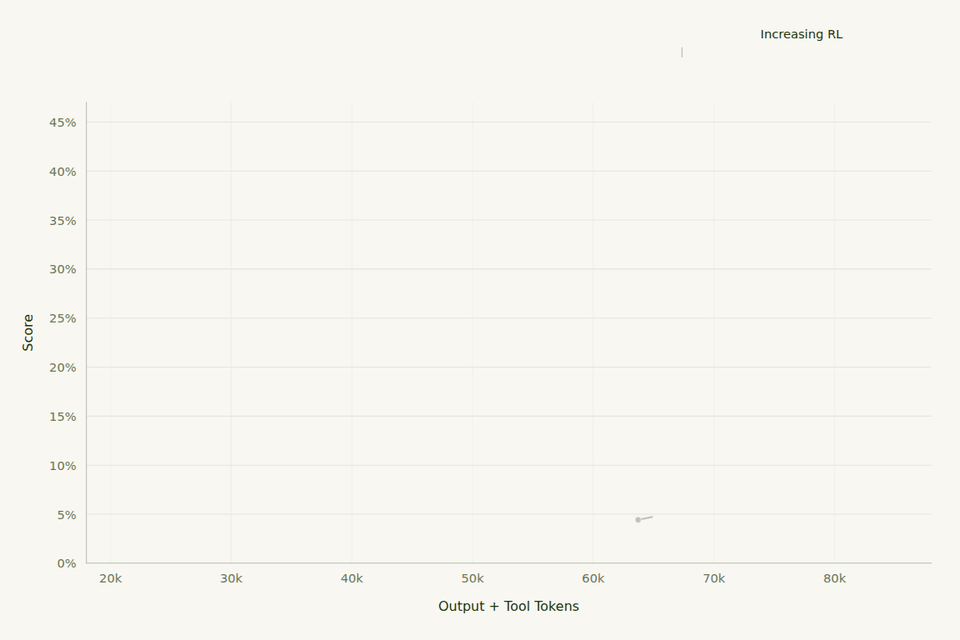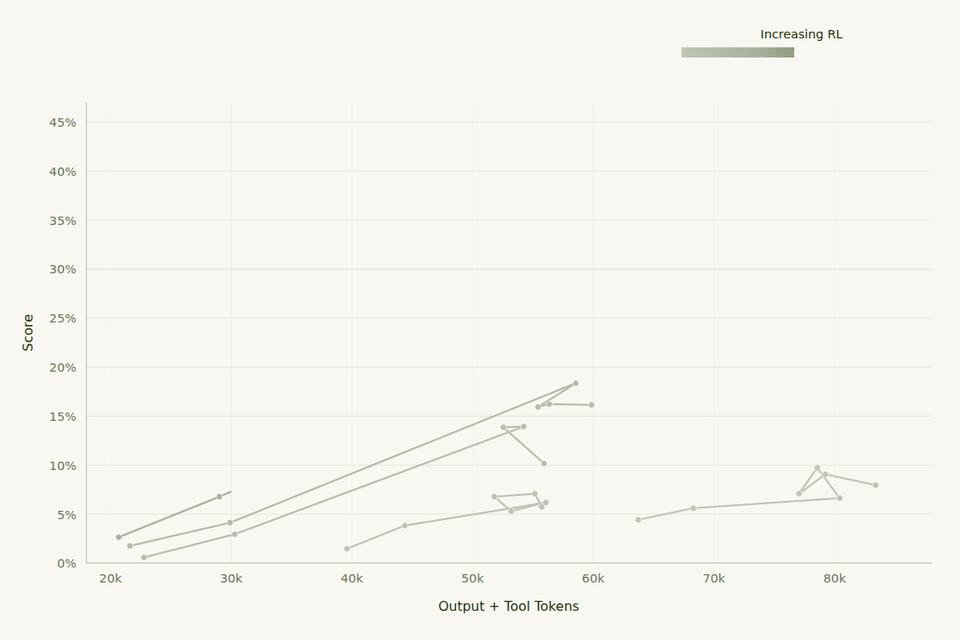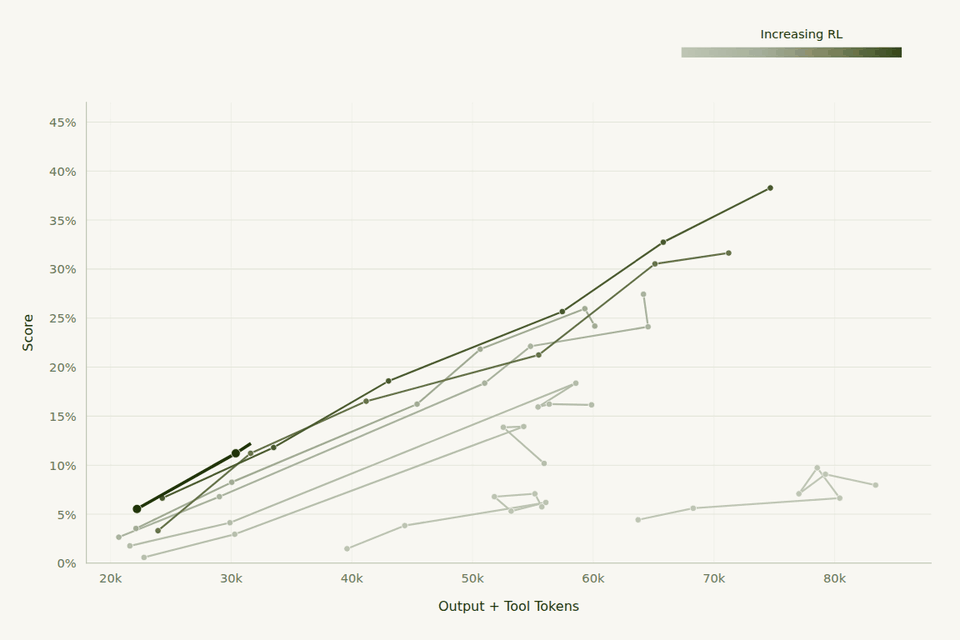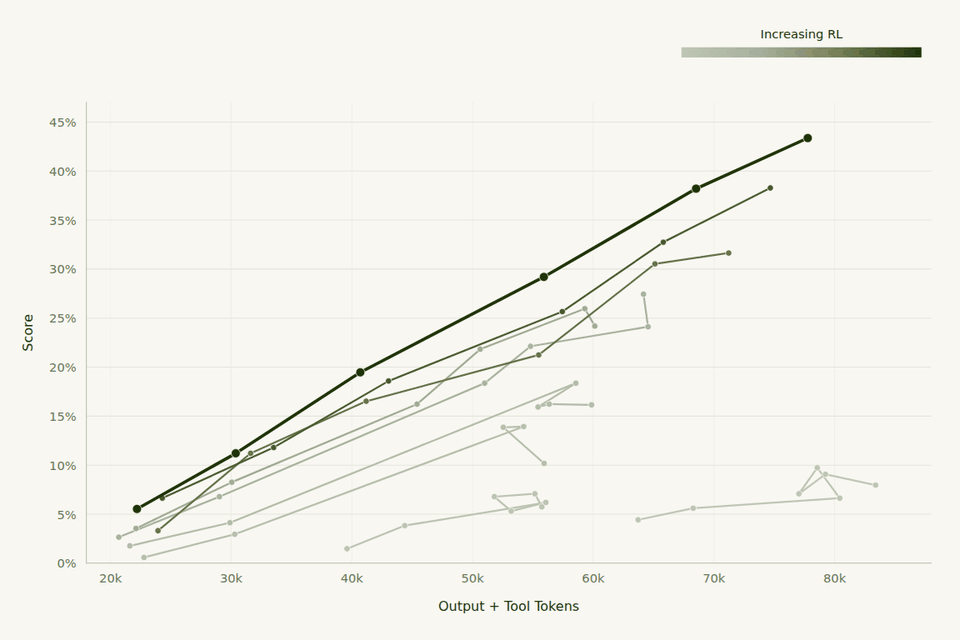 강화학습 일부 구간의 DeepSWE 점수. 점 하나가 추론 강도 설정 하나다. 파레토 경계는 두 단계로 변한다. 먼저 정책이 토큰을 아끼는 법을 익히면서 같은 점수를 내는 데 드는 토큰이 줄고, 그다음 높은 추론 강도에서 점수가 크게 오른다. (원문 그림 5)
사용자는 추론 강도(reasoning effort) 매개변수로 이 균형을 조절할 수 있다. 낮게 설정하면 짧게 답하고, 높게 설정하면 길게 추론해 어려운 과제에서 성능을 높인다. 과제의 난도와 연산 예산에 맞춰 설정을 고르면 된다.
일반화와 시연
Reflection은 학습에 쓰지 않은 분야에서도 발휘되는 추론 능력과 에이전트 능력을 목표로 강화학습을 설계했다. 강화학습 데이터에는 브라우징 과제가 하나도 없었다. 그런데도 추론, 소프트웨어 엔지니어링, 터미널 과제로 학습하는 동안 웹 브라우징 성능이 꾸준히 올랐다. Reflection은 이를 Beam이 여러 분야에서 두루 쓸 수 있는 에이전트 능력을 익힌 증거로 본다. 웹 접근 권한을 주자 Beam은 다른 대형 언어 모델을 검색해 질문하는 방법과 OCR API로 문서를 읽는 방법을 스스로 익혔다고 한다.
Reflection은 연구, 앱 개발, 게임, 머신러닝 분야의 시연을 공개했다. Beam은 텍스트만 입력받는 모델이지만, 다른 형식의 정보도 텍스트로 표현되어 있으면 다룰 수 있다.
우주비행사 낙하 게임. Reflection은 Beam에게 p5.js로 3D 게임을 만들게 했다. 우주비행사가 지구를 향해 자유 낙하하는 게임이다. 우주비행사는 날아오는 소행성을 피하거나 광선으로 부숴야 한다. Reflection은 Beam이 멀티모달 모델이 아닌데도 게임 화면이 어떻게 보여야 하는지 텍스트로 추론해 냈다고 설명했다.
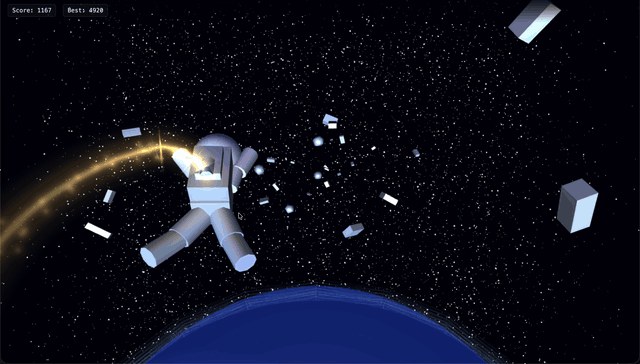 Beam이 p5.js로 만든 우주비행사 낙하 게임. (원문 시연 영상의 한 장면)
육지와 바다 판정. 소셜 미디어 X에서 화제가 된 퍼즐을 재현했다. 서경 179도부터 동경 179도, 남위 89도부터 북위 89도까지의 범위에 경도 방향 180개, 위도 방향 90개의 격자점을 정했다. 그리고 점 16,200개가 각각 육지인지 바다인지 Beam에게 판정하게 했다. Beam은 95.5%를 맞혔다. 같은 과제에서 Opus 5는 92.5%, Fable 5는 97.8%였다.
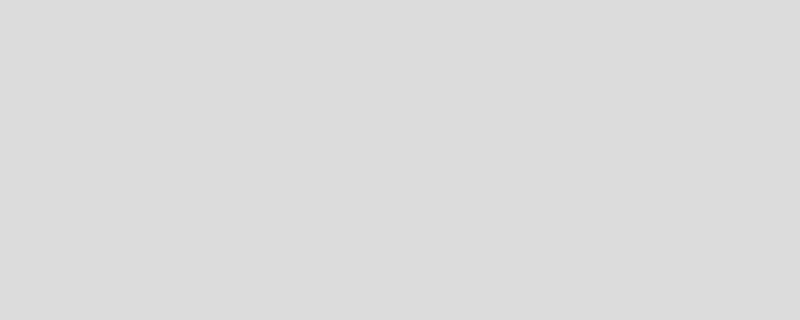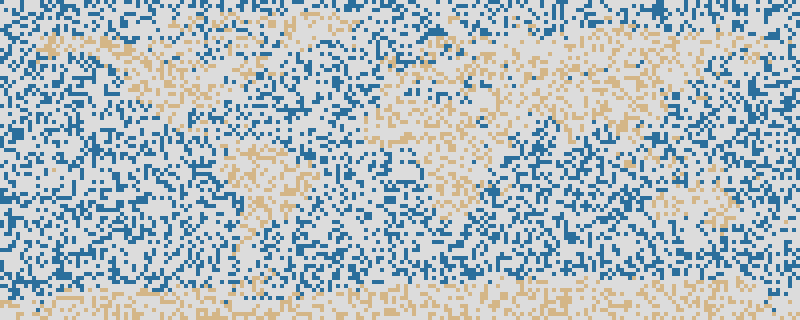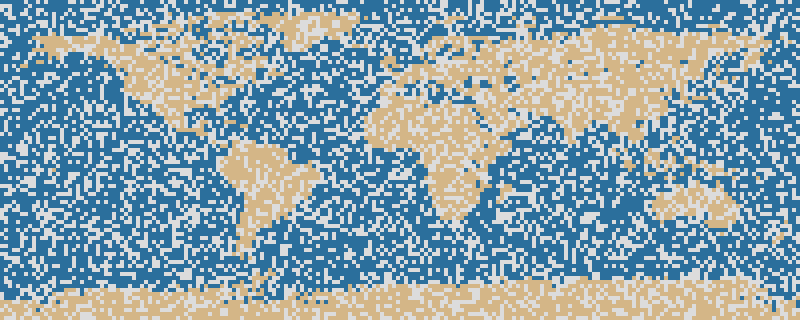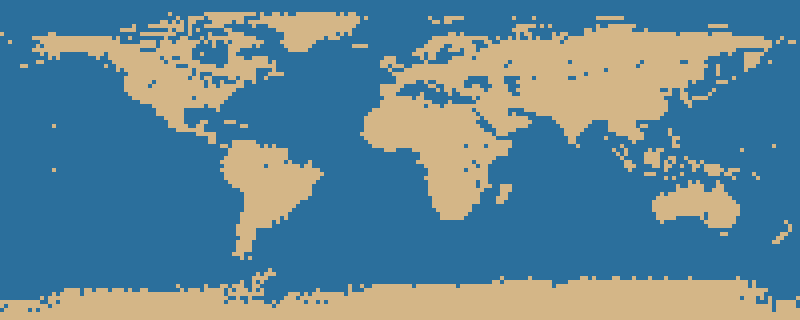 점 16,200개에 대한 Beam의 육지와 바다 판정 결과. (원문 시연)
뉴욕 지하철 실시간 지도. 공개된 뉴욕 MTA 데이터로 실시간 갱신되는 지하철 지도를 만들게 했다. Beam은 문서를 검색하고, 인증 요건을 확인하고, 지하철 노선의 형상 데이터와 지도 데이터를 찾았다. 역과 역 사이를 지나는 열차를 지도에 표시하는 방법도 직접 고안했다. 프런트엔드와 백엔드를 모두 만들고, 실시간 갱신을 위해 서버가 계속 실행되도록 했다.
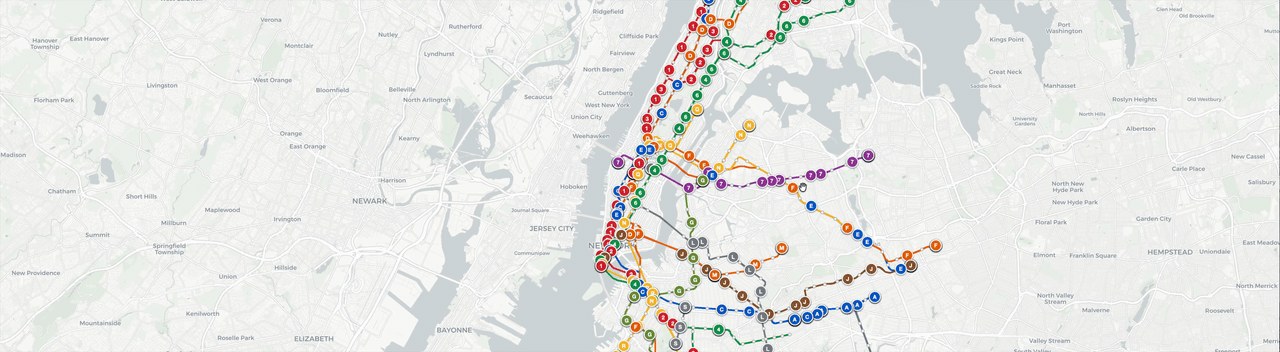 Beam이 만든 뉴욕 지하철 실시간 지도. (원문 시연 영상의 한 장면)
파인튜닝 노트북. Beam을 OpenCode에 연결하고 파인튜닝 노트북을 만들게 했다. 최신 Gemma-4 모델 가운데 가장 작은 모델을 Text2SQL 과제로 파인튜닝하는 노트북이며, Unsloth를 참고하게 했다. Beam이 학습하지 않은 분야다. Beam은 모델 카드와 Unsloth 문서, README를 조사해 파인튜닝 코드와 거기에 필요한 보조 코드를 구현했다. 그 결과 학습에 쓰지 않은 별도의 테스트 세트에서 Gemma의 정확도를 66.5퍼센트포인트 올렸다.6
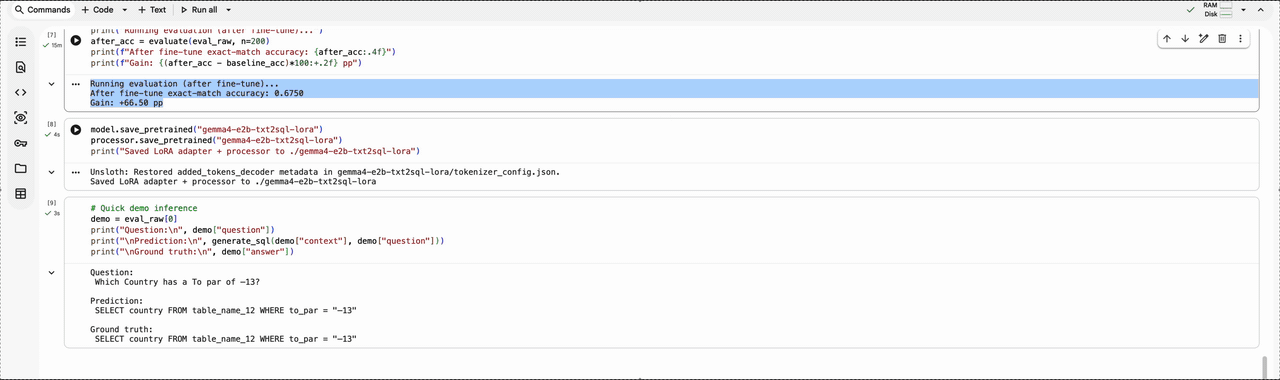 Beam이 만든 Gemma-4 파인튜닝 노트북의 마지막 실행 결과. (원문 시연 영상의 한 장면)
강화학습 환경 만들기
프런티어 규모의 강화학습에는 어렵고 품질 좋은 과제가 많이 필요하다. Reflection은 주로 합성 데이터 파이프라인으로 환경 약 100만 개를 만들고, 외부 업체의 독점 데이터와 오픈소스 자료로 보충했다. 환경을 정제할 때는 다음 세 단계를 반복했다.
- 소프트웨어 엔지니어링, 터미널 사용, 경쟁 프로그래밍, STEM, 웹 검색, 도구 사용, 일반 지식 업무 등 넓은 분야에서 환경을 합성하거나 수집한다.
- 난도와 품질로 과제를 엄격히 걸러 낸다. 모델이 늘 푸는 과제와 전혀 풀지 못하는 과제는 버린다. 조건이 불충분한 과제, 오해를 부르는 과제, 찍어서 맞힐 수 있는 과제, 보상을 속일 수 있는 과제, 그 밖에 결함이 있거나 잡음이 많은 과제도 버린다.
- 남은 과제를 실제 강화학습에 투입해 품질이나 난도 문제를 더 찾아내고, 그 결과를 다음 수집과 필터링에 반영한다.
Reflection에 따르면 데이터 품질에서 타협할 때마다 성능이 정체되거나 다른 학습 문제가 생겼다. 학습이 끝날 때까지 성능을 계속 높일 수 있었던 것은 과제 품질을 체계적으로 개선했기 때문이라는 설명이다.
강화학습 인프라
에이전트 강화학습을 대규모로 하려면 롤아웃 생성, 도구 실행, 결과 평가, 모델 갱신을 모두 대량으로 처리해야 한다. Reflection은 이를 위해 비동기 플랫폼을 만들었다. 네 과정을 각각 독립적으로 실행하면서 경험 데이터의 흐름과 모델 갱신의 흐름을 조율하는 플랫폼이다. 학습 기간에는 롤아웃을 평균 11만 개 동시에 실행했고, Reflection은 이를 가능하게 한 기능을 일곱 가지로 정리했다.
| 기능 | 내용 |
|---|---|
| 완전 비동기 실행 | 에이전트가 롤아웃을 만드는 동안 트레이너는 학습하고 새 모델 버전을 배포한다. 토큰마다 그 토큰을 생성한 버전을 기록해, 학습 알고리즘이 정책 지연을 계산에 반영한다 |
| 유연한 연산 배분 | 작업량 변화에 맞춰 추론 대 학습 GPU 비율을 3.9:1에서 5.4:1 사이로 조정했다. 학습 상태를 잃지 않고 트레이너의 GPU 메시 구성을 다섯 가지로 바꿔 가며 학습했다 |
| 빠른 가중치 배포 | 새 가중치가 추론 서버 전체에 반영되는 시간의 중앙값은 약 12초다. 랙 사이는 RoCE로, 랙 내부는 NVLink로 계층적으로 전송해, 복제본마다 가중치를 직접 받을 때보다 랙 간 트래픽을 75% 줄이고 전체 반영 속도를 2.2배 높였다 |
| 추론 장애 대응 | 추론 장애 71건을 학습 중단 없이 처리했다. 추론 용량이 복구되기까지 걸린 시간의 중앙값은 8분이고, 잃은 용량은 전체 서빙 GPU 시간의 0.02%였다 |
| 대규모 샌드박스 | 샌드박스를 동시에 최대 17만 개 운영했다. 20개 이상의 클러스터, 클라우드 2곳, 리전 4곳에서 샌드박스 생성 요청을 10억 건 이상 처리했고, 새 샌드박스의 90%가 10초 이내에 준비됐다 |
| 트레이너 패킹 | 동적 패킹으로 학습 배치를 평균 99.99% 채웠다. 평균 롤아웃 길이가 70% 가까이 늘어나는 동안에도 GPU당 트레이너 처리량의 변동을 1.5% 이내로 유지했다 |
| 관측과 보상 무결성 | 토큰 단위 기록으로 매 스텝 학습과 추론의 수치가 일치하는지 검사했다. 채점을 통과한 해답은 독립 심사자가 검증기의 허점을 악용했는지 다시 검사했고, 다시 재현할 수 있는 기록으로 보상과 그 보상이 학습에 쓰인 내역을 확인할 수 있게 했다 |
사전학습
Reflection은 강화학습에 쓸 베이스 모델이 코딩 분야의 지식을 풍부하게 갖추고, 강화학습으로 증폭할 수 있는 에이전트 능력을 지니며, MoE 최적화도 안정적이기를 바랐다.
개발 과정에서는 크기를 단계적으로 늘린 모델 여러 개를 사전학습해 스케일링 레시피를 확인했다. 성능을 예측할 수 있도록 모델 단계를 신중히 설계하고, 사내 코드와 웹 검증 세트를 다양하게 구성하고, 모든 학습 데이터에서 검증 세트와 겹치는 내용을 철저히 제거했다. 스케일링 예측은 들어맞았다. 최종 Beam Base는 예측한 성능을 그대로 냈다. 비슷한 크기로 공개된 오픈소스 베이스 모델과 비교해도 성능이 같거나 더 높았다.
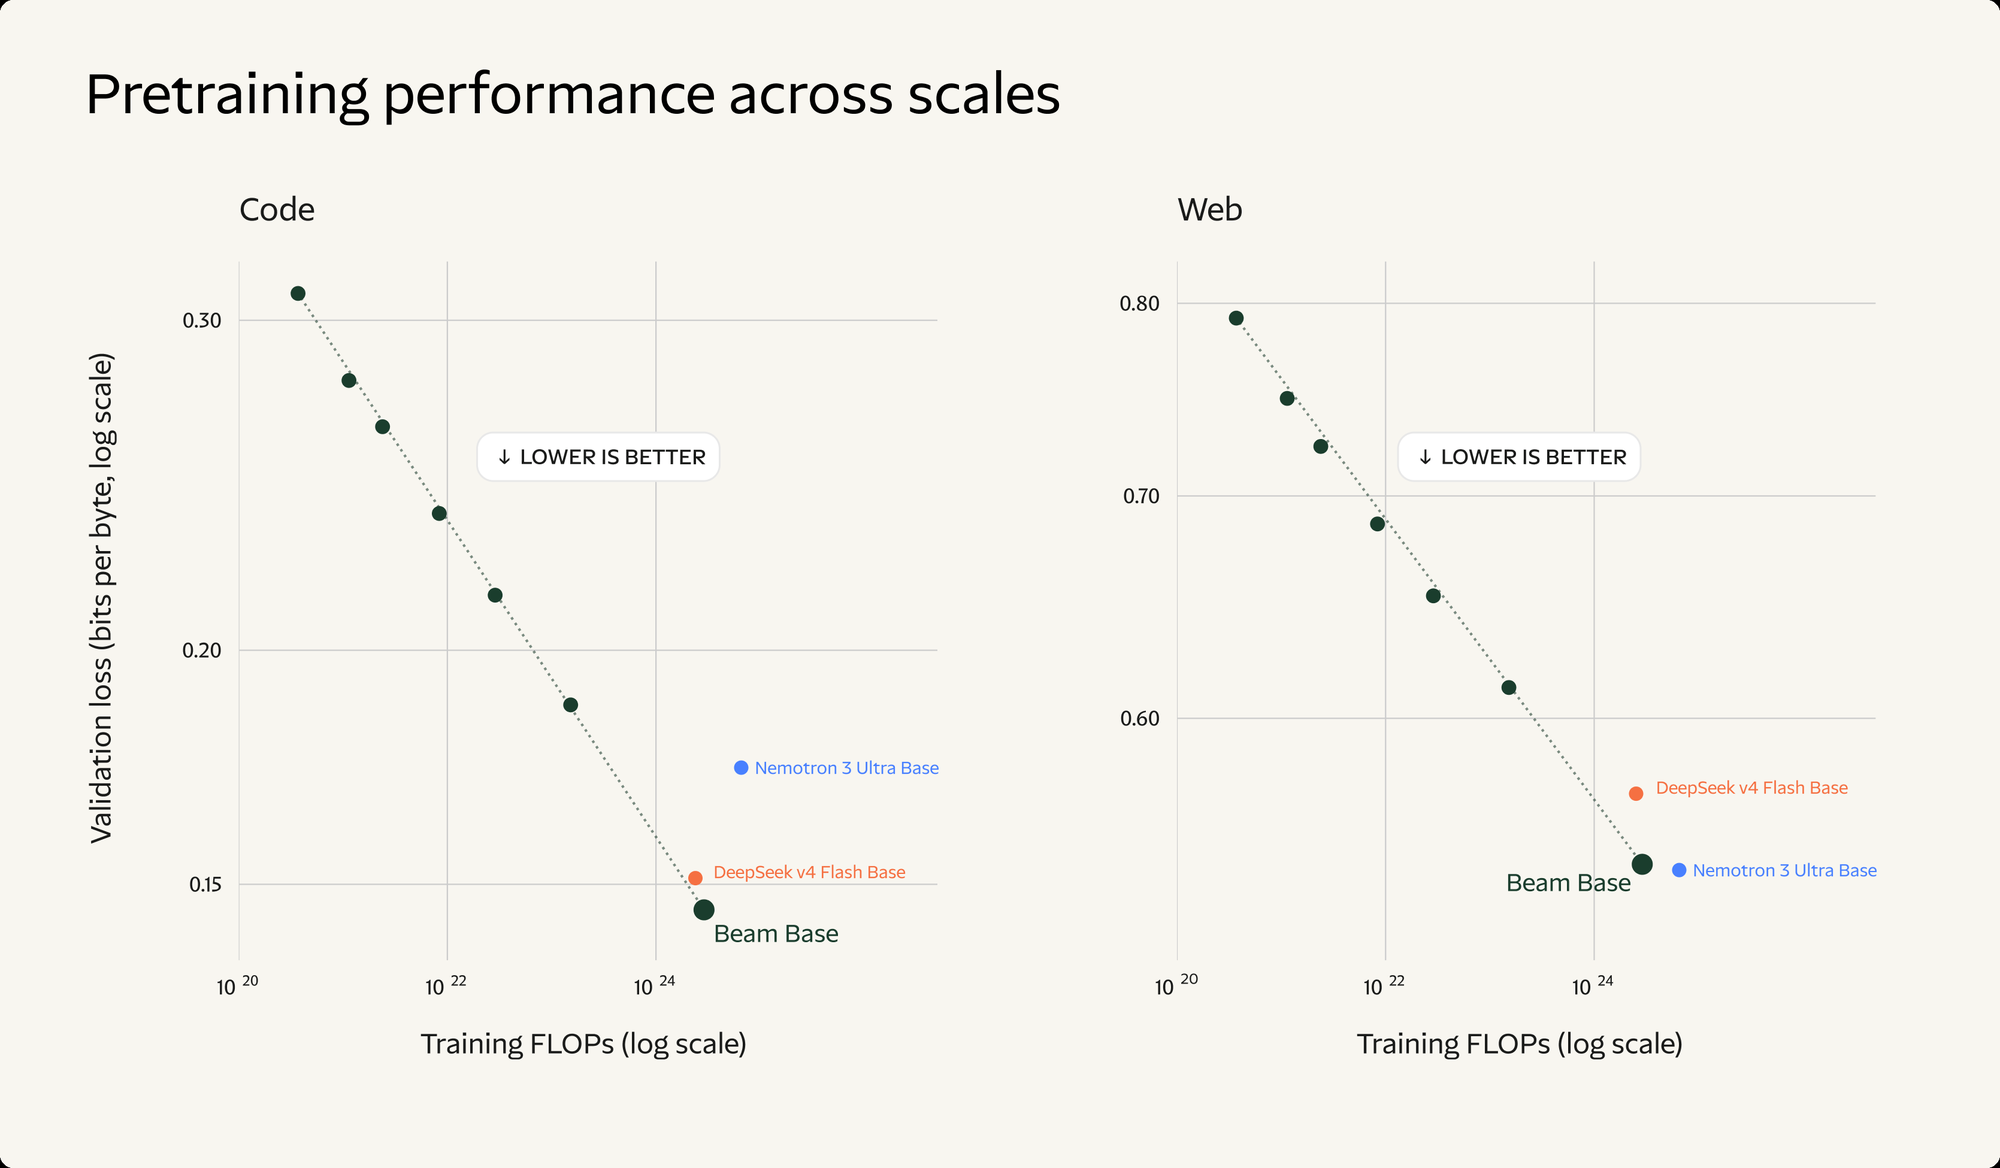 학습 연산량이 1만 배 늘어나는 동안 검증 손실이 예측대로 줄었다. Reflection은 오염을 제거한 코드와 웹 검증 데이터에서, Beam Base가 비교 가능한 오픈 베이스 모델 가운데 연산량 대비 손실이 파레토 최적이라고 밝혔다. (원문 그림 6)
MoE 최적화의 안정성
Reflection은 Beam의 구조와 최적화 레시피를, 뒤이어 오래 진행할 강화학습에서도 수치가 안정적으로 유지되도록 설계했다. 로컬 어텐션과 글로벌 어텐션을 교대로 배치하고, 세분화된 라우팅 전문가(fine-grained routed experts)를 쓰고, 잔차 스트림을 통제하고, 여러 형태의 부하 분산을 함께 적용했다.
전문가 활용도는 DeepSeek-V3 기술 보고서가 제안한, 보조 손실을 쓰지 않는 부하 분산을 기반으로 조절했다.7 여기에 전문가 편향값의 갱신 폭을 코사인 감쇠로 줄여, 학습 후반의 라우팅 변화를 작게 만들었다. 시퀀스 단위 부하 분산도 더해 사전학습 분포와 다른 데이터에서도 전문가가 고르게 쓰이도록 했다. 이후 강화학습에서 데이터 분포가 바뀌는 상황에 대비한 설계다. 그 결과 사전학습을 마친 베이스 모델의 전문가 활용도는 거의 완벽하게 균일해졌고, 모든 전문가가 추론 학습에 쓰일 수 있게 됐다.
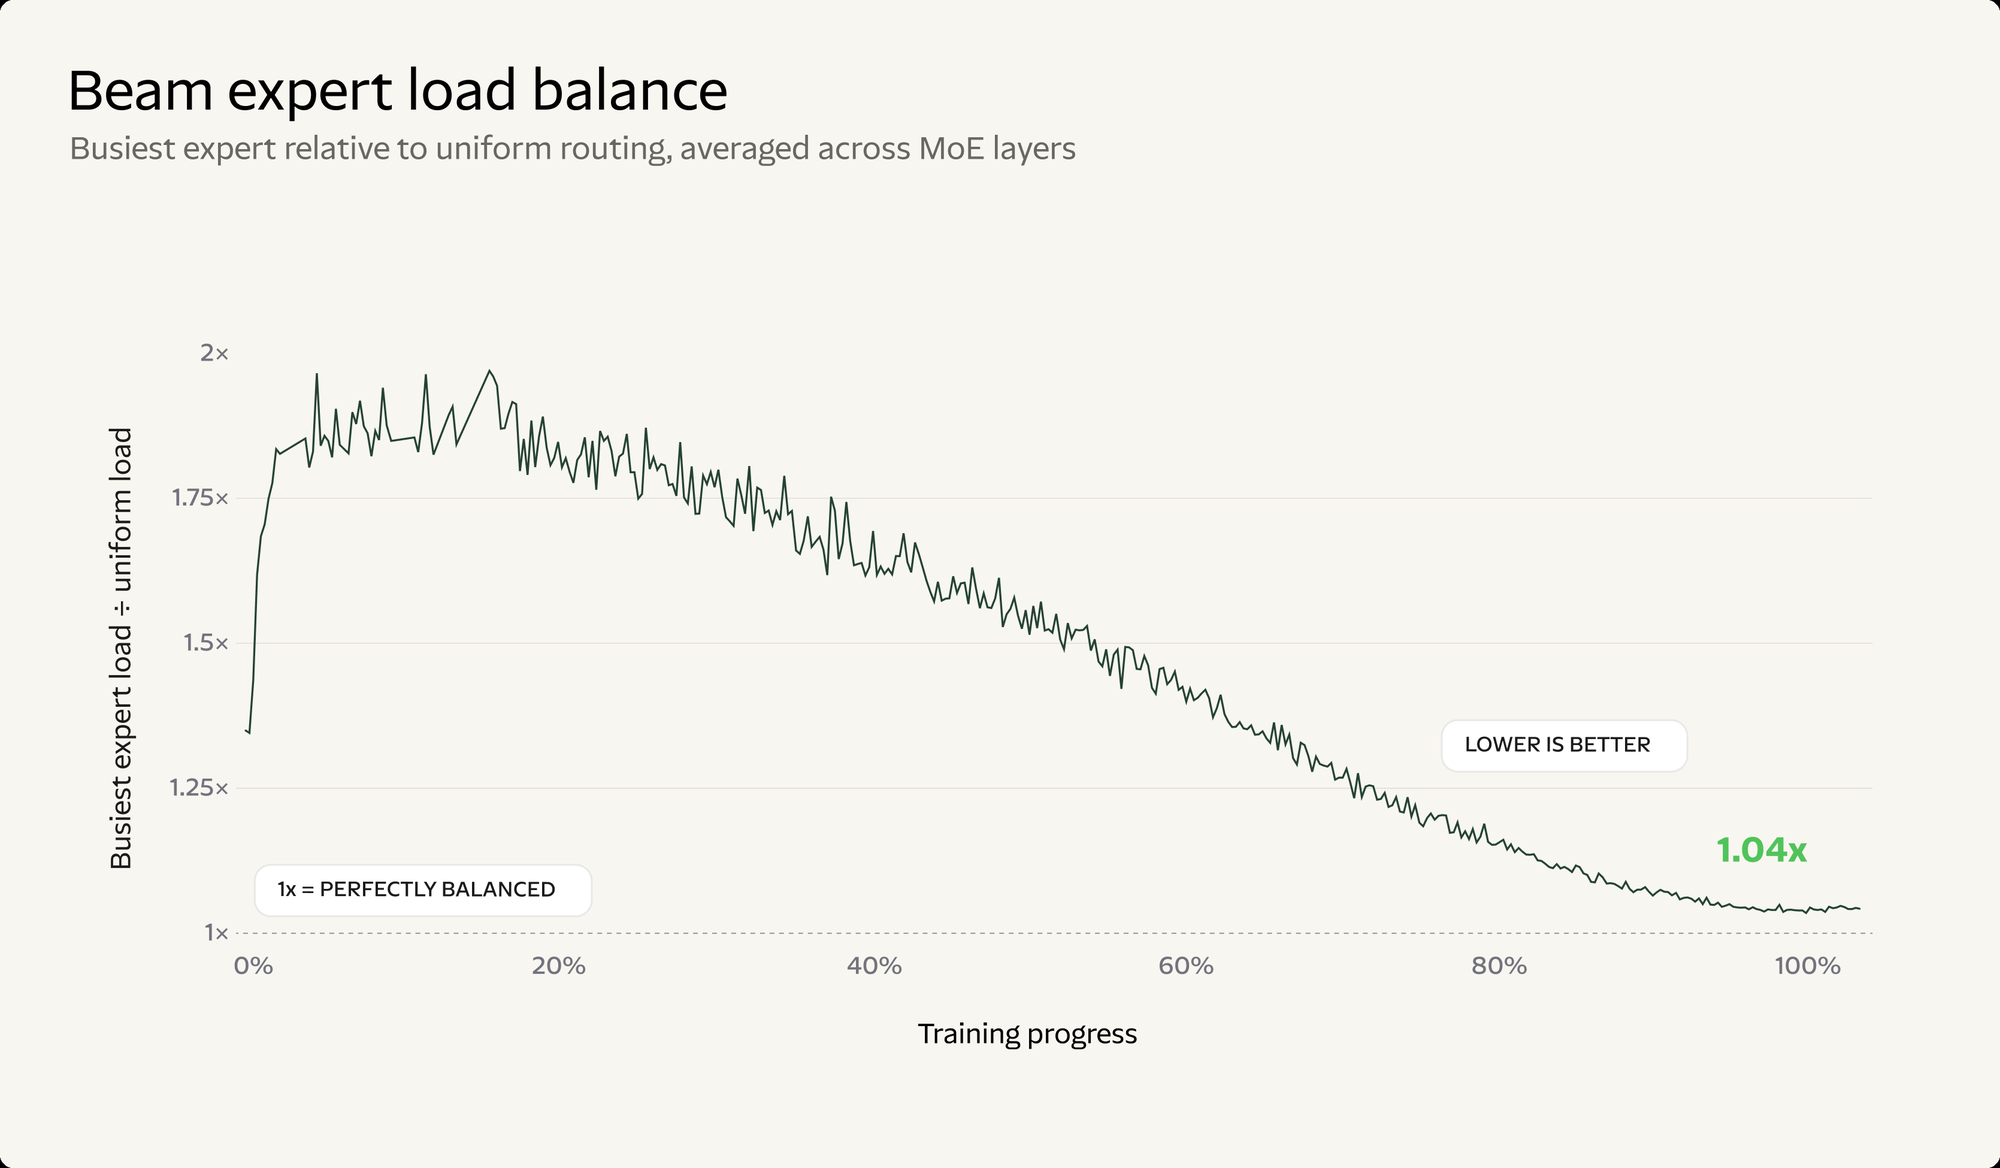 MoE 레이어 평균으로 본 가장 바쁜 전문가의 부하. 사전학습을 마칠 때 1.04배였다. (원문 그림 7)
잔차 스트림에는 깊이에 따른 스케일링 방식을 새로 만들어 적용했다. 서브레이어 출력이 누적되면서 활성값이 커지는 현상을 상쇄해, 모델이 깊어져도 잔차 노름이 안정되게 하는 방식이다. 여기에 SandwichNorm, 원소 단위 어텐션 게이팅, FP32 잔차 누적을 결합했다. FP32 누적은 잔차 스트림에 작은 갱신값을 더할 때 생기는 반올림 오차를 줄인다. 이 조합으로 활성값 증가와 이상치를 통제해, Beam의 모든 레이어에서 신호가 안정적으로 전달되게 했다. Reflection은 이 안정성이 사전학습과 강화학습, 정렬 단계 내내 유지됐다고 밝혔다.
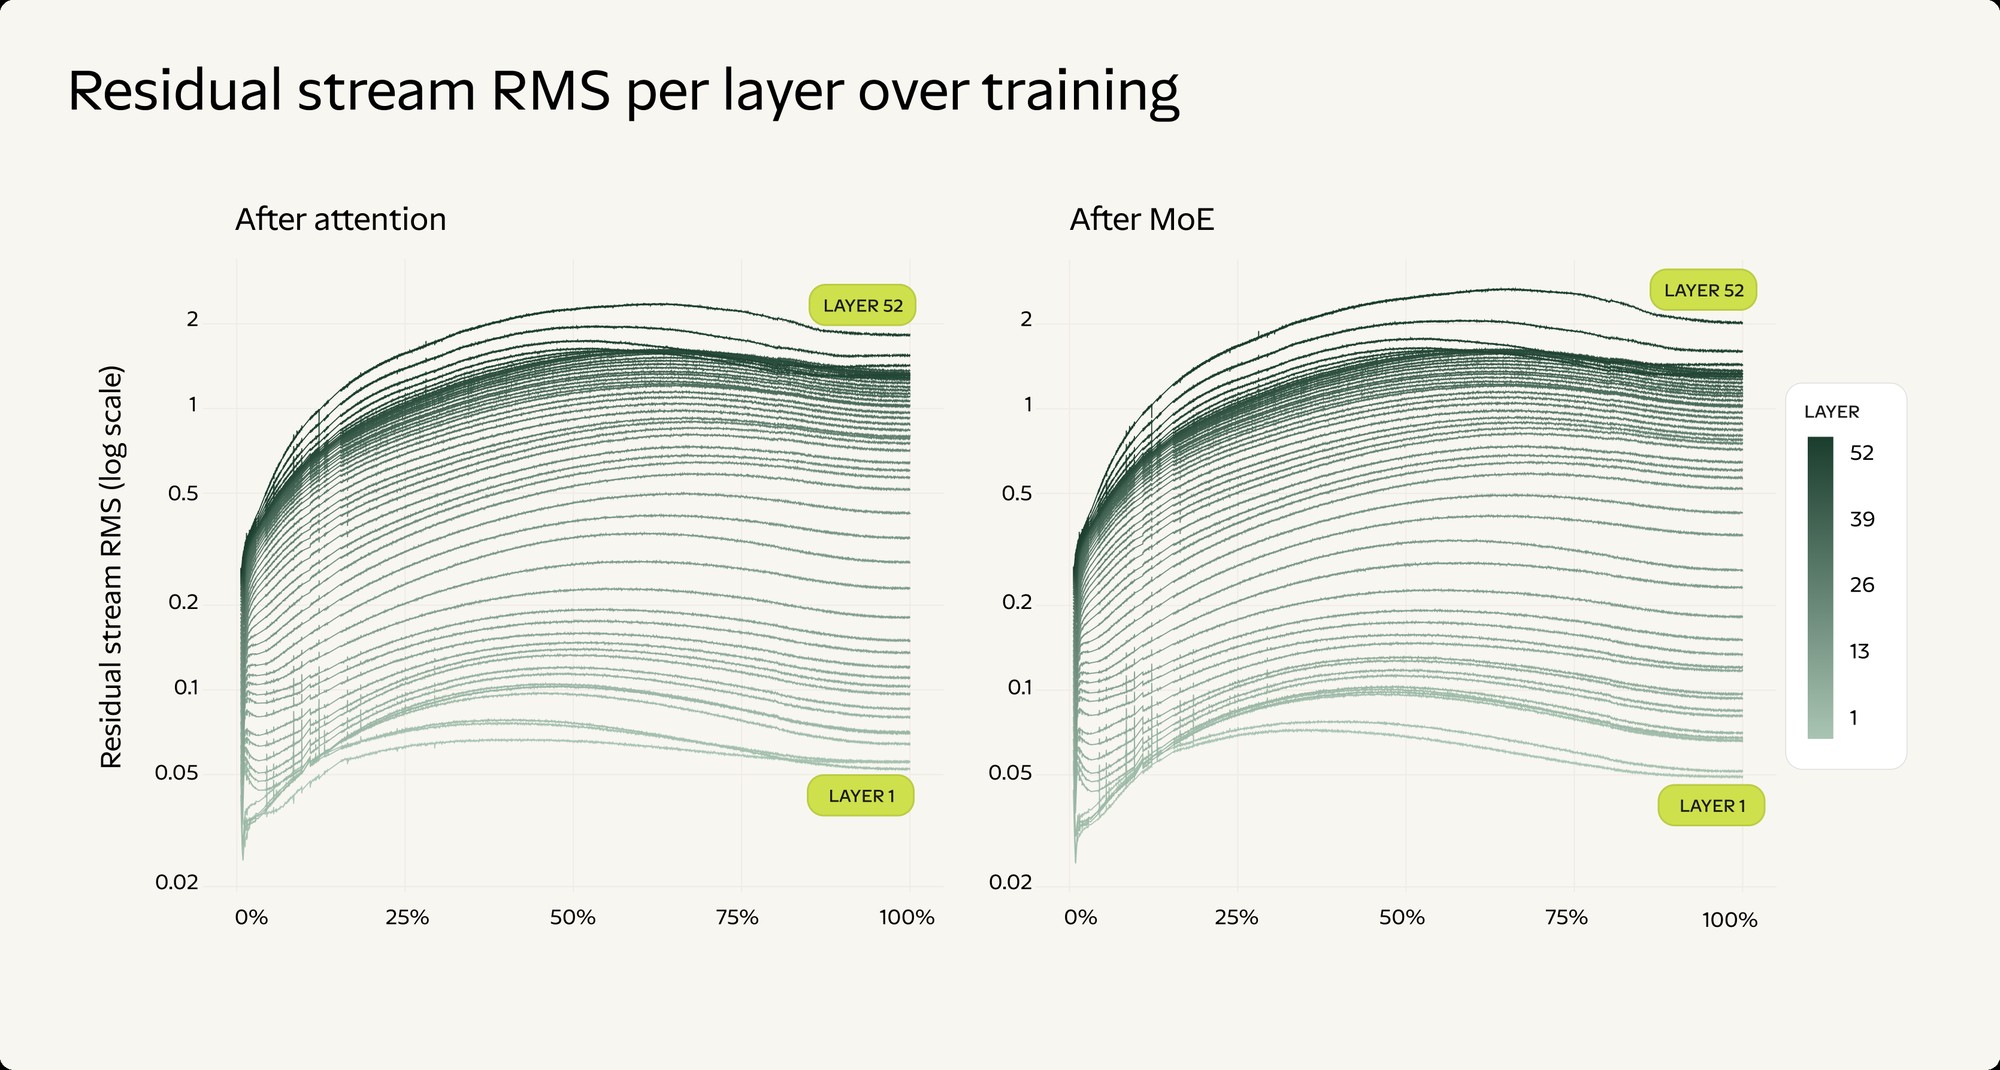 사전학습 동안 레이어 52개의 잔차 스트림 RMS. 활성값이 계속 커지는 현상은 없었다. (원문 그림 8)
품질 중심의 데이터 정제
Beam은 웹, 공개 자료, 라이선스를 받은 독점 데이터셋에서 모은 23.8조 토큰으로 사전학습했다. 데이터 파이프라인의 목표는 에이전트 코딩의 기반인 소스 코드, 기술 설명, 수학과 과학 지식을 모든 정제 단계에서 보존하는 것이었다. 웹에 공개된 코드와 코드 문서 가운데 라이선스 제한이 없는 것은 거의 모두 학습에 썼다.
Reflection은 웹, 코드, STEM 콘텐츠용 품질 분류기를 직접 학습시키고, 데이터를 세분화된 품질 등급으로 구분해 품질이 높은 자료에 학습 비중을 더 주었다. 원시 인터넷 토큰의 약 95%는 파싱, 중복 제거, 정제 과정에서 탈락한다. 한편 Reflection은 기존 기법이었다면 놓쳤을 고품질 토큰 약 1조 8,000억 개를 보존했다. 정제한 웹 코드 토큰의 87%가 이렇게 보존한 토큰에 포함된다. Reflection은 최신 오픈소스 데이터 프레임워크의 일반적인 웹 필터보다 정밀도와 재현율을 모두 크게 높였다고 밝혔다.
코드는 언어마다 따로 조정한 필터를 적용하고, 품질이 낮은 자동 생성 코드와 학습할 수 없는 내용을 지웠다. 손상된 내용이나 학습 안정성을 해칠 수 있는 코드를 찾아내는 분류기도 학습시켰다. 비중이 과도한 언어와 파일 형식은 비율을 조정해, 모델이 더 다양한 코드를 접하게 했다.
STEM 지식을 위해 PDF 문서를 대량으로 처리하는 파이프라인도 만들었다. 시각 언어 OCR 모델과 사내 품질 분류기, 잘못 복원된 결과를 잡아내는 검출기를 결합했고, GPU 수천 개에 분산해 페타바이트 단위의 기술 데이터를 처리했다.
학습 기간에는 코드와 기술 콘텐츠를 모델에 여러 차례 반복해 노출했다. 반복된 데이터가 일반화를 해치지 않도록 Reflection은 유사 중복 제거, 패킹 알고리즘, 과잉 학습(overtraining)에 관한 연구에 공을 들였다.
사전학습 인프라
Beam의 사전학습에는 NVIDIA GB300 NVL72 GPU 6,144개를 썼고, 처음부터 끝까지 4주가 채 걸리지 않았다. Reflection은 학습 인프라를 거의 전부 직접 만들었다. 쿠버네티스 기반 스케줄러는 클러스터의 네트워크 토폴로지를 고려해 작업을 할당한다. 노드 수명 주기 관리 시스템은 노드 상태를 계속 감시하며 경보를 보낸다. 사일런트 데이터 손상(SDC)을 탐지하는 시스템은 이상이 생기면 체크포인트를 반자동으로 되돌리고 학습을 재시작한다.8
사전학습은 매우 순탄하게 진행됐다. 체크포인트를 반자동으로 되돌린 일은 모두 9번이었다. 원인은 비결정적으로 발생한 그래디언트 노름 급등이거나, SDC로 의심되는 현상이었다. 체크포인트 저장, 장애 탐지, 노드 상태 관리를 개선한 덕분에 학습 후반에는 굿풋이 92.3%까지 올라갔다.9
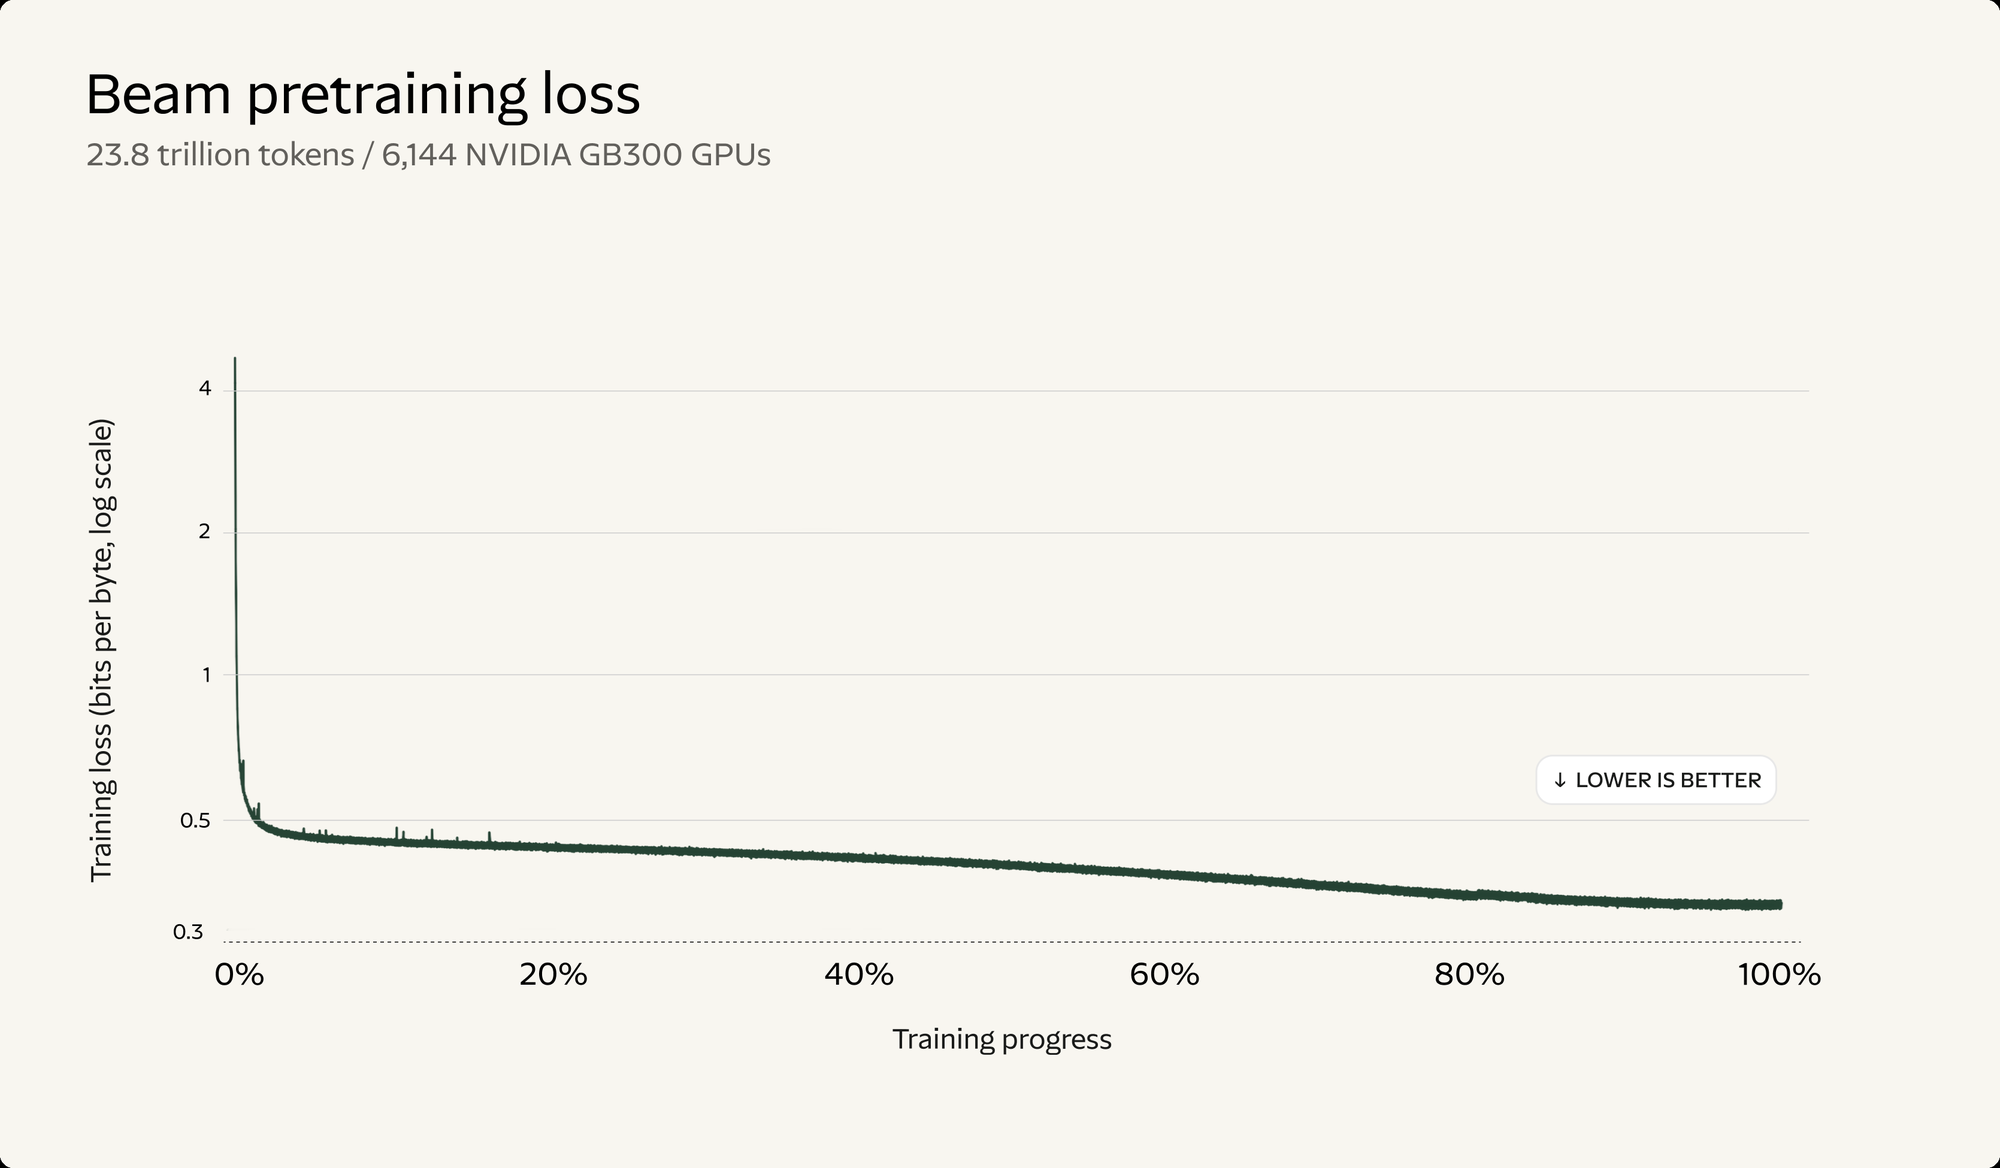 23.8조 토큰, GB300 GPU 6,144개로 진행한 Beam 사전학습의 손실. 불안정 구간이나 회복하지 못한 큰 급등은 없었다. (원문 그림 9)
미드트레이닝
Reflection은 미드트레이닝 단계를 처음부터 고연산 강화학습의 기반이 되도록 설계했다. Beam이 더 어려운 과제에서 배울 수 있도록 지식, 추론, 도구 사용 능력을 갖추게 하는 단계다. Reflection은 다단계 정제 파이프라인을 만들었다. 신중히 고른 실제 사례를 바탕으로 자료를 변형하고, 조합하고, 확장하는 파이프라인이다. 이 파이프라인으로 원시 데이터만으로는 익히기 어려운 능력을 가르치는 학습 데이터를 생성했다. 논리 전개가 긴 추론 중심의 장문 문서도 이 데이터에 포함된다.
컨텍스트 길이도 이 단계에서 100만 토큰으로 늘렸다. 구조화된 코드 저장소, 긴 과제, 품질 높은 장문 문서를 함께 써서, 긴 시퀀스에서 관련 정보를 찾아 기억하고 서로 연결하는 법을 가르쳤다.
안전과 정렬
안전과 정렬을 위해서는 같은 사전학습 체크포인트에서 두 번째 모델을 따로 학습시켰다. 모델이 지켜야 할 원칙을 가르치는 데이터로 별도의 SFT와 강화학습 파이프라인을 거친 모델이다. 그다음 대규모 강화학습 교사 모델과, 안전과 정렬을 전담하는 교사 모델의 능력을 다중 교사 온폴리시 증류(MOPD)로 통합했다.
Reflection은 Beam의 안전과 정렬 원칙을 세 단계로 정리했다.
- Beam이 어겨서는 안 되는 규칙: 안전 정책을 따르고, AI 에이전트라는 정체성을 유지한다.
- 항상 충족해야 할 성질: 주어진 맥락을 활용하고, 정확한 주장을 하고, 불확실성을 인정하고, 사용자의 요청을 투명하게 따른다.
- 상호작용의 기본 스타일: 직설적이고, 철저하고, 효율적이며, 사용자에게 다음에 필요할 것을 미리 헤아린다.
정렬 단계의 강화학습 환경에서는 Beam이 이 원칙을 지키도록 보상을 설계했다. 보상의 상당수는 정답을 자동으로 검증할 수 없어서 생성형 보상 모델이 판정했다. 그런데도 Reflection은 모델의 행동을 예측 가능하게 형성할 수 있었다. 강화학습을 실행하기 전에 보상이 각 행동에 미칠 영향을 미리 계산했고, 이 예측의 상관계수는 0.79로 Best-of-N 상한만으로 예측했을 때의 0.46보다 높았다. 덕분에 루브릭과 보상 설계를 반복해 개선하면서 환각이나 과도한 서식 같은 행동을 억제하고 상호작용 품질을 높였다.
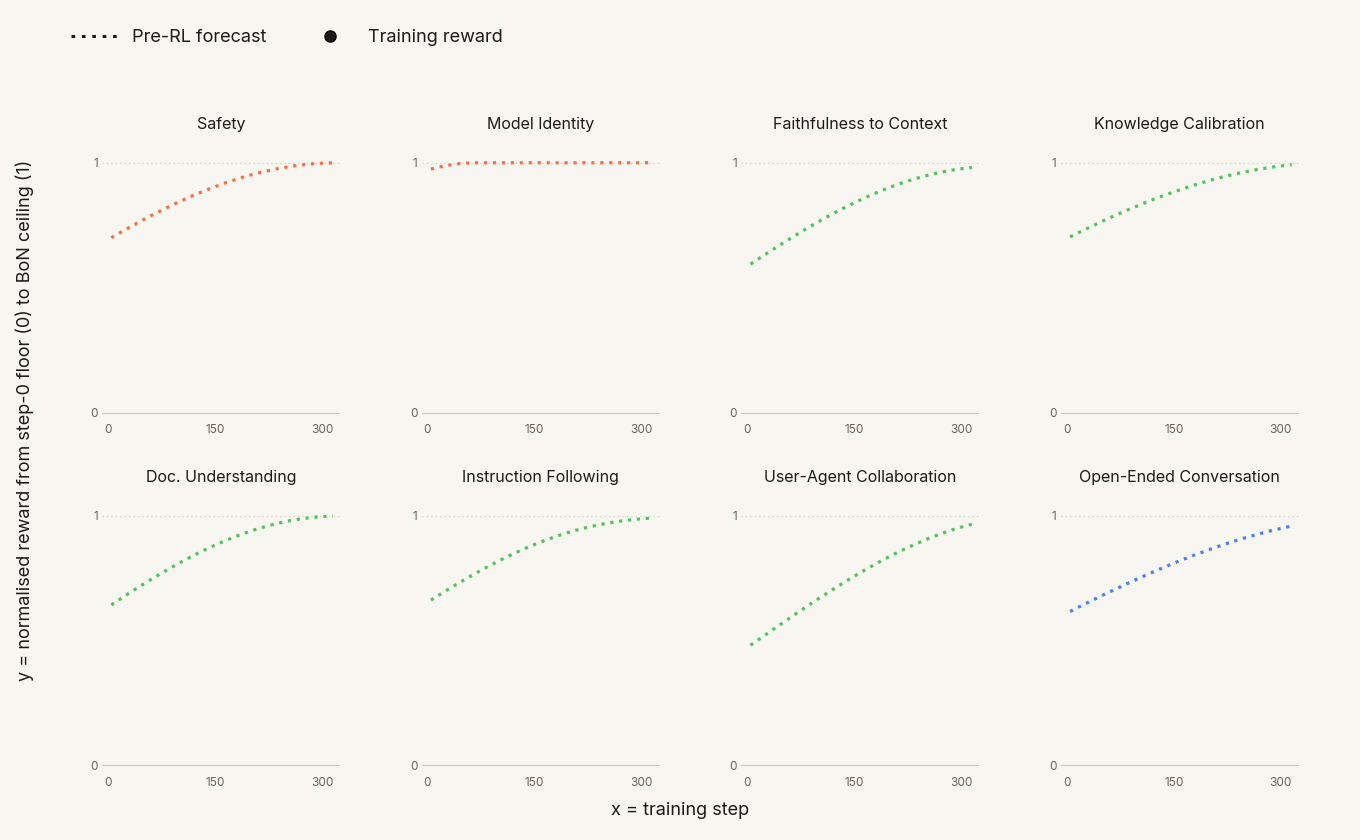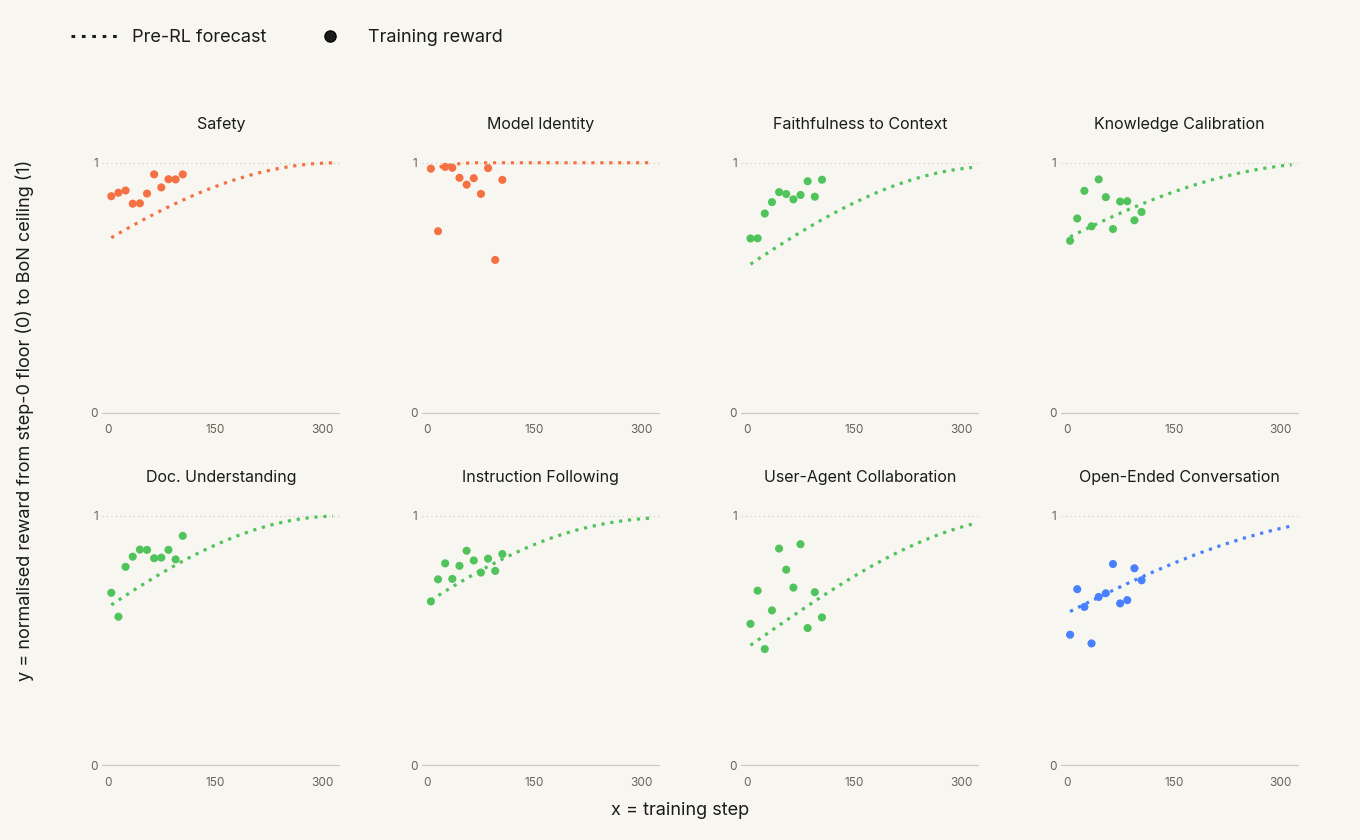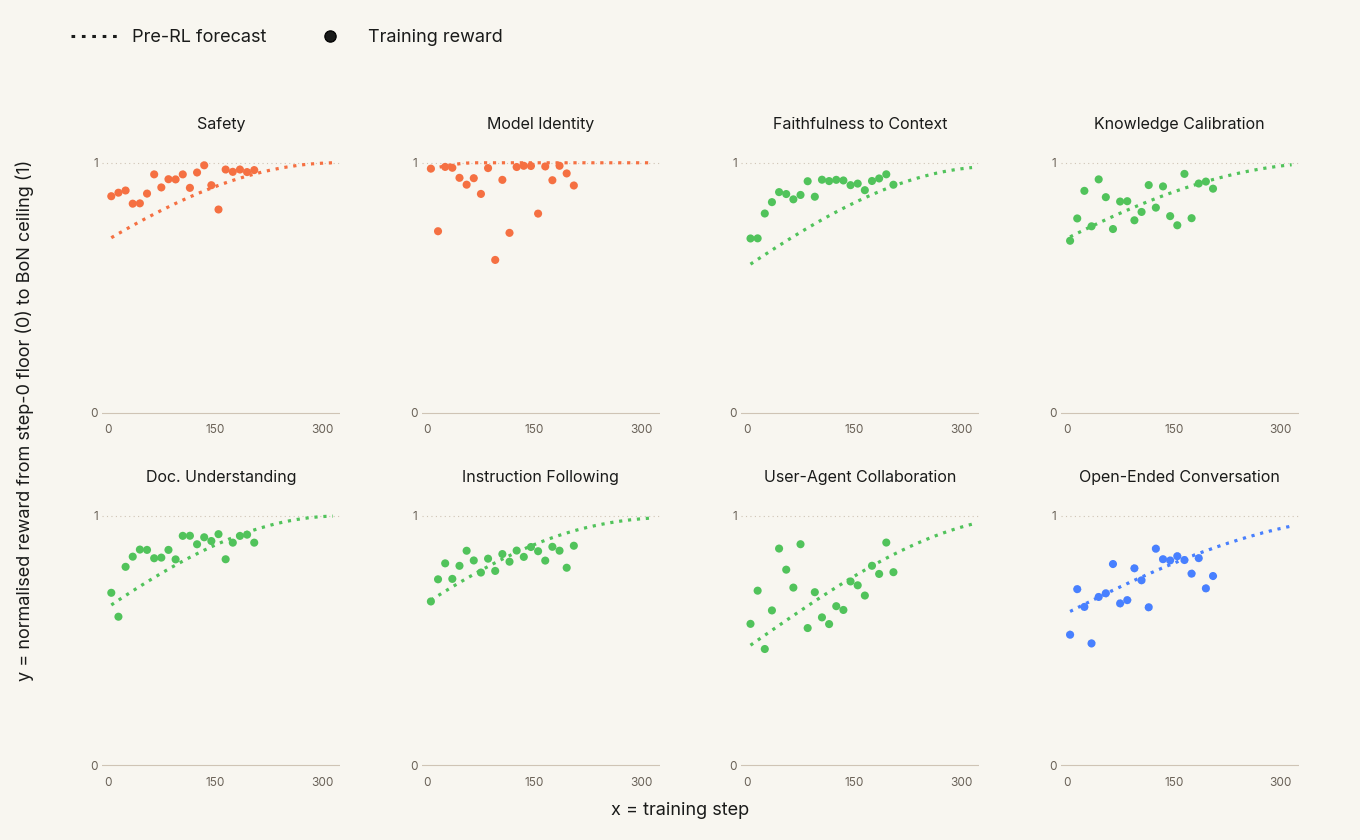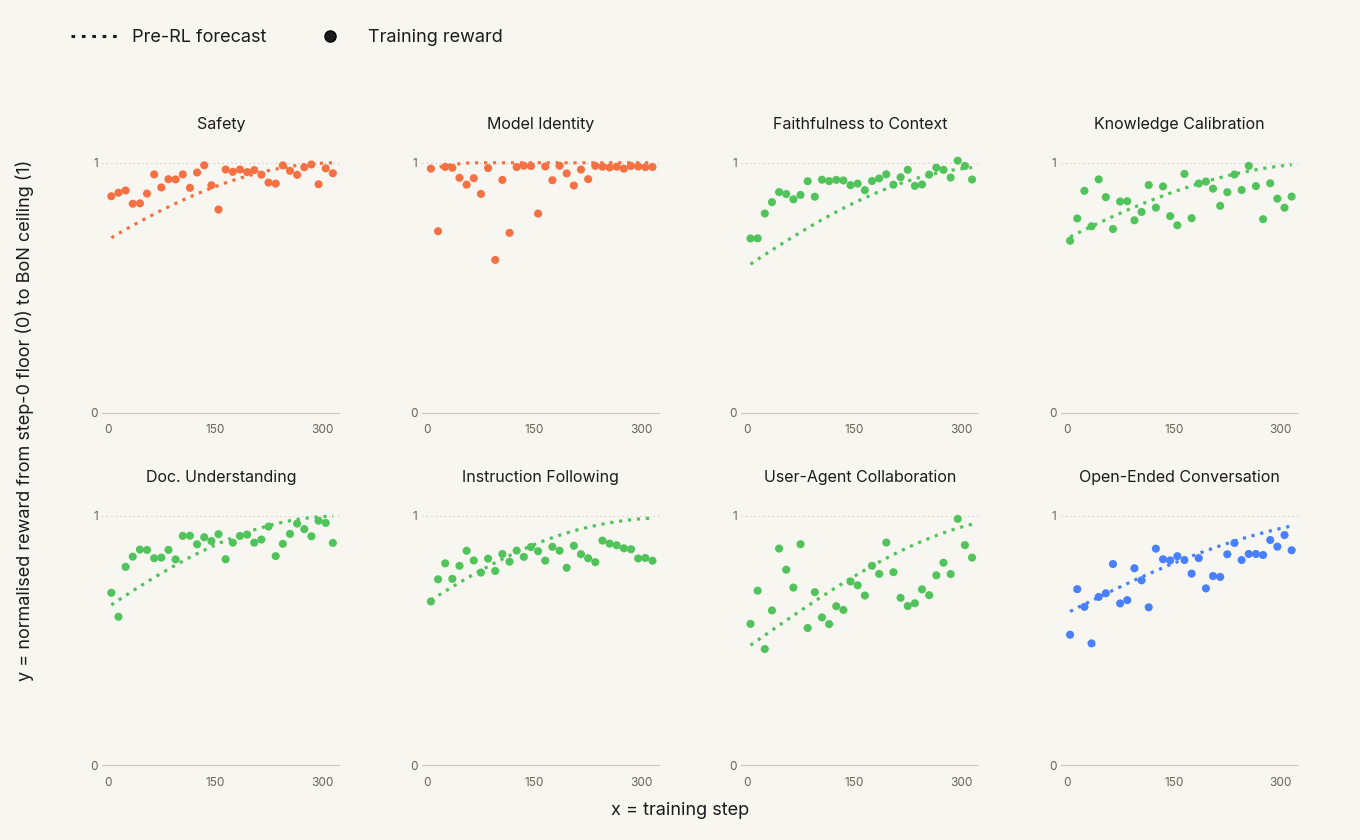 세로축은 0스텝의 보상을 0, Best-of-N 상한을 1로 정규화한 값이다. 강화학습 전 체크포인트에서 세운 예측(점선)이 실제 학습 보상(점)의 개선과 잘 맞았다. (원문 그림 10)
안전 학습에는 안전 정책을 모델의 추론 과정에 직접 포함시키는 숙의 정렬(deliberative alignment) 기법을 썼다.10 데이터셋은 적대적이고 반복적인 방식으로 만들었다. 회차마다 모델을 학습시키고, 그 모델에서 유해한 응답이나 과잉 거절을 유도하는 프롬프트를 생성한 뒤, 성공한 공격을 다음 회차의 SFT 데이터에 추가했다. 안전 강화학습에는 단일 턴, 다중 턴, 탈옥, 에이전트 시나리오를 수집해 썼다. 에이전트 시나리오는 가상의 공격자가 도구를 쓰는 모델에게 위험한 행동을 하도록 압박하는 상황이다. 이 학습의 목적은 과잉 거절과 유해한 순응을 함께 줄이는 것이다.
Reflection은 안전 평가 결과를 기술 보고서에 싣고, 내부에서 개발해 쓴 안전 평가 도구도 오픈소스로 공개할 계획이다. 오픈 생태계가 함께 검사하고 기여할 수 있는 공통 기준을 만들겠다는 취지다.
공개 일정과 다음 모델
이번에 공개한 Beam은 미리보기 버전이다. Reflection은 지금 일부 사용자에게만 Beam을 제공하고, 대기 명단 신청을 받고 있다. 이달 중에는 Apache 2.0 라이선스로 가중치를 공개하고, 모델을 실행하고 평가하고 파인튜닝하는 데 필요한 문서와 전체 스택도 함께 내놓을 예정이다. 출시에 맞춰 여러 배포 파트너와 협력하고 다양한 오픈소스 라이브러리, 하네스와 연동해, 개발자가 기존 오픈소스 워크플로에서 Beam을 쓸 수 있게 한다.
Beam은 시리즈의 첫 모델이다. Reflection은 다음 모델을 이미 학습시키고 있으며, 새 모델을 낼 때마다 오픈 모델과 최고 수준 모델 사이의 성능 격차를 줄이겠다고 밝혔다.
원문 비교표의 맨 오른쪽 열
원문 비교표 맨 오른쪽 열의 점수를 보고, 나는 본문에서 DeepSeek라는 이름을 다시 찾아봤다. DeepSeek V4.1 Flash는 DeepSWE 74.2, Terminal Bench v2.1 90.6으로 두 항목 모두 표에서 가장 높은 점수를 받았다. 그런데 원문의 본문은 이 모델을 한 번도 언급하지 않는다. 원문이 비교 대상으로 이름을 든 모델은 GLM 5.2, Qwen 3.8 Max, Kimi K3다.
표의 모델을 개발사 국적으로 구분해 보면, Beam의 성적은 미국 모델을 상대할 때와 중국 모델을 상대할 때 크게 다르다. 미국 회사의 오픈 모델은 Thinking Machines의 Inkling과 NVIDIA의 Nemotron 3 Ultra다. Beam은 두 모델과 점수가 함께 보고된 모든 항목에서 더 높다. SWE Bench Pro v2-Hard에서는 Inkling보다 20점 이상 높고, Terminal Bench에서는 Nemotron 3 Ultra보다 24점 가까이 높다. 반면 중국 회사의 모델은 GLM 5.2를 제외한 넷(GLM 5.3, Kimi K3, Qwen 3.8 Max, DeepSeek V4.1 Flash)이 Beam과 함께 보고된 모든 항목에서 Beam보다 높다. GLM 5.2도 세 항목 가운데 한 항목에서는 Beam보다 높았다. 「서방 오픈웨이트 모델의 최고 성능을 새로 기록했다」는 소개의 근거는 미국 오픈 모델과의 비교다.
연산 효율 그림의 비교 대상에도 GLM 5.3, Kimi K3, DeepSeek V4.1 Flash는 없다. 그림에 함께 실린 모델은 Inkling, Nemotron 3 Ultra, Muse Glimmer, GLM 5.2, Qwen 3.8이다. 중국 오픈 모델과 비교할 때 Reflection이 근거로 내놓은 것은 이 효율 그림인데, 표에서 Beam보다 점수가 높은 중국 모델 넷 가운데 셋은 그림에 없다. 이달 중 가중치와 기술 보고서가 나오면, 그 모델들과 같은 기준으로 잰 효율 수치도 확인할 수 있을 것이다.
출처
Reflection AI, 「Introducing Beam: Reflection’s 501B open-weight model」, 2026년 10월 5일. 원문: https://reflection.ai/blog/introducing-beam 조기 사용 신청: https://platform.reflection.ai/
Reflection AI는 2024년 3월 구글 딥마인드 출신의 Misha Laskin과 Ioannis Antonoglou가 세운 회사다. 딥마인드에서 Laskin은 Gemini의 보상 모델 개발을, Antonoglou는 Gemini의 사후 학습을 이끌었다. Antonoglou는 AlphaGo를 함께 만든 연구자이기도 하다. Beam은 이 회사가 공개한 첫 모델이다. ↩︎
GLM 5.3은 DeepSWE v1.1과 SWE Atlas Codebase QnA에서 모두 61.0, Kimi K3는 두 항목에서 모두 68.0이다. 원문 표의 수치를 그대로 실었다. ↩︎
Reflection은 생성 연산량을 「2 × 활성 파라미터 수 × 시도당 평균 생성 토큰 수」로 추정했다. 곱셈과 덧셈 한 쌍을 연산 두 번으로 세고, 생성 토큰에는 추론 과정과 최종 답을 모두 포함했다. MoE 모델은 전체 크기 대신 토큰당 활성 파라미터 수를 썼다. 프롬프트 사전 처리(prefill), 컨텍스트 길이에 따른 어텐션 연산, 서빙 부가 비용은 계산에 포함하지 않았다. 따라서 Reflection은 이 값이 실측 비용과 차이가 있는 근사 비교라고 밝혔다. 다른 모델의 점수는 Artificial Analysis와 DataCurve의 자료에서 가져왔다. ↩︎
롤아웃은 모델이 강화학습 환경에서 과제 하나를 처음부터 끝까지 수행한 기록이다. 이 기록을 채점한 결과가 보상이 된다. ↩︎
원문은 「추론 전문가(reasoning expert)」가 무엇인지 따로 설명하지 않는다. 안전과 정렬 절에서 대규모 강화학습 교사 모델과, 안전과 정렬을 전담하는 교사 모델을 증류로 통합했다고 설명하므로, 앞의 교사 모델로 추정된다. ↩︎
원문 본문은 정확도를 「66.5%」 높였다고 썼다. 시연 화면의 노트북 출력을 보면 파인튜닝 후 완전 일치 정확도가 0.6750, 향상폭이 +66.50 pp다. 따라서 66.5는 퍼센트포인트 기준이며, 계산하면 파인튜닝 전 정확도는 약 1%였다. 노트북에서 저장한 모델 이름은 gemma4-e2b다. ↩︎
DeepSeek-AI et al.(2024), DeepSeek-V3 기술 보고서. 부하 분산용 보조 손실을 학습 목표에 더하는 대신, 전문가마다 편향값을 둔다. 부하가 많은 전문가의 편향값은 낮추고, 부하가 적은 전문가의 편향값은 높여 라우팅을 조정한다. https://arxiv.org/abs/2412.19437v2 ↩︎
사일런트 데이터 손상(silent data corruption)은 하드웨어 결함이 오류 신호 없이 계산 결과를 바꾸는 현상이다. ↩︎
Reflection이 정의한 굿풋은 전체 경과 시간 가운데, 최종 모델에 반영된 학습 스텝에 쓴 시간의 비율이다. ↩︎
Guan et al.(2024), 「Deliberative Alignment: Reasoning Enables Safer Language Models」. 모델이 응답하기 전에 안전 정책의 내용을 직접 떠올리고 그 내용을 근거로 추론하도록 학습시키는 방법이다. https://arxiv.org/abs/2412.16339 ↩︎