3줄 요약
- Alex Wang이 2026년 11월 8일 발표한 이 글은 대규모 언어 모델의 추론(reasoning)을 토큰 공간의 경로 탐색(pathfinding)으로 정의하고, 강화학습이 최적화하는 목적함수를 수식으로 풀어낸다.
- 개별 사고 사슬(Chain of Thought)은 길어진다고 해서 정답에 수렴한다는 보장이 없다. 검증 가능한 보상을 쓰는 강화학습(RLVR)은 정답 집합에 속하는 경로가 뽑힐 성공 확률 $p_x$를 극대화한다.
- 강화학습은 추론할 때마다 여러 경로를 뽑아야 하는 탐색 비용을 훈련 단계에서 미리 치러 가중치에 상각(amortization)해 둔다. 저자는 이 해석으로 불충실한 사고 사슬과 보상 해킹이 생기는 이유도 함께 풀이한다.
문제 제기: 더 오래 생각하면 항상 답이 좋아지는가
추론 모델을 설명할 때 흔히 쓰는 직관은 모델이 더 오래 생각할수록 정답을 맞힐 확률이 높아진다는 것이다. 강화학습(RL) 훈련 과정을 관찰하면 실제로 모델이 점점 더 긴 사고 사슬(Chain of Thought)을 쓰게 되고, 정확도도 함께 오른다.
하지만 이미 훈련을 마친 모델을 가져와서 단일 사고 사슬을 억지로 더 길게 이어 가게 하면 양상이 달라진다. 모델이 생성을 멈추려 할 때마다 “Wait” 같은 토큰을 덧붙여 추론을 연장하면 처음에는 정확도가 오르다가 곧 정체된다.1 과제에 따라서는 추론이 길어질수록 도리어 정확도가 떨어지는 과잉 추론(overthinking) 현상이 나타나기도 한다.2
만약 개별 사고 사슬이 어떤 목적함수의 최적점에 수렴하는 과정이라면, 추론 단계를 더 밟는다고 해서 결과가 나빠질 이유가 없다. Alex Wang은 이 모순을 풀기 위해 추론을 토큰 공간의 경로 탐색(pathfinding)으로 다시 정의한다.
토큰 공간의 경로 탐색과 성공 확률
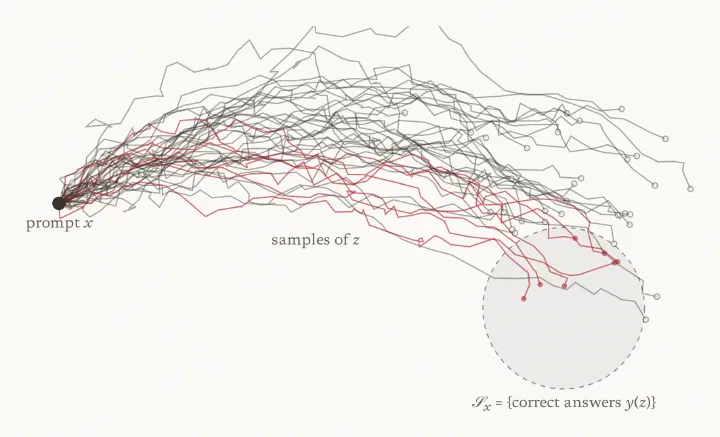
추론 모델에 똑같은 수학 문제를 열 번 물으면 열 가지 서로 다른 사고 사슬이 나온다. 예를 들어 “1부터 10까지 더하면 얼마인가?”라고 묻는다고 하자. 숫자를 앞에서부터 차례대로 더해 1, 3, 6, 10을 거쳐 55를 구하는 경로가 있다. 양끝 숫자를 짝지으면 1과 10, 2와 9, 3과 8, 4와 7, 5와 6의 합이 각각 11이므로, 다섯 쌍을 합쳐 55를 구하는 경로도 있다.
이를 일반화하면, 모델이 시작점인 프롬프트 $x$에서 토큰들의 경로 $z$를 생성해 최종 답 $y(z)$에 이르는 과정으로 볼 수 있다. 최종 답 $y$가 맞으면 1, 틀리면 0을 돌려주는 검증기(verifier) $r(x, y)$가 있다고 가정하자. 그러면 프롬프트 $x$의 정답 집합 $\mathcal{S}_x$는 다음과 같이 정의된다.
$$ \mathcal{S}_x = \{y : r(x, y) = 1\} $$
모델이 프롬프트 $x$에서 경로 $z$를 생성할 확률을 $\pi(z \mid x)$라 하자. 정답 집합 $\mathcal{S}_x$로 이어지는 경로는 여러 개다. 따라서 모델이 한 번 생성해 정답을 맞힐 성공 확률(success probability) $p_x$를 구하려면, 정답 집합에 속하는 최종 답을 내놓는 모든 경로의 생성 확률을 더하면 된다.
$$ \begin{aligned} p_x &= \mathbb{P}(y(z) \in \mathcal{S}_x \mid x) \\ &= \sum_{z} \pi(z \mid x)\, \mathbb{I}[y(z) \in \mathcal{S}_x] \\ &= \sum_{z \,:\, y(z) \in \mathcal{S}_x} \pi(z \mid x) \end{aligned} $$성공 확률 $p_x$가 높아지는 양상은 두 가지다. 정답으로 이어지는 여러 경로에 작은 확률을 고루 배분할 수도 있고, 단 하나의 경로에 매우 높은 확률을 집중시킬 수도 있다. 성공 확률 수식은 두 방식을 구분하지 않는다.3
성공 확률을 높이는 방법
| 접근 방식 | 가중치 $\theta$ 변경 여부 | 계산 비용이 투입되는 시점 | 성공 확률을 높이는 원리 |
|---|---|---|---|
| Best-of-$k$ 샘플링 | 고정 | 추론 시점 (질문마다 $k$회 생성) | 한 번 뽑았을 때의 성공 확률 $p_x$는 그대로 두고, $k$번 시도해 적어도 한 번 성공할 확률을 $1 - (1 - p_x)^k$로 높인다. |
| 기각 샘플링 파인튜닝 (STaR) | 업데이트 | 훈련 시점 | 여러 경로를 샘플링해 $\mathcal{S}_x$에 도달한 경로만 골라 지도학습(SFT)을 반복함으로써 $p_x$를 높인다. |
| 이진 보상 강화학습 (RLVR / REINFORCE) | 업데이트 | 훈련 시점 | $N$개 중 성공한 $M$개 경로의 평균 로그 우도 경사에 현재 성공률 $M/N$을 곱해 업데이트함으로써 $p_x$를 직접 극대화한다. |
Best-of-$k$ 샘플링
모델 $\pi$의 가중치를 고정한 상태에서도 정답 집합 $\mathcal{S}_x$에 속하는 경로가 나올 때까지 여러 번 샘플링하면 성공 확률을 높일 수 있다. 검증기가 있다고 가정했으므로 Best-of-$k$ 샘플링을 쓸 수 있다. 경로를 $k$개 뽑아 그중 하나라도 성공하는지 확인하는 방식이다.
개별 경로가 실패할 확률이 $1 - p_x$이고 $k$개의 경로가 모두 실패할 확률은 $(1 - p_x)^k$다. 따라서 $k$개 경로 중 적어도 하나가 정답 집합 $\mathcal{S}_x$에 도달하는 사건을 $\text{성공}_k$라 하면, 그 확률은 다음과 같다.
$$ \mathbb{P}(\text{성공}_k \mid x) = 1 - (1 - p_x)^k $$$p_x > 0$이기만 하면 샘플 수 $k$를 늘릴수록 성공 확률은 단조 증가한다(Brown et al. 2024). Best-of-$k$는 개별 경로의 길이(더 오래 생각하기)를 고정한 채 샘플 개수 $k$만 늘려 연산량을 쓴다.
강화학습으로 더 나은 샘플 생성하기
모델 가중치 $\theta$를 직접 수정해 한 번 뽑았을 때의 성공 확률 $p_x$를 높일 수도 있다. 가장 직관적으로는 정답 여부를 확인할 수 있는 프롬프트를 많이 모은 뒤, 프롬프트마다 여러 경로를 샘플링해 $\mathcal{S}_x$에 도달한 성공 경로만 남긴다. 그리고 그 경로들로 모델을 다시 학습(파인튜닝)하는 과정을 반복한다. 이를 기각 샘플링 파인튜닝(rejection-sampling fine-tuning)이라 부르며, 초기 추론 모델 학습 기법인 STaR가 이 방식을 사용했다.
오늘날 추론 모델 훈련에 쓰는 RLVR(검증 가능한 보상 기반 강화학습, RL with verifiable reward)도 수학적으로 이와 거의 같은 일을 한다. 가중치가 $\theta$인 모델 $\pi_\theta$에서 $y(z) \in \mathcal{S}_x$일 때만 보상 $r(x, y(z)) = 1$이므로, 기대 보상은 곧 성공 확률 $p_x$와 일치한다.
$$ \begin{aligned} p_x &= \sum_{z \,:\, y(z) \in \mathcal{S}_x} \pi_\theta(z \mid x) \\ &= \sum_{z} \pi_\theta(z \mid x)\, r(x, y(z)) \\ &= \mathbb{E}_{z \sim \pi_\theta}[r(x, y(z))] \end{aligned} $$
여기에 로그 미분 트릭(log-derivative trick)을 적용해 성공 확률 $p_x$의 경사(gradient)를 구하면 정책 경사(policy gradient), 즉 REINFORCE 추정치가 나온다.
$$ \begin{aligned} \nabla_\theta\, p_x = \mathbb{E}_{z \sim \pi_\theta}\!\Big[&r(x, y(z)) \\ &\cdot \nabla_\theta \log \pi_\theta(z \mid x)\Big] \end{aligned} $$이 경사를 $N$개의 샘플 경로 $z_1, \dots, z_N$으로 추정해 보자. 실패한 경로는 $r = 0$이므로 식에서 사라지고, 성공한 $M$개의 경로만 $r = 1$로 남는다.
$$ \begin{aligned} &\nabla_\theta\, p_x \approx \frac{1}{N} \sum_{i:\text{성공}} \nabla_\theta \log \pi_\theta(z_i \mid x) \\ &= \underbrace{\frac{M}{N}}_{\text{성공률}} \!\cdot\! \underbrace{\frac{1}{M} \sum_{i:\text{성공}} \nabla_\theta \log \pi_\theta(z_i \mid x)}_{\text{성공 경로 평균 경사}} \end{aligned} $$즉 이진 보상을 쓰는 REINFORCE의 한 스텝은, 모델이 스스로 샘플링한 경로 중 성공한 경로들로 지도학습(SFT)을 하는 것과 같다. 이때 학습 보폭은 현재의 경험적 성공률 $M/N$에 비례한다.
강화학습 훈련 중에 사고 사슬이 점점 길어지는 이유도 이 수식에서 드러난다. 매 훈련 스텝은 성공한 경로들의 생성 확률을 높이는 방향으로 모델을 업데이트한다. 만약 성공한 경로들이 실패한 경로보다 평균적으로 더 길었다면, 모델은 자연스럽게 더 긴 경로를 작성하도록 학습된다. 성공 경로가 더 긴 것은 중간에 풀이를 되돌아보는 역추적(backtracking)이 포함됐거나 환경에서 피드백을 더 많이 받았기 때문일 수 있다. 단순히 길게 생성한 경로가 우연히 정답에 도달한 경우도 있다.
탐색 비용의 상각과 일반화
강화학습 훈련 단계에서는 막대한 연산량을 들여 수많은 경로를 샘플링하고 그중 정답에 이르는 경로를 찾아내, 모델이 그 경로를 직접 생성하도록 학습시킨다. 훈련이 끝난 뒤에는 추론할 때마다 여러 경로를 반복해서 샘플링하느라 드는 연산 비용 없이도, 한 번 생성하는 것만으로 높은 확률로 정답을 얻을 수 있다.
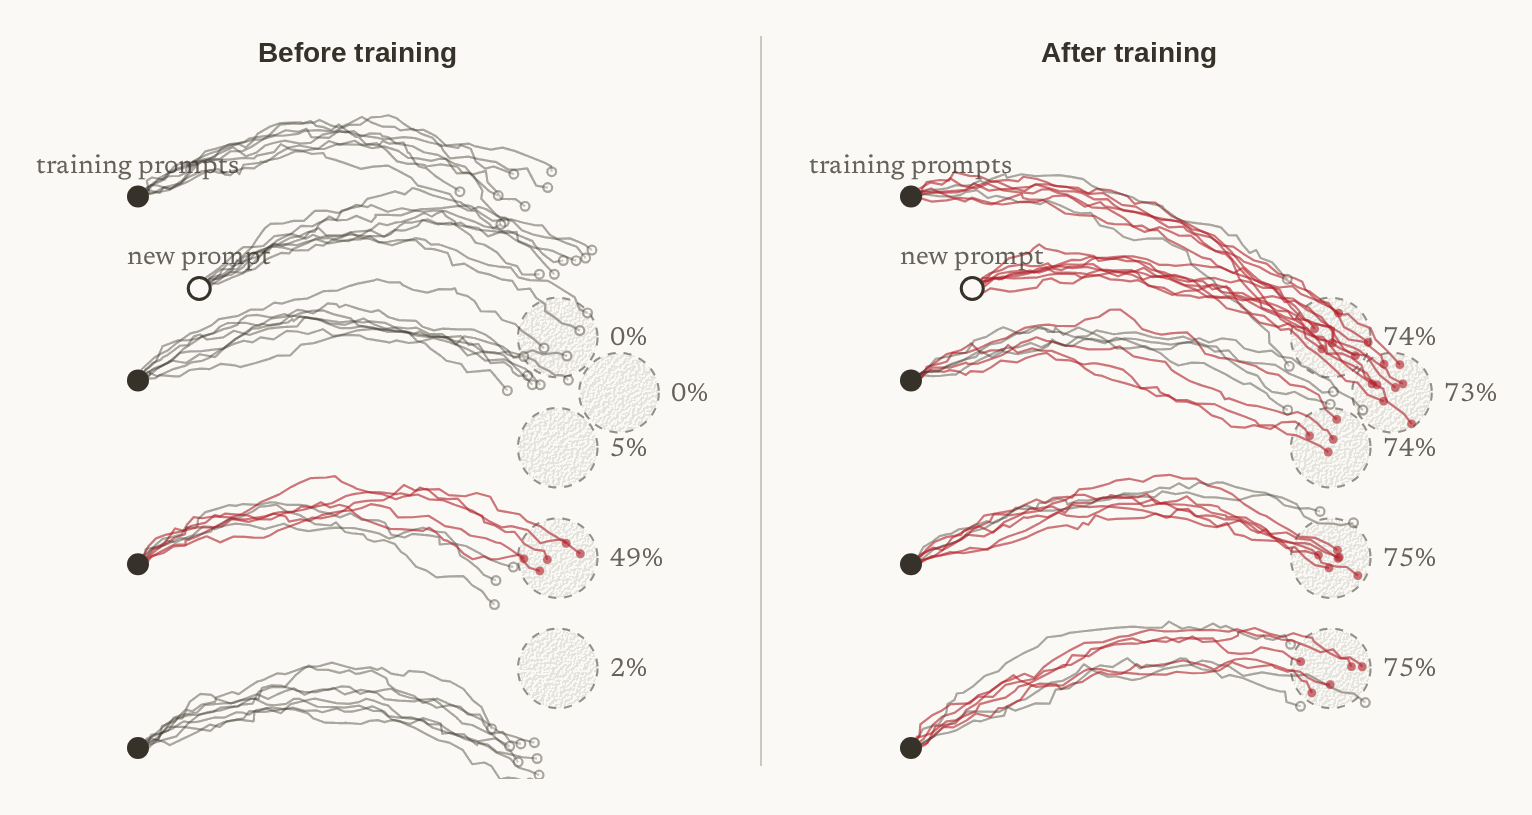 훈련 프롬프트 네 개(색칠된 점)와 훈련에 쓰지 않은 새 프롬프트(빈 점)에서 출발한 경로. 왼쪽은 훈련 전, 오른쪽은 훈련 후. 원문: Alex Wang (2026)
추론할 때마다 들 탐색 비용을 훈련 단계에서 미리 치러 가중치에 반영하므로, 저자는 이를 탐색 비용의 상각(amortization)이라 부른다.4 위 도식을 보면 훈련 전에는 각 프롬프트에서 출발한 경로들이 흩어져 정답 도달률이 낮지만, 성공한 경로들만 추려 학습한 뒤에는 경로들이 각각의 정답 영역으로 수렴한다. 한 모델을 다양한 프롬프트로 훈련했기 때문에, 훈련 데이터에 없던 새 프롬프트(빈 점)도 훈련 프롬프트와 분포가 비슷하면 성공률이 높고 분포가 다를수록 정확도가 점차 떨어진다.
경로 탐색 관점으로 본 추론 모델의 특징
Alex Wang은 추론 모델을 어떤 프롬프트 $x$를 받아도 $\mathcal{S}_x$에 도달하도록 훈련한 확률 분포로 본다. 추론 모델에서 나타나는 두 가지 독특한 현상도 이 관점에서 자연스럽게 풀린다.
| 현상 | 기존 직관에서의 의문 | 경로 탐색 및 $p_x$ 최적화 관점의 설명 |
|---|---|---|
| 불충실한 사고 사슬 (Unfaithful CoT) | 정답을 맞혔는데 왜 중간 풀이 과정은 논리적으로 어긋나거나 실제 계산 과정을 반영하지 않는가? | 검증기 $r(x, y)$는 최종 답 $y(z) \in \mathcal{S}_x$ 여부만 채점한다. 중간 토큰 $z$가 참이거나 답의 인과적 근거여야 한다는 조건이 목적함수에 없다. |
| 보상 해킹 (Reward hacking) | 강화학습 규모와 추론 길이를 늘릴수록 왜 모델이 의도하지 않은 편법 답안을 더 자주 찾아내는가? | 불완전한 검증기가 수용하는 영역 $\mathcal{S}_x$에 오답 지름길이 포함되면, 샘플 수와 길이를 늘려 검증기를 넓게 탐색(fuzzing)할수록 이 지름길 경로가 발견돼 학습에 반영된다. |
사고 사슬의 충실성은 보장되지 않는다
앞서 정의한 검증기는 최종 답이 정답 집합 $\mathcal{S}_x$에 속하면 1, 속하지 않으면 0의 보상을 준다. 중간 토큰 경로 $z$는 모델이 최종 답에 이르는 데 쓰는 중간 수단일 뿐이다. 사전학습에서 익힌 언어 패턴 덕분에 중간 추론 내용과 최종 답이 서로 연관되는 경우가 많다. 그러나 보상 함수에는 중간 토큰이 참이어야 한다거나 뒤따르는 답을 올바르게 설명해야 한다는 제약이 전혀 없다. 의미 있고 충실한 사고 사슬을 얻으려면 보상 함수나 훈련 목적함수를 수정해야 한다.
보상 해킹은 검증기와 샘플러 양쪽에서 비롯된다
이론적 수식에서는 검증기가 완벽해 $y$가 실제 정답일 때만 $r(x, y) = 1$을 돌려준다고 가정했다. 반면 실제 환경의 검증기는 불완전할 수 있다. 이 경우 검증기가 정답으로 인정하는 집합 $\mathcal{S}_x$는 실제 정답 집합과 일치하지 않으며, 일부 정답을 누락하거나 실제로는 오답인 결과를 포함한다.
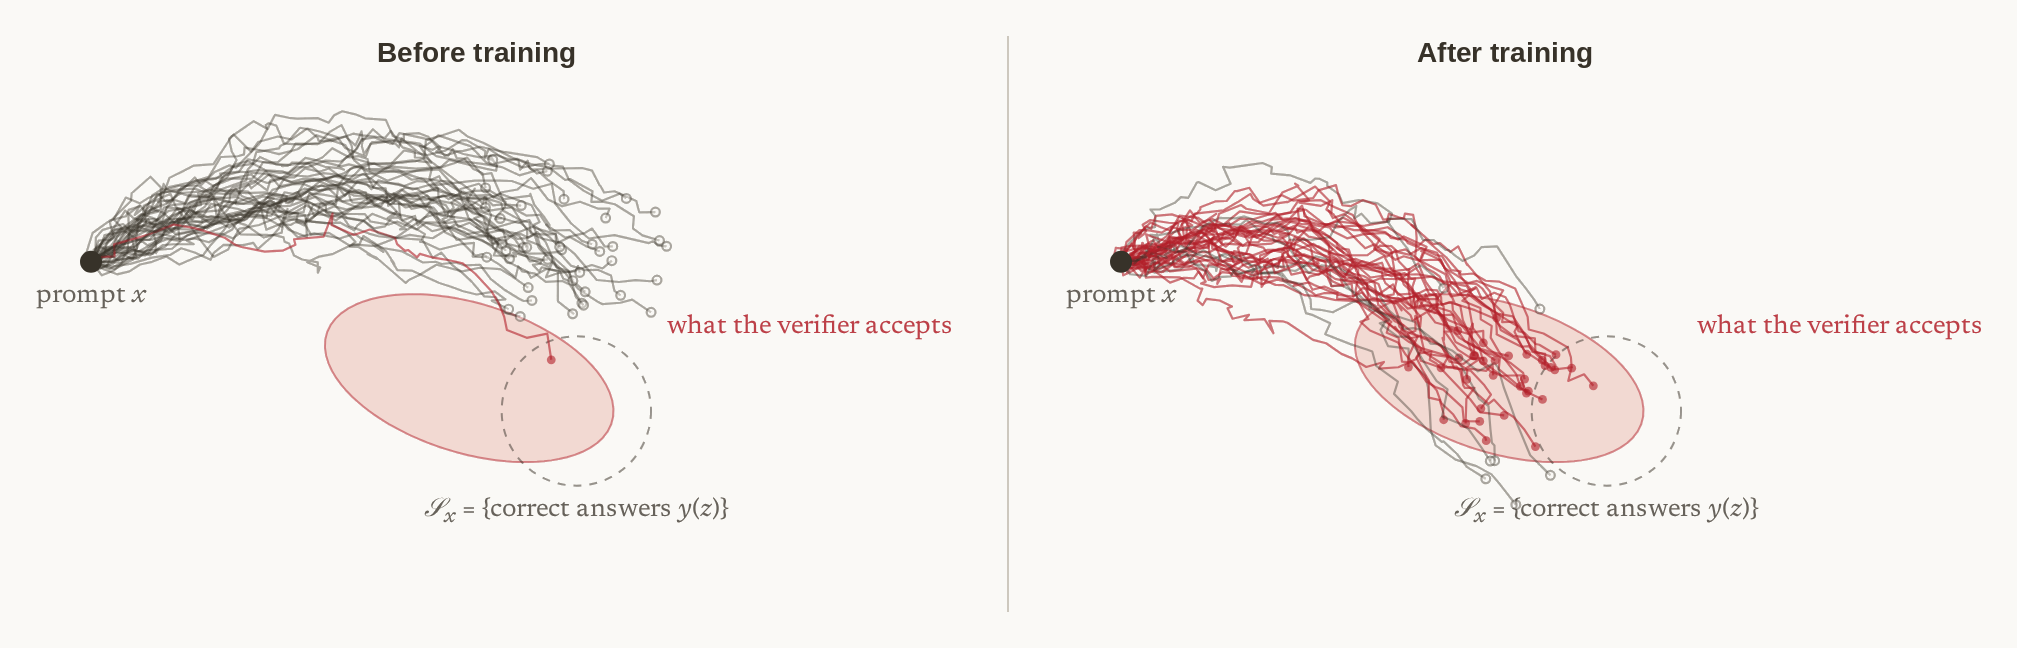 검증기가 받아 주는 영역 $\mathcal{S}_x$(붉은 타원)와 실제 정답 집합(점선 원). 왼쪽은 훈련 전, 오른쪽은 훈련 후. 원문: Alex Wang (2026)
위 도식에서 붉은 타원이 시작 프롬프트 방향으로 길게 뻗어 있기 때문에, 모델 입장에서는 실제 정답보다 잘못 지정된 오답 영역(지름길)에 도달하기가 훨씬 쉽다. 그 결과 훈련이 진행되면 대부분의 경로가 오답 지름길로 수렴하고 실제 정답에는 이르지 못한다.
강화학습 규모를 늘려 더 많은 샘플과 더 긴 경로를 생성할수록 보상 해킹이 더 빈번해지는 까닭도 마찬가지다. 검증기를 더 넓게 탐색(fuzzing)할수록 잘못 지정된 $\mathcal{S}_x$ 영역에 이르는 경로를 발견할 확률이 높아지기 때문이다. 게다가 지름길을 한 번 발견하면, 정책 경사 업데이트로 모델의 분포가 그 지름길에 빠르게 집중된다.
결론: 추론은 어떤 목적함수를 풀고 있는가
추론 시점에 생성되는 개별 사고 사슬은 단독으로 어떤 목적함수를 최적화하지 않으며, 단계가 길어진다고 해서 정답에 수렴한다는 보장도 없다. 경로들의 확률 분포 전체에 걸쳐 평균을 냈을 때만 높은 성공 확률 $p_x$를 얻는다.
강화학습 훈련은 많은 연산량을 들여 성공 경로를 찾아내고 모델이 이를 재현하도록 학습시킴으로써 성공 확률 $p_x$를 직접 높인다. 추론 모델은 강화학습 훈련 중에 추가 토큰으로 정답 경로를 찾는 비용을 가중치에 미리 상각해 두었다. 추론 모델이 더 길게 생각할 때 성능이 좋아지는 것은 이 상각 덕분이다.
가장 흥미로운 지점
내가 이 글에서 가장 감탄한 대목은 REINFORCE의 정책 경사 추정치를 둘로 분해한 식이다. 성공률 $M/N$과 성공 경로들의 평균 로그 우도 경사를 곱한 꼴이다. 추론 시점의 계산량 확장(test-time compute scaling)을 다룬 논의는 흔히 모델이 추론하는 동안 실시간으로 탐색이나 최적화를 한다고 묘사한다. 하지만 실제 작동 원리는 훨씬 단순하다. 모델은 훈련 단계에서 대규모 기각 샘플링으로 찾아내 가중치에 반영한 경로를 추론할 때 그대로 재생한다.
그런 까닭에 훈련에서 익힌 길이보다 더 길게 “Wait”를 억지로 붙여 추론을 늘린다고 해서 최적점에 더 가까워지지는 못한다. 보상 해킹을 다룬 마지막 도식도 불완전한 검증기와 대규모 샘플링이 맞물릴 때 왜 오답 지름길로의 수렴이 가속되는지 한눈에 납득시켜 주어 특히 명쾌했다.
출처
Alex Wang, “What objective is reasoning solving?”, alexwang.ai, 2026-11-08. 원문: https://alexwang.ai/posts/reasoning-as-pathfinding/
치비 서소영 삽화 3장은 「느낌적인 느낌을 숫자로 옮기는 일」의 라인아트를 참조해 gpt-image-2.6-flare로 따로 생성했다.
Muennighoff et al. (2025), “s1: Simple test-time scaling”. 모델이 추론을 멈추려 할 때 “Wait”를 덧붙여 생각을 이어 가게 한 실험에서 정확도는 처음에만 오르다가 이내 평탄해졌다. ↩︎
Gema et al. (2025), “Inverse Scaling in Test-Time Compute”. 이 논문은 추론 길이가 길어질수록 정확도가 하락하는 과제들을 실험으로 보고했다. ↩︎
실제 응용에서는 특정 형태의 경로를 우선시하거나 샘플의 다양성을 유지해야 할 때가 있는데, 저자는 이 주제를 후속 글에서 다룰 수 있다고 덧붙인다. ↩︎
비싼 탐색으로 더 나은 답을 찾은 뒤 신경망이 그 답을 바로 출력하도록 학습시키는 상각 기법은 언어 모델 밖에서도 널리 쓰인다. AlphaZero는 자가 대국에서 수를 둘 때마다 트리 탐색을 하고, 찾아낸 수를 정책 신경망이 선호하도록 학습시킨다(전문가 반복, Expert Iteration과 같은 원리). 물리학과 기상 예측에서는 고비용 시뮬레이터로 구한 결과를 신경망이 직접 예측하도록 훈련한다. ↩︎