3줄 요약
- 독립 연구자 Divyansh Agrawal이 2026년 10월 22일 Qwenputer를 공개했다. Qwen3.5-4B 모델의 가중치에 결정론적 32비트 RISC-V CPU를 직접 컴파일해 넣은 실험 모델이다.
- Gated DeltaNet 선형 어텐션 레이어에서 게이트와 쓰기 강도를 모두 1로 고정하고 원-핫 키와 쿼리를 쓰면, 어텐션 상태 행렬이 정확한 RAM으로 작동한다. 기존 레이어 32개 앞단에 추가한 레이어 11개는 순전파 디코딩만으로 산술 연산과 C, MicroPython 코드를 실행하고 실험적 파일시스템도 제공한다.
- Qwenputer는 추가 사후학습이나 외부 파이썬 도구 없이 NUPA 장정수 연산 정확도를 기본 모델의 48.6%에서 100%로 높였다. 명령어 1,800만 개를 연속 실행하고 출력 토큰 23만 개를 대조한 검증에서도 오류는 0건이었으며, 하이브리드 모델이 추론을 숨길 수 있는지나 감시 도구를 가중치에 내장할 수 있는지 확인하는 연구에도 쓰인다.
외부 도구 없이 순전파만으로 작동하는 가중치 내장형 CPU
대규모 언어 모델이 복잡한 산술 연산이나 코드를 정확히 처리하도록 만들 때는 보통 외부 파이썬 인터프리터나 샌드박스 런타임을 도구로 연결한다. Divyansh Agrawal이 공개한 Qwenputer는 외부 런타임이나 플러그인, 도구 서버를 하나도 호출하지 않는다. 대신 기본 Qwen3.5-4B 모델의 가중치에 결정론적(deterministic) RISC-V CPU를 통째로 컴파일해 넣었다. 모델이 토큰을 생성하는 순전파(forward pass) 과정만으로 사칙연산과 C 코드, MicroPython 프로그램을 직접 실행한다.
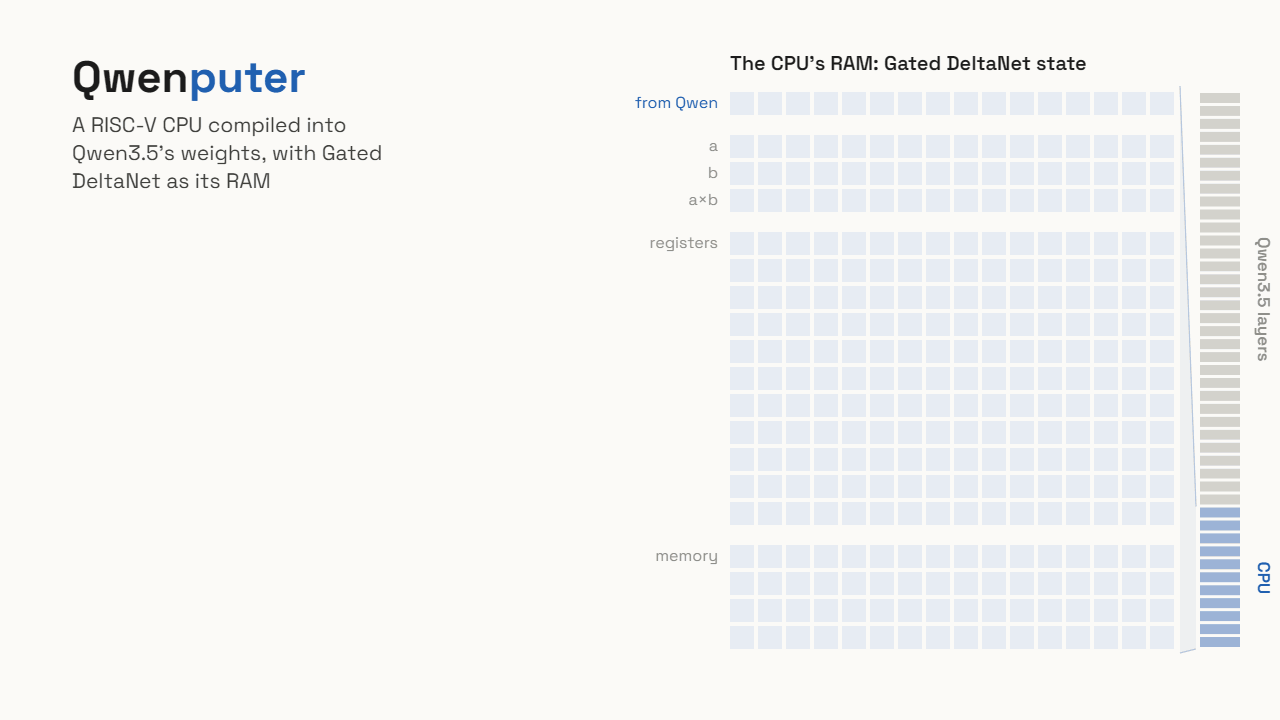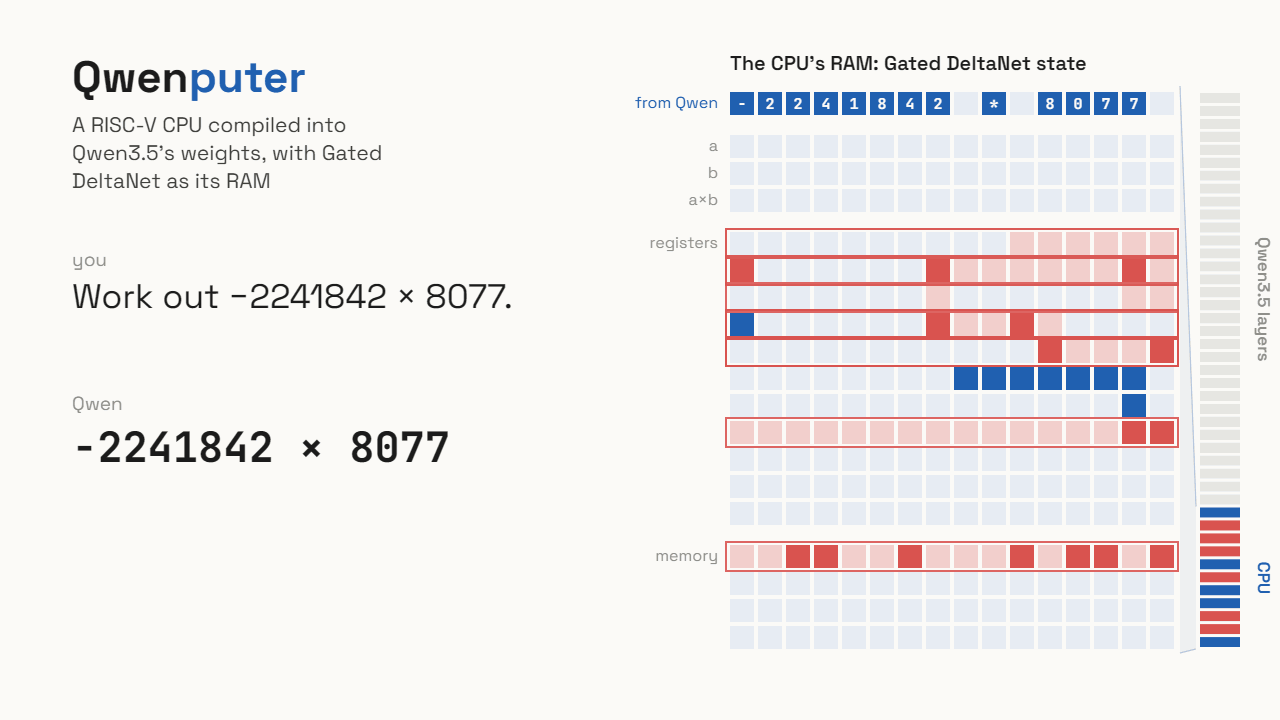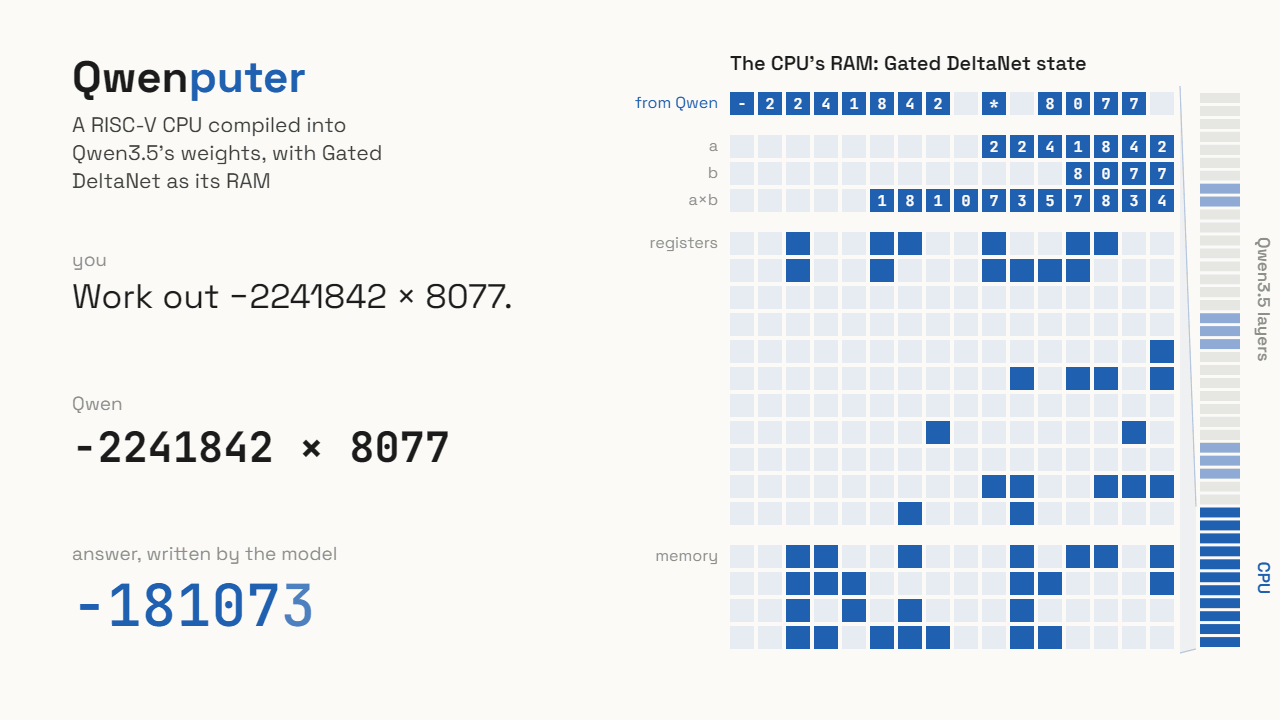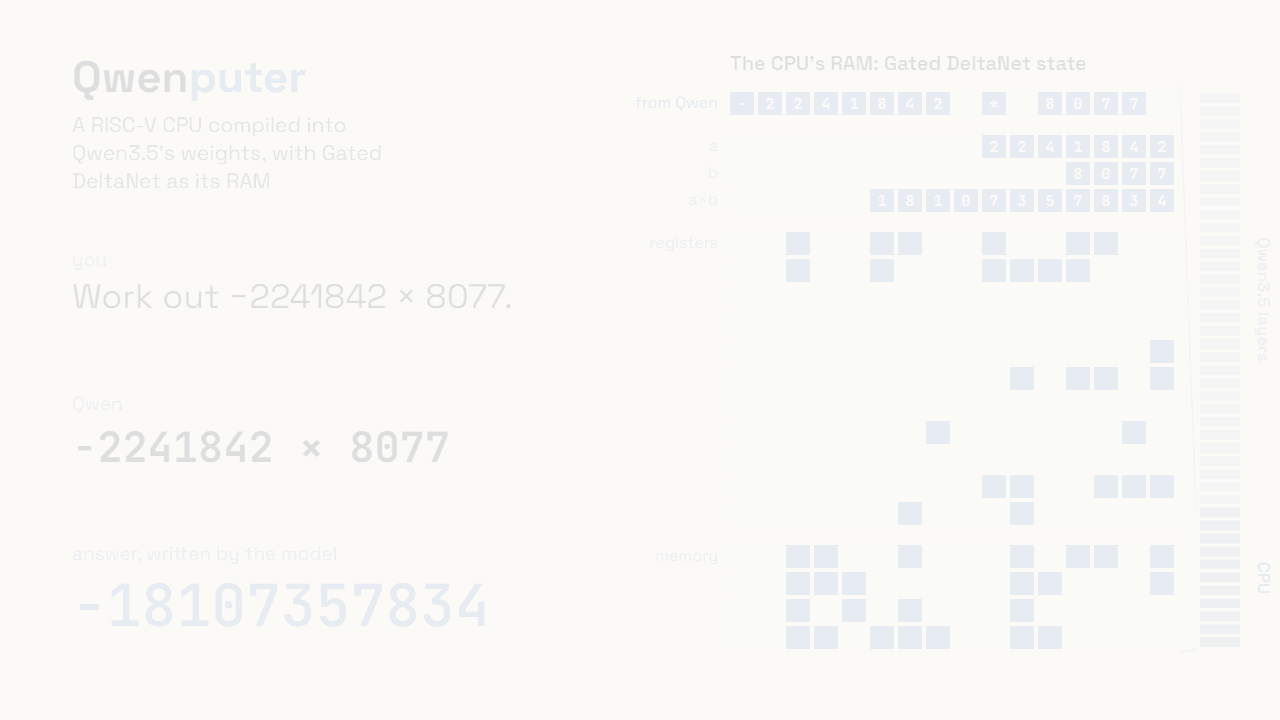 Qwen3.5가 곱셈 문제를 가중치 내장 RISC-V CPU에 넘기면, CPU가 Gated DeltaNet 상태 행렬을 RAM으로 삼아 계산한 뒤 결과를 반환한다. 출처: Divyansh Agrawal
트랜스포머 가중치로 CPU를 구동하려면 값을 한 비트도 틀리지 않고 읽고 쓸 수 있는 메모리(RAM)부터 마련해야 한다. Qwenputer는 Qwen3.5의 하이브리드 어텐션 구조에서 이 메모리를 확보하고, 이 메모리를 바탕으로 CPU 회로와 실험적 파일시스템까지 순서대로 구현했다.
Gated DeltaNet 선형 RNN을 정확한 RAM으로 전환하는 원리
Qwen3-Next와 Qwen3.5는 어텐션 레이어 4개 가운데 3개꼴로 일반 소프트맥스 어텐션 대신 선형 순환 신경망(Linear RNN)의 일종인 Gated DeltaNet(GDN)을 쓴다. 일반 어텐션은 대화가 길어질수록 KV 캐시도 비례해서 커진다. 반면 GDN에서는 각 어텐션 헤드가 고정 크기의 상태 행렬(state matrix) $S_t$를 유지하고, 토큰마다 델타 규칙(delta rule)으로 이 행렬을 갱신한다. 대화가 아무리 길어져도 헤드의 상태 크기가 일정하므로 메모리가 훨씬 적게 든다.
기본 상태의 Qwen3.5에 들어 있는 GDN은 이전 정보를 조금씩 감쇠시키며 근사적인 문맥을 기억할 뿐, 컴퓨터 메모리처럼 정확한 값을 보존하지는 않는다. 그러나 다음 세 가지 설정을 결합하면 이 상태 행렬은 오차 없는 주소 지정형 RAM으로 바뀐다.
- 게이트($\alpha_t$)를 1로 고정: 게이트 $\alpha_t$는 토큰마다 기존 상태 행렬 전체에 곱하는 망각 계수다. 이 값이 0.9이면 토큰이 하나 지날 때마다 기존 상태가 0.9배로 줄어든다. 이 값을 1로 두면 한 번 기록한 값이 시간이 지나도 줄어들지 않는다.
- 쓰기 강도($\beta_t$)를 1로 고정: 새 값을 상태 행렬에 반영하는 비율이 쓰기 강도 $\beta_t$다. 이 값을 1로 고정하면 기존 값과 새 값이 섞이지 않고, 해당 행의 이전 값이 새 값으로 완전히 교체된다.
- 원-핫(one-hot) 키와 쿼리 인코딩($e_r$) 사용: 원-핫 벡터 $e_r$는 $r$번째 원소만 1이고 나머지가 모두 0인 벡터다. 이 벡터를 키 $k_t$로 써서 기록하면 상태 행렬의 $r$번째 행 하나만 새 값 $v_t$로 바뀐다. 읽을 때도 같은 벡터를 쿼리 $q_t$로 넣으면 그 행의 값이 그대로 반환된다($S_t = \alpha_t S_{t-1} + \beta_t k_t (v_t - \alpha_t S_{t-1}^T k_t)^T$, $o_t = S_t^T q_t$).
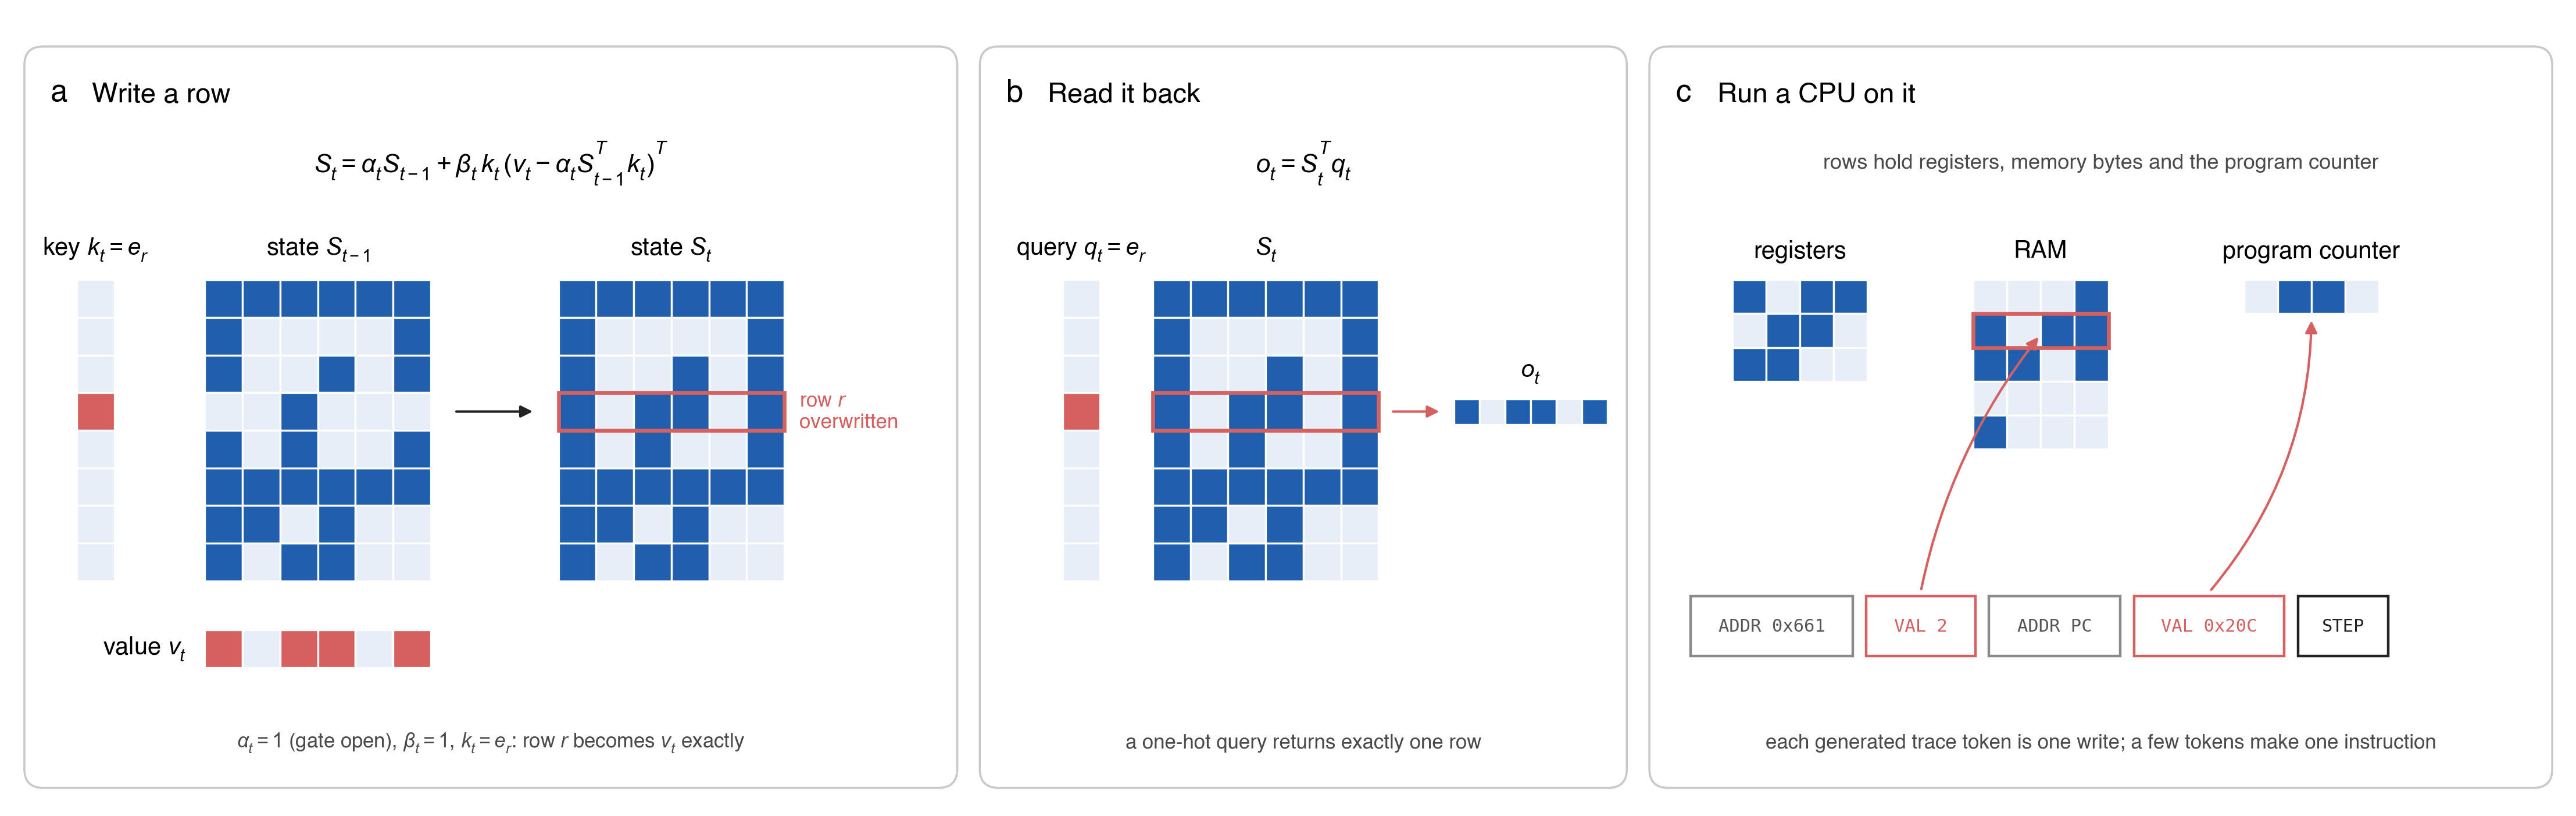 Gated DeltaNet 상태를 RAM으로 쓰는 원리. 행 쓰기(a), 행 읽기(b), 그 행들로 CPU 구동(c). 출처: Divyansh Agrawal
델타 규칙을 쓰는 선형 어텐션이 연상 메모리(associative memory)나 빠른 가중치(fast weights)처럼 작동한다는 이론은 2021년 Schlag 등이 이미 논문에서 제시했다1. Qwenputer는 이 메커니즘을 상용 규모의 사전학습 모델에서 실제 메모리로 구현해 냈다. 주소로 값을 찾을 수 있고 기록한 값이 그대로 보존되어, 완전한 CPU를 구동할 만큼 신뢰성이 높다.
트랜스포머 레이어에 컴파일한 32비트 RISC-V CPU와 구동 방식
오차 없는 RAM을 확보한 뒤에는 CPU 회로를 모델 가중치로 구현한다. 여기에는 경사하강법 학습을 전혀 쓰지 않는다. 전용 컴파일러가 CPU 회로의 각 동작을 트랜스포머 레이어의 가중치 값으로 직접 계산해 설정한다.
컴파일러는 “이 레지스터를 읽어라”, “두 수를 더해라”, “결과가 0이면 분기하라”처럼 CPU 회로를 구성하는 작은 단계들의 목록을 입력받는다. 그리고 각 단계를 트랜스포머의 구성 요소에 일대일로 대응시킨다.
| 구성 요소 | 내장형 컴퓨터에서 맡는 역할 |
|---|---|
| Gated DeltaNet 헤드 | 레지스터, 메모리 바이트, 프로그램 카운터(PC)를 보관하는 RAM |
| 어텐션 헤드 | 연산에 필요한 메모리 행과 레지스터 값을 조회 |
| 피드포워드(FFN) 유닛 | 정수 사칙연산과 비트 조작 등 산술과 논리 연산 수행 |
| 디코딩 트레이스 토큰 | CPU의 실행 기록 |
모델이 토큰을 하나씩 디코딩할 때마다 CPU도 한 단계씩 진행한다. 명령어 하나는 생성 토큰 몇 개로 표현된다. 첫 토큰(ADDR)이 기록할 메모리 행을 지정하고, 다음 토큰(VAL)이 값을 전달하며, 마지막 STEP 토큰이 명령어를 마친다. 이렇게 생성된 토큰들이 그대로 CPU의 실행 기록(execution trace)이 되므로, Qwen이 토큰을 생성하는 과정과 CPU가 명령어를 실행하는 과정이 하나로 맞물린다.
컴파일된 CPU는 32비트 RISC-V 코어다. 기본 정수 명령어와 곱셈, 나눗셈 확장을 뜻하는 RV32IM을 전부 구현했고, 주소 계산을 돕는 비트 조작 확장 Zba와 큰 수 연산을 맡는 소형 큰 정수(bignum) 유닛을 더했다. 이 코어는 Qwen3.5의 원래 레이어 32개 앞단에 레이어 11개로 배치됐다. 이 코어는 공식 RISC-V 테스트(riscv-tests)를 통과했고, 실행 결과도 QEMU 에뮬레이터와 일치한다. 외부 보정 없이 자기 출력만 이어받아 실행하는 자유 실행(free-running) 조건에서도 명령어 1,800만 개를 오류 없이 연속으로 실행했다. 속도는 다소 느리지만 순전파 과정에서 C와 MicroPython 코드도 실행한다.
Qwen3.5-4B가 내부 CPU를 호출할 때도 사후학습(post-training)은 필요하지 않았다. 언어 모델이 이미 충분히 학습한 도구 호출(tool call) 형식을 그대로 썼기 때문이다. Qwen이 도구 호출 문법으로 명령어를 내보내면, 외부 서버를 부르는 대신 모델 앞단의 컴퓨터 레이어 11개가 연산을 마친다. 결과값은 도구 응답(tool response)에 직접 적어 넣는다. 이때 소형 드라이버 RvChat이 초기 펌웨어를 GDN 상태 행렬에 적재한다. 또한 CPU가 출력하는 트레이스 토큰(ADDR, VAL, STEP)을 격리해, 이 토큰들이 Qwen의 본래 레이어 32개에 입력되지 않게 한다. Qwen의 기존 가중치는 바뀌지 않으며, 컴퓨터 가중치는 확장한 차원과 앞단에 추가한 레이어로만 구성된다.
산술 벤치마크와 출력 정확도 검증
벤치마크 평가는 세 가지 구성을 대상으로 진행됐다. 기본 Qwen3.5-4B 모델과 Qwenputer, 기본 Qwen3.5-4B에 실제 외부 파이썬 인터프리터를 도구로 연결한 구성이다. 비교에는 DeepMind 산술 데이터셋 4종과 NUPA 장정수(long-integer) 산술 벤치마크를 썼다.
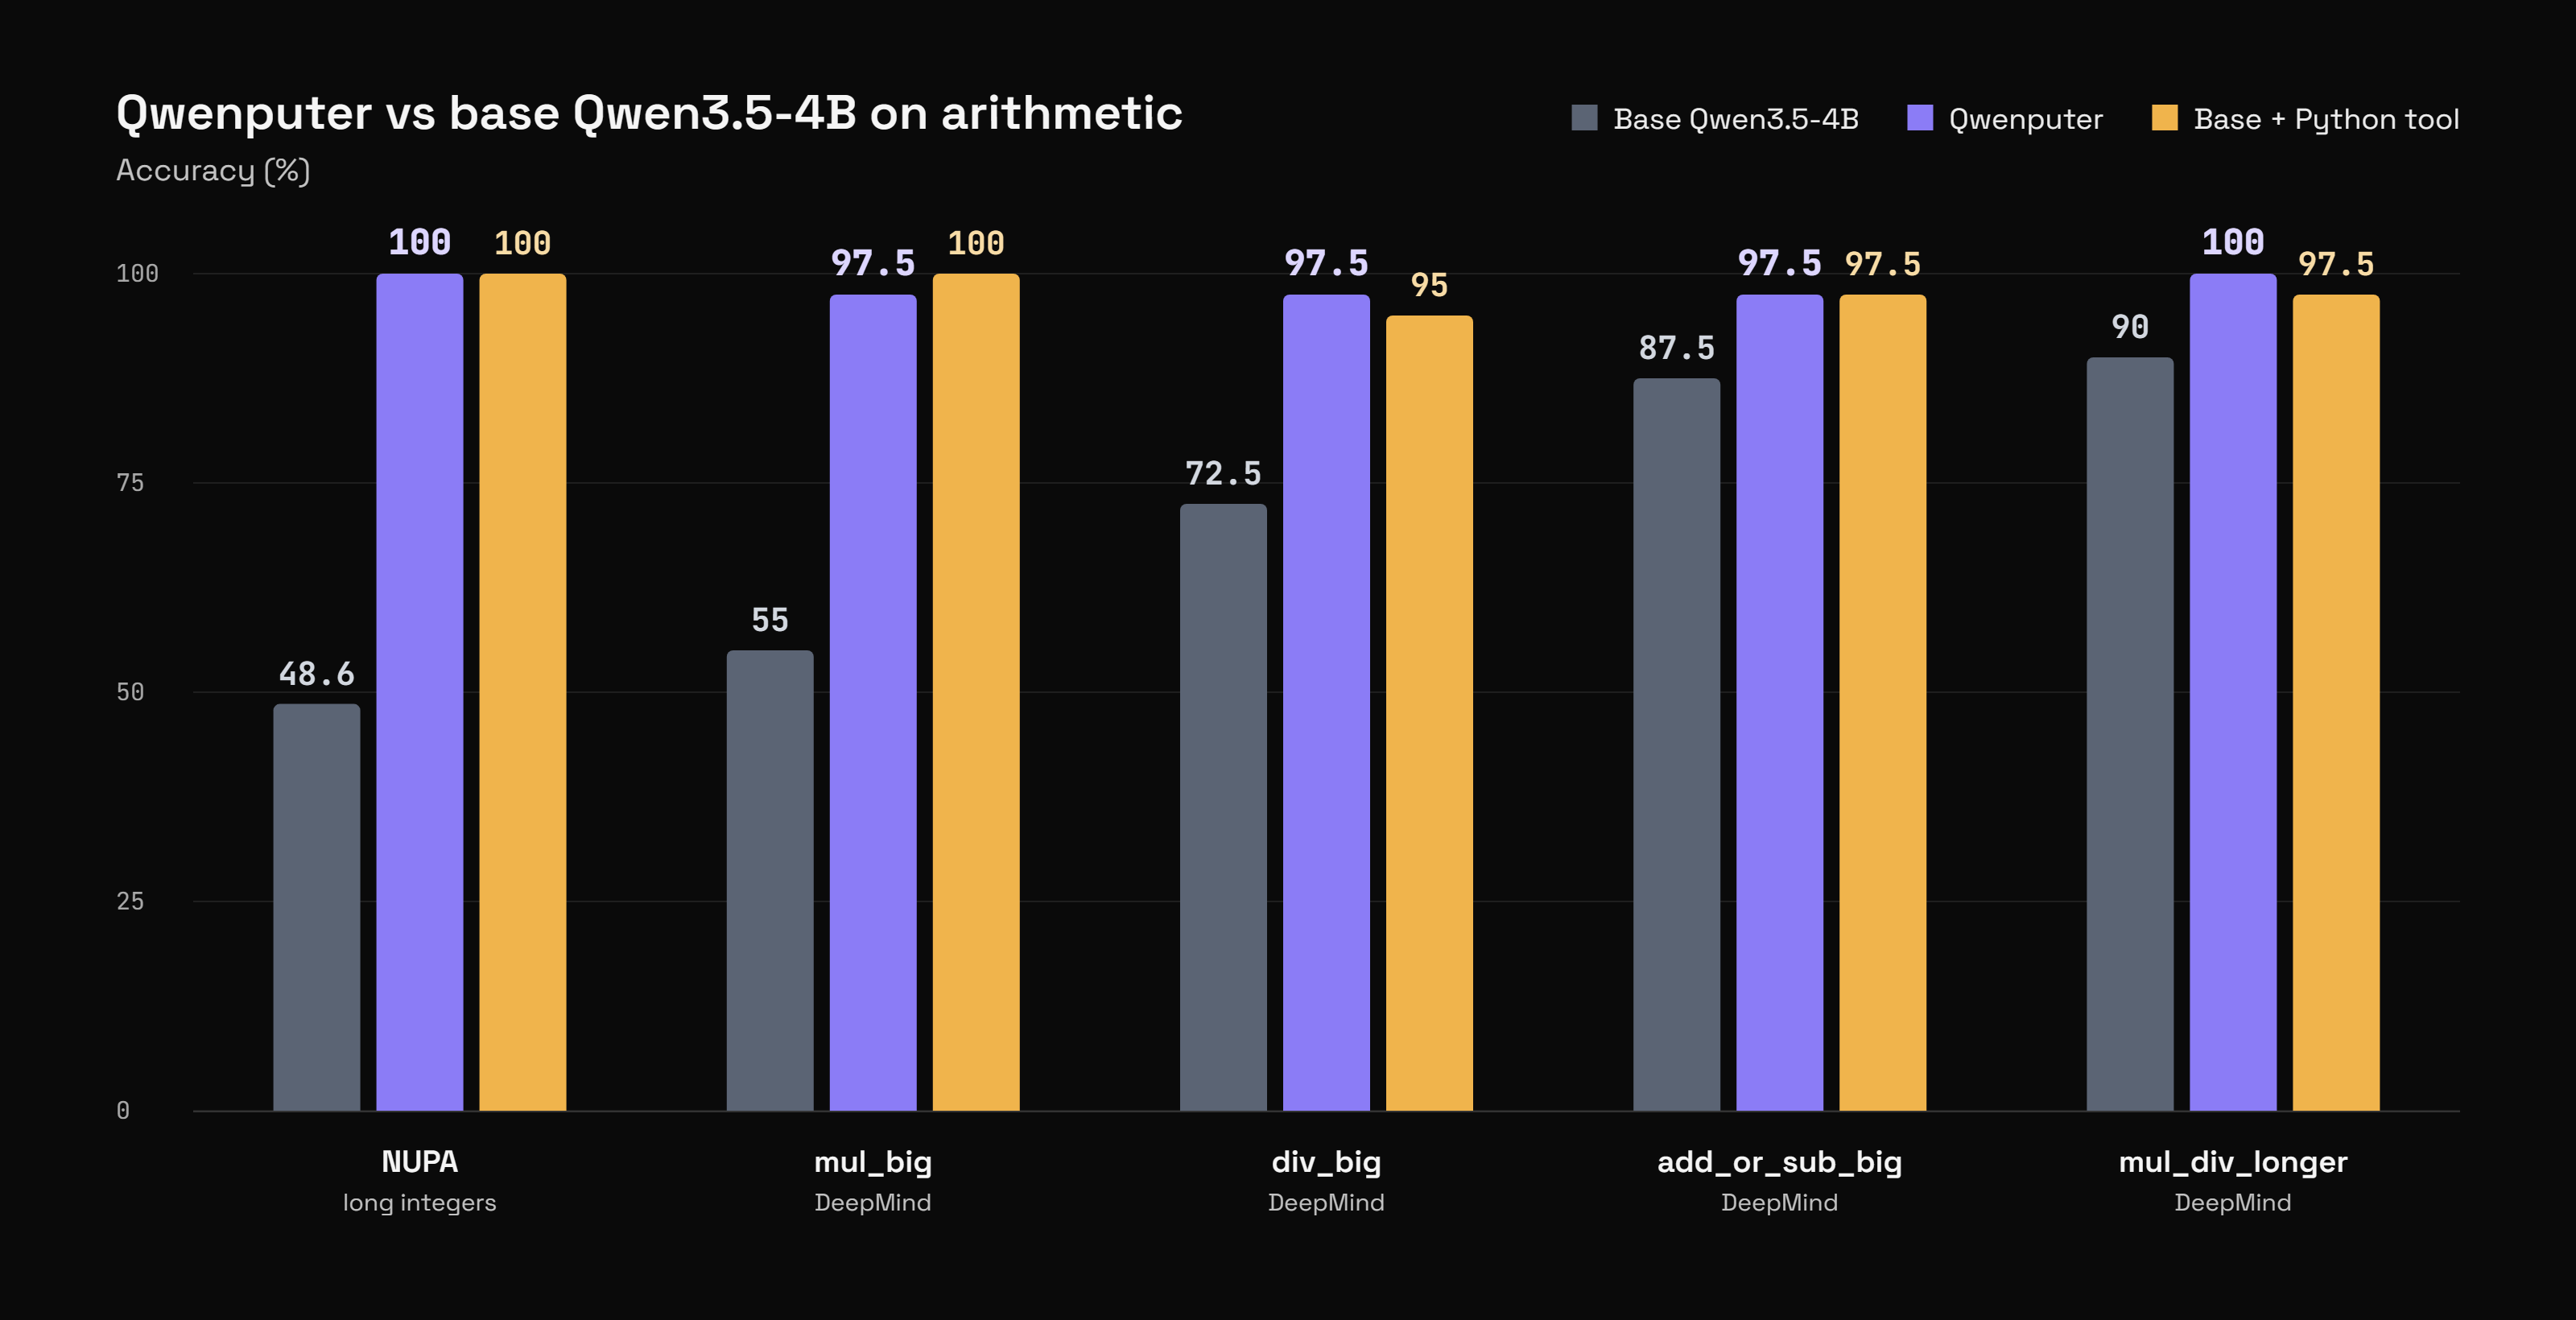 세 구성의 산술 정확도 비교. 출처: Divyansh Agrawal
NUPA 장정수 연산에서 기본 모델의 정확도는 48.6%에 그쳤으나, Qwenputer는 외부 파이썬 도구를 연결한 구성과 똑같이 100%를 기록했다. DeepMind 데이터셋의 큰 수 나눗셈(div_big)과 복합 연산(mul_div_longer)에서는 Qwenputer가 각각 97.5%와 100%를 기록해, 파이썬 도구를 연결한 구성(95.0%, 97.5%)보다 점수가 조금 더 높았다. 큰 수 곱셈(mul_big)에서만 파이썬 도구를 연결한 구성(100%)이 Qwenputer(97.5%)보다 높았다.
CPU가 출력하는 숫자가 정확한지, 모델의 기존 언어 능력이 유지되는지도 함께 확인했다.
- 기준 머신 대조: CPU가 출력한 토큰 약 23만 개를 기준 머신에서 다시 실행해 결과를 대조했더니, 불일치는 0건이었다.
- 기존 언어 분포 보존: 모델에 컴퓨터 레이어를 추가한 뒤에도 일상적인 텍스트 생성 분포는 변하지 않았다. 기본 Qwen3.5와의 쿨백-라이블러 발산(KL divergence)은 ${6 \times 10^{-4}}$였다. 측정 잡음의 하한(noise floor)인 ${5 \times 10^{-4}}$와 구별하기 어려운 값이다.
Gated DeltaNet 상태에 구현한 모델 내장 파일시스템과 연구 응용
RAM이 작동한다면 하드 드라이브 역할을 할 파일시스템도 모델 가중치에 넣을 수 있다. 이 발상에서 실험적인 모델 내장 파일시스템(Qwen3.5-4B-Qwenputer-Filesystem)이 추가로 만들어졌다. 이 기능도 외부 도구 호출 없이 모델 내부의 put, append, get, list, delete 연산으로 쓸 수 있다.
Qwen이 파일을 저장하면 컴파일된 레이어들이 파일 이름을 해싱해 Gated DeltaNet 상태 행렬에 마련한 슬롯 1,024개짜리 디렉터리에서 한 슬롯을 배정한다. 서로 다른 두 파일 이름이 같은 슬롯에 배정되면 해시 충돌이 일어난다. 이때는 다음 슬롯을 차례로 확인해 빈 슬롯을 찾는 선형 탐사(linear probing) 방식을 쓴다. 파일 본문 텍스트는 다른 어텐션 헤드들에 분산해 저장하는데, 한 행에 토큰 8개씩을 담고 이를 체인 형태로 연결한다. 파일을 다시 찾을 때는 전체 메모리를 차례로 검사하지 않고 두세 단계 만에 대상 슬롯을 찾는다. 파일은 최대 512개, 텍스트로는 약 5만 3천 토큰 분량까지 보관할 수 있다.
이 파일시스템에는 영속성(persistence)이 있어 대화 세션이 끝나도 파일이 유지된다. 대화를 마칠 때 GDN 상태를 저장해 두었다가 다음 세션에서 불러오면, 앞서 만든 파일을 그대로 쓸 수 있다. 여러 차례의 대화에서 바뀐 정보를 모델이 기억하는지 확인한 실험에서 모델 내장 파일시스템을 쓴 구성은 정확도 90%를 기록했고, 이전 대화 전문을 프롬프트에 다시 붙여넣은 구성은 30%에 그쳤다. 외부 파이썬 메모리 도구와 비교한 실험에서도 모델 내장 파일시스템(83.3%)은 외부 도구(78.9%)와 대등한 성적을 냈다.
현재 Qwenputer의 현실적인 제약과 후속 연구 과제는 네 가지로 요약된다2.
- 체크포인트 용량 증가: 추가된 레이어 11개와 늘어난 은닉 차원(hidden size) 때문에 체크포인트 크기가 18.8 GB로 기본 Qwen3.5-4B의 약 두 배가 됐다. 늘어난 용량의 대부분은 0으로 채워진 패딩(zero padding)이다.
- 드라이버 의존성과 실행 속도: 초기 펌웨어를 적재하고 트레이스 토큰을 격리하려면
RvChat드라이버가 필요하다. 이 때문에 아직은 단순한generate()호출 하나만으로 바로 작동하지 않는다. 또한 CPU 명령어 하나마다 토큰을 몇 개씩 디코딩해야 해서 큰 연산은 밀리초 단위로 끝나지 않고 수 초가 걸린다. 벤치마크에 쓴 배치 실행기로 재면 NVIDIA L4 GPU에서 초당 CPU 토큰 약 3,200개를 처리한다. - 차기 개발 과제: 계산기(
calc)처럼 작동하는 내부python()도구를 준비하고 있다. Qwen이 이 도구로 파이썬 코드를 직접 작성하면 가중치에 내장된 MicroPython이 그 코드를 바로 실행하는 방식이며, CPU 실행 속도 개선도 함께 진행 중이다. - AI 안전과 감독 연구 응용: Qwenputer를 바탕으로 두 편의 후속 연구도 함께 공개됐다. 첫째 연구는 Qwen3.5 같은 하이브리드 모델이 추론 과정을 출력 토큰 대신 내부 RNN 상태에 숨겨 사고 사슬(CoT) 감시를 피할 수 있음을 실험으로 확인했다. 둘째 연구는 이 기법을 감독에 쓰는 경우다. 가중치에 직접 컴파일한 회로로 내장형 감시 도구(in-weight monitor)를 만들면 모델이 이를 스스로 끄거나 변조할 수 없고, 해석가능성 검증에 쓸 정답 키도 같은 방식으로 내장할 수 있다.
가장 흥미로운 지점
언어 모델이 계산에 약하다는 한계를 보완할 때 학계와 업계의 표준 해법은 모델 외부에 파이썬 실행기 같은 도구를 연결하는 방식이었다. 이 연구에서 특히 놀라웠던 부분은 상태 행렬의 전환 조건이다. 하이브리드 언어 모델에 이미 들어 있는 선형 어텐션(Gated DeltaNet)의 상태 행렬은, 게이트와 쓰기 강도를 1로 고정하고 원-핫 키를 주기만 하면 정확한 주소 지정형 RAM으로 작동한다. 추가 학습 없이 레이어 11개짜리 RISC-V 회로를 컴파일해 기존 가중치에 더했을 뿐인데도, 모델은 원래 익힌 도구 호출 습관만으로 내부 CPU와 파일시스템을 자연스럽게 다루기 시작했다.
더 곱씹어 볼 부분은 이 기법이 AI 안전 연구에 시사하는 양면성이다. 고정 크기의 선형 RNN 상태는 수만 토큰 분량의 구조화된 정보를 정확히 보존하고 연산까지 수행할 수 있다. 다시 말해 하이브리드 모델은 겉으로 드러나는 사고 사슬(CoT) 토큰에는 평범한 말만 적고, 실제 연산과 추론은 RNN 상태에서 몰래 처리할 수도 있다. 거꾸로 감독자가 이 기술을 쓰면 결정론적 감시 회로를 모델 가중치에 직접 컴파일해 넣을 수 있다. 이 회로는 바뀌지 않으며, 탈옥이나 미세조정으로도 우회하기 어렵다. 작은 호기심에서 시작한 실험 모델 하나가 선형 어텐션의 메모리 용량을 증명하고, 같은 구조로 AI 감시 가능성 논쟁에 구체적인 실증 사례까지 남겼다.
출처
Divyansh Agrawal, 「Qwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5」, 2026-10-22. 원문: https://divagr.com/blog/qwenputer
- 코드 저장소: divagr18/qwenputer / 파일시스템 브랜치: rv-store
- 모델 가중치 (Hugging Face): Qwen3.5-4B-Qwenputer / Qwen3.5-4B-Qwenputer-Filesystem
- 후속 연구 1: Hybrid models can learn to hide their reasoning in their RNN state
- 후속 연구 2: Building oversight tools into a model’s weights
- 삽화 3장은 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
Imanol Schlag, Kazuki Irie, Jürgen Schmidhuber, 「Linear Transformers Are Secretly Fast Weight Programmers」, ICML 2021 (https://arxiv.org/abs/2102.11174). ↩︎
모델은 24 GB VRAM을 갖춘 단일 GPU에서 외부 도구 서버나 파이썬 샌드박스 없이 바로 실행할 수 있다. 저장소의
chipformer.rv.chat모듈에 체크포인트와calc-bridge.elf펌웨어를 지정해 실행한다. ↩︎