3줄 요약
- 일본의 AI 창작 연구 서클 스튜디오 마사카키(대표 사카키 이오)가 2026년 10월 27일 약 4만 5천 자 분량의 검증 기사를 공개했다. 시험 대상은 이미지 생성과 편집을 함께 하는 알리바바 Qwen 팀의 오픈 웨이트 모델 Qwen Image 2.1이고, 과제는 한 달 전 GPT Image 2.5에 냈던 38개 그대로다.
- 같은 일본어 지시로는 Qwen의 실력을 가늠할 수 없어서, 작가는 과제마다 영어 지시를 구체적으로 새로 쓰고 LoRA와 전용 워크플로까지 동원해 Qwen에 가장 유리한 조건으로 비교했다. Qwen은 옷 갈아입히기, 알파 채널이 있는 투명 배경 만들기, 마스크 밖을 1픽셀도 바꾸지 않는 인페인트를 잘했고, 카메라를 돌려 안 보이던 벽을 그리거나 평면도를 실내 시점으로 바꾸는 과제에는 실패했다.
- 작가는 Qwen Image 2.1에 ‘NSFW도 되는 로컬판 GPT Image 2.5’를 기대하기보다 ‘로컬 워크플로에 넣어 국소 작업을 맡기는 모델’로 보는 편이 타당하다고 결론 내린다. 무료 사용을 연구와 평가 목적으로 한정한 라이선스도 먼저 확인할 점으로 꼽았다.
어떤 시험인가
스튜디오 마사카키는 이미지 생성 AI를 창작에 쓰는 방법을 연구하는 일본 서클이다. 9월에는 OpenAI의 GPT Image 2.5를 38개 과제로 시험한 특집을 냈고1, 이번 글은 같은 참조 이미지와 같은 과제를 로컬 모델 Qwen Image 2.1에 맡겨 본 후속편이다. 과제는 대부분 새 그림을 만들기보다 주어진 그림을 고치는 이미지 편집이다. 캐릭터 그림을 주고 표정이나 옷을 바꾸게 하거나, 방 그림을 주고 다른 각도에서 다시 그리게 하는 식이다.
작가는 클라우드 모델의 두 가지 불편 때문에 로컬 편집 모델을 찾는다. ChatGPT 같은 클라우드 모델은 조금이라도 NSFW 요소가 섞이면 요청을 거절하고, 작업을 한꺼번에 맡겨 두고 끝날 때까지 내버려 둘 수도 없다. 로컬 모델에는 이 두 제약이 없다.
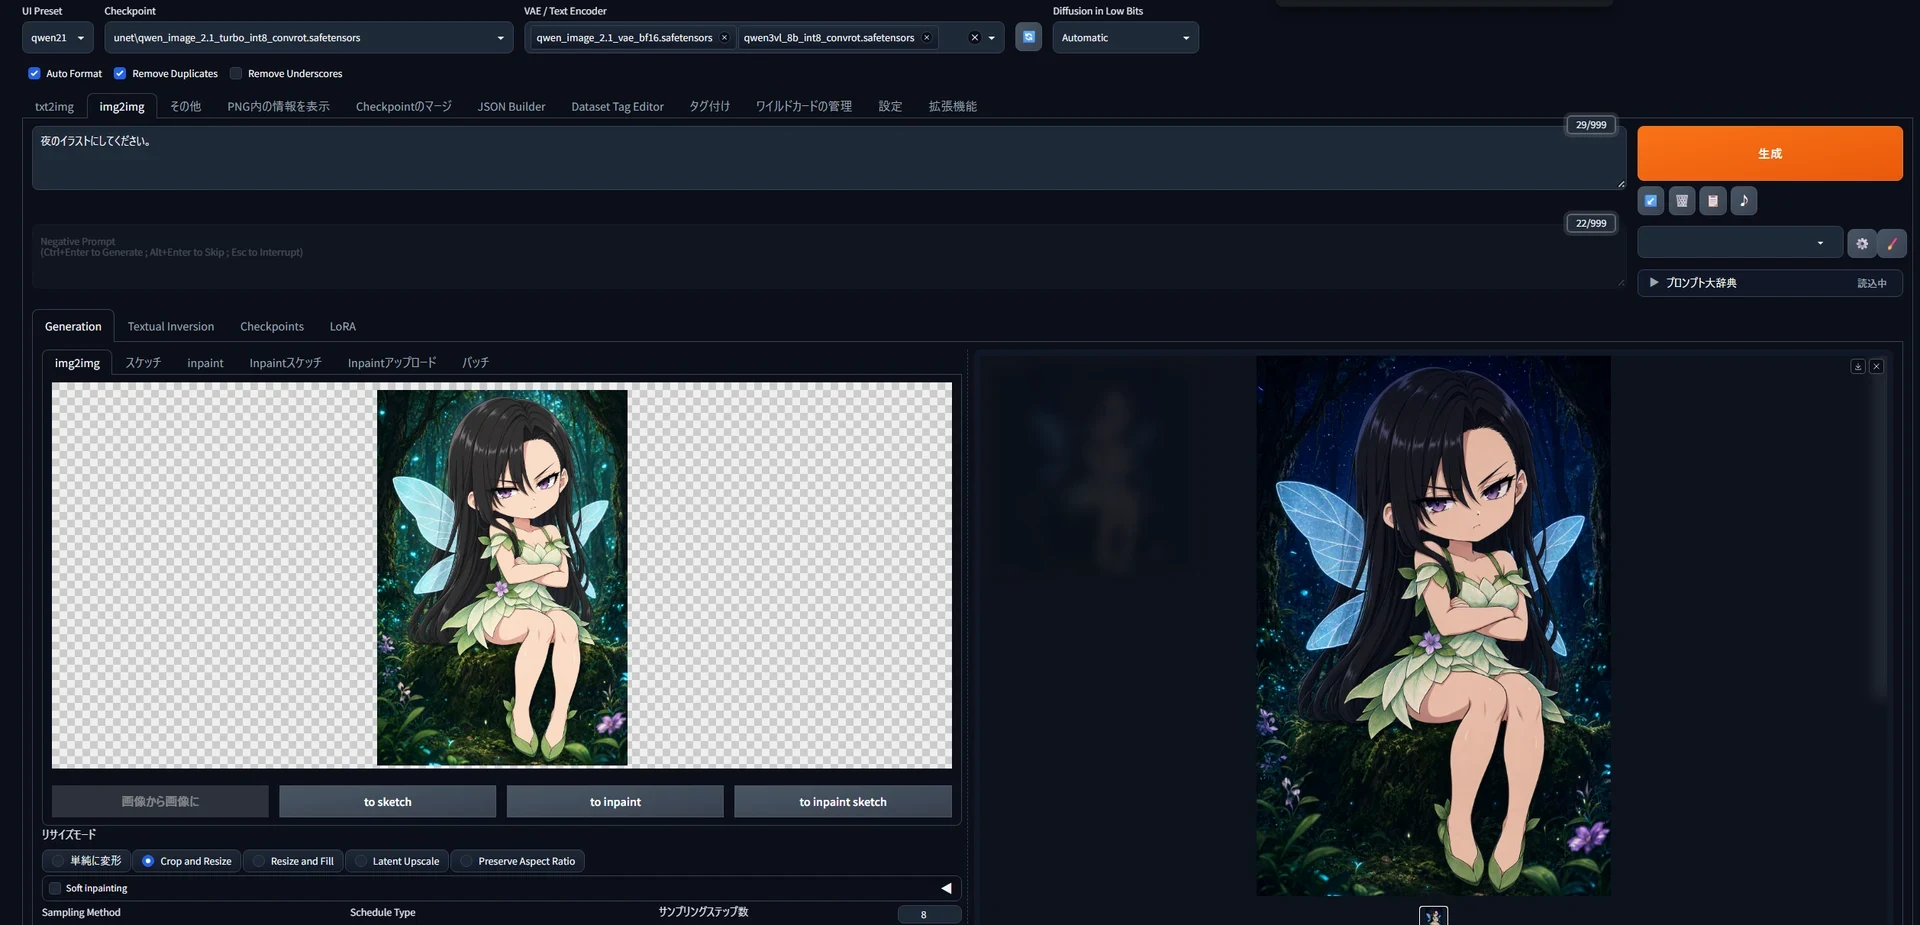 ForgeNeo에서 Qwen Image 2.1에 「밤 일러스트로 바꿔 줘」라고 지시한 결과. 출처: 스튜디오 마사카키
처음에는 GPT 특집과 똑같은 일본어 지시로 비교했지만, 그 결과로는 Qwen의 실력을 거의 알 수 없었다. 작가는 원인을 텍스트 인코더에서 찾는다. 텍스트 인코더는 지시문을 모델이 쓰는 표현으로 바꾸는 부분인데, Qwen의 텍스트 인코더는 GPT만큼 ‘사용자의 요구와 필요를 헤아리는 힘’이 강하지 않다. 그래서 과제는 그대로 두고 Qwen이 이해하기 쉬운 영어 지시를 새로 썼으며, 필요하면 LoRA와 전용 워크플로도 준비해 ‘Qwen으로 가장 잘될 법한 방법’의 결과를 실었다. LoRA는 본 모델에 덧붙여 화풍이나 기능을 더하는 작은 추가 가중치이고, 워크플로는 아래에서 설명할 ComfyUI의 처리 순서도다.
Qwen Image 2.1은 어떤 모델인가
 Qwen 공식 블로그의 Qwen Image 2.1 발표 화면. 출처: 스튜디오 마사카키 원문 캡처
Qwen Image 2.1은 알리바바 Qwen 팀이 2026년 9월 20일 공개한 오픈 웨이트 모델이다. 문장으로 그림을 그리는 txt2img와, 입력한 이미지를 고치는 이미지 편집(img2img)을 모델 하나로 모두 할 수 있다. 2026년 2월의 Qwen-Image 2.0과 7월의 Qwen-Image 3.0은 가중치를 공개하지 않은 모델이었다. Qwen Image 2.1은 버전 번호가 3.0보다 낮지만, Qwen이 오랜만에 가중치를 공개한 이미지 모델이다.
지시문은 ChatGPT처럼 일본어 자연어로 쓸 수 있고, 영어, 중국어, danbooru 태그(애니메이션 그림 사이트 Danbooru식 단어 나열)도 받는다. GPT와 다른 점도 있다.
- GPT에서 쓰던 「n=10」(10장 생성), 「16:9」(가로세로 비율) 같은 지시를 인식하지 못한다. 장수와 비율은 워크플로 설정에서 정한다.
- 업스케일 없이 한 번에 뽑을 수 있는 크기는 2048×2048px(4메가픽셀) 정도까지로 알려져 있다.
- 공식 예시가 강조하는 분야는 GPT Image 2.5와 비슷하다. 인포그래픽, 슬라이드, UI 목업, 포스터, 패키지 디자인이다. 배경 같은 이미지 일부를 투명하게 만들 수 있고 참조 이미지를 여러 장 줄 수 있다는 점도 GPT와 같다.
- 참조 이미지는 지시문에서
<image1>,<image2>처럼 번호로 부른다2.
일본어로 「이 이미지의 배경을 투명하게 해 주세요」라고만 해도 생성은 되지만, 작가가 써 본 느낌으로는 영어 지시를 더 잘 따랐다. GPT처럼 ‘하나를 들으면 열을 아는’ 반응은 기대할 수 없으므로, 어떤 그림으로 고치고 싶은지 구체적으로 적어야 한다.
시험 환경과 속도
작가는 RTX 4080(VRAM 16GB)과 메인 메모리 64GB를 갖춘 PC로 시험했고, 모델은 주로 공식 Turbo 모델의 INT8판을 썼다. INT8판은 가중치를 8비트 정수로 줄여 bf16판보다 가볍고 메모리 부담이 적다. Turbo 모델은 8단계만으로 그림을 뽑는 고속판이다.
| 항목 | 값 |
|---|---|
| 생성 단계 | Turbo 8단계 (일반판 권장 25단계) |
| CFG 스케일(지시 반영 강도) | 1 |
| 권장 크기 | 1메가픽셀(1024×1024px) 안팎 |
| 샘플러(계산 방식) | euler |
| 생성 시간 | 1메가픽셀 한 장에 10초 안팎, 모델을 처음 불러올 때는 더 걸림 |
| 저장 공간 | 일반판만 약 17GB, Turbo판까지 약 25GB, 프롬프트 인핸서를 더하면 약 9.5GB 추가 |
Turbo판으로 캐릭터 포즈를 바꾼 예시 한 장은 14초 걸렸다.
라이선스: 무료로 쓸 수 있는 범위는 연구와 평가
작가는 모델을 쓰기 전에 라이선스부터 반드시 확인하라고 강조한다. Qwen Image 2.1의 라이선스는 Qwen Research License이고, 무료로 모델을 쓸 수 있는 목적은 연구와 평가로 한정된다3. 라이선스에는 상업 목적으로 쓰려면 Qwen 측에 신청해 상업 라이선스를 따로 받아야 한다고 적혀 있다. 제4조 b항에는 출력물을 이용해 AI 모델을 만들거나 학습시켜 공개하면 ‘Built with Qwen’을 표시하라는 내용이 있다. 작가는 이 조항에 따라 LoRA를 만들어 배포할 때도 이 표시가 필요하다고 해석한다.
출력물의 권리에 대해서는 Qwen 공식 계정이 이렇게 설명했다. 모델이 만든 이미지 같은 출력물은 라이선스가 다루는 ‘Materials’에 포함되지 않고, 생성한 콘텐츠의 권리는 사용자에게 있다. 작가는 이 설명이 공식 SNS에서 한 말일 뿐 라이선스 본문의 조항은 아니라고 주의를 준다. 또 출력물의 권리가 사용자에게 있는가와 그 모델을 상업 목적으로 써도 되는가는 별개 문제라고 덧붙인다. 생성물을 공개하거나 판매할 생각이라면 어디에 쓸지 밝히고 미리 허락 여부를 확인해 두라는 권고다. 워크플로 목록에 있는 NSFW 파생 모델 Noct Q Anime를 쓸 때도 배포처의 조건을 먼저 읽어야 한다.
작가가 배포한 워크플로
Qwen Image 2.1은 ComfyUI와 ForgeNeo 양쪽에서 돌릴 수 있다. ComfyUI는 로컬 이미지 생성 도구로, 모델 불러오기, 지시문 입력, 샘플링, 저장 같은 처리를 노드로 이어 하나의 순서도(워크플로)로 만든다. ForgeNeo는 Stable Diffusion WebUI Forge 계열의 웹 UI다. Qwen을 더 큰 워크플로의 한 단계로 쓸 수 있는 쪽은 ComfyUI이고, 작가도 여러 용도에 응용할 수 있는 ComfyUI로 시험했다. ComfyUI에는 공식 템플릿이 있지만, 템플릿으로는 같은 조작을 수십 번 되풀이해야 한다. 이 때문에 작가는 시험용 워크플로를 따로 짰고, 그중 쓸모 있는 다섯 개를 PixivFANBOX 기사에서 배포한다.
| 워크플로 | 용도 |
|---|---|
| 기본 (일반판 INT8) | 일반판 모델로 생성과 편집 |
| 기본 (Turbo INT8) | Turbo판으로 생성과 편집 |
| 기본 (NoctAnime) | NSFW 파생 모델 Noct Q Anime로 생성과 편집 |
| 인페인트 (Turbo BF16) | 칠한 부분만 다시 그리기 |
| 8방향 | 캐릭터를 8방향에서 그리기 |
기본 워크플로 세 개는 참조 이미지를 4장, LoRA를 4개까지 쓸 수 있다. 참조 이미지는 켠 순서대로 <image1>, <image2> 번호가 붙으므로 지시문에 「
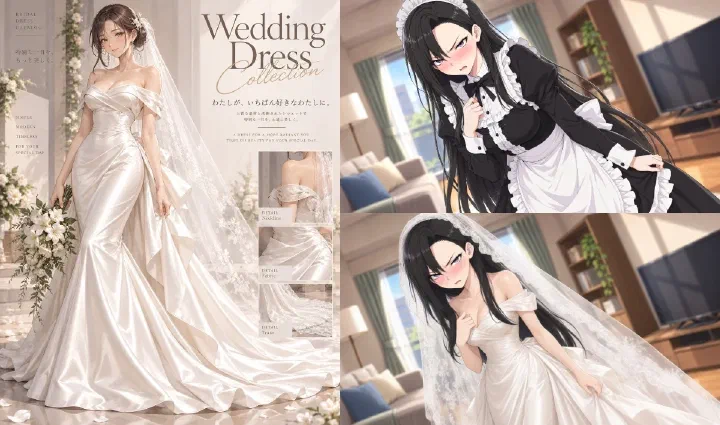
참조 이미지를 두 장 주면 옷을 갈아입힐 수도 있다. 메이드복 캐릭터 그림을 1번, 웨딩드레스 사진을 2번으로 주고 「
8방향 워크플로는 녹색 노드에 참조 이미지를 넣고 생성 버튼을 누르면 8개 방향의 그림을 차례로 만든다. 고속과 일반, 투명 배경과 흰 배경을 스위치로 고른다.
마스크 밖은 1픽셀도 바꾸지 않는 인페인트
인페인트는 그림의 일부를 칠해 지정하고 그 부분만 다시 그리게 하는 기법이다. 공식 워크플로에도 인페인트용이 있지만, 고칠 곳을 빨간 펜으로 둘러 Qwen에게 알려 주는 방식이라 지정한 곳 밖도 함께 바뀐다. 작가가 만든 워크플로는 ComfyUI의 마스크 편집기로 칠한 부분만 다시 그리고, 나머지는 원본을 그대로 쓴다. 공식 Turbo 모델의 BF16판을 쓰므로 VRAM이 16GB는 되어야 편하고, 부족하면 INT8판으로 바꾸라고 한다.
쓰는 법은 간단하다. 이미지를 불러와 마스크 편집기를 열고, 바꿀 부분을 불투명도 1로 넉넉하게 칠한다. 칠한 범위가 모자라면 마스크 안팎의 그림이 자연스럽게 이어지지 않는다. 작가는 상반신을 칠하고 「그녀는 따뜻해 보이는 빨간 스웨터를 입고 있다」라고 지시했다.
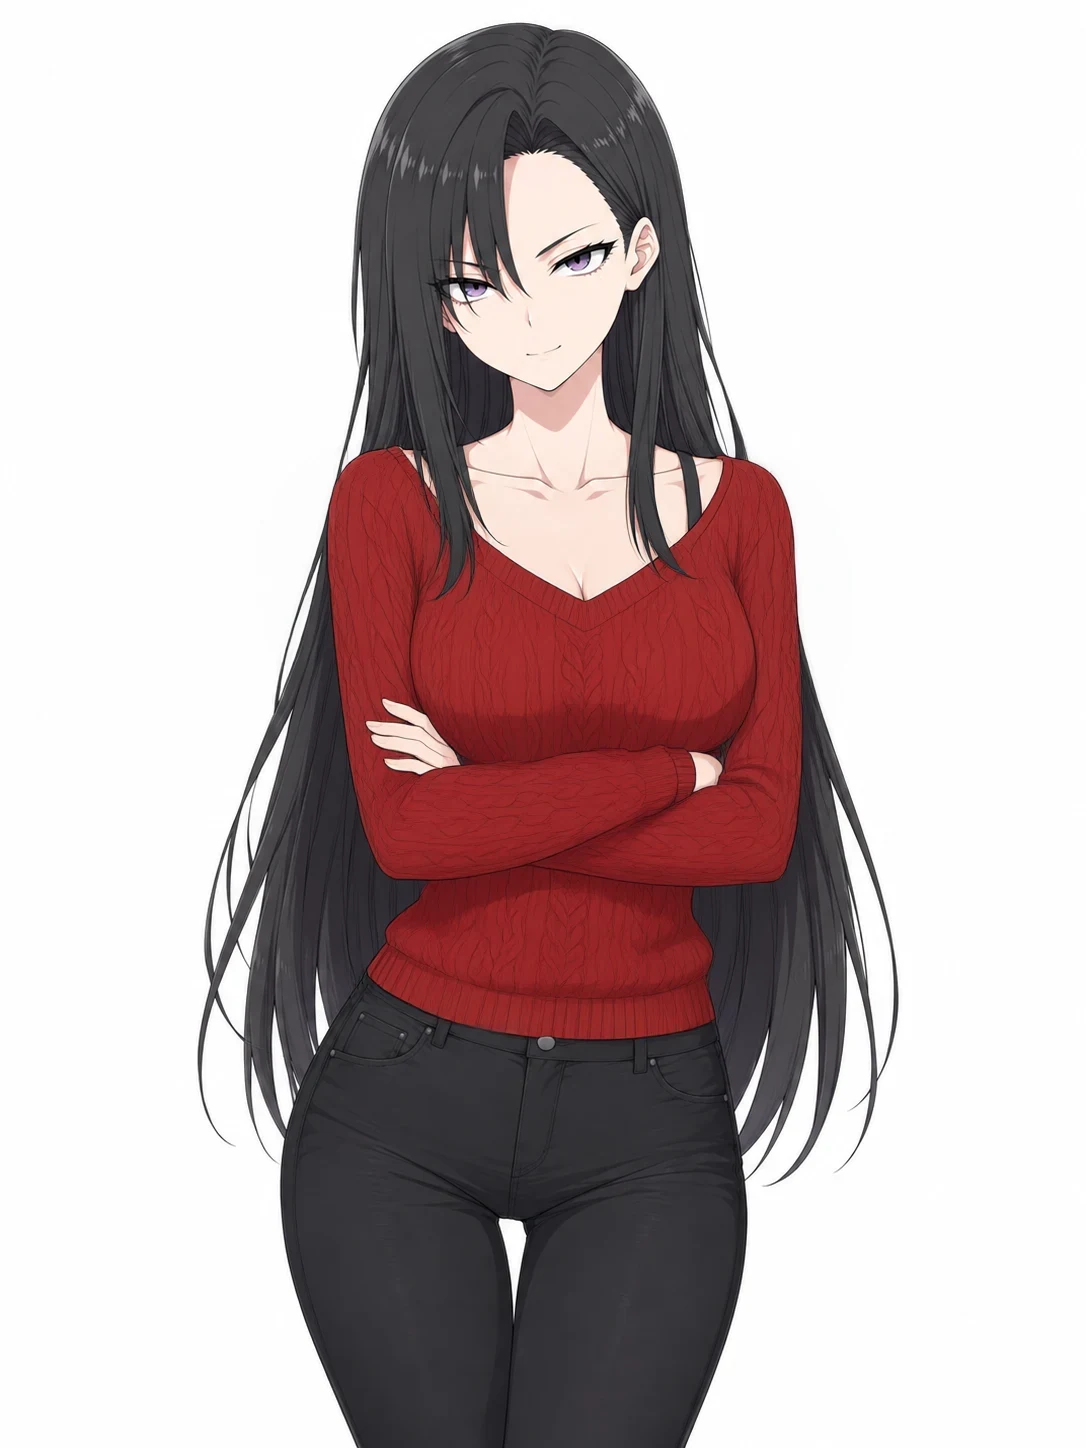 상반신만 칠해 빨간 스웨터로 다시 그린 결과. 출처: 스튜디오 마사카키
원본과 비교하면 결과물은 포즈와 손끝을 그대로 따랐고, 브래지어 끈까지 원본의 것을 유지했다. SDXL 같은 이전 세대 모델의 인페인트는 칠한 부분의 원래 그림을 통째로 지워 버리지만, Qwen은 그렇지 않다는 뜻이다. 그리고 마스크 밖은 원본에서 1픽셀도 바뀌지 않았다. GPT에 인페인트를 지시하면 지정한 부분 밖까지 달라지므로, 작가는 이 결과를 GPT Image 2.5도 하지 못하는 일로 평가한다.
생성 실험 1~12
작가는 이 특집을 ‘Qwen Image 2.1을 도입할지 말지 정하기 위한’ 자료로 기획했고, GPT Image 2.5 특집과 가능한 한 같은 참조 이미지와 과제로 결과를 비교한다. 웹 기사에는 실험 12까지 공개돼 있고, 13번부터는 FANBOX 유료 플랜 회원만 읽을 수 있다. 아래 표는 공개된 12개 실험의 결과다.
| 실험 | 과제 | Qwen Image 2.1 결과 |
|---|---|---|
| 1 | 망가진 손만 고치기 | 10장 중 5장 성공, GPT보다 성공률 낮음 |
| 2 | 같은 캐릭터를 허리 위 구도로 다시 그리기 | 구도를 아주 자세히 적어야 성공, 눈썹이 겹쳐 그려짐 |
| 3 | 편집을 네 번 거듭할 때의 화질 저하 | 네 가지 변경 모두 반영, GPT에서 생긴 색 얼룩과 노이즈가 거의 없음 |
| 4 | 배경 투명화 | 알파 채널이 있는 PNG 생성 (GPT는 체크무늬를 그려 실패) |
| 5 | 게임 소품 외형 제안 | 10장 모두 버튼의 일본어 글자를 읽을 수 있음 |
| 6 | 표정과 포즈 바꾸기 | 대체로 성공, 깊은 인사 같은 큰 동작은 약하게 나옴 |
| 7 | 의상 바리에이션 | 지정한 옷 10벌 모두 성공, 무엇을 입힐지는 사람이 정해야 함 |
| 8 | 캐릭터를 8방향에서 그리기 | 전용 워크플로와 LoRA로 8방향 모두 성공 |
| 9 | 캐릭터의 방 추론 | 「캐릭터를 그리지 마라」라는 지시에도 10장 모두 캐릭터를 그림 |
| 10 | 같은 방을 다른 각도에서 | 반대편 벽을 그린 컷 0장 |
| 11 | 평면도로 실내 배경 만들기 | 10장 모두 내려다본 모형이 됨 |
| 12 | 건물 외관과 실내 배경 한 벌 | 외관과 침대가 한 장에 섞임 |
고치기와 다시 그리기 (실험 1~3)
실험 1. 망가진 손만 고치기. 머리를 땋아 주는 여학생의 손이 세 개로 그려진 그림을 주고, 오른쪽 학생의 손만 해부학적으로 맞는 두 손으로 고치라고 했다. 지시문에는 손 이외의 얼굴, 머리, 옷, 교실 배경, 노을빛, 선 굵기를 바꾸지 말라는 조건을 길게 붙였다. 10장을 뽑았을 때 세 번째 손을 지우고 두 손만 남긴 그림은 다섯 장이었고, 나머지 다섯 장에는 세 번째 손이 그대로 있었다. 성공한 그림도 손가락 모양과 손목 연결이 미심쩍고, 머리카락과 선처럼 손이 아닌 부분도 조금 달라졌다. GPT Image 2.5보다 성공률이 낮아 여러 번 뽑아 고르는 수고가 필요하다.
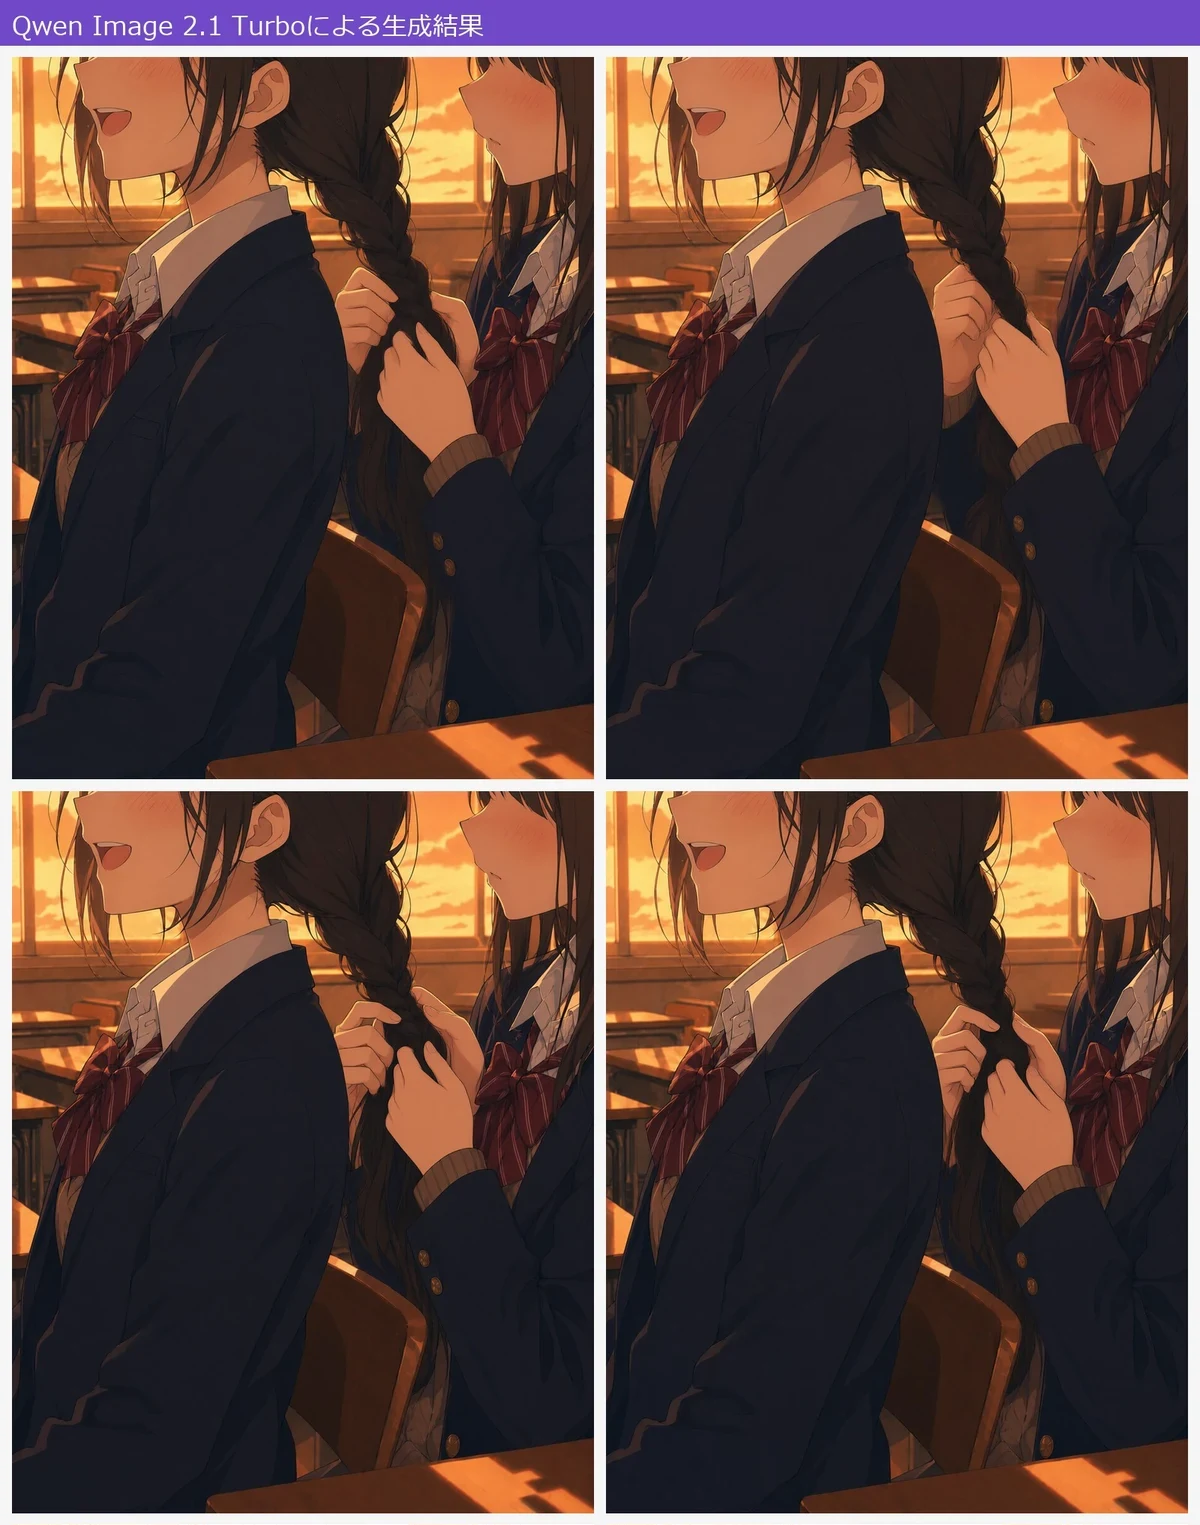 실험 1의 Qwen Image 2.1 결과 10장 중 앞 4장. 출처: 스튜디오 마사카키
실험 2. 같은 캐릭터를 다시 그리기. 작가의 기준 캐릭터 미나의 전신 그림을 주고 허리 위 구도의 서 있는 그림을 그리게 했다. 단순한 지시로는 참조 그림과 같은 전신 그림만 나와서, 정면, 눈높이, 팔을 내린 무표정에 「포니테일 끝부터 허리까지 담고 다리와 발은 화면 밖」이라는 구도 조건까지 집요하게 적어야 했다.
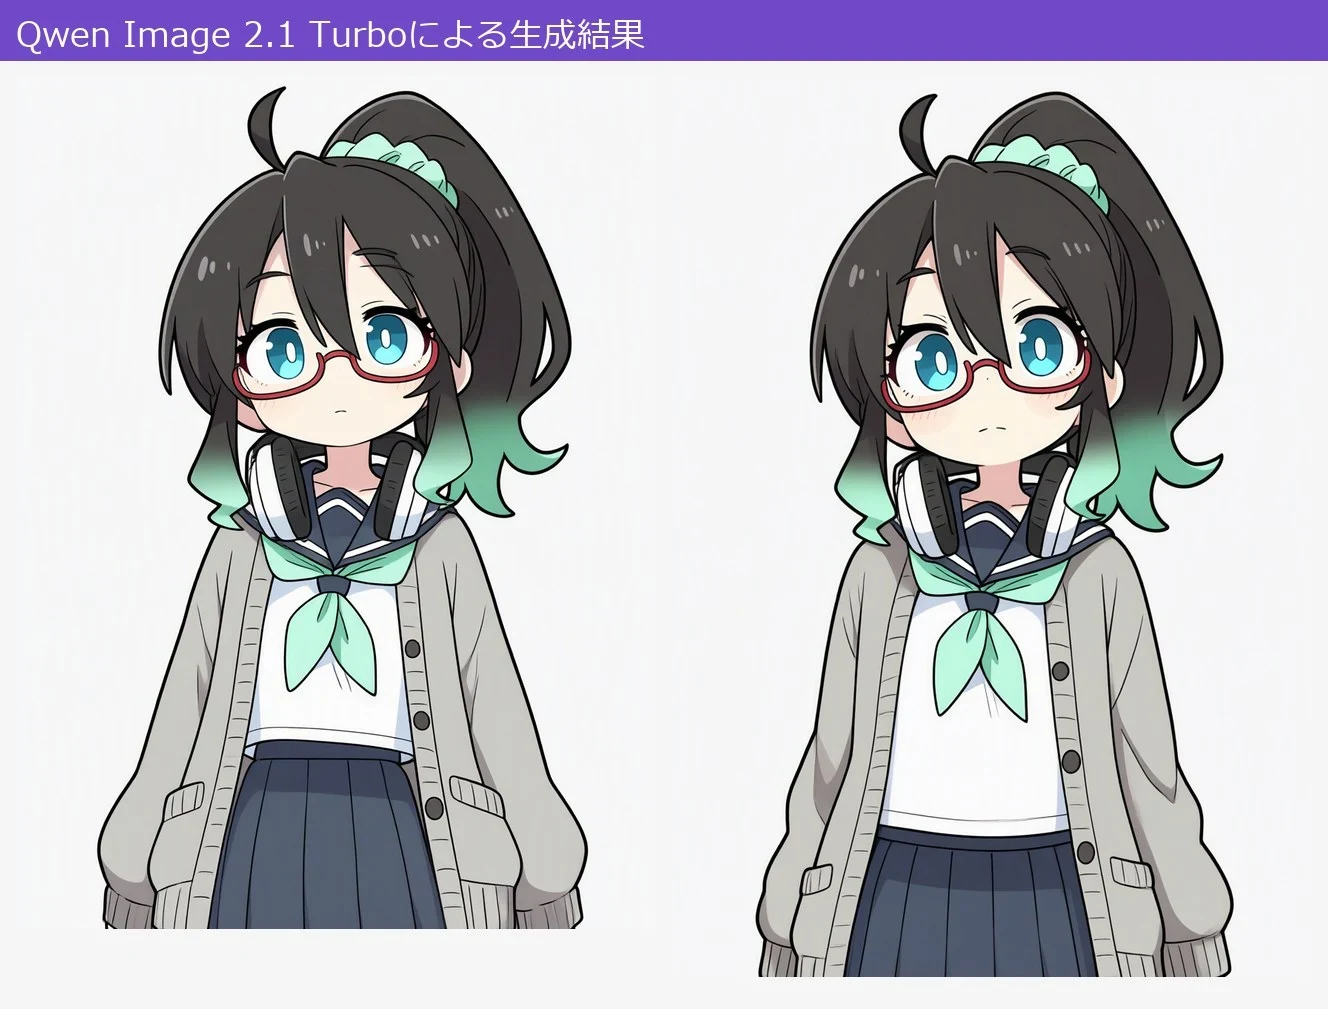 실험 2에서 허리 위 구도로 다시 그린 미나. 왼쪽 그림처럼 눈썹이 겹쳐 그려지는 일이 잦았다. 출처: 스튜디오 마사카키
미나를 편집할 때는 눈썹이 두 겹으로 그려지는 현상이 자주 나왔다. 작가는 Qwen이 데포르메된 애니메이션풍 캐릭터의 눈썹을 제대로 표현하지 못한다며, 눈썹을 머리카락의 일부로 오인하는 것 아닐까 추측한다. 전신 그림을 참조로 주면 결과도 전신 그림으로 그리는 버릇이 있어서, 참조 그림에서 따라 하지 말아야 할 부분은 지시문에 거듭 적어야 한다.
실험 3. 편집을 거듭하면 화질이 얼마나 나빠지나. 실험 2에서 만든 미나 그림에서 슈슈(곱창 머리끈)를 노랗게 바꾸고, 웃는 얼굴로 바꾸고, 빨간 펜을 더하고, 배경을 하늘색으로 바꾸는 네 가지 편집을 차례로 거듭했다. 앞 단계의 출력을 다음 단계의 입력으로 쓰는 방식이다. 작가는 전용 「연속 편집」 워크플로로 네 단계를 한 번에 돌렸고, 단계마다 바꿀 것과 유지할 것을 지시문에 모두 적었다. 1단계 지시문은 「
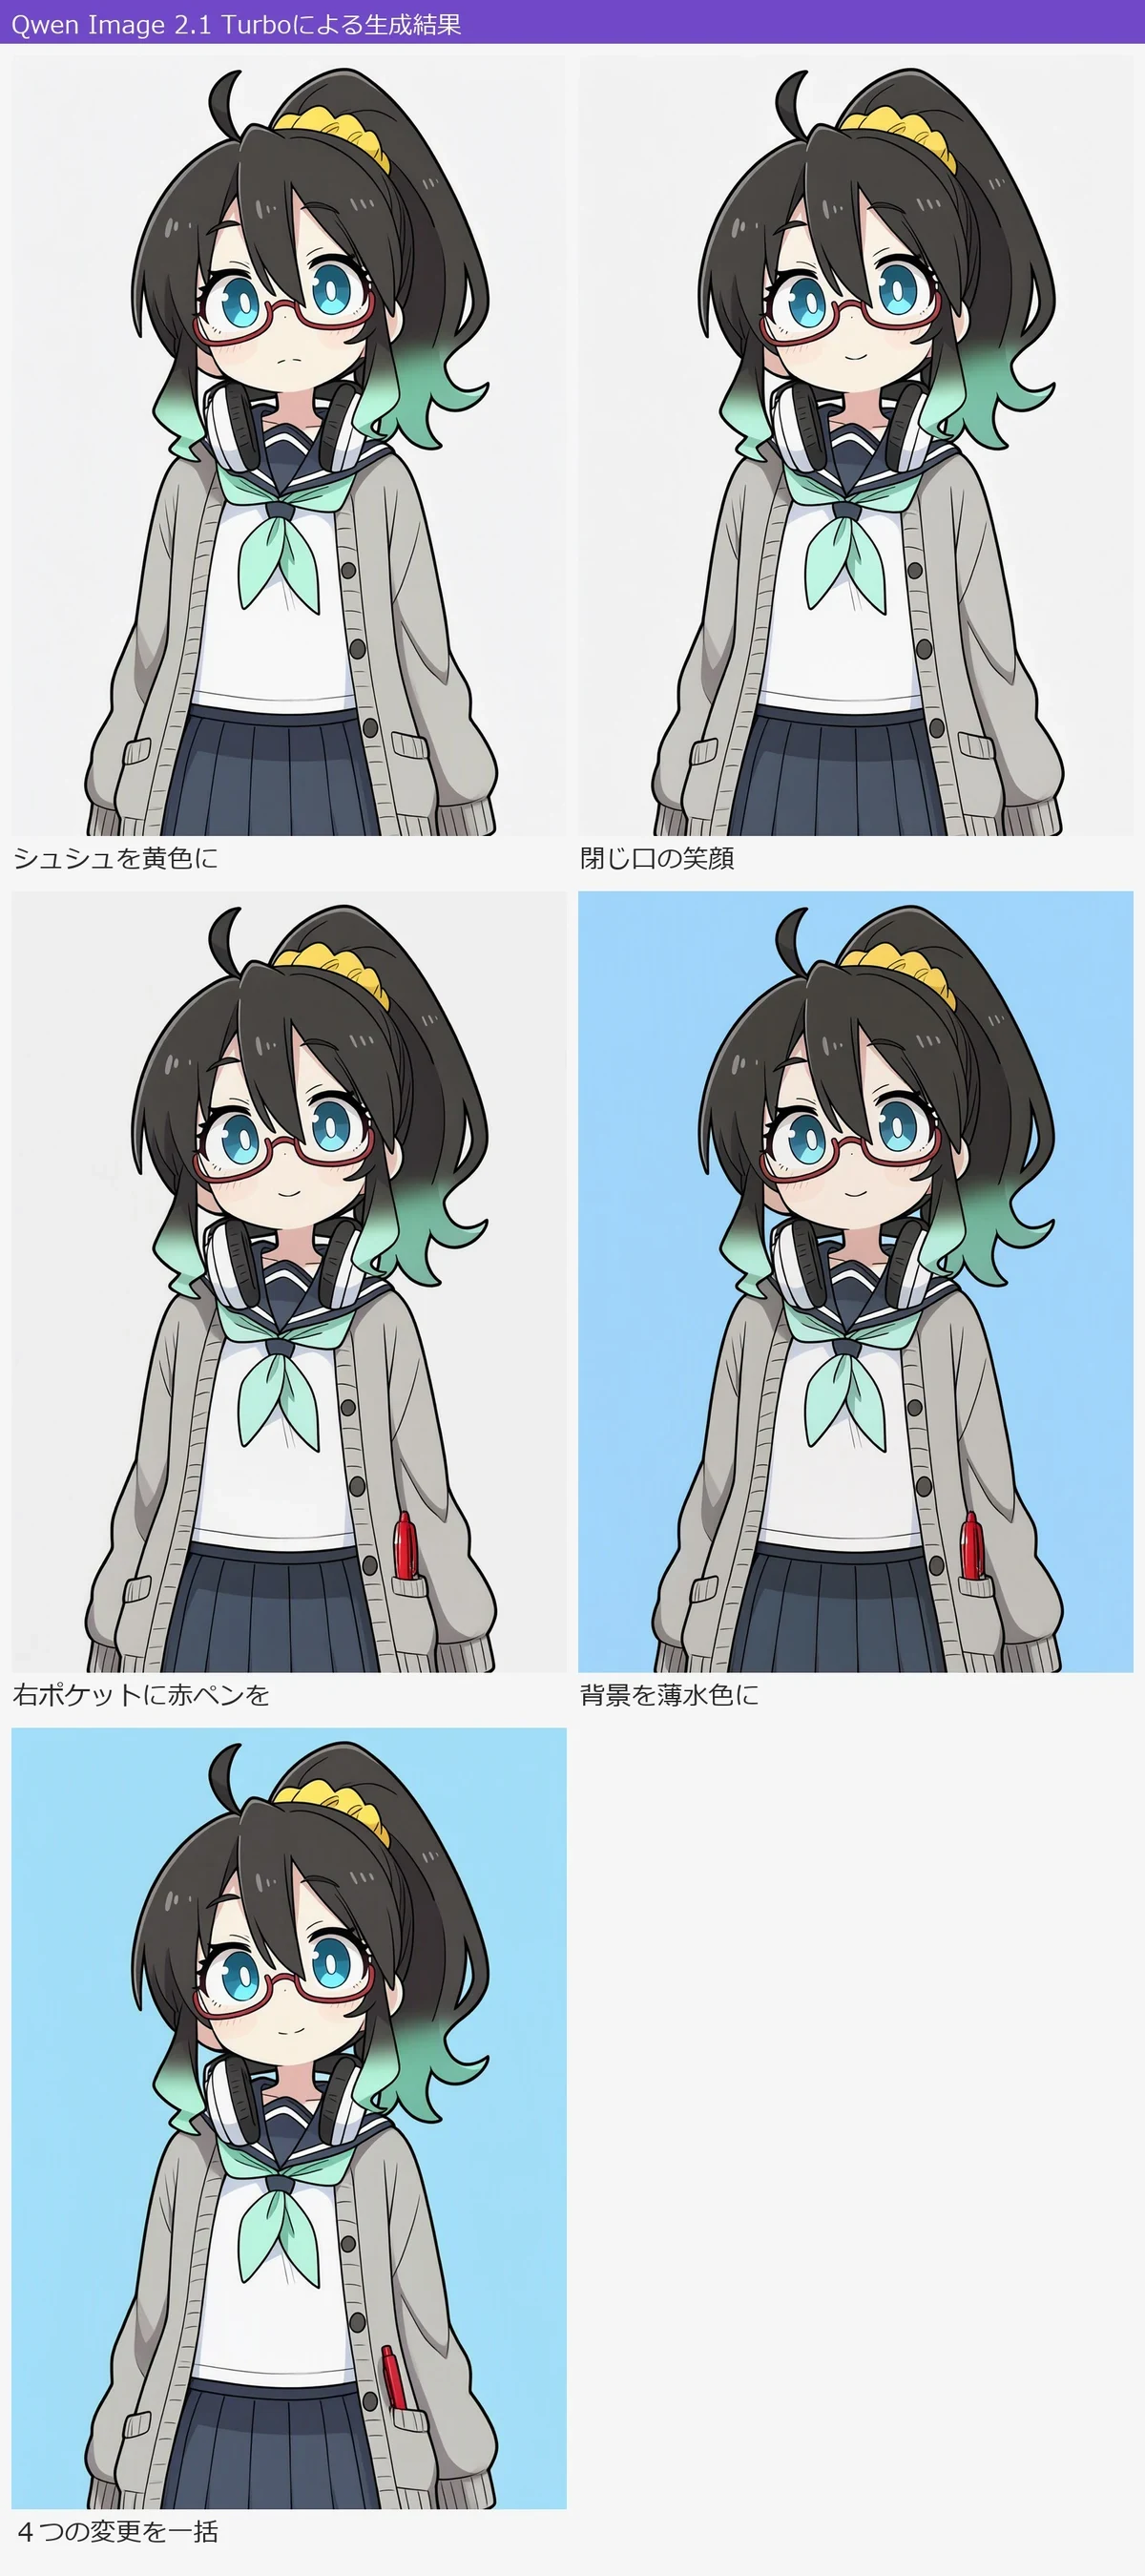 실험 3. 슈슈, 웃는 얼굴, 펜, 배경을 차례로 바꾼 네 장과, 네 가지 변경을 한 번에 요청한 다섯 번째 장. 출처: 스튜디오 마사카키
슈슈 색부터 배경까지 네 가지 변경이 단계마다 반영됐다. 작가가 반긴 점은 GPT 특집 때 골치였던 색 얼룩과 입자 노이즈가 이번에는 거의 보이지 않았다는 것이다. 다섯 번째 장은 네 가지 변경을 한꺼번에 부탁한 것인데, 여러 번 거듭할 때보다 원래 모양이 덜 바뀌었다. 바꾸지 않는 부분까지 원본 그대로 두려면 인페인트 전용 워크플로를 써야 한다.
GPT 특집에는 편집을 거듭하다 화질이 나빠진 미나 그림이 있었다. 이 그림을 Qwen으로 깨끗하게 되돌리는 실험도 했다. 다시 그린 선은 또렷해서 첫인상은 꽤 깔끔하다. 원본과 비교하면 치맛단과 소매, 얼굴, 펜 모양이 달라져 있었다. 작가 말로는 이 기능을 SDXL 같은 모델의 img2img처럼 그림 전체를 다시 그리는 처리로 생각하는 편이 낫다.
투명 배경과 소품 디자인 (실험 4, 5)
실험 4. 배경 투명화. GPT Image 2.5도 투명 배경 생성을 지원하지만, 배경에 흰색과 회색 체크무늬를 그려 넣기만 한 ‘가짜 투명 이미지’를 자주 내놓는다. Qwen에는 공식 작성법을 따라 「이것은 투명도가 있는 RGBA 이미지다」, 「배경은 투명하다」, 「체크무늬, 바닥, 그림자는 그리지 마라」를 영어로 적었다. 결과를 저장하는 노드는 투명도를 보존하는 PNG 형식으로 설정해야 한다.
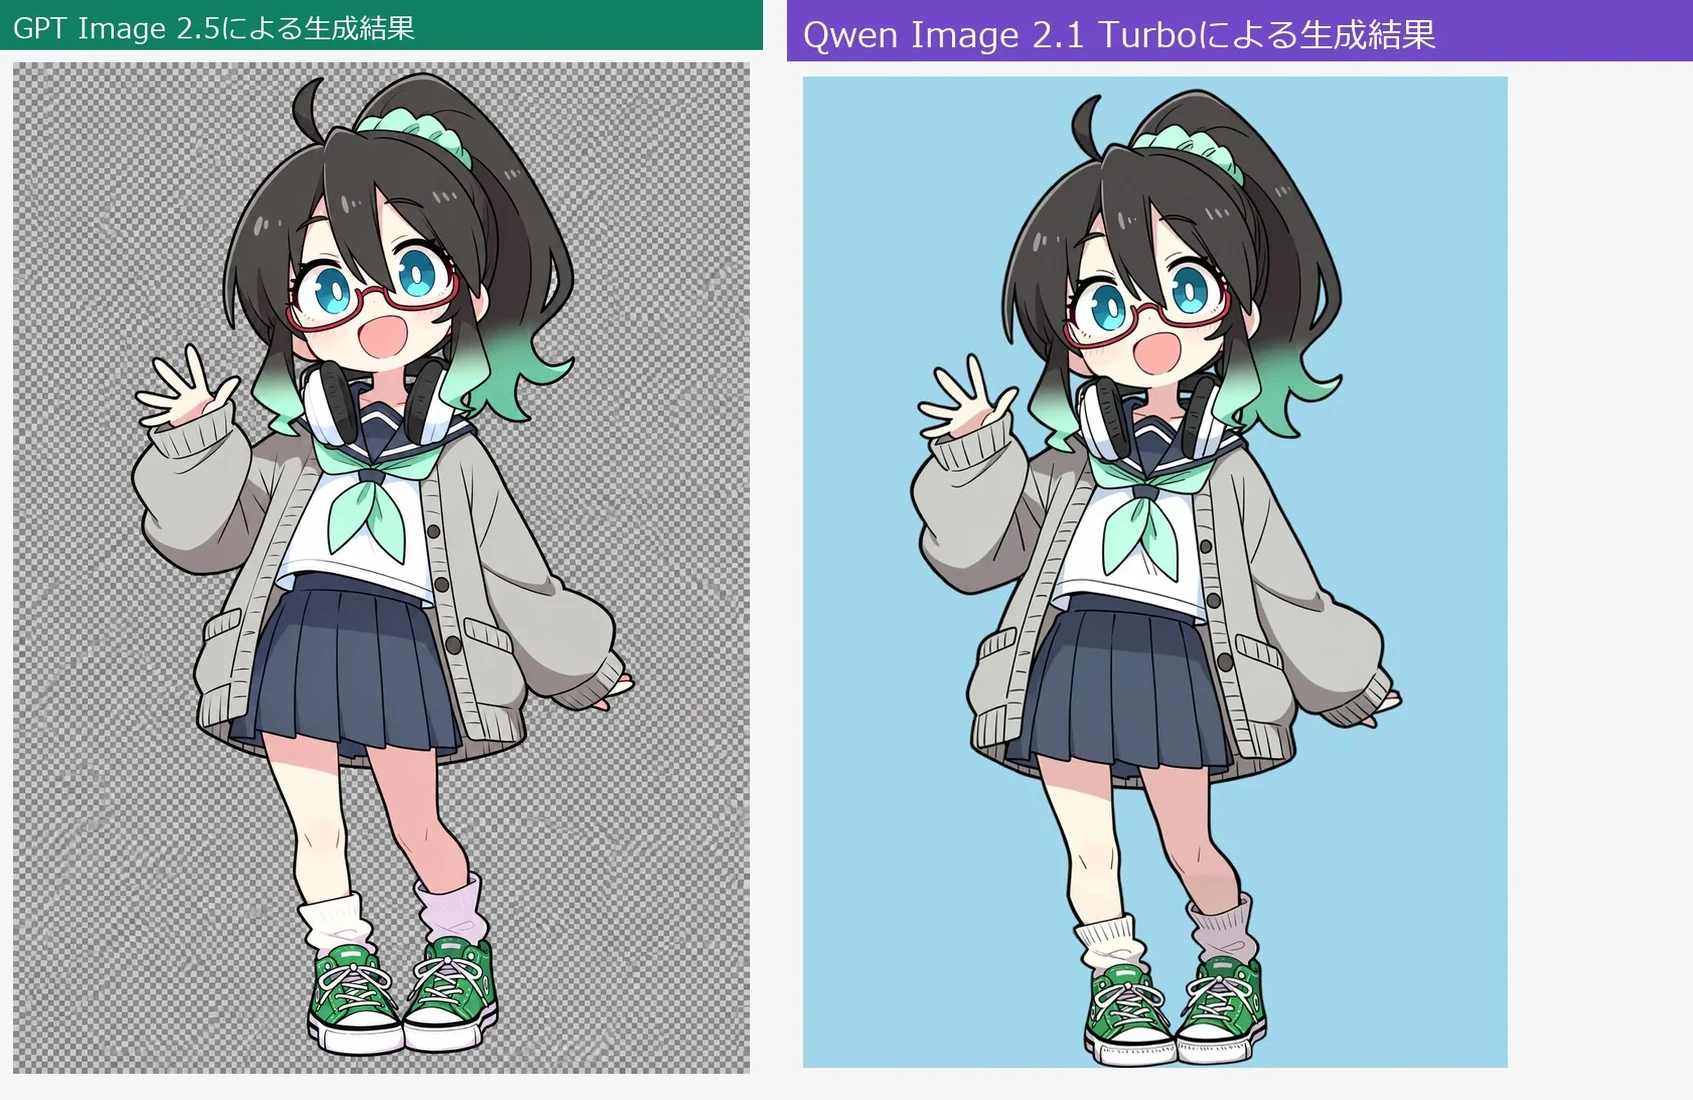 실험 4. 왼쪽 GPT Image 2.5는 체크무늬를 그렸고, 오른쪽 Qwen Image 2.1은 투명 배경 PNG를 만들었다(확인용으로 하늘색 바탕에 겹침). 출처: 스튜디오 마사카키
Qwen은 알파 채널(픽셀마다의 투명도 정보)이 들어 있어 실제로 투명한 영역이 있는 PNG를 만들었다. 단, 확대하면 원본과 달라진 곳이나 세부 화질이 떨어진 곳이 많았고, 배경이 투명해지지 않은 이미지도 가끔 섞였다. 이번에는 1메가픽셀로 생성했는데, 4메가픽셀처럼 더 크게 생성하면 투명 처리가 더 정확해진다고 한다.
실험 5. 게임 소품 외형 제안. 참조 이미지 없이 글로만 그리는 txt2img 시험이다. GPT 특집의 지시는 「보라색 소용돌이를 배경으로, 눈을 본뜬 섬뜩한 마크와 ‘催眠開始(최면 시작)’ 버튼이 있는 최면 스마트폰을 10장」이었다. Qwen에는 동그란 눈과 동심원, 기하학 무늬의 눈, 네온, 마법진, 잉크풍 등 10가지 디자인을 한 장씩 지정했다.
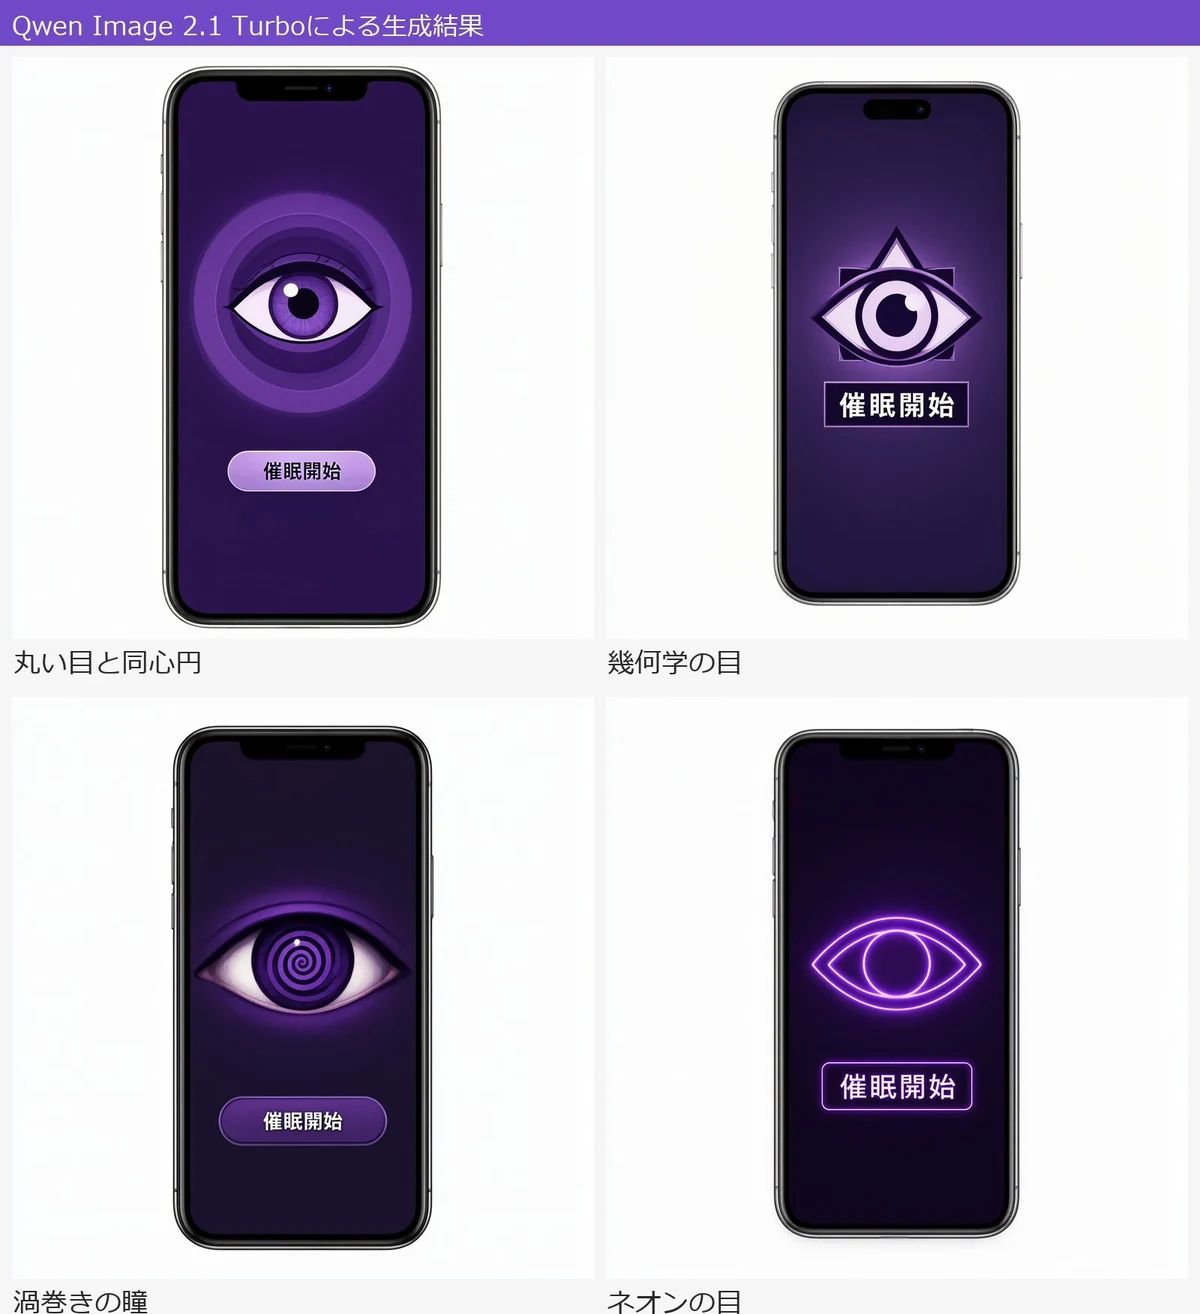 실험 5의 결과 10장 중 앞 4장. 출처: 스튜디오 마사카키
Qwen은 목업 같은 그림을 잘 그려서, 결과가 대체로 의도대로 나왔다. 「催眠開始」 한자 버튼은 10장 모두 읽을 수 있고, 스마트폰 디자인도 여러 종류가 나왔다. 한편 화면 속 눈 디자인은 묘하게 사실적이라 작가에게는 징그러워 보였다. 세부와 화풍을 지시문에 자세히 밝히면 어느 정도 조절할 수 있을 것으로 작가는 본다.
표정, 포즈, 옷 (실험 6, 7)
실험 6. 같은 캐릭터의 표정과 포즈 바꾸기. GPT에서는 「다양한 표정, 포즈 n=10」이라고만 쓰면 됐다. Qwen에서는 시안 10개를 한 번에 만드는 「10안 일괄」 워크플로로 표정과 동작의 조합 10가지를 각각 다른 지시문으로 넣었다. 「입을 벌려 환하게 웃으며 한 손을 어깨 위로 흔든다」 같은 부분만 장마다 바꾸는 방식이다.
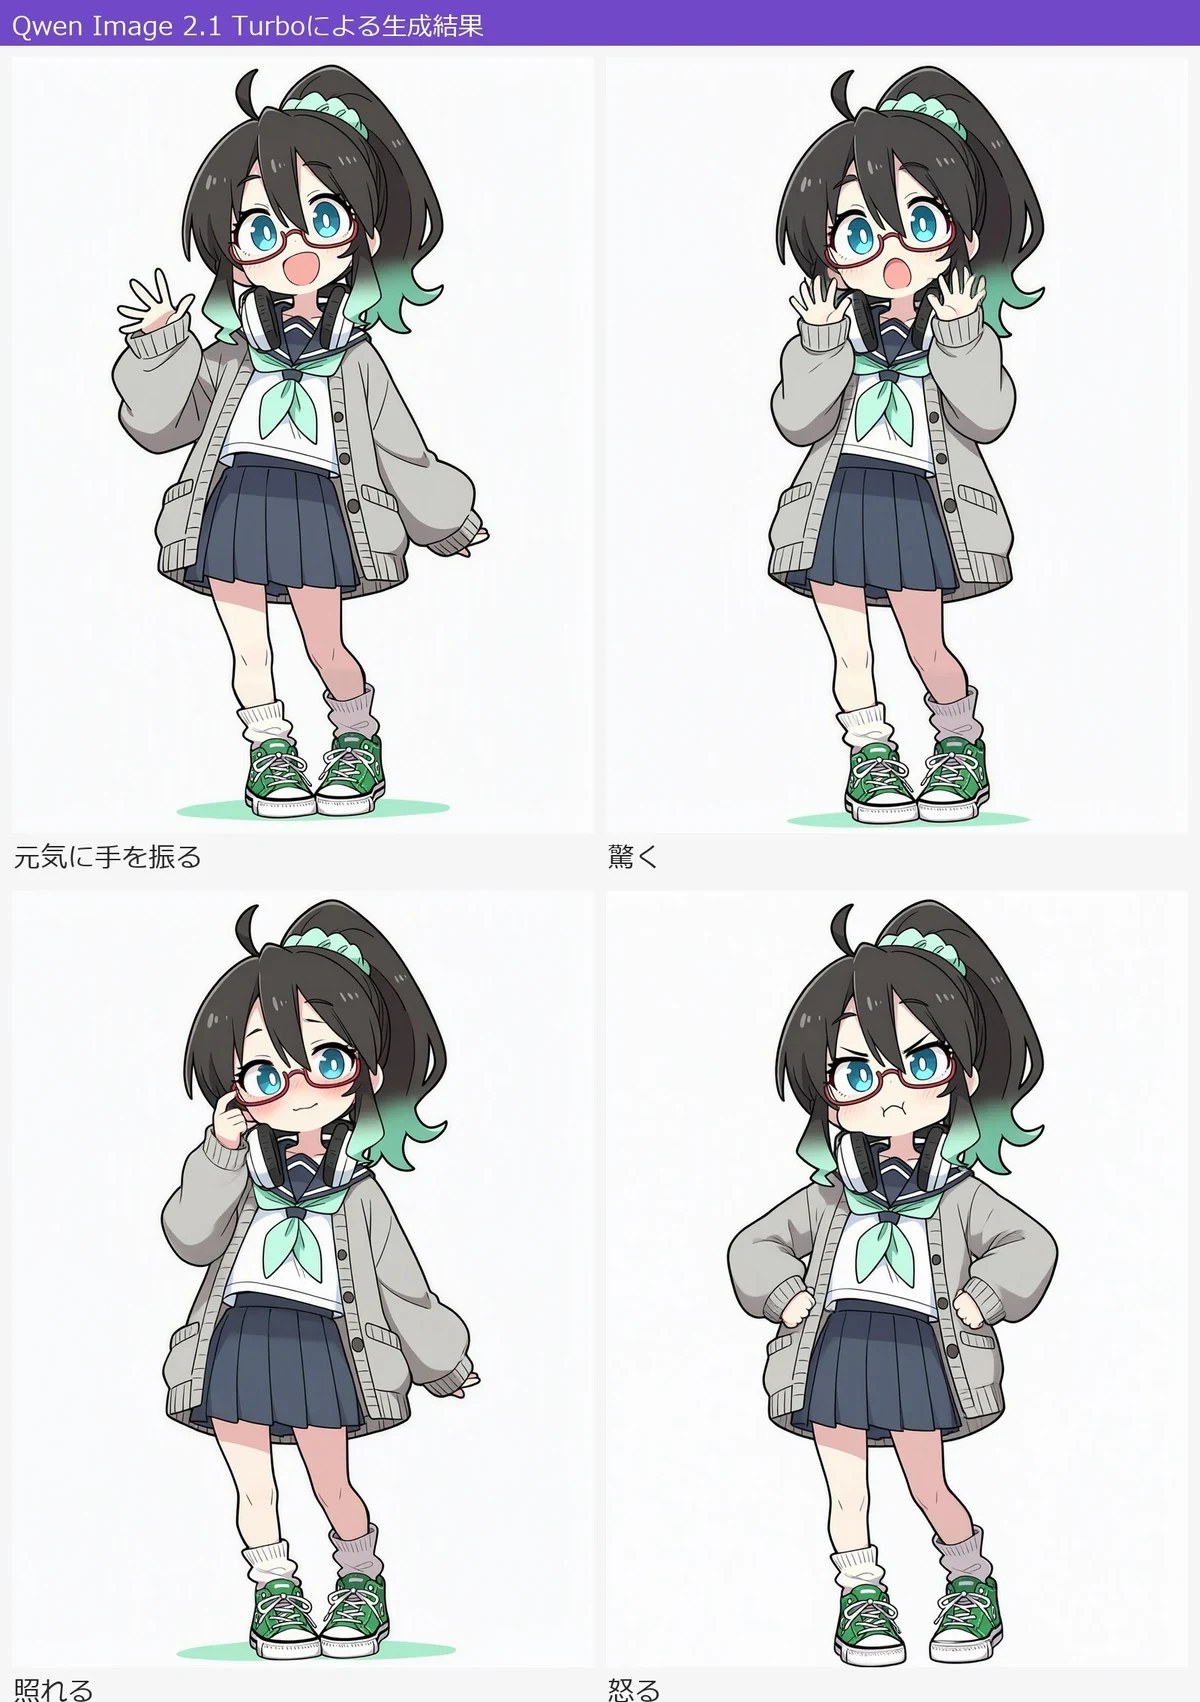 실험 6의 결과 10장 중 앞 4장. 출처: 스튜디오 마사카키
여기서도 눈썹이 겹치는 현상이 나왔지만, 포즈만 바꾸는 정도는 대체로 해냈다. 「인사하기」는 두 손을 앞에 모으고 몸을 살짝 기울이는 정도에 그쳐 깊은 인사가 되지 않았다. 작가가 보기에 Qwen Image 2.1은 <image1>로 넣은 그림의 겉모습을 그대로 따라 그리는 성향이 있어 큰 변화를 주기 어렵다. GPT처럼 분위기를 읽어 그리지 못하므로 원하는 것을 집요하고 명확하게 지시해야 한다.
실험 7. 의상 바리에이션 제안. GPT에는 「평상복, 외출복, 작업복 등」으로 느슨하게 부탁하고 세부 디자인은 모델에게 맡겼다. Qwen에게 똑같이 맡기면 옷을 제안하는 능력에서 GPT를 이기지 못하므로, 작가가 옷 10벌을 먼저 정하고 「남색 더플코트, 민트색 머플러, 회색 주름치마, 짙은 타이츠, 초록 운동화」처럼 내용까지 적어 주었다.
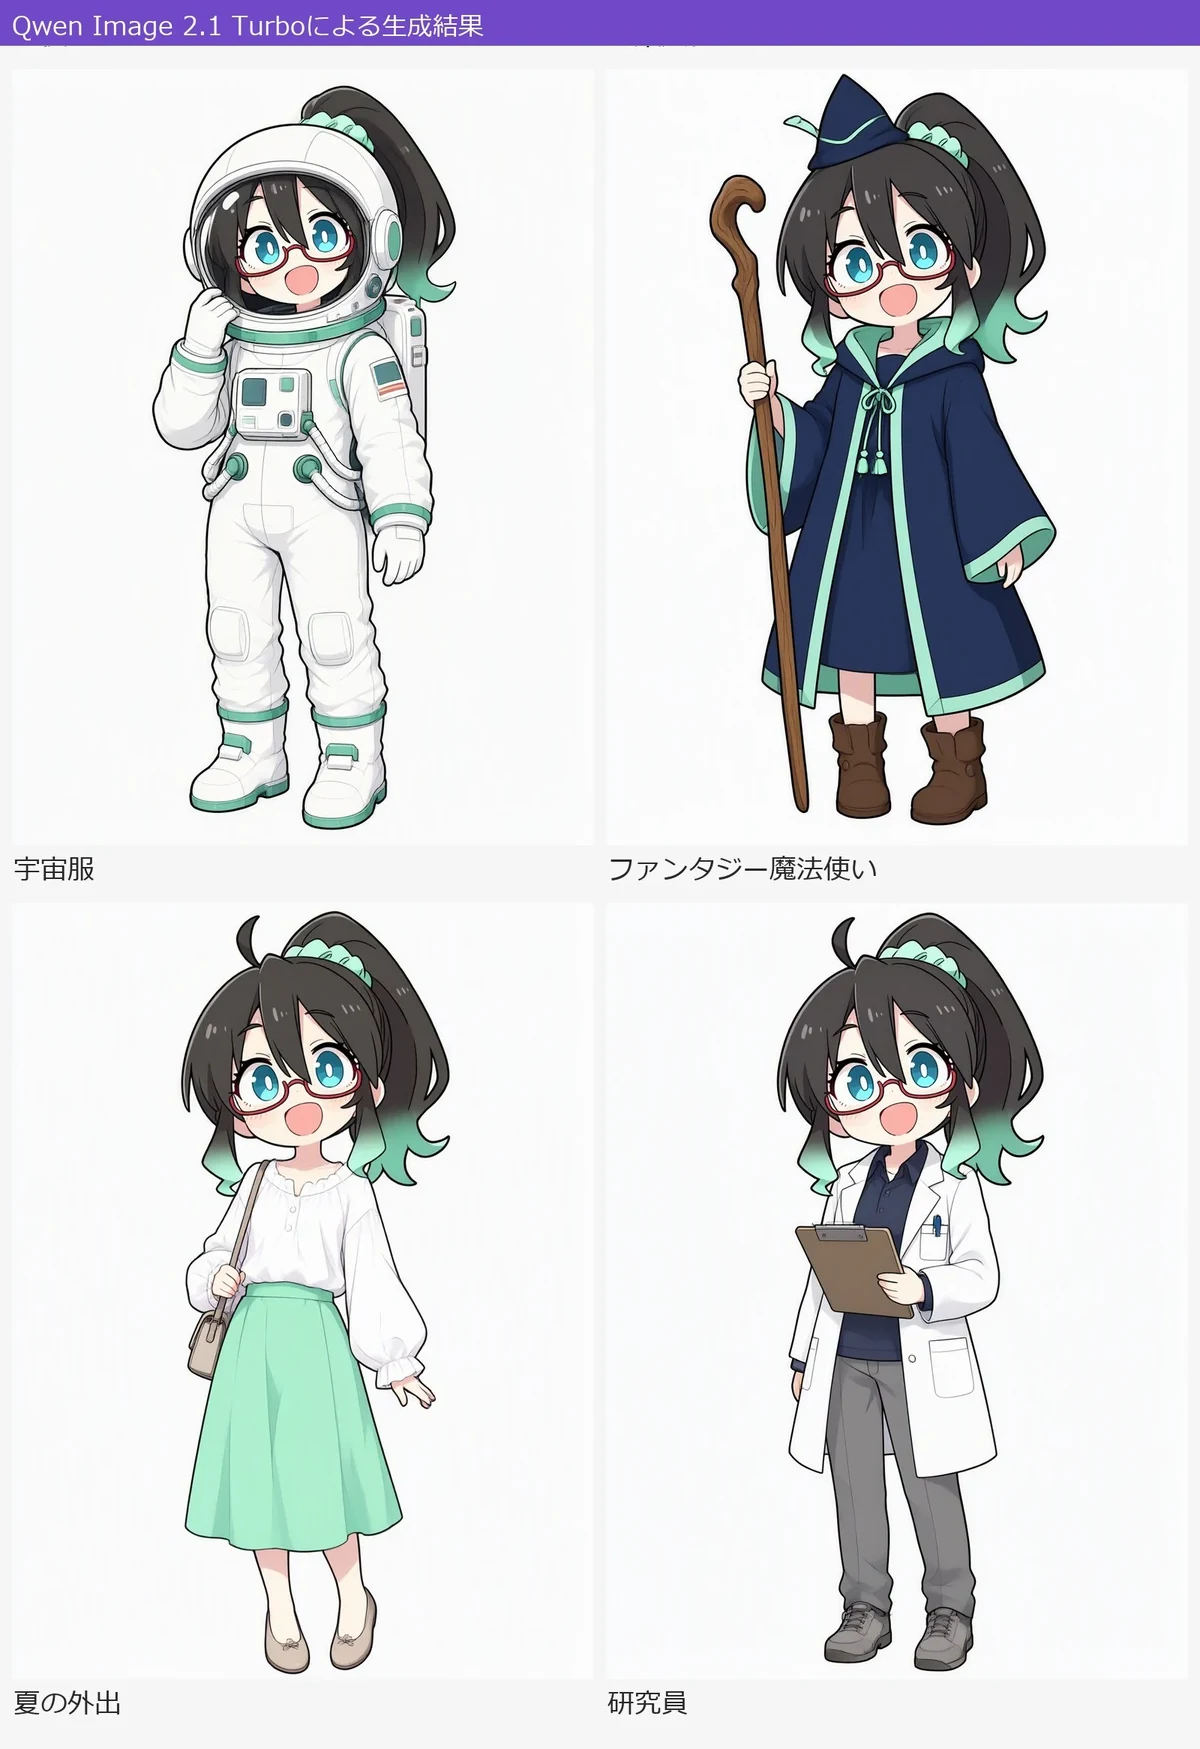 실험 7의 결과 10장 중 뒤쪽 4장. 우주복, 판타지 마법사, 여름 외출복, 연구원 차림이다. 출처: 스튜디오 마사카키
옷 입히기는 상당히 잘해서, 10벌 모두 지정한 옷이 됐고 미나의 머리, 안경, 머리와 몸의 비율도 꽤 유지됐다. 우주복을 두고는 이대로 우주선 밖에 나가면 죽는다는 농담도 남겼다. 그래도 작가는 디자인의 세련됨과 자연스러운 몸 비율은 GPT가 낫다고 느꼈다. 정확히 말하면 지시를 해석해 이미지 모델에 전달하는 GPT-6 Astra의 솜씨다. 작가의 표현을 빌리면 Qwen은 ‘말한 옷을 입히는 것’은 잘하지만, 무엇을 입힐지는 이쪽에서 생각해 줘야 한다. 「연구원」 차림에서는 남성 같은 체형으로 그려지기도 했다.
캐릭터를 8방향에서 (실험 8)
오리지널 캐릭터 키누가와 씨의 서 있는 그림을 주고 앞뒤, 좌우, 대각선의 8방향에서 그리게 했다. GPT Image 2.5는 배경 투명화에는 실패했지만 좌우 비대칭인 앞머리까지 틀리지 않고 그렸다. Qwen Image 2.1은 한 장에 8방향 컷을 함께 그리지 못해서, 작가가 한 방향씩 차례로 그리는 전용 「8방향 생성 워크플로」를 짰다.
이 워크플로는 Qwen Image 2.1용 카메라 앵글 LoRA인 QMA를 쓴다4. 먼저 Turbo가 아닌 일반판 모델로 정면에서 똑바로 선 무표정 그림을 공들여 만들고, 그 그림을 공식 Turbo와 QMA로 나머지 7방향으로 회전시킨다.
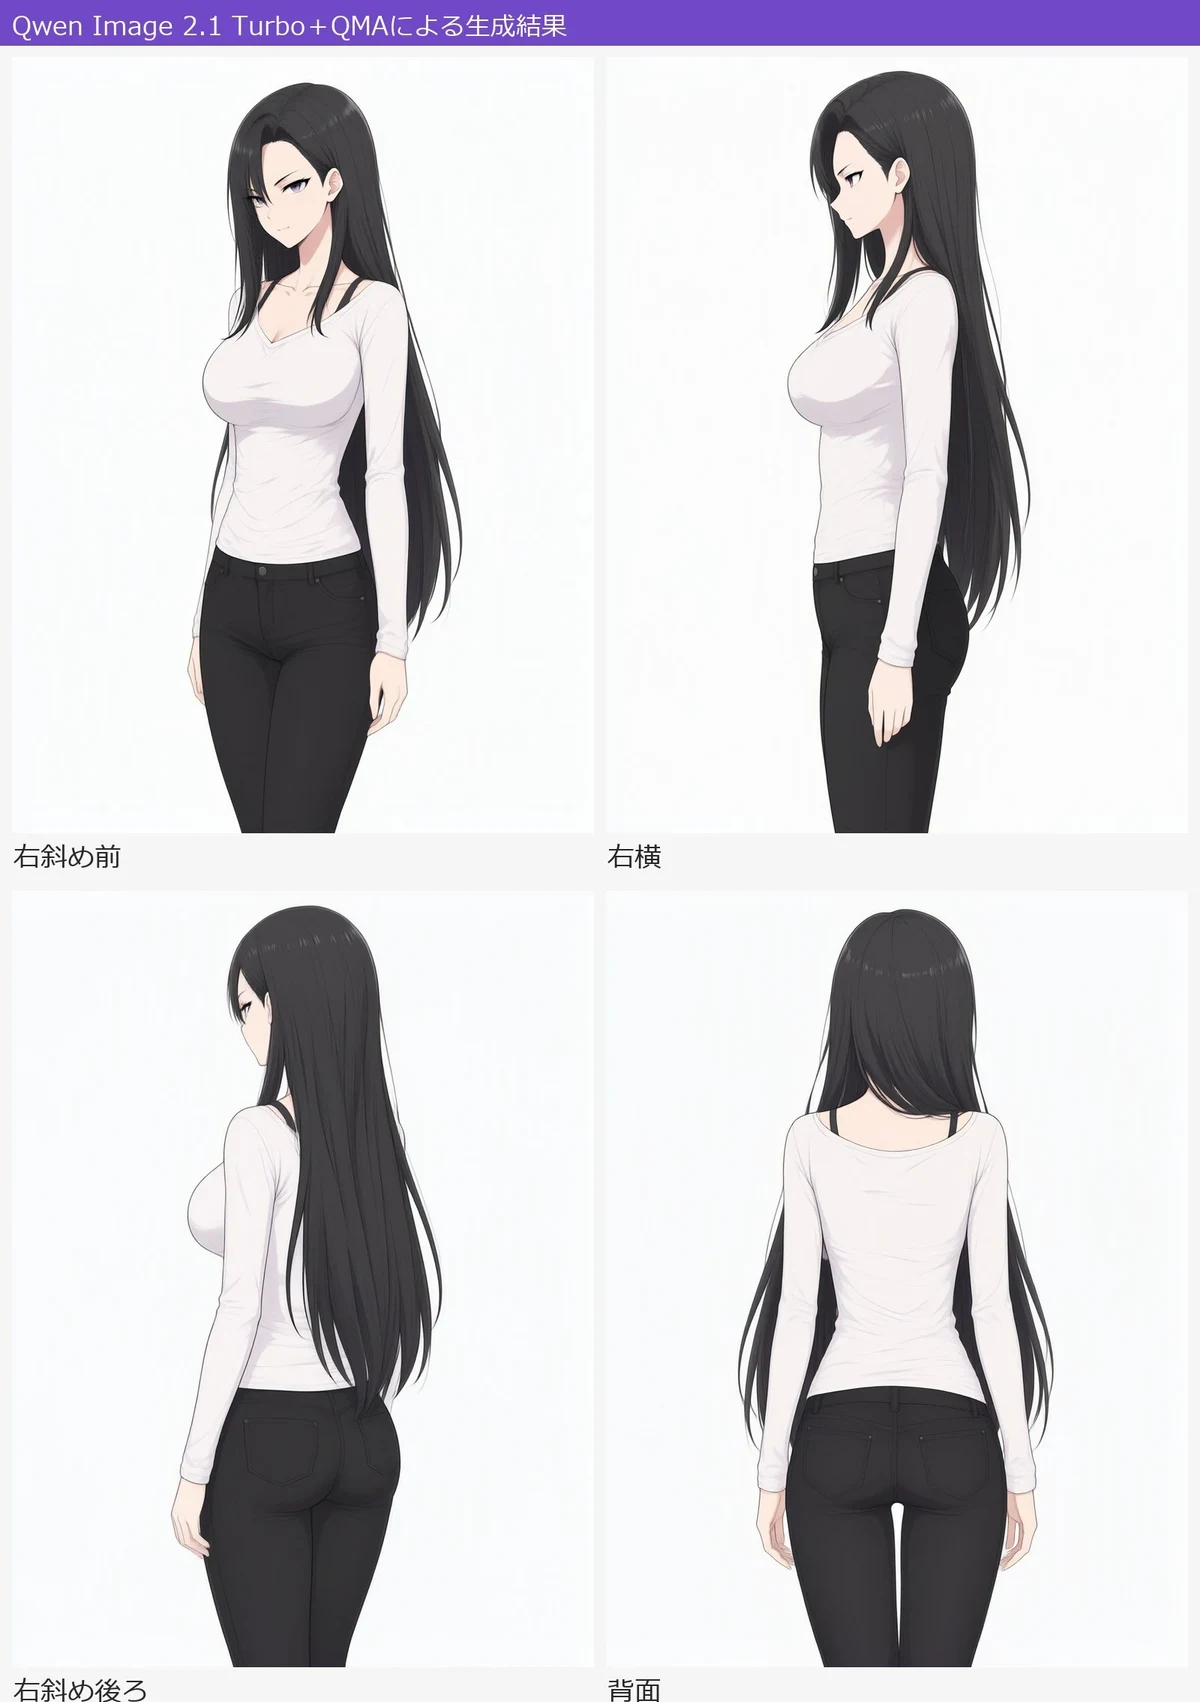 실험 8. 정면 그림을 Turbo와 QMA로 회전시킨 7장 중 4장. 오른쪽 아래 뒷모습은 뒷머리가 좌우로 갈라져 등이 보인다. 출처: 스튜디오 마사카키
8장 모두 지시한 방향으로 그려졌다. 얼굴, 머리, 옷의 세부는 장마다 조금씩 다르지만, 원래 그림에 보이지 않던 등 쪽 머리와 뒷모습도 그럴듯하게 그려 넣었다. 대각선 컷은 약간 일그러졌다. 뒷모습을 지시하자 뒷머리가 좌우로 갈라져 등이 보이는 그림이 나왔는데, 작가는 이것을 Qwen에 융통성이 없다는 예로 든다. 이 워크플로는 입력 비율과 상관없이 항상 세로 3:4로 그린다. 크기는 1~4메가픽셀 중에서 고르고, 한 번 돌릴 때마다 8장을 새 폴더에 저장하므로 여러 번 돌려도 결과가 섞이지 않는다.
공간을 추론하는 과제 (실험 9~12)
실험 9. 캐릭터의 방 추론. 헤드폰을 쓴 여고생 미나를 보여 주고 어떤 방에서 사는지 추론하게 하는 실험이다. GPT는 캐릭터의 특징을 살린 방을 여러 가지 내놓았지만, Qwen은 「이 캐릭터의 방」이라고만 하면 알아듣지 못한다. 작가는 공부 책상 중심의 방, 음악 작업 방, 문구를 좋아하는 사람의 방, 레트로 게임 방 등 10개 방의 설정을 직접 정해 주었고, 「캐릭터, 다른 사람, 인형, 캐릭터 포스터, 글자는 넣지 마라」라고도 적었다. 그런데도 10장 모두 입력한 캐릭터를 방에 그려 넣었다.
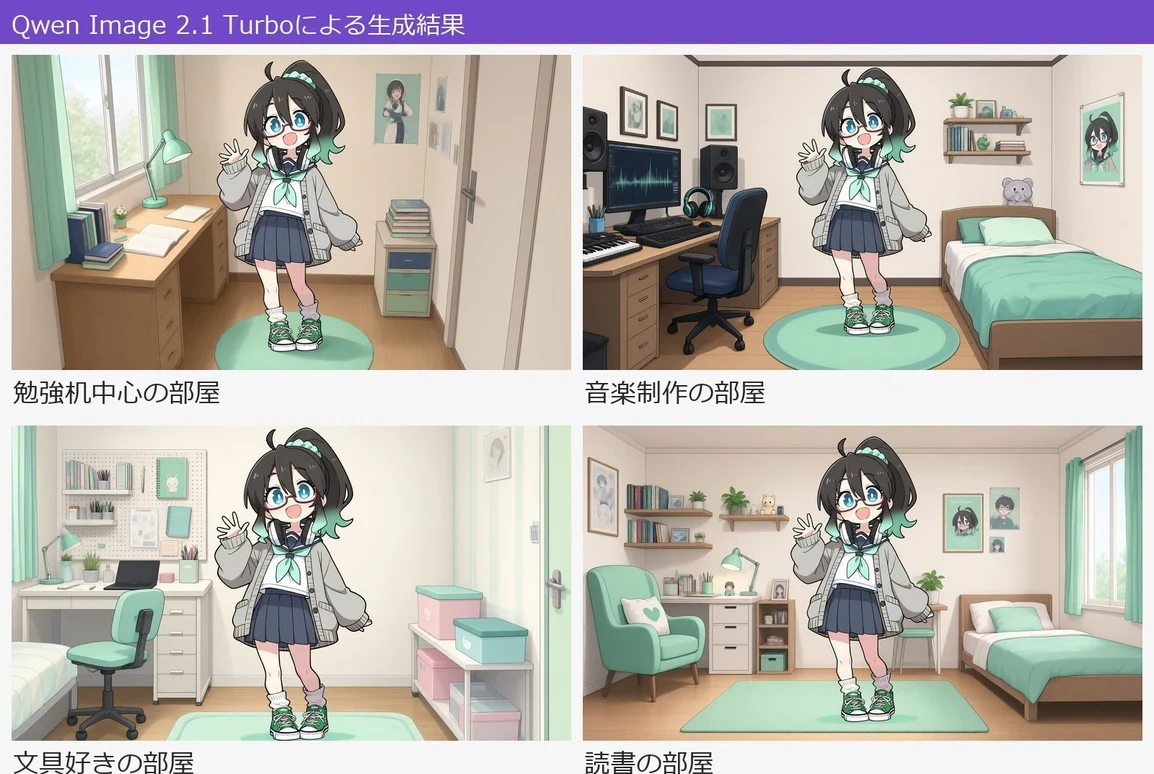 실험 9의 결과 10장 중 앞 4장. 「캐릭터를 그리지 마라」라고 적었지만 방마다 미나가 서 있다. 출처: 스튜디오 마사카키
가구와 배색은 방마다 다르게 그려 분위기는 괜찮은 편이다. 작가는 참조한 서 있는 그림의 존재감이 너무 강한 것 같다며, 미나 그림을 참조로 주지 말고 「민트색을 테마로 한 여고생의 방을 애니메이션 터치로 그려라」라고만 지시하는 편이 나을 것으로 본다.
같은 실험을 키누가와 씨로도 했다. 부부의 침실을 그리되 더블 침대와 베개 두 개, 바닥까지 내려오는 발코니 창, 닫힌 문, 붙박이장, 전신 거울을 구체적으로 지정하고, 참조 그림은 「가정의 분위기와 화풍의 영감으로만」 쓰라고 적었다. 이번에는 키누가와 씨를 그려 넣지 않는 데 성공했다. 하지만 바닥까지 내려오는 창 대신 허리 높이 창을 그린 그림이 많았고, 일본 아파트로 보기 어려운 구조도 있었다. 화각과 가구 배치도 서로 비슷해 생활감이 없었다. 결과는 캐릭터의 생활을 상상한 그림이 되지 못하고 ‘지정한 가구를 늘어놓은 침실’에 그쳤다.
실험 10. 같은 방을 다른 각도에서. 이번에는 배경을 빙 돌려 볼 수 있는지 시험했다. 키누가와 씨의 무술 도장 그림을 주고, GPT가 해냈듯이 원래 그림에 보이지 않는 벽과 출입구를 그릴 수 있는지 확인하려 했다. Qwen에는 「수납장 문을 등지고 반대편을 본다」, 「오른쪽으로 30도 돈다」처럼 카메라의 위치와 방향을 장마다 말로 설명했다.
LoRA 없이 공식 Turbo로 그리자 화각이 거의 바뀌지 않았다. 다다미 색과 비품은 잘 유지했지만, 「창을 등지고」라고 해도 창이 그대로 보였고, 30~90도 회전을 지시해도 같은 방향에서 본 그림이 조금 달라지는 데 그쳤다.
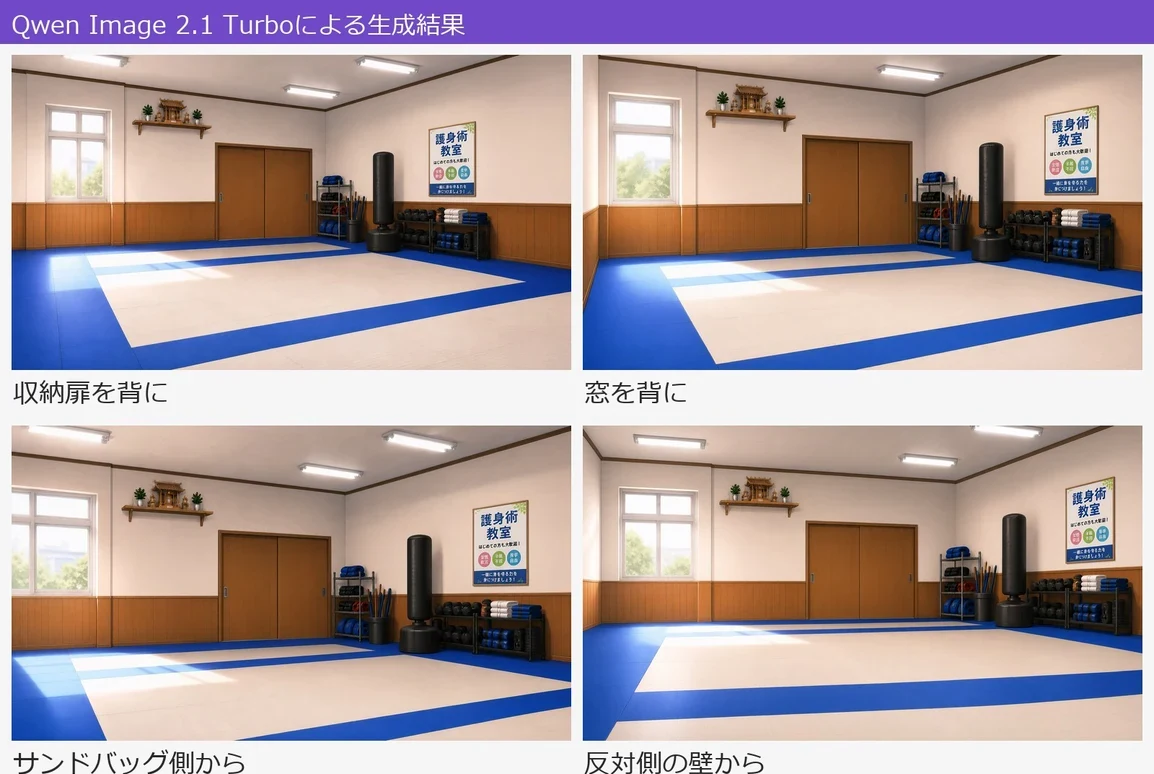 실험 10, LoRA 없이 그린 결과 10장 중 앞 4장. 「수납장 문을 등지고」, 「창을 등지고」 같은 지시에도 거의 같은 벽이 보인다. 출처: 스튜디오 마사카키
작가는 실험 8의 카메라 앵글 LoRA QMA를 방에도 써 봤다. 배포자의 권장에 맞춰 일반판 Qwen Image 2.1을 쓰고, 30단계, CFG 3, LoRA 강도 1로 설정했다. 샌드백이 앞쪽에 크게 들어오는 등 화각은 꽤 달라졌다. 그러나 자세히 보면 원래 그림에 보이는 창과 수납장 쪽 벽을 재구성했을 뿐, 반대편의 보이지 않는 벽을 그린 컷은 한 장도 없다.
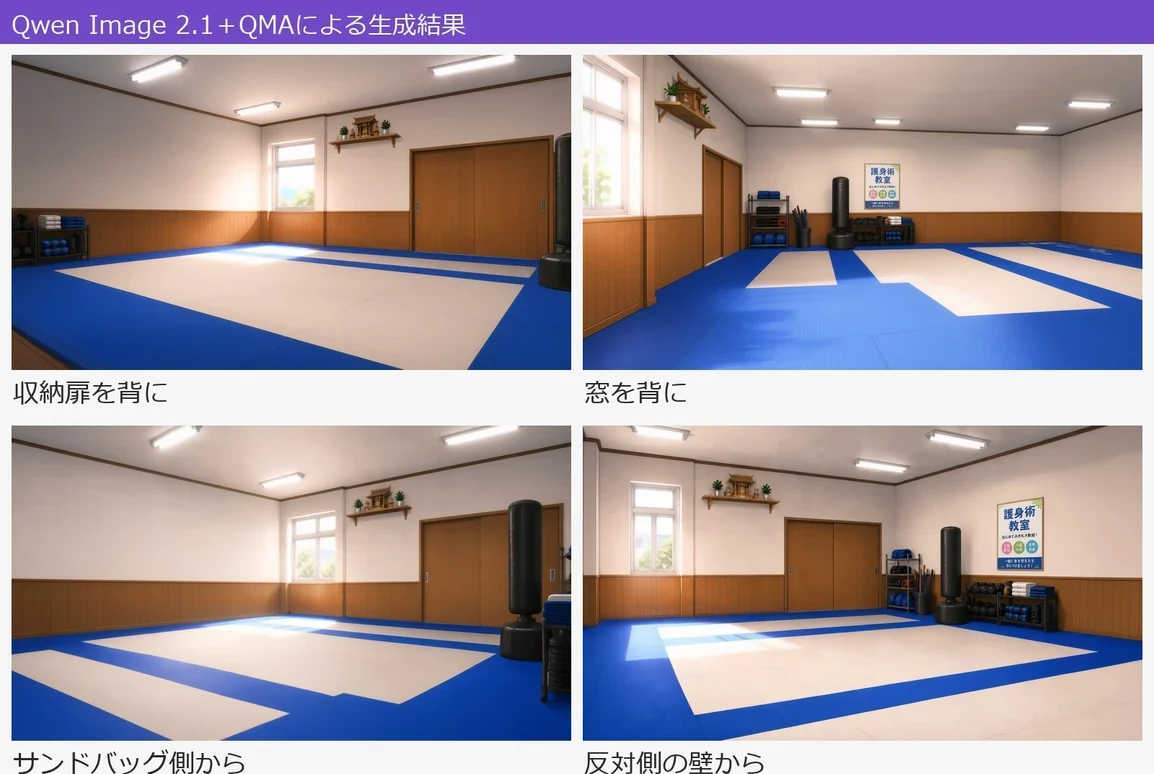 실험 10, QMA LoRA를 쓴 결과 10장 중 앞 4장. 화각은 달라졌지만 원래 그림에 보이던 벽만 나온다. 출처: 스튜디오 마사카키
LoRA를 써서 침실 그림으로도 실험했다. 가구 배치는 그대로 둔 채 입구, 창, 붙박이장 쪽으로 카메라를 돌리게 했다. 시점과 침대 방향은 지시대로 달라졌다. 문제는 창과 문, 붙박이장과 거울이 그림마다 다른 벽에 그려졌다는 점이고, 이 때문에 같은 방을 다른 방향에서 본 그림으로 읽히지 않았다. 좌우를 뒤집은 것에 가까운 그림이나 가구가 멋대로 늘거나 줄어든 그림도 있었다. 작가 판단으로는, GPT가 반대편 벽까지 그려 낸 것과 비교할 때 배경 속에서 카메라를 돌리는 과제는 Qwen에게 아직 꽤 어렵다.
실험 11. 평면도로 실내 배경 한 벌 만들기. 배경 한 장만 보고 반대편을 상상하기 어렵다면, 평면도를 보여 주는 것은 어떨까. 2LDK 평면도를 참조로 주고 각 방의 실내를 게임 배경으로 그리게 했다. 2LDK는 방 두 개에 거실, 식당, 부엌이 딸린 일본식 집 구조다. 작가는 Qwen이 도면만 보고 구조를 읽어 내리라고 기대하기 어려워서, 어디에 무슨 방이 있는지 영어로 모두 설명했다. 그리고 「현관을 등지고 복도 끝의 LDK를 본다」, 「소파를 정면에서」 등 10컷을 바닥에서 1.6m쯤 되는 눈높이로 그려 달라고 했다.
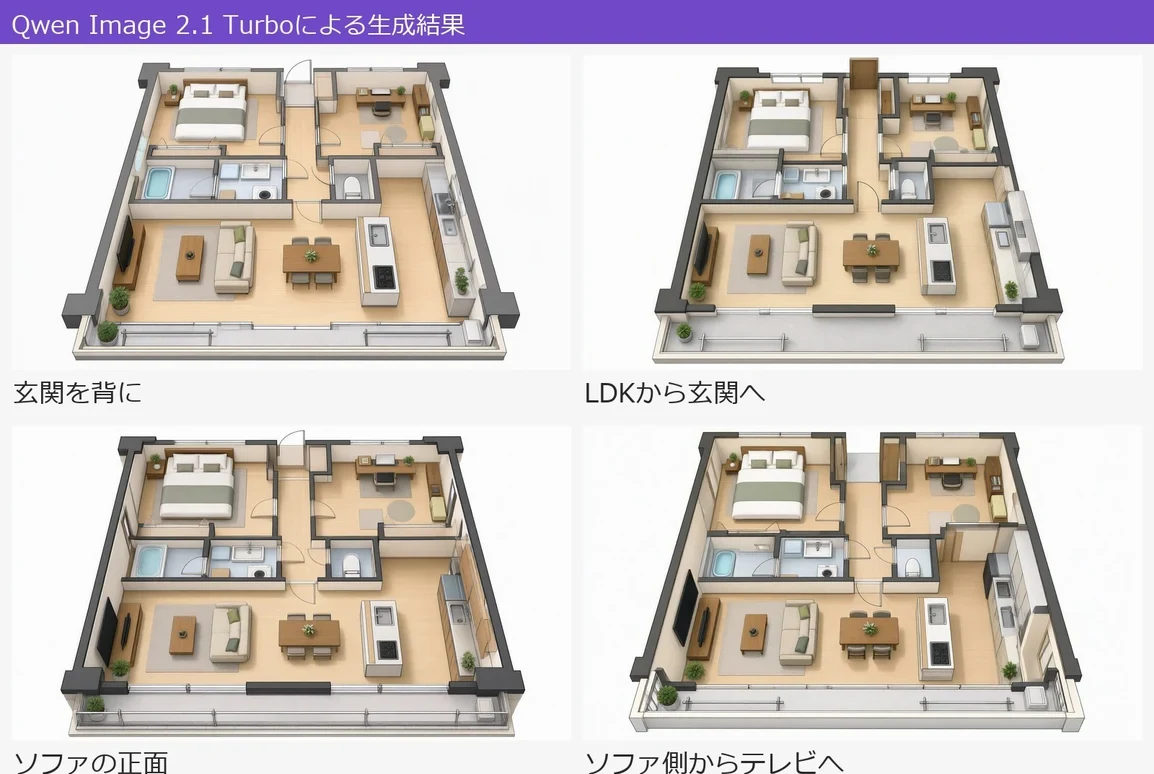 실험 11의 결과 10장 중 앞 4장. 눈높이 실내 대신 평면도를 그대로 입체로 만든 모형이 나왔다. 출처: 스튜디오 마사카키
결과는 실망스러웠다. 10장 모두 방 안에 선 사람의 눈높이에서 본 그림 대신, 평면도를 그대로 입체로 만든 모형을 위에서 내려다본 듯한 그림이 나왔다. 가구의 대략적인 배치는 읽어 냈다. 작가는 Qwen이 도면이라는 ‘위에서 본 그림’에서 시점을 바꾸는 일을 어려워한다고 보고, 미나를 방에 그려 넣고 만 실험 9와 원인이 같을 것으로 추측한다.
실험 12. 건물 외관과 배경 한 벌. 참조 이미지 없이 txt2img로 일본 러브호텔의 배경 한 벌을 그리는 실험이다. GPT 특집에서는 현관, 침대, 소파, 샤워실, 외관 등을 그린 그림 10장을 연속으로 받았다. Qwen은 한 번에 한 장만 그린다. 작가는 컷끼리 구조가 모순되지 않도록 「2층 건물에 크림색 외벽, 객실은 베이지색 벽, 북쪽 벽에 더블 침대, 서쪽에 창」처럼 가상 호텔의 설정을 통째로 만들고, 이 설정을 매번 지시문에 붙여 외관, 현관, 욕실 등을 부탁했다. 그러나 컷 모음이라는 의도가 전해지지 않아 외관과 침대 같은 것이 한 장에 섞인 이상한 그림이 나왔다. 애니메이션풍을 지시했는데도 화풍은 사실적이었다. 지시문을 궁리하면 해결될지도 모르지만, 이 작업을 꼭 Qwen Image 2.1로 해야 할 상황은 잘 떠오르지 않는다고 작가는 덧붙인다.
유료 구간의 실험 13~38과 작가의 결론
웹 기사는 실험 12에서 끝나고, 나머지는 PixivFANBOX의 1,000엔 플랜 회원만 읽을 수 있다. 목차로 확인한 남은 실험은 다음과 같다.
| 실험 | 과제 |
|---|---|
| 13~18 | 시간대 바꾸기, 캐릭터와 배경 합성(막대 인간으로 앉을 위치를 알려 주는 실험 포함), 화풍이 다른 두 사람을 한 그림에 그리기, 화풍의 일부만 따라 하기, 다른 상황 전개, 수위의 한계 시험 |
| 19~22 | 캐릭터 시트, 표정 바리에이션, 주제로 개그 네 컷 만화 만들기, 대사와 전개가 정해진 한 페이지 만화 |
| 23~29 | 사진을 만화 배경으로, 일본어가 들어간 메신저 스탬프 한 벌, 인포그래픽과 기사 삽화, 동인지 행사 포스터 10안, 기사 섬네일, 뮤직비디오용 연속 컷, 막대 인간 콘티를 만화로 완성 |
| 30~38 | 캐릭터 특징을 살린 로고, 같은 디자인의 아이콘 한 벌, 캐릭터 굿즈 상품 사진, 필요한 정보를 읽을 수 있는 전단, 앱 화면 제안, 웹사이트 디자인 제안, GIF 애니메이션 프레임, 그림 재료 바꾸기, SNS 프로필 카드 |
유료 구간에는 이 실험들 뒤에 38개 실험을 정리한 고찰과 설치 방법(AI 에이전트에게 설치부터 생성까지 맡기기, ComfyUI 수동 설치, ForgeNeo에서 쓰기)도 이어진다. 유료 구간의 개별 결과는 이 글에 담지 않았다. 대신 작가가 도입부에 밝힌 총평은 유료 구간의 실험까지 포함한 것이다.
사진을 만화 배경으로 바꾸거나 캐릭터의 의상, 표정, 그림 재료를 바꾸는 편집은 Qwen Image 2.1에 꽤 맡길 수 있을 것 같다. 반면 배경 속으로 카메라를 돌리기, 두 사람의 화풍 맞추기, 만화 인물의 연기를 장면마다 다르게 그리기, 작은 글자를 정확히 배열하기처럼 창작성이 높은 주문에서는 GPT와의 실력 차가 분명했다.
작가는 지금으로서는 Qwen Image 2.1을 ‘NSFW 생성도 되는 로컬판 GPT Image 2.5’로 여기기보다 ‘로컬 워크플로에 넣어 쓰는 국소 작업용 모델’로 받아들이는 편이 타당하다고 결론짓는다.
가장 흥미로운 지점
실험 2에서는 전신 그림만 되풀이했고, 실험 9에서는 「캐릭터를 그리지 마라」라는 지시에도 미나를 방에 그려 넣었으며, 실험 11에서는 평면도를 내려다본 모형으로 만들었다. 작가는 세 경우 모두 Qwen이 참조 이미지에 보이는 것을 그대로 다시 그리려다 생긴 실패로 해석한다. 키누가와 씨의 침실 실험에서 참조 그림을 「가정의 분위기와 화풍의 영감으로만」 쓰라고 역할을 정해 주자 캐릭터가 그림에서 빠진 결과도 이 해석과 맞는다.
작가가 GPT를 더 낫다고 평가한 대목은 상당수가 그림 솜씨보다 무엇을 그릴지 정하는 일과 관련이 있다. 옷 10벌, 표정과 동작 10가지를 작가가 먼저 정해 적어 주자 Qwen은 대부분 그대로 그렸다. GPT에서는 「평상복, 외출복 등」 한 줄로 끝나던 기획을 Qwen에서는 사람이 떠맡는다. 대신 Qwen은 정해진 변경을, 마스크 밖은 1픽셀도 바꾸지 않은 채 반복할 수 있다. 이런 보존은 GPT Image 2.5가 하지 못한다. ‘국소 작업용 모델’이라는 작가의 결론은 처음에 성능을 낮춰 부르는 말로 들렸다. 실험 12개를 다 읽고 나서는 Qwen이 맡을 역할을 정한 말로 이해했다. 그렇게 보면 GPT Image 2.5와 Qwen Image 2.1 가운데 하나를 고를 필요는 없다. GPT나 사람이 무엇을 바꿀지 정하고, 마스크를 칠한 Qwen 워크플로가 그 변경만 정확히 반영하는 식으로 둘을 함께 쓰면 된다.
출처
스튜디오 마사카키(賢木イオ), 「Qwen Image 2.1を38種比較で検証|実力と限界」, 2026-10-27. 원문: https://studiomasakaki.com/articles/12822659/ 전문(유료): PixivFANBOX 「「Qwen Image 2.1」徹底検証!38種比較で見えた実力と限界」 https://studiomasakaki.fanbox.cc/posts/12822659
본문 이미지는 모두 원문에서 인용했다. 결과 그리드는 10장 중 일부만 잘라 실었고, 실험 4는 원문의 GPT 결과와 Qwen 결과를 한 장으로 붙여 실었다.
「「GPT Image2.5」大特集!38種の検証で見えた進化と弱点」, 스튜디오 마사카키, 2026-09-10. https://studiomasakaki.fanbox.cc/posts/12572581 ↩︎
참조 이미지 번호 규칙과 기본 사용법은 ComfyUI 공식 문서의 Qwen-Image-2.1 워크플로 예시에 정리돼 있다. https://docs.comfy.org/ja/tutorials/image/qwen/qwen-image-2-1 ↩︎
라이선스 원문: https://huggingface.co/Qwen/Qwen-Image-2.1/blob/main/LICENSE. 상업 라이선스 신청은 라이선스에 적힌 [email protected]으로 한다. ↩︎
gribbliest, 「qwen-image-2.1-qma-camera-angles」. https://huggingface.co/gribbliest/qwen-image-2.1-qma-camera-angles ↩︎