3줄 요약
- 딥러닝 연구소 Q Labs가 공개 경쟁 벤치마크 Noise를 시작했다. 자동 미분과 역방향 패스를 전혀 쓰지 않고, 순전파만으로 3,770만 파라미터 GPT 언어 모델을 사전학습하는 경쟁이다.
- Q Labs가 처음 제시한 Dust 알고리즘은 가중치 대신 토큰별 활성화값에 노이즈를 더한다. 이 방식으로 순전파 한 번에 수천 개의 개체를 병렬로 평가하며, 기존 가중치 공간 진화 전략인 EGGROLL보다 효율이 1,000~10,000배 높고 SGD 역전파와 대등한 손실을 달성했다.
- 벤치마크 공개 후 열흘 동안 오픈소스 기여자들은 아다마르 직교 측정(Boost에서 Cut으로 전환), 항등 경로 기여도, 어텐션 경로 복원, 텐서 코어 모멘트 커널을 잇달아 도입했다. 그 결과 목표 손실 도달 시간은 1.76시간에서 1.6초로 4,010배 단축됐고, 1에폭 최저 검증 손실도 4.167에서 3.676으로 감소해 Adam 역전파 기준선인 3.769보다 낮아졌다.
왜 역전파 없는 사전학습인가
현대 신경망 학습에서는 기여도를 할당(credit assignment)하는 표준 알고리즘으로 역전파(backpropagation)를 쓴다. 역전파는 모델 전체가 미분 가능해야 하고 1차 기울기(first-order gradient)를 계산한다. 오늘날의 신경망 아키텍처, 옵티마이저, AI 하드웨어는 모두 이 전제 조건에 맞춰 함께 설계됐다.
Q Labs 연구진(샘입 다할, 비슈와스 만달, 세르다르 귈바하르, 악샤이 베게스나)은 연산량이 계속 증가하면 탐색(search)에 기반한 무차별 대입(brute-force) 학습 알고리즘이 역전파를 대체할 것이라고 본다.1 리처드 서튼이 2019년 『쓴 교훈(The Bitter Lesson)』에서 정리했듯, 궁극적으로는 연산량 증가에 비례해 성능이 향상되는 범용 방법이 도메인 지식을 반영한 기법을 압도한다. 바둑 AI 알파고(AlphaGo)의 발전 과정에서도 같은 현상이 확인됐다. 초기에는 인간 기보로 사전학습하는 방식이 유리했지만, 충분한 연산량이 투입되자 순수 자가 대국만으로 학습한 알파고 제로(AlphaGo Zero)가 이전 버전을 능가했다. 연구진은 미분 가능성과 역전파도 연산량이 부족할 때 학습 효율을 높이는 귀납적 편향(inductive bias)이라고 진단한다. 연산량이 풍부해지면 도리어 적용 가능한 아키텍처의 종류를 제약한다는 것이다. 또한 손실 함수의 국소 영역만 탐색하기 때문에 일반화를 위해 막대한 데이터가 필요하다고 설명한다.
Q Labs는 이 가설을 가장 까다로운 과제인 트랜스포머 언어 모델 사전학습에서 입증하기 위해 Dust 알고리즘도 함께 발표했다.2 미분 없이 함수 평가값만으로 기울기를 추정하는 기존 영차 최적화(zeroth-order optimization)와 진화 전략(Evolution Strategies, ES)은 가중치(weight)에 노이즈를 더한다. 최신 대규모 가중치 공간 진화 전략인 EGGROLL(Sarkar et al., 2025)은 저랭크(low-rank) 노이즈로 가중치 복사 비용을 줄였지만, 배치 내 시퀀스 하나가 모집단 개체(population member) 하나에 대응하므로 순전파 횟수가 곧 모집단 크기의 한계가 된다.
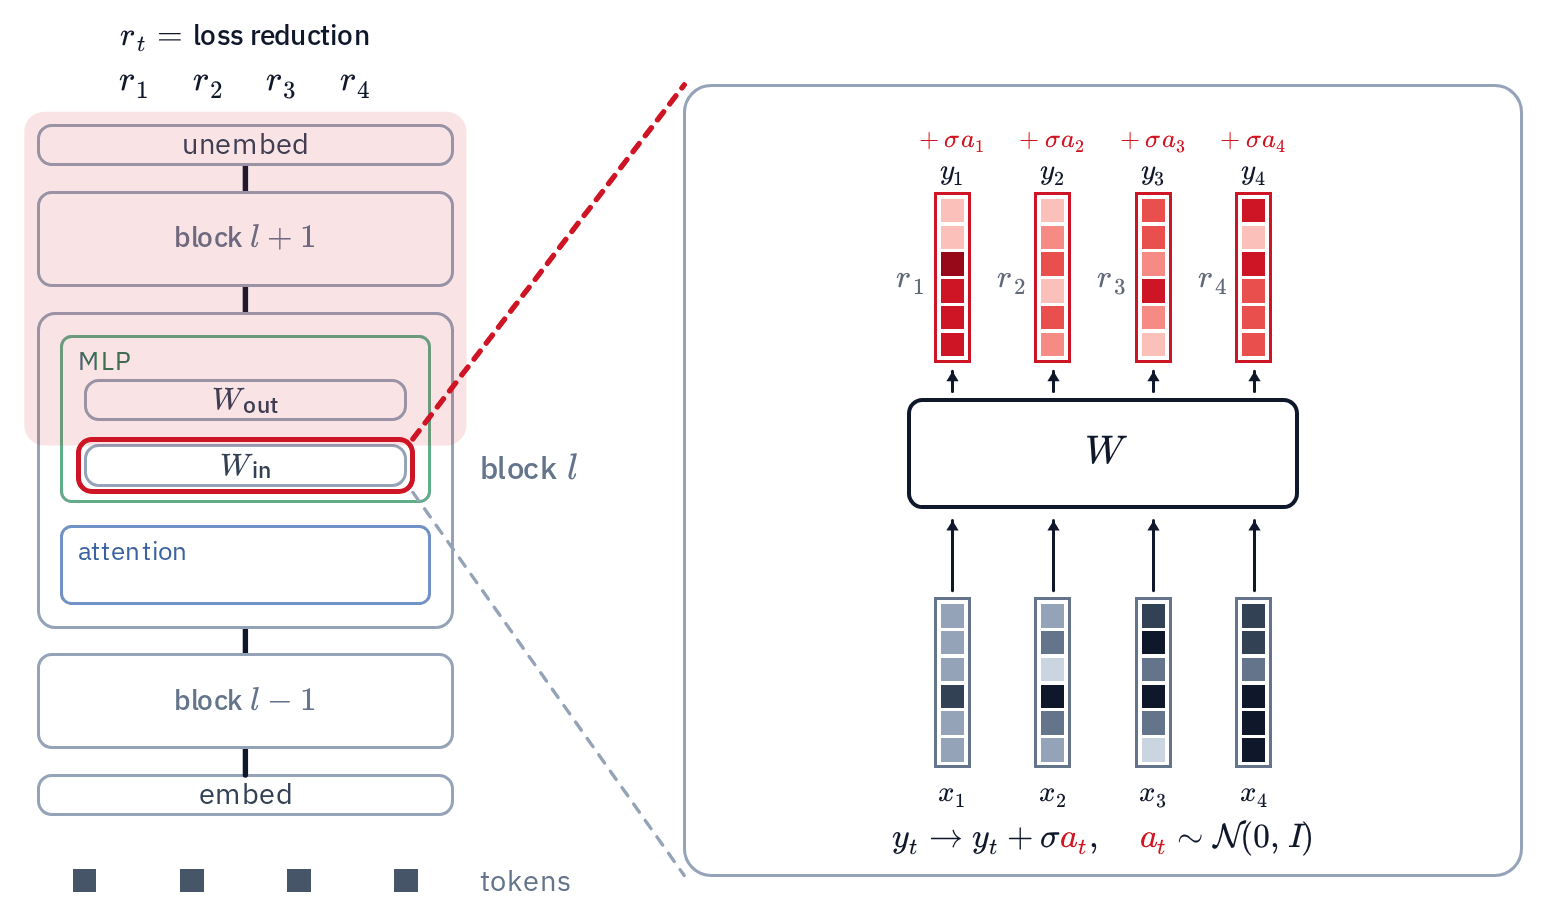 Dust의 토큰별 활성화값 섭동 구조. 각 선형 계층 출력 $y_t = Wx_t$에 토큰마다 독립적인 가우시안 노이즈 $\sigma a_t$를 더하고 순전파를 실행해 토큰별 손실 감소량 $r_t$를 보상으로 부여한다. 출처: Q Labs, Dust (2026).
Dust는 가중치 대신 각 선형 계층의 출력인 활성화값(activation)에 토큰마다 독립적으로 가우시안 노이즈를 더하는 노드 섭동(node perturbation) 방식을 택한다. 시퀀스 길이가 수천 토큰인 트랜스포머에서 토큰마다 서로 다른 노이즈 $a_t \sim \mathcal{N}(0, I)$를 주입하면, 각 토큰은 가중치 행렬에 저랭크 노이즈가 적용된 독립 개체처럼 작동한다. 이렇게 구성한 가상 모집단(virtual population)을 이용하면 가중치 복사본을 실제로 생성하지 않고도 순전파 한 번으로 수천 개의 개체를 동시에 평가할 수 있다. 기전 해석가능성(mechanistic interpretability) 연구에서 모델의 추론 과정이 활성화값에 표상된다는 점이 확인된 만큼, 활성화값 섭동은 잠재 추론(latent reasoning)을 직접 탐색하는 학습으로 이어진다.
| 비교 항목 | 가중치 공간 ES (EGGROLL) | 활성화값 섭동 (Dust) |
|---|---|---|
| 노이즈 주입 대상 | 가중치 행렬 $\theta$ (저랭크 노이즈) | 선형 계층 출력 활성화값 $y_t$ |
| 순전파 1회당 평가 개체 | 시퀀스당 1개 | 시퀀스 내 모든 토큰 $T$개 병렬 |
| 모듈 간 간섭 제어 | 개체별 가중치 분리로 간섭 없음 | 블록 및 계층 유형별 분할 순전파 |
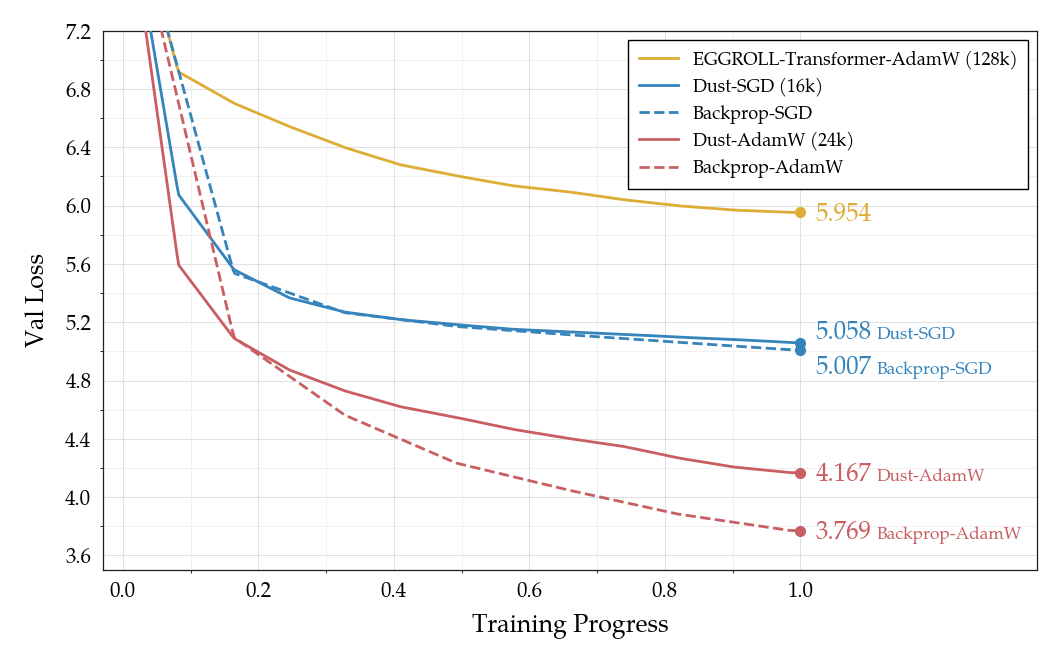
Dust에서 $K$번의 노이즈 추출(draw)을 반복해 토큰별 손실 감소량 $r_t$로 노이즈를 가중 평균하면 계층 출력의 오차 추정치 $\hat{g}_t = -\frac{1}{K\sigma}\sum_{i=1}^K r_t^{(i)} a_t^{(i)}$가 얻어진다. 이 오차 추정치와 순전파 때 이미 계산한 계층 입력 $x_t$의 외적을 계산해 토큰별로 합산하면 가중치 기울기 추정치 $\widehat{G}_W = \sum_t \hat{g}_t x_t^\top$를 얻는데, 이 추정치는 일반 옵티마이저에 바로 입력할 수 있다.3 실험 결과 Dust는 100만 토큰 이상 구간에서 EGGROLL-Transformer보다 1,000~10,000배 효율적이었고, 모집단 크기를 1만 6,000개로 늘렸을 때 SGD 기준 검증 손실 5.058을 기록하며 역전파 SGD(5.007)와 거의 같은 수준에 도달했다. 통념과 달리 모델 크기가 커질수록 모집단 효율이 더 높아져, 2억 4,300만 파라미터 모델이 120배 작은 모델보다 대부분의 모집단 크기에서 더 낮은 손실을 기록했다. 그러나 AdamW 옵티마이저와 결합했을 때는 역전파(3.769)가 Dust(4.167)보다 여전히 낮은 손실을 보였다.
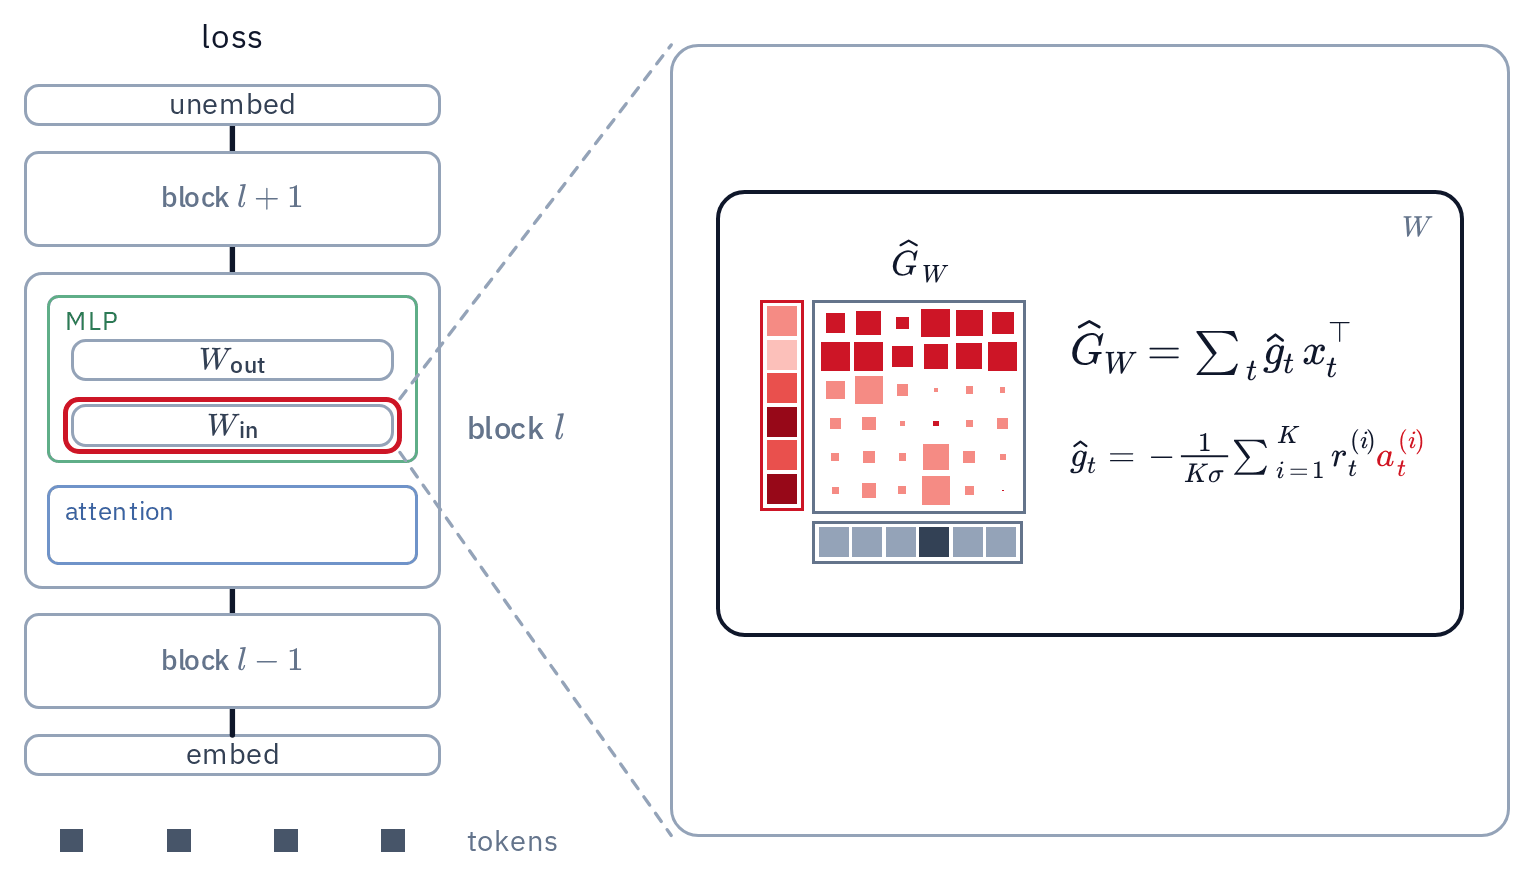 토큰별 출력 오차 추정치 $\hat{g}_t$와 입력 $x_t^\top$의 외적으로 가중치 기울기 $\widehat{G}_W$를 복원하는 과정. 이렇게 구한 기울기 행렬은 SGD나 AdamW 같은 표준 옵티마이저에 그대로 입력된다. 출처: Q Labs, Dust (2026).
Noise 벤치마크의 고정 조건과 두 가지 트랙
Q Labs는 옵티마이저, 학습률 스케줄, 기여도 할당 방식을 함께 설계하면 Dust 대비 1,000배 이상의 추가 효율 향상이 가능하다고 보고 공개 스피드런 Noise를 시작했다. 학습 알고리즘을 제외한 모든 조건은 Dust 논문의 1,000만 토큰 실험 설정으로 고정했다.4
| 고정 항목 | 세부 규격 | 제약 및 허용 범위 |
|---|---|---|
| 모델 아키텍처 | 3,770만 파라미터 GPT (8블록, 차원 512, 8헤드) | RoPE, RMSNorm, SSSL 어텐션 마스크, 격층 값 임베딩 고정 |
| 학습 및 검증 데이터 | FineWeb 1,000만 토큰 (각각 2,048토큰인 시퀀스 4,880개) | 4,096 BPE 토크나이저, 최대 1에폭, 검증 세트 111만 토큰 평가 |
| 기여도 측정 규칙 | 자동 미분(autograd) 및 역방향 패스 전면 금지 | 순전파 손실로만 오차 측정, 비선형 연산은 최대 1단계만 허용 |
학습이 끝난 최종 가중치는 참조 모듈(utils/model.py)의 state_dict에 정확히 로드되어야 하며, 검증 손실을 보고 중간 체크포인트를 고르는 행위는 금지된다. 비선형 연산은 최대 한 단계만 허용하며, 선형 변환은 단계 수에서 제외한다. 한 번 비선형 단계를 거친 신호에는 다른 비선형 단계를 다시 적용할 수 없다. 이 규칙은 역전파처럼 블록 단위로 오차를 연쇄 전달하는 우회 방식을 차단하며, 미분 불가능한 신경망에도 그대로 적용할 수 있게 한다. 반면 가중치 초기화, 배치 크기, 시퀀스 순서, 순전파 구성과 커널 컴파일은 모두 자유이며, H100 GPU 8개를 장착한 단일 노드에서 시드 0으로 측정한 스크립트와 로그를 GitHub PR로 제출한다.
| 트랙 구분 | 목표 | 초기 기준선 (Dust + AdamW) |
|---|---|---|
| 트랙 1 (Validation loss) | 시간 제한 없이 1에폭 학습 후 최저 검증 손실 달성 | 검증 손실 4.167 (1시간 46분) |
| 트랙 2 (Speedrun) | 검증 손실 4.2 이하에 도달하는 최단 학습 시간 달성 | 1시간 46분 (검증 손실 4.167) |
열흘 만의 4,000배 가속과 역전파 기준선보다 낮은 손실 달성
벤치마크 공개 후 첫 열흘 동안 커뮤니티는 트랙 2(스피드런)에서 검증 손실 4.2에 도달하는 시간을 1.76시간(1시간 46분)에서 1.6초로 4,010배 단축했다. Q Labs 연구진이 향후 목표로 제시했던 ‘Dust 대비 1,000배 개선’이 열흘 만에 달성됐다.
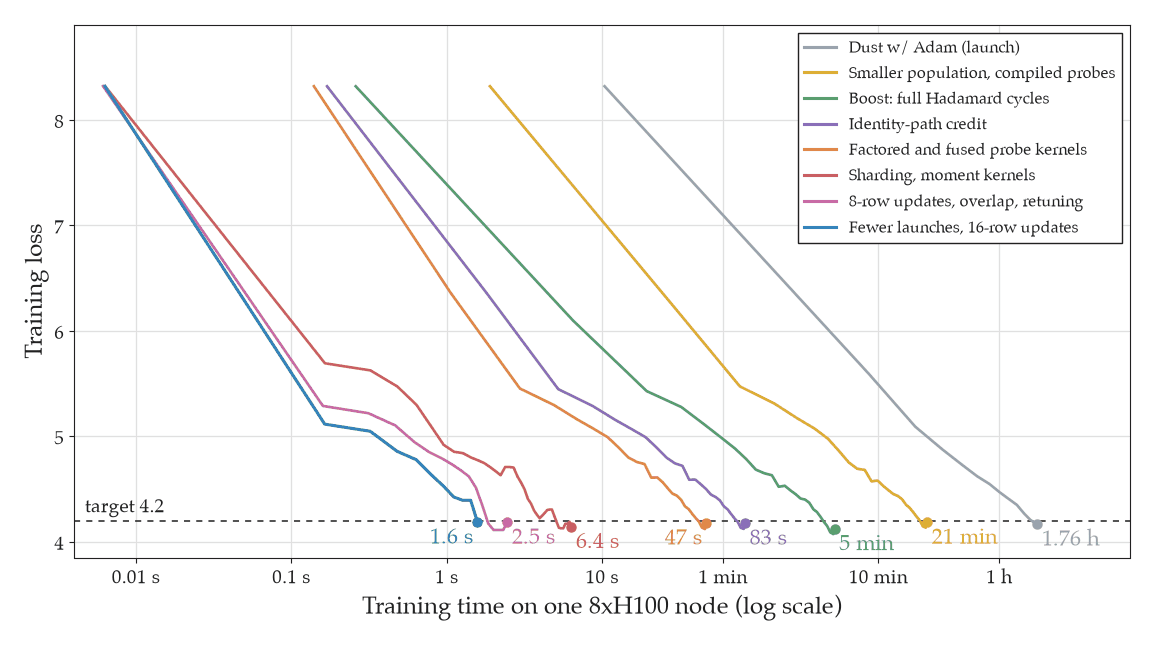 Noise 트랙 2(스피드런) 주요 기록의 학습 시간 대비 손실 곡선(로그 스케일). 열흘 동안 22차례 기록이 경신되며 목표 검증 손실 4.2 도달 시간이 1.76시간에서 1.6초로 줄었다. 출처: Q Labs, Noise (2026).
트랙 1(검증 손실 최소화) 역시 같은 기간에 14차례 기록이 경신되며 초기 4.167에서 3.676(35분 소요)으로 낮아졌다. 동일한 1,000만 토큰 조건에서 Adam과 학습률 쿨다운을 사용한 표준 역전파의 검증 손실(3.769)보다 0.093 낮은 수치다. 순전파만 쓰는 학습법이 1에폭 언어 모델 사전학습에서 Adam 역전파 기준선보다 낮은 손실을 기록한 첫 사례다.5
| 단계 및 기록 번호 | 검증 손실 | 핵심 기법 및 기여자 (소요 시간) |
|---|---|---|
| 기준선 (#1~#3) | 5.954 → 4.167 | EGGROLL 5.954(5시간 20분), Dust+SGD 5.058(1시간 19분), Dust+AdamW 4.167(1시간 46분) |
| 옵티마이저와 표본 개선 (#4~#8) | 4.088 → 3.991 | ANVIL II 도입(@Lazarus-931), 직교 표본과 유한차분 헤드 및 연상 기여도 메모리(@JaydenTeoh), 16k 모집단 축소(1시간 12분) |
| 결정론적 순환 (#9) | 3.945 | Boost → Cut: 부호 반전 아다마르 완전 순환으로 모집단 없이 전 뉴런 기여도 측정(@spicylemonade, 8분) |
| 어텐션 경로 복원 (#10~#13) | 3.896 → 3.707 | 자체 쿼리 경로(@hoo0681, @Lazarus-931), 정확한 값과 값 경로(@CharlesDDDD), 미래 토큰 프로브(@NotDesigned, 3.722로 Adam 역전파 기준선보다 낮은 손실 기록), 초기 블록 1홉 기여도(@hoo0681) |
| 궤적 병합 최종 기록 (#14) | 3.676 | 시퀀스당 2 GPU 분할 학습 및 32개 보류 시퀀스 기반 종단 가중치 평균 병합(@CharlesDDDD, 35분) |
커뮤니티가 찾아낸 4가지 기술적 전환점
1. ANVIL II 옵티마이저와 직교 표본 및 연상 메모리
기여자들이 가장 먼저 손댄 부분은 노이즈로 추정한 기울기에 맞는 옵티마이저와 표본 추출 방식이다. @Lazarus-931은 NanoGPT 스피드런(modded-nanogpt PR #360)에서 고안된 ANVIL II 옵티마이저를 트랜스포머 블록 행렬에 도입했다(나머지 파라미터는 Adam 유지). ANVIL II는 빠르게 반응하는 모멘텀($\beta=0.85$)과 느리게 반응하는 모멘텀($\beta=0.98$)을 결합한 뒤, 6단계 5차 다항식 반복(Newton-Schulz 계열)으로 기울기 행렬을 직교화(orthogonalization)하여 업데이트한다. 옵티마이저를 교체한 것만으로 검증 손실이 4.167에서 4.088까지 낮아졌다.
이어 @JaydenTeoh는 Dust의 무작위 가우시안 노이즈가 만드는 분산을 줄였다. 노이즈 방향을 서로 직교하게 뽑는 직교 표본(orthogonal draws)을 도입하고, 언어 모델링 헤드에서는 샘플링하는 대신 닫힌 형식(closed form)의 수식을 사용해 각 토큰의 정답 로짓 방향으로 유한차분을 계산했다. 여기에 직전 스텝의 기여도 정보를 다음 노이즈 추출의 사전분포(prior)로 재활용하는 연상 기여도 메모리(associative credit memory)를 결합해 손실을 4.008까지 낮췄다.
2. Boost → Cut과 아다마르 완전 순환
트랙 1과 트랙 2 모두에서 성능과 속도를 가장 크게 개선한 기법은 @spicylemonade가 도입한 Boost → Cut과 아다마르 완전 순환(full Hadamard cycle)이다. Dust는 수만 개의 무작위 노이즈 표본으로 모집단을 구성하고 평균을 계산하느라 1시간 넘게 걸렸다. @spicylemonade는 이 확률적 샘플링을 없앴다. 대신 부호가 반전된 아다마르 직교 행렬의 기저 방향 전체를 순서대로 적용하고, 각 방향의 유한차분을 측정하는 결정론적 방식을 도입했다. 은닉 차원이 512일 때 모집단 없이 정확히 차원 수만큼의 직교 이동만으로 모든 토큰에서 모든 뉴런의 기여도를 간섭 없이 측정한다.
이를 활용한 학습은 초반의 Boost(단계별 학습)와 후반의 Cut(강한 경로를 따른 종단 간 학습)으로 이어진다. 초반 Boost 단계에서는 각 서브블록, 즉 어텐션과 MLP 직후의 잔차 스트림에 공유 출력 헤드를 바로 연결한다. 각 블록은 이 출력 헤드에서 계산한 읽기(readout) 손실을 낮추도록 독립적으로 학습하며, 그 결과 트랙 2의 목표 손실 도달 시간이 21분에서 5분(검증 손실 4.123)으로 단축됐다. 후반 Cut 단계에서는 이후 블록의 어텐션 출력을 노이즈 없이 순전파해 얻은 값으로 고정한다. 그 상태에서 각 토큰의 출력 기여도가 큰 상위 $k$개 MLP 유닛만 활성화해 마지막까지 순전파를 실행한다. 어텐션이 고정되어 있으므로 한 토큰의 활성화값 변화는 오직 그 토큰 자신의 최종 손실에만 영향을 주며, 모든 토큰을 서로 간섭 없는 독립 실험으로 병렬 측정할 수 있다. Boost에서 Cut으로 이어지는 2단계 학습을 통해 트랙 1의 검증 손실은 3.945까지 낮아졌고 학습 시간은 8분으로 줄었다.
3. 고정된 어텐션의 기여도 복원과 종단 가중치 병합
Cut 단계는 어텐션을 고정해 토큰 간 간섭을 차단한 대신, 한 토큰의 변화가 어텐션을 통해 자기 자신이나 미래 토큰의 손실에 미치는 기여도를 놓친다는 한계가 있었다. 트랙 1의 후속 기록들은 이 누락된 기여도 경로를 하나씩 복원하는 과정이었다.
| 복원 단계 (기록 번호) | 달성 손실 (시간) | 복원한 기여도 경로 및 핵심 메커니즘 |
|---|---|---|
| 자체 쿼리와 값 경로 (#10~#11) | 3.896 → 3.777 (18분) | 이후 블록 어텐션의 자체 쿼리 경로(@hoo0681, @Lazarus-931), 정확한 값 계산과 RMSNorm 1단계 뒤 선형 값 경로 및 전체 MLP 유닛 측정(@CharlesDDDD) |
| 미래 토큰 프로브 (#12~#13) | 3.722 → 3.707 (24분) | 어텐션을 거쳐 미래 토큰 손실로 전달되는 프로브와 키 및 게이트 기여도(@NotDesigned, Adam 역전파 기준선 3.769보다 낮은 손실 달성), 초기 블록 1홉 기여도(@hoo0681) |
| 종단 가중치 병합 (#14) | 3.676 (35분) | 시퀀스마다 GPU 2개로 분할 학습한 뒤, 마지막 32개 시퀀스를 사용해 감쇠율 9개(0.5~0.01)에 해당하는 EMA 가중치를 주성분 부분공간과 여공간에서 좌표 탐색으로 병합(@CharlesDDDD) |
최종 우승 기록(#14)은 종단 가중치 병합(end merge)을 사용했다. 에폭의 60%부터 5스텝마다 서로 다른 감쇠율을 적용한 가중치 지수이동평균(EMA) 9개를 유지한다. 마지막 업데이트가 끝나면 학습에 사용하지 않고 남겨 둔 마지막 32개 학습 시퀀스로 순전파만 약 5,000회 실행하는데, 이 과정에는 약 1분이 걸린다. 각 행렬과 임베딩 테이블의 상위 64개 입력 공분산 주성분 부분공간과 여공간에서 손실을 가장 많이 낮추는 EMA 가중치 조합을 좌표 탐색(coordinate sweep)으로 합쳐 검증 손실을 3.676까지 낮췄다.
4. 항등 경로 기여도와 텐서 코어 커널 최적화
트랙 2(스피드런)에서는 목표 손실 4.2만 달성하면 되므로, 블록마다 순전파 실험을 반복하는 비용 자체를 줄이는 방향이 주효했다.
| 스피드런 기록 단계 | 도달 시간 | 핵심 단축 기법 및 기여자 |
|---|---|---|
| 초기 기준선 → Boost (#1~#4) | 1시간 46분 → 5분 | 모집단 5k 축소(@JaydenTeoh 등, 22분), 프로브 컴파일(@pculaf, 21분), Boost 단계별 학습(@spicylemonade, 5분) |
| 항등 경로와 커널 융합 (#5~#9) | 4분 21초 → 47초 | 닫힌 형식 허브 및 값 기여도(@Euraba, 2분 37초), 항등 경로 기여도(@Lazarus-931, 83초), 분해 프로브(@jon123boss, 62초), 융합 커널 및 MLP 순환 생략(@isaac0804, 47초) |
| 멀티 GPU 샤딩과 모멘트 커널 (#10~#13) | 15.4초 → 6.4초 | 토큰 샤딩 JAX 구현(@RobertTLange, 15.4초), 가중치 변화 외삽(@areu01or00, 14.6초), 데이터 없는 블록 1 lag-1 RoPE 초기화(@erodola, 13.1초), 헤드별 텐서 코어 모멘트 커널(@RobertTLange, 6.4초) |
| 배치 확장과 통신 중첩 (#14~#22) | 5.7초 → 1.6초 | 8시퀀스 배치(@Euraba, 5.7초), 후반 EMA와 짝수 블록 어텐션 생략 및 통신 중첩(@erodola, 2.7초), bf16 기울기(@Euraba, 2.5초), 런치 통합(@RobertTLange, 1.7초), 16시퀀스 250스텝 및 초기부터 어텐션 생략(@areu01or00, 1.6초) |
트랙 2의 학습 시간을 분 단위에서 초 단위로 단축한 핵심 기법은 @Lazarus-931이 고안한 항등 경로 기여도(identity-path credit)다. 블록마다 따로 노이즈 실험을 실행하는 대신, 최종 출력층 직전의 잔차 스트림에서 아다마르 순환으로 토큰별 기여도를 단 한 번만 측정하고 이를 잔차 연결 스칼라(residual scalars)를 통해 모든 이전 블록에 그대로 전달했다. Boost와 Cut의 구분이 사라지면서 학습 시간이 83초로 줄었고, @isaac0804가 프로브 커널을 융합하고 MLP 은닉 순환을 생략해 47초까지 단축했다.
47초에서 최종 기록인 1.6초까지는 멀티 GPU 분산 처리와 수치 커널 최적화가 시간을 단축했다. @RobertTLange는 토큰과 어텐션 헤드를 8개 GPU에 분산(sharding)하고, 쿼리, 키, 값의 어텐션 가중 2차 모멘트($X, Y, X^2, Y^2, XY$)를 텐서 코어 타일 단위로 한 번에 계산하는 Triton/Pallas 모멘트 커널(moment kernels)을 작성해 6.4초를 기록했다. 이어 @erodola는 세 가지 기법을 도입했다. 구조적 시작(structured start)은 데이터를 전혀 사용하지 않고 초기 가중치 공식만으로 블록 1의 어텐션 헤드를 초기화하는 방법으로, 이렇게 초기화한 RoPE 헤드는 직전 토큰(lag-1)을 가리킨다. 후반 평균(tail average)은 학습의 60%가 지난 뒤 가중치 EMA를 혼합하는 방법이고, 후반 스킵(late skip)은 짝수 블록인 0, 2, 4, 6번 블록의 어텐션 실험을 생략하는 방법이다. 또한 전체 순전파를 단일 CUDA 그래프로 컴파일하고 All-to-All 및 Reduce-Scatter 통신을 연산과 비동기로 겹쳐 실행했다.6 마지막으로 @areu01or00이 업데이트당 시퀀스 수를 8개에서 16개로 늘려 전체 스텝 수를 400회에서 250회로 줄이고, 첫 스텝부터 짝수 블록 어텐션 실험을 생략해 1.6초(검증 손실 4.186) 기록을 세웠다.
3,000만 토큰 체제로의 확장과 오픈 아키텍처 트랙
Q Labs 연구진은 열흘 만의 4,000배 가속과 역전파 기준선보다 낮은 손실 달성을 높이 평가하면서도, 지금까지의 기록 상당수가 직전 기록의 하이퍼파라미터와 세부 구성을 조정해 1,000만 토큰 단일 설정에 맞춘 결과라는 점을 분명히 밝혔다. 연구진은 모델과 데이터 규모를 늘렸을 때도 성능이 계속 향상되려면, 옵티마이저와 기울기 추정기를 함께 설계하는 방식(optimizer-estimator codesign)처럼 더 근본적인 변화가 필요하다고 설명했다. 이에 따라 Q Labs는 2026년 10월 22일 자로 1,000만 토큰 트랙을 아카이브(archive/10M/)로 마감하고, 학습 데이터를 3,000만 토큰(각각 2,048토큰인 시퀀스 1만 4,648개)으로 3배 늘린 새 라운드를 시작했다.
| 3,000만 토큰 신규 트랙 | 평가 기준 및 제약 | 초기 기준선 및 출발 기록 |
|---|---|---|
| 트랙 1 (Validation loss) | 고정 GPT 아키텍처, 3,000만 토큰 1에폭 최저 검증 손실 | Dust+Adam 3.767(5시간 17분), 10M 우승 레시피(#14) 3.409(1시간 43분)7 |
| 트랙 2 (Speedrun) | 고정 GPT 아키텍처, 검증 손실 3.5 이하 최단 도달 시간 | 10M 우승 레시피(#14) 기준 1시간 43분 (검증 손실 3.409) |
| 트랙 3 (Open Architecture) | 평가 인터페이스 유지 하에 모델 아키텍처(train/arch/model.py) 자유 변경 | 고정 아키텍처 트랙 1 기록(3.409) 기준 |
신설된 트랙 3(오픈 아키텍처)은 평가 인터페이스(GPT(GPTConfig()), init_weights(), 손실 반환)와 3,000만 토큰 1에폭 조건만 지키면 모델 구조 자체를 자유롭게 바꿀 수 있는 부문이다. 역전파에 맞춰 설계된 현재의 트랜스포머 구조 대신 순전파 탐색 학습에 더 적합한 아키텍처를 함께 찾겠다는 취지다.
가장 흥미로운 지점
내가 이번 결과에서 가장 눈여겨본 대목은 처음에는 확률적 노이즈를 사용했던 벤치마크가 불과 며칠 만에 완전한 결정론적 직교 순환과 닫힌 형식(closed-form) 수식으로 재편됐다는 점이다. 벤치마크 이름은 ‘Noise’이고, 처음 제시된 Dust 역시 최대 2만 4,000개의 무작위 가우시안 노이즈 표본을 평균 내어 기울기를 추정했지만, 상위 기록을 달성한 해법들은 무작위성을 차례로 제거했다. @spicylemonade의 아다마르 순환은 확률적 샘플링을 직교 기저 순환으로 바꿨고, @JaydenTeoh와 @Euraba, @RobertTLange의 커널들은 출력 헤드와 키 및 값의 기여도를 노이즈 샘플링 없이 수학적 닫힌 형식과 2차 모멘트 행렬곱으로 직접 계산했다.
역전파를 배제하더라도 무작위 샘플링에만 의존할 필요는 없다. 규칙이 허용하는 ‘비선형 연산 1단계 이내의 순방향 측정’과 트랜스포머의 잔차 스트림 구조를 결합하자, 커뮤니티는 역방향 연쇄법칙을 쓰지 않고도 텐서 코어에 친화적인 정방향 직교 프로브와 모멘트 연산을 발명해 냈다. 신설된 트랙 3(오픈 아키텍처)에서는 미분 가능성을 요구하지 않는 신경망 구조도 제안할 수 있다. 이 정방향 측정법에 적합한 구조로 어떤 모델이 제안될지, 나는 후속 제출물을 기다리게 된다.
출처
- Q Labs (Serdar Gülbahar, Bishwas Mandal, Akshay Vegesna, Samip Dahal), 「Noise: Speedrun for pretraining without backpropagation」, Q Labs Research, 2026-10.
- 원문: https://qlabs.sh/noise
- GitHub 리포지토리 (30M 신규 트랙 및 10M 아카이브): https://github.com/qlabs-eng/noise
- 보충 원문: Samip Dahal, Bishwas Mandal, Serdar Gülbahar, Akshay Vegesna, 「Dust: Pretraining Transformers Without Backpropagation」, Q Labs Research, 2026. https://qlabs.sh/research/dust/
- 치비 서소영 삽화 2장은 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
Q Labs는 제프 딘(Jeff Dean) 등의 투자를 받아 일반화와 데이터 효율의 근본적 개선을 연구하는 딥러닝 연구소다. 역전파 대체 연구인 Dust와 Noise 외에도 초다중 에폭 사전학습으로 데이터 효율을 13배 높인 NanoGPT Slowrun, $10^7$개 계층 규모의 신경망을 지향하는 연산 깊이 스케일링 연구를 진행하고 있다. ↩︎
Samip Dahal, Bishwas Mandal, Serdar Gülbahar, Akshay Vegesna, 「Dust: Pretraining Transformers Without Backpropagation」, Q Labs Research, 2026. https://qlabs.sh/research/dust/ ↩︎
여러 계층과 토큰에 동시에 노이즈를 넣으면 서로의 효과가 섞이는 간섭(interference)이 발생한다. Dust는 세 가지 방법으로 간섭을 줄인다. 첫째, 노이즈 없이 순전파해 얻은 활성화값을 캐싱해 두고, 블록 $l$의 특정 계층 유형에만 노이즈를 준 뒤 블록 $l$부터 끝까지만 다시 실행한다. 둘째, 어텐션 내부(쿼리, 키, 값, 게이트, 값 임베딩)는 토큰 손실 변화가 미미하므로 해당 블록의 어텐션 출력 오차 추정치와의 내적으로 보상을 계산한다. 셋째, 언어 모델링 헤드는 캐싱된 로짓에서 어휘 일부에 해당하는 값만 선택해 교차 엔트로피를 다시 계산함으로써 적은 연산으로 큰 모집단을 평가한다. ↩︎
Q Labs,
qlabs-eng/noiseGitHub Repository (MIT License), 2026. https://github.com/qlabs-eng/noise ↩︎커뮤니티가 도입한 새로운 옵티마이저(ANVIL II 등)를 역전파에도 동일하게 적용하면 역전파의 손실이 더 낮아진다. 따라서 동일 옵티마이저 조건에서는 여전히 역전파의 손실이 더 낮지만, 순전파 기반 학습이 표준 Adam 역전파 기준선보다 낮은 손실에 도달했다는 점에 의의가 있다. ↩︎
PyTorch
flex_attention에서return_lse=True옵션을 쓰면 내부 경고가 발생해 블록 루프의torch.compile그래프가 깨지고 수많은 작은 커널이 개별 실행됐다.@erodola는return_aux=AuxRequest(lse=True)로 이를 우회해 8개 블록 순전파 전체를 단일 컴파일 그래프로 묶었다. ↩︎3,000만 토큰 조건에서 표준 역전파 기준선의 검증 손실은 Adam이 3.419(1분 미만), ANVIL II + Adam이 3.340(1분 미만)이다. ↩︎