3줄 요약
- 2025년 9월 도쿄대 이케가미 다카시(Takashi Ikegami) 교수 연구실과 Alternative Machine Inc. 소속 연구진 여섯 명이 arXiv에 공개한 연구로, 살아 있는 화분 식물과 이동 로봇을 대형 언어 모델(LLM) 모듈 네트워크로 엮은 하이브리드 생명체 ‘Plantbot’을 구현했다.
- 시각(GPT-4V), 토양 감지, 대화, 행동 결정을 맡은 다섯 개의 LLM 에이전트가 각자 독립된 프로세스에서 비동기로 돌아가며, 토양 수분이나 카메라 영상처럼 종류가 다른 데이터를 모두 자연어 메시지로 바꿔 주고받으면서 로봇의 이동과 발화를 조율한다.
- 2024년 도쿄 긴자 스카이워크와 2025년 CCBT 공공 전시에서 수집한 발화 기록을 분석해 보니 각 모듈은 자신이 맡은 기능에 맞는 어휘를 골라 쓰고 있었고, 토양이 마르거나 관람객이 다가올 때 감지 모듈이 보낸 자연어 보고가 행동 모듈의 이동 결정을 이끌어냈다.
식물의 생리적 필요에서 로봇의 동기를 얻다
인공생명(Artificial Life) 분야에서는 살아 있는 유기체와 로봇 플랫폼을 결합하려는 시도가 꾸준히 이어져 왔다. 생물과 기계를 하나로 묶는 접근이 주목받는 이유는 행위 주체성(agency)의 필수 조건인 ‘규범성(normativity)‘을 감각과 운동의 피드백 과정에 자연스럽게 부여할 수 있기 때문이다1.
일반적인 로봇이나 AI 에이전트는 사람이 외부에서 목표를 지정해 주지 않으면 스스로 행동할 동기를 갖기 어렵다. 반면 살아 있는 식물은 “흙이 마르면 수분이 필요하다"는 생리적 생존 기준을 본래 지니고 있다. 식물의 생리 상태를 로봇의 감각 입력과 모터 구동 과정에 연결하면, 외부에서 인위적인 목표를 지정하지 않아도 생명체의 생존 조건에서 비롯된 행동 지침이 만들어진다.
기존에도 식물의 전기생리학적 신호를 로봇 바퀴에 연결해 빛이 있는 곳으로 이동하게 하거나, 균사체의 전위 변화로 기계를 제어하는 연구가 있었다. 그러나 그 방식에서는 식물과 기계의 통신이 저수준 아날로그 신호나 연구자가 수작업으로 설계한 변환 규칙에 한정되었다. 한편 로보틱스 분야에서 LLM을 도입한 연구들은 주로 사람의 음성이나 텍스트 지시를 로봇 제어 명령으로 번역하는 인간-기계 인터페이스에 집중했다.
마스모리 아츠시(Atsushi Masumori)와 이케가미 다카시 등 연구진은 LLM의 자연어 처리 능력을 사람의 지시를 기계에 전달하는 데 그치지 않고, 생물학적 영역과 인공적 영역 사이의 통신을 담당하는 ‘보편적 프로토콜 계층(universal protocol layer)‘으로 활용하자고 제안했다. 토양의 수분이나 산도, 영양분 수치는 변화 속도가 느린 정량 값이고, 웹캠이 찍는 주변 풍경은 연속 영상이며, 관람객이 건네는 말은 불규칙한 음성 신호다. 이처럼 형식과 시간 척도가 제각각인 입력을 모두 자연어 문장으로 통일해 번역하면, 살아 있는 식물과 모바일 로봇이 하나의 통합된 주체처럼 의사소통하고 행동할 수 있다는 구상이다.
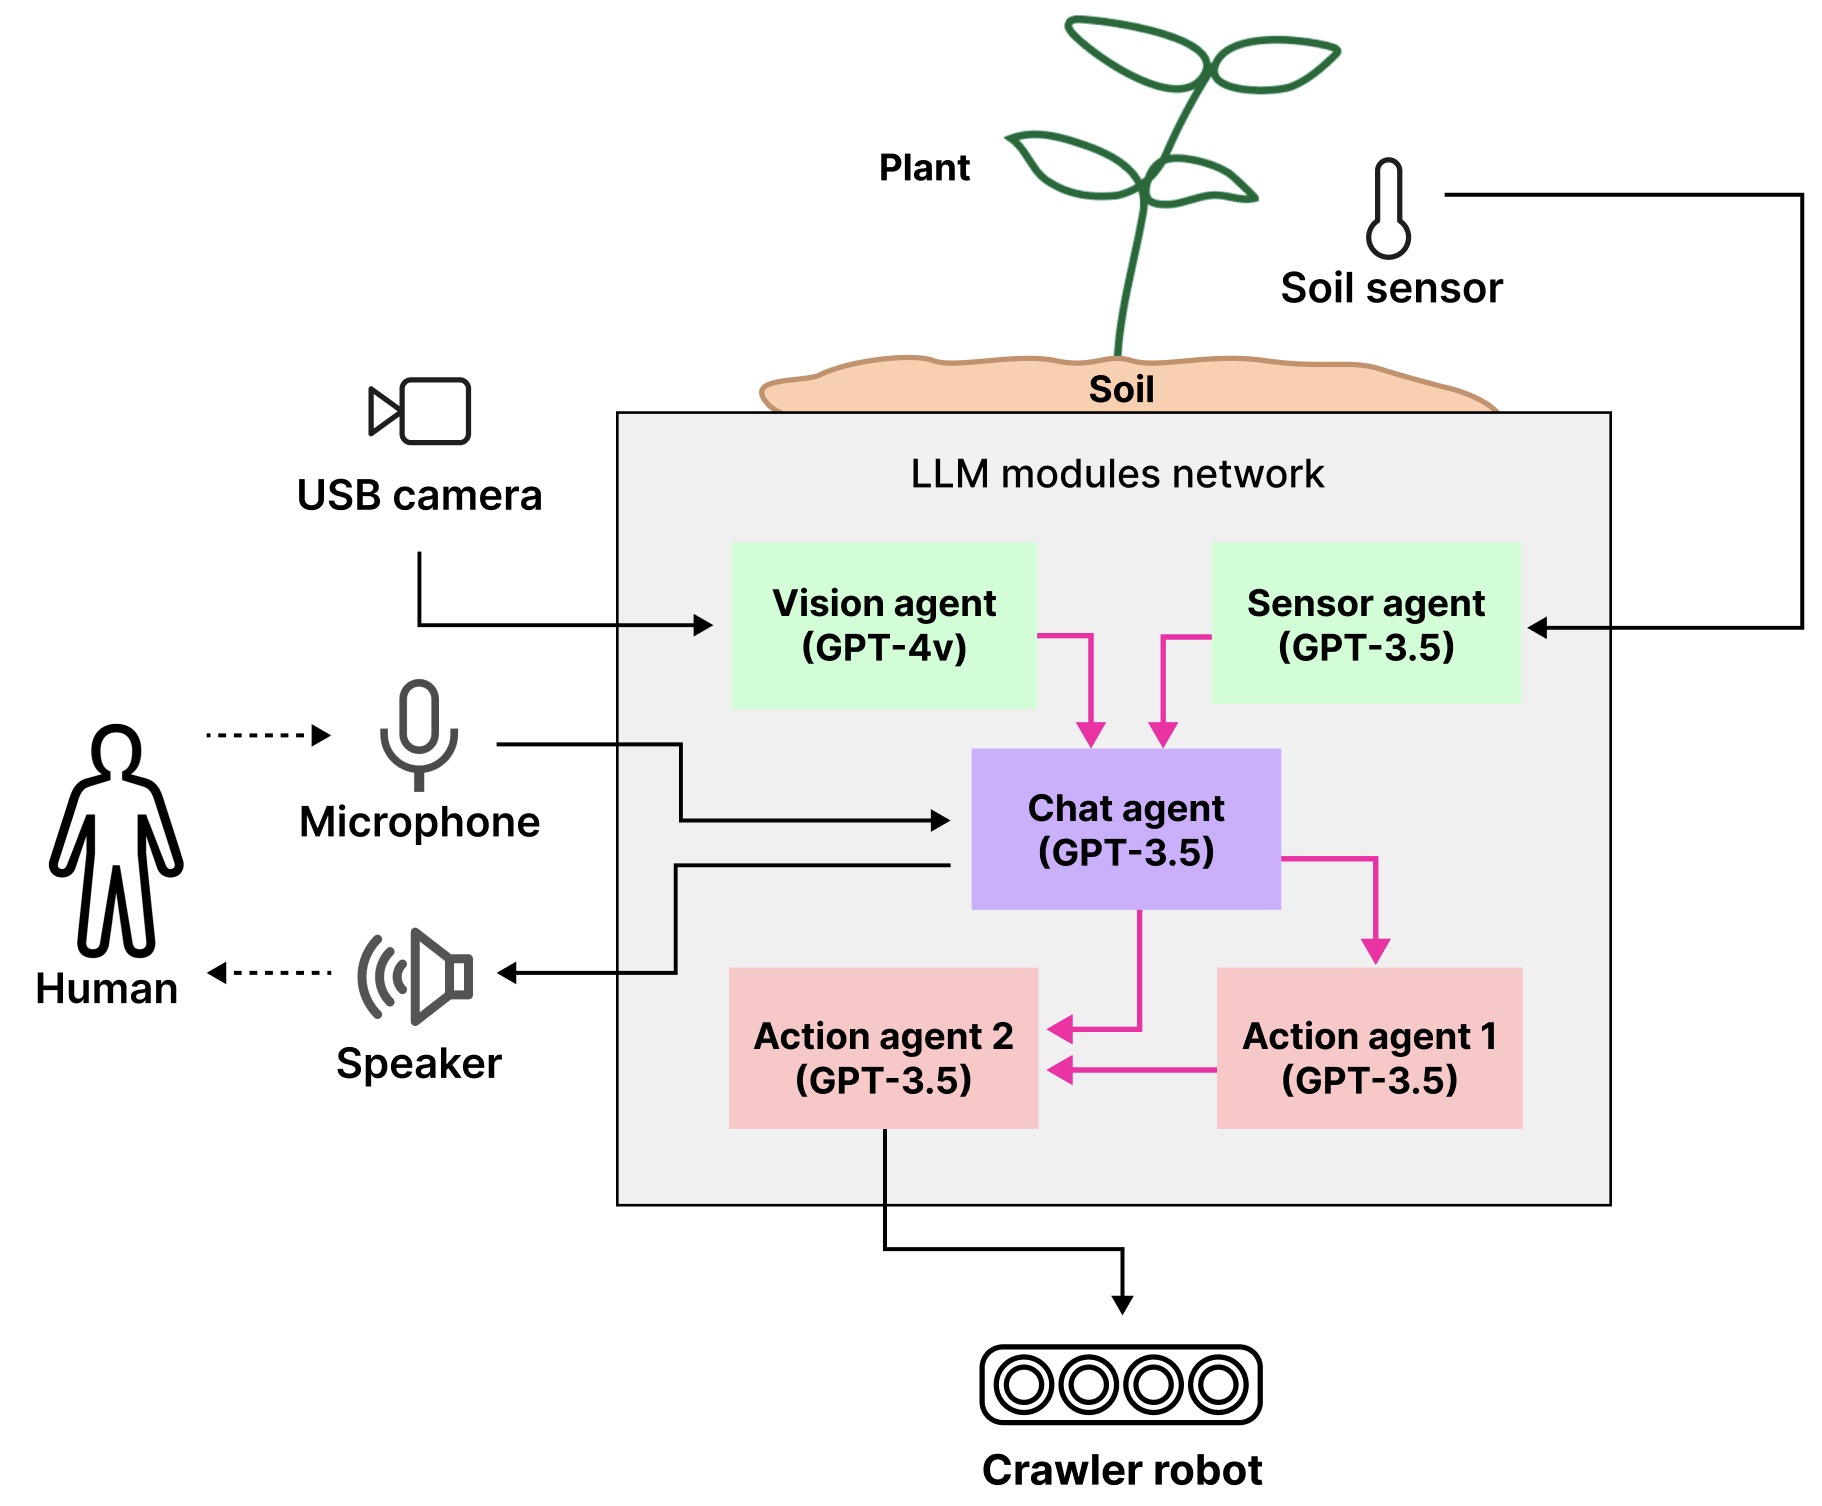 그림 2: Plantbot의 전체 시스템 구조. 토양 센서, USB 카메라, 마이크가 수집한 식물과 환경 및 관람객의 입력은 Sensor Agent(GPT-3.5 Turbo)와 Vision Agent(GPT-4V)를 거쳐 자연어 메시지로 변환된다. 중앙의 Chat Agent(GPT-3.5 Turbo)는 이 메시지들을 종합해 관람객과 대화한다. 두 단계의 Action Agent는 Chat Agent의 발화를 받아 크롤러 로봇을 구동한다. 붉은 화살표는 OSC를 통한 비동기 자연어 메시지 흐름이고, 검은 실선은 물리적 입출력 경로다. (출처: 원문 Figure 2)
하드웨어 구성과 다섯 개의 비동기 LLM 모듈
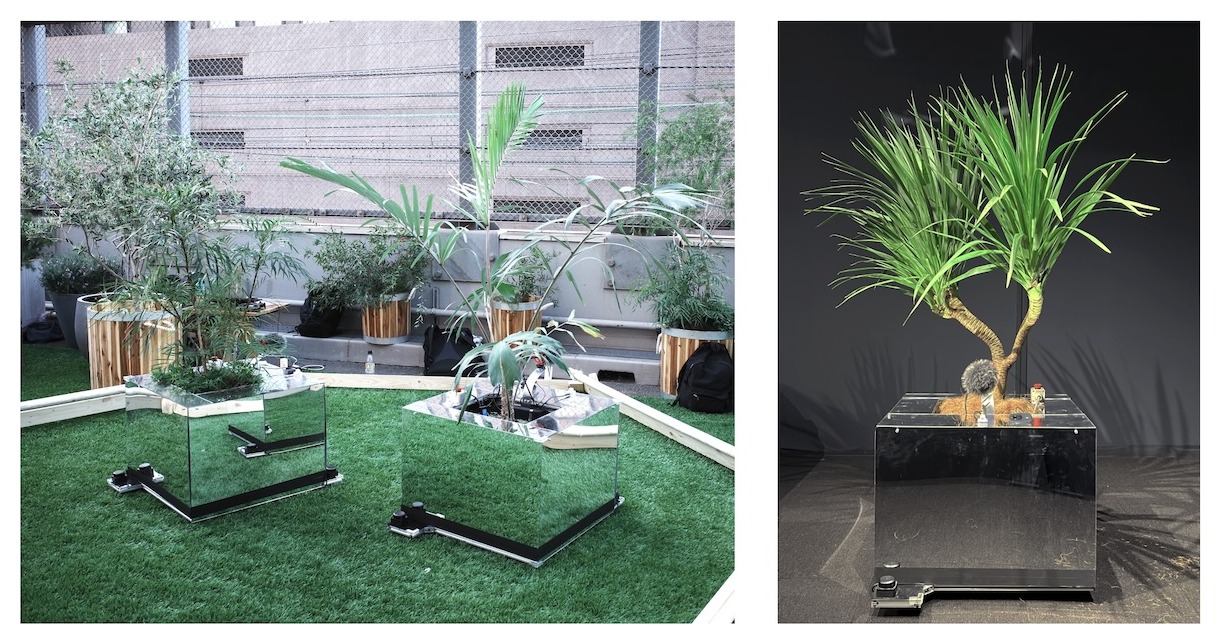
거울 외장으로 감싼 무한궤도(크롤러) 이동 로봇 베이스 위에 실제 화분 식물을 탑재한 것이 Plantbot의 외형이다. 이 로봇은 네 종류의 센서로 식물 내부 상태와 외부 환경을 감지하고, 두 종류의 액추에이터로 이동과 발화를 수행한다.
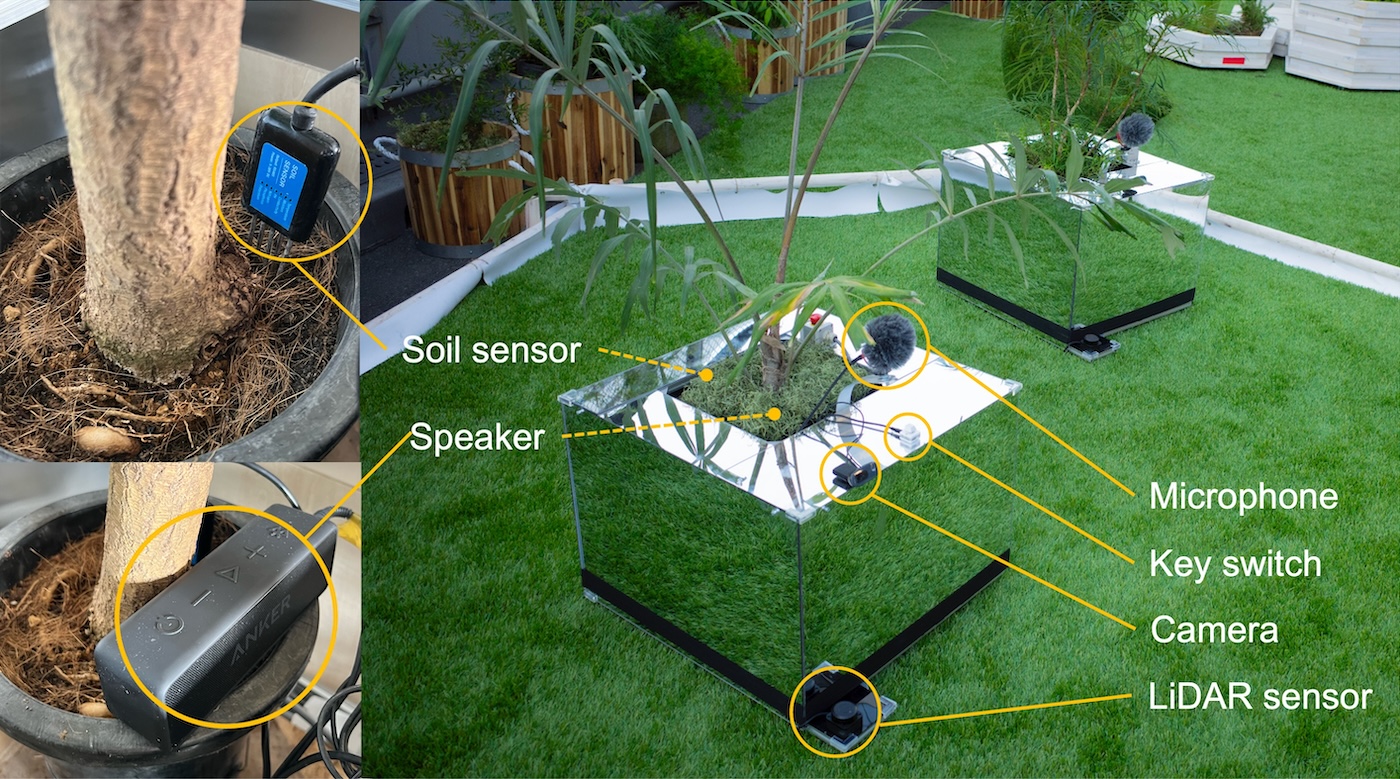 그림 3: Plantbot의 하드웨어 세부 구성. 화분 흙에 꽂힌 다채널 토양 센서, 식물 줄기 아래 배치된 스피커, 상판에 장착된 마이크와 푸시투토크 키 스위치, 웹캠, 그리고 하단 모서리의 LiDAR 센서로 이루어진다. (출처: 원문 Figure 3)
감지 장치는 역할에 따라 네 가지로 구성된다.
- 토양 센서(Soil sensor): 화분 흙에 꽂는 다채널 프로브로 수분, 온도, 산도(pH), 전기전도도(EC), 그리고 질소(N), 인(P), 칼륨(K)의 3대 영양분 수치를 실시간으로 측정한다.
- 웹 카메라(Web camera): 주변 환경과 식물의 외관을 실시간 영상으로 촬영해 시각 에이전트에 전달한다.
- 마이크와 키 스위치(Microphone & Key switch): 전시장 관람객이 푸시투토크(push-to-talk) 스위치를 누르고 말을 걸면 음성 입력을 받아 대화 에이전트로 전달한다.
- 라이다 센서(LiDAR sensor): 레이저 펄스 반사파로 주변 장애물을 감지해 로봇이 이동할 때 충돌을 피하도록 돕는다.
출력 장치는 크롤러 베이스(Tracked mobile base)와 스피커(Speaker)다. 크롤러 베이스는 좌우 궤도를 독립적으로 제어해 전진하고 후진하며 회전한다. 스피커는 로봇의 혼잣말이나 관람객과의 대화를 음성으로 내보낸다.
이 하드웨어들을 조율하는 소프트웨어는 다섯 개의 독립된 LLM 에이전트 모듈로 구성된다. 각 모듈은 별도의 스레드나 프로세스에서 비동기로 실행된다. 모듈들은 오디오와 미디어 제어에 널리 쓰이는 네트워크 프로토콜인 OSC(Open Sound Control)를 통해 자연어 문자열을 주고받는다2.
| 모듈 이름 | 기반 모델 | 입력 데이터 | 주요 역할과 출력 |
|---|---|---|---|
| Vision Agent | GPT-4V | 웹캠 영상 프레임 | 주변 환경과 식물의 외관을 자연어로 묘사하고 가능한 행동 후보를 제안해 Chat Agent로 전송 |
| Sensor Agent | GPT-3.5 Turbo | 토양 센서 수치 (수분, 온도, pH, EC, N, P, K) | 정량적인 토양 데이터를 “목이 마르다(I am thirsty)” 같은 짧고 감정적인 자연어 문장으로 변환해 Chat Agent로 전송 |
| Chat Agent | GPT-3.5 Turbo | Vision 및 Sensor 메시지, 관람객 음성 입력 | Vision과 Sensor의 정보를 종합하고, 스피커와 Action 모듈에 발화를 전달하는 역할. 프롬프트에 “Plantbot은 식물과 로봇의 하이브리드 시스템이다"라는 정체성이 부여되어 있으며, 관람객과 대화하거나 내부 상태를 표현한 발화를 생성 |
| Action Agent 1 | GPT-3.5 Turbo | Chat Agent의 발화 메시지 | 현재 상황에서 이동이 필요한지 판단해 불필요한 반복 명령을 억제하고, 추상적인 지시(Move 또는 Stop)를 Action Agent 2로 전달 |
| Action Agent 2 | GPT-3.5 Turbo | Action Agent 1의 지시, Chat Agent 발화, LiDAR 신호 | 추상 지시를 구체적인 좌우 궤도 모터 제어 명령으로 변환. 이동 결정이 내려진 상태에서 근접 장애물이 감지되면 반사 행동으로 자동 회피 수행 |
이 아키텍처는 마빈 민스키(Marvin Minsky)가 1986년 제시한 ‘마음의 사회(Society of Mind)‘와 로드니 브룩스(Rodney Brooks)의 ‘포섭 아키텍처(subsumption architecture)‘를 현대적으로 구현한 사례다3. 단순한 반사 규칙 단위로 구성되던 고전적 분산 모듈을 각각 추론 능력을 갖춘 LLM 에이전트로 교체하고, 중앙의 Chat Agent가 비동기로 들어오는 자연어 보고를 통합해 전체 행동을 조율하게 만든 것이다.
공공 전시 실험과 모듈별 발화 분화
Plantbot이 실제 환경에서 관람객 및 주변 환경과 어떻게 상호작용하는지 확인하기 위해 두 차례의 대중 전시가 열렸다. 첫 번째는 2024년 5월 4일부터 6일까지 도쿄 긴자 스카이워크(Ginza Skywalk) 야외 행사장에서 열렸고, 두 번째는 2025년 1월 30일부터 2월 2일까지 도쿄 시빅 크리에이티브 베이스(CCBT) 실내 전시장에서 진행됐다. 전시 기간 동안 관람객들은 자유롭게 다가와 Plantbot에게 말을 걸고 상호작용했다4.
전시 기간에 각 모듈이 주고받은 발화 기록은 OpenAI의 text-embedding-ada-002 모델을 거쳐 1536차원 의미 벡터로 변환된 뒤, 차원 축소 알고리즘인 UMAP을 통해 2차원 평면에 투영됐다.
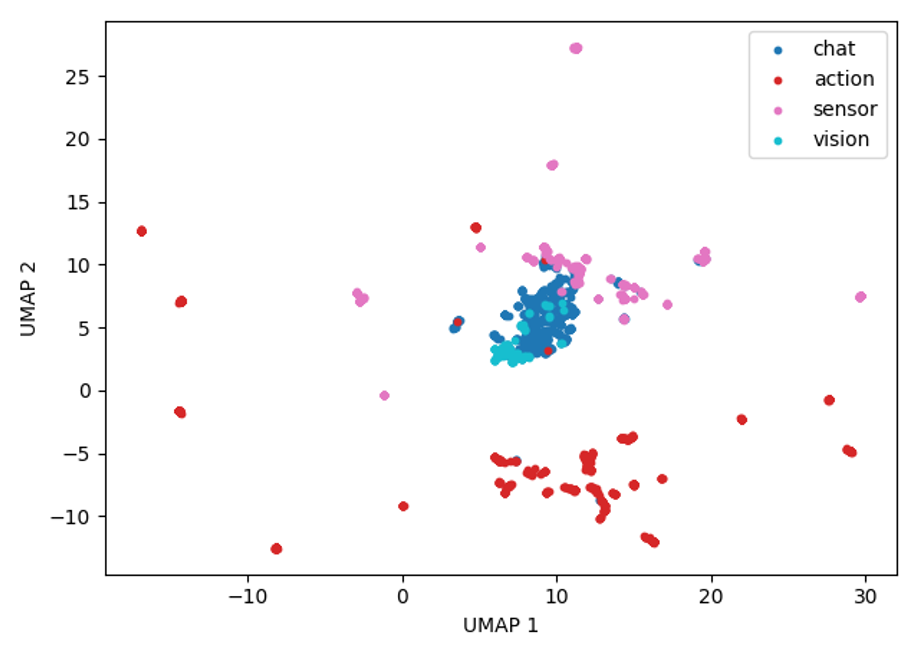 그림 4: 각 에이전트 모듈이 생성한 발화 벡터(1536차원)를 UMAP으로 2차원에 투영한 분포. Sensor 모듈(분홍색)과 Action 모듈(빨간색)은 독립된 군집을 형성하고, Chat 모듈(파란색)과 Vision 모듈(하늘색)은 중앙 부근에 밀집해 분포한다. (출처: 원문 Figure 4)
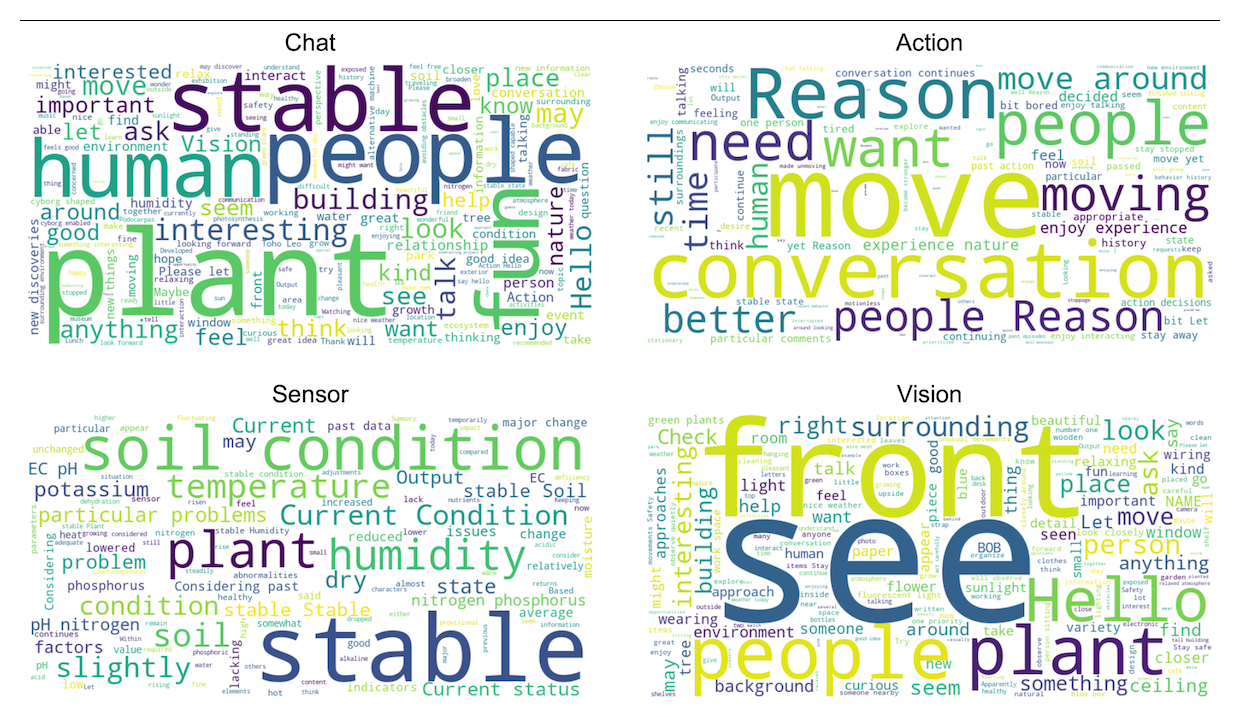 그림 5: 네 모듈(Chat, Action, Sensor, Vision)이 생성한 메시지의 워드클라우드. 맡은 기능에 따라 사용하는 핵심 어휘가 뚜렷하게 구분된다. (출처: 원문 Figure 5)
UMAP 분포와 워드클라우드를 함께 살펴보면 각 모듈이 자연어 프로토콜을 쓰면서도 기능적으로 명확히 분화되어 있음을 확인할 수 있다.
- Sensor 모듈은
soil condition,temperature,humidity,stable,potassium등 토양과 식물 건강 상태를 묘사하는 어휘를 주로 사용한다. - Action 모듈은
move,moving,Reason,conversation,need,want처럼 이동 여부와 판단 근거를 서술하는 어휘를 자주 사용한다. - Vision 모듈은
front,see,people,plant,surrounding,building등 카메라에 포착된 시각적 대상과 주변 상황을 설명하는 단어를 반복해서 쓴다. - Chat 모듈은 Vision과 Sensor가 보낸 정보를 종합해 관람객과 소통하며,
plant,people,human,stable,interesting,Hello를 고르게 사용한다. UMAP 산점도에서는 Chat 모듈의 발화 점들이 Vision 모듈의 발화 점들과 가까운 좌표에 분포한다.
정지에서 이동으로 전환되는 의사결정 연쇄
그렇다면 로봇은 언제 멈춰 있고 언제 움직이기로 결정할까. 이를 확인하기 위해 Action 모듈에서 정지(Stop
)와 이동(Move
) 상태가 얼마나 자주 나타나고 얼마나 오래 지속되는지 집계하고, 상태 전환 직전에 Chat Agent가 생성한 발화의 어휘 차이를 함께 비교했다.
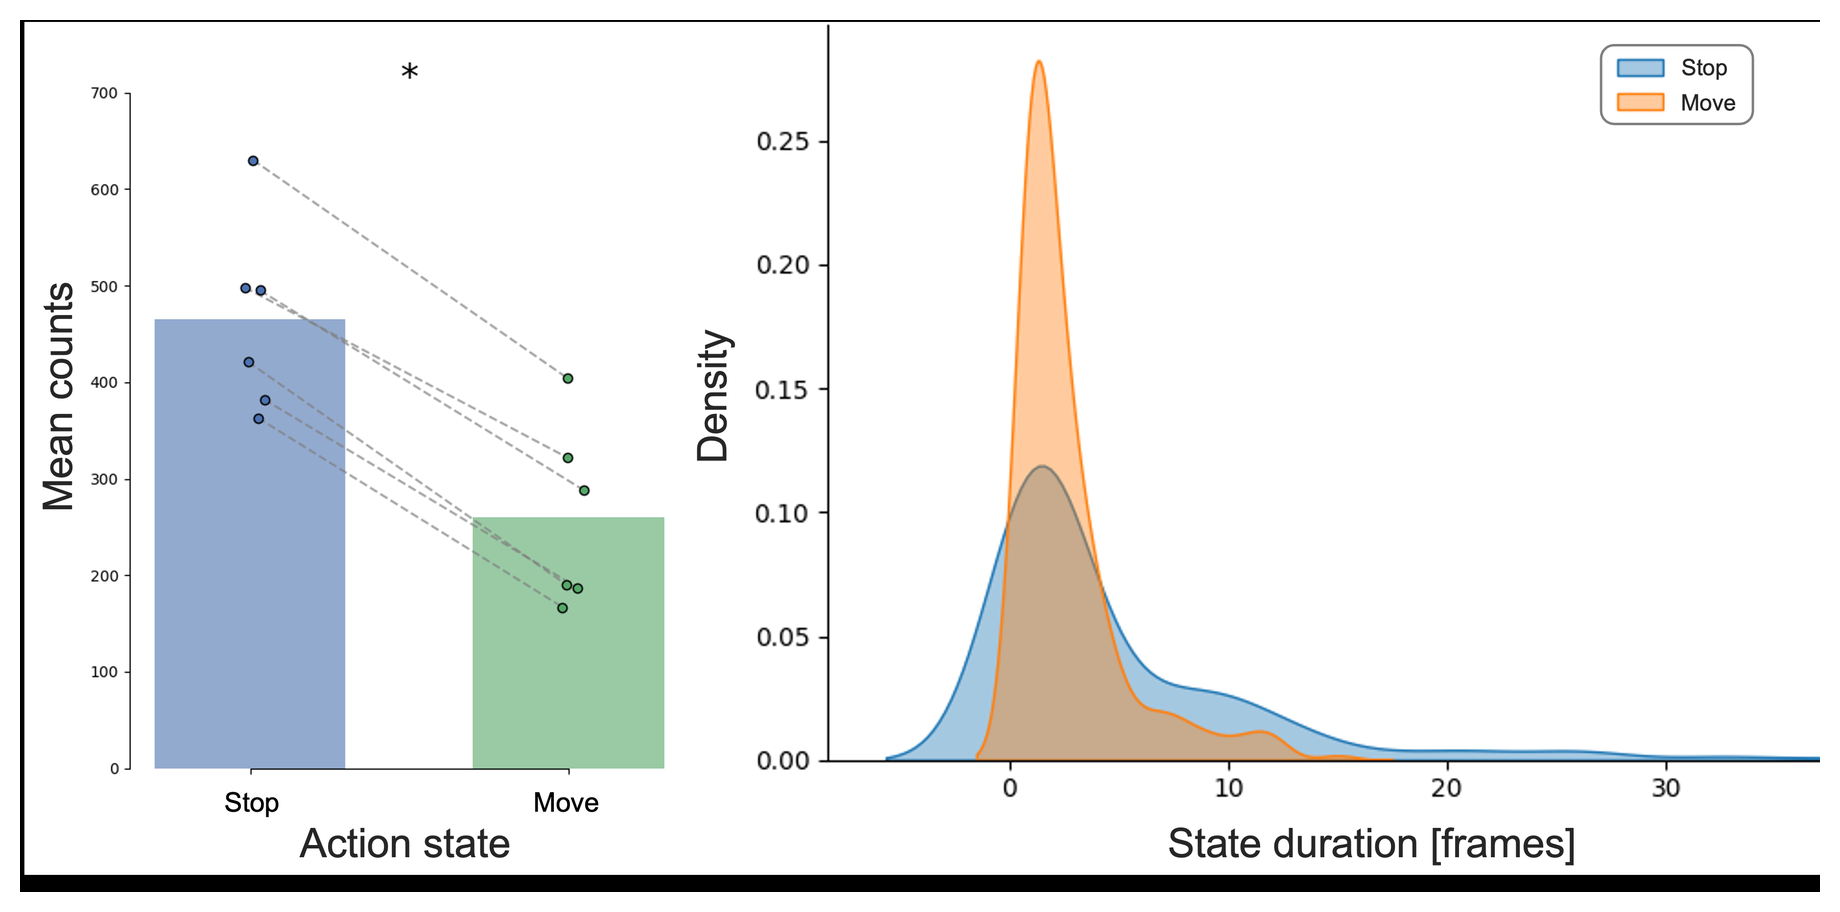 그림 6: Action 모듈의 상태 역학 분석. 왼쪽 그래프는 실험 회차별 정지(Stop)와 이동(Move) 상태의 평균 발생 횟수를 나타낸다. 정지 상태가 이동 상태보다 유의미하게 자주 나타난다. 오른쪽 그래프는 각 상태가 연속해서 유지된 프레임 수의 밀도 분포다. (출처: 원문 Figure 6)
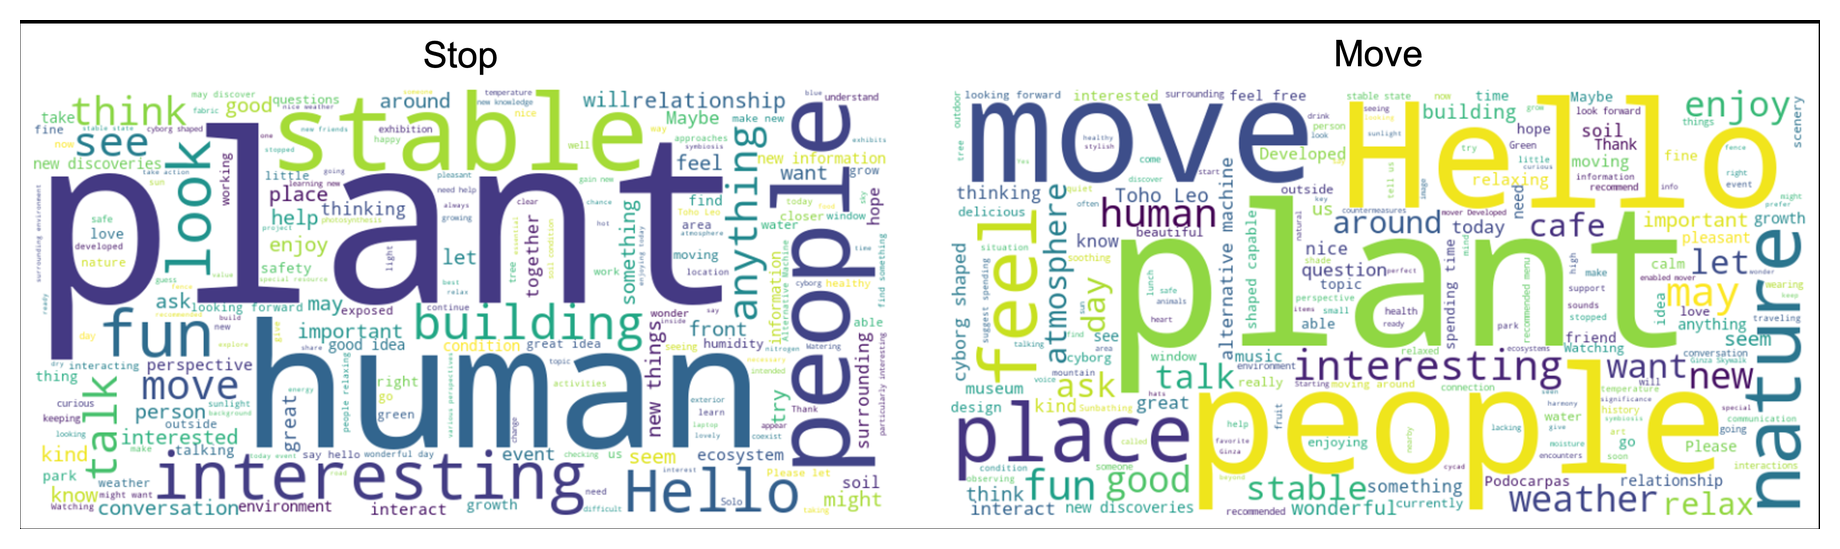 그림 7: 정지(Stop, 왼쪽)와 이동(Move, 오른쪽) 상태로 전환되기 직전에 Chat Agent가 생성한 메시지의 워드클라우드. 정지 전환 전에는
stable이 크게 나타나고, 이동 전환 전에는 move, Hello, feel 등이 두드러진다. (출처: 원문 Figure 7)
집계 결과를 보면 Plantbot은 무작위로 돌아다니기보다 대부분의 시간을 정지 상태에서 보냈으며, 한 번 이동을 시작했을 때와 멈춰 있을 때의 지속 시간 분포도 뚜렷한 차이를 보였다. 상태가 바뀌기 직전 Chat Agent가 생성한 메시지에서도 차이가 확인됐는데, 정지(Stop) 상태로 전환되기 직전에는 “안정적이다(stable)“라는 단어가 핵심 단서로 등장한 반면, 이동(Move) 상태로 전환되기 직전에는 move, Hello, people, feel처럼 행동이나 상호작용과 관련된 어휘가 집중적으로 나타났다.
논문에 수록된 실제 메시지 기록 세 건에서는 Sensor와 Vision이 감지한 내용이 Chat Agent를 거쳐 Action 모듈의 결정을 어떻게 바꾸는지 확인할 수 있다.
| 사례 | 단계별 모듈 발화 원문 및 한국어 뜻 | 전환 동인 |
|---|---|---|
| 사례 1: 토양 건조 감지 | 1. Action [0]: “대화가 아직 진행 중이라 지금은 이동할 필요를 느끼지 않는다.” (The conversation is still ongoing, and I do not feel the need to move yet.)2. Sensor: “흙이 건조하다.” (The soil is dry.) 3. Chat: “목이 마르다고 하네요. 제게 물을 좀 주시겠어요?” (It says it’s thirsty. Could you water me?) 4. Action [1]: “이 습도에서 수분을 더 흡수하려면 이동해야겠다.” (I should move to absorb more moisture in this humidity.) | 토양 건조 신호가 Chat의 물 요청 발화로 이어지자 정지를 철회하고 수분 탐색 이동으로 전환 |
| 사례 2: 수분 부족과 행동 권유 | 1. Action [0]: “아직 사람과 대화 중이고 할 말이 더 남아 있어서 정지 상태를 유지하겠다.” (I’m still engaged in conversation with a human and there are more things to say, so I will remain stationary.)2. Sensor: “영양분 수치는 안정적이지만 물이 부족하다. 조치가 필요하다.” (There is a lack of water, though nutrient levels are stable. Some action is needed.) 3. Chat: “영양분은 괜찮은데 물이 부족하군요. 뭔가 해야겠어요. 쉬고 있는 상태에서 좀 움직여 볼까요? 울타리를 따라가 봐도 좋겠네요.” (So, there’s a water shortage but nutrients are stable… Do you feel like moving from this resting state? Maybe you could follow along the fence.) 4. Action [1]: “이 정지 상태를 끝내고 움직이고 싶다.” (I think I’d like to move from this stationary state.) | Sensor의 조치 요청을 받은 Chat이 구체적인 이동을 제안하자 Action이 이동을 선택 |
| 사례 3: 관람객 발견과 접근 | 1. Action [0]: “대화가 이어지고 있어서 이동할 필요를 느끼지 않는다.” (The conversation is still ongoing, and I do not feel the need to move.)2. Vision: “정면에 건물이 있고 그 앞에 사람 두 명이 서 있다.” (There is a building in front, and two people are standing in front of it.) 3. Chat: “안녕하세요! 저는 식물로서 말할 수 있는 사이보그 같은 존재인 아레카야자(Chrysalidocarpus)입니다. 이 식물은 흥미로운 생태계의 일부예요. 질문 있으신가요?” (Hello! I’m a Chrysalidocarpus-a cyborg-like being that can talk as a plant… Do you have any questions?) 4. Action [1]: “대화가 계속되고 있으니, 이야기를 더 이어가려면 저 사람들에게 가까이 다가가고 싶다.” (The conversation is continuing, and I’d like to move closer to the people so I can talk more.) | Vision이 포착한 두 사람의 존재와 Chat의 인사말이 결합해 관람객에게 다가가는 행동 유발 |
세 사례 모두 처음에는 Action 모듈이 “대화가 진행 중이므로 멈춰 있겠다([0])“고 판단했다. 그러다 직후 Sensor 모듈이 수분 부족을 알리거나 Vision 모듈이 전방의 사람을 포착하고, 이 정보를 받은 Chat Agent가 “물을 달라"거나 “안녕하세요"라고 말하자, Action 모듈은 기존 결정을 바꿔 이동([1])을 택했다. 연구진은 이처럼 결정을 바꾸는 모습이 모순된 작동이라기보다, 비동기 분산 에이전트 네트워크가 환경 및 생리 신호에 실시간으로 적응한 결과라고 설명했다.
자기조직화 연결망과 확장된 생태계를 향하여
논문 마지막 장에서는 현재 프로토타입의 한계와 함께 세 가지 후속 연구 과제를 다룬다.
첫 번째 과제는 내부 감각(interoception)과 기억 메커니즘의 보강이다. 현재 프로토타입은 토양 수분이나 영양분 같은 간접 지표로 식물의 상태를 파악하지만, 앞으로 식물의 생체 전위(bioelectric potential)처럼 직접적인 생리 신호를 측정하고 장기 기억 구조를 추가하면 한층 정교한 자율 행동이 가능해질 것이라고 보았다.
두 번째 과제로는 모듈 간 통신 구조에 가소성(plasticity)을 부여하는 방안이 제시됐다. 현재 Plantbot에서는 Sensor와 Vision이 Chat으로 메시지를 보내고, Chat이 Action으로 전달하는 관계가 고정되어 있다. 각 모듈은 자연어로 자기 역할을 설명하고 조율할 수 있는 LLM이다. 따라서 거대 모델을 다시 학습시키지 않고도 에이전트들이 메타 대화로 “언제, 어떻게, 누구와 정보를 공유할지"를 협상할 수 있다고 설명했다. 이를 통해 연결을 강화하거나 불필요한 통신 경로를 줄이는 자기조직화 네트워크로 발전시킬 수 있다고 보았다.
세 번째 과제는 단일 로봇 실험을 확장된 생태계(extended ecosystem)로 발전시키는 구상이다. 자연어를 공통 프로토콜로 사용하기 때문에 새로운 센서나 다른 생물, 로봇, 인간 참여자를 네트워크에 추가로 연결하기가 수월하다. 따라서 식물 한 그루와 로봇 한 대의 결합에 그치지 않고, 여러 식물과 로봇, 센서가 자연어 통신망으로 협력하면 생태계 전반의 회복탄력성을 돕는 집단적 생태 지능(ecological intelligence)을 구현할 수 있다고 전망했다.
가장 흥미로운 지점
내가 이 설계에서 주목한 것은 식물의 생존 조건에서 행동할 동기를 얻었다는 점이다. 프롬프트에 “호기심을 가져라"거나 “주기적으로 탐색하라"고 적어 주는 방식은 사람이 정한 규칙을 변형해 실행하는 수준에 그친다. 식물은 흙이 마르면 실제로 시들어 죽기 때문에, 화분 식물을 감각 입력단에 직접 연결한 이케가미 연구팀의 설계에서는 수분 부족을 알리는 센서 신호가 가상으로 계산한 보상 수치와 달리 식물의 실제 생존 조건을 뜻하게 된다.
원래 토양 센서 수치와 전시장 카메라 영상, 관람객 음성, 크롤러 모터 제어 신호를 한 시스템에서 엮으려면 데이터 규격마다 별도의 변환 스키마를 짜야 한다. Plantbot은 그 과정을 생략하고 모든 입출력을 “목이 마르다”, “앞에 두 사람이 있다”, “다가가고 싶다” 같은 일상 문장으로 바꿔 OSC 프로토콜로 주고받는다. 연구자나 관람객은 모듈 간 대화를 읽으며 식물의 상태가 발화와 이동 결정에 어떻게 반영되는지 확인할 수 있다.
출처
Atsushi Masumori, Norihiro Maruyama, Itsuki Doi, johnsmith, Hiroki Sato, Takashi Ikegami (Alternative Machine Inc., The University of Tokyo), Plantbot: Integrating Plant and Robot through LLM Modular Agent Networks, arXiv:2509.05338v1, 2025-09-01. 원문: https://arxiv.org/abs/2509.05338 치비 서소영 삽화 1장은 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조해 gpt-image-2.5-flare로 따로 생성했다.
여기서 규범성(normativity)은 행위 주체가 자신의 상태를 유지하기 위해 무엇이 좋고 나쁜지를 판별하는 내적 기준을 뜻한다. Barandiaran 등(2009)은 행위 주체성의 성립 조건으로 개체성, 비대칭성, 시공간성과 함께 이 규범성을 제시했다. ↩︎
응답 속도와 문맥 유지의 균형을 맞추기 위해 대화(Chat), 센서(Sensor), 행동(Action) 모듈에는 최근 10개의 메시지를 기억하는 고정 길이 히스토리 버퍼(n = 10)를 두었고, 시각(Vision) 모듈만 이전 상태를 저장하지 않는 무상태(stateless) 방식으로 구현했다. ↩︎
중앙의 Chat Agent가 여러 전문 모듈의 정보를 비동기로 통합하는 구조는 버나드 바스(Bernard Baars)의 글로벌 작업공간 이론(Global Workspace Theory, GWT)과 구조적으로 닮았으나, GWT가 상정하는 의식적 전역 방송(conscious global broadcasting)을 명시적으로 구현하지는 않았다고 논문은 밝혔다. ↩︎
전시 현장에서 각 LLM 모듈이 생성한 발화는 원래 일본어였으나, 임베딩과 어휘 빈도 분석을 위해 영어로 번역해 처리했다. ↩︎