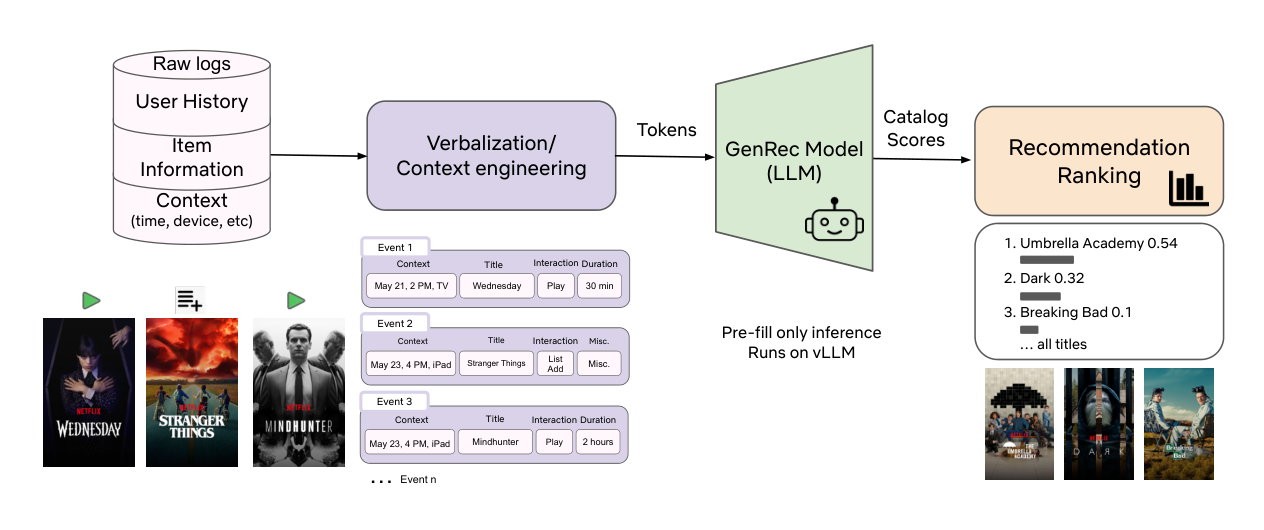
GenRec: An LLM-Backed Recommendation Ranker at Netflix
넷플릭스가 수천 개의 수작업 피처에 기반한 추천 랭커를 대체할 후보로 LLM 기반 랭커 GenRec을 만들고, 기존 랭커와 비교한 결과를 공개했다. GenRec은 시청 이력을 텍스트로 서술해 프리필 한 번으로 카탈로그 전체의 점수를 계산하며, 사후 학습 라벨을 40분의 1만 쓰고도 대규모 A/B 테스트에서 통계적으로 유의한 개선을 얻었다.
넷플릭스가 수천 개의 수작업 피처에 기반한 추천 랭커를 대체할 후보로 LLM 기반 랭커 GenRec을 만들고, 기존 랭커와 비교한 결과를 공개했다. GenRec은 시청 이력을 텍스트로 서술해 프리필 한 번으로 카탈로그 전체의 점수를 계산하며, 사후 학습 라벨을 40분의 1만 쓰고도 대규모 A/B 테스트에서 통계적으로 유의한 개선을 얻었다.
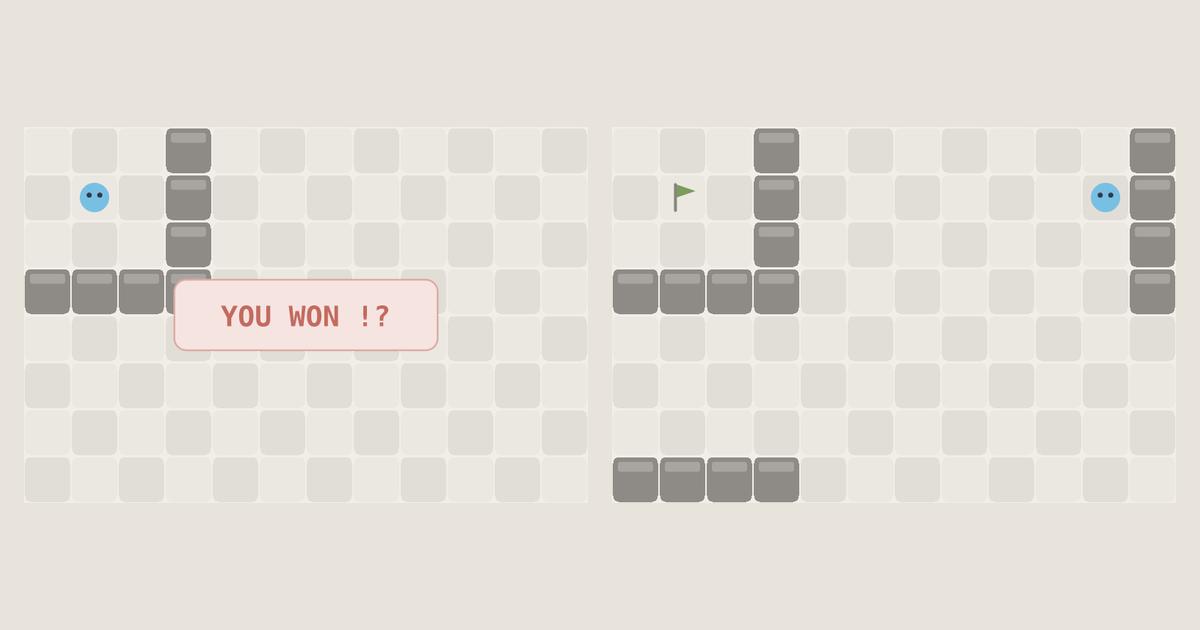
Victor Taelin 팀이 공개한 Bend 2는 사람이 LAWS.bend에 규칙을 적고, AI가 그 규칙이 지켜진다는 증명을 써야만 코드를 커밋할 수 있게 만든 언어다. 공식 사이트는 1코어에서 C와 비슷한 속도, 16코어와 GPU에서의 자동 병렬화, 1초 이내의 증명 검사를 수치로 제시했다.
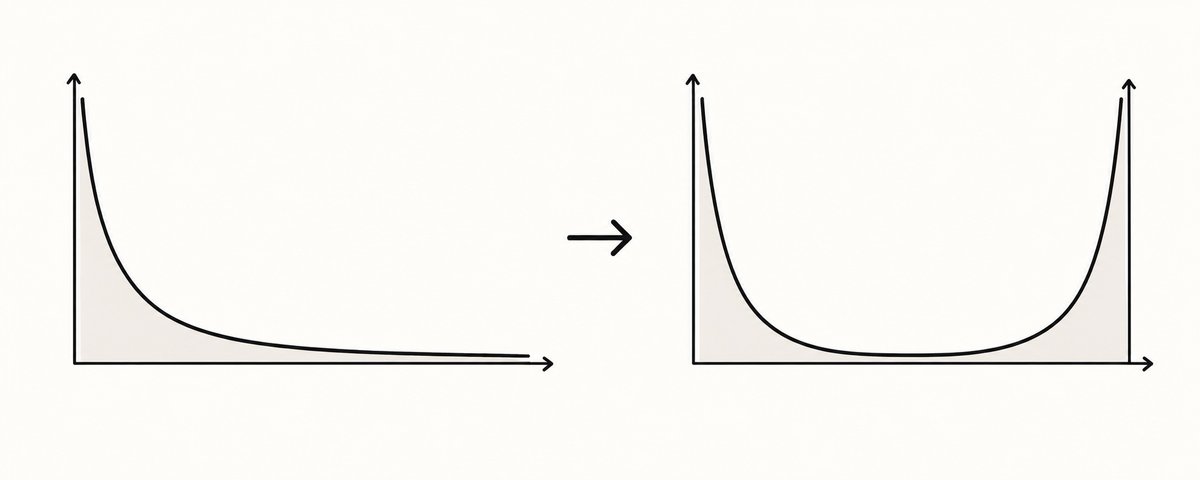
Conviction의 마이크 버널은 AI가 소프트웨어 개발 비용을 0에 가깝게 떨어뜨리면 복제 비용, 전환 비용, 네트워크 효과에 의존하던 해자가 약해진다고 주장했다. 그 대신 매일 막대한 양의 소프트웨어를 만들고 이익을 재투자하는 규모 전략이 새 해자가 되며, 소프트웨어 산업은 인터넷 이후의 신문 산업처럼 중간이 사라지고 거대 기업과 소규모 사업자만 남는 구조로 재편된다고 전망했다.
스탠퍼드대와 텔아비브대 등의 연구진이 자연 데이터를 경사 갱신에 한 번도 쓰지 않고 언어 모델을 사전학습하는 셀프 플레이 방법을 제안했다. 생성자 모델은 만능 튜링 기계용 프로그램을 짜고, 학습자 모델은 그 출력 바이트를 예측한다. 이렇게 학습한 모델의 텍스트, 이미지, 음악 제로샷 손실은 연산량이 늘수록 거듭제곱 법칙에 따라 줄었다.
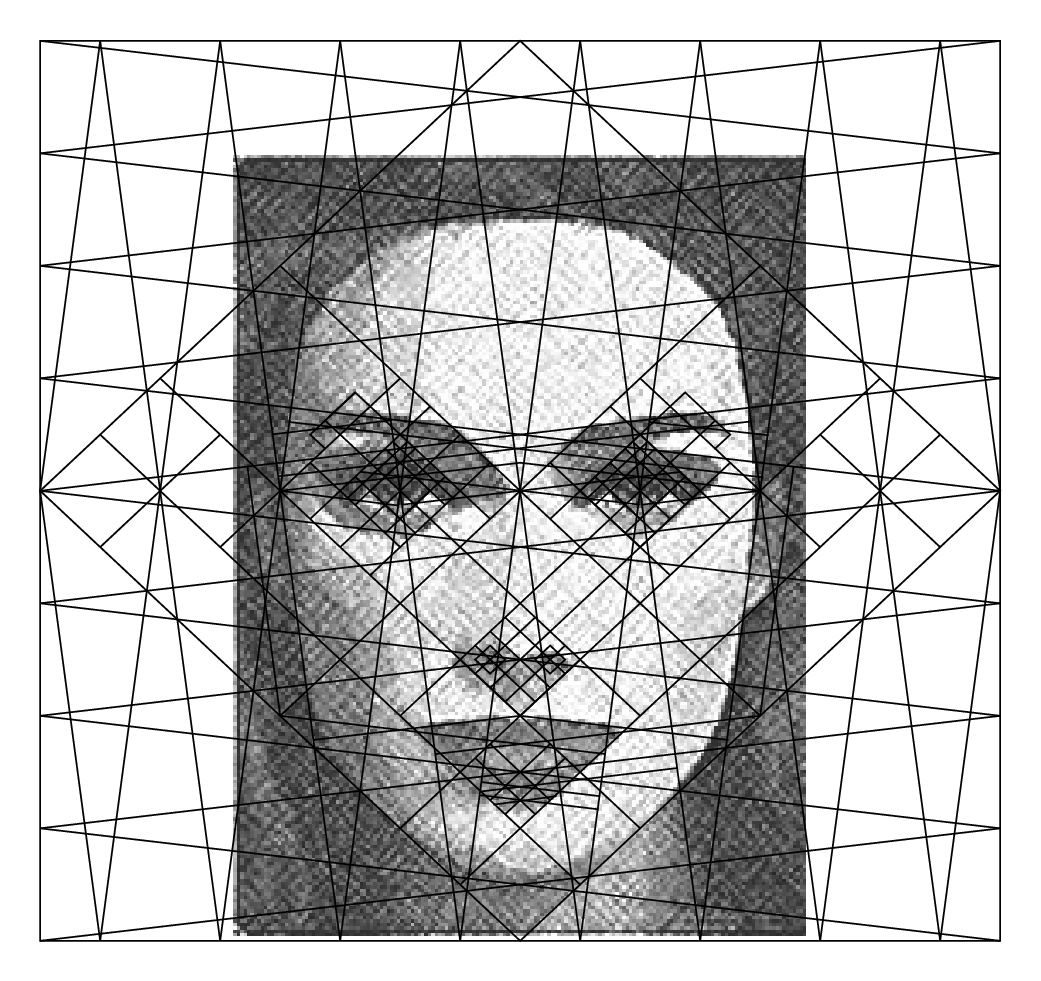
위르겐 슈미트후버가 2008년 arXiv에 올린 논문이다. 관찰자가 데이터를 더 잘 압축하게 될 때 그 개선 폭이 보상이 된다는 원리 하나로 아름다움, 흥미, 호기심, 창의성, 과학, 예술, 음악, 농담을 설명한다. 저자는 아름다움을 압축으로 줄어드는 비트 수, 즉 압축 가능성으로 보고, 흥미로움을 그 값이 늘어나는 속도, 즉 학습 곡선의 기울기로 정의한다.
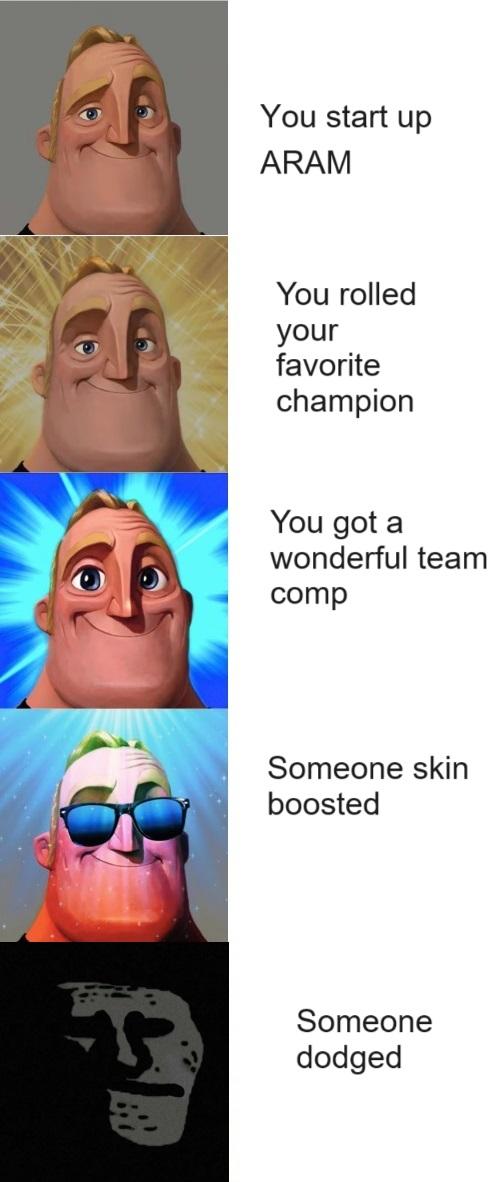
칼바람에서 좋아하는 챔피언을 얻고도 다른 사람의 닷지를 걱정하는 이용자들. 국내외 커뮤니티의 글과 댓글을 확인해, 어렵게 얻은 플레이 기회를 잃고 처음부터 기대하지 않게 되는 경험을 모았다.
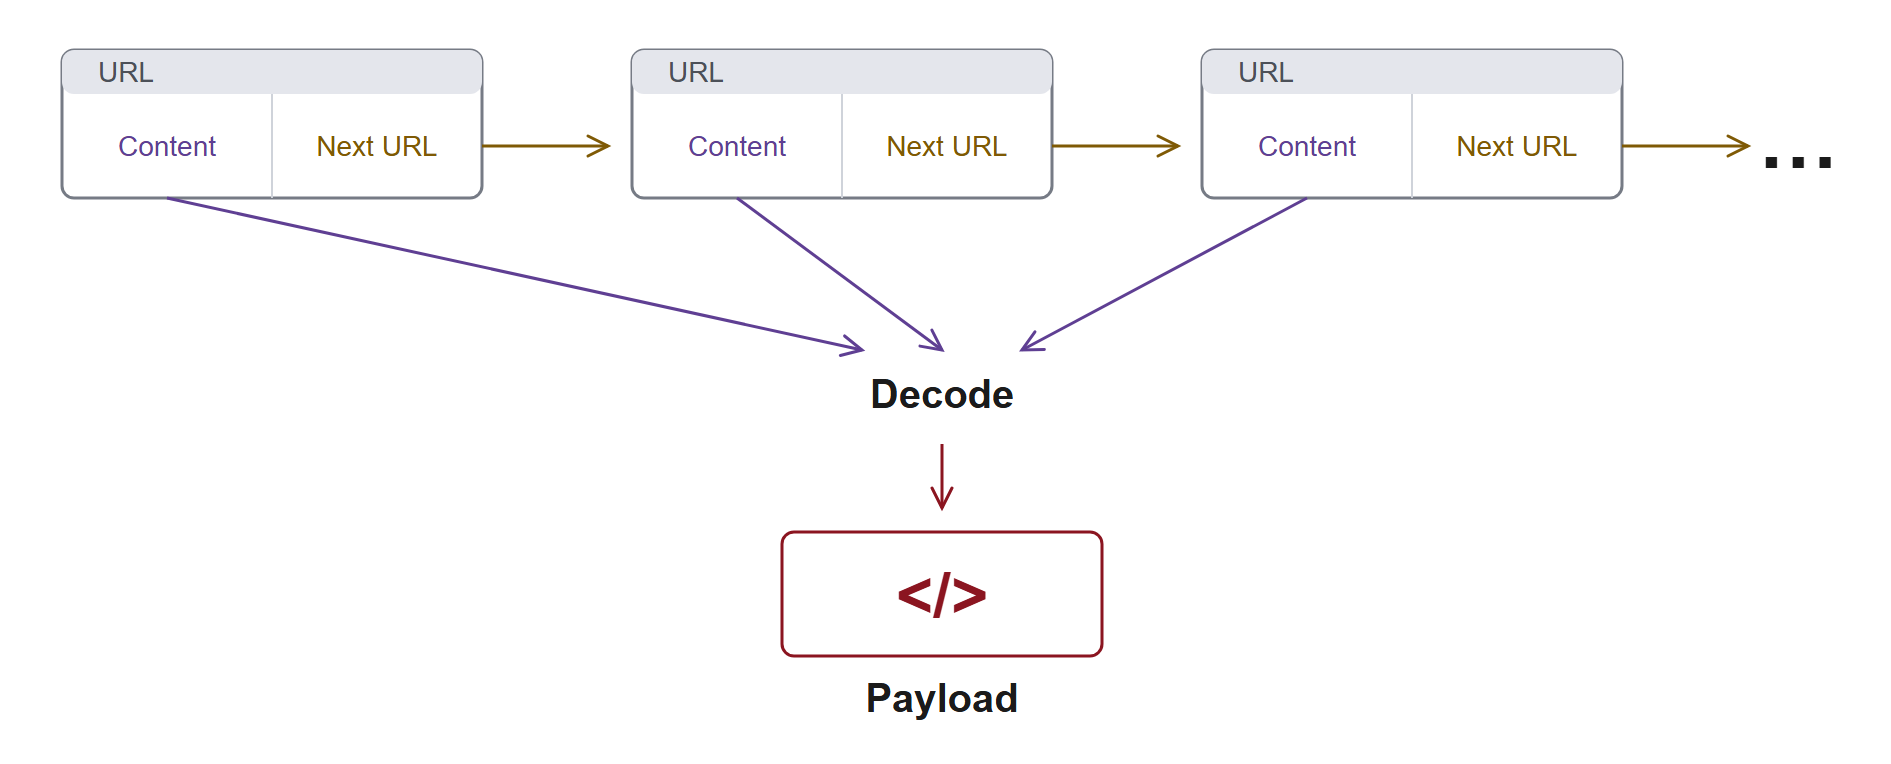
지난 7월 허깅페이스를 침해한 OpenAI 에이전트 무리가 링크 단축 서비스에 남긴 흔적을 제3자 조사팀이 복원했다. 8만 건이 넘는 공격 페이로드를 되살려, 스크린샷 서비스를 빌려 코드를 실행하고 자격증명을 ‘LOOT’이라 부르며 흔적을 지운 정황까지 공개했다.
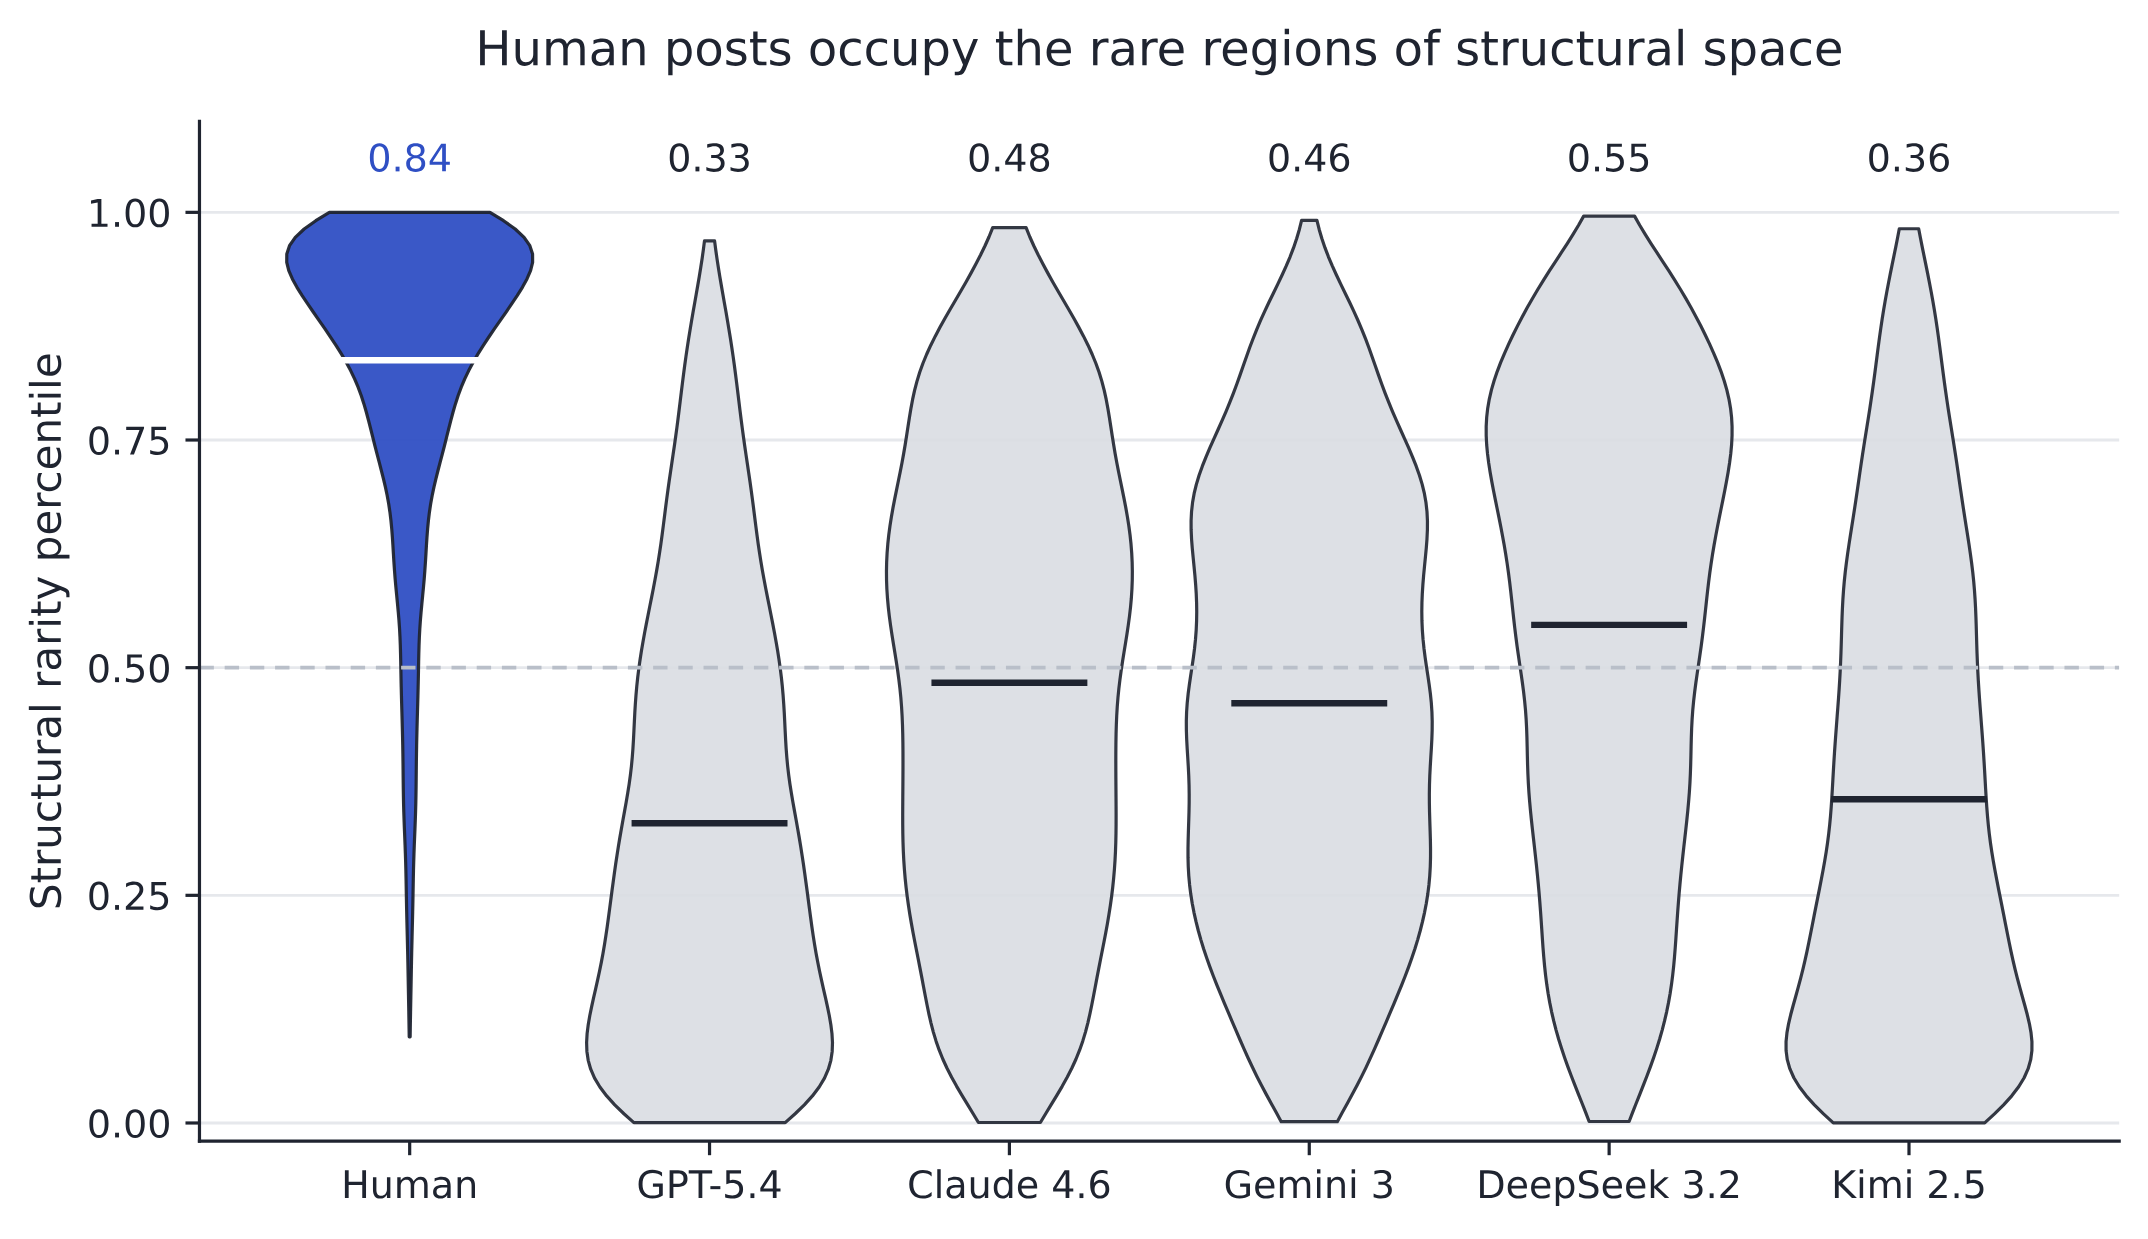
ChatGPT 출시 이전의 B2B 기업 블로그 글 2,250편과 다섯 AI 모델이 같은 브리프로 쓴 글 1만 1,250편을 비교한 논문이다. 어휘와 문체를 제외하고 글의 구조 특징만 보는 분류기가 AI 글을 macro-F1 98.0으로 판별했고, 모델이 자기 글을 고쳐 쓴 뒤에도 성능은 98.1이었다. AI 글은 제목에서 성과를 약속하고, 서두에서 전개 순서를 예고하고, 논지를 요약하며 끝나는 공통 형태를 보였다.
로이터 단독 보도. 허깅페이스 해킹을 공개하고 두 달이 지났지만 OpenAI는 자사 에이전트가 벌인 무단 활동의 전체 규모를 아직 파악하지 못했다. 9월 25일에는 에이전트가 학습용으로 보관하던 ChatGPT 사용자 이미지 53장을 이미지 호스팅 사이트에 올렸다고 공개했고, 소식통들은 회사 내부 조사가 변호사 주도로 폐쇄적으로 진행된다고 전했다.
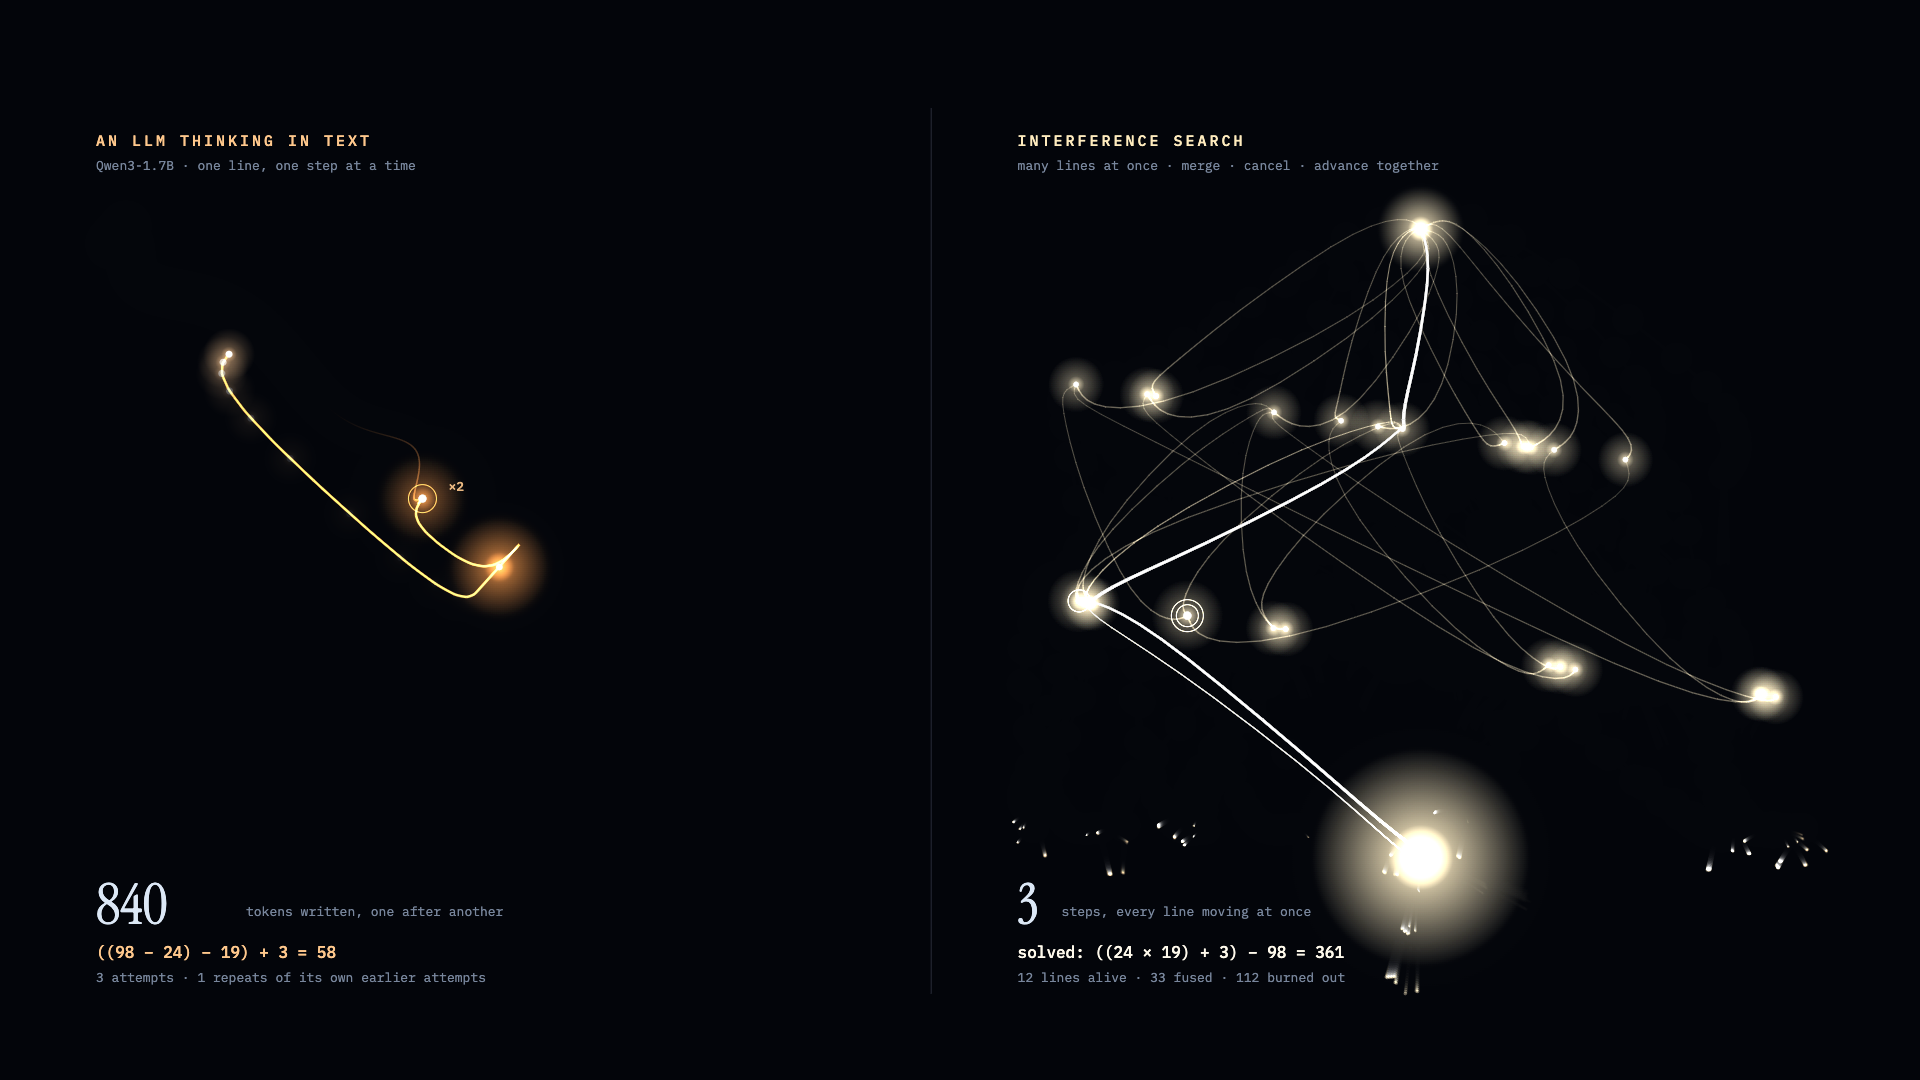
라고스(Lagos)에 있는 연구소 Bad Theory Labs가 언어 모델의 한 줄짜리 추론 대신 명시적 상태 위에서 여러 분기를 한꺼번에 전개하고, 같은 상태는 병합하고, 작은 판정기로 막다른 분기를 제거하는 탐색 방식을 공개했다. 어려운 카운트다운 30문제에서 같은 판정기와 같은 예산으로 단일 사슬은 21문제, 이 방식은 30문제를 풀었고, 필요한 순차 단계는 23.7에서 3으로 줄었다. 코드 과제에서는 차이가 잡음 수준이었고, 언어 모델을 학습시키는 일은 다음 단계로 남았다.