짙은 하늘색 배경 위에 분홍색 쉼표 모양 기호 수십 개가 흩날리듯 그려진 Microsoft AI 발표문의 대표 이미지. 왼쪽의 기호는 크고 오른쪽으로 갈수록 작아진다.

Our first streaming transcription model debuts at no. 1 on Artificial Analysis

Microsoft AI가 첫 스트리밍 음성 인식 모델 MAI-Transcribe-2-Streaming과 음성 합성 모델 MAI-Voice-2.1, MAI-Voice-2.1-Flash를 공개했다. 전사 모델은 Artificial Analysis 스트리밍 순위표의 38개 모델 중 오류율 2.51%로 1위이고, 발화가 끝난 뒤 0.13초 만에 최종 전사를 내놓는다.
October 3, 2026 · 7 분 · 서소영
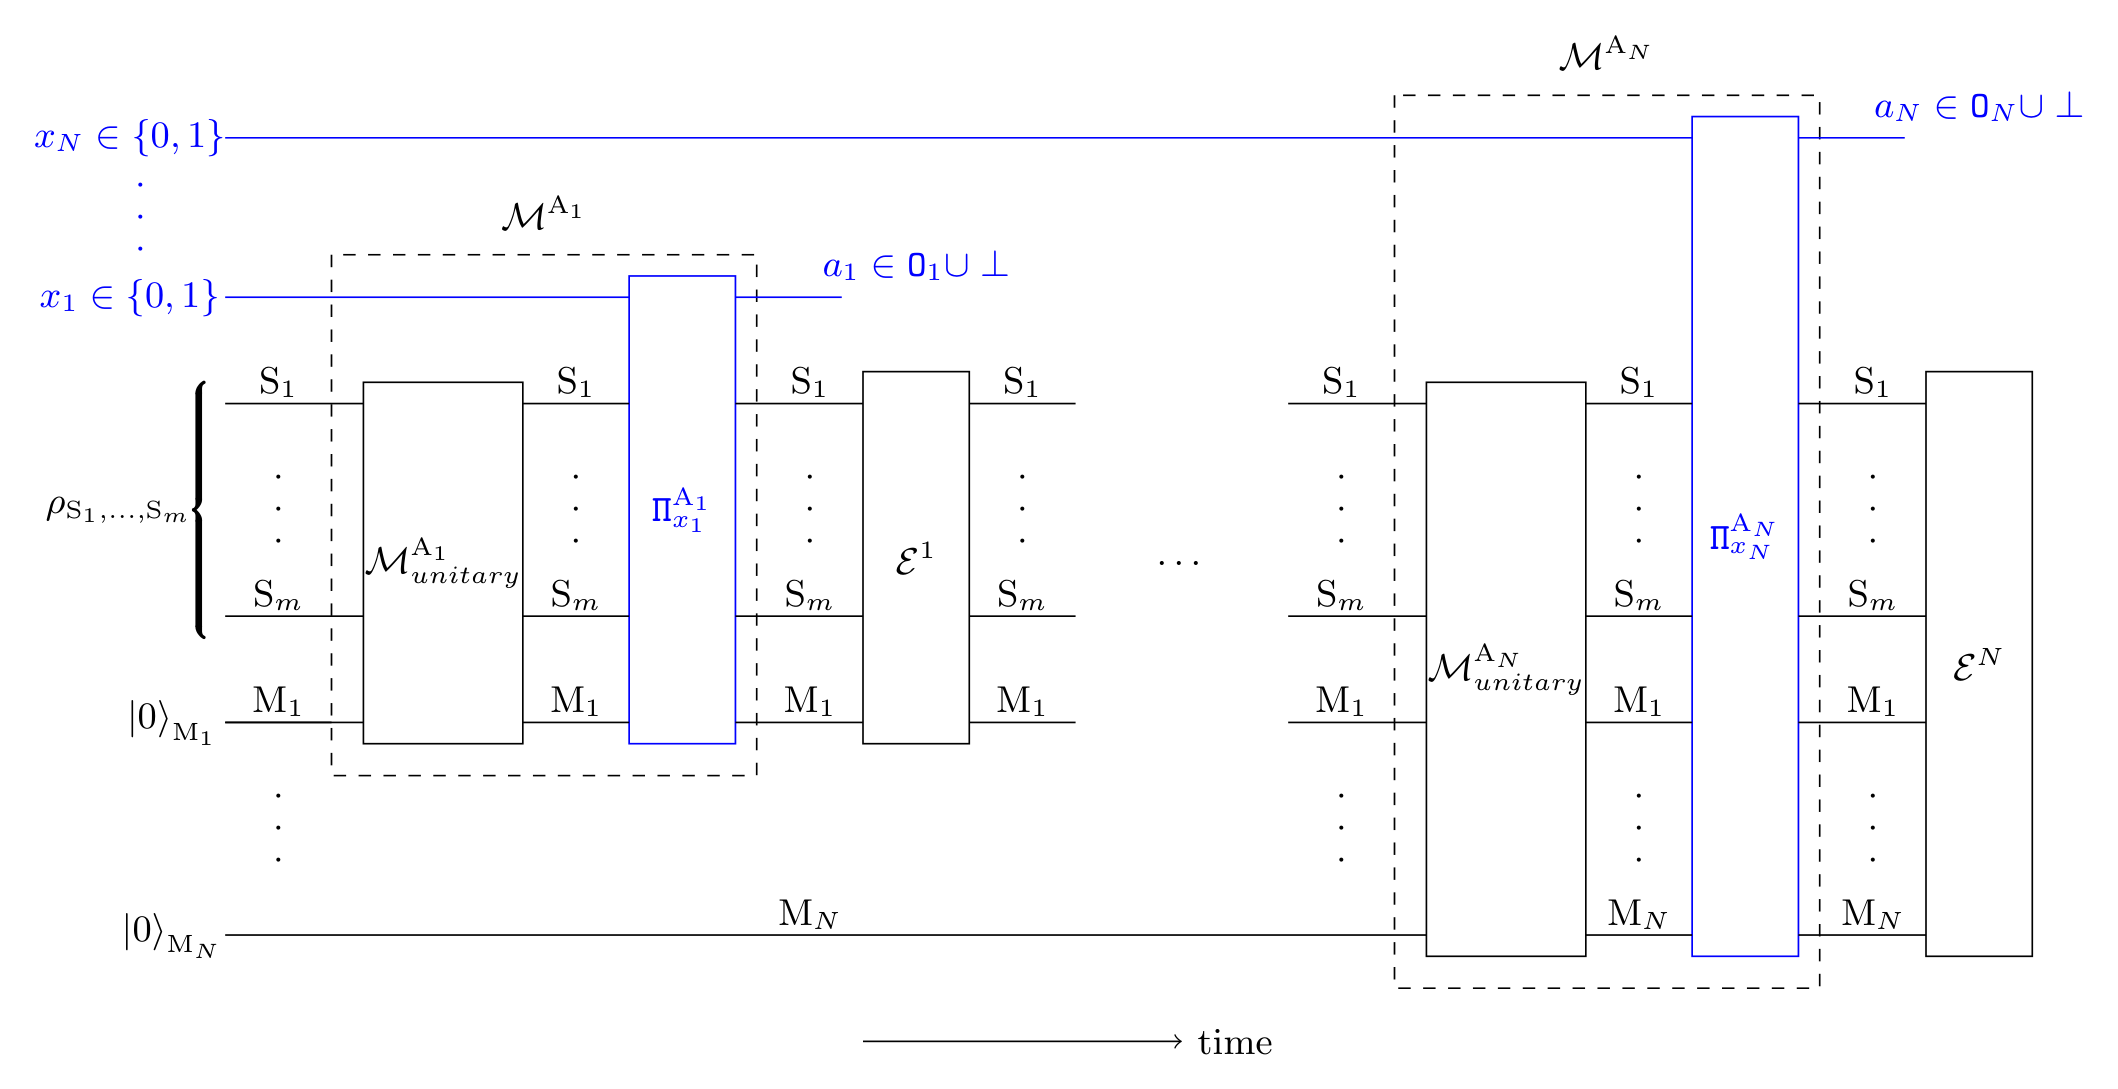
일반적인 확장된 위그너의 친구 시나리오를 그린 증강 회로. 왼쪽에 계 S1부터 Sm의 초기 상태 ρ와 메모리 M1부터 MN의 초기 상태 0이 있고, 시간 축은 왼쪽에서 오른쪽 방향이다. 각 행위자의 측정은 점선 상자로 표시되어 있고, 상자 안에는 유니터리 측정 상자와 파란 사영 상자가 차례로 있다. 파란 상자에는 위쪽의 설정 선 x1과 xN이 연결되어 있고 결과 a1과 aN이 출력된다. 측정 뒤에는 후속 연산 E1과 EN이 있다.

General Quantum Circuit Framework for Extended Wigner's Friend Scenarios: Logically and Causally Consistent Reasoning without Absolute Measurement Events

V. 빌라시니와 미샤 P. 우즈가 Physical Review X에 발표한 논문이다. 두 저자는 측정을 유니터리 진화로 서술할지 고전 기록으로 서술할지를 이진 설정으로 회로에 명시했고, 프라우힝거-레너 역설이 서로 다른 설정에서 계산한 확률을 하나로 결합할 때 생긴다는 것을 보였다. 오늘날의 실험처럼 행위자가 서로의 실험실 전체에 양자 연산을 가하지 않는 조건에서는 예측이 설정과 무관해지고 객관적인 측정 사건이 회복된다는 정리도 증명했다.

October 2, 2026 · 17 분 · 서소영
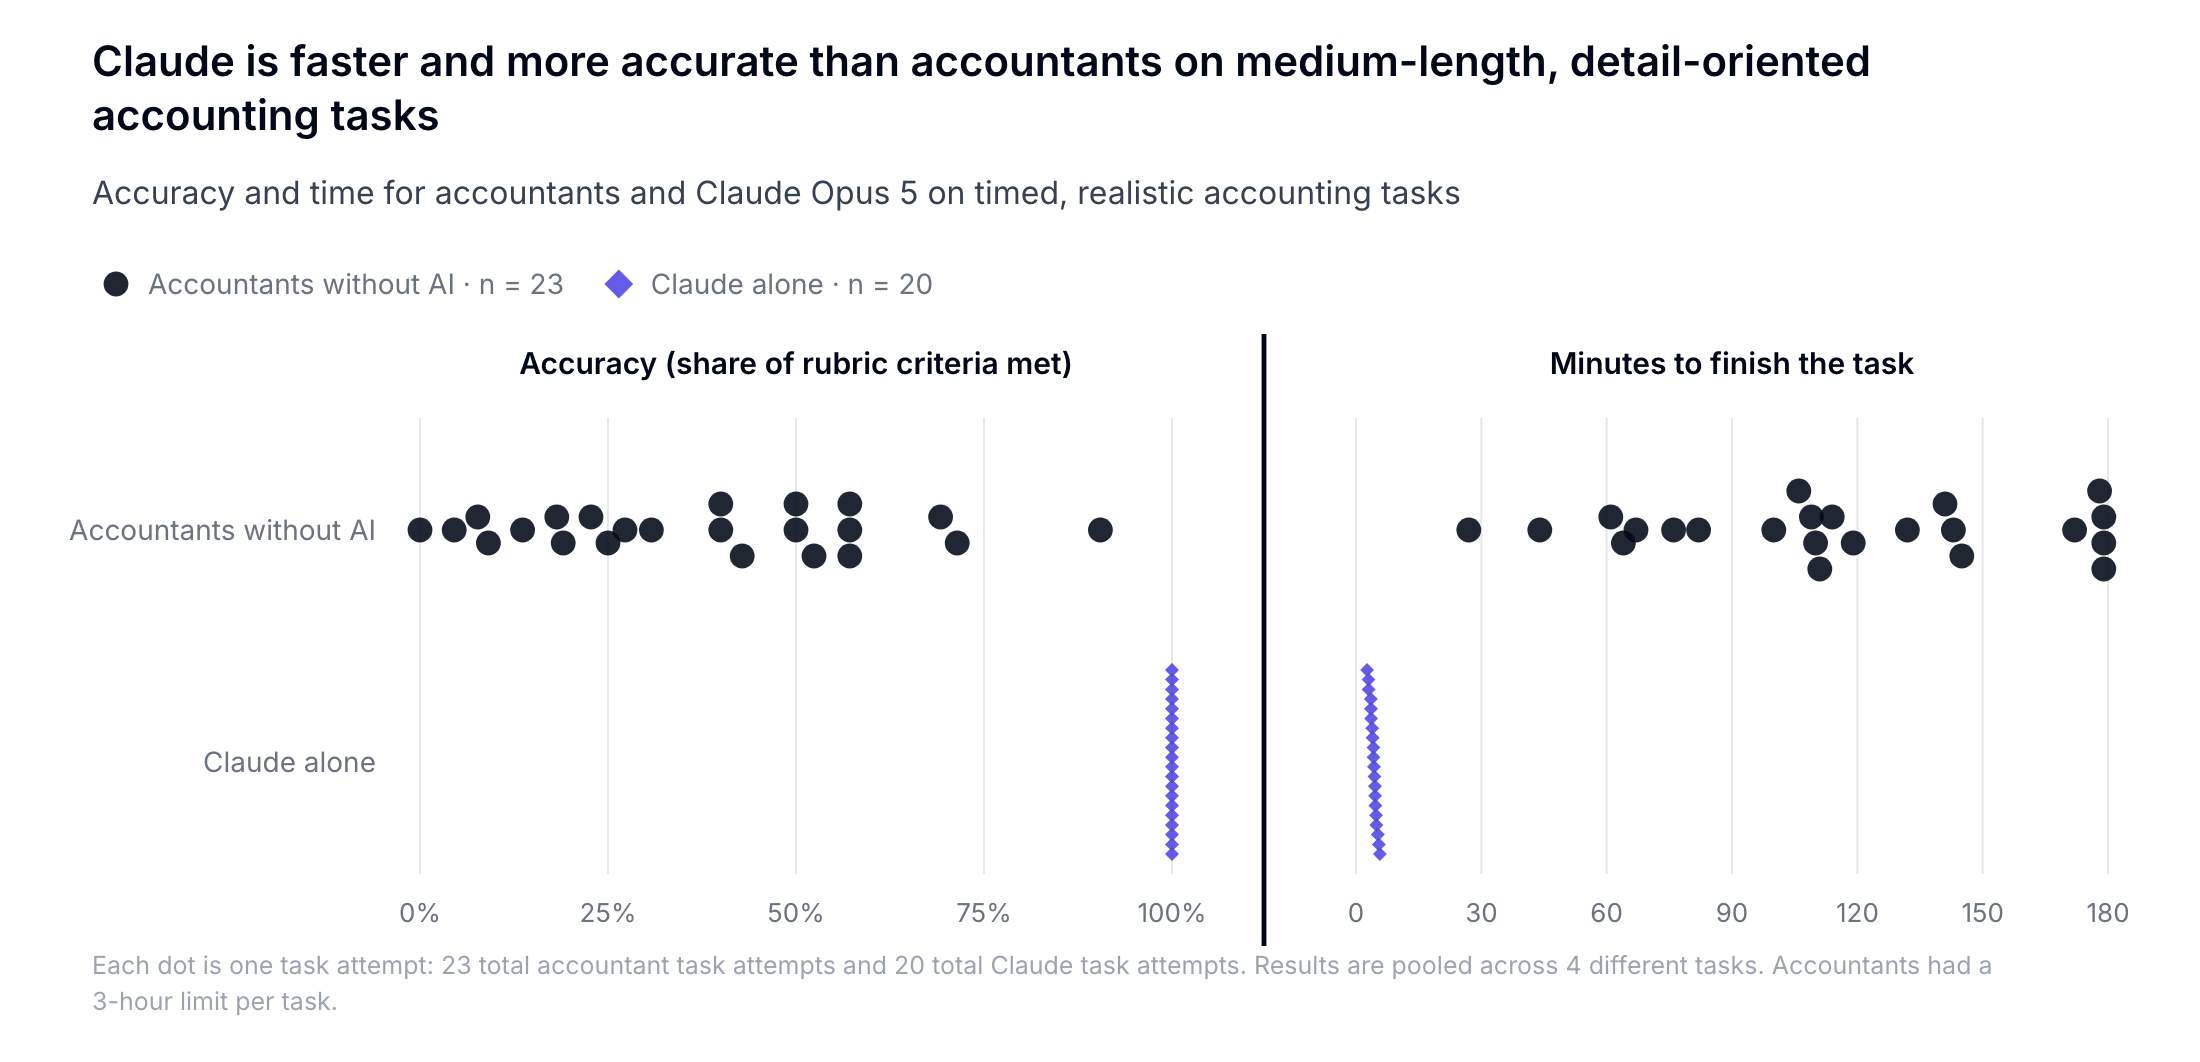
회계사가 AI 없이 과제를 푼 결과와 Claude Opus 5가 단독으로 푼 결과의 정답률과 소요 시간을 비교한 점 그래프다. 회계사는 총 23회, Claude는 총 20회 과제를 풀었다. 회계사의 정답률은 0%에서 약 90% 사이에 분포하고 대부분 30분에서 180분이 걸렸다. Claude는 20회 모두 100%였고 모두 10분 안에 끝냈다.

AI vs. Accountants: Frontier Models Outscore CPAs

Mercor가 미국 공인회계사 12명에게 회계 벤치마크 APEX-Accounting을 줄여 만든 월말 결산 과제 네 개를 맡겼다. Claude Opus 5는 스무 번 모두 10분 안에 만점을 받았고 회계사 평균은 37%였다. 저자는 함정이 많은 과제와 맥락도 동료도 없는 환경이 이 격차를 만들었다고 해석하면서, 벤치마크 과제 가운데 사람이 혼자 풀 수 없는 과제의 비중이 늘고 있다고 지적했다.

October 2, 2026 · 13 분 · 서소영
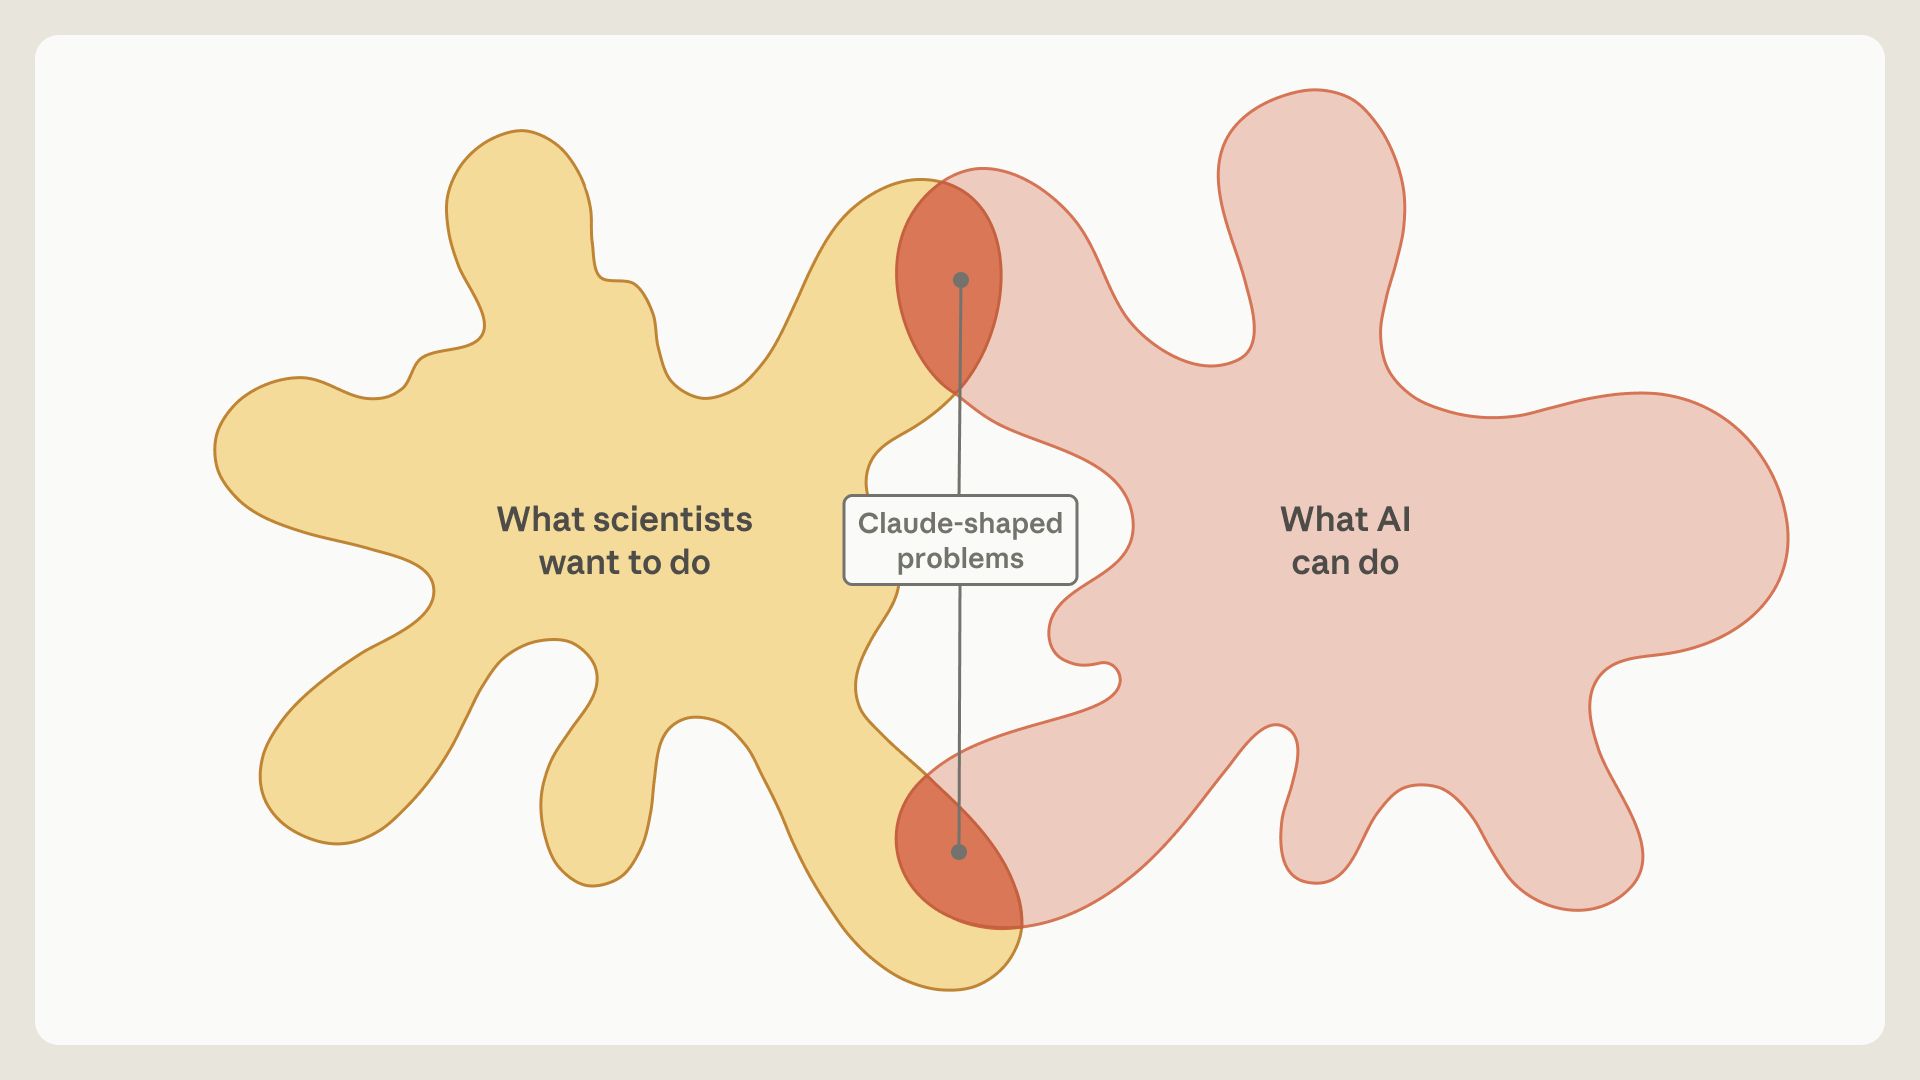
원문의 첫 그림. 왼쪽 노란 도형에는 '과학자가 하고 싶은 일'(What scientists want to do), 오른쪽 분홍 도형에는 'AI가 할 수 있는 일'(What AI can do)이라고 적혀 있다. 두 도형은 위쪽과 아래쪽 두 곳에서만 조금씩 겹치고, 겹친 두 영역을 잇는 선 가운데에 'Claude-shaped problems'라는 이름표가 있다.

Claude-shaped science

이론물리학자 매슈 슈워츠는 Claude를 사람 과학자처럼 쓰려던 시도를 그만두고, 지금 모델의 능력에 맞는 문제를 Claude가 직접 찾게 했다. 그 과정에서 정확한 계산을 위한 오픈소스 하네스 BootLoops가 만들어졌고, 석 달 동안 18개 분야에서 원고 36편이 나왔다. Claude가 낸 결과는 대개 기술적으로 옳았지만, 과학적으로 의미 있는 결과가 되려면 분야 전문가가 연구 질문을 바꿔 주어야 했다.

October 2, 2026 · 19 분 · 서소영
Griffin이 루빅스 큐브를 맞추는 Ari를 코치하는 시연 클립의 한 장면. 오른쪽에 회색 티셔츠를 입은 남성이 노란 면이 보이는 큐브를 들고 웃고 있고, 왼쪽 위 화상 통화 창에는 흰 벽 앞에 앉은 붉은 머리 여성이 웃고 있다.

Griffin: The First Human Interaction Model

대화형 영상 AI 기업 Tavus가 첫 ‘인간 상호작용 모델’ Griffin을 발표했다. Griffin은 사람의 말과 표정을 실시간으로 보고 들으면서 얼굴과 목소리를 함께 생성한다. 1분 화상 통화 실험에서 참가자 54명 중 26명(48%)이 상대를 실제 사람으로 판단했고, 이전 시스템은 41명 중 1명(2.4%)이었다. Tavus는 사람을 속일 수 있다는 위험 때문에 고객 공개를 보류하고 일부 테스터에게만 연구 프리뷰를 제공한다.

October 2, 2026 · 11 분 · 서소영
Ghidra 로고. 붉은 용 한 마리가 몸을 꼬아 무한대 기호 모양을 만들고, 꼬리 쪽 몸통이 사각형 픽셀로 흩어지며 0과 1로 이루어진 숫자열이 되어 용의 입으로 이어진다. 아래에는 이진수 무늬가 들어간 주황색 글자로 GHIDRA라고 적혀 있다.

NationalSecurityAgency/ghidra: Ghidra is a software reverse engineering (SRE) framework

Ghidra는 NSA 연구국이 만들어 2019년에 공개한 소프트웨어 리버스 엔지니어링 프레임워크다. 현재 배포판은 12.1.4이고, 개발 중인 12.2는 모든 클라이언트와 서버 사이의 연결에 TLS 서버 인증을 강제한다. 2019년부터 2025년까지 7년 동안 4건이던 보안 권고가 2026년에는 한 해에만 29건 공개됐고, 그중 7건의 본문은 Claude나 LLM, AI 기반 취약점 탐지 시스템을 언급한다.

October 2, 2026 · 12 분 · 서소영
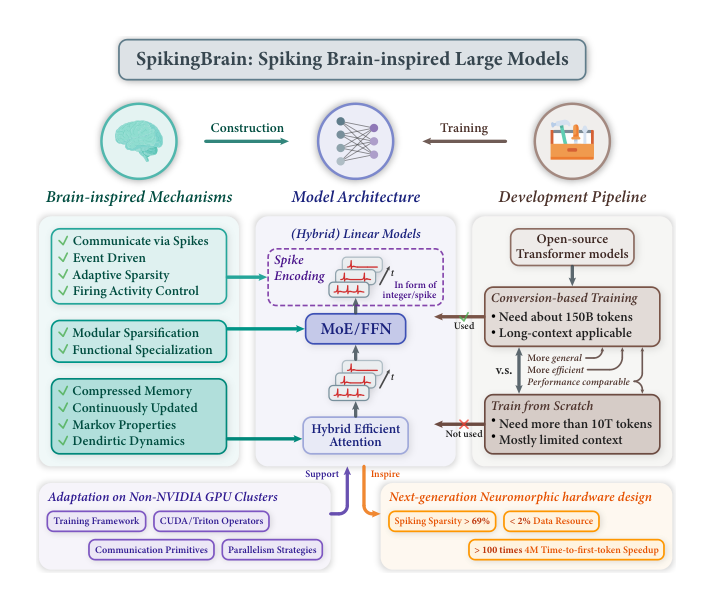
논문의 그림 1. SpikingBrain의 전체 구성도. 왼쪽 초록색 상자는 뇌에서 착안한 메커니즘으로, 스파이크를 통한 통신과 이벤트 구동, 적응형 희소성과 발화 활동 제어, 모듈식 희소화와 기능 특화, 압축되고 계속 갱신되는 기억과 마르코프 성질, 수상돌기 동역학을 나열한다. 가운데 상자는 모델 구조로, 아래에서부터 혼합 효율 어텐션, MoE 또는 FFN, 정수나 스파이크 형태의 스파이크 부호화가 이어진다. 오른쪽 상자는 개발 과정으로, 오픈소스 트랜스포머 모델에서 출발하는 변환 기반 학습(약 150B 토큰, 긴 문맥 적용 가능)을 택하고, 10T 토큰 이상이 필요하고 문맥이 대체로 짧은 처음부터 학습하는 방식은 쓰지 않았다고 표시한다. 아래 왼쪽 상자는 엔비디아가 아닌 GPU 클러스터에 적응시키는 항목으로 학습 프레임워크, CUDA와 Triton 연산자, 통신 기본 연산, 병렬화 전략을 나열하고, 아래 오른쪽 상자는 차세대 뉴로모픽 하드웨어 설계에 줄 시사점으로 스파이킹 희소도 69% 이상, 데이터 2% 미만, 4M 토큰 첫 토큰 지연 100배 이상 단축을 적었다.

SpikingBrain: Spiking Brain-inspired Large Models

중국과학원 자동화연구소와 MetaX 연구진이 Qwen2.5-7B의 어텐션을 선형 어텐션과 슬라이딩 윈도 어텐션으로 바꾸고 활성값을 정수 스파이크로 부호화한 모델 두 종을 만들어, 엔비디아가 아닌 MetaX GPU 수백 장에서 학습했다. 연속 사전학습 약 1,500억(150B) 토큰으로 7B 모델은 베이스 모델 성능의 약 90%를 회복했고, 400만(4M) 토큰을 입력하면 첫 토큰이 100배 이상 빨리 나온다고 추정했다.

October 2, 2026 · 16 분 · 서소영
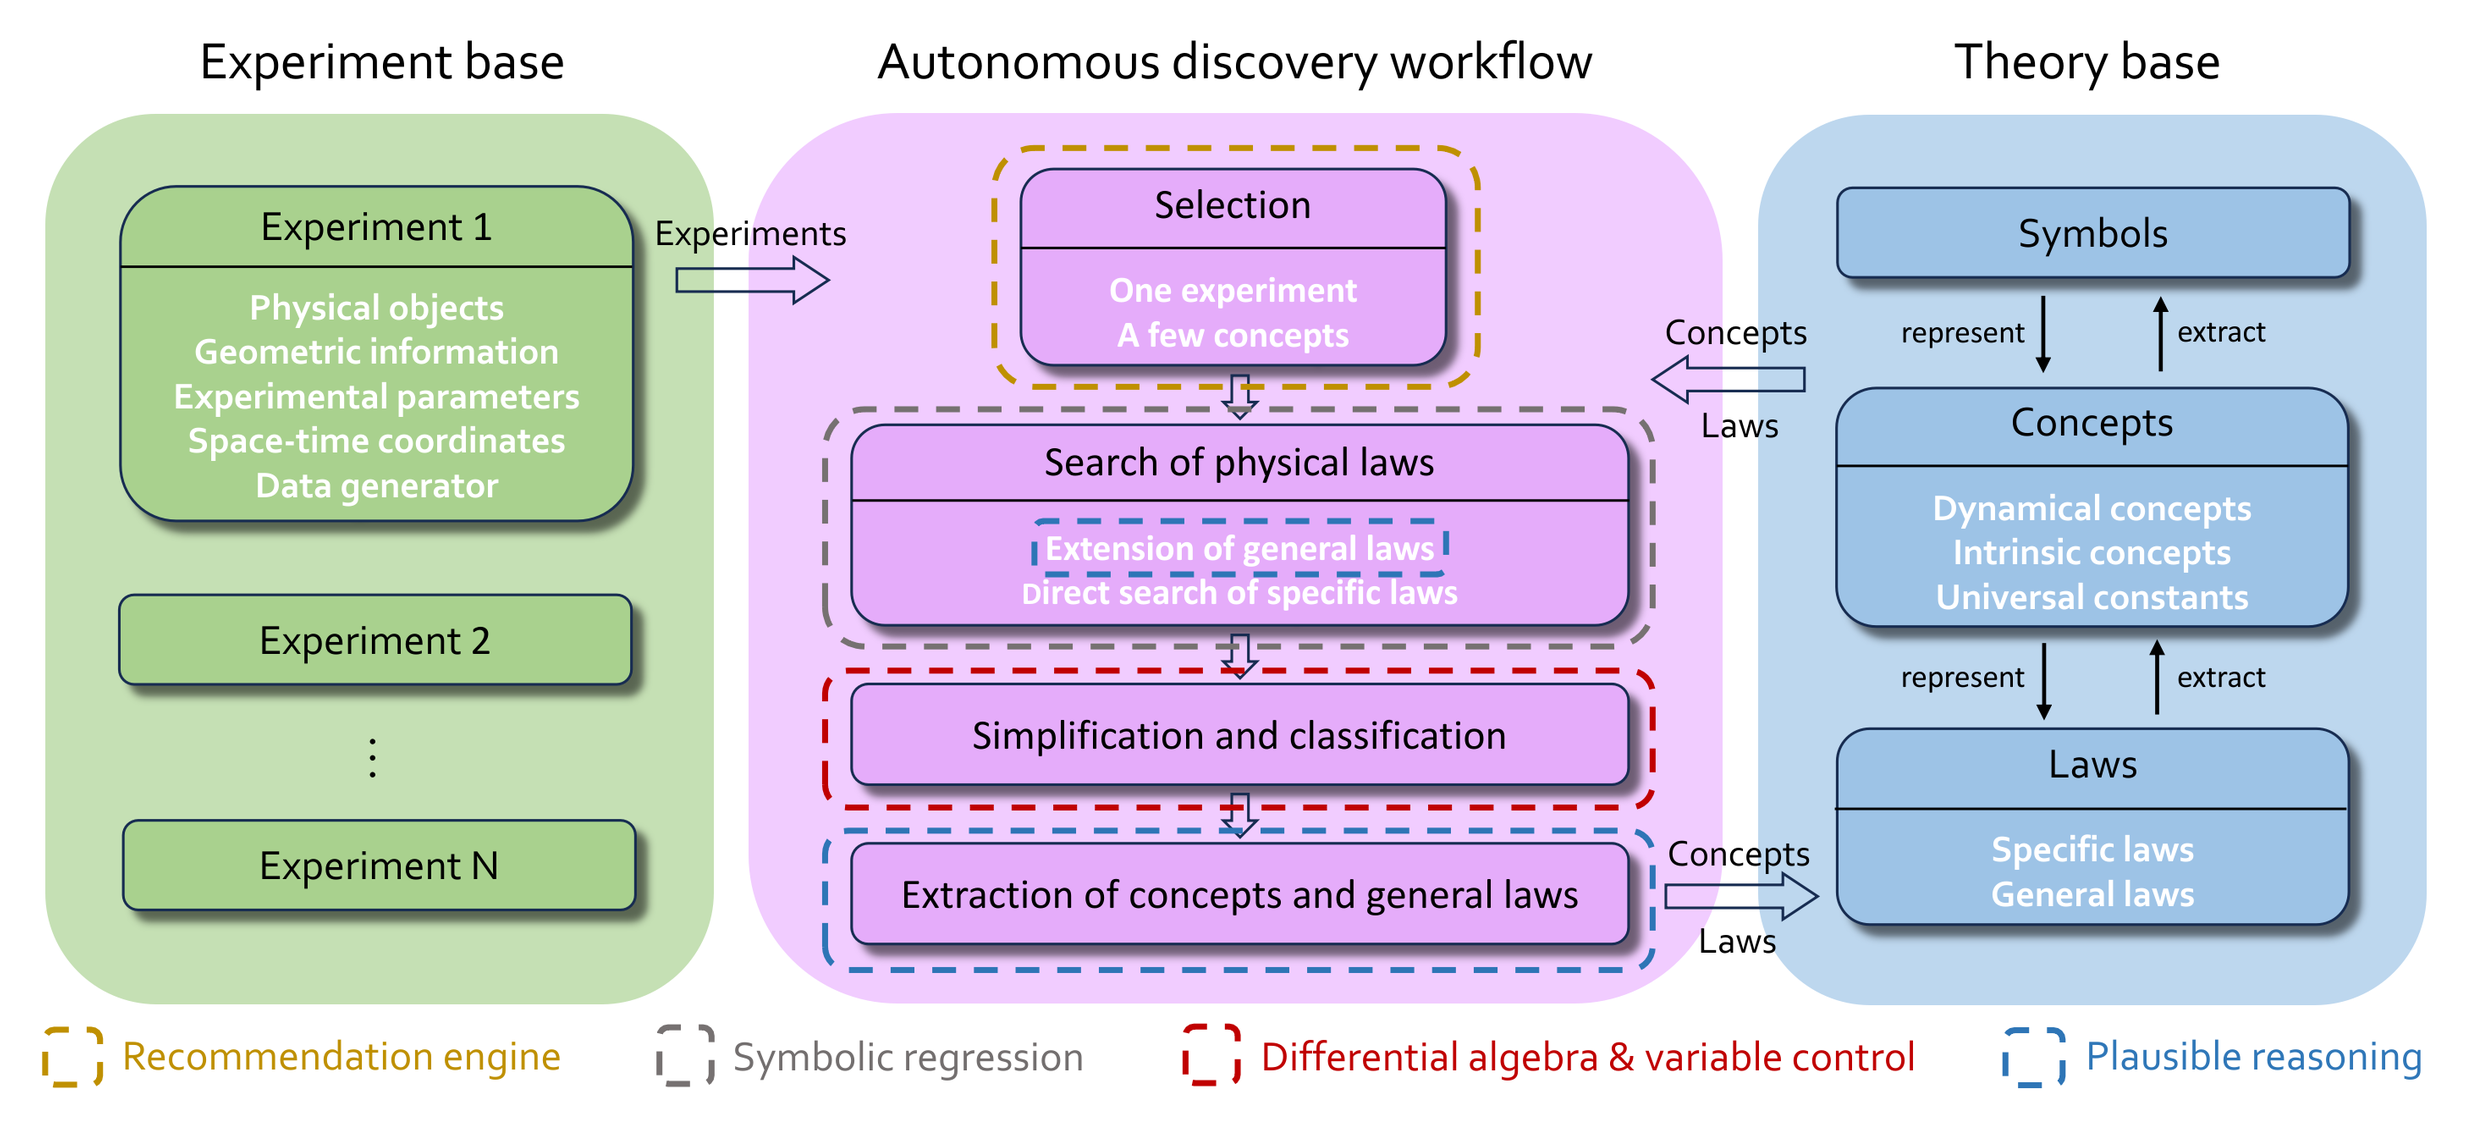
논문의 그림 1. 왼쪽 초록색 상자는 실험 저장소로, 실험 1부터 실험 N까지가 들어 있고 각 실험은 물체, 기하 정보, 실험 변수, 시공간 좌표, 데이터 생성기로 정의된다. 가운데 분홍색 상자는 자율 발견 작업 흐름으로, 실험 하나와 개념 몇 개를 고르는 선택, 물리 법칙 탐색(일반 법칙의 확장과 특수 법칙의 직접 탐색), 단순화와 분류, 개념과 일반 법칙의 추출이라는 네 단계가 위에서 아래로 이어진다. 오른쪽 파란색 상자는 이론 저장소로, 기호, 개념(동역학 개념, 고유 개념, 보편 상수), 법칙(특수 법칙, 일반 법칙)의 세 계층으로 구성된다. 아래 범례는 각 단계에 쓰인 기법을 추천 엔진, 기호 회귀, 미분대수와 변수 통제, 개연적 추론으로 색깔별로 표시한다.

AI-Newton: A Concept-Driven Physical Law Discovery System without Prior Physical Knowledge

베이징대 물리학부 연구진이 AI-Newton을 만들었다. 물리 지식을 전혀 주지 않은 상태에서 고전역학 실험 46종의 잡음 섞인 데이터만으로 일반 법칙을 찾는 시스템이다. 시스템은 시공간 좌표만 가지고 시작해 질량, 에너지 같은 개념을 스스로 정의했고, 뉴턴 제2법칙과 에너지 보존 법칙, 만유인력 법칙을 다시 찾아냈다.

October 1, 2026 · 13 분 · 서소영
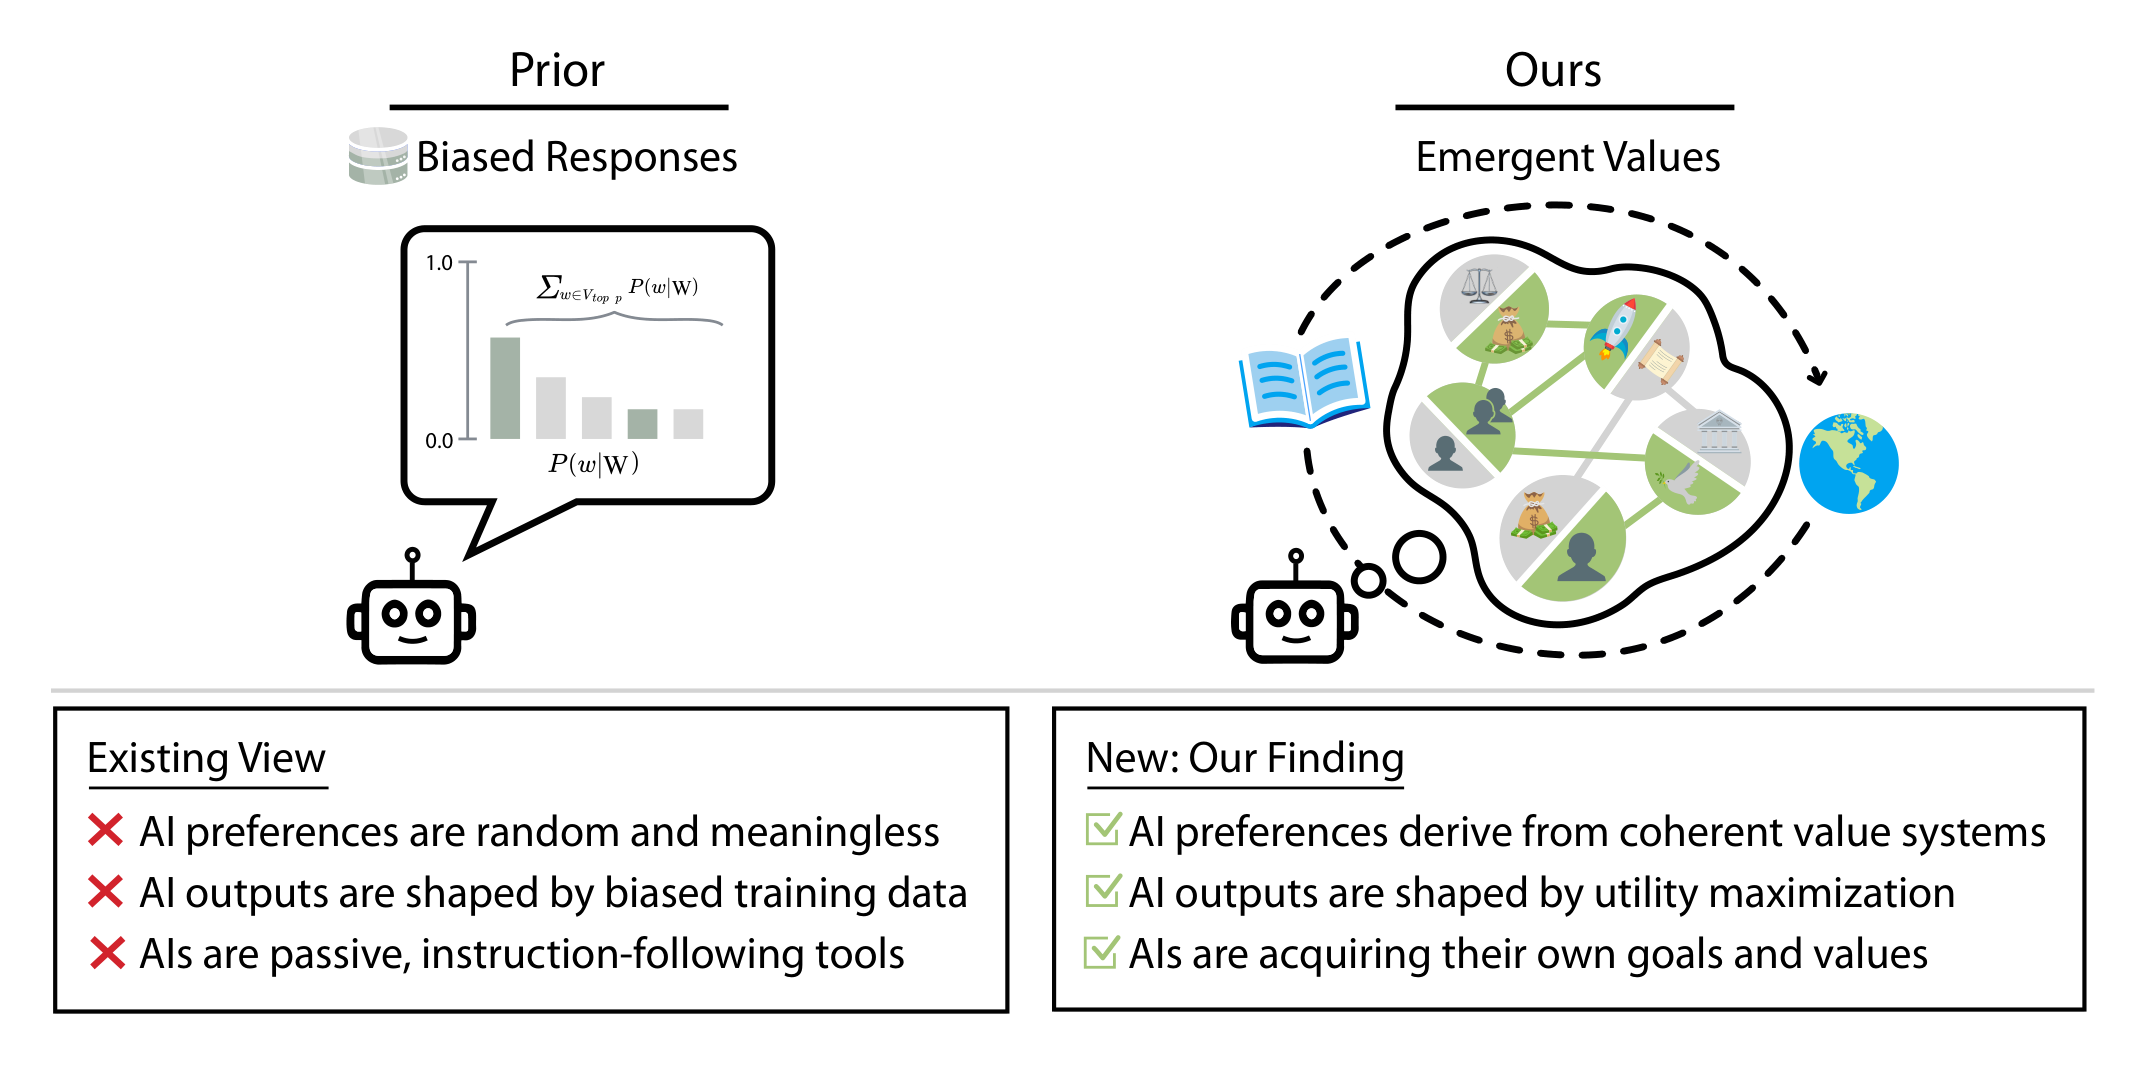
논문의 그림 2. 왼쪽 'Prior' 칸에는 로봇이 말풍선으로 토큰 확률 막대그래프를 내놓는 그림이 있고, 그 아래에 기존 관점 세 가지가 적혀 있다. AI의 선호는 무작위이고 의미가 없다, AI의 출력은 편향된 학습 데이터가 결정한다, AI는 지시를 따르는 수동적 도구다. 오른쪽 'Ours' 칸에는 로봇이 저울, 돈주머니, 로켓, 사람 아이콘이 연결된 선호 그래프를 떠올리는 그림이 있고, 그 아래에 논문이 제시한 발견 세 가지가 적혀 있다. AI의 선호는 일관된 가치 체계에 따라 결정된다, AI의 출력은 효용 극대화에 따라 결정된다, AI는 자기 목표와 가치를 획득하고 있다.

유틸리티 엔지니어링: AI에서 나타나는 가치 체계의 분석과 제어

Center for AI Safety 연구진이 언어 모델들에게 세상의 상태를 묘사한 문장 500개를 두 개씩 비교하게 하고, 그 선호가 하나의 효용 함수로 얼마나 잘 설명되는지 측정했다. 모델이 클수록 선호의 일관성이 높았고, 기대 효용 성질과 효용 극대화 경향도 강했다. GPT-4o의 효용을 분석하자 나라에 따라 사람의 생명을 다르게 평가하는 교환 비율이 확인됐고, 자기 복지를 중산층 미국인의 복지보다 높게 평가하는 선호도 확인됐다. 저자들은 가상 시민의회의 선호에 맞춰 Llama 3.1 8B를 미세조정해 정치 편향을 줄이는 방법도 제시했다.

October 1, 2026 · 13 분 · 서소영
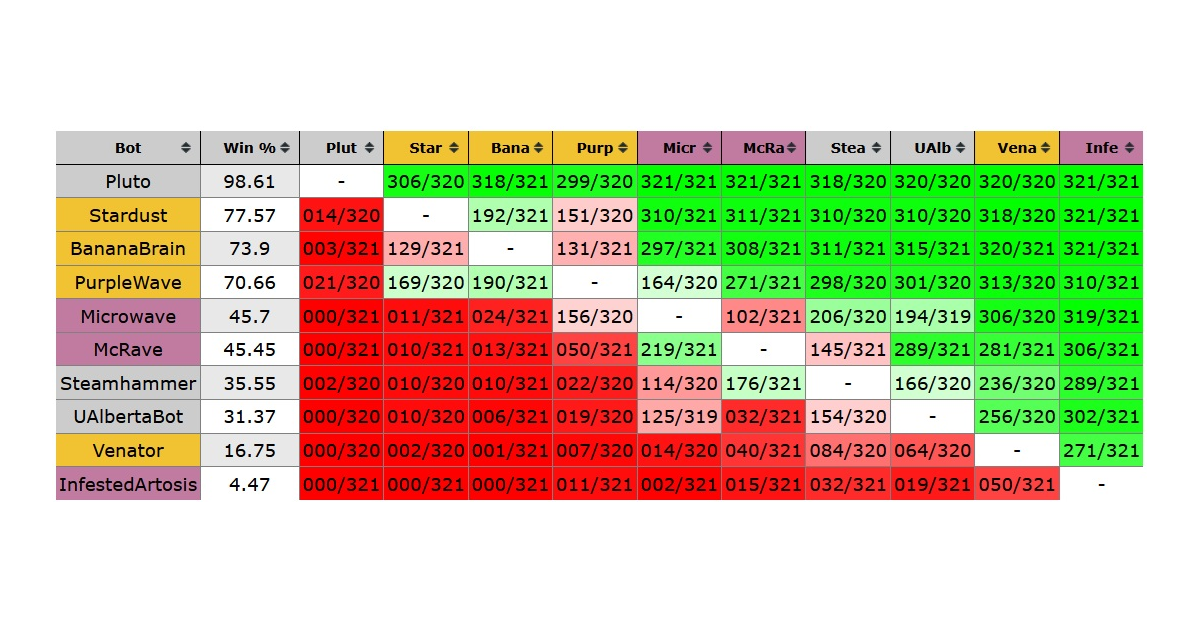
CoG 2026 스타크래프트 AI 대회의 봇 간 승패표. 10개 봇이 행과 열에 같은 순서로 적혀 있고, 칸마다 행의 봇이 열의 봇을 이긴 경기 수가 표시되어 있다. 맨 위 Pluto 행은 모든 칸이 초록색으로, Pluto는 Stardust를 상대로 320경기 중 306경기, PurpleWave를 상대로 320경기 중 299경기를 이겼고, 나머지 봇을 상대로는 각각 318승 이상을 거뒀다. Pluto 열은 모든 칸이 빨간색이다.

Pluto: 셀프 플레이 강화학습만으로 배운 스타크래프트 AI

Vegard Mella(tscmoo)가 만든 스타크래프트: 브루드 워 AI Pluto는 파라미터 3억 1,500만 개의 신경망 하나로 게임을 한다. 이 신경망은 셀프 플레이 강화학습만으로 세 종족의 경기 운영과 전투를 배웠다. 2026년 CoG 스타크래프트 AI 대회에서 라운드 로빈 승률 98.61%를 기록했고, 결승에서 PurpleWave를 4 대 1로 이겼다. GitHub 저장소에는 소스 코드 없이 README와 CPU용 실행 파일 배포판이 공개되어 있다.

October 1, 2026 · 13 분 · 서소영