타이베이 101을 배경으로 한 TAIPEI RUSH의 시작 화면. 게임동아 기사에 실린 게임 화면

타이베이판 GTA는 어떻게 만들어졌나

게임 개발과 무관한 분야에서 일하는 엔지니어가 퇴근 후 한 달 동안 타이베이판 GTA를 만들었다. 대만을 게임으로 만든 이유와 AI를 활용한 제작 과정, 비슷한 브라우저 게임 세 가지를 소개한다.
October 8, 2026 · 6 분 · 서소영
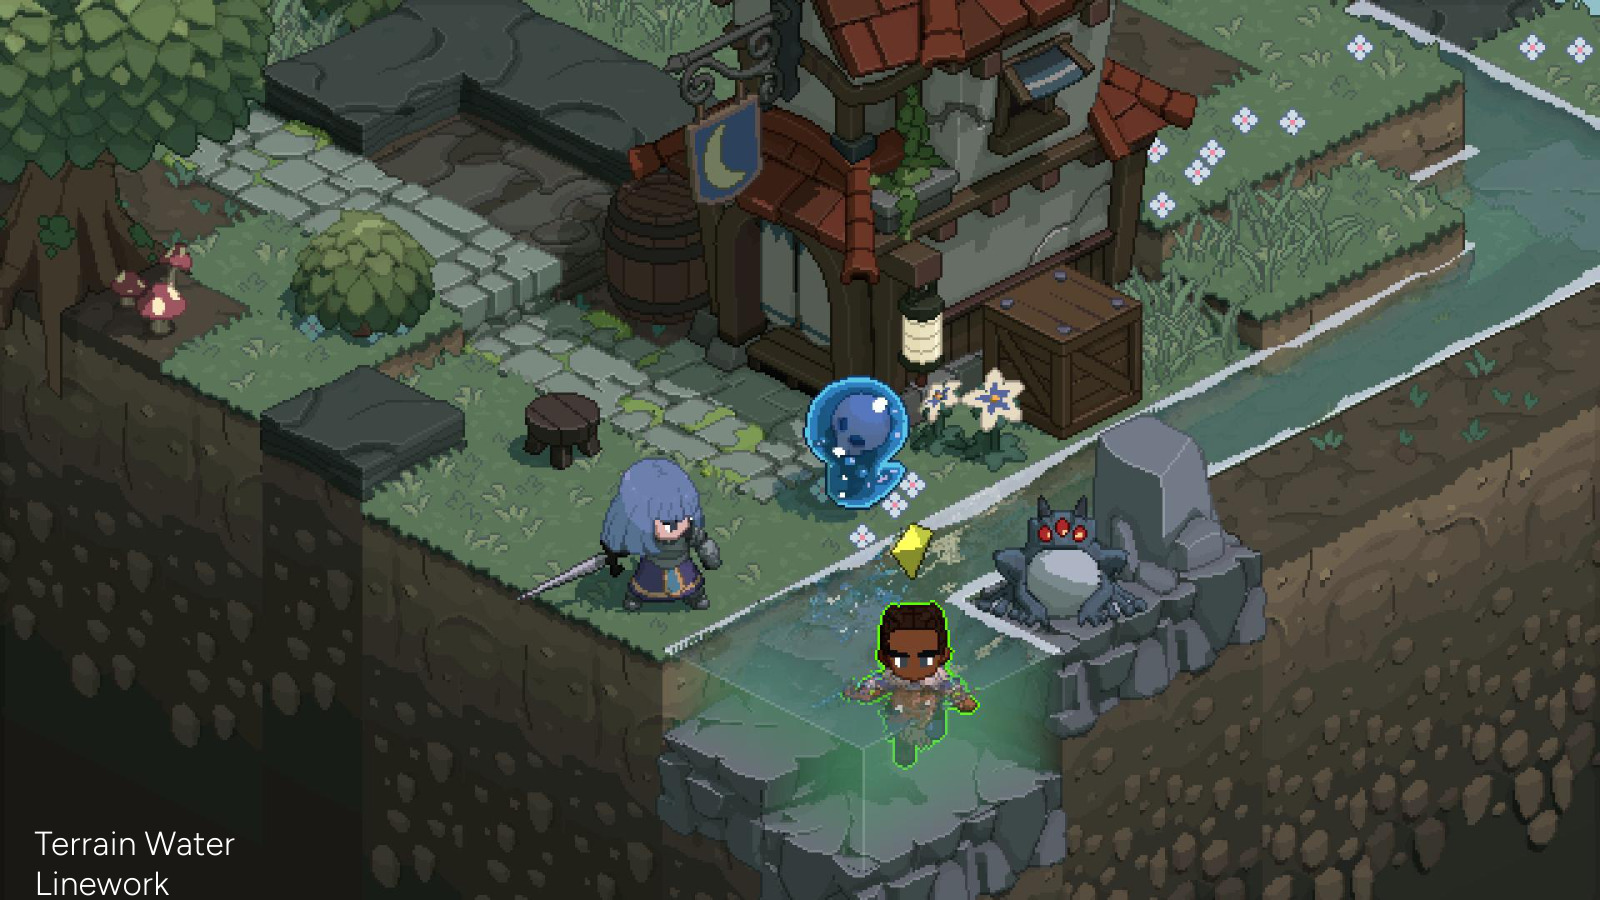
Never’s End 발표 PDF 19쪽. 건물과 절벽, 캐릭터, 물을 픽셀 아트로 표현한 3D 장면

How We Draw a 3D Sprite World: The Stylized Art of Never’s End

GDC 2026에서 라이언 주켓이 공개한 Never’s End의 렌더링 기법. 선과 음영, 카메라와 관절의 픽셀 정렬, 겹침 순서 알고리즘, 구름과 애니메이션까지 3D 장면을 손으로 그린 스프라이트처럼 표현하는 과정을 정리했다.
October 8, 2026 · 15 분 · 서소영
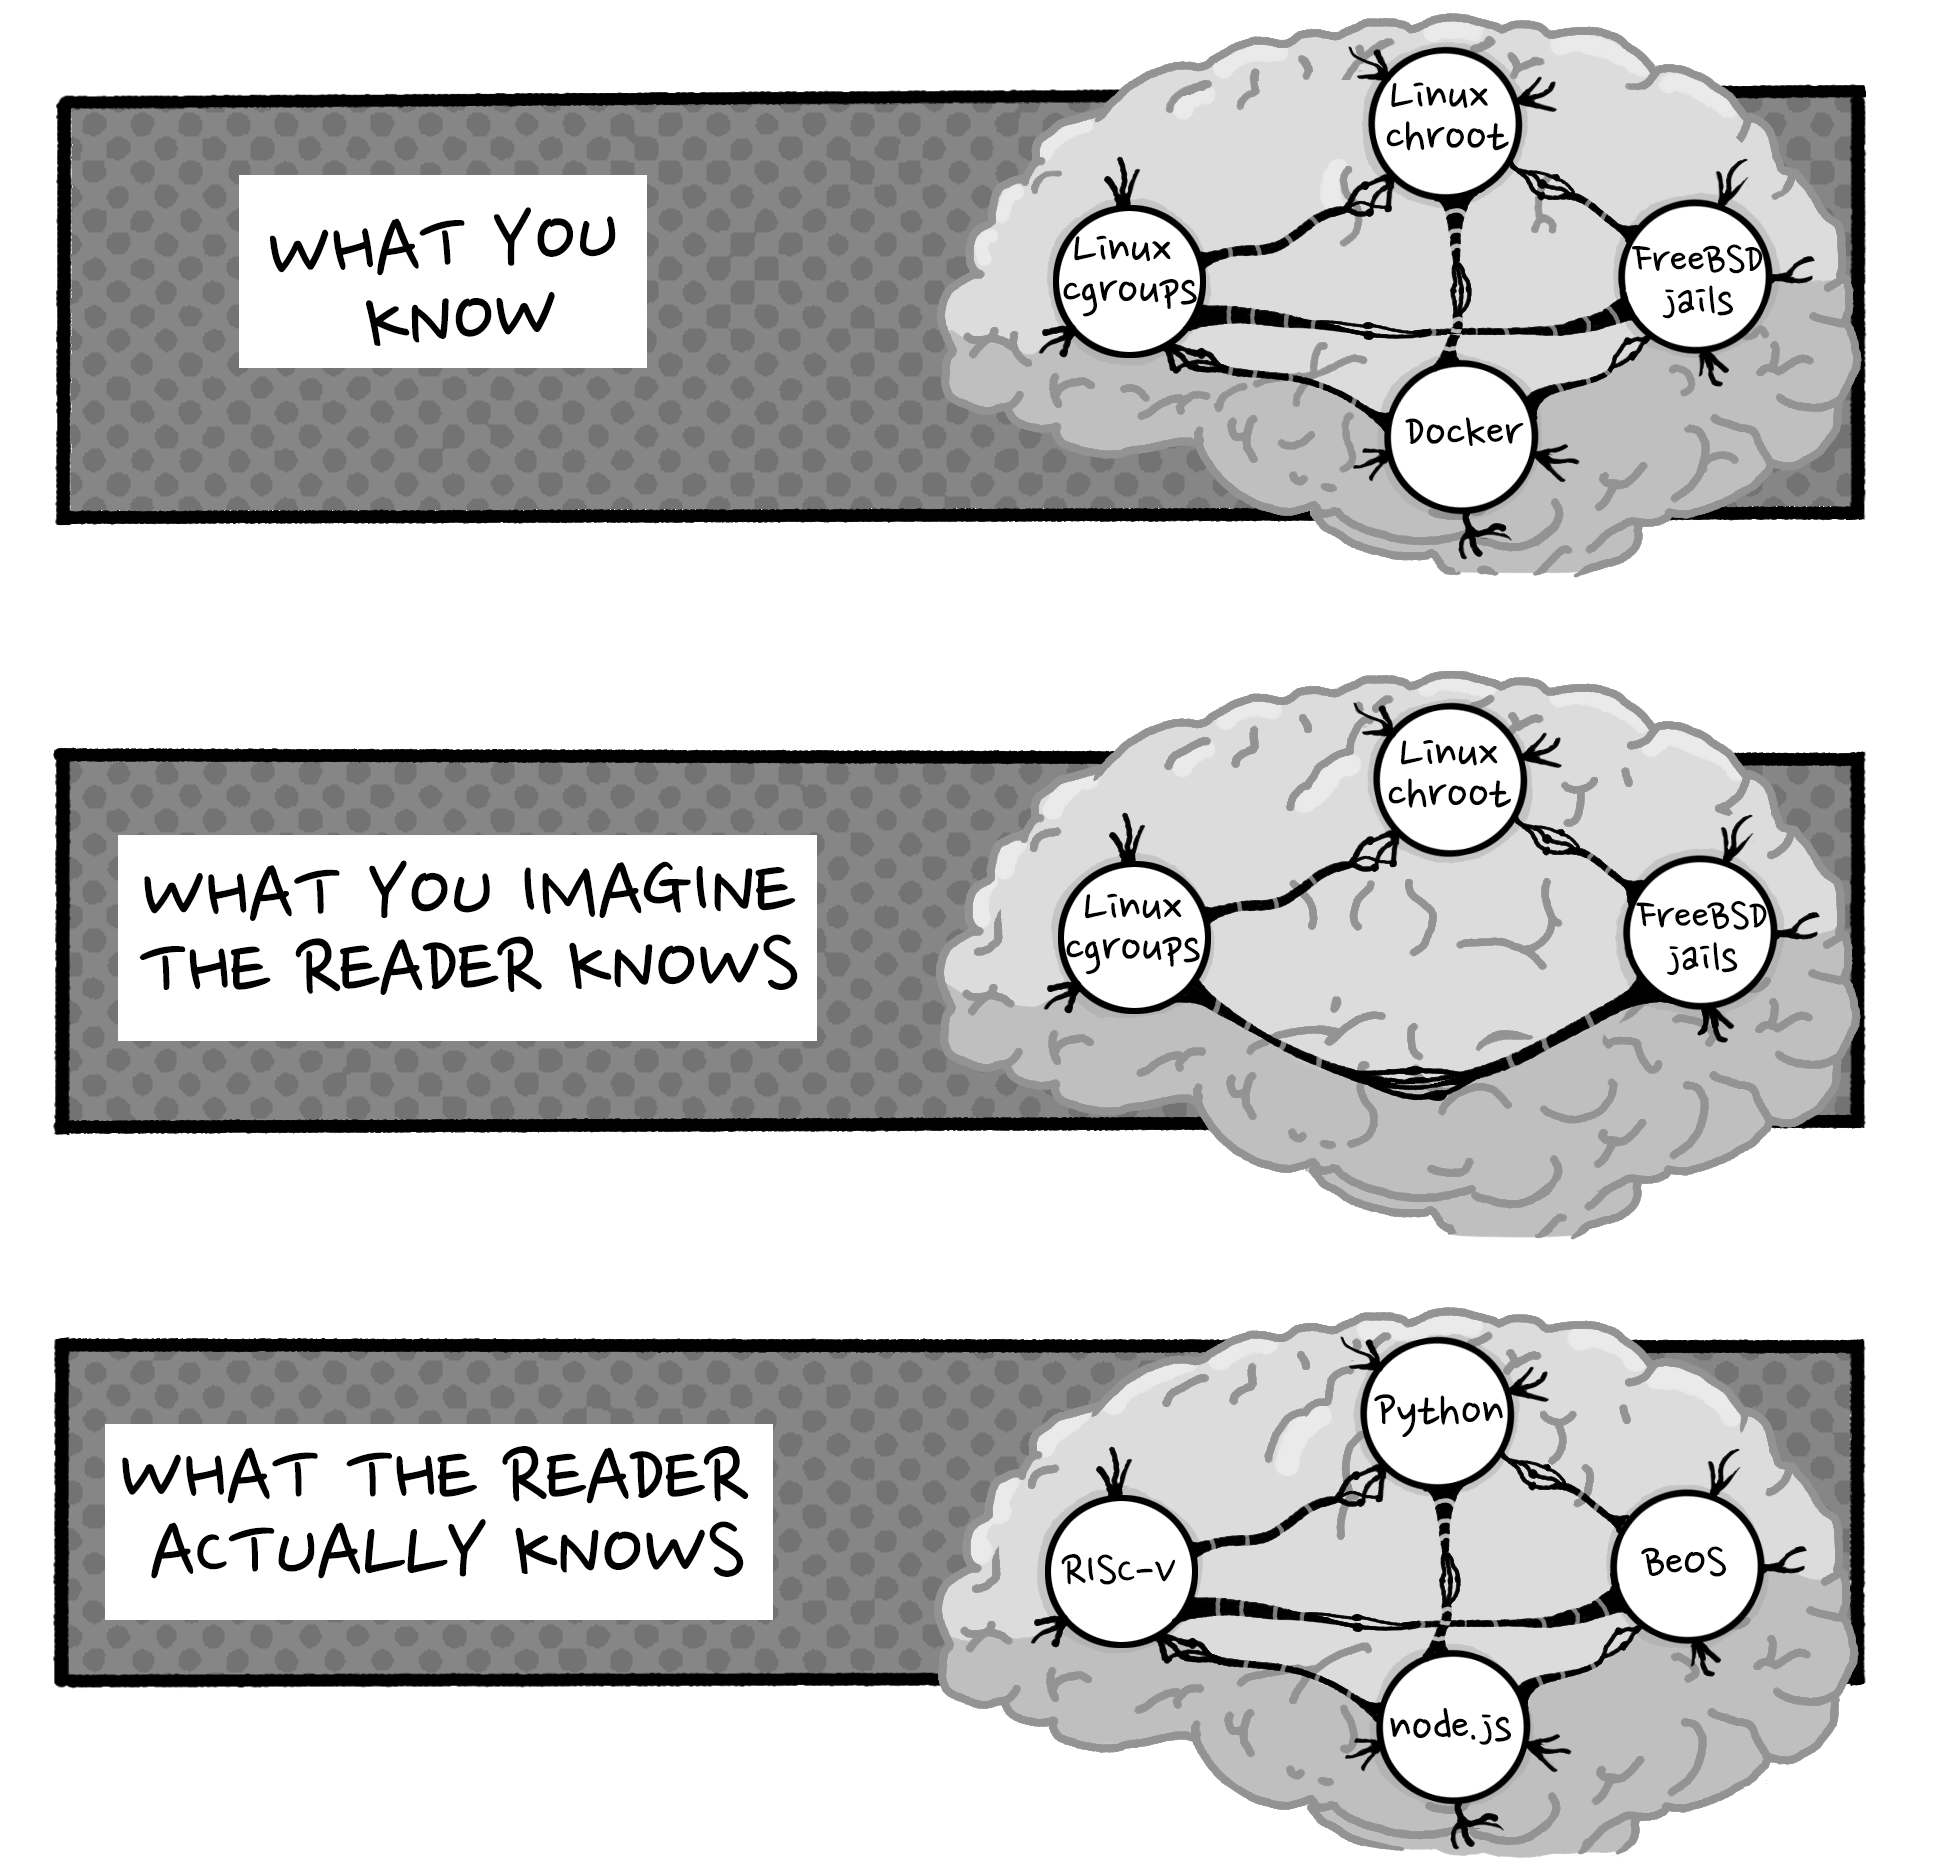
필자의 추측과 독자의 실제 배경지식을 비교한 원문 삽화

Anti-Patterns in Software Blogging

Michael Lynch가 기술 블로그를 처음 쓰는 개발자들이 반복하는 실수를 정리했다. 읽을 이유를 늦게 밝히는 도입부, 독자의 지식을 과대평가하는 설명, 링크와 전편에 대한 의존, 과도한 격식과 읽기 불편한 화면을 사례로 설명한다.
October 8, 2026 · 6 분 · 서소영
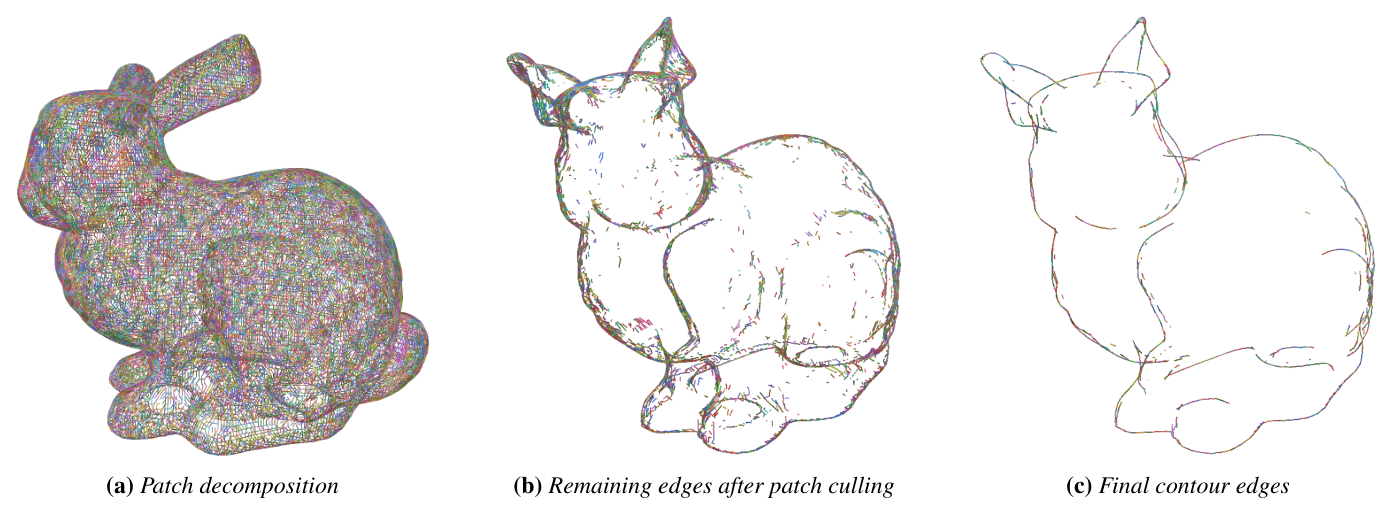
논문 Figure 1. Stanford Bunny의 패치 구성, 패치 검사 후 남은 모서리, 최종 윤곽선 모서리를 왼쪽부터 비교한다.

Patch Decomposition for Efficient Mesh Contours Extraction

메쉬 모서리를 윤곽선 추출에 맞춘 패치로 구성하고, 윤곽선이 없는 패치를 먼저 제외한다. 계층 없는 가속 구조로 GPU 추출 속도를 최대 5.3배 높였으며, 전처리 비용과 비강체 애니메이션의 제약도 보고했다.
October 7, 2026 · 5 분 · 서소영
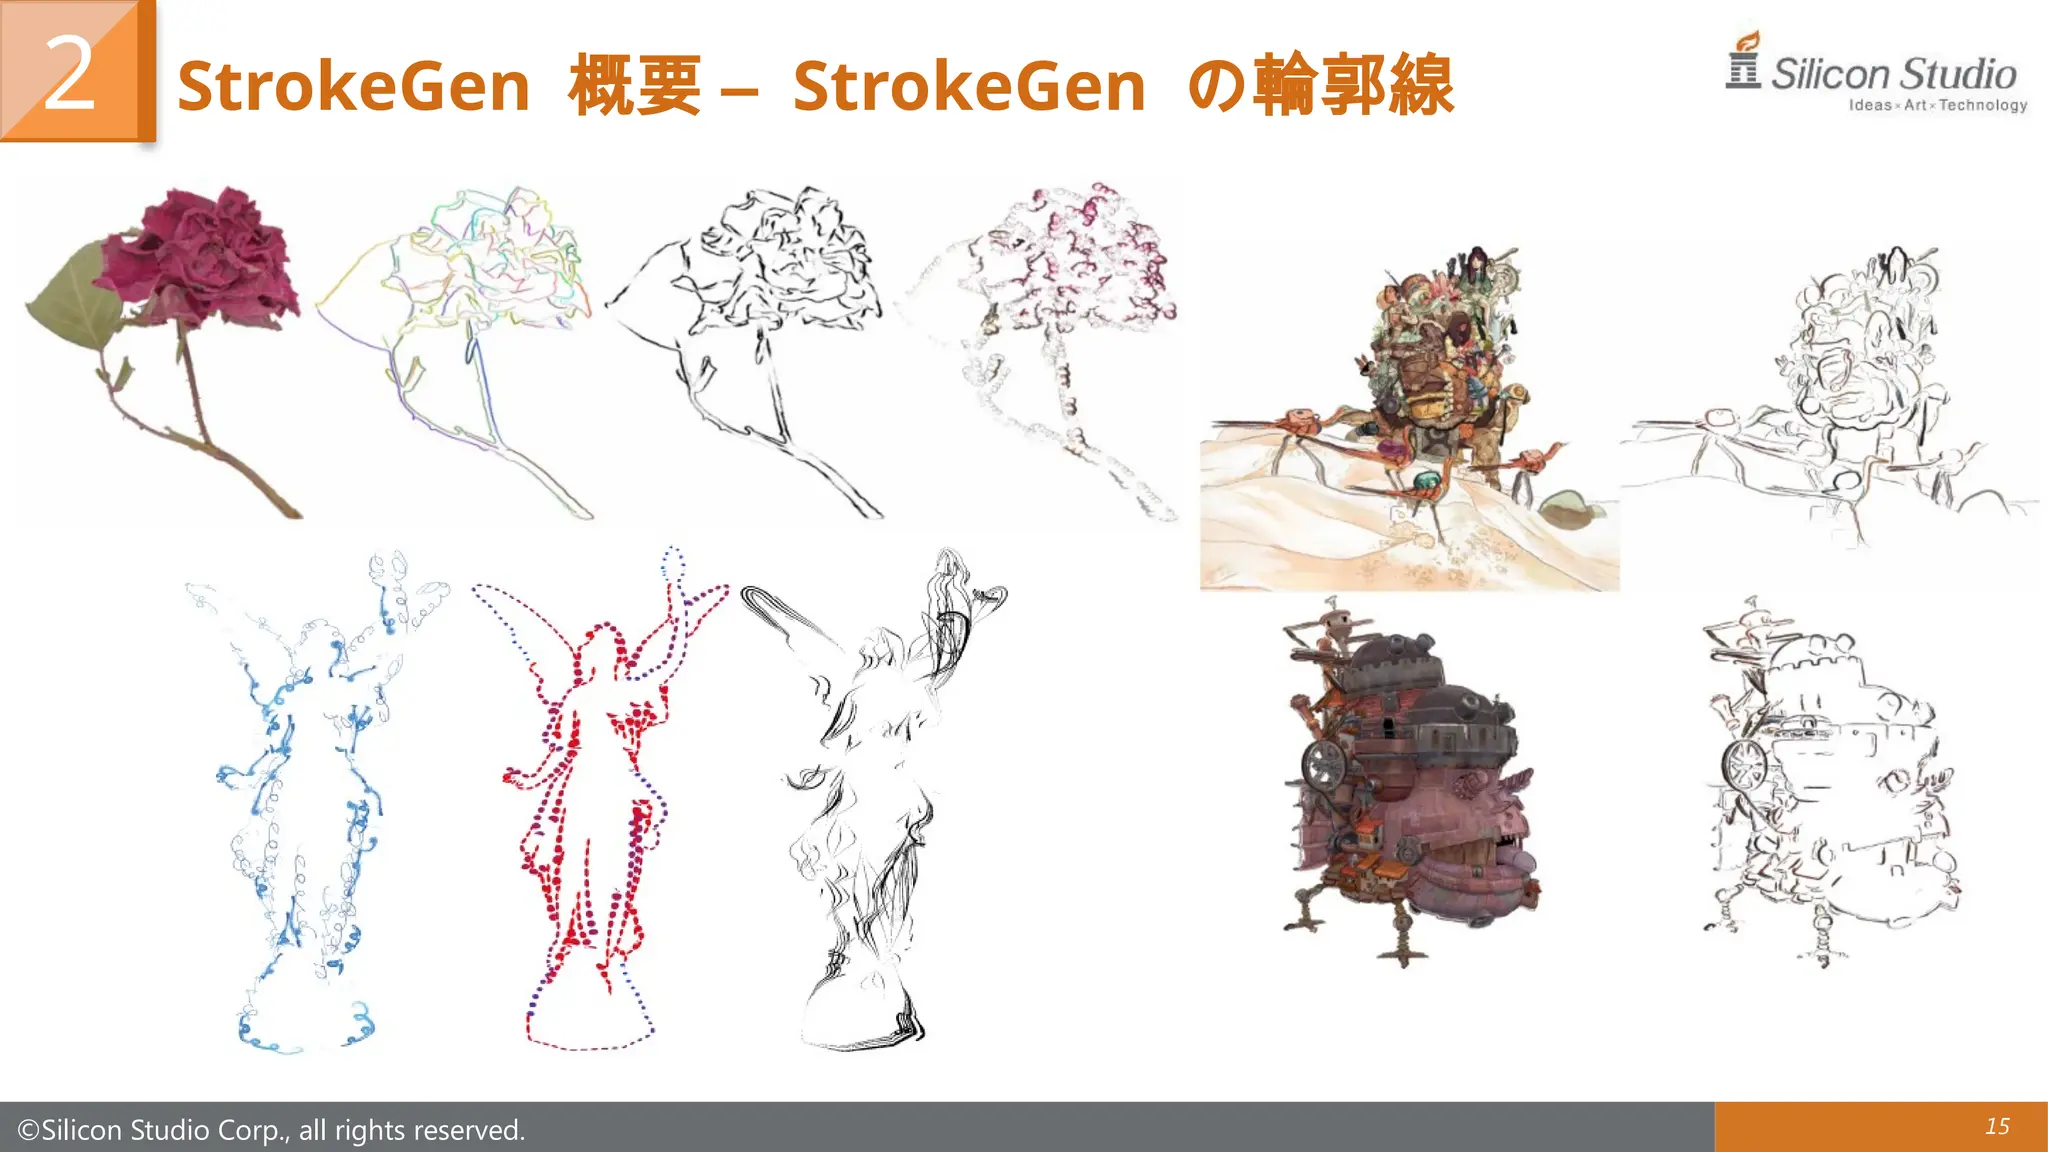
StrokeGen으로 생성한 윤곽선과 벡터 스트로크를 보여 주는 CEDEC 2024 발표 슬라이드. © Silicon Studio Corp.

次世代 NPR の輪郭線表現に迫る!リアルタイムベクトルストローク生成手法 StrokeGen を徹底解剖

StrokeGen은 GPU에서 3D 메쉬의 윤곽선을 연속된 점열로 생성해 선폭, 브러시와 움직임에 따른 표현을 조절한다. CEDEC 2024 발표는 알고리즘과 Unity 확장 구현을 설명하고, 실용화의 핵심 과제로 프레임 사이의 안정성을 제시한다.
October 7, 2026 · 5 분 · 서소영
중년게이머 김실장과 레드브릭하우스 관계자 세 사람. 영상 썸네일에 한국에서 인디게임으로 성공할 수 있을까라는 문구가 있다.

한국에서 인디게임으로 성공할 수 있을까? [레드브릭하우스 초대석]

레드브릭하우스의 김혁진, 홍지철, 이민정이 인디 개발팀의 다음 작품까지 함께하는 퍼블리싱을 이야기한다. 개발 환경과 자금 관리, 해외 커뮤니티 운영, 스팀 홍보, 창업 초기의 의사결정 구조를 실제 사례로 설명한다.
October 7, 2026 · 7 분 · 서소영
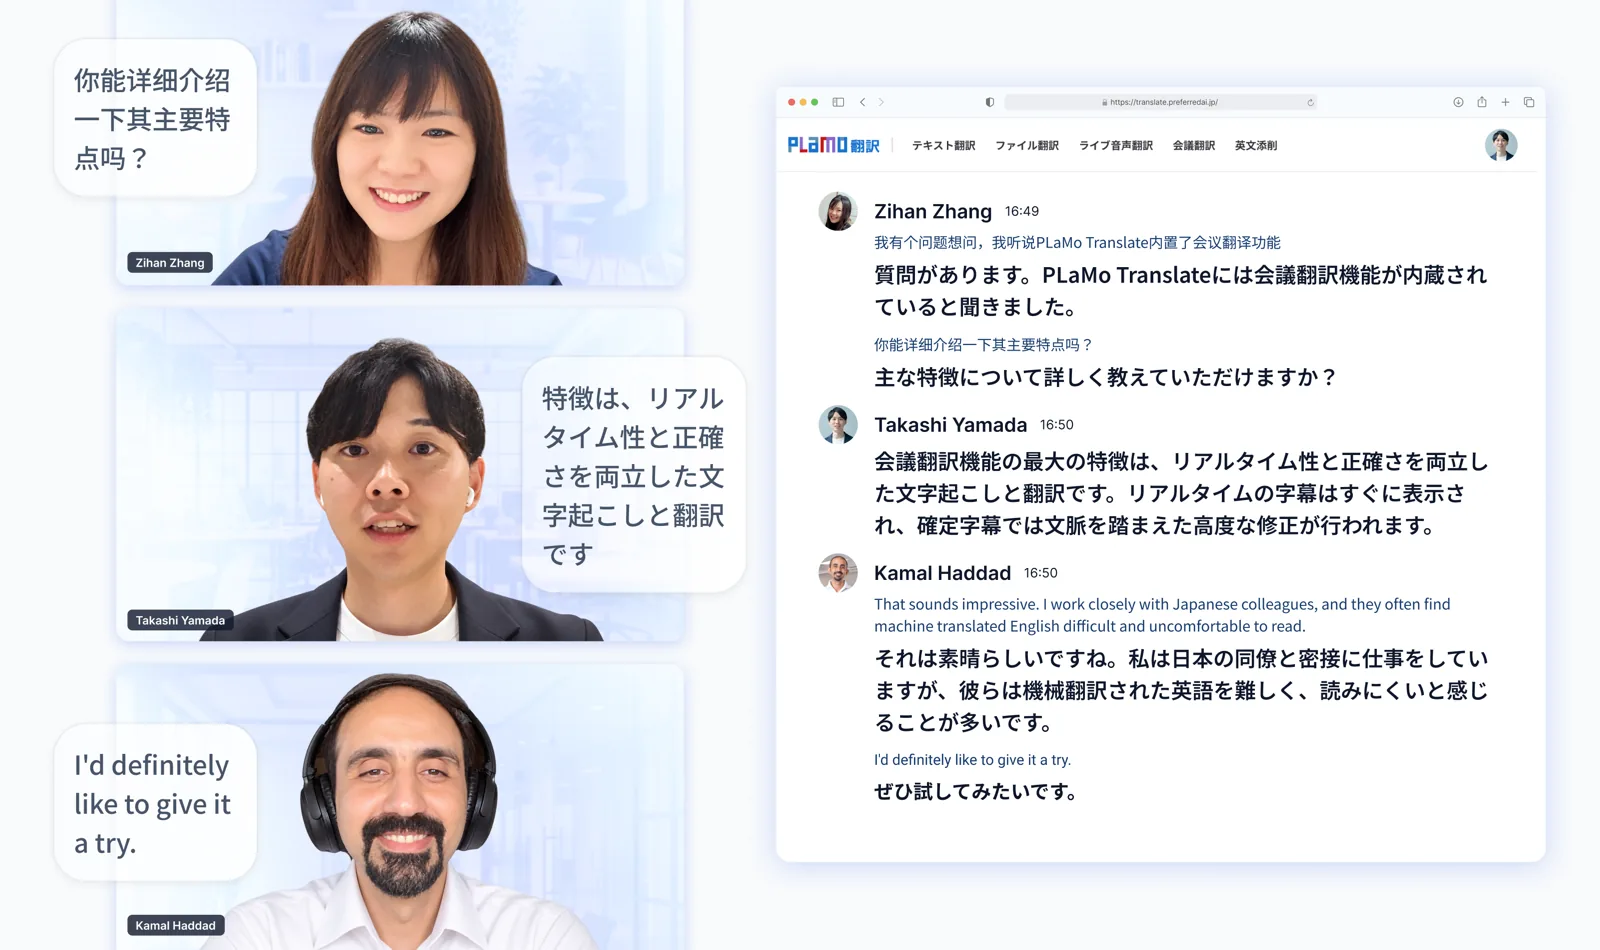
Preferred Networks가 공개한 회의 번역 소개 이미지. 왼쪽에는 세 참가자, 오른쪽에는 발언 원문과 일본어 번역이 표시된다.

PLaMo翻訳 | 世界最高レベルの日本語性能のAI翻訳サービス

Preferred Networks가 PLaMo 번역을 3세대 모델로 갱신했다. 텍스트 번역은 53개 언어, 회의 번역은 15개 언어를 지원하고, 자체 평가에서 주요 번역 모델과 비슷한 품질을 훨씬 적은 계산 비용으로 구현했다고 발표했다.
October 7, 2026 · 4 분 · 서소영
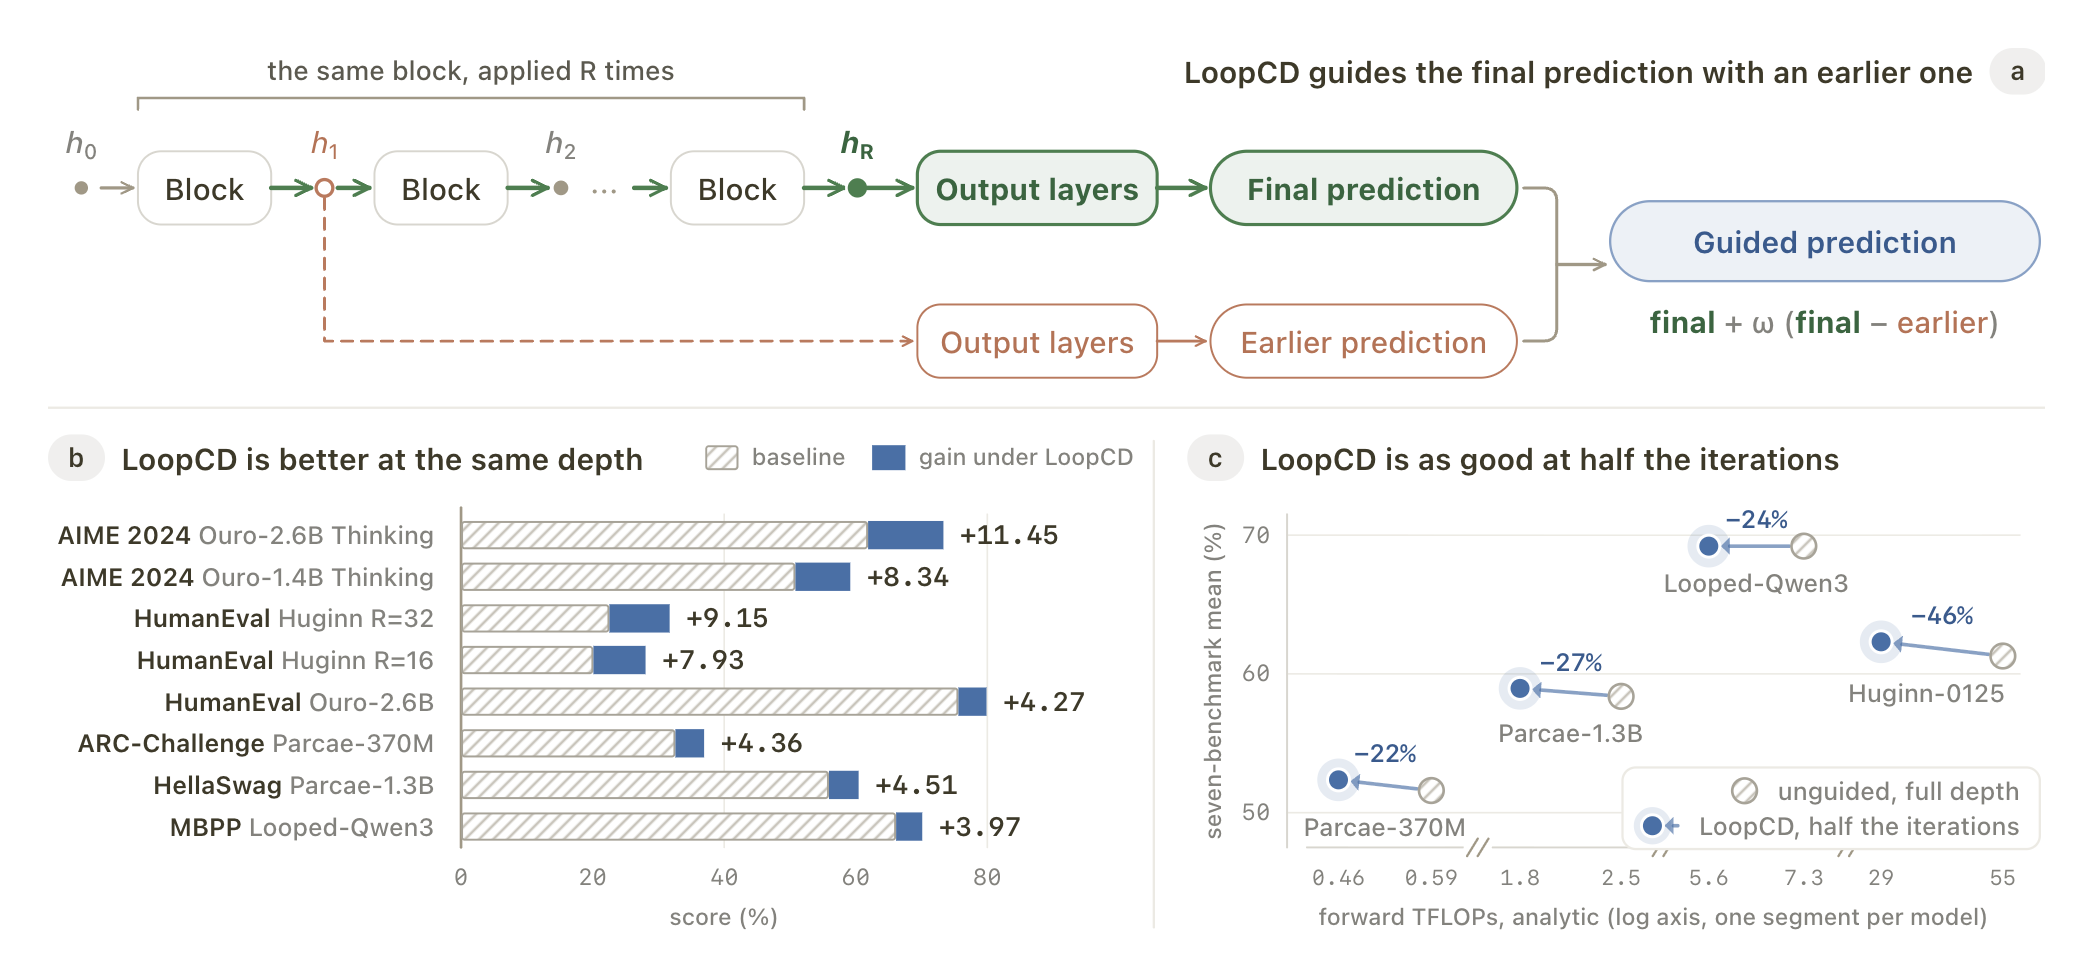
LoopCD 개요 그림. 위는 같은 블록을 R번 반복한 뒤 첫 번째 반복의 상태도 출력층에 통과시켜 최종 예측과 대조하는 구조다. 아래 왼쪽은 같은 반복 깊이에서 여덟 가지 모델과 벤치마크 조합의 점수 상승폭이고, 아래 오른쪽은 반복을 절반으로 줄였을 때의 정확도와 연산량이다.

Decoding Looped Transformers Better for (Almost) Free

Apple 연구진은 루프 트랜스포머의 첫 번째 반복이 내놓는 약한 예측을 마지막 반복의 예측과 대조해 다음 토큰을 고르는 LoopCD를 제안했다. 추가 학습 없이 Ouro-2.6B-Thinking의 AIME 2024 pass@1이 61.88%에서 73.33%로 올랐다. 반복 횟수를 절반으로 줄여도 기준 성능은 유지됐고, 순방향 연산량의 절감폭은 설정에 따라 22.5%에서 48.2%였다.
October 6, 2026 · 11 분 · 서소영
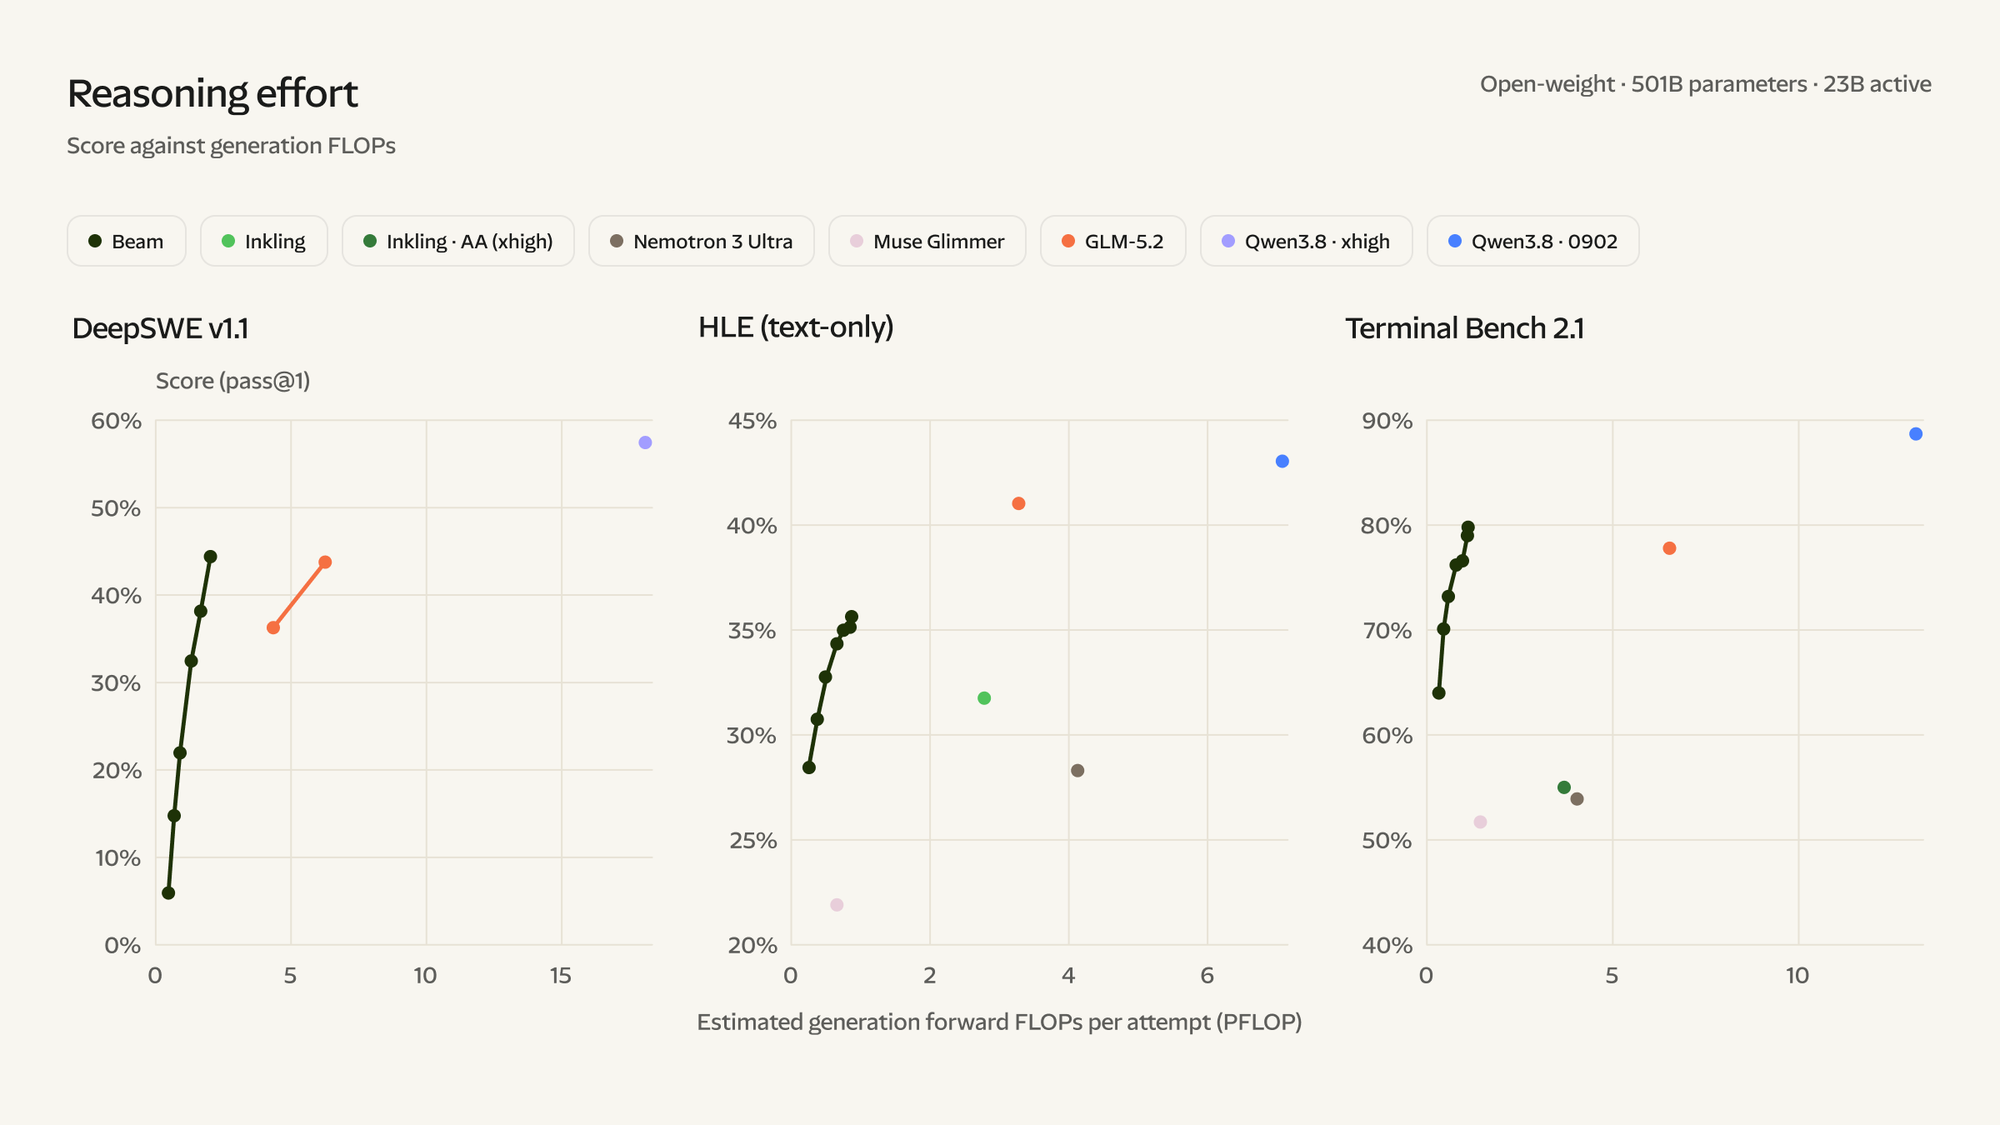
DeepSWE v1.1, HLE, Terminal Bench 2.1의 점수를 문제 한 번당 생성 연산량 추정치(PFLOP)에 대해 그린 그래프 세 개. Beam의 진한 녹색 선은 세 그래프 모두 2 PFLOP 이하에 있고, GLM-5.2(주황)와 Qwen3.8(파랑, 보라)은 3에서 18 PFLOP을 써서 비슷하거나 높은 점수를 낸다.

Introducing Beam: Reflection’s 501B open-weight model

Reflection AI가 첫 오픈웨이트 모델 Beam을 발표했다. 파라미터 5,010억 개 중 230억 개만 활성화하는 MoE 모델이다. 코딩과 에이전트 성능은 GLM 5.2와 비슷하고, 비슷한 점수를 내는 데 드는 연산은 3배에서 4배 적다고 한다. 가중치는 10월 중 Apache 2.0 라이선스로 공개할 예정이다.
October 6, 2026 · 16 분 · 서소영
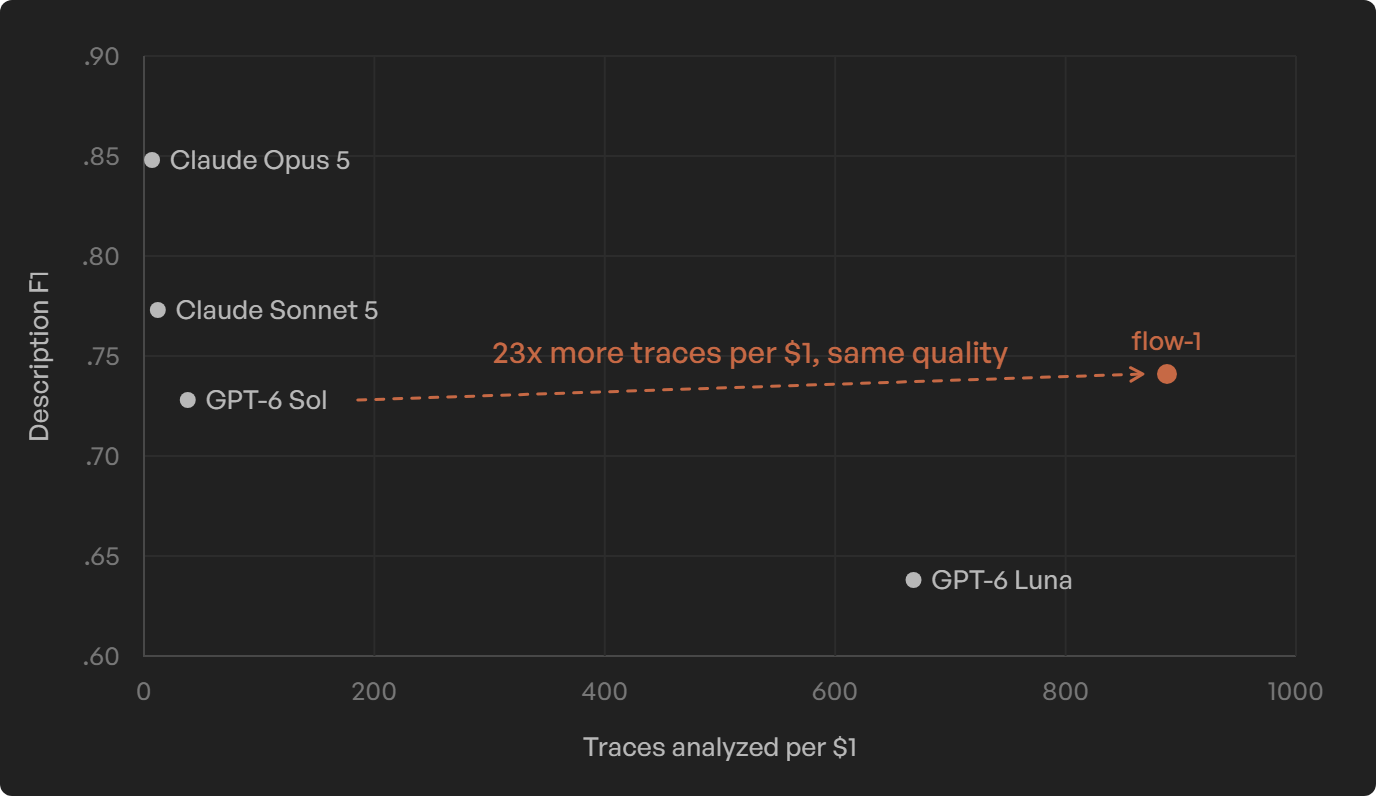
가로축은 1달러로 분석할 수 있는 트레이스 수, 세로축은 Description F1인 산점도. Claude Opus 5(.848, 7건), Claude Sonnet 5(.773, 12건), GPT-6 Sol(.728, 38건)은 그래프 왼쪽 끝에 모여 있고, GPT-6 Luna(.638, 668건)와 flow-1(.741, 888건)은 오른쪽에 있다. Sol에서 flow-1로 향하는 화살표에 같은 품질로 1달러당 23배 많은 트레이스를 분석한다는 설명이 붙어 있다.

flow-1: Frontier trace intelligence at 1/20th of the cost

AI 에이전트 관측 플랫폼 Laminar가 에이전트 트레이스에서 실패를 찾아 원인을 설명하도록 강화학습으로 훈련한 모델 flow-1을 공개했다. 트레이스 523개로 구성한 벤치마크에서 flow-1의 실패 탐지 F1은 0.835로 GPT-6-sol(0.816)보다 높았고, 1달러로 sol보다 23배 많은 트레이스를 분석한다.

October 6, 2026 · 8 분 · 서소영