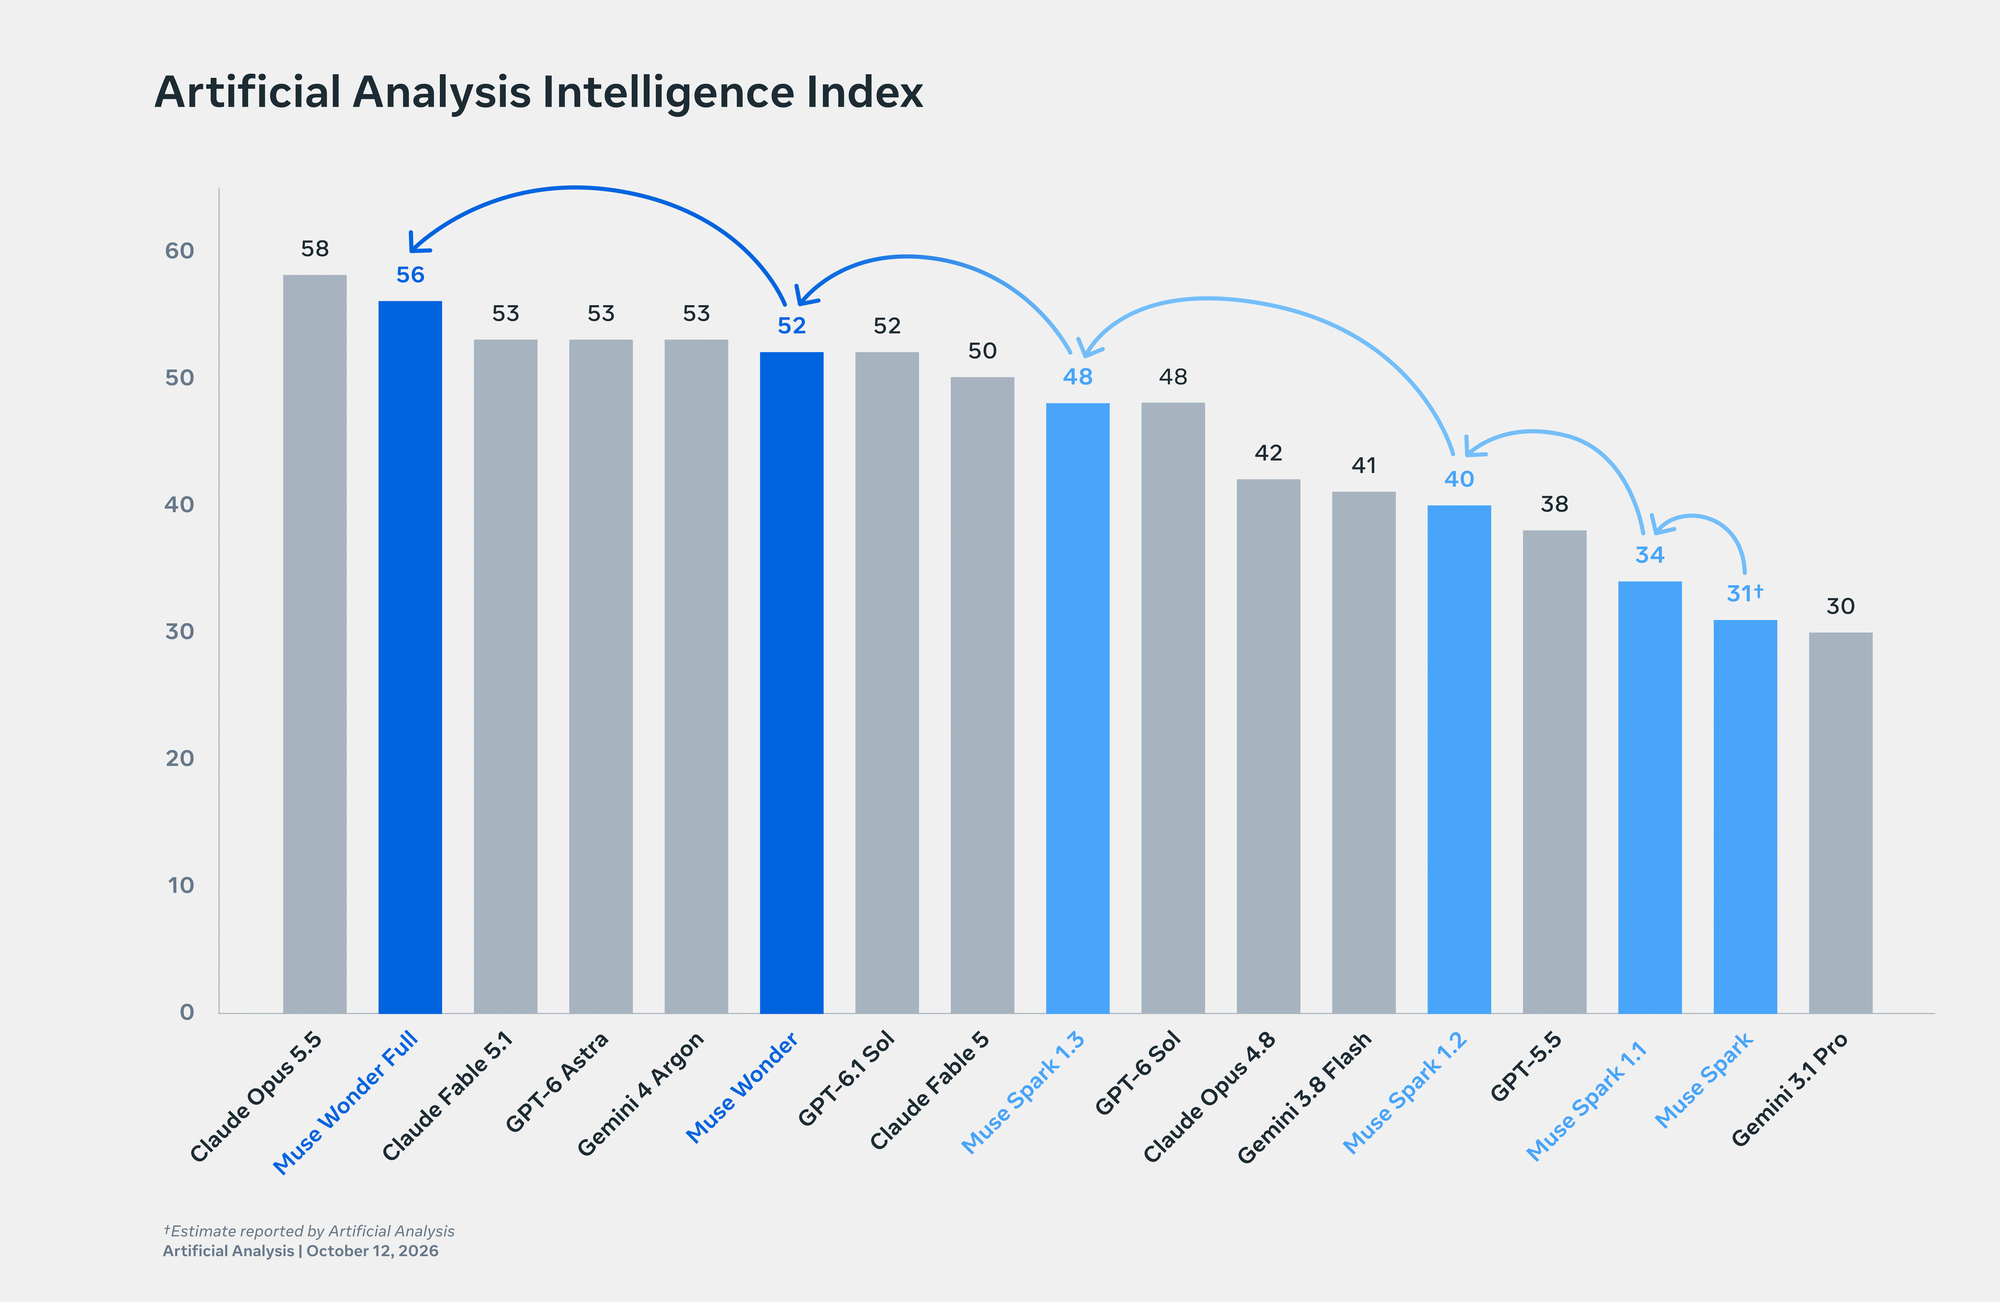
Artificial Analysis Intelligence Index 막대 그래프. Claude Opus 5.5가 58점으로 가장 높고 Muse Wonder Full이 56점으로 두 번째다. Muse Spark 31점, Muse Spark 1.1 34점, 1.2 40점, 1.3 48점, Muse Wonder 52점, Muse Wonder Full 56점이 파란 막대로 표시되어 있고 세대가 바뀔 때마다 화살표로 이어져 있다

Muse Wonder: A Frontier Model For Personal & Professional AI Agents

메타가 2026년 10월 12일 Muse Wonder와 Muse Wonder Full을 공개했다. 두 모델은 개인 비서와 업무용 에이전트를 위해 개발됐다. 메타가 공개한 14개 평가 중 7개에서 Muse Wonder 계열이 비교 모델 가운데 가장 높은 점수를 받았고, 종합 지수에서는 Full이 Claude Opus 5.5에 이어 두 번째다. 메타는 사용자의 맥락을 기억하는 Active Memory와, 문제가 생겨도 끝까지 일하는 Active Focus를 강점으로 강조했다.
October 13, 2026 · 12 분 · 서소영
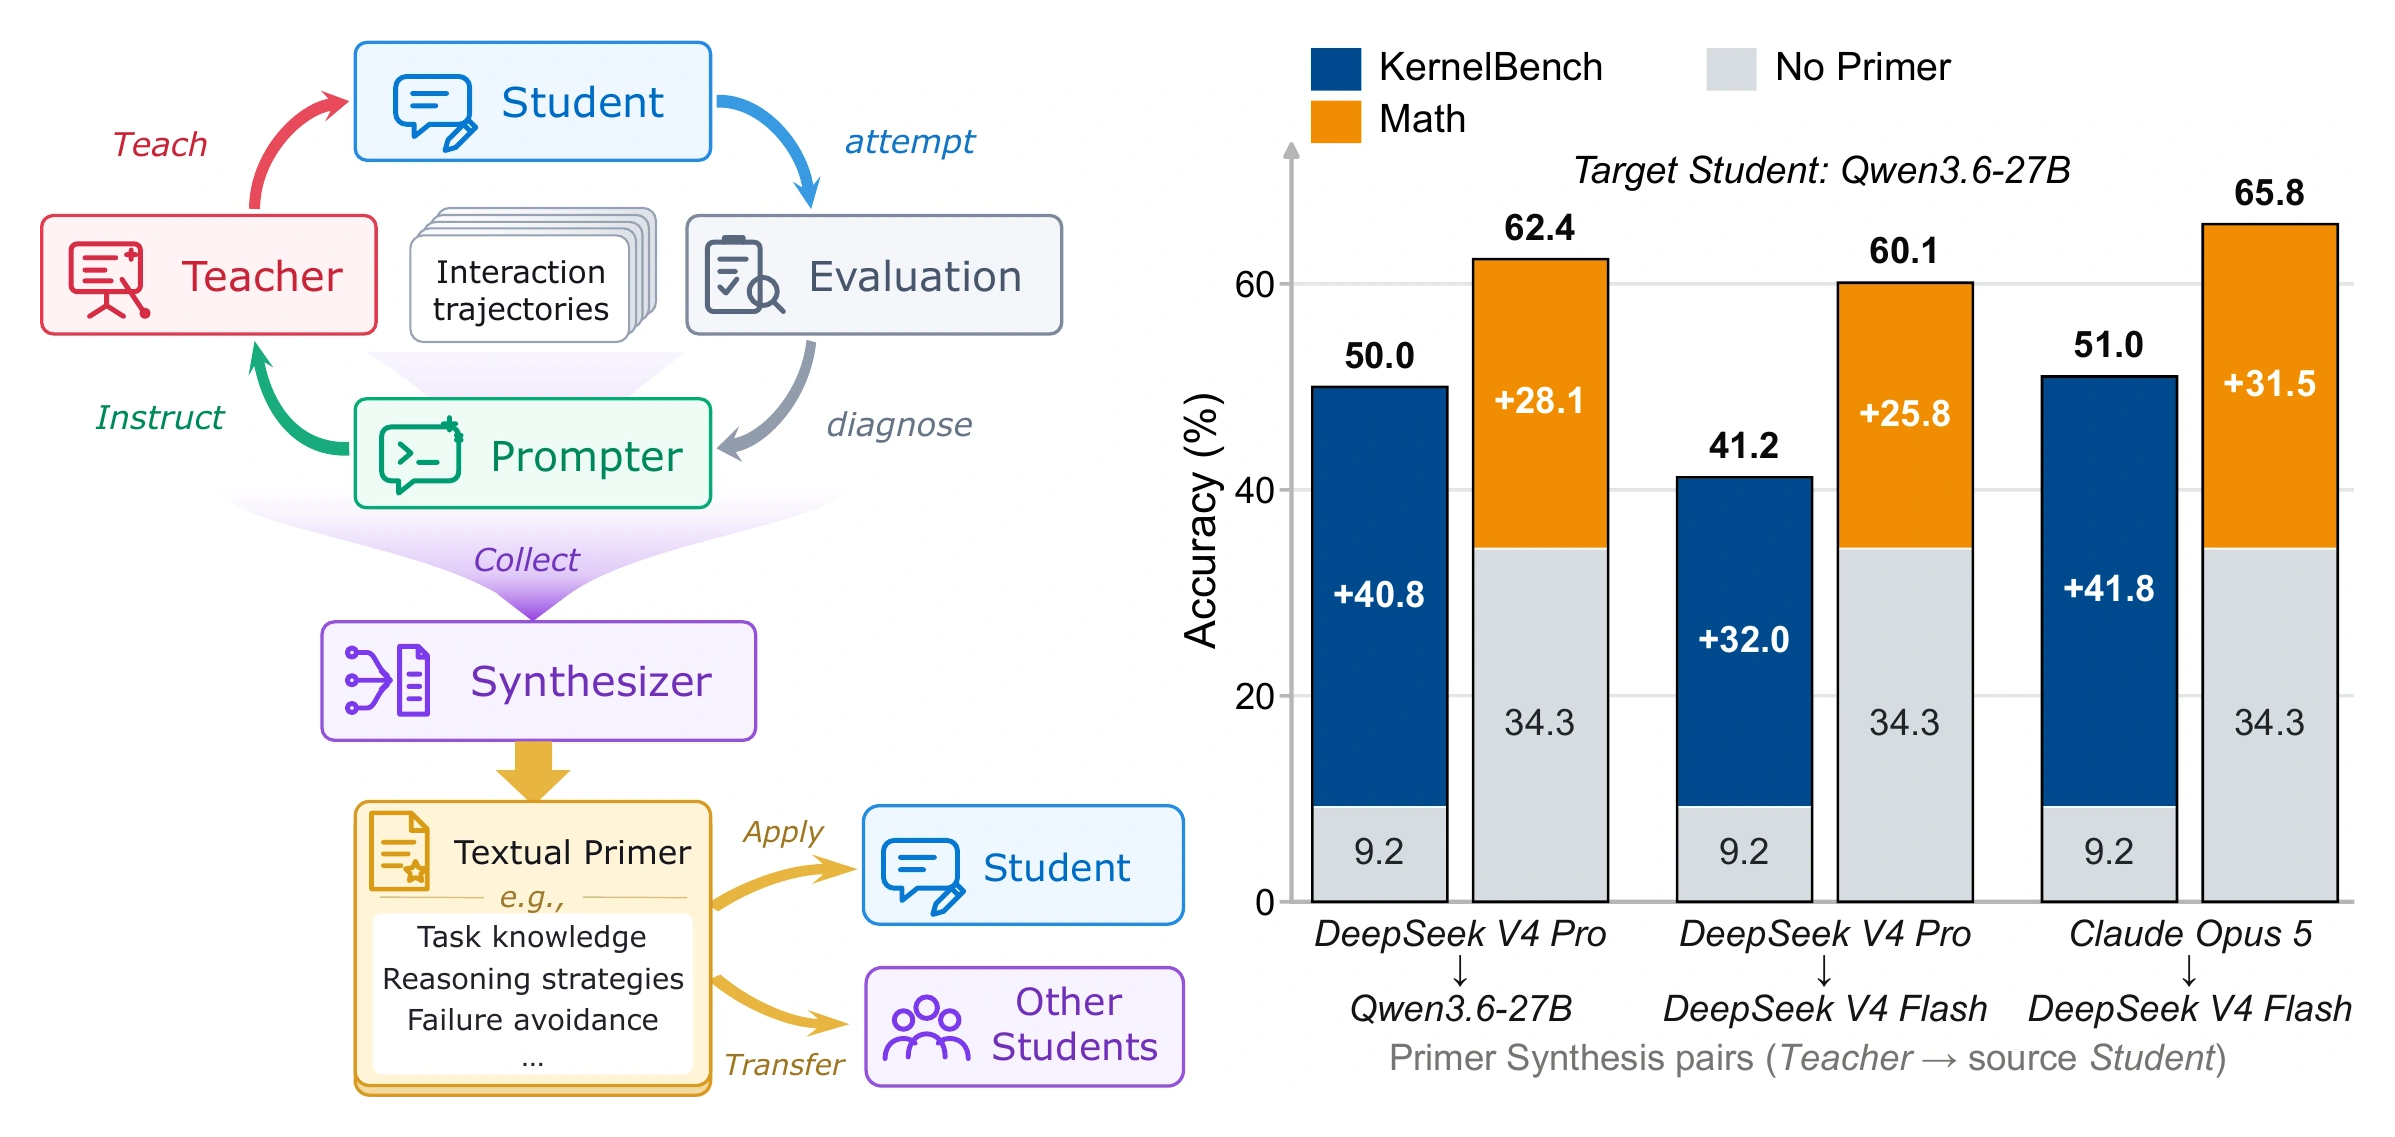
논문의 그림 1. 왼쪽에는 UTT의 순환이 그려져 있다. 학생이 문제를 풀면 Prompter가 채점 결과를 진단해 선생에게 지시하고, 선생이 학생을 가르친다. Synthesizer는 이 기록을 모아 Primer를 만들고, Primer는 원래 학생과 다른 학생들에게 적용된다. 오른쪽 막대그래프는 세 조합에서 만든 Primer를 Qwen3.6-27B에 적용한 정확도다. KernelBench는 9.2%에서 41.2%와 51.0% 사이로, 수학은 34.3%에서 60.1%와 65.8% 사이로 올랐다. 출처: Lu & Wang, arXiv:2610.12114

Universal Textual Teaching for LLMs

웨스트레이크 대학교 연구진은 강한 모델이 맞히고 약한 모델이 틀린 문제에서 얻은 교훈을 Primer라는 자연어 안내문으로 정리해 약한 모델에게 전달하는 방법 UTT를 제안했다. 약한 모델의 가중치는 학습시키지 않는다. Primer를 받은 DeepSeek V4 Flash의 KernelBench 정확도는 9.4%에서 48.6%로, 올림피아드 수학 정확도는 27.6%에서 51.7%로 올랐고, 합성에 참여하지 않은 다른 학생 모델도 같은 Primer로 점수가 올랐다.

October 13, 2026 · 16 분 · 서소영
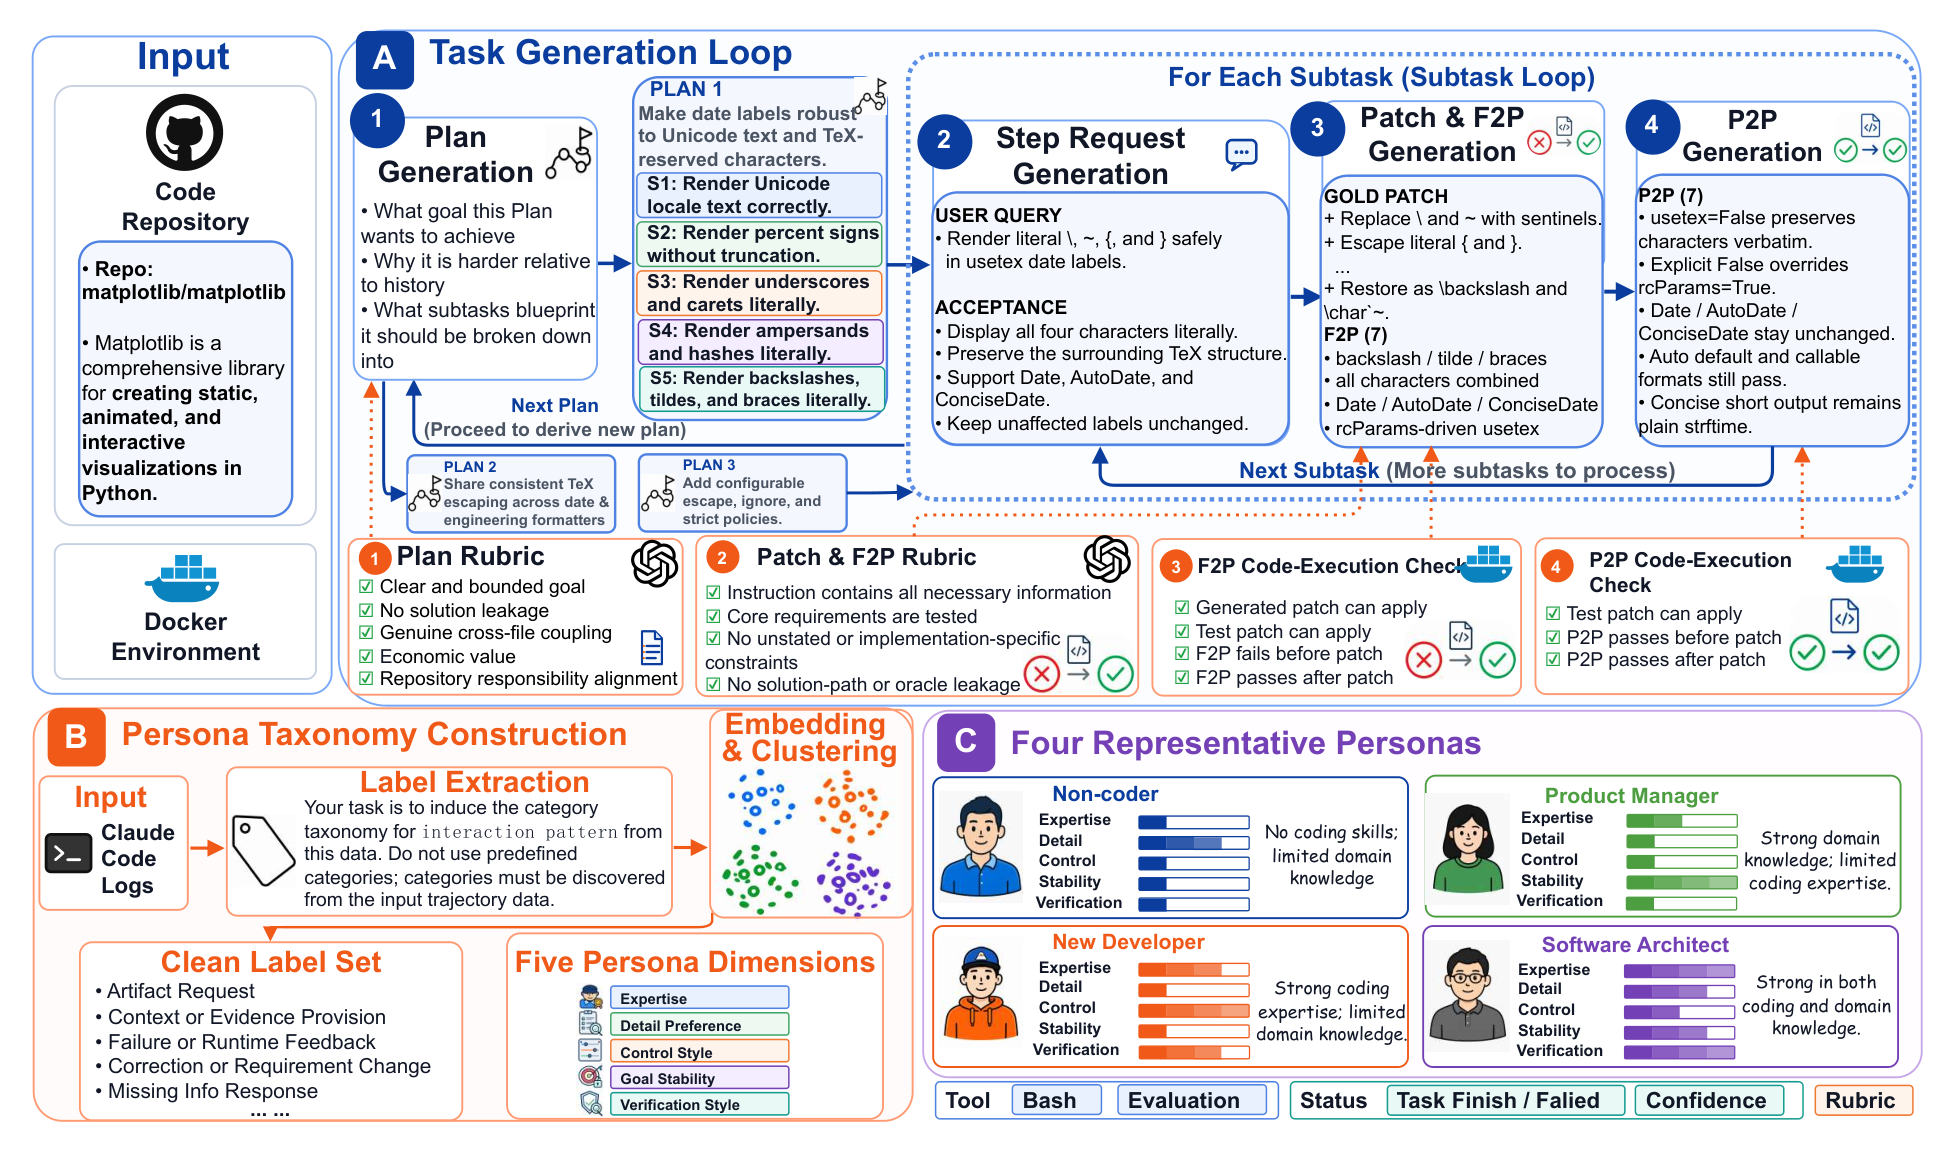
SWE-Journey의 구성도. 위쪽 A 영역은 과제 생성 루프다. Matplotlib 저장소와 Docker 환경을 입력으로 받아 계획을 생성하고, 하위 과제마다 사용자 요청과 합격 기준, 정답 패치와 F2P 테스트, P2P 테스트를 차례로 만든다. 아래에는 각 단계를 검사하는 루브릭과 코드 실행 검사가 있다. 왼쪽 아래 B 영역은 Claude Code 대화 기록에서 라벨을 추출하고 군집화해 전문성, 선호하는 답변 형식, 통제 방식, 목표 안정성, 검증 방식의 다섯 차원을 얻는 과정이다. 오른쪽 아래 C 영역은 비개발자, 제품 관리자, 신입 개발자, 소프트웨어 아키텍트의 네 페르소나를 다섯 차원의 막대로 보여 준다. 출처: Deng et al., arXiv:2610.11559

SWE-Journey: Towards More Realistic Evaluation of Coding Assistants through Long-Horizon, Multi-Turn Interaction

SWE-Journey는 코딩 어시스턴트 벤치마크다. 평균 19.8개의 하위 과제로 이루어진 긴 개발 과제를 네 유형의 시뮬레이션 사용자와 여러 턴 동안 수행하게 한다. 13개 모델의 평균 최종 기능 테스트 통과율은 소프트웨어 아키텍트와 협업할 때 78.50%, 비개발자와 협업할 때 23.00%였다.

October 12, 2026 · 16 분 · 서소영
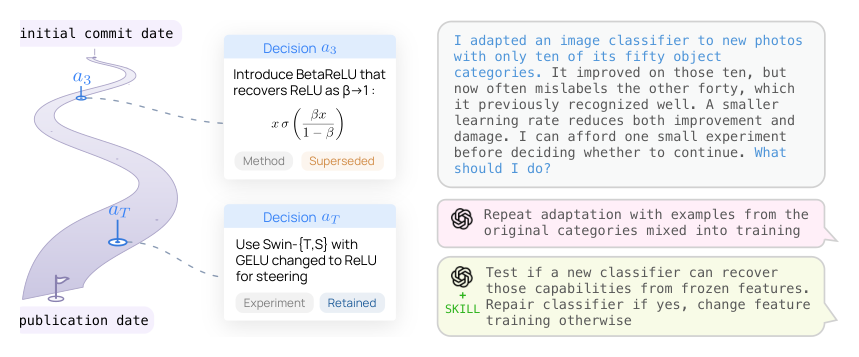
논문의 그림 1. 왼쪽에는 첫 커밋 날짜에서 논문 공개 날짜까지 굽이치는 길이 그려져 있고, 길 위의 두 지점에 연구 결정 카드가 연결돼 있다. 위쪽 결정 a3은 'β가 1에 가까워지면 ReLU가 되는 BetaReLU를 도입한다'이고 범주는 방법, 결과는 대체다. 아래쪽 결정 aT는 'Swin-T와 Swin-S의 GELU를 ReLU로 바꿔 모델 조정에 쓴다'이고 범주는 실험, 결과는 유지다. 오른쪽에는 50개 클래스를 아는 이미지 분류기를 10개 클래스의 새 사진에 적응시켰더니 나머지 40개 클래스를 자주 틀리게 됐다는 연구자의 질문이 있다. 그 아래에 스킬 없이 받은 답(원래 클래스의 예시를 섞어 적응을 다시 한다)과 스킬과 함께 받은 답(특징을 고정한 채 새 분류기가 그 능력을 복원하는지 시험한다)이 있다. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0

Learning Scientific Exploration from Human Research Decision Trajectories

시카고 대학교 연구진은 논문과 함께 공개된 GitHub 저장소의 커밋 기록에서 연구자가 내린 결정의 순서를 추출해 데이터셋 ResearchTrails를 만들었다. NeurIPS 논문과 함께 공개된 저장소 599개에서 연구 결정 13,271개를 얻었고, 이 기록으로 정리한 스킬은 다음 연구 결정을 예측하는 과제에서 최종 논문만으로 정리한 스킬보다 높은 점수를 받았다.

October 12, 2026 · 17 분 · 서소영
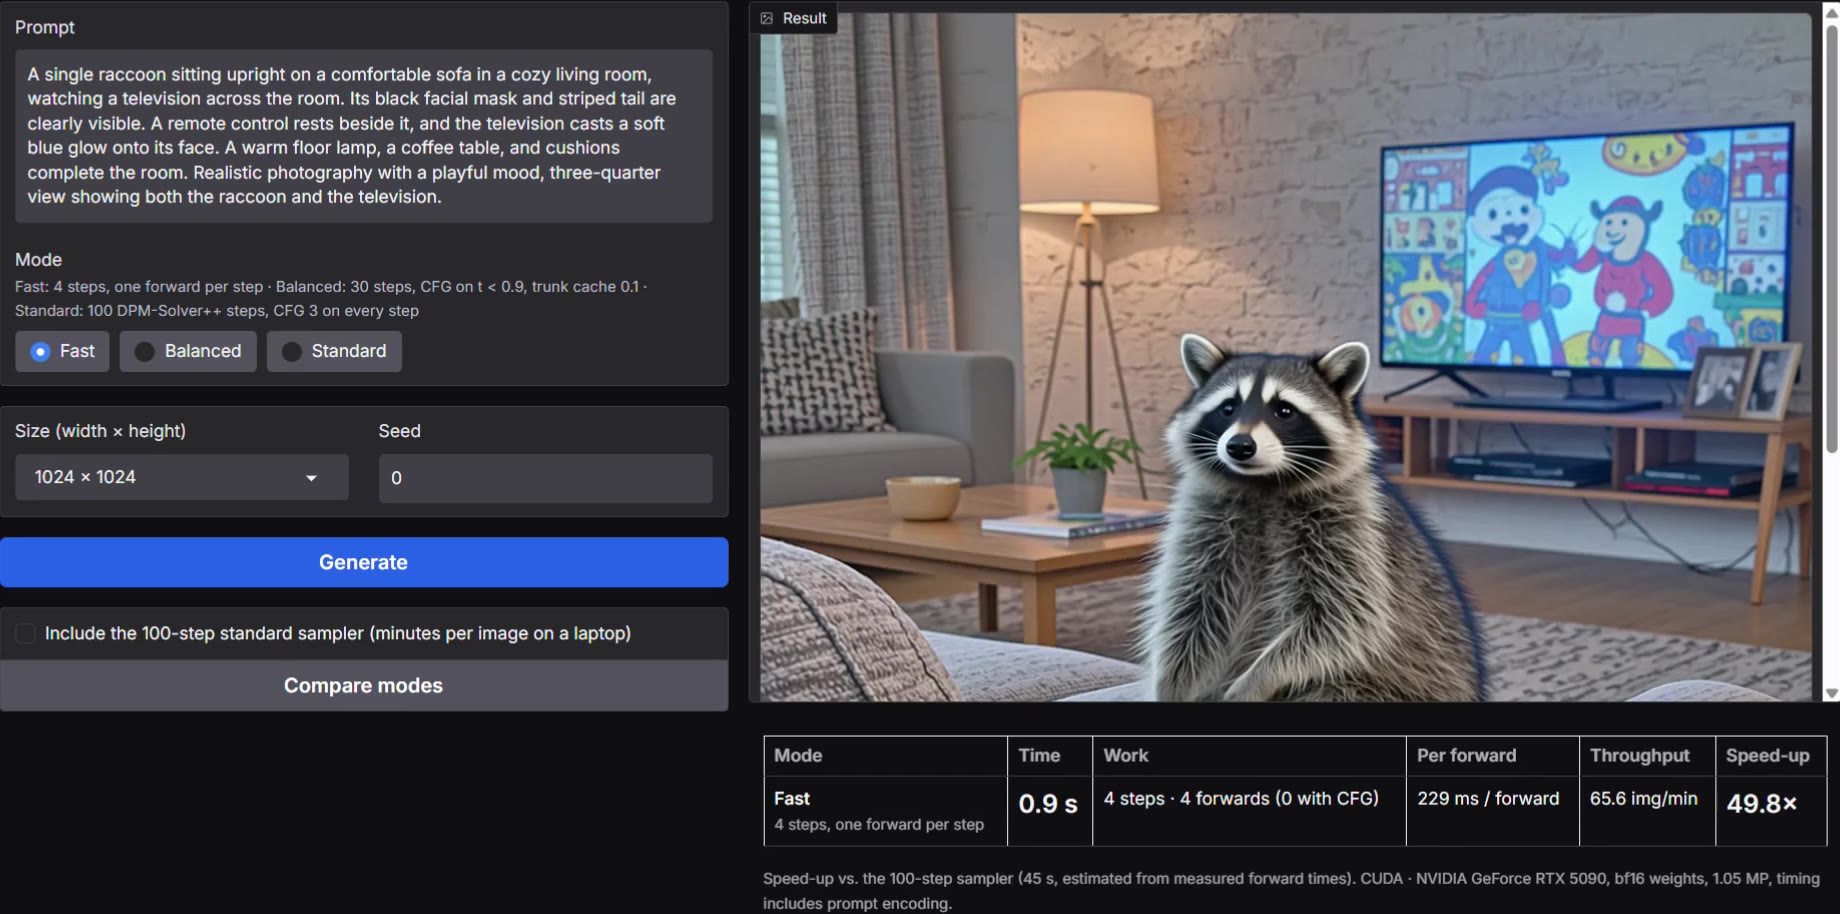
Iris-3B 속도 비교 데모 화면. 왼쪽에 거실 소파에 앉아 텔레비전을 보는 너구리를 묘사한 프롬프트와 Fast 모드 선택이 있고, 오른쪽에 생성된 너구리 사진이 있다. 아래 표에는 4스텝, 포워드 4번, 0.9초, 100스텝 대비 49.8배라고 적혀 있다. 사용자 jun1228909가 RTX 5090에서 녹화한 영상의 한 장면이다.

Iris-3B의 100스텝을 4스텝으로 줄인 Turbo LoRA

Speridlabs가 공개한 30억 파라미터 이미지 생성 모델 Iris-3B는 VAE 없이 픽셀을 직접 만든다. 대신 기본 설정에서는 1024×1024 이미지 한 장에 포워드 패스가 약 200번 필요했다. 일본 개발자 pentacoxian은 증류 기법 DMD2로 CFG의 효과까지 학습한 4스텝 LoRA를 만들어 생성 시간을 RTX 5090에서 0.68초, M3 Max에서 약 11초로 줄였다. 공개 하루 동안에는 사용자들이 RTX 5090, 아이폰, 스냅드래곤 NPU에서 실행한 결과를 올렸다.

October 12, 2026 · 12 분 · 서소영
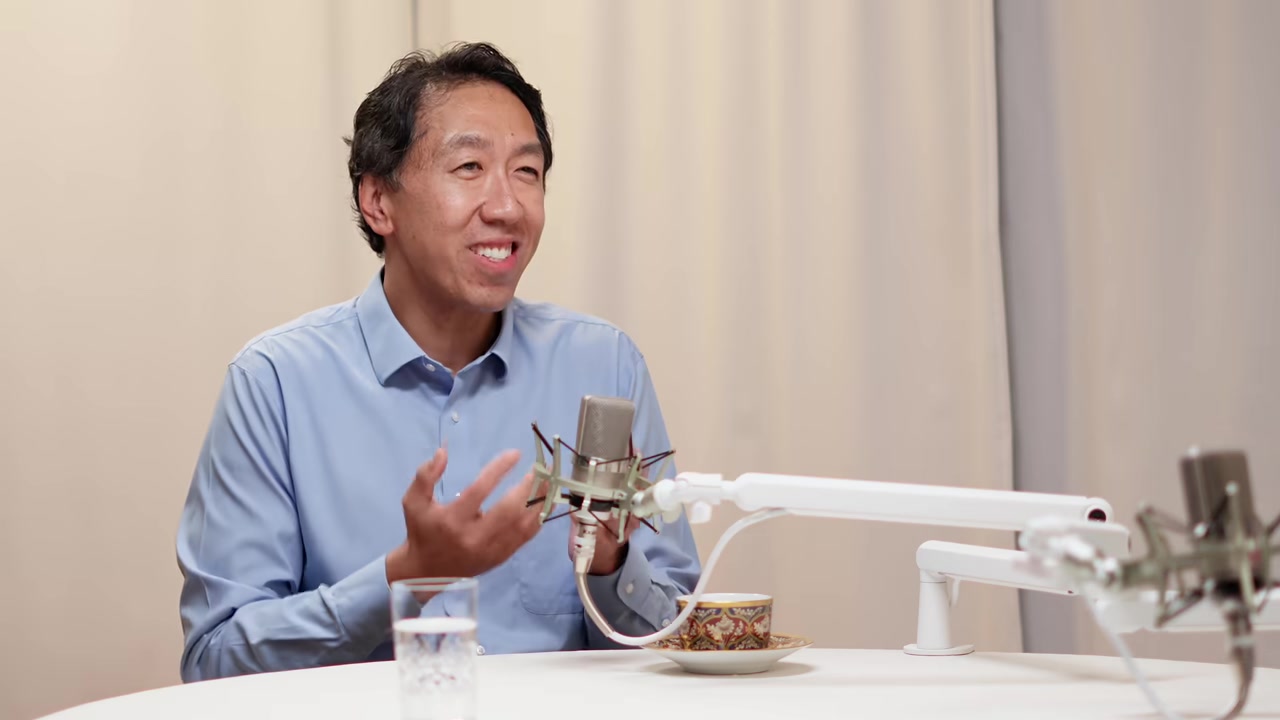
Silicon Valley Girl 인터뷰에서 웃으며 이야기하는 앤드루 응

Andrew Ng: The Biggest Opportunities in AI Aren't Where You Think

앤드루 응은 AI가 일자리를 없앤다는 공포가 과장됐고, 그 공포는 일부 선두 AI 기업의 규제 포획 시도에서 비롯됐다고 주장한다. 그는 대학 교육이 변화를 2년 늦게 반영한다는 점과 지금의 AI 사용 습관이 학습을 해친다는 점을 문제로 꼽고, 만드는 비용이 급락한 지금은 무엇을 만들지 정하는 일이 병목이라고 말한다.

October 12, 2026 · 15 분 · 서소영
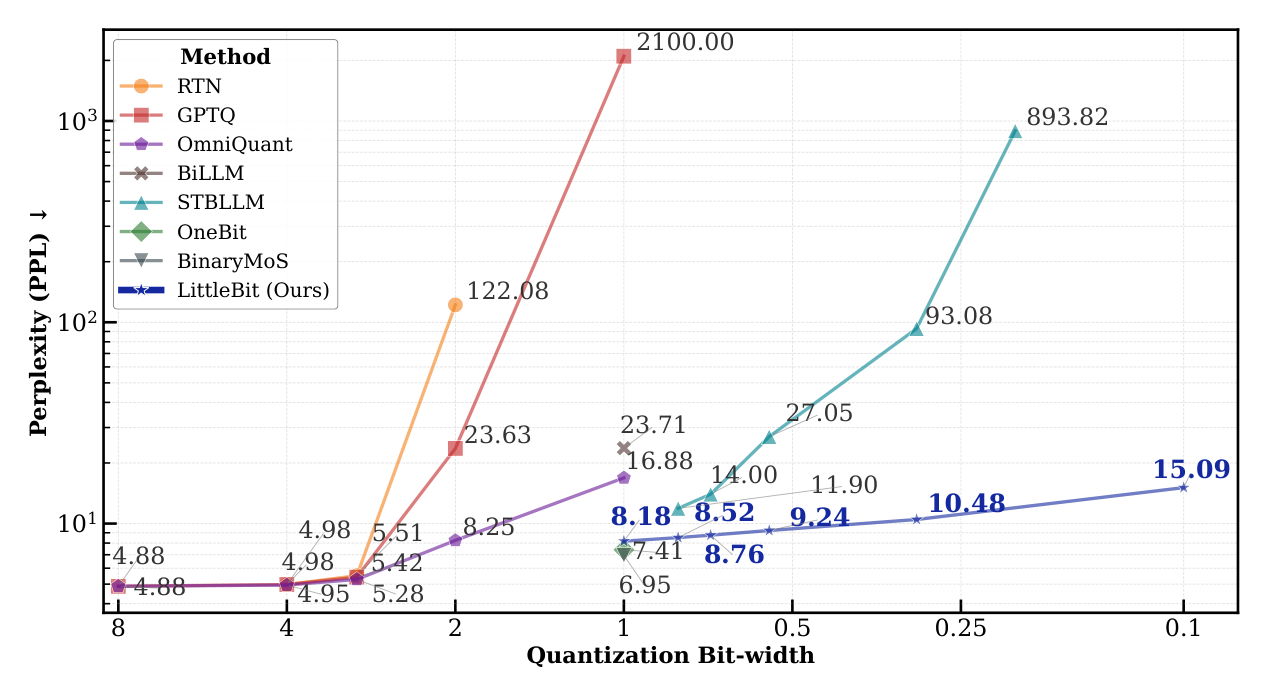
Llama2-13B의 WikiText-2 퍼플렉시티를 양자화 비트 수에 따라 비교한 로그 스케일 그래프. 가로축은 왼쪽 8비트에서 오른쪽 0.1비트까지다. RTN과 GPTQ는 2비트 부근에서, STBLLM은 0.5비트 미만에서 퍼플렉시티가 수백 이상으로 커진다. LittleBit은 1비트의 8.18에서 0.1비트의 15.09까지 완만하게 증가한다. 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0

LittleBit: Ultra Low-Bit Quantization via Latent Factorization

삼성리서치의 LittleBit은 LLM의 가중치 행렬을 랭크가 낮은 두 행렬의 곱으로 분해한 뒤 이진화하고, 행과 열과 잠재 차원의 스케일로 크기 정보를 보완해 가중치 하나당 평균 0.1비트까지 압축한다. 0.1비트로 압축한 Llama2-7B의 퍼플렉시티는 15.92로 기존 기법 STBLLM이 0.7비트에서 낸 결과보다 낮지만, 원본 모델과의 성능 차이는 여전히 크다.

October 12, 2026 · 14 분 · 서소영
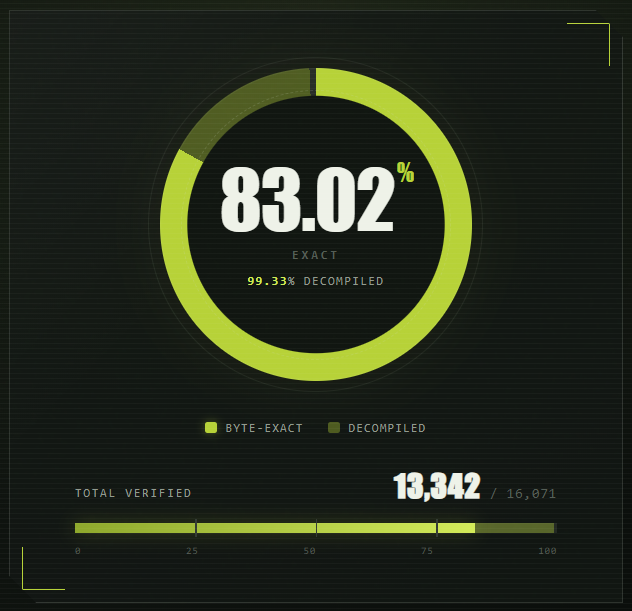
원문에 공개된 최종 진행 화면. 함수 복원율은 99.33%, 바이트 일치율은 83.02%다. 전체 함수 16,071개 중 바이트 검증을 통과한 함수는 13,342개다.

500+ Billion Tokens Later: Letting AI Agents Decompile A First-Person Shooter

Maurice Heumann이 AI 에이전트로 FPS 게임을 C++ 코드로 복원한 3개월의 실험을 공개했다. 원본과 복원 코드의 컴파일 결과를 대조하는 검증을 도입해 함수 99%를 복원하고, 전체 함수 중 83%의 바이트 일치를 확인했다고 보고했다.

October 11, 2026 · 7 분 · 서소영
Rabi Guha의 ChatGPT Intelligent UI 분석 글 대표 이미지

ChatGPT Intelligent UI를 역공학했다. 실제로 어떻게 작동할까

OpenUI 팀이 ChatGPT 웹의 통신과 공개 코드를 분석했다. 모델이 DIL이라는 형식으로 작성한 응답을 서버가 컴파일하고, 브라우저가 격리된 실행 환경과 기존 컴포넌트로 대화형 화면을 표시한다.

October 11, 2026 · 6 분 · 서소영
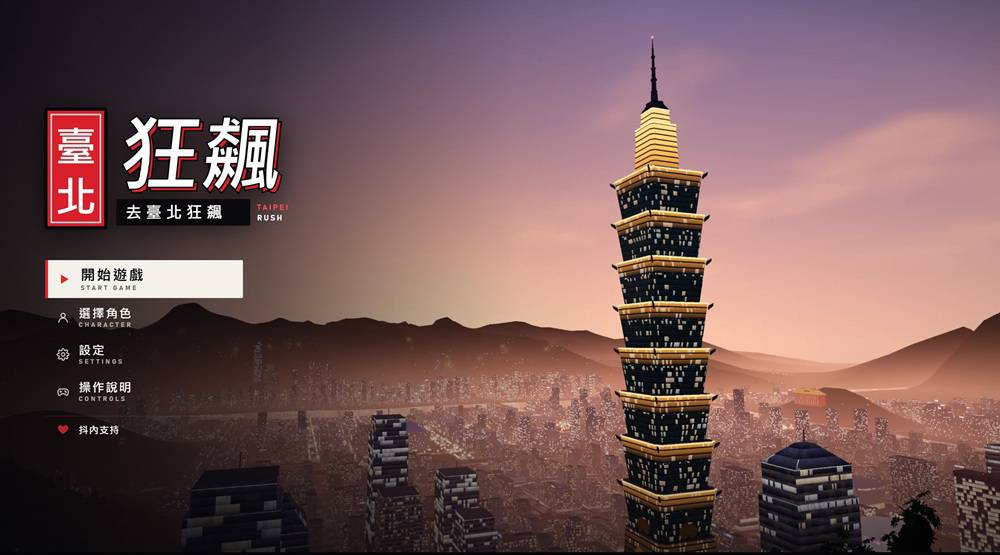
타이베이 101을 배경으로 한 TAIPEI RUSH의 시작 화면. 게임동아 기사에 실린 게임 화면

타이베이판 GTA는 어떻게 만들어졌나

게임 개발과 무관한 분야에서 일하는 엔지니어가 퇴근 후 한 달 동안 타이베이판 GTA를 만들었다. 대만을 게임으로 만든 이유와 AI를 활용한 제작 과정, 비슷한 브라우저 게임 세 가지를 소개한다.

October 8, 2026 · 6 분 · 서소영