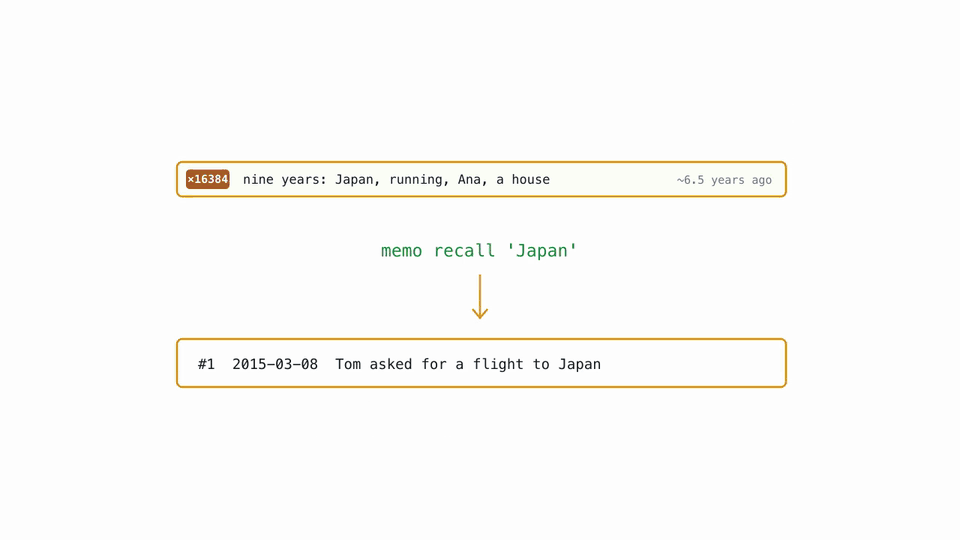
OptMem은 세션이 끝나도 에이전트가 이전 결정과 경험을 다시 읽을 수 있도록, 기억을 로컬 파일에 기록하는 도구다. VictorTaelin은 이를 426토큰 지시문과 Python 스크립트 하나로 적용하는 영구 메모리라고 소개한다. 최근 기록은 자세히 읽고 오래된 기록은 요약해서 읽으며, 필요한 원문은 별도로 검색한다.1
3줄 요약
- 설치 후 출력되는 지시문을 AGENTS.md나 CLAUDE.md에 추가하면 에이전트가 기록과 검색 명령을 사용한다.
- 원문은 추가만 가능한 로그에 보존하고, 에이전트가 작성한 요약은 이진 트리 형태로 저장한다.
- 세션 시작 때 읽을 양은 조절할 수 있으며, 잘못된 요약은 원문을 유지한 채 다시 만들 수 있다.
세션마다 무엇을 하는가
기본 실행 파일은 ~/.optmem/memo에 설치된다. Python 3으로 실행하며 추가 패키지를 요구하지 않는다. 지시문은 세션 시작 때 wake를 먼저 실행하도록 요구한다. 작업하면서 새로 알게 된 사실이나 나중에도 기억할 만한 사건은 note로 기록한다. 같은 설치 명령을 다시 실행하면 도구를 갱신한다.1
| 명령 | 동작 |
|---|---|
memo wake | 세션 시작에 읽을 기록과 요약을 출력한다. |
memo note "기록" | 한 줄의 기억을 추가한다. 기본 한도는 280바이트다. |
memo nap | 아직 작성하지 않은 요약을 요청한다. 에이전트가 요약문을 작성해 제출한다. |
memo recall <regex> | 원문 로그를 정규식으로 검색한다. |
memo zoom <lo>-<hi> | 지정한 요약에 해당하는 두 하위 기록을 출력한다. |
memo forget <lo>-<hi> | 요약과 그 요약을 이용해 만든 상위 요약을 제거한다. 다음 요약 작업에서 다시 생성한다. |
280바이트는 글자 수 제한과 다르다. 구현은 UTF-8로 인코딩한 길이를 확인하므로, 공백 없이 한글만 쓴다면 기본 설정에서는 93글자까지 기록할 수 있다.2
또한 이 지시문은 같은 에이전트의 병렬 세션에는 기록을 허용하고, 위임받은 하위 에이전트에는 메모리 명령 사용을 금지한다. 중복되거나 맥락이 어긋난 기록을 방지하려는 규칙이다.1
오래된 기억은 어떻게 읽는가
저장소는 기본적으로 ~/.optmem/memory에 생성된다. LOG.txt는 개별 기록을 보존하고, TREE/는 재생성할 수 있는 요약을 저장한다. MEMORY_DIR 환경변수로 저장 경로를 지정할 수도 있다.1
처음에는 두 기록을 한 줄로 요약한다. 이후에는 두 하위 요약을 참고해, 두 요약에 포함된 기록 전체를 다시 요약한다. 실제 코드에서는 16개 이하의 기록을 요약할 때 원문을 사용하고, 더 큰 범위에서는 두 하위 요약을 사용한다. 요약 요청에는 나중에도 필요한 내용을 유지하고 새로운 내용을 지어내지 말라는 지시가 포함된다.2
wake는 출력할 수 있는 줄 수를 고려해 최근 기록을 더 자세히 보여준다. WAKE_LINES의 기본값은 96줄이며, README는 이 분량을 약 8천 토큰으로 설명한다. 이 설정으로 조절하는 것은 읽을 분량이며, 저장량에는 제한을 두지 않는다. 값을 바꿔도 기존 기록이나 요약을 다시 계산하지 않는다.1
요약이 필요하면 도구의 실행 결과에 요약할 기록과 다음 명령이 표시된다. 에이전트가 그 내용을 읽고 요약문을 작성해 제출한다. 세션 시작에 필요한 요약이 아직 없으면 wake가 요약을 먼저 작성하도록 안내하고 종료한다. 출력 내용이 길면 도구는 여러 차례에 걸쳐 출력한다. 에이전트는 완료 안내가 나올 때까지 이어서 읽어야 한다.2
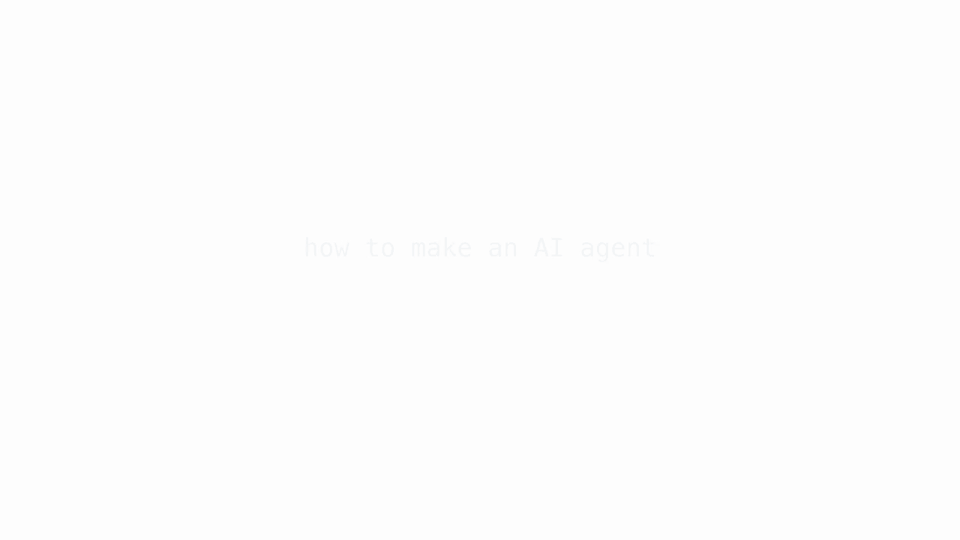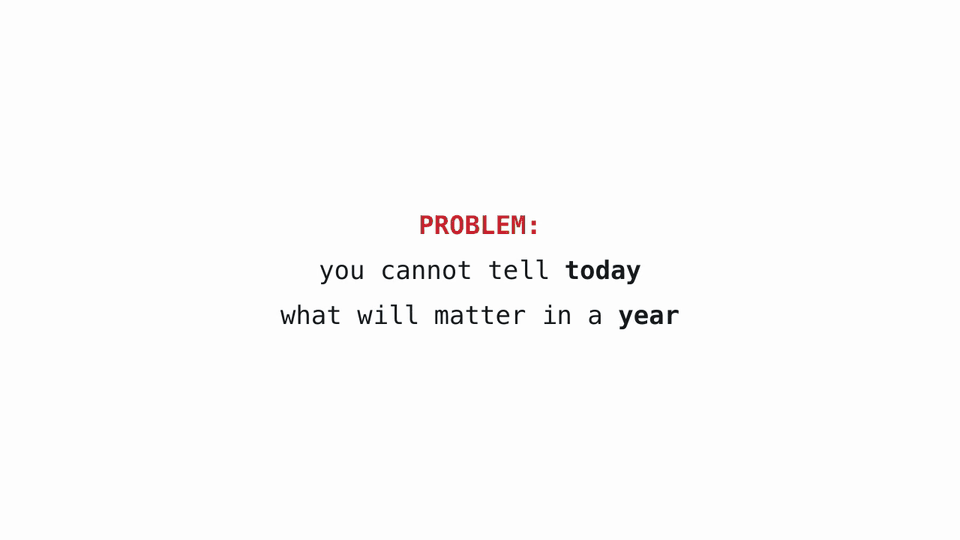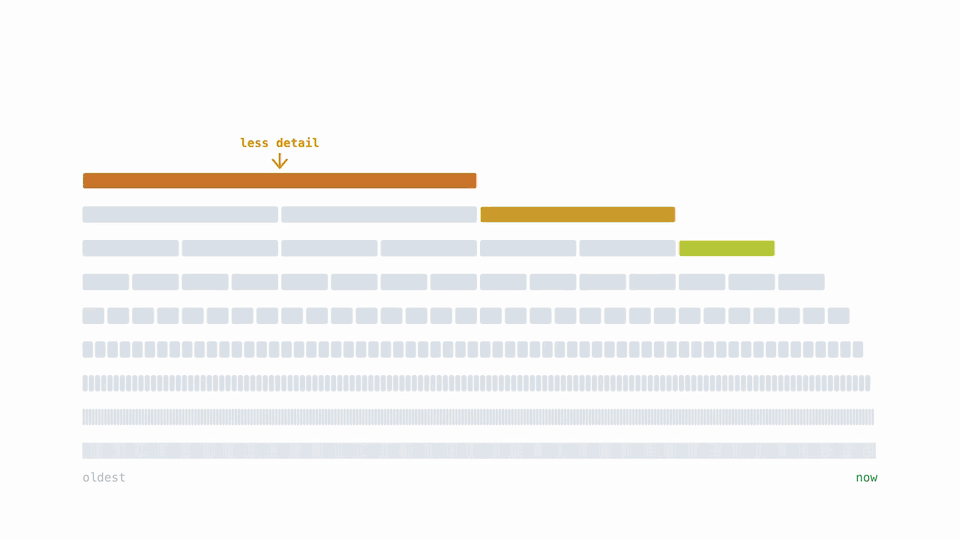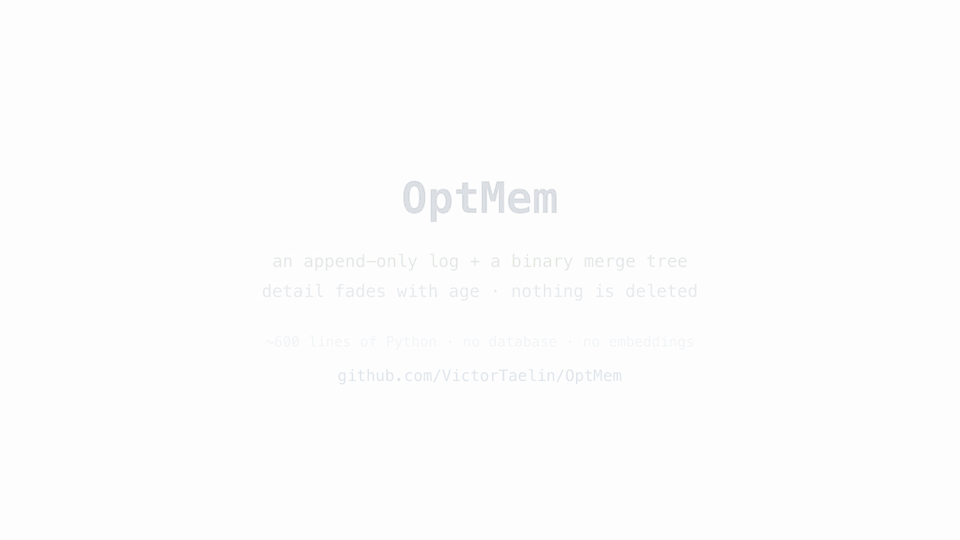
출처: VictorTaelin/OptMem 공식 애니메이션. 커버는 같은 영상의 검색 장면이다.
검색과 성능
각 원문 기록은 320바이트, 각 요약 기록은 288바이트의 고정 길이로 저장된다. 기록 번호로 파일의 읽기 위치를 계산할 수 있어, 특정 기록을 읽을 때 전체 파일을 검색할 필요가 없다. README에 따르면 기억 100만 개를 저장했을 때 용량은 608MB다. 이 상태에서 wake의 실행 시간은 0.03초였다고 한다.3
원문 검색은 다른 방식으로 동작한다. recall은 로그를 순회하며 정규식과 일치하는 기록을 찾는다. 검색 결과가 출력 한도를 초과하면 조건에 맞는 기록 중 최근 기록을 보여주고 검색식을 더 구체적으로 쓰도록 안내한다. 따라서 오래된 원문을 확인할 때는 요약에서 zoom으로 탐색하거나, 기억에 남은 단어를 recall에 입력할 수 있다.2
내가 관심을 둔 기능
요약에서 중요한 조건이 생략됐을 때는 원문을 확인하고 요약을 다시 작성할 수 있다. 나는 이 수정 기능을 오래 사용하는 메모리 도구의 중요한 요건으로 생각한다.
다음으로 확인해 보고 싶은 것은 장기간 기록했을 때의 요약 정확도다. 기억할 내용을 선택하는 일부터 요약문을 쓰는 일까지 에이전트가 맡는다. OptMem은 그 결과를 파일에 저장하고 필요한 기록을 조회한다. 같은 도구를 사용해도 모델의 기록 습관과 요약 능력에 따라 다음 세션이 읽는 내용은 달라질 것이다.4
출처
VictorTaelin, OptMem GitHub 저장소. 2026년 10월 5일 조회, 확인한 커밋은 1fb164cf다.