3줄 요약
- UCLA 아이도간 오즈잔 연구실이 이미지 생성의 계산 단계를 빛의 전파로 대체한 광학 생성 모델을 Nature에 발표했다. 얕은 디지털 인코더가 무작위 가우시안 잡음을 2차원 위상 패턴으로 바꿔 둔다. 이 패턴을 공간 광변조기에 띄우고 평면파로 비추면, 회절 디코더가 목표 데이터 분포를 따르는 새 이미지를 단 한 번에 만들어 낸다. 조명 전력과 위상 시드를 미리 계산하는 비용을 빼면 합성 과정 자체에는 연산 전력이 들지 않는다.
- 학습은 확산 모델 증류로 이뤄진다. 먼저 DDPM 교사 모델을 목표 분포에 학습시켜 동결하고, 그 교사가 만들어 내는 잡음과 이미지 쌍으로 얕은 디지털 인코더와 회절 디코더를 함께 최적화한다. 광학 모델이 만든 데이터만으로 훈련한 MNIST 분류기는 평균 99.18%의 정확도를 기록했는데, 표준 MNIST로 훈련한 분류기보다 0.4% 낮은 값이다.
- 연구진은 520nm 가시광 장치에서 손글씨 숫자와 패션 상품 이미지를 실제로 생성했고, 5.8억 파라미터 인코더를 붙여 반 고흐풍 작품을 단색과 컬러로 뽑아냈다. 같은 그림을 디지털 DDPM으로 만들면 장당 265~2,916 J이 드는 반면, 광학 모델 쪽에서 드는 비용은 인코더 연산에 해당하는 장당 1.13~12.44 J이다.
잡음을 위상으로 바꾸고 나머지는 빛에 넘긴다
생성 모델이 커지면서 추론에 드는 전력과 시간이 문제가 됐다. 논문은 여기에서 출발한다. 연구진은 확산 모델에서 착상을 가져오되, 반복적인 잡음 제거를 디지털 신경망 대신 자유 공간을 지나는 빛으로 처리하겠다고 제안한다.
구조는 두 부분으로 되어 있다. 앞쪽에는 얕고 빠른 디지털 인코더가 있다. 이 인코더는 정규분포에서 뽑은 무작위 2차원 잡음을 받아 2차원 위상 패턴으로 바꾼다. 연구진은 이 패턴을 광학 생성 시드라고 부른다. 뒤쪽에는 회절 디코더가 있다. 위상 시드를 공간 광변조기(SLM)에 표시하고 결맞은 평면파로 비추면, 변조된 광파가 자유 공간을 전파한 뒤 디코더 표면을 통과해 이미지 센서 평면에 이미지를 맺는다. 그 이미지가 목표 분포를 따른다.
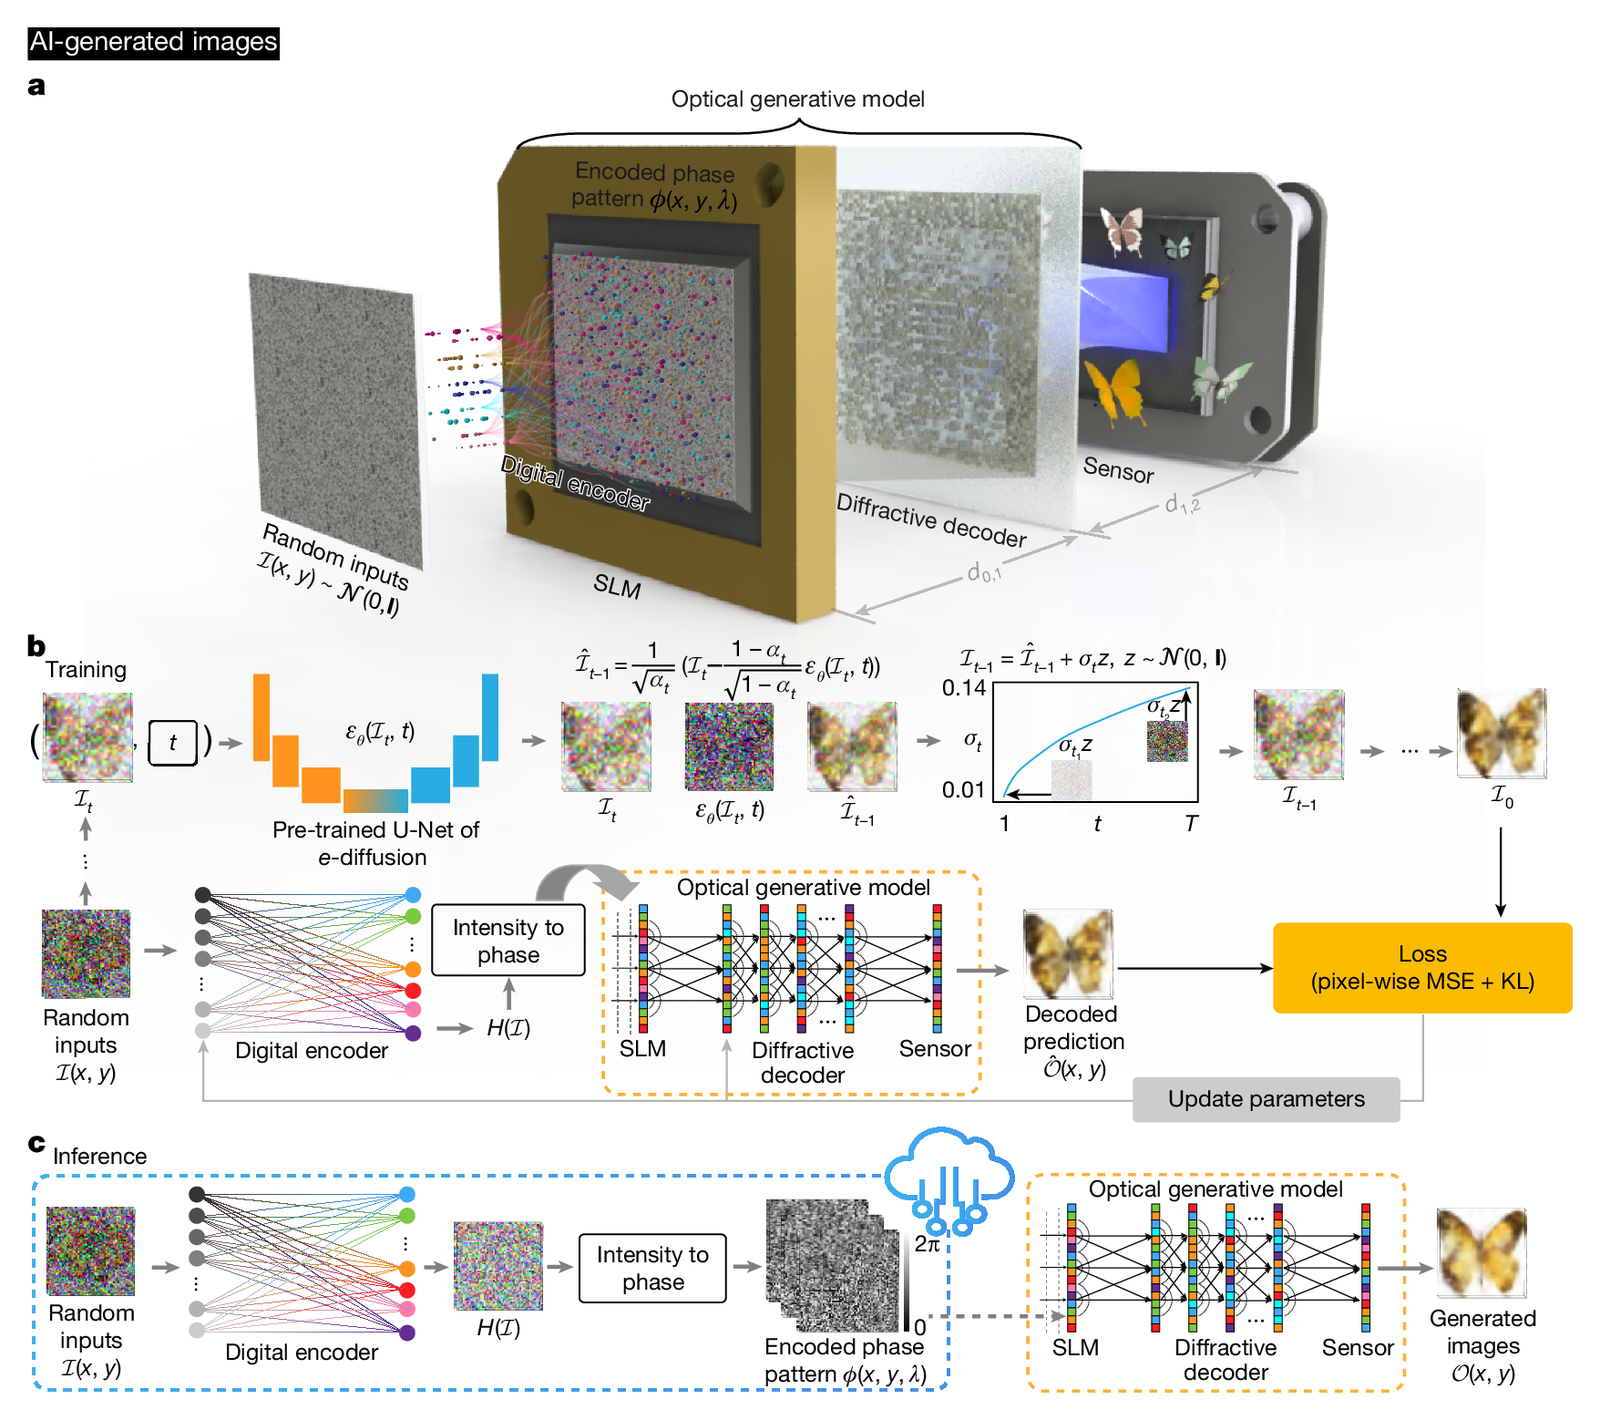 Fig. 1. 스냅샷 광학 생성 모델의 설계. 출처: Chen et al., Nature (2025), CC BY 4.0
시드 계산은 한 번만 하면 된다. 이 점이 중요하다. 위상 시드를 미리 여러 장 계산해 두면, 그 다음부터는 저장된 시드 가운데 하나를 무작위로 골라 광변조기에 표시하기만 하면 된다. 이미지 한 장을 새로 합성하는 데 드는 디지털 연산이 없다. 갱신 속도는 광변조기의 프레임률이 정한다.
디코더는 목표 분포마다 다른 상태로 최적화되지만, 일단 최적화가 끝나면 고정된다. 다른 분포로 바꾸고 싶으면 시드 묶음과 디코더 표면의 상태만 교체하면 되고, 광학 장치 자체는 손대지 않는다.
교사 확산 모델을 광학으로 증류한다
광학 모델을 바닥부터 학습시키지는 않는다. 연구진은 먼저 DDPM 기반의 디지털 교사 모델을 목표 데이터 분포에 학습시킨다. 학습이 끝나면 교사를 동결하고, 이 교사가 만들어 내는 잡음과 이미지의 쌍을 학습 데이터로 삼아 얕은 디지털 위상 인코더와 회절 디코더를 함께 최적화한다.
손실 함수는 두 항의 합이다. 교사 출력과 광학 모델 출력 사이의 평균제곱오차가 첫째 항이고, 교사 분포와 모델 분포 사이의 쿨백 라이블러 발산이 둘째 항이다. 분포는 생성된 이미지의 히스토그램으로 잰다.
MNIST와 Fashion-MNIST용 인코더는 완전 연결층 세 개로 이뤄진 다층 퍼셉트론 변형이다. 활성화 함수는 기울기 0.2의 LeakyReLU를 쓴다. 클래스 라벨이 있는 데이터셋에서는 잡음을 평탄화한 벡터에 32차원 클래스 임베딩을 이어 붙여 입력으로 넣는다. 입력 해상도는 모든 데이터셋에서 32×32다.
광학 쪽 수치는 다음과 같다. 인코더 출력을 0에서 2π 범위로 정규화해 위상 패턴을 만들고, 가로세로 10배로 업샘플링한다. 그 결과 물체면의 크기는 2.56mm×2.56mm, 해상도는 320×320이 된다.
디코더 층의 학습 가능한 위상 특징은 400×400개이고, 최소 횡방향 해상도는 8μm다. 조명 파장은 단색 동작에서 520nm를, 다색 동작에서 450nm와 520nm와 638nm를 쓴다.
거리도 고정되어 있다. 광변조기 평면에서 디코딩 층까지의 축 방향 거리는 120.1mm, 디코딩 층에서 센서 평면까지는 96.4mm다.
빛의 전파는 각 스펙트럼법으로 모델링했고, 디코딩 층은 위상만 변조하는 소자로 두었다. 이 요소들이 모두 미분 가능한 순방향 모델 안에 들어가기 때문에, 디지털 인코더의 가중치와 디코더 표면의 위상값을 같은 역전파로 함께 학습시킬 수 있다.
손글씨와 옷으로 확인한 성능
MNIST와 Fashion-MNIST에 각각 모델을 학습시킨 결과, 두 데이터셋의 모든 클래스에서 전에 없던 이미지가 만들어졌다. 평가에는 인셉션 점수(IS)와 프레셰 인셉션 거리(FID)를 썼고, 두 지표 모두 생성 이미지 1,000장 묶음으로 측정했다.
IS 평가에서 광학 생성 이미지는 원본 데이터셋보다 높은 값을 기록했고, t 검정의 P 값이 0.05 미만으로 나왔다. 원본보다 통계적으로 더 다양한 이미지를 만들었다는 뜻이다. FID는 100회 반복 계산의 통계를 함께 보고했는데, 생성 이미지가 원본 분포와 일관된다는 해석을 뒷받침한다.
연구진은 분류기 실험으로 더 직접적인 검증을 시도했다. 합성곱 신경망 기반 이진 분류기를 열 개씩 세 벌 준비했다. 첫째 벌은 표준 MNIST 훈련 데이터만으로, 둘째 벌은 표준 데이터와 광학 생성 데이터를 절반씩 섞어, 셋째 벌은 광학 생성 데이터만으로 훈련했다. 세 벌 모두 표본 수를 같게 맞췄고, 평가는 표준 MNIST로만 진행했다. 광학 생성 데이터만으로 훈련한 분류기는 평균 99.18%의 정확도를 기록했다. 표준 MNIST로 훈련한 분류기보다 평균 0.4% 낮다.
여기에 클래스별 IS가 높고 FID가 낮다는 결과를 겹쳐 보면, 광학 모델이 목표 분포를 따르면서도 전에 없던 필체를 만들어 낸다고 해석할 수 있다.
회절 효율도 별도로 다뤘다. 회절 효율은 센서에 도달한 총 광 출력을 광변조기 평면에 입사한 총 입력 전력으로 나눈 값이다. 학습 손실에 효율 관련 항을 추가하면 이 값을 끌어올릴 수 있다. 디코딩 층이 하나인 모델은 이미지 품질을 조금 희생하는 대가로 평균 41.8%까지 올라갔고, 디코딩 층을 다섯 개로 늘린 모델은 FID를 100 근처로 유지하면서 평균 50% 정도를 기록했다.
가시광 장치에서의 실험
연구진은 실험 장치를 전부 가시광 영역에서 구성했다. 520nm 레이저(Fianium) 빛을 4f 계로 걸러 내는데, 푸리에 평면에 0.1mm 핀홀을 두었다. 그 다음 선형 편광자로 편광 방향을 광변조기 액정의 동작 방향에 맞춘다. 첫 번째 광변조기가 위상 시드를 표시한다. 이 광변조기는 Meadowlark XY Phase 시리즈이고, 화소 피치는 8μm, 해상도는 1,920×1,200이다. 빔 스플리터를 지난 광파는 두 번째 광변조기가 고정 디코더 역할로 받는다. 이쪽 소자는 HOLOEYE PLUTO-2.1이며, 화소 피치는 8μm, 해상도는 1,920×1,080이다. 출력은 QImaging Retiga-2000R 카메라로 촬영했는데, 이 카메라의 화소 피치는 7.4μm, 해상도는 1,600×1,200이다.
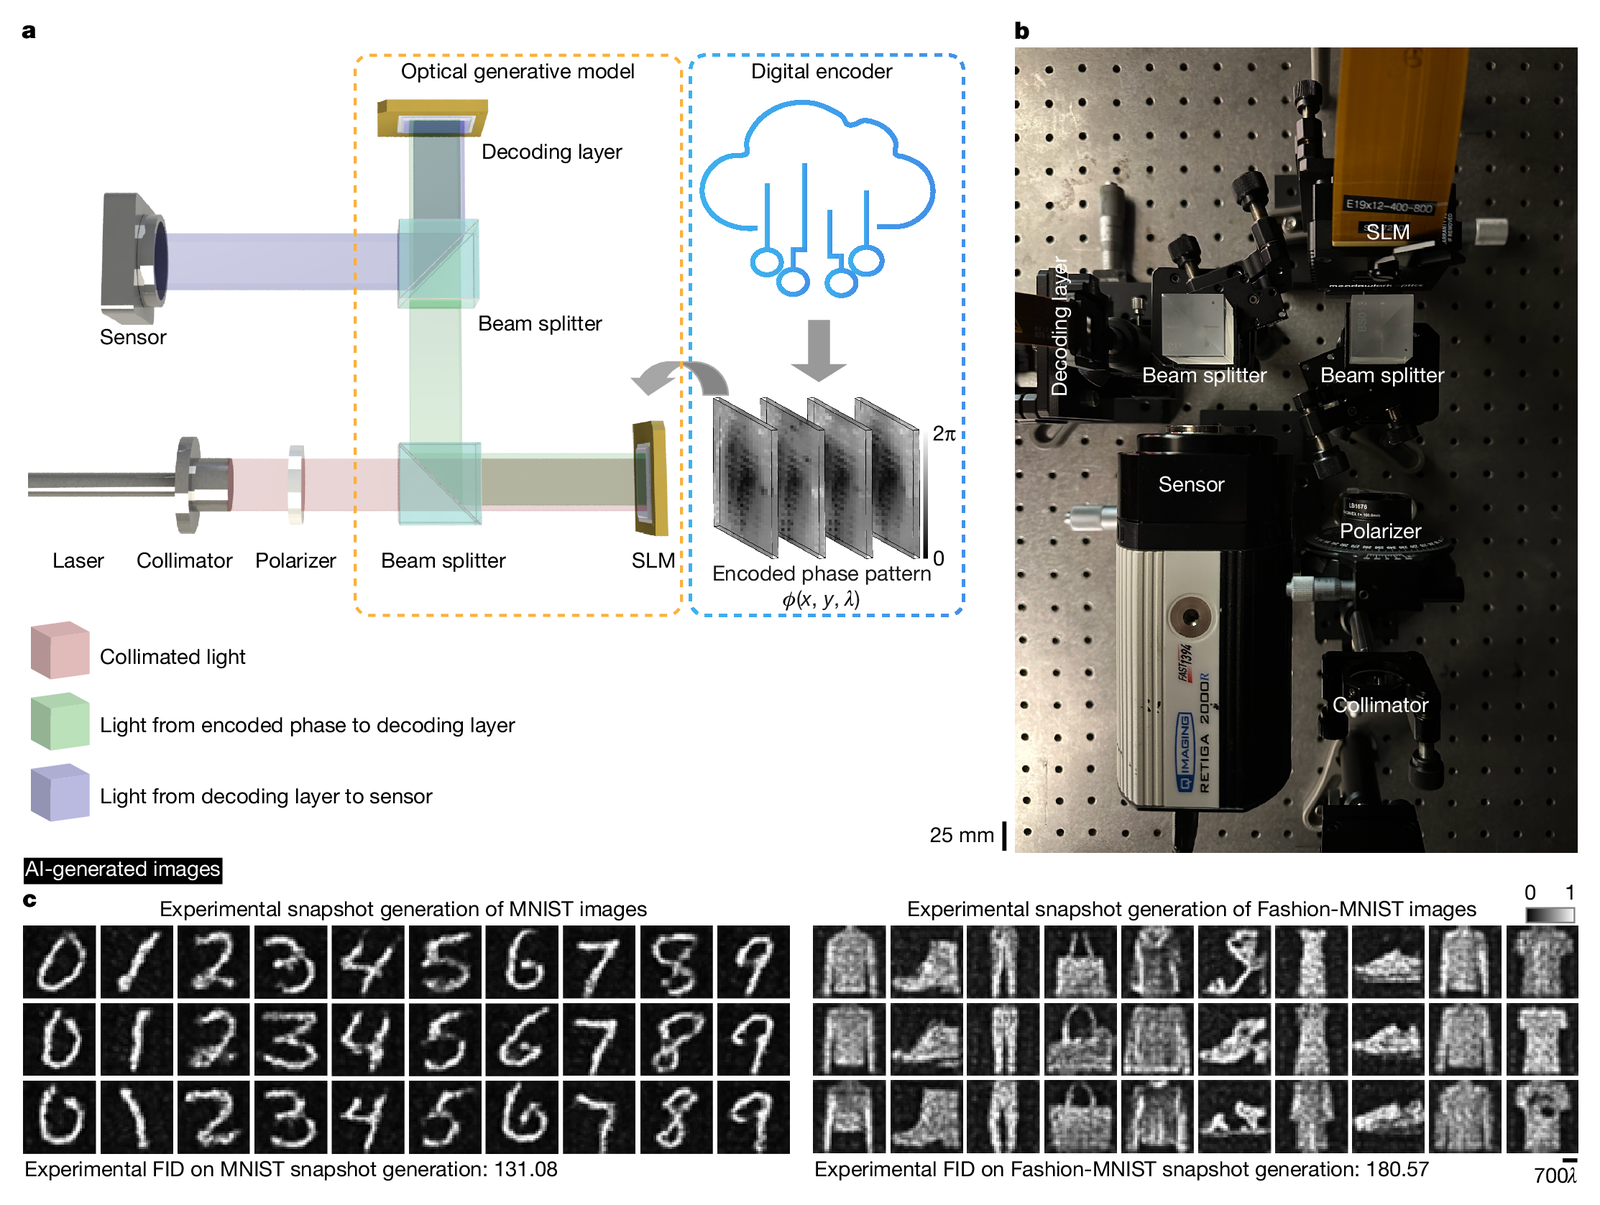 Fig. 3. 스냅샷 광학 생성 모델의 실험적 구현. 출처: Chen et al., Nature (2025), CC BY 4.0
실험으로 측정한 FID는 MNIST에서 131.08, Fashion-MNIST에서 180.57이었다. 전체 추론 시간은 광변조기의 로딩 시간이 좌우한다. 프레임률이 1kHz를 넘는 고속 위상 변조기를 쓰면 이 시간을 줄일 수 있다.
잠재 공간 실험도 따로 했다. 정규분포에서 뽑은 두 입력을 선형 보간하고 클래스 임베딩도 같은 비율로 보간해 넣으면, 생성된 손글씨 숫자가 한 글자에서 다른 글자로 부드럽게 변해 간다. 보간 구간 내내 숫자로 알아볼 수 있는 특징이 유지된다는 점에서, 모델이 연속적이고 정돈된 잠재 표현을 학습했다고 볼 수 있다.
반 고흐풍 작품 생성
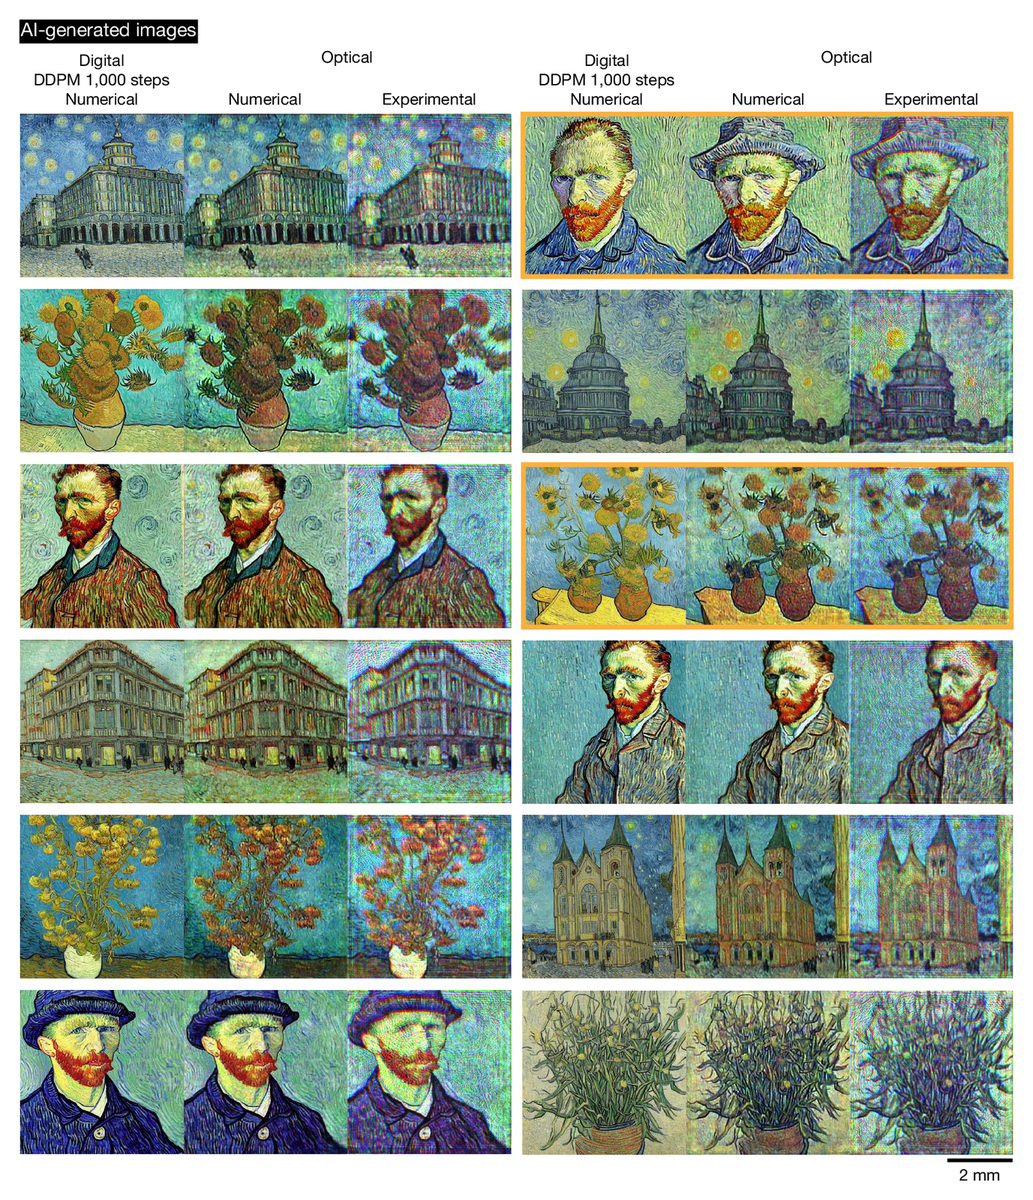
해상도를 올린 실험에서 이 논문의 가장 눈에 띄는 결과가 나왔다. 같은 광학 장치를 쓰되 위상 패턴과 디코딩 층의 해상도를 1,000×1,000으로, 센서 평면을 640×640으로 올렸다. 단색 생성에는 520nm를, 컬러 생성에는 450nm, 520nm, 638nm를 순차적으로 조명했다. 컬러의 경우 파장마다 위상 시드를 따로 만들어 같은 광변조기에 차례로 표시하고, 세 장을 디지털로 합친다. 디코더 상태는 세 파장이 공유한다.
디지털 인코더의 파라미터 수를 4,400만에서 5.8억까지 늘려 가며 비교했고, 본문 도판에 실린 결과는 5.8억 파라미터 인코더를 쓴 것이다. 비교 대상인 교사 확산 모델은 파라미터가 10.7억 개이고, 이미지 한 장을 만들 때 추론 단계를 1,000회 수행한다.
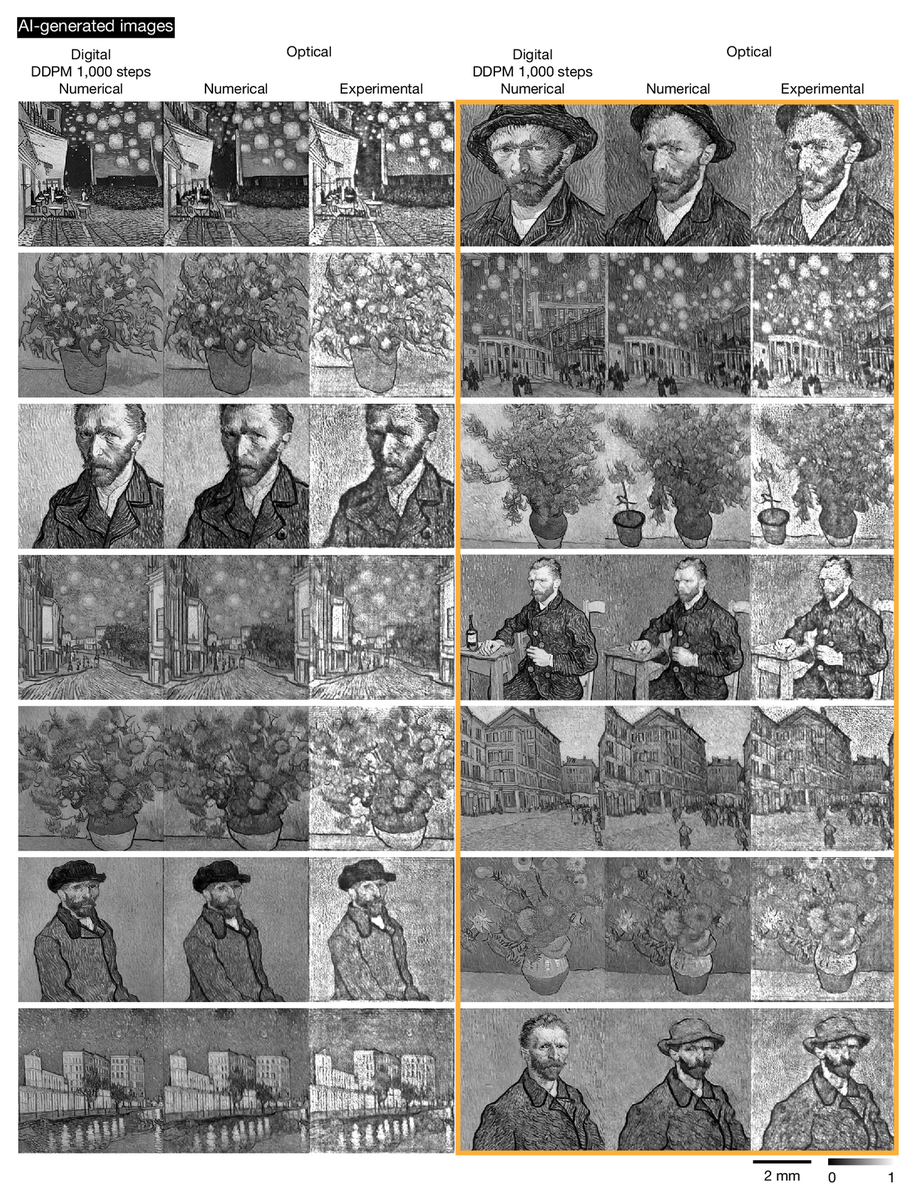 Fig. 4. 고해상도 단색 반 고흐풍 작품 생성. 출처: Chen et al., Nature (2025), CC BY 4.0
결과는 두 갈래로 제시된다. 왼쪽 세 열에서는 광학 모델이 한 번의 통과로 만든 이미지가 1,000단계를 거친 교사 확산 모델의 출력과 거의 같다. 오른쪽 세 열에서는 교사와 다른 그림이 나왔다. 연구진은 앞쪽을 생성 과정의 일관성으로, 뒤쪽을 출력의 창의적 변이성으로 설명했다.
컬러 결과에서는 약간의 색수차가 관찰됐지만 고해상도 이미지의 품질은 유지됐다. 시뮬레이션과 실험 결과 사이의 최대 신호 대 잡음비, 그리고 CLIP 점수를 함께 보고해 화소 수준과 의미 수준 모두에서 일치한다는 것을 보였다. 인증된 반 고흐 그림이 800점 남짓뿐이라 IS나 FID를 계산하는 것은 의미가 없다고 밝혔다.
디코더의 역할을 확인하는 대조 실험도 있다. 같은 디지털 인코더를 쓰되 회절 디코더를 빼고 자유 공간 전파만으로 복호하면, CLIP 점수가 10에서 15 미만으로 내려가며 아예 실패하는 경우가 생긴다. 회절 디코더를 넣은 쪽은 안정적으로 이미지를 만들어 냈다.
반복형 광학 생성 모델
스냅샷 모델과 별개로, 확산 과정을 광학에서 그대로 재현하는 반복형 모델도 만들었다. 센서에 맺힌 강도 이미지에 설계된 분산의 가우시안 잡음을 더해 다음 시간 단계의 광학 입력으로 되먹이는 방식이다. 표준 DDPM은 더해진 잡음을 예측하지만, 이 모델은 잡음이 제거된 표본을 곧바로 예측한다. 손실은 원본 이미지를 기준으로 계산했다.
이쪽 모델은 디코딩 층을 다섯 개 쓰고 층 사이 간격은 20mm로 두었다. 총 시간 단계는 1,000이고, 학습은 RTX 4090 한 장에서 PyTorch 2.21로 진행했다. Butterflies-100과 Celeb-A 데이터셋에 각각 학습시켜 다색 이미지를 생성했다.
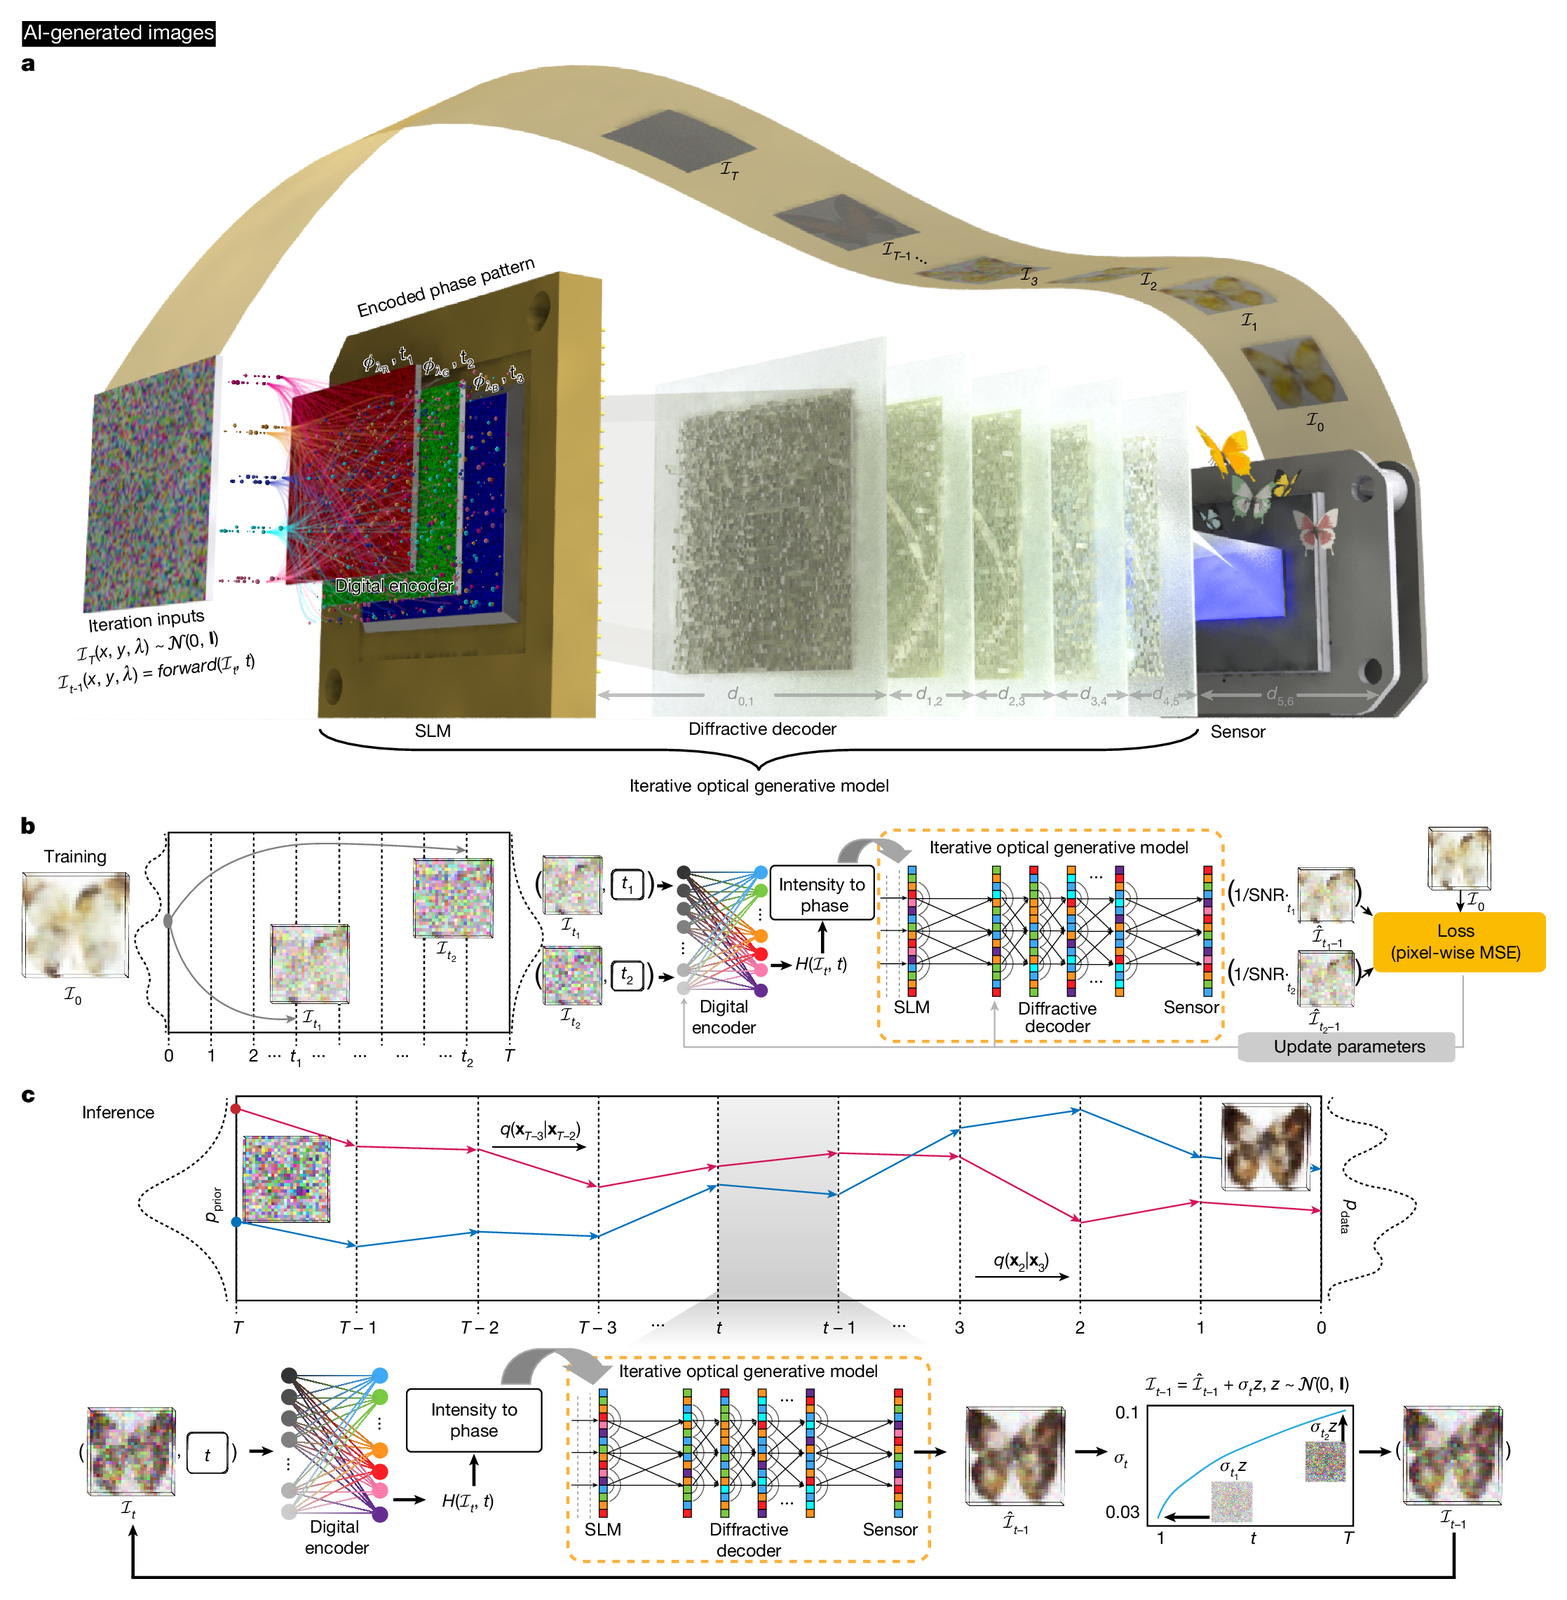 Fig. 2. 반복형 광학 생성 모델. 출처: Chen et al., Nature (2025), CC BY 4.0
반복형 쪽이 스냅샷 다색 생성보다 배경이 깨끗하고 품질이 높았다. 연구진이 강조하는 또 다른 이점은 학습 내내 모드 붕괴를 겪지 않았다는 것이다. 연속된 반복이 분포 매핑 과제를 시간 단계마다 독립된 가우시안 과정으로 분해하기 때문이라고 설명한다.
흥미롭게도 디지털 인코더를 아예 빼고 학습시킨 반복형 모델도 사람 얼굴 이미지를 만들어 냈다. 광변조기에서 강도를 위상으로 바꾸는 변환과 이미지 센서에서 일어나는 광전 변환만으로도 복잡한 영역 간 변환이 이뤄졌다. 물론 인코더를 함께 학습시킨 쪽보다 성능과 다양성은 떨어졌다.
반면 스냅샷 다색 모델에는 생성 실패가 관찰됐다. 추정 잡음 분산이 경험적 임계값 0.015를 넘으면 실패로 분류했는데, Butterflies-100에서 3.3%, Celeb-A에서 6.8%였다. 이 실패율은 학습을 오래 진행할수록 심해졌다. 출력이 반복적인 특징으로 제한되는 모드 붕괴와 비슷한 현상이다.
에너지 계산서
논문은 에너지 비교를 꽤 꼼꼼하게 했다. 광학 생성 모델에서 전력을 쓰는 곳은 전자식 인코더 신경망, 입력 광변조기, 조명광, 회절 디코더의 네 군데다.
| 항목 | 이미지 한 장당 에너지 |
|---|---|
| 인코더 연산 (MNIST, Fashion-MNIST) | 0.003~0.033 mJ (6.29 MFLOPs, 0.5~5.5 pJ/FLOP 기준) |
| 인코더 연산 (반 고흐풍, 5.8억 파라미터) | 1.13~12.44 J |
| 입력 광변조기 (60Hz, 1.9~3.5 W) | 약 30~58 mJ, 최신 소자로는 2.5 mJ 미만 |
| 조명광 (파장 채널당) | 0.8 mJ 미만 |
| 이미지 센서로 디지털화할 경우 | 약 2~4 mJ |
디지털 확산 모델 쪽 계산서는 다음과 같다. MNIST와 Fashion-MNIST 생성에는 약 287.68 GFLOPs가 들어가고, 이를 전력으로 환산하면 장당 0.14~1.58 J이다. 반 고흐풍 작품에는 530.26 TFLOPs가 들어가서 장당 265~2,916 J이 필요하다. 연구진은 추론을 20배 가속하는 DDIM 기준도 함께 계산했는데, 그 경우 각각 7~79 mJ과 13.25~145.8 J이 든다. 여기에 생성된 이미지를 모니터에 띄운다면 60Hz 기준으로 장당 13~500 mJ이 추가된다.
연구진은 이 비교에서 조건을 분명히 한다. 생성된 이미지를 디지털 영역에 저장하고 후처리해야 한다면, 광학 모델은 디지털과 아날로그 사이를 오가는 변환 단계 때문에 전력과 속도에서 손해를 본다. 반대로 생성된 이미지가 아날로그 영역에 머물러 사람이 직접 보는 용도라면, 예컨대 근안 디스플레이나 머리 착용형 장치라면, 위상 시드를 미리 계산해 두는 비용만 치르고 나머지를 빛에 넘길 수 있다.
남은 제약과 확장 가능성
첫 번째 제약은 광학 장치의 정렬 오차와 물리적 불완전성에서 온다. 두 번째로 위상 변조 소자의 비트 심도가 제한된다. 연구진은 비트 심도 제한을 학습 과정의 순방향 모델에 직접 넣으면 성능이 상당 부분 회복된다는 것을 보였다.
이 분석에서 나온 결론 하나가 응용 측면에서 중요하다. 디코더 표면은 특징당 위상 준위가 세 개(0, 2π/3, 4π/3)만 있어도 충분했다. 2광자 중합이나 광 리소그래피 기반 나노 가공은 특징당 2에서 16개의 이산 위상 준위를 무난히 만들어 내므로, 두 번째 광변조기를 수동형 박막 표면으로 대체할 수 있다. 그렇게 되면 장치는 더 작고 가볍고 싸진다.
인코딩 방식에 대한 대조 실험도 있다. 위상 인코딩 대신 진폭이나 강도로 인코딩한 모델은 손글씨 숫자에서 FID가 더 나빴고, 반 고흐풍 작품에서는 일관된 고해상도 출력을 만들어 내지 못했다. 연구진은 위상 패턴의 선형 결합이 출력에서 선형 중첩으로 나타나지 않기 때문에 위상 인코딩 자체가 비선형 정보 부호화 기제로 작동한다고 설명한다.
연구진은 확장 가능성으로 다중화 실험을 함께 제시했다. 같은 위상 패턴을 서로 다른 파장으로 비추되, 올바르게 짝지어진 회절 디코더만 해당 파장 채널의 정보를 복원할 수 있게 설계했다. 디코더가 물리적 보안 키 역할을 하는 셈이다. 인코더와 디코더가 한 쌍으로 설계되고 디코더를 나노 가공으로 만들면, 설계 파일 없이 역설계하거나 복제하기 어렵다.
내가 눈여겨본 것
교사 확산 모델의 1,000단계를 광학 한 번의 통과로 압축했다는 결과보다, 그 압축이 어디까지 유지되는지를 밝힌 부분이 기억에 남는다. 어떤 시드에서는 광학 모델이 교사와 거의 같은 그림을 만들고, 어떤 시드에서는 전혀 다른 그림을 만든다. 논문은 앞쪽을 일관성으로, 뒤쪽을 창의적 변이성으로 각각 긍정적으로 읽는다. 증류 모델을 평가하면서 교사와의 일치와 교사로부터의 이탈을 동시에 미덕으로 놓을 수 있는 과제가 생성 말고 또 있을까 싶다.
또 하나는 에너지 비교에 붙은 단서 조항이다. 광학 생성 모델이 압도적으로 유리한 구간은 결과물이 디지털로 돌아오지 않는 경우로 한정된다. 센서로 디지털화하는 순간 장당 2에서 4 mJ이 추가되고, 변환 단계의 지연도 따라붙는다. 근안 디스플레이와 머리 착용형 장치를 논문이 거듭 언급하는 것은 이 조건을 만족하는 응용이 그쪽이기 때문이다. 범용 생성 모델을 대체하겠다는 주장으로 읽으면 어긋난다. 생성된 그림이 사람 눈으로 곧장 가는 용도에 한해 성립하는 이야기다. 연구진이 스스로 붙인 광학 예술가라는 표현이 그 범위를 잘 보여 준다.
마지막으로 디코더 표면의 위상 준위가 세 개면 충분하다는 결과를 덧붙이고 싶다. 이 결과 덕분에 두 번째 광변조기가 유리판 한 장으로 바뀔 수 있다. 실험실 광학대 위의 시연이 제품 부품으로 이어지는 경로를 논문이 직접 제시한 셈이다.
출처
Shiqi Chen, Yuhang Li, Yuntian Wang, Hanlong Chen, Aydogan Ozcan, “Optical generative models”, Nature, 2025년 8월 27일 온라인 게재. UCLA 아이도간 오즈잔 연구실.
논문은 Creative Commons Attribution 4.0 International 라이선스로 공개되어 있으며, 본문에 인용한 도판은 같은 라이선스에 따라 원문에서 가져왔다. 학습 및 테스트 코드는 Zenodo에 공개되어 있다.
원문: https://www.nature.com/articles/s41586-025-09446-5 코드: https://zenodo.org/records/15446687