3줄 요약
- OpenUI가 2026년 9월 8일에 OUI-1을 공개했다. 구글의 확산 언어 모델 DiffusionGemma를 파인튜닝하여 인터페이스 기술 언어인 openui-lang을 쓰도록 만든 모델이다. 전체 파라미터 26B 가운데 토큰마다 4B만 쓰고, 가중치는 Apache 2.0 라이선스로 허깅페이스에 올라와 있다.
- 기준이 된 DiffusionGemma는 Generative UI Benchmark에서 13.0%를 받았다. 지도 파인튜닝만으로는 스키마 오류와 배선 오류 중 하나가 줄면 다른 하나가 늘었고, 생성 시간도 1.6초에서 4.3초로 길어졌다. 파서를 보상 함수로 쓰는 자기 증류를 넣고 나서야 두 오류가 함께 줄고 속도도 1.9초까지 돌아왔다.
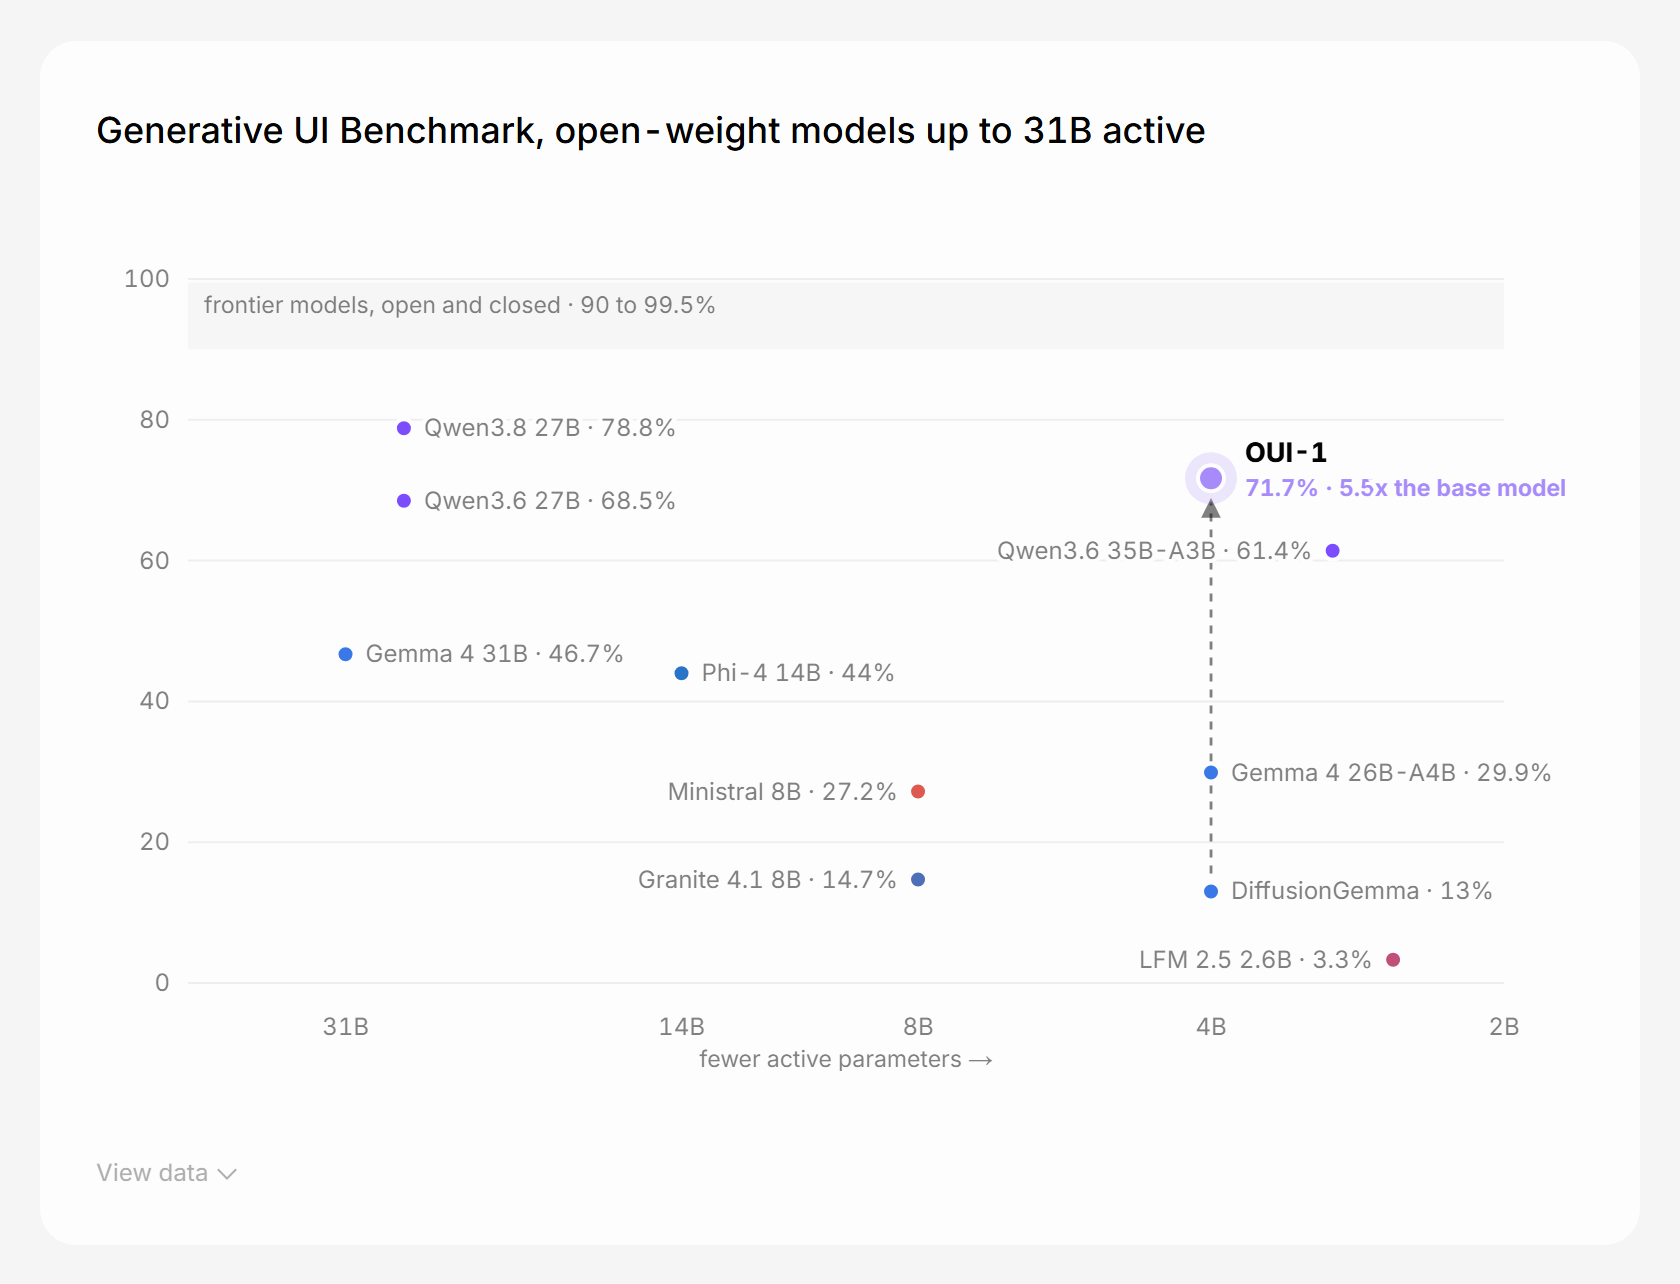
- OUI-1의 최종 점수는 71.7%로 기준 모델의 5.5배가 되었다. 활성 파라미터가 4B 이하인 공개 모델 가운데 이보다 높은 점수를 받은 모델은 없었다. 더 높은 점수는 토큰마다 27B를 전부 쓰는 밀집 모델에서만 나왔다.
OUI-1이라는 모델
OUI-1은 DiffusionGemma를 파인튜닝한 모델이고, openui-lang이라는 언어로 사용자 인터페이스를 작성한다. 전체 파라미터는 26B지만 토큰 하나를 처리할 때 실제로 쓰이는 것은 4B다. OpenUI는 이 구성을 26BA4B로 표기했다. FP8 양자화를 적용하면 RTX 5090 같은 소비자용 GPU 한 장에서 돌아간다고 밝혔다. 가중치는 허깅페이스에 thesysdev/OUI-1로 공개되어 있으며, 라이선스는 기반 모델과 같은 Apache 2.0이다.
무엇을 풀려고 했나
OpenUI는 에이전트가 만들어 내는 인터페이스를 소프트웨어의 미래로 본다. 이 미래를 현실로 만들려면 세 가지 조건을 동시에 만족해야 한다고 정리했다.
- 인터페이스가 1초 안에 생성되어야 한다.
- 소프트웨어로 쓸 수 있을 만큼 결과가 안정적이어야 한다.
- 모델이 소비자용 하드웨어에서 돌아갈 만큼 작아야 한다.
OpenUI가 이런 경험을 만들어 본 것은 이번이 처음이 아니다. AppLess라는 프로젝트에서 Cerebras 위에 올린 Gemma 4로 같은 그림을 이미 보여 주었다. 그런데 그 구현은 클라우드에 있는 특수 하드웨어에 기대고 있었다. 같은 반응 속도를 사용자의 기기에서 내려면 훨씬 적은 연산으로 같은 품질과 정확성을 얻어야 하는데, OpenUI는 이것이 더 어려운 문제라고 적었다.
왜 DiffusionGemma였나
언어 쪽 준비는 끝나 있었다. openui-lang은 같은 인터페이스를 JSON으로 적을 때보다 토큰을 최대 67%까지 덜 쓴다. 게다가 스트리밍을 전제로 설계되어, 모델이 생성을 끝내기 전부터 화면에 인터페이스가 나타나기 시작한다. 남은 문제는 이 언어를 충분히 빠르게 작성하면서도 충분히 작은 하드웨어에서 돌아가는 모델을 찾는 것이었다.
자기회귀 모델은 토큰을 하나씩 만들어 내기 때문에 메모리 대역폭에서 병목이 생긴다. DiffusionGemma는 다르게 동작한다. 잡음에서 시작해 256토큰 블록 전체를 한꺼번에 생성하고, 각 토큰은 모델이 확신하는 순간에 확정된다. 구글은 H100 한 장에서 초당 1,000토큰이 넘고 RTX 5090에서도 700토큰이 넘는다고 보고했다.1
속도는 이렇게 확보되었다. 그러나 속도만으로는 소프트웨어가 되지 않는다. 생성된 인터페이스가 실제로 동작해야 하는데, OpenUI가 메워야 했던 구멍이 바로 여기였다.
출발점의 점수
DiffusionGemma는 Generative UI Benchmark에서 13.0%를 받았다. 속도와 하드웨어 조건은 원하던 대로였지만 안정성이 따라오지 않았다.
openui-lang의 파서가 있어서 실패의 종류를 구분할 수 있었다. OpenUI는 오류를 두 갈래로 나누어 놓았다.
- 스키마 오류는 정해진 항목에 없는 값을 쓰거나, 필수 속성을 빠뜨리거나, 존재하지 않는 컴포넌트를 지어낸 경우다.
- 배선 오류는 이름을 쓰긴 했는데 어디에도 정의하지 않았거나, 섹션을 정의해 놓고 루트에 붙이지 않은 경우다.
속도를 잃지 않으면서 이 두 오류를 함께 줄이는 것이 이후 작업의 목표가 되었다.
1단계, 지도 파인튜닝
OpenUI는 더 큰 모델들이 작성한 openui-lang 예제 약 700개로 시작했다. 예제는 7개 컴포넌트 라이브러리에 걸쳐 있었다. 학습은 A100 한 장에서 LoRA 파인튜닝으로 진행했다. 손실은 내려갔다. 그런데 벤치마크 점수도 같이 내려갔다. 모델은 더 길고 빽빽한 프로그램을 쓰도록 학습되었다. 하지만 그 프로그램 가운데 파서를 깨끗하게 통과하는 사례는 거의 없었다.
그래서 범위를 벤치마크가 쓰는 컴포넌트 라이브러리 하나로 좁혔다. 점수는 13.0%에서 28.8%로 올라갔다. 그러나 여기서 다른 문제가 드러났다. 한 차례 학습을 돌리면 배선 오류가 줄고 스키마 오류가 늘었다. 다음 차례에는 정반대가 나타났다.
| 실행 | 스키마 오류 | 고아 섹션 |
|---|---|---|
| n | 78 | 66 |
| n + 1 | 112 | 40 |
| n + 2 | 51 | 65 |
두 오류는 시소처럼 움직였다. 기준 모델보다는 확실히 나았지만, 둘을 함께 끌어내린 실행은 한 번도 없었다. OpenUI는 이것을 LoRA의 용량 한계로 추정했다. LoRA로는 모델이 한 번에 한 가지 규칙만 익힐 수 있고, 전체 파인튜닝으로 넘어가면 이 맞교환이 풀릴 것이라고 보았다.
그리고 두 번째 문제가 나타났다. 모델이 느려져 있었다. 샘플러는 엔트로피가 기준 아래로 떨어지면 토큰을 확정한다. 따라서 언어를 잘 아는 모델일수록 더 일찍 확신에 도달해 빨라져야 했다. 실제로는 반대였다. 똑같은 가벼운 요청 20개를 주었을 때 출력 하나에 걸리는 시간이 1.6초에서 4.3초로 늘어났다.
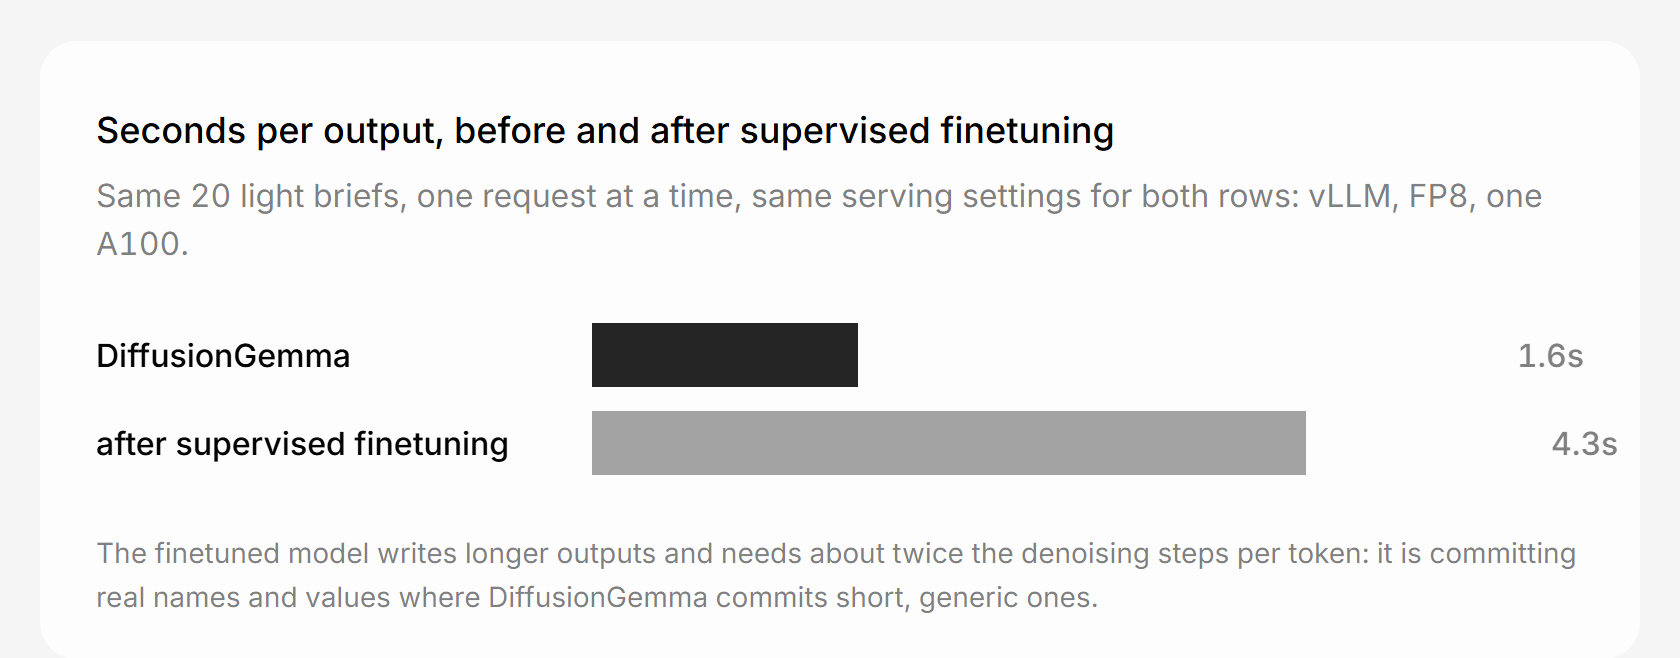
출력의 성격이 달라졌기 때문이다. 기준 모델은 문장당 평균 22토큰으로 짧고 일반적인 값을 썼기 때문에 빨랐다. 파인튜닝한 모델은 실제 이름과 값을 넣으면서 문장당 평균 32토큰을 썼고, 토큰 하나를 확정하는 데 약 두 배의 잡음 제거 단계가 필요했다. 더 쓸모 있는 인터페이스를 만들도록 가르친 대가로, DiffusionGemma를 고른 이유였던 속도를 잃고 말았다.
2단계, 자기 증류
전환점은 openui-lang에 검증 가능한 보상이 있다는 것을 알아차린 순간에 왔다. 파서는 인터페이스가 구조적으로 유효한지 판단할 수 있다. 유효하지 않다면 스키마 오류인지 배선 오류인지도 지목할 수 있다. 모델이 스스로의 교사가 될 수 있다는 뜻이다. 프로그램을 생성하고, 파서의 피드백으로 살리거나 고치고, 그 결과에서 다시 배우면 된다. 자기 증류는 확산 언어 모델의 잡음 제거 단계를 줄이는 방법으로도 이미 알려져 있었기 때문에, 잃어버린 속도를 되찾을 길이기도 했다.23
OpenUI가 쓴 방식은 거부 샘플링에 기반한 자기 학습에 수선 단계를 더한 것이다.
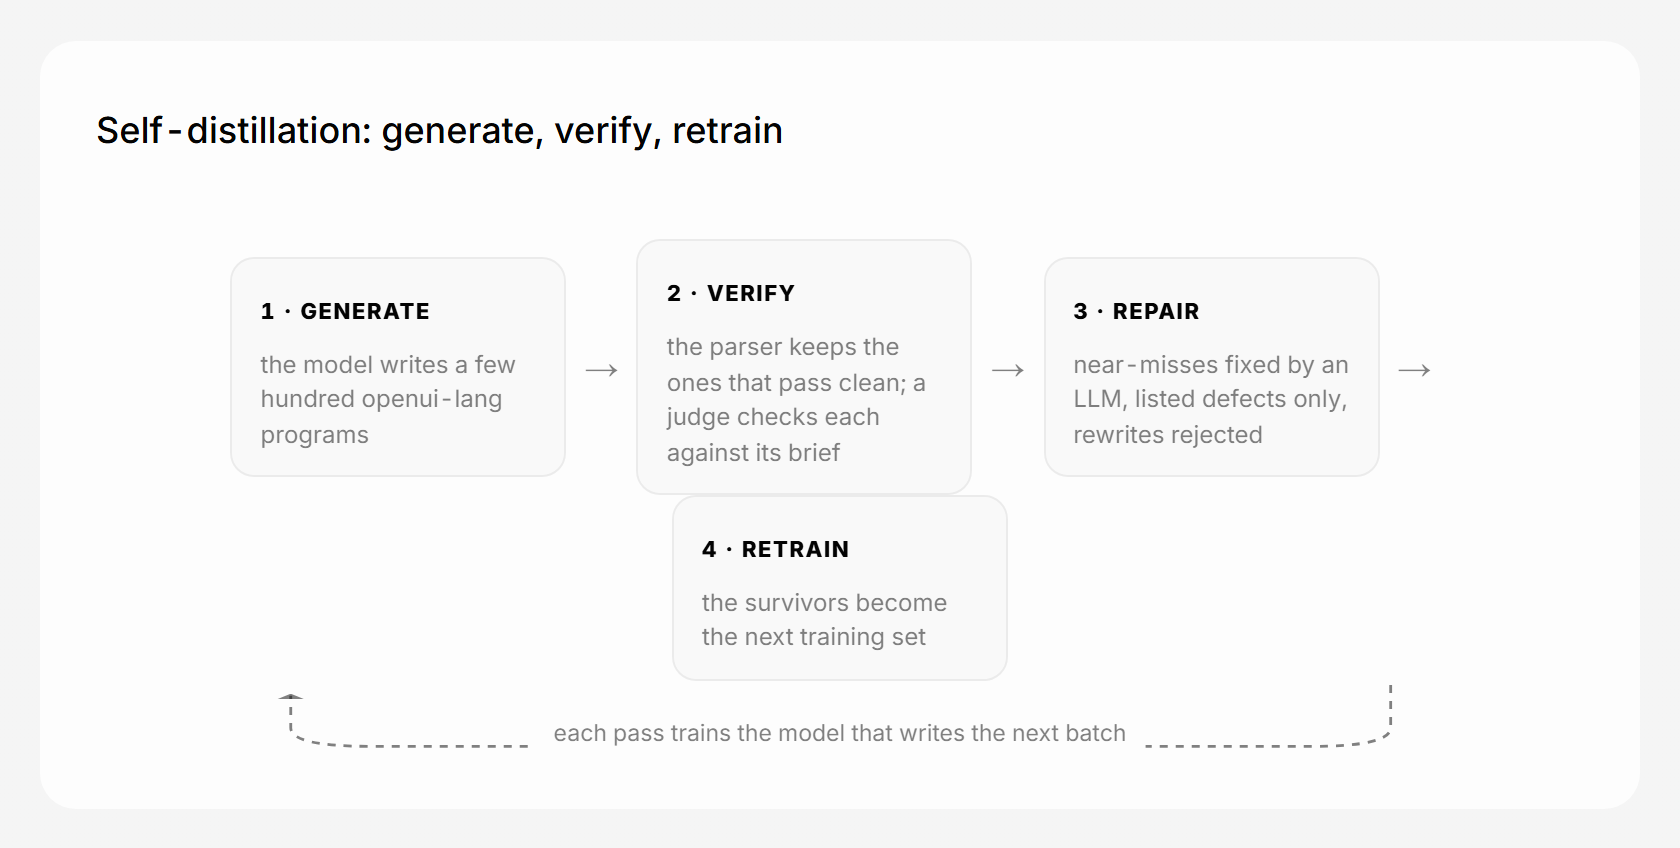
모델이 openui-lang 프로그램을 수백 개 쓰면 파서가 통과시킨 것만 남긴다. 아깝게 실패한 것은 수선 단계로 넘어가는데, 이때 고치는 범위는 파서가 지목한 결함뿐이다. 프로그램을 다시 쓰거나 없던 것을 지어내는 수정은 거부된다. OpenUI는 수선의 중앙값이 문장 하나를 바꾸는 정도였다고 적었다. 그다음에는 판정자가 살아남은 프로그램이 원래 요청과 맞는지 확인한다. 이렇게 걸러진 프로그램이 다음 실행의 학습 집합이 된다. 500스텝 학습은 A100 한 장에서 한두 시간이 걸린다. 학습을 마친 모델은 다음 묶음을 생성하고, 순환은 다시 시작된다.
속도가 돌아왔다. 같은 요청 20개에서 출력당 생성 시간이 4.3초에서 1.9초로 떨어졌다. 출력 토큰 수는 DiffusionGemma보다 28% 더 많았는데도 그랬다. 그리고 시소가 멈췄다. 벤치마크 점수는 57.1%에 도달했고, 같은 모델에서 스키마 오류가 292개에서 76개로, 배선 오류가 971개에서 484개로 내려갔다. 이전의 모든 실행이 한 오류를 다른 오류와 맞바꾸었던 것과 달리, 자기 증류는 둘을 함께 개선했다.
OpenUI는 이것이 가장 단순한 형태의 강화학습이라고 설명했다. 파서가 보상 함수를 맡은 거부 샘플링이라고 보면 된다. 왜 이것이 통하는지에 대해서는 검증되지 않은 가설을 하나 내놓았다. 모델 자신이 쓴 텍스트로 학습하면 손실은 거의 모든 곳에서 낮게 유지된다. 따라서 기울기는 달라진 몇 곳에만 몰린다는 설명이다. 그 몇 곳이란 수선된 문장, 그리고 샘플링이 최빈값 쪽으로 기울어진 자리다. 앞의 것은 배선을 고치는 법을 가르친다. 뒤의 것은 모델을 날카롭게 만들어, 엔트로피 기준에 더 일찍 도달하고 토큰도 더 일찍 확정되게 한다. 반면 교사 모델이 쓴 데이터로 학습하면 그 기울기가 전혀 다른 문체 전반으로 흩어진다.
3단계, 27개 라이브러리로
라이브러리 하나에서 나온 결과는 질문을 하나 남겼다. 모델이 인터페이스를 만드는 법 자체를 익혔을 수도 있고, 컴포넌트 라이브러리 하나를 통째로 외웠을 수도 있었다. OpenUI는 지도 파인튜닝과 자기 증류라는 같은 방법을 27개 컴포넌트 라이브러리에 그대로 적용했다.
결과
그렇게 나온 모델이 OUI-1이다. Generative UI Benchmark 점수는 71.7%로, DiffusionGemma의 13.0%에서 5.5배가 되었다.
활성 파라미터 31B 이하의 공개 모델 가운데 OUI-1보다 높은 점수를 받은 모델은 하나뿐이었다. 그 모델은 Qwen3.8 27B로, 점수는 78.8%였다. Gemma 4 31B는 46.7%에 그쳤다. 그런데 Qwen3.8은 밀집 모델이라 토큰 하나마다 27B를 전부 쓴다. OUI-1의 활성 파라미터는 4B다. 활성 4B 이하에서 OUI-1보다 높은 점수는 없었고, 더 높은 점수를 보려면 밀집 27B까지 올라가야 했다.
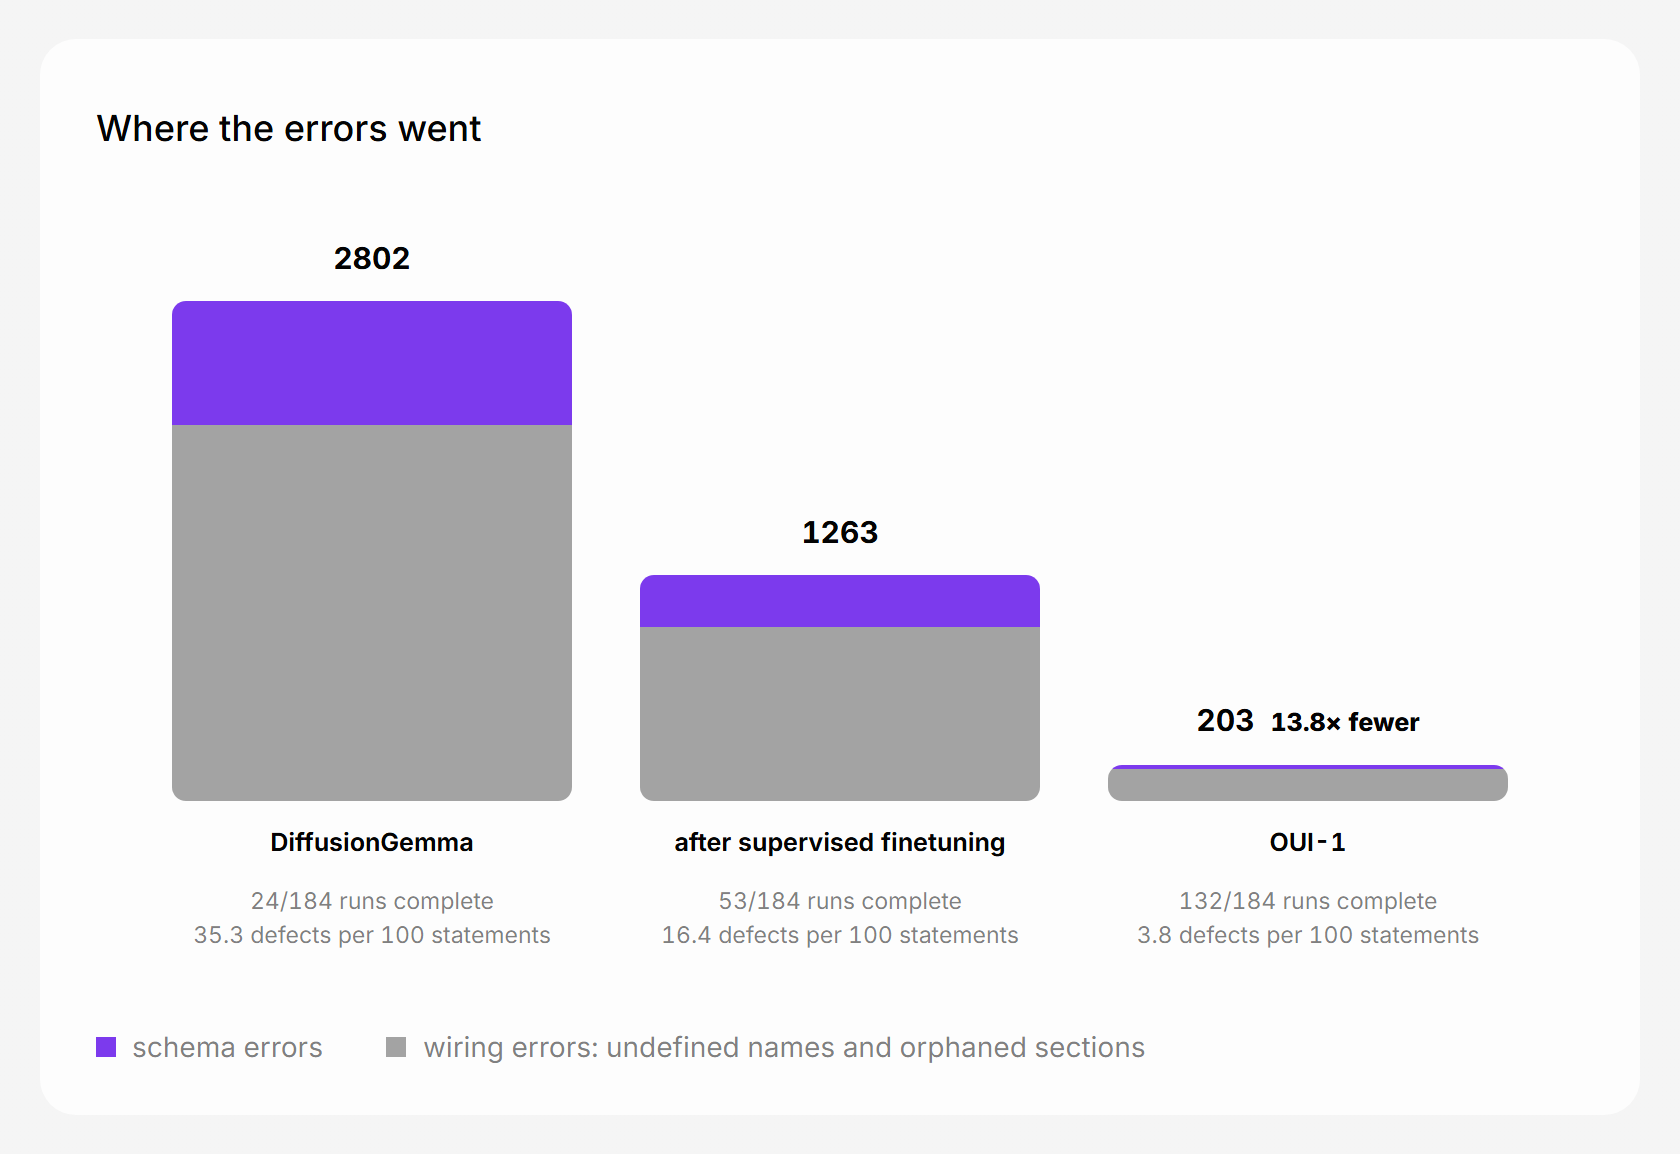
오류 자체도 크게 줄었다. 벤치마크는 모두 184회 실행됐다. 이 가운데 끝까지 수행한 횟수는 DiffusionGemma 24회, 지도 파인튜닝 후 모델 53회, OUI-1 132회였다. 문장 100개당 결함 수는 35.3개에서 16.4개를 거쳐 3.8개로 내려갔다.
벤치마크가 쓰는 라이브러리 밖에서도 성능이 유지되는지 확인하려고, OpenUI는 AppLess 라이브러리에 속한 요청 60개를 시험했다. 이 요청들은 학습에 한 번도 쓰이지 않았다. OUI-1은 55개의 유효한 출력을 냈고, DiffusionGemma는 23개를 냈다.
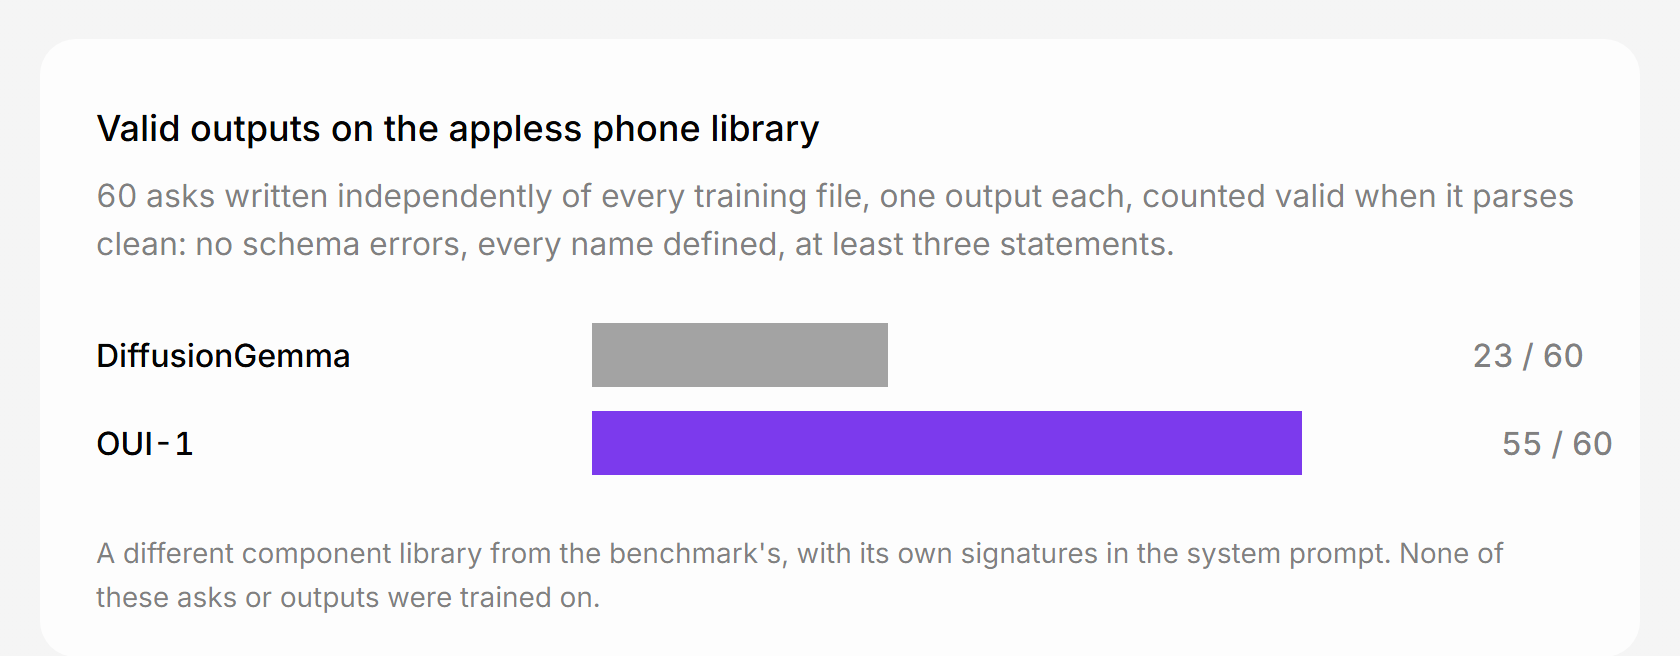
처음에 Cerebras 위의 Gemma 4에 기대고 있던 AppLess는 이제 OUI-1 위에서 돌아간다. 특수 추론 하드웨어가 있어야 가능했던 경험이, 소비자용 하드웨어를 겨냥해 만든 활성 4B 공개 모델 위로 옮겨갔다.
앞으로의 세 방향
OpenUI는 다음 과제로 세 가지를 꼽았다.
- 개인 기기. OUI-1 같은 모델을 사용자 가까이에서 돌려서, 사용자의 맥락을 기기 안에 더 많이 남긴다.
- OpenUI Lang 0.5. 인터페이스가 자체 상태와 질의, 변경을 갖게 해서 상호작용 하나하나를 모델 대신 런타임이 처리하게 한다.
- 더 낮은 지연. 로컬에서 생성되는 인터페이스가 1초 안에 도착하게 만든다.
가장 흥미로운 지점
내가 가장 눈여겨본 것은 파인튜닝이 모델을 느리게 만들었다는 대목이다. 확산 언어 모델의 샘플러는 확신이 서면 토큰을 확정한다. 그러니 언어를 더 잘 알게 된 모델은 더 빨라져야 맞다. 그런데 실제로는 두 배 넘게 느려졌고, 그 원인은 모델이 더 유용해졌다는 데 있었다. 기준 모델은 짧고 일반적인 값을 내놓았기 때문에 빨랐다. 쓸 만한 이름과 값을 내놓기 시작한 모델은 확정해야 할 것이 많아져서 느려졌다. 품질 개선의 대가가 속도 저하로 나타난 것인데, 이런 종류의 맞교환은 발표문에 잘 실리지 않는다.
그다음으로 눈에 띈 것은 파서를 보상 함수로 쓴 방식이다. 코드 생성에서 컴파일러를 보상으로 쓰는 시도는 이미 여럿 있었지만, 여기서 대상이 되는 것은 인터페이스 기술 언어다. 화면에 무엇이 그려지는지까지 파서가 판단하지는 못한다. 그래서 OpenUI는 구조 검증을 파서에 맡기고, 요청과의 일치 판단은 별도의 판정자에게 넘겼다. 기계적으로 확인할 수 있는 부분과 그렇지 않은 부분을 갈라 놓은 구성이다. 검증 가능한 보상이 존재하는 좁은 영역에서 작은 모델이 어디까지 갈 수 있는지를 보여 주는 사례로 읽힌다.
아쉬운 점도 하나 있다. OpenUI는 자기 증류가 왜 통했는지를 가설로만 남겨 두었고, 분리해서 검증하지는 않았다고 분명히 밝혔다. 속도 회복과 오류 감소가 같은 원인에서 나왔는지, 아니면 서로 다른 이유로 함께 일어났는지는 이 글만으로는 알 수 없다.
출처
OpenUI, “Introducing OUI-1: world’s first model for Generative UI”, 2026년 9월 8일. 원문: https://www.openui.com/blog/oui-1
모델 가중치: https://huggingface.co/thesysdev/OUI-1 벤치마크와 채점 코드: https://github.com/thesysdev/Generative-ui-bench
본문 도표는 원문 페이지에서 갈무리했다.