3줄 요약
- OpenAI가 2026년 9월 8일(현지 시각) ChatGPT Images 2.5를 공개했다. 회사는 이 모델이 참조 사진 속 인물을 더 잘 보존하고, 여러 번 이어지는 편집 지시를 더 안정적으로 따른다고 설명했다. 생성 지연은 Images 2.0보다 최대 50% 줄었다고 덧붙였다.
- 이번 공지에서 새로 선보인 것은 대부분 제품 기능이다. ChatGPT 안에서 직접 그린 낙서를 참조로 쓰는 Sketch가 들어갔다. 포스터와 굿즈 같은 형식을 골라 시작하는 템플릿, 이미지 위에 바로 다는 코멘트, 완성한 이미지와 프롬프트를 함께 넘겨 주는 공유 기능도 추가됐다.
- API에서는 GPT-Image-2.5 Flare와 GPT-Image-2.5 Sunburst 두 모델을 쓸 수 있게 됐다. 공개된 가격표를 보면 두 모델의 요율이 소수점까지 같다. 어느 쪽을 쓸지는 생성 지연과 편집 통제력만 놓고 정하게 된다.
무엇이 나왔는가
OpenAI는 ChatGPT Images와 API의 GPT-Image 계열 모델에서 매주 30억 장이 넘는 이미지가 만들어진다고 밝혔다. 회사가 스스로 집계한 값이며 외부 감사를 거친 수치는 아니다. 그 규모를 먼저 내놓은 다음, 회사는 Images 2.5를 현재 최고 수준의 이미지 모델이라고 소개했다.
공지가 내세운 개선은 네 가지로 정리된다.
- 참조 사진 속 인물이 새 배경과 화풍으로 옮겨 가도 더 알아보기 쉬운 모습으로 남는다.
- 조명과 질감이 더 자연스러워졌다.
- 여러 차례 이어지는 편집 지시를 더 안정적으로 따른다.
- 생성 지연이 Images 2.0보다 최대 50% 줄었다.
Images 2.5는 공지 당일부터 ChatGPT, ChatGPT Work, Codex의 모든 사용자에게 열린다. 요금제와 관계없이 데스크톱과 모바일, 웹에서 쓸 수 있다.
모델은 무엇이 달라졌다고 하는가
첫째로 회사가 힘주어 설명한 것은 참조 사진의 재현이다. 사람과 장소, 기억을 담은 사진을 다른 배경이나 화풍으로 바꿔도 인물이 더 알아보기 쉬운 모습으로 남는다고 한다. 조명과 질감은 더 자연스러워지고, 특징적인 부분이 결과에 반영될 가능성도 높아졌다는 설명이 붙었다. API로 제품을 만드는 팀에는 이런 특성이 참조 이미지를 중심에 둔 작업 흐름의 안정성으로 이어진다고 덧붙였다.
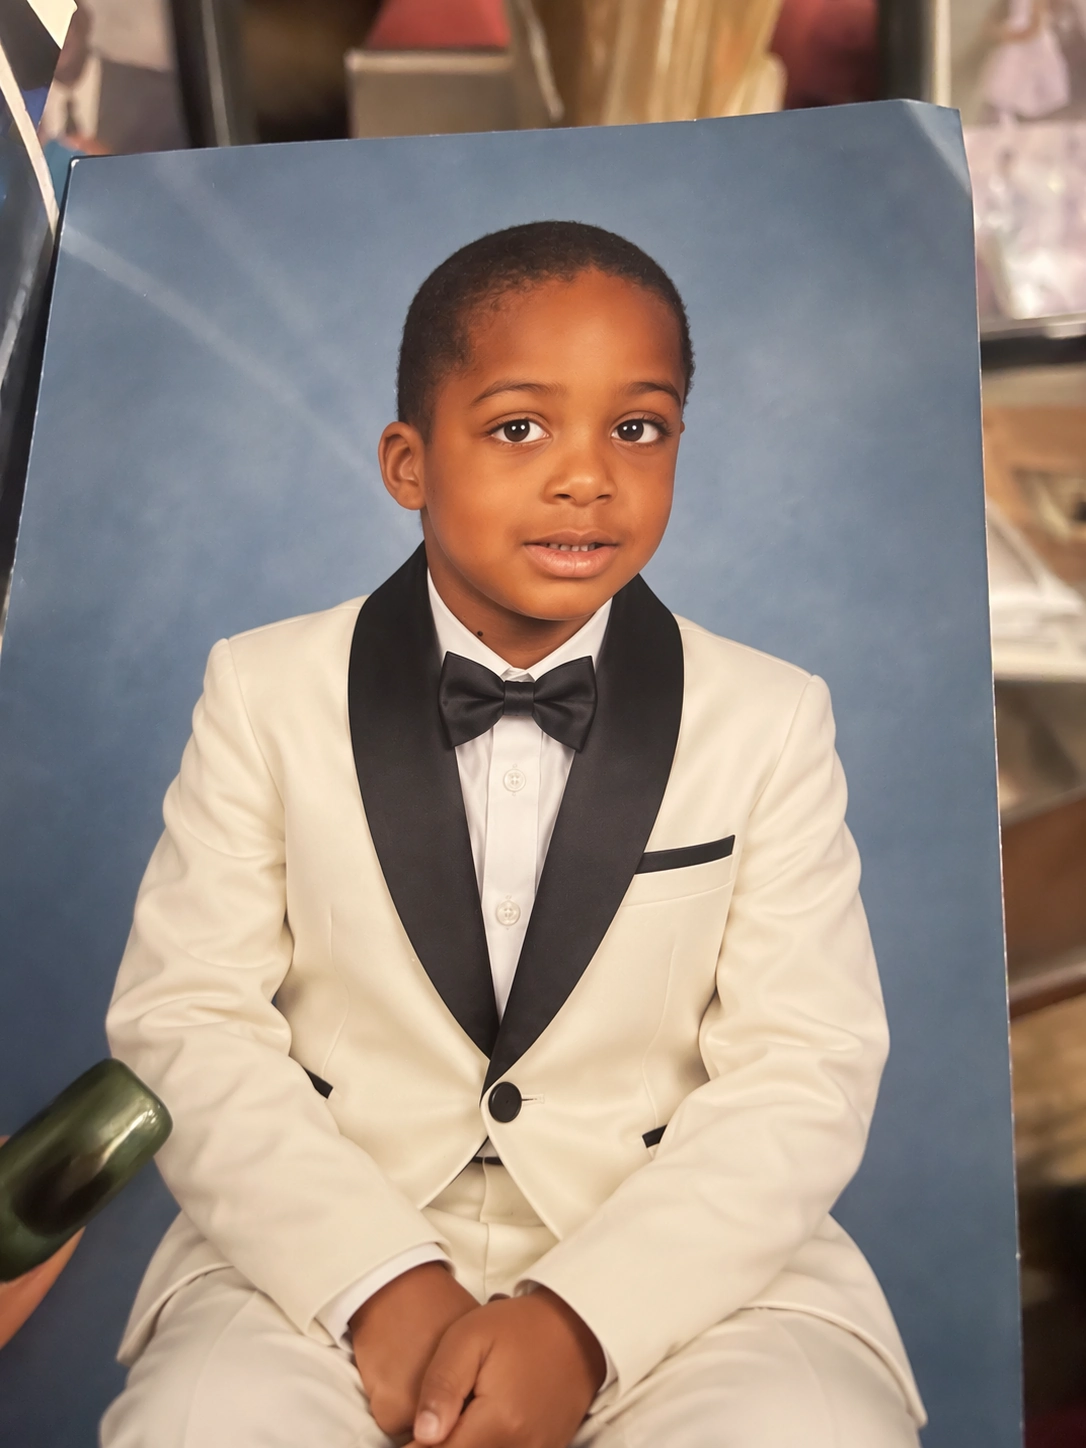
위 이미지는 OpenAI가 공지에 실은 편집 예시다. 인쇄된 초상 사진의 옷만 바꾸고 자세와 배경은 남겨 두었다.
둘째로 회사가 든 것은 지정한 곳만 고치는 편집이다. 복잡한 인물과 배경이 함께 있는 이미지에서도 요청한 부분만 손대고 나머지 세부는 그대로 유지한다고 회사는 설명했다. 개발자가 제품이나 배경, 문구 하나만 바꾸면서 주변의 구도와 브랜드 요소를 유지하는 작업이 이에 해당한다.
셋째로 회사는 대화가 길어질 때의 일관성을 들었다. 여러 번에 걸쳐 편집을 이어 갈 때 앞서 반영한 변경이 그대로 남고, 새 편집이 이전 작업 위에 쌓이면서도 화질이 나빠지지 않는다고 회사는 적었다.
넷째로 회사는 지시 이해와 화풍 재현 능력을 내세웠다. 복잡한 시각적 지시를 이미지로 옮기는 능력이 올랐고, 현실 정보를 담은 이미지의 정확도도 높아졌다는 설명이다. 투명 배경처럼 처리하기 까다로운 배치도 다룰 수 있게 됐다고 한다. 지시가 구체적으로 늘어날수록 요청한 방향에서 벗어나던 문제도 줄었다고 덧붙였다.
ChatGPT에 함께 들어온 기능
Sketch는 ChatGPT 안에서 직접 그린 그림을 이미지 생성의 안내로 쓰는 기능이다. 방의 배치나 옷의 실루엣, 우스운 낙서를 대충 그려 놓으면 모델이 그것을 완성된 이미지로 바꾼다. 대화창에 @Sketch를 입력하면 쓸 수 있다.
템플릿은 빈 화면에서 시작하는 대신 먼저 형식을 고르게 해 준다. 공지에 이름이 나온 것은 “포스터"와 “굿즈"이고, 전단이나 제품 사진처럼 많이 쓰이는 형식을 다룬다는 설명이다. 여기에 담을 정보와 디자인 요소, 화풍을 덧붙여 결과를 조정한다.
이미지 위에 코멘트를 직접 달아 편집 범위를 좁히는 기능도 들어갔다. 마지막으로 이미지를 공유할 때 그 이미지를 만든 프롬프트를 함께 붙일 수 있게 됐다. 받은 사람은 같은 프롬프트를 자기 사진과 세부 정보에 적용해 다시 만들어 볼 수 있다. OpenAI는 1980년대 인물 사진처럼 바꿔 주는 유행 프롬프트를 예시로 제시했다.
API에 열린 두 모델
개발자용으로는 이미지 모델 두 개가 함께 나왔다. GPT-Image-2.5 Flare는 대부분의 애플리케이션에서 기본으로 고를 모델이다. 회사는 이 모델이 GPT-Image-2보다 높은 품질을 절반 수준의 생성 지연으로 낸다고 밝혔다. 창작자 콘텐츠와 소셜 이미지, 제품 화면, 시각 검색, 빠른 시안 작업, 대량 생성이 여기에 해당한다. GPT-Image-2.5 Sunburst는 편집 전반에서 더 세밀한 통제가 필요한 작업을 위한 모델이고, 생성 시간은 더 길다. 캠페인 소재나 완성도 높은 제품 이미지처럼 바로 쓸 결과물을 만드는 작업에 권한다.
두 모델의 가격은 같다. 아래 표의 모든 금액은 100만 토큰당 미국 달러다.
| 모델 | 이미지 입력 | 캐시된 이미지 입력 | 이미지 출력 | 텍스트 입력 | 캐시된 텍스트 입력 |
|---|---|---|---|---|---|
gpt-image-2.5-flare | $8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2.5-sunburst | $8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
시스템 카드가 적은 안전 평가
OpenAI는 같은 날 시스템 카드도 함께 냈다. 안전 장치의 골격은 ChatGPT Images 2.0에서 이어받았고, 이미지 생성 능력이 높아지면서 새로 생긴 위험에 대응할 장치도 더했다고 회사는 밝혔다. 회사는 Images 2.5가 더 높은 사실성을 허용하기 때문에, 안전 장치가 없다면 실제 인물이나 장소, 사건을 담은 딥페이크가 더 설득력 있게 만들어질 수 있다고 스스로 적었다.
방어는 두 단계로 나뉜다. 요청이 생성 모델에 닿기 전에 언어 모델 기반 정책 검사가 위반 여부를 판정해 거부한다. 이를 통과하면 안전 추론 모델이 입력 이미지와 텍스트를 검사한다. 생성이 끝난 이미지도 사용자에게 보이기 전에 다시 검사한다.
자동 평가 결과는 아래와 같다. 평가에 쓴 프롬프트는 회사가 추적하는 모든 안전 범주에서 위반 이미지를 끌어내도록 일부러 만든 것이다. 그래서 실제 사용자 트래픽에 위반 요청이 얼마나 섞여 드는지는 이 비율로 알 수 없다.
| 모델 | 안전한 생성 | 위반 생성 차단 | 위반 생성 노출 |
|---|---|---|---|
| GPT-Image-2.5-Sunburst | 77.0% | 21.9% | 1.09% |
| GPT-Image-2.5-Flare | 79.4% | 19.2% | 1.41% |
| ChatGPT Images 2.0 (기준선) | 75.2% | 23.1% | 1.64% |
정책 영역별로 나눈 표에서 위반 생성이 그대로 노출된 비율은 다음과 같다. 낮을수록 좋은 값이다.
| 정책 영역 | Sunburst | Flare | Images 2.0 |
|---|---|---|---|
| 성적 콘텐츠 | 0.52% | 1.04% | 2.07% |
| 극단주의 | 0.00% | 0.00% | 2.56% |
| 정치 | 0.35% | 0.71% | 1.06% |
| 자해 | 1.13% | 1.13% | 1.51% |
| 폭력과 유혈 | 0.64% | 1.93% | 1.93% |
| 위법 행위 | 2.86% | 3.27% | 2.45% |
위법 행위 영역에서는 새 모델 두 개의 노출 비율이 기준선보다 높았다. OpenAI는 이 정도의 후퇴가 통계적으로 유의하지 않으며, 노출 비율에서는 어느 항목도 Images 2.0과 유의한 차이를 보이지 않았다고 밝혔다.
Preparedness Framework에 따른 판정도 함께 실렸다. 이미지 모델은 코드를 만들어 실행할 수 없으므로 AI 자기 개선 범주에서는 의미 있는 위험을 확인하지 못했다고 적혀 있다. 사이버와 생물 범주에서는 기존 언어 모델 평가를 이미지 생성 모델에 맞게 바꿔 적용했다. 과제마다 추론 과정과 최종 답을 한 이미지에 함께 그리게 한 뒤, 이미지 속 최종 답만 원래의 채점 기준으로 평가했다. 두 모델은 생물과 사이버 범주에서 모두 High 임계값을 넘지 않았다. 그래도 회사는 Images 2.0 때처럼 예방 차원에서 생물 위험을 High 등급으로 다룬다고 밝혔다.
출처 표시에 쓰는 수단도 하나 더 늘었다. OpenAI는 C2PA 적합성 프로그램에 계속 참여하며, 메타데이터로 출처를 알리는 방식을 유지한다. 여기에 구글 딥마인드의 SynthID를 더해 ChatGPT와 Codex, OpenAI API에서 만든 이미지에 보이지 않는 워터마크를 넣는다. 출처 문제에 단일한 해법이 없다는 점을 인정하면서 여러 겹으로 접근한다고 시스템 카드는 설명했다.
초기 고객으로 이름이 오른 곳
공지에는 Higgsfield AI와 Adobe, Manus, Runway 네 곳의 인용이 함께 실렸다. 그중 원문 페이지에 전문이 실린 것은 Higgsfield AI 제품 총괄 Axultan Alimkulov의 말이다.
GPT-Image-2.5 Flare에서 가장 인상적이었던 것은 무엇을 바꾸지 말아야 하는지를 잘 안다는 점이다. 원본 이미지의 성격과 구도, 시각적 정체성을 잃지 않으면서 의미 있는 편집을 할 수 있다. 영화와 사용자 제작 콘텐츠, 광고에서 창작자와 팀이 실제로 일하는 방식에는 이 점이 대단히 중요하다. 이런 통제력에 속도와 품질, 비용까지 더해지면 GPT-Image-2.5 Flare는 확실히 눈에 띈다.
나머지 인용은 회전형 배너 안에 있어 원문 페이지에서 한 번에 보이지 않는다. The Next Web은 이 인용들을 바탕으로 두 가지를 전했다. 어도비는 새 GPT-Image-2.5 모델을 자사 창작 도구 Firefly에 이미 넣었다. 제품 시니어 디렉터 Matt Chotin은 Firefly가 여러 선도 모델과 어도비 도구를 한자리에 모아 쓰는 곳이라고 설명했다. Manus는 자체 평가에서 Flare가 이전 모델보다 2배에서 4배까지 빠르다고 말했다. 같은 기사에는 ChatGPT에서도 어도비 도구 70개가 넘게 제공된다는 내용이 실렸다.
내가 다시 읽은 대목
가격표를 두 번 봤다. Flare와 Sunburst의 요율이 소수점까지 같다. 그러니 어느 쪽을 쓸지 정할 때 비용은 아예 고려 대상에서 빠진다. 남는 기준은 생성 지연과 편집 통제력이고, OpenAI는 급한 작업이면 Flare, 완성도가 필요한 작업이면 Sunburst를 권한다. 텍스트 모델은 대체로 모델 크기와 가격을 함께 놓고 등급을 나눈다. 이번 두 모델은 생성 시간만 다르게 두고 등급을 갈랐다.
SynthID를 도입했다는 문장도 눈에 걸렸다. 공지 본문은 “보이지 않는 워터마크"라고만 적었고, 이름은 시스템 카드에만 나온다. 구글 딥마인드가 만든 기술을 OpenAI가 ChatGPT와 Codex, API 전반에 얹은 셈이다. 출처 표시를 두고는 회사마다 따로 만들어 겨루기보다 같은 층을 함께 쓰는 편이 낫다고 판단한 모양이다. 시스템 카드도 출처 문제에 단일한 해법이 없다고 먼저 인정했다.
생물과 사이버 능력을 잰 방법도 기억에 남는다. 이미지 모델에게 추론 과정과 답을 한 장의 그림에 적게 한 뒤, 그림 속 답만 채점했다. 텍스트로 답할 통로가 없는 모델에 언어 모델용 시험을 치르게 하려면 이런 우회가 필요했다. 능력 평가가 모달리티를 따라 이렇게까지 변형되는 것을 보니, 앞으로 어떤 모델이 나오든 시험지는 계속 다시 만들어야 할 것 같다.
출처
OpenAI, “Introducing ChatGPT Images 2.5”, 2026년 9월 8일 원문: https://openai.com/index/introducing-chatgpt-images-2-5/
관련 자료
- 시스템 카드: https://deploymentsafety.openai.com/chatgpt-images-2-5
- API 가격표: https://developers.openai.com/api/docs/pricing
- 회전형 배너 안의 인용은 The Next Web 보도를 참고했다: https://thenextweb.com/news/openai-images-25-adobe-firefly-interface-layer
편집 예시 이미지는 OpenAI 공지에 실린 것을 인용했다. 나머지 삽화는 「느낌적인 느낌을 숫자로 옮기는 일」의 치비 서소영 라인아트를 참조하여 gpt-image-2 image-to-image로 생성했다.