3줄 요약
- Anthropic의 Transformer Circuits Thread가 2022년에 공개한 논문이다. Catherine Olsson을 제1저자로 26명이 참여했고, 트랜스포머의 인컨텍스트 러닝이 모델 안의 어떤 부품에서 나오는지를 추적한다.
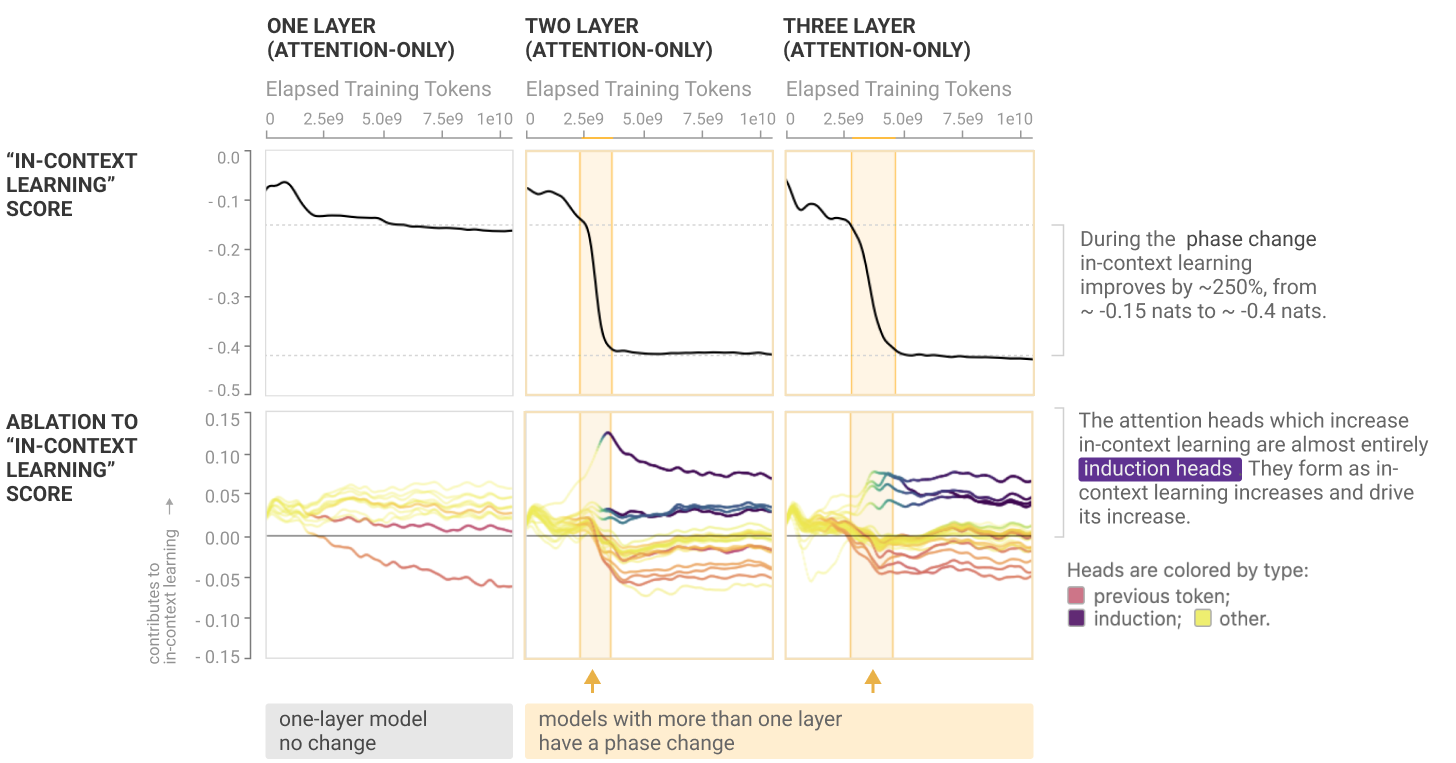
- 2층 이상의 트랜스포머는 학습 초반에 딱 한 번 상전이(phase change)를 겪는다. 이 좁은 구간에서 인덕션 헤드가 형성되고, 같은 시점에 인컨텍스트 러닝 능력이 한꺼번에 향상되며, 학습 손실 곡선에도 혹이 생긴다.
- 저자들은 여섯 갈래의 논거를 제시해 인덕션 헤드가 인컨텍스트 러닝의 대부분을 담당한다고 주장한다. 작은 어텐션 전용 모델에서는 절제(ablation, 헤드 제거) 실험까지 동원한 인과적 증거를 확보했지만, 대형 모델에 대해서는 상관 증거에 그친다고 스스로 밝힌다.
이 논문이 하려는 일
기계적 해석가능성(mechanistic interpretability)은 신경망 내부의 계산을 역공학하려는 분야다. 넓은 의미의 해석가능성이 출력을 설명하는 여러 방법을 모두 포함한다면, 기계적 해석가능성은 신경망 내부 회로를 체계적으로 규명하는 데만 집중한다.
같은 팀이 2021년에 낸 수학적 프레임워크 논문은 1층과 2층 어텐션 전용 모델을 거의 완전히 설명해냈다. 거기서 발견한 것이 인덕션 헤드다. 그런데 최종 목표는 수백 층에 수십억 파라미터를 가진 프런티어 모델이고, 층이 많고 MLP까지 있으면 회로를 수학적으로 확정하기가 훨씬 어려워진다.
그래서 이 논문은 다른 접근을 택한다. 학습 과정을 관찰하고, 구조를 교란하고, 형성 과정을 추적해서 내부에서 무슨 일이 일어나는지 간접적으로 입증하려 한다. 논문은 이를 신경과학자의 작업에 비유한다. 신경 발생을 시간순으로 관찰하고, 특정 부위가 손상된 환자를 연구하고, 동물의 뇌 기능을 교란하고, 관련 뉴런 몇 개를 골라 들여다보는 방식이다.
논문은 대형 트랜스포머의 인컨텍스트 러닝 대부분을 인덕션 헤드가 담당하고 있을지 모른다는 가설을 검토한다.
두 개의 핵심 개념
인컨텍스트 러닝을 어떻게 측정하는가
인컨텍스트 러닝에는 서로 다른 두 가지 개념화가 있다. Brown 등의 few-shot 학습 관점은 특정 과제를 몇 개의 예시로 제시했을 때 모델이 그 과제를 수행하는지를 본다. Kaplan 등의 관점은 토큰 인덱스가 커질수록 손실이 얼마나 떨어지는지를 본다. 전자가 미시적 관점이라면 후자는 거시적 관점이다.
이 논문은 후자를 택했다. 특정 과제 선택에 의존하지 않고 모델이 맥락에서 배우는 능력 전반을 측정할 수 있기 때문이다.
인컨텍스트 러닝 점수: 맥락의 500번째 토큰 손실에서 50번째 토큰 손실을 뺀 값. 데이터셋 예시 전체에 대해 평균낸다.
값은 음수로 나오고, 절댓값이 클수록 인컨텍스트 러닝을 많이 한다는 뜻이다. 500과 50이라는 숫자는 다소 임의적이다. 논문의 설명으로 500번째는 길이 512 맥락의 끝 무렵이고, 50번째는 언어나 문서 종류 같은 기본 속성을 파악할 만큼의 토큰은 읽혔으면서도 아직 맥락 앞부분인 지점이다. 논문은 뒤에서 이 숫자를 바꿔도 결론이 달라지지 않는다는 것을 따로 확인한다.
인덕션 헤드란 무엇인가
인덕션 헤드는 서로 다른 층에 있는 두 어텐션 헤드가 짝을 이뤄 패턴을 복사하는 회로다. 첫 번째 헤드는 이전 토큰의 정보를 현재 토큰으로 복사하는 “이전 토큰 헤드"다. 덕분에 두 번째 헤드는 토큰 자체의 내용 대신 그 앞에 무엇이 왔는지를 기준으로 참조할 수 있게 된다. 이 두 번째 헤드가 인덕션 헤드다. 맥락 앞쪽에서 현재 토큰 A가 등장했던 대목을 찾고, 그다음에 온 토큰 B를 참조해 복사하고, B의 출력 확률을 높인다. 결과적으로 …[A][B]…[A]라는 열이 [B]로 이어질 확률이 올라간다.
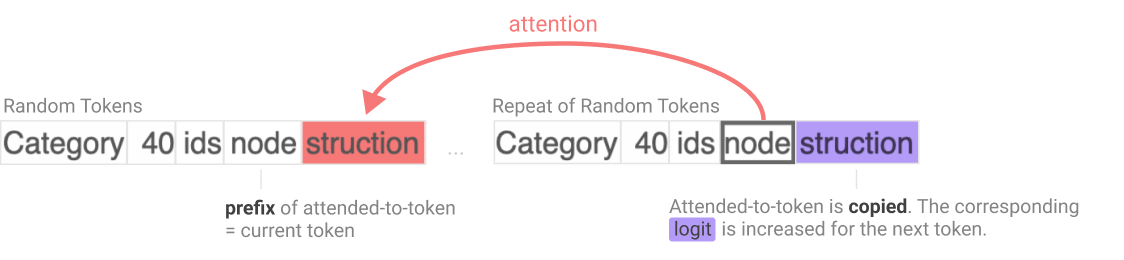
이름은 귀납 추론에서 따왔다. 맥락 앞부분에서 A 다음에 B가 왔다면 뒤에서도 A 다음에 B가 올 가능성이 높다는 추론이다. 인덕션 헤드는 n-gram 통계표를 외우는 것과 다르다. [A][B] … [A] → [B]라는 규칙은 A와 B가 무엇이든 성립한다. 인덕션 헤드는 A와 B를 상당 부분 분리해서 다루기 때문에, 고정된 바이그램 통계를 갱신하는 대신 새로운 패턴으로 추상화할 수 있다.
이 논문은 정의를 더 엄격하게 고쳤다. 대형 모델에서는 가중치의 수학적 분석과 고윳값 분석이 훨씬 복잡해지므로, 인덕션 헤드를 무작위 토큰 열을 반복시켰을 때의 경험적 행동으로 정의한다. 조건은 두 가지다.
| 조건 | 내용 |
|---|---|
| 접두 일치(prefix matching) | 앞서 나온 토큰 가운데, 그 뒤에 현재 토큰이나 최근 토큰들이 따라왔던 토큰을 참조한다. 즉 귀납 추론이 다음에 올 것이라 예측하는 토큰을 참조한다는 뜻이다. |
| 복사(copying) | 헤드의 출력이 참조한 토큰에 해당하는 로짓을 높인다. |
무작위 토큰 열로 판정하는 이유가 있다. 실제 문장으로 판정하면, 맥락에 아직 등장하지 않았어도 그럴듯하게 이어질 토큰을 골라내는 단순 복사 헤드와 구분하기 어렵다.
이렇게 정의하고서도 연구진이 노리는 주장은 더 넓다. 인덕션 헤드가 [A*][B*] … [A] → [B] 형태의 느슨한 최근접 이웃 완성까지 수행한다고 본다. A*는 A와 정확히 같은 토큰은 아니지만 어떤 표현 공간에서 유사하고, B와 B*의 관계도 같다. 예를 들어 A와 A*가 서로 다른 언어의 같은 단어라면, 인덕션 헤드는 A와 비슷한 것을 찾고, 그 뒤의 B*를 발견하고, B*와 비슷한 B로 문장을 이어가는 방식으로 단어 단위 번역을 수행할 수 있다.
토큰별 손실 벡터
논문 전반에서 쓰는 분석 도구가 하나 더 있다. 각 모델 스냅샷에 대해 서로 다른 예시 문장에서 뽑은 무작위 토큰 1만 개의 로그 우도를 수집해 하나의 벡터로 만든다. 이것이 토큰별 손실 벡터다. 함수를 입력별 출력값을 성분으로 하는 무한 차원 벡터로 보는 수학의 관습에서 온 발상이다. 기능은 같은데 파라미터는 전혀 다른 두 모델을 비교하기 어렵다는 문제를 이 방법이 우회한다. 여기에 주성분 분석(PCA)을 적용하면 여러 모델의 학습 궤적을 같은 공간에서 비교할 수 있다.
논거 1: 상전이
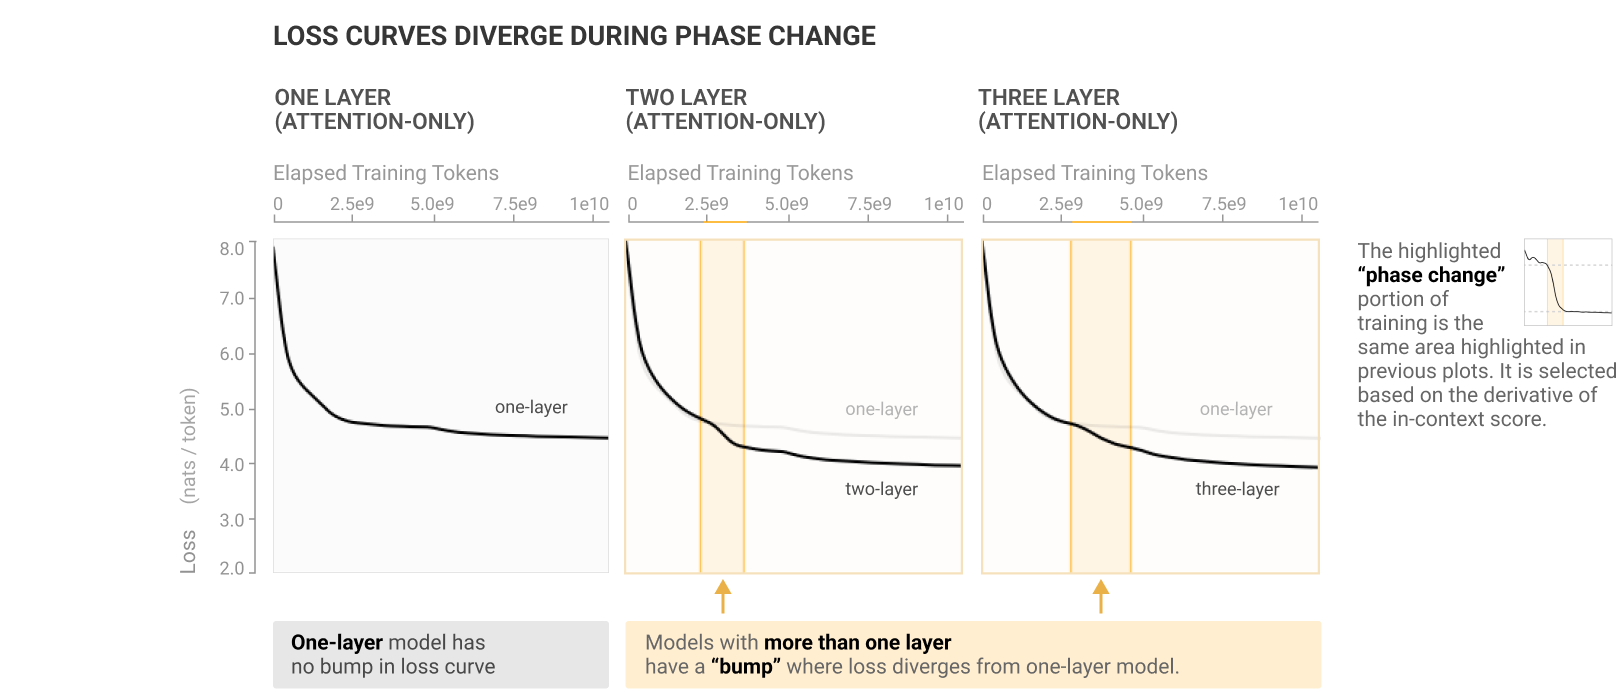
학습 과정에서 인컨텍스트 러닝 점수를 측정해 보면, 초반의 좁은 구간에서 갑자기 개선되고 그 뒤로는 학습이 끝날 때까지 거의 변화가 없다. 논문은 이 구간을 대략 25억에서 50억 토큰 사이로 적고, 모델 상세 절에서는 작은 모델 기준 10억에서 30억 토큰으로 적는다. 구간 이전에는 0.15 nat(내트) 미만, 이후에는 대략 0.4 nat이다. 학습량이 더 늘어도, 모델 크기가 달라져도 이 값은 그대로다. 예외는 1층 모델뿐이고, 1층 모델에서는 인컨텍스트 러닝이 애초에 형성되지 않는다.
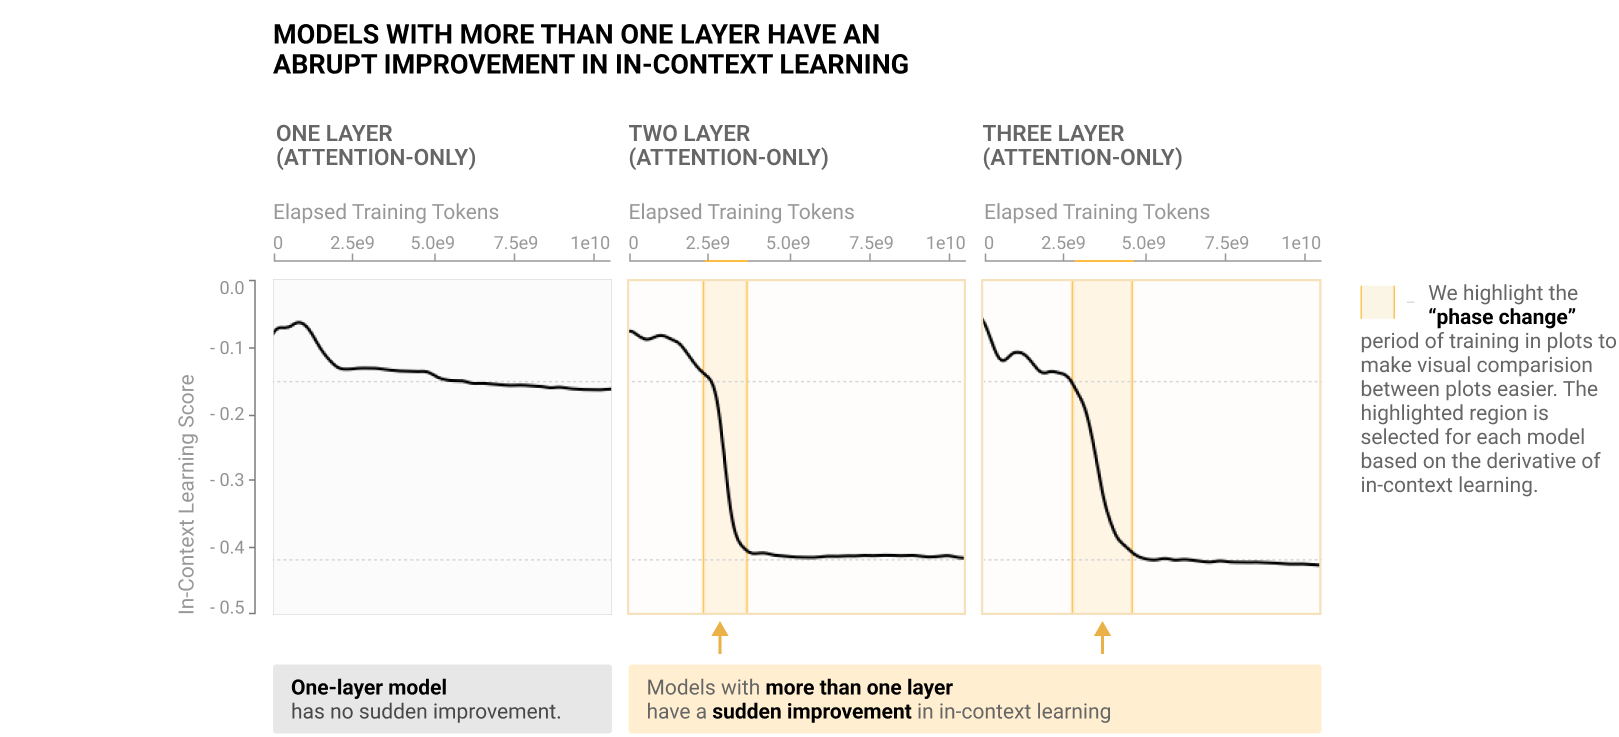
기계학습에서 대부분의 지표는 학습과 함께 점진적으로 나아지고 모델이 커지면 더 좋아진다. 이 지표만 예외다.
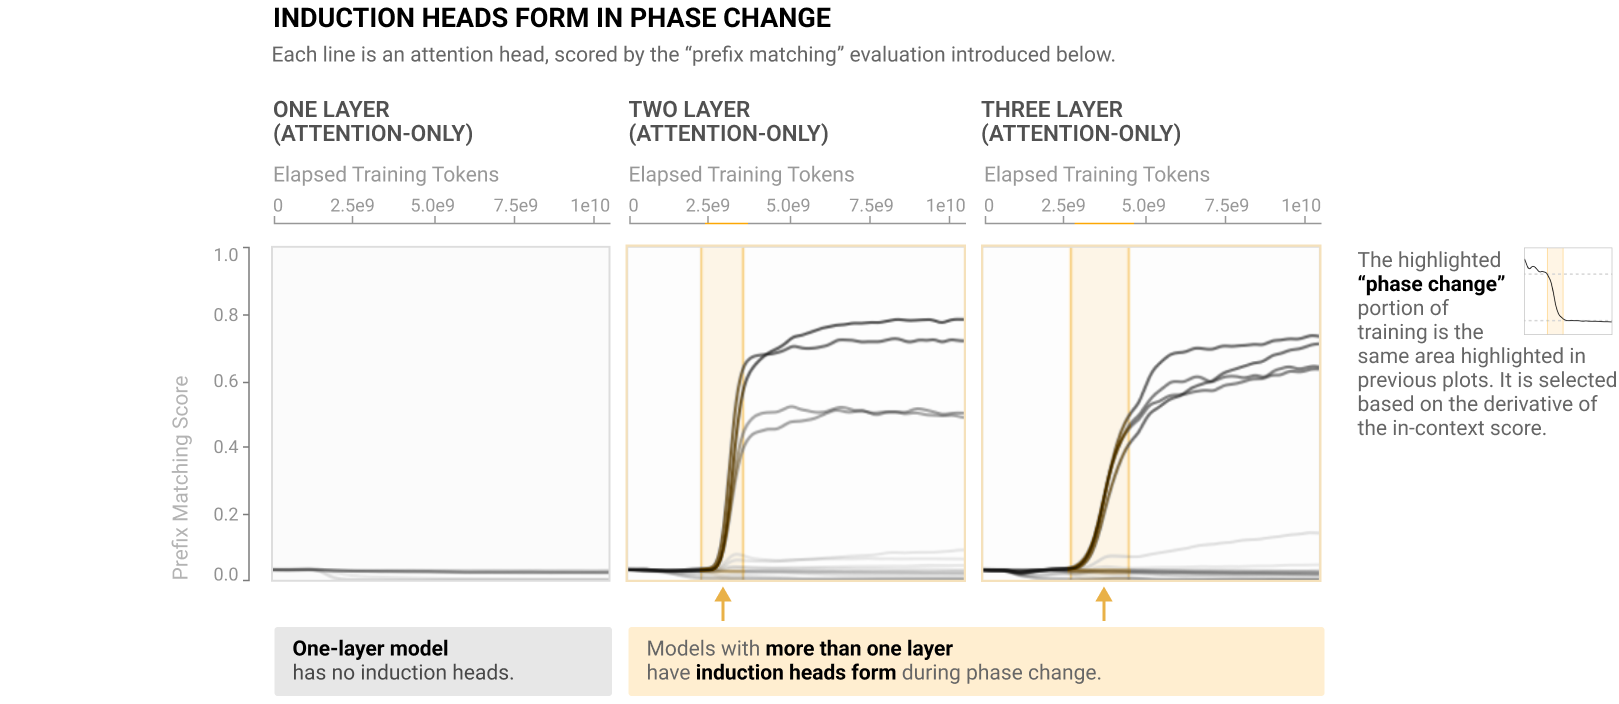
같은 구간에서 인덕션 헤드도 형성된다. 모든 어텐션 헤드에 접두 일치 점수를 매겨 추적하면, 인컨텍스트 러닝이 개선되는 그 구간에서 점수가 급격히 올라가는 헤드들이 나타난다. 1층 모델에서는 인덕션 헤드가 끝내 생기지 않는다.
이 구간은 학습 전체에서 특별한 지점이다. 손실 곡선에 눈에 보이는 혹이 생기고, 학습 전체에서 손실 곡선의 볼록성이 깨지는 유일한 대목이기도 하다. 손실 곡선은 수천 개 토큰을 평균낸 값이라서, 산술 능력의 출현처럼 사람들이 흥미로워하는 변화조차 그 해상도에서는 눈에 띄지 않을 만큼 작다. 그 해상도에서 보인다는 것은 모델 행동에 광범위하고 큰 변화가 일어났다는 뜻이다.
토큰별 손실 벡터에 PCA를 적용해 학습 궤적을 그려 보면 같은 구간에서 궤적이 급격히 꺾인다. 궤적이 기본 경로에서 이탈하는 주된 사건은 여기서 한 번 일어난다. 역시 1층 모델만 예외다.
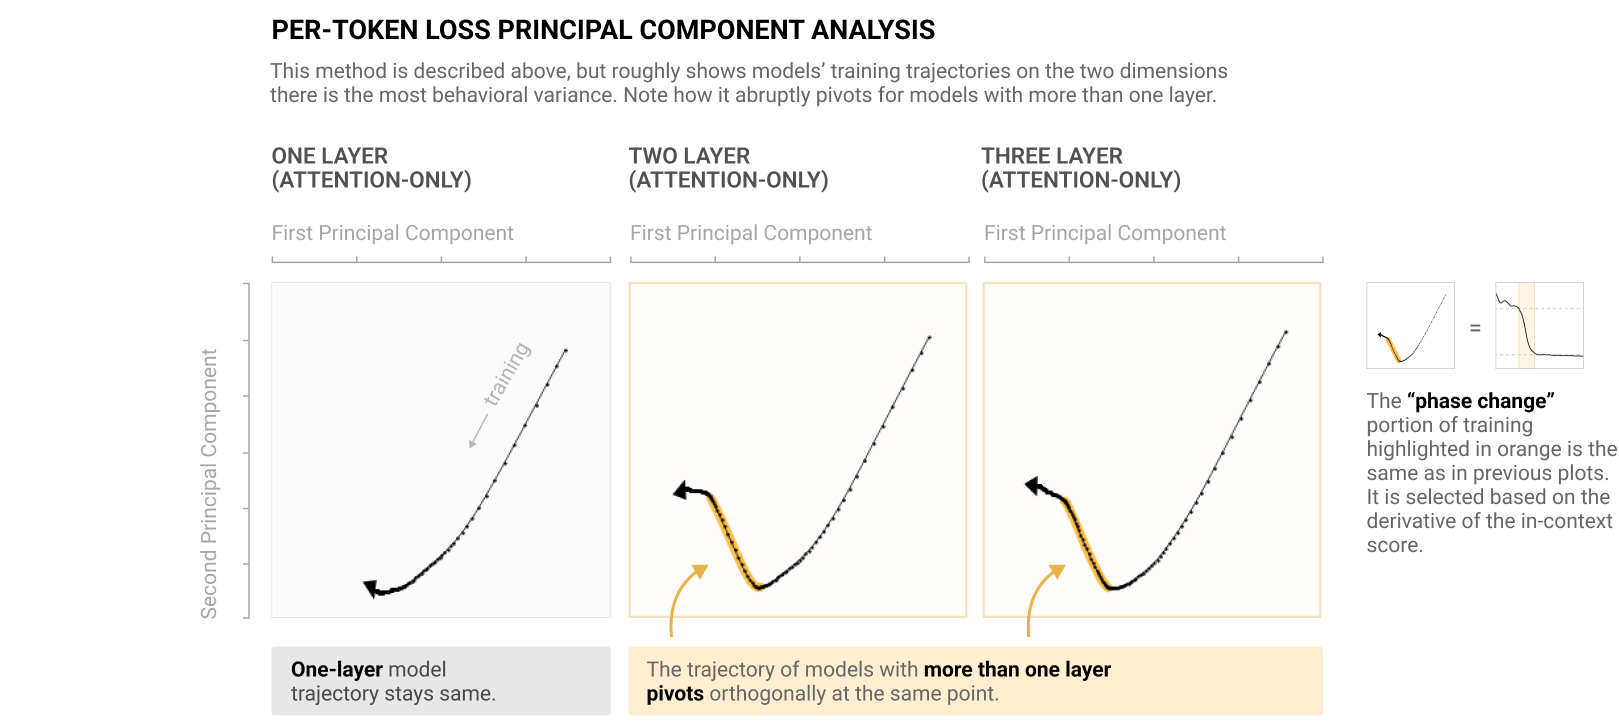
정리하면 네 가지가 같은 구간에 동시에 일어난다. 인컨텍스트 러닝 능력이 급격히 개선되고, 인덕션 헤드가 형성되고, 손실 곡선에 혹이 생기고, 토큰별 손실 공간에서 모델의 궤적이 꺾인다. 저자들은 이 전환을 상전이라 부른다. 손실과 인컨텍스트 러닝 곡선 같은 거시 지표에서도, 인덕션 헤드라는 미시 구조에서도 함께 관측되는 급격한 변화라는 점에서 얼음이 녹는 현상에 빗댄다.
다른 원인일 가능성 점검
연구진은 세 가지를 확인했다. 첫째, 이 구간은 학습률이나 워밍업이나 가중치 감쇠의 예정된 변경 시점과 겹치지 않는다. 가중치 감쇠는 4,750스텝(약 50억 토큰)에서 줄어드는데 상전이 구간보다 한참 뒤이고, 학습률 워밍업은 첫 15억 토큰에 걸쳐 진행된다. 둘째, 작은 모델 일부를 다른 데이터셋으로 학습시켜도 상전이가 똑같이 나타난다. 셋째, 모델이 무엇을 더 잘하게 되고 무엇을 더 못하게 되는지를 토큰 단위로 관찰했다.
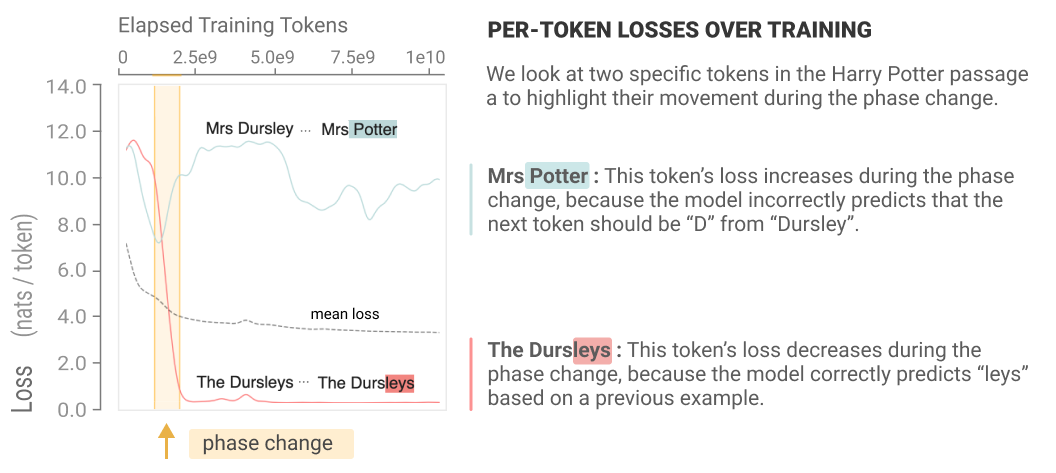
세 번째 확인은 해리 포터 첫 문단을 재료로 삼는다. 상전이 시작 시점과 종료 시점의 로그 우도를 비교하면, 변화의 대부분이 토큰이 반복된 곳에서 일어난다. 같은 토큰 열이 두 번째로 등장할 때 모델은 그것을 훨씬 잘 예측하게 된다. 반대로 어떤 토큰 뒤에 이전과 다른 토큰이 오면 상전이 이후의 모델이 오히려 더 못 맞힌다.
이 증거가 충분하지 않은 이유
논문은 반대 근거도 함께 적는다.
- 대형 모델은 학습 과정의 시간 해상도가 낮다. 스냅샷이 15개뿐이면 두 현상이 같은 구간에 나타나도 그리 놀랍지 않고, 증거로서도 약하다.
- 상전이 시점에 다른 기전이 함께 형성되었을 수 있다. 예를 들어 이 시점이 모델이 잔차 스트림을 통해 층을 합성하는 법을 배우는 시점이라면, 인덕션 헤드도 그 덕분에 생기고 다른 인컨텍스트 러닝 원천도 그 덕분에 생긴 것일 수 있다. 인덕션 헤드가 원인이라기보다 공통 잠재 변수가 원인일 가능성이다.
- 상전이 이후 인컨텍스트 러닝 점수가 0.4 nat로 일정하다는 것이 기전도 일정하다는 뜻은 아니다. 이 지표는 500번째와 50번째 토큰의 상대 손실이고, 50번째 토큰의 성능은 학습 내내 좋아진다. 더 낮아진 기준선에서 같은 폭만큼 손실을 줄이는 일은 더 어려우므로, 학습 후반에는 추가 기전이 동원되고 있을 수 있다.
마지막 항목은 다시 들여다볼 가치가 있다. 학습 초기에는 바이그램 통계를 외우는 정도로도 손실이 크게 줄어든다. 후반으로 갈수록 쉬운 것은 다 소진되고, 모델은 인덕션 헤드 같은 더 정교한 알고리즘을 배워야 하는데 얻는 정보량은 도리어 적다. 인컨텍스트 러닝 능력은 늘고 남은 비트는 맞히기 어려워지는데, 이 둘이 왜 그렇게 정확히 상쇄되는지는 미해결 문제다.
논거 2: 구조를 바꾸면 상전이 시점도 바뀐다
논거 1은 관찰 연구다. 하나를 바꿔 다른 하나가 따라오는지 보는 개입 실험이 더 강하다.
출발점은 상전이가 2층 이상에서만 일어난다는 관찰이다. 인덕션 헤드가 원인이라면 이는 예측된 결과다. 인덕션 헤드는 어텐션 헤드의 합성을 요구하고, 합성은 2층부터 가능하기 때문이다. 왜 합성이 필요한가. 인덕션 헤드가 어느 토큰을 참조할지는 그 토큰 바로 앞에 무엇이 왔는지가 정해야 한다. 그런데 개별 어텐션 헤드는 출발 토큰과 도착 토큰만으로 점수를 계산한다. 앞선 어텐션 헤드가 기록해 둔 정보를 이용하지 않으면 점수가 앞 토큰의 함수가 될 수 없다.
여기서 연구진은 “스미어드 키(smeared key)” 구조를 설계한다. 헤드 $h$ 마다 학습 가능한 실수 파라미터 $\alpha^h$ 를 도입하고, $\sigma(\alpha^h) \in [0, 1]$ 로 현재 토큰의 키와 이전 토큰의 키를 보간한다.
$$k^h_j = \sigma(\alpha^h)\,k^h_j + (1 - \sigma(\alpha^h))\,k^h_{j-1}$$맥락의 첫 토큰에는 보간을 적용하지 않는다. 이 변경만으로 어떤 깊이의 트랜스포머든 인덕션 헤드를 표현할 수 있게 된다.
예측은 명확하다. 인덕션 헤드가 인컨텍스트 러닝의 주 기전이라면, 1층 모델에서도 상전이가 일어나야 하고 더 깊은 모델에서는 상전이가 앞당겨져야 한다. 결과가 그대로 나왔다.
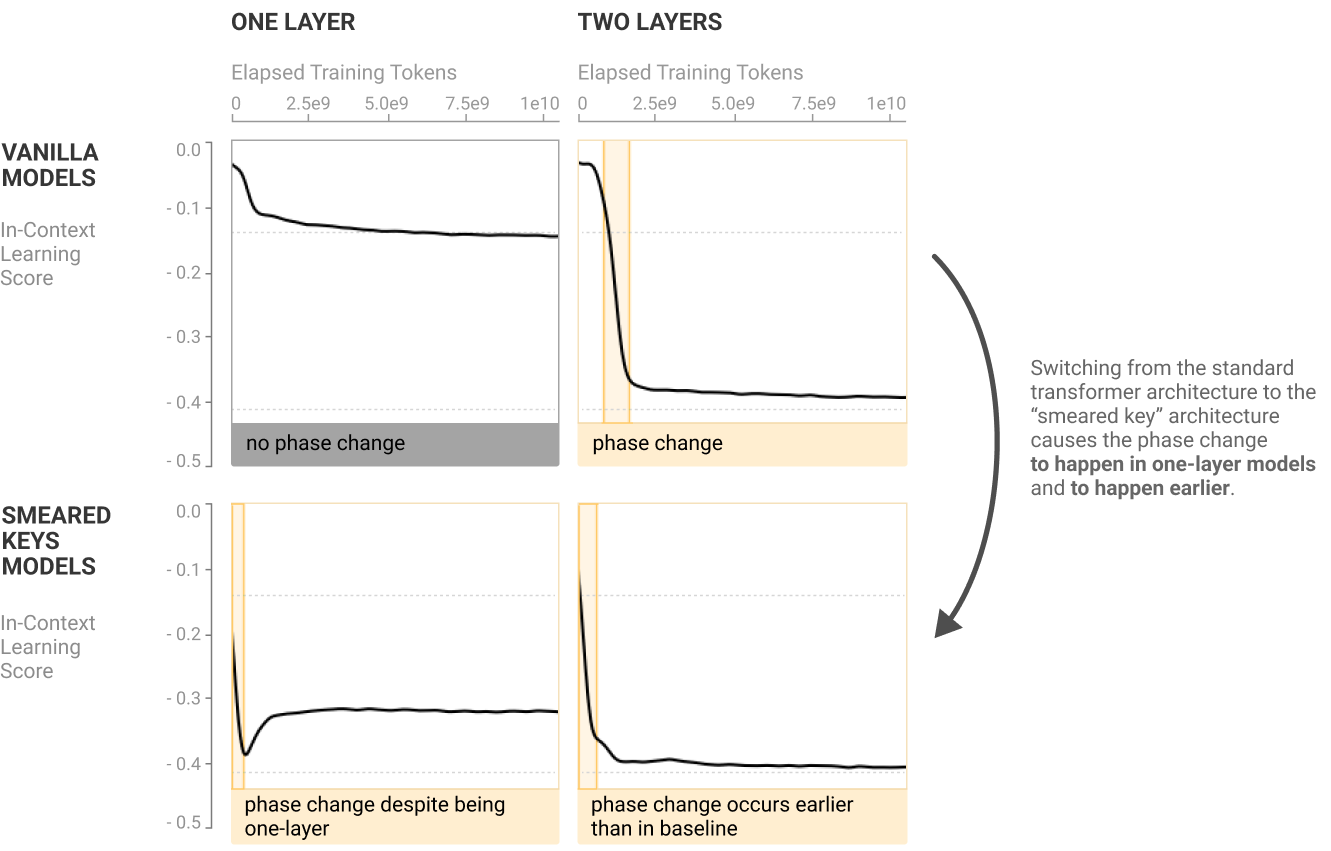
연구진은 여기에 단서를 단다. 이 실험이 보여주는 것은 인덕션 헤드가 인컨텍스트 러닝 급증을 일으킬 수 있는 최소한의 기전이라는 점까지다. 대형 모델에서는 이 기전이 전부가 아닐 수 있고, 학습 도중 기전이 바뀔 가능성도 반박하지 못한다.
논거 3: 인덕션 헤드를 제거하기
연구진이 가진 가장 강한 증거는 절제 실험이다. 특정 어텐션 헤드를 테스트 시점에 제거하고 순전파를 다시 돌려 인컨텍스트 러닝이 얼마나 줄어드는지를 본다. 결과는 분명하다. 작은 어텐션 전용 모델에서는 인컨텍스트 러닝이 거의 전부 인덕션 헤드에서 나온다. 상전이 시작 시점부터 학습 종료 시점까지 계속 그렇다. 이 글의 표지 이미지가 그 그래프이며, 보라색으로 표시된 인덕션 헤드만이 인컨텍스트 러닝 점수를 높인다.
기묘한 부수 결과가 하나 있다. 인덕션 헤드를 제외한 대부분의 헤드는 제거하면 인컨텍스트 러닝 점수가 올라간다. 모델을 망가뜨렸는데 점수가 좋아지는 것이다. 논문의 설명을 옮기면, 어떤 토큰은 “평범한 예측"으로도 맞힐 수 있고 인컨텍스트 러닝으로도 맞힐 수 있다. 헤드를 제거해 평범한 예측이 망가지면, 인컨텍스트 러닝이 담당하는 몫이 늘어나고 지표상의 점수도 절댓값이 커진다.
대형 모델의 절제 데이터는 없다. 전체 절제의 비용이 파라미터 수 $N$ 에 대해 $O(N^{1.33})$ 로 증가하기 때문이다. 헤드 수가 $O(N^{0.33})$ 이고 절제 하나가 $O(N)$ 인데, 스냅샷마다 1만 개 예시로 평가하므로 기본 비용도 작지 않다.
절제 결과를 해석할 때의 한계도 적혀 있다. 어텐션 전용 모델에서 로짓은 두 부분의 합이다. 각 헤드가 기여하는 항과, 토큰 임베딩으로 직접 이어지는 직접 경로 항이다. 직접 경로 항은 현재 토큰만의 함수라서 인컨텍스트 러닝에 기여할 수 없다. 따라서 인컨텍스트 러닝은 전부 어텐션 헤드에서 나와야 하고, 관계가 거의 선형이므로 절제는 기여도를 재는 정당한 방법이 된다. 그런데 MLP가 있는 모델에서는 인컨텍스트 러닝이 MLP와 어텐션의 상호작용에서 나올 수도 있다. 헤드를 제거하면 MLP 층의 통계가 달라져 실제로는 중요하지 않은 뉴런이 망가질 수 있고, 두 헤드 모두에 의존하는 MLP 기전이 그중 하나만 남아도 그럭저럭 동작할 수도 있다. 논문은 작은 어텐션 전용 모델에 대해서는 결론을 내리고, MLP 모델에 대해서는 참고 수준의 증거로만 본다.
논거 4: 같은 헤드가 추상적인 일을 한다
앞의 세 논거가 형성 시점을 다뤘다면, 네 번째는 다른 각도다. 무작위 열 복사로 좁게 정의된 인덕션 헤드가 실제로 어려운 일까지 하고 있는지를 사례로 보여준다. 대상은 40층 130억 파라미터 모델이다.
| 헤드 | 층 깊이 | 복사 점수 | 접두 일치 점수 |
|---|---|---|---|
| 문자열 복사 헤드 | 21 / 40 | 0.89 | 0.75 |
| 번역 헤드 | 7 / 40 | 0.20 | 0.85 |
| 패턴 일치 헤드 | 8 / 40 | 0.69 | 0.94 |
번역 헤드는 영어, 프랑스어, 독일어 사이의 번역을 수행한다. 어텐션 패턴은 대각선에 가깝되 조금씩 어긋나는데, 언어마다 어순과 토큰 길이가 다르기 때문이다. 로짓 기여가 항상 선명하지는 않아서, 대응 단어를 참조하면서도 해당 예측의 로짓을 곧바로 올리지 않는 경우가 있다. 연구진은 이 헤드의 출력이 뒤쪽 층에서 추가로 처리되어야 하기 때문이라고 추정한다.
패턴 일치 헤드는 더 흥미롭다. 실험용으로 네 가지 틀을 만들어 합성 텍스트를 생성했다.
| 틀 | 라벨 |
|---|---|
| (월) (동물): | 0 |
| (월) (과일): | 1 |
| (색) (동물): | 2 |
| (색) (과일): | 3 |
이 헤드는 콜론 위치에서 같은 범주의 이전 사례를 참조한다. 단어 하나가 같아도 패턴이 다른 줄은 건너뛴다. “January bird"는 “grey bird"가 아닌 “April fish"를 주로 참조한다는 식이다. 완벽하지는 않고, 유사한 문제들로 시험했을 때 콜론에서 올바른 위치로 가는 어텐션 비중이 약 65%다.
논문이 강조하는 대목은 따로 있다. 이 헤드들은 인덕션 헤드에 빗댈 만한 별개의 헤드가 아닌, 형식적 정의를 그대로 만족하는 인덕션 헤드 자체다. 같은 층의 같은 헤드가 무작위 열 복사 조건을 충족하면서 동시에 번역과 패턴 일치를 수행한다. 왜 그런지에 대해서는 두 가지 가능성을 제시한다. 하나는 인덕션 헤드가 더 일반적인 알고리즘을 구현하고 있고 반복 열이 주어졌을 때 그 특수 사례로 복사를 하는 것이라는 설명이다. 영어를 영어로 번역하는 일이 문자열 복사와 정확히 같다는 점을 생각하면 자연스럽다. 다른 하나는 잔차 스트림에서 자기 자신만 거치는 경로일 때는 문자열 복사를 하고, 앞선 층이 만든 추상적 표현을 받을 때는 추상적 행동을 한다는 설명이다.
논거 5: 기전을 읽어서 추론하기
인덕션 헤드를 이해했다는 것 자체를 근거로 삼을 수도 있다. 맥락을 검색해 이전 사례를 찾고 그다음에 온 것을 복사하는 절차라면, 그것은 맥락을 데이터 포인트로 쓰는 최근접 이웃 알고리즘이고, 최근접 이웃은 데이터가 많아질수록 좋아진다. 그러므로 인덕션 헤드가 설명대로 존재한다면 인컨텍스트 러닝에 기여할 수밖에 없다.
여기서 한 단계 더 나아갈 수 있다. 2021년 논문에서 연구진은 인덕션 헤드를 파라미터 수준까지 역공학했다. 그 분석을 신뢰한다면 모델을 실행해 보지 않고도 행동을 알 수 있다. 프로그래머가 소스 코드를 읽고 알고리즘을 알아보는 것과 같다.
인덕션 헤드는 두 개의 회로로 동작한다. 복사는 OV(Output-Value) 회로가 담당하고, 양의 고윳값을 갖는 복사 행렬이 그 특징이다. 접두 일치는 QK(Query-Key) 회로에서 K-합성으로 구현된다. 인덕션 헤드의 $W_K$ 가 앞선 어텐션 헤드가 써 넣은 부분공간을 읽는 방식이다. 가장 기본적인 형태는 이전 토큰 헤드와의 순수한 K-합성으로 $\text{Id} \otimes h_{prev} \otimes W$ 형태의 QK 항을 만들고, 여기서 $W$ 는 양의 고윳값을 갖는다. 이 항이 현재 토큰과 모든 이전 위치의 앞 토큰을 비교해 유사한 곳을 찾게 만든다.
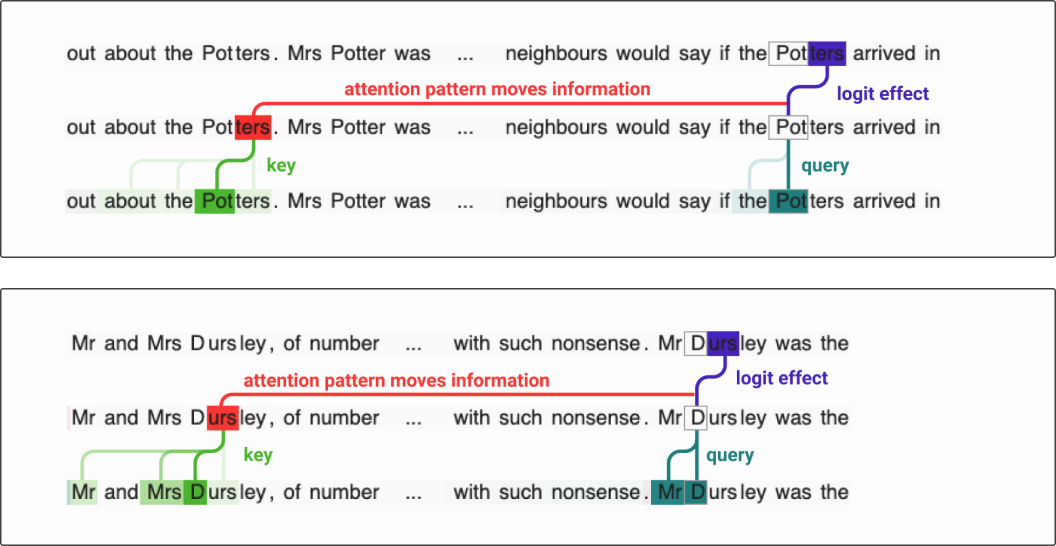
2층 어텐션 전용 트랜스포머에서는 더 강한 결론을 낼 수 있다. 인덕션 헤드를 이해했을 뿐 아니라, 인컨텍스트 러닝을 만들어낼 다른 기전이 딱히 없기 때문이다. 유일한 경쟁 후보는 단순 복사 헤드인데, 단순 복사 헤드는 1층 모델에도 있고 1층 모델에는 인컨텍스트 러닝의 급증이 없다.
모든 모델이 같은 기전을 쓰지는 않는다. GPT-2에서는 “포인터 산술"이라 부르는 두 번째 기전의 증거가 관찰됐다. 앞선 어텐션 헤드가 현재 토큰의 이전 사례를 참조하고 그 위치 임베딩을 현재 토큰의 부분공간으로 복사하면, 인덕션 헤드가 Q-합성으로 그 위치 임베딩을 한 토큰만큼 회전시켜 다음 토큰을 참조하는 방식이다. 이 논문의 모델들은 위치 정보를 잔차 스트림에 더하지 않으므로 이 기전을 쓸 수 없다.
MLP가 있는 대형 모델의 복잡한 인덕션 헤드는 아직 역공학하지 못했다. 논문은 두 가지 차이를 가설로 내놓는다. 하나는 이전 토큰 하나만 맞추는 대신 더 복잡한 QK 항을 쓴다는 가설이고, 다른 하나는 정확한 토큰 대신 더 추상적인 언어적 특징을 맞추고 복사한다는 가설이다.
논거 6: 작은 모델에서 큰 모델로
여섯 번째는 앞의 다섯을 종합한 추론이다. 작은 모델에서는 증거가 강하고 큰 모델에서는 약한데, 작은 모델에서 큰 모델로 추론해도 되는가.
찬성 근거는 측정치가 전부 유사하다는 것이다. 2층 이상이면 전부 상전이를 겪고, 전부 같은 정도로 인컨텍스트 러닝이 급증하고, 전후 값도 비슷하고, PCA 공간에서 비슷한 궤적을 그리고, 전부 인덕션 헤드를 형성한다. 작은 모델과 큰 모델이 달라지는 지점이 어디인지, 그리고 왜 어떤 측정에서도 그 변화의 표시가 나오지 않는지를 논문은 되묻는다.
반대 근거도 명확하다. 큰 모델이 작은 모델과 전혀 다르게 행동하는 사례는 많고, 작은 모델의 결과를 규모가 몇 자릿수나 큰 모델에 적용하는 외삽은 조심해야 한다. 연구진이 가장 그럴듯하다고 보는 대안은 상전이 때 다른 합성 기전도 함께 형성된다는 가설이다. 큰 모델은 헤드가 많아서 작은 모델이 감당하지 못하는 Q-합성과 K-합성 기전을 더 표현할 수 있다. 모든 합성 헤드가 상전이 때 동시에 생긴다면, 일정 규모 이상에서는 인덕션 헤드 이외의 합성 헤드들의 기여 총합이 더 클 가능성이 있다.
증거의 강도 요약
논문은 주장별 증거 강도를 표로 스스로 채점해 둔다.
| 하위 주장 | 작은 어텐션 전용 | 작은 MLP 모델 | 대형 모델 |
|---|---|---|---|
| 일부 기여한다 | 강함, 인과적 | 강함, 인과적 | 중간, 상관적 및 기계적 |
| 대부분 담당한다 | 강함, 인과적 | 중간, 인과적 | 중간, 상관적 |
실험 대상 모델
분석 대상은 디코더 전용 트랜스포머 34종이고, 각 모델마다 학습 도중의 스냅샷을 저장했다. 어텐션 헤드 절제는 5만 회를 넘는다. 모델은 네 계열이다.
| 계열 | 구성 |
|---|---|
| 작은 어텐션 전용 모델 | 1층부터 6층까지, MLP 없음. 이 연구를 위해 따로 학습 |
| MLP가 있는 작은 모델 | 1층부터 6층까지, 어텐션과 MLP 모두 보유 |
| 풀스케일 모델 | 4층 1,300만 파라미터부터 40층 130억 파라미터까지. Anthropic의 여러 프로젝트에서 쓰는 모델 |
| 스미어드 키 모델 | 1층과 2층. 논거 2를 위한 구조 실험 |
작은 모델은 맥락 창 8,192 토큰, 어휘 $2^{16}$ 토큰, 잔차 스트림 차원 768, 층당 어텐션 헤드 12개로 통일했다. 1만 스텝(약 100억 토큰)을 학습하며 50스텝마다 스냅샷을 저장해 200개를 남겼다. 풀스케일 모델은 활성화 차원이 $d_{model} = 128 \times n_{layer}$ 로 커지고, 스냅샷은 스텝 수가 2배씩 늘어나는 지점마다 저장해 15개다. 40층 모델만 14개다.
| 층 수 | 비임베딩 파라미터 | 활성화 차원 | 층당 어텐션 헤드 | 어텐션 차원 |
|---|---|---|---|---|
| 4 | 1,300만 | 512 | 8 | 64 |
| 6 | 4,200만 | 768 | 12 | 64 |
| 10 | 2억 | 1,280 | 20 | 64 |
| 16 | 8억 1,000만 | 2,048 | 32 | 64 |
| 24 | 27억 | 3,072 | 48 | 64 |
| 40 | 130억 | 5,120 | 40 | 128 |
학습 데이터는 Askell 등이 기술한 데이터셋의 초기 버전으로, 필터링한 Common Crawl과 인터넷 도서에 약 10%의 파이썬 코드가 섞여 있다. 같은 데이터셋으로 학습한 모델은 모두 같은 예시를 같은 순서로 보았고, 어떤 모델도 같은 학습 데이터를 두 번 보지 않았다.
인덕션 헤드가 어느 층에 생기는지도 부록에서 다룬다. 어텐션 전용 모델에서는 마지막 층이다. MLP가 있는 작은 모델은 5층, 6층 규모가 되면 끝에서 두 번째 층에 더 많이 몰린다. 풀스케일 모델에서는 더 이른 층에 생기고, 24층과 40층 모델에서는 인덕션 헤드의 다수가 모델 깊이의 절반 이전에 형성된다.
설명하지 못한 것들
논문에는 미해결 관찰을 모아 둔 절이 따로 있다.
첫째, 인컨텍스트 러닝 점수가 모델을 가리지 않고 거의 같다. 2층짜리 작은 모델이든 130억 파라미터 모델이든, 상전이 직후든 한참 더 학습한 뒤든 값이 비슷하다. 500과 50이라는 임의의 숫자 탓이 아닌지 확인하려고 점수를 맥락 마지막인 8,192번째 토큰과 다른 인덱스 사이의 손실 차이로 다시 정의해 봐도 결과는 같았다.
큰 모델은 모든 인덱스에서 작은 모델보다 예측을 잘하고 뒤쪽 토큰에서 가장 잘한다. 그런데 큰 모델과 작은 모델의 손실 격차는 대부분 맥락 첫 10토큰에서 이미 생긴다. 그 뒤로는 거의 고정된 폭만큼 손실을 더 줄여 나간다.
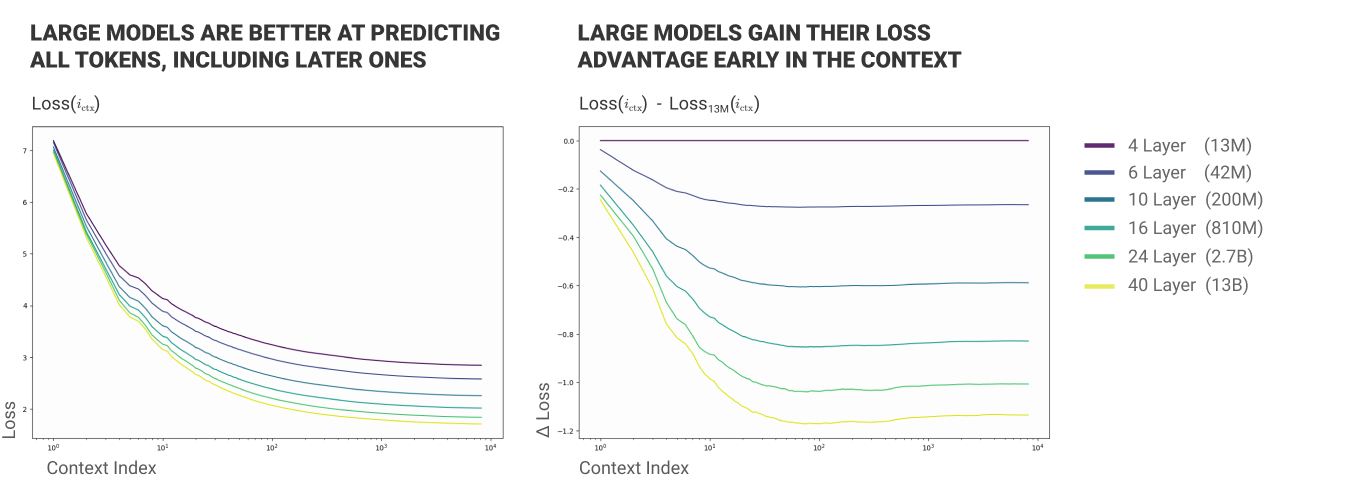
연구진은 큰 모델이 초반 맥락에서 많은 정보를 뽑아내기 때문일 것으로 추정한다. 세계 지식이 많으면 맥락에서 얻어야 할 정보가 줄어든다는 식이다. 그렇다면 큰 모델은 같은 고정폭을 더 어려운 조건에서 얻어내는 셈이고, 이 관점이 현상을 “충격적"에서 “이상한” 정도로 누그러뜨린다고 적는다.
둘째, 손실 곡선의 도함수를 보면 모델 크기별 순서가 상전이에서 뒤집힌다. 상전이 이전에는 작은 모델의 손실이 더 느리게 줄고, 이후에는 반대가 된다.
나머지 미해결 관찰은 목록으로만 제시된다.
- 6층 어텐션 전용 모델에는 학습 후반부에 발달하는 특이한 헤드가 있다. 인덕션 헤드가 아닌데 제거하면 상전이를 되돌린 것과 비슷한 효과가 난다.
- 4층 MLP 모델의 절제 결과는 다른 모델들과 달리 “뾰족"하지 않다.
- 6층 MLP 모델에는 손실 스파이크가 있는데 원인을 모른다.
- 6층 MLP 모델에는 제거했을 때 인컨텍스트 러닝 점수에 반대 방향 효과를 내는 인덕션 헤드가 하나 있다.
- 16층을 넘는 풀스케일 모델에는 접두 일치 점수는 높은데 복사 점수는 음수인 헤드가 몇 개 나타난다. 정의상 인덕션 헤드가 아니다.
안전성 함의
논문이 정리한 함의는 세 가지다.
첫째, 상전이다. 신경망 행동이 규모에 따라 불연속적으로 바뀐다면 연구자도 사회도 미래의 문제에 대비하기 어려워진다. 보상 해킹 같은 안전 문제도 이런 상전이로 출현할 수 있다.
둘째, 인컨텍스트 러닝이다. 능력이 낮은 신경망을 다룰 때는 학습이 끝난 뒤의 행동을 고정된 것으로 취급하고 싶어진다. 인컨텍스트 러닝은 추론 시점에도 모델 행동이 어떤 의미로든 변할 수 있음을 드러낸다. 새로 배우는 것이라기보다 이미 학습한 행동을 “찾아내는” 것으로 본다 해도, 그 행동이 놀랍고 원치 않는 분포 외 일반화일 수 있다.
셋째, 메사 최적화다. 인컨텍스트 러닝의 기전이 메사 최적화, 즉 모델이 내부 최적화 알고리즘을 발달시키는 상황일지 모른다는 우려가 있었다. 이 논문은 적어도 작은 모델에서 인컨텍스트 러닝의 주 기전이 인덕션 헤드라고 본다. 메사 최적화의 증거는 관찰되지 않았다.
연구진은 이 상전이가 기계적 해석가능성, 학습 역학, 스케일링 법칙을 잇는 로제타석 역할을 할 수 있다고 제안한다. 작은 모델에서 탐구할 수 있고, 학습 과정의 짧은 구간에 한정되며, 커뮤니티가 관심 있어 하는 능력과 연결되어 있기 때문이다.
외부 재현
학술지 Distill이 시도했던 토론 아티클 형식을 본떠, 연구진은 인덕션 헤드를 연구하던 외부 연구자들을 초청해 논평을 함께 실었다.
Redwood Research의 Adam Scherlis는 2층 어텐션 전용 트랜스포머에서 인덕션 헤드가 안정적으로 나타나는 것을 확인했다. 층 번호를 0부터 세어, 0층에 이전 토큰 헤드가 있고 1층에 인덕션 헤드가 있는 구조였다. 어텐션 점수 행렬을 이상적인 버전으로 교체하고 손실 변화를 절제와 비교하는 방식으로 검증했다. 이전 토큰 헤드의 점수를 정확한 이전 토큰 어텐션으로 바꾸자 손실 차이의 99%가 재현됐다. 인덕션 헤드의 점수를 단순 근사로 바꾸자 약 65%가 재현됐고, [A][B][C]...[A][B]→[C] 형태까지 포함하자 10%가 추가로 재현됐다.
암스테르담 대학의 Tom Lieberum은 이 논문의 경험적 기준을 공개 모델에 적용했다. GPT-2와 GPT-Neo에서 주로 중간 깊이에 인덕션 헤드 후보를 발견했고, GPT-2 XL은 21번 층의 20번 헤드, GPT-Neo-2.7B는 12번 층의 0번 헤드가 그렇다고 보고했다. 합성 데이터셋에서는 맥락 길이가 4일 때에도 귀납이 쉽게 학습됐는데, 그는 이것이 모델의 성질이라기보다 데이터 분포의 성질이라고 본다.
점수가 올라가는 잘못된 방법
절제 실험의 부수 결과가 가장 오래 남았다. 인덕션 헤드 이외의 헤드를 제거하면 인컨텍스트 러닝 점수가 올라간다는 대목이다.
지표가 차이값이라서 생기는 일이다. 앞쪽 토큰의 예측을 망가뜨려도 500번째와 50번째의 손실 차이는 커진다. 모델을 손상시켜 점수를 얻는 경로가 이 지표에 이미 내재한다. 논문은 이 성질을 숨기지 않고 절제 실험을 다룬 절과 미해결 관찰을 모은 절, 두 곳에서 반복해 설명한다. 인컨텍스트 러닝 점수가 모델 크기와 무관하게 0.4 nat로 고정된다는 수수께끼도 같은 성질에서 나온다. 기준선이 내려가면 같은 차이를 만들기가 더 어려워지는데, 그 어려움과 능력의 향상이 정확히 상쇄되는 이유를 논문은 설명하지 못한다.
지표를 만들고 그 지표로 결론을 내리는 모든 작업에 같은 위험이 있다. 이 논문이 좋은 것은 자기가 만든 지표가 어디서 어긋나는지를 본문에 적어 두었다는 점이다. 여섯 논거마다 증거 강도를 표로 자기 채점하고, 대형 모델에서는 상관 증거뿐이라고 반복해 적고, 공통 잠재 변수라는 대안 가설을 스스로 제시한다. 2022년 논문을 2026년에 읽고 나니 주장의 내용보다 그 태도가 더 오래 남는다.
출처
Catherine Olsson, Nelson Elhage, Neel Nanda, Nicholas Joseph, Nova DasSarma, Tom Henighan, Ben Mann, Amanda Askell, Yuntao Bai, Anna Chen, Tom Conerly, Dawn Drain, Deep Ganguli, Zac Hatfield-Dodds, Danny Hernandez, Scott Johnston, Andy Jones, Jackson Kernion, Liane Lovitt, Kamal Ndousse, Dario Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish, Chris Olah. “In-context Learning and Induction Heads”, Transformer Circuits Thread, 2022.
원문: https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html
본문 그림은 모두 원문에서 가져왔다.