3줄 요약
- 스탠퍼드 대학교 Hazy Research와 Together AI 연구진이 확산 언어 모델(DLM)의 느린 반복 샘플링과 큰 학습 비용을 해결하기 위해 토크나이저와 생성기를 차례로 학습하는 Next-Concept Modeling(NCM)을 발표했다.
- 다중 스케일 잔차 VQ-VAE 토크나이저가 문장을 코드 수가 적은 개략 단계부터 코드 수가 많은 세부 단계까지 여러 단계의 이산 코드로 부호화하고, 트랜스포머는 첫 단계부터 차례로 단계마다 코드 전부를 한 번에 생성한다.
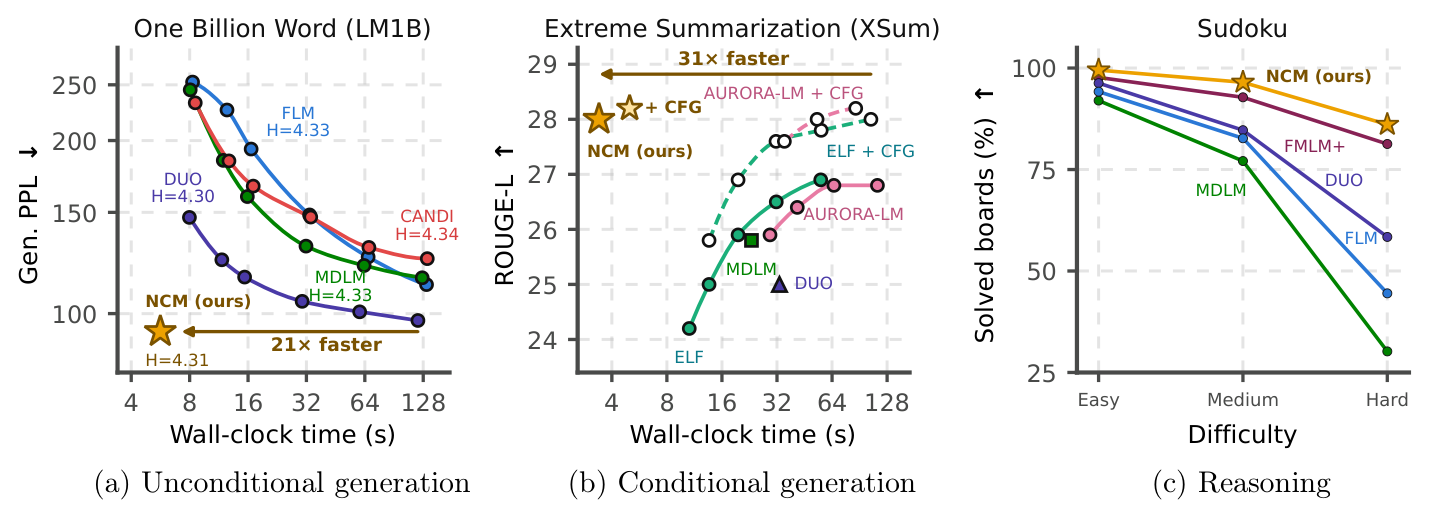
- 약 1억 파라미터 규모 실험에서 NCM은 가장 성능이 좋은 확산 비교군보다 LM1B에서 21배, OpenWebText에서 10배, XSum 요약에서 31배 빠르게 문장을 생성하면서 품질은 같거나 더 좋았다. 학습 토큰은 4~5배 적게 썼고, 2,500만 파라미터 규모의 스도쿠 추론에서는 모든 난이도에서 정답률이 가장 높았다.
확산 언어 모델의 세 가지 병목
자기회귀(Autoregressive, AR) 언어 모델은 토큰을 한 번에 하나씩 순서대로 생성하므로 문장 길이 $L$만큼의 순차 단계를 거쳐야 한다. 이 추론 지연을 줄이기 위해 등장한 비자기회귀 대안이 확산 언어 모델(Diffusion Language Model, DLM)이다. 최근에는 수십억 파라미터 규모의 오픈 모델 LLaDA가 공개됐고, Mercury와 DiffusionGemma가 상용 서비스에 쓰이고 있으며, DFlash처럼 확산 모델을 투기적 디코딩(speculative decoding)의 초안 생성기로 활용하는 시도도 이어지고 있다.
원리상 확산 언어 모델은 여러 토큰을 동시에 예측하므로 토큰 수보다 훨씬 적은 단계만으로 문장을 완성할 수 있어야 한다. 그러나 실제 추론과 학습에서는 세 가지 병목이 발생한다.
첫째, 여전히 많은 샘플링 단계가 필요하다. 토큰을 병렬로 예측하더라도 노이즈를 조금씩 제거하는 과정을 수십 번에서 수백 번 반복해야 하며, 단계 수를 줄이면 문장 품질이 급감한다. 교사 모델을 적은 단계로 압축하는 증류(distillation)나 플로우 맵(flow map) 기법이 제안됐지만, 이미 학습 비용이 큰 모델에 추가 학습 과정을 더해야 한다. 게다가 적은 단계로 압축된 모델은 표본 다양성 지표인 평균 유니그램 엔트로피($H$)가 낮아지는 대가를 치른다.1
둘째, 단계당 연산 비용이 크다. 전체 시퀀스 확산 모델은 샘플링 단계마다 길이 $L$인 시퀀스 전체를 처리한다. 또한 양방향 어텐션(bidirectional attention)을 사용하기 때문에 자기회귀 모델처럼 이전 단계의 키와 값(KV) 캐시를 그대로 재사용할 수 없다. 문장을 여러 블록으로 구분해 블록 내부만 병렬로 노이즈를 제거하는 블록 자기회귀 확산(block-autoregressive diffusion) 방식을 쓰면 KV 캐시를 활용할 수 있지만, 앞 블록 생성이 끝날 때까지 다음 블록이 대기해야 하므로 병렬성이 줄어든다.
셋째, 학습 예산이 방대하다. 기존 확산 언어 모델이 높은 품질로 수렴하려면 같은 데이터셋을 여러 번 학습해야 한다. 예를 들어 대표적인 이산 확산 모델인 MDLM과 DUO는 OpenWebText 데이터셋에서 100만 스텝 동안 5,000억 개가 넘는 토큰을 처리하며 학습한다.
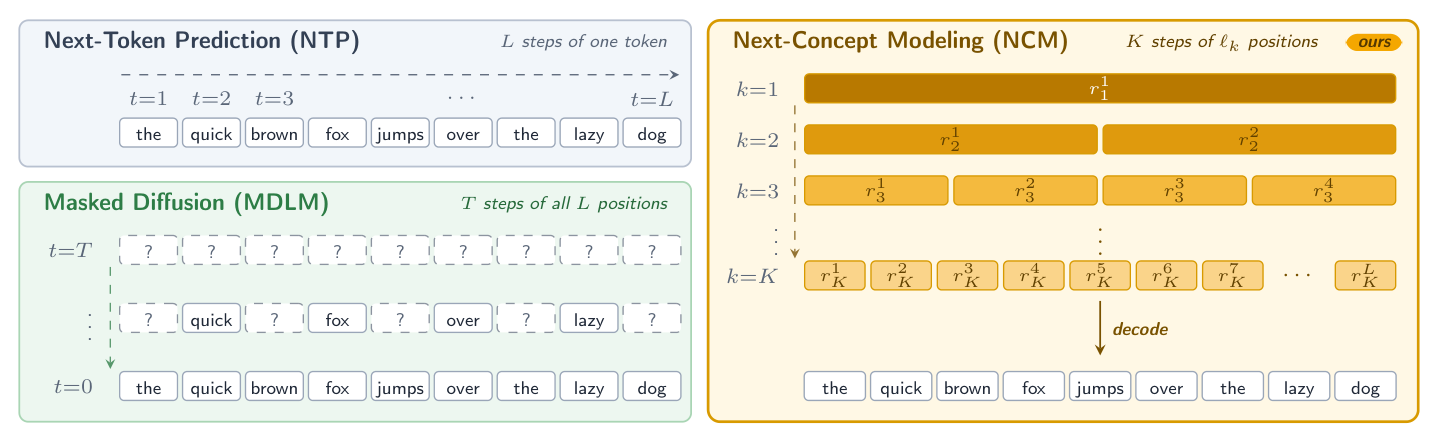 원문 Figure 2: 세 가지 텍스트 생성 패러다임 비교. 다음 토큰 예측(NTP)은 매 단계 토큰 1개씩 총 $L$단계를 진행하고, 마스크 확산(MDLM)은 모든 $L$개 토큰 칸을 $T$단계에 걸쳐 반복 정제한다. NCM은 $K \ll L$개의 계층 단계를 거치며, 각 단계 $k$의 코드 $\ell_k$개를 동시에 예측한 뒤 마지막에 토큰으로 복호화한다. 출처: arXiv:2610.14162
연구진이 제안한 Next-Concept Modeling(NCM)은 텍스트의 표현 방식과 생성 스케줄을 함께 바꾼다. 이미지 생성에서 낮은 해상도부터 높은 해상도까지 단계별로 모든 패치를 병렬 예측하는 다음 스케일 예측(Next-Scale Prediction)을 쓰는 VAR에서 착안해, 문장 전체를 $K$개 단계($K \ll L$)의 이산 코드 계층으로 표현한다. 첫 단계는 길이 $\ell_1$의 짧은 코드 열로 문장의 개요를 나타내고, 뒤 단계로 갈수록 코드 개수($\ell_k$)가 늘어나면서 세부 표현을 보완한다. 논문에서 말하는 ‘개념(concept)’은 이 계층의 개략 단계들이 부호화하는 상위 수준의 문장 정보를 가리킨다.
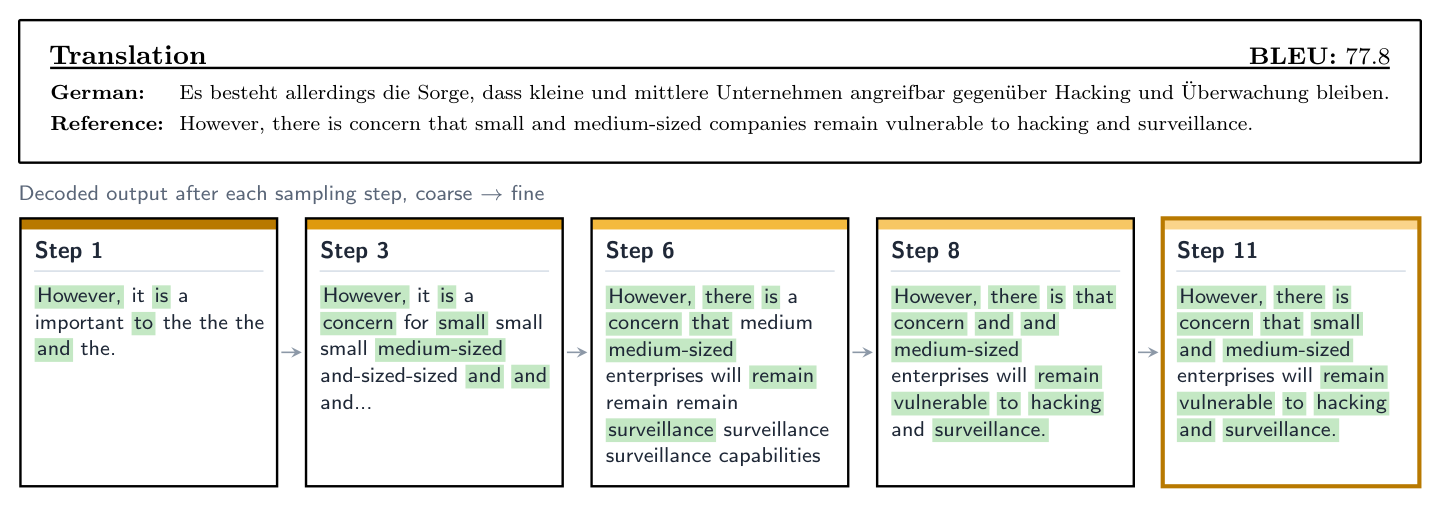 원문 Figure 3: WMT14 독일어-영어 번역에서 샘플링 단계별 복호화 결과(최종 BLEU 77.8). 초록색 음영은 정답 참조문과 일치하는 단어다. 출처: arXiv:2610.14162
독일어 원문(“중소기업이 해킹과 감시에 취약한 상태로 남을 수 있다는 우려가 있다”)을 영어로 번역하는 예에서 1단계 복호화 결과는 “However, it is a important to the…” 수준에 그친다. 이어 3단계에서 concern, small, medium-sized가 나타나고, 6단계에서 enterprises, remain, surveillance가 추가된다. 8단계에서는 vulnerable to hacking이 추가되고, 마지막 11단계에서 중복 단어가 사라져 참조 번역문과 거의 같은 문장이 된다.2
다중 스케일 잔차 토크나이저와 단계별 병렬 생성
이미지는 가로세로 픽셀을 평균 내거나 보간하는 방식으로 자연스럽게 해상도를 줄일 수 있지만, 이산적인 단어 토큰으로 이루어진 텍스트에는 그에 대응하는 자명한 다운샘플링 연산이 없다. 또한 이미지에서는 픽셀 몇 개가 미세하게 달라도 육안으로 구분하기 어렵지만, 텍스트에서는 토큰 하나만 틀려도 문장 의미가 바뀌거나, 프로그램이 실행되지 않거나, 스도쿠 답이 틀린다. NCM은 이를 해결하기 위해 1차 학습에서 다중 스케일 잔차 VQ-VAE 토크나이저를 먼저 학습해 동결하고, 2차 학습에서 이 코드 계층을 생성하는 트랜스포머를 학습한다.
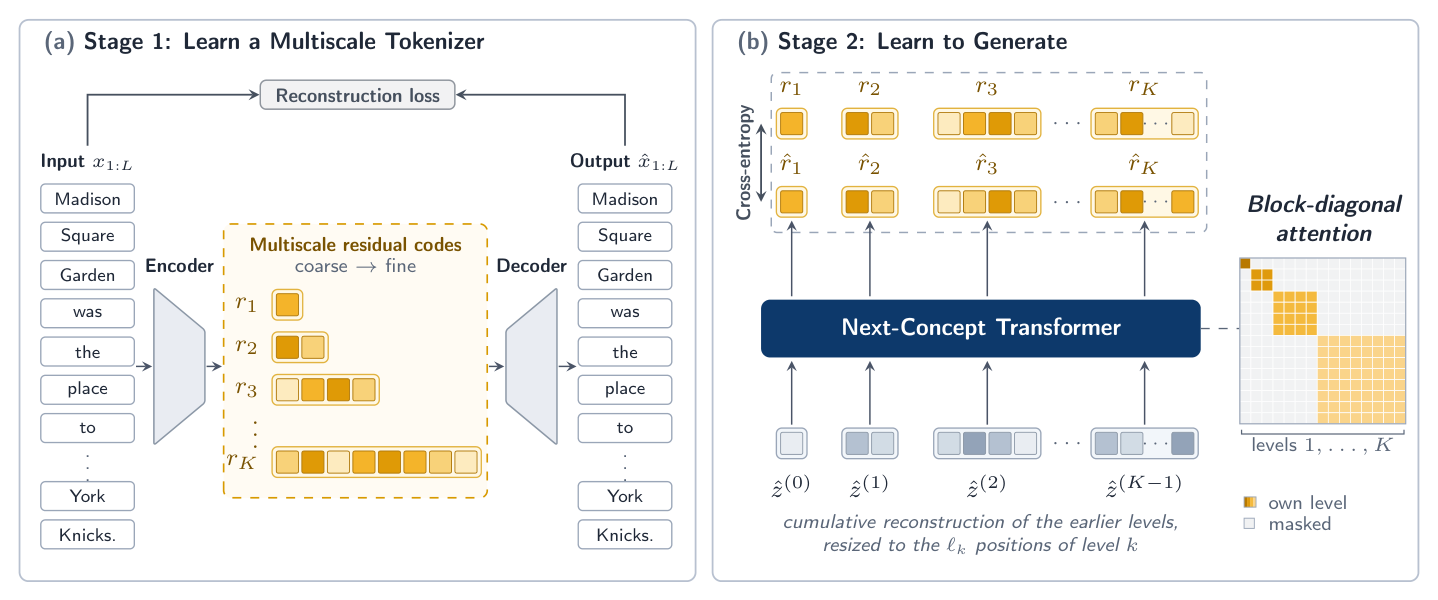 원문 Figure 4: NCM의 1차, 2차 학습. (a) 다중 스케일 잔차 VQ-VAE 토크나이저 학습과 (b) 누적 복원 벡터 $\hat{z}^{(k-1)}$를 입력받는 트랜스포머 생성기 학습. 출처: arXiv:2610.14162
토크나이저의 인코더 $E_\phi$는 길이 $L$인 토큰 시퀀스 $x \in \mathcal{T}^L$을 잠재 벡터 $z = E_\phi(x) \in \mathbb{R}^{L \times d}$로 변환한다. 초기 잔차는 $z^{(0)} = z$, 초기 누적 복원값은 $\hat{z}^{(0)} = 0$이다. 단계 $k \in \{1, \dots, K\}$는 이전 단계까지 표현하지 못한 잔차 $z^{(k-1)}$를 길이 $\ell_k$($\ell_1 < \ell_2 < \dots < \ell_K = L$)로 다운샘플링하고, 그 단계의 코드북 $\mathcal{V}_k$에서 가장 가까운 벡터의 인덱스 $r_k^i$를 찾는다.3
$$u_k = \text{Down}_k(z^{(k-1)}) \in \mathbb{R}^{\ell_k \times d}$$$$r_k^i = \arg\min_{j \in \{1, \dots, |\mathcal{V}_k|\}} \| u_k^i - e_{k,j} \|_2^2$$선택된 코드북 벡터 $e_k(r_k) \in \mathbb{R}^{\ell_k \times d}$는 복원 연산자 $R_k$로 길이 $L$까지 늘린 뒤 누적 복원 벡터에 더한다.
$$\hat{z}^{(k)} = \hat{z}^{(k-1)} + R_k(e_k(r_k))$$$$z^{(k)} = z - \hat{z}^{(k)}$$이때 토크나이저를 단순하게 학습하면 모델이 개략 단계의 짧은 코드들을 무시하고 길이가 $L$인 마지막 단계에만 모든 정보를 부호화하기 쉽다. 연구진은 개략 단계들이 유의미한 전역 정보를 반드시 포함하도록 중첩 드롭아웃(nested dropout)을 적용했다. 중첩 드롭아웃은 학습 중 절단 단계 $k \in \{1, \dots, K\}$를 무작위로 뽑고, 첫 $k$개 단계만 합산한 부분 복원 벡터 $\hat{z}^{(k)}$로 원문 토큰의 교차 엔트로피 복원 손실과 양자화 손실을 계산한다. 첫 몇 단계만으로도 원문을 복원해야 하므로 개략 단계 코드가 전역 정보를 부호화하게 된다.4
| 데이터셋 | 복원 정확도(%) | 코드북 활용률(%) |
|---|---|---|
| OpenWebText | 99.99 | 83.10 |
| LM1B | 99.86 | 89.31 |
| TinyStories | 99.98 | 90.12 |
| XSum (요약) | 99.79 | 86.20 |
| WMT14 (번역) | 98.79 | 61.89 |
| Sudoku (추론) | 100.00 | 80.73~83.85 |
숫자 하나만 틀려도 오답이 되는 스도쿠에서는 쉬움, 보통, 어려움 모든 난이도에서 복원 정확도 100.00%를 기록했고, OpenWebText와 TinyStories의 복원 정확도도 각각 99.99%와 99.98%였다.5
생성기 학습에서는 토크나이저를 동결한 뒤 약 1억 파라미터 규모의 NCM 트랜스포머 생성기를 학습한다. 생성기는 이전 단계까지의 누적 복원 벡터 $\hat{z}^{(k-1)}$를 조건으로 삼아 현재 단계 $k$에 속한 $\ell_k$개의 코드를 한 번의 순전파(forward pass)로 동시에 예측한다.
$$p_\theta(r_{1:K}) = \prod_{k=1}^K p_\theta(r_k \mid \hat{z}^{(k-1)})$$$$p_\theta(r_k \mid \hat{z}^{(k-1)}) = \prod_{i=1}^{\ell_k} p_\theta(r_k^i \mid \hat{z}^{(k-1)})$$NCM 생성기는 블록 대각 어텐션(block-diagonal attention)과 조건 오염(conditioning corruption)을 사용한다. 먼저 블록 대각 어텐션에서 단계 $k$의 입력은 직전 단계까지의 누적 복원 벡터 $\hat{z}^{(k-1)}$를 현재 단계의 길이 $\ell_k$에 맞게 크기 변환(resize)하고 은닉 차원으로 투영한 값이다. 입력 자체가 이미 $1$단계부터 $k-1$단계까지의 정보를 모두 합산한 값이므로, 트랜스포머는 이전 단계 블록을 다시 참조할 필요가 없고 각 단계 블록이 자기 블록만 참조하는 블록 대각 어텐션으로 충분하다. 학습 때는 $K$개 단계를 한 번의 순전파로 계산하고, 추론 때는 단계 $k$에서 길이 $\ell_k$만 처리한다.6
조건 오염은 학습과 추론 사이의 입력 불일치를 줄인다. 학습 중에는 정답 코드로 만든 깨끗한 누적 복원 벡터를 입력으로 주지만(teacher forcing), 실제 추론 중에는 모델이 스스로 예측한 코드들을 바탕으로 다음 단계를 생성한다. 각 단계의 코드들을 병렬로 뽑기 때문에 일부 코드에서 발생한 오류가 누적 복원 벡터에 섞여 다음 단계로 전파될 수 있다. 연구진은 학습 때 입력 조건 코드 일부를 같은 단계 코드북의 임의의 코드로 바꿔 오염된 누적 복원 벡터 $\tilde{z}^{(k-1)}$를 만들고, 정답 레이블은 깨끗한 코드 $r_k^i$로 둔다. 모델은 오염된 조건에서도 올바른 코드를 예측하도록 학습된다.7
프롬프트가 주어지는 조건부 생성(번역, 요약, 스도쿠)에서는 블록 대각 어텐션에 프리픽스 언어 모델(Prefix-LM) 방식 어텐션을 더한다. 프롬프트 토큰들은 동결된 VQ-VAE 인코더의 임베딩 테이블을 통해 변환된 뒤 서로를 자유롭게 참조하고, 생성 대상인 각 단계 블록은 프롬프트 전체와 자기 단계 블록만 참조한다.
무조건부 및 조건부 생성과 스도쿠 추론 성능
연구진은 무조건부 생성(TinyStories, LM1B, OpenWebText), 조건부 생성(WMT14 독일어-영어 번역, XSum 극단적 요약), 논리 추론(스도쿠) 세 영역에서 NCM을 평가했다. 효율성 지표는 생성기 호출 횟수를 뜻하는 함수 평가 횟수(NFE)와 단일 NVIDIA H100 SXM 80GB GPU(배치 크기 16)에서 시퀀스 1,024개를 생성하는 실제 소요 시간(wall-clock time) 두 가지다.
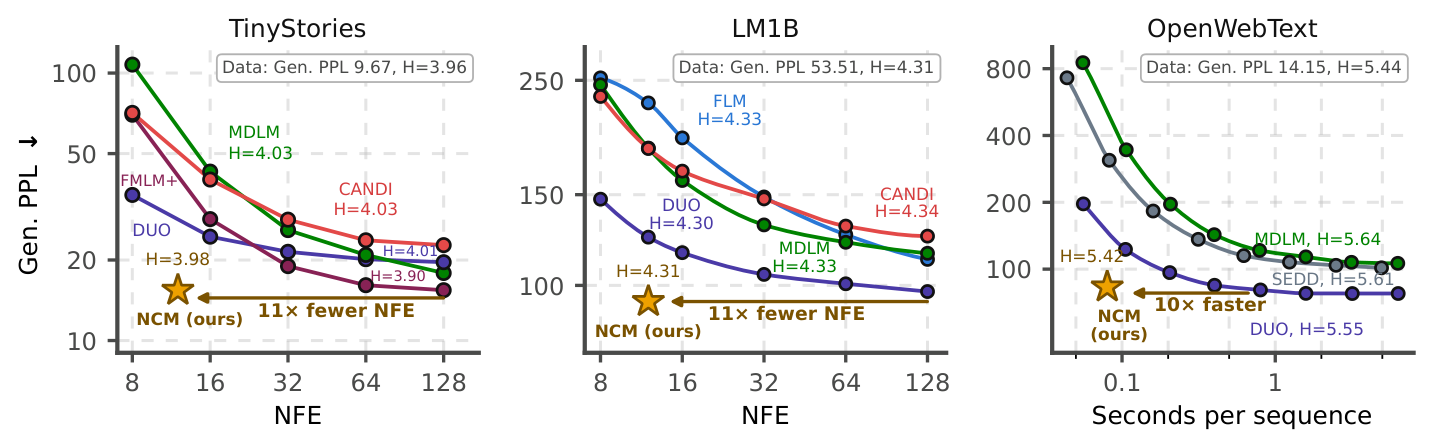 원문 Figure 5: TinyStories, LM1B, OpenWebText에서 함수 평가 횟수(NFE) 및 시퀀스당 생성 시간 대비 생성 퍼플렉시티(Gen. PPL). 출처: arXiv:2610.14162
무조건부 생성의 품질 지표는 문장 유창성을 재는 생성 퍼플렉시티(Gen. PPL, 낮을수록 우수)와 표본 다양성을 재는 유니그램 엔트로피($H$, 실제 데이터의 $H$와 가까울수록 우수)다.
| 데이터셋 | 방법 | NFE | Gen. PPL ↓ | 엔트로피(H) |
|---|---|---|---|---|
| TinyStories | 실제 데이터 | - | 9.67 | 3.96 |
| MDLM | 128 | 17.89 | 4.03 | |
| DUO | 128 | 19.63 | 4.01 | |
| FMLM+ | 128 | 15.43 | 3.90 | |
| NCM | 12 | 15.41 | 3.98 | |
| LM1B | 실제 데이터 | - | 53.51 | 4.31 |
| MDLM | 128 | 115.45 | 4.33 | |
| FLM | 128 | 112.33 | 4.33 | |
| DUO | 128 | 97.30 | 4.30 | |
| NCM | 12 | 93.05 | 4.31 | |
| OpenWebText | 실제 데이터 | - | 14.15 | 5.44 |
| MDLM | 1,024 | 105.15 | 5.63 | |
| SEDD | 1,024 | 101.43 | 5.61 | |
| DUO | 1,024 | 77.69 | 5.55 | |
| NCM | 32 | 83.12 | 5.42 |
TinyStories와 LM1B에서 NCM(97M)은 단 12번의 함수 평가(NFE)만으로 128번을 호출하는 확산 모델들보다 모두 퍼플렉시티가 낮았다. LM1B에서 생성 퍼플렉시티는 NCM이 93.05, DUO가 97.30이었다. NCM의 엔트로피는 실제 데이터와 같은 4.31이었고, 생성 속도는 128 NFE를 쓰는 DUO보다 21배 빨랐다.8 1,024토큰을 생성하는 OpenWebText 실험에서 NCM(95M)은 32단계를 사용했다. 생성 퍼플렉시티는 NCM이 83.12, MDLM이 105.15, SEDD가 101.43이었다. NCM은 1,024단계를 쓰는 이산 확산 모델들보다 생성 속도가 10배 빨랐다.9
조건부 생성인 WMT14 독일어-영어 번역과 XSum 문서 요약 결과는 다음과 같다. 분류기 없는 가이던스(classifier-free guidance, CFG)를 쓰지 않는 기본 설정에서 XSum용 NCM(88M)은 8 NFE로 ROUGE-1 35.0, ROUGE-2 12.8, ROUGE-L 28.0을 기록했다. 128 NFE를 쓰는 확산 요약 모델 중 가장 성능이 좋은 AURORA-LM(130M, ROUGE-L 26.6)보다 높고, 생성 속도는 31배 빠르다.
| 디코딩 설정 | 방법 | WMT14 BLEU (NFE) | XSum ROUGE-L (NFE) |
|---|---|---|---|
| 가이던스 없음 | AR (99M) | 25.2 (64) | 24.4 (64) |
| MDLM (99M) | 18.4 (64) | 25.8 (64) | |
| DUO (205M) | 21.3 (64) | 25.0 (64) | |
| E2D2 (99M) | 24.8 (64) | 22.0 (64) | |
| ELF (140M) | 17.2 (64) | 26.4 (64) | |
| AURORA-LM (130M) | - | 26.6 (128) | |
| NCM (120M/88M) | 22.6 (11) | 28.0 (8) | |
| CFG 또는 MBR | ELF + CFG | 26.4 (128) | 27.8 (128) |
| AURORA-LM + CFG | - | 28.6 (184) | |
| NCM + CFG | 23.9 (22) | 28.2 (16) | |
| NCM + MBR | 25.2 (132) | 29.6 (128) |
NCM은 표본 하나를 만드는 비용이 낮다. 기존 확산 모델이 표본 하나에 쓰는 연산 예산으로 후보 문장을 여러 개 생성한 뒤, 후보끼리의 평균 유사도가 가장 높은 문장을 고르는 최소 베이즈 위험(Minimum Bayes Risk, MBR) 디코딩을 적용할 수 있다. XSum에서 후보 16개를 뽑아 MBR 디코딩을 수행한 NCM(총 128 NFE)은 ROUGE-L 29.6을 달성해 가이던스를 적용한 AURORA-LM(184 NFE, 28.6)보다 ROUGE-L이 더 높았다. WMT14 번역에서도 후보 12개를 쓰는 NCM + MBR(132 NFE)이 BLEU 25.2를 기록해 자기회귀 모델(25.2)과 동률을 이뤘다.
| 분류 | 방법 (크기) | NFE ↓ | 쉬움(%) | 보통(%) | 어려움(%) |
|---|---|---|---|---|---|
| 자기회귀 | AR Greedy (25M) | 128 | 14.6 | 5.1 | 1.0 |
| 이산 확산 | MDLM (29M) | 128 | 92.0 | 77.1 | 30.2 |
| DUO (29M) | 128 | 96.3 | 84.7 | 58.4 | |
| 연속 플로우 | FLM (29M) | 128 | 94.2 | 82.7 | 44.5 |
| S-FLM (29M) | 128 | 94.8 | 85.2 | 45.0 | |
| FMLM+ (29M) | 16 | 97.7 | 92.8 | 81.3 | |
| 제안 모델 | NCM (25M) | 12 | 99.5 | 96.5 | 86.1 |
스도쿠는 9×9 보드의 가로줄, 세로줄, 3×3 박스마다 1부터 9까지의 숫자가 중복 없이 들어가야 한다. 첫 칸부터 차례대로 숫자를 하나씩 확정하며 이미 적은 숫자를 고치지 못하는 자기회귀 모델(AR Greedy)은 힌트가 30개뿐인 어려움 난이도에서 정답률이 1.0%에 그쳤다. 반면 NCM(25M)은 보드 전체의 표현을 개략 단계부터 세부 단계로 정제하며 앞 단계의 부분 해답을 수정한다. 12 NFE를 사용한 NCM의 정답률은 쉬움 99.5%, 보통 96.5%, 어려움 86.1%로, 모든 확산, 플로우 기반 비교군보다 높았다.10
스케일링, 학습 효율, 계층 프로빙 분석
NCM의 10~31배 추론 가속에는 함수 평가 횟수(NFE) 감소 외에 단계당 연산량 감소도 기여한다. 전체 시퀀스 확산 모델은 단계마다 길이 $L$ 전체를 계산하지만, NCM은 개략 단계들의 코드 길이 $\ell_k$가 매우 짧아 단계당 평균 연산량이 훨씬 적다.
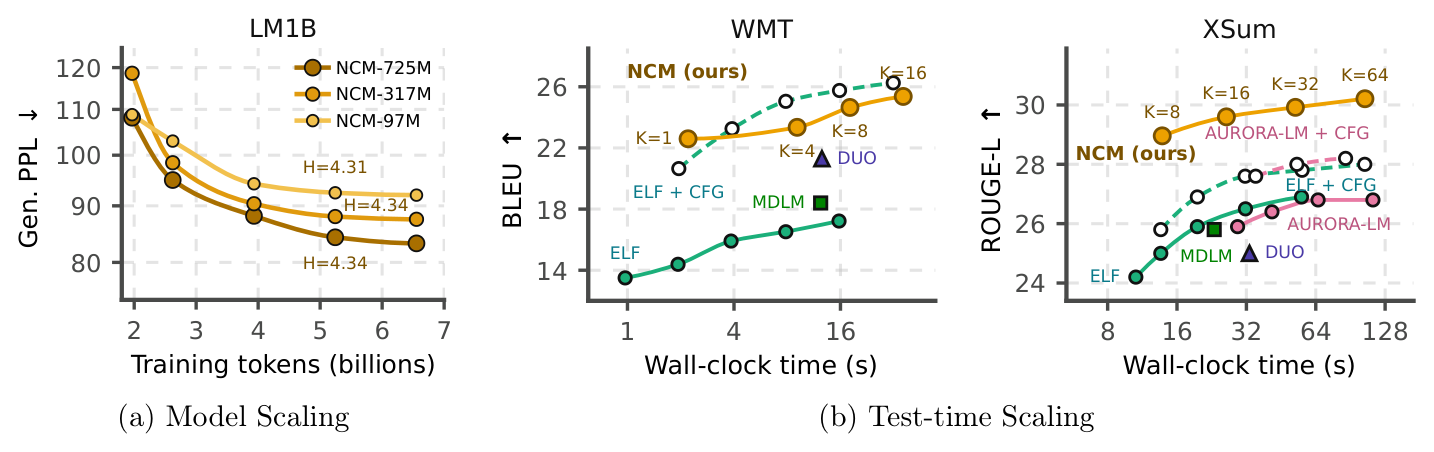 원문 Figure 6: (a) LM1B에서 생성기 파라미터 규모(97M, 317M, 725M)에 따른 학습 곡선과 (b) WMT14 번역 및 XSum 요약에서 MBR 디코딩 시 추론 시간 대비 성능 곡선. (b)의 $K$는 후보 문장 수다. 출처: arXiv:2610.14162
생성기 트랜스포머의 크기를 97M, 317M, 725M으로 늘리면 같은 학습 토큰 예산에서 LM1B 생성 퍼플렉시티가 꾸준히 낮아졌다. 학습에 투입된 전체 토큰 노출량도 비교했다. LM1B에서 토크나이저(68.04억)와 생성기(65.54억)를 합산한 NCM의 학습 토큰은 총 133.6억 개로, 확산 모델들이 사용한 660억 개보다 4.9배 적었다. OpenWebText에서도 NCM은 총 1,272.2억 개(토크나이저 616.8억 + 생성기 655.4억)를 사용해 5,000억 개 이상을 쓰는 MDLM과 DUO보다 약 4배 적은 학습 토큰으로 수렴했다. 확산 모델은 가능한 마스크 복원 순서를 모두 학습해야 하지만, NCM은 개략 단계부터 세부 단계까지 고정된 한 가지 순서만 학습한다.
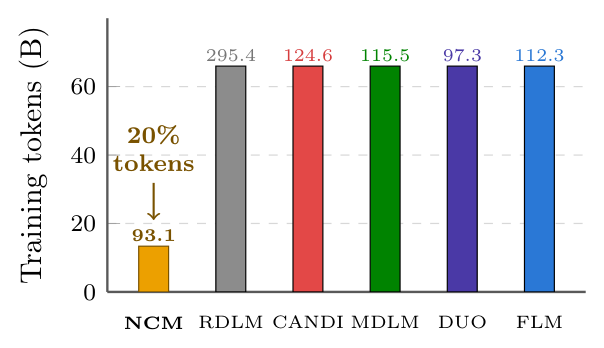 원문 Figure 7: LM1B 수렴까지의 총 학습 토큰 수. 막대 위 숫자는 Gen. PPL이다. 출처: arXiv:2610.14162
그렇다면 개략 단계의 코드들은 실제로 어떤 정보를 부호화하고 있을까. 연구진은 12단계로 구성된 TinyStories 모델을 대상으로 세 가지 프로빙 실험을 수행했다.
첫째, 원래 이야기의 1~3단계 코드만 고정하고 4~12단계를 서로 다른 랜덤 시드로 다시 샘플링했다. 그러자 전체 단어의 42%~54%가 바뀌었음에도 이야기의 핵심 줄거리는 유지됐다. 예를 들어 원래 이야기(Story A)는 추운 날 밖에 나간 소녀가 큰 나무 아래 상자에서 덮개를 찾아 입었는데 그 덮개가 갑자기 살아 움직이는 내용이다. 1~3단계를 고정하고 나머지를 새로 생성하자 주인공 이름은 ‘Sue’로, ‘나뭇잎 덮개(wrap)’는 ‘목도리(scarf)’나 ‘스웨터(sweater)’로 바뀌었다. 그래도 “추위를 피하려고 나무 아래 상자에서 옷가지를 찾아 입었는데 마지막에 그 옷가지가 스스로 움직였다”는 서사 구조는 두 시드 모두에서 같았다.
둘째, 서로 다른 두 이야기의 개략 단계 표현을 절반씩 섞은 뒤 이후 단계를 생성하자 두 이야기의 소재와 사건이 결합됐다. 크레용으로 폐간판에 그림을 그리는 쌍둥이 이야기와 추운 날 움직이는 덮개를 발견하는 소녀 이야기를 섞자, 아이들이 크레용으로 간판에 그림을 그리며 추위를 이기려다 그림 속 형상들이 살아 움직이는 이야기가 만들어졌다.
셋째, 1단계의 코드 여덟 개 중 두 개만 검증 데이터셋의 다른 이야기 코드로 치환해 같은 시드로 생성했다. 그러자 줄거리는 유지됐고, 등장인물이나 핵심 소품과 사건만 바뀌었다. 등장인물이 바뀐 예에서는 고양이 Lily가 소녀 Sue가 됐다.
현재 NCM은 계층 깊이 $K$와 단계별 코드 길이 스케줄 $\ell_k$를 사전에 고정하므로, 짧은 응답이나 쉬운 문장을 생성할 때도 $K$단계를 모두 거쳐야 한다. 입력 난이도에 따라 단계 수를 조절하는 적응형 스케줄이 도입된다면 연산을 추가로 아낄 수 있다. 또한 토크나이저와 생성기를 따로 학습하고 있어 표현 학습이 생성 목적함수와 직접 정렬되지 않는다는 한계가 있다. 현재 7억 2,500만 파라미터(725M)까지 확인한 스케일링 실험을 수십억 파라미터 규모와 대규모 코퍼스로 확장하는 과제가 남아 있다.
가장 흥미로운 지점
이미지에서 통하던 다음 스케일 예측을 텍스트에 적용하려면 무엇을 바꿔야 하는지, 이 논문의 답이 가장 궁금했다. 부록의 어텐션 절제 실험(Table 9)을 보면 자기 단계 블록만 참조하는 블록 대각 어텐션이 이전 단계 블록까지 모두 참조하는 블록 인과 어텐션보다 생성 속도와 퍼플렉시티 모두 더 좋았다. 누적 복원 벡터 $\hat{z}^{(k-1)}$가 이전 단계들의 코드북 벡터를 선형 합산해 전역 문맥을 이미 전달하므로, 이전 단계 블록들에 다시 어텐션을 계산하는 과정은 표현력을 높이기보다 최적화 부담만 늘렸던 셈이다.
1단계 코드 두 개만 치환한 프로빙 실험에서도 개략 단계 코드의 역할이 확인된다. 자기회귀 모델은 첫 토큰부터 차례로 확정하느라 전역 구조를 미리 계획하거나 수정하기 어렵고(스도쿠 어려움 정답률 1.0%), 확산 모델은 수백 단계 동안 매번 전체 길이를 다시 계산하느라 비용이 크다. NCM은 문장의 전역 개요를 짧은 이산 코드 몇 개로 먼저 결정한 뒤 단계마다 세부 표현을 병렬로 정제해 두 문제를 함께 줄였다.
출처
Hermann Kumbong, Ishan S. Khare, Iddah Mlauzi, Andrew Woen, Charles Ding, E. Kelly Buchanan, Simran Arora, Azalia Mirhoseini, Christopher Ré (Stanford University & Together AI), “Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation”, arXiv:2610.14162v1, 2026-10-09.
원문: https://arxiv.org/abs/2610.14162
코드 저장소: https://github.com/HazyResearch/ncm
치비 서소영 삽화 2장은 「느낌적인 느낌을 숫자로 옮기는 일」의 라인아트를 참조해 gpt-image-2.5-flare로 생성했다.
유니그램 엔트로피($H$)는 생성된 표본 내 단어 분포의 다양성을 측정하는 지표다. 반복적이거나 안전한 표현만 생성하면 GPT-2-large 기준 생성 퍼플렉시티(Gen. PPL) 수치는 낮아지지만 엔트로피 $H$가 실제 데이터보다 크게 떨어지므로, 연구진은 실제 데이터의 엔트로피 수준을 유지하는 조건에서 생성 퍼플렉시티를 비교했다. ↩︎
부록 Table 12에 수록된 전체 11단계 궤적을 보면 중간 단계의 BLEU 점수는 1단계 6.0에서 6단계 17.7, 8단계 51.7로 오른 뒤 9단계에서 38.9로 잠시 낮아졌다가 10단계 56.3, 11단계에서 77.8에 이른다. 각 단계는 앞 단계까지의 복원값에 잔차를 더하는 방식이라, 중간 복호화 품질이 단계마다 반드시 오르지는 않는다. ↩︎
부록 F.1.2의 절제 연구(ablation)에 따르면, 단계별 코드 길이 $\ell_k$를 1에서 128까지 늘리는 스케줄 중에서는 코사인(cosine), 제곱(quadratic), 선형(linear)처럼 완만하게 늘리는 쪽이 초기에 급격히 늘리는 제곱근(square-root), 로그(logarithmic) 스케줄보다 퍼플렉시티가 훨씬 낮았다. ↩︎
토크나이저 학습 목적함수 $\mathcal{L}_{\text{tok}}$은 세 손실의 합이다. 절단 단계 $k$의 토큰 복원 교차 엔트로피 손실, 인코더 출력 $z$가 양자화 벡터에서 멀어지지 않게 하는 커밋먼트 손실($\beta \, \text{MSE}(z, \text{sg}[\hat{z}^{(k)}])$), 코드북 양자화 손실($\text{MSE}(\text{sg}[z], \hat{z}^{(k)})$)이다. 여기서 $\text{sg}[\cdot]$는 그래디언트 전파를 막는 stop-gradient 연산이며, 이산 양자화 단계의 역전파에는 직통 추정기(straight-through estimator)를 사용한다. ↩︎
부록 G의 오류 분석(Table 11)에 따르면 OpenWebText에서 발생한 0.01%의 복원 오류는 주로 인접한 연도 숫자(
1957→1956,1948→1947), 유사한 범주의 고유명사(Sydney→Melbourne,Brisbane→Adelaide), 튀르키예어 발음 구별 기호(diacritics), 또는 복합어 띄어쓰기 경계에서 나타났다. ↩︎부록 F.2.1의 TinyStories 어텐션 비교 실험(Table 9)에서 블록 대각 어텐션은 Gen. PPL 15.41, 샘플링 시간 5.65초를 기록해, 이전 단계 블록들을 모두 참조하는 블록 인과(block-causal) 어텐션(Gen. PPL 19.63, 7.90초)과 직전 2개 단계만 참조하는 슬라이딩 윈도우 어텐션(Gen. PPL 17.84, 6.83초) 둘보다 품질과 속도 모두 우수했다. ↩︎
부록 F.3의 절제 연구에 따르면 조건 오염률은 개략 단계에서 높고 세부 단계로 갈수록 선형 감소하는 스케줄(평균 오염률 0.50)에서 생성 품질이 가장 높았다. ↩︎
참조 평가 모델(GPT-2-large)에 따른 편향을 배제하기 위해 연구진은 부록 E.1(Table 7)에서 Mistral-7B, Llama-3.1-8B, Gemma-2-9B, Qwen-3-14B 네 가지 외부 모델로도 LM1B 생성 결과를 평가했다. NCM(97M, 12 NFE)의 네 모델 평균 Gen. PPL은 83.24로, 128 NFE와 5배 많은 학습 토큰을 사용한 DUO(92.52), FLM(104.59), MDLM(114.31), CANDI(125.54)보다 낮았다. ↩︎
OpenWebText에서 이산 확산 모델인 DUO는 Gen. PPL 77.69로 NCM(83.12)보다 낮았으나 1,024 NFE를 사용해 생성 시간이 10배 이상 걸렸고 유니그램 엔트로피(5.55)가 실제 데이터(5.44)보다 높았다. 연속 플로우 기반 모델인 FLM(Gen. PPL 62.23, $H=5.33$)과 FMLM+(Gen. PPL 66.60, $H=5.21$)는 NCM보다 퍼플렉시티가 낮지만, 유니그램 엔트로피가 실제 데이터($H=5.44$)보다 낮다. 표본 다양성을 줄인 대가로 얻은 수치다. ↩︎
부록 J.7(Figure 20)에 수록된 어려움 난이도(힌트 30개) 스도쿠 풀이 궤적을 보면, 81칸 중 정답과 일치하는 칸 수가 1단계(코드 1개) 16칸에서 4단계(코드 6개) 21칸, 8단계(코드 26개) 44칸, 10단계(코드 50개) 62칸, 11단계(코드 67개) 64칸으로 늘어난 뒤 마지막 12단계(코드 89개, 퍼즐 구분 토큰 포함)에서 81칸 전부를 맞힌다. ↩︎