3줄 요약
- 넷플릭스 추천 연구진 12명이 2026년 8월 arXiv에 산업 논문을 올렸다. 수천 개의 수작업 피처를 쓰던 기존 판별형 랭커를 대신할 LLM 기반 추천 랭커 GenRec의 설계를 다룬다. 논문은 두 단계의 학습 과정 가운데 추천 과제에 맞춘 Phase 2 사후 학습과 서빙 방식을 주로 설명한다.
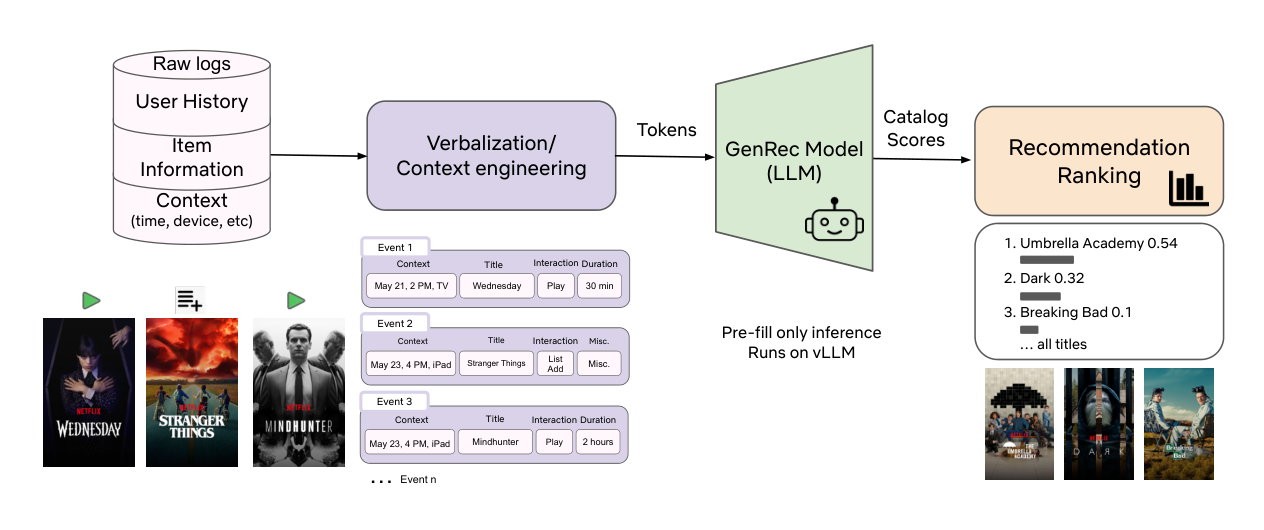
- GenRec은 회원의 시청 이력과 접속 맥락을 텍스트로 서술해 LLM에 입력하고, 카탈로그 인지 랭킹 헤드가 프리필 한 번으로 카탈로그 전체의 점수를 계산한다. Phase 2 라벨 데이터를 기존 랭커의 40분의 1만 쓰고도 오프라인 MRR이 약 1.6% 올랐다.
- 넷플릭스 트래픽의 약 10%를 4주 동안 할당한 A/B 테스트에서 GenRec은 단기 홈페이지 참여 지표를 0.115%, 장기 핵심 지표를 0.006% 개선했고, 두 결과 모두 통계적으로 유의했다. 저자들은 추천 모델을 만드는 주된 작업이 피처 설계에서 컨텍스트 설계로 바뀔 것이라고 전망했다.
기존 추천 시스템의 한계
넷플릭스의 현재 추천 시스템은 사용자와 아이템, 상호작용에 관한 수작업 피처를 대량으로 쓰고, 피처 사이의 고차 교차까지 계산한다. 용도마다 맞춤 설계한 아키텍처도 여러 가지를 쓴다. 피처 교차를 모델링하는 전용 네트워크, 회원의 관심 변화를 모델링하는 트랜스포머, 여러 추천 과제를 함께 학습하는 멀티태스크 구조 등이다.
이 시스템은 영화와 시리즈, 게임, 라이브 이벤트, 팟캐스트까지 여러 콘텐츠 종류를 추천하도록 오랜 기간 개선되어 왔다. 그런데 새 콘텐츠 종류나 새 추천 화면을 추가할 때마다 피처 엔지니어링과 아키텍처 설계, 인프라 변경, 실험에 많은 품이 들었다고 한다. 저자들은 시스템이 복잡해진 탓에 빠르게 늘어나는 사업 요구에 대응하기 어려워졌다고 썼다.
그렇다고 기성 LLM을 그대로 추천기로 쓸 수도 없다. 논문은 기성 LLM의 문제를 네 가지로 정리했다.
- 전 세계적으로 인기 있는 작품을 과하게 추천한다.
- 넷플릭스 카탈로그에 없는 작품을 지어낸다.
- 세밀한 사업 제약을 무시한다.
- 개인화 수준이 낮다.
GenRec은 사내 파운데이션 LLM을 넷플릭스 데이터로 사후 학습해 이 문제들을 해결하려는 시도다. 논문은 카탈로그 전체의 순위를 매기는 과제에 집중했고, GenRec을 기존 추천 스택을 LLM 기반 시스템으로 전환하는 첫 시도라고 소개했다.
두 단계 학습 구조
GenRec의 학습은 두 단계로 구성된다. Phase 1에서는 오픈소스 LLM을 넷플릭스의 독점 데이터로 학습시켜, 회원과 콘텐츠를 깊이 이해하는 파운데이션 LLM을 만든다. Phase 2에서는 이 파운데이션 모델을 추천 순위 데이터와 목표로 다시 학습시켜 GenRec을 얻는다.1
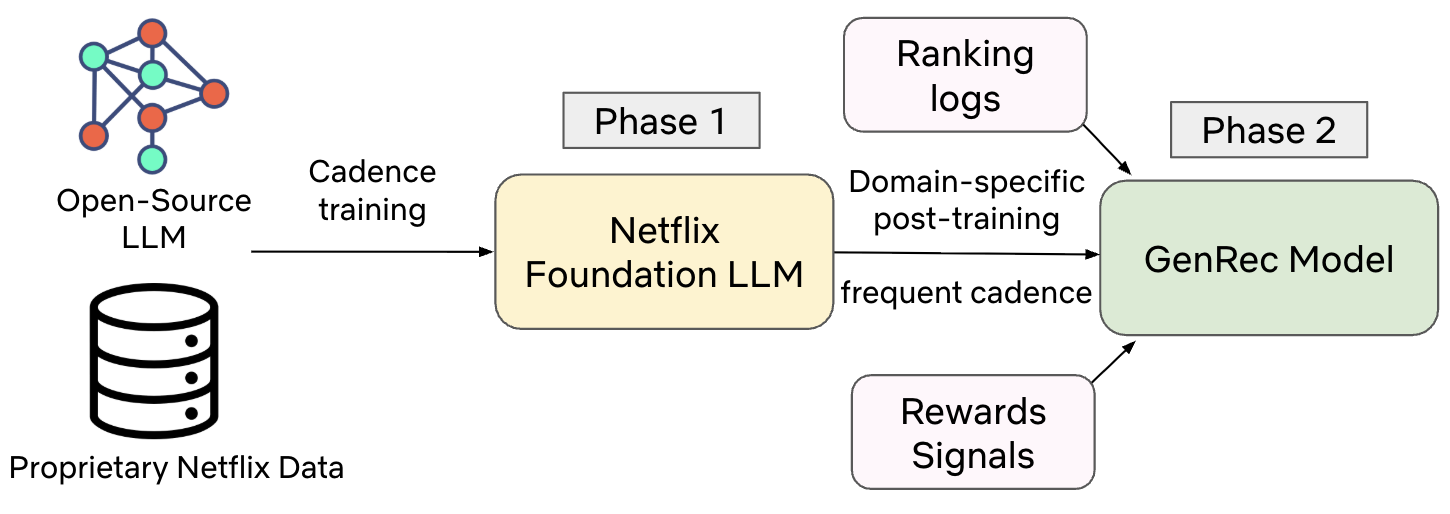 Figure 2. GenRec의 두 단계 학습 구조. Phase 1은 파운데이션 LLM을 만들고, Phase 2는 랭킹 로그와 보상 신호로 이 모델을 자주 사후 학습한다. 출처: Li et al., arXiv:2608.10257
두 단계는 목표가 서로 다르다.
| 항목 | Phase 1 | Phase 2 |
|---|---|---|
| 역량 | 세계 지식, 개인화, 콘텐츠 이해, 언어 능력을 균형 있게 갖추도록 학습한다 | 순위 품질과 추천 조정2 같은 랭킹 역량에 집중한다 |
| 갱신 주기 | 드물다. 회원과 콘텐츠에 대한 장기적 이해를 목표로 한다 | 잦다. 신작 공개와 인기 변화, 회원의 최근 관심을 반영해야 한다 |
| 비용 | 가장 유능한 모델을 목표로 하며 서빙 비용 제약이 덜하다 | 대규모 트래픽을 처리해야 하므로 서빙 비용이 명시적인 제약이다 |
시청 기록을 대화 형식으로
넷플릭스 회원들이 만드는 상호작용 이벤트는 모두 합치면 수천억 건이나 된다. 시청, 게임 플레이, 엄지 평가, 내 목록 추가 같은 신호가 여러 추천 화면에서 발생한다.
GenRec은 회원의 이력을 사용자와 추천기 사이의 단일 턴 또는 멀티 턴 “대화"로 변환한다. 각 턴은 두 메시지로 구성된다. 사용자 메시지는 맥락과 이력, 과제를 합친 것이고, 어시스턴트 메시지는 그 턴에서 회원이 실제로 한 반응이다.
| 구성 요소 | 내용 |
|---|---|
| 맥락 | 추천 화면, 시각, 기기, 지역 등 |
| 사용자 프로필과 이력 | 국가, 가입 기간, 요금제, 과거 상호작용 등 |
| 아이템 정보 | 아이템 ID, 메타데이터(제목, 공개 시점, 줄거리 등), 인기 추세 등 |
| 과제 | 예: 이 사용자가 다음에 재생하거나 엄지를 올릴 작품 예측 |
| 어시스턴트 메시지 | 재생, 재생 시간, 중도 이탈, 엄지 평가 같은 회원의 실제 반응. 학습의 정답 신호로 쓰인다 |
논문은 이 대화 형식이 복잡한 추천 로그를 하나의 텍스트 형식으로 통일해 표현하는 방법이라고 설명했다. GenRec은 같은 대화 데이터로 언어 모델링 목표와 랭킹 목표를 함께 학습한다.
컨텍스트 엔지니어링: 무엇을 입력에 포함할 것인가
기존 추천기는 상호작용과 메타데이터를 수작업 피처나 밀집 임베딩으로 변환한다. GenRec은 같은 정보를 자연어나 간단히 구조화한 텍스트로 서술한다. 논문은 이 과정을 언어화(verbalization)라고 부른다. 아이템 사이의 관계, 시간에 따른 행동 변화, 관심사의 변화 같은 고차 패턴은 사람이 피처로 설계하는 대신 LLM이 직접 학습한다.
저자들은 언어화가 신호를 텍스트로 바꾸는 작업에 그치지 않는다고 강조했다. 회원 한 명의 이력은 이벤트 수가 많고 이벤트마다 메타데이터도 풍부해서 토큰 예산을 쉽게 초과한다. 컨텍스트가 너무 길면 어텐션이 분산되고 학습과 추론 비용도 크게 늘어난다. 그래서 GenRec은 어떤 이벤트와 속성을 입력에 포함할지 네 가지 규칙으로 정한다.
| 규칙 | 대상과 처리 |
|---|---|
| 전부 유지 | 오래 시청한 기록, 엄지 올리기처럼 신호가 강한 이벤트. 메타데이터를 더 자세히 적는다 |
| 완전히 생략 | 아주 짧은 재생, 잡음이 많은 조회와 클릭처럼 신호가 약한 최근 이벤트. 토큰 비용에 비해 순위 품질에 기여하는 바가 작다 |
| 요약 또는 압축 | 몰아보기처럼 반복되는 행동. 이벤트를 하나하나 나열하는 대신 압축한다 |
| 선택적 보강 | 신작이나 콜드 스타트 아이템처럼 중요한 아이템. 사전 학습 모델과 과거 상호작용에서 얻을 정보가 적으므로 메타데이터를 더 자세히 적는다 |
토큰 예산이 고정되어 있으므로 단기와 중기 이력을 우선해 세밀하게 서술한다. 오래된 이력은 생략하거나 짧은 관심사 요약으로 압축한다.
모델 구조와 학습 목표
GenRec은 파운데이션 LLM과 똑같은 디코더 전용 트랜스포머를 백본으로 쓴다. 넷플릭스는 여기에 카탈로그 인지 랭킹 헤드를 추가했다. 이 헤드는 추천 결과를 넷플릭스 카탈로그의 작품으로 제한하고, 큰 후보 집합의 점수를 효율적으로 계산한다.
점수는 세 과정을 거쳐 계산된다.
- 언어화. 언어화 함수 $V$가 상호작용 이력 $H$, 아이템 메타데이터 $M_i$, 맥락 $\tau$를 텍스트 시퀀스 하나로 변환한다. 식으로 쓰면 $x = V(H, \{M_i\}_{i \in C}, \tau)$이다.
- 풀링 표현. LLM이 $x$를 인코딩하고, 풀링 위치의 은닉 상태를 $d$차원 표현 $h$로 쓴다. 이 벡터가 사용자의 선호와 맥락을 요약한다.
- 카탈로그 인지 점수. 점수 헤드 $\phi$가 $h$와 아이템마다 학습된 $d$차원 임베딩 $e_i$를 결합해 아이템 $i$의 점수를 계산한다.
LLM 가중치와 점수 헤드, 아이템 임베딩은 함께 학습된다. 카탈로그 전체에 소프트맥스를 적용해 점수를 확률 분포로 바꾸고, 그 점수로 순위를 정한다. 카탈로그가 너무 커서 모든 아이템의 점수를 계산하기 어려운 경우에는, 일부 아이템만 표본으로 뽑아 계산하는 샘플드 소프트맥스로 대신한다.
GenRec은 크게 두 가지 목표로 학습한다.
- 랭킹 목표. 가치가 높은 반응에 해당하는 아이템에 높은 점수를 주도록 학습한다. 오래 시청한 기록과 강한 명시적 피드백이 양성 라벨이 되며, 잡음 제거 논리와 기준값은 콘텐츠 종류마다 다르다. 손실 함수로는 카탈로그 또는 후보 집합에 대한 교차 엔트로피를 쓴다.
- 언어 모델링 목표. 언어화한 입력과 출력(예측한 작품 제목 등)에 대한 언어 모델링 손실도 함께 학습한다. 백본의 언어 이해 능력과 생성 능력을 유지하기 위해서다. 자연어로 서술한 이력과 메타데이터를 이해하려면 이 능력이 필요하고, 프롬프트로 추천을 조정하는 기능도 이 능력에 의존한다.
전체 손실은 두 목표와 기타 목표의 가중합으로 정의된다.
$$ \mathcal{L} = \alpha \cdot \mathcal{L}_{\text{ranking}} + \beta \cdot \mathcal{L}_{\text{language}} + \gamma \cdot \mathcal{L}_{\text{misc}}, \quad \alpha + \beta + \gamma = 1 $$$\alpha$, $\beta$, $\gamma$는 오프라인 실험으로 조정하는 하이퍼파라미터다.
추론 단계에서 GenRec은 랭킹 과제만 수행한다. 언어 모델링 목표는 학습 과정에서 랭킹을 보완할 텍스트 정보를 제공한다. 프롬프트 조정에 반응하는 능력도 이 목표 덕분에 유지된다. 나중에 추천 이유를 자연어로 설명하는 생성 기능을 추가할 수 있는 것도 이 때문이다.
보상 신호로 장기 만족을 반영하기
GenRec은 추천 정확도 외에 두 가지 목표를 더 충족해야 한다. 하나는 영화와 시리즈, 라이브, 게임, 팟캐스트의 비율을 맞추는 콘텐츠 혼합 규칙 같은 사업 요구다. 다른 하나는 단기 참여보다 장기적인 회원 만족을 최대화하는 것이다.
원시 상호작용 시퀀스로만 학습하면 모델이 이 두 목표를 소홀히 할 위험이 있다. 예컨대 새 작품 탐색보다 몰아보기를, 게임보다 영상을 과하게 추천할 수 있다. 당장의 클릭은 늘지만 카탈로그 탐색과 장기 잔존율은 떨어지는 작품을 고를 수도 있다.
그래서 넷플릭스는 별도의 보상 모델에서 나온 신호를 학습 목표에 포함했다. 보상 신호는 두 종류로 구분된다.
- 장기 만족의 대리 지표. 단기 참여 이벤트가 장기 성과와 얼마나 강하게 상관되는지를 추정한다. 실제 장기 지표는 잡음이 크고 늦게 관측되므로, 과거 데이터로 학습한 더 안정적인 대리 지표를 쓴다. 회원이 서비스를 다시 찾게 하거나, 카탈로그의 더 많은 작품을 탐색하게 하거나, 참여가 오래 지속되는 반응에 높은 값을 준다.
- 행동 재조정. 콘텐츠 종류(영화, 게임, 라이브, 팟캐스트)와 공개 단계(공개 전, 갓 공개, 상시 인기작)에 따라 추천 행동의 균형을 다시 맞춘다. 콘텐츠 종류 간 노출 공정성 같은 사업 목표를 위해서다.
GenRec은 기존 보상 모델링 프레임워크에 있는 여러 보상 모델의 출력을 보상 가중 랭킹 손실로 통합한다. 학습 예시마다 여러 보상 신호에서 계산한 스칼라 가중치를 부여하고, 그 예시의 랭킹 손실에 이 가중치를 곱한다. 보상 모델이 높게 평가한 반응은 가중치가 커지고, 가치가 낮거나 바람직하지 않은 행동은 가중치가 작아진다.
저자들은 이 방식이 완전한 강화학습보다 배포와 유지가 쉽다고 했다. 예비 실험에서는 GRPO 같은 강화학습 방식이 지도 미세조정보다 추가 성능 향상을 냈지만, 학습 부담이 커서 후속 연구로 미뤘다고 밝혔다.
서빙: 생성하지 않고 프리필만 한다
GenRec은 vLLM 기반의 넷플릭스 사내 LLM 서빙 스택에서 운영된다. 전 세계 수억 명의 회원을 상대하므로 서빙 비용이 핵심 제약 조건이며, 추론 비용은 대략 모델 크기와 컨텍스트 길이의 곱에 비례한다. 넷플릭스는 비용을 줄이기 위해 두 가지 전략을 병행했다.
- 더 큰 데이터셋이나 목표에 맞춘 데이터셋으로 더 작은 모델과 증류 모델을 학습시킨다. 큰 모델의 품질을 최대한 유지하면서 요청당 연산량을 줄이려는 전략이다.
- 앞서 설명한 언어화 압축으로 컨텍스트 길이를 줄인다.
추론 방식도 비용을 좌우한다. GenRec은 큰 후보 집합의 순위를 매겨야 하므로, 토큰을 하나씩 생성하거나 빔 서치를 쓰는 자기회귀 디코딩으로는 비용을 감당할 수 없다. 백본은 자기회귀 디코딩이 가능한 생성형 디코더 전용 LLM이지만, 넷플릭스는 GenRec을 일부러 프리필 전용 구성으로 배포했다. 이 구성에서는 입력 컨텍스트를 한 번 처리하는 순전파만으로 후보 집합 전체의 순위가 나온다.
이 선택은 관련 연구와 다르다. 구글의 PLUM, 스포티파이의 GLIDE, 콰이쇼우의 OneRec-Think 같은 LLM 기반 생성형 추천 시스템은 대개 추론할 때 빔 서치로 아이템 토큰을 생성한다. 논문은 이 방식의 지연 시간이 후보 집합이 클수록 감당하기 어려운 수준이 된다고 지적했다. 그리고 순전파 한 번으로 점수를 내는 랭킹 헤드가 서빙 비용 면에서 유리하다고 설명했다.
실험 결과
기존 프로덕션 랭커와의 비교
연구진은 여러 해에 걸쳐 조정해 온 성숙한 판별형 프로덕션 랭커와 GenRec을 비교했다. 오프라인에서 GenRec은 Phase 2 라벨 학습 예시를 프로덕션 모델보다 약 40배 적게 쓰고도 MRR3이 기준 대비 약 1.6% 향상되었다. 학습 데이터와 입력 신호를 더 늘리면 오프라인 지표도 계속 올라갔다고 한다.
온라인에서는 핵심 배치 연산 화면4에서 A/B 테스트를 했다. 넷플릭스 트래픽의 약 10%를 4주 동안 할당했다. 데이터와 입력 신호를 적게 쓴 구성으로도 GenRec은 단기와 장기 온라인 지표 모두에서 통계적으로 유의한 개선을 기록했다.5
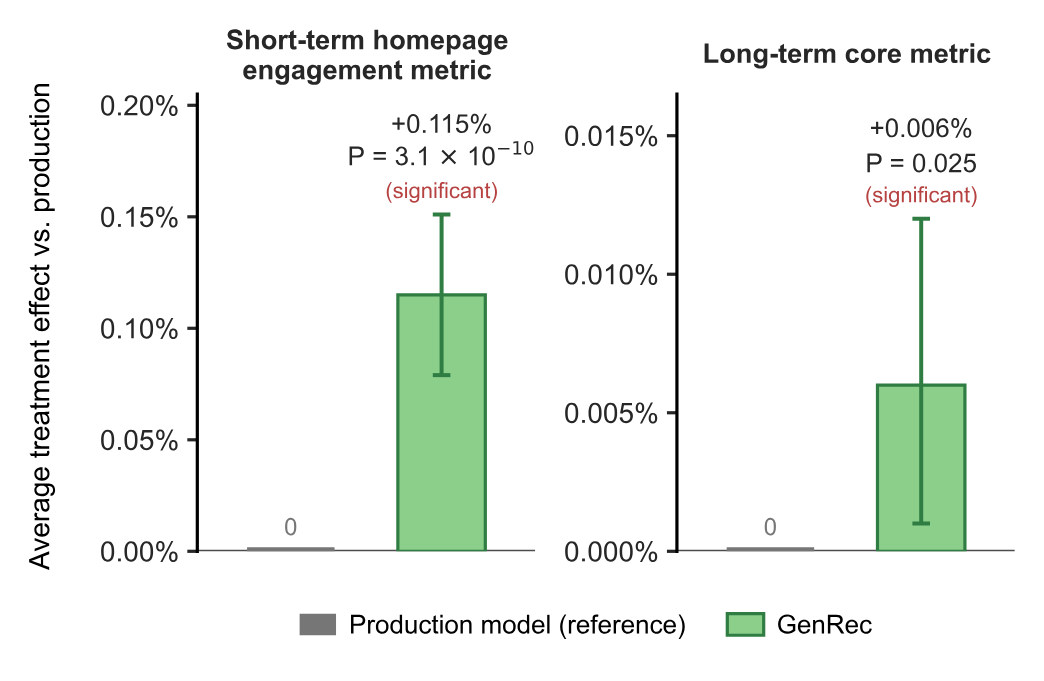 Figure 3. 프로덕션 모델 대비 GenRec의 평균 처치 효과. 단기 홈페이지 참여 지표는 +0.115%(p = 3.1 × 10⁻¹⁰), 장기 핵심 지표는 +0.006%(p = 0.025)다. 출처: Li et al., arXiv:2608.10257
저자들은 장기 핵심 지표의 개선 폭 0.006%도 넷플릭스 규모에서는 통계적으로 의미 있는 차이라고 설명했다.
저자들은 GenRec이 Phase 2 학습에 쓴 데이터가 적다는 점도 강조했다. Phase 2는 Phase 1보다 훨씬 자주 갱신하므로, 이 단계의 데이터 효율이 높으면 랭커를 최신 상태로 유지하는 데 드는 연산이 그만큼 줄어든다.
데이터와 모델 규모
연구진은 Phase 2 학습 데이터를 가장 작은 구성의 1배에서 20배까지 늘려 가며, 약 10억 파라미터 모델과 약 100억 파라미터 모델을 각각 학습시켰다. 데이터를 늘릴 때마다 두 모델의 MRR은 한 번도 떨어지지 않고 올랐다. 10억 파라미터 모델은 100억 파라미터 모델보다 MRR의 절댓값이 낮았지만 증가 양상은 비슷했다.
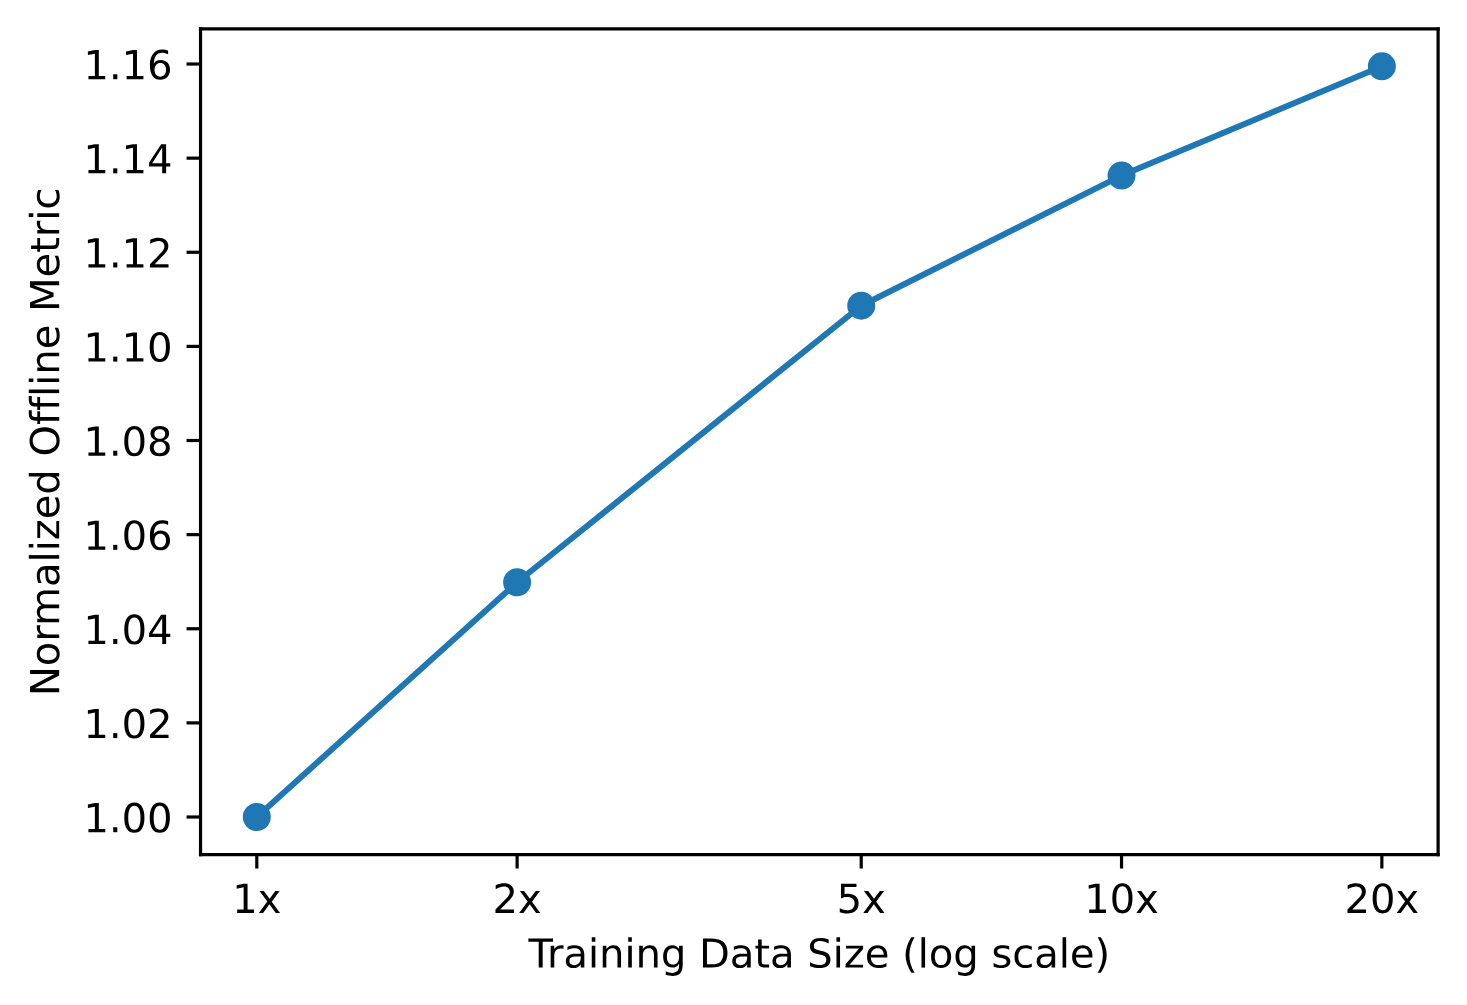 Figure 4. 약 100억 파라미터 모델에서 Phase 2 데이터 규모에 따른 오프라인 지표(가장 작은 구성을 1로 정규화). 데이터가 2배, 5배, 10배, 20배일 때 지표는 약 1.05, 1.11, 1.14, 1.16이다. 출처: Li et al., arXiv:2608.10257
모델 크기 실험에서는 GPU 구성과 학습 시간을 비슷하게 맞춘 조건에서 10억에서 100억 파라미터 규모의 백본을 비교했다. 같은 학습 예산에서 큰 백본이 일관되게 높은 오프라인 MRR을 기록했다.
데이터와 모델 규모를 늘리면 품질은 오르지만 학습과 서빙 비용도 함께 늘어난다. Phase 2는 학습 주기가 짧고 대규모 온라인 트래픽을 직접 처리하므로 이 비용이 특히 중요하다. 연구진은 데이터 규모, 모델 크기, 컨텍스트 길이의 실험 결과를 함께 비교해 품질과 비용의 파레토 프런티어에서 “최적 구간"을 찾았다고 밝혔다. 최적 구간의 구성은 달성할 수 있는 품질 향상의 대부분을 얻으면서도 연산 예산을 초과하지 않는다.
Phase 1과 Phase 2의 기여
| 비교 | 오프라인 순위 지표(MRR) |
|---|---|
| Phase 1의 효과 | 기성 오픈소스 LLM을 백본으로 쓸 때보다 10~20% 향상 |
| Phase 2의 효과 | 막 학습을 마친 Phase 1 모델보다 35~50% 향상. 시간이 지날수록 향상 폭이 커진다 |
기성 LLM 대신 Phase 1 파운데이션 모델을 백본으로 삼았을 때 오프라인 지표는 10~20% 높게 나왔다. 저자들은 Phase 1에서 학습한 개인화 능력과 콘텐츠 이해 능력이 그만큼 중요하다고 해석했다.
Phase 2 사후 학습은 Phase 1 모델이 가장 최신인 시점에 평가해도 35~50%의 추가 향상을 냈다. 평가 시점을 2주 뒤로 미루자 향상 폭은 약 80%까지 커졌다. 논문은 향상 폭이 커지는 원인으로 두 가지를 들었다. 하나는 과제 특화 학습의 효과이고, 다른 하나는 자주 갱신하지 않는 Phase 1 백본이 인기 추세와 회원 관심의 변화를 반영하지 못하게 되는 효과다.
컨텍스트 길이
컨텍스트 창의 길이는 품질과 비용에 모두 영향을 준다. 언어화가 길수록 회원의 행동과 맥락에 관한 정보를 더 많이 제공하지만, 학습과 서빙 비용도 늘어난다. 연구진은 짧으면서도 품질을 유지하는 언어화를 찾으려고 세 가지 작업을 차례로 수행했다.
- 이벤트 선별과 압축. 신호가 약하거나 잡음이 많은 이벤트를 빼고, 반복 행동을 압축하고, 신호가 강한 상호작용은 유지한다.
- 이력 길이 탐색. 정리된 시퀀스에서 입력에 포함하는 이벤트 수를 바꿔 가며 MRR을 측정했다. 이벤트 수가 많아질수록 품질도 개선되었지만, 개선 폭이 급격히 줄어드는 엘보 지점 이후에는 토큰을 더 추가해도 이득이 미미했다.
- 간결한 언어화 구성. 포함하기로 한 이벤트마다 상세도가 다른 프롬프트를 만들어 성능을 비교했다. 반응 정보를 줄이거나, 문장을 단순하게 바꾸거나, 퓨샷 예시를 빼는 식이다.
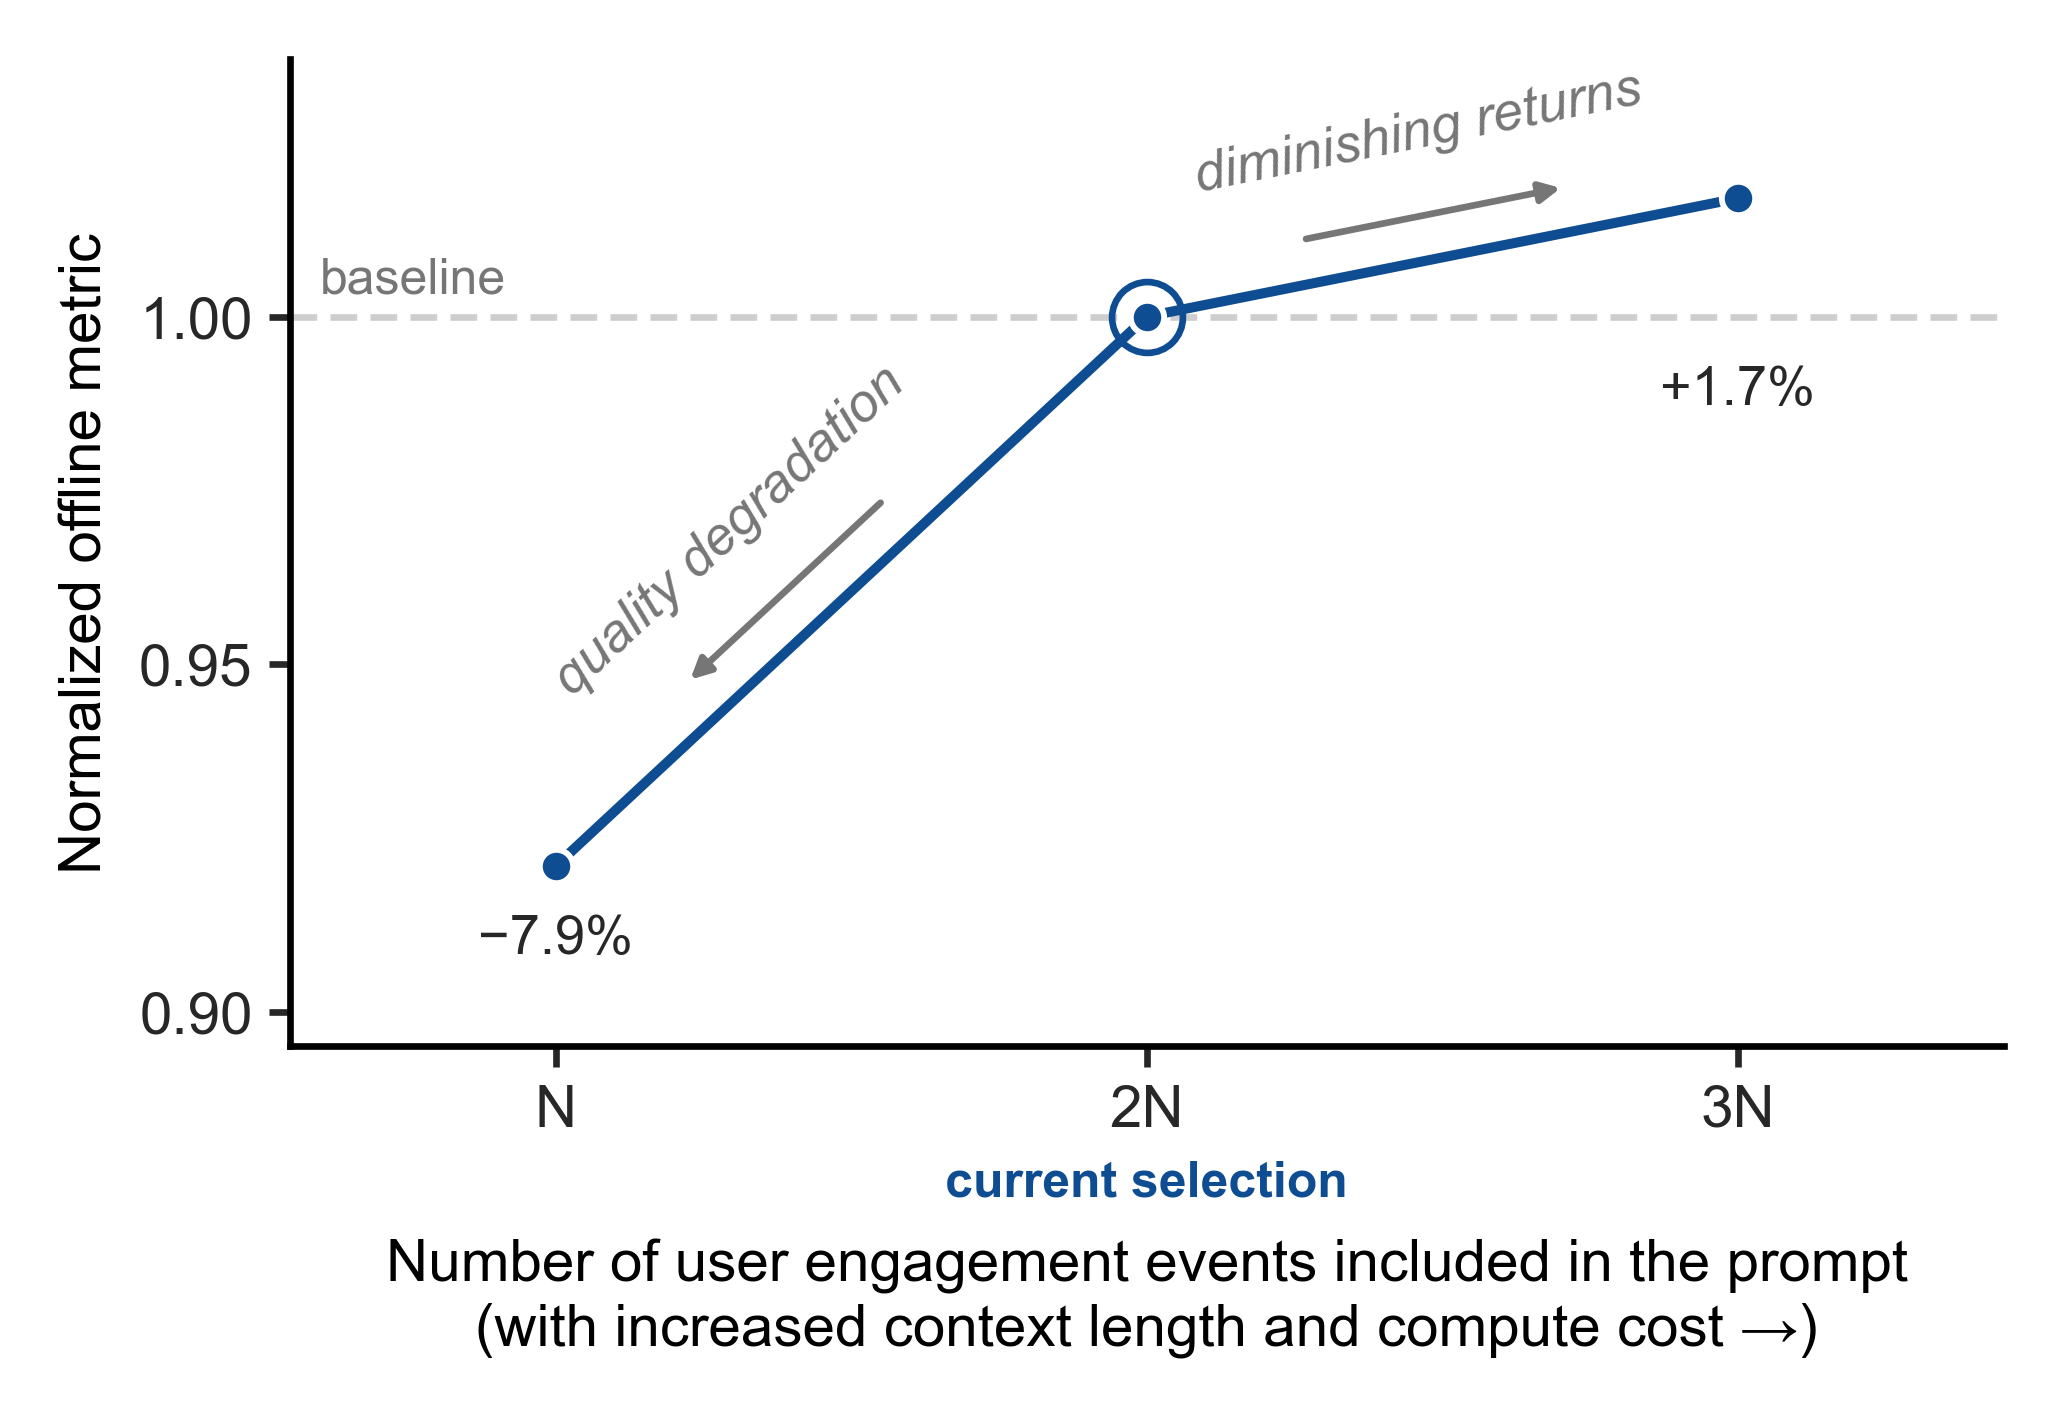 Figure 5. 프롬프트에 포함한 회원 반응 이벤트 수에 따른 정규화 오프라인 지표. 현재 구성인 2N을 기준(1.00)으로 삼으면, 이벤트를 N개로 줄일 때 지표가 7.9% 떨어지고 3N개로 늘려도 1.7% 오르는 데 그친다. 출처: Li et al., arXiv:2608.10257
세 가지 작업을 마친 뒤 연구진은 오프라인 순위 지표를 거의 떨어뜨리지 않고 컨텍스트 길이를 원래 토큰 예산의 약 3분의 1로 줄였다. 예를 들어 약 5,000토큰이던 입력이 약 1,700토큰이 되었다. GenRec의 처리 속도는 대체로 연산량으로 결정되므로 서빙 비용이 컨텍스트 길이에 거의 비례한다. 그 덕분에 서빙 비용도 원래의 약 3분의 1로 줄었다고 보고했다.
논문이 전망하는 추천 시스템의 변화
저자들은 LLM 기반 추천으로 전환하려면 “랭커를 트랜스포머로 교체하는 일” 이상이 필요하다고 했다. 사용자와 콘텐츠를 표현하는 방식, 모델과 학습의 구조, 서빙 인프라의 설계가 모두 달라진다고 설명했다. 논문 6절은 다섯 가지 변화를 제시했다.
| 영역 | 기존 추천 시스템 | LLM 기반 추천 |
|---|---|---|
| 입력 | 수작업 피처와, 이를 지원하는 집계, 최신성 관리, 누수 방지 인프라 | 원시 상호작용, 콘텐츠 메타데이터, 맥락, 도구 출력, 사용자 메모리로 구성한 텍스트 컨텍스트 |
| 아키텍처 | 투타워 모델, DLRM식 피처 교차 네트워크, 맞춤 어텐션 블록, 대형 멀티태스크 구조 | 파운데이션 모델과 같은 트랜스포머 백본으로 표준화 |
| 규모 확장 | 희소 ID, 복잡하게 설계된 목표, 과제별 아키텍처 탓에 수확 체감이 나타난다 | 사전 학습 LLM의 데이터 스케일링과 모델 스케일링 특성을 공유한다. 스케일링 법칙을 설계 지침으로 쓴다 |
| 학습 | 추천기마다 처음부터 구축 | 사전 학습한 공용 백본을 과제별 사후 학습과 보상 정렬로 적응 |
| 인프라 | MLP와 행렬 분해 모델 중심의 전통적 추천 인프라 | GPU 가속, vLLM과 Triton, 배칭과 캐싱을 갖춘 LLM 인프라. KV 캐시, 프리픽스 캐시, 프리필 전용 추론이 핵심 수단이다 |
입력의 변화를 저자들은 이렇게 요약했다.
“프롬프트"가 새로운 피처 벡터가 된다. 모델링 노력의 초점은 개별 피처 설계에서 컨텍스트 엔지니어링으로 바뀐다. 어떤 신호를 포함할지, 그것을 어떻게 요약할지, 얼마나 오래된 이력까지 포함할지, 유한한 토큰 예산으로 어떻게 인코딩할지를 정하는 일이다.
저자들은 아키텍처를 과제마다 설계할 필요가 줄어들고, 그 대신 데이터와 스케일링 법칙, 사후 학습 전략, 추론 최적화가 혁신의 대상이 된다고 봤다. 학습 방식을 공용 백본으로 통일하면 여러 용도가 같은 파운데이션과 인프라를 재사용할 수 있다. 따라서 분리된 시스템마다 비슷한 기능을 다시 구현할 필요도 줄어든다고 했다.
가장 흥미로운 지점
서빙 중인 GenRec은 텍스트를 한 토큰도 생성하지 않는다. 디코더 전용 LLM에 회원의 이력을 입력해 프리필을 한 번 실행하고, 그렇게 얻은 은닉 상태 하나를 카탈로그 전체의 아이템 임베딩과 결합해 점수를 계산할 뿐이다. 언어 모델링 손실은 학습 단계에서만 쓰이며, 이 손실 덕분에 프롬프트로 추천을 조정하는 능력이 유지된다. 추천 이유를 자연어로 설명하는 기능은 향후 과제로 남아 있다. 제목에는 LLM이 들어 있지만, 추론 시점의 GenRec은 회원의 이력을 인코딩하는 대형 인코더와 카탈로그 전체를 분류하는 소프트맥스 헤드로 작동한다. 내가 보기에 넷플릭스가 LLM에게서 필요로 한 것은 생성 능력보다는 이력을 이해하는 능력이었다. 생성에 드는 비용은 설계 단계에서 아예 없앴다.
Phase 2의 효과가 시간이 지날수록 커진다는 결과는 운영 비용 문제로 읽힌다. Phase 1 모델이 최신일 때 35~50%이던 향상 폭이 2주 뒤에는 약 80%가 된다. 2주 사이에 파운데이션 모델과 최신 시청 데이터의 격차가 그만큼 커진다는 뜻이다. 격차가 이렇게 빨리 커진다면 Phase 2 학습은 자주 반복할 수밖에 없고, 반복할 때마다 드는 데이터와 연산의 양이 운영 비용을 좌우하게 된다. 저자들이 라벨을 40분의 1만 쓰고도 기존 랭커보다 나은 성능을 냈다는 점을 여러 번 강조한 것도 이 때문일 것이다.
출처
Ying Li, Shradha Sehgal, Arjun Rao, Rein Houthooft, Yunan Hu, Yaochen Zhu, Sourabh Medapati, Yun Li, Linas Baltrunas, Grace Huang, Ashish Rastogi, Kamelia Aryafar (Netflix). “GenRec: An LLM-Backed Recommendation Ranker at Netflix.” arXiv:2608.10257. v1은 2026년 8월 10일, v2는 2026년 8월 21일에 제출되었다.
이 글의 그림은 모두 논문에서 인용했다. 논문은 arXiv 비독점 배포 라이선스로 공개되어 있다.
원문: https://arxiv.org/html/2608.10257v2
논문은 Phase 1의 출발점이 된 오픈소스 모델의 이름을 밝히지 않았다. 모델 크기도 “약 10억 파라미터”, “약 100억 파라미터"처럼 자릿수로만 적었다. ↩︎
논문의 표현은 recommendation steering이다. 추천 모델을 새로 설계하는 대신 프롬프트로 추천 결과를 조정하는 기능을 뜻한다. ↩︎
MRR(Mean Reciprocal Rank, 평균 역순위)은 각 정답 아이템 순위의 역수를 평균한 값이다. 정답이 1위면 1, 2위면 0.5, 4위면 0.25가 된다. ↩︎
논문의 표현은 batch-compute surfaces이며, 따로 정의하지는 않았다. 보통은 요청마다 실시간으로 계산하지 않고, 추천 결과를 주기적으로 미리 계산해 두는 화면을 가리킨다. 논문 결론도 GenRec을 배치 연산 화면의 프로덕션 트래픽에 적합한 랭커로 소개했다. ↩︎
논문 본문은 온라인 결과를 Figure 4로 가리키지만, 온라인 지표 그림은 Figure 3이다. Figure 4는 데이터 규모 실험 그림이다. ↩︎