3줄 요약
- 2026년 9월 27일, AI 연구소 Hyperstition의 Deven Pietrzak가 NanoGPT 스피드런 신기록과 그 방법을 정리한 보고서를 공개했다. NanoGPT 스피드런은 H100 GPU 8장으로 파라미터 1억 2,400만 개짜리 언어 모델을 학습시키는 공개 경쟁으로, 참가자들은 FineWeb 검증 손실이 3.28까지 낮아지는 데 걸리는 시간을 겨룬다. 저자의 트레이너는 39.914초를 기록했고, 같은 기계에서 잰 기존 89번 기록의 73.889초보다 33.975초(46.0%) 빠르다.
- 단축분의 대부분은 세 가지 변경에서 나왔다. 샘플링 소프트맥스는 학습 대부분의 구간에서 출력층이 어휘 일부만 채점하게 해 8.41초를 줄였다. n-gram 표는 행 수를 224배로 늘리고 트라이그램을 추가해 7.06초를 줄였다. 새 옵티마이저 ANVIL II와 학습 막바지의 가중치 평균이 줄인 시간은 5.09초다.
- 저자는 이번 단축 폭이 퍼센트 기준으로 이전 45개 기록(44번부터 89번까지)의 단축 폭을 모두 합친 45.8%보다 크다고 밝혔다. 제출 PR은 9월 28일 저장소에 머지됐다. Hyperstition은 프런티어 규모에서도 쓸 수 있는 기법 가운데 ANVIL II를 제외한 나머지를 공개 기록에 포함하지 않았다고 적었다.
NanoGPT 스피드런과 이번 기록
안드레이 카파시는 llm.c로 GPT-2를 재현하면서 45분 동안 학습해 검증 손실 3.28을 얻었다. 스피드런은 이 값을 목표 손실로 삼는다. 2024년 5월 이 45분이 첫 기록으로 등록된 뒤, 여러 참가자가 아키텍처와 옵티마이저, 커널을 고치며 기록을 줄여 왔다. 2024년 10월의 세 번째 기록에서 Muon 옵티마이저1가 처음 쓰였고, 2026년 7월 17일에 등록된 89번 기록은 1.23분이었다.
저자는 PR #360에 다음 측정값을 제출했다. 두 트레이너를 같은 기계에서 번갈아 실행했고, 모든 실행은 캐시가 비어 있는 상태에서 시작했다.
| 실행 횟수 | 학습 구간 시간 | 최종 검증 손실 | |
|---|---|---|---|
| 이번 기록 | 18 | 39.914 ± 0.120초 | 3.27731 ± 0.00099 |
| 89번 기록 | 9 | 73.889 ± 0.137초 | 3.27828 ± 0.00205 |
18회 실행에서는 검증 손실이 모두 3.28보다 낮았다. 목표 3.28과 비교한 유의확률도 PR에 적혀 있는데, $p = 9.4 \times 10^{-10}$이다. 속도로 환산하면 1.85배다. PR 설명에 따르면 저자는 이 기록을 만드는 데 5일을 썼다. 제출 전 이틀 동안에는 외부 네 곳에서 각각 검토하고 재현했다. PR은 8월 31일에 제출됐고 9월 28일 머지됐다2.
시간 측정 규칙도 원문에 적혀 있다. 컴파일과 워밍업은 측정을 시작하기 전에 끝낸다. 학습 시간에는 마지막 가중치 평균과 동기화가 포함되고, 검증은 측정이 끝난 뒤 전체 어휘로 한다.
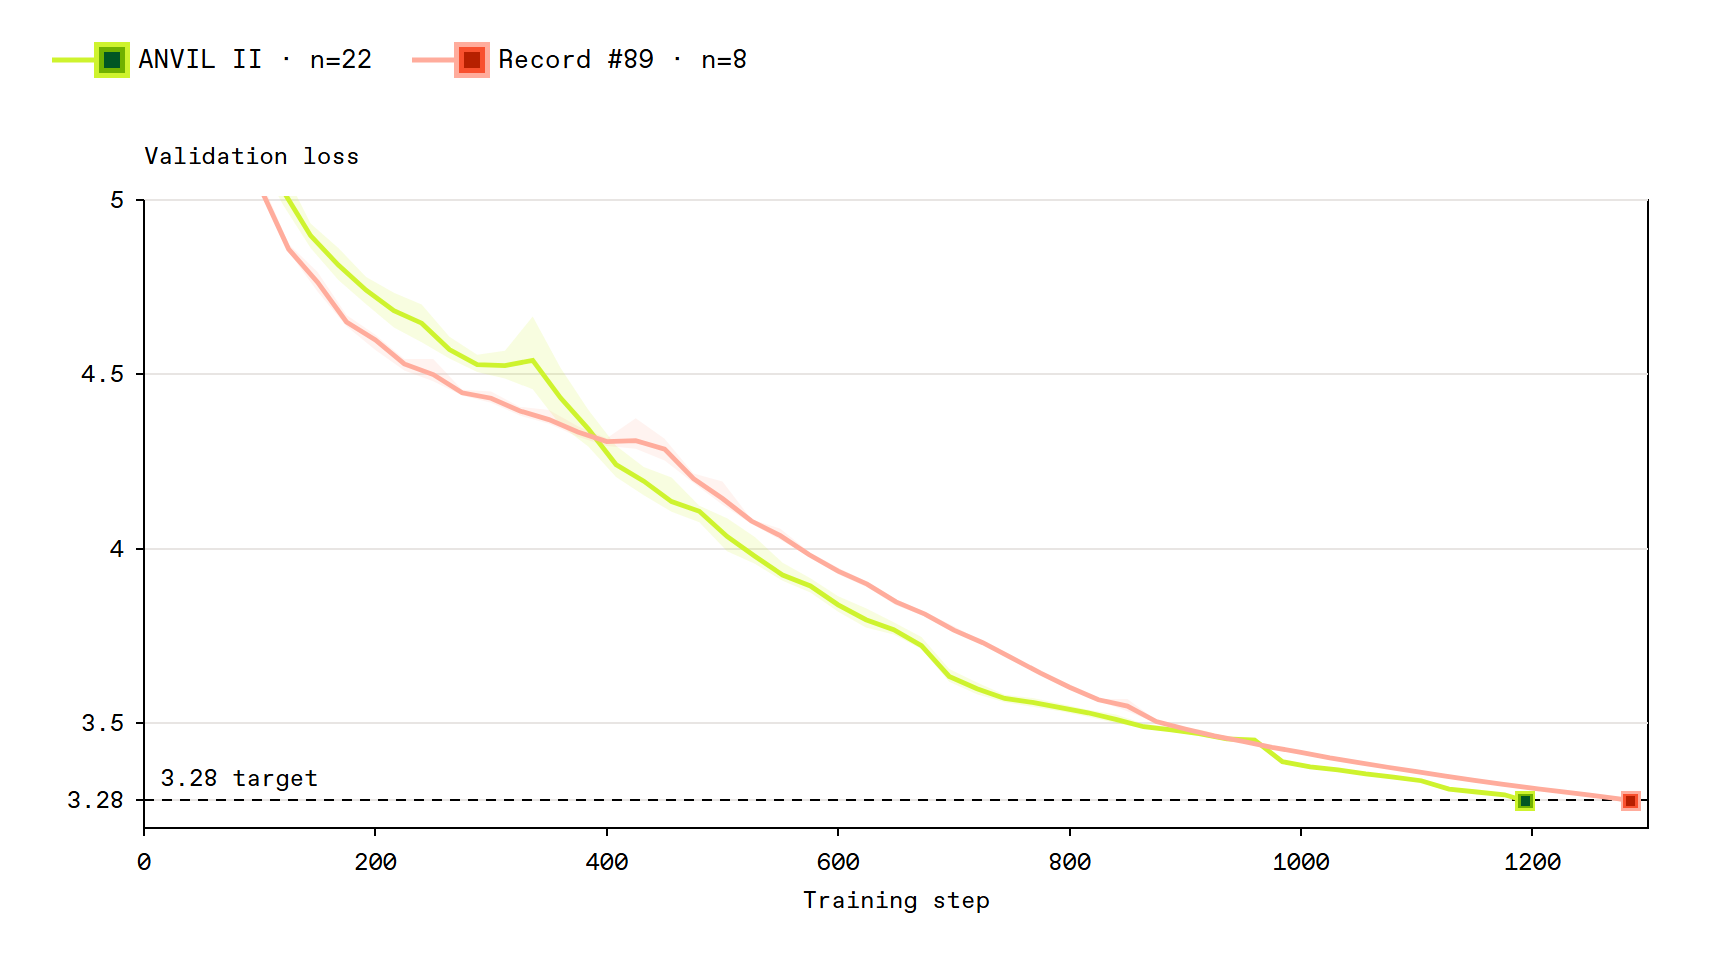 그림 1. 학습 스텝별 검증 손실. 출처: 원문 「ANVIL II vs record 89」 그래프
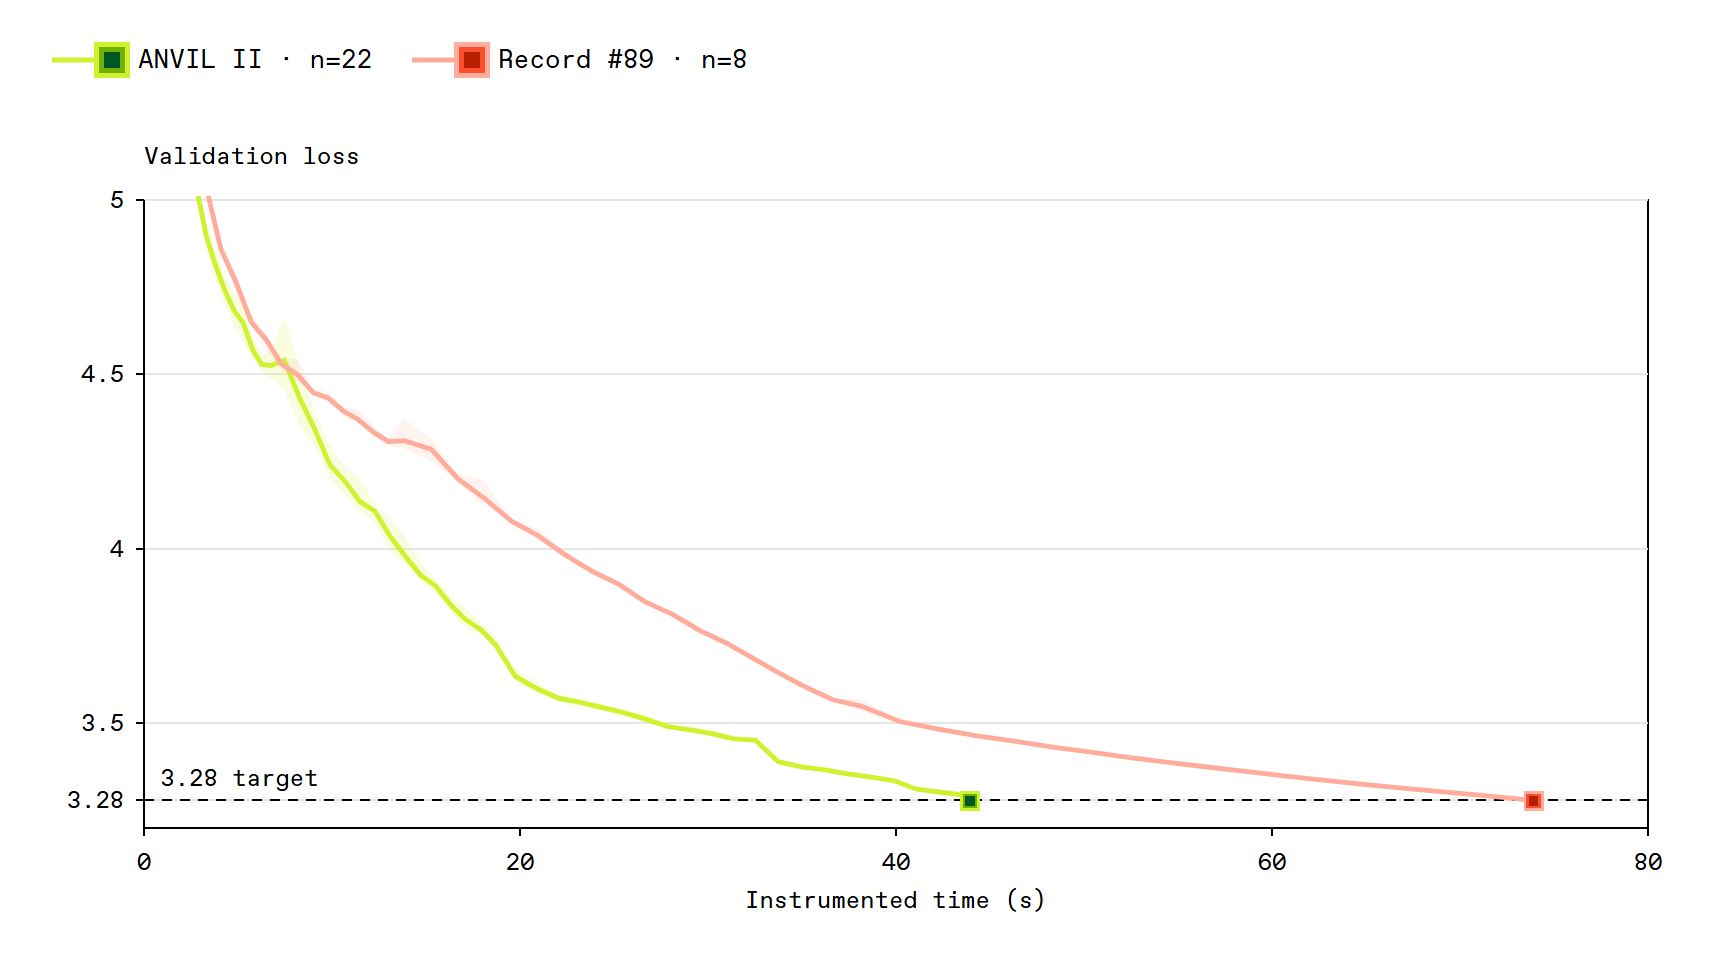
원문 그래프는 같은 곡선을 스텝 축과 시간 축으로 보여 준다3. 스텝 축에서 ANVIL II는 목표 손실에 89번 기록보다 약 90스텝 먼저 도달한다. 시간 축에서는 두 곡선의 차이가 더 크다. 스텝 수가 줄어든 데다 스텝 하나에 드는 시간도 줄었기 때문이다.
무엇이 몇 초를 줄였나
저자는 두 가지 방식으로 기여도를 측정했다. 첫째는 완성된 트레이너에서 구성 요소를 하나씩 제거한 뒤, 학습 시간이 얼마나 늘어나는지 재는 제거 실험이다.
| 원문 그래프 항목 | PR의 항목명 | 내용 | 줄인 시간 |
|---|---|---|---|
| Sampled softmax | Sampled-softmax training loss | 출력층이 학습 대부분의 구간에서 어휘 일부만 채점 | 8.41초 |
| Larger table | Embeddings, hashed n-gram table | 바이그램 표 확장, 트라이그램 채널 추가 | 7.06초 |
| ANVIL + averaging | ANVIL, optimizer | 옵티마이저 교체와 학습 막바지 가중치 평균 | 5.09초 |
| FP8 | Full-stack FP8 | MLP의 순전파와 역전파 전체를 FP8로 계산 | 4.95초 |
| Smaller model | Mixed-width attention | 모델 깊이 축소, mixed-width QK 어텐션 | 3.82초 |
| CUDA graphs | Training-step graph capture | 학습 스텝 전체를 CUDA 그래프로 캡처 | 2.99초 |
| Sparse updates | Sparse grad comms & data loader | 표 기울기의 희소 통신, 데이터 로더 개선 | 1.20초 |
| Layer mixing | MUDDformer residual mix | MUDDformer 방식의 잔차 혼합 | 0.49초 |
PR에 따르면 제거 실험은 대부분 두 번씩 실행했다. 시간은 그대로 두고 손실을 낮추는 변경은 손실 개선분을 시간으로 환산해 표에 적었다4.
둘째로 저자는 출발 구성에 변경을 하나씩 더해 가며 누적 효과를 쟀다. 최종 옵티마이저 업데이트 규칙과 데이터 로더, 학습 스텝 수 1,194는 모든 단계에서 같다.
| 단계 | 학습 시간 | 최종 검증 손실 |
|---|---|---|
| 출발 구성 | 68.04초 | 3.2993 |
| + 표 용량 확장 | 68.50초 | 3.2635 |
| + 샘플링 소프트맥스 | 61.24초 | 3.2664 |
| + FP8, 모델 폭과 깊이 변경 | 44.52초 | 3.2962 |
| + CUDA 그래프 | 40.83초 | 3.2966 |
| + 가중치 평균 | 40.89초 | 3.2784 |
| + 희소 값 임베딩 | 39.90초 | 3.2780 |
표 용량을 확장하면 학습 시간은 0.46초 늘지만 손실은 0.0358 낮아진다. FP8 도입과 모델 폭, 깊이 변경은 시간을 16.72초 줄이는 대신 손실을 0.0298 높인다. 여기에 가중치 평균을 적용하면 학습 시간은 0.06초 늘고, 손실은 다시 목표치보다 낮아진다. 저자는 스텝당 시간을 거의 바꾸지 않으면서 손실을 크게 낮추는 변경이 있고, 그런 변경은 목표 손실에 필요한 스텝 수를 줄인다고 설명했다.
누적 실험에서 줄어든 시간은 28.15초다. 전체 단축분 33.975초는 89번 기록과 직접 비교해서 얻은 값이고, 누적 실험은 그중 일부 변경의 효과만 재구성해 측정했다.
ANVIL II와 가중치 평균
ANVIL은 빠른 모멘텀과 느린 모멘텀 두 개를 함께 유지한다. 업데이트 행렬에 다항식 사상을 여섯 번 적용해 특잇값 분포를 평탄하게 만들고, 그 결과 행렬의 강한 방향과 약한 방향 사이의 불균형이 줄어든다. 느린 모멘텀과의 일치 여부에 따라, 조심스러운 가중치 감쇠(cautious weight decay)를 적용할 원소를 고른다. PR에 따르면 ANVIL은 89번 기록의 옵티마이저와 비교해 비슷한 실행 시간에 손실을 21밀리나트 낮췄다. ANVIL II를 확장한 기법은 같은 연구소의 다른 글 「Cutting Pretraining Costs by 62%」에서 다룬다.
가중치 평균은 학습 막바지에 적용한다. 저자는 마지막 가중치를 그대로 쓰지 않고, 학습 종료 직전에 모은 가중치 평균과 섞는다. 평균으로는 지수이동평균(EMA)을 쓴다. 감쇠율 $\beta$가 0 이상 1 미만일 때 평균의 갱신식은 다음과 같다.
$$ \bar\theta_t = \beta\bar\theta_{t-1} + (1-\beta)\theta_t $$매 업데이트에서 현재 가중치가 $1-\beta$의 비중으로 반영되므로, 최근 가중치일수록 평균에 미치는 영향이 크다. 출력층(readout)은 최종 가중치 35%와 평균 65%를 섞는다. 저자는 출력층과 행렬 뱅크, 값 임베딩의 업데이트 시점이 서로 다르므로 각각의 일정에 맞춰 평균을 계산해야 한다고 설명했다.
저자가 제시한 근거는 다음과 같다. 극소점 근처에서는 손실을 볼록한 이차 함수로 근사할 수 있다. 학습 막바지의 가중치가 이 근방에서 변동한다면, 평균을 내면 변동 폭에 해당하는 손실이 줄어든다. 이 근사에서 평균 가중치의 손실은 개별 체크포인트 손실의 가중 평균보다 크지 않다. 옵티마이저 규칙과 학습 일정을 고정하고 비교했을 때, 평균을 쓰면 손실이 3.29660에서 3.27840으로 낮아졌고 학습 시간은 40.831초에서 40.891초로 늘었다.
샘플링 소프트맥스
모델은 토큰마다 어휘 50,304개 모두에 점수를 매긴다. 이때 출력층에서 수행하는 행렬 곱셈이 학습 연산량의 약 3분의 1을 차지한다. 저자는 토큰 하나 단위로 보든 배치 전체 단위로 보든, 어휘 대부분은 업데이트에 큰 영향을 주지 않는다고 판단했다. 그래서 로컬 배치의 정답 토큰을 모두 포함하고, 정답이 아닌 토큰도 중복 없이 추가해 후보 집합을 구성했다. 출력층의 순전파와 역전파는 이 후보 집합에 해당하는 어휘 열에 대해서만 계산한다.
이렇게 하면 소프트맥스의 정규화 항이 달라진다. 후보 집합을 $C$, 전체 어휘를 $V$, 어휘 원소 $j$의 점수를 $z_j$라 하면 두 정규화 항은 다음과 같다.
$$ Z=\sum_{j\in V}e^{z_j},\qquad Z_C=\sum_{j\in C}e^{z_j} $$전체 소프트맥스 확률을 $p_j = e^{z_j}/Z$라 하면, 후보 집합에 배정된 확률 질량은 $r_C = Z_C/Z$다. 후보 집합으로 제한한 분포는 후보 원소에서 $\tilde p_j = p_j/r_C$이고, 후보가 아닌 원소에서 0이다. 정답 토큰이 후보 집합에 포함되어 있으면, 로짓에 대한 두 손실의 기울기 차이를 L1 노름으로 계산할 수 있다.
$$ \lVert\nabla_z\ell_C-\nabla_z\ell\rVert_1 = 2(1-r_C) $$모델이 후보 집합에 배정한 확률 질량이 클수록 제한된 소프트맥스의 기울기 오차가 작아진다는 뜻이다. 이 방법은 스텝당 연산을 줄이는 대신 최종 검증 품질을 떨어뜨릴 수 있다. 저자는 학습이 진행될수록 후보 집합을 늘리고 마지막에는 전체 어휘를 쓰게 해서 검증 손실 격차를 크게 줄였다.
작은 후보 집합에서 전체 어휘로 한 번에 바꾸면 점진적으로 늘릴 때보다 결과가 나빴다. 최종 일정은 후보 수를 10,240개, 14,336개, 24,576개 순으로 늘리고, 마지막 87스텝은 전체 50,304개를 쓴다. 저자는 후보 집합을 늘려 가면서 학습이 끝날 때까지 전체 어휘 학습과의 검증 손실 격차를 없앨 수 있는지를 시험했다.
바이그램과 트라이그램 표
n-gram 표는 연속한 토큰 두 개나 세 개의 조합을 해시해 행 번호를 정한다. 토큰 두 개의 조합은 바이그램, 세 개의 조합은 트라이그램이다. 모델은 해당 행에 저장된 학습 벡터를 국소적인 토큰 패턴 정보로 사용한다. 89번 기록도 바이그램 표를 쓰고 있었지만, 그 구현은 연산량과 메모리를 많이 낭비했다. 모든 GPU가 표 사본을 하나씩 가지고 있었다. 게다가 배치 하나가 영향을 주는 행은 몇 개뿐인데도 매 업데이트마다 표 전체 크기의 기울기를 만들었다. 이 구조에서는 표를 확장하거나 트라이그램 표를 추가하면 학습이 더 느려졌다.
저자는 표의 행을 GPU 8장에 8분의 1씩 분산 저장했다. 각 GPU는 이후 배치들이 갱신할 행만 요청해 로컬 캐시에 보관한다. 역전파 때는 같은 행 번호의 업데이트를 먼저 합산해서 그 행을 저장한 GPU로 보낸다. PR 설명에 따르면 Adam 옵티마이저도 이번 스텝에 사용된 행에만 적용한다.
옵티마이저 상태도 줄였다. 행 하나에 필요한 옵티마이저 상태는 6,144바이트였다. 저자는 이를 2차 모멘트 스칼라 하나와 타임스탬프 하나로 바꿔 합계 8바이트로 줄였다. 행이 다시 업데이트될 때는 직전 업데이트의 타임스탬프로 그동안 적용하지 못한 2차 모멘트 감쇠량을 계산한다. 이와 별도로 GPU마다 두던 표 사본을 없애 GPU당 12.2GiB를 절약했다.
그 결과 표의 행 수는 377,280개에서 바이그램과 트라이그램 채널을 합쳐 8,460만 개로 늘었다. 저자는 채널마다 검증 손실 개선분과 스텝당 추가 시간을 비교해 크기를 정했다. 최종 레시피를 같은 스텝 수만큼 학습하면, 원래 크기의 표에서는 손실이 약 3.313이고 확장한 표에서는 3.278이다. 원래 크기의 표로 손실 3.28에 도달하려면 7초에서 8초가 더 걸린다.
충돌도 줄었다. 학습 토큰 1억 개를 표본으로 조사했을 때, 원래 바이그램 표의 전형적인 행 하나를 서로 다른 토큰 쌍 30개가 공유했다. 확장한 표에서는 전형적인 행 하나에 토큰 쌍이나 세 토큰 조합이 하나만 대응했다.
PR에서 저자는 이 표에 대한 반론에 직접 답했다. 먼저 제거 실험이 틀렸다는 지적에는 추가 실험으로 답했다. 표 확장을 제외한 뒤 검증 손실이 다시 3.28 미만이 될 때까지 학습 스텝을 늘리자 7초가 더 걸렸다고 한다. 그동안 표를 확장하지 않은 이유가 과도한 파라미터 수나 대회 규칙이라는 의견도 있었다. 이에 저자는 89번 기록의 표만 해도 파라미터가 2억 9,000만 개로, 모델 파라미터의 두 배 이상이었다고 반박했다. 저자는 그동안 표가 확장되지 않은 이유로 속도를 들었다. 기존 코드에서는 비용이 표 크기에 비례해 늘지만 효과는 대략 로그 함수 형태로 증가해서, 2억 9,000만 개가 그 균형점이었다는 설명이다. 새 구조에서 표의 파라미터를 650억 개에서 약 4분의 1인 160억 개로 줄여도 학습 시간은 0.17초만 단축됐다고 한다. 저자는 표를 확장하지 않고 희소 업데이트 구조만 바꿨어도 1초 이상 줄었을 것이라고 덧붙였다.
가장 흥미로운 지점
내가 가장 오래 곱씹은 숫자는 650억이다. 스피드런이 학습시키는 언어 모델은 파라미터가 1억 2,400만 개인데, 이번 기록에서 그 모델이 참조하는 n-gram 표의 파라미터는 PR 설명 기준으로 650억 개다. 저자도 PR에서 이 표가 프런티어 규모 학습으로는 확장될 수 없다고 인정했다. 그리고 Hyperstition은 프런티어 규모에서도 쓸 수 있는 기법 가운데 ANVIL II를 제외한 나머지를 공개 기록에 포함하지 않았다고 밝혔다. 이 두 문장을 함께 읽으면, 33.975초 가운데 연구소가 큰 규모 학습에도 통한다고 인정한 기법의 몫은 ANVIL과 가중치 평균의 5.09초 정도다.
하지만 이 기록을 규칙을 악용한 결과로만 볼 수는 없다. 표의 크기를 제한하던 것은 규칙보다 표 사본과 전체 크기 기울기라는 구현 비용이었고, 저자는 그 비용을 GPU 간 행 분산과 8바이트 옵티마이저 상태로 해결했다. Muon처럼 큰 모델 학습에 채택된 기법도 이 스피드런에서 처음 등장했다. 이번 기록에 제기된 반론은 이 경쟁이 앞으로 무엇을 겨루게 될지에 관한 질문이기도 하다. 큰 모델 학습에 쓰일 기법이 앞으로도 이 경쟁에서 발견될까, 아니면 H100 8장과 파라미터 1억 2,400만 개라는 조건에 특화된 최적화만 겨루게 될까.
출처
Deven Pietrzak, Hyperstition, 2026년 9월 27일. 원문: https://hyperstition.cc/training-nanogpt-in-39-9-seconds 제출 PR: https://github.com/KellerJordan/modded-nanogpt/pull/360 기록표: https://github.com/KellerJordan/modded-nanogpt#world-record-history
Muon은 행렬 파라미터의 업데이트를 뉴턴-슐츠 반복으로 직교화한다. 2024년 10월 4일 켈러 조던 등이 스피드런 세 번째 기록에서 처음 도입했고, 이후 문샷 AI의 Kimi K2 학습에 변형판인 MuonClip이 쓰였다. ↩︎
저장소 README 기록표에는 이 기록이 92번(0.665분)으로 등재되어 있다. 원문과 PR이 비교 대상으로 삼은 89번 기록과 이 기록 사이에 90번(1.13분)과 91번(1.126분)이 있다. 91번 기록과 비교하면 단축 폭은 약 41%다. ↩︎
그래프 범례에는 ANVIL II를 22회, 89번 기록을 8회 측정한 것으로 표시돼 있다. 본문과 PR에 적힌 측정 횟수는 각각 18회와 9회다. 시간 축 그래프의 가로축은 계측 시간(instrumented time)이며, ANVIL II 곡선은 공식 기록 39.914초가 아닌 44초 부근에서 끝난다. ↩︎
환산에 쓴 비율은 손실 1밀리나트(0.001나트)당 164밀리초다. 저자는 제거 실험의 단축 시간 합계가 33.98초가 되도록 이 비율을 정했다. 실제로 측정한 비율은 1밀리나트당 120밀리초에서 250밀리초 사이였고, 164밀리초도 이 범위에 포함된다고 밝혔다. ↩︎